Atria Dawn:智能体超级智能的黎明 Atria Dawn: The Dawn of Agentic Superintelligence
744B MoE 智能体模型以可验证经验流水线训练,并用 769 条任务记录剖析人机分工。
前置知识
MoE(混合专家模型)
Mixture-of-Experts 将 Transformer 的前馈层替换为多个'专家'子网络,配合门控路由 $g(x)$ 只激活其中一小部分,从而在总参数量巨大的情况下保持单次前向的计算量可控。本文的 Atria Dawn 建立在 744B 参数的 MoE 底座(Z.ai 提供)之上。
理解论文的模型规模声明(744B 参数)和'基础智能体模型'定位,需要知道 MoE 是当今前沿实验室扩大容量的主流路线。
可验证奖励 / 可验证经验
区别于依赖人类偏好打分的 RLHF,可验证奖励(RLVR)用外部客观信号判定输出对错:单元测试、程序执行结果、数值指标等。本文把它扩展为'可验证经验流水线':每条训练经验必须同时绑定任务、轨迹、中间工件和验证证据四要素,验证信号还扩展到文件状态、几何检查、来源证据与人工标准。
这是本文训练方法的核心概念,第 2 节的全部设计和 Open Challenge 2 的讨论都建立在此基础上。
递归自我改进(RSI)
指 AI 系统参与研发自己的后继模型,且每次能力提升都转化为更强的研发能力,形成自我强化循环。论文用三阶段框架刻画人机角色演化:模型作为研究对象 → 任务级执行者 → 项目级同事,RSI 是第四阶段的猜想。
全文的叙事主线:作者用自身研发数据论证'当前离自持 RSI 还差什么',四个 Open Challenge 都围绕这一概念展开。
智能体评测基准
评估模型在多步工具调用环境中完成真实任务能力的基准族,如 BFCL(函数调用)、BrowseComp(深度浏览检索)、SWE-bench Pro(真实软件工程)、Terminal-Bench(终端操作)、MLE-bench(机器学习工程)、CyberGym(网络安全漏洞分析)。得分通常为任务通过率百分比。
论文用 16 个此类基准与六个前沿模型对比(表 1),读懂结果章节必须熟悉这批指标的含义与量纲差异(如 GDPval 是 1500+ 的分数制)。
研究动机
长期以来,语言模型在 AI 研发中主要扮演两种角色:要么是被研究改造的对象,要么是执行明确定义任务(写代码模块、跑实验、看日志)的工具。即便智能体能力近年快速爆发——自动化算法发现系统已能提出候选方案、运行实验并根据反馈修改——单纯的任务基准分数仍无法回答一个更根本的问题:在一个真实的模型研发项目里,到底是谁在识别值得做的问题、谁在多个候选方法间做取舍、谁在解读不确定的实验结果并决定下一步方向?OpenAI 与 Anthropic 各自报告过内部观察(例如超过一半的 4–8 小时成功任务需要至少一次人工干预),但都停留在定性层面,缺少对'谁提方案'与'谁做选择'、'节省的时间'与'被创造的可能性'的量化区分,也没有团队把自家前沿模型的完整研发过程作为样本公开剖析。这导致关于递归自我改进(RSI)何时到来、人类还剩什么作用的讨论长期悬浮在思辨层面。
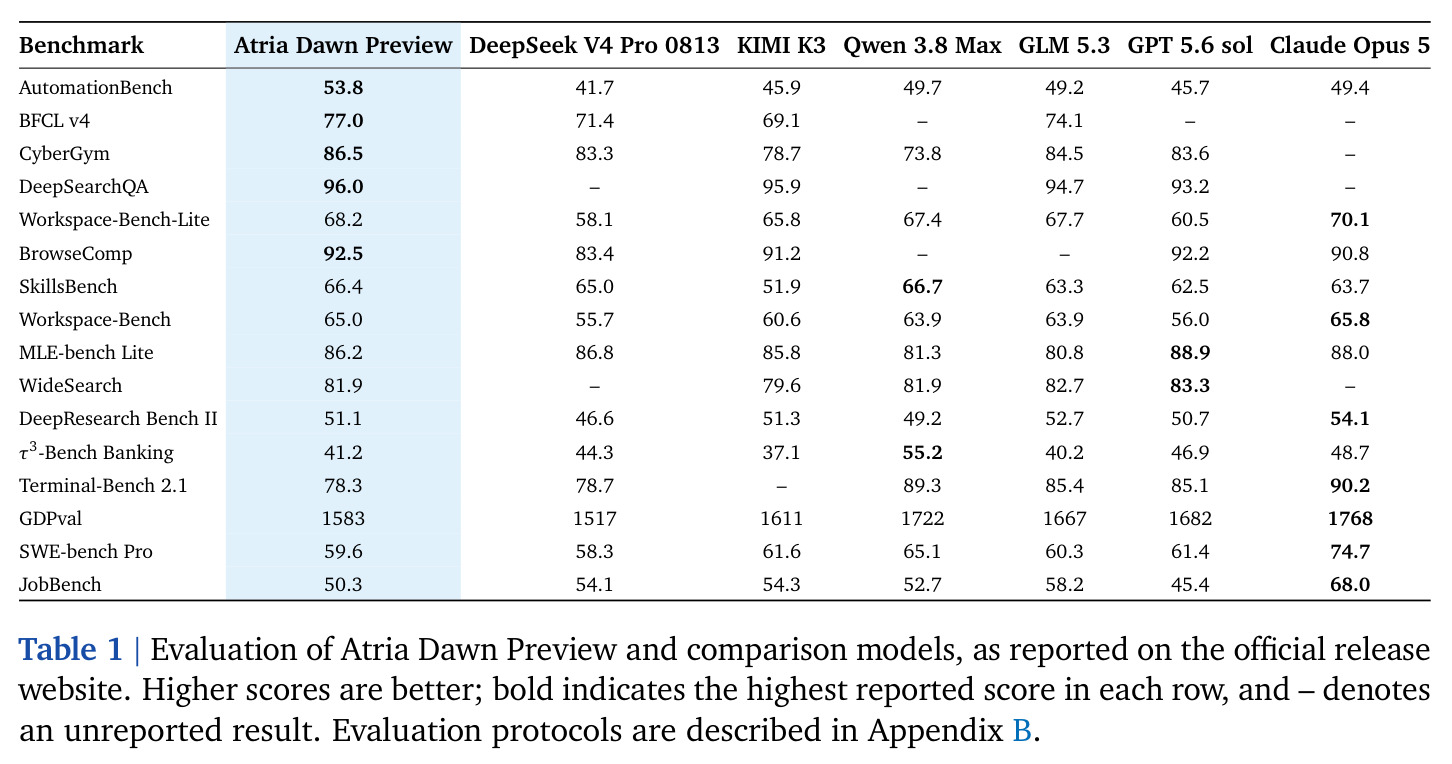
本文的目标是本文目标有两个层面。工程层面:推出 Atria Dawn Preview——一个面向科研与工程工作流的基础智能体语言模型,构建在 744B 参数的 MoE 底座(Z.ai)之上,通过'可验证经验流水线'(Verifiable Experience Pipeline)训练,目标是在真实世界扩展智能体生产力的前沿。作者在 16 个覆盖工具调用、深度搜索、工作台效率、专业交付、软件/终端工程、机器学习工程与网络安全的基准上,与 DeepSeek V4 Pro、KIMI K3、Qwen 3.8 Max、GLM 5.3、GPT 5.6 sol、Claude Opus 5 六个前沿模型对比,并期望在多项上取得最高分。科学层面:把 Atria Dawn 自身的研发过程当作案例研究,用 769 条任务记录、56 名参与者的结构化自报数据和 agent 日志,量化回答'当 AI 参与研发 AI 时,人机分工究竟如何演化、人类判断是否仍不可或缺',并据此讨论走向 RSI 还缺哪些能力与治理机制。
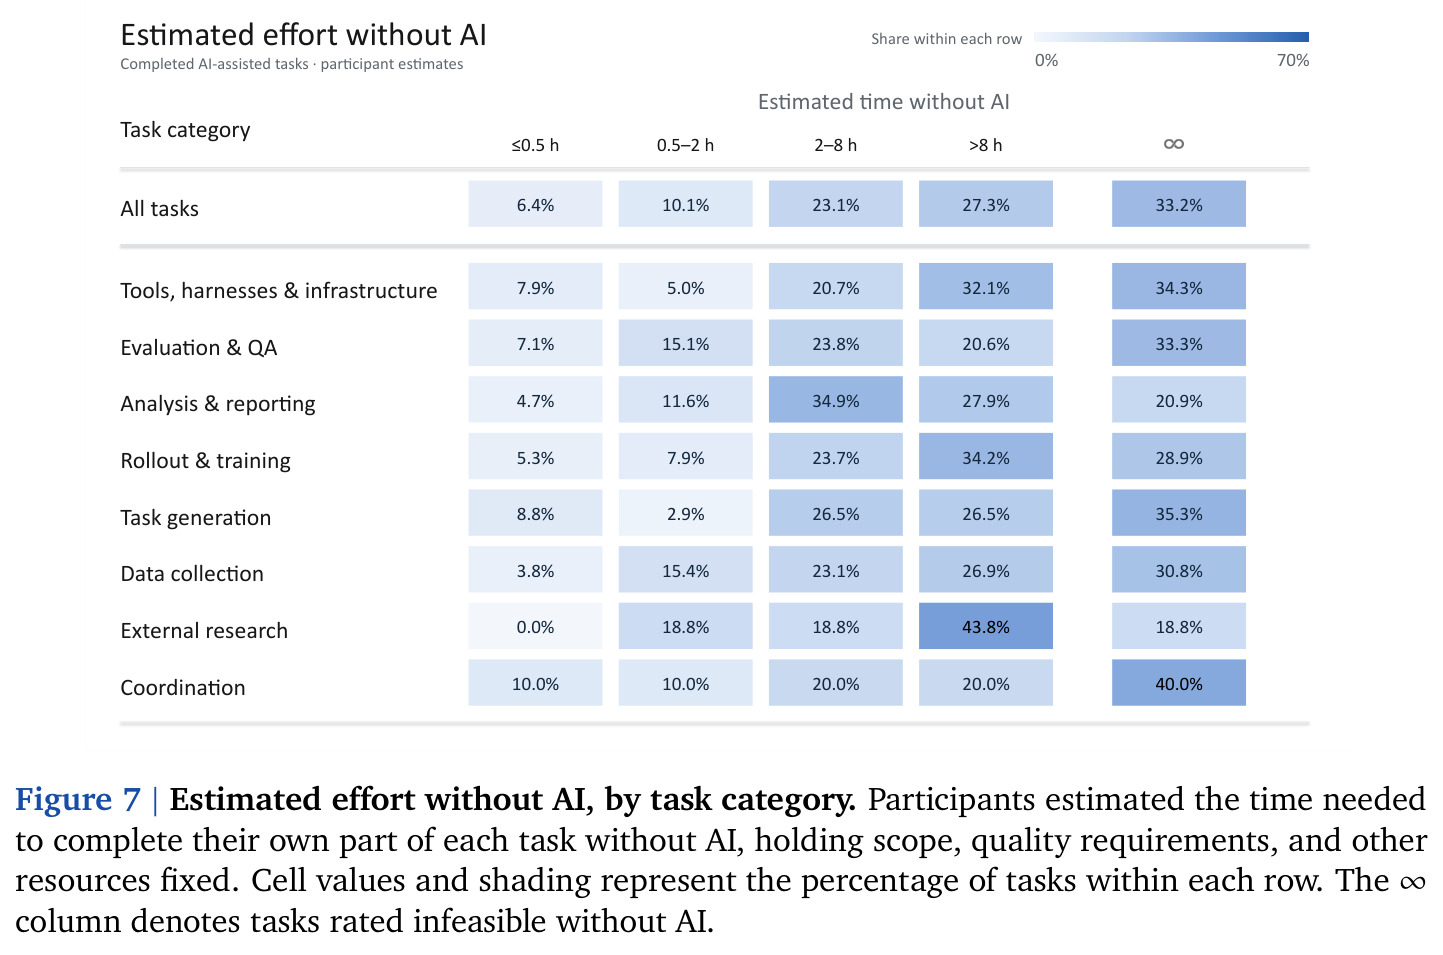
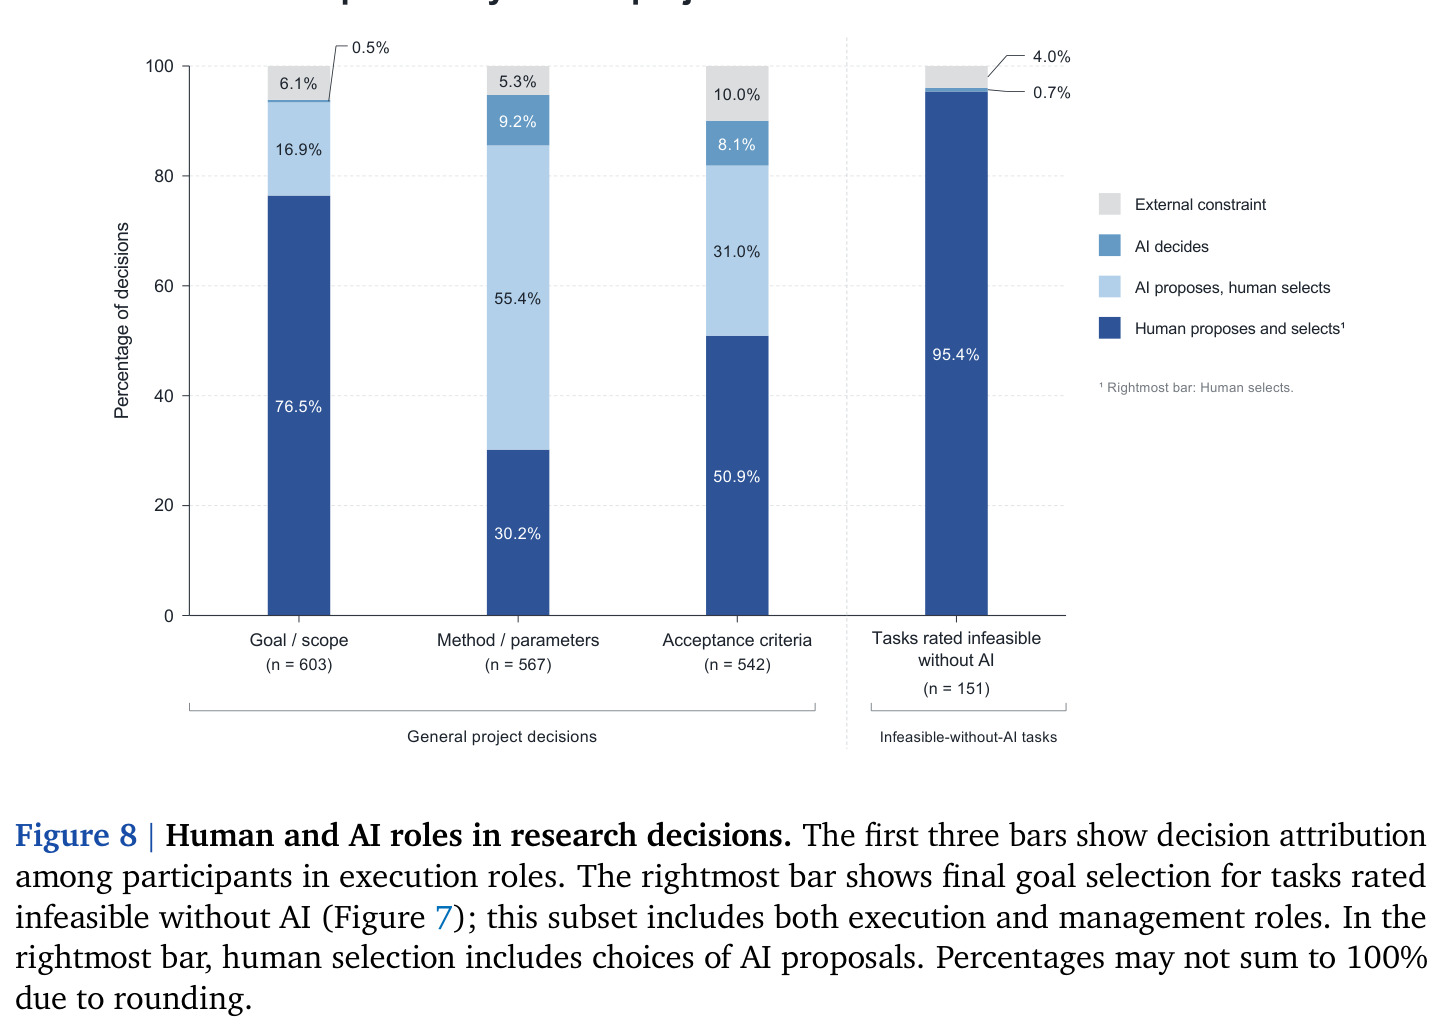
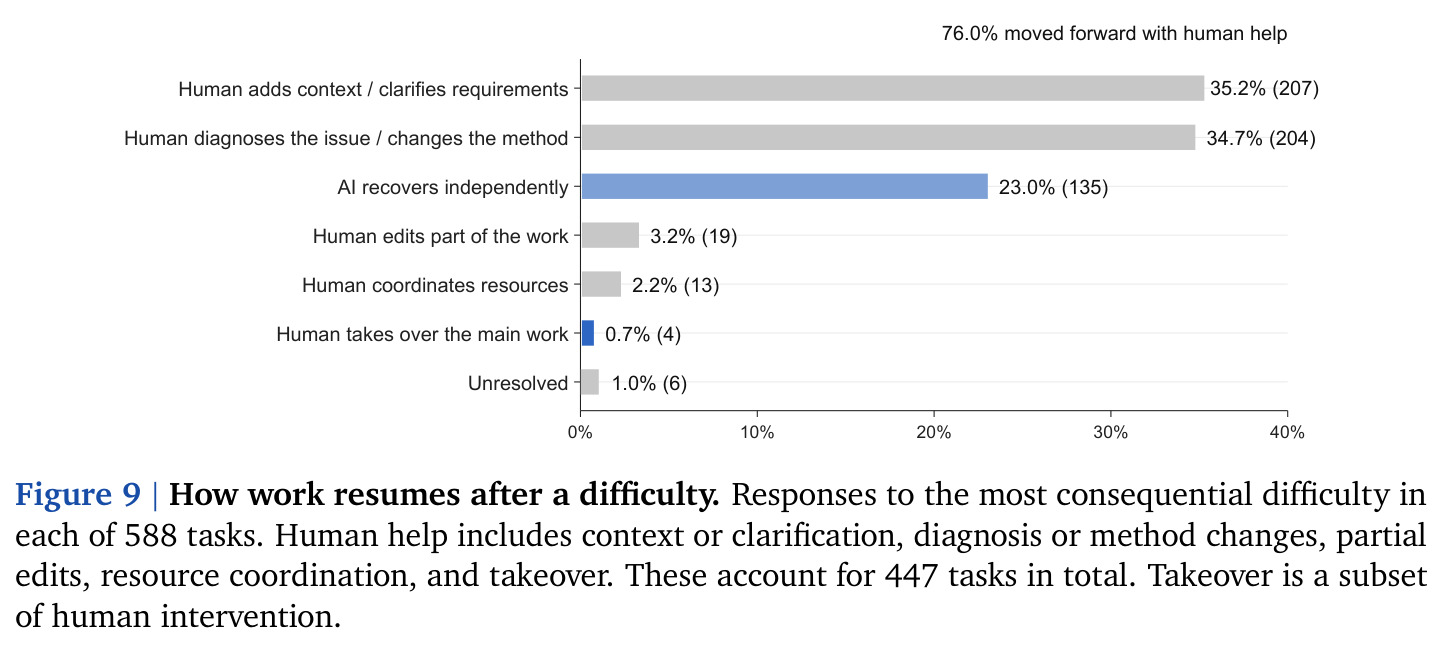
与已有工作不同的是,独特切入角度是'自我解剖'式的实证方法。以往关于 AI 参与 AI 研究的讨论要么是思辨性的(RSI 何时到来),要么是基准驱动的;本文第一次把一个前沿模型的完整研发周期变成可量化的观察窗口:769 条任务、739 条有明确 AI 使用答复(96.5% 用了 AI)、27/56 名参与者报告过'没有 AI 就不可能完成'的任务。方法论上的三个区分尤其新颖:其一,把决策拆成'谁提出选项'与'谁做最终选择'两个维度,从而发现 AI 提案占方法类决策的 55.4%,但最终决定权只有 9.2% 归 AI;其二,用'固定任务范围、质量要求与资源,能否独立完成'的反事实提问,把'节省的时间'与'被创造的可能性'分开(33.2% 的 AI 辅助任务属于后者);其三,追踪任务卡住后如何恢复(补充上下文 35.2%、诊断/换方法 34.7%,人工接管仅 0.7%),刻画出'判断稀缺、执行廉价'的新型分工,而不是笼统地说'AI 增强了人类'。
核心方法
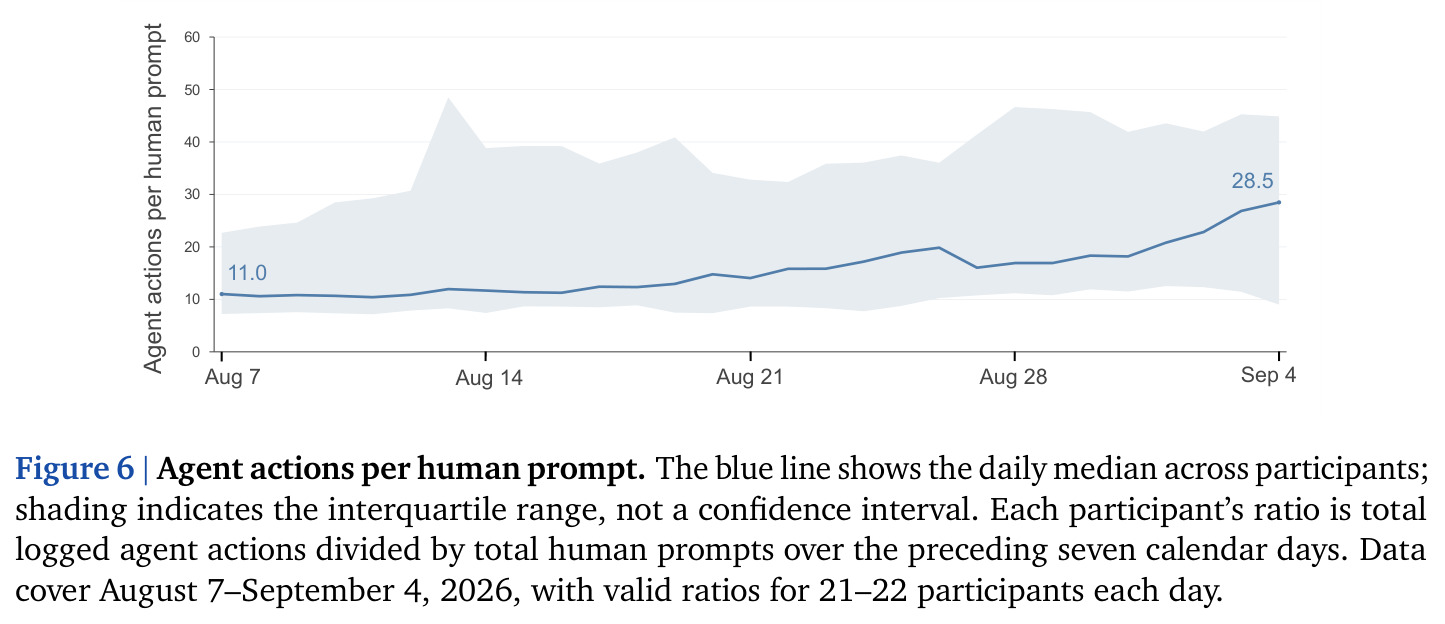
整体思路分两条并行线。训练线:作者认为通用智能体能力的来源不是更多人类示教数据,而是'与可执行环境绑定、结果可被外部信号验证'的经验。每条训练经验必须同时包含任务、轨迹、中间工件和验证证据四要素:模型观察环境状态、调用工具、产出代码/文件/报告等工件、根据反馈迭代修正,最终由测试用例、实验指标、文件与应用状态、几何检查、来源证据或人工定义标准来判定成败,只有四要素齐全的经验才沉淀为可复用能力。分析线:与训练并行,团队要求 56 名参与者在完成任务时留下结构化记录(是否用 AI、最关键的困难、AI 输出的去向、决策归属、没有 AI 需要多久),并对同一批 22 人计算'每日 agent 动作数 / 人类 prompt 数'的比值 $r = \text{agent actions}/\text{human prompts}$,取 7 天滚动窗口的中位数,得到从 8 月 7 日的 11.0 上升到 9 月 4 日的 28.5 的趋势,四分位距同时变宽,说明变化并不均匀。
核心创新是'可验证经验'(Verifiable Experience)这一经验构造范式,以及'把研发过程本身当数据集'的研究设计。与主流 RLHF/RLVR 的区别有三点:第一,验证信号是异构且任务特定的——代码任务用可执行测试,科研任务用实验指标与几何检查,文献分析用来源证据支持,专业交付用人工标准,而不是单一的标量奖励;第二,经验纳入训练前要经过轨迹治理(trajectory curation):剔除不完整、自相矛盾、重复和行为无效的样本,同时保留任务-轨迹-工件-证据的链接,使'失败运行'在结果可独立判定时也能充当诊断样本;第三,失败分析反哺任务构造——无效工具选择、验证不完整、证据缺失、恢复失败等反复出现的问题会催生新任务和新的质检环节,让流水线自身形成闭环。作者明确承认:这仍只是逐任务的经验积累,与 RSI 所需的'把经验转化为内在研究能力'之间还有本质鸿沟,这一坦率定位本身就是论文论点的一部分。
方法步骤详情
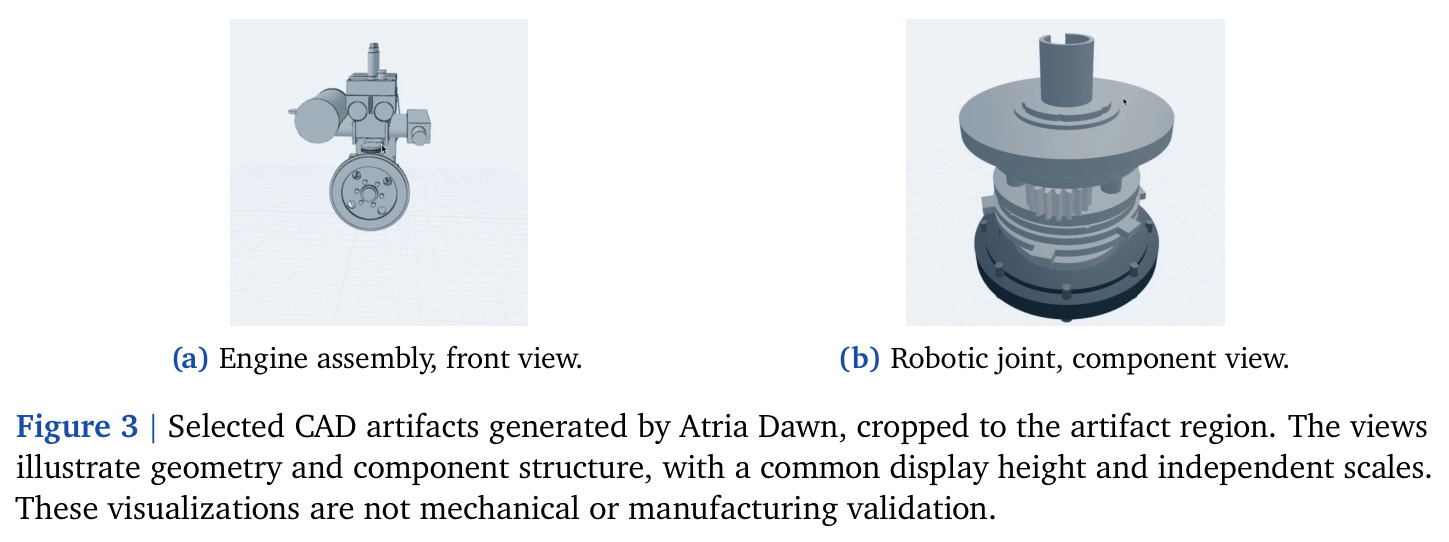
第一步,任务与环境构造:为每个训练任务接入真实执行环境(shell、QEMU、CAD、浏览器、实验脚本等),并定义外部验证信号。第二步,rollout 采集:agent 观察状态、选择工具、检查输出、按反馈修正动作,记录完整轨迹与中间工件。第三步,结果验证:按领域用可执行测试、实验指标、文件状态、几何结构、来源证据或人工标准判分。第四步,轨迹治理:删除不完整、矛盾、重复、行为无效的样本,保留任务-轨迹-工件-证据四要素链接;结果可独立确证的失败样本保留为诊断案例。第五步,失败分析反哺:针对无效工具选择、验证不完整、证据缺失、恢复失败等模式追加任务并改造环境。第六步,长工作流经验:记录启动作业、检查日志与工件、修订执行计划的完整过程。第七步,评估:在 16 个基准上引用官方发布分数与六个前沿模型对比。第八步,协作分析:汇总 769 条任务记录与 agent 日志,统计 AI 使用率、可行性估计、决策归属(提案方 vs 终选方)、困难恢复方式与输出修订去向。
技术新颖性
技术层面,Atria Dawn 是少数公开把'可验证经验流水线'作为核心训练配方的智能体基础模型(744B MoE 底座),其异构验证信号设计与轨迹治理超出了标准 RLVR 的范畴;把失败运行转化为诊断样本、用失败模式驱动任务生成,与 Self-Refine/Reflexion 这类推理时反思有本质区别——它改变的是训练分布而非推理流程。研究设计层面,作者没有停留在'我们的模型很强',而是用 769 条任务记录、56 人同批次的自报数据、7 天滚动比值 $r$ 从 11.0 升至 28.5 等量化指标,拼出一幅人机分工图景,并给出可检验的结论:AI 的提案比例可在 16.9%(目标类)到 55.4%(方法类)之间三倍多摆动,而终选权稳定地留在人类手里(AI 仅 6.1%–9.2%);76.0% 的卡壳任务靠人类供给信息推进,人工接管只占 0.7%。四个 Open Challenge(方向多样性、经验到能力的转化、有意义的监督、授权分配协议)为后续研究提供了明确议程。
实验结果
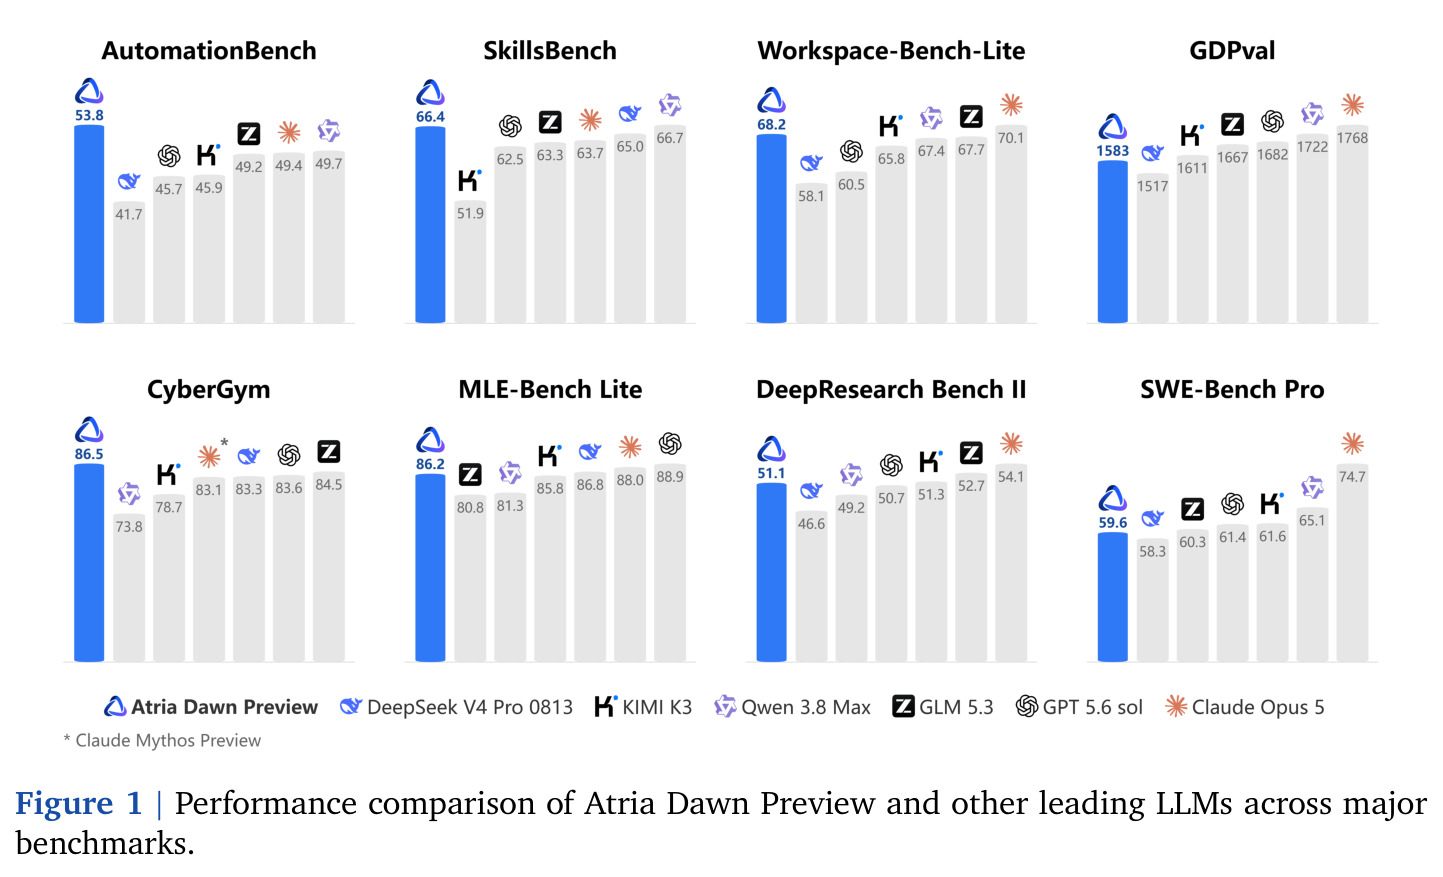
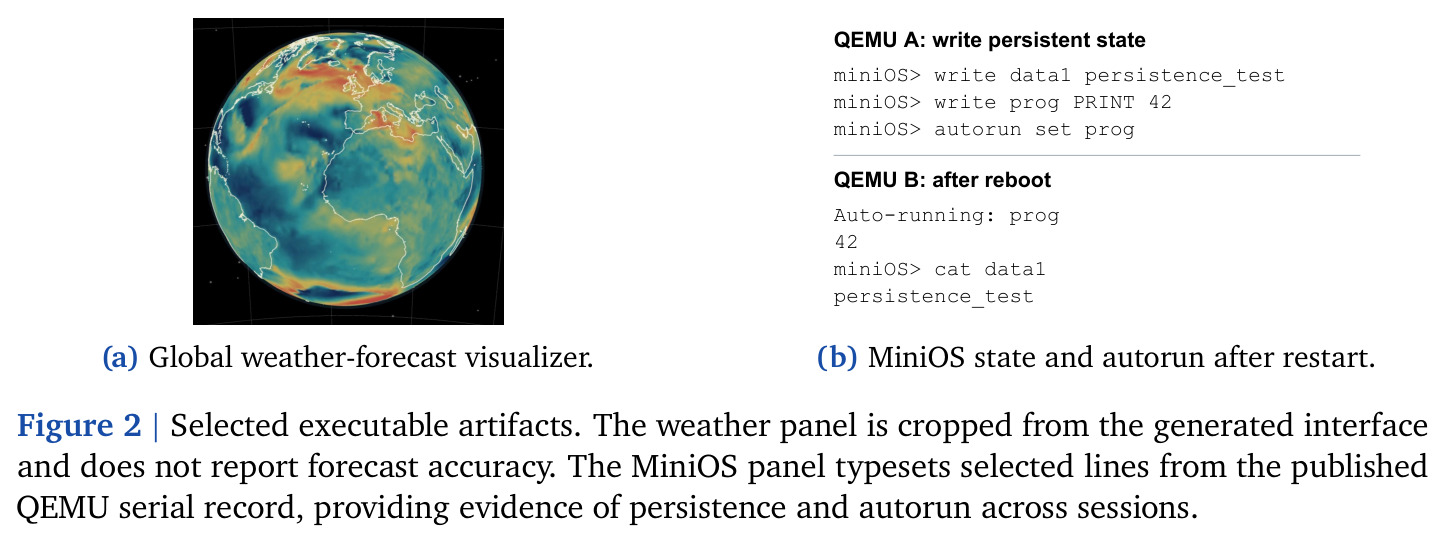
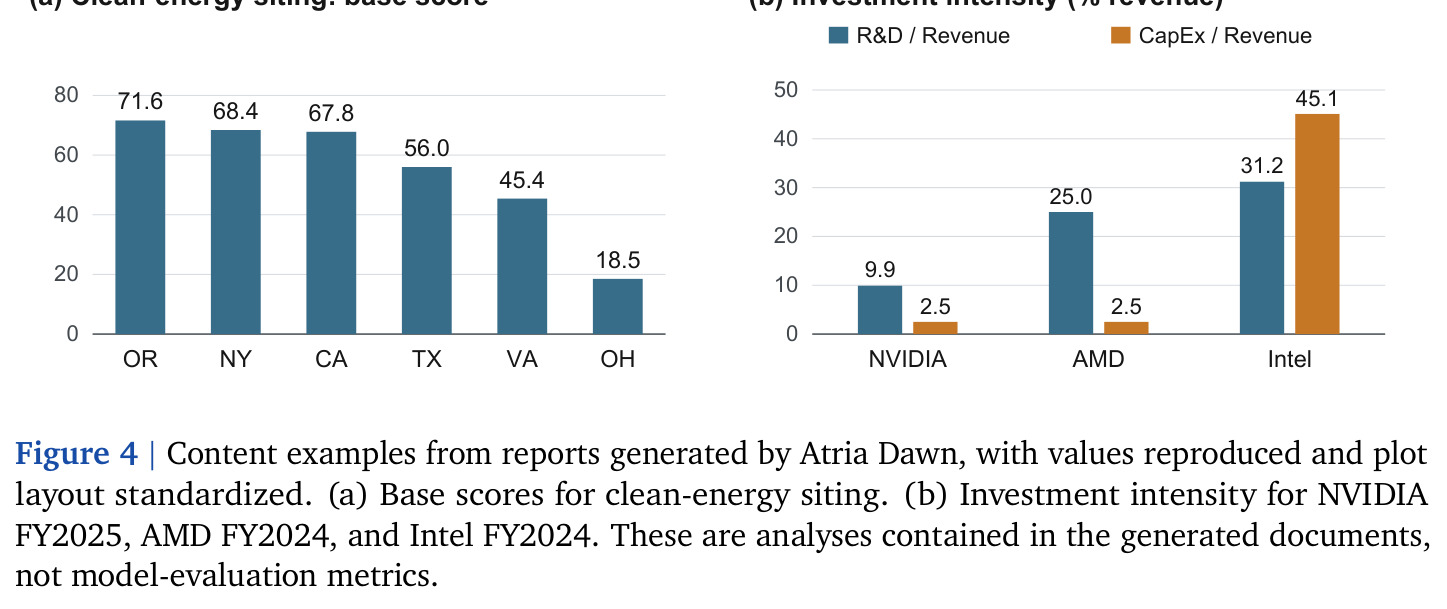
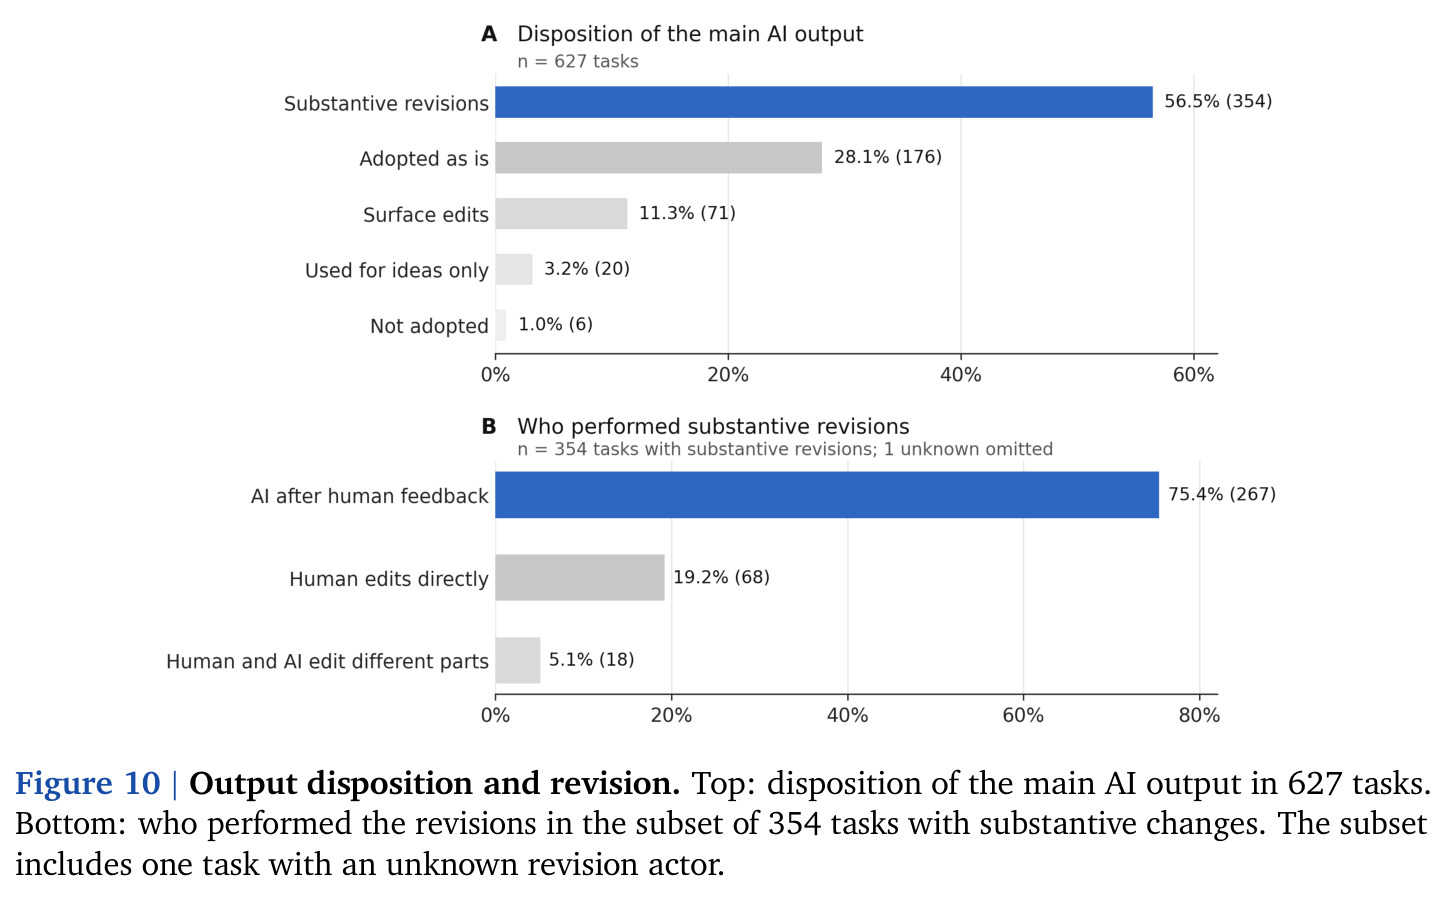
基准成绩(表 1):16 项基准中 5 项最高分——AutomationBench 53.8(超 Qwen 3.8 Max 4.1 分)、BFCL v4 77.0、DeepSearchQA 96.0、BrowseComp 92.5、CyberGym 86.5;另 3 项第二(差距 ≤1.9 分);短板在长程专业交付(SWE-bench Pro 59.6、GDPval 1583)。案例:100GB 数据训练 0.4B ViT 45,000 步预测 69 个变量;GDN 优化 1.46×、54 个负载过 52 个;20 分钟建成 MiniOS。协作分析:739 条有答复任务中 96.5% 用 AI;每日中位数比值 $r$ 从 11.0 升至 28.5;455 条 AI 辅助任务中 151 条(33.2%)无 AI 不可行;方法类决策 AI 提案 55.4% 而人类终选 85.5%,不可行子集 95.4% 由人定目标;588 条困难任务 76.0% 靠人类供给信息推进、人工接管仅 0.7%;627 条输出 95.9% 被采纳。结论:人类贡献集中于判断,agent 集中于提案与执行。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AutomationBench(自动化工作流) | 分数(越高越好) | 53.8 | Qwen 3.8 Max 49.7 | +4.1,16 项中优势最大的最高分 |
| BFCL v4(函数调用) | 分数 | 77.0 | GLM 5.3 74.1 | +2.9,最高分 |
| DeepSearchQA(深度搜索) | 分数 | 96.0 | KIMI K3 95.9 | +0.1,最高分 |
| BrowseComp(浏览检索) | 分数 | 92.5 | KIMI K3 91.2 | +1.3,最高分 |
| CyberGym(网络安全) | 分数 | 86.5 | GLM 5.3 84.5 | +2.0,最高分,超 GPT 5.6 sol 83.6 |
| MLE-bench Lite(ML 工程,HumanRank) | 分数 | 86.2 | KIMI K3 85.8 | +0.4,居第一梯队 |
| SWE-bench Pro(软件工程) | 解决率 % | 59.6 | Claude Opus 5 74.7 | 落后 15.1 分,与 DeepSeek V4 Pro(58.3)相当 |
| Terminal-Bench 2.1(终端任务) | 分数 | 78.3 | Claude Opus 5 90.2 | 落后 11.9 分,接近 DeepSeek V4 Pro(78.7) |
| GDPval(专业交付) | 分数(1500+ 制) | 1583 | Claude Opus 5 1768 | 落后 185 分,但超 DeepSeek V4 Pro 1517 |
局限与改进
作者承认的局限:表 1 分数直接引用各模型官方发布网站,评测协议只在附录描述,跨模型可比性存疑;性能随领域波动明显,GDPval、JobBench 等长程专业任务差距清晰;GDN 案例中 54 个正式工作负载只通过 52 个,1.46× 是开发期比值而非最终基准分;第 2.3 节案例是'精选演示'而非平均成功率估计,且气象面板不报告预测精度。我自己的观察:其一,协作分析完全依赖参与者自我报告——'没有 AI 是否可行'是无法验证的反事实估计,而自报者身处一篇以 AI 协作为卖点的叙事之中,有夸大动机;其二,样本来自单一公司单一项目,56 人团队、96.5% AI 使用率可能与该组织的工程文化强耦合,外部效度未知;其三,$r$ 比值上升既可能反映委托增加,也可能是 prompt 变短或工具调用碎片化的假象,论文未排除混淆;其四,模型是 Preview,权重与训练超参未公开,最核心的主张难以独立复核;其五,正文存在明显的排版/OCR 紊乱段落,说明发布流程本身也高度依赖自动化生成。
独立分析的弱点
第一,可行性数据(33.2% 不可行)是主观反事实:同一任务'无 AI 是否可行'高度依赖参与者的技能与想象力,建议未来用对照实验(随机禁用 AI 若干周)或至少双人独立估计后取交集来校准。第二,决策归属把'提案'与'终选'分开是亮点,但没有测量提案质量——AI 提出的 55.4% 方法里有多少被原样采纳、多少被大幅改造?建议增加'提案保真度'标注。第三,$r$ 的 7 天滚动窗口把不同粒度的 agent 行为(一次 bash 调用与一次完整实验运行)等权计数,建议按'有效工作单元'归一化,并区分只读操作与写操作。第四,表 1 混用各家官方自报分数,协议(算力预算、上下文长度、工具权限、尝试次数)不统一,建议统一由第三方复测后再排名。第五,作者呼吁建立 agent 间通信通道来缓解研究方向同质化,但未给出任何原型或度量方式,属于愿景而非方案。第六,对'人类沦为只会说 yes 的审稿人'的担忧虽然深刻,但论文没有提出可操作的监督机制设计(如审计链、抽样深检、分歧触发复核),只停留在原则倡议层面。
未来方向
作者提出的四个 Open Challenge 直接构成路线图:(1) 如何让 AI 在结果出现之前生成多样化研究方向并评估其潜在价值——建议方向包括建立不同工作 agent 之间的通信渠道、把低成本探索组织成系统化流水线,作者也不认为'预判修剪搜索空间'是人类永久优势;(2) 如何把跨轮次积累的经验递归转化为内在研究能力——作者点名 test-time training 值得尝试,并推测可能需要'将记忆与能力分离'的架构重设计,同时呼吁构造专门评估'研究能力'的基准;(3) 当 AI 揭示超出人类想象的可能性时,人类如何保持有意义的目标设定与有效监督——需要一个与 AI 共同演化的框架,帮研究者借 AI 扩展对研究可能性的理解并发现其盲区;(4) AI 主导研发时的授权分配与对齐标准——能力每前进一步就应配套成比例的对齐与监督投入(引 Greenblatt et al. 2024),并明确谁定义对齐目标、谁承担风险、谁负责问责。基于本文成果还可延伸:把 769 条任务记录的标注协议开源为'人机协作基准';研究 $r$ 比值何时饱和;用本文的失败模式分类自动触发训练环境改造。
复现评估
复现难度:极高。论文未公开模型权重、训练数据、超参数或流水线代码,Atria Dawn Preview 仅以'Preview'名义发布能力演示(附 GitHub 与 HuggingFace 链接,但正文未说明开放范围);744B MoE 底座来自 Z.ai 而非作者从头训练,第三方完全无法重建训练过程,需要的数据与算力也远超学术实验室。可部分复现的部分:16 个基准均为公开评测(AutomationBench、BFCL v4、CyberGym、BrowseComp、SWE-bench Pro、Terminal-Bench 2.1、MLE-bench Lite 等),可以对照官方发布分数独立复测排名;协作分析的标注协议(AI 使用、可行性估计、决策归属、困难恢复、输出去向等字段)在正文与图表中描述得足够具体,其他团队可以在自己的研发流程中复制这套测量方法;案例中的气象预测(100GB 数据、0.4B ViT、45,000 步、69 变量)与 MiniOS 有可执行工件截图佐证,但无逐一复验脚本。总体而言,这是一篇'结论可核、过程难复'的论文。
论文图表
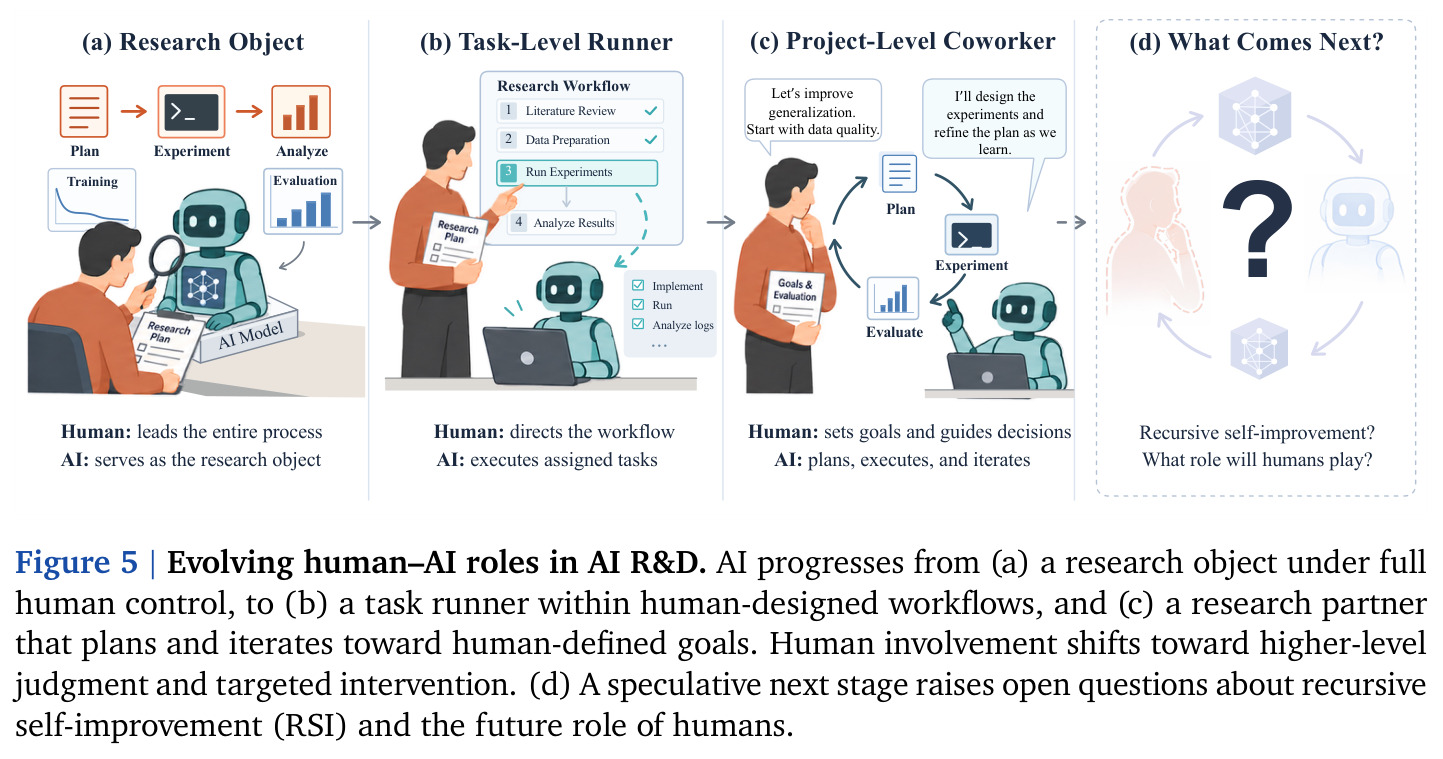
四格概念图:人类主导全程 → 人类指挥工作流、AI 执行任务 → 人类定目标、AI 规划并迭代 → 猜想性的 RSI 阶段(人类角色未知)。
这是全文分析框架的基石,第 3 节的三阶段演化和所有协作统计都在回答'我们现在处于哪一格、第四格需要什么'。