HarnessVLN:通过智能体框架统一免训练具身导航 HarnessVLN: Unifying Training-Free Embodied Navigation through an Agent Harness
统一Agent Harness协调记忆、空间证据与工具执行,免训练统一指令与目标导航
前置知识
具身导航(Embodied Navigation)
指智能体在三维环境(模拟器或真实世界)中仅凭自身传感器观测来移动的技术:它需要解读 RGB-D 观测、积累空间知识并输出底层动作,以完成两类核心任务——按自然语言指令走完路线的指令跟随导航(VLN-CE 上的 R2R、RxR),以及找到指定目标物体的目标导航(HM3D-v2、HM3D-OVON)。
本文的两大任务家族、四个评测基准(R2R、RxR、HM3D-v2、HM3D-OVON)都建立在这个问题上,所有实验指标均围绕导航是否成功展开。
免训练/零样本导航(Training-free / Zero-shot)
不在目标导航任务上做任何梯度训练或微调,而是直接复用预训练多模态大模型(MLLM)的语义与推理能力来解读指令、定位目标、规划探索,把路径规划与底层控制交给现成模块。与之相对的是 NaVid、NavFoM、ABot-N0 等需要大规模轨迹数据训练的导航基础模型。
HarnessVLN 的核心卖点就是 zero-shot、training-free:理解它与训练式方法的优劣对比,是读懂 Table 2 与 Table 3 实验设定和结论的前提。
多模态大语言模型(MLLM)规划器
以 GPT-5.5、GPT-5.6-luna、Qwen-3.8-27B 为代表的多模态大模型,能同时理解图像与文本。在免训练导航系统中,它通常充当高层规划器:接收观测与任务上下文,提出“走向某处”“停止”等语义操作,再由下游模块落地执行。
HarnessVLN 中 MLLM 只负责提建议,是否执行由 Harness 裁决——理解“规划与执行分离”这一角色划分是读懂全文设计哲学的关键。
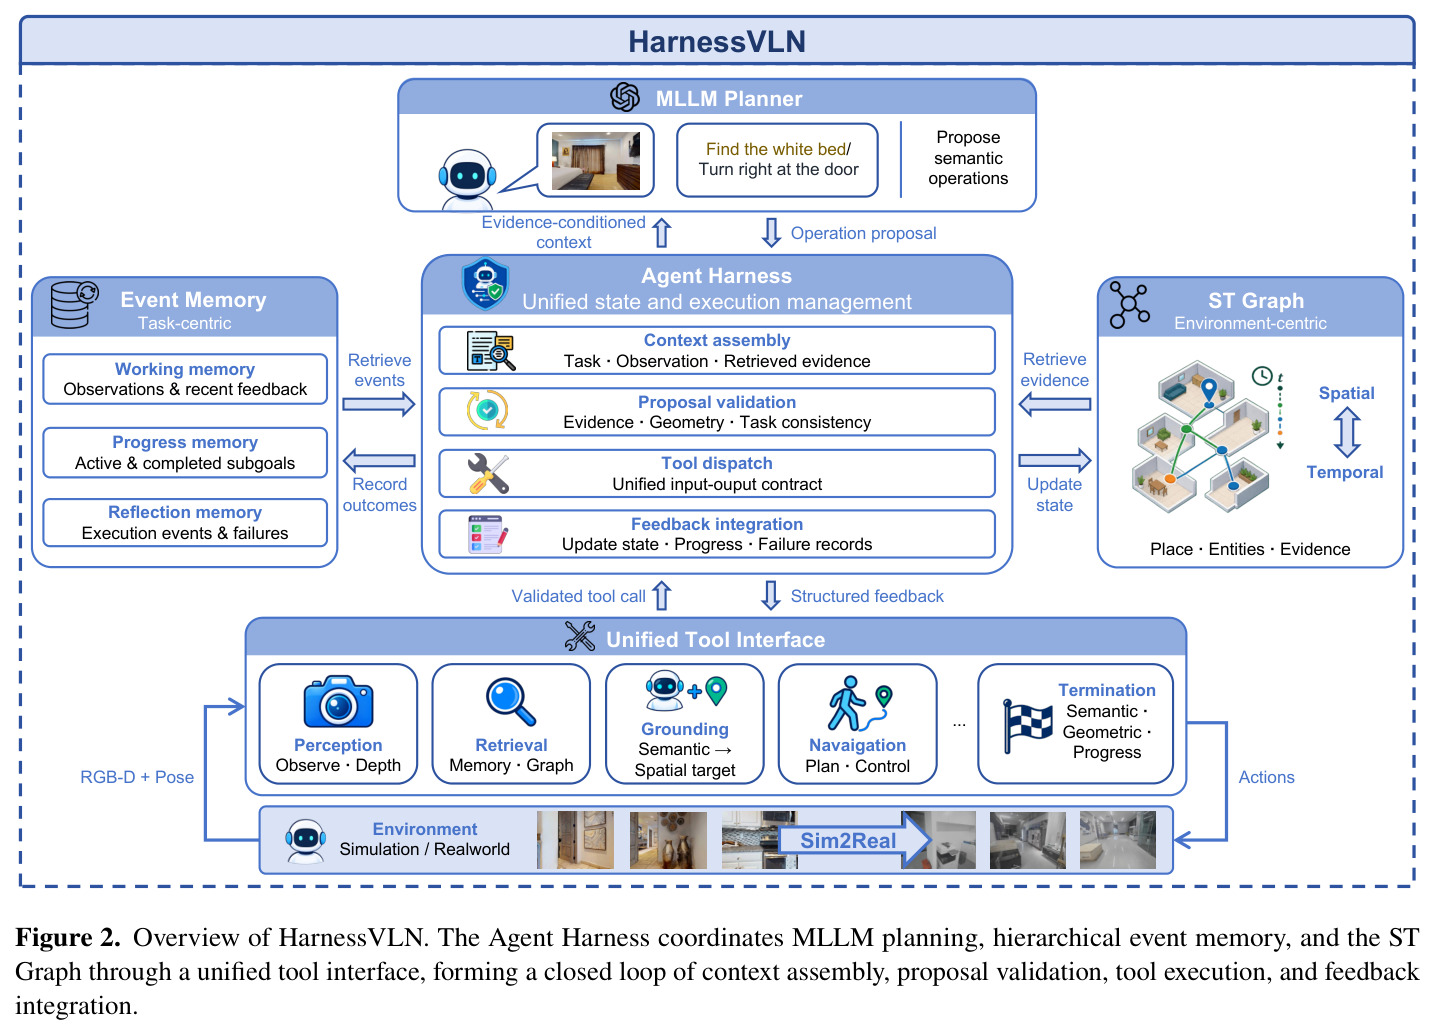
Agent Harness(智能体框架)
一种把推理模型、工具、记忆和环境反馈组织进统一运行时的智能体架构:每次模型提出的操作都要经过框架校验后才分发给工具执行,工具返回结构化反馈再更新内部状态。此前 Aspire(机器人程序修复)和 Harness VLA(操作原语协调)已采用该范式,但都集中在机械臂操作任务。
HarnessVLN 的贡献正是把 Agent Harness 范式推广到长时程导航任务,论文标题中的 “Harness” 即来源于此。
导航评测指标 SR / SPL / OSR / nDTW / NE
SR 是成功到达目标的回合比例;SPL 在 SR 基础上按实际路径与最短路径之比加权,衡量效率;OSR 表示停止时刻目标曾出现在视野内的比例,OSR 与 SR 差距大说明“看到了但没停对”;nDTW 衡量实际轨迹与参考轨迹的贴合度;NE 是终点到目标的米制距离误差。
论文所有结论都靠这些数字说话,OSR 与 SR 的差距更是其停止验证模块消融分析(Table 4)的直接依据。
时空图(Spatiotemporal Graph, ST Graph)
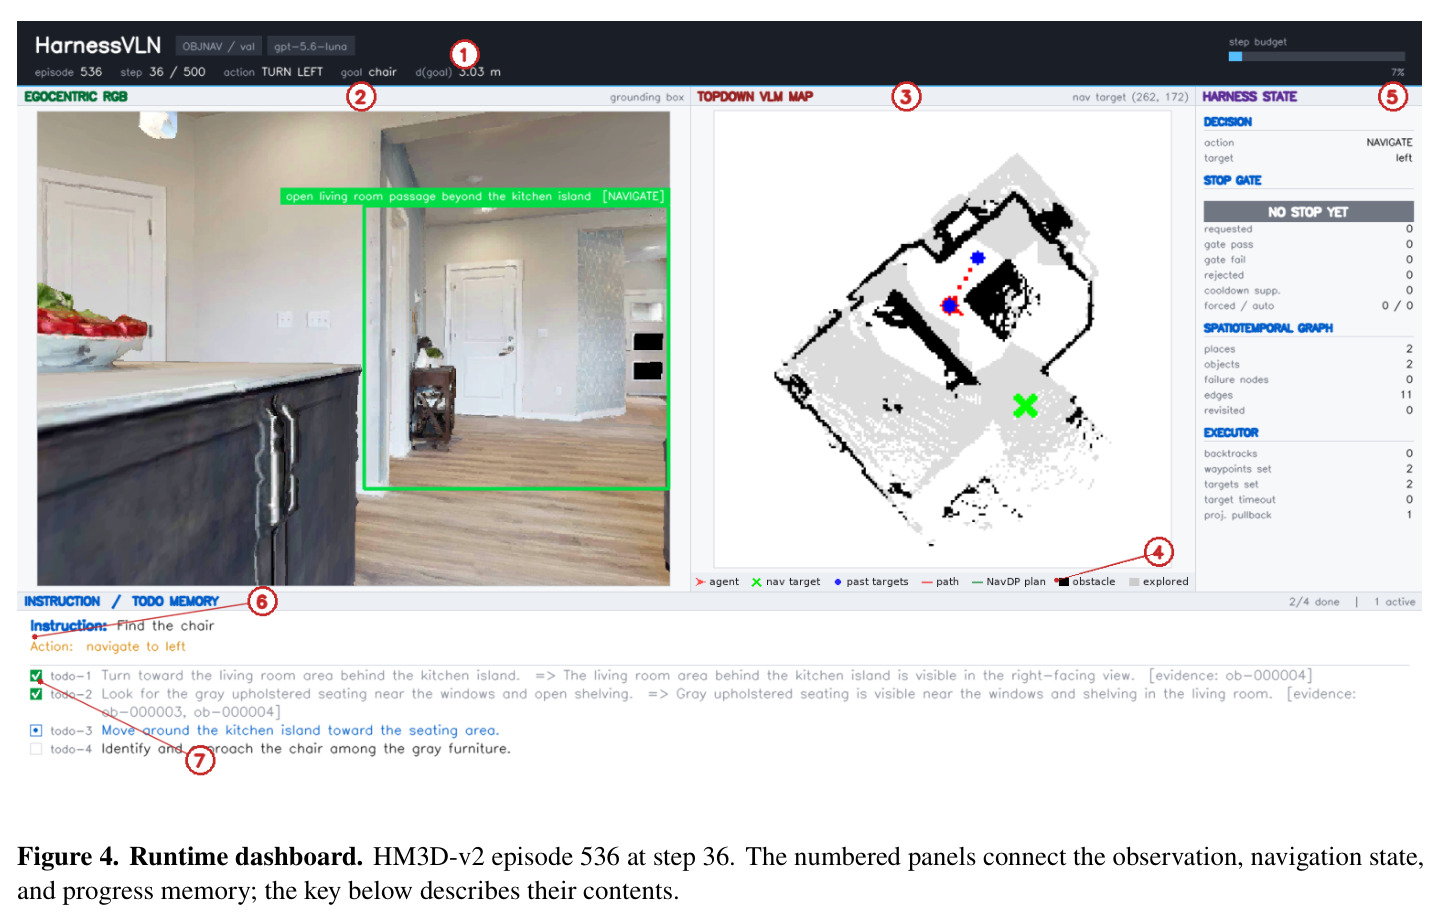
一种带时间戳的空间记忆结构:地点节点记录去过哪里、由哪些观测支持,实体节点记录目标物体假设及其置信度,边(如 ObservedFrom、NavigableTo)记录观测视角与拓扑连接。它能区分“当前证据”与“过时假设”,并在失败发生处留下轻量标注供恢复时检索。
ST Graph 与分层事件记忆是 HarnessVLN 的两大记忆支柱,消融实验显示去掉图检索后 R2R 上 SR 掉 6 个百分点。
研究动机
具身导航的两条主流路线各有痛点。训练式方法(NaVid、Uni-NaVid、NavFoM、ABot-N0 等)从大规模轨迹演示中学习“观测+语言到动作”的映射,在目标任务上很强,但换一个任务形式或环境往往需要重新收集数据并训练。免训练方法虽然借助 MLLM 的语义能力避开了训练,却普遍把模型当成任务特定流水线中的规划器:感知模块喂观测,规划器提子目标,下游模块负责落地。问题在于,语义上说得通的计划未必有空间证据支撑——交互过程中,过时的观测、不可达的目标和执行失败会让后续规划偏离真实任务状态,典型表现为反复冲向一个实际在墙后的目标、在原地打转,或者明明还没走到指令描述的地标就提前停下。识别到目标不等于能走到,发出动作不等于完成子目标,这正是 R2R 等基准上 OSR 与 SR 动辄相差二三十个百分点的原因。
本文的目标是本文的目标是构建一个零样本、免训练的导航框架 HarnessVLN:用一个统一的 Agent Harness 协调感知、检索、grounding、导航、恢复与终止六个环节,使同一套协议既能跑指令跟随导航(VLN-CE R2R、RxR),也能跑目标导航(HM3D-v2、HM3D-OVON)。具体而言,Harness 在每次分发模型提议的操作前,都要对照空间证据、几何可行性与当前子目标一致性做校验,并把结构化的工具反馈写回内部状态;用分层事件记忆跟踪任务进度与执行历史,用持久化时空图(ST Graph)保存可复用的空间证据和失败标注;再用一个可替换的导航执行器把校验通过的目标转成可执行动作。量化目标很明确:在四个基准上全面超越既有免训练 SOTA(此前最优分别为 R2R 55.0%、RxR 41.8%、HM3D-v2 74.4%、HM3D-OVON 50.2%),并能把同一套协议不加训练地部署到真实人形机器人上。
与已有工作不同的是,已有工作的切入角度要么是“把规划器做强”——无论是训练导航基础模型还是换更强的 MLLM;要么像 Aspire、Harness VLA 那样把 Agent Harness 用于机械臂操作这类短时程任务。HarnessVLN 的独特之处在于把问题从“更聪明的规划器”转移到“运行时治理”:作者观察到,单纯升级规划器解决不了导航的核心矛盾——语义计划与物理执行之间的脱节。因此本文主张由 Harness 而非模型本身来掌握三件事:证据如何保留(带时间与地点的空间证据)、提议如何验证(证据、几何、子目标三重校验)、失败如何影响后续决策(失败标注的空间索引与恢复机制)。另一个反直觉的设计是终止权的收缴:MLLM 只能“申请”停止,必须通过语义、几何、进度三重证据检验才能真正结束回合,停止由具身证据而非模型自信决定。
核心方法
直觉上,HarnessVLN 把导航智能体组织成一个“提案—审批—执行—复盘”的闭环:MLLM 是提方案的规划器,Harness 是把关的经理,工具是各职能部门。形式化地,决策步 $t$ 的状态为 $S_t = \{x, \omega_t, p_t, z_t, M_t, G_t\}$,其中 $x$ 是任务说明(路线指令或目标类别),$\omega_t$ 是与位姿对齐的 RGB-D 观测和局部几何地图,$p_t$ 是当前位姿,$z_t$ 是任务进度,$M_t$ 是分层事件记忆,$G_t$ 是持久化时空图。每个决策步执行算法 1 的循环:先把观测记入事件记忆并合并进图(ConsolidateGraph),然后确定活跃子目标 $g_t$,按子目标对图做任务条件化检索得到紧凑证据集 $R_t$,拼装上下文交给 MLLM 提议操作 $c_t$;Harness 校验后得到 $\hat{c}_t$ 并分发给工具,工具返回结构化反馈更新状态进入下一轮,直到出现经过验证的终止状态。整个系统在指令跟随与目标导航之间只切换任务特定的进度表示 $z_t$ 与完成判据,Harness 协议本身完全不变。
核心创新是 Harness 主导的“提案验证”机制:在分发任何工具调用前,Harness 检查四件事——参数合法性、支撑证据的来源与新鲜度、目标点的几何可行性、与活跃子目标及相关失败历史的一致性,不合格的提议直接打回。这与既有系统的本质区别在于:以往 MLLM 提出的语义计划几乎直接被执行,规划与执行之间的鸿沟无人把关;HarnessVLN 让每一次“识别到目标”都必须落到可验证的空间证据上。第二个关键设计是双记忆分离:任务中心的事件记忆(工作/进度/反思三层)保存完整执行史,环境中心的 ST Graph 只保存可复用的空间结构与轻量失败标注,二者通过事件引用关联,既支持失败感知检索,又不让 MLLM 上下文随轨迹无限膨胀。第三个关键设计是证据化终止:$F_{stop} = F_{semantic} \wedge F_{geometric} \wedge F_{progress}$,三关全过才许停;被拒绝的停止申请会记入事件记忆并触发继续观测、精化目标、接近或回退。
方法步骤详情
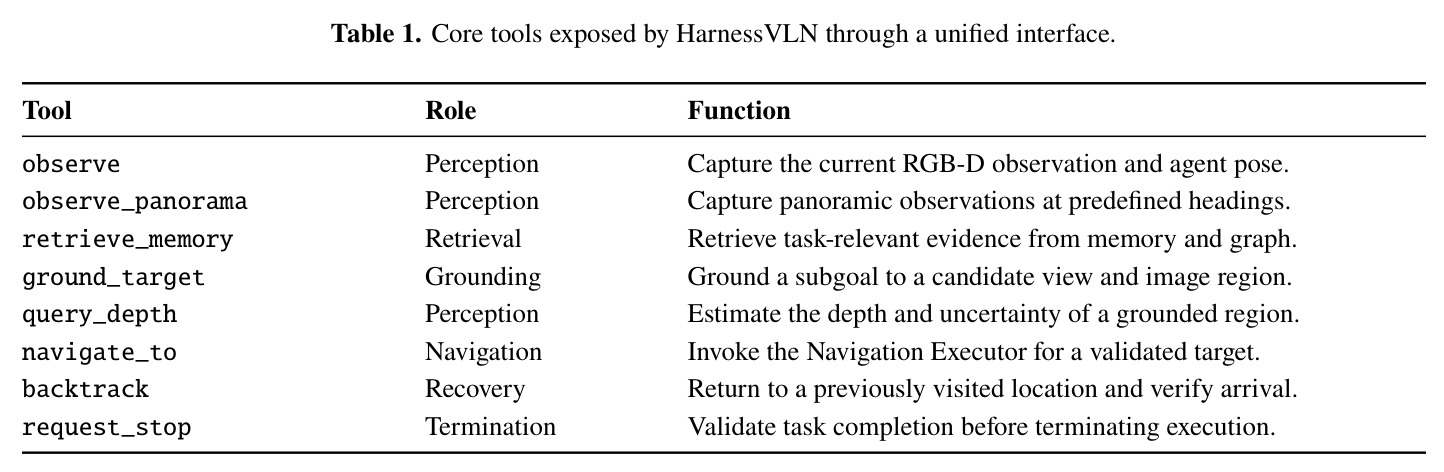
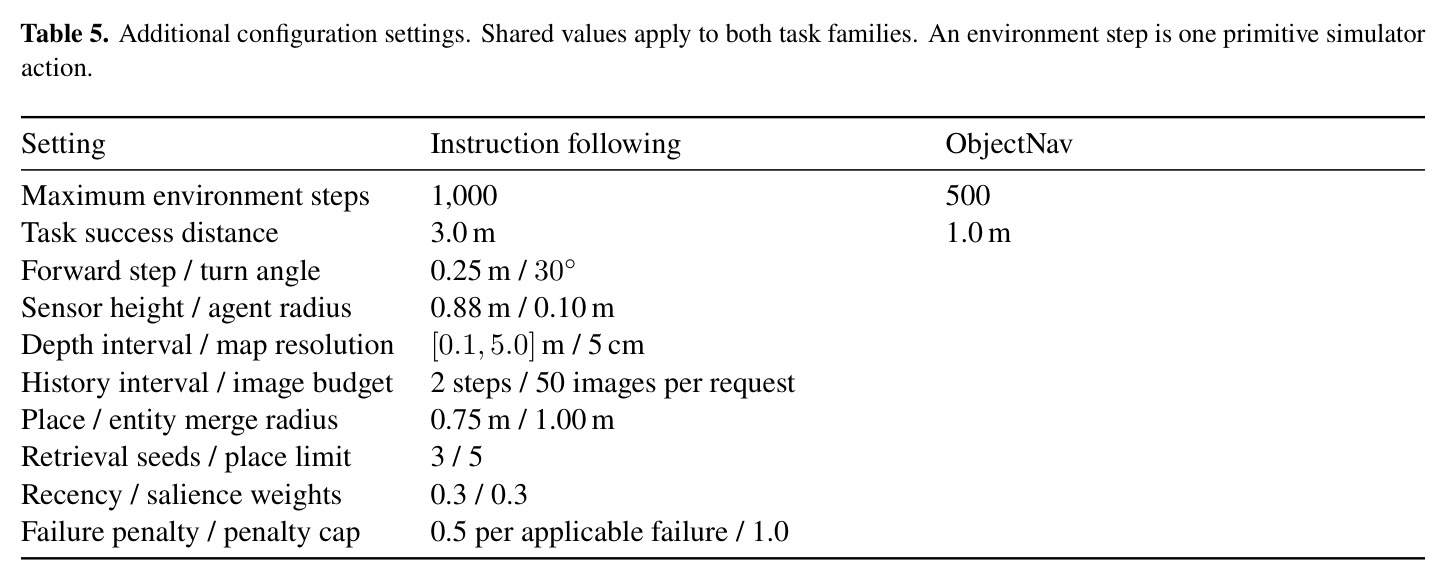
完整流程分六步。①感知:observe 与 observe_panorama 采集 640×480、79° 视场的 RGB-D 观测与全景。②记忆维护:工作记忆只留当前观测与最近工具反馈;进度记忆将任务分解为子目标(pending/active/completed/blocked 四态,同时最多一个 active,完成需位姿对齐观测或成功工具结果支撑);反思记忆完整记录不可达、碰撞、无进展、停止被拒等失败事件的位置与时间戳。③建图:ST Graph 定义为 $G_t = (V_P \cup V_E, E_t, T_t)$,相容观测并入地点节点,实体节点存目标假设与置信度,失败挂轻量标注,权重随子目标更替衰减、随重复失败增强。④检索:按 $s(v_i \mid g_t) = R(v_i, g_t) + \lambda_{rec} C(v_i) + \lambda_{sal} A(v_i) - \lambda_{fail} P(v_i, g_t)$ 评分取 top-K 地点及邻近实体。⑤规划执行:GroundingDINO 与 SAM 做开放词表定位,query_depth 估深与不确定性,navigate_to 调用执行器(FMM 规划、爬楼用 NavDP),backtrack 回退并验证到达。⑥终止:request_stop 须通过语义、几何、进度三重校验。
技术新颖性
技术新颖性体现在四点。其一,统一工具契约:observe、observe_panorama、retrieve_memory、ground_target、query_depth、navigate_to、backtrack、request_stop 八个异构工具共享同一输入输出约定,任何工具可被替换而不动 MLLM 和 Harness 协议,这使同一框架能跨指令跟随与目标导航两个任务族,也支撑了到 AgiBot A3U 真机的 Sim2Real 迁移。其二,时间索引的空间证据:与多数只存地图或拓扑的方法不同,ST Graph 给每条证据打时间戳并区分“当前证据”与“被取代的假设”,检索时还能用惩罚项 $P(v_i, g_t)$ 降低与当前子目标相关的历史失败位置的重试优先级,这是失败感知恢复的结构化基础。其三,终止仲裁:把停止从模型的自由动作变成需要证据审批的请求,直接针对 OSR−SR 差距这一行业痛点。其四,与导航基础模型路线正交:HarnessVLN 不训练任何导航策略,MLLM 只管任务级规划,路径规划与控制交给可替换的执行器,语义能力与运动控制可以独立升级。
实验结果
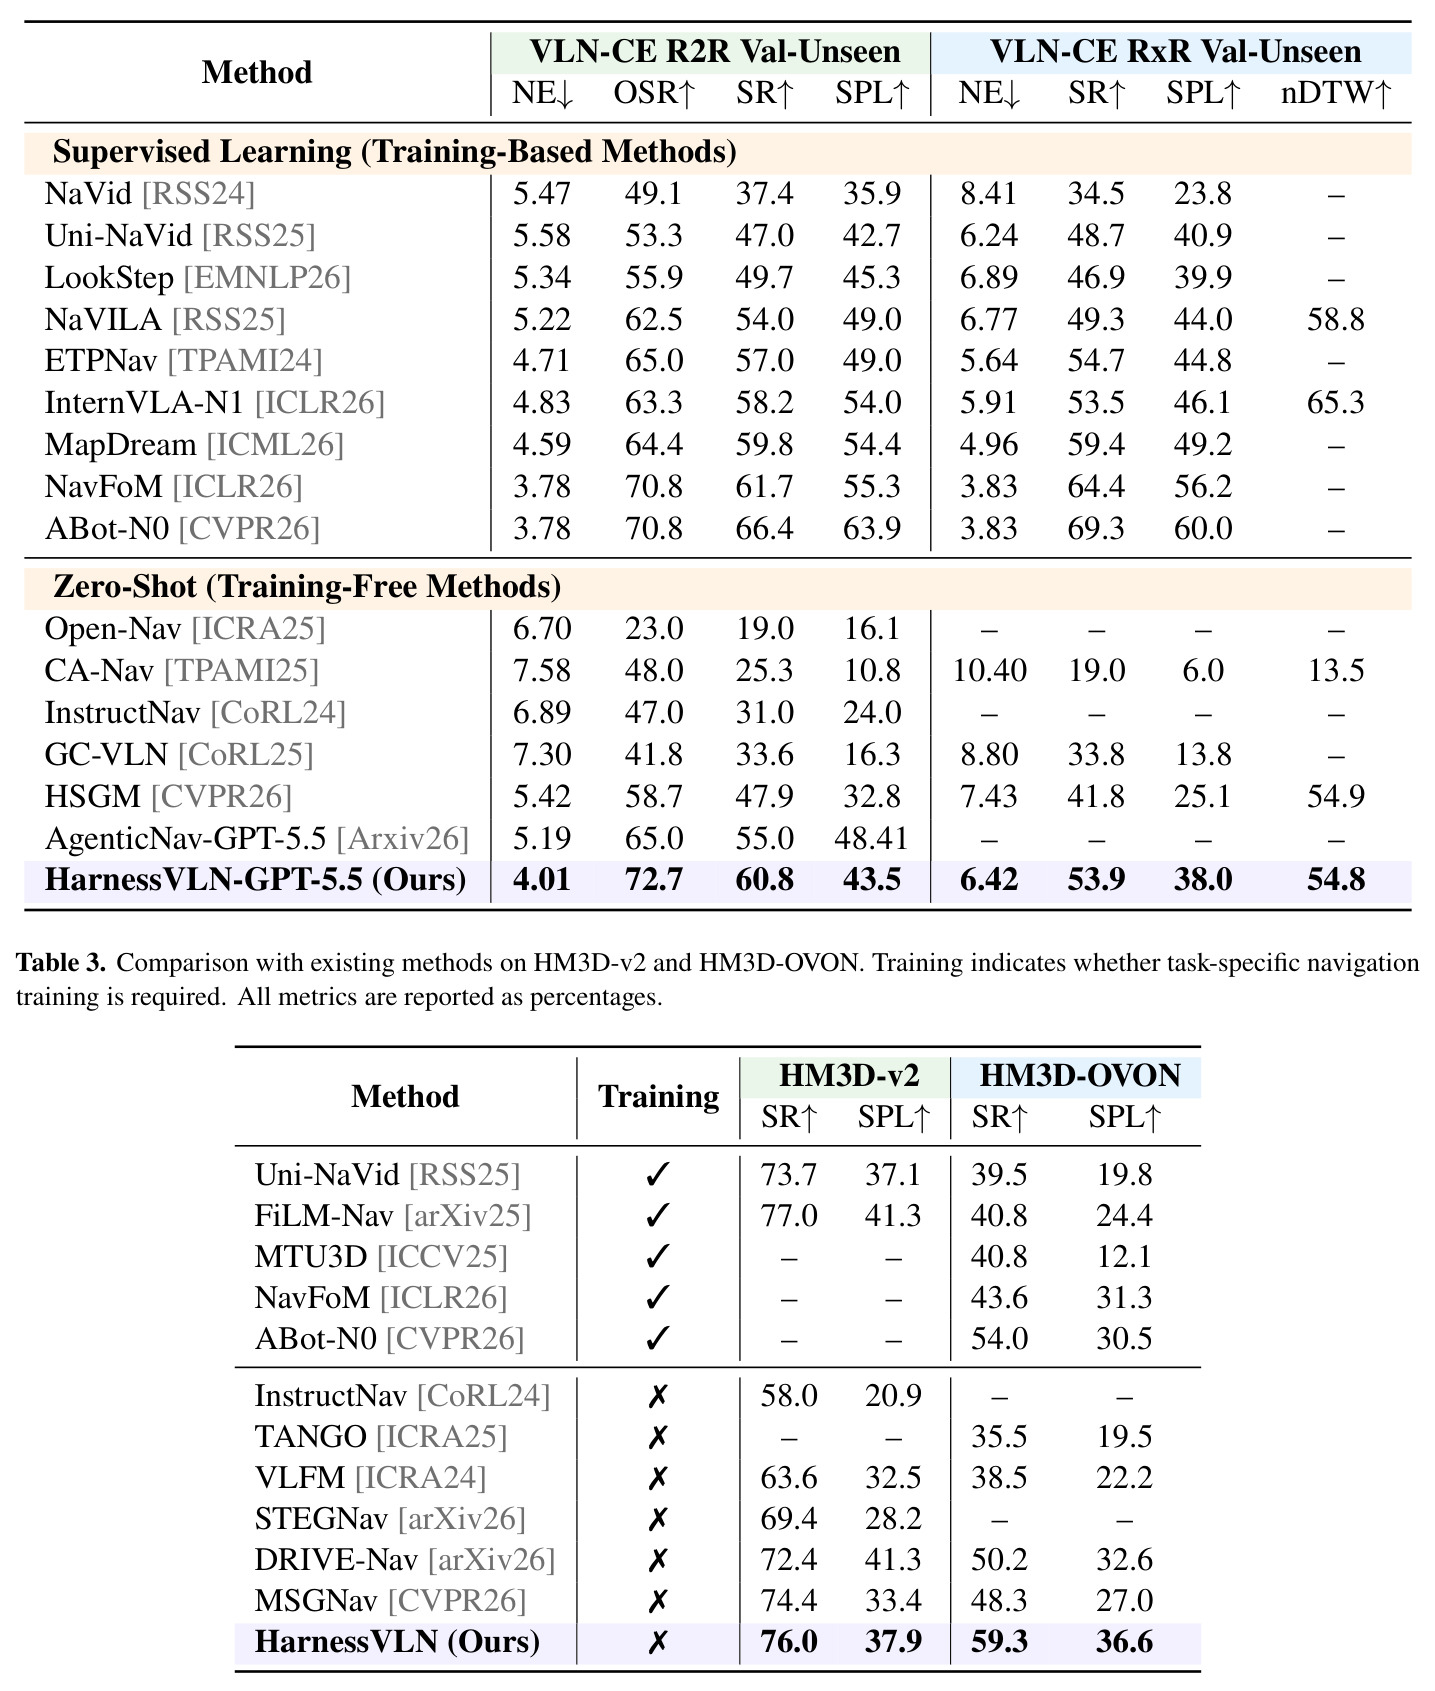
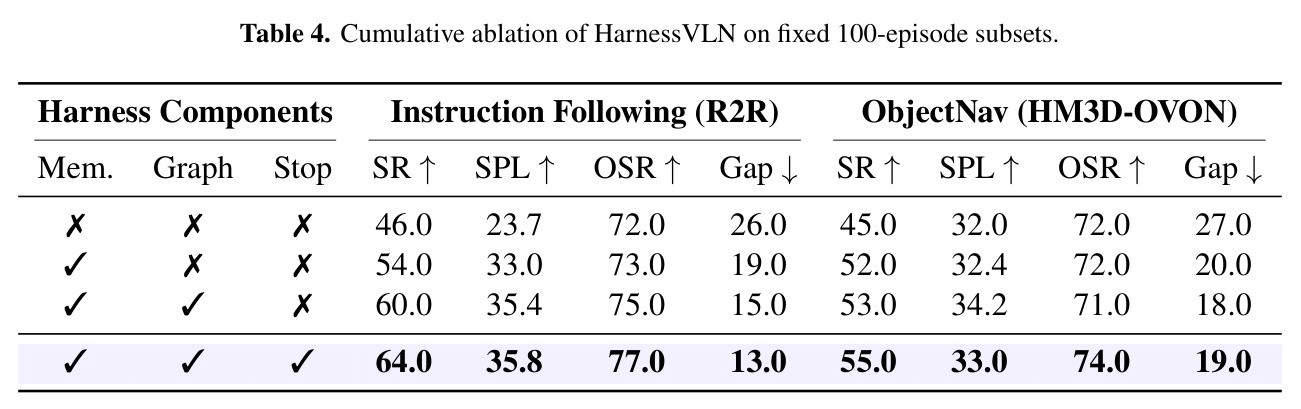
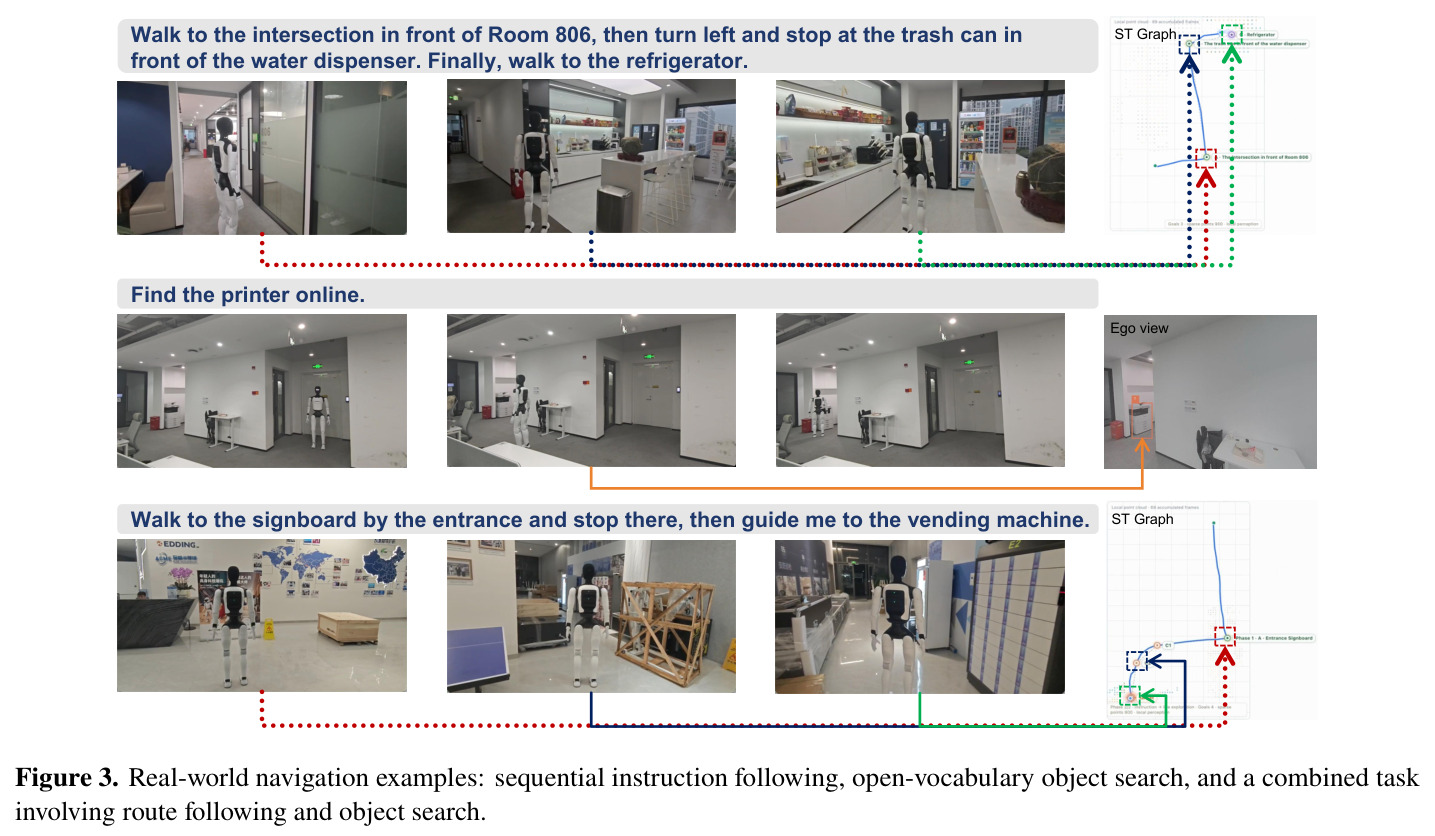
四个基准均刷新免训练 SOTA。指令跟随(Table 2,底座 GPT-5.5):R2R val-unseen 达 SR 60.8%、OSR 72.7%、SPL 43.5%、NE 4.01 米,比同底座的免训练最优 AgenticNav 高 5.8 与 7.7 个百分点,并超过 ETPNav 等多数训练式方法;RxR 达 SR 53.9%、SPL 38.0%、nDTW 54.8%,比 HSGM 高 12.1 与 12.9 个百分点。目标导航(Table 3,底座 GPT-5.6-luna):HM3D-v2 SR 76.0% 为免训练最高(超 MSGNav 的 74.4%),但 SPL 37.9% 低于 DRIVE-Nav 的 41.3%;HM3D-OVON 达 SR 59.3%、SPL 36.6%,为含训练式方法在内的全场最高,超 DRIVE-Nav 9.1 与 4.0 个百分点、超训练式 ABot-N0 的 54.0%。消融(Table 4,各 100 回合)显示三组件累计带来 R2R +18.0、OVON +10.0 的 SR 提升:事件记忆 +8.0/+7.0、图检索 +6.0/+1.0、停止验证 +4.0/+2.0,R2R 的 OSR−SR 差距从 26.0 收窄至 13.0。真机上,搭载 Qwen-3.8-27B 的 AgiBot A3U 机器人在三个真实场景完成顺序指令、开放词表搜物与组合任务。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 指令跟随 VLN-CE R2R val-unseen | SR(成功率) | 60.8% | AgenticNav-GPT-5.5:55.0%(免训练 SOTA,同底座) | +5.8 个百分点 |
| 指令跟随 VLN-CE R2R val-unseen | OSR | 72.7% | AgenticNav-GPT-5.5:65.0% | +7.7 个百分点 |
| 指令跟随 VLN-CE RxR val-unseen | SR(成功率) | 53.9% | HSGM:41.8%(免训练 SOTA) | +12.1 个百分点 |
| 目标导航 HM3D-v2 | SR(成功率) | 76.0% | MSGNav:74.4%(免训练最优) | +1.6 个百分点 |
| 目标导航 HM3D-OVON(开放词表) | SR(成功率) | 59.3% | DRIVE-Nav:50.2%(免训练最优;训练式最优 ABot-N0 为 54.0%) | +9.1 个百分点 |
| 目标导航 HM3D-OVON(开放词表) | SPL | 36.6% | DRIVE-Nav:32.6% | +4.0 个百分点 |
局限与改进
作者承认两点:其一,当前 Harness 依赖预定义的编排与校验规则,尚未具备自适应或自进化能力;其二,停止验证的收益不均匀——它把 R2R 的 OSR−SR 差距从 15.0 收窄到 13.0,却让 OVON 的差距从 18.0 反升到 19.0,SPL 也从 34.2% 降到 33.0%。从数据还能看到更多:HM3D-v2 的 SPL(37.9%)低于 DRIVE-Nav(41.3%),RxR 的 SPL(38.0%)明显低于训练式最优,R2R 的 SPL(43.5%)也低于同底座的 AgenticNav(48.4%),说明校验与回退机制在用效率换成功率;系统深度绑定 GPT-5.5 与 GPT-5.6-luna 这类前沿闭源模型,与较老的免训练方法对比时,部分增益可能来自底座模型的世界知识而非框架本身;消融只在各 100 回合的子集上进行,样本量偏小;真实世界实验只有三个定性场景,没有报告成功率或失败统计。
独立分析的弱点
独立来看有几个弱点。第一,推理开销:每个决策步都要走完“检索—拼装—提议—校验—执行—反馈”一圈,叠加 GPT-5.5 级别的调用,单回合成本与延迟很高,难以部署到对实时性敏感的平台;改进方向是把 Harness 的编排与校验蒸馏成小型本地模型,或缓存高频决策模式。第二,校验规则手工设计:语义/几何/进度三关的判据是预定义的,遇到规则未覆盖的失败模式(如动态行人、门被关上)可能失效,可以引入从交互反馈中学习的验证策略。第三,图合并启发式缺乏检验:“空间相容则并入已有地点节点”的判据没有专门消融,错误合并会污染拓扑并误导回退,可增加合并置信度与图修正机制。第四,上游感知依赖:ground_target 依赖 GroundingDINO+SAM,开放词表定位一旦失败会级联影响整条链路,而论文未报告定位环节自身的误差分析。第五,检索打分中的 $\lambda_{rec}$、$\lambda_{sal}$、$\lambda_{fail}$ 是固定超参,缺少跨环境敏感性实验,换个场景分布可能需要重调。
未来方向
作者明确提出的方向是让 Harness 具备自进化能力:通过在开放环境中的持续交互来改进预定义的编排与校验,而不是依赖人工规则。在此基础上可以延伸出几条路:一是把提案验证从规则升级为可学习策略,用工具反馈作为奖励信号在线优化;二是把大模型的规划与校验能力蒸馏进端侧小模型——论文真机端已用 Qwen-3.8-27B,说明这条路线现实可行;三是把 ST Graph 扩展为多智能体共享的空间记忆,支持多机器人协作导航与证据互通;四是将导航基础模型(如 NavFoM、ABot-N0)作为可替换执行器接入同一 Harness 协议,检验免训练规划与训练式执行器的互补性;五是扩展到动态场景、多楼层与室外环境,检验时间戳证据与失败标注机制在非静态世界中的鲁棒性;六是把 OSR−SR 差距作为一等公民指标,研究随任务自适应的终止判据。
复现评估
复现难度中等偏上。有利的方面:评测协议完全标准化(R2R/RxR val-unseen、HM3D-v2 的 1000 回合、HM3D-OVON 的 3000 回合验证集),感知与执行组件(GroundingDINO、SAM、FMM 规划器、NavDP)均为开源工作,消融用固定 100 回合子集、算力与费用可控,项目页 https://agibot-harnessvln.netlify.app/ 提供了系统介绍。不利的方面:正文未明确承诺开源代码,而 Harness 的提示词、上下文拼装格式、校验判据等工程细节恰是成败关键,很难仅凭论文还原;主实验依赖 GPT-5.5 与 GPT-5.6-luna 的 API,每回合数十至上百次决策调用,费用可观且结果受模型版本漂移影响;真机部分需要 AgiBot A3U 人形机器人、3D 激光雷达、Fast FoundationStereo 与 NVIDIA Thor 板载算力,普通实验室无法复制,只能在仿真中验证核心结论。总体而言,仿真端复现可行但工程量大,端到端数字的精确复现存在不确定性。
论文图表
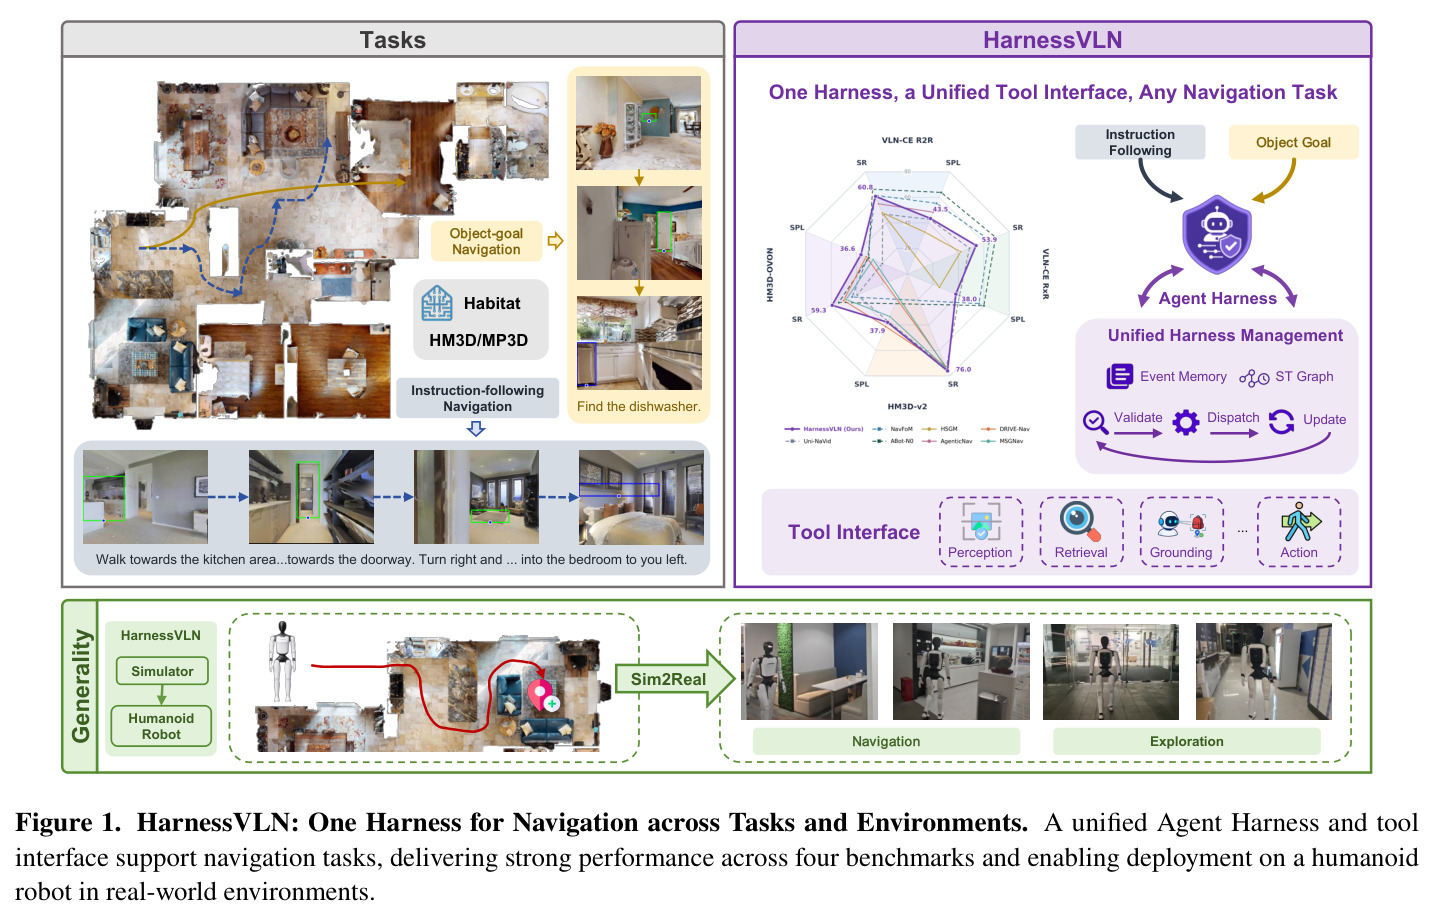
概览图:左侧展示统一的 Agent Harness 通过统一工具接口同时服务指令跟随导航(HM3D/MP3D 场景,R2R/RxR)与目标导航(Habitat 中“找到洗碗机”),右上标注 Sim2Real 与通用性;右侧展示同一 Harness 协议部署到人形机器人,覆盖导航与探索。2026 年 9 月 14 日发布于 cs.RO。
一张图看懂论文主线:“一个 Harness、统一工具接口、任意导航任务”的核心卖点,以及四基准+真机部署的结果版图,适合作为读者建立全局认知的入口。