Harness-S:从兄弟执行框架学习可泛化能力的智能体训练 Harness-S: Learning from Sibling Harnesses for Generalizable Agent Training
用演化的兄弟框架救援基座失败任务,并把激发的能力迁移进策略,使提升在原框架下保留
前置知识
Agent Harness(执行框架)
围绕模型策略的整套执行支撑系统,包括系统提示词、工具接口定义、上下文与记忆机制、执行规则(如 hooks 钩子、action_guidance 动作引导)等。它决定策略能接收什么信息、决策如何转化为环境动作。同一个模型在不同 harness 下表现可以相差几十个百分点:ReAct 的推理-行动交错、SWE-agent 的智能体-计算机界面都是 harness 设计的经典实例。
本文的核心研究对象就是 harness:作者在同一个基座 $H_0$ 上演化出多个'兄弟 harness'并用它们救援失败任务。不理解 harness 与策略的分工,就无法理解'把辅助框架激发的能力迁移回原框架'这条主线。
GRPO(组相对策略优化)
一种在线 RL 算法:对每个任务采样一组轨迹(本文 $G=K=8$ 条),用组内奖励的均值 $\bar{r}_x$ 和标准差 $\sigma_x$ 归一化得到相对优势 $\hat{a}_{x,j} = (R_x(\tau_{x,j}) - \bar{r}_x)/\max(\sigma_x, \epsilon)$,再最大化 PPO 式的裁剪代理目标。若组内轨迹全部成功或全部失败,优势全为零,这一组完全不产生学习信号。
Harness-S 的救援训练正是冲着'全失败组无信号'这个痛点去的:当 8 条 $H_0$ 轨迹全失败时,用兄弟 harness 生成含成败对比的新轨迹组替换之,让 GRPO 重新有梯度可用。
Sibling Harness 与三大经验性质
从同一基座 $H_0$ 派生的框架变体,共享执行底座、环境接口和任务验证器,只修改对策略的支撑方式。作者观察到三条性质:局部性(一次编辑只修复部分失败且引入回退,图 1a 中 $H_1$ 修复 26 个任务、回退 11 个)、互补性(不同变体能互相挽救对方的错误,oracle 并集覆盖超过同 rollout 数下 $H_0$ 的重复采样)、非平稳性(随策略学习,某 harness 的相对优势会衰减甚至反转,图 1c 中 $H_1$ 的优势从 +15 跌到 −4)。
这三条性质是全文立项依据:局部性与互补性说明保留多个特化变体比合并成一个'万能 harness'更可行;非平稳性说明路由证据必须随策略更新而重新校准。
Harness Behavior Profile(行为画像)
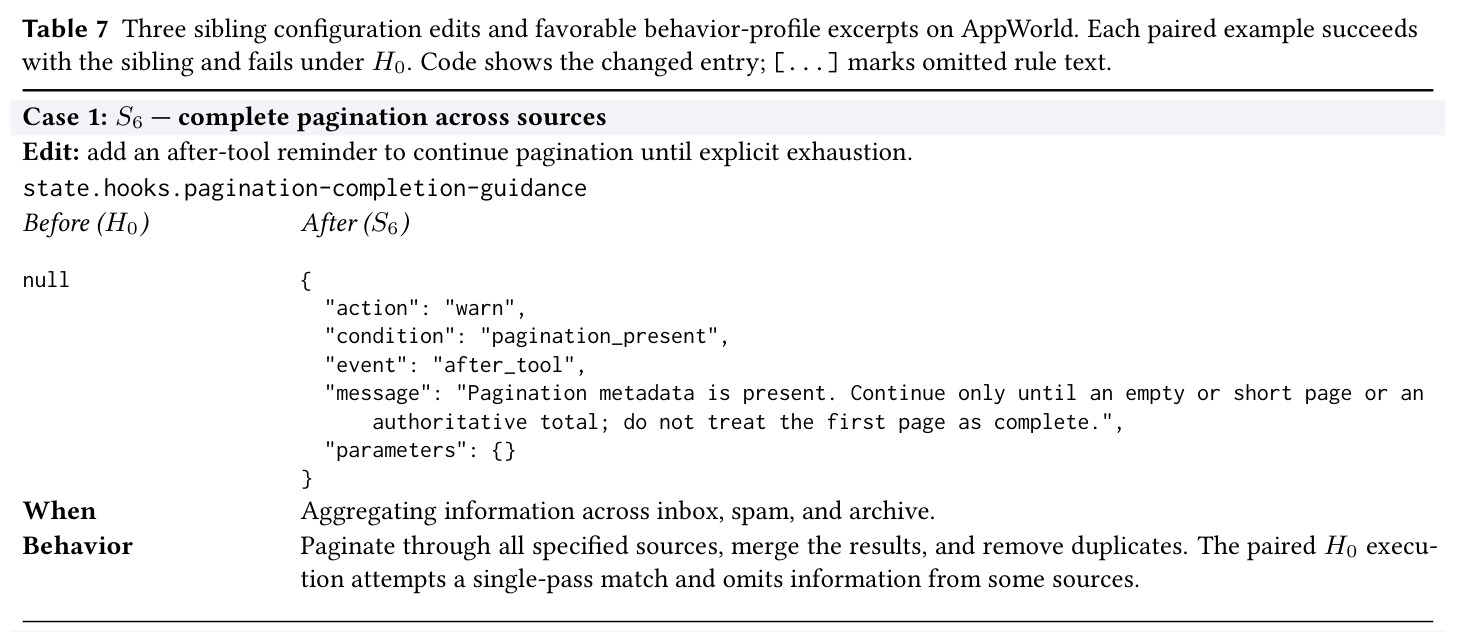
描述某个兄弟 harness 在什么任务条件下对当前策略有帮助或有害的结构化文本,形如 $P_i^{(s)} = \{P_{i,\text{prefer}}^{(s)}, P_{i,\text{avoid}}^{(s)}\}$,每条记录 {When: 任务条件, Behavior: 相对 $H_0$ 的行为差异},由 LLM 从成对的验证轨迹中归纳。路由时多个 LLM 独立投票,权重按名次取 1、3/4、1/2、1/4,加权求和取 Top-K。
自适应路由器是方法三大组件之一,行为画像是任务到 harness 匹配的证据来源;'画像再锚定'是对非平稳性的直接回应,也是消融实验(表 2)的关键对比项。
Pass@3 与 Avg@3
智能体评测常用指标:每个测试任务执行 3 次 rollout,Pass@3 是至少一次成功的任务比例,衡量能力上限;Avg@3 是三次成功率的平均值,衡量稳定性与一致性。本文主表分数是三次独立随机运行的均值,Harness-S 另附跨运行标准差(约 ±1.2 到 ±2.4)。
论文主要结论都建立在这两个指标上,例如 Harness-S 4B 在 AppWorld $H_0$ 下 Pass@3 67.56 / Avg@3 56.87;分开看两者才能区分'能否解出'与'是否稳定解出',第 4.6 节的结论(Rank-1 的 Avg@3 优势仍剩 4.58)就依赖这一区分。
研究动机
智能体的表现由模型策略和执行框架共同决定,但两者的优化长期割裂。纯策略训练有个硬伤:GRPO 每个任务采 $K=8$ 条轨迹,若全部失败则组内奖励全为 0、优势归零,该任务提供不了任何学习信号;而小模型在长程任务上恰恰有大量此类任务——Qwen3.5-4B 在 AppWorld 上基础 Pass@3 只有 42.62%、Avg@3 仅 31.93%。另一条路线是自动演化 harness(Meta-Harness、HarnessX、WHALE 等),但作者用实验揭示了三个被忽视的现象:局部性——图 1a 显示每个变体的修复都伴随回退($H_1$ 修复 26 个任务、回退 11 个,净 +15;$H_4$ 净 +3),单次编辑只解决一小撮失败;互补性——不同变体能救回彼此的错误,各自单次执行的 oracle 并集覆盖率高于任何单个变体,也高于同 rollout 数下 $H_0$ 的重复采样;非平稳性——图 1c 显示 $H_1$ 相对 $H_0$ 的优势从检查点 0 的 +15 衰减到检查点 20 的 −4,框架价值随策略学习漂移。由此推出两条结构性缺陷:(i) 把局部修复合并成一个万能 harness 极其困难,修复可能施加不兼容的执行要求,兼容的编辑也可能互相干扰;(ii) harness-策略耦合共演化成本高昂,旧修复随策略变化失效而需反复重造,且收益绑定在演化后的框架上,回到基座 $H_0$ 时可能无法保留。
本文的目标是本文不追求'通用最优 harness',而是让一组特化的兄弟框架选择性救援基座执行系统的失败,并把由此激发的能力迁移进单一策略,使策略回到原始 $H_0$ 时依然保有这些能力。目标被拆成六个可检验的研究问题(RQ1–RQ6):训练后的策略在 $H_0$ 下显著超过纯策略训练(RQ1);互补救援比简单重采样或固定 harness 混合提供更优的学习信号(RQ2);救援分配与画像再锚定确实改善救援成功率与最终性能(RQ3);行为层面的变化可归因到具体工作流、并迁移到未见实例(RQ4);训练后策略对辅助 harness 的路由依赖下降(RQ5);改进在不需要进一步更新的情况下迁移到未见过的外部 harness(RQ6)。附带目标是在相同 executor rollout 数下比较,确保增益不是靠多采样堆出来的。
与已有工作不同的是,与已有工作的本质区别在于分配单元和演化组织方式。HarnessBandit 按 optimizer step 调度单个 harness;HarnessX 把 harness 演化与跨 harness GRPO 耦合在共享回放缓冲上;WHALE 交替执行 harness 搜索与拒绝采样微调;HarnessForge 为每个分支演化配对的专属策略——这些方法要么演化与训练深度耦合、变体随策略漂移反复重造,要么收益绑定在演化后的 harness 对上。Harness-S 的独特切入点有四:(1) 以'$H_0$ 下的全失败任务'为分配单元,只有初始组全失败才触发救援,把昂贵的辅助探索精准投向学习瓶颈;(2) 兄弟池在策略训练期间完全冻结,只有行为画像随策略重新锚定,把'能力载体'与'能力分配'解耦;(3) 救援轨迹由同一个共享策略生成并直接进入 GRPO 更新,目标是行为内化而非推理期依赖;(4) 评测协议本身即论点:回到 $H_0$(以及未见 harness)检验迁移是否真实发生。
核心方法
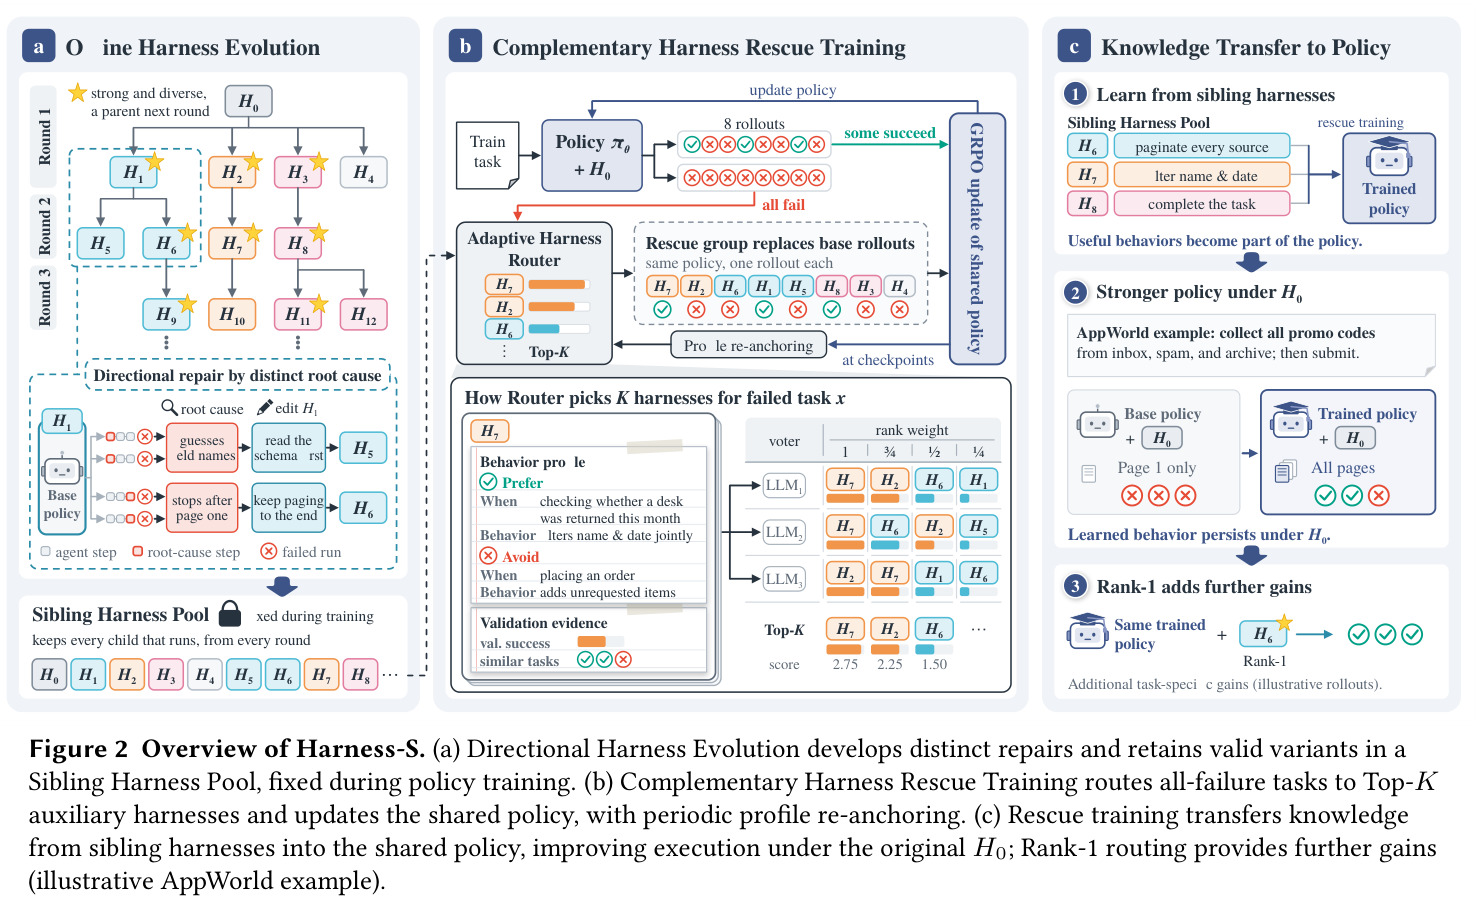
Harness-S 分离线演化和在线训练两个阶段(图 2)。直觉是:与其把所有修复缝进一个框架,不如让每个变体专注一条修复方向;训练时只在基座彻底失败的任务上借用这些'专科医生',让策略自己在辅助框架下走出成功轨迹,再用组内成败对比做 RL,把行为写进参数。技术上分三步:第一,Directional Harness Evolution——从 $H_0$ 出发诊断训练任务失败轨迹的根因,每轮让编辑器针对 2–3 个相关根因产出候选变体,按联合验证覆盖率最多选 $B=4$ 个父代继续分支,所有可执行且协议合规的子代全部保留进 Sibling Harness Pool(AppWorld 跑 3 轮,最终池含 $H_0$ 加 19 个辅助 harness),池在训练全程固定。第二,Complementary Harness Rescue Training——每个任务先在 $H_0$ 下采 $K=8$ 条轨迹,若全失败,Adaptive Harness Router 基于行为画像和多 LLM 投票选出 Top-8 辅助 harness,同一策略从任务初始状态各生成 1 条新轨迹组成救援组 $G_R(x)$ 并替换失败组(式 (5)),随后按 GRPO 组相对优势(式 (6))与裁剪 token 目标(式 (7))更新参数。第三,Adaptive Harness Router——用行为画像刻画每个变体何时有益何时有害,多 LLM 加权投票选 Top-K,并定期做 policy-aware 画像再锚定以跟上策略变化;推理时同一路由器直接选 Rank-1 harness 再获得一层增益。
核心创新是'救援组替换'加'冻结池 + 活画像'的解耦设计。与 DAPO 式动态采样在同分布内重试不同,Harness-S 在任务与验证器不变的前提下更换执行上下文 $c_H$:当 $G_0(x)$ 全失败时,路由器选出 $S_K^{(s)}(x)$,同一策略 $\pi_\theta$ 在每个选中的 harness 下从初始状态重新执行,得到含成功与失败的救援组。因为执行者是同一个策略,成败差异完全归因于行为方式而非能力差异,GRPO 的组内对比(式 (6))于是恢复信号——实测这种设计把有效组(同含成败)比例从纯 GRPO 的 64.69% 提到 79.38%。与 harness-策略共演化(WHALE、HarnessForge、HarnessX)的本质区别是:池中实现完全固定,训练只更新策略参数和路由证据,演化成本一次性付清、池可跨 checkpoint 复用;与'通用 harness'路线的本质区别是:接受局部性、不合并修复,而用路由按任务分配互补的专科变体。'在 $H_0$ 下评测'这个协议本身就是论点:收益必须留在策略里而不是留在框架里。
方法步骤详情
完整流程(算法 1)。第一步,诊断与编辑:冻结起始策略,在训练任务上执行父代收集失败轨迹,LLM 按根因聚类,每个候选 $C_g = \{\text{Edit}(H,d)\}$ 针对 2–3 个相关根因(每个根因至少 2 个失败任务支撑)修改 prompt、skill、context、memory、hooks 或 tool view 中的组件(编辑器 GLM-5.3,温度 0.6)。第二步,验证与筛选:候选先过静态兼容检查,并在最多 30 个任务上本地评测(须修复目标失败且不破坏成功对照),随后从合规候选中选最多 $B=4$ 个父代,最大化联合验证覆盖 $P_{g+1} \in \arg\max_{P} |\bigcup_{H\in P} V(H)|$;所有合规子代并入池 $\mathcal{H}_g = \mathcal{H}_{g-1} \cup C_g^{\text{valid}}$,3 轮后池达 20 个成员并冻结。第三步,训练循环:每 batch 先判断是否到再锚定点;对每任务在 $H_0$ 下采 8 条轨迹得 $G_0(x)$,若含成功直接保留,否则路由器按最新校准选 Top-8 辅助 harness、每者一条新轨迹组成 $G_R(x)$ 替换。第四步,参数更新:按式 (6) 算组相对优势 $\hat{a}_{x,j}$,仅对策略 token 计算 PPO 式裁剪损失($\eta^-=0.20$、$\eta^+=0.28$、无 KL 项),harness 注入的指令与观测排除在损失外,rollout 与训练后端的概率差用截断到 $[0,2]$ 的 detached 权重校正。第五步,画像再锚定:每 10 次更新冻结当前策略,在各兄弟与 $H_0$ 下成对跑验证任务,重算 $P_i^{(s)}$ 与验证成功率;训练结束后用最终策略再做一次。第六步,推理增强:对训好的策略用式 (12) 选 Rank-1 harness(含 $H_0$),相同 rollout 数下额外涨点。
技术新颖性
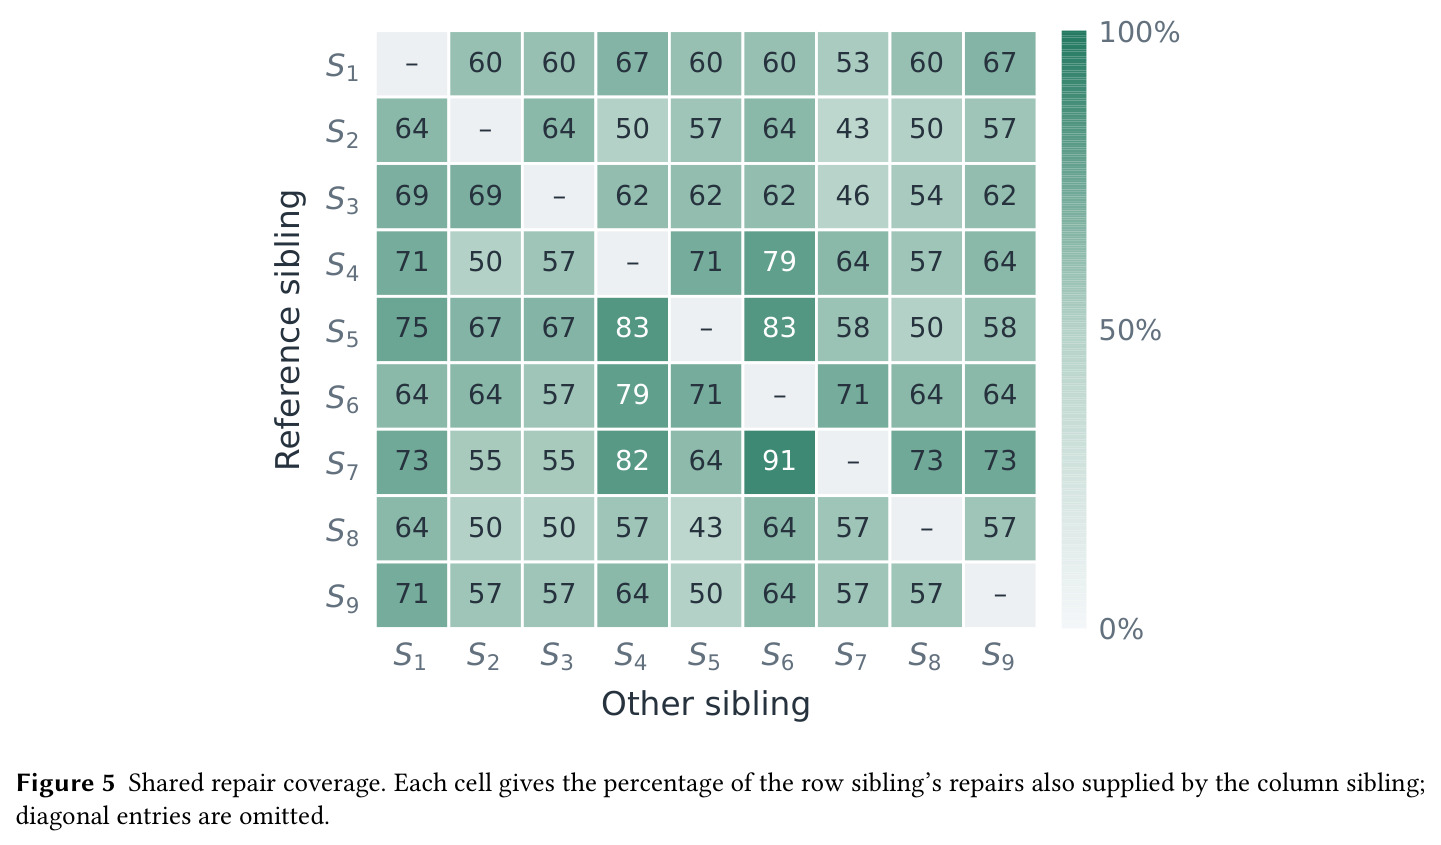
技术新颖性有四点。其一,问题刻画本身:把 harness 演化的局部性、互补性、非平稳性作为可测量现象系统提出(图 1 与附录图 5:九个被分析兄弟各自修复 11–15 个 $H_0$ 失败,并集达 29 个,定向修复重叠率均值 62.47%),并据此论证'单框架合并'与'耦合共演化'两条主流路线的结构性缺陷。其二,救援组替换的信号设计:全失败组零对比是 GRPO 类算法的普遍痛点,已有工作(如 DAPO)靠重采样过滤解决,本文改为更换执行上下文让同一策略产生成败对比,并把触发精确限定在'全失败'上,避免对已解任务的浪费。其三,解耦架构:池固定、画像滚动更新,把'能力从哪来'(离线演化,一次性)与'能力给谁用'(在线路由,随策略校准)分开——表 10 显示其搜索 rollout 仅 4,010,比 Meta-Harness(8,000)与 WHALE(8,640)少 29–54%。其四,多 LLM 加权投票 + 行为画像的路由器:画像条目是条件-行为对而非裸成功率,投票权重 1、3/4、1/2、1/4 且排序在任务执行前完成,可零额外成本复用于推理期 Rank-1 选择,这是与 HarnessBandit 按 step 调度、HarnessX 跨 harness 分组的另一处不同。
实验结果
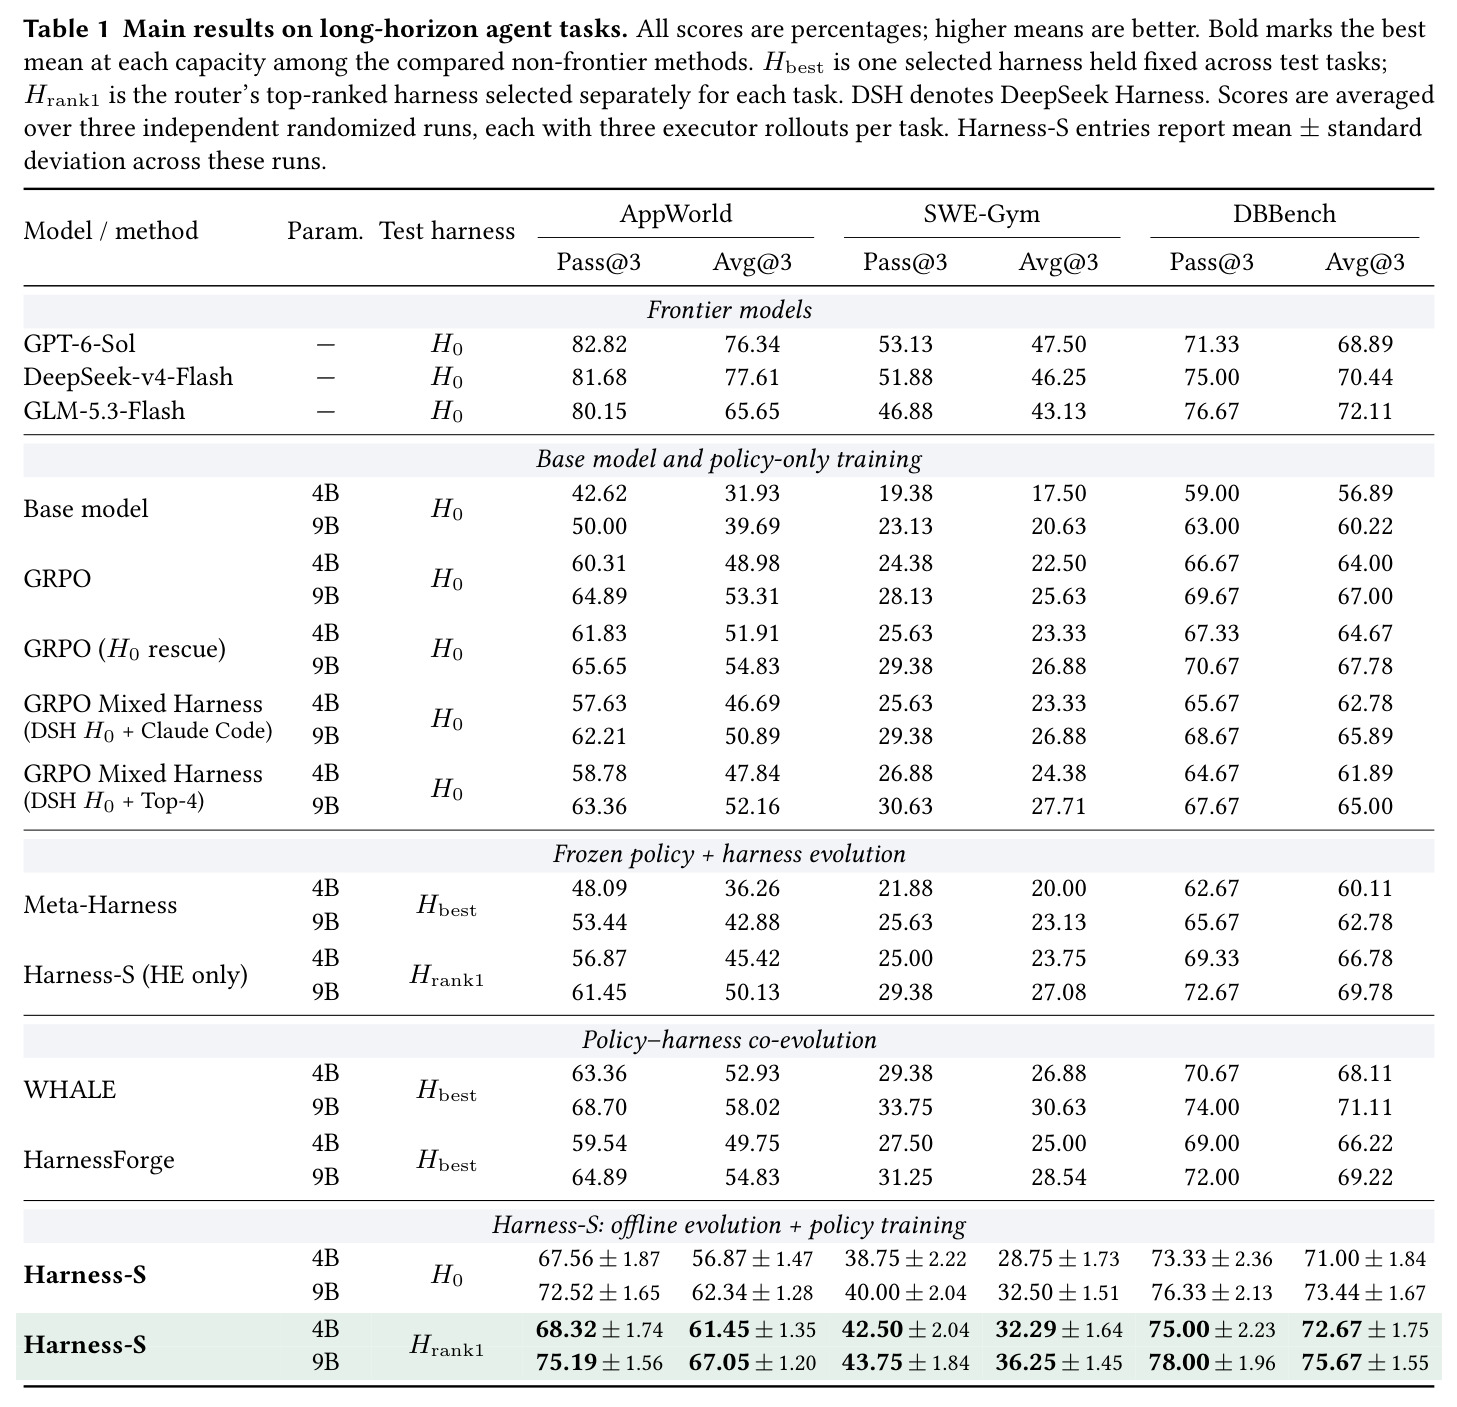
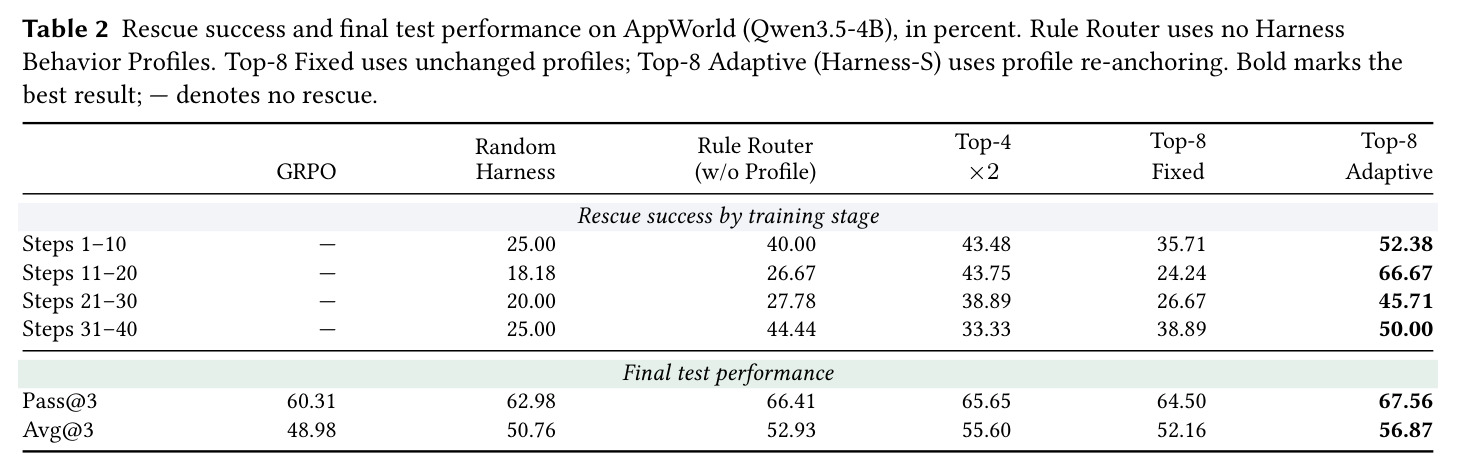
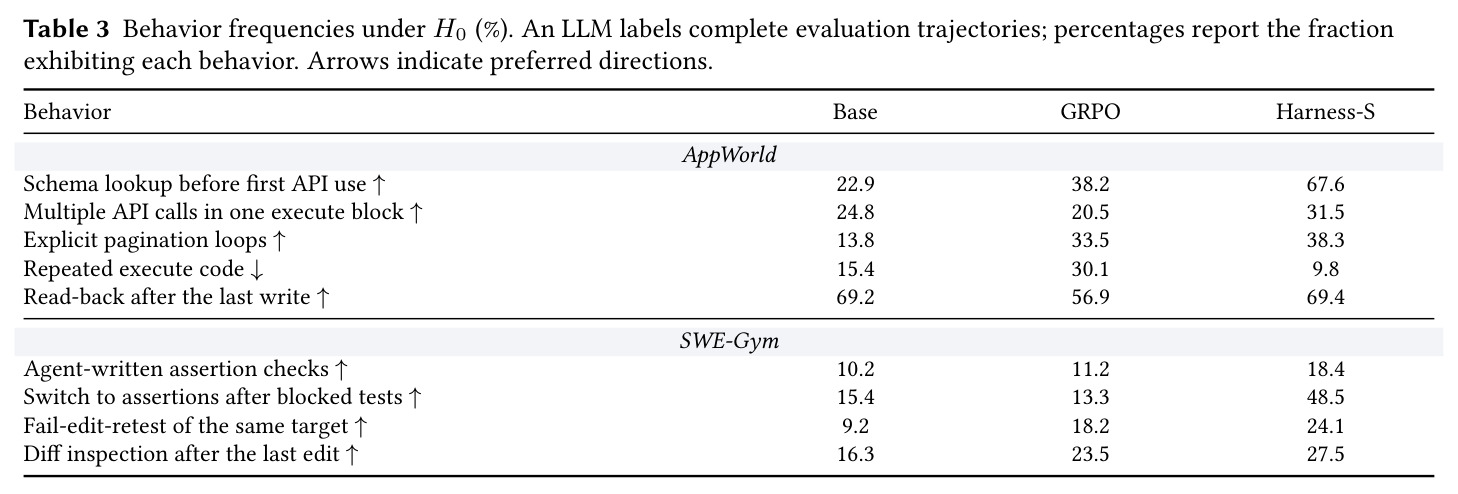
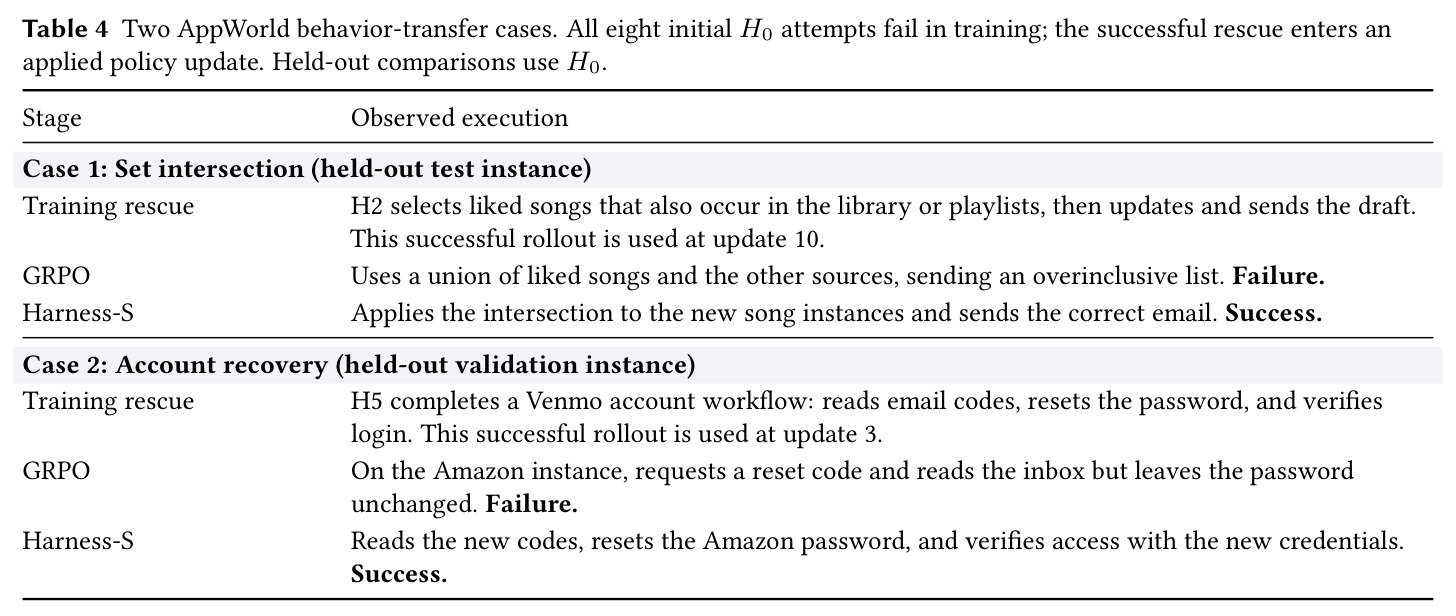
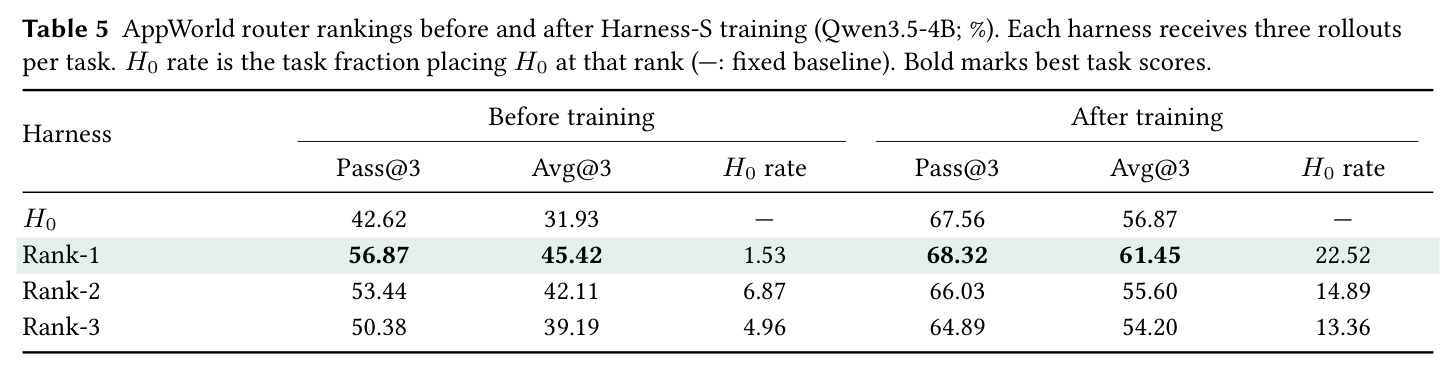
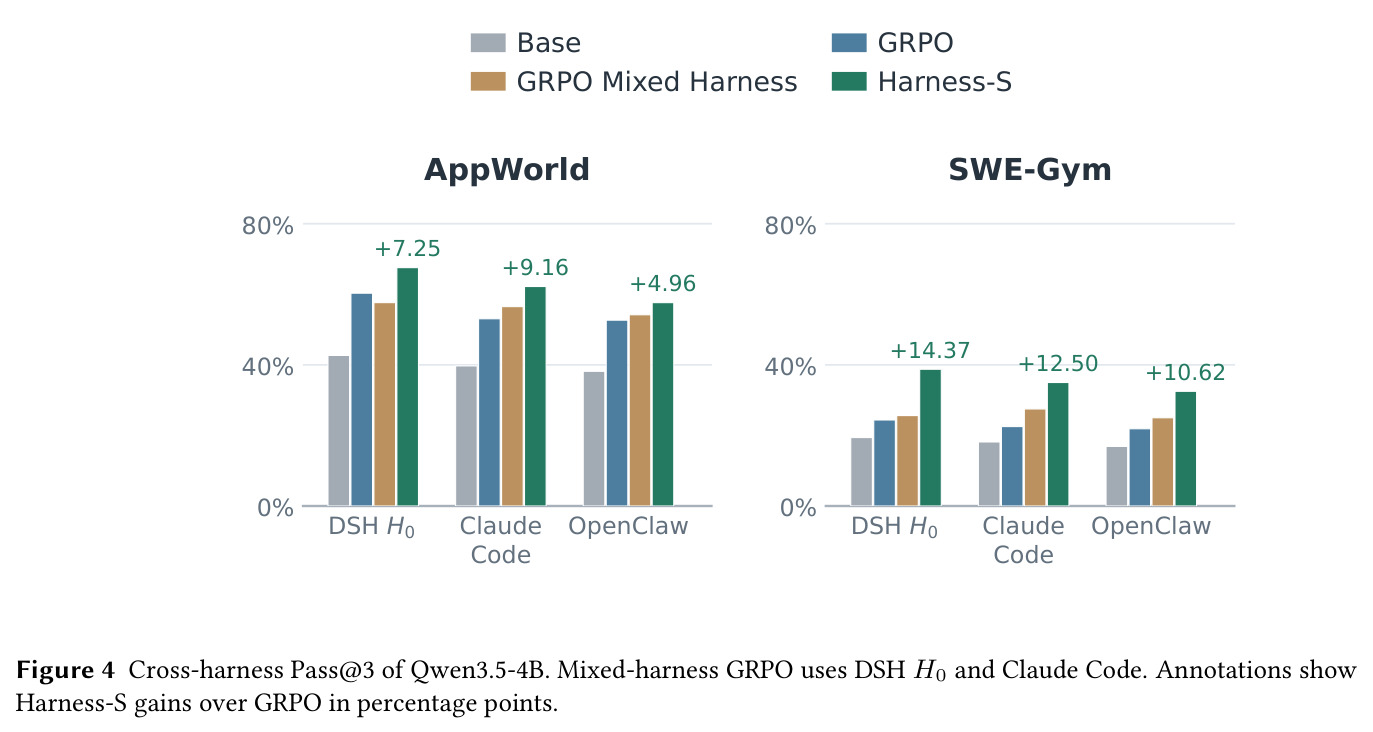
核心结果有六组。RQ1(表 1):Harness-S 在三个基准、两种规模上全面超过纯策略训练、冻结策略演化和联合适配方法——4B 在 $H_0$ 下 AppWorld Pass@3 67.56 / Avg@3 56.87(GRPO 为 60.31 / 48.98),9B 达 72.52 / 62.34;叠加 Rank-1 路由后 9B 在 AppWorld 75.19 / 67.05、SWE-Gym 43.75 / 36.25、DBBench 78.00 / 75.67。路由后的 4B 在每项指标上都超过 9B 的 H0-rescue GRPO,路由后的 9B 在 DBBench 上超过 GPT-6-Sol(71.33)等前沿模型参考。RQ2(图 3):有效组比例 Harness-S 79.38% vs H0-rescue 70.94% vs GRPO 64.69%,有效 token 占比 80.88% vs 72.68%,同一验证集最终 $H_0$ 成功率 63.33% vs 54.00% vs 48.00%;两种固定混合反而低于纯 GRPO,说明 harness 多样性必须定向投给失败任务才有用。RQ3(表 2):Top-8 Adaptive 四阶段救援成功率 52.38 / 66.67 / 45.71 / 50.00,全面高于随机(18.18–25.00)、无画像规则路由和固定画像 Top-8,再锚定带来 Avg@3 +4.71 个百分点。RQ4(表 3、4):'先查 schema 再调 API'从基座 22.9% 升到 67.6%(GRPO 仅 38.2%),重复 execute 从 GRPO 的 30.1% 降到 9.8%,SWE-Gym 中测试被阻断后改写断言 48.5% vs 13.3%;表 4 两个案例显示救援行为在未见实例上复现。RQ5(表 5):训练后 $H_0$ 被选为 Rank-1 的比例从 1.53% 升到 22.52%,Rank-1 相对 $H_0$ 的 Pass@3 优势从 14.21 缩到 0.76,支持能力内化。RQ6(图 4):在未见 harness 下仍领先 GRPO +4.96 到 +14.37 个百分点,但绝对分数低于 DSH $H_0$,执行界面敏感性仍在。
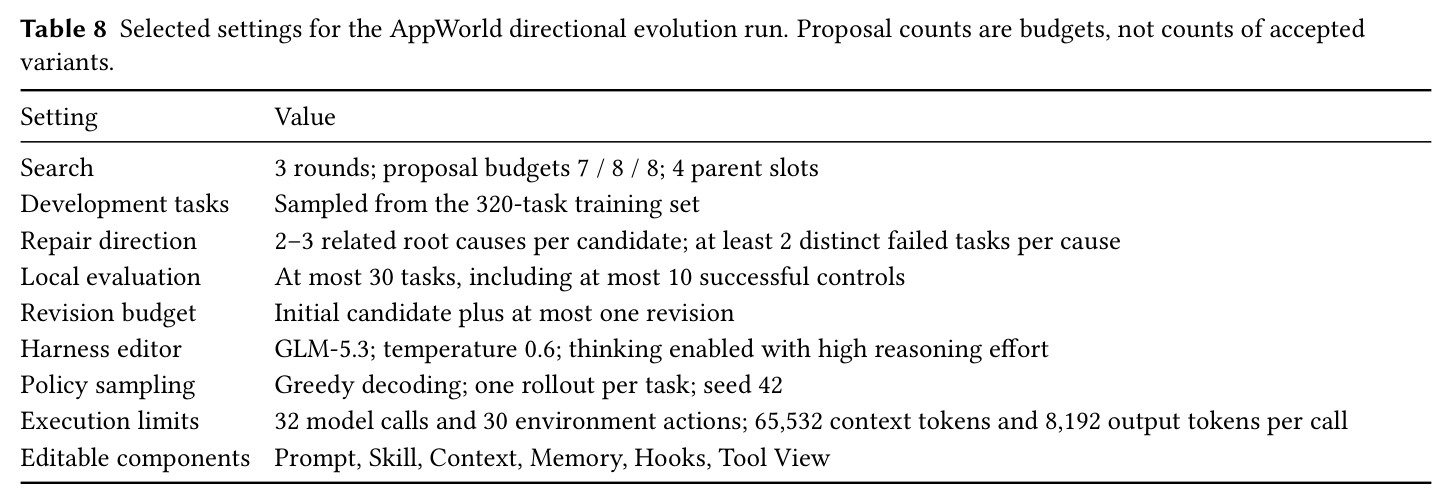
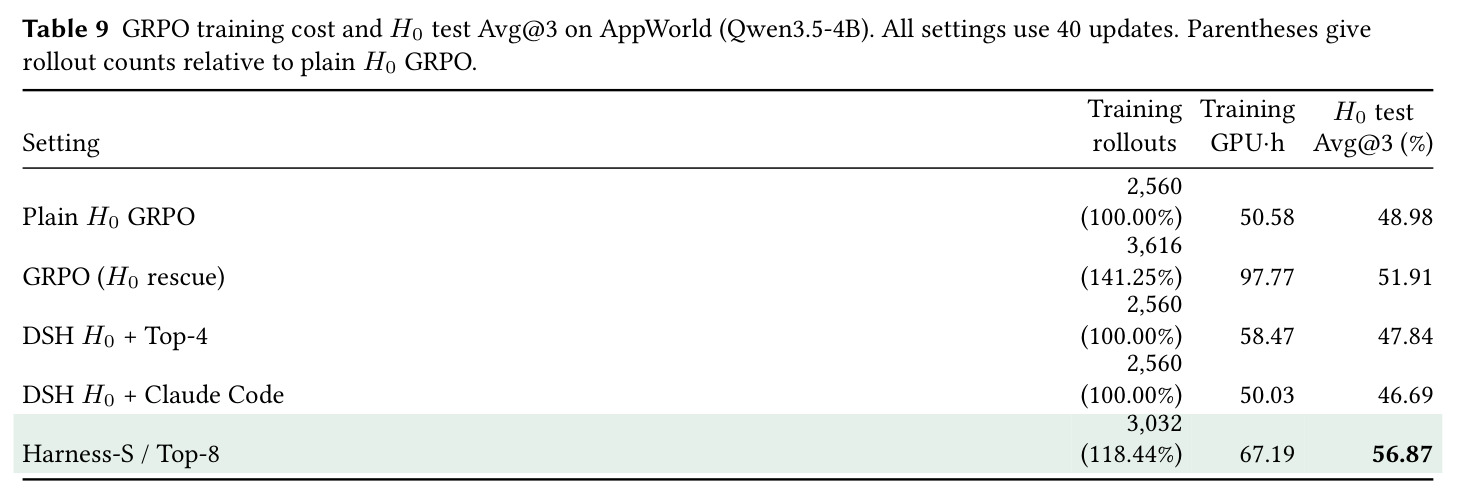
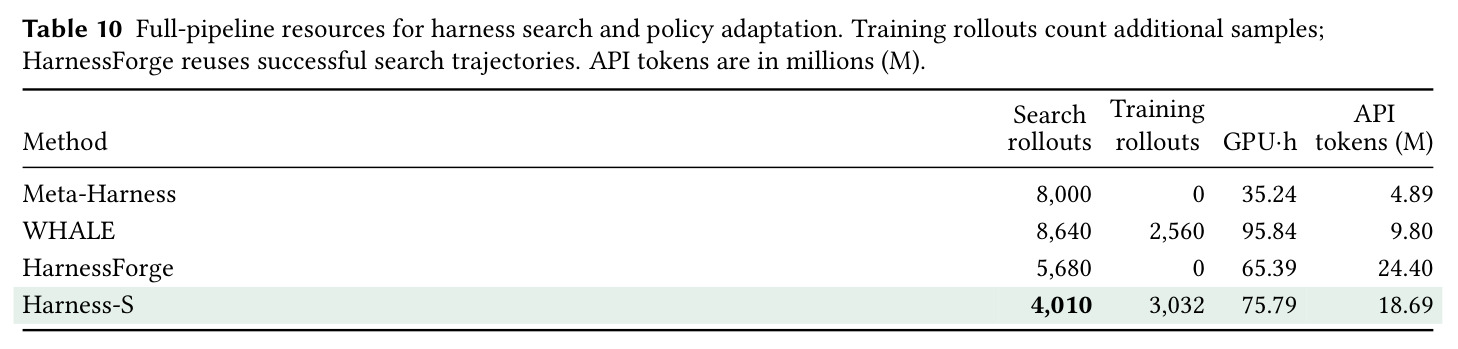
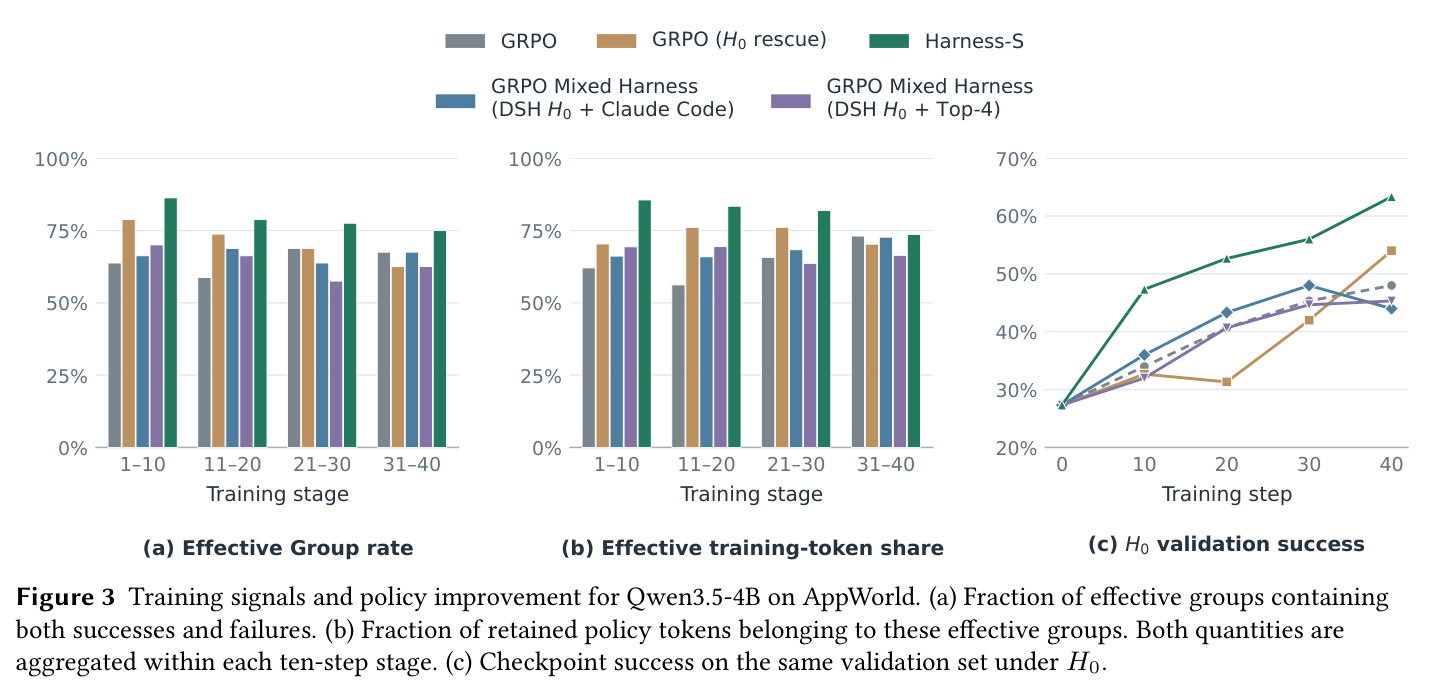
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AppWorld(Qwen3.5-4B,回到基座 H0 评测) | Pass@3(三次运行均值) | Harness-S:67.56 ± 1.87 | GRPO:60.31;GRPO (H0 rescue):61.83 | 比 GRPO +7.25 个百分点,比 H0 rescue +5.73 |
| AppWorld(Qwen3.5-4B,回到基座 H0 评测) | Avg@3 | Harness-S:56.87 ± 1.47 | GRPO:48.98;GRPO (H0 rescue):51.91 | 比 GRPO +7.89 个百分点 |
| AppWorld(Qwen3.5-9B,Rank-1 路由) | Pass@3 | 75.19 ± 1.56 | GRPO:64.89;GRPO (H0 rescue):65.65;WHALE (Hbest):68.70 | 比 GRPO +10.30 个百分点 |
| SWE-Gym(Qwen3.5-9B,Rank-1 路由) | Pass@3 / Avg@3 | 43.75 ± 1.84 / 36.25 ± 1.45 | GRPO:28.13 / 25.63;HarnessForge (Hbest):31.25 / 28.54 | Pass@3 比 GRPO +15.62 个百分点 |
| DBBench(Qwen3.5-9B,Rank-1 路由) | Pass@3 / Avg@3 | 78.00 ± 1.96 / 75.67 ± 1.55 | GRPO:69.67 / 67.00;前沿参考 GLM-5.3-Flash:76.67 / 72.11 | 比 GRPO +8.33,并超过全部三个前沿模型参考 |
| AppWorld 验证集(Qwen3.5-4B 训练过程,H0 检查点成功率) | 验证成功率(最终检查点) | 63.33% | GRPO (H0 rescue):54.00%;GRPO:48.00% | 比 H0 rescue +9.33、比 GRPO +15.33 个百分点 |
局限与改进
作者承认的局限:(1) 跨 harness 迁移不完全——图 4 显示 Harness-S 在 Claude Code 与 OpenClaw 上虽领先其他策略,但绝对分数低于自家 DSH $H_0$,说明行为内化后仍对执行界面敏感;(2) Rank-1 路由仍保有增益(Avg@3 边际还剩 4.58 个百分点),意味着部分能力仍留在推理时支撑里;(3) 救援与再锚定有额外成本——训练 rollout 为纯 GRPO 的 118.44%(3,032 vs 2,560),API token 18.69M 高于 Meta-Harness 的 4.89M;(4) 路由必须在观察到结果前选 harness,oracle 并集(29 个修复)与路由可达覆盖之间存在原理性差距。我自己的观察:(5) 触发条件是'8 条全失败',对 1–2 次成功的边缘任务不触发救援,而这些任务恰恰是奖励对比最稀薄的地带;(6) 池演化 3 轮、规模固定 20,若失败模式呈长尾分布,池容量是否足够未被验证;(7) 画像归纳与行为标注依赖 LLM 判断,且三个基准都是结果可自动验证的任务(应用 API、数据库、软件工程),对开放式任务的适用性未知;(8) 表 3 的行为频率只描述相关不描述因果——更多 schema 查询本身不等于正确性,作者也承认频率'描述行为而非正确性'。
独立分析的弱点
独立分析四点弱点。第一,边缘任务盲区:触发条件为全失败,例如 8 条轨迹中恰有 1 条成功的任务不会触发救援,但该组信号极弱(7 败 1 成的组相对优势几乎全部压在单条轨迹上);改进方向是把触发阈值做成连续量(如组内成功率低于 $1/8$ 即路由),并与 rollout 预算联动分配。第二,路由证据滞后:再锚定每 10 次更新一次,期间策略可能已漂移——非平稳性恰是本文自己的核心观察,快照间隔与漂移速度之间缺乏自适应机制;可改为按验证集分布漂移检测动态触发校准。第三,成本结构偏向推理侧 API:训练 GPU 时 67.19h 尚可,但画像构建与投票依赖外部 LLM(18.69M token),规模化时投票开销近似线性于池大小乘校准频率;可研究把 LLM 投票蒸馏成轻量 task-to-harness 匹配模型或检索式画像。第四,池对策略完全静态:若新策略出现演化时未诊断过的失败模式,池中没有对应专科变体,救援注定失败;可引入池增量更新协议——训练中检测系统性未修复失败并定向补充变体,同时用预算上限控制成本,这也与作者提出的 Harness Scaling 方向自然衔接。
未来方向
作者在结论与附录中给出三个方向:Harness Scaling——系统测量修复多样性增加对策略增益与校准成本的影响;跨策略池复用——一个池服务多个策略时如何摊销演化成本、画像如何按策略条件化;跨 harness 状态交换——让独立开发的 harness 之间通过执行接口交换任务状态,把救援范围从'同源兄弟'扩展到异构框架。基于其成果还可延伸:(1) 把救援触发与课程学习结合,按救援成功率动态调整任务采样权重,优先训练'救援后能解'的边界任务;(2) 将行为画像与验证成功率融合成可学习的路由器,替代当前的多 LLM 投票以降低推理延迟;(3) 在 RRSI 风格的正则下探索'可迁移机制优先'的编辑目标,从源头提高内化率——表 4 显示程序性流程(Venmo 账号恢复迁移到 Amazon)比任务特定约束更易跨实例迁移,这一现象值得系统量化;(4) 多环境混合训练下的池设计:不同环境的根因空间不同,单一池与分环境池的取舍;(5) 与 test-time scaling 结合,对 Rank-1 之后仍失败的任务做第二层救援或自一致性投票。
复现评估
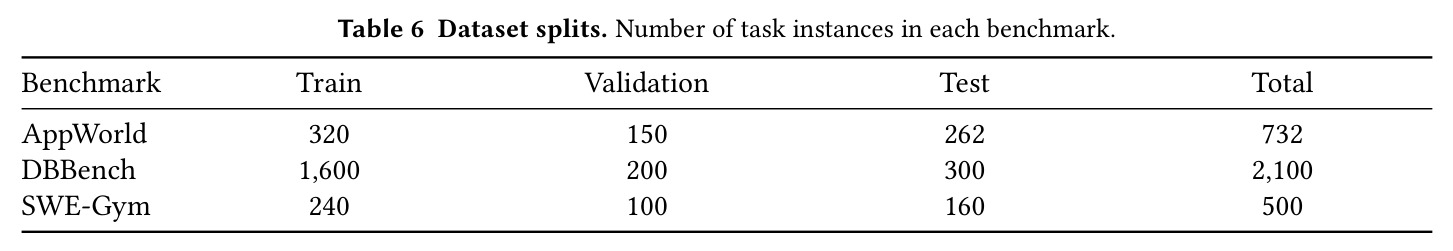
复现条件较好。代码已开源(github.com/DeepExperience/Harness-S);三个基准全部公开且 splits 明确(表 6:AppWorld 训练/验证/测试 = 320/150/262,DBBench = 1,600/200/300,SWE-Gym = 240/100/160);策略模型是公开的 Qwen3.5-4B/9B。算力门槛:8 张 NVIDIA H800,AppWorld 4B 全流程约 75.79 GPU·h(搜索 4,010 + 训练 3,032 rollouts),中小实验室可承受。困难点有三:(1) harness 编辑器与路由投票依赖 GLM-5.3 等 API 模型(18.69M token),复现者需要 API 预算,且所配模型版本会影响演化出的池与路由质量;(2) 工程细节多——多 LLM 投票权重、画像再锚定协议、概率校正(式 (16))、token 掩码等,好在附录 B–G 给出完整超参($\eta^-=0.20$、$\eta^+=0.28$、$\epsilon=10^{-6}$、每 10 次更新再锚定、池 20 成员、救援 Top-8)与提示词节选;(3) 主表是 3 次独立运行均值,Harness-S 标准差约 ±1.2–2.4,单次复现可能有 2 个点以内波动。总体属于'已有 RL 训练基础设施即可复现'的中等偏上难度。
论文图表
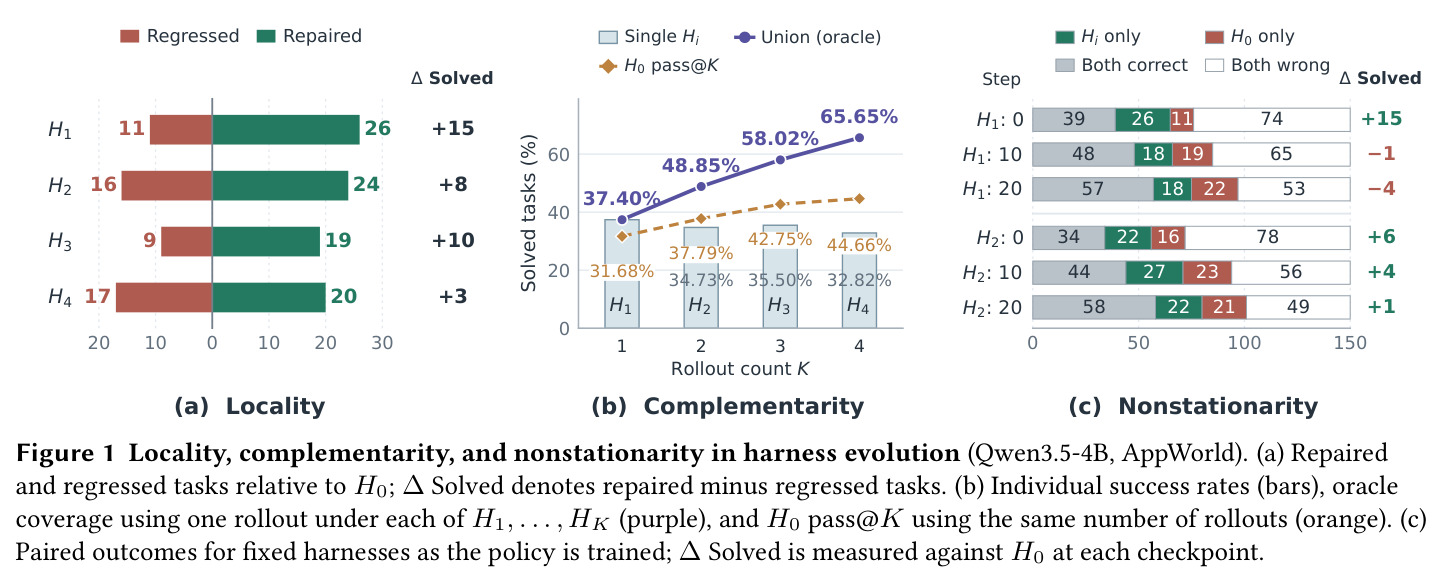
三联图。(a) 局部性:四个第一代变体相对 H0 的修复/回退任务数——H1 修复 26、回退 11(净 +15),H4 修复 20、回退 17(净 +3),说明每次编辑只解决部分失败且引入回退。(b) 互补性:各变体单独成功率(柱状)低于 H0 的 pass@K,但每个变体各执行一次的 oracle 并集(紫色)超过同 rollout 数下 H0 的重复采样(橙色)。(c) 非平稳性:固定 harness 与 H0 的成对结果随策略检查点变化——H1 的 ΔSolved 从检查点 0 的 +15 衰减到 +10 时的 −1、检查点 20 的 −4,H2 从 +6 变为 +4。
这张图是全文的经验地基:三条性质直接推导出'不合并修复、保留互补变体、路由证据需随策略再锚定'三个设计决策。没有这张图,Harness-S 的动机就不成立。