MoME:面向上下文感知稀疏查找的记忆嵌入混合 MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
把每个 token 的单一记忆行扩展为多槽位混合,用隐藏状态门控实现上下文感知的记忆查找
前置知识
混合专家(MoE)
MoE 是一种条件计算架构:网络中包含多个并行的“专家”子网络和一个路由器,每个输入 token 只被送到得分最高的少数几个专家处计算,从而在总参数量增长的同时保持每 token 的计算量(FLOPs)基本不变。门控通常用 softmax 加 top-K 选择实现,并配合负载均衡损失防止专家塌缩。GShard、Switch Transformer、Mixtral 等前沿模型都靠它解耦“总容量”与“计算成本”。
MoME 的槽位门控直接借用 MoE 的思想(top-K 激活、学习路由),只是把稀疏选择的对象从计算侧的 FFN 专家换成了存储侧的记忆槽位;理解 MoE 才能明白 MoME 的设计取舍与两者可组合的原因。
注意力 value 流与值残差
在自注意力与分组查询注意力(GQA)中,每个 token 的隐藏状态经投影得到 Query、Key、Value 三组向量,其中 Value 决定注意力输出实际“搬运”的信息内容。Value Embedding 一类方法正是在 value 流上做文章,例如 ResFormer 把第一层的 value 向量作为残差加回后续层。推理时 K/V 会被缓存以加速自回归解码。
MoME 把检索到的记忆经门控残差加到每个 value 头上,即 $\tilde v_{t,i}=v_{t,i}+\gamma_{t,i}\tilde m_{t,i}$;理解注入位置才能明白其延迟优势(记忆分支与 value 投影并行计算、最后才汇合)。
记忆嵌入增强 Transformer
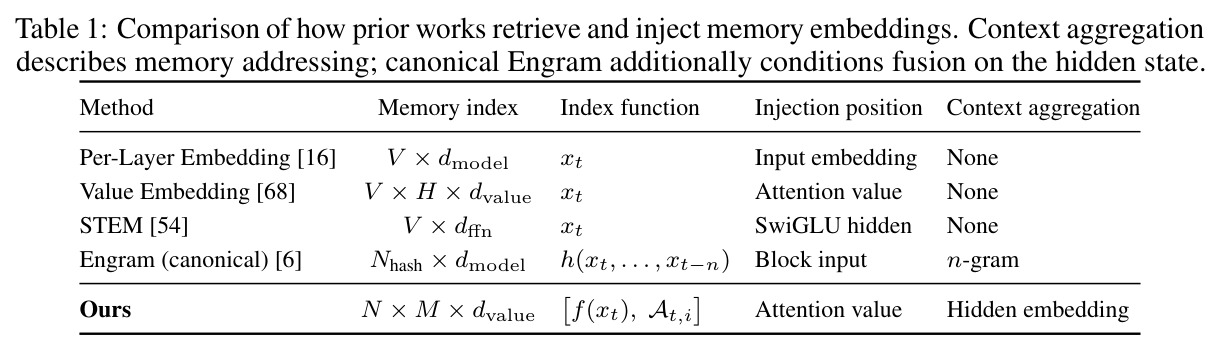
这类方法在主干之外学习一张可查询的嵌入表,按输入的确定性函数(token id 或 n-gram hash)取出对应行并注入主干:Gemma 3n 的 Per-Layer Embedding 注入输入嵌入,Value Embedding 注入注意力 value 流,STEM 融入 SwiGLU 隐层,Engram 用 2/3-gram hash 查表再门控融合。因为每个 token 只激活表的一小部分,记忆表可以低成本地大幅扩参。
MoME 与这些方法同属一个家族并逐一对比(Table 1),论文的问题意识——“确定性索引导致上下文盲检索”——正是从这张对比表的空缺中引出的。
bpb(bits per byte)
语言建模损失按 UTF-8 字节数归一化后的比特数:$bpb=\sum_i -\log_2 p_\theta(y_i|x_{<i})/\text{bytes}(y_i)$。相比按 token 归一化的困惑度,bpb 对不同 tokenizer 词表大小不敏感,可在不同模型间公平比较,数值越低越好。论文所有预训练实验都以 train/val bpb 为主要指标。
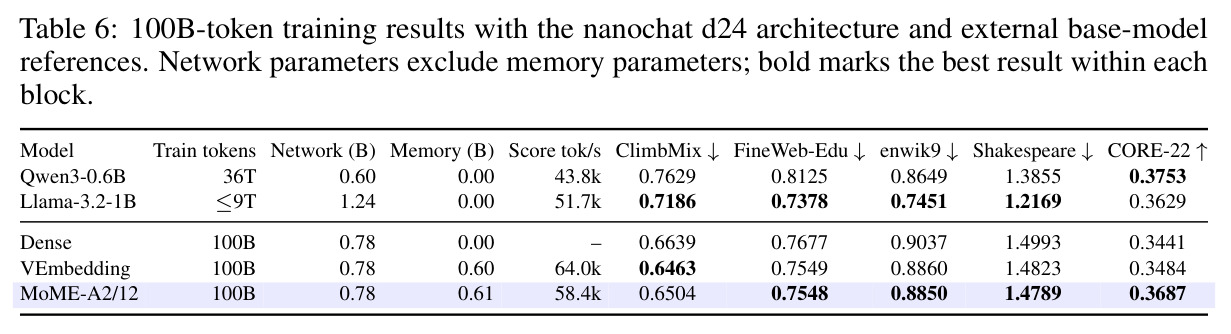
主结果表(Table 2、3、6)全用 bpb 衡量语言建模质量,MoME 相对 Bigram/VE/STEM 的提升幅度都在千分之几 bpb 的量级,需要理解该指标才能判断这些数字的意义。
CORE 指标
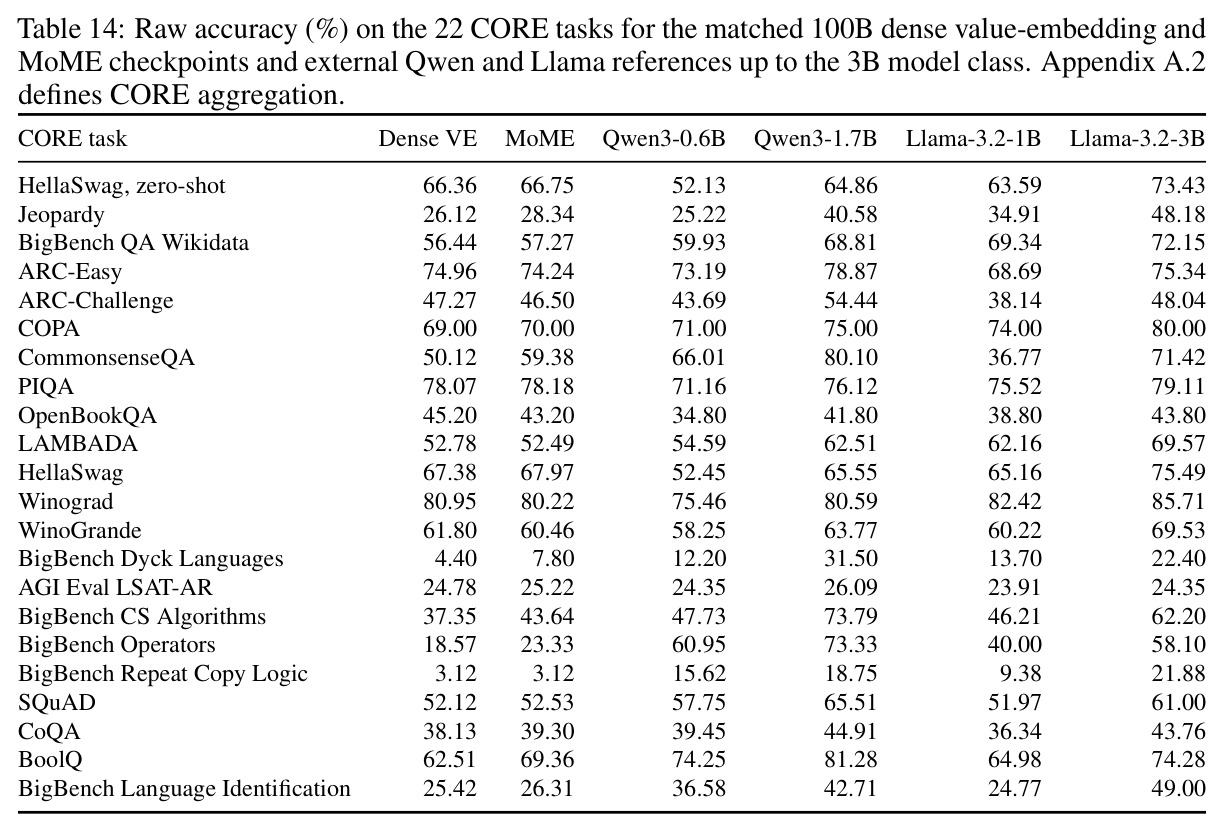
nanochat 提出的聚合评测:对 22 个任务(ARC、HellaSwag、BoolQ、SQuAD、多个 BigBench 子集等)分别计算原始准确率,按各自随机基线 $r_j$ 校正后取平均,即 $CORE=\frac{1}{J}\sum_j (a_j-r_j)/(1-r_j)$。它比单一 bpb 更贴近下游能力,同时消除任务间随机基线差异带来的偏差。
MoME 最稳定的卖点就是 CORE 系统性高于所有记忆基线(如 100B token 下 0.3687 vs VE 的 0.3484),而这个优势在 bpb 上并不总是成立,读懂该指标才能正确解读论文结论。
Top-K 门控与 sigmoid 归一化
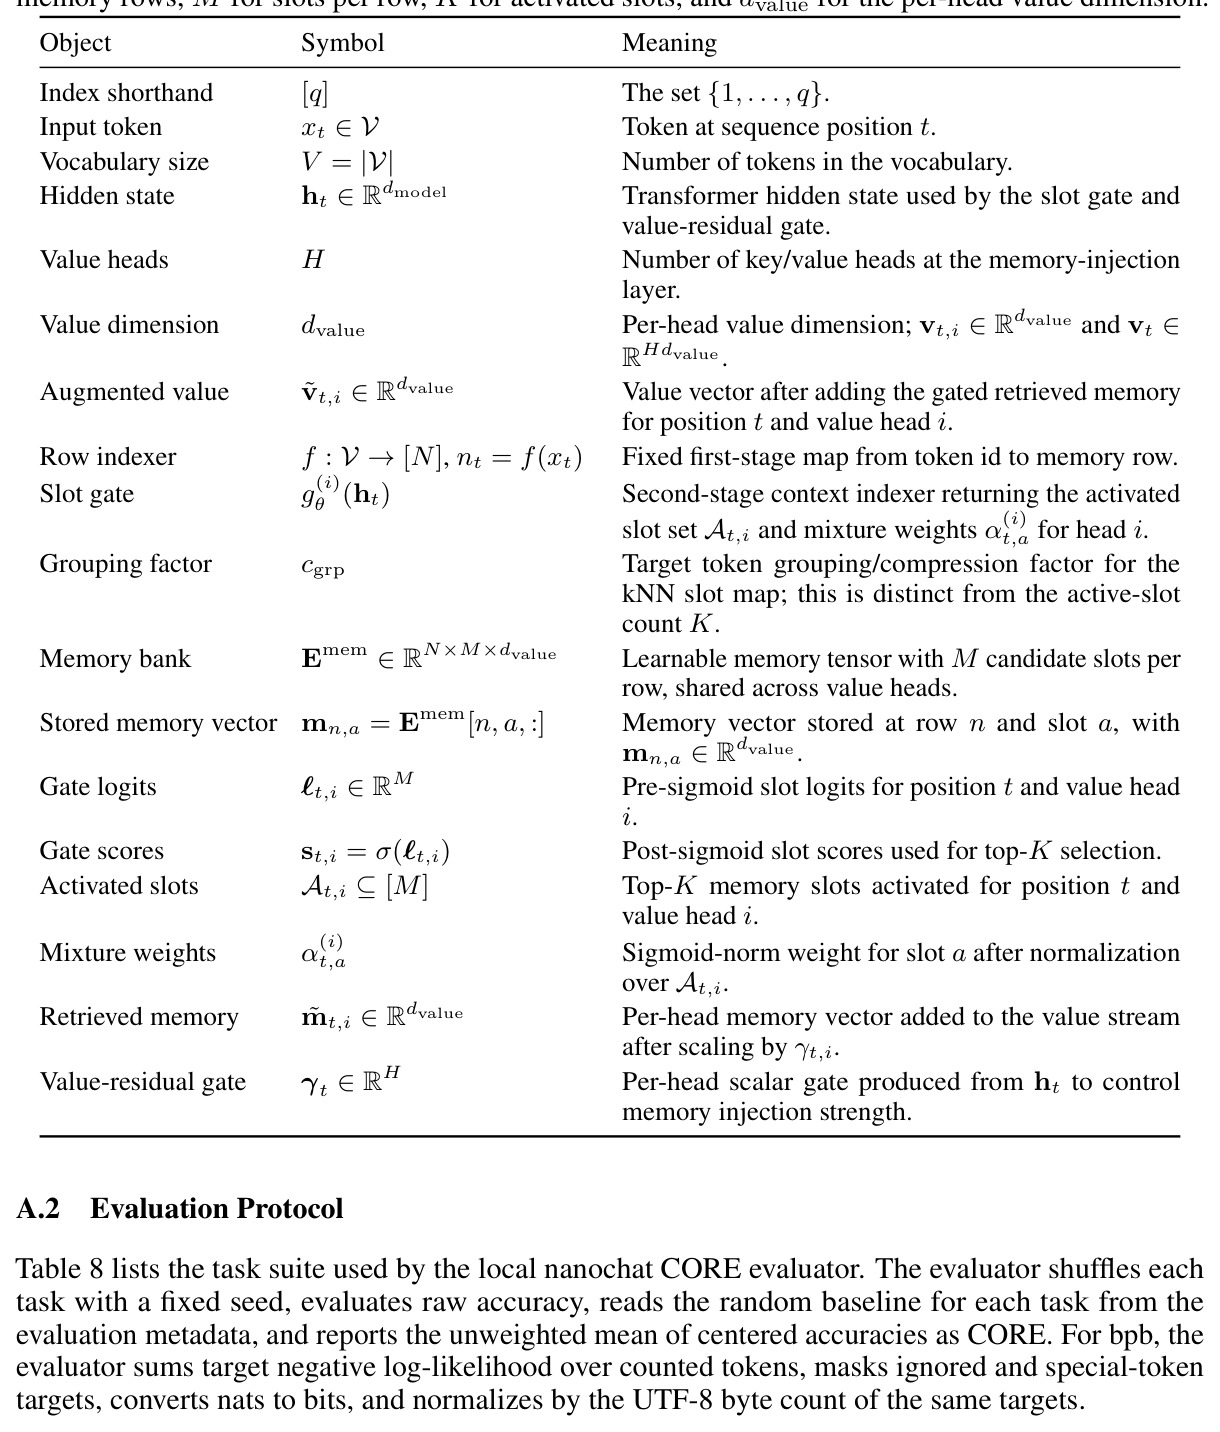
Top-K 门控先给 M 个候选项打分,只保留分数最高的 K 个参与计算、其余置零以保持稀疏。MoME 对选中的 K 个槽位使用 sigmoid 分数并在其内部归一化:$\alpha_{t,a}=\sigma(\ell_{t,a})/\sum_{b\in A}\sigma(\ell_{t,b})$,这与标准 MoE 在全部专家上的 softmax 不同;K=1 时才退化为 softmax。
这是 MoME“读哪几个槽位、各占多少权重”的具体机制,是方法一节的核心公式,也解释了为什么同一个 token 在不同语境会激活不同槽位。
研究动机
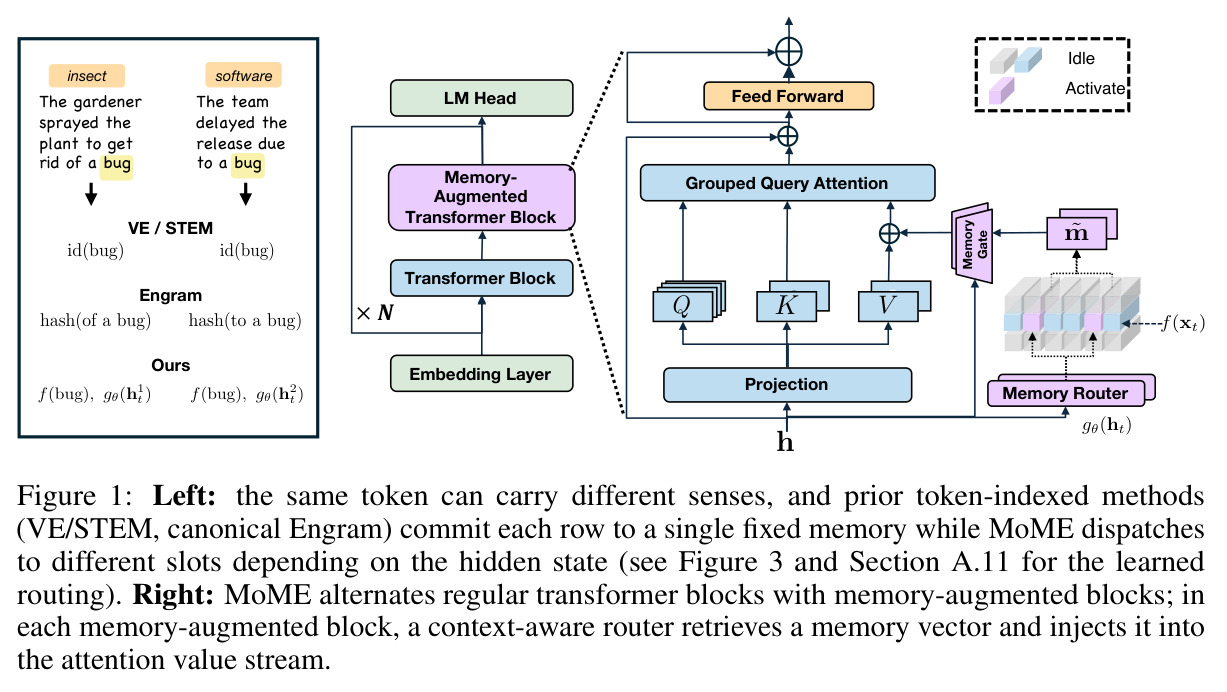
近年来一类“条件记忆”方法试图为 Transformer 增加廉价的可学习记忆表:Gemma 3n 的 Per-Layer Embedding 按 token id 注入输入嵌入,Value Embedding 注入注意力 value 流,STEM 融入 SwiGLU 隐层,Engram 用固定的 2/3-gram hash 查表,Bigram 用前后 token 组合查表。它们的共同限制是:查表索引是表面形式的确定性函数,与模型当前的隐藏状态无关。这带来两个复合问题。其一是容量错配:一行记忆对应一个 token,但 token 的语义负载并不均等——cats/cat 这类近乎同义的变体各自占一行、重复存储同样的内容,而 bank(银行 vs 河岸)、python(编程语言 vs 蟒蛇)、spring(季节/弹簧/动词)这类多义词却被迫把几个迥异的语义挤进同一个固定向量。其二是上下文盲检索:同一个 token 无论出现在什么语境都取回同一份记忆,模型只能靠后续层计算去“纠正”检索结果。也就是说,现有记忆机制在容量分配和内容选择两个层面都没有利用上下文。
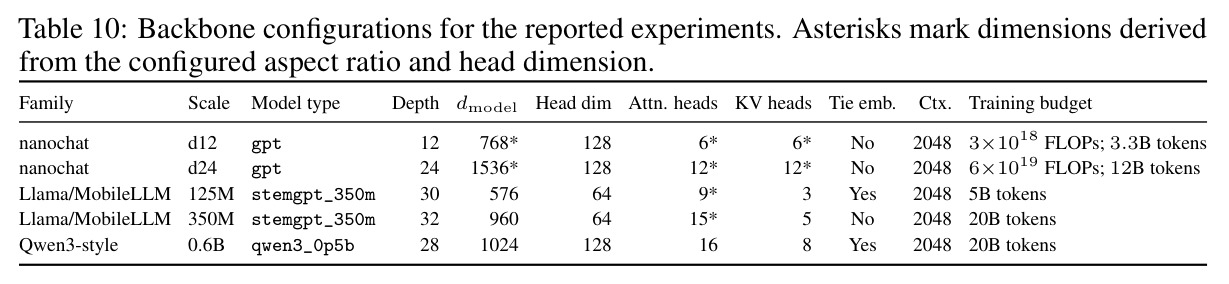
本文的目标是论文的目标是设计一种上下文感知的条件记忆机制,同时保留 token 索引查找的全部效率优点:查表级开销、可用低成本扩张记忆容量、推理延迟增幅小。具体做法是把每个 token 对应的记忆行从单个向量扩展为 $M$ 个槽位的混合,由当前隐藏状态决定这次读取哪 $K$ 个槽位、各占多少权重,使同一表面 token(如 python)在不同语义语境下检索到不同的记忆内容。在验证层面,作者设定了严格的受控比较:在 nanochat、Llama/MobileLLM、Qwen3 三个骨干家族上,以等记忆参数或等训练 token/FLOPs 的口径,与 Value Embedding、STEM、Bigram 等最强记忆基线对比;并考察记忆容量从 75.5M 到 604M 的扩展趋势、与 Bigram 及稀疏 MoE-FFN 的可组合性,以及学到的路由是否真的按语义分流。
与已有工作不同的是,本文的独特切入点是把“稀疏门控选择”从 MoE 的计算侧搬到记忆表的存储侧,并拆解出两级索引结构:一级 token 索引 $f(x_t)$ 选行(确定性、便宜),二级上下文索引 $g_\theta(h_t)$ 在行内选槽(学习得到、随语境变化)。与 Value Embedding/STEM 的“一 token 一向量”相比,MoME 让多义词天然获得多个槽位;与 Engram 的差异更微妙——Engram 只在融合阶段用隐藏状态做门控,寻址本身仍是 n-gram hash,而 MoME 让寻址的第二级直接依赖 $h_t$。此外 MoME 不对一级索引做任何假设,因此 Bigram 的 hash 表可以直接充当 $f$,与 MoME 的槽位混合正交叠加,为“同时放大 n-gram 表与槽数”的复合扩展打开了空间。这种“行由 token 定、内容由上下文选”的分解,在此前所有记忆嵌入工作中都是缺失的一环。
核心方法
直觉上,MoME 给每个 token 配了一排带锁的储物柜($M$ 个槽位):模型读到一个词时,根据它所在的具体语境(隐藏状态 $h_t$)打开最相关的几个柜子取货,而不是永远取同一个包裹。技术上,记忆是可学习张量 $E^{mem}\in\mathbb{R}^{N\times M\times d_{value}}$,其中 $N$ 是行数(由 token 索引器决定)、$M$ 是每行槽位数、$d_{value}$ 是注入点每个注意力 value 头的维度。整体架构是常规 Transformer 块与记忆增强块交替(通常占一半的层,即奇数层):记忆增强块保留标准注意力与 FFN 计算,额外挂一个侧路记忆模块——读入块输入的隐藏状态,检索一个上下文相关的记忆向量,再按头注入注意力 value 流。两个索引器分工明确:$f(x_t)\to n_t$ 选行,$g_\theta(h_t)\to(A_{t,i},\alpha)$ 在行内选槽并给出权重;最后由独立的值残差门 $\gamma_\theta(h_t)$ 控制注入强度。
核心创新是“两级索引分解”:已有方法的记忆寻址是单一确定性函数 $f(x_t)$(token id 或 n-gram hash),MoME 把它复合成先 $f(x_t)$ 后 $g_\theta(h_t)$——行由 token 决定、槽位由上下文决定。这带来一个本质转变:记忆容量从“按 token 分配”变为“按语义内容分配”。多义词(bank 的金融义与河岸义)可以在同一行里各占一个槽位、互不干扰;近义变体(cats/cat)则可通过可选的 kNN 行分组共享一行,把省下的容量换成更多槽位。与标准 MoE 的区别在于稀疏化的对象:MoE 选择的是计算(哪些 FFN 专家参与本次前向),MoME 选择的是参数存储(读这一行的哪几份记忆),因此路由器只有 $d_{model}\times M$ 的投影开销,不需要负载均衡损失,也不会显著拖慢训练。与 Engram 的区别在于上下文进入的层次:Engram 的门控只调节“取出的记忆以多强注入”,MoME 的门控决定“取出哪份记忆”,这是检索语义的根本不同。
方法步骤详情
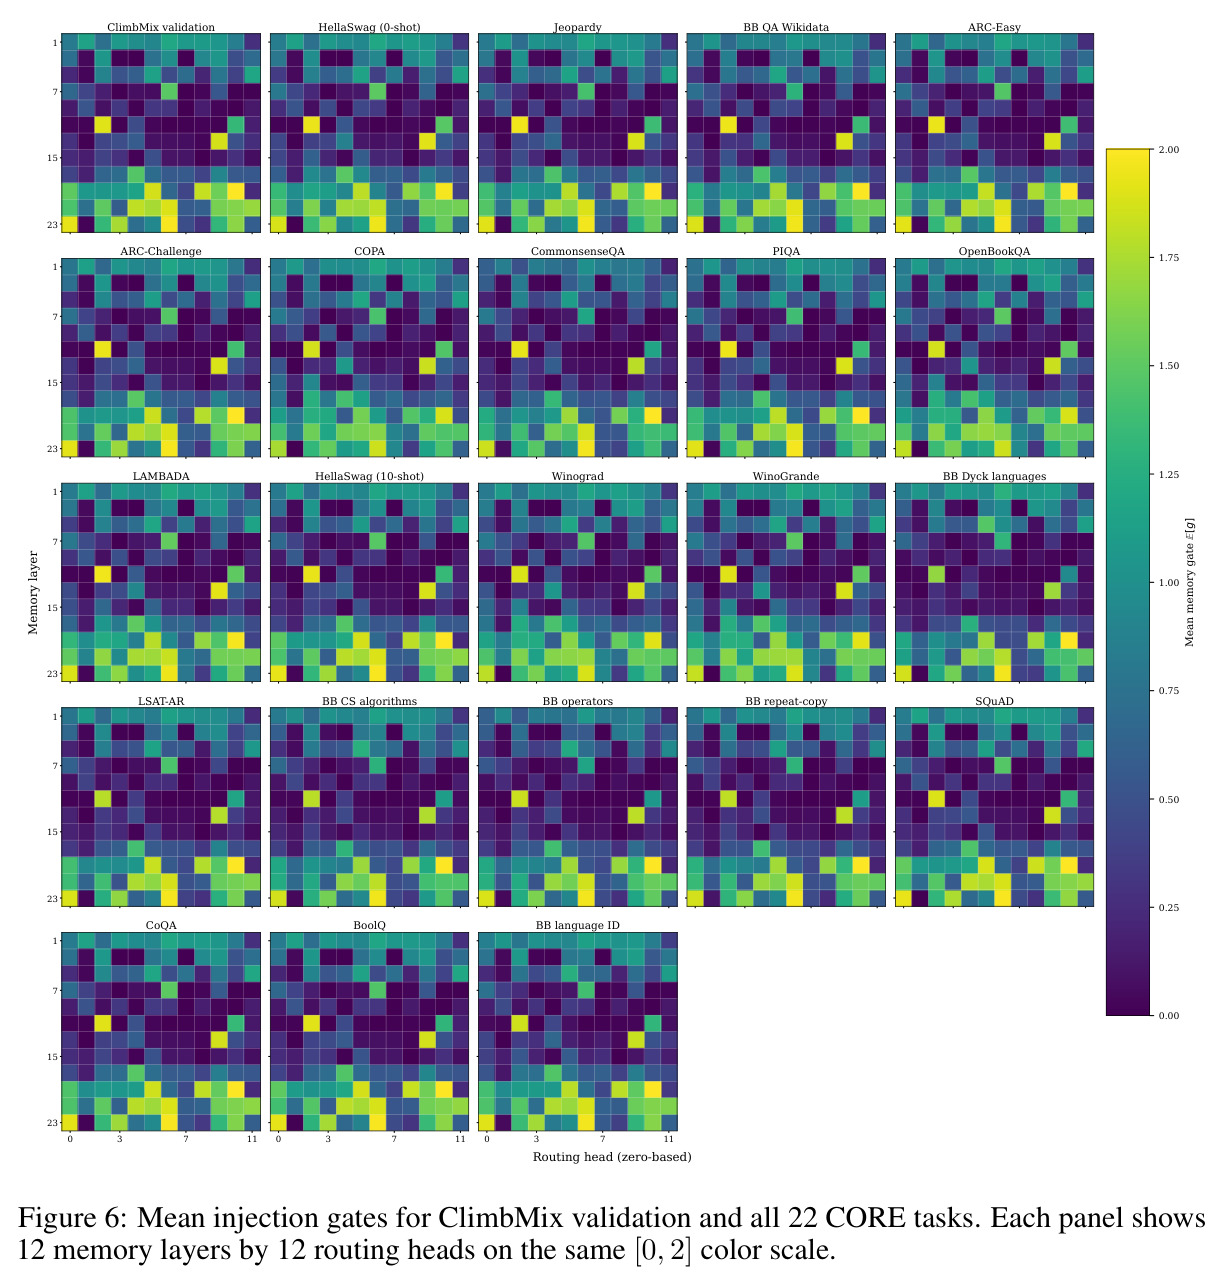
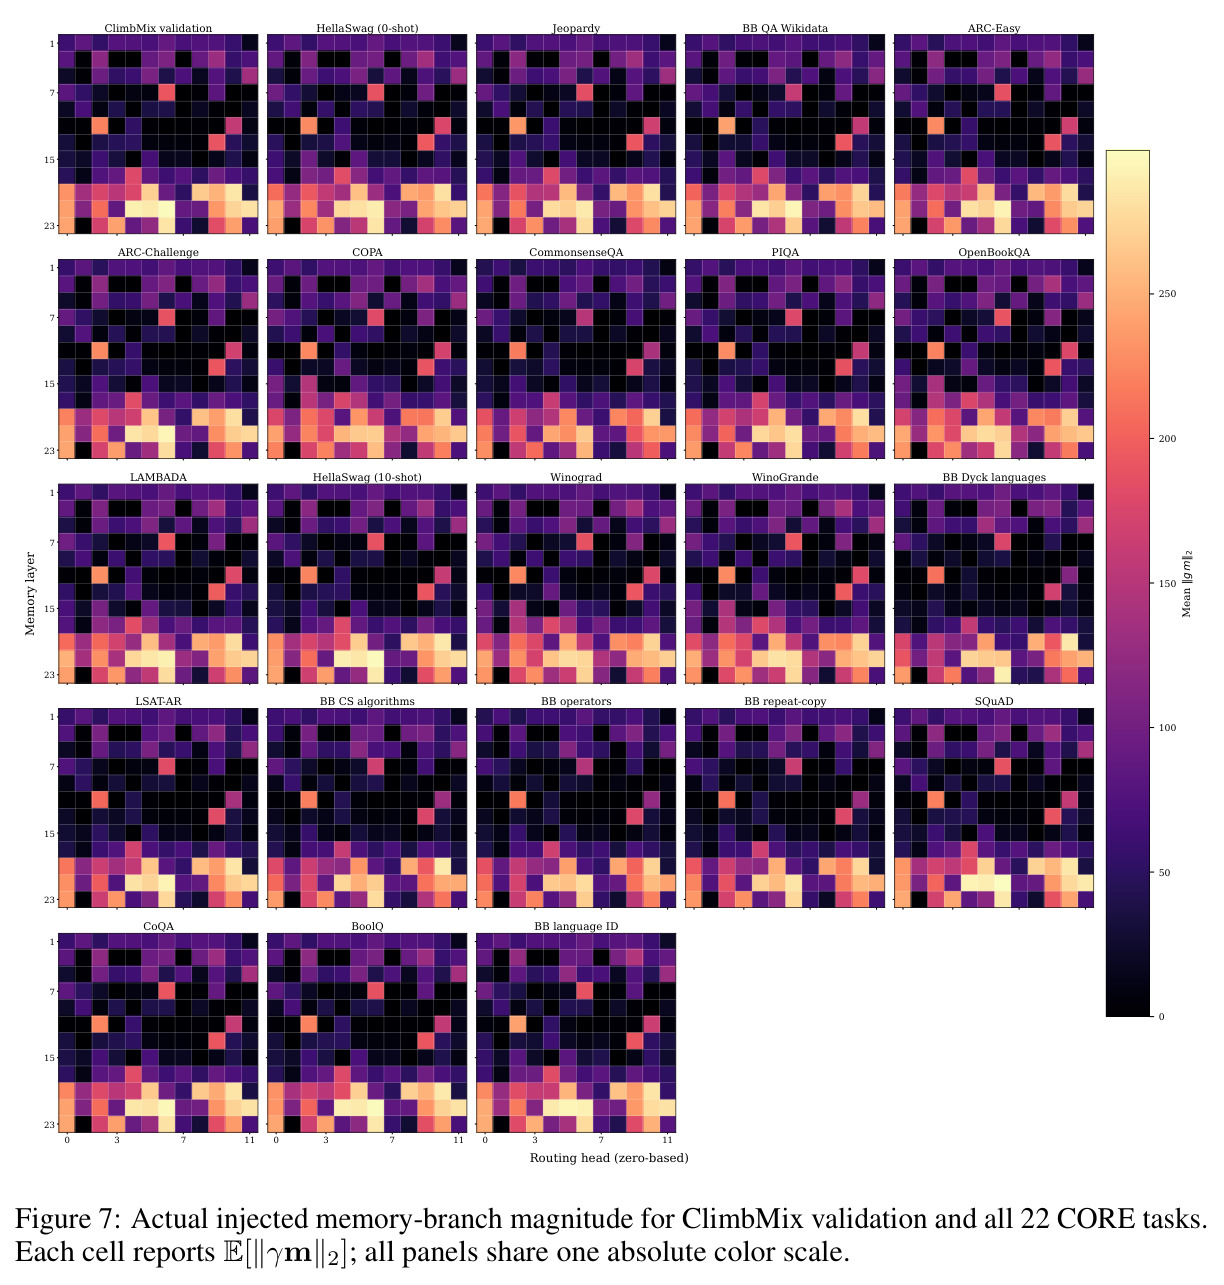
前向分七步。(1) 离线准备(可选):用约 1B token 轻量预训练的嵌入矩阵 $U_{ref}$ 做 kNN 匹配构造固定行映射 $f$,语义相近的 token 分入同行;分组因子 $c_{grp}\in\{2,4\}$ 下行数缩为 $V/c_{grp}$、每行槽数扩 $c_{grp}$ 倍,总参数不变。(2) 一级索引:token $x_t$ 到达记忆增强块(插在奇数层)后计算行号 $n_t=f(x_t)$(默认恒等)。(3) 选槽:每个 value 头 $i$ 独立算槽位 logits $\ell_{t,i}=W_g^{(i)}h_t+b_g^{(i)}\in\mathbb{R}^M$,Top-K(默认 $K=2$)得激活集 $A_{t,i}$。(4) 归一化:sigmoid 分数在选中槽位内归一化得权重 $\alpha_{t,a}$($K=1$ 时用 softmax)。(5) 聚合:$\tilde m_{t,i}=\sum_{a\in A_{t,i}}\alpha_{t,a}\,m_{n_t,a}$。(6) 注入:$\gamma_{t,i}=[2\sigma(W_\gamma h_t+b_\gamma)]_i$(零初始化时为 1),$\tilde v_{t,i}=v_{t,i}+\gamma_{t,i}\tilde m_{t,i}$。(7) 训练:所有 value 头共享一张表(参数上限 $NMd_{value}$),矩阵参数用 Muon、记忆表用 AdamW(lr 0.1–0.2);路由分支与 value 投影并行、只在门控残差处汇合,推理延迟约为隐藏状态注入方案的一半。
技术新颖性
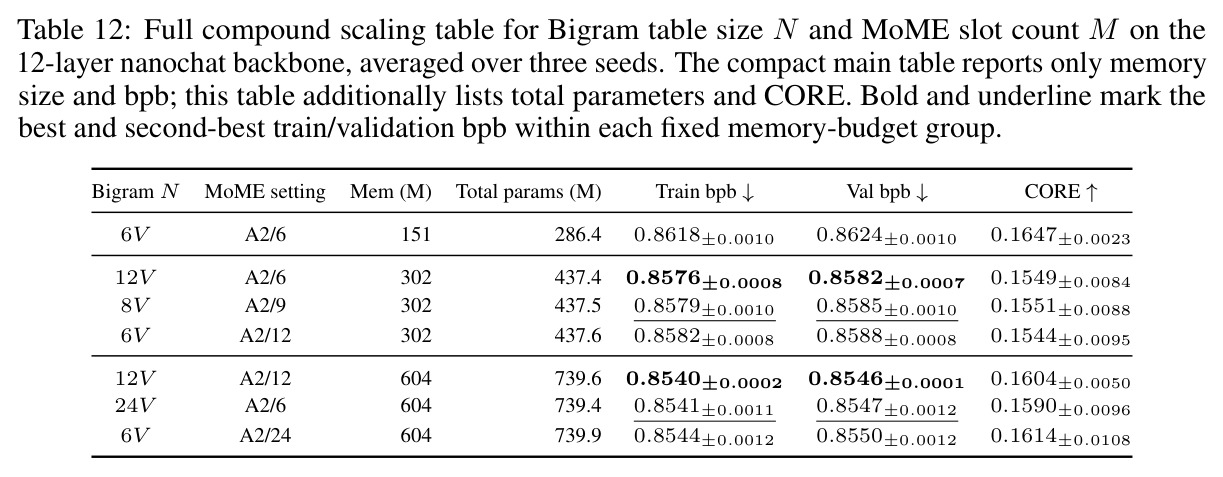
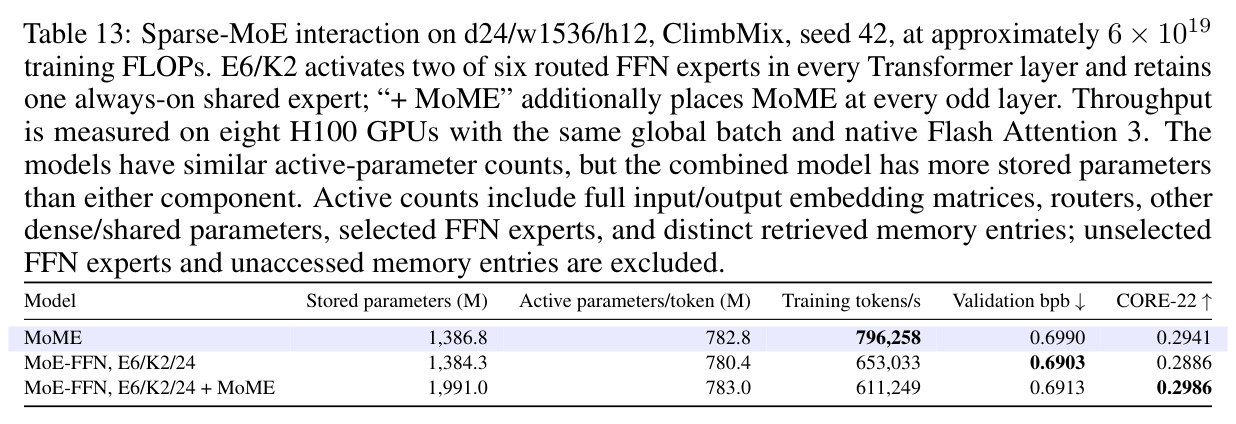
技术新颖性可从四个坐标定位。相对记忆嵌入家族(VE/STEM/Engram/Bigram):这是该家族第一个把隐藏状态引入寻址的工作,此前所有方法的检索都是表面形式的固定函数(Table 1 系统对比了这一空缺);sigmoid-norm 行内归一化相对 softmax 允许多个槽位同时保持高权重,更适合“几个语义都相关”的软组合。相对 MoE:MoE 稀疏化计算侧的 FFN,MoME 稀疏化存储侧的记忆槽位,二者正交——Table 13 显示 E6/K2 的 MoE-FFN 与 MoME 叠加后 CORE-22 从 0.2886 升至 0.2986,为全文最高。相对内容寻址记忆网络:MoME 刻意不走 content-addressable 检索(需与全部记忆比较、延迟高),而是保留 token 索引的一级寻址换取查表级速度。相对多头设计:共享一张表但每个头独立路由(每头有自己的 $W_g^{(i)}$ 与 $A_{t,i}$),在参数效率与头间表达自由度之间取得平衡。把 Bigram hash 直接复用为一级索引 $f$ 的复合方案(Table 4)则展示了一种新颖的“索引侧+存储侧”联合缩放维度。
实验结果
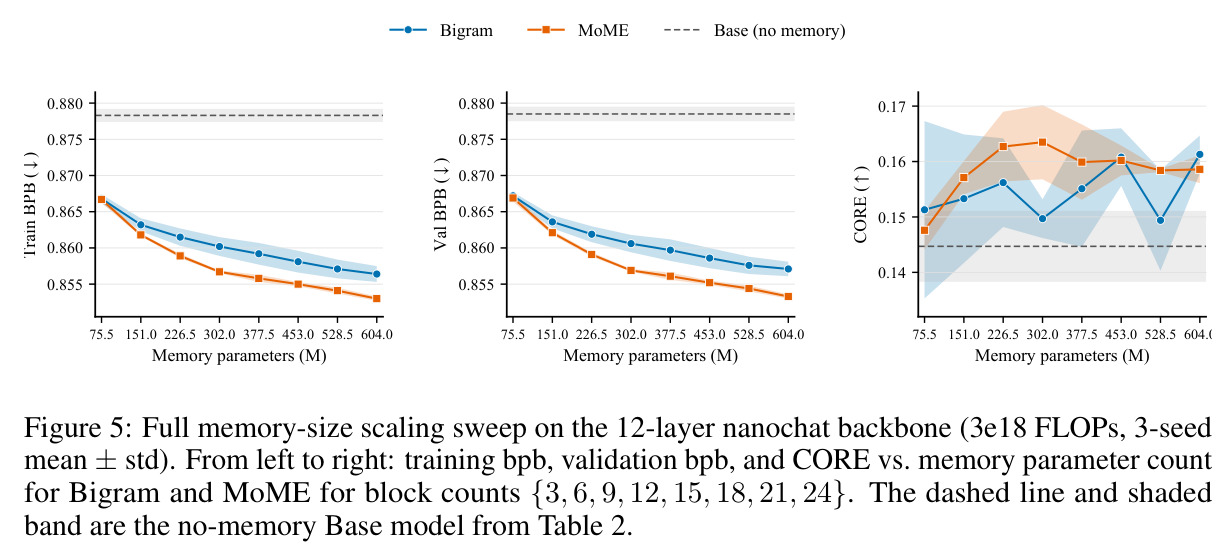
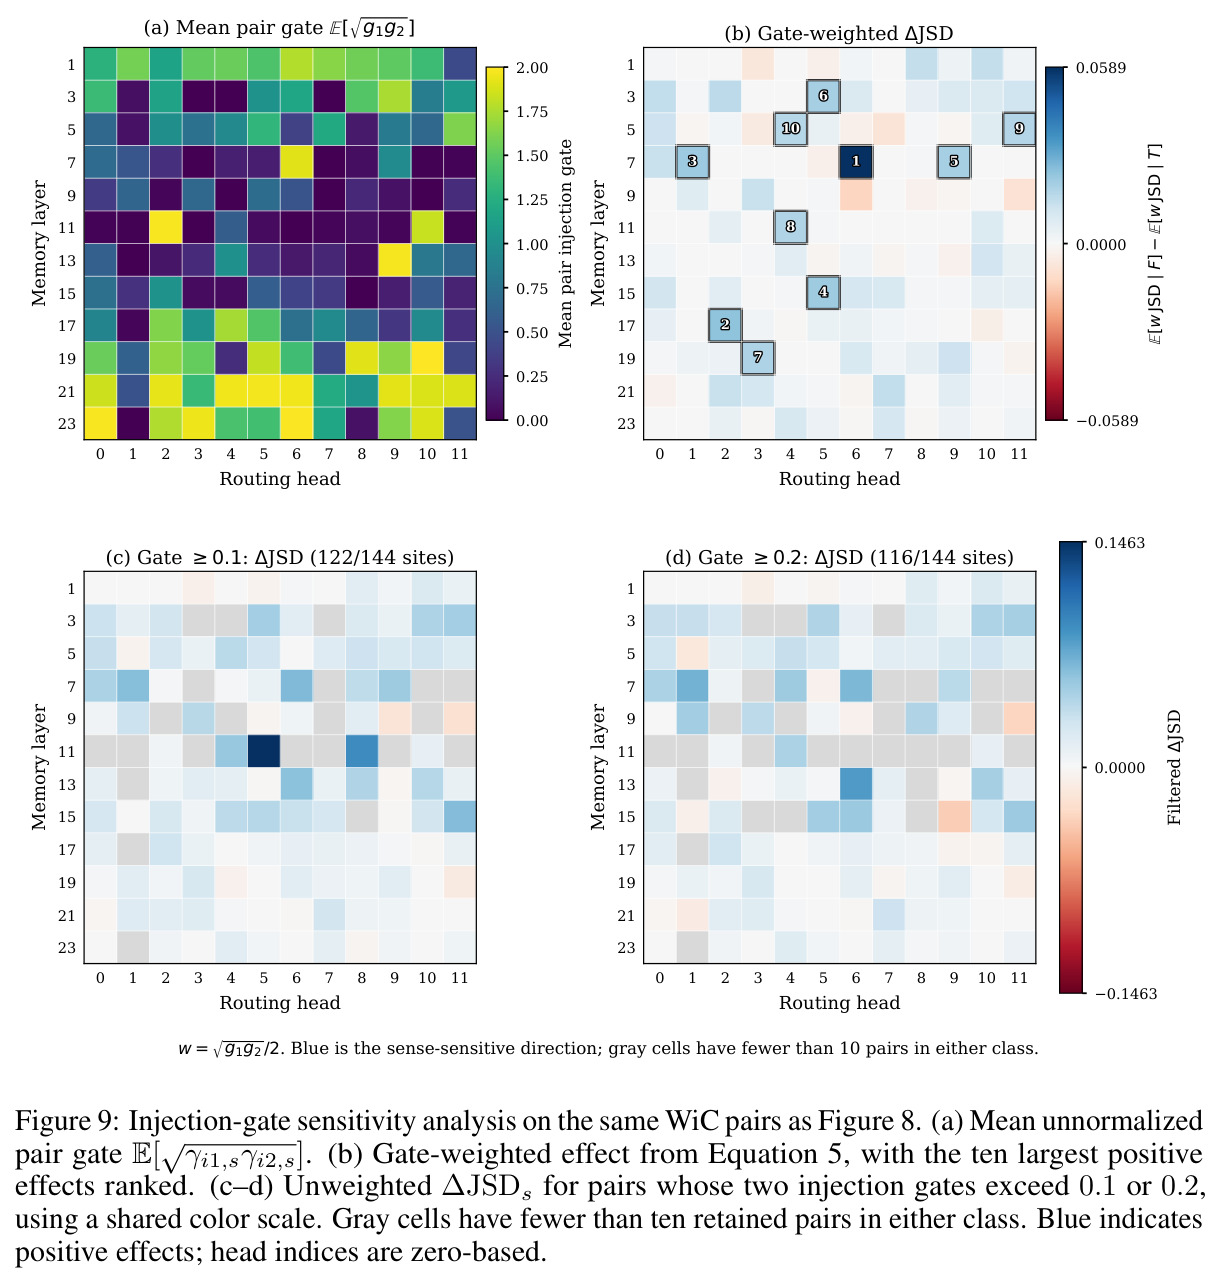
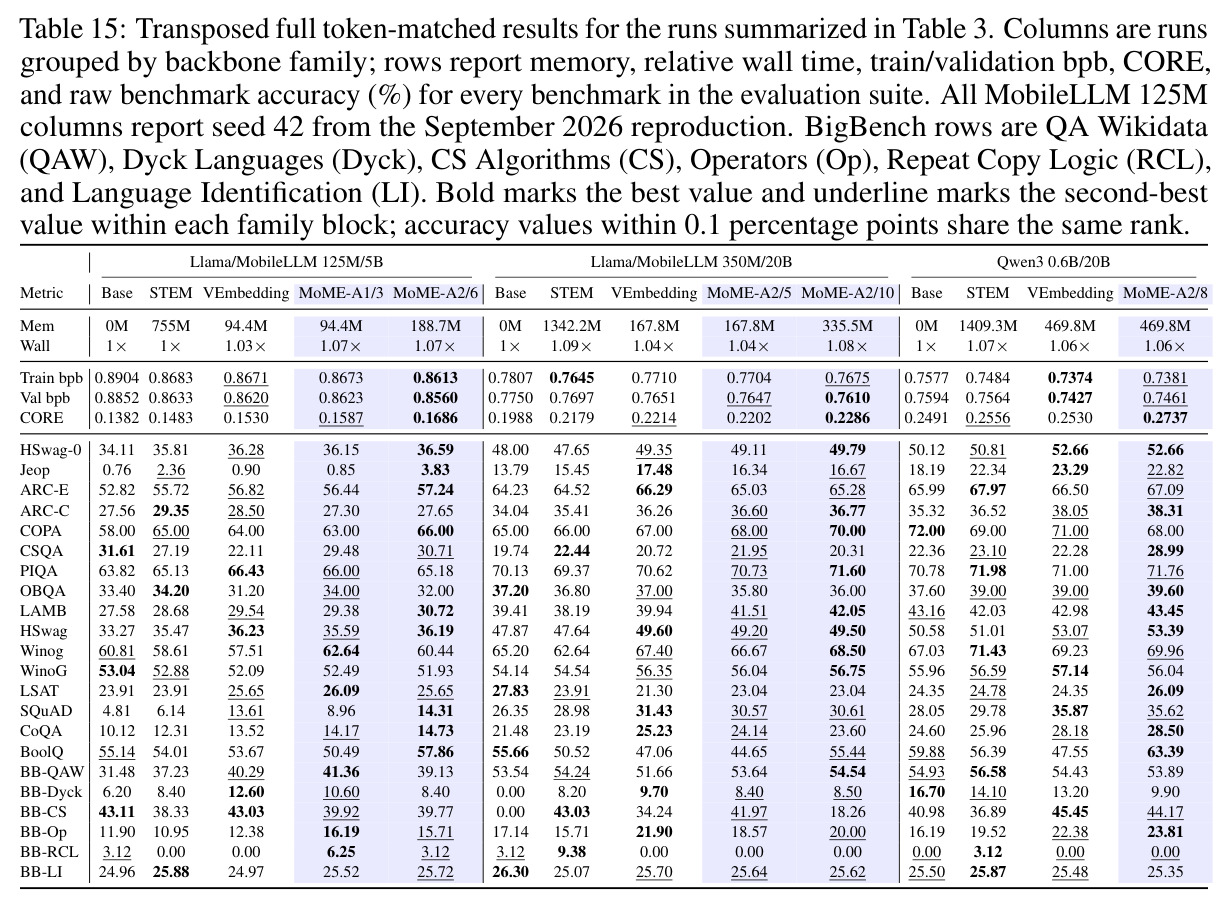
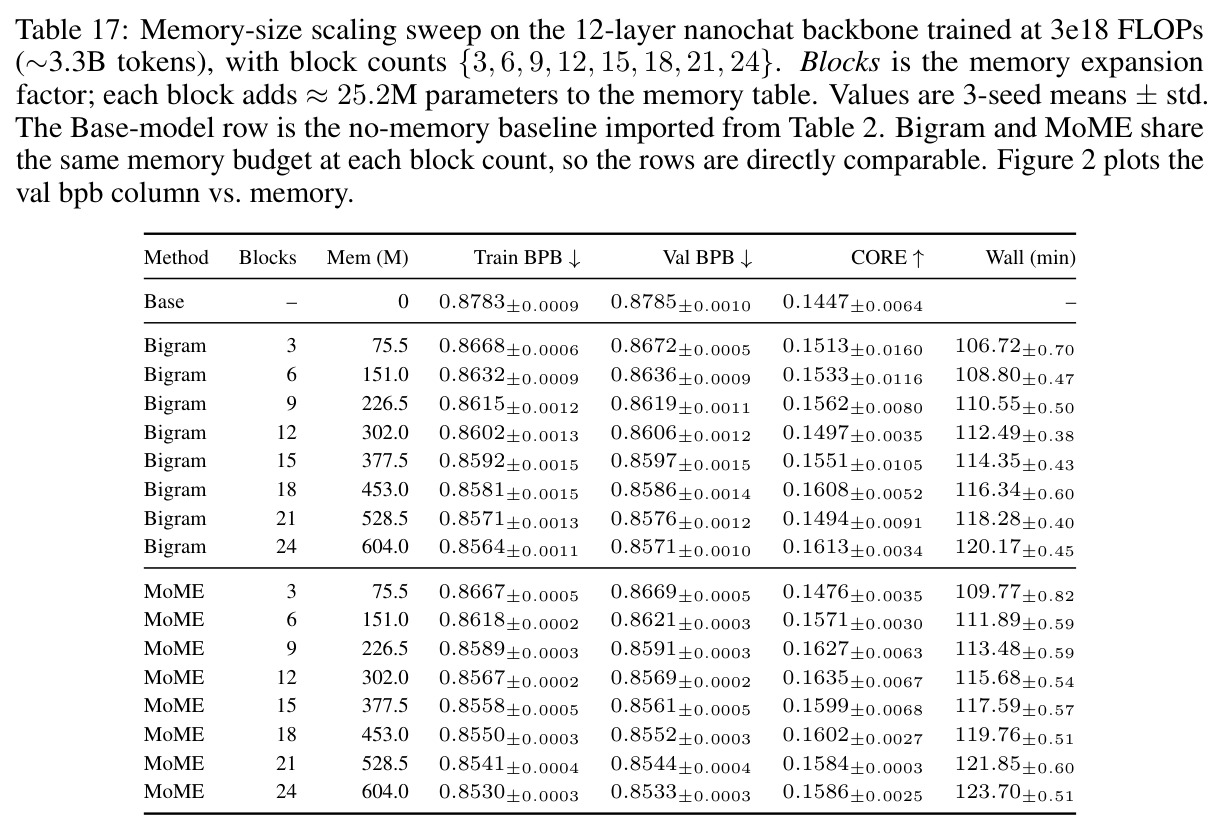
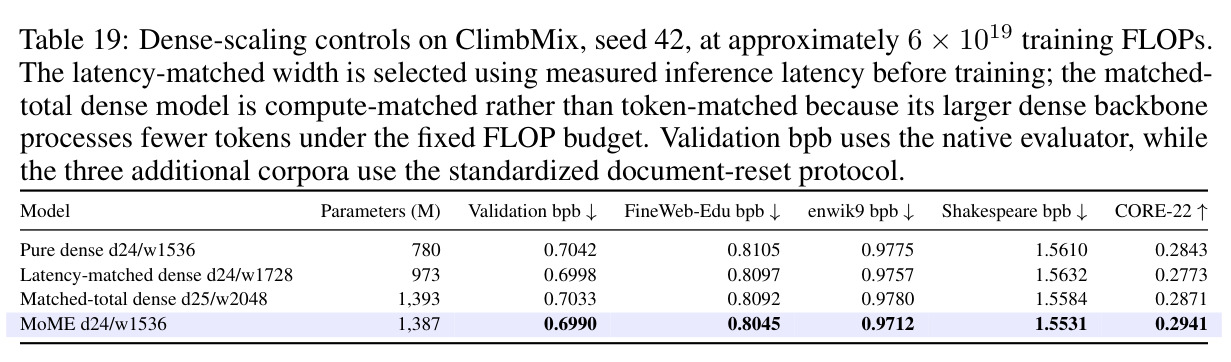
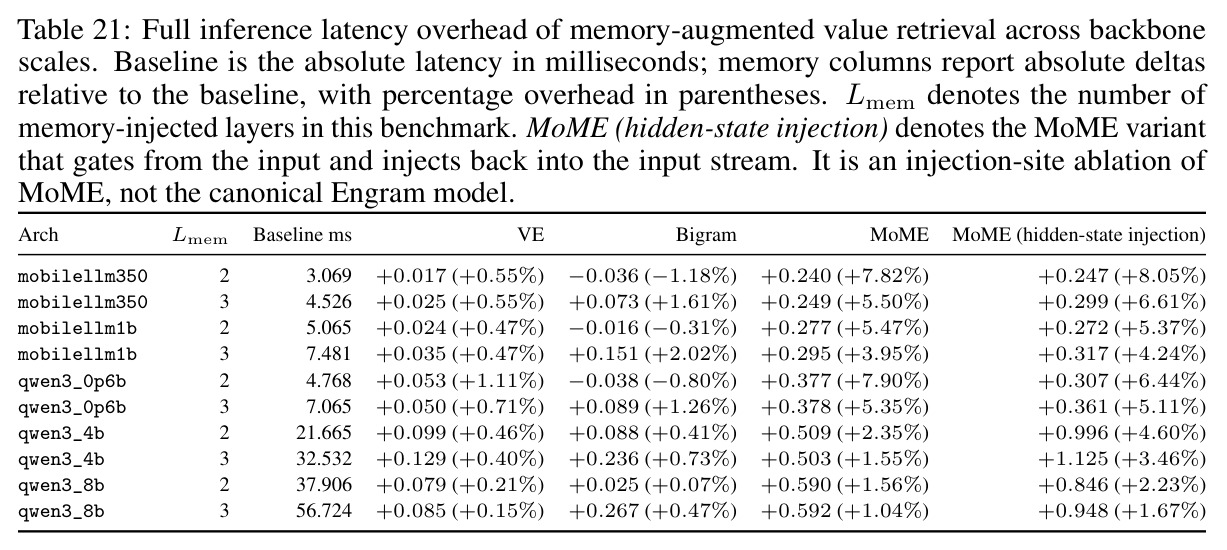
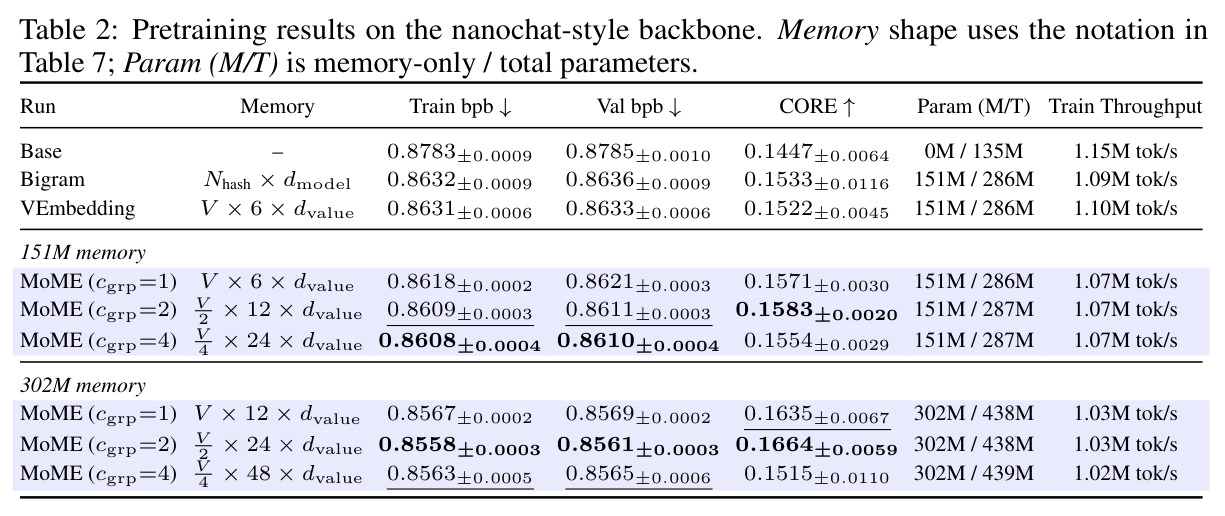
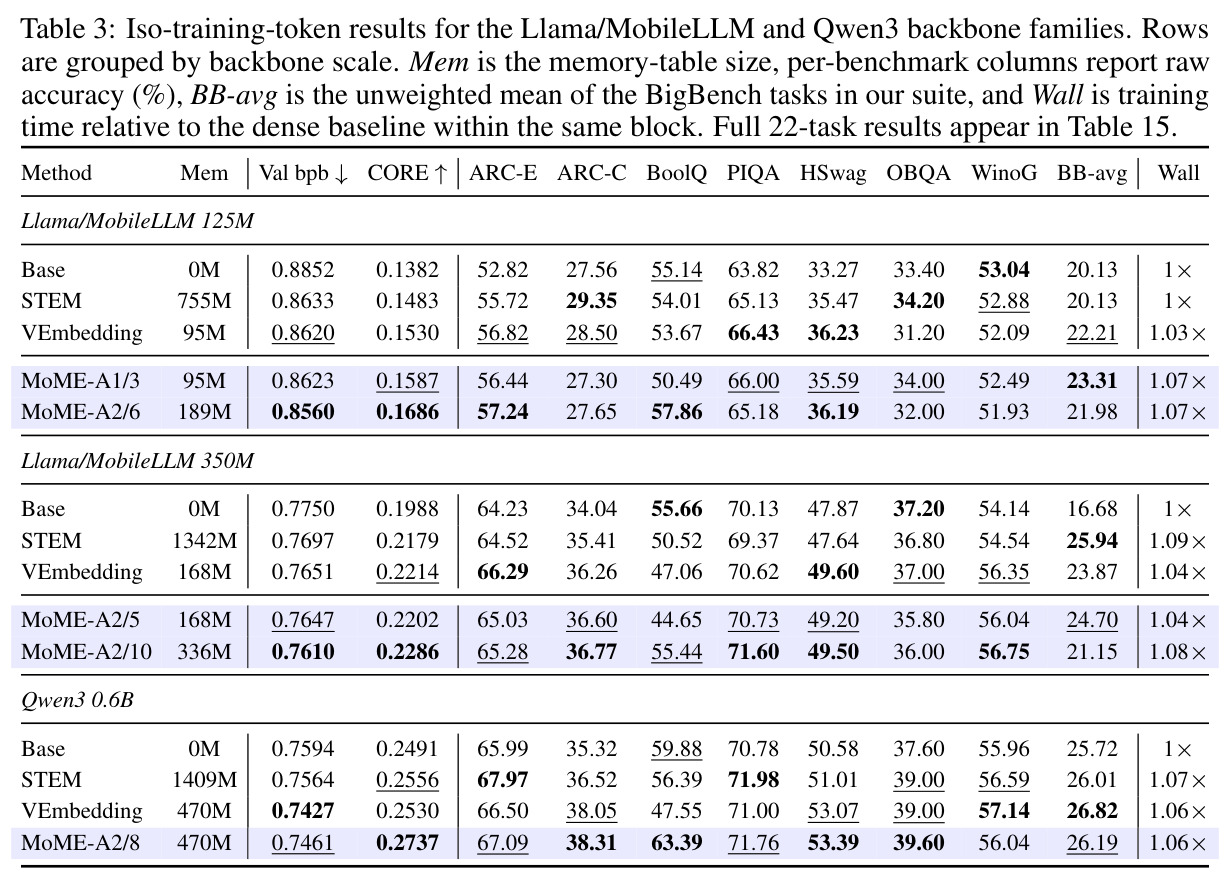
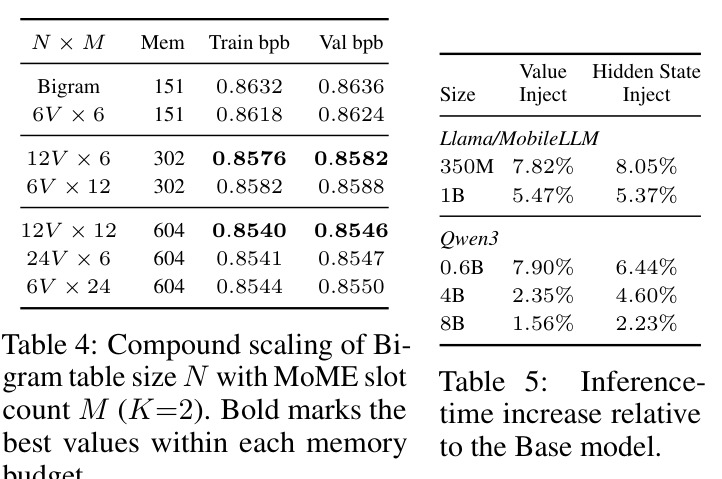
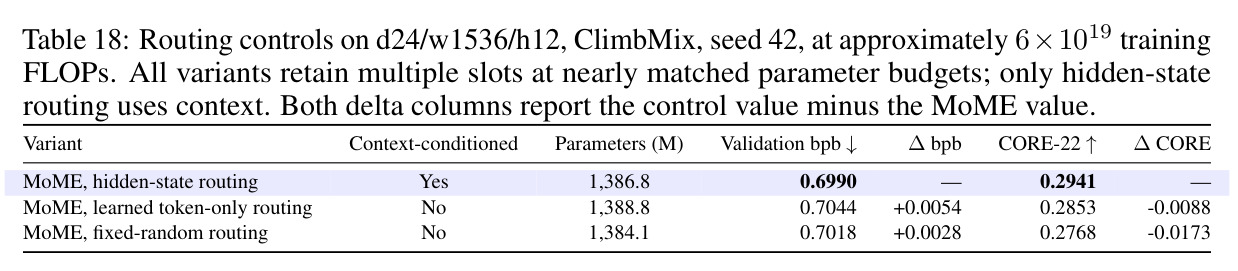
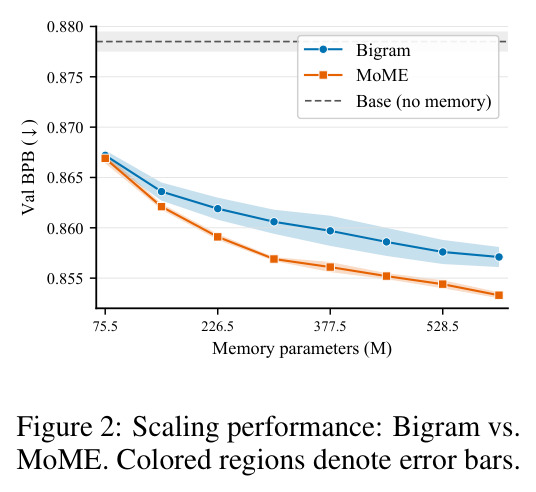
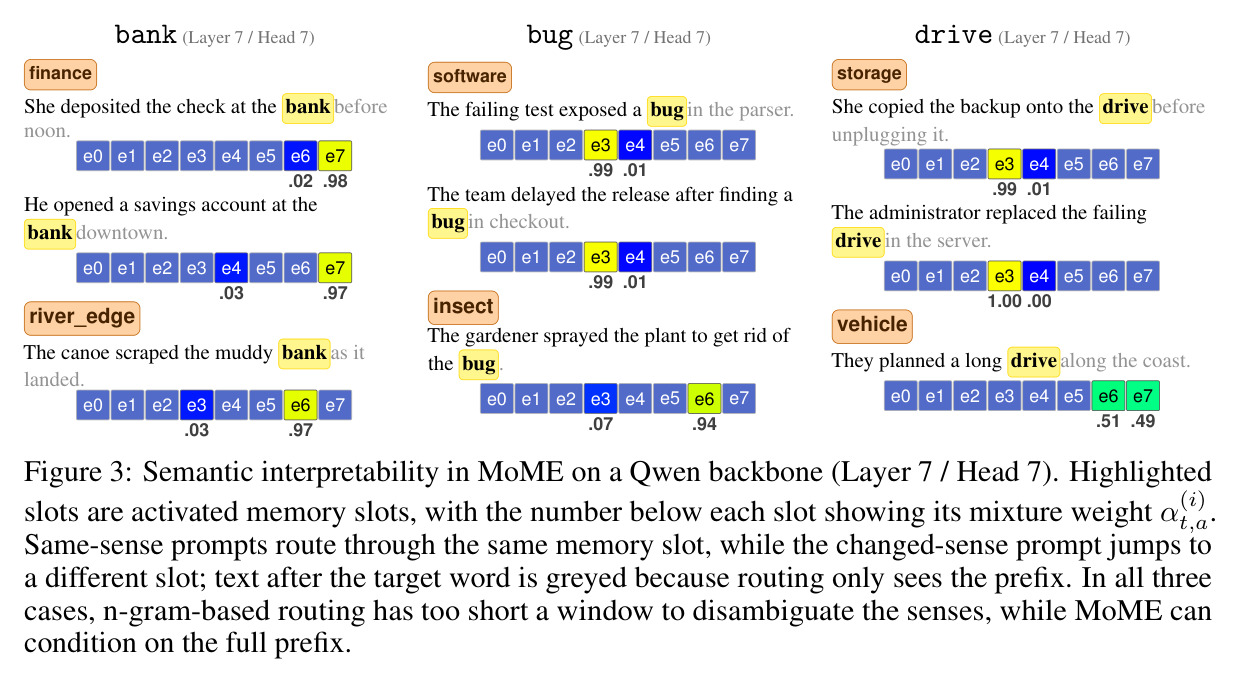
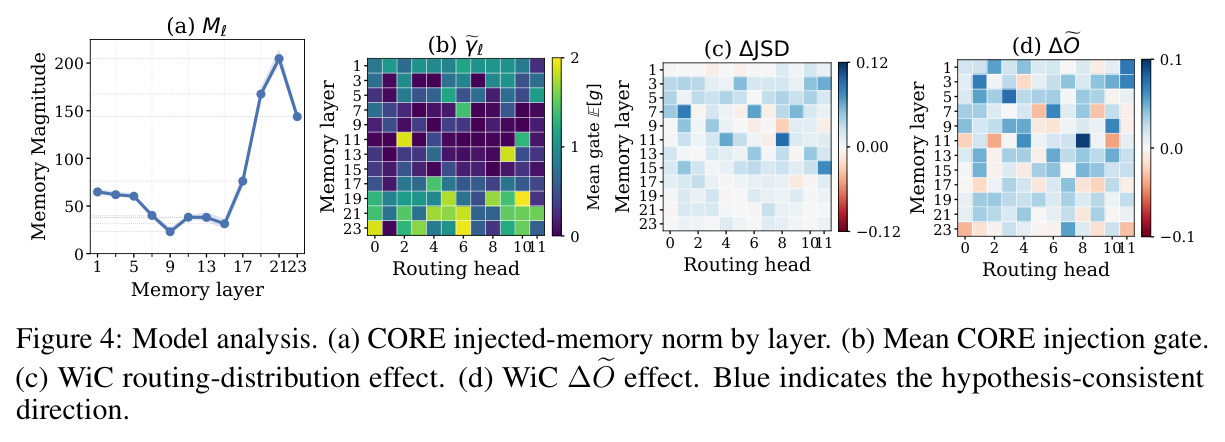
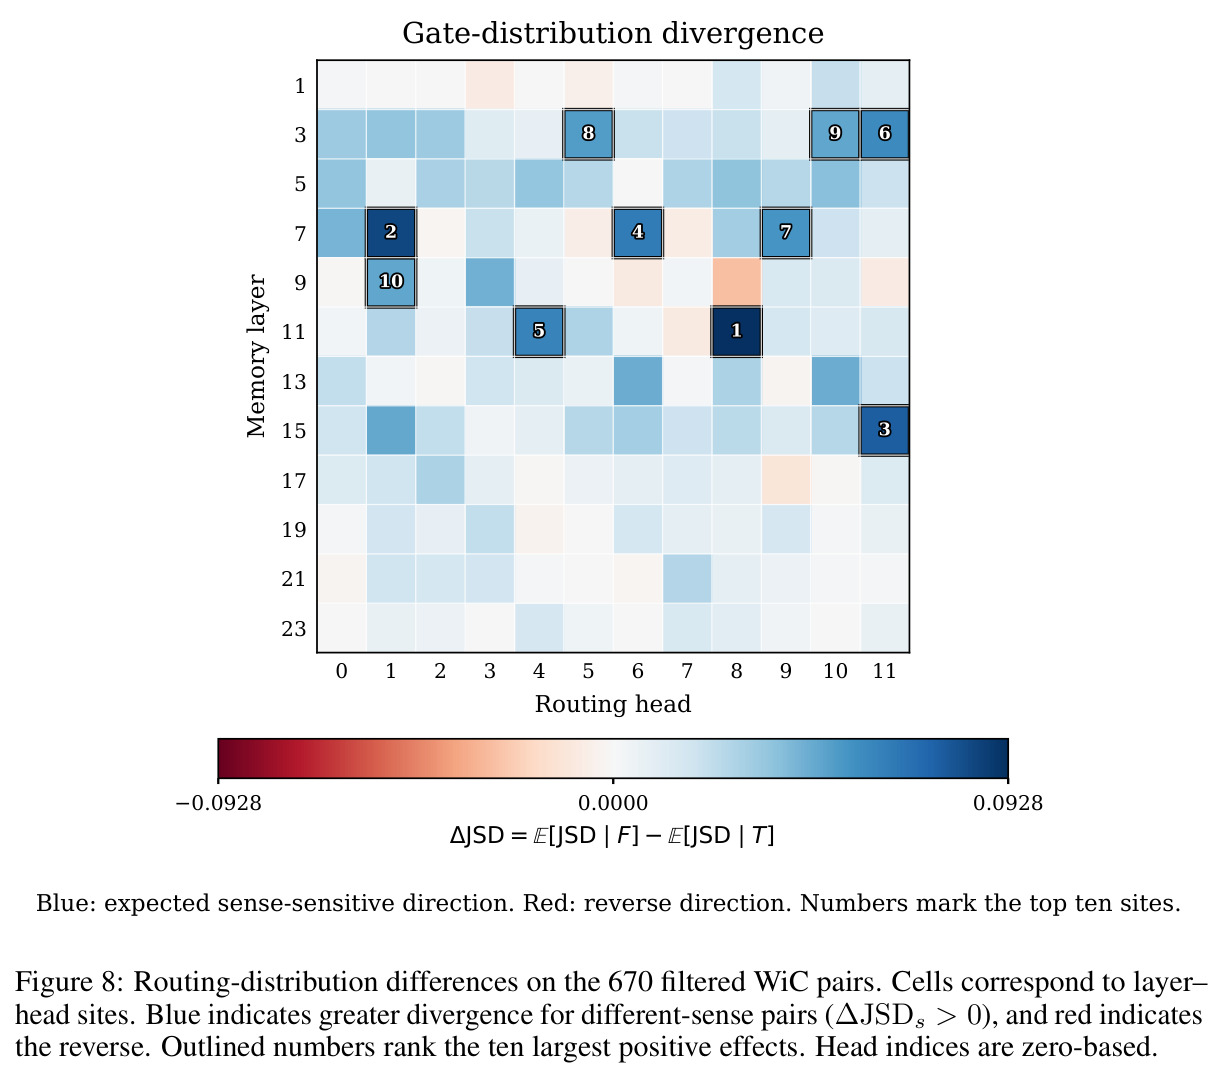
实验覆盖五个层面。(1) nanochat d12 等参数(151M 记忆、$3\times10^{18}$ FLOPs、3 种子):MoME(cgrp=2) val bpb 0.8611、CORE 0.1583,优于 Bigram 0.8636/0.1533、VE 0.8633/0.1522、Base 0.8785/0.1447;记忆翻倍到 302M 后达 0.8561/0.1664;吞吐 1.07M tok/s 与 Bigram 差距 <2%。(2) 等 token 跨家族(MobileLLM 125M/5B、350M/20B、Qwen3 0.6B/20B):MoME 的 CORE 全部最高(0.1686/0.2286/0.2737),用远少于 STEM 的记忆参数(189M vs 755M;336M vs 1342M;470M vs 1409M)同时压过其 bpb 与 CORE,墙钟为 Base 的 1.04–1.08×。(3) 记忆扩展(Figure 2/5):75.5M–604M 每档 MoME 的 val bpb 都低于等记忆 Bigram(604M:0.8533 vs 0.8571),方差更小。(4) 复合扩展(Table 4):以 Bigram hash 作一级索引,604M 预算下 12V×A2/12 达 0.8546,优于单独缩放。(5) 100B token(Table 6,d24,ClimbMix):域外三语料全最优(0.7548/0.8850/1.4789 vs Dense 0.7677/0.9037/1.4993),CORE-22 0.3687 最高(VE 0.3484),逼近 Qwen3-0.6B 的 0.3753。机制上:Table 18 消融显示隐藏态路由 0.6990/0.2941,token-only 路由 0.7044/0.2853、固定随机 0.7018/0.2768,证明增益来自上下文;Figure 3 中 bank/bug/drive 换语义即换槽位(权重差达 0.99 vs 0.01);670 对 WiC 上 117/144 个位点 $\Delta$JSD>0、110/144 个位点 $\Delta\hat O$>0,最大效应层 11/头 8($\Delta$JSD=0.0928)。延迟(Table 5/21):qwen3_4b 值流注入 +0.509ms(+2.35%),隐藏状态注入变体 +0.996ms(+4.60%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| nanochat d12 预训练(151M 记忆,3×10^18 FLOPs) | 验证 bpb | 0.8611(MoME cgrp=2) | 0.8636(Bigram)/ 0.8785(Base) | 比 Bigram 低 0.0025,比 Base 低 0.0174 |
| nanochat d12 预训练(151M 记忆) | CORE | 0.1583 | 0.1533(Bigram)/ 0.1447(Base) | +0.0050(vs Bigram) |
| MobileLLM 350M,20B token 等预算预训练 | 验证 bpb | 0.7610(MoME-A2/10,336M 记忆) | 0.7697(STEM,1342M 记忆)/ 0.7651(VEmbedding,168M) | 用约 1/4 于 STEM 的记忆参数降低 0.0087 bpb |
| MobileLLM 350M(20B token) | CORE | 0.2286 | 0.2179(STEM)/ 0.2214(VEmbedding) | +0.0107(vs STEM) |
| Qwen3 0.6B(20B token 等预算) | CORE | 0.2737(MoME-A2/8,470M 记忆) | 0.2556(STEM,1409M)/ 0.2530(VEmbedding) | +0.0181(vs STEM) |
| 100B token ClimbMix,d24 骨干,域外语料 | enwik9 bpb | 0.8850 | 0.9037(Dense)/ 0.8860(VEmbedding) | 比 Dense 低 0.0187 |
| 100B token ClimbMix,d24 骨干 | CORE-22 | 0.3687 | 0.3484(VEmbedding)/ 0.3441(Dense) | +0.0203(vs VEmbedding),逼近 Qwen3-0.6B 的 0.3753 |
| qwen3_4b 推理延迟(2 个记忆层) | 相对 Base 延迟增幅 | +2.35%(+0.509ms,值流注入) | +4.60%(+0.996ms,隐藏状态注入变体) | 延迟开销约减半 |
局限与改进
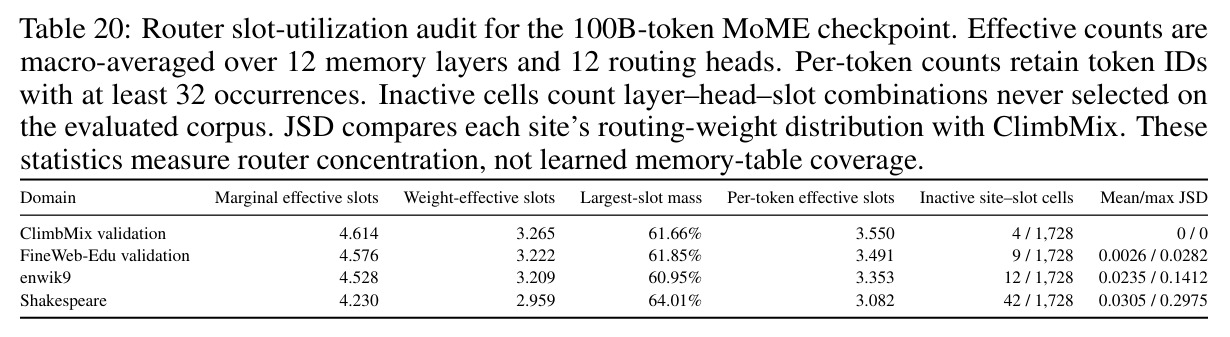
作者承认的局限是计算规模:最大扩展检查(Table 6)总参数约 1.4B 但稠密骨干仅约 0.8B、训练 100B token 且单种子;CORE 激活与 WiC 路由分析只是描述性证据,未做因果干预(交换/屏蔽槽位)证明这些行为确实改善下游精度或域移鲁棒性。我补充观察。第一,指标间有张力:等 token 实验中 Qwen3 0.6B 的 val bpb 是 VE 更低(0.7427 vs 0.7461),100B 的域内 ClimbMix 也是 VE 更低(0.6463 vs 0.6504),MoME 优势集中在 CORE 与域外语料,说明收益更多体现在下游任务与分布外泛化而非纯语言建模损失。第二,与 MoE-FFN 组合时 val bpb 反而略升(0.6913 vs 0.6903),只有 CORE 提升,吞吐还从 653k 降至 611k tok/s,组合代价未被讨论。第三,路由利用率不高:最大槽位质量约 62%、权重有效槽位数约 3.3(共 12 槽、Top-2),相当一部分记忆参数很少被用到。第四,WiC 探针有混淆:634 个名词对 vs 36 个动词对,仅 81 个目标词组同时含两种语义标签,且 144 个位点的多重比较未做 max-T 或 FDR 校正。
独立分析的弱点
独立分析的弱点与改进方向。其一,槽位利用塌缩:路由质量集中于少数槽位(最大槽位约 62%),12 槽中有效使用的仅约 3 个,约 4 倍参数买不到 4 倍容量;可借鉴 MoE 的负载均衡辅助损失、熵正则或槽位退火摊平使用分布。其二,路由视野受限:$g_\theta(h_t)$ 只看当前隐藏状态(即前缀信息),而消歧常需后文——作者在 WiC 过滤时甚至要求目标词位于句子后半段;可引入轻量双向摘要 token 或延迟路由(读到句末再回填记忆)缓解。其三,一级索引粒度仍是 token 级:只测了与 Bigram(2-gram)的组合,未探索 3-gram 或短语级索引与上下文槽位的叠加,而实体/搭配级记忆可能价值最大。其四,训练墙钟 1.04–1.08× 的开销来自路由分支的额外 kernel(投影、top-K、聚合),小批量多层场景更明显;可将路由投影与 value 投影融合为单个 GEMM 或用查表式实现。其五,评测以 bpb/CORE 为主,缺少对记忆机制真正敏感的场景(长上下文检索、代码库级任务、多语言低频词)的专门验证,“记忆注入先验”这一解释缺乏直接证据。
未来方向
作者提出的方向有二:一是设计更好的复合扩展策略,把高效 token 路由与记忆混合槽位联合缩放(Table 4 已给出初步证据,最优配置是同时放大 Bigram 表与槽数至 12V×A2/12);二是利用学到的语义路由作为模型行为引导的把手——若能控制一个词读取哪个槽位,就相当于获得轻量的知识编辑/steering 通道。在此基础上可延伸:其一,槽位的结构化初始化与约束,例如用词义库(WordNet 同义词集)或字典学习先验初始化槽位,让“一槽一义”显式成立并提升可解释性;其二,参数记忆与非参数检索(RAG)的分工研究——MoME 缓存高频静态模式、外部检索负责长尾事实,两者的适用边界值得刻画;其三,因果干预实验(槽位屏蔽、交换、反事实替换)验证“路由—语义—输出”的因果链,这正是作者自认的缺口;其四,引入记忆表的生命周期管理(更新、遗忘、持续学习),使条件记忆成为在线知识注入的载体;其五,扩展到 10B 级以上骨干与多模态输入,检验上下文感知查找在大规模下是否仍保持 2% 左右的延迟优势。
复现评估
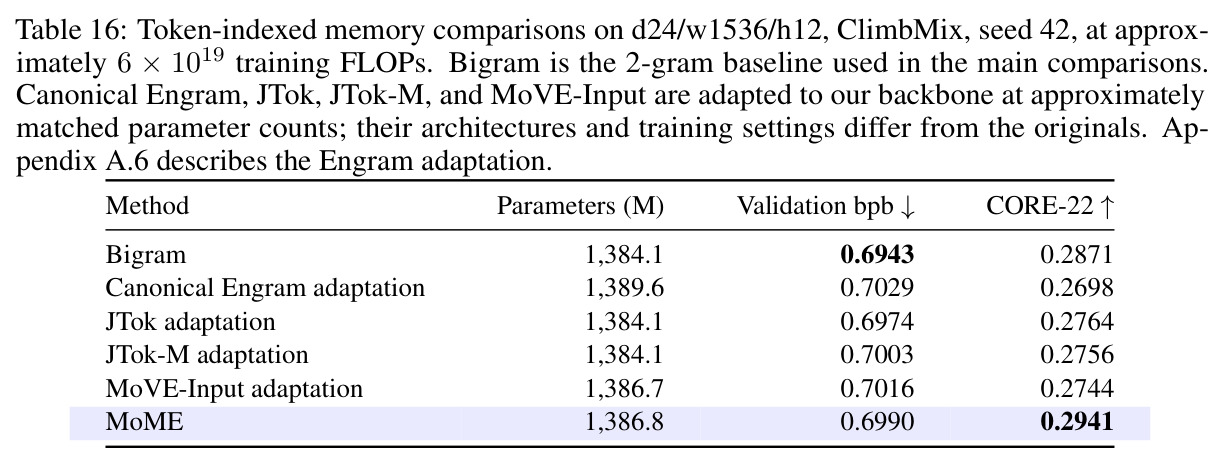
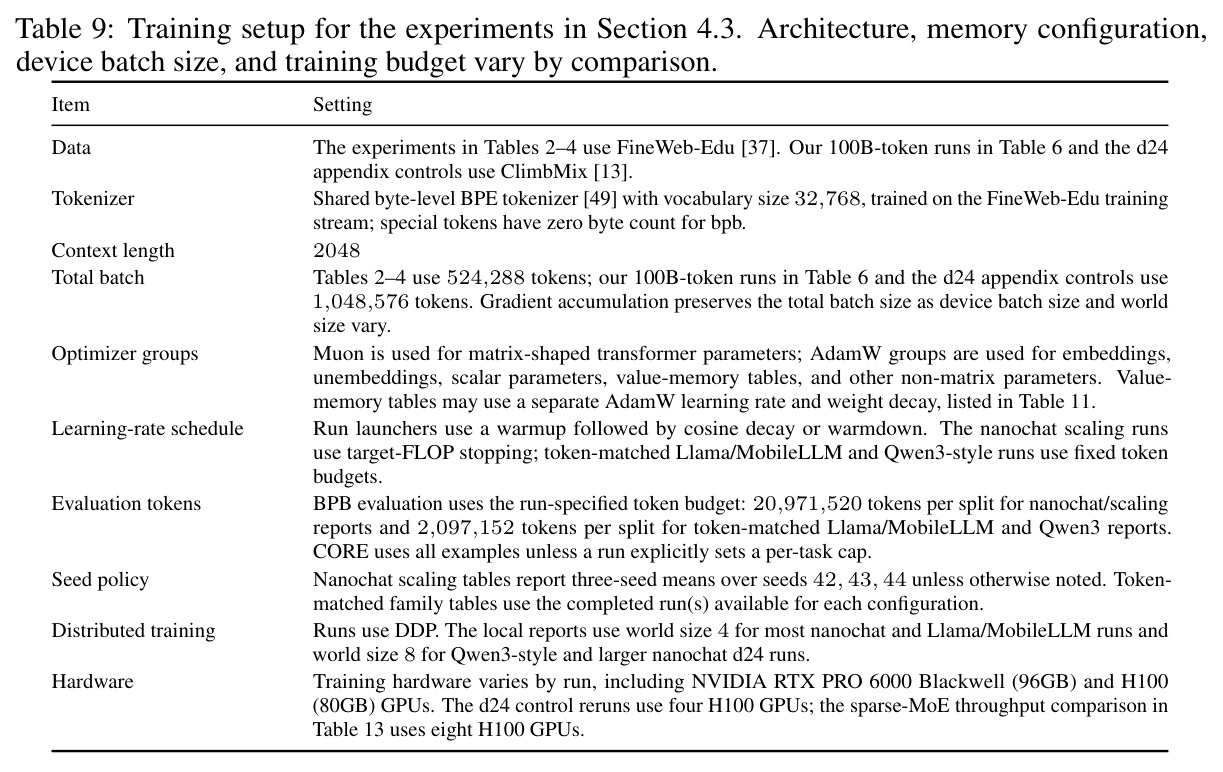
论文声明代码与预训练模型已开源。复现材料完备:附录给出全部训练配置(Table 9–11:FineWeb-Edu/ClimbMix 数据、32k BPE、2048 上下文、524k/1M token 批、Muon+AdamW 分组、记忆表 lr 0.1–0.2/wd 0.001、各家族记忆层位置与 A-K/M 配置)、22 任务 CORE 协议与 bpb 计算细节。算力方面:nanochat d12 主实验约 $3\times10^{18}$ FLOPs(3.3B token、3 种子),Llama/MobileLLM 与 Qwen3 系列为 5–20B token,原实验用 4–8 张 H100 或 RTX PRO 6000(96GB);最大项是 100B token 的 d24 运行(8×H100 量级、估计数周)。总体评估:小规模复现(d12 等参数对比、MobileLLM 125M)单机 4 卡数天可行、难度中低;大规模结论(Table 6 的 100B、Table 13 的 MoE 组合)门槛高且单种子,独立验证成本大。注意细节:种子策略(42/43/44 三种子均值)、kNN 分组依赖约 1B token 的轻量预训练嵌入、Bigram 基线是 modded-nanogpt 实现而非原始 Engram。
论文图表