面向可扩展预训练与持续学习的嵌套稀疏性 Nested Sparsity for Scalable Pretraining and Continual Learning
把条件计算从MLP扩展到注意力,NESTOR以嵌套稀疏超越MoE,算力效率提升1.13–1.29倍
前置知识
混合专家(Mixture of Experts, MoE)
MoE 把 transformer 每层的 MLP 替换为 $E$ 个专家 MLP,一个可学习路由器为每个 token 计算打分 $r(x_j)\in\mathbb{R}^E$,用 TopK 选出 $K_e\ll E$ 个专家,输出按所选打分的 softmax 门控权重加权求和。总参数量随 $E$ 增长,而每个 token 的计算只随 $K_e$ 增长,实现“大参数量、低计算量”的条件计算,是 DeepSeek、Llama 等现代大模型的主流选择。
NESTOR 的 column 路由与嵌套专家完全沿用 MoE 的 TopK+门控形式,只是施加对象从 MLP 换成注意力;理解 MoE 是看懂本文机制对称性($C=1$ 时严格退化为 MoE)的前提。
条件计算(Conditional Computation)
条件计算指每个输入只使用模型总权重的一个输入相关“激活”子集做前向计算,使总参数量的增长远快于单 token 的激活参数与 FLOPs。自 Bengio (2013)、Shazeer (2017) 以来它一直是降低大模型训练与推理成本的核心思路,MoE 是其在现代 LLM 中最成功的实现。
论文的核心命题是:条件计算不必局限于 MLP 权重,还可以施加到注意力算子上并与 MoE 分层组合,这需要对条件计算本身的收益逻辑有基本认识。
缩放定律(Scaling Laws)
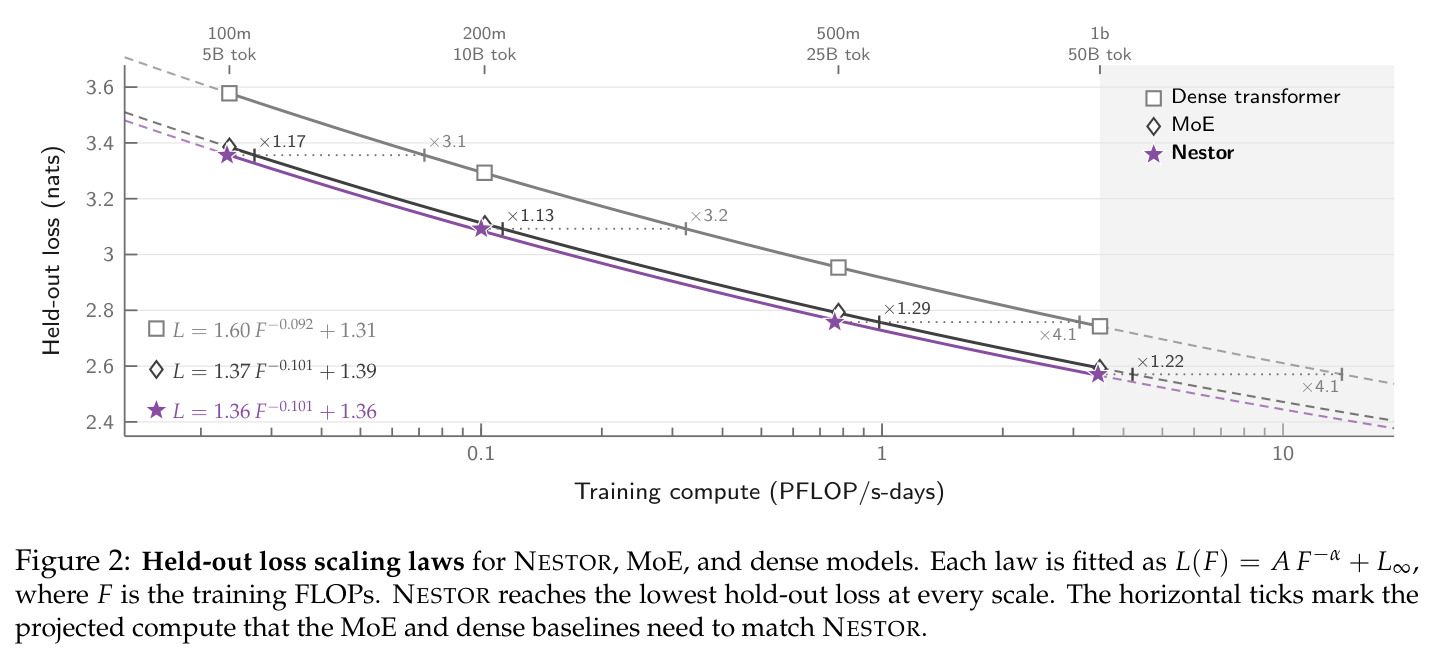
缩放定律用幂律 $L(F)=AF^{-\alpha}+L_\infty$ 拟合 held-out 损失随训练算力 $F$ 的下降。比较不同架构时,在各自拟合曲线上对目标损失作水平线,交点给出基线追平该损失所需的算力,其比值即架构的计算效率倍数,是 Kaplan/Hoffmann 以来衡量架构的标准方法。
论文用四规模缩放定律实验证明 NESTOR 比 MoE 计算“高效 1.13–1.29 倍”且该倍数不随规模缩小,所有结论都以这套方法论为骨架。
持续预训练与灾难性遗忘
持续预训练指在预训练模型基础上继续在长文档(长上下文扩展)或新领域(书籍、代码、数学、外语)上训练。神经网络学新分布后在旧分布上性能退化即灾难性遗忘,LLM 也不例外;常见缓解手段是回放旧数据,但回放会占用训练预算、牺牲新域适配增益。
论文的第二大贡献是 NESTOR 在领域适配中“学得一样多、忘得更少”,并把上下文从 4k 扩展到 64k 时更省算力;不熟悉遗忘问题就无法理解这些实验的设计动机。
稀疏注意力(Sparse Attention)
稀疏注意力通过限制每个 query 能 attend 的 token 集合来降低长上下文的注意力成本,实现方式包括滑窗(Longformer)、哈希/聚类(Reformer、Routing Transformer)、按 query 的 top-K 块选择(NSA、DeepSeek 稀疏注意力)等。所有 token 仍共享同一套注意力参数,目的只是低成本逼近全注意力。
NESTOR 与这些方法的本质区别在于它同时稀疏化注意力参数与注意力图,且模式由学习路由产生而非预设;理解旧范式才能看懂这一差异。
研究动机
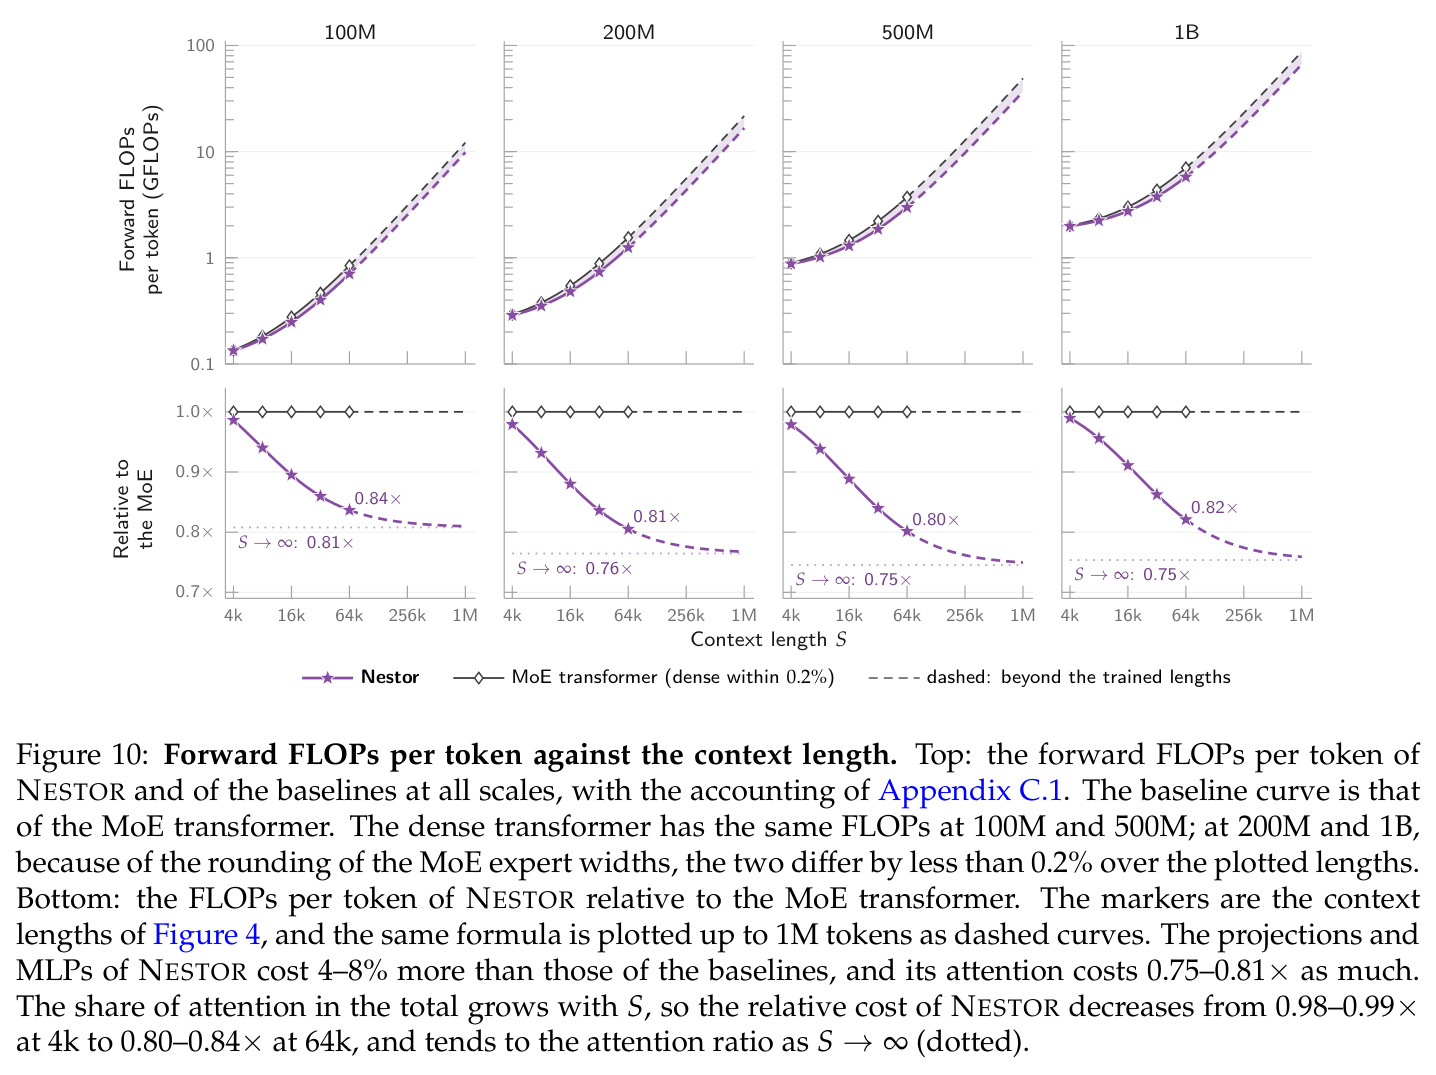
现代大语言模型的条件计算几乎完全由混合专家(MoE)实现:每层把 MLP 换成 $E$ 个专家 MLP,路由器只为每个 token 激活 $K_e$ 个,参数量随 $E$ 增长而单 token 算力只随 $K_e$ 增长。但这种稀疏性被局限在 MLP 权重内——每个 token 在每一层都使用同一套注意力参数。注意力算子占据每 token 激活参数的相当比例,在长上下文时更是计算开销的大头:从 4k 扩展到 64k 上下文时注意力 FLOPs 会远超线性层。另一方面,预训练模型常需持续训练以适配新领域(书籍、数学、代码、德语)和更长上下文,而这会引发灾难性遗忘:模型在新分布上变强的同时旧分布性能退化。能否设计一种把条件计算同样施加到注意力上、并与 MoE 稀疏性自然嵌套的机制,同时改善预训练效率与持续学习能力,是本文要解决的核心问题。
本文的目标是论文的目标是设计一种新的条件计算机制:仿照 MoE 对 MLP 的推广方式去推广注意力算子,并让两种稀疏性分层嵌套,得到一个统一泛化 MoE transformer 与稠密 transformer 的架构 NESTOR。具体目标有三:其一,在语言模型预训练中验证 NESTOR 在同等算力与同等稀疏度下优于常规 MoE transformer,并通过 100M–1B 激活参数四规模的缩放定律研究确认优势不随规模缩小;其二,验证 NESTOR 更适合持续预训练——既能像 MoE 一样高效适配四个新领域且遗忘更少,又能更高效地把上下文从 4k 扩展到 64k;其三,在具有分层潜在结构的统计模型上给出理论分析,解释嵌套为何带来计算效率与抗遗忘能力。
与已有工作不同的是,已有工作的切入角度各有局限:稀疏注意力(滑窗、哈希聚类、top-K 检索如 NSA)只稀疏化注意力图,所有 token 共享同一套注意力参数,目的是低成本逼近全注意力;注意力头混合(MoH)只稀疏化参数,每个 token 仍 attend 全部上下文;Piekos 等 (2025) 虽同时稀疏化两者,但由注意力头在每层独立选 token,与 MLP 路由互不相关。NESTOR 的独特切入是:一次路由决策(每块一次、由 token 发起)同时决定 token 使用哪些注意力参数、attend 哪些 token、以及使用哪些专家,使注意力参数稀疏、注意力图稀疏、专家稀疏三种稀疏性分层嵌套,且在形式上与 MoE 完全对称——用同样的 TopK+门控公式泛化注意力,正如 MoE 泛化 MLP。
核心方法
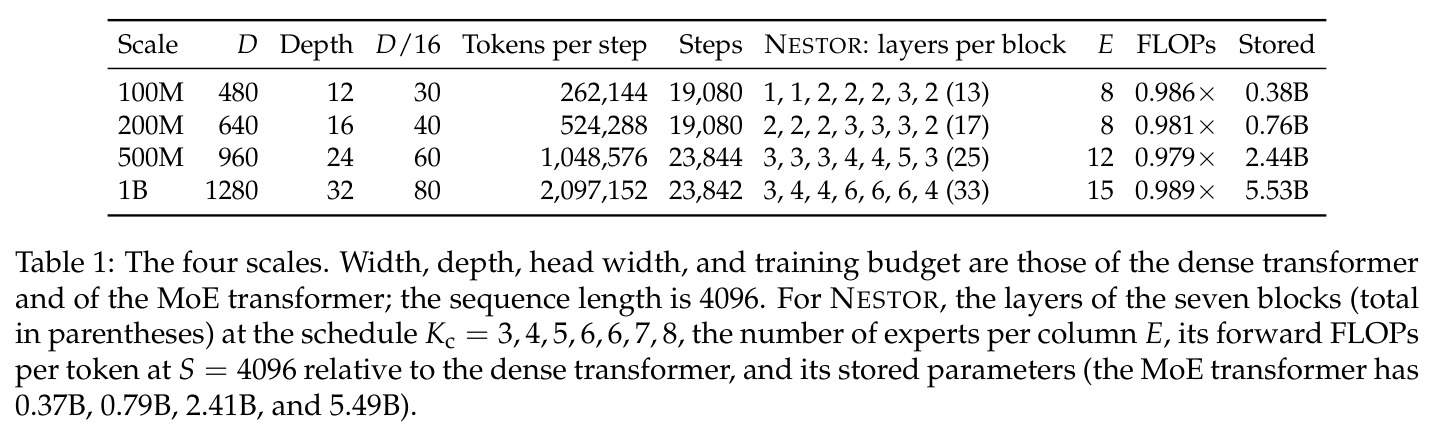
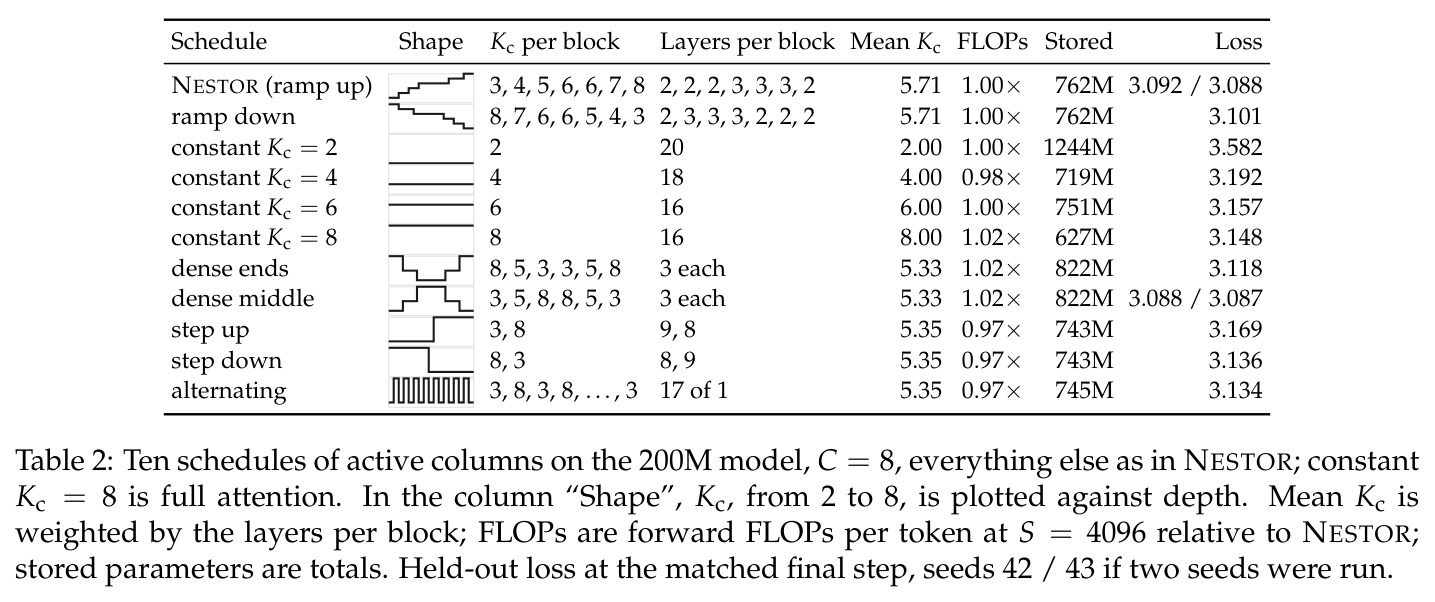
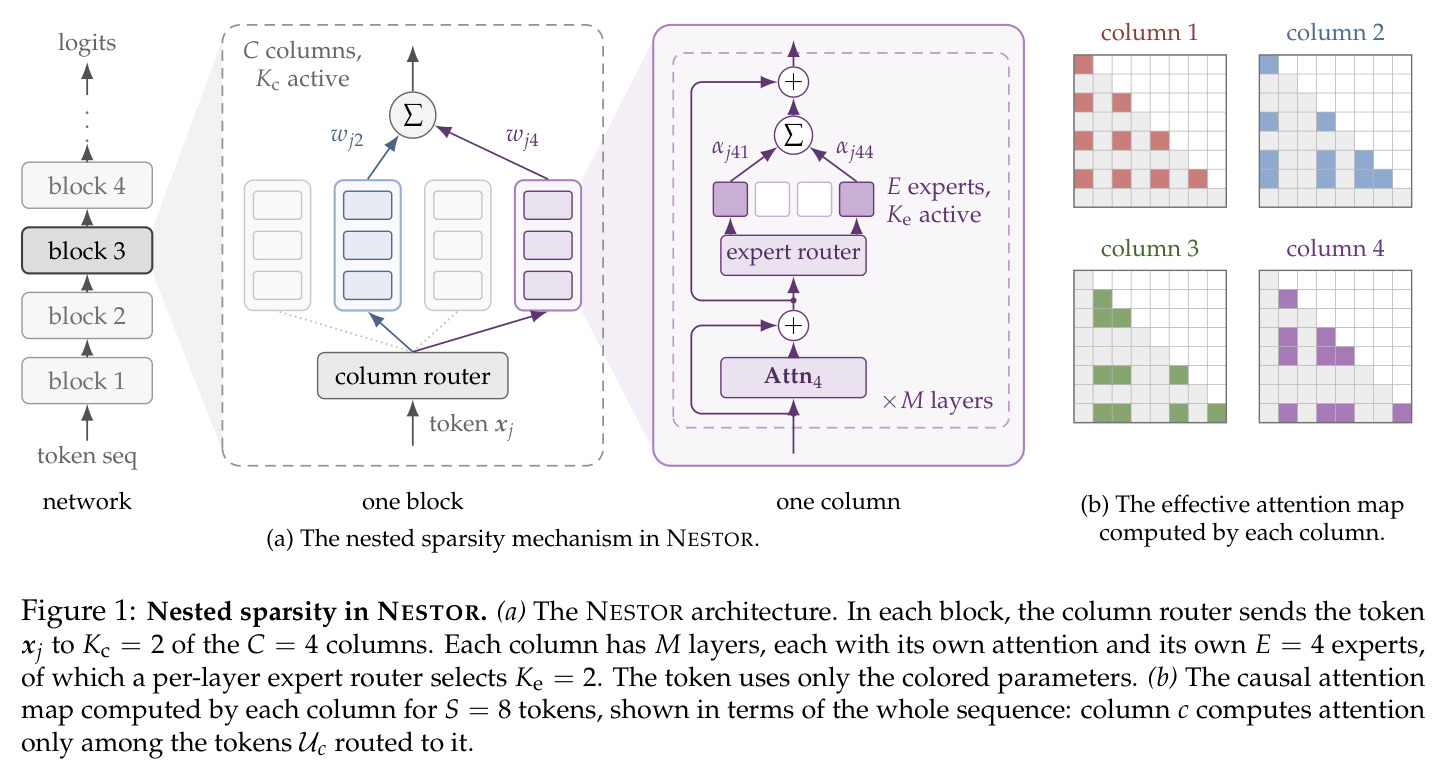
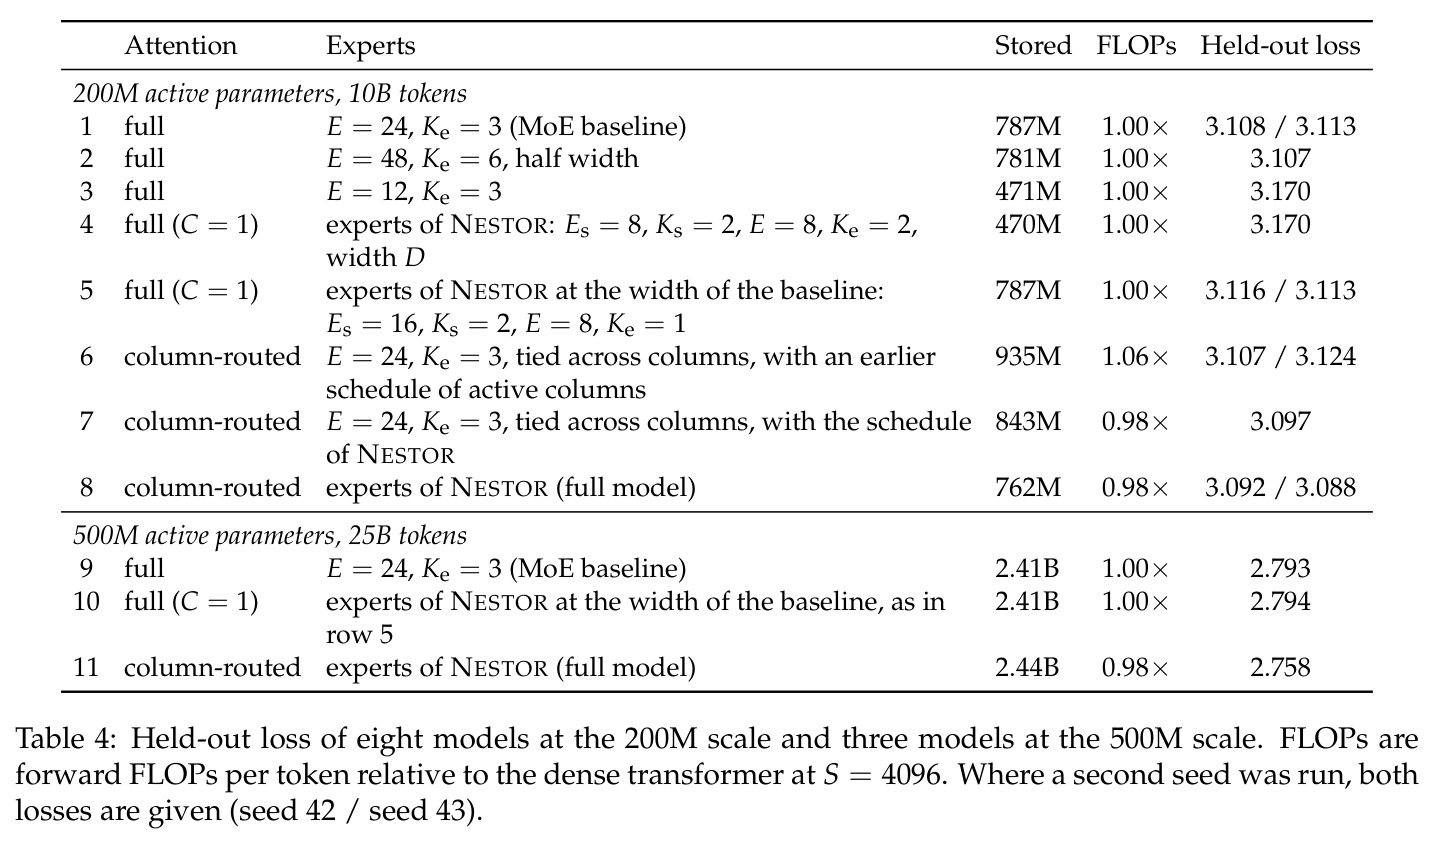
直觉上,不同 token 需要不同的“阅读方式”:代码 token 关心作用域内的声明,数学 token 关心生效的假设,普通叙述只需局部上下文。与其让所有 token 共享一套注意力参数并扫描全序列,不如让每组 token 走进自己的“功能柱”(column),在柱内用自己的注意力读自己的子序列、用自己的专家加工信息。技术上,NESTOR 把网络按每 $M$ 层分组为块,每块入口的 column router 为每个 token 打分 $s(x_j)\in\mathbb{R}^C$ 并选 TopK 的 $K_c$ 个 column;每个 column 是深度为 $M$ 的小型 MoE transformer,拥有独立的 $M$ 套注意力参数、$E$ 个专家及其专家路由器。实验设 $C=8$、$K_c$ 随深度从 3 增至末块的 8(全注意力)、$E=24$、$K_e=3$,辅以少量跨 column 共享专家和 attention residual。设 $C=1$ 严格退化为 MoE,再设 $E=1$ 退化为稠密 transformer,故 NESTOR 是二者的元架构。
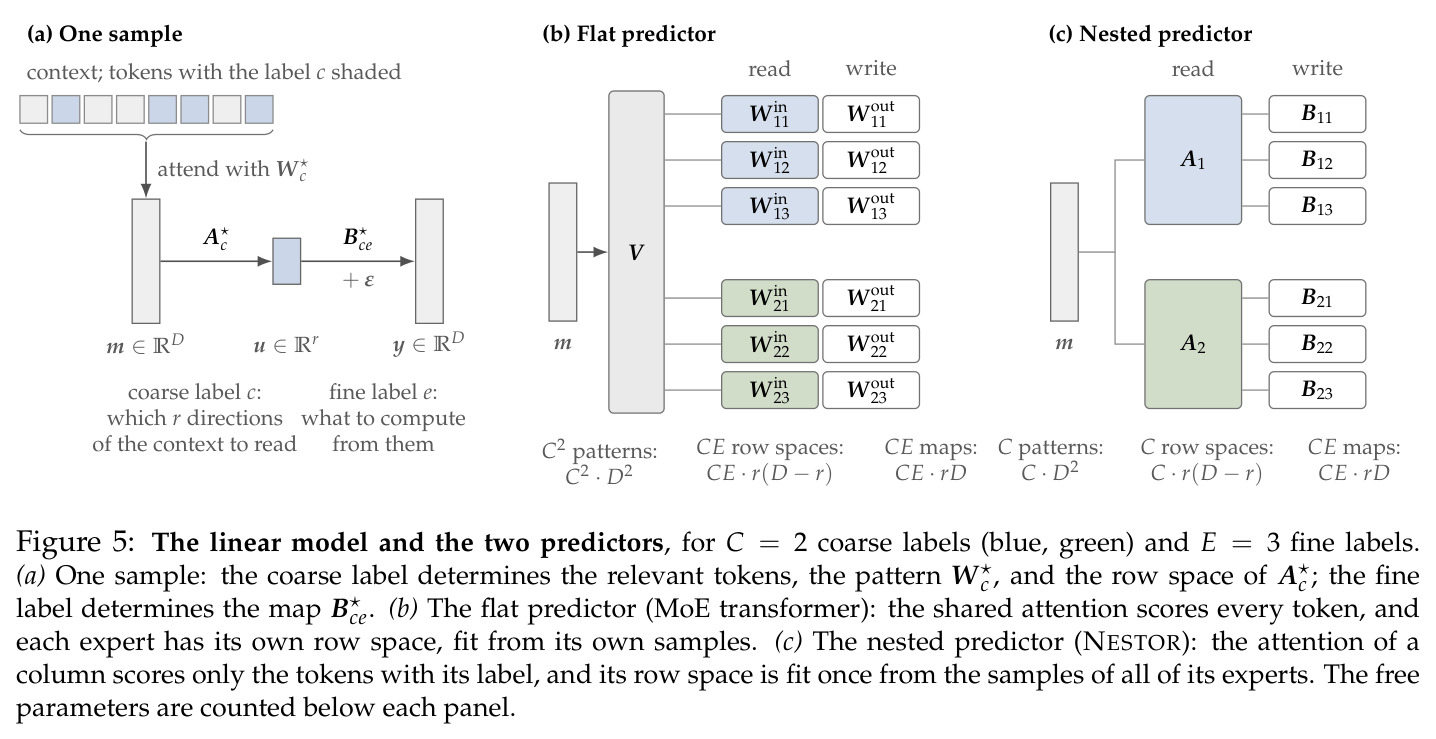
核心是两个公式。列路由注意力:$a_j = x_j + \sum_{c\in C_j} w_{jc}\,\mathrm{Attn}_c(x_j, (x_i)_{i\in U_c,\, i\le j})$,其中 $C_j=\mathrm{TopK}(s(x_j),K_c)$,$U_c$ 是路由到 column $c$ 的 token 集合;嵌套专家层:$x_j^+ = a_j + \sum_{c\in C_j} w_{jc}\sum_{e\in E_{jc}} \alpha_{jce}\,\mathrm{MLP}_{c,e}(a_j)$,专家以二元组 $(c,e)$ 索引。与 MoE 的本质区别:一次 column 路由同时决定注意力参数稀疏(只用 $K_c/C$ 的注意力)与注意力图稀疏(只在 $U_c$ 内 attend,约 $1/C$ 的上下文),而不像稀疏注意力或 MoH 只稀疏化其中一维。理论刻画了嵌套的参数节约:在 $C$ 个粗类、$E$ 个细类的线性模型中,flat 预测器需 $C^2$ 个 pattern 块与 $CE$ 个行空间,nested 预测器只需各 $C$ 个,有效自由度 $d_N\approx C(D^2+ErD)$ 对 $d_F\approx C(CD^2+2ErD)$,比值 $d_F/d_N\in[2,C]$。数据直觉是语料具有分层潜在结构:粗粒度潜变量 $c$ 决定读哪些 token、如何加权,细粒度潜变量 $e$ 决定如何使用读到的统计量。
方法步骤详情
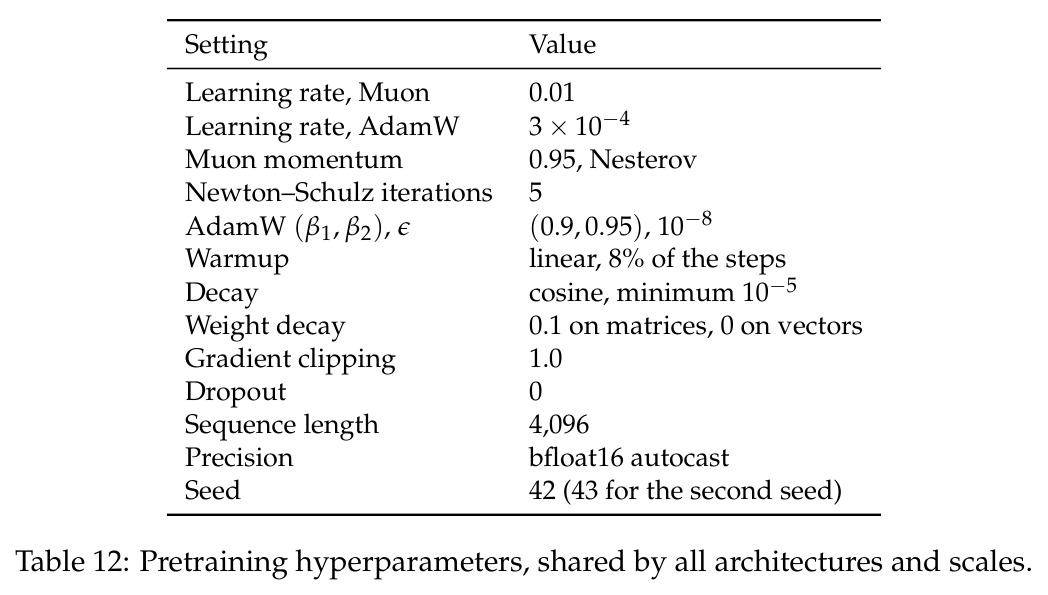
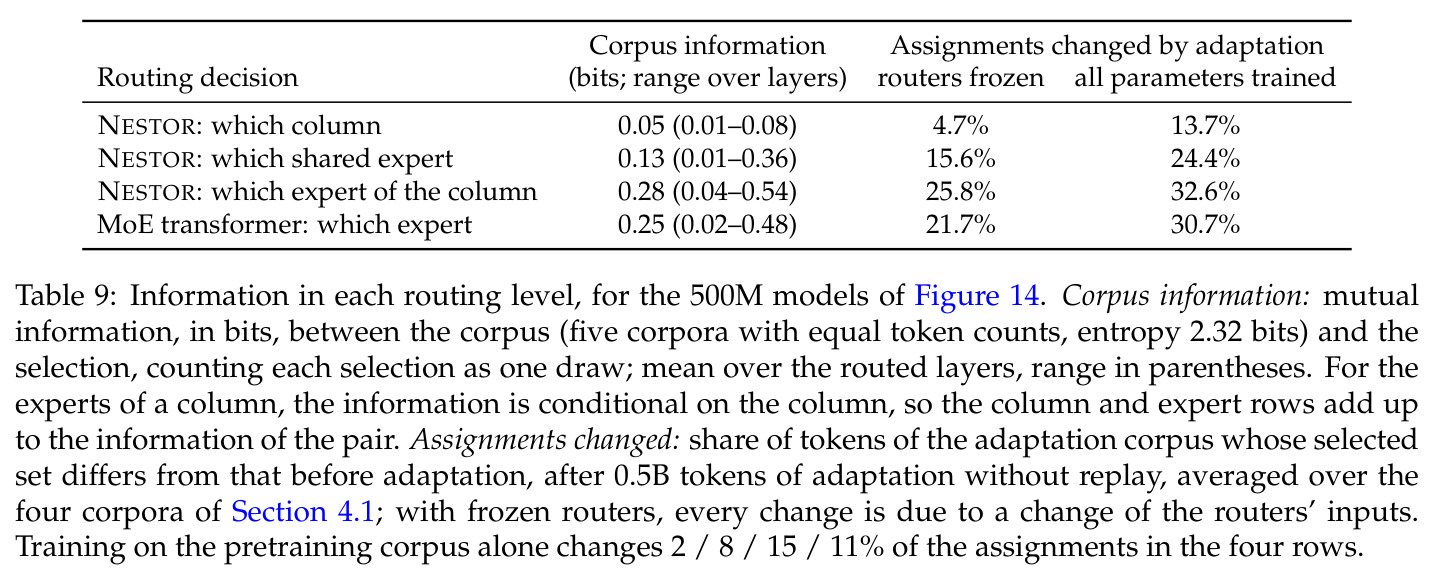
前向流程分六步。第一步,token 序列 $x_1,\dots,x_S$ 进入某块的 $M$ 层。第二步,column router 为每 token 输出打分 $s(x_j)\in\mathbb{R}^C$,TopK 选出 $K_c$ 个 column 得 $C_j$,门控权重 $w_{jc}$ 为所选打分的 softmax;路由不带辅助损失,用免反传更新的 bias 保持负载均衡(Wang et al. 2024; DeepSeek-AI 2024)。第三步,每个激活 column $c$ 用自己的多头注意力 $\mathrm{Attn}_c$ 只在 $U_c$ 内做因果注意力,输出按 $w_{jc}$ 加权求和得 $a_j$。第四步,column 内专家路由器 $r_c$ 从 $E=24$ 个专家选 $K_e=3$ 个,输出按 $\alpha_{jce}$ 加权求和。第五步,残差合并:每个激活 column 维护自己的残差流,用 attention residual 把 token embedding、先前块输出与当前块各流均值做学习 softmax 加权混合。第六步,稀疏调度:$K_c$ 从首块 3 增至末块 8,另加少量跨 column 权重共享的专家。预训练在 DCLM-baseline、上下文 4096、每激活参数 50 token 下进行,四个规模训练 5B/10B/25B/50B token。
技术新颖性
与最近工作的对比凸显其新颖性:相对稀疏注意力方法,NESTOR 稀疏化的不只是注意力图还有参数,且模式由学习路由产生而非预设;相对注意力头混合(Zhang 2022; Csordas 2024),NESTOR 同时稀疏化上下文;相对 Piekos 等 (2025) 的“头选 token”机制,NESTOR 的选择由 token 发起、每块一次,且所选模块包含 $M$ 层的全部注意力与专家,因而稀疏是“嵌套”的而非逐层独立。理论上 Table 4 的消融表明两种嵌套成分缺一不可:$C=1$ 时两类预测器重合;若各 column 共享专家矩阵 $W_e$,则 $W_eA_c$ 的列空间对所有 $c$ 相同,无法表达 $B^\star_{ce}$ 列空间随 $c$ 变化的目标。此外,任意稀疏注意力模式或任意序列到序列骨干网络都可放进 column 内部,使 NESTOR 成为可组合并行深度网络的元架构;作者还给出与大脑皮层功能柱的类比——块对应由低级到高级的脑区,column 对应皮层柱。
实验结果
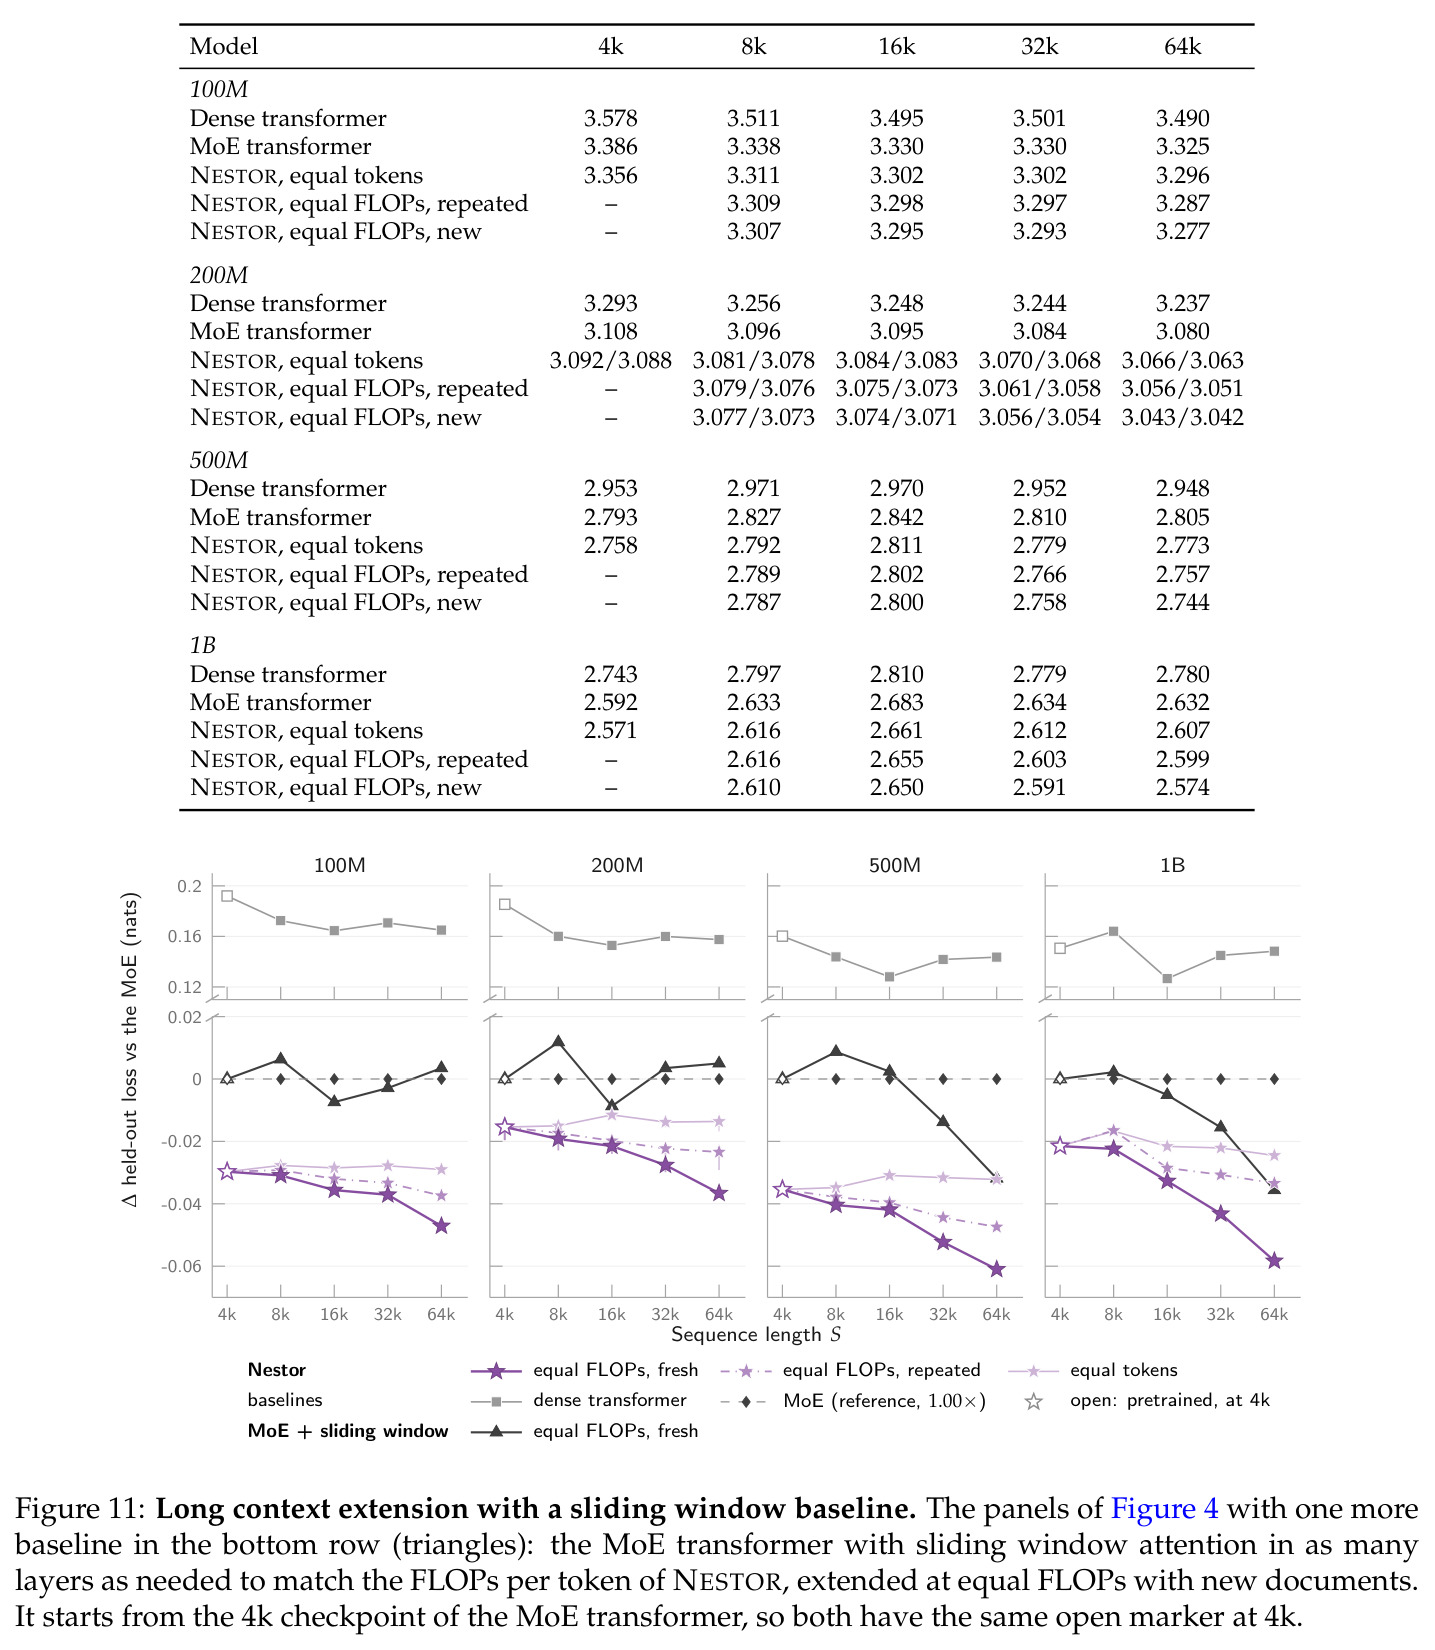
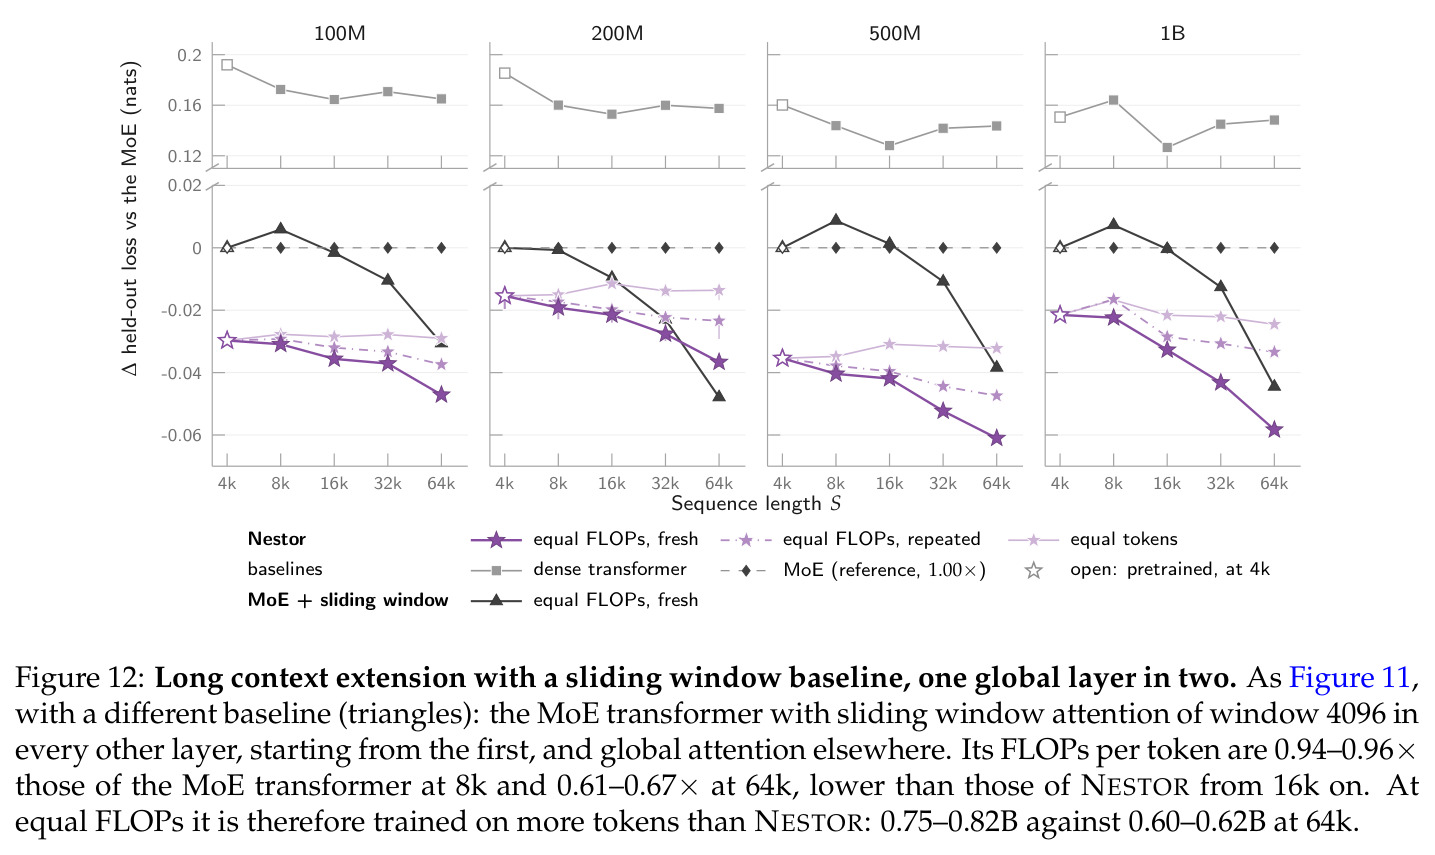
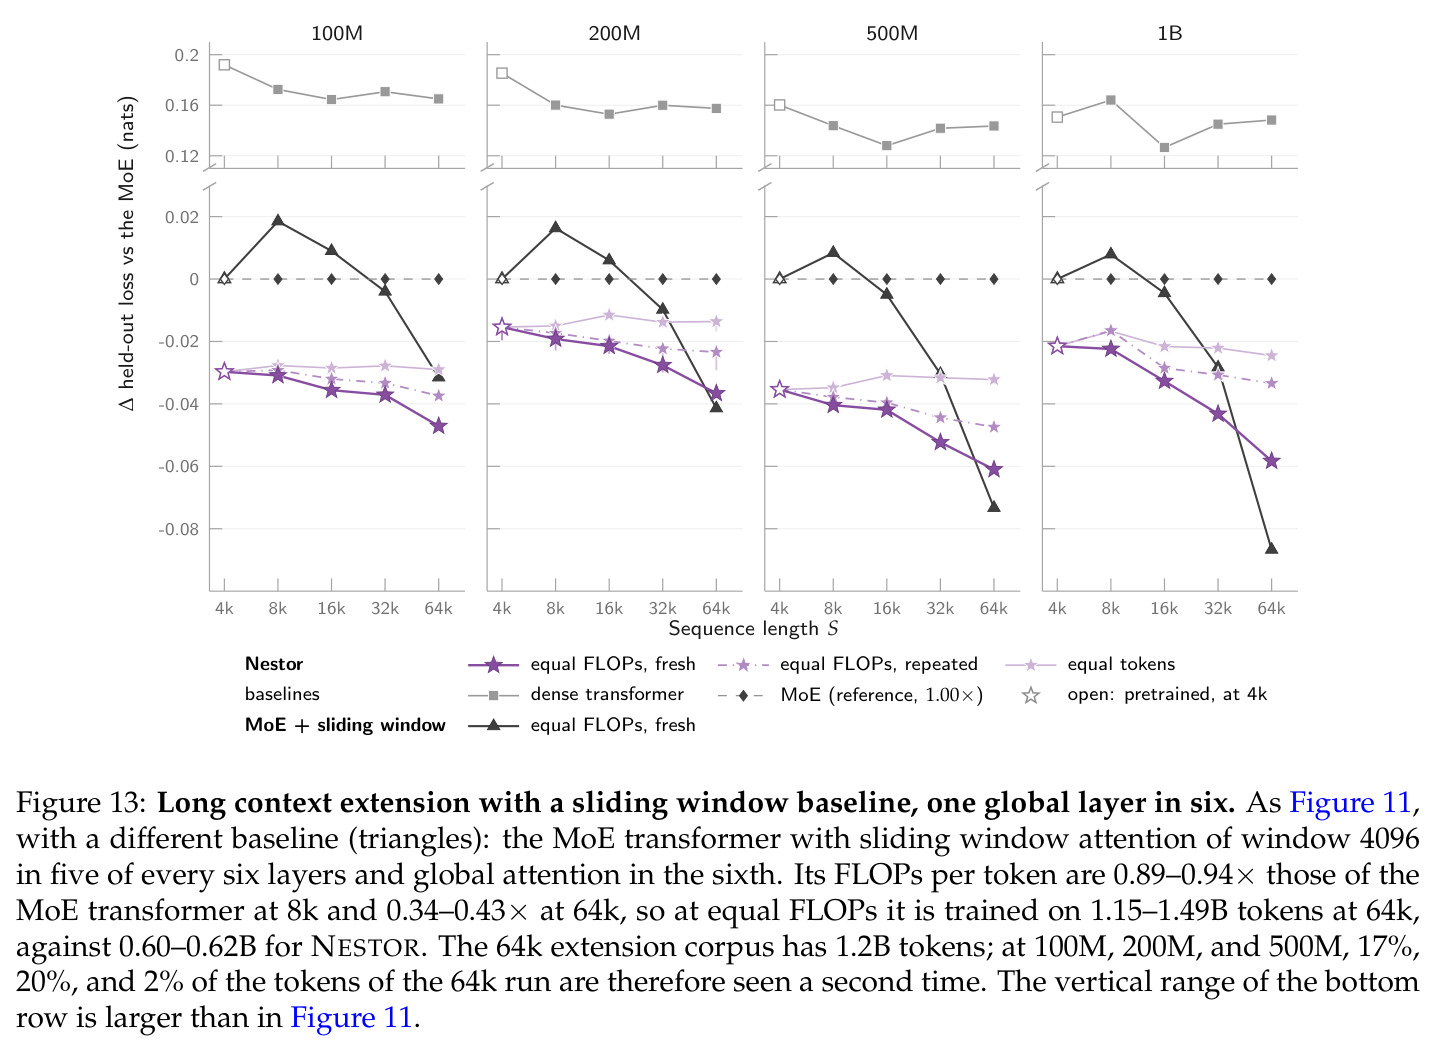
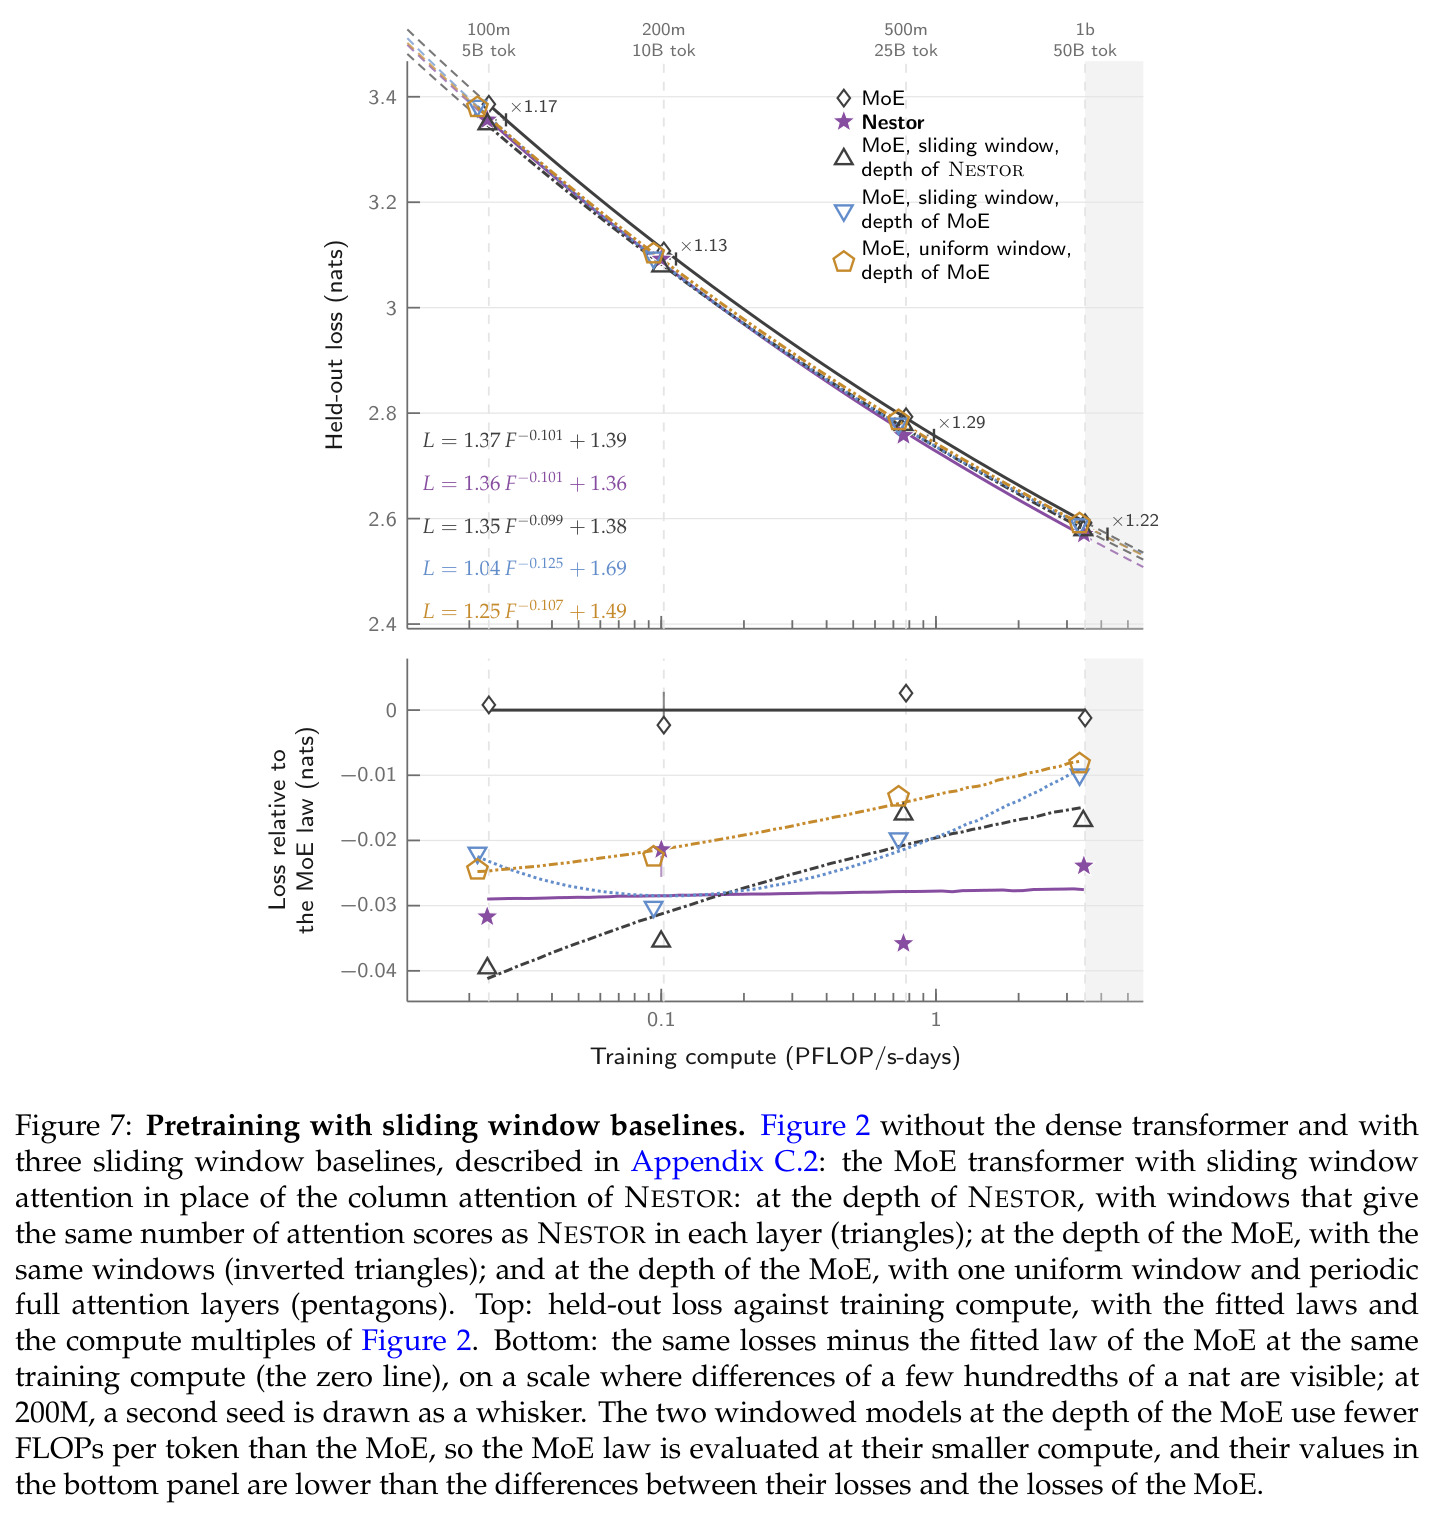
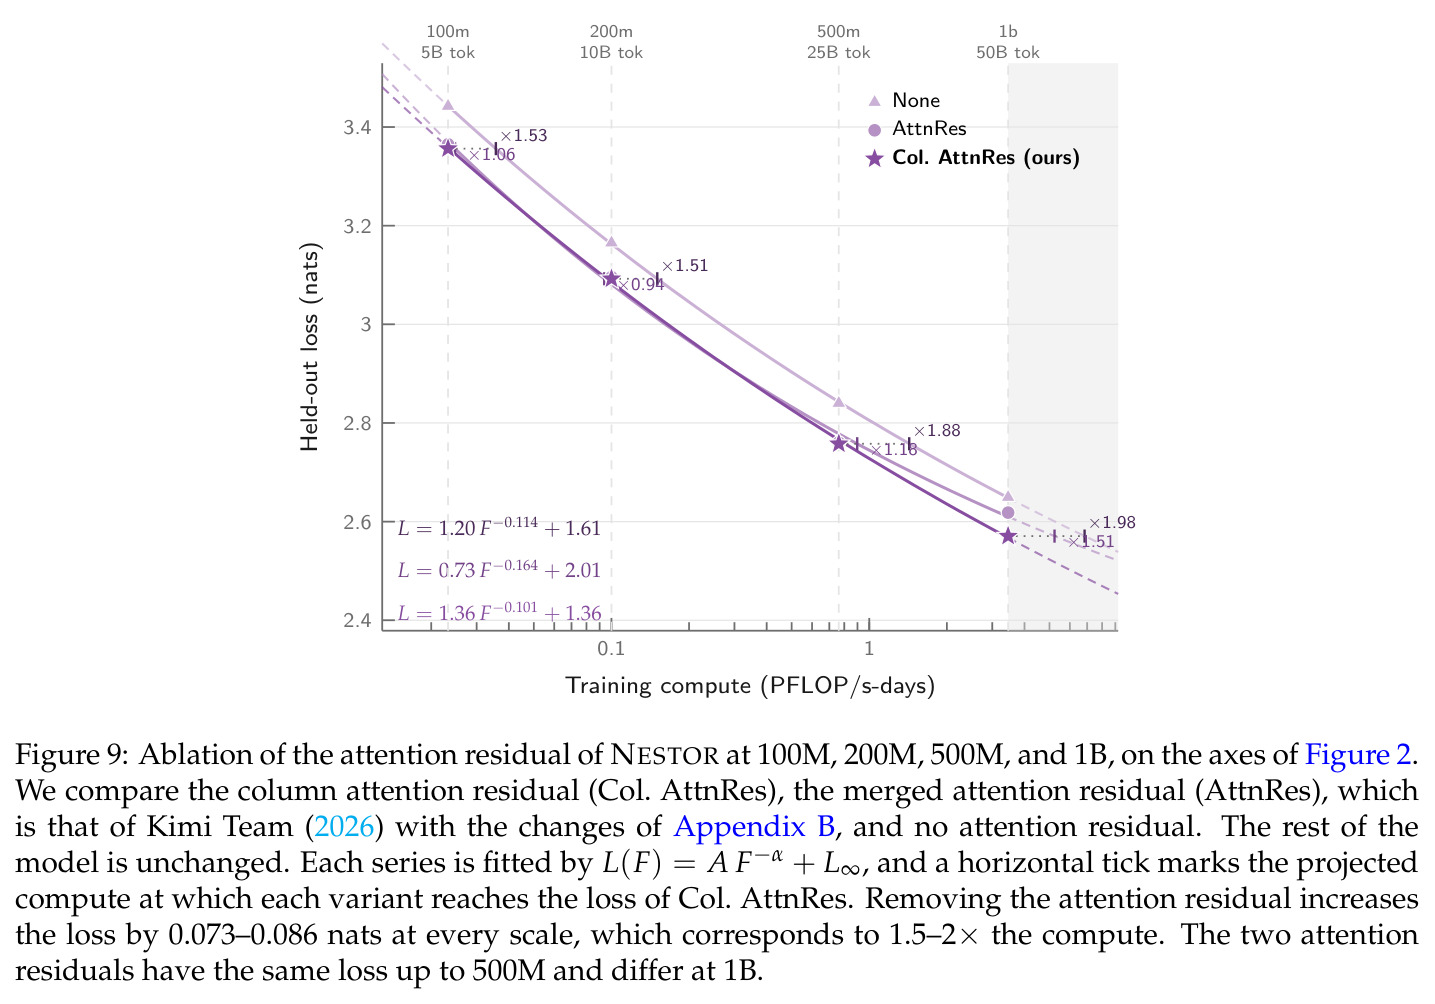
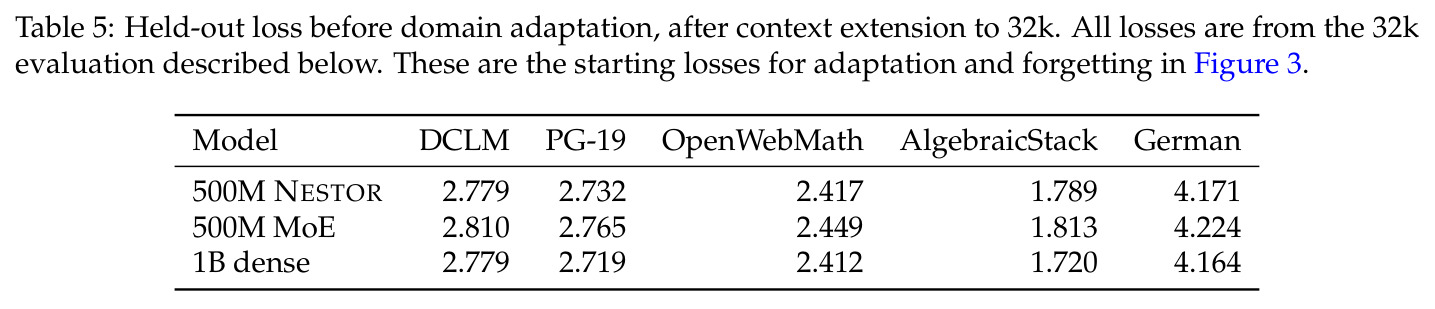
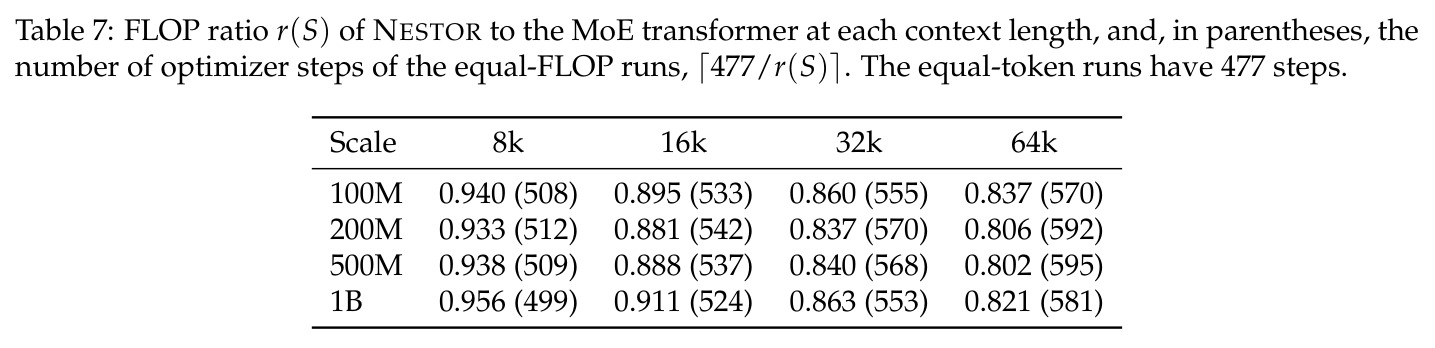
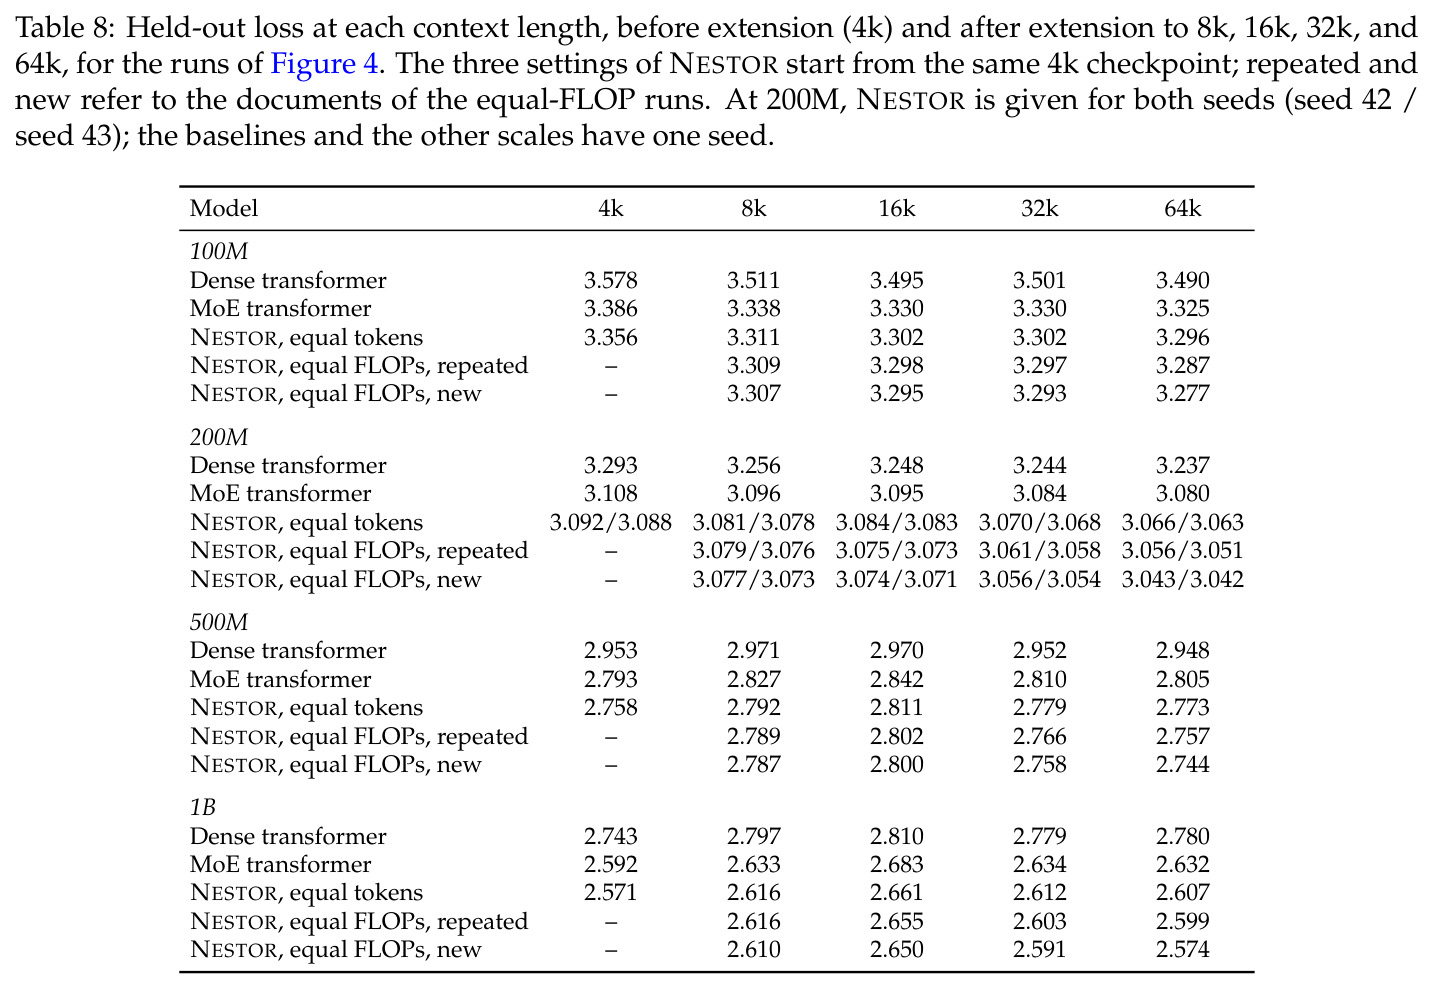
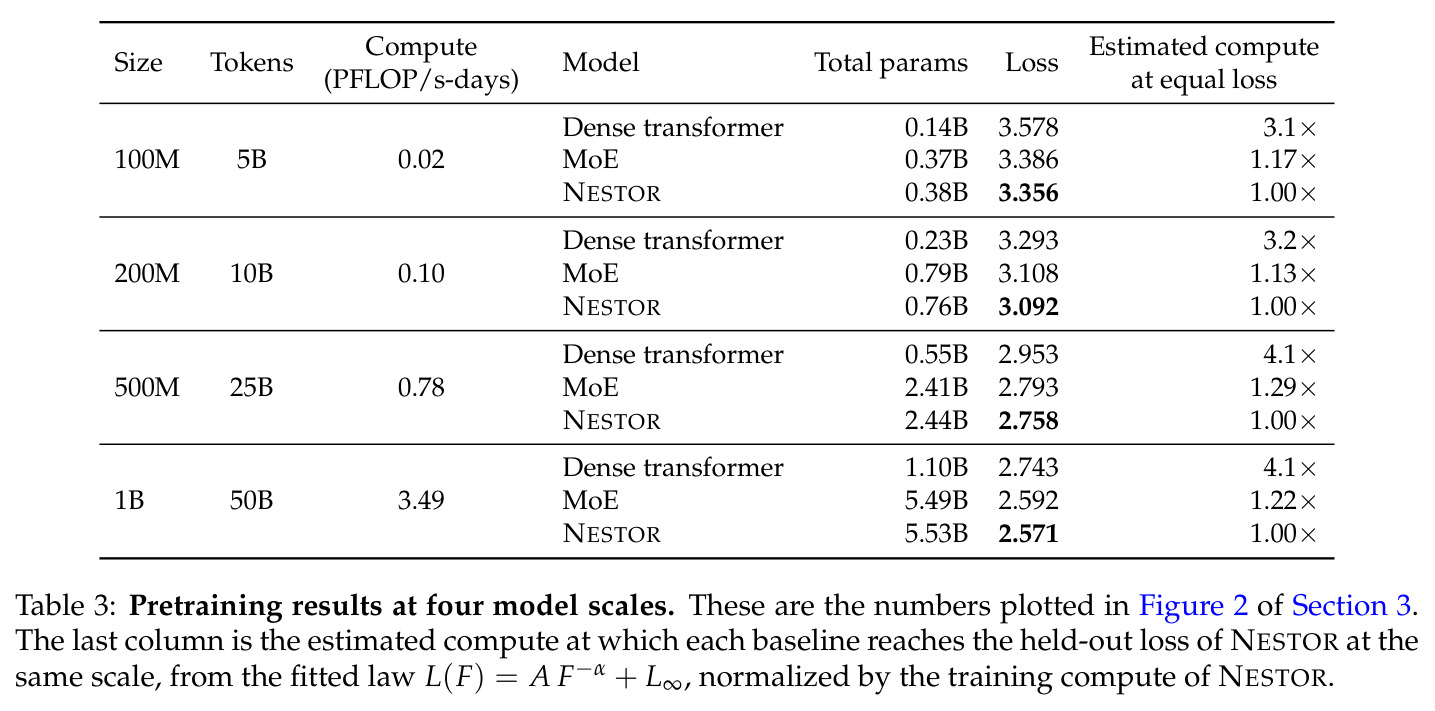
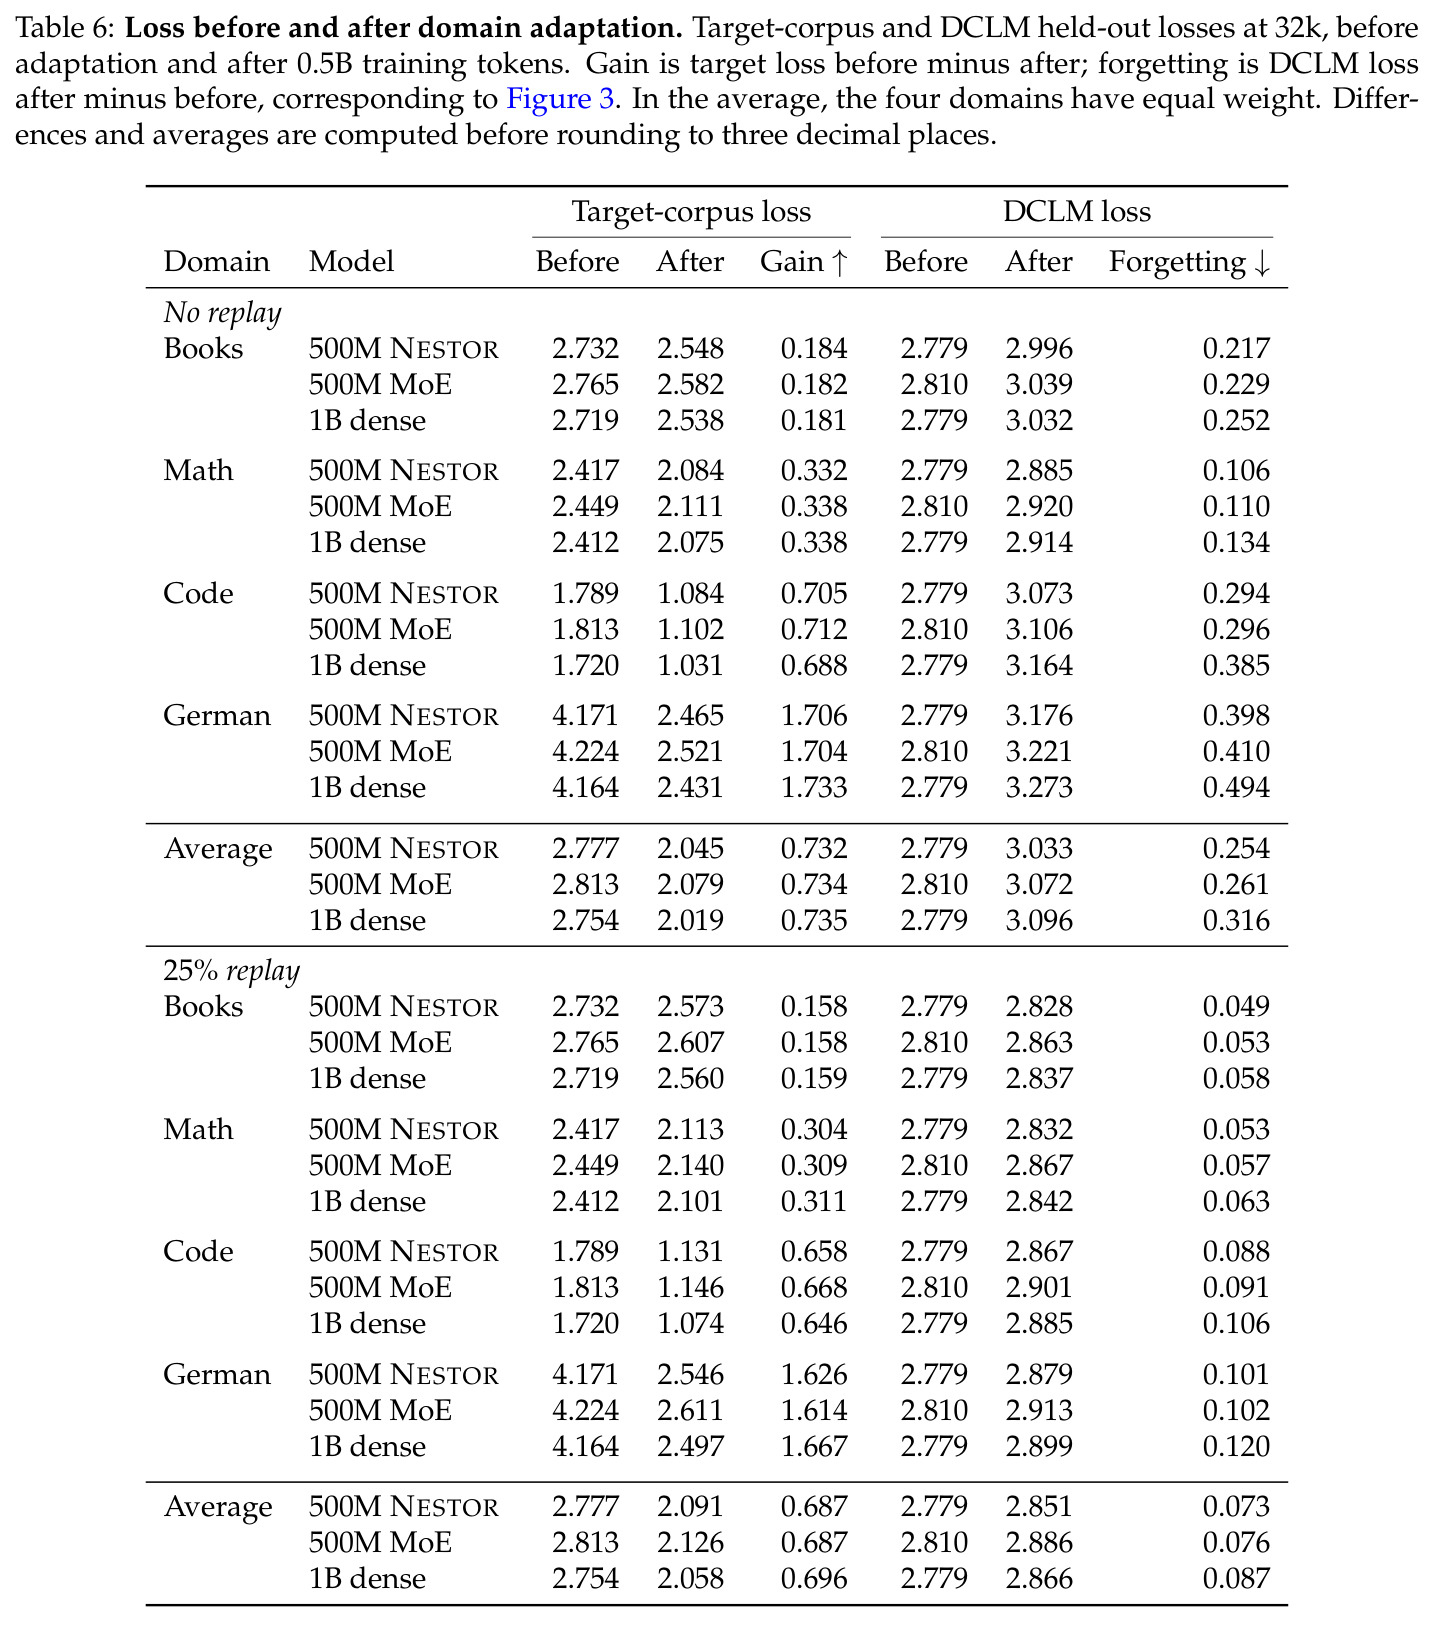
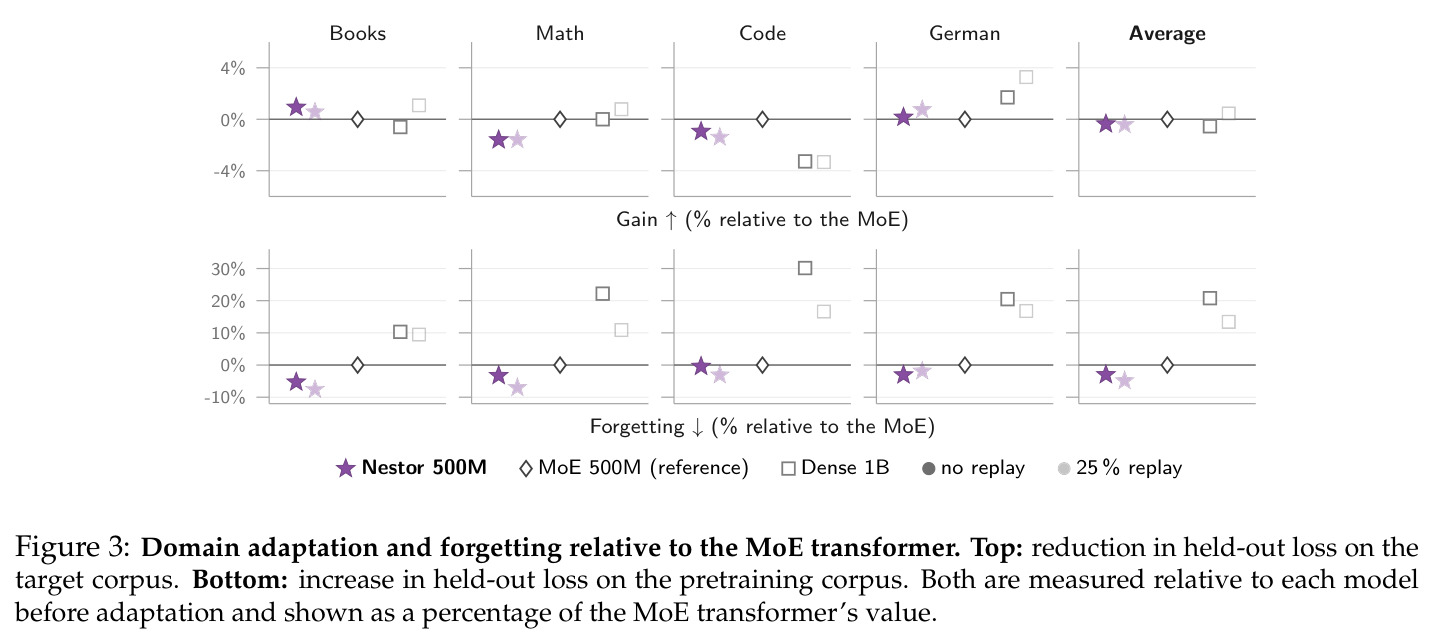
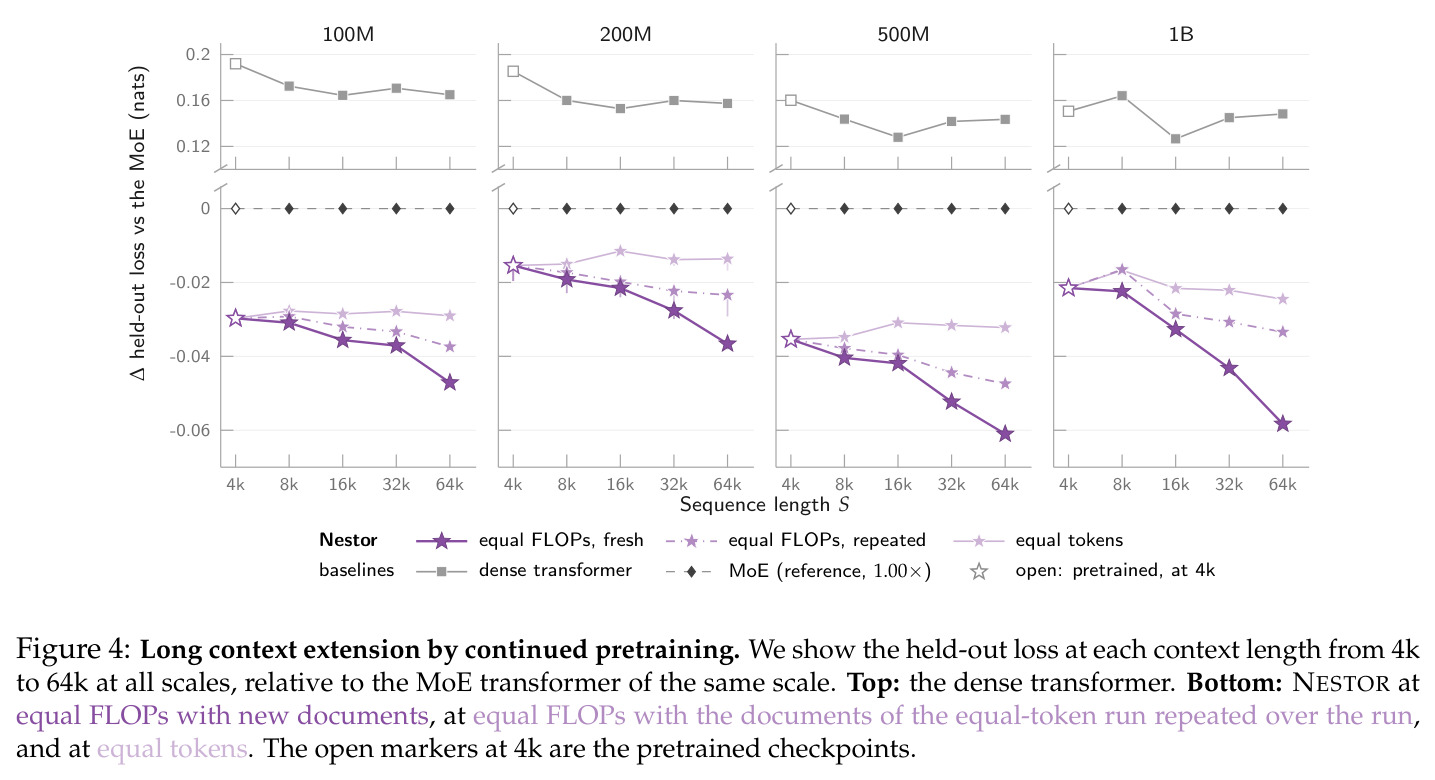
预训练缩放定律(Figure 2):在 100M/200M/500M/1B 激活参数四个规模(训练 5B/10B/25B/50B token,DCLM-baseline,上下文 4096)上 NESTOR 的 held-out loss 全部最低。拟合 $L(F)=AF^{-\alpha}+L_\infty$ 后,NESTOR 与 MoE 的指数到三位小数一致($\alpha\approx0.101$)但 NESTOR 系数与不可约损失更小;追平 NESTOR 需 MoE 花费 1.17×/1.13×/1.29×/1.22×(四个规模)算力、dense 花费 3.1×/3.2×/4.1×/4.1×,均不随规模缩小。领域适配(Figure 3):500M NESTOR、500M MoE、1B dense 各在 books/math/code/German 上训 0.5B token 无回放:三者适配增益相近(NESTOR 与 dense 均在 MoE 的 1% 内),遗忘方面 NESTOR 比 MoE 少 3%,dense 多 21%;25% 回放使三者遗忘均降约 70%、增益损失约 6%,排序不变(NESTOR 仍少 5%)。长上下文(Figure 4):4k 扩展到 8k–64k,等 token 时 NESTOR 与 MoE 增益相当;等 FLOPs 时省出的算力换更多 token(倍数 $R(S)=(S_0+S)/(S_0+\rho S)$,随 $S$ 趋近 $1/\rho$),花在新数据上收益最大且相对 MoE 优势随长度增大。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语言模型预训练(DCLM-baseline,上下文 4096,50 token/激活参数) | held-out cross-entropy loss 与追平 NESTOR 所需算力比 | 100M–1B 四个规模 held-out loss 全部最低;1B 规模下 MoE 需 1.22×、dense 需 4.1× NESTOR 的算力才能追平 | 等稀疏度 MoE transformer($E=24,K_e=3$)与等宽深 dense transformer | 相对 MoE 节省 13–29% 算力(1.13–1.29×),相对 dense 节省 3.1–4.1×,且倍数不随规模缩小 |
| 领域自适应持续预训练(books/math/code/German 各 0.5B token,无回放) | 目标域 held-out loss 降幅(增益)与预训练域 loss 升幅(遗忘),相对 MoE 的百分比 | 增益与 MoE 相差 <1%,遗忘比 MoE 少 3%;25% 回放时仍少遗忘 5% | 500M MoE transformer(参照系),1B dense transformer(遗忘多 21%) | 在增益持平的前提下遗忘减少 3%(回放设置下 5%),且每 token 训练 FLOPs 更少 |
| 长上下文扩展(4k→8k/16k/32k/64k 继续预训练) | 各目标长度的 held-out loss,相对同规模 MoE transformer(1.00×) | 等 token 时保持优势;等 FLOPs + 新数据时损失差随 $S$ 扩大,可在相同算力下训练 $R(S)=(S_0+S)/(S_0+\rho S)$ 倍 token | 同规模 MoE transformer 与 dense transformer | 等 FLOPs 下优势随上下文长度单调增长,极限趋近 $1/\rho$(激活列比例的倒数) |
局限与改进
作者承认的局限:最大模型仅 1B 激活参数,且只以 held-out loss 评估,算力倍数能否在更大规模与 post-training 后的标准 benchmark 上保持尚待验证;NESTOR 是元架构,本文只测试了 column 内全因果注意力,列内改用稀疏或线性注意力本可复合节省但未验证。我补充观察到:脚注承认若只计线性层 FLOPs,NESTOR 在 4096 上下文比基线多用 4–8% 算力,说明 token 级路由的实现效率有损耗;领域适配实验冻结了两个稀疏模型的路由器,未探索路由自适应的收益;长上下文算力节省公式 $R(S)$ 假设路由均衡($\rho=K_c/C$),实际路由不均衡时收益会打折;理论模型限于一层单头线性注意力与平方损失,与深层非线性 transformer 有差距;等 FLOPs 的部分收益来自重复/更多数据,与纯架构优势混在一起,需要更细的归因。
独立分析的弱点
第一,长上下文收益依赖路由均衡假设:若某些场景(如代码)使 token 高度集中于少数 column,$U_c$ 变大,注意力 FLOPs 上升且 $R(S)$ 的节省缩水,改进方向是负载感知路由或列容量约束。第二,每块只路由一次虽省计算,但块内 $M$ 层不能换 column,可能限制表达灵活性,可探索块内细粒度重路由或跨块软融合。第三,token 级 gather/scatter 在现有 GPU 上 kernel 效率低,4–8% 的线性层额外 FLOPs 表明需要针对嵌套稀疏的融合 kernel 与每 column 独立的 KV cache 管理,否则推理侧收益打折扣。第四,持续学习实验冻结路由器、只测 4 个领域且领域集合固定,真实场景领域更多且可能需要动态增删 column/专家,缺乏扩容与热更新机制。第五,仅以 held-out loss 评估,无法判断下游任务表现、生成质量与 post-training 的交互;理论上 $d_F/d_N\in[2,C]$ 的下界为 2,说明当专家参数占主导时嵌套的参数节约有限。每个弱点都指向一个可验证的后续实验设计。
未来方向
作者提出的方向:在更大规模上验证算力倍数并在 post-training 后的标准 benchmark 上确认收益迁移;利用 NESTOR 的元架构性质,在 column 内使用稀疏或线性注意力以在长上下文复合节省;用具有特殊性质(如可解释性、模块化)的子网络充当 column,通过嵌套结构在层级保留这些性质。基于成果可延伸的方向:把检索式 top-K 稀疏注意力放进列内并与路由联合学习;将粗类 $c$ 解释为模态或语言,做天然分组的多模态/多语种预训练;在持续学习中引入专家与 column 的动态扩删及路由器热更新,摆脱冻结路由的限制;依据 Theorem 1 的自由度刻画自适应选择 $C$、$E$、$r$;研究嵌套稀疏与 KV cache 压缩、推测解码的协同;验证皮层功能柱类比启发的列内局部学习规则。
复现评估
论文声明代码与 checkpoint 已开源在 GitHub,复现的基本要素齐全:预训练数据为公开的 DCLM-baseline,领域适配使用公开的 PG-19、OpenWebMath、AlgebraicStack、FineWeb-2,长上下文扩展用 DCLM 长文档。规模为 100M–1B 激活参数、5B–50B token,从 Figure 2 横轴看训练算力约在 0.1–10 PFLOP/s-days 量级,属于学术实验室用数百张卡可承担的范围;参数化、optimizer 与各实验细节分别在附录 C、D 给出,架构的完整数学描述在附录 B。难点主要在工程而非算力:嵌套稀疏需要 token 级路由与每 column 独立 KV cache,现有 MoE 框架(如 Megatron/DeepSpeed-MoE)需较大改动,作者也承认其实现比基线低效 4–8%。总体而言,复现主表主图难度中等,复现持续学习部分需多次 0.5B token 的继续训练 run,算力需求中等,建议按 100M 规模先行验证。
论文图表