长上下文混合专家训练中的显存峰值全面抹平:四个有界流式算子 Flattening Every Memory Peak in Long-Context Mixture-of-Experts Training
四个只改计算顺序的流式算子同时压平四类显存峰值,使 MoE 训练跑通百万 token 上下文
前置知识
混合专家模型(MoE)与专家并行(Expert Parallelism)
MoE 把 Transformer 的 FFN 替换为大量"专家"子网络,路由器为每个 token 选 top-$k$ 个专家计算,实现参数量大而计算量小的稀疏激活。专家并行把不同专家的分片权重放到不同 GPU 上,token 若被路由到别的 rank 持有的专家,就要通过 all-to-all 通信被"派送"过去,计算完再"合并"回来。
本文的第一个显存峰值正来自专家分发:每个 rank 必须接收所有路由到它所持专家的 token,缓冲大小由路由矩阵决定,是四个无界项之一。
峰值显存与活跃张量组(live set)
训练的显存占用不是一个平均值,而是若干"必须同时驻留在 GPU 上的张量组"的最大值。例如 backward 中某一时刻,所有未释放的激活、梯度、优化器状态的并集才是峰值。峰值是这些组的最大值:只压低其中三组、放任第四组自由增长,工作负载一大就会在那个组上 OOM。
全文的问题定义就建立在 live set 上:作者找出四个现有并行方案不约束的 live set,并为每一个给出启动时即可确定的闭合形式上界(式 6)。
梯度检查点(Gradient Checkpointing)
前向时不保存每层的全部中间激活,只在层边界保存"检查点"(该层输入 $h_\ell$),backward 到该层时从检查点重新计算内部激活,用额外一次前向计算换取显存。代价是每个被检查点化的层的输入必须从 forward 一直活到该层 backward 重计算结束。
检查点边界(深度 × 序列长度个张量)是第三个无界峰值;而且本文反复强调:任何显存 bound 必须在重计算后的 backward 中仍成立,否则毫无意义,这是各算子设计的硬性验收标准。
ZeRO-3/FSDP 与优化器状态卸载(Optimizer Offload)
AdamW 优化器每个参数需要工作权重、梯度、fp32 主权重和两个动量共约 16 字节。ZeRO-3/FSDP 把这些持久状态分片到各 rank;卸载(ZeRO-Offload)进一步把 fp32 主权重与动量搬到 CPU 内存,代价是更新在 CPU 上串行执行,期间 GPU 空转。本文基线 FSDP2-best 即 ZeRO-3 式全分片加 CPU 优化器卸载。
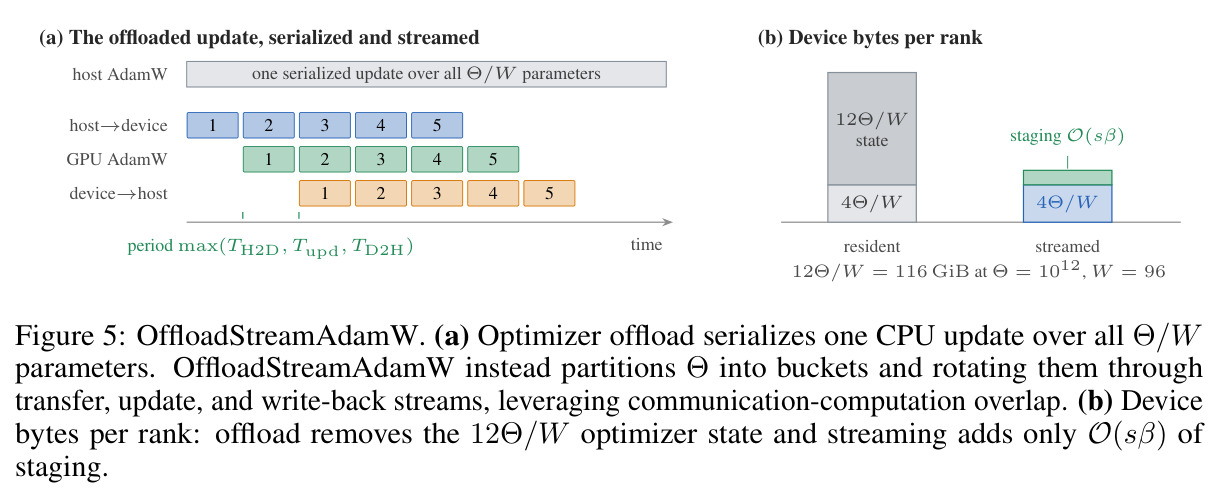
卸载优化器是第四个峰值的来源:$12\Theta/W$ 字节的状态在 host 上串行更新,GPU 闲置;本文的 OffloadStreamAdamW 正是针对这个时间成本设计的。
在线 log-sum-exp(online softmax)与融合交叉熵
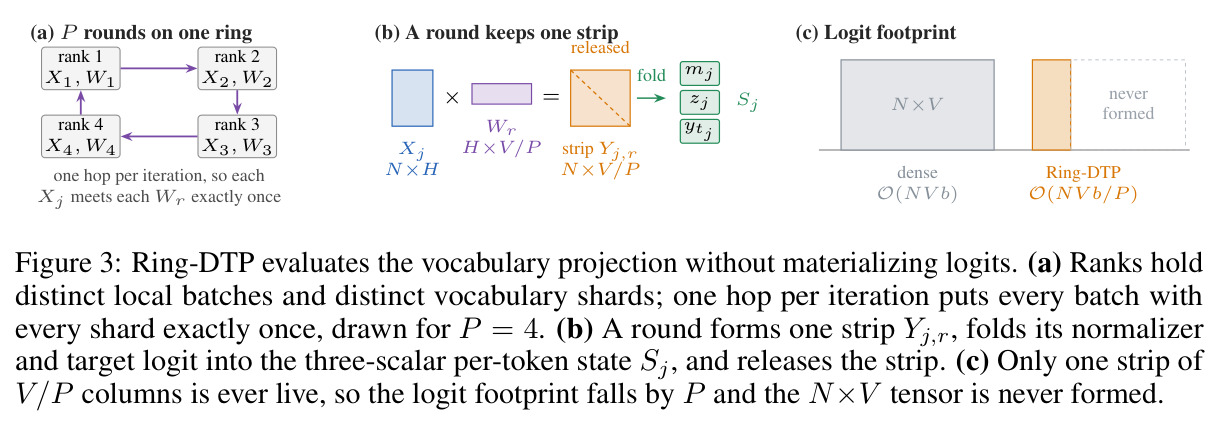
计算交叉熵不需要整行 logits,只需三个标量:运行最大值 $m$、指数和 $z$、目标 logit $y_t$。按词表分块流式处理时用递推 $m'=\max(m,\max_v y_v)$、$z'=e^{m-m'}z+\sum_v e^{y_v-m'}$ 归并,最后损失为 $m+\log z-y_t$,结果与一次性 softmax 完全相同。Cut Cross-Entropy、Liger-Kernel 都基于此。
Ring-DTP 的数学基础:把这套单卡技巧扩展到 batch 与权重同时分片的多卡场景,需要设计环上调度并保证每轮条带折叠的精确性。
All-to-all 集合通信与分组 GEMM
All-to-all 是每个 rank 同时向其他所有 rank 发送不同数据片的集合通信原语,MoE 专家分发/合并都靠它,其 backward 是对称的逆 all-to-all。分组 GEMM(grouped matmul)把不同专家的不规则 token 批组织成一次批处理矩阵乘(MegaBlocks 风格),是专家计算的执行形式。
PipelinedLLEP 的三段流水线(dispatch → 分组专家矩阵乘 → combine)建立在两者之上;chunk 切分会增加集合通信启动次数,是其吞吐代价的直接来源。
研究动机
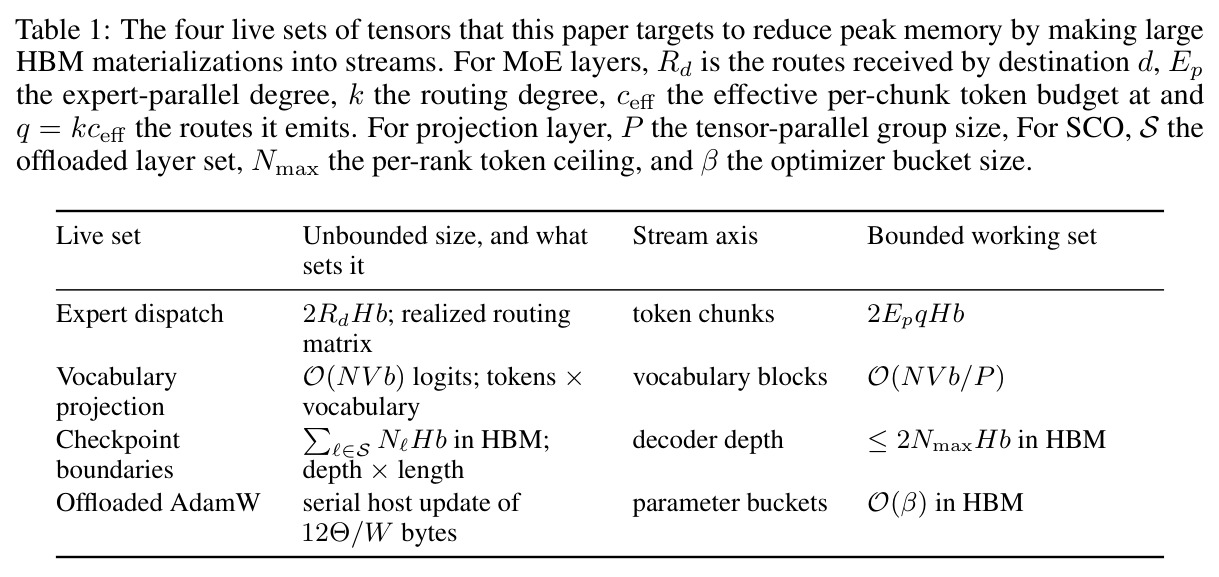
训练超大 MoE 模型时,训练步骤的显存占用是若干"必须同时驻留的张量组"(live set)的最大值,任何一组峰值超过 HBM 上限,整个 step 就 OOM。现有并行方案(ZeRO-3/FSDP、序列并行、专家并行)只分片了持久状态,却有四个峰值无人看管,且各自随不同变量增长:专家分发缓冲随路由矩阵 $R_d$(批量大小 × top-$k$ × 路由不均衡度)增长;词表投影随 $N\times V$ 的 logits 张量增长——在 200K 词表、百万上下文时仅 logits 一项就超出 HBM;梯度检查点边界随"深度 × 序列长度"增长;AdamW 优化器状态随参数量增长(每参数 16 字节)。哪个先爆取决于具体配置:词表大、上下文长时 logits 主导;路由偏斜严重时专家分发主导;层数深时检查点边界主导;参数多设备少时优化器状态主导。只压最大的一项,下一个就会顶上来,等于白做。实测中,扫参调优后的 FSDP2 基线在 120B/241B/667B 三个规模分别止步于 128K/32K/64K 上下文。而扩容 GPU 往往不可行,标准换法都要付时间代价:检查点重计算、分片通信、CPU 串行更新。
本文的目标是本文的目标是把这四个无界峰值同时压到启动时即可确定的闭合形式上界之下,而不是只优化其中当前最大的一个。具体验收标准有三条:第一,每个算子给出的界必须在检查点重计算后的 backward 阶段仍然成立——因为检查点化 step 的峰值通常出现在 backward 中,只在 forward 成立的界没有价值;第二,四个算子彼此独立、可单独启用,训练只需为实际存在的峰值付费("pay only for the peaks it has"),不为用不上的界付出吞吐代价,这正是四个算子要成套开发的原因;第三,所有算子只允许改变计算与数据搬运的顺序和粒度,必须返回与被替换实现完全相同的前向值和梯度——不引入低秩适配、不量化优化器状态、不做近似路由或近似注意力,因此显存和吞吐数字可与标准 BF16 全参数训练直接对比。最终组合进 MoP rank 布局,在 120B、241B、667B 三个 MoE 模型上以 16/32/64 张 H200 训到 1M 上下文,且每卡预算存在闭合形式(式 6),启动前即可检验配置可行性。
与已有工作不同的是,已有工作各自解决四类峰值中的一类,但没有统一的"每卡预算闭合形式"视角。流式损失方面:Cut Cross-Entropy、Liger-Kernel 等融合交叉熵核假设整个 batch 驻留在单卡上,根本不需要跨卡调度;Megatron 词表并行虽切分权重,却要求每个 rank 持有相同的 batch 副本,等效批量变小、长上下文扩展性差;Ring Attention 环上只有一个操作数可动,不存在"搬激活还是搬权重"的选择问题。MoE 分发方面:FasterMoE、Lina、PipeMoE、ScheMoE 都用流水线重叠通信,但分块数按带宽利用率选取,接收缓冲仍在 all-to-all 物化时随实际路由负载涨;LLEP 消除了路由偏斜的时间代价,但一次仍物化整个 routed batch。激活方面,DeepSpeed 与 PyTorch 支持整段卸载检查点区域;优化器卸载沿用 ZeRO-Offload 的 CPU 串行更新。本文的独特切入是:为每个峰值给一个"启动时已知的界",并要求界在重计算下依然成立——这组精确性条件与机制级评测是现有布局类工作(如 MoP)没有给出的。
核心方法
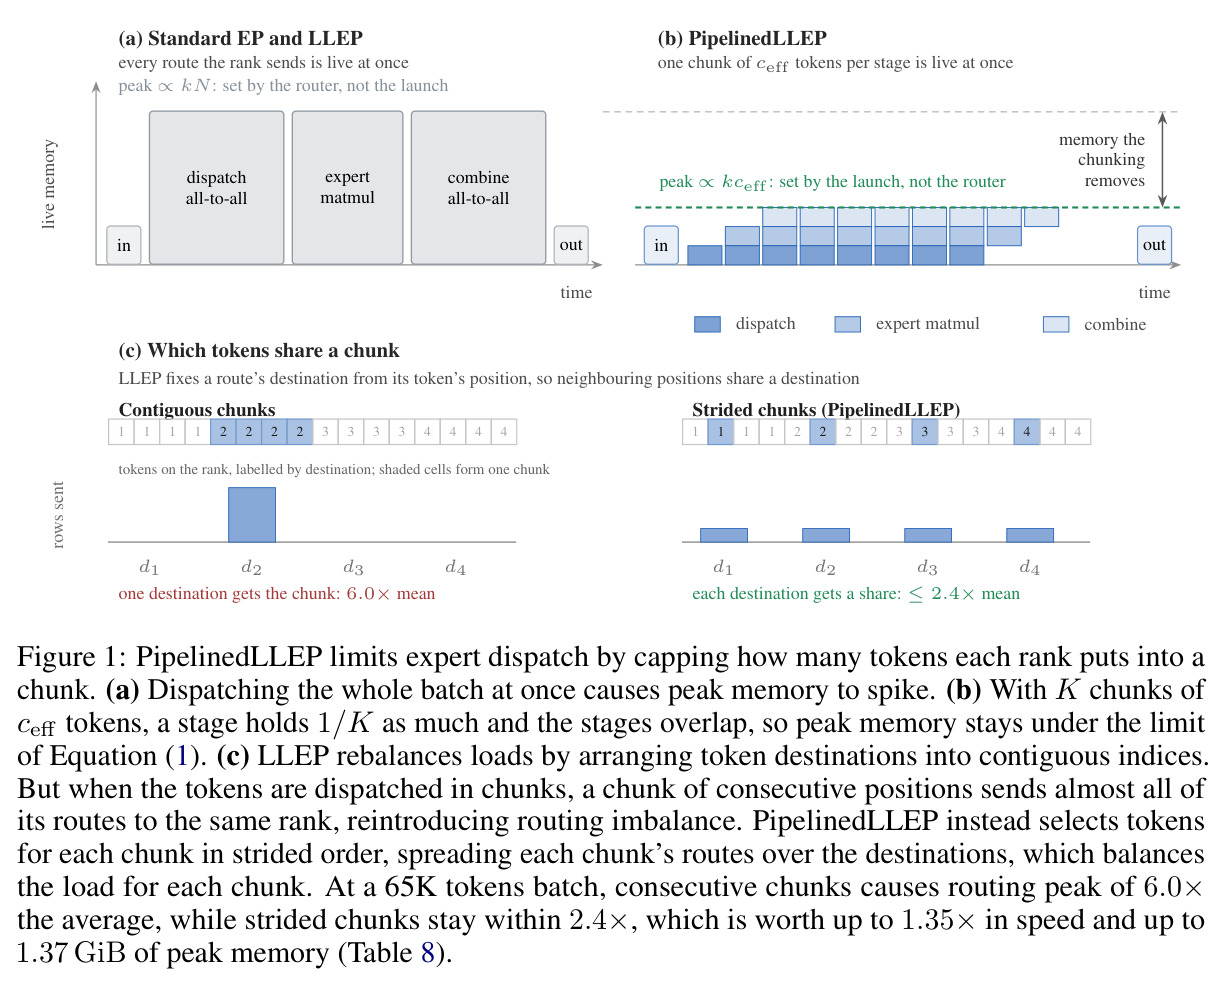
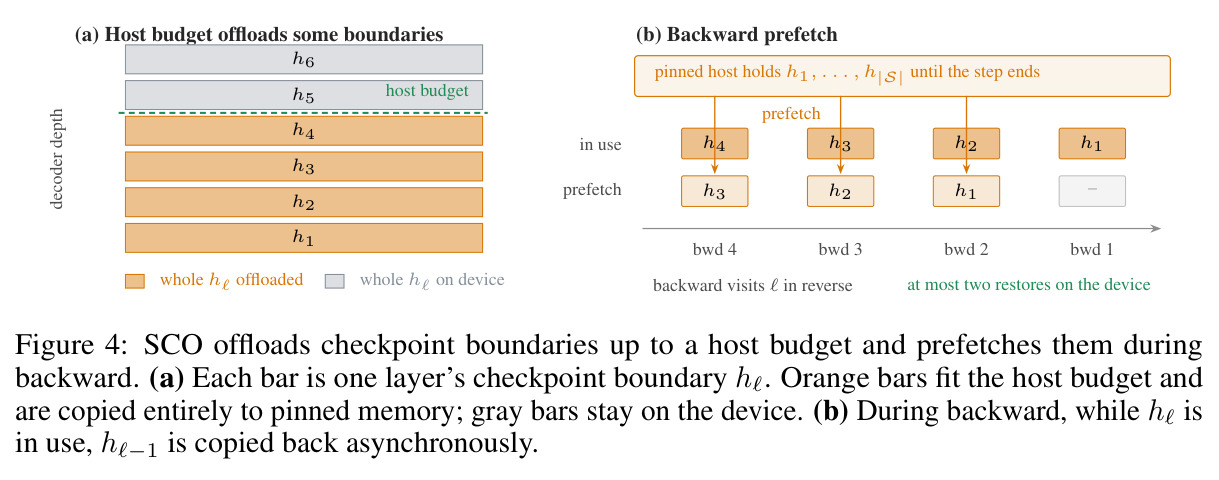
直觉上,训练 step 的显存峰值由四个互不重叠的 live set 决定:MoE 层内的分发临时张量、输出头的 logits 条带、跨层存活的检查点边界、更新时刻的优化器状态。本文为每一项设计一个"有界流式算子",把本来一次性物化的大张量变成按固定预算流动的流,使 GPU 工作集在启动时由模型与启动配置唯一确定。技术路线:(1) PipelinedLLEP 给每个发送 rank 设 token 预算 $c$,把批次切成 $K$ 个 chunk 走 dispatch→分组专家矩阵乘→combine 的三段流水线,接收缓冲上限变为 $2E_pkc_{eff}Hb$,与路由矩阵完全无关;(2) Ring-DTP 在 $P$ 个 rank 的环上让每个本地 batch 依次遇到每个词表分片,每次只形成 $N\times V/P$ 的条带并用在线 log-sum-exp 折叠,峰值降为 $O(NVb/P)$,$N\times V$ 张量永不形成;(3) SCO 按 host 预算把检查点边界异步卸载到 pinned 内存,backward 时提前一层预取,HBM 上界 $\le 2N_{max}Hb$;(4) OffloadStreamAdamW 把优化器状态分成至多 $\beta$ 参数的 bucket,用两个 staging slot 在 H2D 传输、GPU 融合更新、D2H 写回三条流上旋转,把步骤时间压到 host 链路往返的下限。四个算子嵌入 MoP rank 布局(ZeRO-3 管稠密权重、序列-头 all-to-all 管注意力、专家并行管专家权重),得到式 (6) 的每卡闭合预算 $M_{peak}=4\Theta/W+O(s\beta)+O(NHb)+O(E_pqHb)+O(NVb/P)+O(NHb)$。
核心创新有两层。其一是问题定义的转变:不再问"怎么切分块让迭代最快"(FasterMoE/PipeMoE/ScheMoE 的准则),而是问"一个接收端最多可能收到多少",并用每源 token 预算给出与路由结果无关的硬上界——路由偏斜只会拉长流水线(时间),不会放大缓冲(显存)。其二是"界必须在重计算下存活"的契约:PipelinedLLEP 把每个 chunk 的专家矩阵乘包进 reentrant 梯度检查点,嵌套在 decoder 层的非 reentrant 检查点内,借助 saved-tensor 钩子让外层检查点截获内层张量;若用非 reentrant 内层检查点,堆叠的专家权重会因 Python 强引用跨 $O(KL)$ 层存活,bound 在 backward 中失效。Ring-DTP 的独特之处是允许每个 rank 保有各自不同的 batch(区别于 Megatron 词表并行的复制 batch),且动态选择环上搬运的操作数:当 $N > V/P$ 时搬权重分片(每跳 $O(HV/P)$ 字节,不随上下文增长),否则搬激活(每跳 $O(NH)$),比 Ring Attention 那种只能单向搬运的环多出一个自由度。SCO 则以"单个检查点边界 + 提前一层预取"为粒度,按 host 预算选择性卸载,区别于 DeepSpeed/PyTorch 的整段卸载。
方法步骤详情
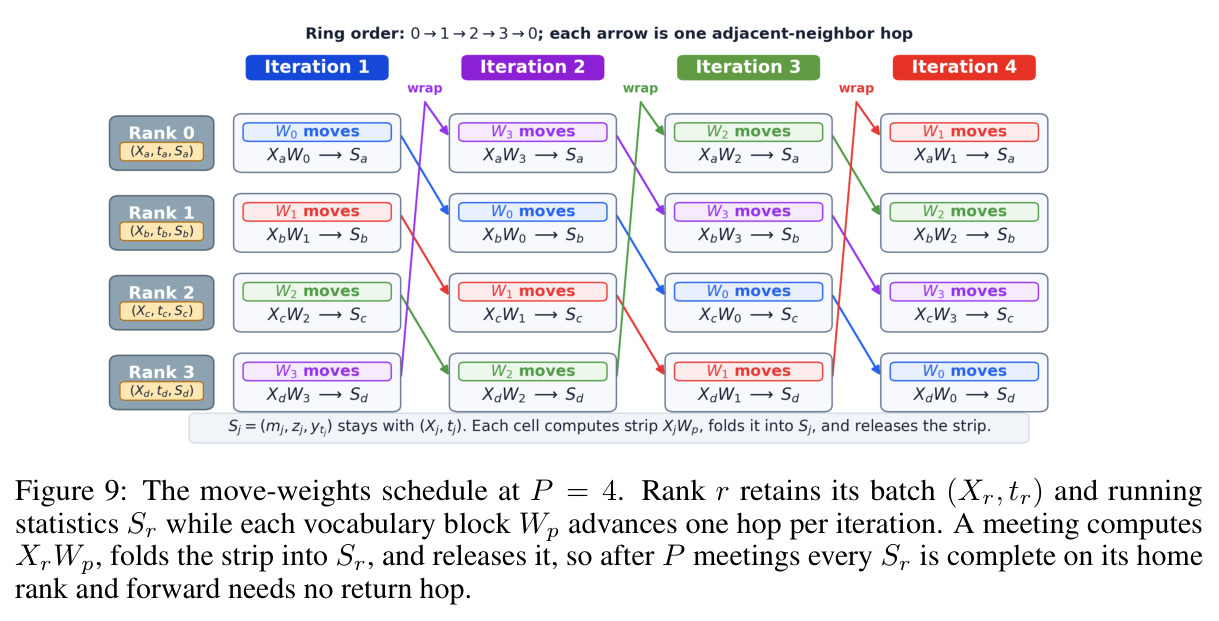
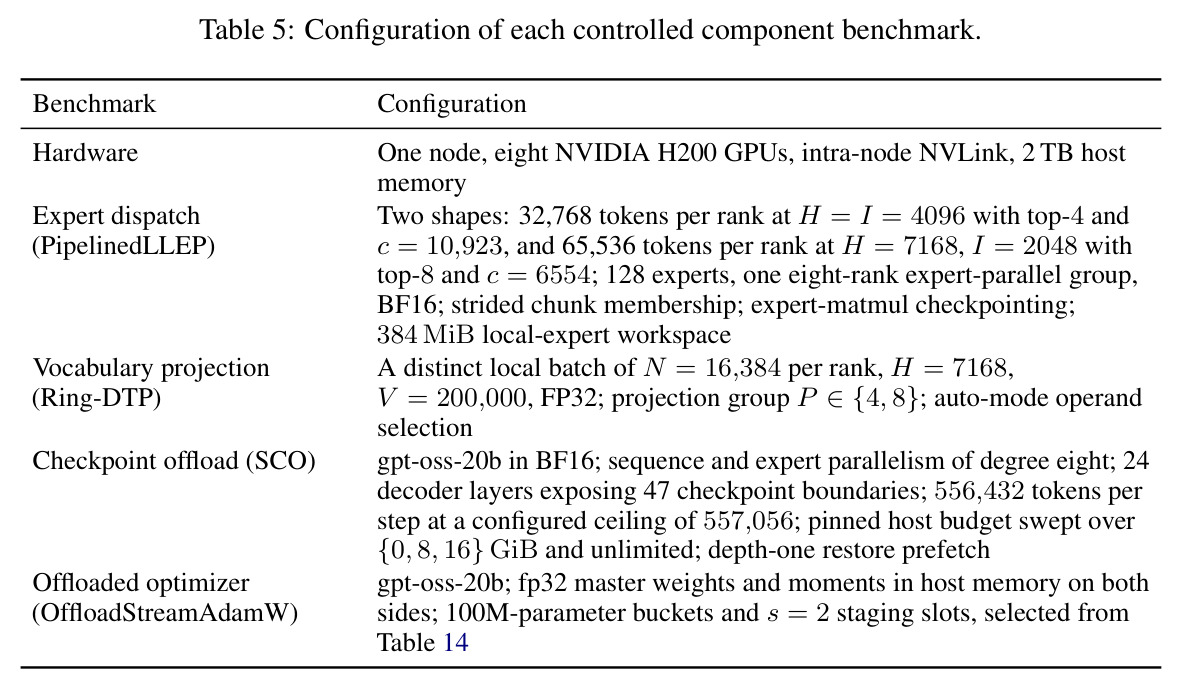
四个算子的完整流程如下。(1) PipelinedLLEP:输入隐状态 $X$、路由权重 $A$、专家 id $E$、预算 $c$、上限 $K_{max}$;先算 $K=\min(\lceil N/c\rceil, K_{max})$ 并经 AllReduceMax 使组内一致,执行一次 LLEP 负载测量与迁移计划;chunk $i$ 取 strided 位置集 $\{i, i+K, i+2K,\dots\}\cap[0,N)$,把每个 chunk 的路由摊到所有目标 rank,避免连续 chunk 因 LLEP 的位置重排把热专家尾部整块发给同一 helper(实测连续分块发送比 6.0× 均值,strided ≤2.4×);每个 chunk 走一次合并的 all-to-all dispatch、reentrant 检查点包裹的分组专家矩阵乘、对称 all-to-all combine,chunk $i+1$ 的 dispatch 与 chunk $i-1$ 的 combine 同期重叠;梯度经对称 all-to-all 回流,专家参数梯度每层只累加一次($K=1$ 时与 LLEP 逐位一致)。(2) Ring-DTP:每个 rank 持有本地 batch $X_r\in\mathbb{R}^{N\times H}$、目标 $t_r$ 与词表分片 $W_r$;$P$ 轮循环中每轮形成条带 $Y_{j,r}=X_jW_r\in\mathbb{R}^{N\times V/P}$,按 $m'=\max(m,\max_v y_v)$、$z'=e^{m-m'}z+\sum_v e^{y_v-m'}$ 折叠进三标量状态 $S_j=(m,z,y_t)$ 后立即释放条带;$P$ 轮后损失为 $m+\log z-y_t$;backward 沿同一环逐条带重放梯度。(3) SCO:前向按序遍历检查点边界,放得进 host 预算的整块异步拷到 pinned 内存并释放卡上副本;backward 反向访问,正在用 $h_\ell$ 重计算时在独立流上预取 $h_{\ell-1}$,卡上最多两个恢复的边界。(4) OffloadStreamAdamW:把每 rank 状态按参数顺序分成 ≤$\beta$ 参数的 bucket(co-group 主权重、动量、最终梯度、bf16 工作权重),经 2 个 staging slot 在三条流上旋转,写回事件完成后归还 slot。
技术新颖性
新颖性可从对照面看清。与 LLEP 的关系:LLEP 只消除路由偏斜的时间代价,PipelinedLLEP 补上其显存维度,用"每源预算 + strided chunk 成员 + 嵌套 reentrant 检查点"三件套把接收界与路由矩阵解耦——strided 成员是必要补丁,因为 LLEP 按全局位置排列目的地,连续 chunk 会把热专家的迁移尾部整块送给同一个 helper rank。与其他 MoE 流水线系统(FasterMoE/Lina/PipeMoE/ScheMoE)的本质区别在判据:它们为带宽选分块数,接收缓冲仍随实际负载涨;本文为显存上限选分块数,给出 no-router-can-move-it 的保证。与融合交叉熵(Cut CE/Liger)和 Megatron 词表并行不同,Ring-DTP 同时处理 batch 与权重双分片,且是首个可在搬激活/搬权重间动态选择的环调度。SCO 的粒度是单边界加预取,且 host 上限是正确性条件(违反会使部分 rank 在集体通信处死锁)而非软约束。OffloadStreamAdamW 把空闲 GPU 当作更新引擎,将卸载优化器的时间成本压到 $12\Theta/W$ 字节的 host 链路下限,且不改变更新规则——区别于 8-bit 量化(BitsAndBytes)、Adam-mini 等改变数值的路线。四个算子两两独立、可单独开关,合成的每卡预算式 (6) 中每一项在 $N\le N_{max}$ 时都由模型或启动配置固定,这是"启动前可检验可行性"这一性质的来源。
实验结果
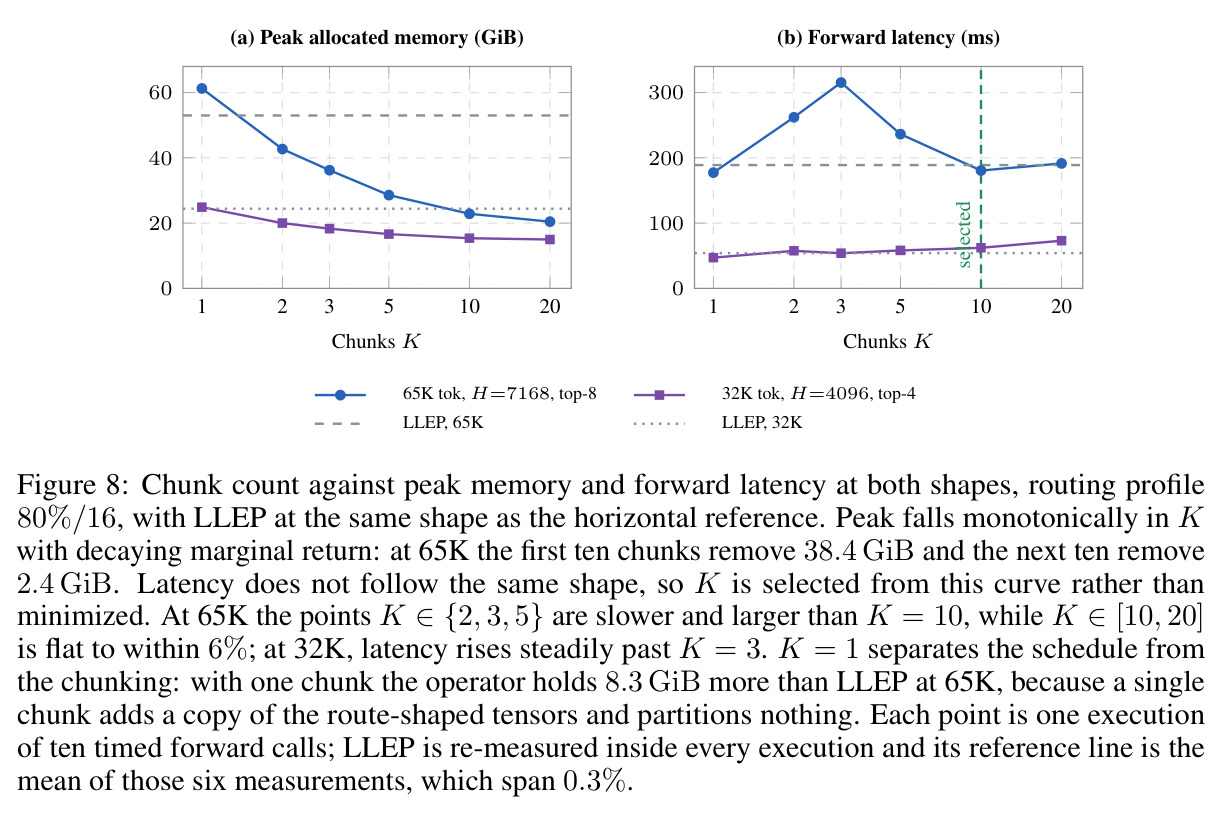
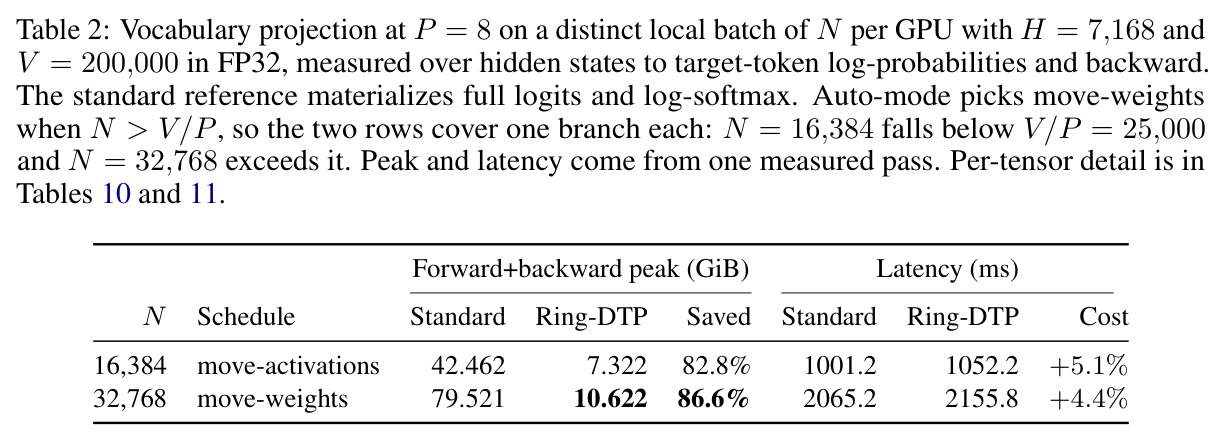
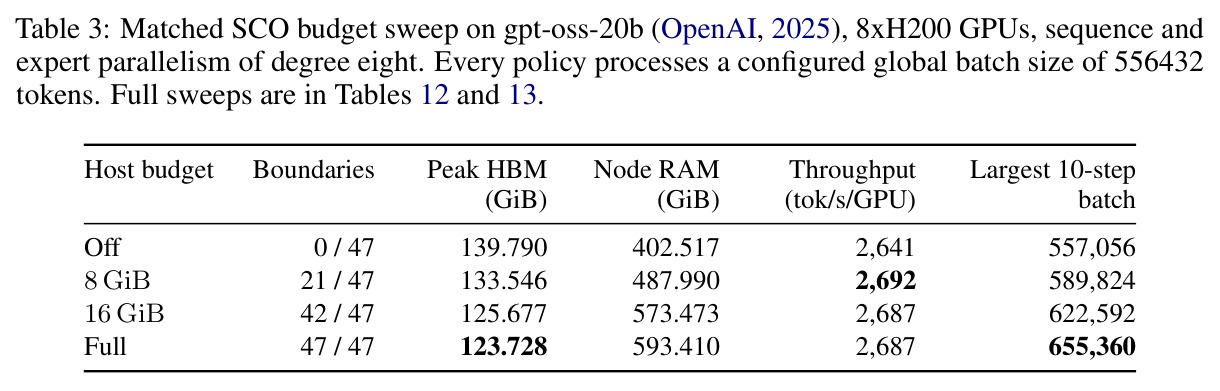
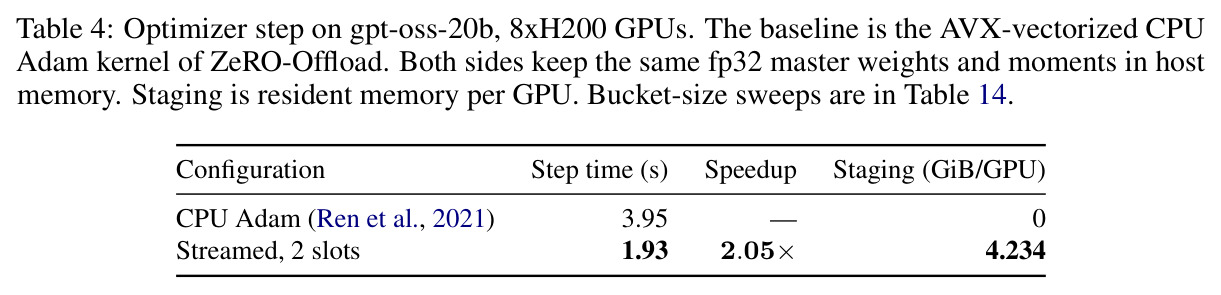
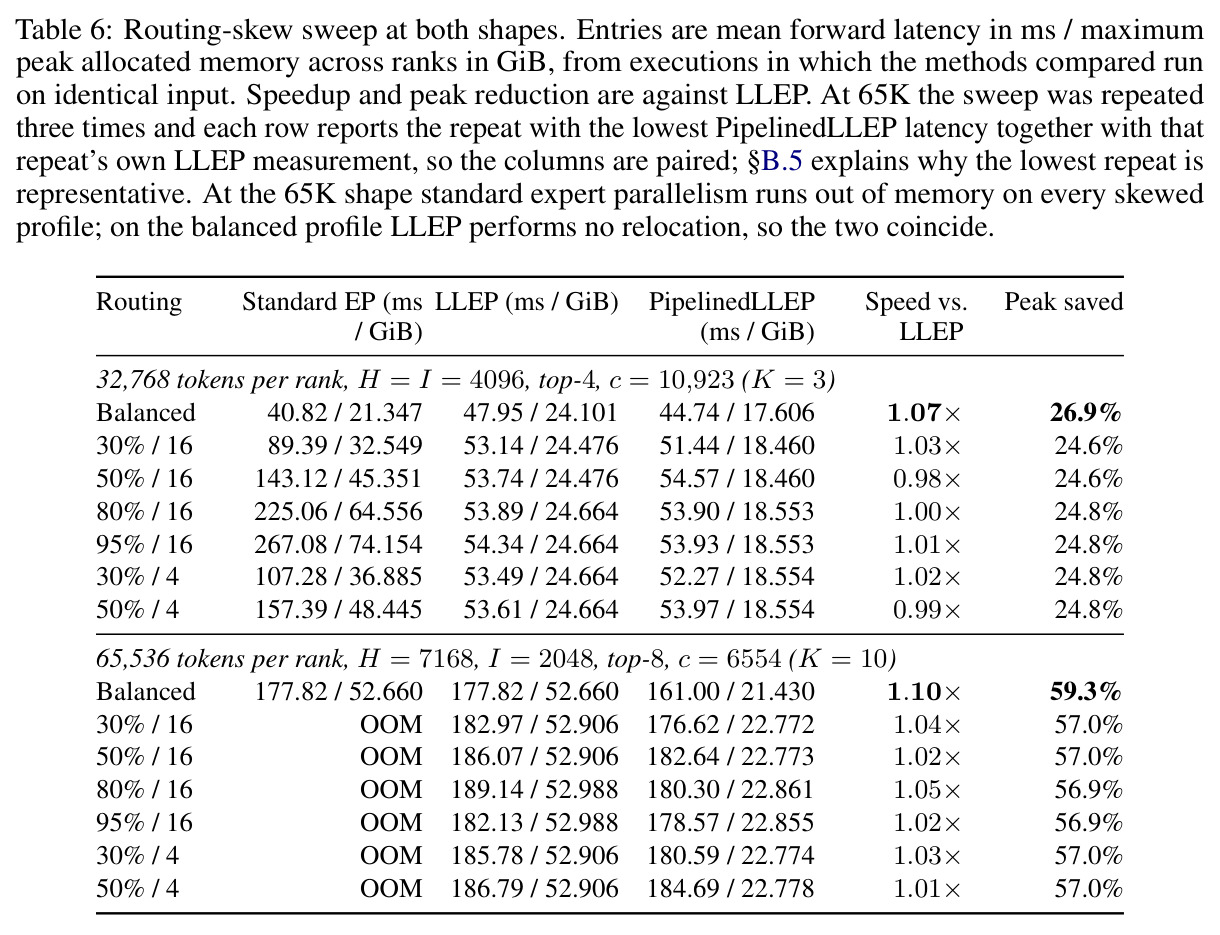
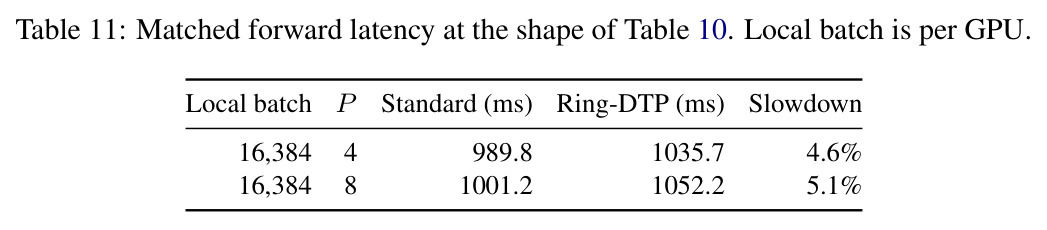
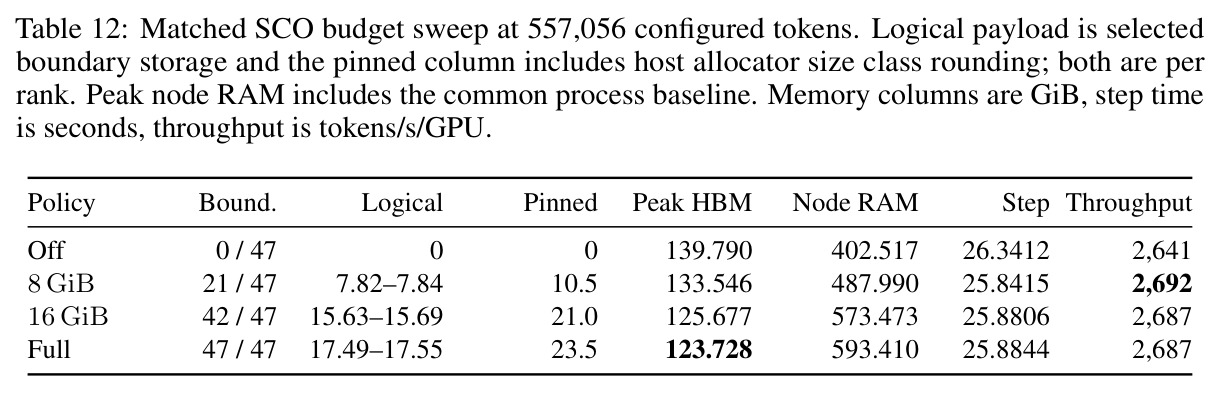
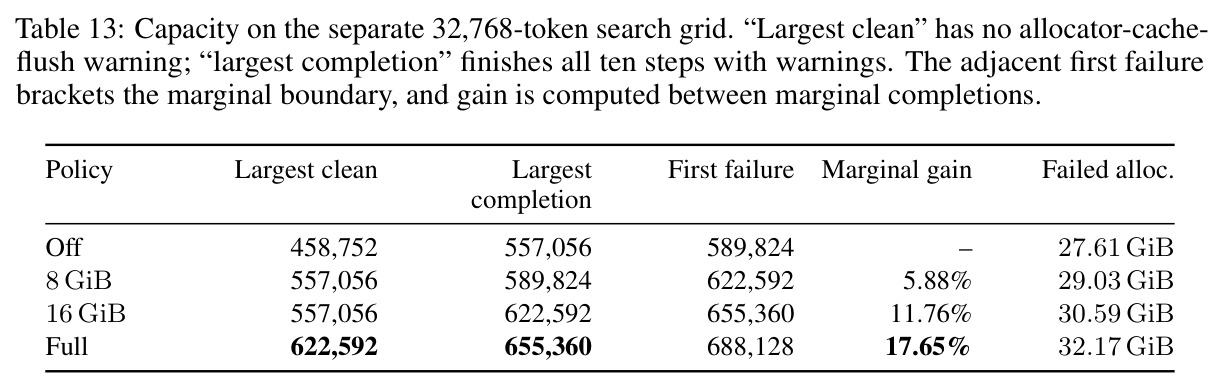
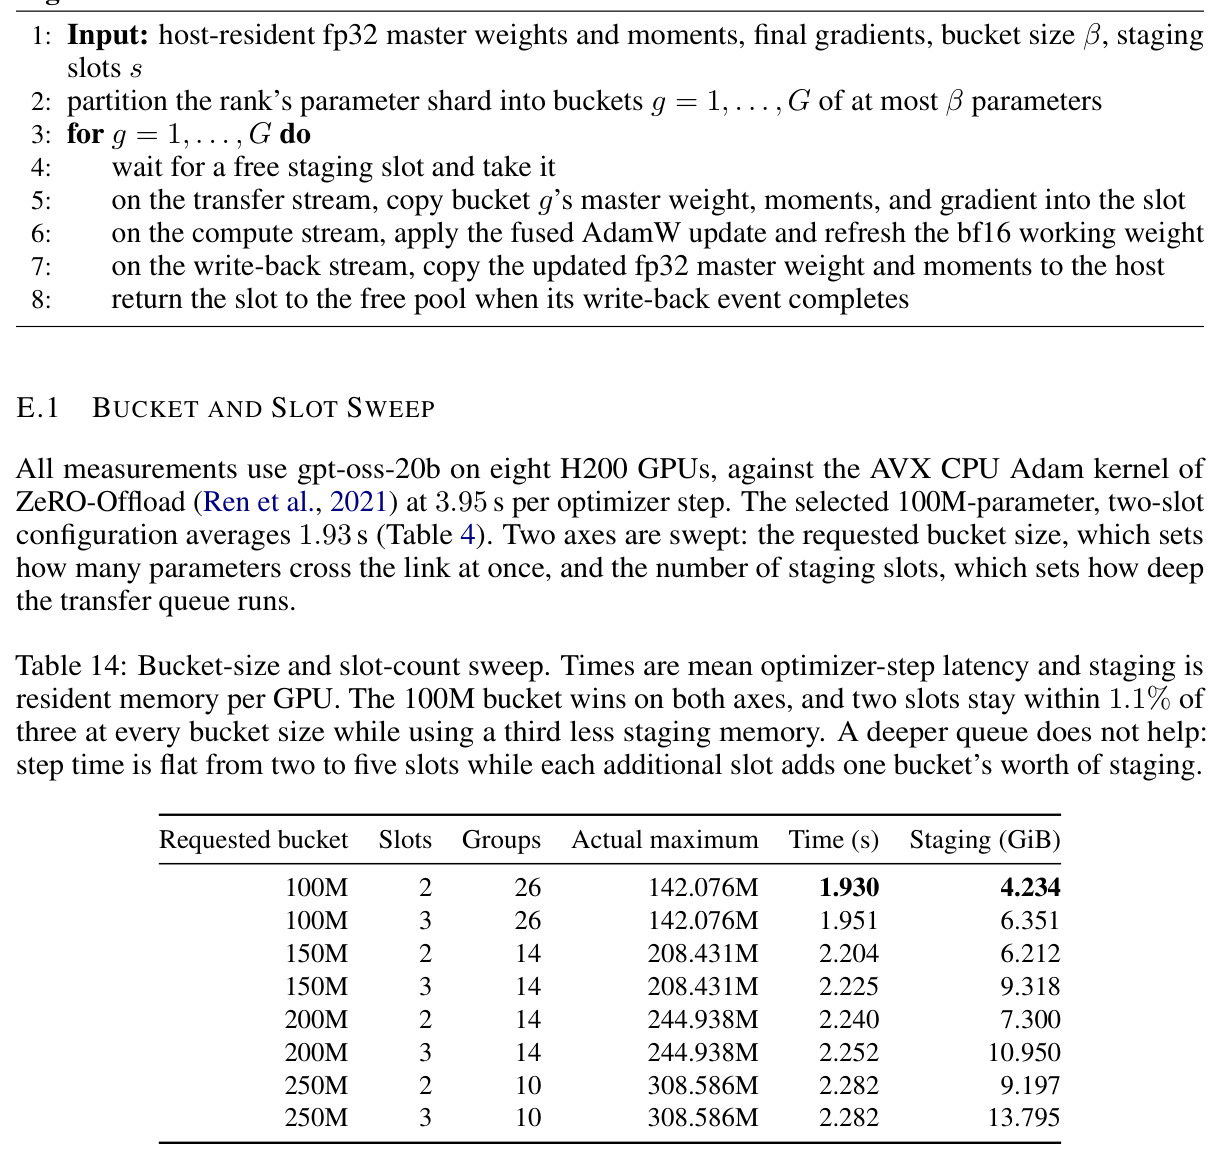
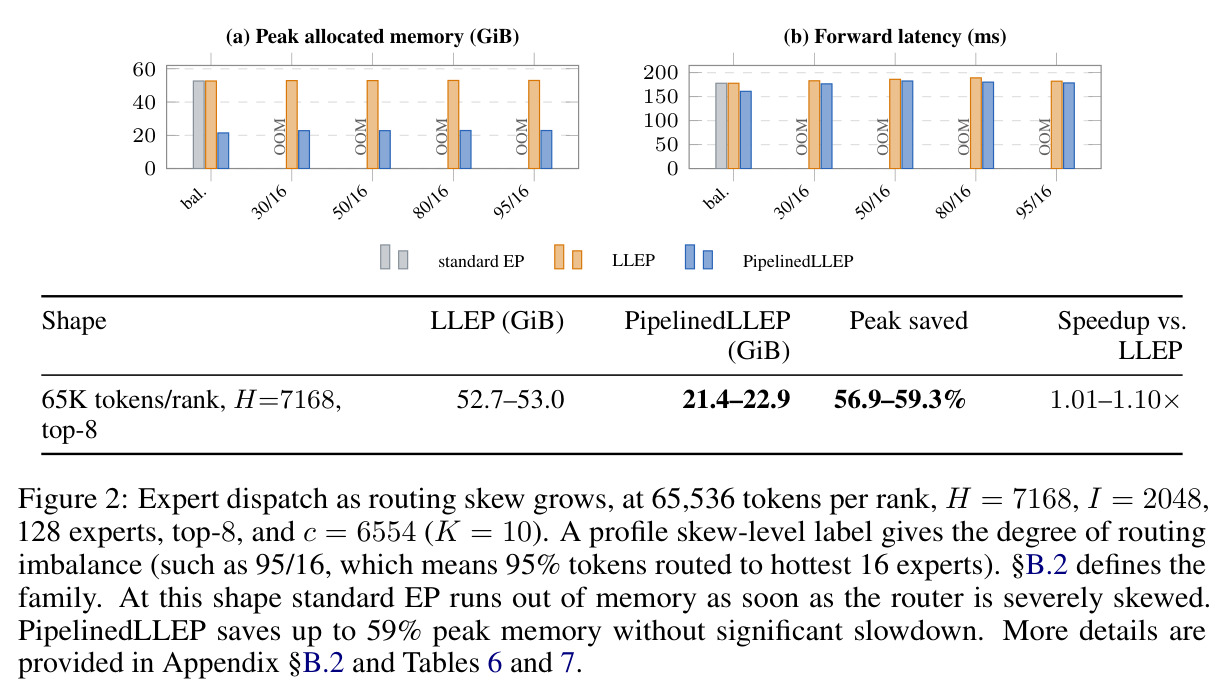
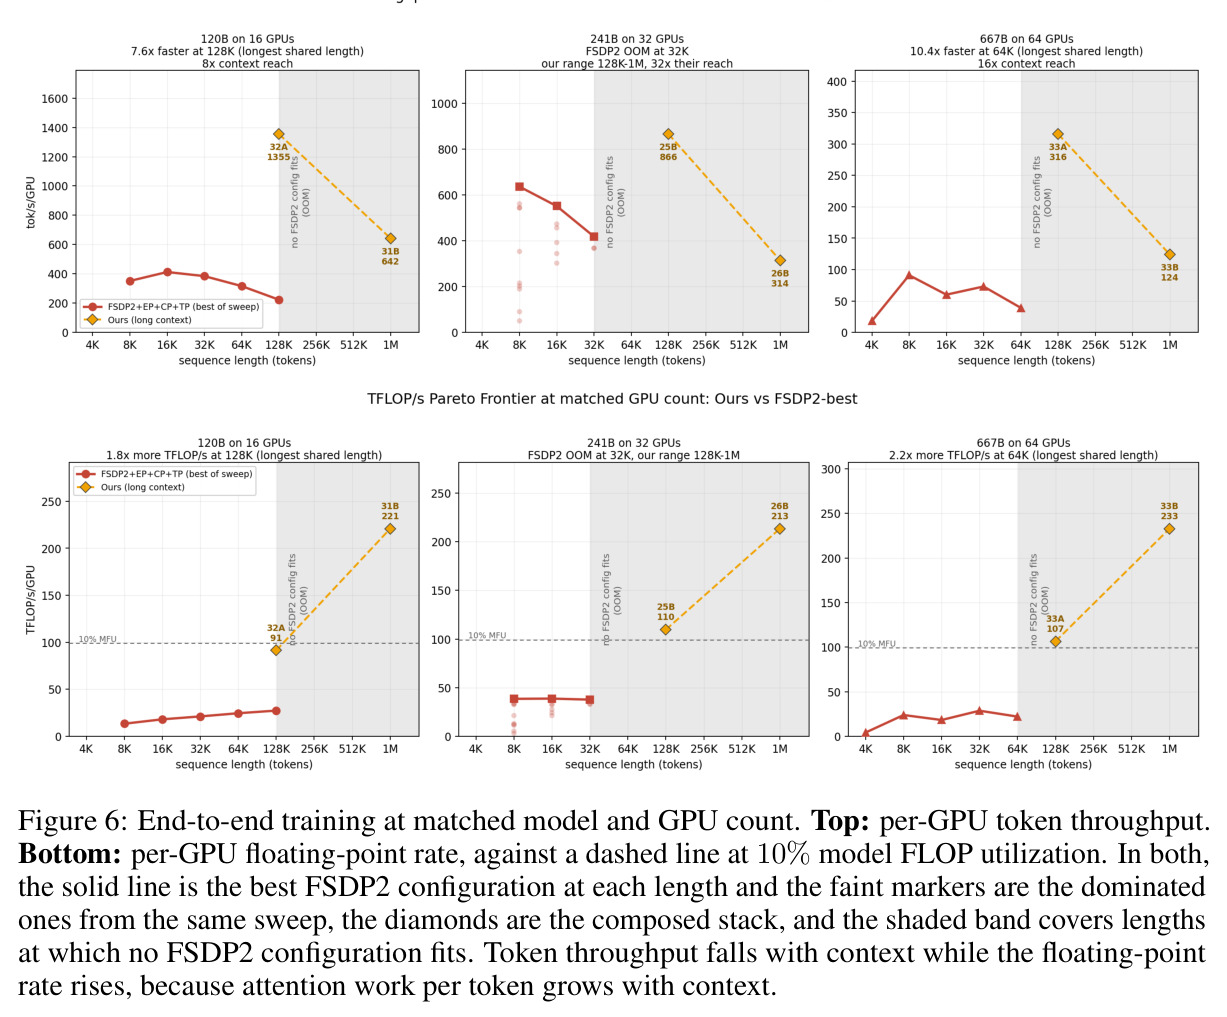
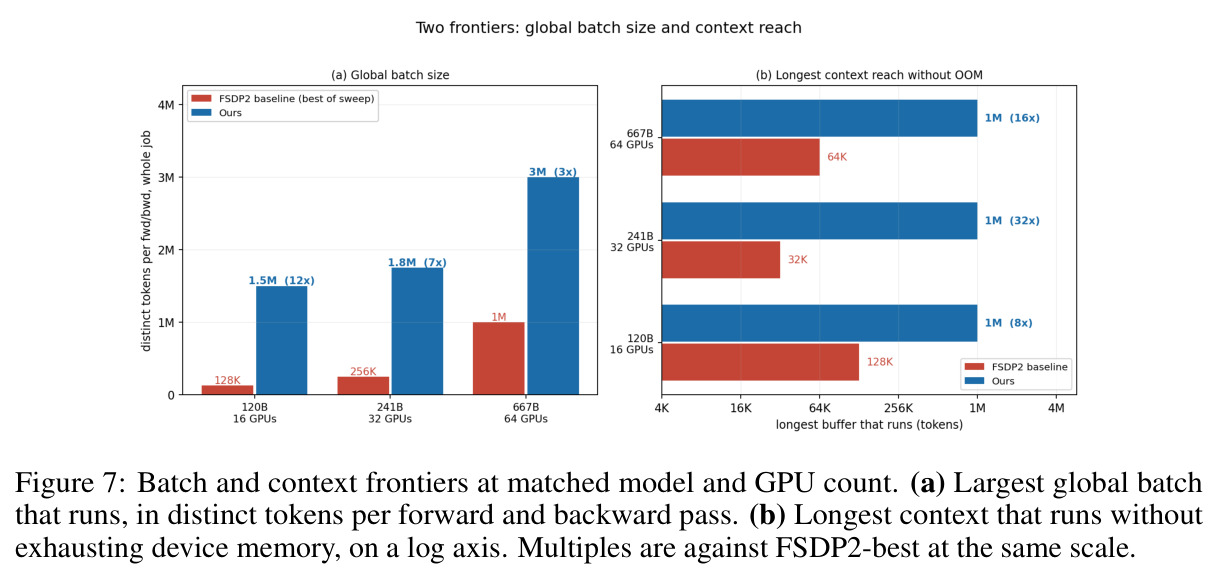
组件级对照实验(单节点 8×H200,字节级相同输入)逐一看:(1) PipelinedLLEP 在 65,536 tokens/rank、$H=7168$、top-8、$c=6554$($K=10$)下,分发峰值从 LLEP 的 52.7–53.0 GiB 降到 21.4–22.9 GiB(-56.9%~-59.3%),速度反而为 LLEP 的 1.01–1.10 倍;所有偏斜画像下标准 EP 全部 OOM。峰值节省随无界 live set 增大:128 tokens 时仅 9.0–11.0%,131,072 tokens 时达 63.4–65.9%。strided chunk 成员比连续成员快 1.03–1.35 倍、峰值低至多 1.37 GiB。含 backward 的复测(Table 9)确认 65K 形状峰值节省仍为 56.9–59.3%,速度 1.04–1.11×。(2) Ring-DTP 在 $P=8$、$H=7168$、$V=200{,}000$、FP32 下:$N=16{,}384$(auto 选搬激活)峰值 42.462→7.322 GiB(-82.8%),$N=32{,}768$(auto 选搬权重)79.521→10.622 GiB(-86.6%),延迟代价仅 4.4–5.1%;基线随 $N$ 翻倍近线性涨(42.5→79.5 GiB),Ring-DTP 只从 7.3 涨到 10.6 GiB。(3) SCO 峰值随 host 预算单调下降:139.790→123.728 GiB(全卸 47/47 边界),吞吐波动 <1.9% 无单调趋势,最大可跑 10-step batch 从 557,056 升到 655,360 tokens(边际增益 +17.65%)。(4) OffloadStreamAdamW 把优化器步从 CPU Adam 的 3.95 s 降到 1.93 s(2.05×),100M bucket + 2 slots、staging 仅 4.234 GiB/GPU,加深队列无增益,证明流水线受 $12\Theta/W$ 链路下限约束。端到端(120B/241B/667B,16/32/64 H200,MoP 布局,对照扫描调优的 FSDP2-best):组合栈在三个规模都训练到 1M 上下文,FSDP2-best 分别止步 128K/32K/64K,可达范围 8–32×;在基线可达的最长上下文处吞吐 7.6×(120B@128K)与 10.4×(667B@64K);每卡算术速率从 128K 的 91–110 TFLOP/s 升到 1M 的 213–233 TFLOP/s,基线全程 <40,匹配长度处为基线 2.2×(667B);最大全局批量 1.5M/1.8M/3M distinct tokens,为基线的 12×/7×/3×。质量验证:gpt-oss-20b 在 128K 上下文 SFT Nemotron-Math 后 AIME 2025 Avg@8 为 59.8%,与 FSDP2 基线的 59.6% 持平(微调前 45.2%),支持精确性声明。
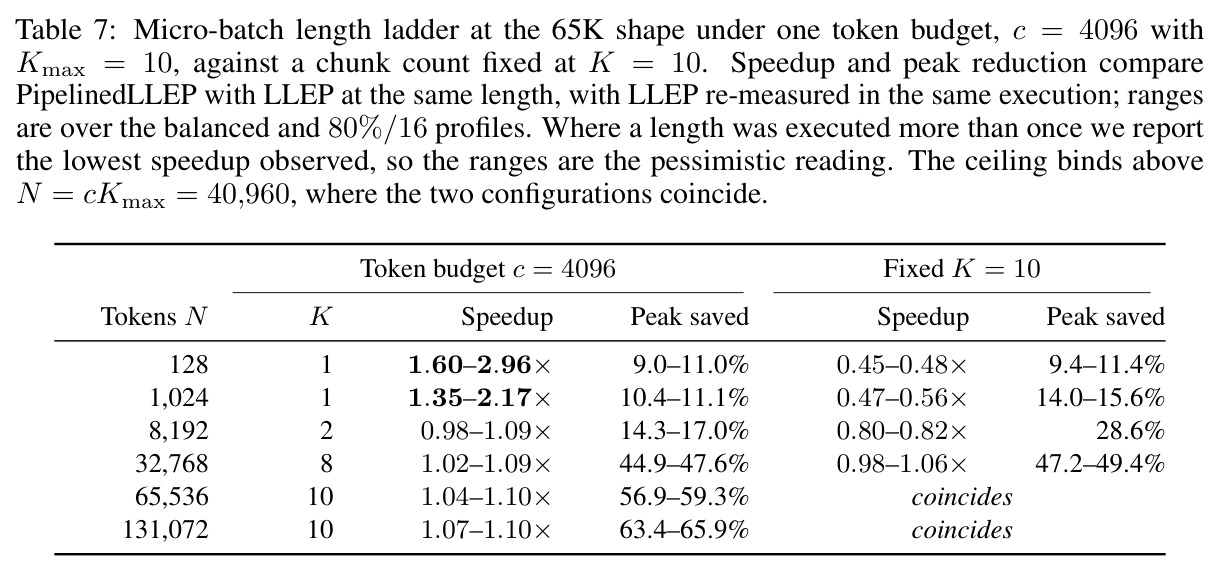
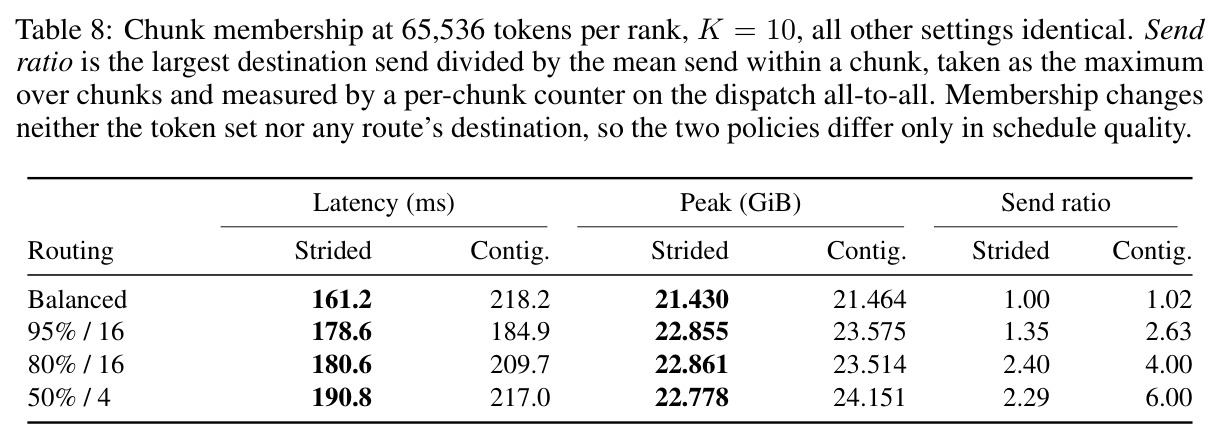
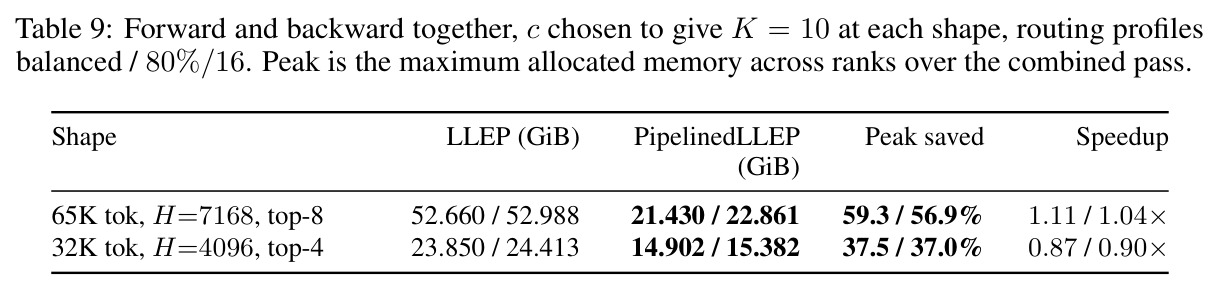
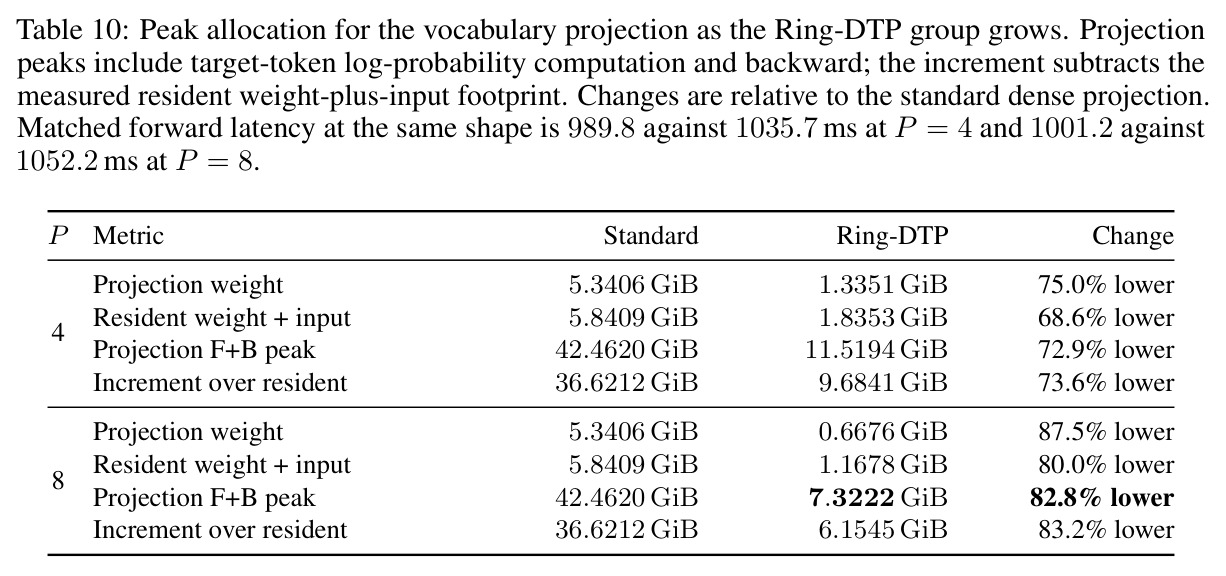
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MoE 专家分发峰值(65K tokens/rank, H=7168, top-8, K=10) | 峰值分配显存 | 21.4–22.9 GiB(PipelinedLLEP,strided) | 52.7–53.0 GiB(LLEP);标准 EP 在偏斜画像下 OOM | -56.9%~-59.3%,速度 1.01–1.10× |
| 词表投影(P=8, V=200K, N=32,768, FP32, 搬权重) | 前向+反向峰值显存 | 10.622 GiB(Ring-DTP) | 79.521 GiB(标准物化 logits+log-softmax) | -86.6%,延迟仅 +4.4% |
| 词表投影(P=8, N=16,384, FP32, 搬激活) | 前向+反向峰值显存 | 7.322 GiB(Ring-DTP) | 42.462 GiB(标准) | -82.8%,延迟仅 +5.1% |
| 检查点边界卸载(gpt-oss-20b, 8×H200, 557K tokens/step) | 峰值 HBM / 最大可跑 10-step 批量 | 123.728 GiB / 655,360 tokens(47/47 全卸载) | 139.790 GiB / 557,056 tokens(卸载关闭) | 峰值省 16 GiB,批量 +17.65%,吞吐波动 <1.9% |
| 卸载优化器步(gpt-oss-20b, fp32 状态在 host) | 每步优化器时间 | 1.93 s(GPU 流式更新,100M bucket × 2 slots,staging 4.234 GiB/GPU) | 3.95 s(ZeRO-Offload AVX CPU Adam) | 2.05× |
| 端到端最长上下文(120B/241B/667B, 16/32/64 H200) | 不 OOM 的最长训练上下文 | 1M tokens(三个规模均可) | 128K / 32K / 64K(FSDP2-best) | 8–32× |
| 端到端吞吐(基线可达最长上下文处) | 每卡 token 吞吐倍数 | 7.6×(120B@128K),10.4×(667B@64K) | FSDP2-best 同长度最优配置 | 最高 10.4× |
| 每卡算术速率(128K→1M 上下文) | TFLOP/s/GPU | 91–110 → 213–233 TFLOP/s | FSDP2-best 全程 <40 TFLOP/s | 匹配长度处 2.2×(667B) |
| 最大全局批量 | 每次前反向 distinct tokens | 1.5M / 1.8M / 3M | FSDP2-best 对应规模 | 12× / 7× / 3× |
| 训练质量(gpt-oss-20b @128K SFT Nemotron-Math → AIME 2025) | Avg@8 准确率 | 59.8%(组合栈) | 59.6%(FSDP2 栈);45.2%(未微调) | 持平,验证梯度/损失精确性 |
局限与改进
作者承认的局限:四个算子都占据"显存效率优先"的设计点,all-to-all 与环形流量假设快速互联——NVLink 上廉价的多次 chunk 启动在慢速网络上代价可能完全不同;token 预算 $c$ 越小接收界越紧但 chunk 数等比增多,而前向时间只在部分区间对 chunk 数平坦(Figure 8 显示 32K 形状 K>3 后延迟稳步上升),因此 $c$ 必须从实测曲线选取而非直接最小化;检查点与优化器流式消耗 host 内存与链路带宽,在 host 内存少于本文 2 TB 的节点上会受限;拓扑敏感性与 $(D,E_p,P,c,\beta)$ 的自动选择仍是开放问题。我自己的观察:其一,65K 形状存在由 host 端 launch 模式引起的双峰延迟(慢模式慢 12–56%,且插入诊断计数器会把慢模式在不同画像间移动),$K_{max}=10$ 部分是为绕开它,暴露了对 Python 层同步结构的工程敏感性;其二,端到端基线只有基于 TorchTitan 的 FSDP2 栈,未与 Megatron-LM/DeepSpeed 等生产栈对比;其三,预训练只验证吞吐与可行性(从头初始化的短程运行),长程收敛曲线未报告,质量验证是 128K SFT 的单点对比;其四,硬件门槛极高(多节点 H200 + 2 TB host RAM),结论对中小实验室适用性有限。
独立分析的弱点
独立分析的弱点与对应改进方向:(1) 关键超参全部手工扫出——$c$ 在 4,096–32,768 tokens/rank 间扫、bucket 100M 与 2 slots 从 Table 14 选——应构建以式 (6) 为约束、以实测带宽/算力为输入的代价模型,按模型与拓扑自动给出 $(D,E_p,P,c,\beta)$;(2) 双峰延迟源于 host launch 模式,且诊断手段(每 chunk host 同步)本身会移动慢模式,说明调度对 Python 侧同步过敏,改进方向是把 per-chunk 元数据交换与启动逻辑下沉到 C++/CUDA Graph,消除 host 序列化点;(3) move-weights 分支每跳 $O(HV/P)$ 字节、move-activations 每跳 $O(NH)$ 字节,在跨节点慢速互联上会成瓶颈,可做层级 ring(节点内 NVLink 全速轮转、节点间低频大块同步)或条带压缩;(4) SCO 的 pinned 预算按 micro-batch 会话管理,长上下文多会话并发时 pinned 内存可能碎片化,可引入统一 host 内存池与预算再平衡;(5) 端到端只在 dropless 路由 + DeepSeek-V3 无辅助损失均衡下验证,极端偏斜且允许 token drop 的场景未测,接收界虽与路由无关,但 chunk 数增多导致的时间退化在持续偏斜下可能被放大;(6) OffloadStreamAdamW 被 $12\Theta/W$ 的链路下限卡死,超大模型可探索动量/梯度的无损分块压缩传输或 NVMe 分层,但这会触及精确性声明,需要小心设计。
未来方向
作者明确指出的开放方向:拓扑敏感性建模,以及 $(D,E_p,P,c,\beta)$ 的自动选择。基于其成果还可延伸:其一,把四个算子做成主流框架(TorchTitan、Megatron-LM、DeepSpeed、vLLM 训练栈)的可插拔组件,式 (6) 天然适合做启动前可行性检查器与 OOM 预防告警,这对工程社区价值很大;其二,专家流行度的时序可预测性研究可让 chunk 预算与 LLEP 迁移计划提前一步预取,进一步隐藏流水线气泡;其三,"每源预算 + strided 成员 + 嵌套检查点"这一契约可推广到其他数据依赖的集合通信场景,如 MoE 推理 dispatch、稠密模型的序列 all-to-all、以及专家卸载/分层专家(expert offloading)系统;其四,1M 上下文与 3M 全局批量使长上下文后训练(论文引用的 Nemotron-Math 数学蒸馏正是此类)成为直接受益场景,可研究长上下文 RLHF/蒸馏在超大批量下的 scaling 行为;其五,在保持梯度精确的边界内探索优化器状态传输的压缩(如 fp8 动量存储 + fp32 计算的混合),逼近并突破 $12\Theta/W$ 链路下限;最后,双峰延迟现象本身值得一次系统性研究,可能揭示 Python 层调度与 NCCL/集合通信的深层交互问题。
复现评估
复现评估:论文正文与附录均未给出开源代码链接,未见明确的代码发布声明,这是最大的复现障碍。但论文给出的实现细节相当充分:四个算子均有完整伪代码(算法 1–4)、组件基准配置汇总(Table 5,含形状、dtype、预算、成员策略)、路由偏斜画像的精确定义与生成规则(附录 B.2)、梯度推导与正确性条件(式 7、附录 C/D)、以及全部原始测量表(Table 6–14),并报告了三重复验的峰值可重复到毫级 GiB、延迟散布 ≤2.6%——这种确定性对复现校验非常友好。数据方面:组件基准用公开的 gpt-oss-20b 与合成路由画像;端到端用自建的 120B/241B/667B 同构 MoE($H=7168$、384 专家、top-8、$V=200{,}000$、7/14/39 层),SFT 用公开 Nemotron-Math 数据,评测 AIME 2025。算力门槛:单节点 8×H200(141 GB)+ 2 TB host RAM 可复现全部组件实验与 20B 级实验;端到端需要 2–8 节点(16–64 H200)并从头预训练至 667B,成本极高,一般实验室只能复现组件级结论。实现高度依赖 PyTorch reentrant/non-reentrant 检查点的具体语义与 saved-tensor 钩子行为,跨版本移植需谨慎。总体评估:信息充分但无代码,组件级复现中等偏难,端到端复现需大厂级资源。
论文图表
单 rank 完整调度伪代码:$K$ 经 AllReduceMax 组内一致化;执行一次 LLEP 负载测量与专家权重迁移计划;chunk $i$ 按 strided 位置集 $\{i,i+K,i+2K,\dots\}$ 收集行并按目的地排序;一次合并的 all-to-all dispatch;reentrant 检查点包裹的分组专家矩阵乘;issue 下一 chunk 的 dispatch 预取;对称 all-to-all combine 与 top-k 归约;标量锚点保证权重迁移的 backward 每层只触发一次。
复现第一个算子的必要细节:嵌套检查点契约、strided 成员与梯度单次累加的落地方式全在这 14 行里。
前向伪代码:先对本地分片 fold 初始化状态;然后按 $N > V/P$ 分支——真则搬权重($P-1$ 跮环形轮转词表分片,逐条带 fold 后释放),假则搬激活(batch 与状态环绕,最后状态回到 home rank);FOLD 函数实现 $m'/z'/y_t$ 三标量递推;输出 $m+\log z-y_t$。
auto 模式双分支的精确定义:搬激活/搬权重的切换条件与各自的数据流是理解 Ring-DTP 可扩展性的核心。
会话级 SCO 伪代码:前向按预算依次判定边界是否卸载(拷贝流异步拷入、释放卡上副本、更新集合 $S$);最后一层若在 $S$ 中则立即启动恢复;backward 反向遍历,先等待当前边界的恢复、再启动前一个边界的预取、重计算并跑 backward、释放已用边界;结束时释放 $S$ 的 pinned 存储。
预取时序(用时一层、提前一层恢复)与 host 上限作为正确性条件(否则集体通信死锁)的实现细节都在此。
单 rank 伪代码:按参数顺序把状态分成 $G$ 个 ≤$\beta$ 参数的 bucket;逐 bucket 等待空闲 staging slot→传输流拷入主权重/动量/梯度→计算流做融合 AdamW 更新并刷新 bf16 工作权重→写回流把 fp32 状态拷回 host→写回事件完成后归还 slot。
三流旋转的精确调度是 2.05× 加速的来源,bucket 的 co-group 定义(哪些张量一起走)决定了最少传输字节数。