IntBMoE:将块级条件化融入专家组合的全参与混合专家 IntBMoE: Integrating Block-Level Conditioning into Expert Composition for Full-Participation Mixture-of-Experts
以有限码本预组合专家块并稀疏路由,同时实现全参与、稀疏执行与有界物化
前置知识
混合专家(Mixture-of-Experts, MoE)
MoE 用一个专家池加一个路由器替代稠密 FFN:路由器为每个 token 计算对全部专家的分数,决定哪些专家处理该 token、以什么权重混合其输出。这样可在总参数量增长的同时控制每个 token 的实际计算量,是 Switch Transformer、DeepSeek-V3 等大模型的核心扩展手段。
本文的动机、方法与全部基线都围绕 MoE 设计空间展开,不理解专家池-路由器结构就无法理解参与/执行/物化这三个关键量的含义。
Top-k 稀疏路由
路由器输出分数 $r_t \in \mathbb{R}^E$,经 softmax 归一化后只选分数最高的 $k$ 个专家执行,其余专家完全不参与计算。Top-1(Switch Transformer)到 Top-2(GShard、DeepSeek-V3)是常见配置,通常还需负载均衡辅助损失防止专家过载或闲置。
IntBMoE 保留了 token 级 Top-k 路由(默认 $k=2$),但选择的对象从专家换成了预组合的多层块,这正是其稀疏执行的来源。
超网络(Hypernetwork)
超网络不直接输出预测,而是生成另一个网络的参数。输入通常是条件嵌入,经小型 MLP 输出目标网络某层的权重或组合系数。若条件依赖输入样本,参数需随输入重新生成,代价高昂;若条件来自有限的静态码本,生成结果可预计算并缓存。
IntBMoE 的核心组件就是一个以码本嵌入为条件的共享超网络,生成值/门两路组合系数;其可缓存性正是全文贡献的基础。
参数物化(Materialization)与参数合并
物化指在运行时构建派生参数集。参数合并类 MoE(SMEAR、Lory)按路由系数对全部专家参数加权求和得到复合专家再执行,物化成本为 $O(GE|\theta|)$,其中 $G$ 是路由单元数——token 级条件下等于 token 数,显存随请求规模无界增长。
"有界物化"是本文三大目标之一,作者用有限码本把物化上界固定为 $K$ 个块,正是针对这一痛点提出的解法。
共享专家与 SwiGLU
共享专家是每个 token 无条件执行的公共路径,承载不需要按 token 区分的通用变换,DeepSeekMoE 首先将其与路由专家隔离。SwiGLU 是 LLM 常用 FFN 激活:$\mathrm{SwiGLU}(x)=\mathrm{SiLU}(xW_1)\odot(xW_2)$,门控线性单元能稳定提升模型性能。
IntBMoE 在路由块之外加了一个常开共享 SwiGLU 专家 $S(x_t)$,消融显示去掉它掉 0.44 个百分点,方法部分会频繁遇到。
研究动机
现有 MoE 设计在三个维度上互相耦合:对单个 token 而言,参与(participation)指有多少专家为其输出贡献知识,执行(execution)指实际需要计算多少个专家(决定计算量),物化(materialization)指需要构建并存储多少个专家规模的参数集(决定显存)。稀疏路由方法(如 Switch Transformer、DeepSeek-V3 MoE)每 token 只激活 1-2 个专家,执行和物化很低,但未选中专家既不影响该 token 输出也收不到学习信号,参与被压缩;稠密输出混合方法(如 MMoE、Soft MoE)让全部专家参与,但执行成本随专家数线性增长;参数合并方法(如 SMEAR、Lory)把全池合并成一个复合专家只执行一次,但每个路由单元都要构建一份专家规模的合成参数,token 级 SMEAR 的物化成本为 $O(GE|\theta|)$,随路由单元数 $G$ 无界增长。三者构成无法同时满足的三角约束,这是本文要打破的死结。
本文的目标是本文的核心目标是让每个 token 都能受益于完整专家池(全参与),同时不需要稠密执行全部专家,也不产生随路由决策数无界增长的参数物化。形式化地说,希望参与度覆盖全部 $E$ 个专家、执行保持稀疏(每 token 只算 $k$ 个单元)、物化被一个与路由决策无关的上界(码本大小 $K$)约束,并且这三个量可以被独立设置而非耦合。此外作者还瞄准真实生产落地:在 AMap 生成式推荐系统 60ms 延迟预算内完成在线服务,因此推理时能预计算并缓存组合参数、把合成开销移出请求路径,也是设计目标的一部分。
与已有工作不同的是,本文的独特切入是把"专家变换的构造"与"在 token 上的执行"拆成两个独立阶段,并让条件信号来自一个有限、与输入无关的码本而非 token 本身。超网络不再像 token 级 SMEAR 那样对每个 token 现场合并全池参数,也不像 HyperMoE 那样为每个 token 生成 HyperExpert,而是只对 $K$ 个可学习码本嵌入各生成一份组合配方,把逐层专家基融合成 $K$ 个可复用、可预计算的多层块;token 层面再用 Top-k 路由稀疏地选中其中几个块执行。这样参与是全池的(每个块都由全部 $E$ 个专家基组合而来)、执行是稀疏的(每 token 只算 $k$ 个块)、物化是有界的(码本固定为 $K$),三个量第一次被同时解耦。
核心方法
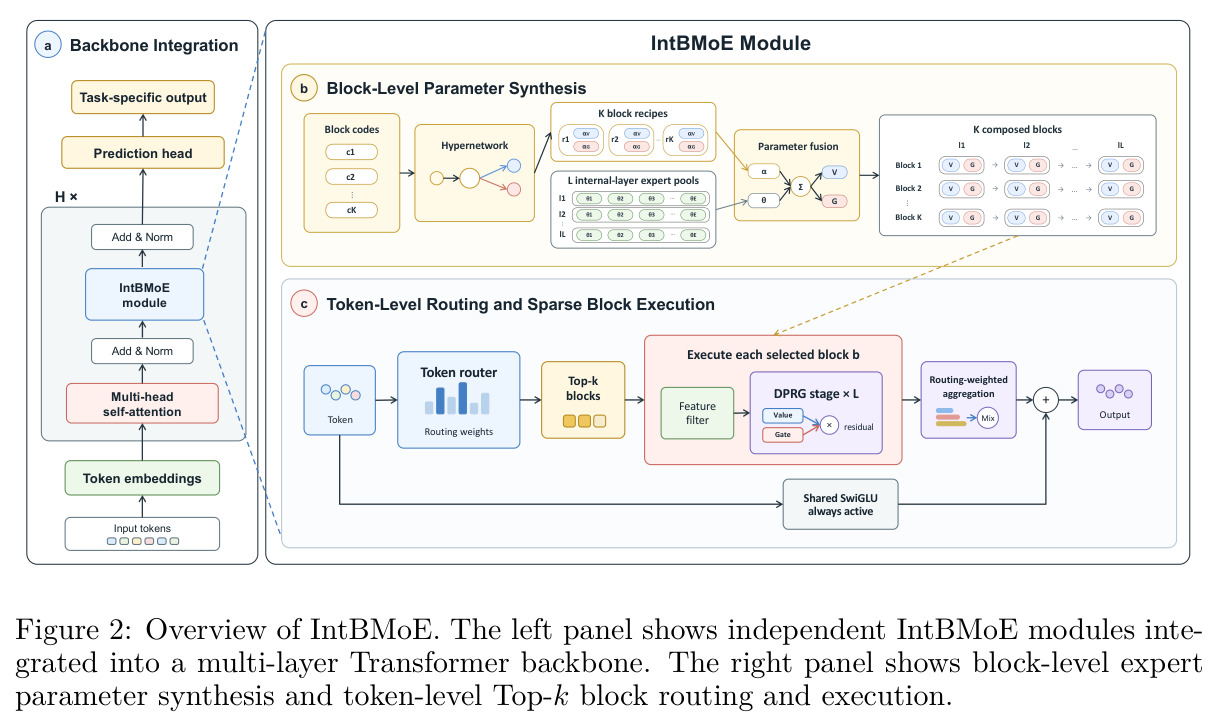
先说直觉:与其让每个 token 现场把全部专家"搅拌"成一个复合专家(SMEAR 的做法,代价高昂),不如提前把专家池预调成 $K$ 种风味各异的积木块,token 只需从积木盒里挑 $k$ 块来用。技术上,IntBMoE 作为 FFN 子层的替换模块嵌入 Transformer:每个模块维护 $K$ 个可学习码本嵌入 $c_b$;一个共享超网络 $h_\phi$ 把每个嵌入映射为值路径和门控路径两组组合系数 $\alpha^V_b, \alpha^G_b \in \mathbb{R}^E$;系数按 $1/\sqrt{E}$ 方差保持缩放后,对 $L$ 个内部层各自的专家池加权求和,得到 $K$ 个与 token 无关、可预计算的 $L$ 层复合块。推理时路由器为每个 token 选 Top-$k$ 块,先用码本嵌入做特征过滤给每个块不同的输入视角,块内经 DPRG 逐层处理,输出按路由概率加权聚合,再加一个常开的共享 SwiGLU 专家。合成成本 $O(KED)$ 一次付清,执行成本 $O(TkD)$ 与 $E$ 解耦。
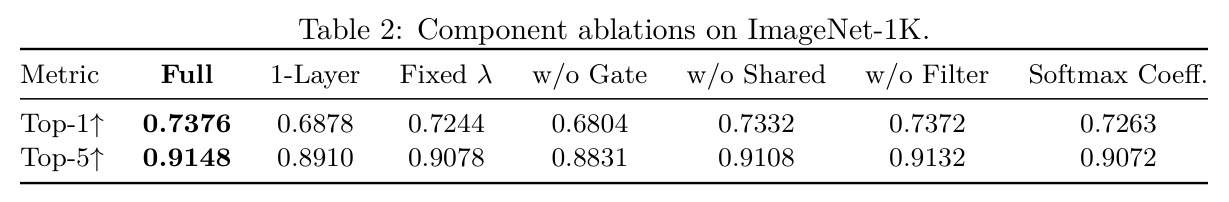
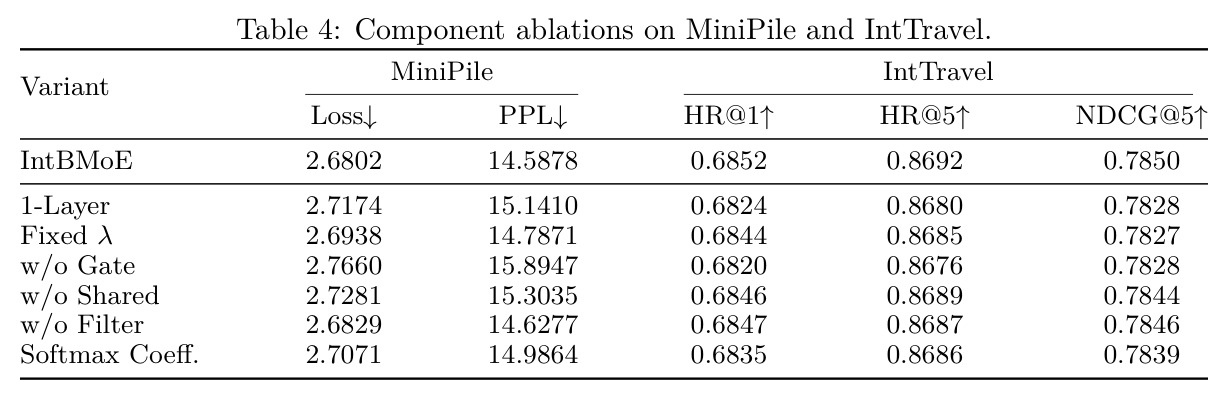
核心创新是把 MoE 的三个成本量——参与、执行、物化——从耦合变为独立可调,关键机制有二。其一,条件化发生在"块"这一中间粒度:码本嵌入是有限、输入无关的可学习参数,超网络据此生成的复合块可在推理前一次性物化并缓存,物化上界由 $K$ 固定、与路由决策次数完全无关;而每个块又融合该层全部 $E$ 个专家基,保证全池参与。其二,DPRG 双路径残差门控:把同一专家池分别组合成值路径和门控路径,以 $\tilde{z}=v\odot(1+\lambda\,\mathrm{SiLU}(g))$ 的残差乘性调制耦合,使复合参数虽由线性合并构成、但作用到 token 时是非线性的,弥补线性合并的表达力损失且只增加常数因子开销。消融显示去掉门控路径掉点最大(ImageNet Top-1 从 73.76% 跌到 68.04%),证明非线性耦合是性能关键。
方法步骤详情
流程六步。(1) 配方生成:码本 $C=\{c_b\}$ 共 $K$ 个嵌入;共享超网络算 $q_b=\mathrm{ReLU}(\mathrm{LN}(Ac_b+a))$,再经两个线性头输出 $\alpha^V_b,\alpha^G_b\in\mathbb{R}^E$,系数不做 softmax、可为负。(2) 逐层合成:第 $\ell$ 层按 $W^{b,p}_{(\ell)}=\frac{1}{\sqrt{E}}\sum_e \alpha^p_{b,e}W^{(\ell)}_e$ 把 $E$ 个专家基合成值/门两套参数,重复 $L$ 层得块 $b$;因与输入无关,推理前可一次预计算并缓存。(3) token 路由:两层 ReLU MLP 输出 $r_t\in\mathbb{R}^K$,取 Top-$k$ 得 $B_t$,权重 $\pi_{t,b}=\mathrm{softmax}(r_t)_b$。(4) 特征过滤:$z^{(0)}_{t,b}=x_t\odot\mathrm{sigmoid}(W_f[x_t\|c_b]+b_f)$,让每个块看到 token 的不同视图。(5) DPRG 执行:$\tilde{z}^{(\ell)}=(W^{(\ell)}_{b,v}z+b^{(\ell)}_{b,v})\odot(1+\lambda\,\mathrm{SiLU}(\mathrm{RMSNorm}(W^{(\ell)}_{b,g}z+b^{(\ell)}_{b,g})))$,层间 LayerNorm,$L$ 层后得 $F_b(x_t)$。(6) 聚合:$y_t=\sum_{b\in B_t}\pi_{t,b}F_b(x_t)+S(x_t)$,$S$ 为常开共享 SwiGLU 专家;训练时全 batch 共享同一组合,合成成本摊薄。
技术新颖性
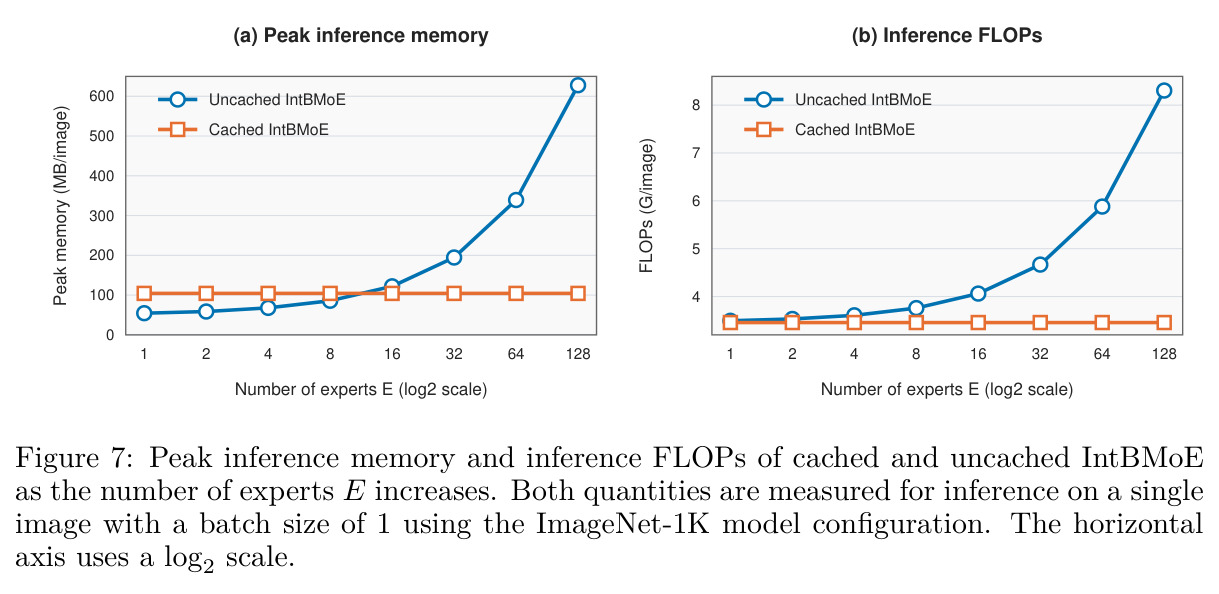
与最相近工作的本质区别:SMEAR 的 token 级形式对每个 token 现场合并全池参数,物化 $O(GE|\theta|)$ 随 token 数无界增长且无法预计算;Lory 用因果分段降低合并频率,但段内所有 token 共享同一组合,牺牲了 token 级适应性;HyperMoE 为每个 token 生成条件化 HyperExpert,条件依赖输入、不可缓存;DSFNet 做输入条件参数合并构造场景特定网络。IntBMoE 反其道而行——把条件信号固定为有限码本,用"预组合 + 稀疏选择"替代"现场组合",首次让物化界与路由决策解耦,使请求时内存与计算不随专家池大小 $E$ 增长(实验中缓存后恒为 104.33MB、3.457 GFLOPs,$E$ 从 1 到 128 不变)。DPRG 则不同于 SMEAR 的纯线性加权:值/门双路径乘性调制引入非线性,同时不扩大专家池。
实验结果
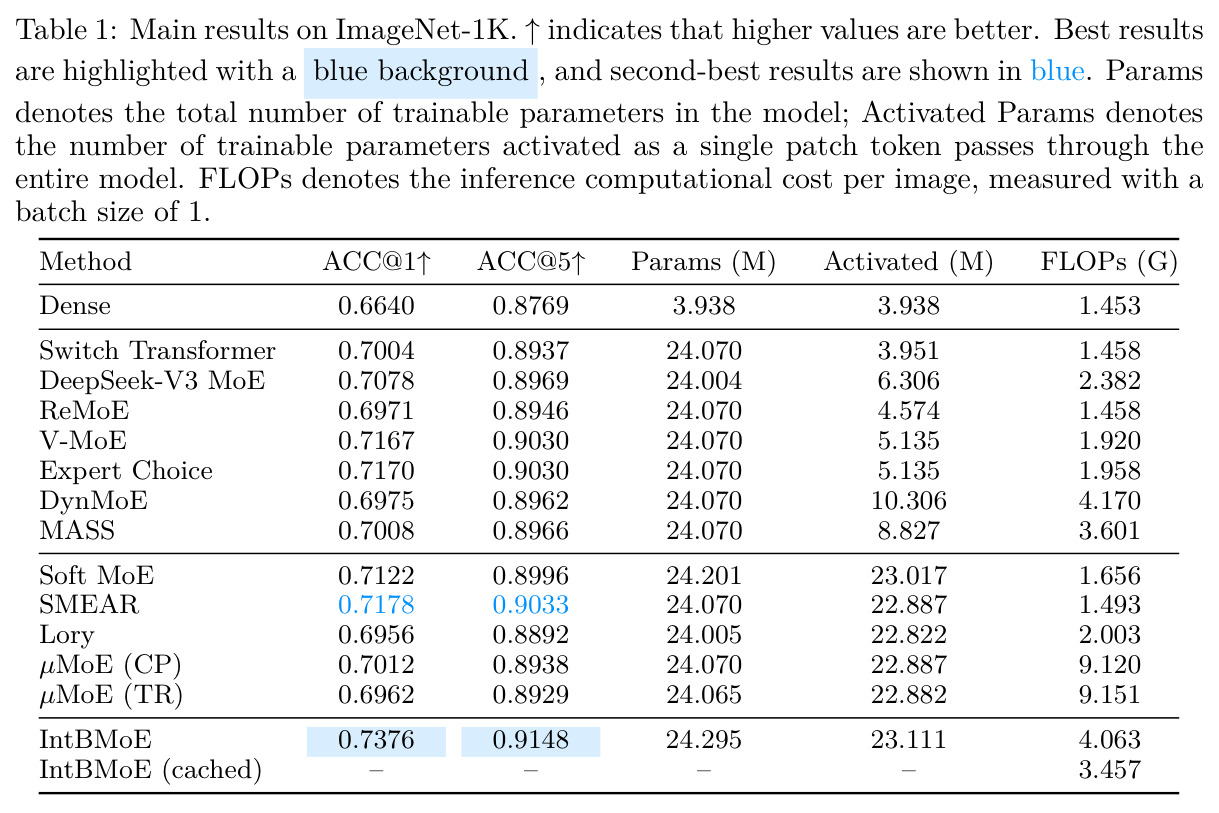
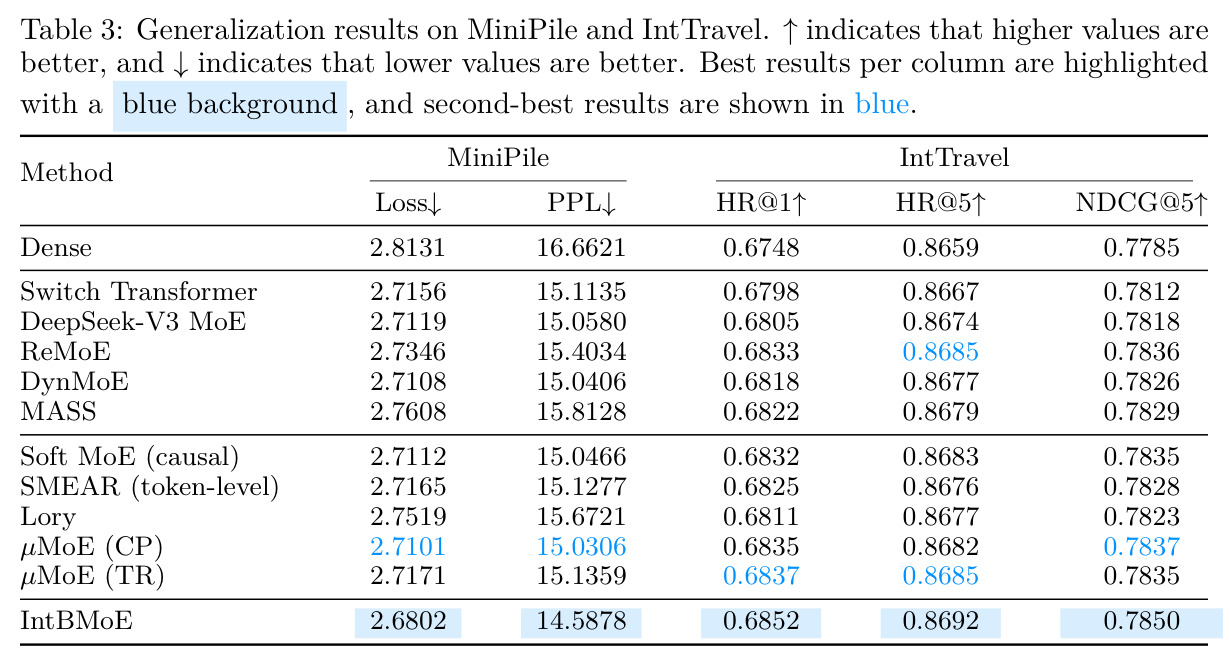
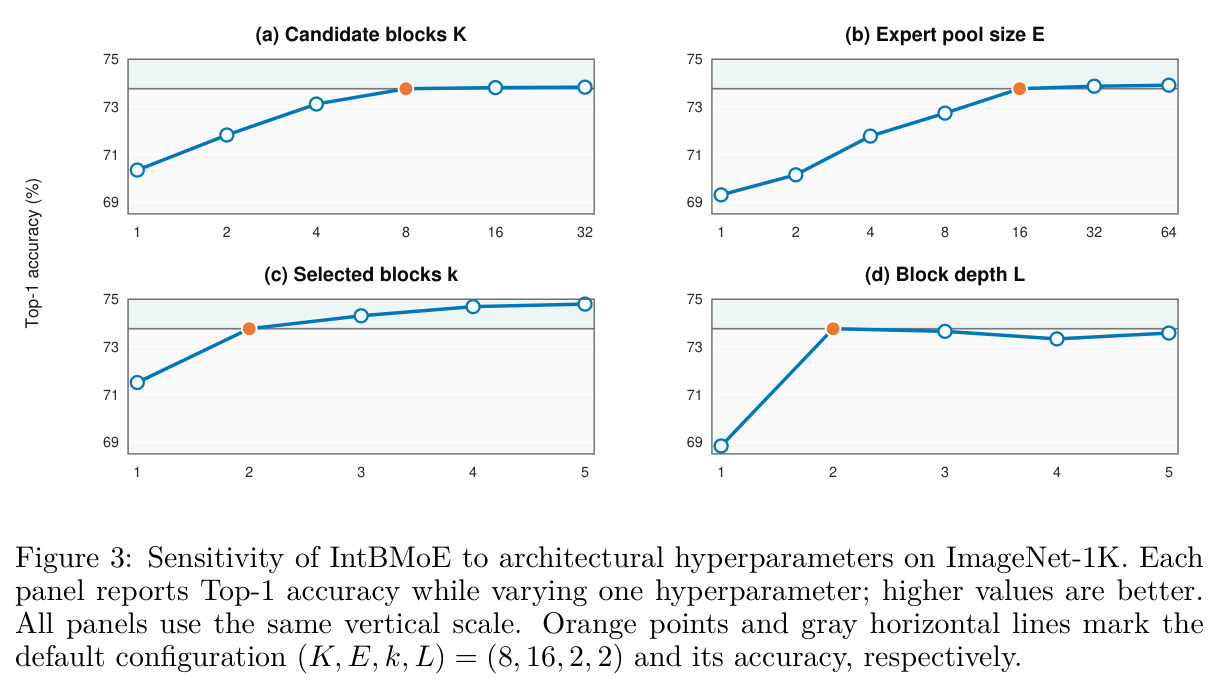
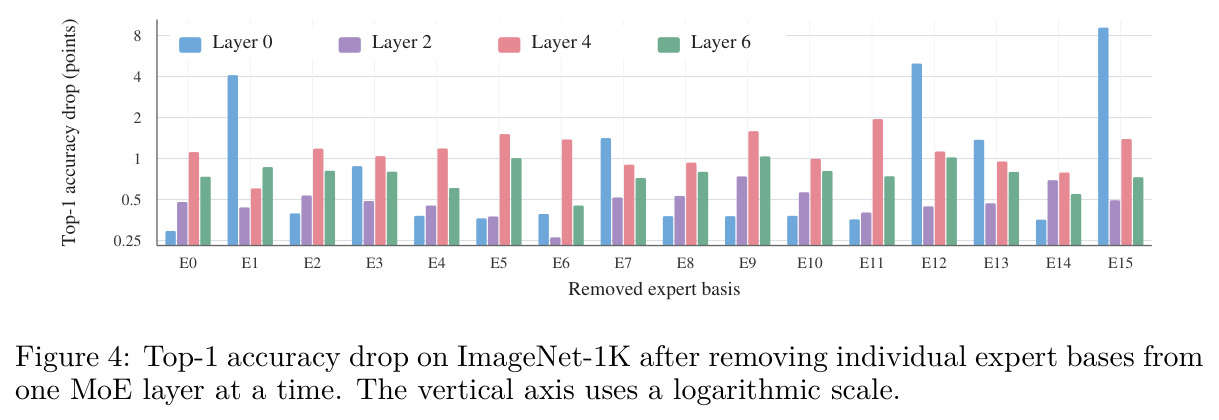
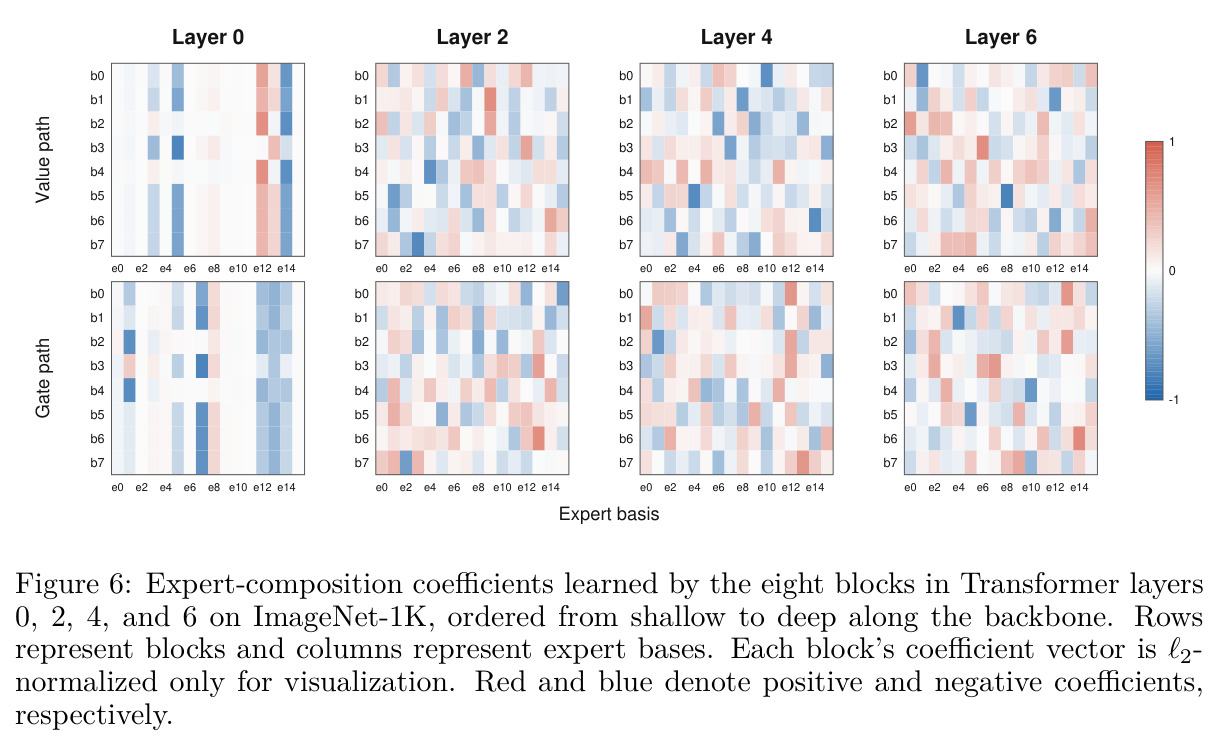
ImageNet-1K 主实验(8 层 DeiT-Tiny、约 24M 参数、三种子均值):IntBMoE 取得 73.76% Top-1 / 91.48% Top-5,比稠密基线(66.40%/87.69%)高 7.36/3.79 个百分点,超最强基线 SMEAR(71.78%/90.33%)1.98/1.15 个百分点,也领先 Switch Transformer 70.04%、DeepSeek-V3 MoE 70.78%、V-MoE 71.67%、Soft MoE 71.22% 等;代价是激活参数 23.111M、未缓存 4.063 GFLOPs,缓存后降至 3.457。消融中去门控路径降幅最大(68.04%),其次单层块 68.78%、softmax 系数 72.63%、固定 $\lambda$ 72.44%、去共享专家 73.32%、去过滤 73.72%。超参默认 $(K,E,k,L)=(8,16,2,2)$:$K$ 8→32 仅 +0.07pp,$E$ 16→64 仅 +0.15pp,$L=2$ 最佳。专家移除实验覆盖第 0/2/4/6 层 64 个专家基,全部造成掉点(层均值 1.60/0.49/1.17/0.78pp,第 0 层移除 $E_{15}$ 达 9.15pp),证实全池参与有效。MiniPile:损失 2.6802、PPL 14.5878,比 $\mu$MoE(CP) 低 2.9%、比稠密低 12.4%。IntTravel:HR@1 0.6852、HR@5 0.8692、NDCG@5 0.7850 均第一。线上 AMap:约 5000 QPS,平均 19ms、P99 38ms(预算 60ms),UVCTR 相对 +2.4%,已全量部署。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-1K 图像分类 | Top-1 准确率 | 0.7376 | SMEAR 0.7178(最强基线);稠密 0.6640 | +1.98pp vs SMEAR;+7.36pp vs 稠密 |
| ImageNet-1K 图像分类 | Top-5 准确率 | 0.9148 | SMEAR 0.9033 | +1.15pp vs SMEAR |
| MiniPile 因果语言建模(18 层 Llama 风格) | PPL(越低越好) | 14.5878 | $\mu$MoE(CP) 15.0306;稠密 16.6621 | 相对最强基线降 2.9%,相对稠密降 12.4% |
| IntTravel 序列推荐(1.628 亿用户、730 万 POI) | HR@1 | 0.6852 | $\mu$MoE(TR) 0.6837 | +0.0015,列第一 |
| IntTravel 序列推荐 | NDCG@5 | 0.7850 | $\mu$MoE(TR) 0.7837 | +0.0013,列第一 |
| AMap 生成式推荐线上 A/B(首页地图推荐) | UVCTR 相对提升 / 延迟 | +2.4% UVCTR;均延 19ms、P99 38ms | 无 MoE 的现有生产模型 | 约 5000 QPS 下满足 60ms 预算,已全量上线 |
局限与改进
从数据可见的局限:(1) 全参与的代价是激活参数高达 23.111M(稠密仅 3.938M、多数稀疏方法 4-10M),未缓存 FLOPs 4.063G 也明显高于 SMEAR 的 1.493G,算力受限场景必须依赖缓存与硬件优化;(2) 主实验规模小——DeiT-Tiny 级 8 层骨干、MiniPile 仅 6GB 语料,尚未验证大规模 LM 预训练上的表现;(3) 码本大小 $K$ 训练后固定,块集合是静态的,无法随任务分布漂移动态增删;(4) 特征过滤增益很小(去掉仅从 73.76% 降到 73.72%),组件性价比存疑;(5) 专家移除实验用 $1/\sqrt{E-1}$ 做尺度补偿属启发式做法。另外 IntTravel 为高德内部数据集,外部研究者无法复现其推荐与线上 A/B 结果。
独立分析的弱点
独立分析来看:其一,训练期合成成本 $O(KED)$ 虽可摊薄到 batch,但当 $E$、$K$ 与层数都大时仍是显存与带宽瓶颈,可探索低秩分解的专家基或分块流式合成;其二,Top-k 路由只选块不选层内专家,粒度比 DeepSeekMoE 的细粒度专家分割更粗,超大模型上可能限制专业化程度,可引入层级路由(先选块、块内再选专家);其三,缓存策略在批量并发服务下的共享、淘汰与显存预算未讨论,生产环境需要 LRU、分片等工程方案;其四,正文未说明负载均衡损失的具体形式,$K=8$ 的块路由存在倾斜风险;其五,码本嵌入与 token 表示联合训练可能出现码本坍缩(多个嵌入学成相近配方),可借鉴 VQ-VAE 的 EMA 更新或正交正则来稳定训练。
未来方向
作者在结论中隐含的方向包括向更大规模语言模型扩展(目前仅 MiniPile 级别)与进一步优化服务效率。基于成果可延伸的:把码本做成可增长结构,新任务/新域动态加入新块、淘汰旧块,实现终身学习式 MoE;将 IntBMoE 与量化、低秩专家基结合,进一步压缩 $O(KED)$ 的存储与合成开销;把块级条件化扩展到注意力子层或多模态骨干;对 $K$、$E$、$k$、$L$ 做自动神经架构搜索以替代手工网格;理论上分析线性组合专家基的函数空间覆盖能力与门控非线性化带来的表达力增益;在多机推理下研究块缓存的一致性、放置与热更新策略。
复现评估
代码开源于 https://github.com/AMAP-ML/DreamX-Rec/。ImageNet-1K 与 MiniPile(公开的 6GB Pile 去重子集)均为公开数据;视觉实验用 8 层 DeiT-Tiny 骨干、约 24M 参数、从零训练并报告三随机种子均值,附录 A 提供完整配置,算力应在单机多卡量级,复现视觉与语言实验难度中等偏低。主要困难在于:IntTravel(1.628 亿用户、730 万 POI、41.3 亿交互)是高德内部数据,推荐实验无法外部复现;线上 A/B(约 5000 QPS、阿里 T-Head PPU、19ms 均延)依赖内部基础设施;缓存实现与 PPU 适配等工程细节也非公开,开源仓库可能只覆盖研究部分。
论文图表
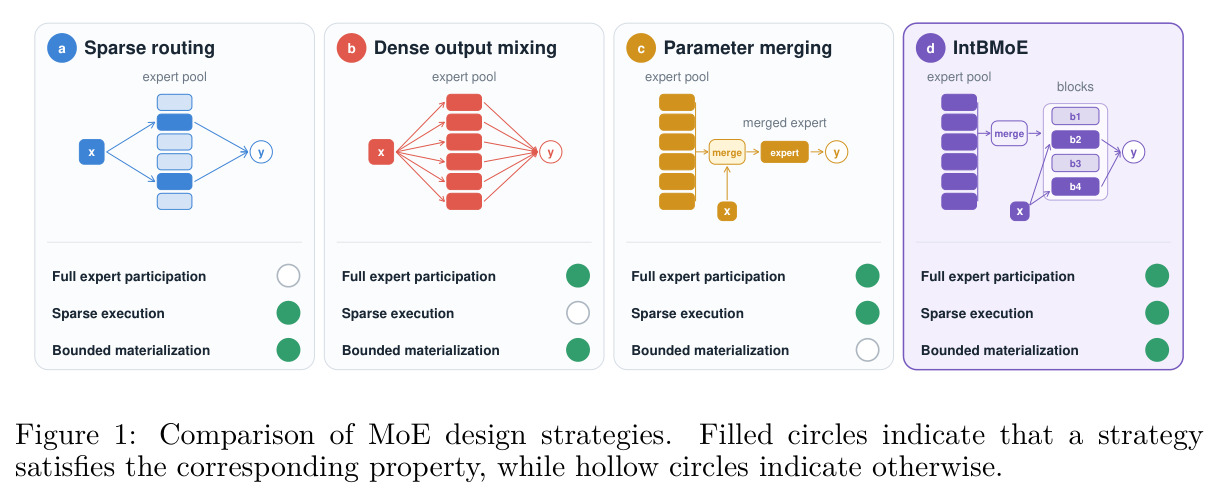
用四列示意图对比稀疏路由、稠密输出混合、参数合并与 IntBMoE 四种 MoE 设计策略,并对"全专家参与、稀疏执行、有界物化"三条性质逐项打勾:前三种策略各自缺一条(稀疏路由缺全参与、稠密混合缺稀疏执行、参数合并缺有界物化),只有 IntBMoE 三条全部满足。
这是全文动机的浓缩:一眼看清三种现有设计各自的耦合缺陷,以及 IntBMoE 如何同时满足三条性质,是理解论文定位的钥匙。