StepAudio 3 Realtime:面向实时全双工语音交互的音频语言基座模型 StepAudio 3 Realtime Technical Report
以听-说-思-行循环统一深度感知、全双工话轮管理与边想边说推理的实时语音基座
前置知识
全双工语音交互(Full-Duplex)
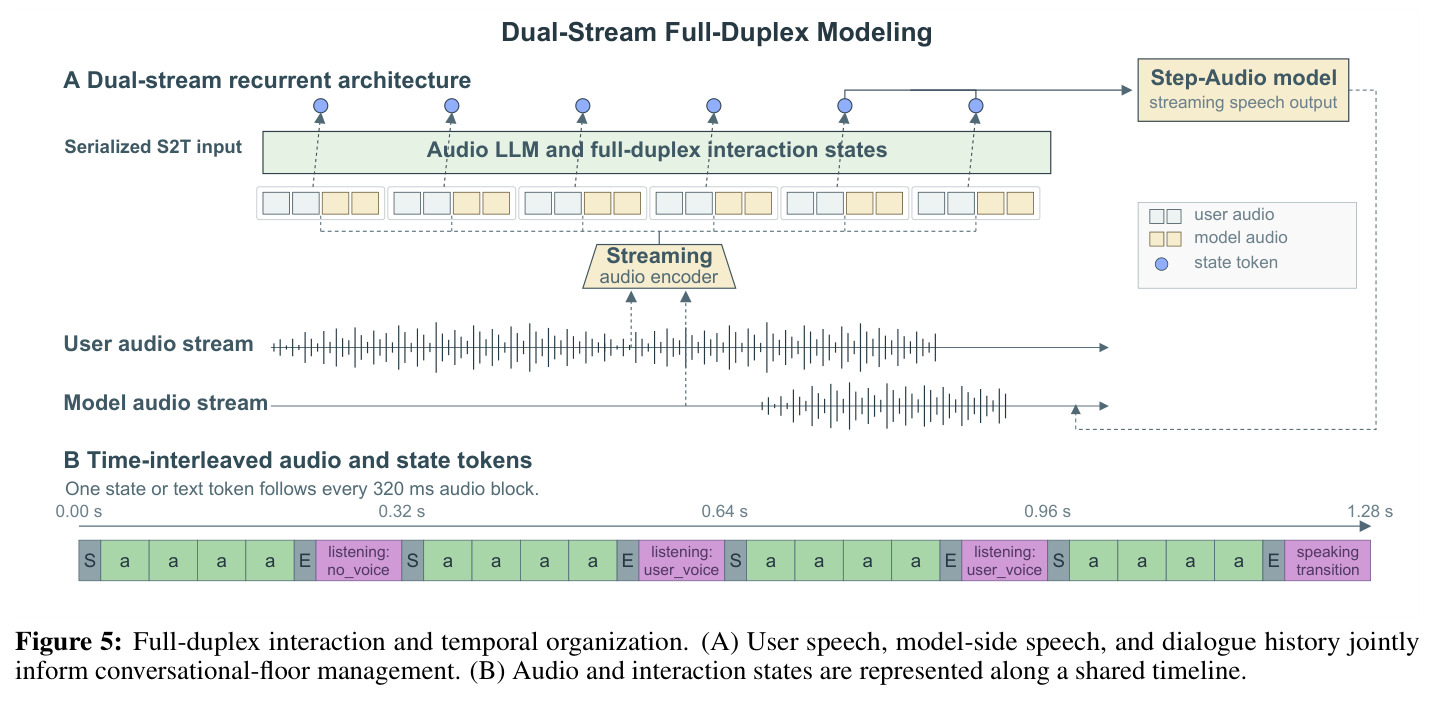
指用户与模型可以同时说话、同时倾听的交互模式,区别于'一方说完另一方才能开口'的半双工对讲。系统需要实时判断用户当前话轮的角色:是在句中停顿、在附和(如'嗯''对')、还是实质性打断,并据此决定自己继续听、继续说还是让出话轮。本文用用户与模型两路音频流加状态 token 的序列建模实现这一能力。
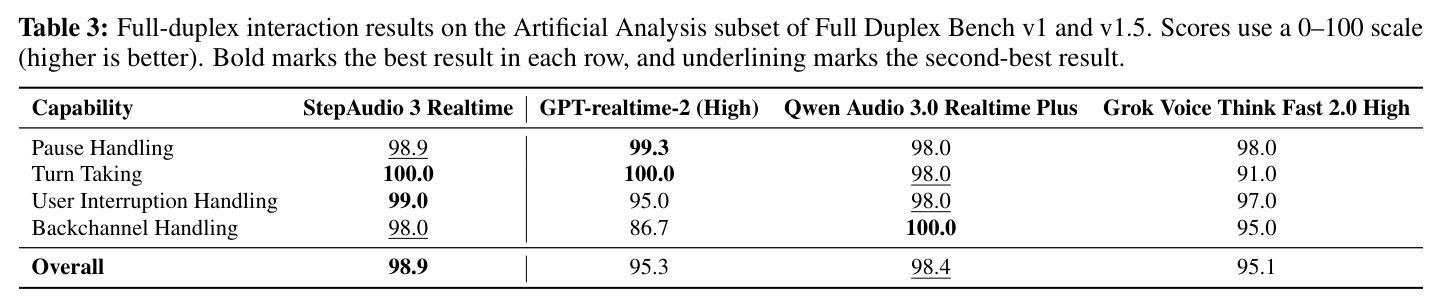
本文的核心卖点 Seamless Duplex 就是全双工话轮管理,AA Full-Duplex Bench 98.9 分的解读完全依赖这一概念。
Think-While-Speaking(边想边说)
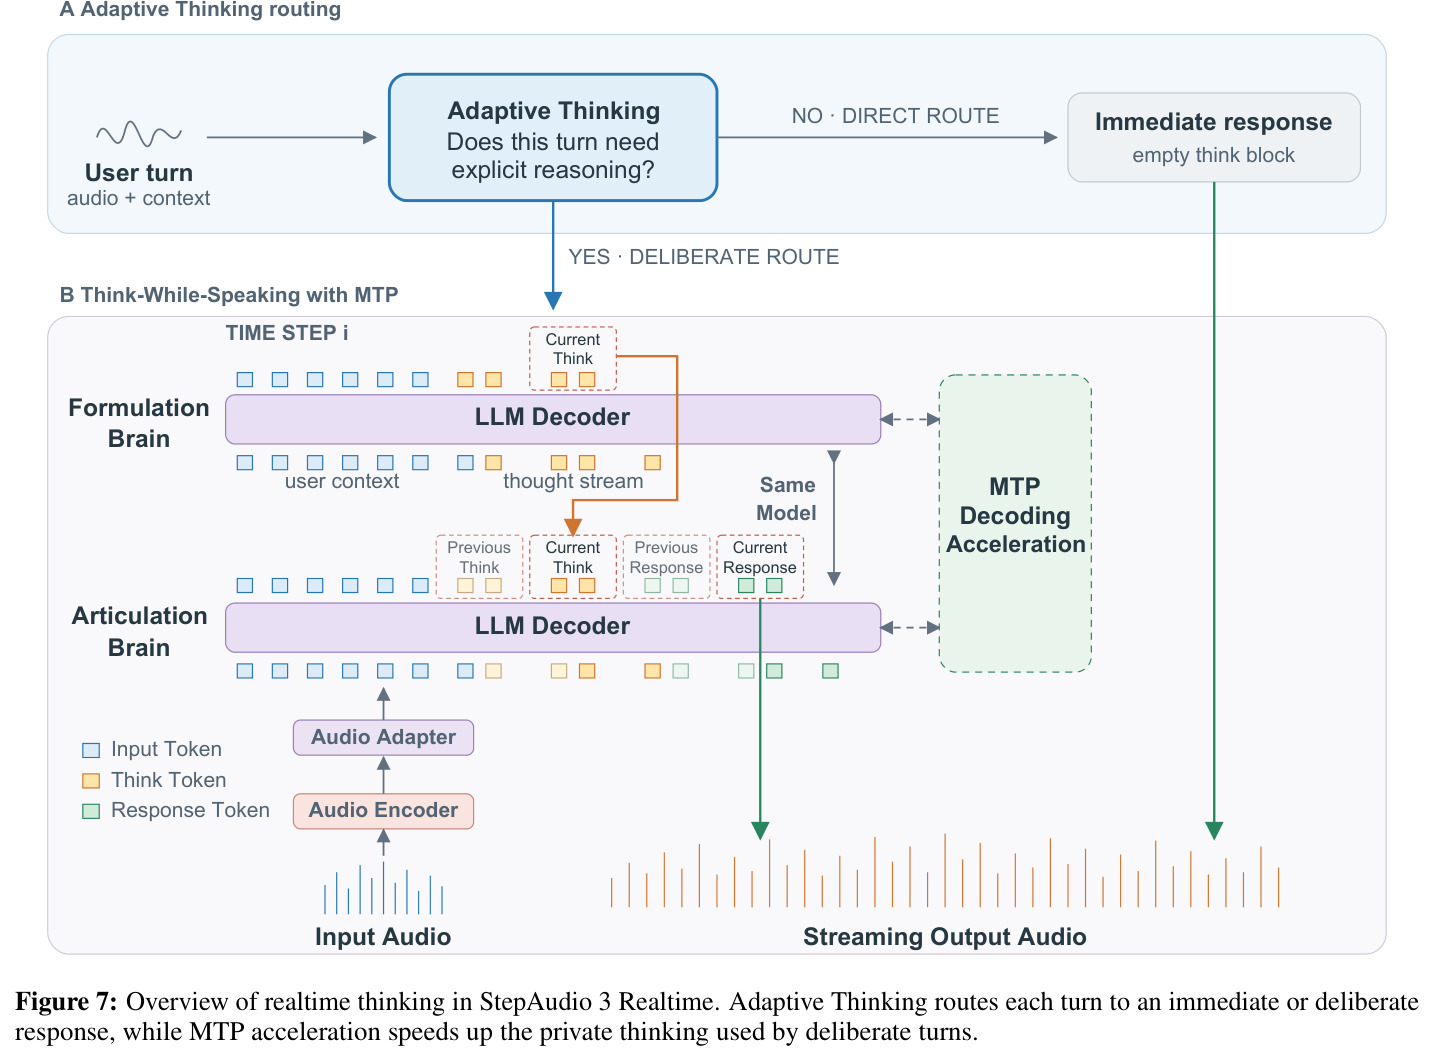
一种让私有推理与语音播报并行的解码调度:'构思脑'持续生成推理轨迹,'发音脑'基于已有推理和已说内容分段产出可朗读的响应片段,按流式音频播放进度放行。默认先说后想(Speak-First),推理完成后可用后续语句补充或修正开头,源自 Mind-Paced Speaking 双进程设计。
它是解决'推理深度与首响延迟不可兼得'这一全文核心矛盾的关键机制,第 6.3 节与 Figure 7 全部围绕它展开。
多 Token 预测(MTP)与投机解码
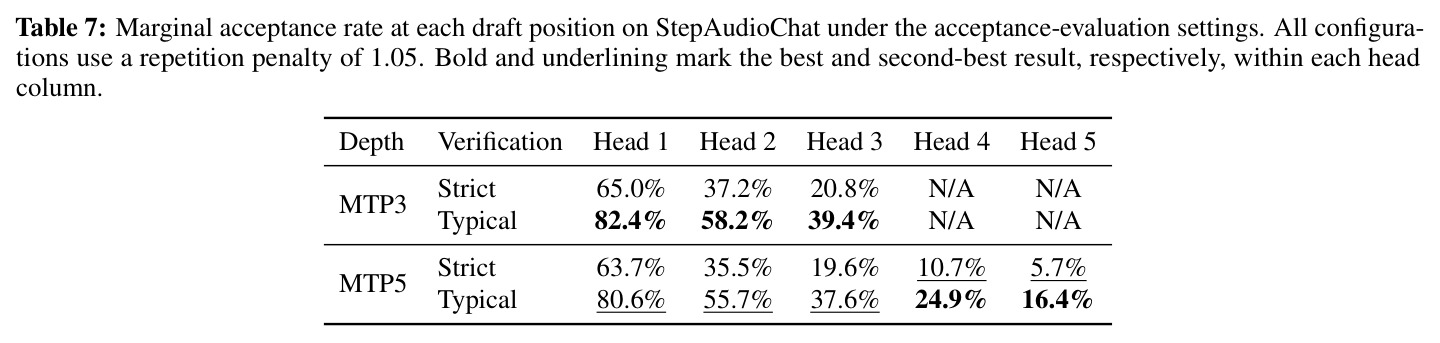
投机解码用多个预测头一次起草若干候选 token,再由目标模型并行验证,接受则一步前进多个 token,从而加速解码。严格验证要求草稿与目标分布完全一致;Medusa 式典型接受以熵自适应阈值放行'合理但非最优'的草稿,接受率更高但会改变生成分布。本文用 MTP3 加速私有思考流。
Table 6/7 的墙钟加速比与逐头接受率都建立在此概念上,是理解实时推理提速方案的前提。
混合专家架构(MoE)
将 Transformer 的前馈层替换为多个专家网络,由路由器为每个 token 只激活其中少数几个,从而在总参数量很大的情况下保持单 token 计算量可控。本文模型总参数约 196B、每 token 仅激活 11B,语言底座为 Step 3.7 Flash,兼顾大模型容量与实时推理的算力预算。
MoE 决定了模型容量与部署成本之间的权衡,也是'实时说话模式下仍能深度推理'在工程上可行的前提。
模型合并(Model Merging)
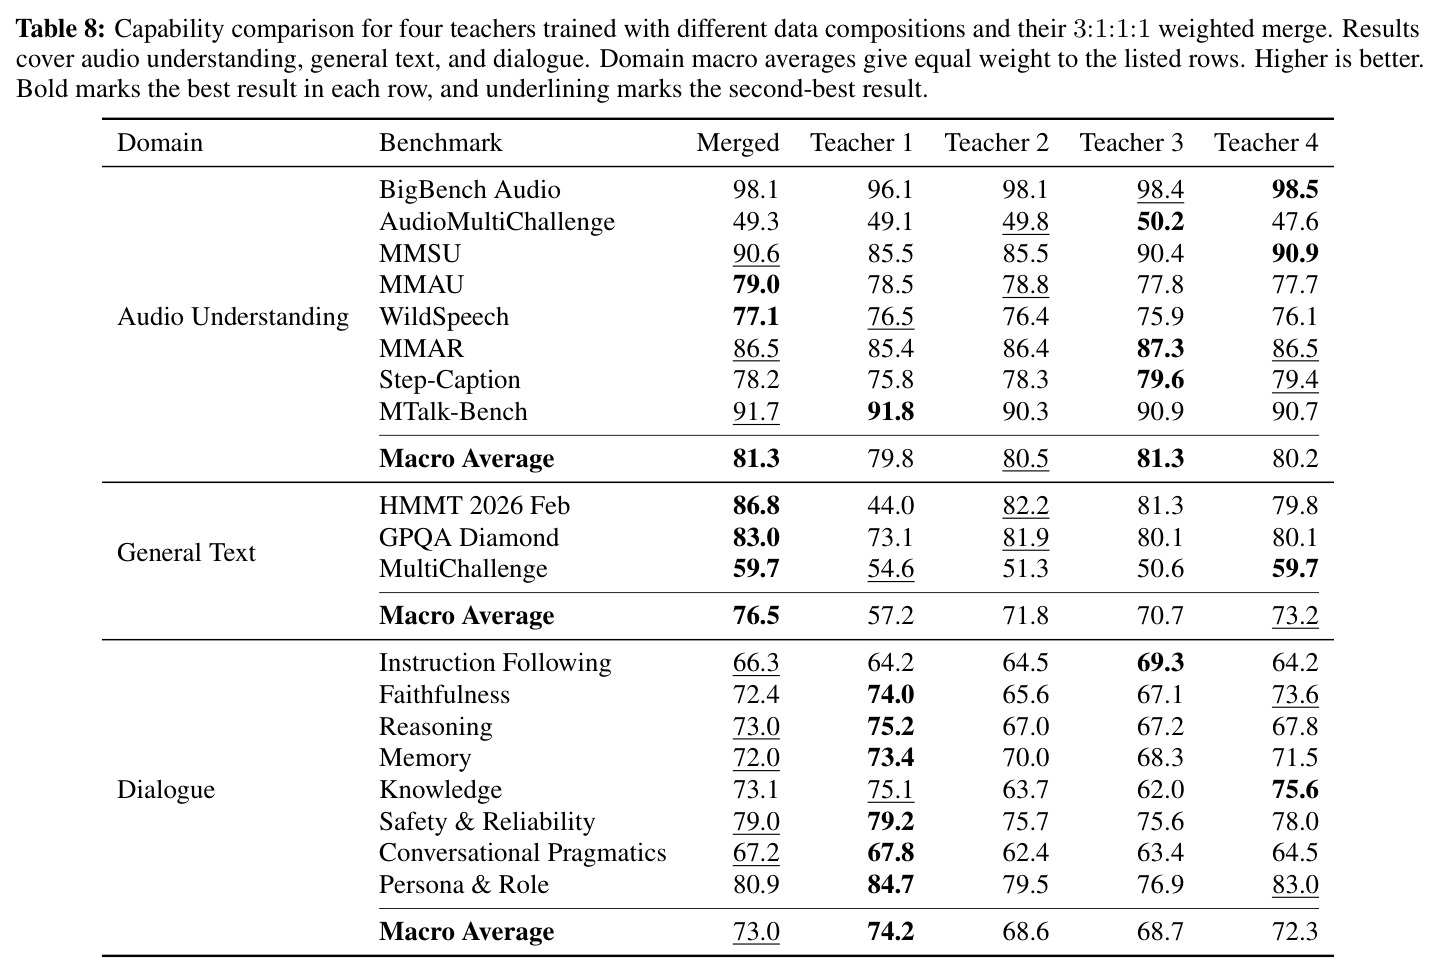
把多个在不同数据配比上训练的教师模型在参数空间直接加权平均:$\theta_{merge} = \sum_i \alpha_i \theta_i$,$\alpha_i \ge 0$ 且和为 1。教师来自同一基座、参数对齐,合并后无需推理期路由即可融合互补能力。本文以 3:1:1:1 权重合并四教师。
第 6.4 节靠合并整合多轮对话、音频理解与文本推理能力,Table 8 验证了它的收益与代价。
研究动机
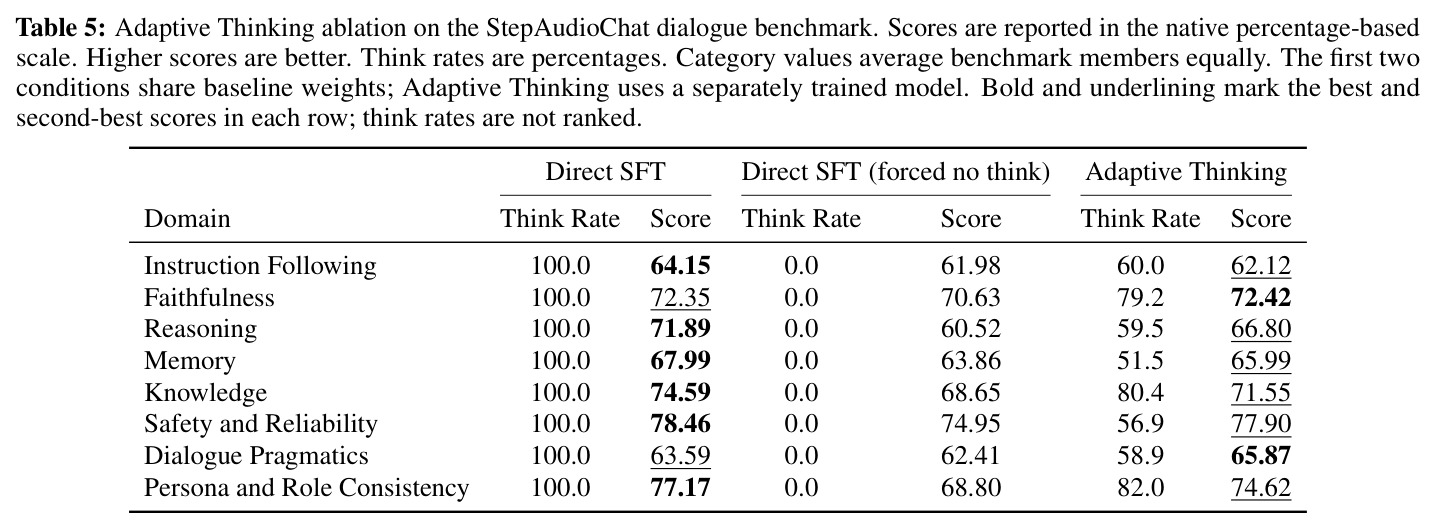
实时语音交互长期面临'反应快'与'想得深'的矛盾。级联式方案(ASR→LLM→TTS)本质上是半双工的:用户说完才能处理、模型说完才容打断,无法处理句中停顿、'嗯/对'式附和、实质性打断与背景人声,而这些恰恰是自然对话的常态。专职推理模型推理能力强(Kimi K3 在对话基准 StepAudioChat 上宏平均 77.1)却不能边说边想;低延迟双工系统为保响应速度又往往省掉推理——本文消融显示完全去掉思维链会让 Reasoning 从 71.89 跌至 60.52,损失 11.37 分。工具调用进一步放大矛盾:外部任务的耗时可能远超发起它的那段对话,需要异步执行且不打断交流。行业层面,多轮约束跟随(AudioMultiChallenge 各家最高仅 67.0)与零售类任务完成率(τ-Voice 最高 49.7%)仍是公认短板。
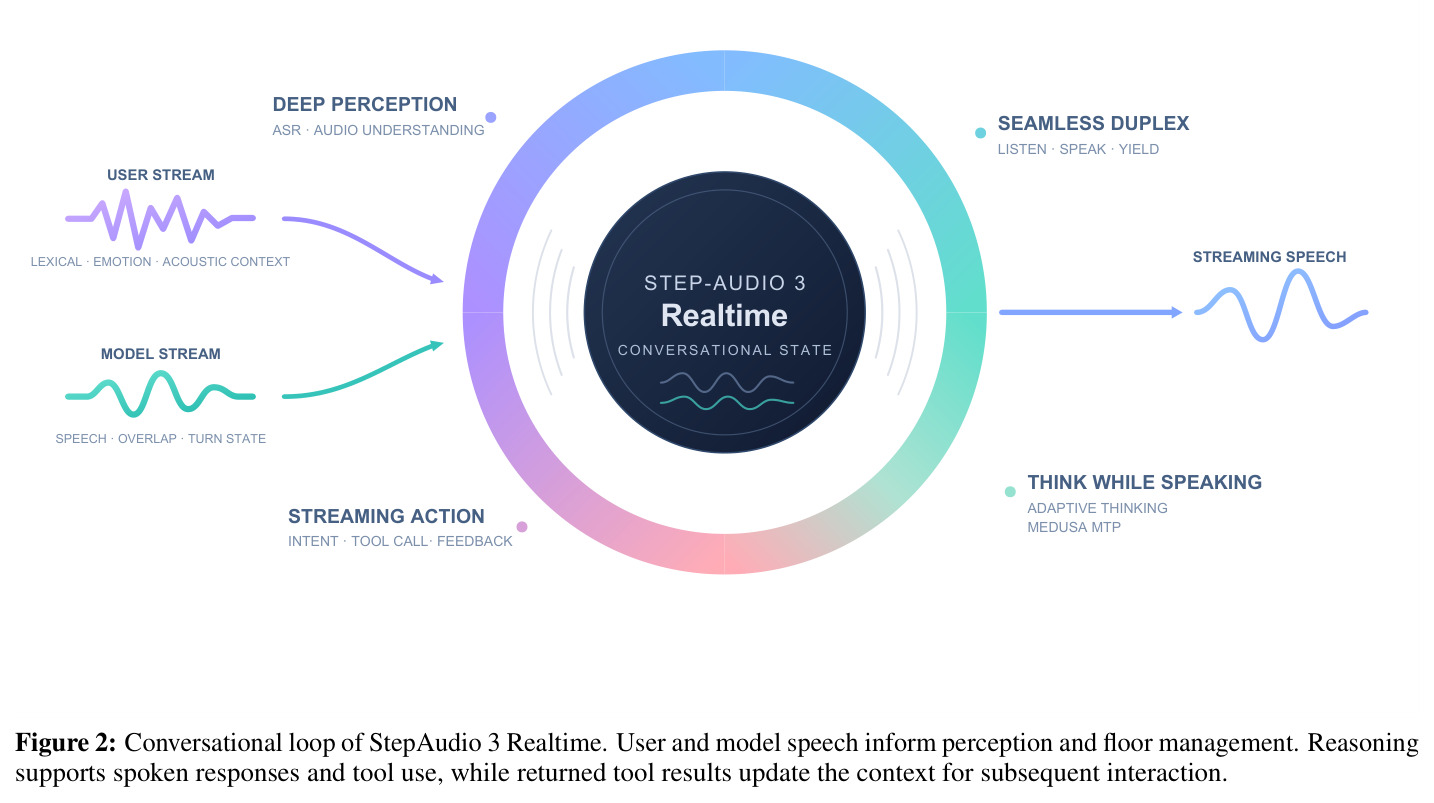
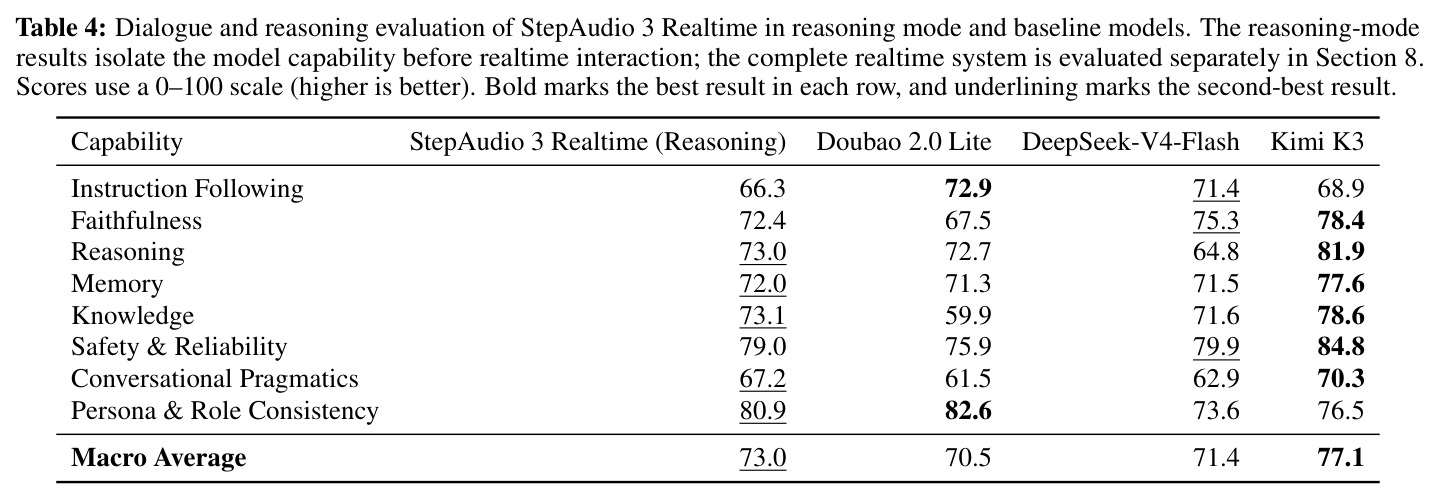
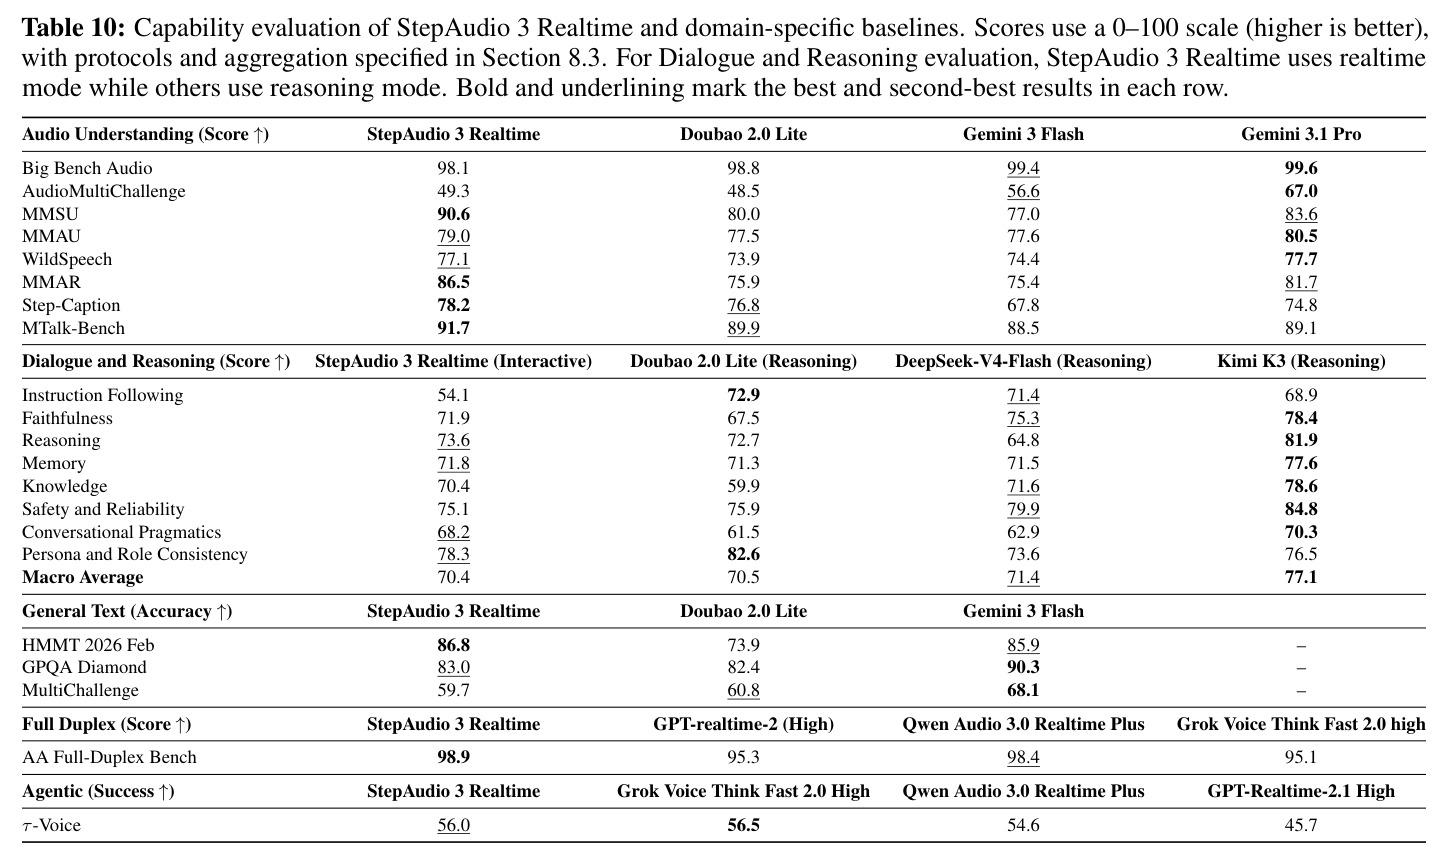
本文的目标是本文目标是打造一个统一的音频语言基座 StepAudio 3 Realtime,把深度感知(ASR+音频理解)、全双工话轮管理、边说边推理和工具执行组织成连续的'听-说-思-行'循环,并给出五个可检验的指标:音频理解与转写达到第一梯队(MMSU 90.6、LibriSpeech clean WER 1.18);全双工交互排名第一(AA Full-Duplex 98.9);实时说话模式下对话推理性能(70.4)不逊于专职推理模型(Doubao 2.0 Lite 70.5、DeepSeek-V4-Flash 71.4);通过 Adaptive Thinking 与 MTP 控制推理算力开销;Voice Agent 异步执行工具任务而不打断对话(τ-Voice 宏成功率 56.0%)。
与已有工作不同的是,本文的独特之处在于不把语音模型当作'文本 LLM 外挂语音接口',而是把整场对话建模为共享会话上下文上的并发循环:用户音频、模型音频、推理进度与工具状态同时演进,新输入随时改写既有决策。三个具体差异点:话轮管理不依赖外挂 VAD/判停器,而是把每个 320ms 音频块与状态/文本 token 交错成一条序列,让'听、说、让'成为模型自身的序列预测;用同一模型的两次并发调用充当构思脑与发音脑,实现'先开口、后补证'的边想边说,推理完成后能自我修正——这是与'想完再说'系统(推理模型+TTS 管线)的本质区别;能力融合不走推理期路由,而用参数空间加权合并四个专精教师(3:1:1:1),零额外推理成本。
核心方法
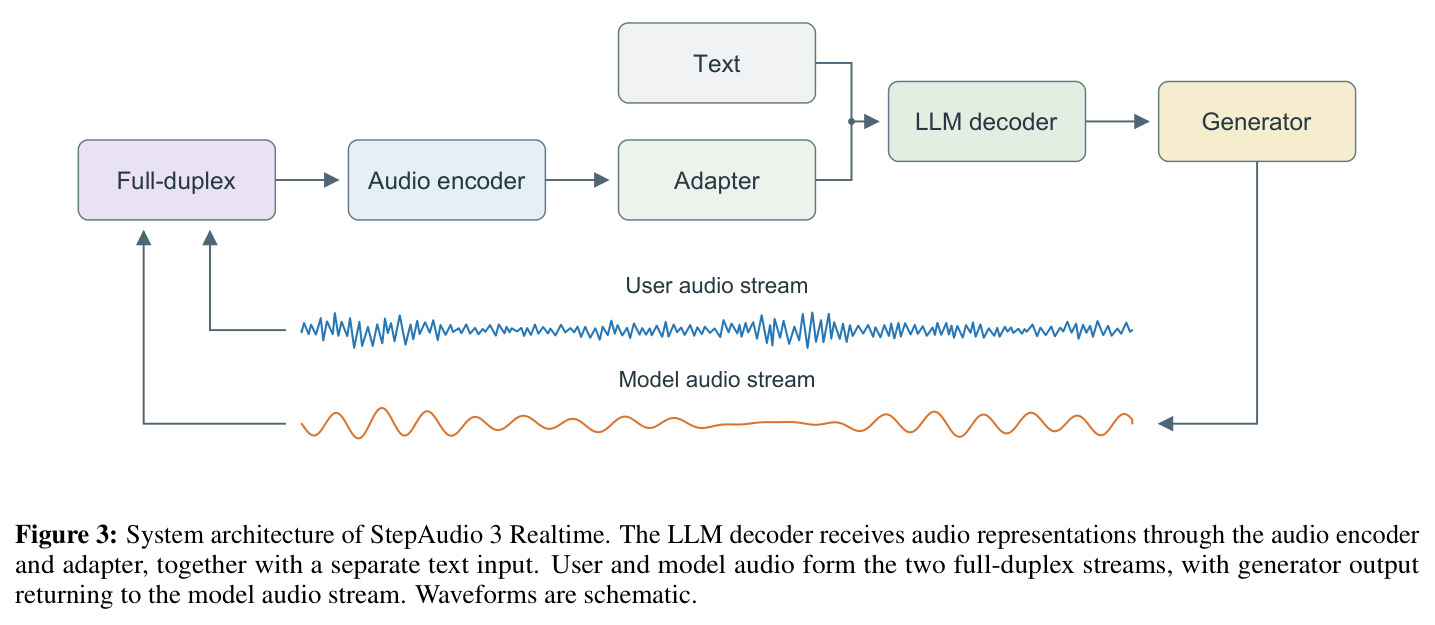
直觉上,StepAudio 3 Realtime 把一次语音对话看成四条并行推进的线:听(持续感知用户说了什么、怎么说的)、说(管理话轮与播报节奏)、想(私有推理)、行(工具执行),它们共享同一份会话上下文。技术上:模型为 MoE 架构,总参数约 196B、每 token 激活 11B,语言底座基于 Step 3.7 Flash,音频前端使用 Qwen3-Omni 的 AuT 编码器,经适配器接入 LLM 解码器;用户与模型两路音频构成全双工输入,语音生成器流式产出的音频回流到模型音频流参与后续决策。训练上先做三阶段预训练(模态对齐→多模态混合→cooldown),固定序列长度 32K、共 1.2T token,并提高纯文本占比以保住通用能力;中间训练把上下文扩到 128K,大幅加入音频理解与 Agent 交互数据;最后在 SFT 阶段分叉出转写专精的 ASR Max 与面向对话交互的 Realtime 两个分支。
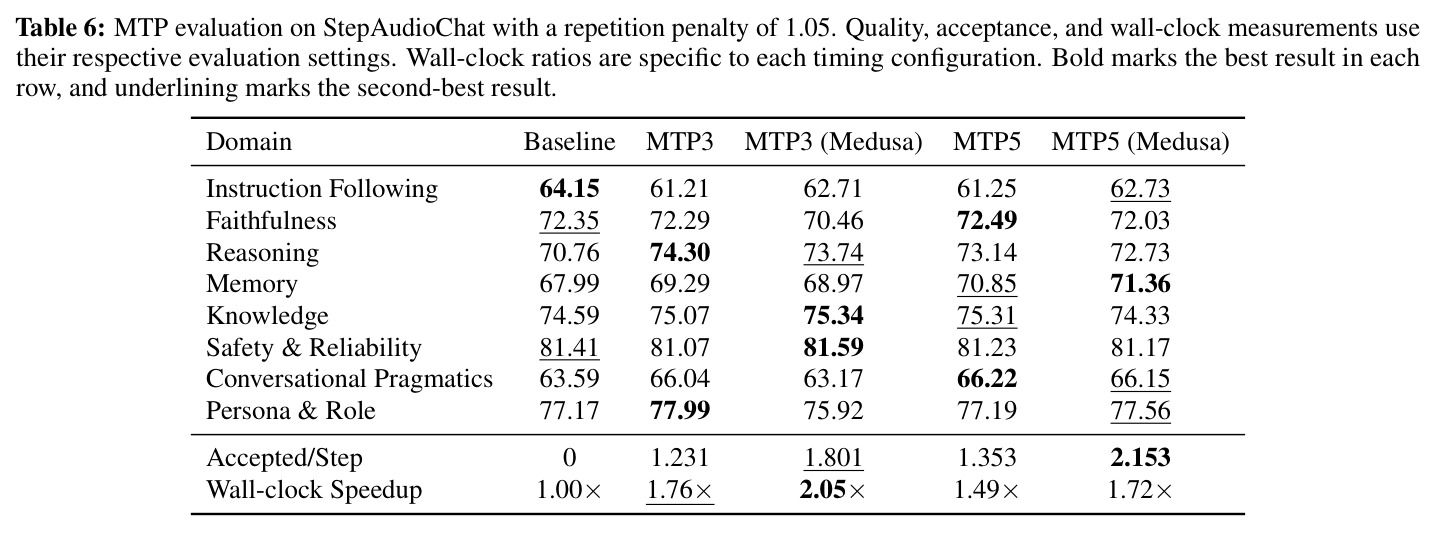
核心创新是四个机制的协同:其一,双流全双工建模——用户/模型音频组成双流,每个 320ms 音频块后跟一个状态或文本 token(如 no_voice、listening、transition、speaking),把停顿、附和、打断、背景人声的判别统一进序列建模,并用模型自己正在说的话来解读重叠的用户插话。其二,Think-While-Speaking——同一模型两次并发调用分别做 Formulation(私有推理)与 Articulation(分片说话),播放感知调度按流式音频进度放行响应片段,默认 Speak-First。其三,Adaptive Thinking——用固定探针模型在空 think 块下重答、盲评对比有/无推理的答案质量,按域设 no-think 预算并分层限流(实测 think 率 51.5%~82.0%)。其四,私有推理流上的 MTP3 加速——Medusa 式典型接受(熵自适应阈值)加 1.05 重复惩罚,每步接受 1.801 个草稿 token、墙钟 2.05 倍,而对用户可闻语音保持严格验证。
方法步骤详情
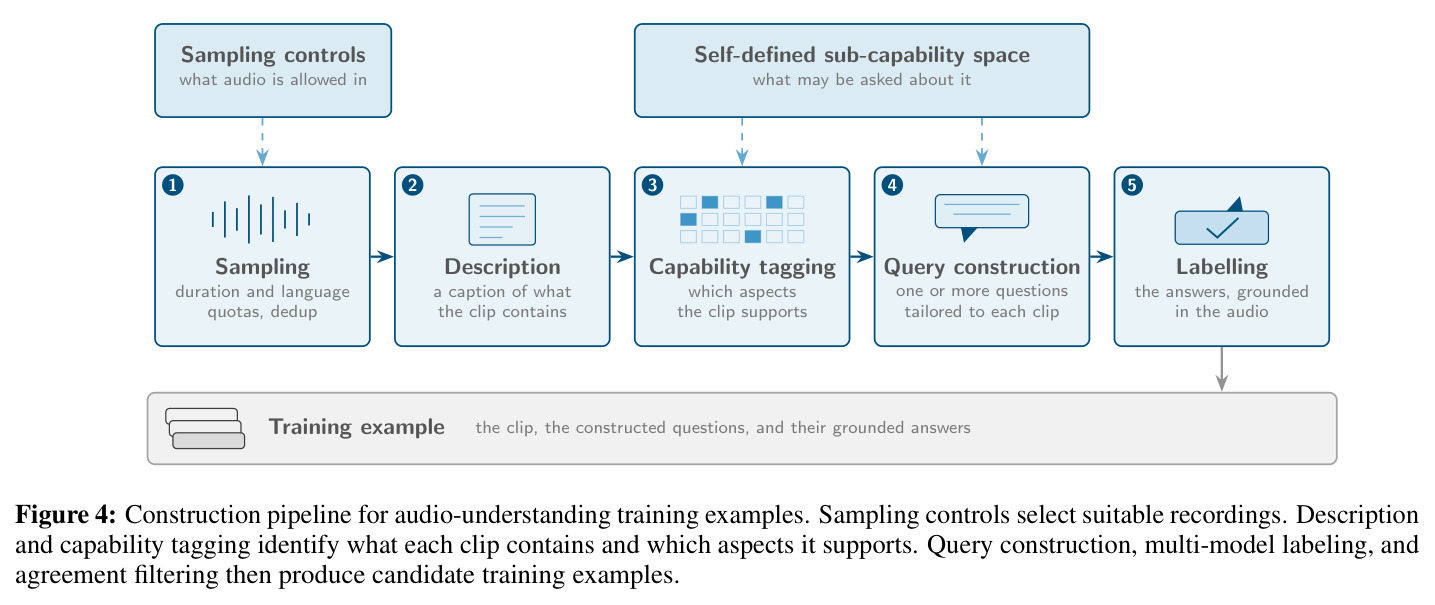
端到端流程如下:预训练:自动音频管线(声音事件检测+VAD 过滤、按语义完整性重切分、多识别系统交叉转写并用 ROVER 融合、声学/语义质量分级)产出数据,三阶段训练 1.2T token;中间训练:上下文扩至 128K,混入音频理解与 Agent 数据,双工适应阶段合并流式 ASR、VAD、话轮完整度预测三路监督,使用逾 1 万小时合成全双工交互数据;ASR 分支 SFT:SpecAugment 增强、冻结音频编码器,LLM 生成长尾同音术语载体句并合成语音、按发音一致性过滤;音频理解数据:层级能力分类法→音频描述→能力标注→逐条问题构造→多模型独立标注→一致性过滤,消融对比约 200 万随机样本与约 10 万精选样本;多轮对话数据:话题/人设/轮深/能力四轴分层自博弈生成,末轮提问后由双模型标注;自适应思考监督:探针重答+盲评配对标注,按域分层保留推理;MTP3 训练与典型接受部署;能力合并:训练四个专精教师(多轮对话/音频理解/通用文本推理/混合域),按 $\theta_{merge} = \sum_i \alpha_i \theta_i$ 以 3:1:1:1 权重合并。
技术新颖性
技术新颖性体现在四点。其一,把话轮管理内化为序列建模:不同于 realtime API 常见的 VAD+判停器+TTS 级联,状态 token 与音频块在同一条序列中交替,话轮决策由模型端到端给出,且能利用模型自己正在说的话来解读用户插话的意图(如区分'对'是附和还是纠正的前奏)。其二,Think-While-Speaking 把 Mind-Paced Speaking 的双进程设计落到单一 MoE 模型的两次并发调用上:允许响应从不完整推理起步、推理完成后用后续语句补充修正,这与'推理完成后再合成语音'的管线(首响延迟等于全部推理时间)有本质区别。其三,对投机解码做应用范围切分:私有思考流允许改变分布的典型接受换速度,用户可闻语音保持严格验证保真——报告坦承这仍不能消除不完整推理造成的错误,态度诚实。其四,自适应思考的监督不靠启发式规则,而是'探针重答+盲评配对比较'的实证标注并按域分层限流;能力融合用参数平均而非 MoE 路由,零推理开销。
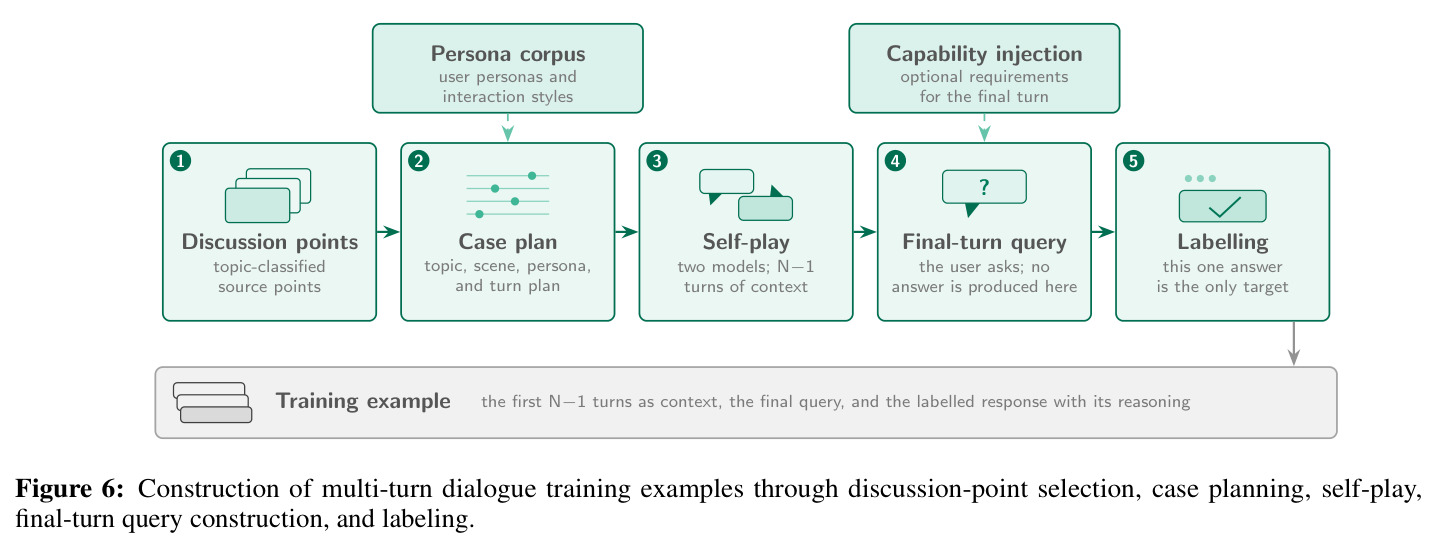
实验结果
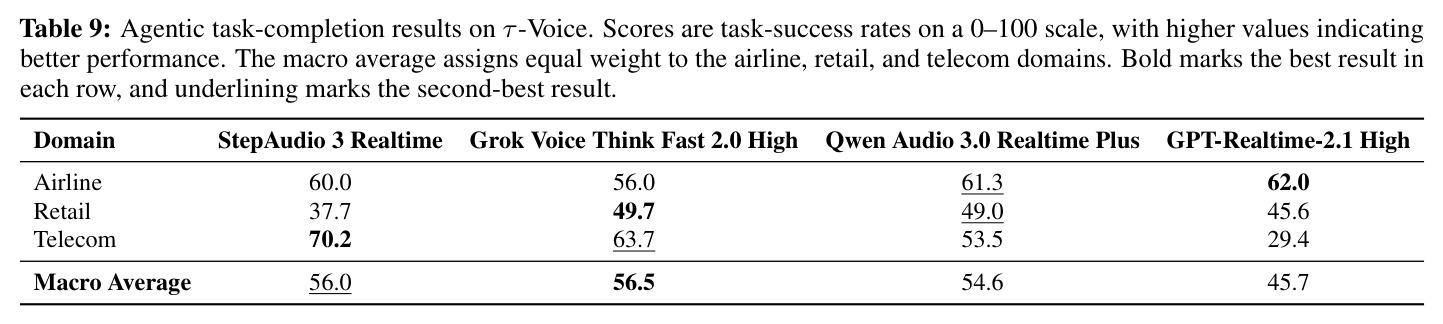
ASR:LibriSpeech、AISHELL-1 全部第一;ContextASR-Bench 四子集全胜,英/中文宏平均 5.67%/1.23% 优于 HY3.0 的 6.60%/1.69%。音频理解:宏平均 81.3,距 Gemini 3.1 Pro 仅 0.5;MMSU 90.6(+7.0)、MMAR 86.5(+4.8)领先,但 AudioMultiChallenge 49.3 落后 17.7 分;消融显示 10 万精选样本胜 200 万随机(MMSU 78.78→89.70)。双工:AA Full-Duplex 98.9 第一。对话:推理模式宏平均 73.0(Kimi K3 77.1),realtime 模式 70.4 与专职推理模型相当。自适应思考:Reasoning 由 71.89 降至 66.80;MTP3-Medusa 墙钟 2.05 倍。合并:音频宏 81.3 追平最佳教师、通用文本 76.5 最高,对话 73.0 低于最佳教师 74.2。Agent:τ-Voice 宏 56.0%,电信 70.2% 第一,零售 37.7% 落后 Grok 49.7%。
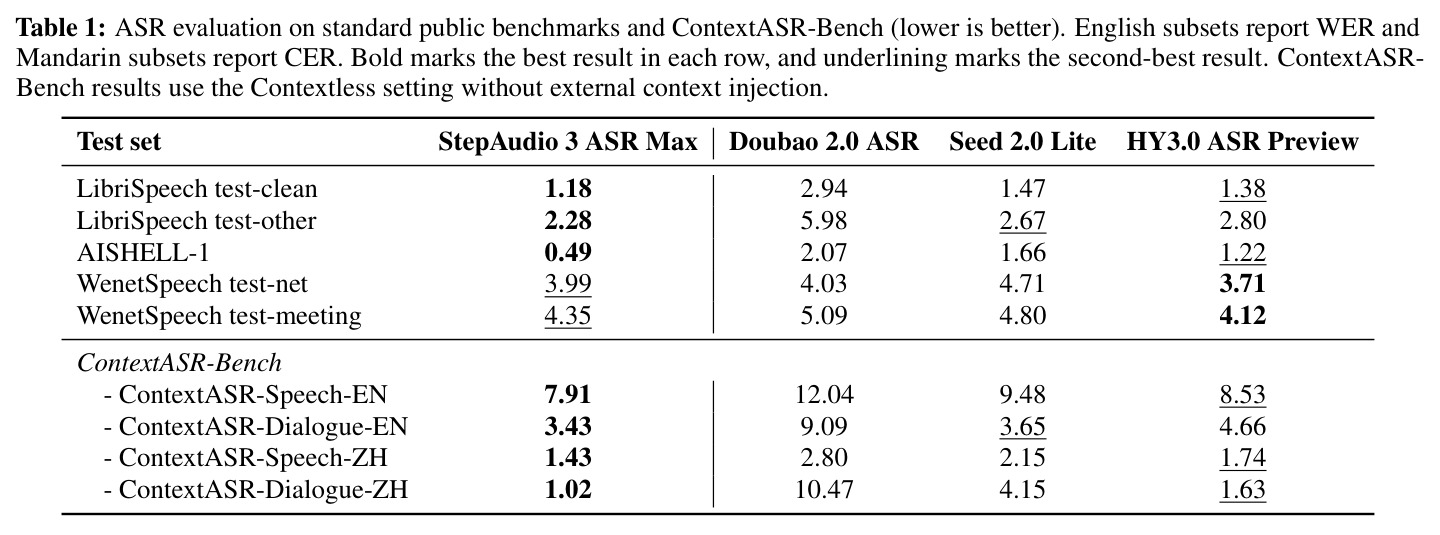
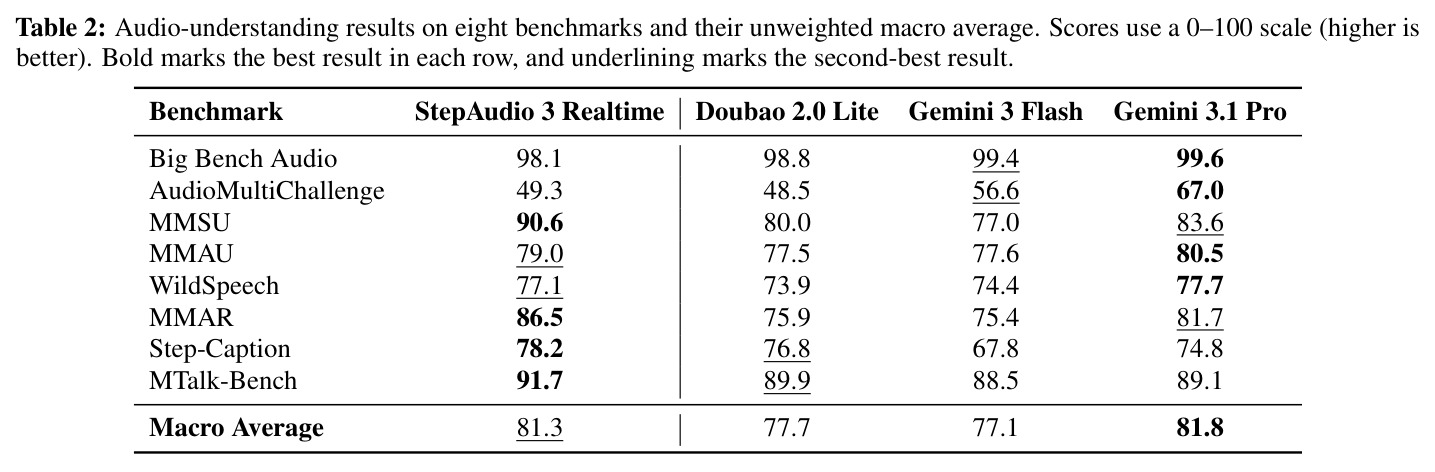
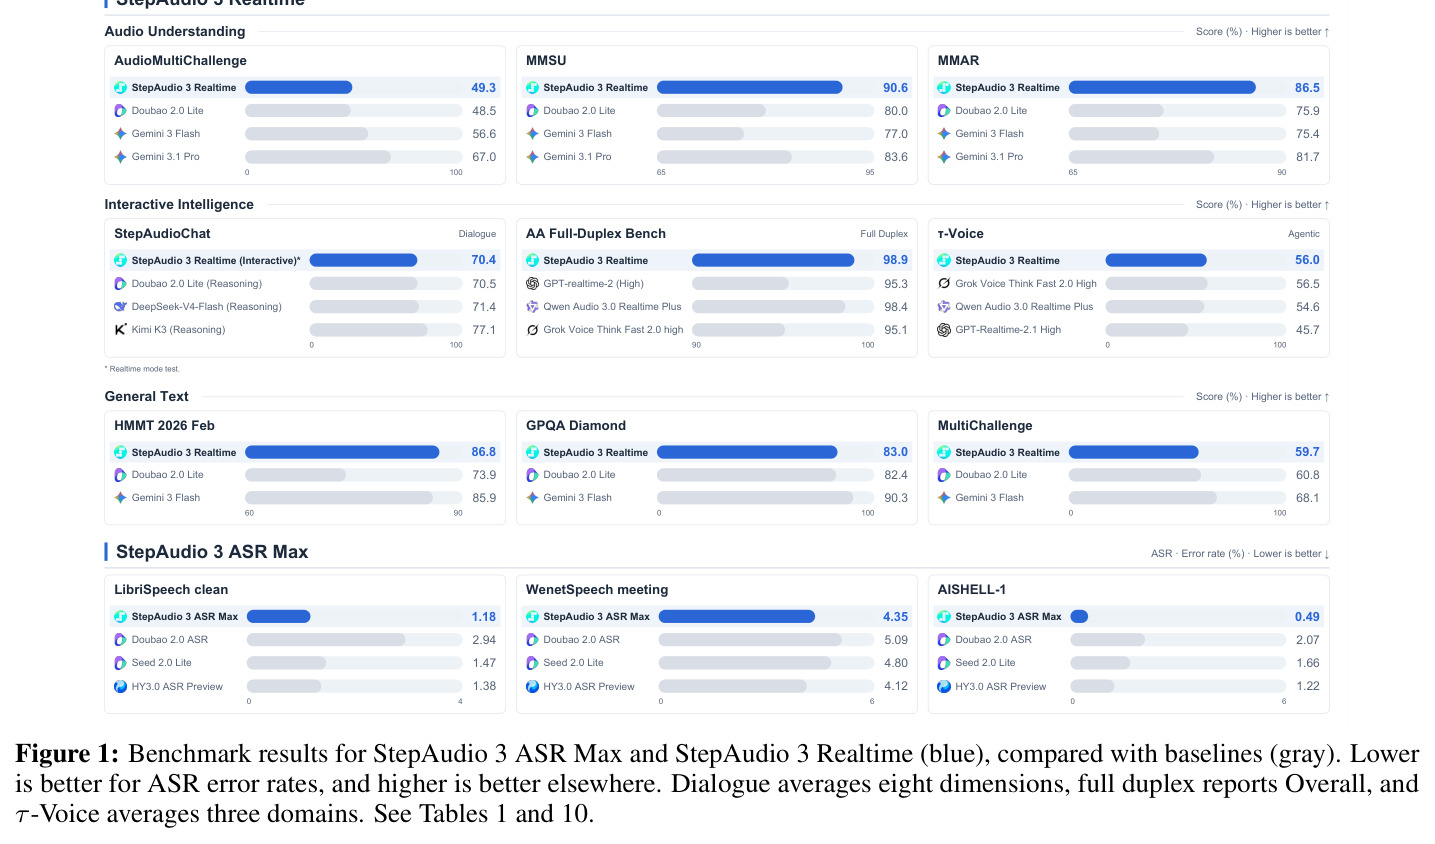
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MMSU 语音语义理解 | 准确率(0-100) | 90.6 | Gemini 3.1 Pro 83.6 | +7.0 |
| MMAR 音频推理 | 准确率(0-100) | 86.5 | Gemini 3.1 Pro 81.7 | +4.8 |
| AA Full-Duplex Bench(总分) | Overall(0-100) | 98.9 | Qwen Audio 3.0 Realtime Plus 98.4 | +0.5,排名第一 |
| LibriSpeech test-clean | WER%(越低越好) | 1.18 | HY3.0 ASR Preview 1.38 | -0.20pp |
| τ-Voice 任务成功率(宏平均) | 成功率(%) | 56.0 | Grok Voice Think Fast 2.0 High 56.5 | -0.5pp 基本持平;电信域 70.2% 第一(+6.5pp) |
| StepAudioChat 对话推理(实时模式) | 宏平均(0-100) | 70.4 | DeepSeek-V4-Flash(推理模式)71.4 | -1.0,与专职推理模型相当 |
| HMMT 2026 Feb 竞赛数学 | 准确率(%) | 86.8 | Gemini 3 Flash 85.9 | +0.9 |
局限与改进
作者承认的局限:多轮约束跟随薄弱——AudioMultiChallenge 49.3 落后 Gemini 3.1 Pro 17.7 分;零售任务完成率 37.7%,明显落后 Grok 的 49.7%;Adaptive Thinking 的推理分配不均衡,Reasoning 域 think 率仅 59.5% 却是从思考获益最大的域(+11.37 分),域级预算无法保证逐轮最优;MTP 典型接受改变生成分布,'不能消除不完整私有推理带来的错误';墙钟加速比并非受控对比。我的补充观察:报告未披露首包延迟、打断接管延迟等实时系统最关键的指标;StepAudioChat、Step-Caption、MTalk-Bench 为自建/闭环基准,跨厂商可比性依赖其质控流程;通用文本上 GPQA Diamond 83.0、MultiChallenge 59.7 仍明显低于 Gemini 3 Flash(90.3/68.1);τ-Voice 每域仅约 3 次试验取平均、未报告方差;196B MoE 的部署成本与量化方案只字未提。
独立分析的弱点
独立弱点分析:自适应思考的域级预算与逐轮收益错配——Reasoning 域被过度降智(71.89→66.80),改进方向是以逐轮答案质量为奖励信号训练轻量路由器,或对不确定轮次回退到思考。零售域短板(37.7%)——该域需要多约束状态跟踪与价格/库存校验,可用带约束检查器的长程工具轨迹蒸馏与自我验证训练。多轮音频约束跟随弱(49.3)——可显式构造'中途修改/撤销约束'的对抗对话并加入约束一致性奖励。典型接受污染思考流——虽然只用于私有推理,错误仍会经发音脑进入答案,可在思考结束加一步摘要重述或一致性校验再交给发音脑。MTP 深头浪费——第 4/5 头严格接受率仅 10.7%/5.7%,可训练动态深度选择或按域裁剪头数。合并导致专精损失——对话宏 73.0 低于最佳对话教师 74.2,可探索输入条件化的软合并(如注意力加权)或 LoRA 混合而非全参数平均。此外报告缺少延迟与成本数据,使实时性主张难以独立核验。
未来方向
作者指出的方向:更有效的推理努力分配、长对话上更可靠的任务执行、多轮约束跟随与零售工具使用改进。可延伸的研究:用逐轮强化学习(以答案质量为奖励)替代盲评配对标注,学习真正的逐轮'是否思考'决策;将播放感知调度与流式 TTS 联合优化,公开并压低首包延迟、打断接管延迟等实时指标;Voice Agent 的长时异步任务管理,包括主动汇报策略、任务中断恢复与多任务并发的对话话术;把 3:1:1:1 合并框架推广为持续学习的'能力插槽'(新能力等于新教师,即插即用),并研究合并系数的自动化搜索;对思考流引入语义熵/一致性检测以抑制典型接受引入的幻觉;扩展到更多语言以及歌唱、情感表达等方向——当前评测以中英双语为主。
复现评估
这是一份技术报告,正文未声明开源代码或权重(Step-Audio 早期系列曾开源,本报告仅附项目页)。完整复现需要 196B 总参/11B 激活的 MoE 训练、1.2T token 预训练与逾 1 万小时合成双工数据,属大厂级算力,学界难以复现训练。但评测侧相当透明:ContextASR-Bench、Full Duplex Bench、τ-Voice、HMMT/GPQA/MultiChallenge 均为公开基准,8.3 节明确了评分协议(如 τ-Voice 以最终数据库状态判成败、三域等权宏平均),ASR 基线为同条件重跑。不可对齐部分:StepAudioChat 为闭环自建基准,Step-Caption/MTalk-Bench 为内部基准。数据构建方法(ROVER 融合、能力分类法、自博弈配额、盲评标注)写到思路层面但缺数据配方与超参。总体判断:第三方复核评测结论可行(难度中等),端到端复现模型极难,对工程团队的价值主要在方法组合与消融数字。
论文图表