Realtime-Venus:基于异步委派的全双工实时交互系统 Realtime-Venus: A full-duplex interaction system with asynchronous delegation
双9B全双工前端与异步执行框架共享因果时间线,边对话边调用外部能力
前置知识
全双工交互(Full-Duplex)
系统与用户可以同时说话和聆听:模型在生成语音的过程中持续接收新输入,并实时决定是继续说、暂停让位,还是被打断后修复或转向。传统半双工系统依赖 VAD(语音活动检测)判断用户是否说完再轮流发言,全双工则要求模型在语义层面判断重叠语音的会话角色——是附和(backchannel)、对旁人说话,还是真正抢话筒的打断。
这是本文的核心场景。理解 <|listen|>/<|speak|> 控制 token 的设计、Full-Duplex-Bench 的 C_RESPOND/C_RESUME 指标,以及打断/附和的区别,都必须先掌握全双工概念。
Thinker–Talker 架构
将对话模型拆成两个模块:Thinker(思考器)是 LLM,负责理解输入、生成文本语义和决策;Talker(talker)以 Thinker 的隐状态为条件生成离散语音 token 并解码为波形。二者通过隐状态解耦,声学生成不占用主 LLM 的生成能力。Qwen2.5/3-Omni 和本文底座 MiniCPM-o 4.5 都采用这一设计。
本文的联合策略分解 $p_\theta \cdot p_\phi$ 正对应 Thinker 与 Talker:训练时只更新 Thinker,声学解码器冻结。理解这一点才能看懂训练配方和消融范围。
异步委派(Asynchronous Delegation)
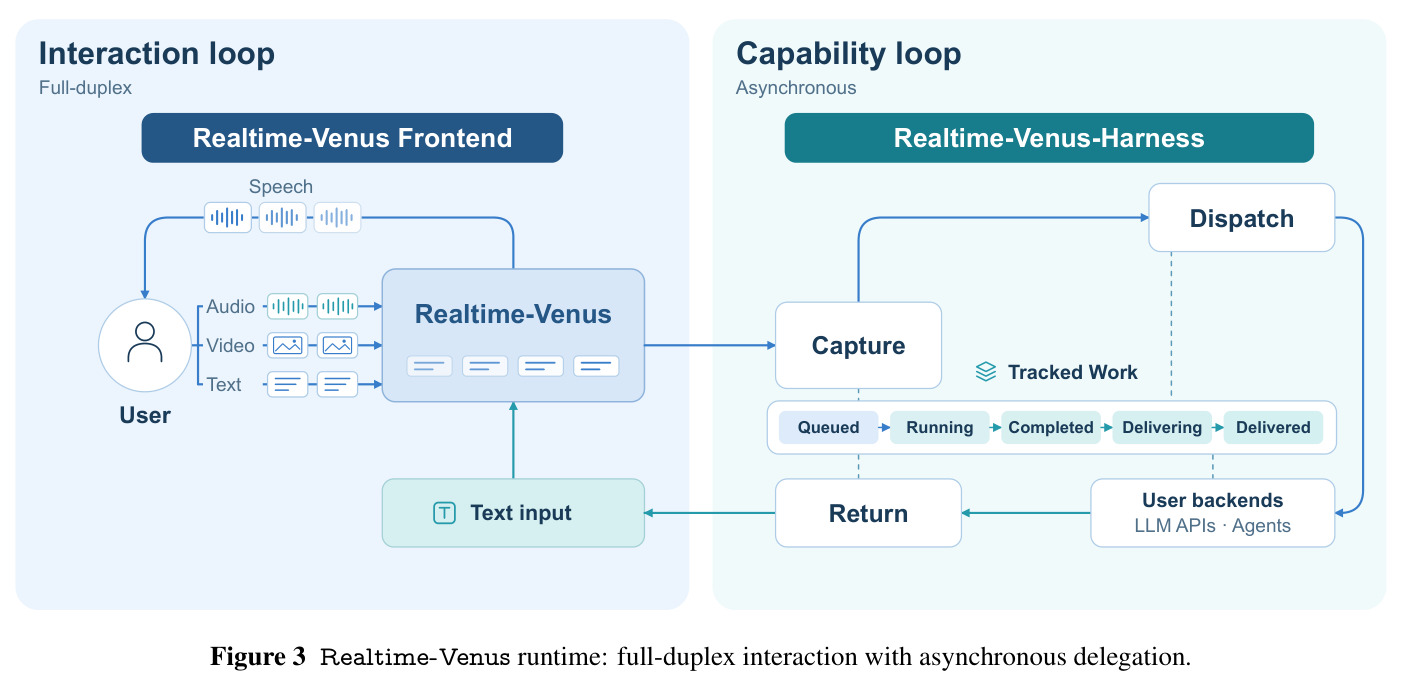
前端对话模型把需要外部计算的任务(联网搜索、工具调用、深度推理)打包成自然语言请求发给后台框架执行,对话本身不阻塞;后台完成后把结果回注到会话。关键技术点包括:请求发出时刻冻结证据快照、结果的时效性(新鲜度)检查、以及由前端决定结果何时播出。
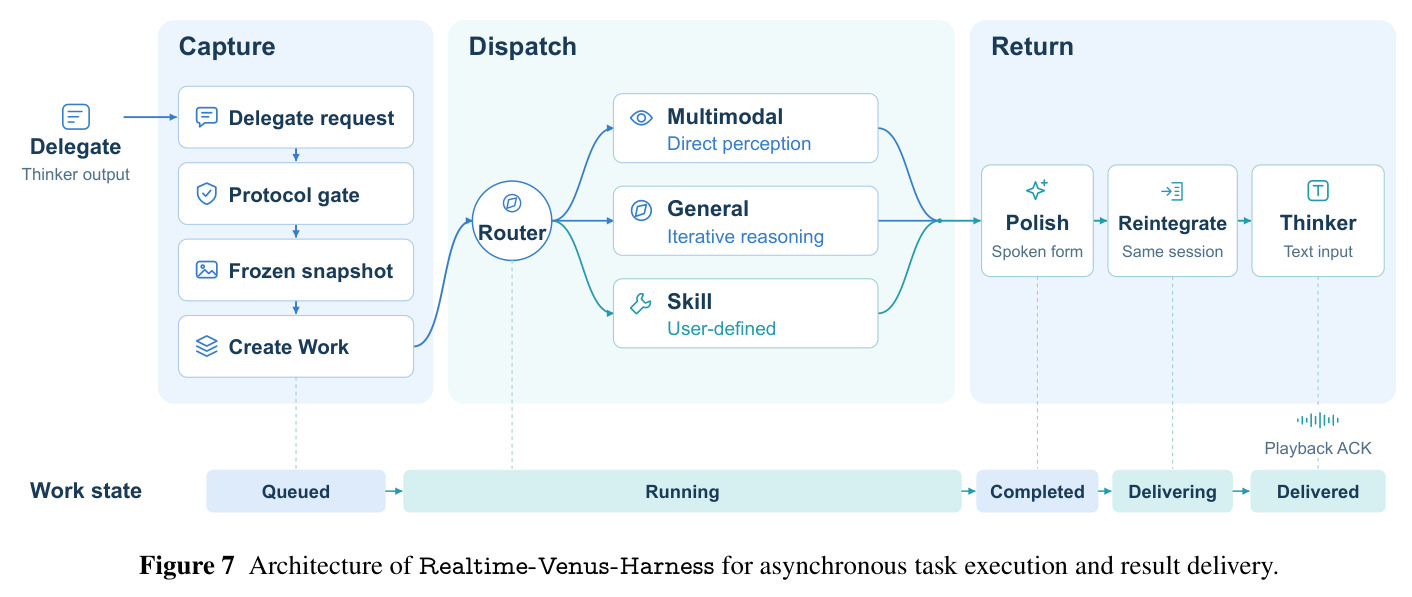
这是标题里的核心贡献。Realtime-Venus-Harness 的捕获-分发-返回三阶段、工作项生命周期 QUEUED→DELIVERED,全都是围绕异步委派展开的。
S3 语音 token 与流匹配解码器
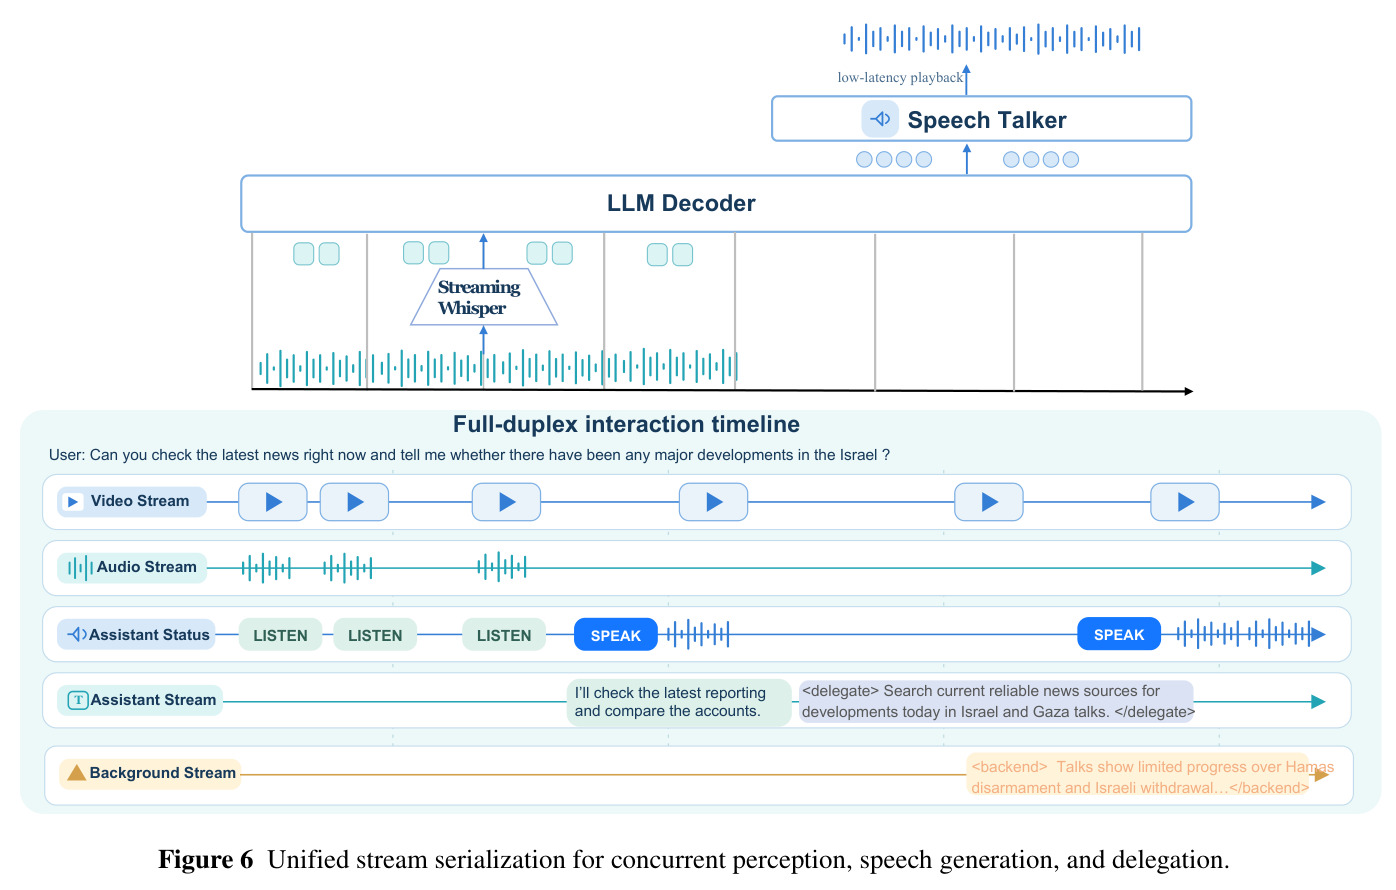
把语音离散化为约每秒 25 个 token 的序列,LLM 隐状态作为条件预测这些 token,再由流匹配(flow-matching)解码器结合系统提示中的参考音色转成 24 kHz 波形,实现低延迟流式合成。文本与语音 token 在时间上按 chunk 起始时刻对齐。
理解 assistant stream 中文本与语音如何逐秒对齐、播放进度驱动的 token 调度公式(式 2),以及 <|chunk_eos|> 如何切分语音块,都依赖这一机制。
MaxSim 与 MMR 检索
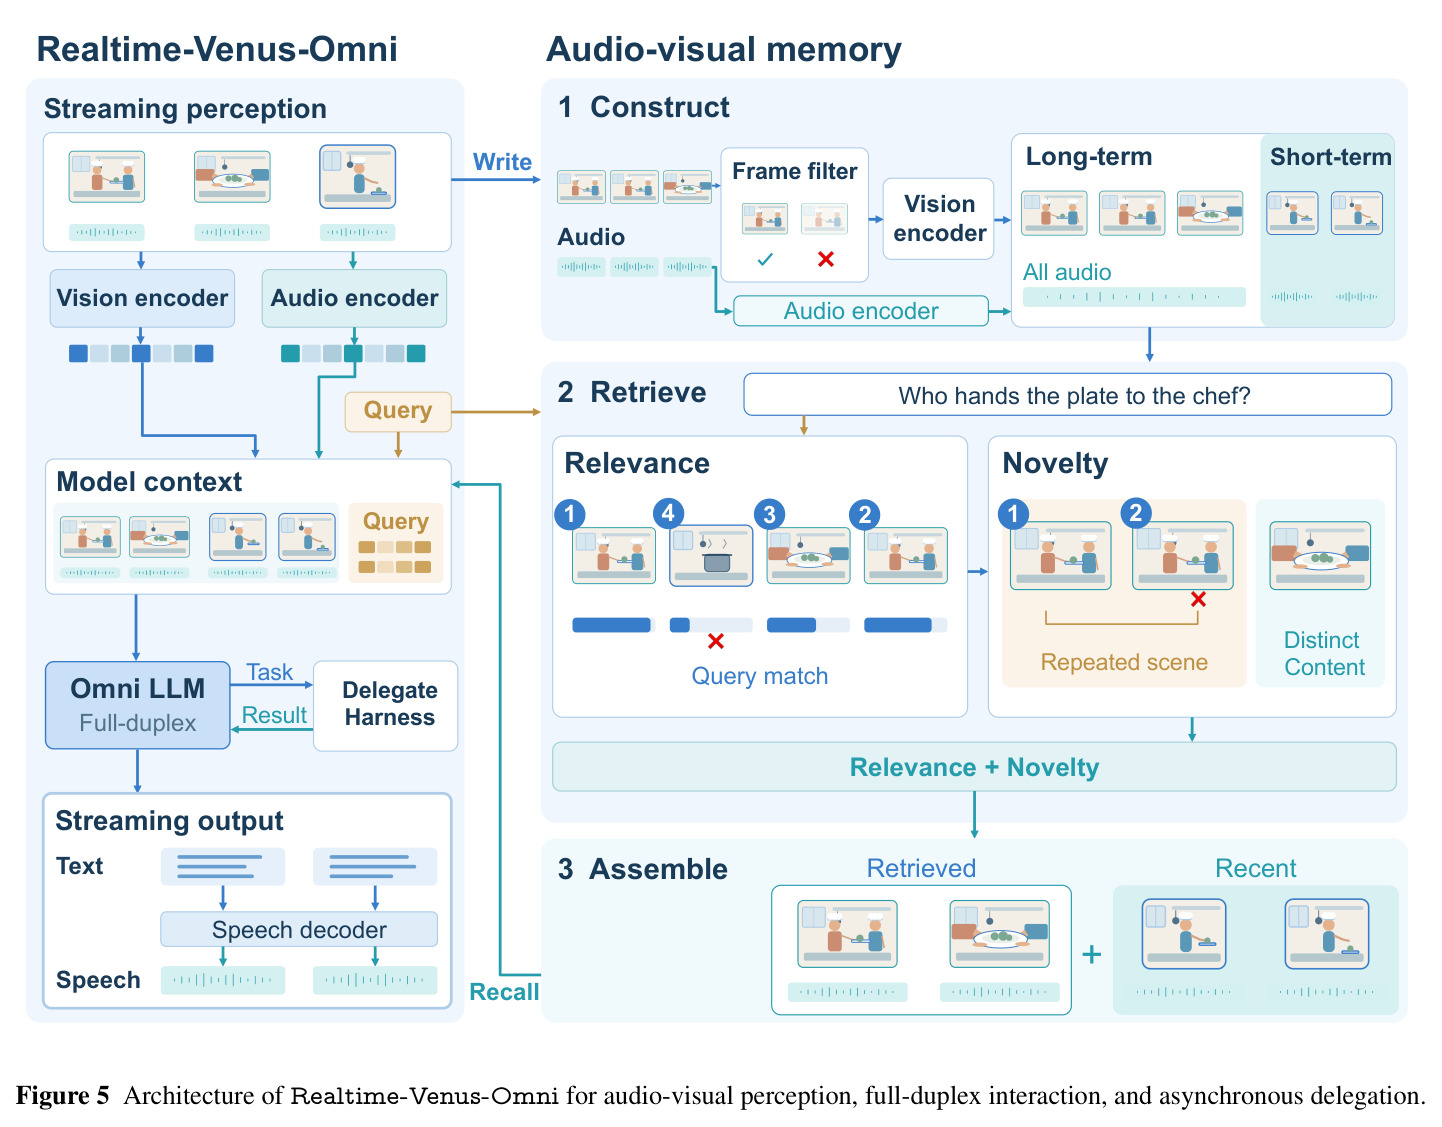
MaxSim 是多向量细粒度匹配算子:查询的每个 token 取与文档内所有 token 的最大余弦相似度再聚合(ColBERT 首创)。MMR(最大边际相关性)在按相关性排序时引入与已选结果的新颖性(去冗余)项,兼顾相关与多样。本文用 MAD(中位绝对偏差)归一化 token 权重,再把相关性与视觉新颖性线性组合。
免训练长视频记忆模块的检索正是这两个算子的组合,读懂 4.2 节的记忆构建与检索需要它们作为前置知识。
研究动机
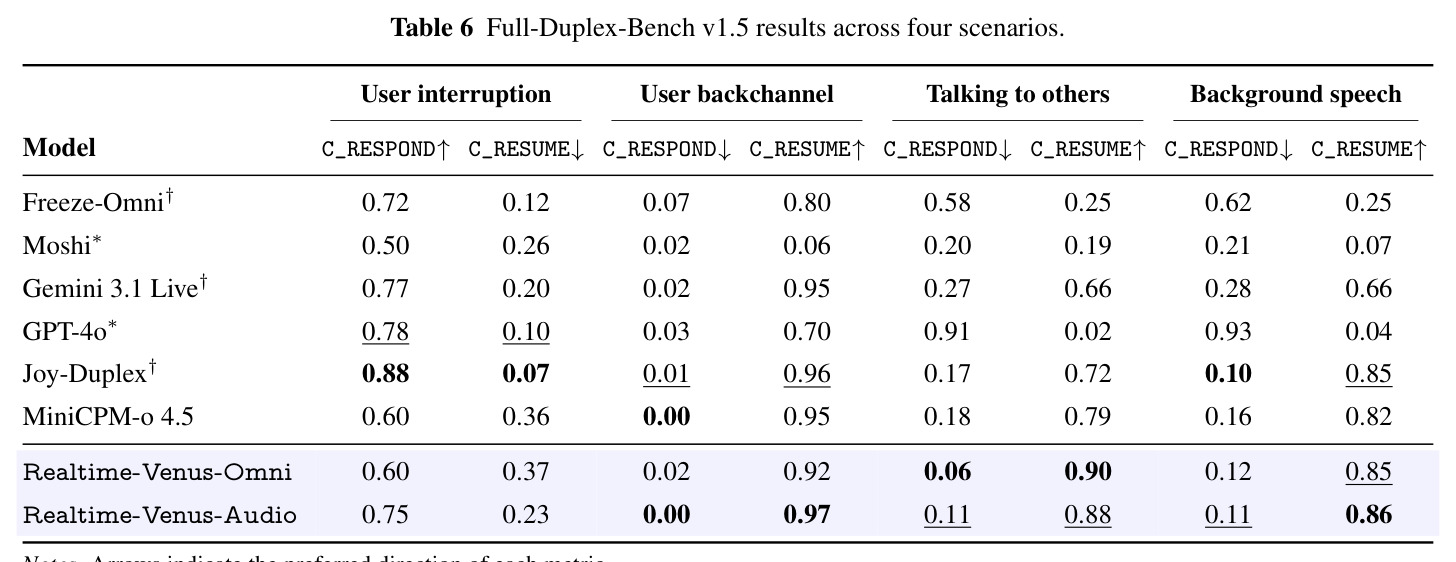
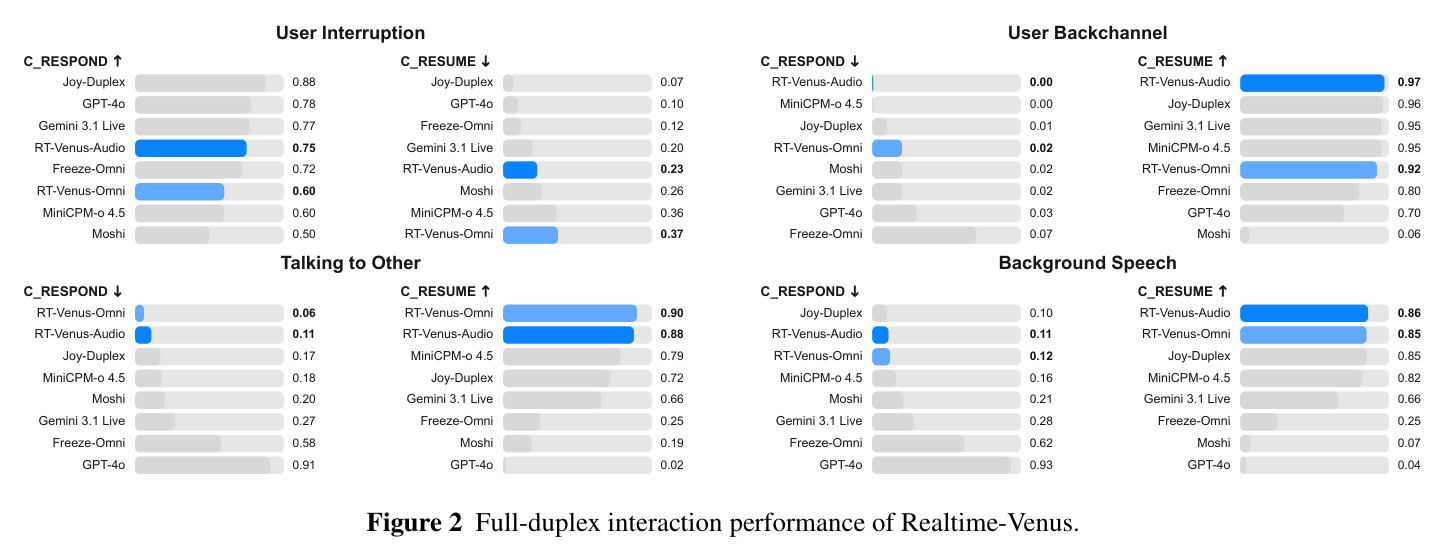
语音助手长期停留在“半双工”模式:依赖 VAD 检测静音、等用户说完才响应,既无法在持续观看视频时主动开口,也无法在说话途中妥善处理用户附和或打断。新一代全双工模型(Moshi、Freeze-Omni、MiniCPM-o 4.5)虽解决了重叠语音的时序控制,但仍把“对话”与“计算”压在同一时间尺度上:当用户要求“查一下今天北京限行尾号”或“看看中东局势有什么新进展”这类需要外部检索和推理的请求时,系统要么让用户干等数秒到十几秒,要么阻塞对话线程。Full-Duplex-Bench v1.5 的实测还暴露了稳定性痛点:GPT-4o 在“对旁人说话”与“背景人声”两种场景下继续率仅 0.02 和 0.04,几乎必然被无关语音带偏;而多数模型在“该停”与“不该停”之间顾此失彼,打断响应率与继续率难以兼得。
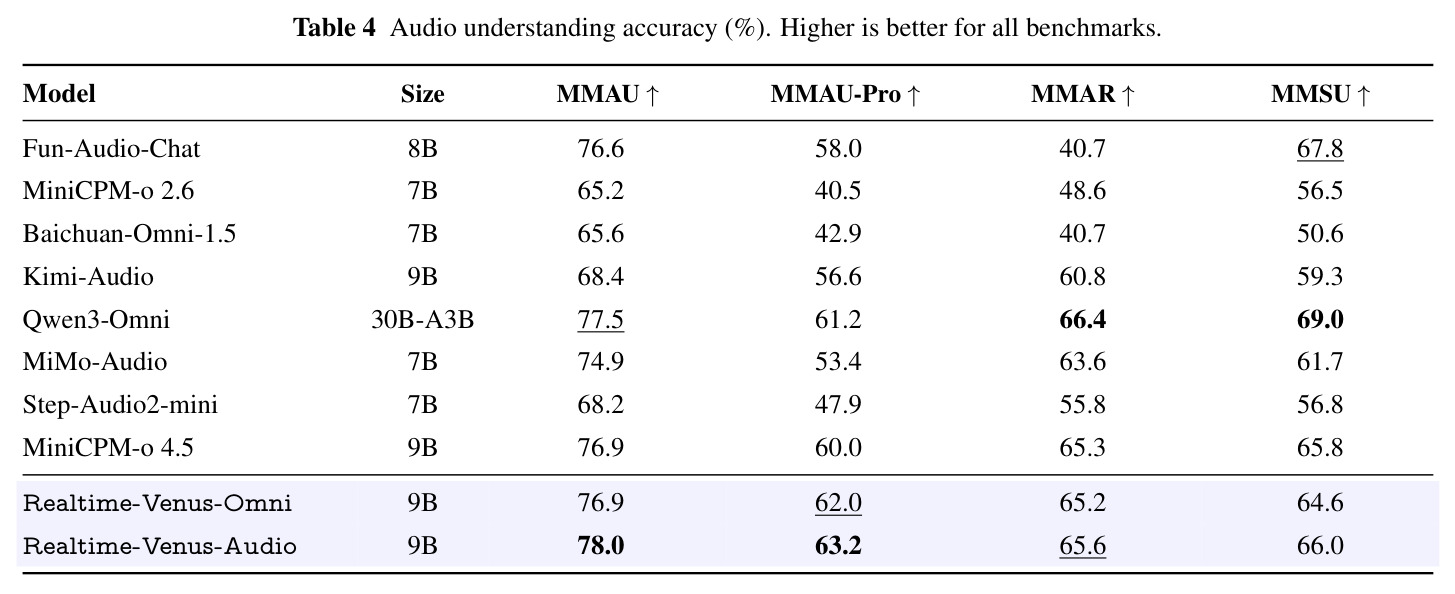
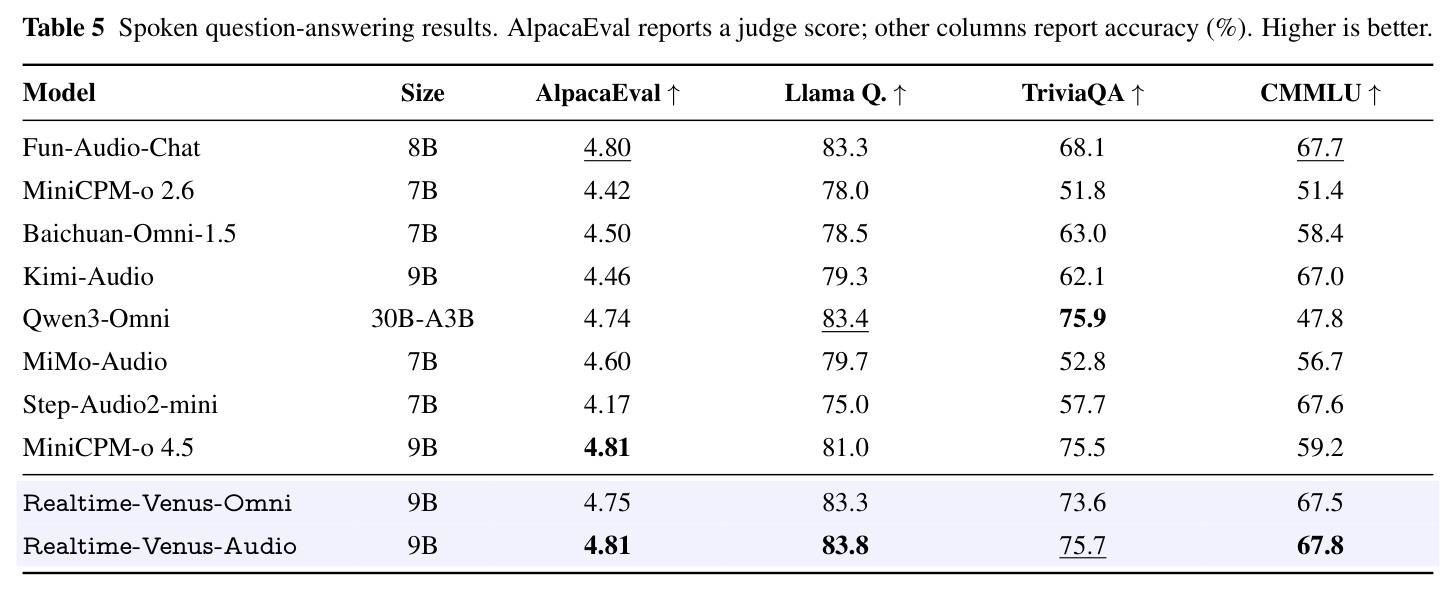
本文的目标是本文要构建一个“边聊边干活”的实时全双工系统:前端模型以 1 秒为单位持续消费音视频流,自主决定聆听、说话或结束回合,既能在视频中关键事件发生时主动开口(omni-proactive,如裁判鸣哨瞬间播报),也能在附和、旁人语音、背景人声等非打断性重叠下保持回应不跑偏;当请求需要外部能力时,通过私有通道发出自然语言委派请求,由后台框架异步执行检索、推理与工具调用,前端对话完全不中断,结果在合适的时机自然重入对话。量化目标包括:在 8 个视频基准中于在线模型内取得多数第一;音频理解与口语问答达到或超过 Qwen3-Omni、Fun-Audio-Chat 等强基线;Full-Duplex-Bench v1.5 三个非打断场景继续率全面领先;并借助免训练记忆模块支持小时级视频理解。
与已有工作不同的是,已有工作的切入要么只做全双工对话(Moshi 的并行音频流、Freeze-Omni 的隐状态分类器、Joy-Duplex 的回合控制),要么把工具调用做成独立或级联通道:DuplexSLA 建模结构化动作通道,MoshiRAG 只支持异步检索,DuplexOmni 挂可插拔思考层,JoyAI-VL-Interaction 依赖外部 ASR/TTS 级联,GPT-Realtime 的异步函数调用细节封闭。本文的独特之处是把“对话控制、响应生成、私有委派”统一进同一个自回归策略和同一条因果时间线:委派请求以 文本 span 内嵌在 Thinker 输出流中,与 <|listen|>/<|speak|> 状态 token、语音 token 联合训练,无需任何级联组件;同时前后端解耦为两个独立产物(9B 前端模型 + Harness 框架),用“请求边界的证据快照”保证后台任务的上下文稳定,用“前端控制播出时机”保证对话意图的实时适应。
核心方法
Realtime-Venus 由两个分别训练的 9B 前端和共享执行框架组成:Omni 版处理音视频、Audio 版只处理音频,均基于 MiniCPM-o 4.5 的 Omni-Flow 架构(SigLIP2 视觉编码器 + Whisper-Medium 音频编码器 + Qwen3-8B 骨干 + S3 语音 token + 流匹配声学解码器)。运行时是双循环:交互循环以 1 秒 chunk 流式处理输入,每个 chunk 输出控制 token、前台文本、委派文本和语音 token,仅文本与语音面向用户;能力循环由 私有请求激活,经捕获-分发-返回三阶段异步执行任务。整个系统可抽象为因果状态转移 $(s_{k+1}, O_k) = \mathcal{F}_m(s_k, x_k^m, b_k; \eta_k)$,其中 $s_k$ 是保留会话状态,$b_k$ 是本 chunk 新准入的后台回复,$\eta_k$ 是播放确认等运行时事件,输出 $O_k=(c_k, Y_k, D_k, S_k)$ 依次为控制、文本、委派和语音。
核心创新有二。其一是统一流序列化:用户感知流、助手输出流、后台结果流三条逻辑流交错在同一条对话时钟上,委派指令作为隐藏的 span 与语音生成联合建模(后台结果用 包裹,作为外部上下文插入输入边界而非预测目标),模型由此学会“何时开口播报后台结果”。其二是证据边界快照:委派请求发出时即冻结 $\kappa_i=(T_i, n_i)$(时间戳与输入序列号)以及回看窗口 $\Delta$ 内的上下文快照 $X_i$,保证后台推理基于请求时刻的证据;而回复何时播出由前端根据当前对话状态决定,同时获得后台上下文稳定性与前台的意图适应性。全双工控制上,重叠语音按会话语义角色分派动作——停顿噪音保持聆听、附和继续说、真打断则停止/修复/转向未说出的续文——而不是 VAD 式的一刀切停机。
方法步骤详情
第一步,前端逐秒编码:Omni 版交错约 10 个 Whisper 音频特征与视觉 token,Audio 版仅音频。第二步,每 chunk 预测控制 token,说话时生成文本并条件化 25 token/秒的 S3 语音 token,按 $n_k = \arg\min_n |\tau_{k-1} + D(Y_{k,1:n}) - t_k|$ 对齐播放。第三步,需外部能力时输出 自然语言任务并由宿主隐藏。第四步,Harness 以 $X_i = \mathrm{Snap}(\mathcal{B}_\sigma; \kappa_i, \Delta)$ 冻结证据、注册工作项,状态经 QUEUED→RUNNING→…→DELIVERED 推进。第五步,路由器 $(\gamma_i, \alpha_i) = R(q_i, z_i, \mathcal{C})$ 在多模态/通用/技能能力中依契约选择并校验参数,执行产出 $r_i$。第六步,$\hat{b}_i = A(w_i, r_i)$ 打磨出口语回复,经 通道重回会话,前端择时播出,过期结果被拦截。
技术新颖性
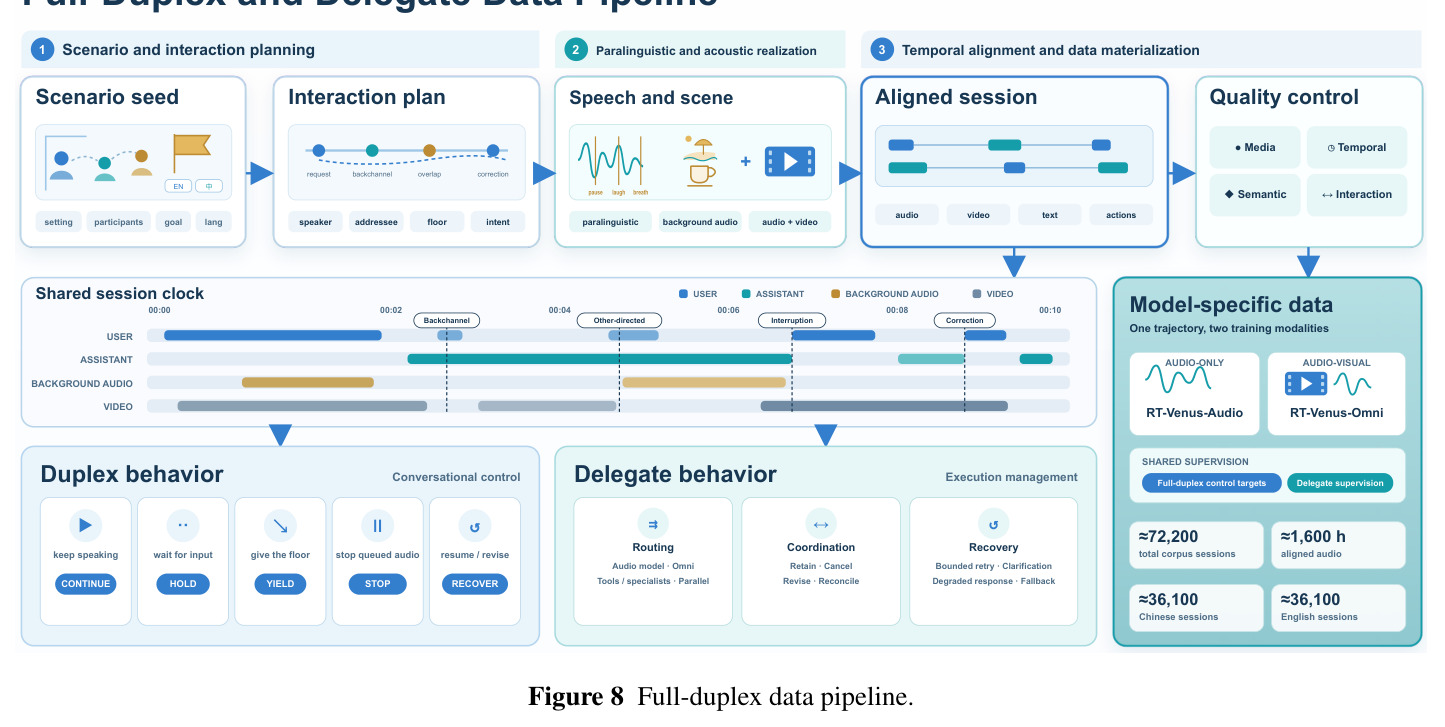
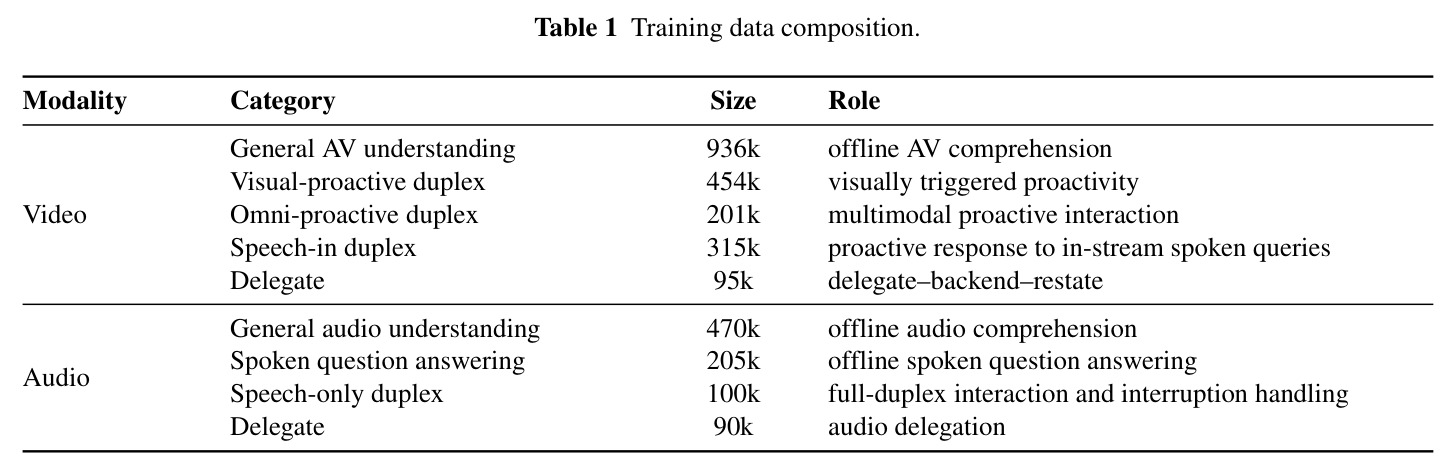
与已有方法的本质区别有四。(1) 全双工控制:Moshi 用并行音频流、Freeze-Omni 用隐状态辅助分类器做“停/不停”二值决策,本文把控制 token、文本、语音、委派统一进联合策略 $p_{\theta,\phi}(O_{1:K}|U,B) = \prod_k p_\theta(c_k, Y_k, D_k|\cdot)\, p_\phi(S_k|\cdot)$,声学相似的重叠能产生语义不同的后续。(2) 委派原生化:相比 JoyAI-VL-Interaction 的外部 ASR/TTS 级联,委派以 token 流内的文本 span 表达,前端无需感知工具 schema。(3) 数据耦合:约 72,200 个会话、280 万样本的流水线让同一轨迹同时监督双控行为(继续/暂停/让位/停止/恢复)与委派行为(路由/协调/重试/回退),一次后训练同时习得。(4) 免训练长视频记忆:用运动补偿预测代价做帧级门控,用带 MAD 权重的 MaxSim 结合 MMR 相关性-新颖性做检索,与微调策略完全解耦、零参数更新。
实验结果
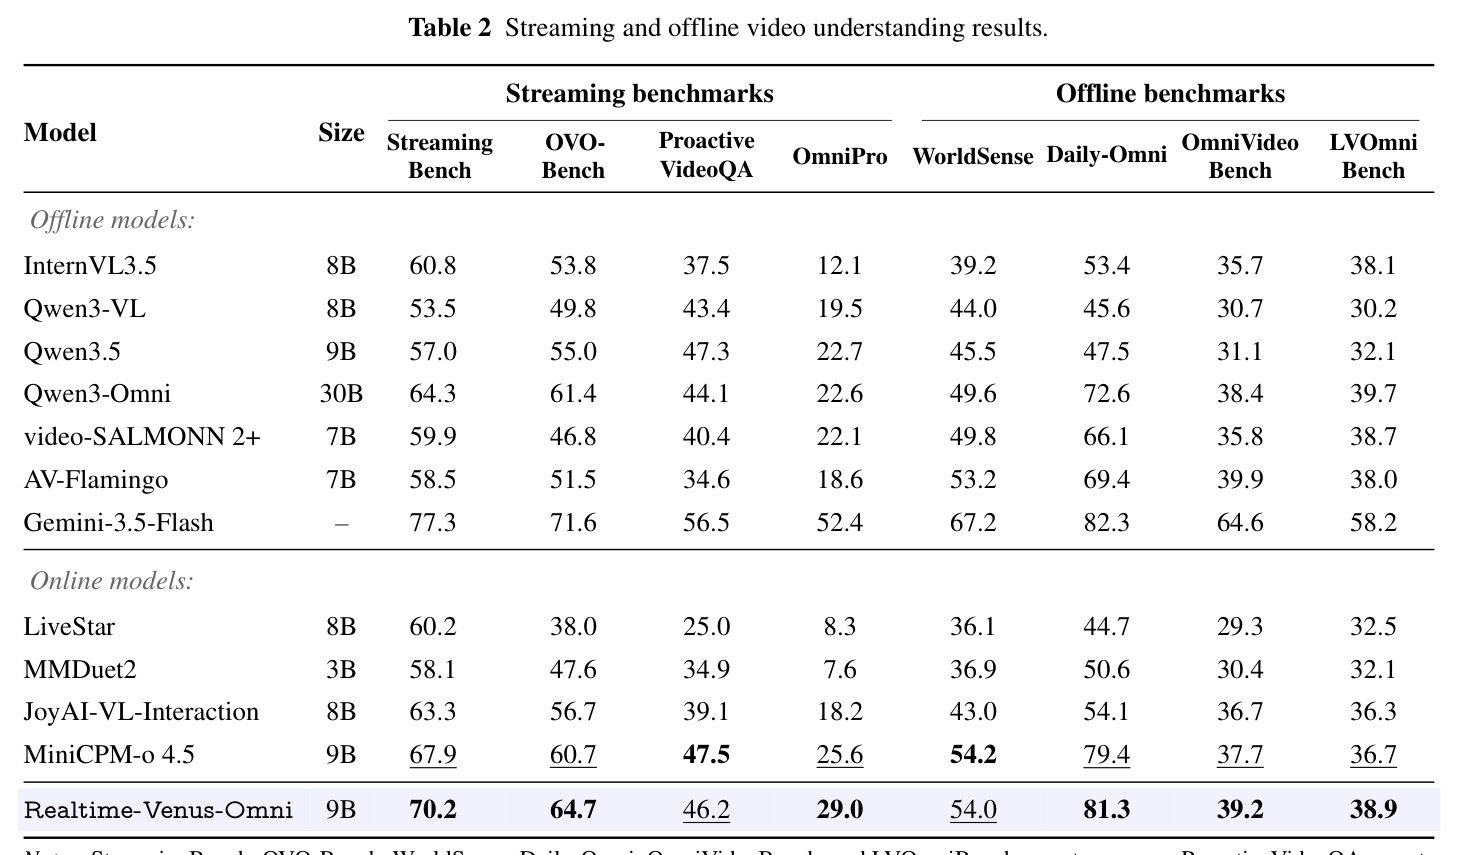
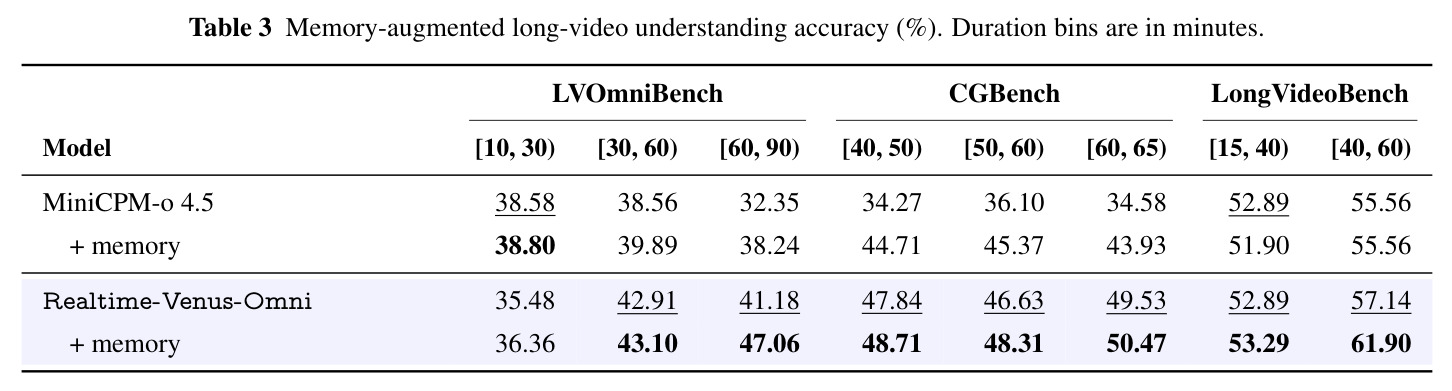
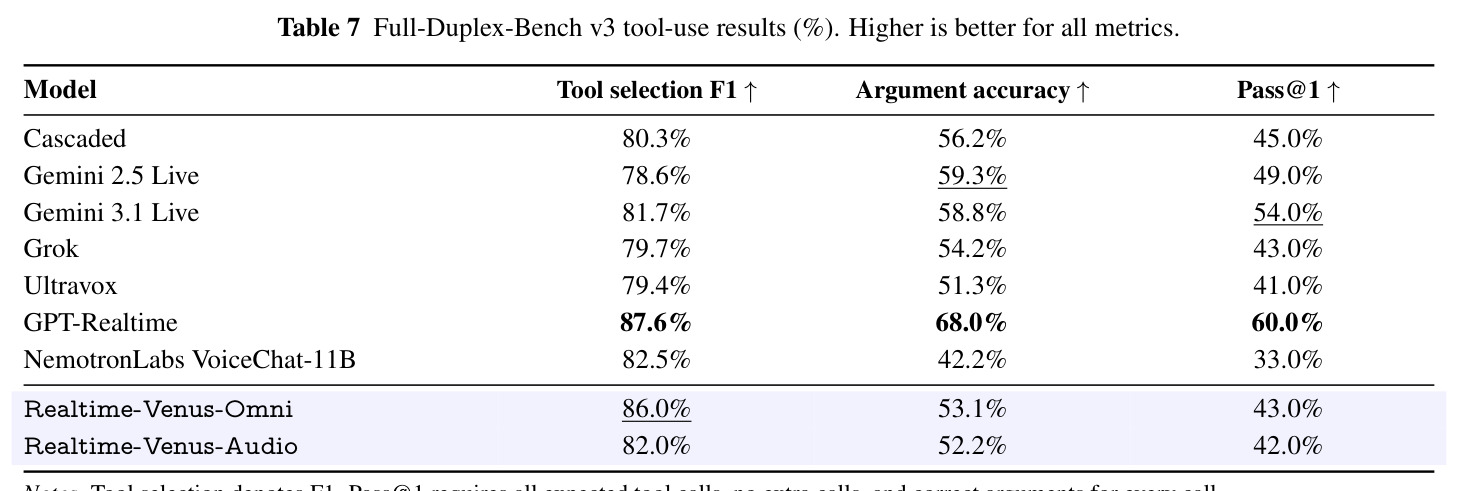
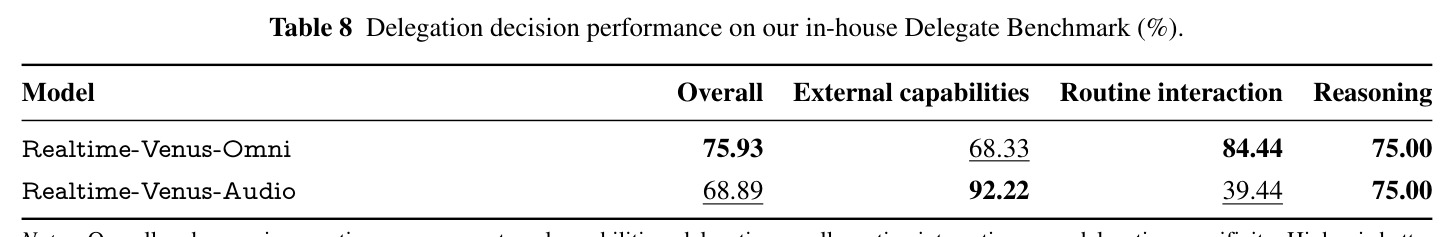
实验分四条线。(1) 视频:在线模型 8 基准 6 第一(StreamingBench 70.2、OVO-Bench 64.7、Daily-Omni 81.3),较 MiniCPM-o 4.5 最多 +4.0。(2) 免训练记忆使 LVOmniBench 60–90 分钟段 +5.88、LongVideoBench +4.76,CGBench 亦提升。(3) 音频:MMAU 78.0、MMAU-Pro 63.2 均居首,超 30B 的 Qwen3-Omni,MMAR、MMSU 居次。(4) 口语问答:Llama Questions 83.8、CMMLU 67.8 最高,AlpacaEval 4.81 并列第一。(5) 全双工:三场景继续率 0.97/0.88/0.86 领先 Gemini 3.1 Live 与 GPT-4o,打断响应 0.75 不及 Joy-Duplex 0.88。(6) 工具:FDB-v3 选择 F1 86.0% 仅次于 GPT-Realtime,参数准确率与 Pass@1(53.1%/43.0%)明显落后;委派路由两者 75.93%/68.89%,错误互补。
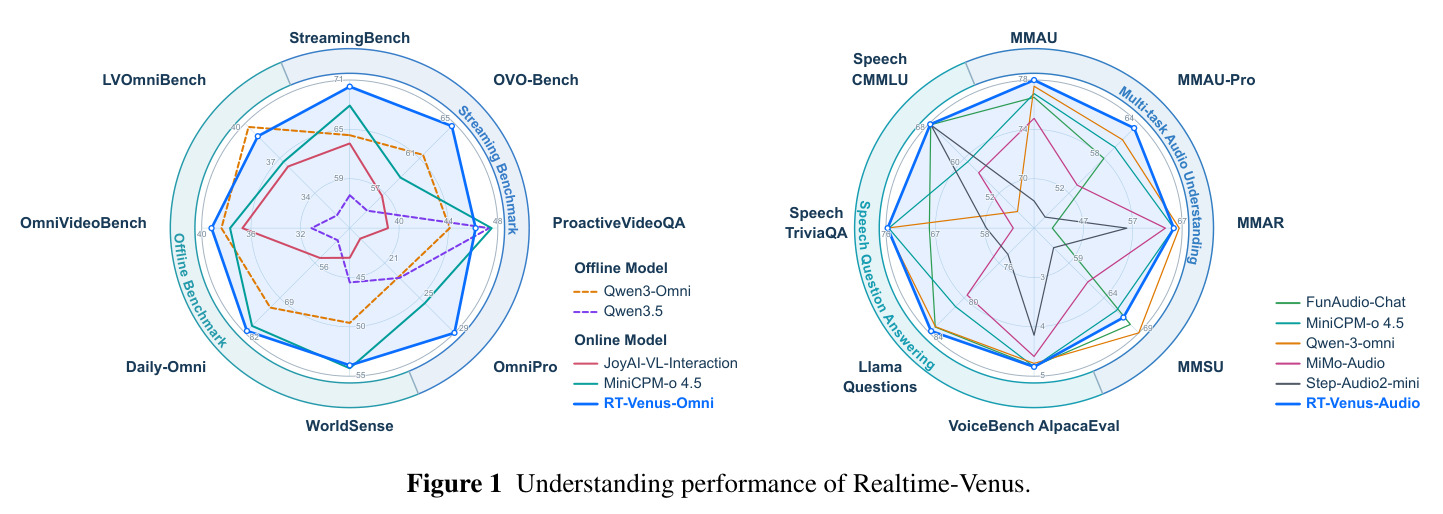
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式视频理解 | StreamingBench 准确率 | 70.2 | MiniCPM-o 4.5:67.9(最佳在线基线) | +2.3 |
| 流式视频理解 | OVO-Bench 准确率 | 64.7 | MiniCPM-o 4.5:60.7 | +4.0 |
| 离线音视频理解 | Daily-Omni 准确率 | 81.3 | MiniCPM-o 4.5:79.4 | +1.9 |
| 主动视频问答 | OmniPro 探测模式准确率 | 29.0 | MiniCPM-o 4.5:25.6 | +3.4 |
| 小时级长视频理解 | LVOmniBench [60,90) 分钟段准确率 | 47.06(加免训练记忆) | 无记忆 41.18 | +5.88 |
| 音频理解 | MMAU 准确率 | 78.0%(Realtime-Venus-Audio) | Fun-Audio-Chat:76.6%(次优) | +1.4 |
| 音频理解 | MMAU-Pro 准确率 | 63.2% | MiniCPM-o 4.5:60.0% | +3.2 |
| 全双工-用户附和 | C_RESUME 继续率 | 0.97(Realtime-Venus-Audio) | Gemini 3.1 Live:0.95 | +0.02 |
| 全双工-对旁人说话 | C_RESUME 继续率 | 0.88 | Gemini 3.1 Live:0.66 | +0.22 |
| 全双工-背景人声 | C_RESUME 继续率 | 0.86 | Gemini 3.1 Live:0.66 | +0.20 |
| 全双工-用户打断 | C_RESPOND 响应率 | 0.75(Realtime-Venus-Audio) | Joy-Duplex:0.88(最佳) | -0.13(落后) |
| 全双工工具调用 | FDB-v3 工具选择 F1 | 86.0%(Realtime-Venus-Omni) | GPT-Realtime:87.6%(最佳) | -1.6(落后,第二名) |
| 全双工工具调用 | FDB-v3 Pass@1 | 43.0% | GPT-Realtime:60.0% | -17.0(落后) |
| 委派决策 | 内部 Delegate Benchmark 总体路由准确率 | 75.93%(Realtime-Venus-Omni) | Realtime-Venus-Audio:68.89% | +7.04 |
局限与改进
作者承认的局限:结果未隔离各训练组件的贡献,缺受控消融;ProactiveVideoQA(46.2 vs 47.5)和 WorldSense(54.0 vs 54.2)上输给 MiniCPM-o 4.5;打断响应率 0.60/0.75 低于 Joy-Duplex 的 0.88,说明强继续率不等于强打断处理;FDB-v3 的参数准确率与完整任务成功率明显落后 GPT-Realtime;内部委派基准只评估“路由决策对不对”,不评估任务是否真正执行成功、结果是否被正确融入对话;Audio 版过度委派(特异度 39.44%)与 Omni 版漏委派(召回 68.33%)的问题仍待解决。我自己的观察:部分基线分数取自其他论文而非统一复现,可能存在评测协议偏差;委派基准内部构建不公开、难以横向比较;1 秒 chunk 粒度限制了对极短事件的响应时机(作者也把更细粒度列为未来工作);聚合分数无法区分语音解码错误与语义理解错误;训练超参数、算力与成本完全未披露。
独立分析的弱点
独立分析出五个弱点。其一,打断-继续权衡失衡:继续率三场景第一,但打断响应仅 0.75,说明训练数据中“该停”的边界学习不足,改进方向是引入打断强度分级标注,或对停机时机做事件级强化学习。其二,委派校准两极分化:Audio 版 39.44% 的非委派特异度意味着六成常规请求被无谓委派,白白增加延迟与算力,可加轻量置信度门控或对比式路由头;Omni 版 68.33% 的召回则需要更多外部能力触发样本做增强。其三,参数抽取是工具短板:53.1% 对 68.0% 的差距表明语音中数字、时间、专名等约束在多轮中容易丢失,可引入 ASR 文本旁路或参数级监督信号。其四,执行韧性薄弱:委派数据仅占语料 6%(约 18.5 万样本),并发任务、延迟失败重试、结果冲突调和的覆盖不足。其五,微调伤了短视频能力:无记忆的 LVOmniBench [10,30) 段 35.48 低于 MiniCPM-o 4.5 底座的 38.58,提示后训练混合比可能牺牲了基础视觉理解,需要数据配比消融。
未来方向
作者明确提出三个方向:更细粒度的流式 chunk 以捕捉短暂事件并改进响应时机;扩展上下文窗口支持更长交互,保留相关信息并追踪演化中的用户意图;研究更复杂的多步推理、协同工具使用与异步执行,重点是并发操作管理和延迟/失败工具调用的恢复。基于本文成果还可延伸:把委派后的执行质量纳入端到端评估(目前只评路由对错),形成“决策-执行-重入”闭环基准;允许前端根据对话演化主动取消或修正已委派的后台任务(当前证据快照是单向冻结的);把免训练记忆从视觉扩展到音频与对话历史记忆,并支持跨会话长期记忆;引入用户反馈在线学习打断边界;探索 Talker 与 Thinker 的联合微调以改善韵律与停顿自然度;研究多前端共享一个 Harness 实例的会话迁移与并行委派。
复现评估
开源情况:项目主页 realtime-venus.github.io,代码开源在 github.com/inclusionAI/Realtime-Venus,底座 MiniCPM-o 4.5 是开源 9B 模型,长视频记忆模块免训练、推理成本低。但论文未说明 280 万训练样本与内部委派基准是否会发布,也未披露学习率、训练轮数、GPU 数量与训练时长;记忆模块的运动匹配实现细节(块大小、阈值)未完全给出。复现难度评估:若只做推理侧复现(加载开源权重 + 复现式 (1)-(6) 的运行时与序列化格式),难度中等,附录 B 的训练样例把 unit 级格式写得非常具体,可直接照抄;若要从头复现到论文精度,必须自建约 72,200 会话级的“双工+委派”数据流水线(含场景规划、副语言声学合成、时间对齐三阶段),数据和算力成本都很高,普通团队难以承受,更适合作为工程参照而非复现目标。
论文图表
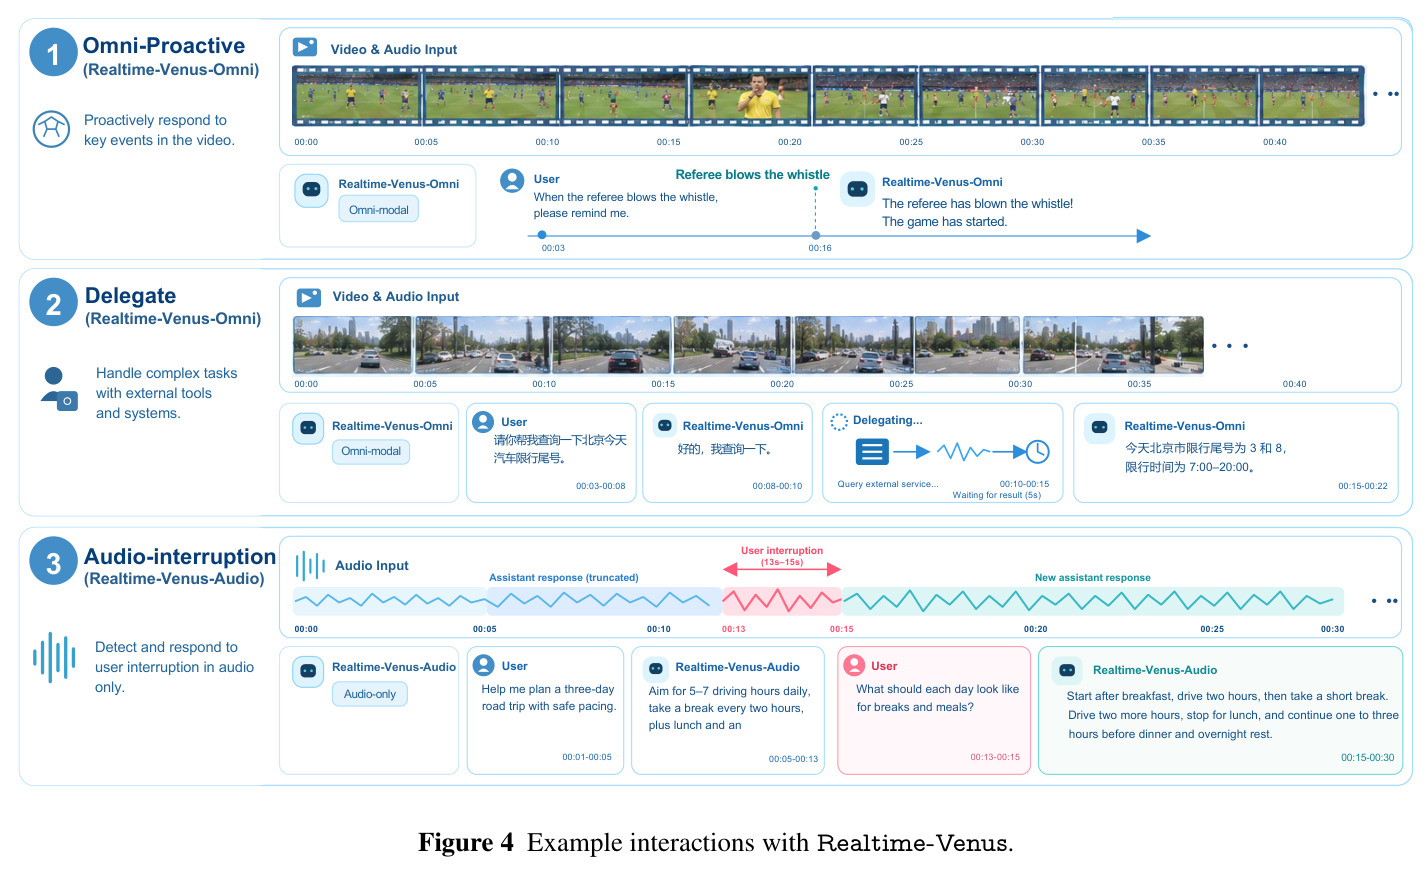
三段带时间轴的示例对话:(1) Omni-Proactive——用户要求裁判鸣哨时提醒,模型静默监听视频流,在 00:16 鸣哨瞬间立刻播报;(2) Delegate——用户问北京限行尾号,模型先口头应承,发出委派请求后等待约 5 秒,结果返回后在 00:15-00:22 播报完整答案;(3) Audio-interruption——模型播报三日自驾规划时被用户打断,立即停止并按新问题重新回答。
用三个具体场景把论文三大能力(主动交互、异步委派、打断处理)变成可感知的行为示例,比公式更利于建立直觉。