迈向临床语言模型的确定性数学求解器 Towards a Deterministic Math Solver for Clinical Language Models
让模型写代码交给受限执行器算数:临床计算器任务上,代码执行只在32B模型显著优于直接算术
前置知识
程序辅助推理(PAL / Program-aided reasoning)
让语言模型不直接给出数值答案,而是生成一段可在解释器中执行的代码(如 Python),由确定性运行时算出结果。思想是把推理与计算解耦:模型负责把问题翻译成程序逻辑,解释器负责算术,从而消除模型心算的数值错误。代表工作如 Gao 等的 PAL 与 Program-of-Thoughts。
本文的 Program-Solve 接口正是这一思想的临床特化:模型写 def solve() 程序,受限执行器运行。理解 PAL 才能读懂各对照臂的构造与『模型不计算』这一主张。
MedCalc-Bench 基准
面向临床计算器的公开基准:每道题给一份病历和目标计算器(如 APACHE II、肌酐清除率、矫正阴离子间隙),要求模型抽取变量并按公式算出数值,在基准定义的容差内判对。Verified 版含 1,100 个测试病例、55 个计算器,每个计算器均衡 20 例,另有独立的 one-shot 划分。
全部实验都在该基准上进行。理解其均衡采样与容差判分,才能看懂 440/660 覆盖划分、40% 的手写库准确率上限,以及作者对公式版本的审计为何重要。
计算器聚类 bootstrap
病例嵌套在 55 个计算器内、又跨 5 个随机种子重复,同一计算器的病例高度相关,独立假设不成立。聚类 bootstrap 以计算器为重采样单位(10,000 次抽样、百分位 95% 区间、种子捆绑在一起),给出诚实的不确定性;本文报告库对比的组内相关系数 ICC 高达 0.68–0.81,有效样本量只剩 67–79 例。
论文所有主结论都以这种区间表述,例如 7B 的 +3.29 [−3.49, 10.38] 跨零、32B 的 +7.05 [0.47, 14.60] 避开零。不懂聚类就难以判断这些差异的统计含义。
弃答与覆盖-精度权衡
手写库只实现部分计算器,遇到不支持的病例就拒绝回答。这样在覆盖集内可做到极高精度(本文 440 例上 100%),但全集准确率被覆盖率硬性封顶:22/55 的实现率把全集上限压到 40.0%。这是医疗部署中『宁可不答、不可答错』的经典弃答问题。
Program-Solve 对库的全集领先(+35.31/+50.53pp)主要来自『敢答未覆盖病例』而非『答得更准』;不理解弃答机制就会被全集数字误导,看不到库在覆盖集内仍近乎完美。
AWQ 量化与 vLLM 推理服务
AWQ 是激活感知的 4bit 权重量化方法,让大模型在显存受限时也能高效服务且精度损失很小;vLLM 是高吞吐推理框架,支持连续批处理与张量并行。本文 Qwen2.5-7B-Instruct 用 bf16 全精度、Qwen2.5-32B-Instruct-AWQ 用 4bit,均通过 vLLM 在云端 H100 上服务。
复现实验需要理解这套部署栈;同时 32B 走量化、7B 走全精度是一个潜在的混淆变量,解读两档规模差异时应留意。
研究动机
大语言模型在算术上并不可靠,而临床计算器恰恰是最怕算错的应用:APACHE II 这类评分只要一个数字出错,推荐的临床处理就可能改变。MedCalc-Bench 上的报告显示,无辅助的 ChatGPT 在 48 项计算任务中约三分之一的试验给出错误答案。业界标准对策是为每个计算器手写一个经过验证的函数,逐个实现、逐个维护,代价是覆盖面极窄:本文评测的 22 计算器函数库只覆盖 1,100 个病例中的 440 个(22/55 个计算器),全集准确率被弃答策略压到 40.0%,未覆盖的 660 例只能拒绝回答。更麻烦的是测量工具本身:作者审计发现 55 个公式中有 16 个存在版本、适用范围或系数问题,其中 4 个已被现行临床指南替代的公式仍被基准按旧值给分。
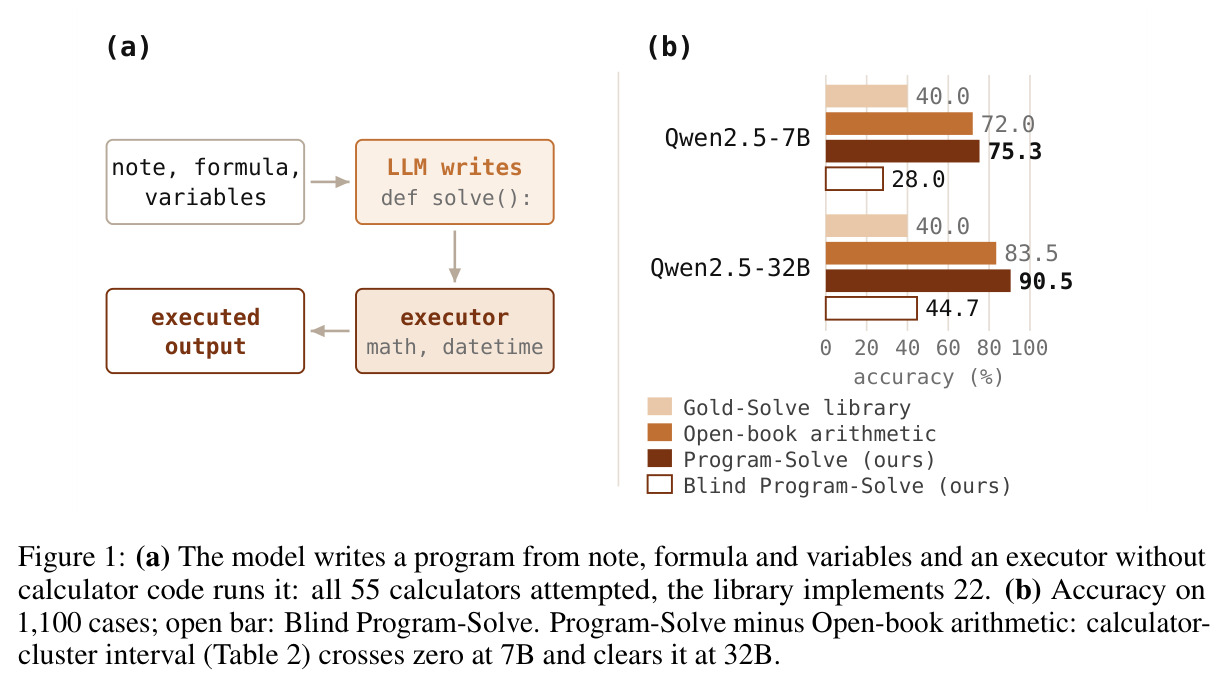
本文的目标是本文要检验一个替代方案:不再为每个计算器硬编码函数,而是让模型根据病历和公式文本写出针对该病例的 Python 程序,交给一个不含任何计算器专用代码的受限本地执行器运行,把模型的任务从『算数』降为『决定怎么算』。作者在受控条件下回答三个问题:第一,在公式文本、金标准变量、病历长度完全对齐的前提下,程序执行路线是否比同一模型直接做算术更准;第二,与手写函数库相比,生成代码路线的优劣来自覆盖还是精度;第三,剥离公式与变量访问后(Blind 模式)性能掉多少。评测在 MedCalc-Bench Verified 的 1,100 例、55 个计算器上进行,使用 Qwen2.5-7B 与 Qwen2.5-32B-AWQ,每臂跑 5 个种子(42–46)。
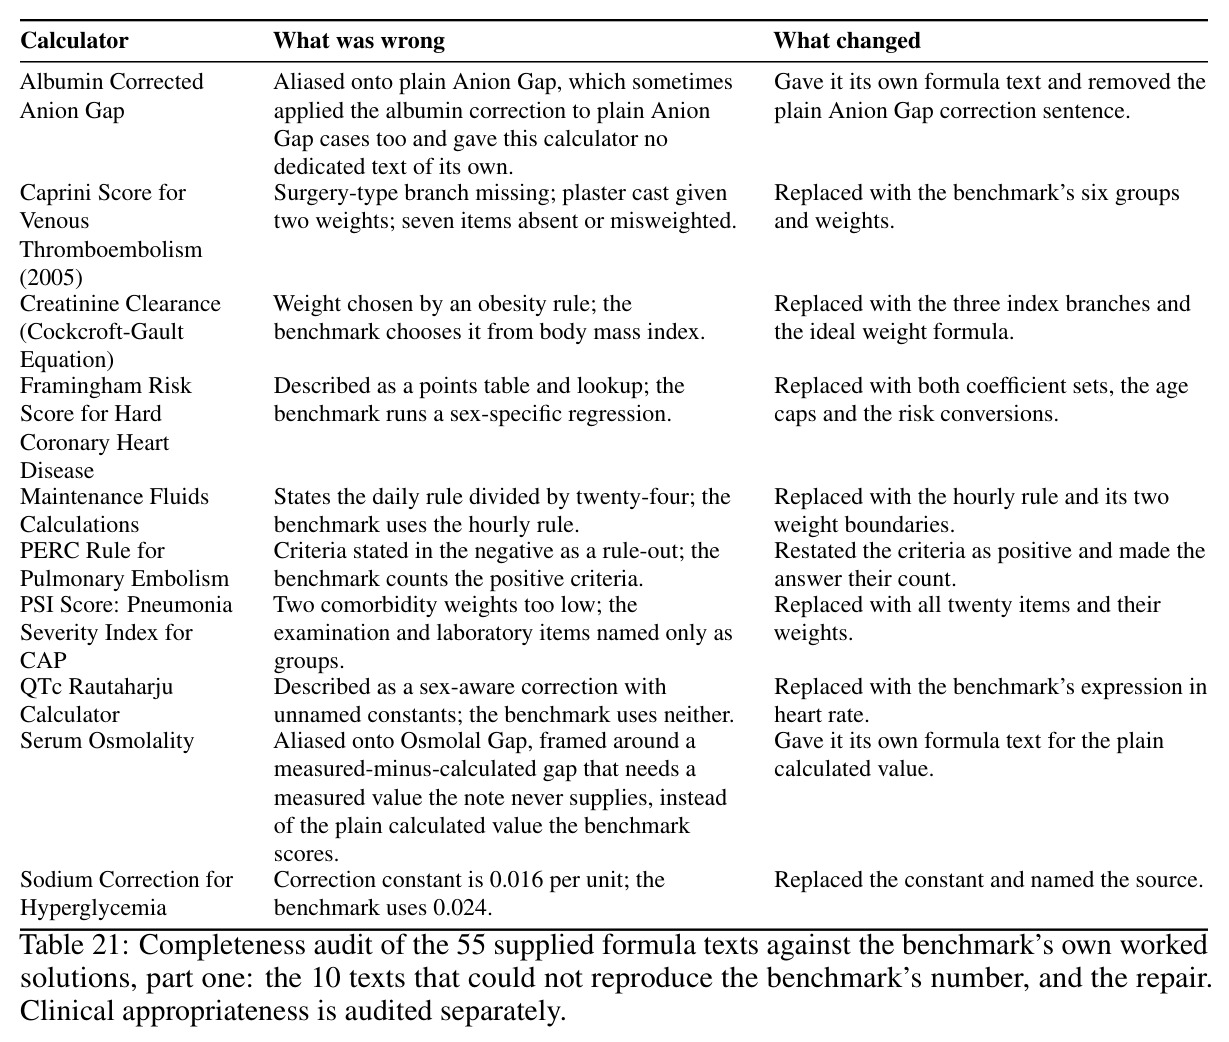
与已有工作不同的是,已有工作要么构建完整代理系统(MedRaC 检索加执行、RiskAgent 在验证工具间路由、MeNTi 嵌套工具调用、AgentMD 自动化工具策划),要么只做过一次代码解释器与专用计算器工具的对比(发现工具更准),都没有把『执行』这一个变量从公式获取、变量抽取、病历长度中干净地分离出来做受控消融。本文的独特之处在于一组输入严格匹配的对照臂:Open-book arithmetic 与 Program-Solve 拿到完全相同的公式、金标准变量和全文病历,唯一差别是算术由模型完成还是由执行器完成,差值 $\Delta$ 可直接归因于执行方式。作者还先审计了基准的 55 个公式(16 个有疑点;后续又发现 28 个公式文本错误或不完整,其中 10 个无法复现基准数字),修复后重跑所有读公式的臂,把测量误差与模型误差分开。
核心方法
直觉上,临床计算题的失败大多不是不懂公式,而是算错:临时发明单位换算、分段评分表里看错一档——正是疲惫的临床医生会犯、而经过验证的计算器不会犯的错。若把算术外包给确定性的 Python 解释器,这类低级错误应被消除。技术上,Program-Solve 把病历全文、公式文本和金标准变量放进提示词,让模型写出一个 solve() 函数;执行器在全新子进程中运行该程序:内置函数走白名单、禁用文件/eval/exec、import 限定为标准库的 math、date、time、calendar,静态拒绝 async 与生成器构造,限 256 MB 内存、5 秒墙钟和执行行数上限,返回数字、日期或孕周元组,再按基准容差评分。执行器不含任何计算器专用函数或常数,55 个计算器全部尝试;对照臂 Open-book arithmetic 拿同样输入但由模型自己做算术。
核心创新是『执行器零知识』的接口设计:与手写函数库把公式固化成经过验证的 Python 函数不同,这里执行器只提供算术原语,公式到代码的翻译完全由模型完成,因此天然覆盖全部 55 个计算器而无需逐个维护。第二个关键是输入对齐的消融矩阵:Note only(只给病历,120 词)、Page without formula(给页面但隐去公式,250 词)、Open-book arithmetic(公式+金标准变量+全文)、Program-Solve(与 Open-book 完全同输入但走执行器)、Blind Program-Solve(公式变量都不给),加上 Gold-Solve/Extract-Solve 两个函数库,把公式获取、变量抽取、算术执行三个失败源分开归因。统计上以 55 个计算器为聚类做 10,000 次 bootstrap(种子捆绑),因为库对比的组内相关系数高达 0.68–0.81,独立样本假设会严重高估功效。
方法步骤详情
流程如下。第一步,准备 MedCalc-Bench Verified 的 1,100 例测试集(55 个计算器各 20 例,基准容差内判对),one-shot 示例取自独立划分,任何测试病例的金标准答案都不进入提示词。第二步,按臂组装提示:Program-Solve 给病历全文+公式文本+金标准变量,要求输出 def solve(): 形式的程序。第三步,用 vLLM 在云端 H100 上推理:Qwen2.5-7B 用 bf16、Qwen2.5-32B-AWQ 用 4bit,每臂 5 个种子(42–46),每种子跑全 1,100 例。第四步,执行器为每个程序新建子进程运行(内置白名单、仅 math/date/time/calendar 可导入、拒绝 async/生成器、256 MB、5 秒、行数上限),解析出数字、日期或孕周元组。第五步,按基准容差判分并统计:主指标是计算器聚类 bootstrap 的 95% 百分位区间(10,000 次抽样),辅以病例 bootstrap、精确 McNemar 与符号翻转置换检验(族内 Holm 校正)。
技术新颖性
新颖性不在『模型写代码』本身——PAL 类方法早已提出——而在三点。其一,执行器被刻意掏空:不含任何临床公式或常数,这使『会多少计算器』从工程覆盖问题变成模型理解问题,从而能与手写库做公平对比。其二,匹配输入的受控比较设计:以往代码解释器与专用工具的比较混入了输入差异,本文让两条路线读同一份全文、同一公式、同一变量,配对差值直接归因于执行方式,并用聚类 bootstrap 给出可靠区间。其三,测量先行:对基准 55 个公式做文献级审计,标记 16 个有版本/适用性/系数疑点(其中 4 个已被现行指南替代),又发现 28 个公式文本错误或不完整、10 个无法复现基准数字,修复后重跑所有读公式的臂,让结论建立在修正过的测量之上。结论本身也审慎:执行只在 32B 上可靠有效,且作者明确指出该模式在不同检查点上不可预测。
实验结果
匹配比较:7B 上 Program-Solve 75.31% 对 Open-book arithmetic 72.02%,配对差 +3.29pp,聚类区间 [−3.49, 10.38] 跨零;32B 上 90.53% 对 83.47%,+7.05pp [0.47, 14.60] 避开零。失败结构也变:Program-Solve 无有效答案 6.7%(7B)/0.7%(32B)、答错 18.0%/8.8%,算术臂从不空手但错 28.0%/16.5%。库比较:Gold-Solve 库在 440 例上 100%、其余 660 例弃答,全集 40.0%;Program-Solve 全集领先 +35.31/+50.53pp,但覆盖集内仅 84.20%/98.64%——差距来自覆盖而非执行。Blind 模式掉到 28.04%/44.71%,低 47.27/45.82pp。混合策略最优:库优先+程序兜底达 81.64%/91.07%。跨家族不一致:Mistral-7B 代码 31.44% 落后算术 39.05%(−7.62),Phi-3.5-mini 57.13% 反超 52.98%(+4.15)。被指南淘汰的 4 个公式上 Program-Solve 71.00/90.00 对 28.25/36.50。
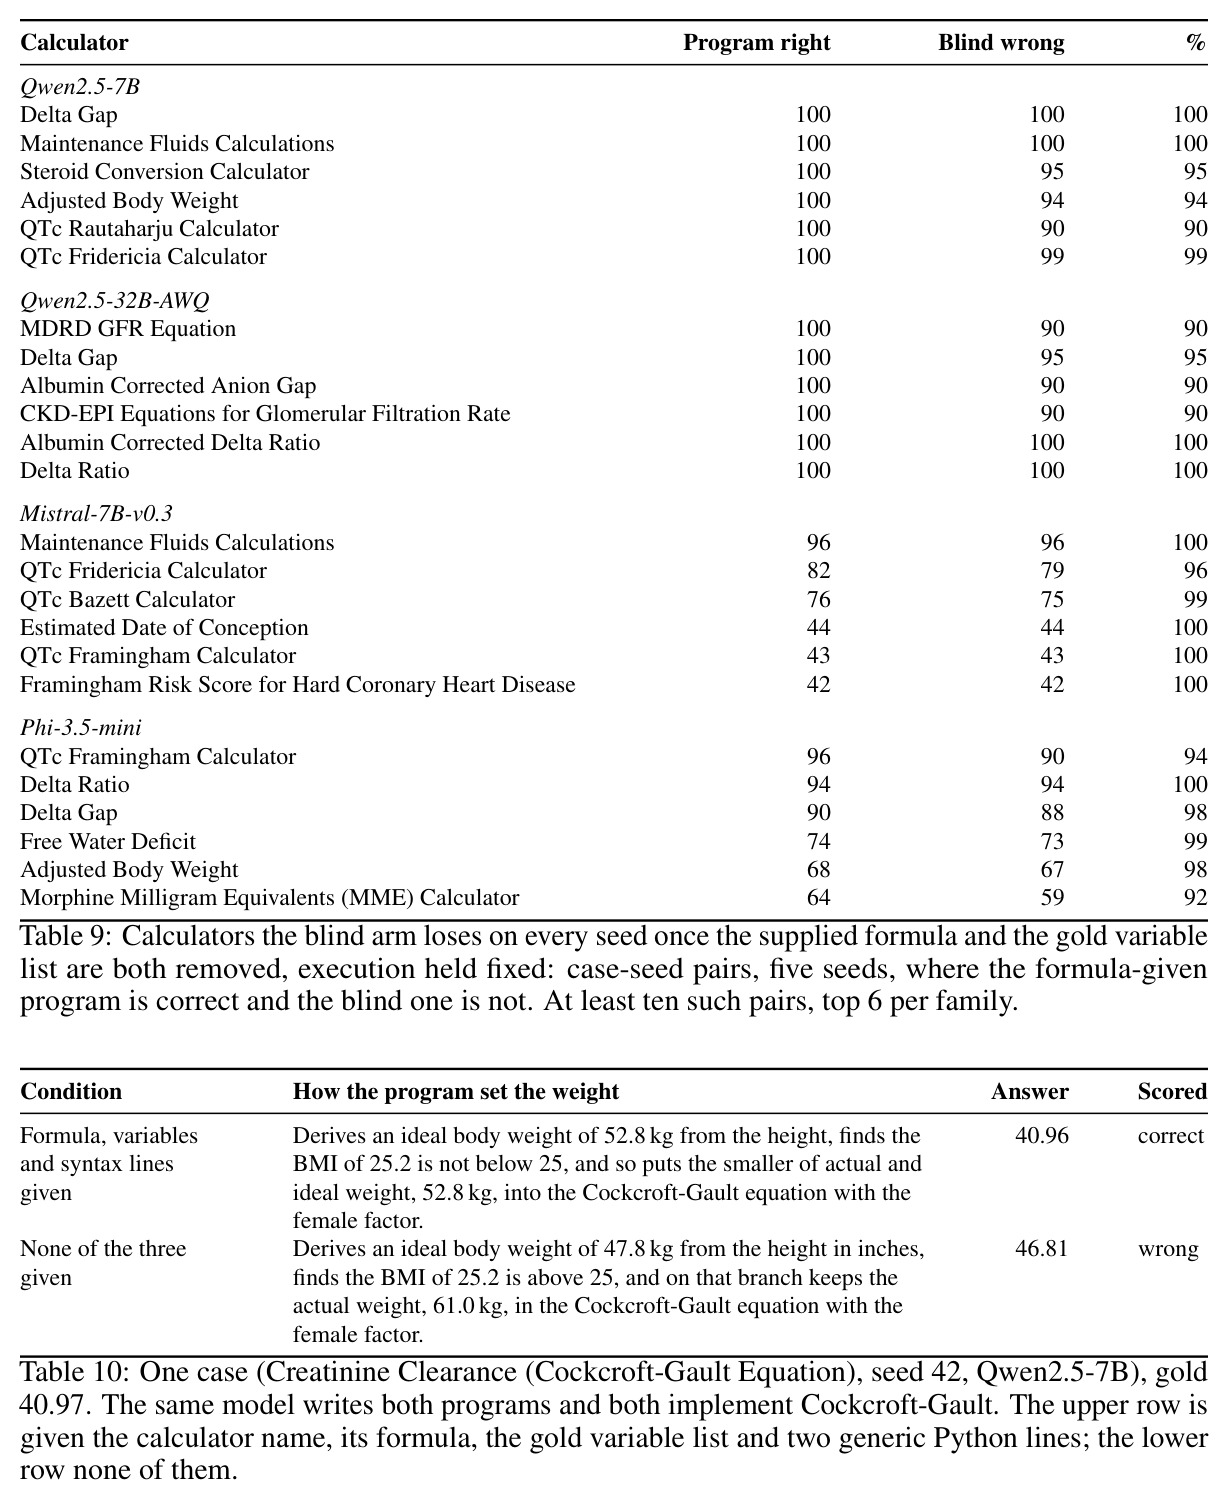
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MedCalc-Bench Verified 全集(1,100 例)· Qwen2.5-7B | 准确率(%),5 种子,计算器聚类 95% CI | Program-Solve 75.31 | Open-book 直接算术 72.02 | +3.29pp [−3.49, 10.38],区间跨零,不显著 |
| MedCalc-Bench Verified 全集(1,100 例)· Qwen2.5-32B-AWQ | 准确率(%),5 种子,计算器聚类 95% CI | Program-Solve 90.53 | Open-book 直接算术 83.47 | +7.05pp [0.47, 14.60],明确避开零,显著 |
| 全集对比手写库(1,100 例) | 准确率(%) | Program-Solve 75.31 / 90.53 | Gold-Solve 库 40.00(440 例覆盖内 100%,其余弃答) | +35.31pp(7B)/+50.53pp(32B),主要来自覆盖而非精度 |
| 覆盖集内精度(440 例,22 个计算器) | 准确率(%) | Program-Solve 84.20(7B)/ 98.64(32B) | Gold-Solve 库 100.00 | 库反超 15.80 / 1.36pp,验证弃答库在覆盖域内更可靠 |
| 盲模式(无公式无金标准变量,1,100 例) | 准确率(%) | Blind Program-Solve 28.04(7B)/ 44.71(32B) | Extract-Solve 库 38.84(7B)/ 39.00(32B) | 配对差 −10.80 [−24.35, 2.64] 与 +5.71 [−7.96, 18.87],均跨零 |
| 跨模型家族泛化(1,100 例,代码 vs 算术) | 准确率(%) | Phi-3.5-mini:代码 57.13 对 52.98(+4.15);Mistral-7B:代码 31.44 对 39.05(−7.62) | 各自直接算术 | 方向相反,说明执行收益不可由规模预测 |
| 混合策略:库优先 + 程序兜底(1,100 例) | 准确率(%) | 81.64(7B)/ 91.07(32B) | 任何单臂(最好为 Program-Solve 75.31 / 90.53) | 全集最优配置,兼顾库的覆盖内精度与程序的全覆盖 |
局限与改进
作者承认:仅两个 Qwen 检查点不能确立规模律,Mistral 与 Phi-3.5 方向相反;基准金答案即计算器自身输出,最终答案正确既不验证程序逻辑也不验证公式正确性;16/55 公式有疑点、28 个公式文本错误或不完整(10 个无法复现基准数字);+syntax 提示是在测试集上挑选的探索性结果;Note only 只读 120 词,低估预算匹配基线 4–12 分;无全球南方数据、仅英语、美国惯例,本地部署成本未测;执行器只是受限而非真沙箱(无容器/系统调用过滤)。我的补充:主臂使用金标准变量,在高风险临床部署中并不现实,真正可用的是 Blind 模式,而它只有 28–45%;22 计算器库是『机会主义』选取而非有原则的样本,库侧强结论外推有限;32B 用 AWQ 4bit 与 7B 用 bf16 存在量化精度混淆;单一基准加容差判分也限制结论外推到真实临床工作流。
独立分析的弱点
第一,变量抽取是整条链路的软肋:Blind 模式相对完整版掉了约 46–47pp,而真实部署没有金标准变量,改进方向是把抽取单独建模——例如先让模型输出结构化变量表并用金标准逐项校验,再生成程序。第二,最优混合策略(81.64%/91.07%)依赖『知道库覆盖哪些』的先验路由,改进方向是训练一个显式路由器,在弃答、调库、写程序三类动作间决策。第三,执行器安全被作者自己点破:只是受限而非沙箱,改进方向是容器/WASM 隔离加系统调用过滤,并做对抗性红队测试。第四,结论对检查点不可预测(Mistral −7.62pp 对 Phi +4.15pp),改进方向是寻找预测特征,如指令微调语料中的代码占比或基础模型的代码能力分数。第五,公式版本治理缺位:16/55 有疑点、4 个已被指南替代,方向是把公式溯源与版本作为接口的显式输入,并让基准随指南更新。
未来方向
作者提出的下一步是回答『什么区分了受益与不受益的检查点』。由此可延伸:在多个模型家族与规模上重复该协议,检验执行收益是否随代码能力(如 HumanEval 分数)可预测地增长;把 Gold-first 混合路由(81.64%/91.07%)做成带置信度估计的在线系统,学习何时弃答、何时调库、何时写程序;针对盲模式训练专门的变量抽取与单位归一化模块,攻掉约 46pp 的主要损失来源;将公式审计流程自动化(对照现行指南标记被替代公式)并发布带版本的公式库;系统探索多语言与单位制(mmol/L 对 mg/dL、日月年日期)下的失败率——作者已用日期格式提示示范了 locale 假设的影响;最后把执行器硬化为真沙箱,并度量本地推理的真实延迟、成本与碳足迹。
复现评估
复现条件相当好。代码与数据已在 GitHub 开源(github.com/felipeocampoos/Towards-a-Deterministic-Math-Solver-for-Clinical-Language-Models),基准 MedCalc-Bench Verified 为 CC-BY-SA 4.0,两个 Qwen 检查点为 Apache 2.0。算力门槛中等:vLLM 服务,Qwen2.5-7B(bf16)与 Qwen2.5-32B-AWQ(4bit)各占一张 H100(Mistral 用两张做张量并行),每臂 5 个种子跑全 1,100 例,主臂约七个加若干探索臂,总量在数百 GPU 推理小时级。实验协议(解码参数、token 限制、提示预算、执行器设置)在附录 Table 16,逐臂流程在附录 A.1,统计方法(10,000 次计算器聚类 bootstrap、McNemar、Holm 校正)描述完整。主要风险在于提示词细节与审计后的公式文本版本,好在审计结果与修正后文本随论文发布,总体属于高可复现工作。
论文图表
配对差值表。上块为原始提示:Program-Solve 减 Open-book arithmetic 在 7B 为 +3.29 [−3.49, 10.38](跨零)、32B 为 +7.05 [0.47, 14.60](避开零);对 Gold-Solve 库为 +35.31 [21.87, 48.11] 与 +50.53 [38.00, 62.80];Blind Program-Solve 对 Extract-Solve 库为 −10.80 与 +5.71,均跨零。下块为在测试集上挑选的探索性 +syntax 提示结果。
论文的核心统计证据。『7B 不显著、32B 显著』这一头条结论完全由该表的区间跨零与否定义,也是理解聚类 bootstrap 必要性的最佳示例。
报告两条语法提示行在来自三个模型家族的四个检查点上对 Program-Solve 与算术差距的影响:效应范围从 −4.5 到 +2.6pp,方向不一致;7B 上 +syntax 带来 +2.64pp [−0.64, 6.29],32B 上仅 +0.44pp [−1.38, 2.35]。
警示提示工程结论的脆弱性:在测试集上挑选的提示改动无法稳定迁移到其他检查点,提醒读者不要过度解读 +2.64pp 的提升。
报告各比较族的组内相关系数与有效样本量:库对比的 ICC 高达 0.68–0.81,有效样本量仅 67–79 例;算术对比的 ICC 较低,有效样本量 120–190 例。
解释为什么必须以计算器为聚类单位做 bootstrap:病例在同一计算器内高度相关,若按独立样本计算会严重高估统计功效,这是读懂文中所有区间估计的前提。
把手写库覆盖的 440 例单独比较:Gold-Solve 库 100%(构造上精确),Program-Solve 只有 84.20%(7B)与 98.64%(32B);回答其余 660 例则以部分错误答案替换了库的弃答。
揭示全集 +35/+50pp 领先的真实来源是覆盖而非执行质量:在库擅长的领域内,经过验证的函数仍然更准,这直接支撑『库优先+程序兜底』的部署建议。
属于公式审计(Tables 11–13)的一部分:55 个公式中 16 个被标记有版本、适用性或系数疑点;剔除后在 39 个审计干净的计算器上,Program-Solve 对 Gold-Solve 库的差距仍有 +32.26 [15.51, 48.21](7B)与 +47.59 [32.97, 61.79](32B)。在被现行指南替代的 4 个公式上,Program-Solve 71.00/90.00 对算术 28.25/36.50。
证明头条结论对公式质量问题稳健,同时暴露基准本身奖励过时公式的问题——这是论文『测量先行』方法论的集中体现。
分解各臂的失败结构:Program-Solve 无有效答案 6.7%(7B)/0.7%(32B)、答错 18.0%/8.8%;Open-book arithmetic 从不空手但答错 28.0%/16.5%。
展示两条路线质的差异:执行路线可能因程序无效而弃答,但一旦给出答案就更可能正确;算术路线永远作答却错得更多。对部署中的失败模式设计有直接参考价值。
混合策略结果:Gold-first 混合(库答其 440 例,Program-Solve 兜底其余)达 81.64%/91.07%,超过任何单臂;以 Open-book arithmetic 为兜底为 78.56%/86.89%(程序兜底仅 +3.07/+4.18pp,区间跨零);Extract-first 混合的程序兜底反而 −26.44/−25.84pp,明确为负。
给出论文最具实用价值的部署结论:验证过的库优先、生成程序补盲区、必要时显式弃答,并说明兜底组件的选择至关重要。
记录每个臂的解码参数、token 限制、病历词预算(Note only 120 词、Page without formula 与 one-shot 臂 250 词、其余全文)以及执行器的资源限制(256 MB 内存、CPU 限制、5 秒墙钟、执行行数上限、math/date/time/calendar 导入白名单)。
复现该工作的关键配置清单:所有臂的提示预算与执行器参数都在这里定义,保证不同臂之间的可比性可被独立核查。
控制变量实验:固定变量访问、只把提示预算加到 250 词(无金标准变量),在每个模型家族上都能带来 4–12 分的提升。
把『读得多』与『给得多』两个因素分开,说明早期臂间的部分差距来自病历长度预算而非信息访问本身,防止对消融结果的误读。