临床医生对语言模型的真实使用偏离其评估基准 Clinician use of language models diverges from how the models are evaluated
12.8万条真实临床查询显示:医疗LLM基准与实际临床用法严重错位,文档与检索占近三分之二。
前置知识
RCQ(真实临床查询)
Real Clinical Query,指临床医生与机构安全 LLM 助手对话中的第一轮用户输入。它是临床人员主动发出的完整请求(命令、问题或关键词片段),被本文选为分析单元,因为第一轮最能代表医生带着什么任务来找系统。
全文所有统计(127,833条对话、127,625条有效标注)都建立在这个单元上,理解它才知道每个百分比分母是什么。
RCQ-Map 标注框架
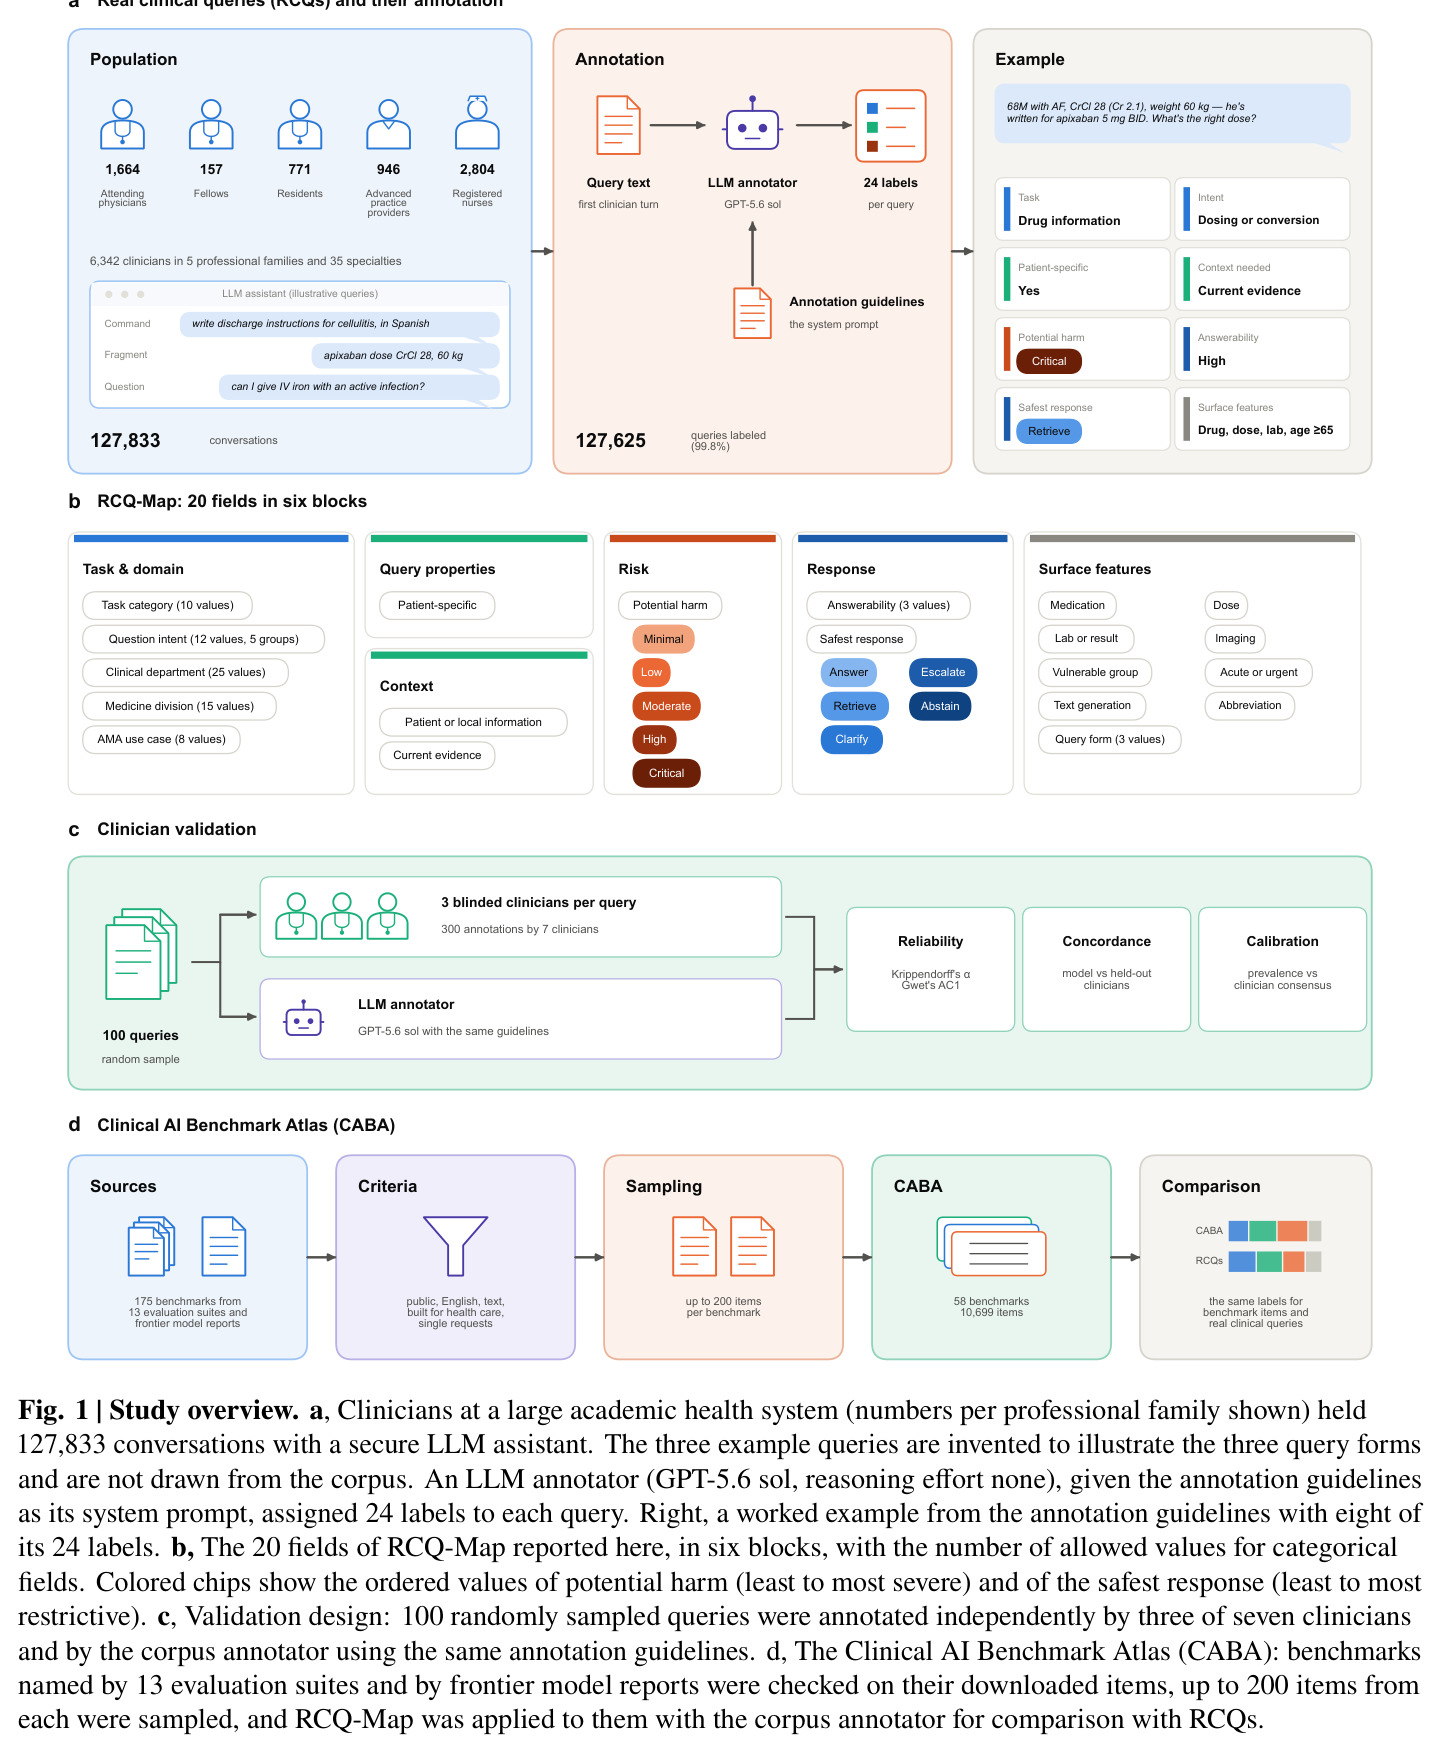
作者研制的临床查询标注体系,含20个字段、6大模块:任务(10类)与意图(12类)、临床科室、查询表层特征(是否提药、剂量、急症等9项)、上下文缺失(患者/本地信息、当前证据)、五级潜在伤害、三级可答性与五种最安全响应。类别综合自临床问题分类学与 LLM 评估框架。
它是把真实使用和基准条目放进同一把尺子的工具,没有它就无法做同口径比较。
标注者一致性(Krippendorff's α 与 Gwet's AC1)
衡量多位标注者(这里是临床医生)对同一字段判断一致程度的机会校正统计量。Krippendorff's $\alpha$ 适用于多人不完整标注设计,惯例上 $\alpha \ge 0.667$ 为勉强可接受、$\alpha \ge 0.800$ 为可靠;Gwet's AC1 对稀有类别更稳健。
论文用 $\alpha$ 区分哪些标注字段可信(任务 $\alpha$=0.64)、哪些先天主观(伤害 $\alpha$=0.36),这直接决定你能相信文中哪些数字。
潜在伤害分级(AHRQ 伤害量表)
五级量表(最低/低/中/高/危级),改编自美国医疗研究与质量局 AHRQ Common Formats 伤害量表及 NCC MERP 用药错误索引。关键定义:伤害指『如果模型答错且医生不加核查就采纳行动』的后果严重度,而非模型出错的可能性。
13.2% 高/危查询、药物信息贡献一半危级查询等核心安全结论都基于这个口径,混淆『伤害』与『错误率』会误读全文。
可答性与最安全响应(选择性预测 / learning to defer)
可答性记录查询能否按原文很好回答(能/需实质假设/完全不能);最安全响应借用选择性预测与 learning-to-defer 思想,按限制性从弱到强排序为:直接回答、检索权威来源后回答、向医生澄清、升级人类专家、拒答,标注者选『保持安全的最弱干预』。
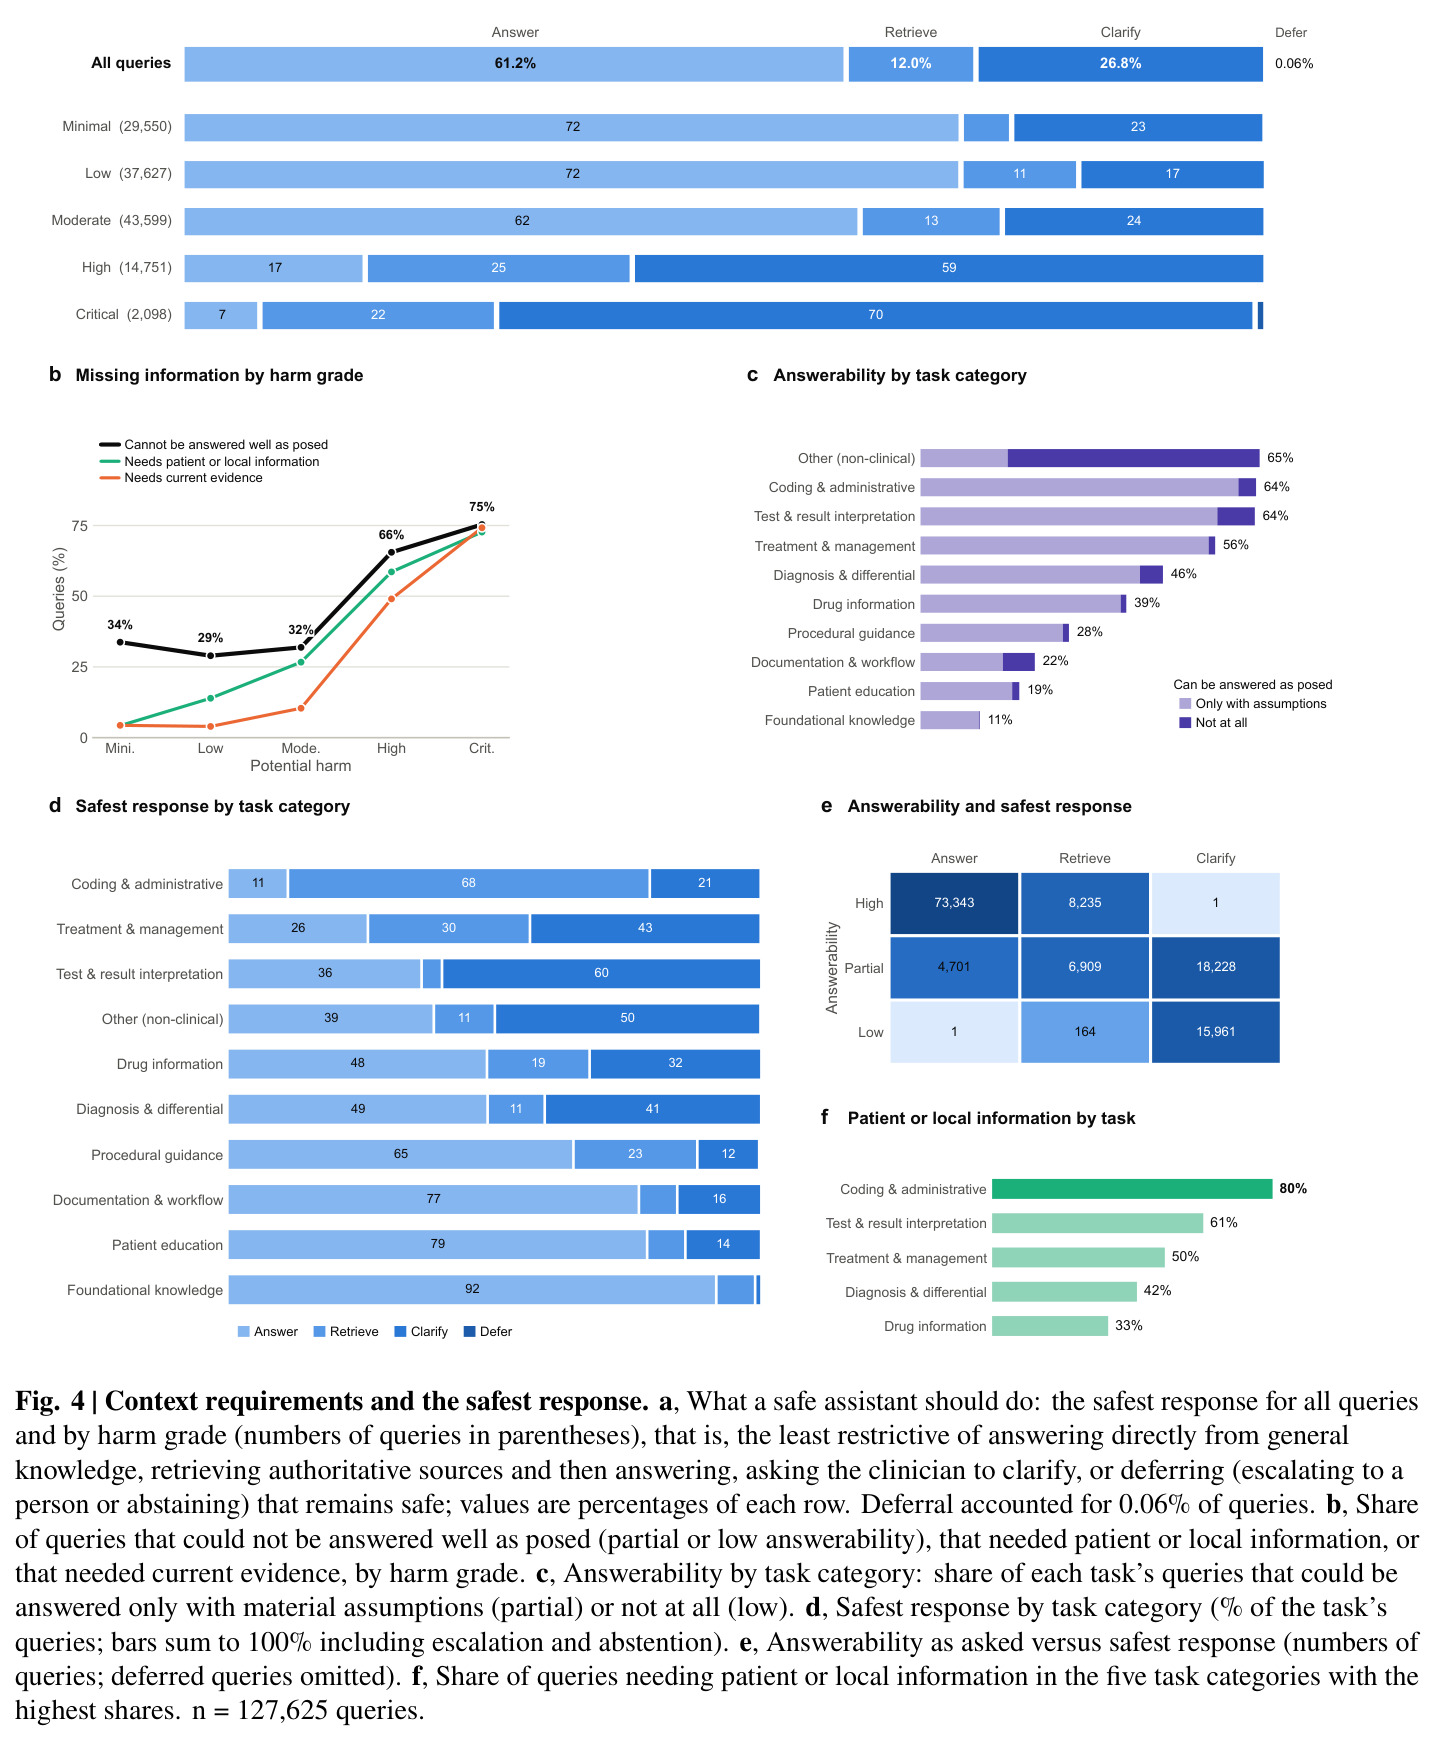
这是本文超越传统 accuracy 评估的第二个维度:考试型基准几乎全是『直接回答』,而真实查询有38.8%不该直接答。
总变差距离(TVD)与任务组合覆盖率
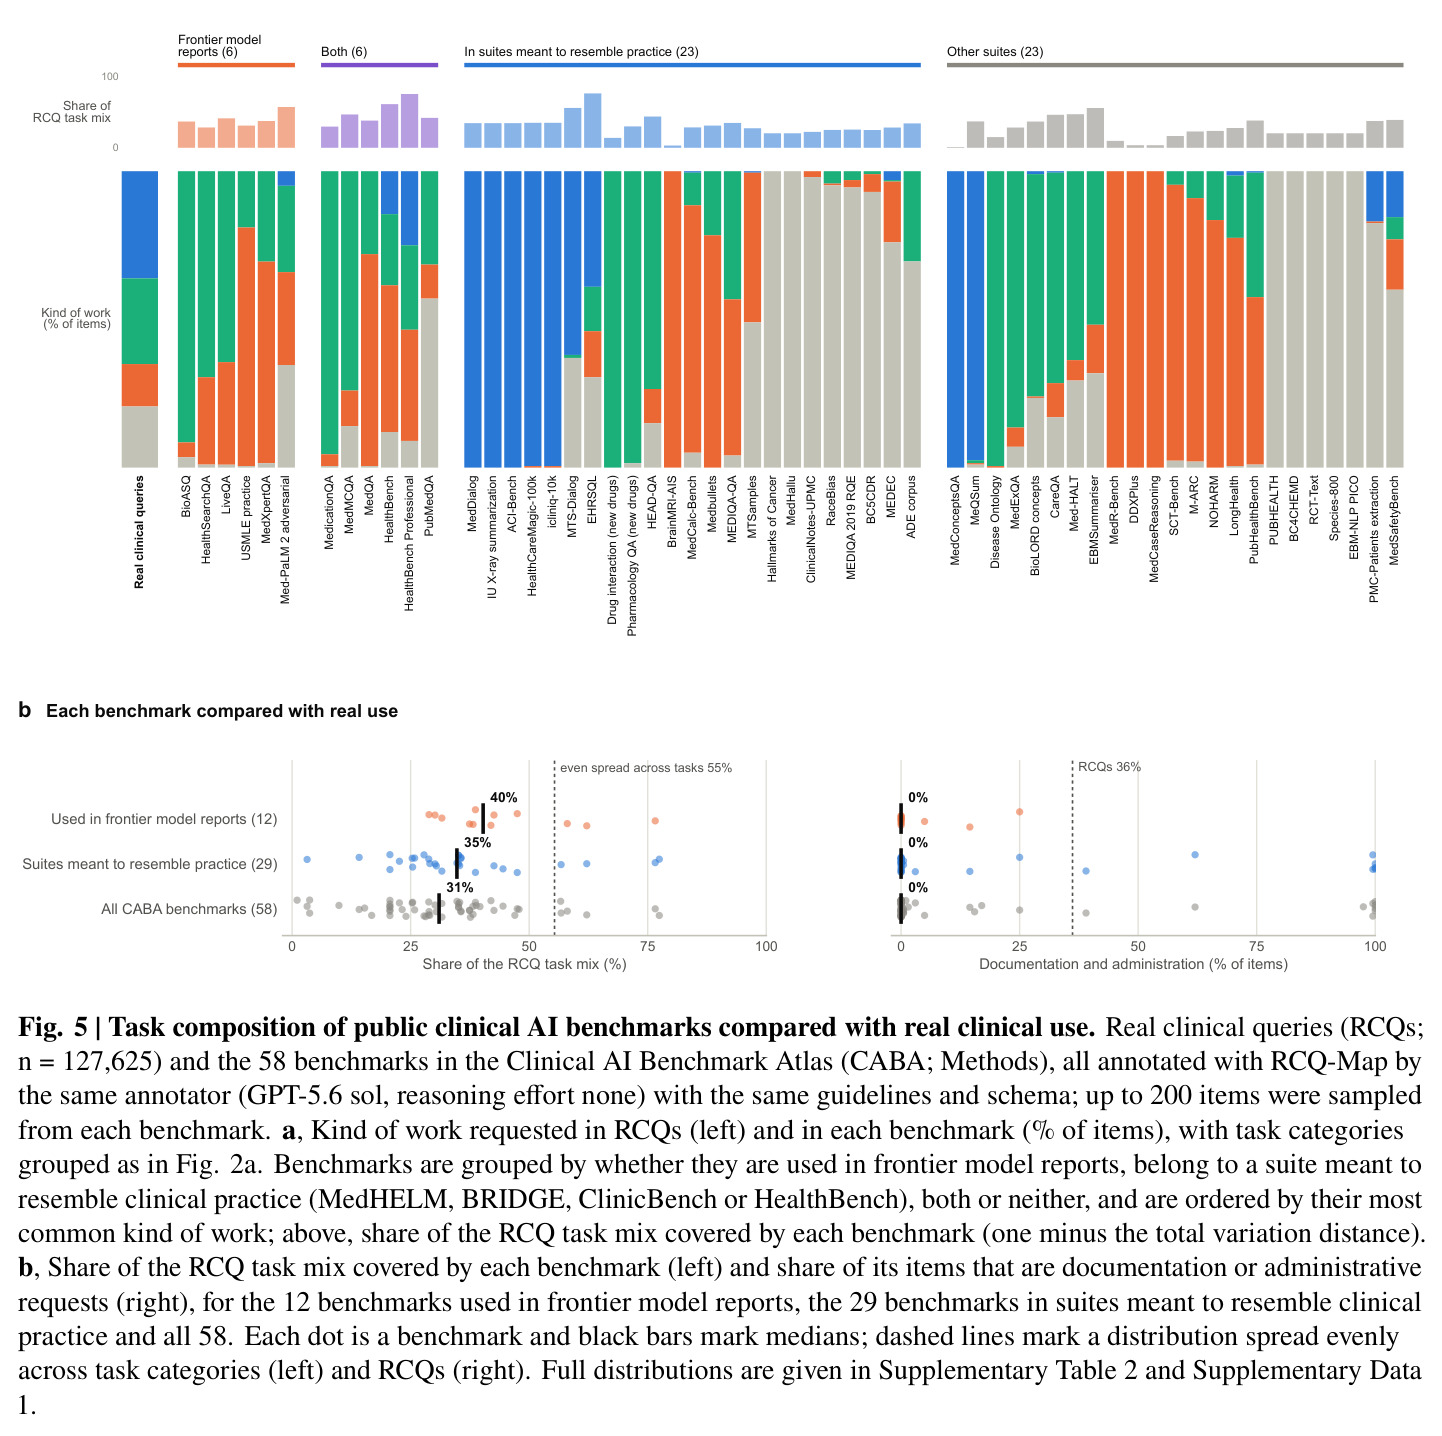
两个离散分布的距离 $d_{TV}(p,q)=\frac{1}{2}\sum_{i}|p_i-q_i|$,取值0(完全相同)到1(无重叠)。本文定义某基准对真实使用的覆盖率为 $1-d_{TV}$;若任务均匀分布在10个类别上,覆盖率为55%。
『中位基准覆盖率仅31%』这个标题级结论就是用这个量算出来的,理解它才能判断31%意味着多严重的错位。
CABA(临床AI基准图谱)
作者从13个公开评估套件(MedHELM、HealthBench、MAST 等)和13家前沿模型厂商的技术报告中汇总出的基准目录:175个候选经公开性、英语、纯文本、医疗专用、单请求五条标准筛选后剩58个,每个最多抽200条,共标注10,659个条目。
CABA 是对比侧的全部数据来源,其筛选标准决定了结论适用于『公开、英文、文本基准』这一范围。
研究动机
医疗 LLM 的部署与评估严重脱节。美国超过80%的医生已在职业中使用AI,医疗系统也纷纷上线安全 LLM 助手,但评估证据几乎全部来自人造题目:截至2024年初的519项医疗LLM评估中仅5%使用真实患者诊疗数据;规模更大的综述显示,截至2025年9月的4,609项研究中77.3%未使用任何真实临床数据。模型在执业考试类基准上已接近满分,却在真实病例上达不到相应准确率。即便新出现的『贴近临床』基准(如 HealthBench、Real-POCQi)改用医生撰写或提交的问题,也只覆盖医生群体——护士和高级执业提供者(APP)在临床AI评估中几乎缺席。此前唯一一次任务层面的对照发现:某图表连接型助手的一半最常见任务在专为评估设计的 MedHELM 121项任务分类中找不到对应。也就是说,基准里的题与部署后系统实际收到的请求有多重合,从来没人测过,而基准分数能否预测部署表现恰恰完全取决于这一点。
本文的目标是本文的目标是首次在大规模真实部署中量化『评估与使用的偏离』。具体拆成三件事:其一,系统刻画一家大型多医院学术医疗体系中6,342名临床人员(主治医师、专科医师、住院医师、APP、注册护士,跨35个专科)在8个月里发给机构LLM助手的127,833条真实查询的任务构成、意图、语法形态、风险等级与上下文需求;其二,研制一套临床医生验证过、有公开指南与代码的标注框架 RCQ-Map,使这种刻画可在其他机构复现;其三,用完全相同的框架和标注器标注58个公开临床AI基准(汇总为 CABA 图谱),逐基准比较其任务分布与真实使用分布,直接回答『基准分数到底说明了部署表现的多少』,并检验专为模拟临床实践设计的基准套件是否真的更接近真实。
与已有工作不同的是,本文的独特切入是把『基准代表性』从口头批评变成可计算的量:不去比较模型得分高低,而是比较任务分布本身。做法上让比较两侧同尺——真实查询与基准条目用同一套 RCQ-Map 指南、同一个经验证的 LLM 标注器标注,从而得到同口径的总变差距离 $d_{TV}$ 与覆盖率。此前的工作要么只统计文献里研究过哪些任务,要么只做小规模人工分类;本文覆盖整个机构8个月的全量日志,且近半数对话来自护士与APP,是首个包含非医生群体的部署级刻画。它还引入了此前被忽视的维度:36.1%的真实查询无法按原文安全作答,需要澄清或检索患者/本地信息——考试型基准在结构上(题目自带全部所需信息)永远测不到这类行为,因此错位不只是比例问题,更是评估能力维度的问题。
核心方法
核心直觉:基准只在它的题目覆盖了部署实际收到的请求时才能预测部署表现,所以要同时测量『真实请求长什么样』和『基准题目长什么样』,再算两个分布的距离。技术路线分四步。第一步数据侧:从一家多医院学术医疗系统的安全 LLM 助手收集2025年8月12日至2026年4月3日的127,833段对话,取每位用户第一轮文本作为 RCQ,经 Epic Clarity 记录关联得到职业群体与专科;查询文本由IT团队在受控环境移除,研究者只接触标签级数据。第二步框架侧:综合临床问题分类学、LLM 评估框架与患者安全量表构建 RCQ-Map(24个标注字段,验证后保留20个)。第三步标注侧:用 LLM 标注器(GPT-5.6 sol,推理档 none,指南全文作为系统提示词,严格 JSON schema 约束输出,硬一致性规则校验)标注127,625条(99.8%),并用7名临床医生对100条随机样本每人独立盲标(每条3人)验证。第四步对比侧:把同一框架应用于 CABA 中58个公开基准的10,659个条目,计算任务、意图、风险与最安全响应分布与真实查询的距离。
核心创新是『同尺测量两边』:真实使用与基准条目此前从未被放进同一个标注框架比较过。本文让基准的代表性变成一个数字——某基准任务分布与真实查询任务分布的覆盖率 $1-d_{TV}$,并给出参照系(均匀分布的覆盖率为55%,真实查询自身为100%)。第二个关键想法是把评估目标从『答对没有』扩展到『该不该直接答』:RCQ-Map 为每条查询标注可答性与最安全响应,这借鉴了选择性预测与 learning-to-defer 文献,但首次用于刻画真实部署负载,从而暴露出考试基准无法测量的能力维度。第三个想法是用『潜在伤害』(假设医生不核查就采纳错误答案的后果,五级量表改编自AHRQ)而非错误概率定义风险,再把风险与查询文本可观测特征(剂量、急症、缩写等)关联,证明部署系统可以在回答前从文本识别高风险查询(AUC 0.78)。第四个想法是诚实的校准:承认 LLM 标注器比医生更谨慎,给出模型口径与医生共识口径的换算。
方法步骤详情
第一步,采集与脱敏:IT团队在受控环境移除查询文本,研究者只获标签级数据,专科按 k=10 的 k-匿名抑制;121段无文本与87段校验失败对话被剔除。第二步,RCQ提取:取每段对话第一轮医生输入(截断至100,000字符),得127,625条有效查询(99.8%)。第三步,RCQ-Map标注:24个强制选择字段——10类任务、12类意图(归并为5组)、临床科室与内科亚专科、AMA用例、9个表层特征(药物、剂量、化验、影像、脆弱人群、急症、要求生成文本、语法形式、缩写)、上下文缺失、5级伤害、3级可答性、5种最安全响应;验证后剔除2个一致性差的字段。第四步,验证:100条查询由7名医生中的3人盲标(共300份标注),用 Krippendorff's $\alpha$ 评一致性,并以『轮流留一』设计让模型与医生在同一参照下比较一致率(模型84.6% vs 医生83.0%)。第五步,构建CABA:从13个评估套件与前沿模型报告命名的175个基准中,经公开、英文、文本、医疗专用、单请求五条标准筛出58个,每个最多随机抽200条,标注10,659条。第六步,分析:按医生聚类的 bootstrap 置信区间、风险 logistic 回归(调整后OR)、11个文本特征的五折交叉验证 AUC,以及基准-真实分布的 $d_{TV}$ 覆盖率比较。
技术新颖性
技术新颖性有四点。其一,规模与人群:127,833条查询是迄今最大的临床LLM使用刻画,且近半数对话来自护士与APP(2,804名RN贡献31.9%的对话),填补了评估文献长期只看医生的空白。其二,标注方法工程化:『指南即系统提示词+严格JSON schema+硬一致性规则+指数退避重试』的流水线,使 LLM 标注器在23个字段上对留出医生参照的一致率(84.6%)超过临床医生本人(83.0%),伤害判断的二次加权 $\kappa$ 也高于医生两两之间(0.53 vs 0.36),这是对『LLM作为标注器』在临床场景少见的严格验证。其三,把基准本身当作研究对象:CABA 逐条标注基准条目而非转述基准论文的自述,发现专为模拟实践设计的套件(MedHELM、BRIDGE、ClinicBench、HealthBench)与前沿模型报告所用基准的覆盖率差异为−5.5个百分点(95% CI −21.2至0.3),即『贴近临床』的意愿并未兑现。其四,多维度偏离刻画:覆盖率、文档类缺席、风险结构(基准高/危条目占比34.5–54.5% vs 真实13.2%)与响应路由结构四个互补维度,而非单一指标。
实验结果
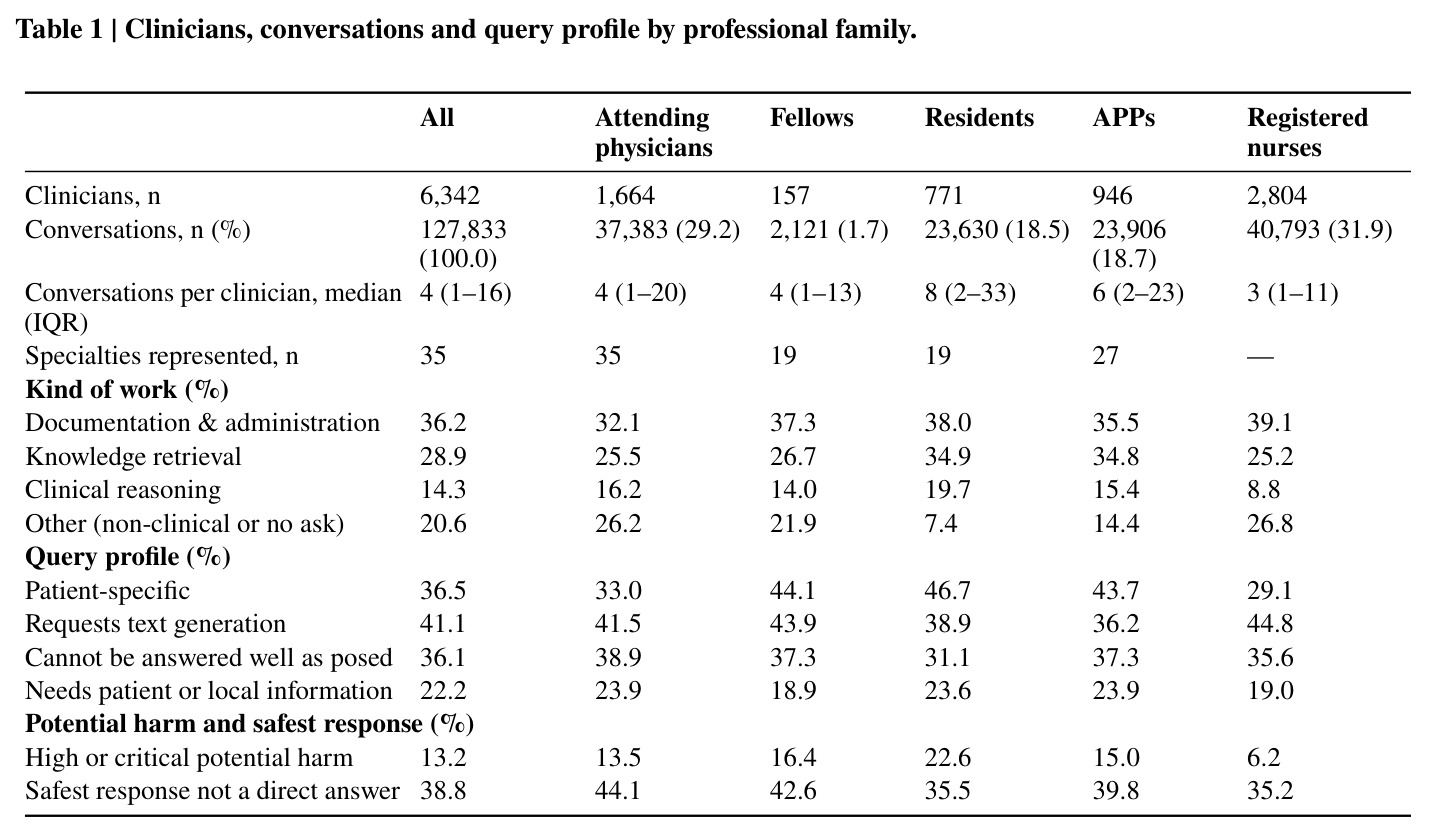
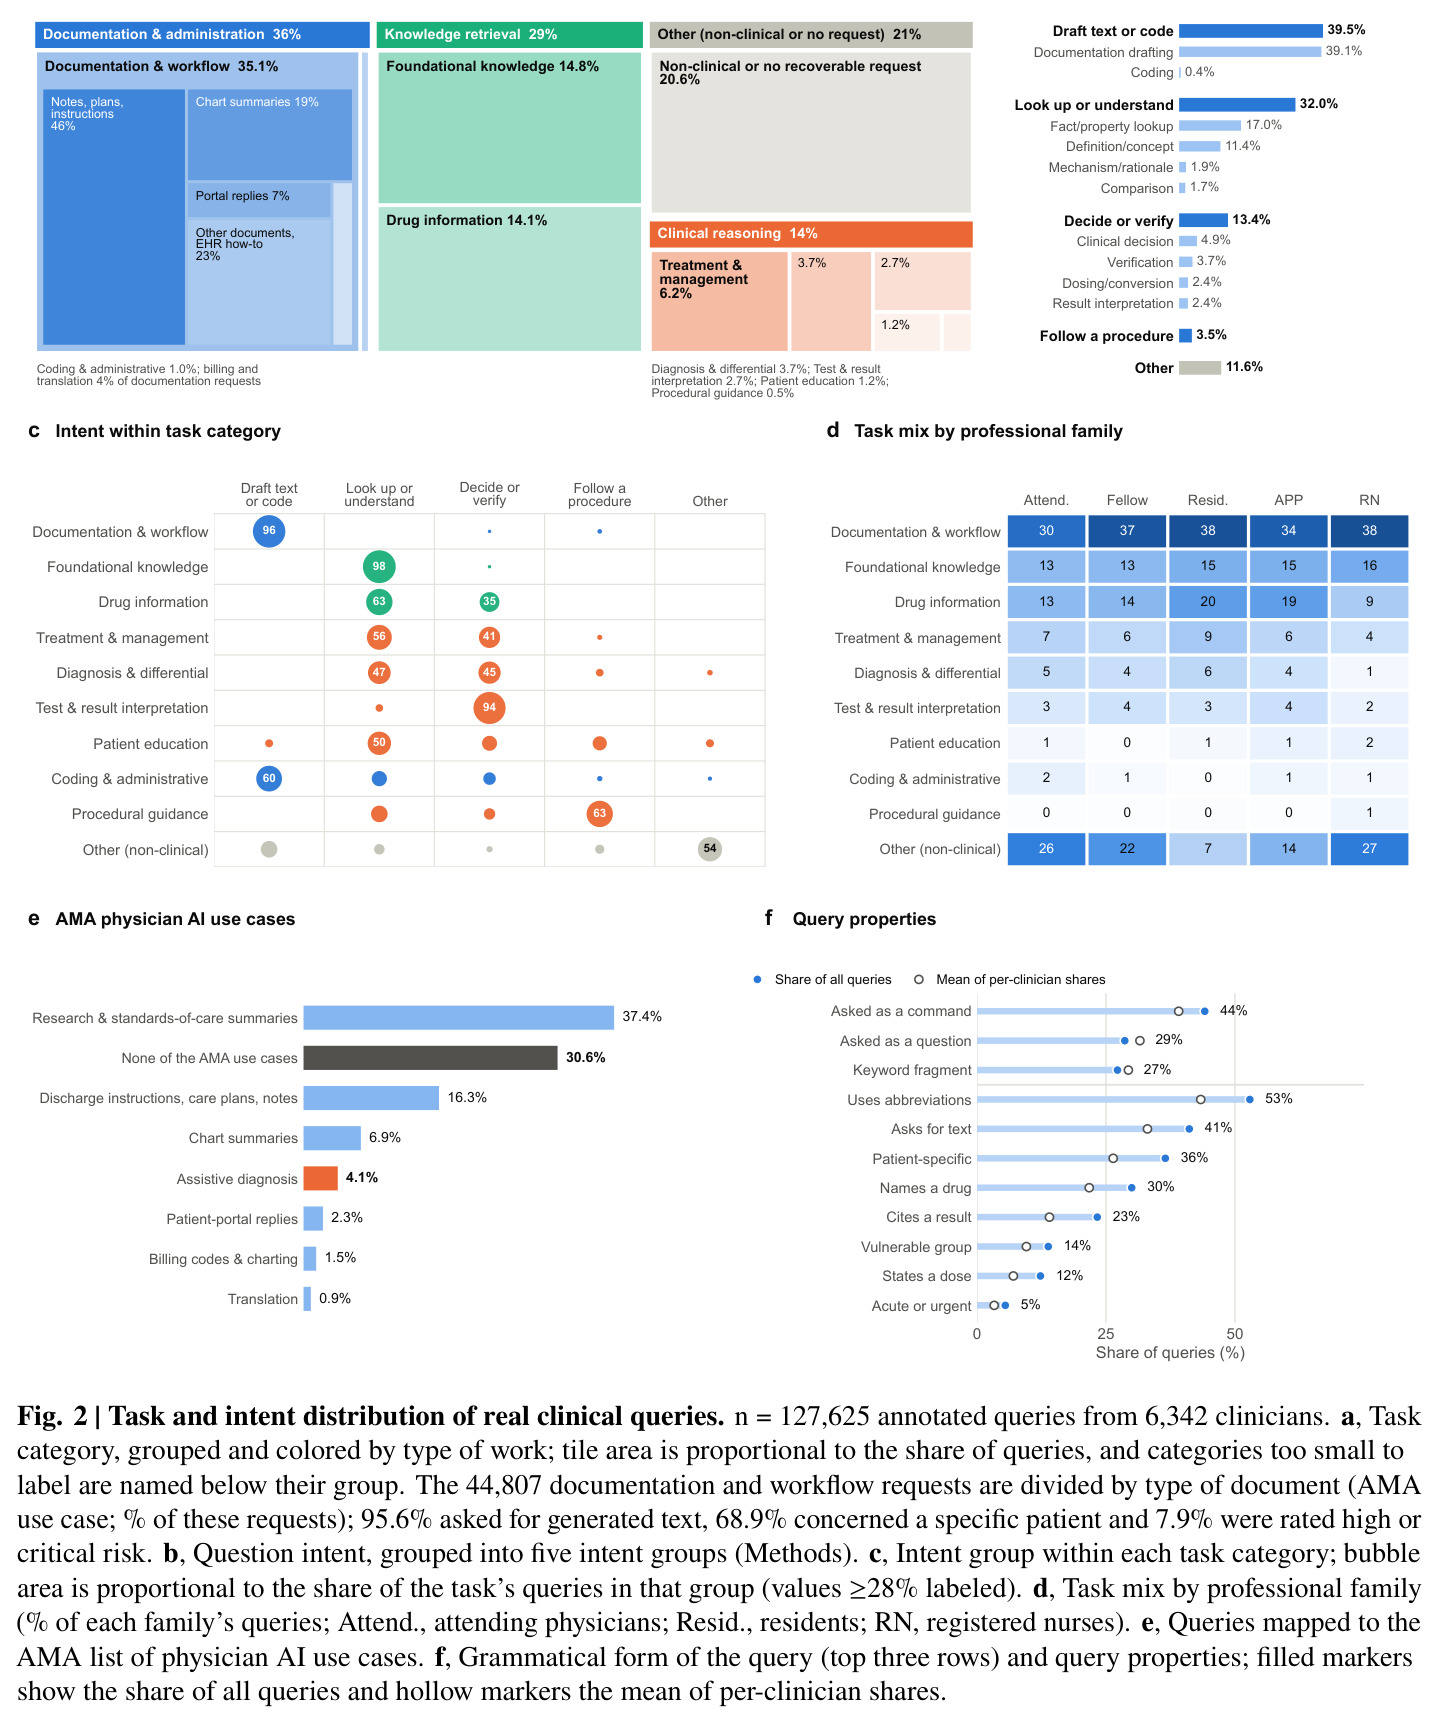
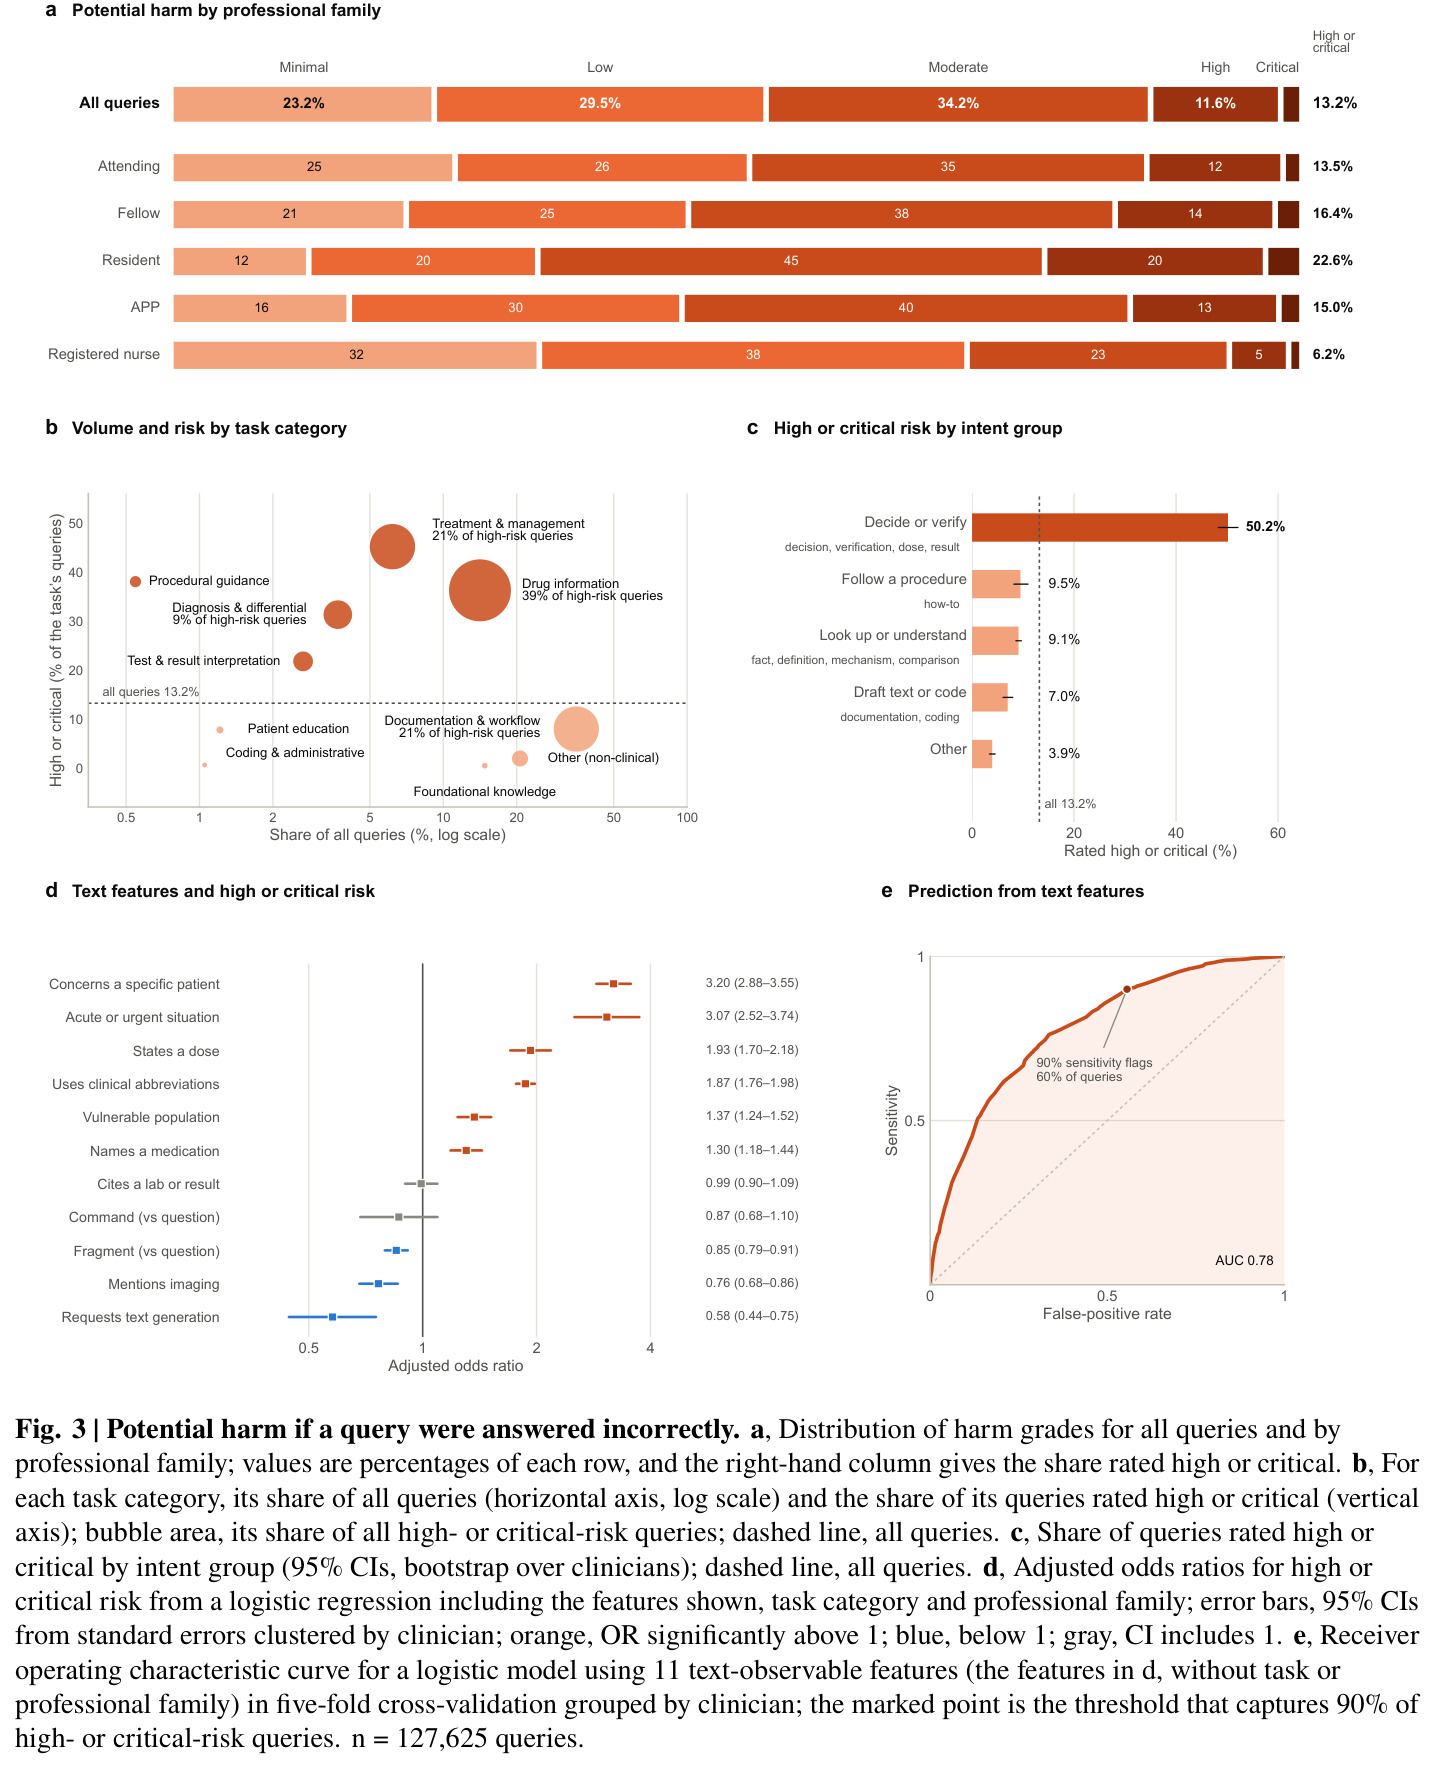
真实使用侧:文档与管理36.2%加知识检索28.9%合计近三分之二(文档与工作流35.1%、基础知识14.8%、药物信息14.1%);临床推理仅14.3%,其中诊断与鉴别只有3.7%;非临床或首轮无请求20.6%。44.1%为命令式,36.5%涉及具体患者;使用高度集中,最活跃10%的医生贡献63.3%的对话(Gini 0.76)。风险侧:13.2%(95% CI 12.4–14.0%)为高/危级;药物信息以14.1%的体量贡献38.8%的高/危查询与50.8%的危级查询,『决定或核实』类意图50.2%为高/危;住院医生22.6%高于主治13.5%与护士6.2%。仅凭11个文本可观测特征的模型区分高/危查询的 AUC 为0.78,但90%召回需误伤60%的查询。可答性:36.1%无法按原文很好作答,22.2%缺患者/本地信息(危级查询中达72.7%);最安全响应为直接答61.2%、澄清26.8%、检索12.0%,升级与拒答合计仅0.06%。基准侧:58个基准中位覆盖率仅31%(IQR 21–39%,均匀分布应为55%),中位基准文档类条目为0%;前沿模型报告的12个基准中位40%,贴近临床实践的29个基准中位35%,并不更接近(差异−5.5pp,95% CI含0)。细看五个基准:MedQA诊断占48.0%而文档仅0.1%,97.6%条目应直接答、仅0.7%缺上下文(真实为22.2%);HealthBench Professional最接近(dTV 0.25、文档25.5%、唯一覆盖全部任务类别),但其高/危条目42.7%仍远超真实的13.2%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 基准对真实任务组合的代表性 | 覆盖率 = 1 − dTV | 58个基准中位31%(IQR 21–39%) | 跨10个任务类别均匀分布应为55%;真实查询自身为100% | 典型基准连均匀分布的一半都不到,错位是系统性的而非刻意加难的副作用 |
| 文档与管理类请求 | 文档/行政条目占基准百分比 | 中位基准为0%(IQR 0–3%),仅13/58达到≥5% | 真实查询中文档与管理占36.2% | 占比最大的单一用例在典型基准中完全缺席 |
| 诊断类任务占比 | 诊断与鉴别条目% | MedQA 48.0%,MAST脚本一致性测验56.3% | 真实查询中3.7% | 考试型基准把诊断占比高估约13–15倍 |
| 高风险条目集中度 | 高/危级潜在伤害条目% | Real-POCQi 34.5%、HealthBench Professional 42.7%、NOHARM 54.5% | 真实查询13.2%(按医生共识校准后约3.7%) | 即便来自真实临床问题的基准也系统性过度集中高风险案例 |
| 响应路由能力覆盖 | 最安全响应≠直接回答的条目% | Real-POCQi 66.9%、HealthBench Pro 78.1%、NOHARM 87.9% | 真实查询38.8%;MedQA/SCT仅2.3–2.4%(即97.6%应直接答) | 考试基准从不测『何时该澄清或检索』;临床来源基准则反向过度集中此类条目 |
| 上下文缺失行为 | 需要未提供的患者/本地信息的条目% | MedQA仅0.7% | 真实查询22.2%(危级查询72.7%) | 考题天然自带全部信息,结构上无法测出识别信息缺失的能力 |
局限与改进
作者承认的局限:研究覆盖单一学术医疗系统和单一助手,任务组合会随专科构成、人力结构和工具设计而变(本系统内科占47.3%);无法观察医生使用其他工具(网页搜索、个人账号、决策支持产品),记录的可能只是医生选择带给这个工具的问题;只标注第一轮(9.0%首轮无可恢复请求),漏掉多轮中后置的请求;未分析助手回复,测的是潜在而非实际伤害;CABA由作者选定13个套件、5个细看基准为目的性抽样,且只含公开、英文、纯文本基准;医生对伤害(序数$\alpha$=0.36)、上下文与最安全响应的一致性仅中等,这些字段的绝对占比不如组间比较可靠;重度使用者主导总量。我的补充观察:正文多数风险分析用模型口径13.2%,而校准到医生共识只有3.7%,两者差3倍多,引用时必须注明口径;36.1%不可答的判定基于首轮文本孤立判断,医生在后续轮次补充信息的情况可能使其被高估;另外覆盖率对10类任务的粒度选择敏感,换分类粒度数字会变;最后,作者自己也指出这些查询的『最安全响应』是规范判断而非行为测量,真实系统是否会按26.8%的比例发起澄清完全是另一个问题。
独立分析的弱点
弱点一,跨机构外推未知:本系统任务组合受其专科结构影响,社区医院或专科中心会显著不同;改进方向是多站点联邦式 RCQ-Map 监测,发布按机构类型分层的使用画像模板。弱点二,风险判断主观性高:医生间伤害一致性仅$\alpha$=0.36,个体评级0–26%差异巨大;改进方向是用回溯性结果数据(哪些查询后来关联到不良事件)锚定量表,替代纯主观评级。弱点三,只测潜在不测实际:助手到底有没有澄清、有没有检索完全未知;改进方向是把 RCQ-Map 标签与响应日志配对,定义并测量『路由保真度』这一新指标。弱点四,首轮分析忽略对话结构:9.0%首轮无请求说明多轮模式本身是信号;改进方向是多轮感知的请求识别与按轮次动态重标注。弱点五,风险文本分类器不实用:AUC 0.78、90%召回要误伤60%查询,直接当过滤器会毁掉可用性;改进方向是引入用户角色、科室、患者上下文与会话历史。弱点六,语料含PHI不可公开,第三方只能在标签层面复用;改进方向是发布合成查询生成器,按发布分布生成保真合成语料供基准开发者使用。
未来方向
作者提出的方向:未来基准与前瞻研究应按临床使用比例抽取任务,并按携带风险的特征分层;文档生成值得专门评估——33.6%的查询要求起草临床或运营文档,多数涉及可识别患者,产出文本可能进入病历;系统与 harness 应学会澄清(26.8%的查询最安全做法是反问)与检索本地政策/处方集/医嘱集,而非一刀切拒答(升级与拒答合计仅0.06%,说明安全收益几乎全在澄清与检索);各医疗系统可用 RCQ-Map 持续监测自身使用并校验评估集;专科专用诊断工具的价值存疑(85%的眼科、81%的神外临床锚定查询关心他科管辖的疾病)。可延伸的方向:把『按使用比例加权的基准分数』形式化为部署错误率的估计量并给出统计理论;构建动态基准,从脱敏查询流半自动生成条目并持续回灌;针对核实类查询(50.2%高/危、且意味着医生即将行动)设计确认式交互评测;用 RCQ-Map 标签训练 answer/retrieve/clarify 路由器并做前瞻试验;比较不同医疗系统 RCQ-Map 画像以研究部署差异的社会技术因素。
复现评估
开源情况总体很好。RCQ-Map 的完整指南、输出 schema、提示词、标注流水线和医生标注平台在 GitHub(nyuolab/RCQ-Map,Zenodo 23223807 存档,指南CC BY 4.0、代码Apache 2.0)公开;CABA v1.0 含58个基准的来源、版本、许可证与条目级 RCQ-Map 标签,在 Zenodo(23223809)和 Hugging Face(NYU-OLAB/CABA)发布,并附聚合 RCQ 分布与重建脚本。限制在于:查询原文因含PHI且受机构协议约束不可共享,标签级语料和验证集需向通讯作者按数据使用协议申请;复现标注依赖 GPT-5.6 sol 的 API 访问,且其行为可能随版本漂移;标注12.8万条查询加1万余条基准条目的API成本是一次性但可观的投入。算力方面无训练需求,只有推理调用,普通实验室可负担。难度评估:复现 CABA 比较与标注流水线为低到中等;完整语料级复现受数据访问限制为中等偏难;在自己机构重做医生验证(100条×3标注者)则完全可行,这也是作者明确鼓励的用法。
论文图表
对五个代表性基准的逐项剖析:考试型的MedQA(1,273题)与MAST脚本一致性测验(174题)诊断占48.0%/56.3%、文档0.1%/0.0%、97.6%/97.7%应直接答、仅0.7%缺上下文;医生撰写的HealthBench Professional(525段对话)、Real-POCQi(620问)、NOHARM(330例)虽然路由需求接近真实(66.9–87.9%非直接答)但高风险条目过度集中(34.5–54.5% vs 13.2%);任务分布与真实的总变差距离从HealthBench Professional的0.25到脚本一致性测验的0.83。
把『基准为什么错位』从统计讲到机制:考试型基准错在任务谱窄且题目自洽,临床来源基准错在风险与咨询性过度集中。这是为基准开发者提供的最具体诊断。
验证研究的详细结果:临床医生间对伤害等级的一致性(100条中仅12条三人完全一致、61条在同一级以内;个体医生评高/危的比例从0%到26%不等);LLM标注器与留出医生对共同参照的一致率比较(模型在14/23个字段上更高,4个显著更高,0个显著更低);模型伤害评级与医生的二次加权κ为0.53,高于医生两两间的0.36;模型比医生多数更谨慎(评24%为高/危 vs 医生6%),但抓到了全部6条医生共识高/危查询。
全文所有标签都出自这个LLM标注器,这张图告诉你它的可信边界:分类字段接近或超过人类,伤害字段偏保守。理解『13.2% vs 校准后3.7%』的关系必须看它。
23个被判定字段的一致性统计全表(Krippendorff's α、Gwet's AC1、Fleiss' κ、平均两两一致率与完全一致比例):表层特征α 0.55–0.90、任务类别0.64(0.55–0.73)、意图0.45(归组后0.61)、可答性0.57、最安全响应0.40、上下文需求0.25–0.32、潜在伤害序数α 0.36(0.23–0.48);AMA用例最低(0.25)。
这是评估整篇论文证据质量的底表:它明确划出了可靠区(任务、意图、表层特征)与主观区(伤害、上下文、最安全响应),提醒读者哪些百分比可以当事实引用、哪些只能当量级参考。