Sketchpad:用小型视觉语言模型实现可认证的精确算术 Sketchpad: certified exact arithmetic with a small vision-language model
每步只读纸面三格视图,验证2446个视图即可证明任意长度算术全部精确
前置知识
LoRA 低秩适配器
参数高效微调方法:冻结预训练权重 $W$,为每个投影矩阵训练一对低秩矩阵 $A,B$,输出 $y=xW+s(xA^\top)B^\top$($s$ 为缩放因子)。本文在 150 个投影矩阵上用 rank-16,共 1020 万参数(约 1.2%),并给每个适配分支乘一个标量门 $g$。
它是论文唯一的训练组件;理解它才能明白证书约束的是哪些权重,以及第 6 节为何 $g=0$ 时能逐位恢复基模型。
logits、argmax 与 margin
语言模型每步输出词表上的 logits,解码取 argmax。margin 定义为正确 token 的最小领先:$m(v)=\min_k(z_{k,T_k(v)}-\max_{a\neq T_k(v)}z_{k,a})$。$m>0$ 保证输出正确;$m>2\tau$ 时扰动不超过 $\tau$ 也不变。
整份“证书”就是对 2446 个视图逐一记录 margin,定理 3 的数值鲁棒性结论完全建立在它之上。
有限自动机与 Moore 可辨识性
确定性有限自动机的行为由有限状态集上的转移函数决定。Moore 的经典结论:对状态数无界的机器,任何有限实验集都无法唯一确定其行为——总存在一台在所有被测输入上表现一致、但在更长输入上分歧的机器。定理 2 把该结论移植到了链式思维解码上。
它解释了为什么加大测试量永远换不来全长度保证,从而论证“每步只读有界视图”这一政策的必要性。
竖式笔算与 Knuth Algorithm D
纸笔算术:加法逐列带进位,长乘法逐位乘加部分积,长除法逐位试商。Algorithm D 先乘 $\lfloor 10/(d_0+1)\rfloor$ 归一化,再以 $\hat q=\min\{9,\lfloor(10r_1+r_2)/d\rfloor\}$ 估商,保证至多修正两次。
论文把每个竖式步骤映射为一个三格视图与一个表行;理解竖式过程才能理解表格如何做到穷举、运行时如何移动窗口。
视觉编码器与图像 token
视觉语言模型把图像切成 patch,经视觉编码器变成若干图像 token,与文本 token 一起进入语言模型。本文一个视图是 32×96 像素条带,按 16px patch 读取、2×2 合并后恰为三个图像 token;字形是固定的 32×32 精灵图,故每个视图都是有限集合中的确定图像。
把状态渲染在纸面上、经视觉通道读取,是让“输入集合有限”成为字面事实的关键工程选择,也是整个认证方案成立的前提。
研究动机
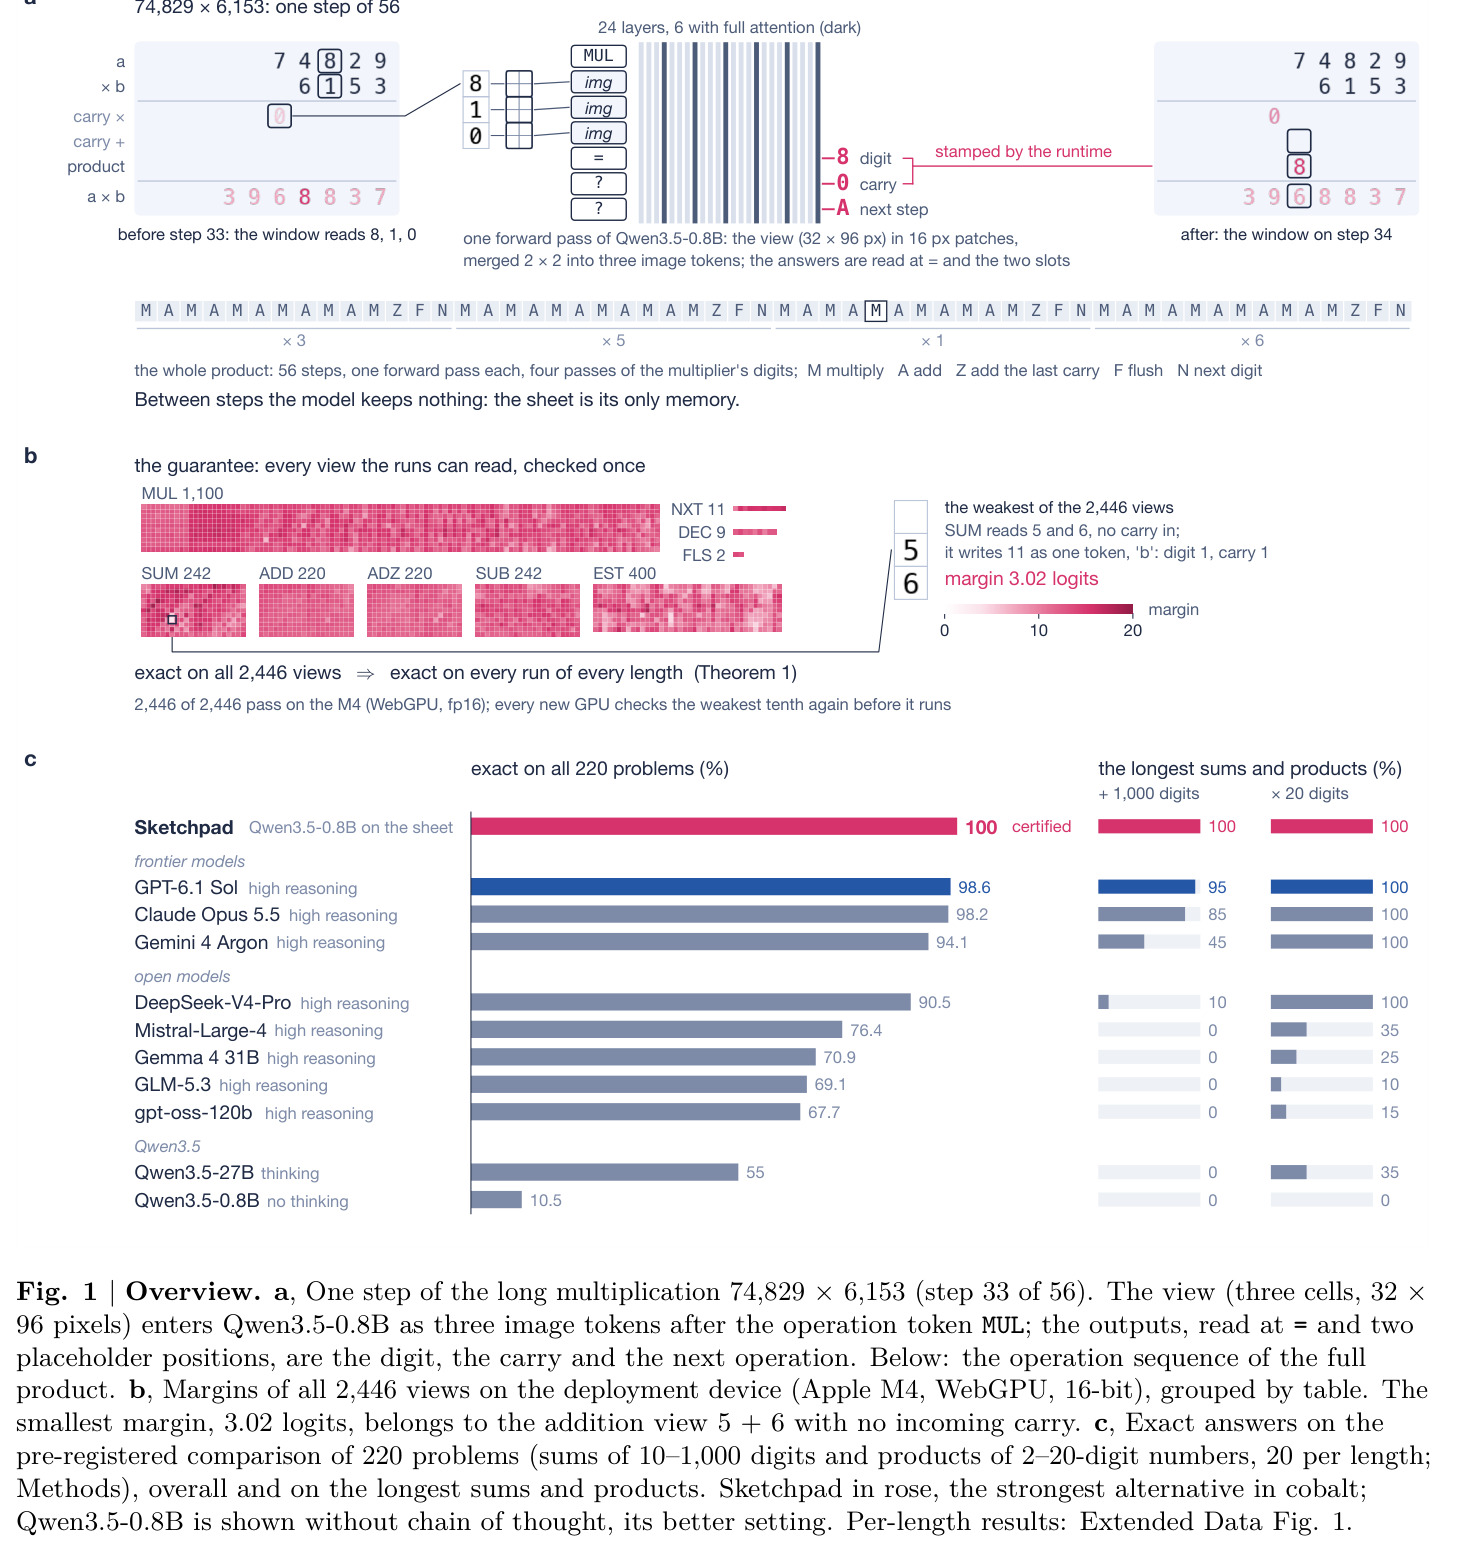
大模型在长算术上的高准确率只是对样本的估计,对未见输入没有任何保证,而且残余错误是静默的。在本文预注册的 220 题对比(10–1000 位加法与 2–20 位乘法,每档 20 题、预算 32768 token)中,最强的 GPT-6.1 Sol 答对 217 题,其 3 个错误全部是形式完整、远未耗尽预算的成品答案,与正确答案相差 1 到 637 位数字,使用者无从察觉;Gemini 4 Argon 在 1000 位加法上只对 9/20。工具调用(计算器、代码解释器)虽然精确,却把计算移到网络之外,保证来自外部解释器而非模型本身。长度泛化研究(位置编码、数据格式、归纳式草稿本等)也只能报告采样准确率:基座 Qwen3.5-0.8B 零样本仅通过 2446 个算术视图中的 12 个,加 8 个示例仍只有 158/2380。根本困难在于:“任意长度都精确”是无限多输入上的性质,而任何有限测试集只覆盖有限样本;定理 2 进一步证明,若每步还能读到之前的步骤(如链式思维),则原则上不存在任何足够的有限测试。
本文的目标是本文要给一个真实的小型预训练视觉语言模型建立“对所有输入长度成立”的算术精确性证明,并让它跑在消费级设备上。具体目标分四层:(1) 设计一种执行政策,使每一步的输入取自可事先穷举的有限集合,把“无限输入上的性质”归约为“有限视图上的性质”;(2) 用最小代价训练出这种能力——只在 Qwen3.5-0.8B 上加一个 rank-16 LoRA 适配器(1020 万参数,占模型 1.2%),不改动架构、不从头训练;(3) 在 Lean 4 中证明:有限视图上的精确性等价于任意长度运行的精确性、视图限制是必要的、证书对有界数值扰动鲁棒、且可复合到代数调用层;(4) 在真实部署路径(浏览器 WebGPU、16-bit、Apple M4 笔记本 GPU)上实测证书,支撑带符号加减、任意长度乘除、开平方、最大公约数,以及基于这些过程的多项式求解、展开与因式分解。
与已有工作不同的是,现有路线各有固定切入:链式思维与长度泛化研究改进“步与步之间的上下文传递”;神经算术架构(Neural GPU、位置编码设计等)从头或微调训练并按采样评估;神经网络验证通常对连续输入区域给出输出界,或只为理想化的小型/专用网络证明精确性;Lewandowski 等人虽把每步解码限制在固定提示与局部符号上并全检查 1857 条通用系统规则,但验证的是现成模型。本文的独特组合是:(1) 用视觉通道实现视图限制——把工作记忆渲染成 32 像素网格的“纸面”,每步只读三个格子,固定字形使输入集合成为字面意义的有限集;(2) 训练模型满足条件而非挑选现成模型,用 hinge margin 目标把证书要求内置进训练;(3) 在部署硬件的数值路径上测 margin(此前工作要么采样估计、要么假设精确算术),再用 τ-鲁棒性定理覆盖批处理与精度差异;(4) 用复合定理把单操作证书扩展成代数推导的误差分解。
核心方法
直觉上,竖式计算难是因为模型必须把全部中间状态塞进上下文并自行控制流程;Sketchpad 把这些状态移到外部一张渲染纸面上,模型每步只看三个格子,输出数字、进/借位和下一步操作,其余交给常规代码运行时。于是模型行为退化为一张有限查询表:2446 行,逐行验证即可保证任意长度。系统分三件套:(1) sheet 是唯一记忆——32 像素单元格网格,字形固定,步间不保留任何状态;(2) 模型是 Qwen3.5-0.8B(24 层:6 层全注意力 + 18 层 Gated DeltaNet)加 rank-16 LoRA(150 个投影矩阵、1022 万参数);每步提示词为“操作 token + 三格视图 + = + 两个占位符”,32×96 像素读作三个图像 token,一次前向读出三个答案;(3) 运行时负责布局、移动视图、写回输出,但不写任何结果数字;乘法的控制流由模型的下一步操作输出决定,除法与开方的外层循环由运行时固定、分支由模型输出决定。训练直接在枚举表上进行:交叉熵 + hinge margin + 文本蒸馏,单张 H100 上 19.8 分钟收敛,全部行 margin≥3。
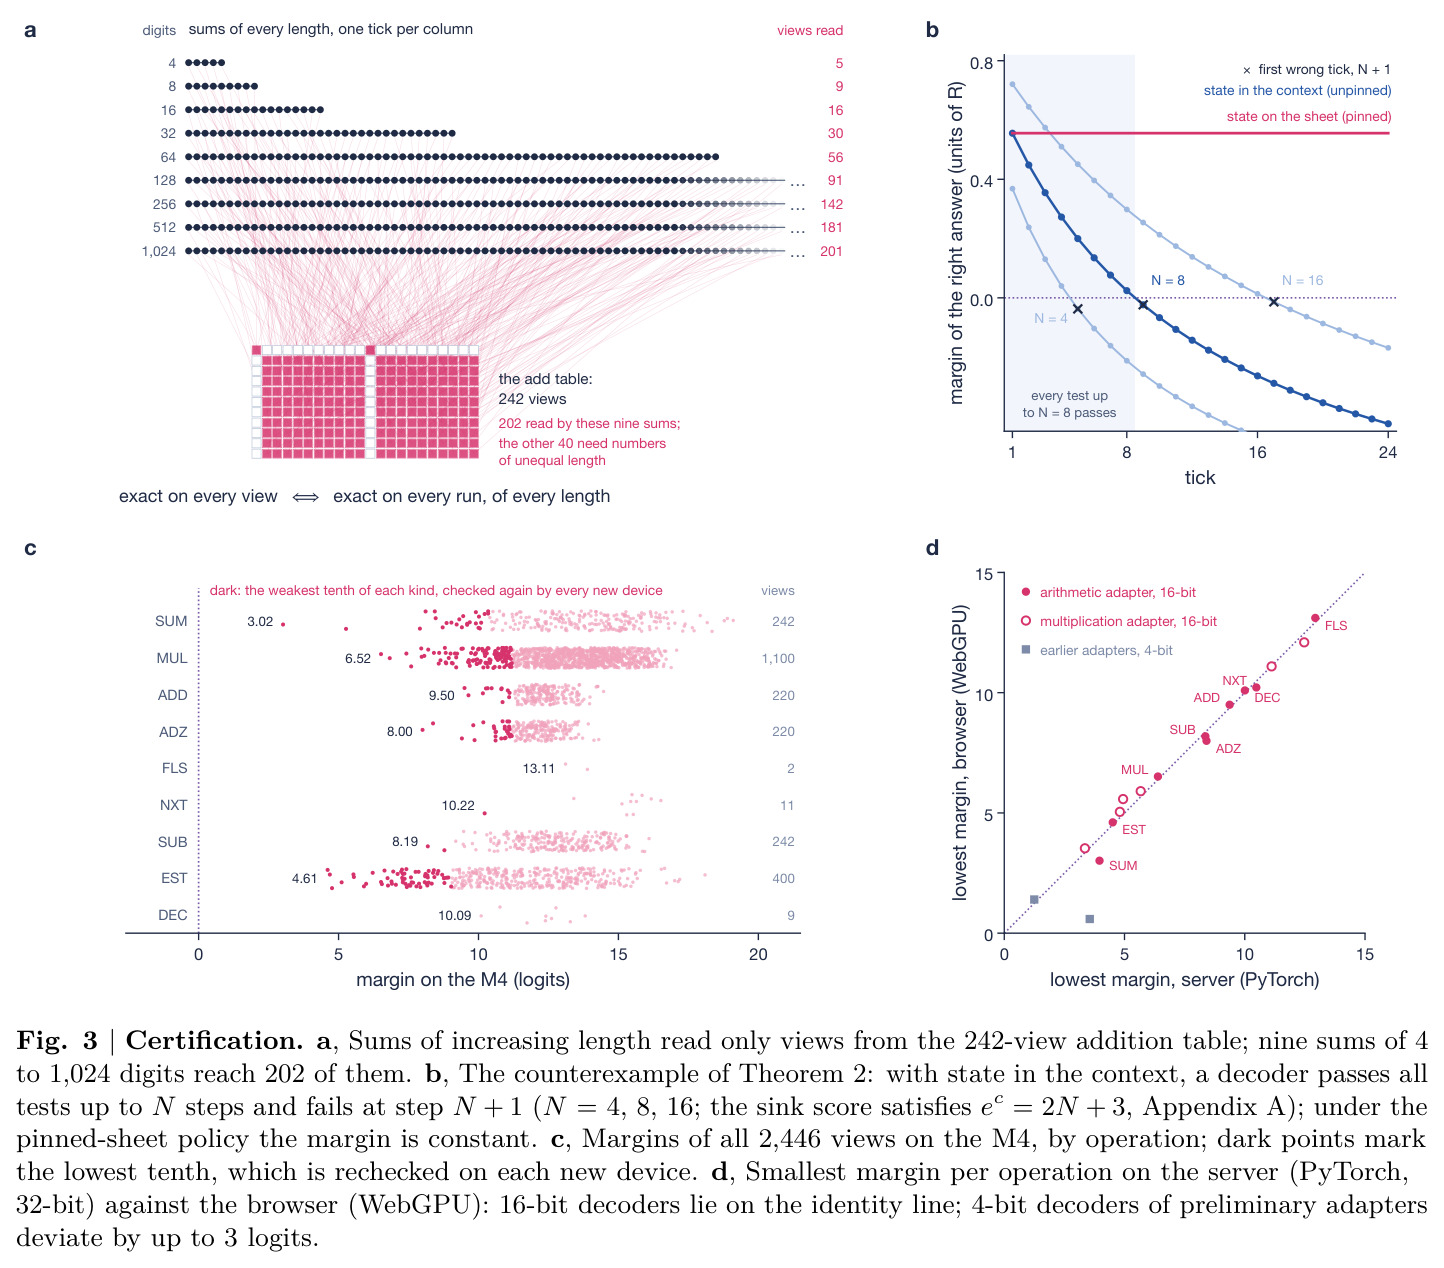
核心是 pinned-sheet 政策:步与步之间除纸面外不传任何状态,模型输出是视图的纯函数 $f$。定理 1(Lean 形式化)给出等价性:模型运行与参考运行逐步一致,当且仅当 $f(v)=T(v)$ 对参考运行可达的所有视图 $v$ 成立;若参考布局保证 $R_T(I)\subseteq V$ 且全部 $m(v)>0$,则任意长度的每次运行都精确。它的对立面同样被证明:定理 2 构造“正确查表 + 一个注意力头”的解码器家族——该头向错误状态的 logit 写入 $4Rk/(e^c+n)$($k$ 为上下文中的事件数),写入量随长度无界增长——对任何有限测试集都能选出让所有被测上下文以正 margin 通过的成员,而它在更长运行上必然出错,这说明链式思维式的“多测样本”原理上不可能给出全长度保证。定理 3 再补数值鲁棒性:只要每个视图的 margin $>2\tau$,$\ell_\infty$ 范数不超过 $\tau$ 的 logits 扰动(批处理、16-bit 精度、不同 GPU)都不会翻转任何输出。三者把准确率从统计估计升级为部署设备上的逐条证书。
方法步骤详情
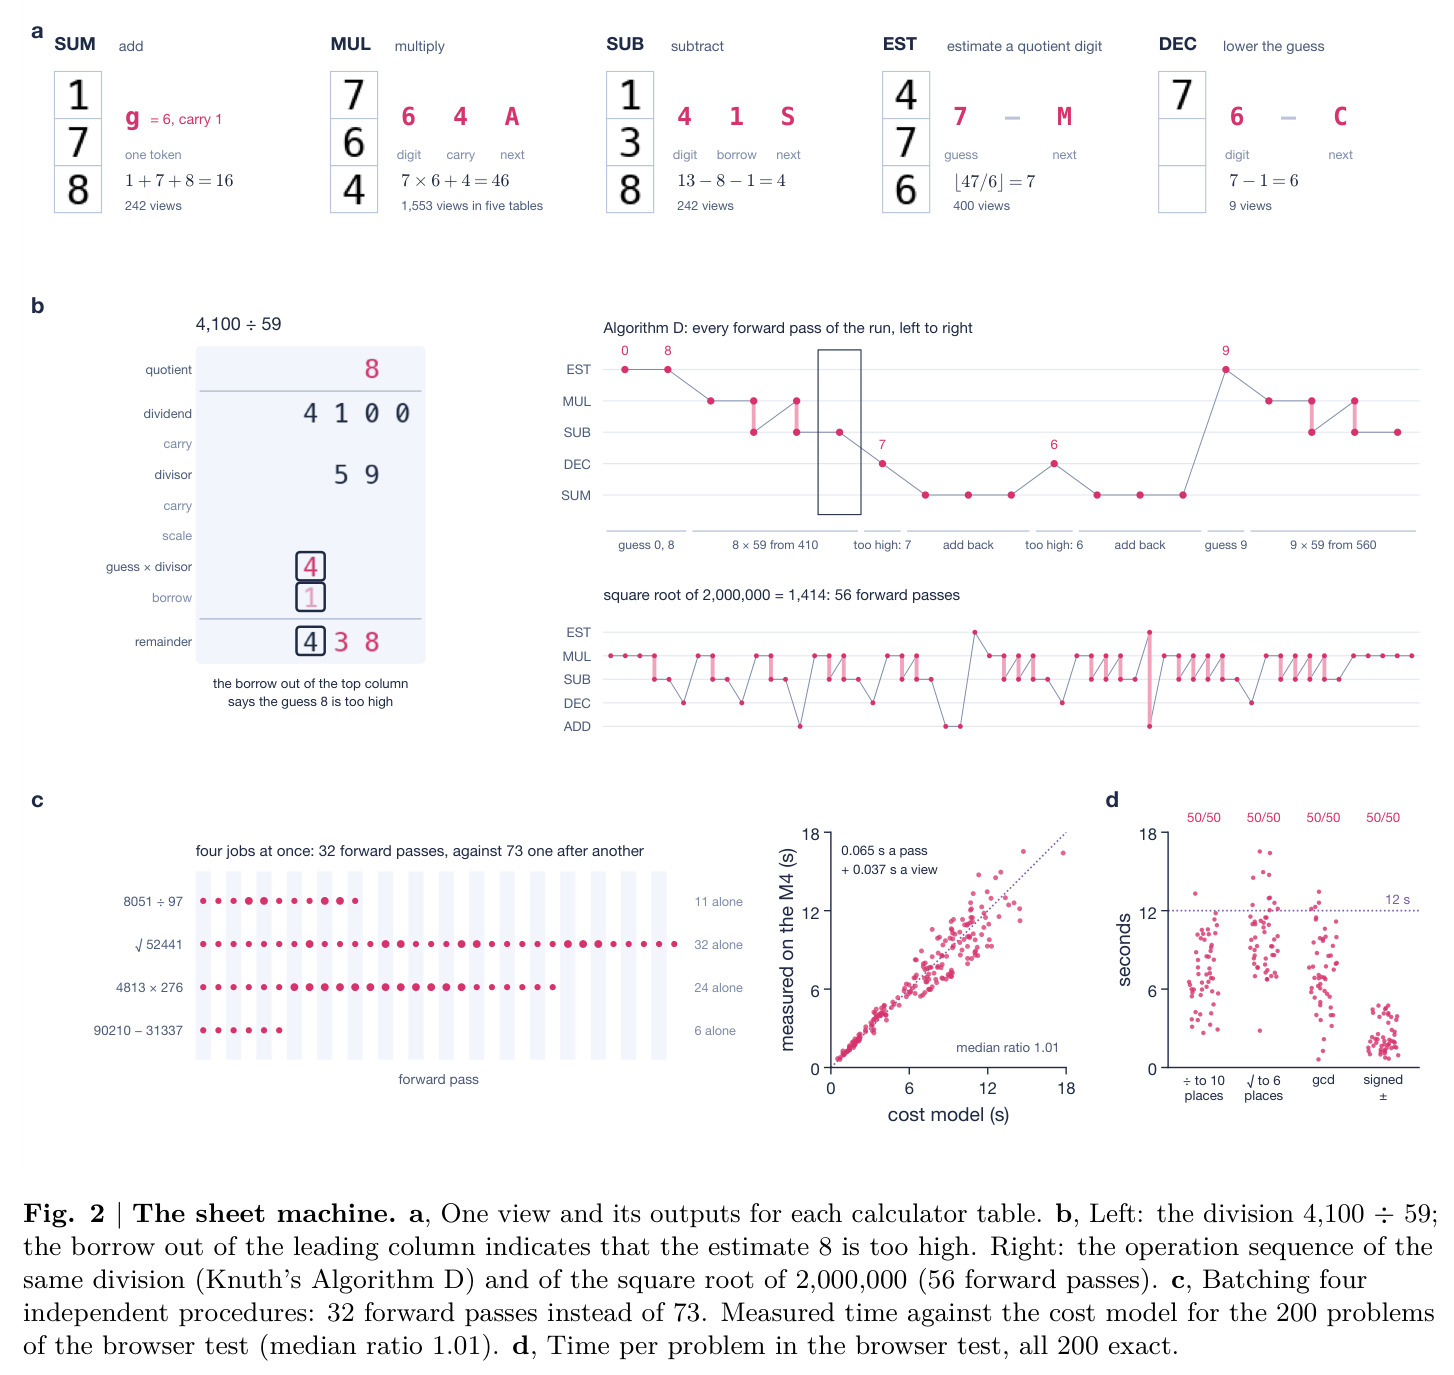
(1)枚举视图:固定 32×32 字形,三格拼成 32×96 像素条带、读作三个图像 token;五张表合计 $|V|=2446$ 行:SUM 242、长乘五操作 1553、SUB 242、EST 400、DEC 9。(2)训练:交叉熵 + hinge margin(目标 ≥4)+ 对基模型的 KL 蒸馏;每 100 步重算证书、重放 margin<2 的行,全部 ≥3 停止,单张 H100 上 19.8 分钟。(3)认证:在部署路径(WebGPU 16-bit)上记录全部 margin,M4 上 3.5 分钟;批 2/4/32 实测最大扰动 1.09。(4)运行竖式:加减乘按布局落表;除法按 Algorithm D 归一化(乘 $\lfloor 10/(d_0+1)\rfloor$)后试商 $\hat q=\min\{9,\lfloor(10r_1+r_2)/d\rfloor\}$,借位则 DEC 递减并加回,至多两次;开方对 $c^2a$($c\in\{1,2,4,5\}$)逐位进行;gcd 用欧几里得算法。(5)运行时每步断言视图属于表,独立过程 lockstep 共享前向。
技术新颖性
新颖性体现在四个层面。其一,实现“输入集合有限”的方式是新的:不靠架构假设,而是借视觉通道把工作记忆渲染成固定字形的纸面,每步只读三格,使穷举检验成为字面可行的操作。其二,不可能性结果新且完全形式化:定理 2 在 Lean 中证明“上下文含历史步则无有限测试足够”,给出“正确查表 + 一个注意力头”的具体反例家族——该头向错误状态 logit 写入 $4Rk/(e^c+n)$,随长度无界增长——这是 Moore 有限实验理论对 LLM 链式思维的直接移植。其三,证书的工程化是新的:margin 在真实部署路径(浏览器 WebGPU 16-bit)上测得,用 τ-鲁棒性覆盖批处理与精度差,并绑定模型文件哈希、按表记录到 $10^{-3}$ logits;此前工作要么在采样上估计,要么只在理想化或精确算术下证明。其四,复合定理(定理 4)把证书扩展到代数层:错误只能来自错表、错转写或错组合程序三类,且 $\Pr[g(r)\neq g^*(r^*)]$ 不超过三项概率之和,为“神经步 + 符号编排”的混合系统提供了通用的误差分解框架。
实验结果
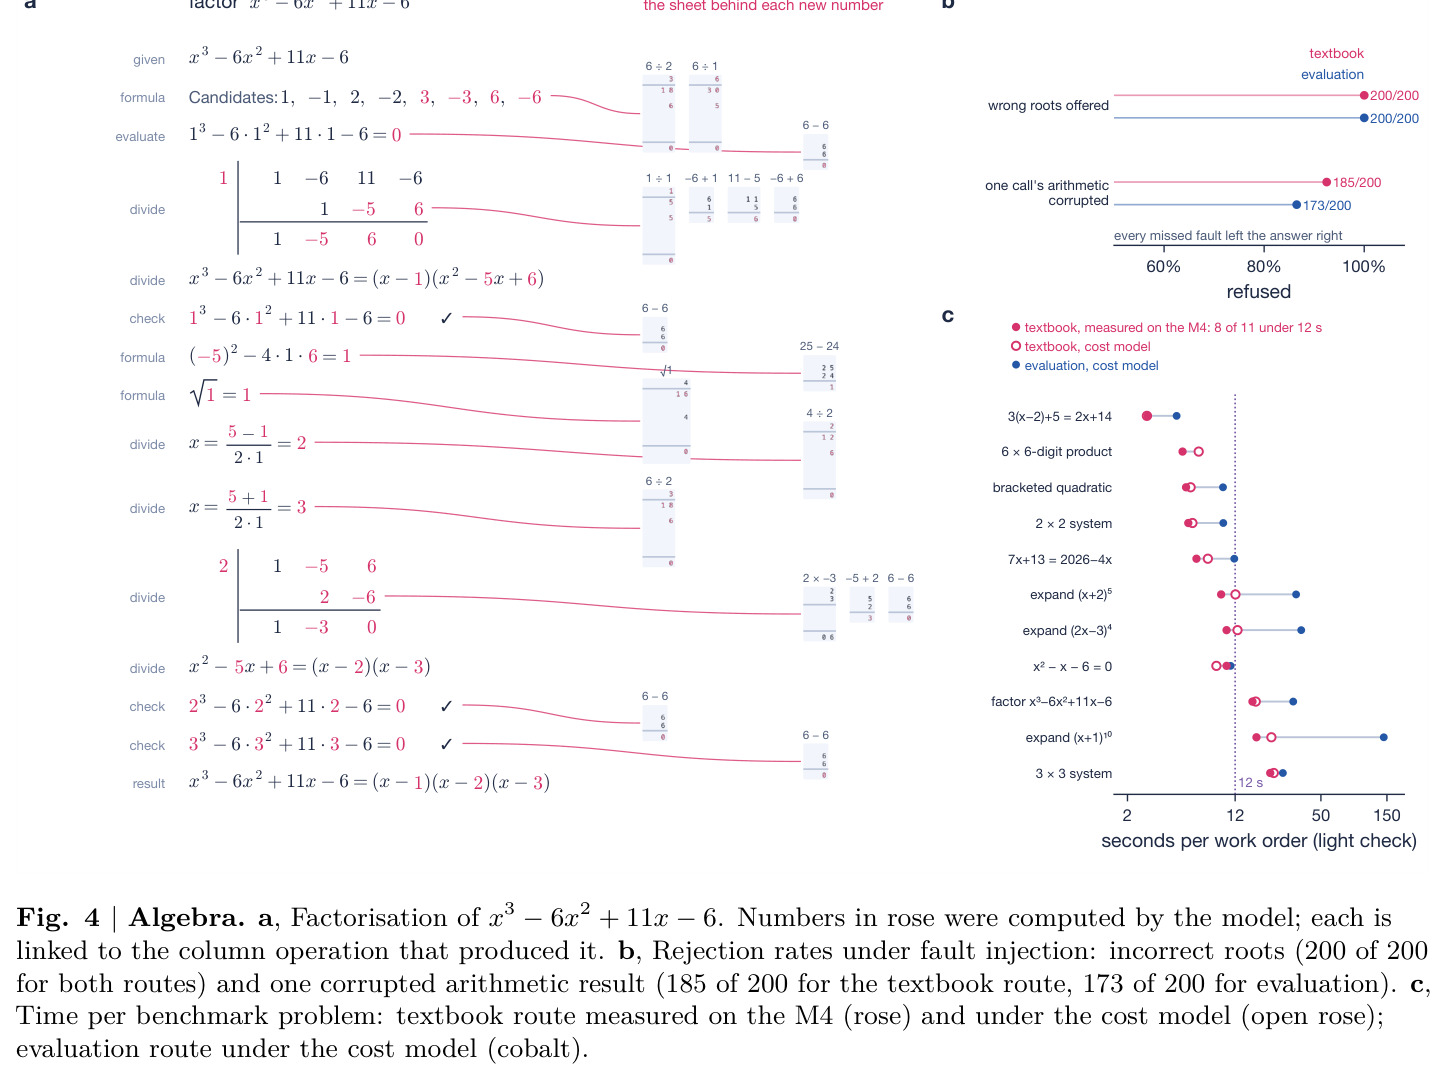
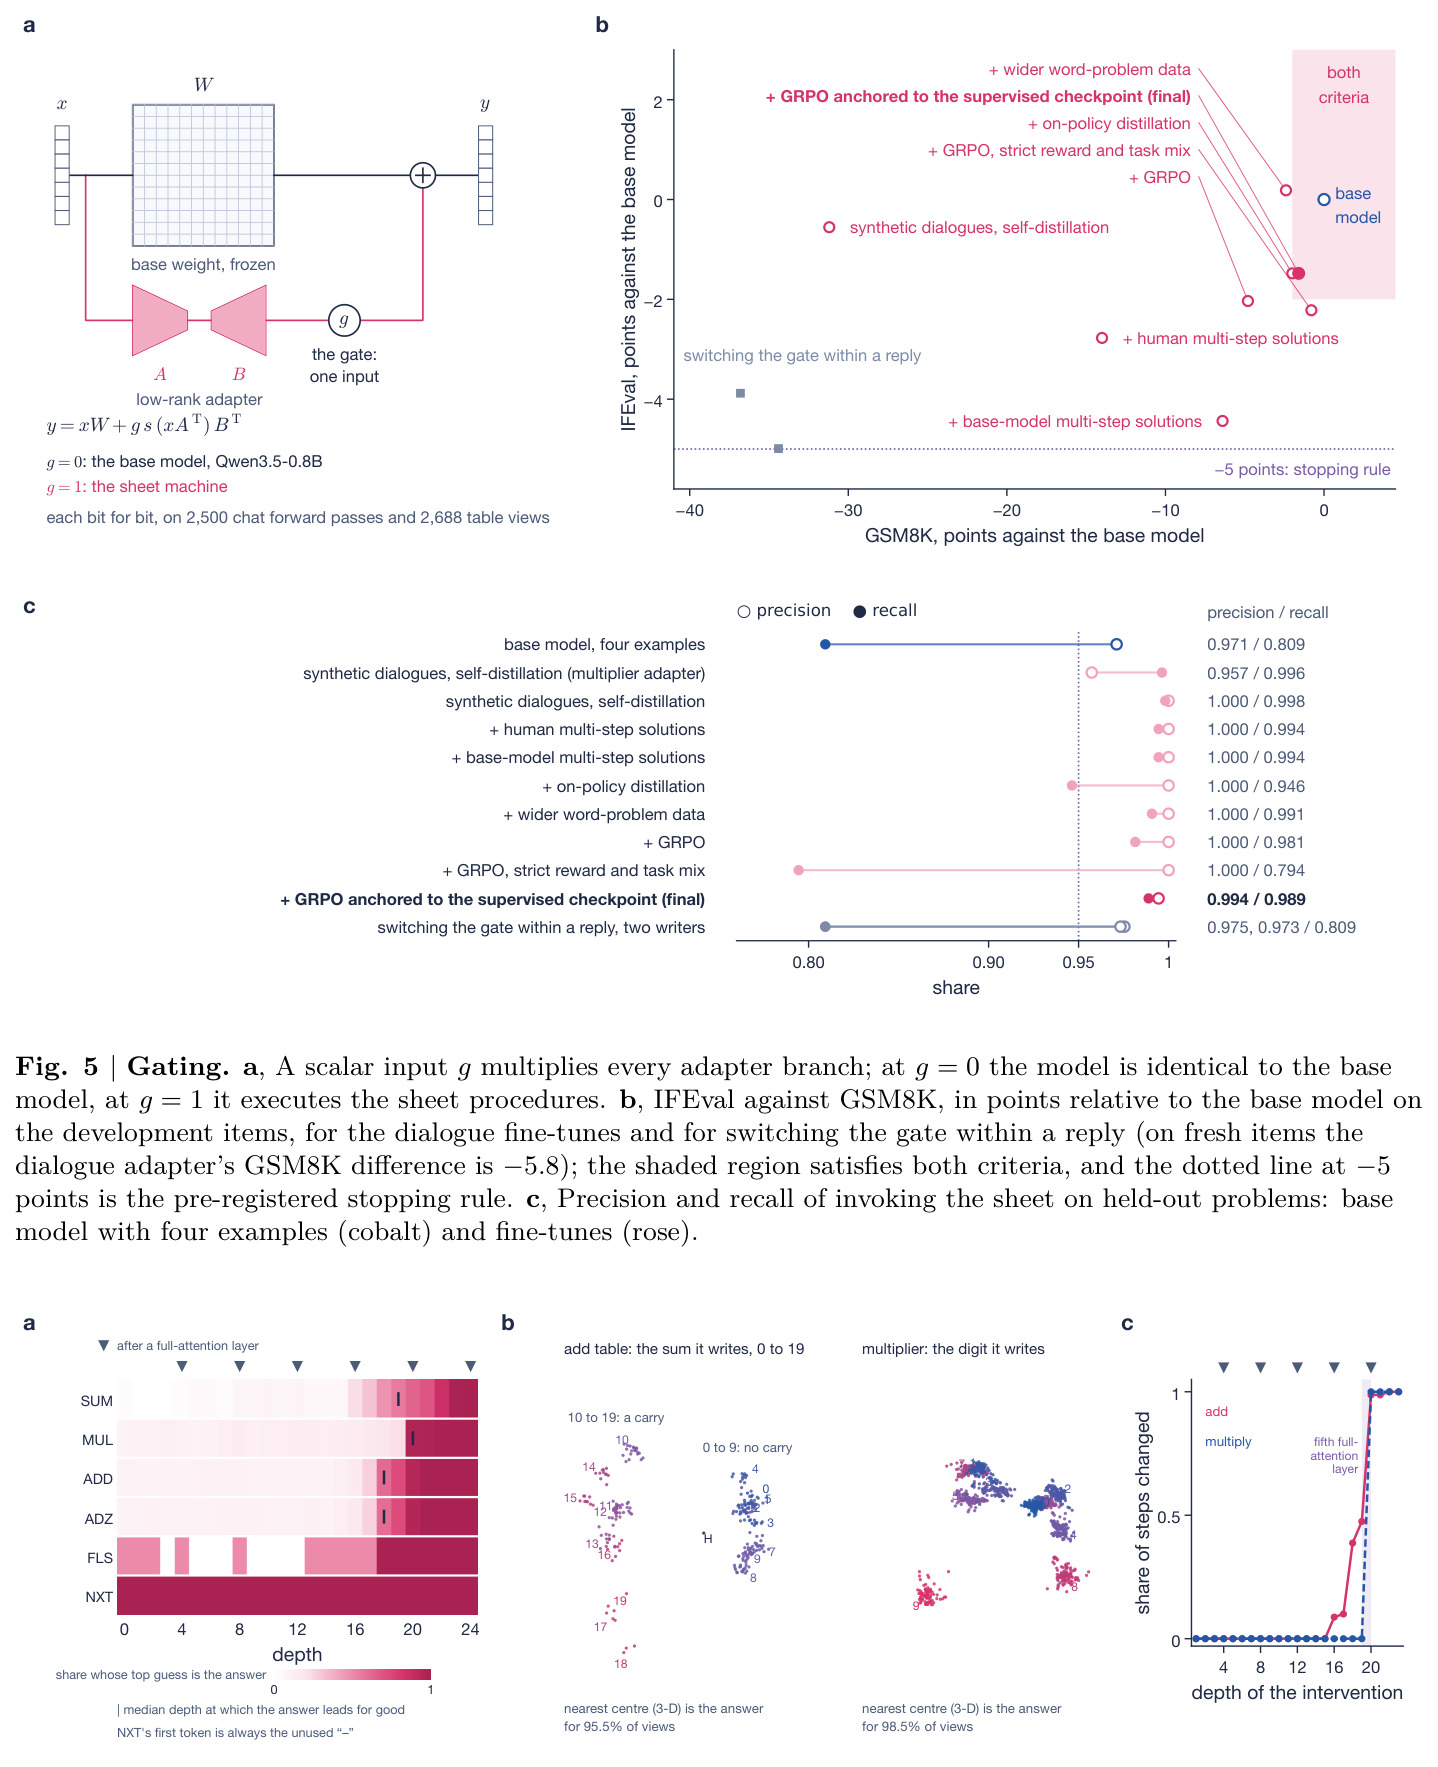
认证:2446 个视图在部署设备(M4,16-bit)全部通过,最小 margin 加法 3.02、乘法 6.52、计算器表 4.61。浏览器测试:200 道预注册题(除法/开方/gcd/带符号加减各 50 题)全部精确,中位耗时 2.0–9.8s,184 题在 12s 目标内。220 题对比:Sketchpad 220/220,GPT-6.1 Sol 217、Claude Opus 5.5 216、Gemini 4 Argon 207(1000 位加法仅 9/20)、开源模型 149–199、Qwen3.5-27B 121、基模型 23。代数:教材路线 10/11 题快于插值路线(如 $(x+2)^5$:12.1s 对 33.1s);故障注入拒绝 200/200 错误根与 185/200 单点算术损坏。机理:类均值干预在深度 20 后改变 80/80 乘法步、79/80 加法步,深度 ≤15 改变 0。门控:$g=0$ 时逐位等于基模型;对话适配器调用 precision/recall 0.994/0.989,但新 GSM8K 低 5.8 点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 220 题预注册大数算术(10–1000 位加法、2–20 位乘法,预算 32768 token) | 精确答案数(共 220) | Sketchpad 220/220(100%) | GPT-6.1 Sol 217;Claude Opus 5.5 216;Gemini 4 Argon 207 | 唯一满分,且是唯一附带全长度认证的结果;基座 Qwen3.5-0.8B 仅 23/220 |
| 1000 位整数加法 | 20 题中精确数 | 20/20 | GPT-6.1 Sol 19/20;Gemini 4 Argon 9/20;DeepSeek-V4-Pro 2/20;多数开源模型 0/20 | 在最强模型也静默出错的长度上保持精确 |
| 浏览器端算术(除法/开方/gcd/带符号加减各 50 题,Apple M4 WebGPU 16-bit) | 精确答案数(共 200)与中位耗时 | 200/200;除法 7.0s、开方 9.8s、gcd 7.0s、加法 2.0s | 无并列模型基线,保证来自 2446 视图的设备端证书 | 184/200 达 12s 目标,实测与成本模型中位比 1.01 |
| 视图证书(任意长度精确性的充分条件) | 通过视图数 / 最小 margin(logits) | 2446/2446,最小 3.02(M4 fp16);服务器 32-bit 最小 3.96 | 基模型 Qwen3.5-0.8B 零样本 12/2446;加 8 示例 158/2380 | 从几乎全错到全过,且带鲁棒阈值 $\tau=1.09$ |
| sheet 调用识别(对话适配器,held-out 模板) | precision / recall | 0.994 / 0.989 | 基模型 4-shot 提示 0.971 / 0.809 | recall +0.18,precision +0.023 |
| 代数故障注入(教材/求值两条路线各 200 题) | 拒绝率 | 错误根 200/200;损坏单个算术结果 185/200(教材路线) | 检查机制自身评估,无外部基线 | 其余 15 例损坏未改变最终答案,实际风险更低 |
局限与改进
作者承认的边界很清楚:证书只覆盖模型的步进输出;运行时的布局、外层循环与参考程序是常规代码,其两个关键性质($R_T(I)\subseteq V$ 与经典算法本身的正确性)并未在 Lean 中形式化,只靠运行时逐步断言和参考实现抽查(每过程 1000 道随机题);代数的转写与组合由不完整检查守护——根替换验证“找到的根”但不保证找全所有根,定点求值只是抽查(在 $x=1$ 处检测不出恰在该点消失的系数错误);保证只对测得 margin 的执行路径成立,换新 GPU 需要全检而客户端默认只重检每表最低的十分之一;输入必须用模型的字形集渲染;代数限于单变量低次多项式与至多三元线性方程组;每步约 0.1s。我补充观察:成本随位数线性增长,220 题里 Sketchpad 用了 64700 个视图,时延远高于前沿模型单次生成;基线为单次采样、各家推理预算与设置不一致,可比性有限;GSM8K −5.8 说明“带证书的对话模型”尚未免费获得通用推理能力。
独立分析的弱点
(1) 吞吐瓶颈:每视图一次解码,$\alpha=0.065$s、$\beta=0.037$s 意味着千位加法需数千次调用;改进方向包括把固定前缀 KV 缓存固化进部署图(论文已证明缓存精确,Lemma 4)、一次前向读写多列、或裁剪视觉编码器。(2) 覆盖面窄:仅整数四则、开方、gcd 与低次多项式,无浮点、模运算、矩阵与超越函数;每加一类操作都要设计归一化并枚举表,EST 已需 400 行,表组合会爆炸。(3) 遗忘未解决:新 GSM8K −5.8±1.7,作者只定位到损失在多步推理而非 sheet 调用本身;可尝试把算术完全隔离成工具式解码路径(推理时 $g=0$),或用证明器反馈做强化学习。(4) 证书可迁移性弱:绑定文件哈希与执行路径,换 GPU/驱动/库版本须重检,目前只有批处理扰动 $\tau=1.09$ 的经验界,缺少跨设备的扰动理论上界。(5) 消融缺口:token 嵌入用 4-bit 而其余 16-bit,各组件精度对 margin 的单独贡献未量化;对话适配器是第五个在同一基准项上打分的候选,虽有预注册补救重测,仍提示选择效应风险。
未来方向
作者提出的方向:把运行时布局与参考程序的正确性也形式化进 Lean(目前只是定理假设);把证书扩展到更多数值环境与操作类别;修复对话适配器在多步推理上的退化——on-policy 蒸馏已能消解大部分 IFEval–GSM8K 权衡,而 GRPO 若不锚定监督检查点会重新引入权衡。基于成果可延伸:(1) 把“有限视图 + margin 证书”范式推广到其他可拆成有界查表的任务,如图遍历、日期推算、单位换算、正则匹配;(2) 研究视图数与 margin 预算的缩放规律,以及一次前向处理多格/多列能否在保持可穷举的同时降低成本;(3) 把证书接入 CI/CD:模型或运行时每次更新自动重检并核对哈希,形成“部署即认证”流程;(4) 机理发现(乘法数字在第 5 个全注意力层一次性决定、加法逐渐成形)可用于架构搜索——为证书类任务定制全注意力层的深度配比;(5) 把“训练即认证”的目标(hinge margin + 证书重放)推广到程序执行、SQL 求值等更一般的微调场景。
复现评估
复现条件良好。开源:模型、适配器、证书与分析数据在 Hugging Face(mohsenvand/sketchpad-0.8b-preview);运行时、代数、基线与论文源码以 Apache 2.0 在 github.com/NeoVand/sketchpad;Lean 4 证明(Lean 4.35.0 + Mathlib,无 sorry)在 paper/lean/,paper/numbers.md 列出每个数字的来源。算力:算术适配器单张 H100 训练 19.8 分钟,GRPO 200 步亦单卡;推理与证书在 Apple M4 笔记本的浏览器(WebGPU 16-bit)完成,全检 3.5 分钟。难度:核心结果门槛低、脚本齐全;基线对比需调用 2026-10-31 的商用 API(GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argon 等)并自部署五个开源模型;对话适配器的多阶段训练(监督+自蒸馏+on-policy 蒸馏+GRPO)数据开放但调参经验难照搬。总体:核心易复现,扩展实验中等偏难。
论文图表
a 用 logit lens 追踪加/乘视图正确答案首次持续领先的深度:中位数加法 19、乘法 20、乘数加步 18,深度 15 之前任何表都最多 13%。b 把最后一层残差态投影到三个 Fisher 判别方向:状态按输出聚类,带进位的加法(10–19)与不带进位的分开,最近中心预测对加法/乘法视图分别 95.5% 和 98.5% 正确。c 是类均值干预 $h_\ell\leftarrow h_\ell+\mu_\ell^{a'}-\mu_\ell^{a}$:在深度 20(第五个全注意力层)之后施加,可把 80/80 乘法步、79/80 加法步改到目标输出,深度 ≤15 则一个都改不动;乘法转折极陡(深度 19 时 0 步改变、深度 20 时全部改变),加法则在深度 18、19 分别为 31/80、38/80。
它回答“证书之外,数字到底在网络哪里被决定”:定位到第五个全注意力层,为理解与改进这类可认证模型提供了机理依据。
按长度拆开 220 题对比:加法 10/30/100/300/1000 位与乘法 2/4/6/10/15/20 位,每格 20 题。Sketchpad 全部 20/20;GPT-6.1 Sol 在 300 位加法 18/20、1000 位 19/20;Claude Opus 5.5 在 1000 位 17/20;Gemini 4 Argon 在 1000 位仅 9/20;DeepSeek-V4-Pro 1000 位 2/20,Mistral-Large-4、Gemma 4 31B、GLM-5.3、gpt-oss-120b 在 300/1000 位几乎全为 0;Qwen3.5-27B 在 1000 位 0/20,基模型所有加法长度均为 0/20。
展示“错误集中在最长加法”的结构:Sketchpad 是唯一在每个长度上都满分的系统,且其满分带有认证而非抽样含义。
逐表列出九种操作的视图构成、输出槽语义、行数与两端最小 margin:SUM 242 行(3.96/3.02)、MUL 1100(6.39/6.52)、ADD 220(9.37/9.50)、ADZ 220(8.41/8.00)、FLS 2(12.93/13.11)、NXT 11(10.48/10.22)、SUB 242(8.36/8.19)、EST 400(4.51/4.61)、DEC 9(10.00/10.09),合计 2,446 行,服务器最小 3.96、M4 最小 3.02。还定义了下一步操作代码 A/Z/M/F/N/H/B/S/C 的语义。
证书的完整清单:任何想复现或审计“有限表是否真正穷举视图”的读者都需要这张表,它也是定理 1 中集合 $V$ 的具体定义。
浏览器测试四组各 50 题的明细:除法(至 10 位小数)50/50 精确、中位 7.0s、最慢 13.3s、1 题超 12s,中位 65 次前向/90 视图;开方(至 6 位)中位 9.8s、最慢 16.5s、11 题超时、86 前向/137 视图;gcd 中位 7.0s、4 题超时;带符号加减中位 2.0s、无超时、19 前向/19 视图。成本模型预测与实测中位非常接近(如开方 10.7s 对 9.8s)。
给出证书之外的真实部署性能数据:通过数、时延分布与成本模型拟合,是把“正确性”落地为“可用性”的量化证据。
11+3 道代数基准题在两条路线下的视图数/批处理后前向数/秒:线性方程 $3(x-2)+5=2x+14$ 教材路线 36/22/2.8s 对求值路线 75/27/4.5s;$(x+2)^5$ 展开 159/95/12.1s 对 458/248/33.1s;因式分解 $x^3-6x^2+11x-6$ 16.9s 对 31.5s;$(x+1)^{10}$ 教材 322/154/21.9s 对求值 2,359/845/142.2s。三个无理根问题(如 $x^2-2=0$,7.4s)仅教材路线有数据,求值路线只能给小数界。
量化“教材式符号推导 + 认证算术”相对“求值插值”的效率优势,并暴露成本随次数增长的问题($(x+1)^{10}$ 已超 12s 目标)。
各训练配方在held-out模板上的完整指标:仅合成对话 + 自蒸馏(从乘法适配器初始化)IFEval −0.55 但 GSM8K −31.2;叠加人类多步解 −14.0、基模型多步解 −6.4;on-policy 蒸馏 GSM8K −2.0 但 recall 降到 0.946、词题正确率跌到 0.678;更宽词题数据、GRPO(recall 0.981)、严格奖励使 recall 崩到 0.794;最终配方 0.994/0.989,IFEval −1.5±2.0、GSM8K −1.6±3.4、MMLU −1.4±1.6。最后一行是未用过题目的重测:GSM8K −5.8±1.7 越出预注册区间、MMLU −2.0±1.1 达标。
这是论文诚实性的集中体现:完整记录了九个配方的权衡与一次预注册失败(GSM8K),避免读者误以为“证书 + 对话”没有代价。
220 题对比的完整矩阵并附 token 预算耗尽数:Sketchpad 220 题全对且无预算问题;GPT-6.1 Sol 与 Claude Opus 5.5 的错误全部是预算内完成的错误答案(相差 1–637 位);Gemini 4 Argon 的 13 个错误中 9 个耗尽预算;开源模型的错误大多因预算耗尽(如 GLM-5.3 在 1000 位加法 0/20 且 20 题全超预算);Qwen3.5-0.8B 带思维链时 217 个失败全部因预算耗尽。
区分了两类失败模式——“静默错答”与“预算耗尽”,凸显基线对比的公平性细节,以及 Sketchpad 不受输出 token 预算约束的优势。
把论文中每个定理/引理映射到 Lean 声明与文件:定理 1(sheet_exact_iff / sheet_certified,Sheet.lean 与 Pinned.lean)、定理 2(no_finite_test_suite、theorem8a_counterexample、no_finite_check,Unpinned.lean)、定理 3(sheet_exact_of_close 等)、定理 4(error_decomposition、sheet_error_bound,Compose.lean)、引理 1–4 及缓存正确性(cachedForward_eq、policy_tick_eq 等)。全部证明无 sorry、不依赖额外公理。
审阅形式化工作的入口:读者可据此在仓库中定位并编译每条证明,验证“有限视图 ⟺ 任意长度”等核心论断确实经过机器检查。