超越 Top-k 技能检索:面向 LLM 智能体的多样性感知技能路由 Beyond Top-k Skill Retrieval: Diversity-Aware Skill Routing for LLM Agents
用查询残差 DPP 重排技能,兼顾相关与互补,提升多技能覆盖率
前置知识
确定点点过程(DPP)
DPP 是一种概率集合选择模型,用核矩阵 $L$ 的行列式 $\det(L_A)$ 给子集 $A$ 打分:行列式同时由对角元(单个物品的质量)和非对角元(物品间相似度)决定,相似物品会相互“排斥”,因此高行列式的子集往往质量高且彼此不冗余。DPP 已广泛用于文档摘要、推荐系统等需要多样性选择的任务。
DSR 的核心就是构造一个查询条件化的 DPP 核并做子集选择,理解行列式如何同时编码“质量×互补”才能看懂方法动机与推断过程。
贪心 MAP 推断
MAP 推断指在 DPP 中寻找使 $\det(L_A)$ 最大的子集 $A$,精确求解是 NP 难的。实践中普遍采用贪心算法:从空集出发,每轮选择带来最大对数行列式边际增益的物品加入,配合增量 Cholesky 分解可以高效更新行列式,无需每轮从头重算,可扩展到大候选集。
DSR 用贪心 MAP 从召回的候选池中挑选最终 k 个技能,算法 1 的主循环就是这个过程,选出的集合质量直接决定覆盖率指标。
检索-重排流水线
大规模检索的标准两段式架构:先用轻量双塔编码器对查询和全部物品计算余弦相似度,召回一个小候选集(如 top-50);再用更强但更慢的逐对重排器(交叉编码器,输出相关性 logit)对候选精细打分。分层设计让昂贵的深度模型只需在小候选集上运行,支撑百万级库存的在线服务。
DSR 完全复用 SkillRouter 的 SR-Emb-0.6B 召回器和 SR-Rank-0.6B 重排器,只改变最后的选择层,论文的核心对照实验正建立在这条流水线上。
查询残差与嵌入空间
L2 归一化的语义嵌入把文本映射到单位球面,余弦相似度即内积。残差指从向量中减去它在查询方向上的投影:$r_i = e_i - (e_i^\top e_x)e_x$,得到与查询正交的分量。将残差与原嵌入按系数混合后再归一化 $\tilde z_i = \lambda r_i + (1-\lambda)e_i$,可以让相似度计算聚焦于“扣除共同查询相关成分后还剩多少重叠”。
查询残差多样性核是本文唯一的方法创新点,其动机——区分“真冗余”与“同查询导致的相关”——完全依赖这一几何直觉。
Recall@k 与 Full Coverage@k
Recall@k 衡量目标技能集合中有多少比例出现在预测列表前 k 位;Full Coverage@k 更严格,要求一个查询的全部目标技能都进入前 k 位才算命中。对需要 2-5 个技能协作的多步任务,漏掉任何一个必要技能都可能导致工作流中断,因此 Full Coverage 更贴近智能体的实际需求。
论文所有结论都围绕这两个覆盖率指标展开,DSR 的收益主要体现在 Full Coverage 上;理解两者差异才能读懂表 1 至表 3 的数字含义。
研究动机
LLM 智能体越来越多地依赖外部“技能”——由指令、脚本、示例和参考文档打包成的可复用模块——来扩展能力,技能库规模已增长到数万量级:SkillRouter 基准的技能池约含 80,000 个候选技能(EASY 层 78,361 个,HARD 层 79,141 个、含 780 个 LLM 生成的干扰技能)。受上下文窗口限制,不可能把全部技能暴露给智能体,而现有点对点(pointwise)路由器对每个候选独立打分后取 top-k,带来两个具体问题:其一,大量技能在功能上彼此冗余,描述相近的技能会同时占据前列位置,浪费宝贵的上下文预算;其二,真实任务往往是组合式的,例如一次数据分析请求可能同时需要表格解析、列清洗、数据变换和可视化等多种互补技能,独立 top-k 检索会漏掉其中一部分。基准数据直接暴露了短板:在 75 条专家验证查询中,51 条多技能查询(每条需要 2-5 个目标技能)上,强基线 SkillRouter 的 Full Coverage@10 只有 0.424、Recall@10 仅 0.659——意味着一半以上的多技能任务在 10 个名额内无法集齐全部所需技能。
本文的目标是本文的目标是把大规模技能路由从“相关性排序”重新表述为“互补集合选择”:给定候选技能池和相关性分数,如何在保持单个技能相关性的同时,让选出的短名单彼此不冗余、并尽可能覆盖多步任务所需的全部技能。具体而言,作者希望在不更换检索器和重排器的前提下——即完全复用 SkillRouter 的 SR-Emb-0.6B 召回与 SR-Rank-0.6B 打分——仅通过改变最后的选择层就提升 Recall@k 和 Full Coverage@k,且增益应集中在多技能查询和较大截断(k=20、50)上,因为那里冗余问题最严重;同时方法需在约 80K 规模的技能库上保持可接受的计算开销,即 DPP 选择只作用于召回的 top-50 候选而非全库,贪心 MAP 用增量 Cholesky 更新实现。
与已有工作不同的是,多样性感知检索并不新鲜——MMR 早在 1998 年就用“相关性+新颖性”平衡重排文档,DPP 也广泛用于摘要和推荐——但把它们直接搬到技能路由会踩一个独特的坑:在技能场景里,两个技能的嵌入相似可能因为它们功能冗余,也可能仅仅因为它们服务于同一个查询却覆盖不同步骤(如表格解析与可视化都“相关”于同一数据分析请求)。均匀惩罚所有相似度会误杀有用的互补技能。DSR 的独特切入是构造“查询残差”空间:先从每个技能嵌入中减去与查询对齐的分量,再在残差空间中度量冗余,从而只惩罚扣除共享查询相关性后仍然重叠的部分。另一个独特性在于对照设计:检索器与重排器完全固定不变,任何指标变化都可归因于选择目标函数的改变,干净地隔离了“多样性选择”本身的作用。
核心方法
直觉上,DSR 把“选技能”从逐个打分变成“组队”:好队友不仅自己能干,还不能与已入选的队友重复。技术上它嵌入在标准的检索-重排流水线之后:第一步用双塔编码器 SR-Emb-0.6B 对查询与全部约 80K 技能计算余弦相似度 $a_i(x) = e_x^\top e_i$,召回得分最高的 M=50 个候选构成 $C_x$,深度模型只在小候选集上运行;第二步用逐对重排器 SR-Rank-0.6B 给每个候选输出相关性 logit $h_i(x)$,经 sigmoid 变换为非负质量分 $q_i(x) = \sigma(h_i(x))$;第三步在查询残差空间计算技能间相似度并构造 DPP 核 $L(x)_{ij} = q_i(x)\,\phi_x(s_i,s_j)\,q_j(x)$,对角元编码质量、非对角元编码残差相似度;第四步做贪心 MAP 选择,从空集开始每轮加入使 $\log\det(L(x)_A)$ 边际增益最大的候选,直到选出 k 个;最后把选中的技能按质量分降序排列输出。整个流程的 DPP 计算只发生在 50 个候选上,配合增量 Cholesky 更新,开销可控。
核心创新是查询残差多样性核。标准 DPP 或 MMR 直接用原始嵌入的余弦相似度度量冗余,这在技能路由中过于激进:一次多步数据分析可能需要表格解析、列清洗、可视化三个技能,它们都强烈相关于同一查询,原始空间中彼此很近,若均匀惩罚相似度,DPP 反而会偏向“表面不同但不太有用”的候选。DSR 先剥离查询对齐分量 $r_i = e_i - (e_i^\top e_x)e_x$,再与原嵌入按 $\lambda=0.85$ 混合并归一化 $\tilde z_i = \lambda r_i + (1-\lambda)e_i$、$z_i = \tilde z_i/\|\tilde z_i\|_2$,最后用 $\phi_x(s_i,s_j) = (1 + z_i^\top z_j)/2$ 把余弦映射到 $[0,1]$,使惩罚只作用于“扣除共同查询相关性后仍重叠”的真冗余。消融证明这是成败关键:换成标准余弦核,多技能 Full Coverage@10 从 0.441 跌到 0.254,甚至低于不做多样性的点对点基线 0.424——朴素多样性比不做多样性更糟。
方法步骤详情
算法 1 流程如下。(1) 编码:输入查询 $x$ 与约 80K 技能池 $S$,输出 L2 归一化的 $e_x$ 与 $\{e_i\}$。(2) 召回:按 $a_i(x)=e_x^\top e_i$ 取 top-M(M=50)得候选集 $C_x$,昂贵的重排只在候选上运行。(3) 质量分:SR-Rank-0.6B 输出逐对 logit $h_i(x)$,$q_i(x)=\sigma(h_i(x))$;消融显示换成嵌入相似度质量,多技能 FC@10 会从 0.441 降到 0.237。(4) 残差构造:计算 $r_i=e_i-(e_i^\top e_x)e_x$,按 $\lambda=0.85$ 混合并归一化得 $z_i$。(5) 构造核:$\phi_x(s_i,s_j)=(1+z_i^\top z_j)/2$,$L(x)_{ij}=q_i\phi_x q_j$,保证 $\phi_x(s_i,s_i)=1$、$L(x)_{ii}=q_i^2$。(6) 贪心选择:从空集起每轮用增量 Cholesky 更新计算 $\log\det$ 边际增益、选最大者加入直至 $|A|=k$;因 $\phi_x(s_i,s_i)=1$,首步自动选中质量最高者 $s^{(1)}=\arg\max q_i(x)$。(7) 输出:按 $q_i(x)$ 降序排列选中技能作为最终短名单。
技术新颖性
技术新颖性有三层。第一,问题层面:把技能路由从 pointwise 排序改为多样性感知的子集选择,并指出技能场景特有的“冗余 vs 共享相关性”歧义——这是 MMR、传统 DPP 应用(文档摘要、推荐、游戏礼包推荐)都未处理过的。第二,方法层面:现有多样性方法都在固定的物品相似度空间里操作,DSR 的核 $\phi_x$ 显式依赖查询 $x$,通过残差投影 $r_i = e_i - (e_i^\top e_x)e_x$ 实现“每个查询一个相似度空间”,混合系数保留 15% 原始嵌入以稳定数值。第三,实验层面:检索器与重排器完全固定,唯一变量是选择目标,使得多技能 Full Coverage@50 上 +0.093 的提升可以干净地归因于多样性选择本身。与 LLM 路由文献(FrugalGPT、RouteLLM、RouterDC 等)的区别也很明确:模型路由通常选一个模型或级联少数模型,而技能路由必须同时暴露多个互补技能,冗余因此成为核心矛盾。
实验结果
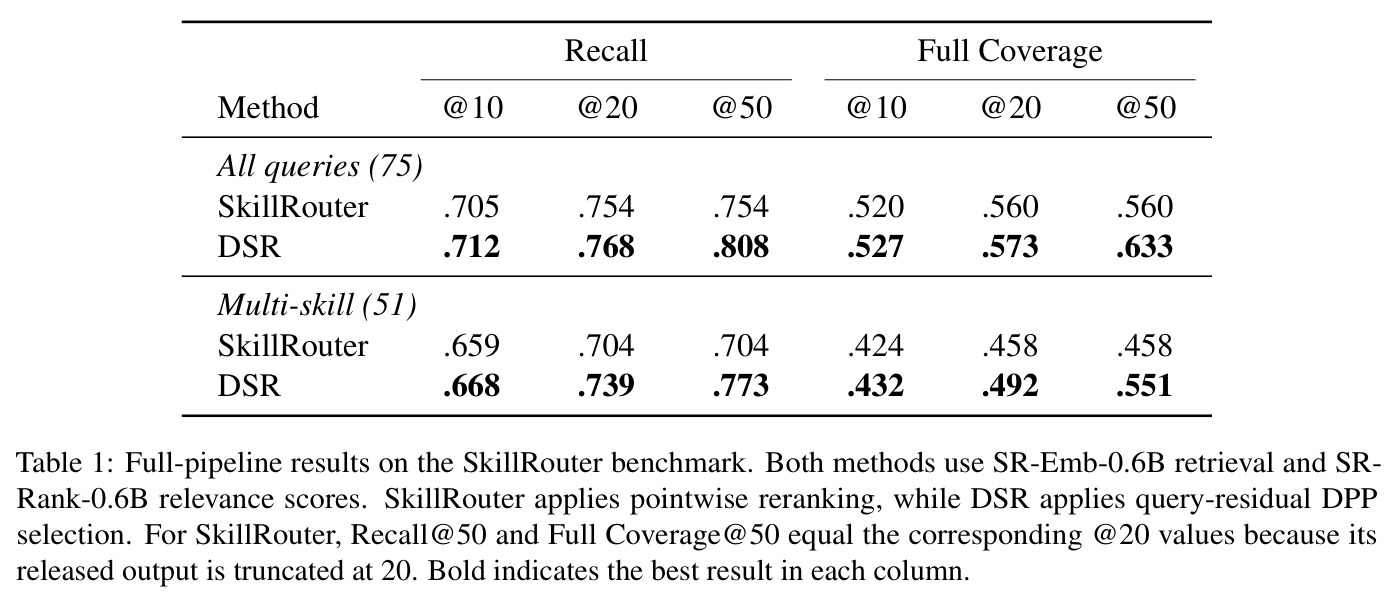
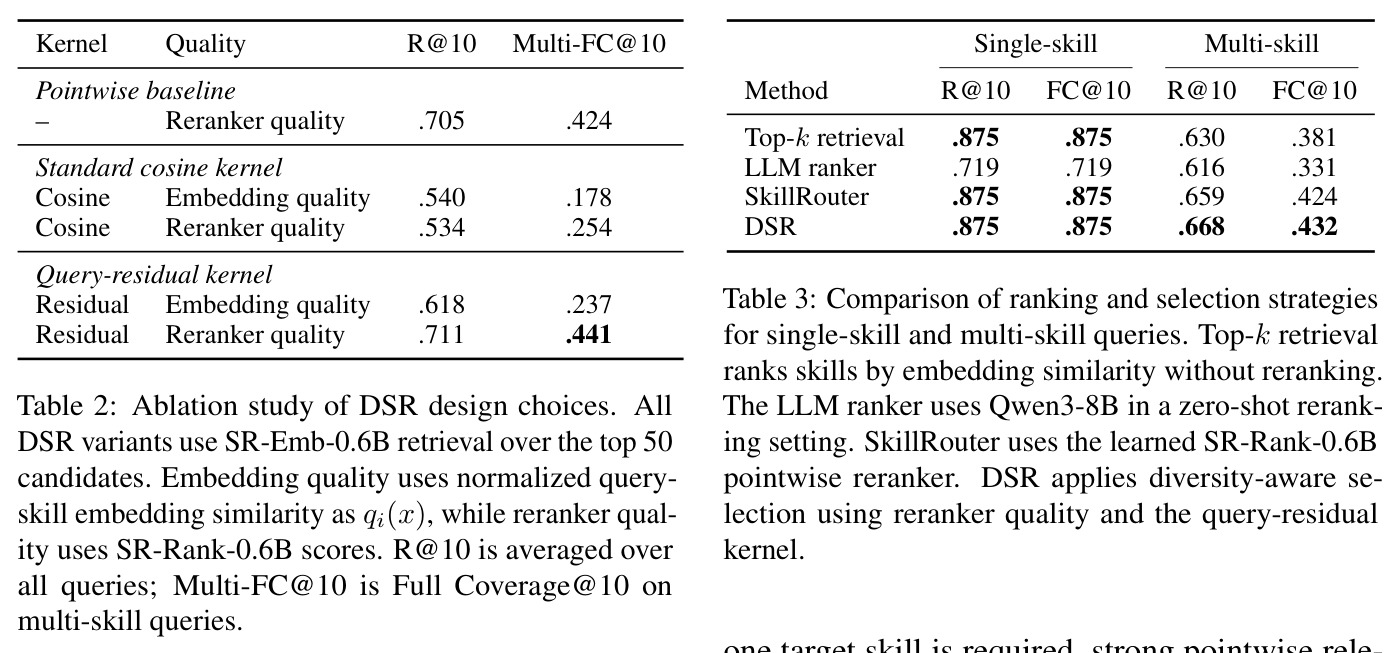
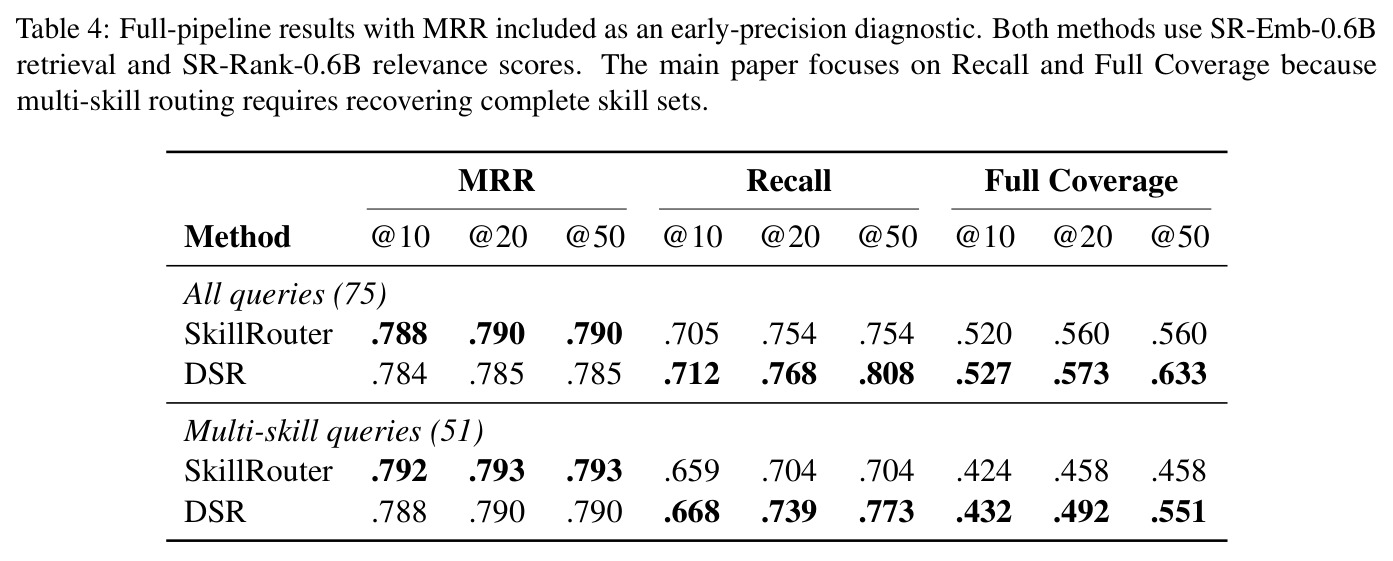
主实验(表 1)在 SkillRouter 基准上对比完整流水线,两法共用 SR-Emb-0.6B 召回与 SR-Rank-0.6B 打分。全部 75 条查询上,Recall@20 从 0.754 提到 0.768、Full Coverage@20 从 0.560 提到 0.573;放宽到 @50 差距拉开:Recall 0.754→0.808(+0.054)、FC 0.560→0.633(+0.073)。多技能子集(51 条)增益更大:Recall@20 0.704→0.739、FC@20 0.458→0.492、FC@50 0.458→0.551(+0.093),验证“任务越组合、多样性选择越有用”。消融(表 2):残差核+重排器质量的 Multi-FC@10 达 0.441,换标准余弦核跌至 0.254(低于点对点基线 0.424);残差核下嵌入质量仅 R@10 0.618 / Multi-FC@10 0.237,换重排器质量升至 0.711 / 0.441。策略对比(表 3):单技能上 Top-k、SkillRouter、DSR 的 R@10 与 FC@10 同为 0.875,Qwen3-8B 零样本重排仅 0.719;多技能上 DSR 以 0.668 / 0.432 领先 SkillRouter(0.659 / 0.424)与 Top-k(0.630 / 0.381)。MRR 诊断(表 4):DSR MRR@10 0.784 vs 0.788(全部查询)、0.788 vs 0.792(多技能),覆盖收益几乎不牺牲首位精度。实验在 NVIDIA A100 80GB 上完成。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SkillRouter 基准·全部 75 条查询 | Recall@50 | 0.808 | 0.754(SkillRouter 点对点重排) | +0.054 |
| SkillRouter 基准·全部 75 条查询 | Full Coverage@50 | 0.633 | 0.560 | +0.073 |
| SkillRouter 基准·全部 75 条查询 | Recall@20 / FC@20 | 0.768 / 0.573 | 0.754 / 0.560 | +0.014 / +0.013 |
| SkillRouter 基准·多技能 51 条查询 | Recall@50 | 0.773 | 0.704 | +0.069 |
| SkillRouter 基准·多技能 51 条查询 | Full Coverage@50 | 0.551 | 0.458 | +0.093 |
| 消融:查询残差核 vs 标准余弦核(重排器质量) | Multi-FC@10 | 0.441 | 0.254(余弦核) | +0.187 |
| 消融:重排器质量 vs 嵌入质量(残差核) | Multi-FC@10 | 0.441 | 0.237(嵌入质量) | +0.204 |
| 多技能查询·排序策略对比 | R@10 / FC@10 | 0.668 / 0.432(DSR) | 0.659 / 0.424(SkillRouter)、0.630 / 0.381(Top-k) | +0.009 / +0.008(对 SkillRouter) |
| MRR 早期精度诊断·全部查询 | MRR@10 | 0.784 | 0.788 | -0.004(基本无损) |
局限与改进
作者承认的局限:一是评测规模小,基准只有 75 条专家验证查询(24 单技能 + 51 多技能),虽覆盖 55 个领域、8 个超类,统计功效仍有限;二是 DSR 工作在召回之后,如果 SR-Emb-0.6B 召回阶段就漏掉目标技能,DPP 无法挽回;三是指标是检索式的 Recall/Full Coverage,不直接度量下游智能体执行成功率——技能集齐后仍可能因规划失误、工具误用或技能指令冲突而失败。我的补充观察:@10 截断下增益很小(全部查询 R@10 仅 +0.007,单技能完全持平),说明方法主要改善“长名单的填充质量”,对只暴露少量技能的低延迟场景帮助有限;@50 对比也不完全对等——SkillRouter 官方输出截断在 20,其 @50 只是 @20 的复制;此外 $\lambda=0.85$、M=50 等超参没有敏感性分析,结论对它们的稳健性未知;实验也缺少与 MMR 等更简单多样性基线的直接对比(只有 DPP 内部余弦核 vs 残差核),且技能库源自 Claude Skill Registry,外推到其他技能生态存疑。
独立分析的弱点
独立分析几个弱点。其一,残差投影假设查询相关性是单一方向:$e_i-(e_i^\top e_x)e_x$ 只能剥离一个查询方向,若查询本身含多个意图(跨领域复合任务),残差空间仍会保留大量“共同相关”成分而被误判为冗余;改进方向是对查询做多意图分解(如聚类出多个查询中心)后逐一剥离。其二,DPP 选择在召回候选内进行,选择层收益与端到端任务成功率之间的耦合未验证:召回质量差时,多样性选择可能只是“在错误候选里选得更多样”;改进方向是把候选生成与多样性目标联合训练,或对召回做意图感知扩充。其三,计算与延迟:虽然只在 top-50 上做贪心 Cholesky,对延迟敏感的在线智能体仍是额外开销,且候选规模需随注册表增长调大;改进方向是轻量近似(随机特征 DPP、候选缓存)与自适应候选数。其四,统计与泛化:75 条查询、单一技能生态来源,小样本下 +0.013 这类 @20 级别的提升难以排除噪声;改进方向是扩评测集、报告显著性检验,并跨注册表复验。
未来方向
作者提出的方向:在更多领域、更复杂工作流和不同技能类型上评测多样性感知路由;把候选生成与多样性感知选择联合优化;用端到端任务完成率连接技能集合覆盖与实际执行效果;研究更高效的 DPP 近似和自适应候选规模以服务延迟敏感场景。基于本文成果可延伸的方向:其一,把查询残差核思想迁移到其他“同查询多物品”场景,如 RAG 文档块选择、多工具 agent 的工具清单构建、API 组合调用——这些场景同样存在“共享相关性伪装成冗余”的问题;其二,学习式残差:用小型投影头代替固定的减法投影,直接以 Full Coverage 为目标端到端优化;其三,动态技能库下的在线 DPP:技能随时间增删,增量维护核矩阵与 Cholesky 因子;其四,与智能体规划器形成闭环:让规划器反馈哪些技能组合实际完成了任务,用真实执行信号替代检索代理指标来训练选择层。
复现评估
复现条件较好。基准是公开的 SkillRouter 基准(Zheng et al., 2026, arXiv:2603.22455),含 75 条专家验证查询、约 80K 技能(EASY 78,361 / HARD 79,141 含 780 个 LLM 生成干扰项),召回与重排模型为公开的 SR-Emb-0.6B 与 SR-Rank-0.6B。DSR 本身只是选择层算法:算法 1 给出全部公式与超参(M=50、$\lambda=0.85$、k∈{10,20,50}),贪心 MAP 配增量 Cholesky 是文献中的标准技术(Han et al., 2017),百行代码即可实现;论文未明确承诺开源 DSR 代码,实验在 NVIDIA A100 80GB 上完成,但 DPP 选择部分计算量很小、CPU 可运行,主要门槛在于获取并跑通 SkillRouter 的模型与技能库。总体难度中等:只做推理、不再训练的话,复现表 1 与表 2 应当直接可行;风险点在于基准查询的完整公开程度以及 @50 截断的实现细节对齐。
论文图表
完整给出 DSR 推理流程:输入查询 $x$、技能池 $S$、候选规模 M 与输出规模 k;先将查询与全部技能编码为归一化嵌入,召回候选集 $C_x$;为每个候选计算重排器质量分 $q_i(x)$;随后做残差投影 $r_i \leftarrow e_i-(e_i^\top e_x)e_x$、混合 $\tilde z_i \leftarrow \lambda r_i+(1-\lambda)e_i$ 并归一化得 $z_i$;用 $\phi_x(s_i,s_j)\leftarrow(1+z_i^\top z_j)/2$ 构造相似度、$L(x)_{ij}\leftarrow q_i\phi_x q_j$ 构造 DPP 核;最后贪心循环:每轮选取对数行列式边际增益最大的候选加入 $A$,直至 $|A|=k$,返回按质量分排序的结果。
这是方法的完整形式化描述,包含了论文全部公式(残差、混合系数、核构造、贪心选择),是理解与复现 DSR 的直接依据;仅看正文段落容易遗漏超参与实现细节。
比较四种递进策略:Top-k 嵌入检索、零样本 Qwen3-8B LLM 重排、学习式 SkillRouter 点对点重排、DSR(重排器质量+查询残差核)。单技能查询上 Top-k、SkillRouter、DSR 的 R@10 与 FC@10 均为 0.875,LLM 重排仅 0.719;多技能查询上 DSR 以 0.668 / 0.432 领先 SkillRouter(0.659 / 0.424)、Top-k(0.630 / 0.381)和 LLM 重排(0.616 / 0.331)。
揭示了方法的适用边界:单技能任务不需要多样性选择,强点对点相关性信号已足够;多技能任务才是多样性感知选择的主战场,且提示式 LLM 重排不足以在大量相似技能间做细粒度区分。