路由内置:从冻结大模型中激发原生技能路由 The Router Within: Eliciting Native Skill Routing from a Frozen LLM
Gavel用两个线性投影从冻结LLM自身前向传播中读出路由信号,无需技能文本进入上下文
前置知识
Agent Skill 与渐进式披露
Agent Skill 是把指令、脚本、参考文件打包成 SKILL.md 文档的能力扩展单元,智能体在任务需要时加载全文。渐进式披露(progressive disclosure)是 Claude Code、Codex 等现行系统的路由方式:把每个已安装技能的名称与描述预先放进系统提示词,让 LLM 在上下文内自行决定读哪个全文。
Gavel 的动机正是该机制的成本:元数据随技能库线性膨胀、分散注意力、限制库规模。理解它才能理解论文要替代什么。
LLM 隐状态与中间层压缩
解码时每一层的隐状态构成输入的内部表示。研究发现中间层会把输入压缩为语义表示(可用矩阵熵衡量状态占据的方向数),深层则混入大量只为预测下一个 token 服务的细节;压缩最剧烈、熵最低处称为压缩谷,约在模型 70% 深度。
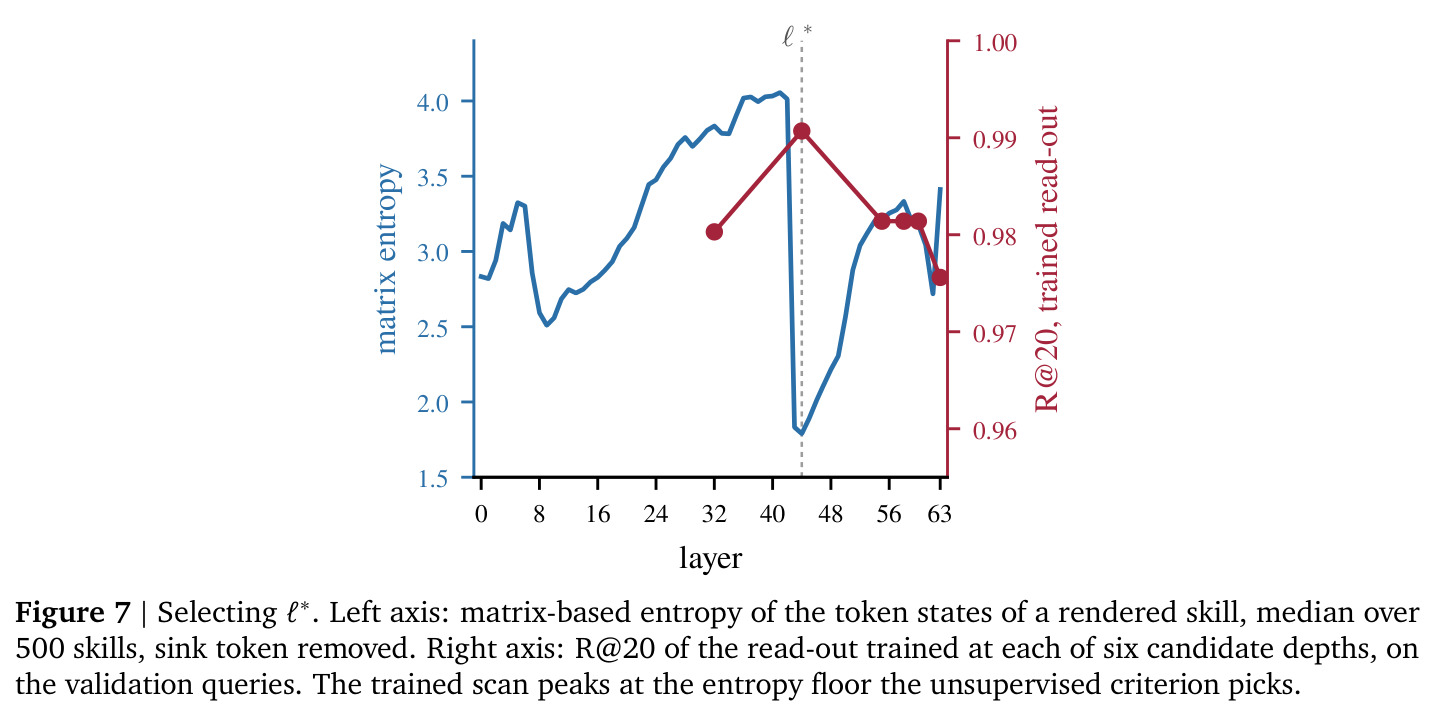
glance 的全部信号读自压缩谷($\ell^*=44/64$ 层),理解隐状态在哪一层最干净是读懂方法设计与层选择实验的前提。
对比学习与 InfoNCE
对比学习通过拉近配对样本(正例)、推远非配对样本(负例)学习表示空间。InfoNCE 是其标准损失,最小化它等价于估计正例相对负采样分布的对数似然比;温度 $\tau$ 控制加权,多正例版本允许一个任务对应多个正确技能。
$W_q$、$W_s$ 用多正例 InfoNCE(式 2)训练,且该损失赋予 glance 分数“对数后验”的概率解释,是三信号可融合为乘积专家的合法性来源。
Late interaction(ColBERT 式匹配)
不同于把整段文本压成单向量再算余弦,late interaction 保留查询与文档每个 token 的向量,得分取每个查询 token 与文档 token 相似度的最大值再聚合。粒度细,能保住少数决定性 token 的贡献,不被大量平庸 token 平均掉。
glance 就是一个跨序列注意力头,按式 (1) 的 max 相似度让每个任务 token 为 top-k 技能投票——正是 late interaction 思想在技能路由上的应用。
查询似然与 LLM yes/no 重排
查询似然(query-likelihood)以 $p(\mathrm{query}\mid\mathrm{doc})$ 给文档打分,衡量文档在多大程度上预示查询;LLM 重排器则让模型读文档后回答“该文档是否相关”,用 yes 与 no 词形概率的对数几率作判别分。
verdict 的两个信号 $L$(式 4)与 $V$(式 5)正是这两种经典重排信号,但读自恢复的安装前向传播,一次前向同时得到两者。
乘积专家(Product of Experts)
Hinton 提出的概率融合方式:多个专家对同一事件的概率相乘(对数域相加),任何一个专家给出极低概率都能压倒其他专家的温和支持,形成“一票否决”机制,优于简单加权平均。
裁定式 $S=g+\alpha L+\gamma V$ 就是三专家乘积:三个信号都是 $\log p(s\mid x)$ 的估计,任一专家可否决其他两个仅勉强容忍的候选。
ε-覆盖(ε-cover)
对单位向量集 $D$,若子集 $C$ 使 $D$ 中每点到 $C$ 最近点的距离不超过 $\varepsilon$,则 $C$ 是 $\varepsilon$-覆盖;若 $C$ 内点两两距离不小于 $\varepsilon$,其大小被覆盖数与填充数夹逼,由集合张成的 $\varepsilon$-可分辨方向数决定而非文档长度。
技能 key 库经 farthest-first 遍历压缩成 ε-覆盖(缩小约 8.5 倍),命题 1 证明 max 分数失真至多 $\varepsilon$ 且绝不抬高——这是库可扩展的关键论证。
研究动机
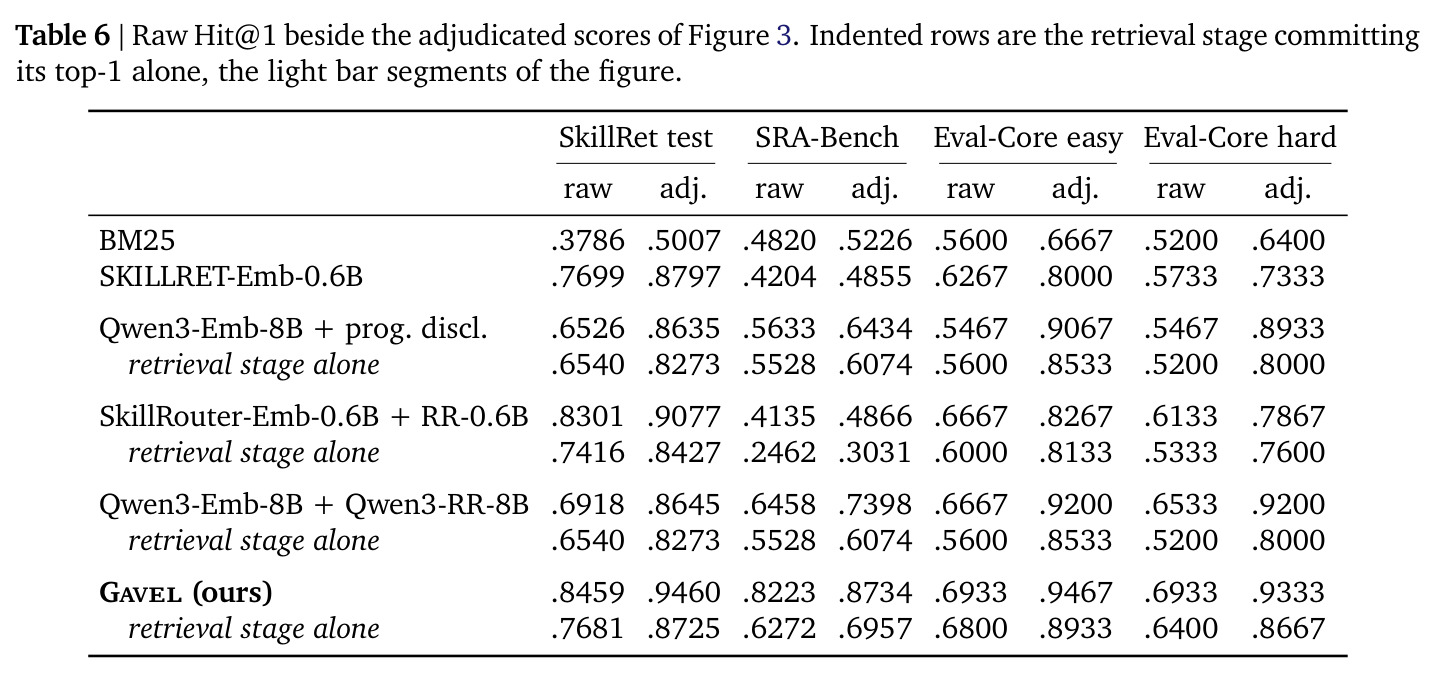
技能(Agent Skill)已成为扩展 LLM 智能体能力的标准方式:一个 SKILL.md 打包指令、脚本和参考文件,任务需要时由智能体加载。现行系统(Claude Code、Codex)采用渐进式披露路由:把所有已安装技能的名称和描述预载入系统提示词,让模型自己决定读哪个全文。但元数据体积随技能库线性增长,会分散注意力、损害任务表现;Codex 被迫把技能元数据限制在上下文窗口的 2%,超出部分直接丢弃,部署因此受限于小库,且路由准确率随技能数量按对数衰减。公共技能库已达数万条规模(Eval-Core 池中有 78,361 个文档,SRA-Bench 有 26,262 个技能)。另一条路是检索式管线(嵌入模型+重排器),上下文干净了,但选择权交给外部模型:独立检索器对任务需求的判断不如智能体 LLM 可靠,尤其在需求于多轮执行中途才浮现的噪声上下文中,且不会随智能体变强而提升。域偏移的代价实测惊人:在 SkillRet 上训练的 SkillRouter-0.6B 嵌入器换到网页流程文档构成的 SRA-Bench,raw Hit@1 跌至 0.2462,甚至不如 BM25 的 0.4820。
本文的目标是本文要回答的问题是:能否让路由既拥有智能体自身的能力,又不占用其上下文?具体目标归结为三个设计约束:(i) 任务专属上下文——在被选中之前,任何技能文本都不得进入上下文,因为元数据预载会分散模型注意力;(ii) 无独立模型——选择应继承智能体 LLM 的判断力并随其进步而免费提升,附加部分必须极轻量(对比检索管线 1.2B–16B 的额外参数);(iii) 安装时索引——技能是放进文件夹的文件,公共库数万条且不断变化,新技能不能触发任何训练。作者提出的 Gavel(Glance And Verdict from a frozen LLM)同时满足三者:仅训练两个线性投影(共 7.9M 参数,一次性训练),路由信号全部来自冻结骨干模型自身的前向传播,在 Qwen3-32B 上零样本迁移到三个公开基准与新构建的 SkillTraj 轨迹基准,并集成进 mini-swe-agent 框架端到端部署。
与已有工作不同的是,独特之处在于接口的选择:论文假设冻结 LLM 的前向传播内部已经携带路由信号,缺的只是一个读出机制。探针研究早已表明隐状态编码的信息超出预测下一 token 所需,但中间层把语义与只为下一 token 服务的内容纠缠在一起,论文附录 A 证明原生机制读不出可用信号——直接用原生注意力 key 做匹配,Hit@1 仅 0.001(训练后的 glance 头为 0.918),信号弱一到两个数量级。与已有工作的本质区别:ToolkenGPT 让冻结 LLM 像输出 token 一样输出工具,但每个工具需单独训练一个嵌入,新工具成本高;GRIT 统一嵌入与生成但需微调整个骨干;检索管线则把判断外包给第二个模型。Gavel 只在压缩谷(矩阵熵最低处,约 70% 深度)嫁接一个新注意力头,训练一次即可随骨干升级免费变强,新技能入库只需一次前向传播、零训练。
核心方法
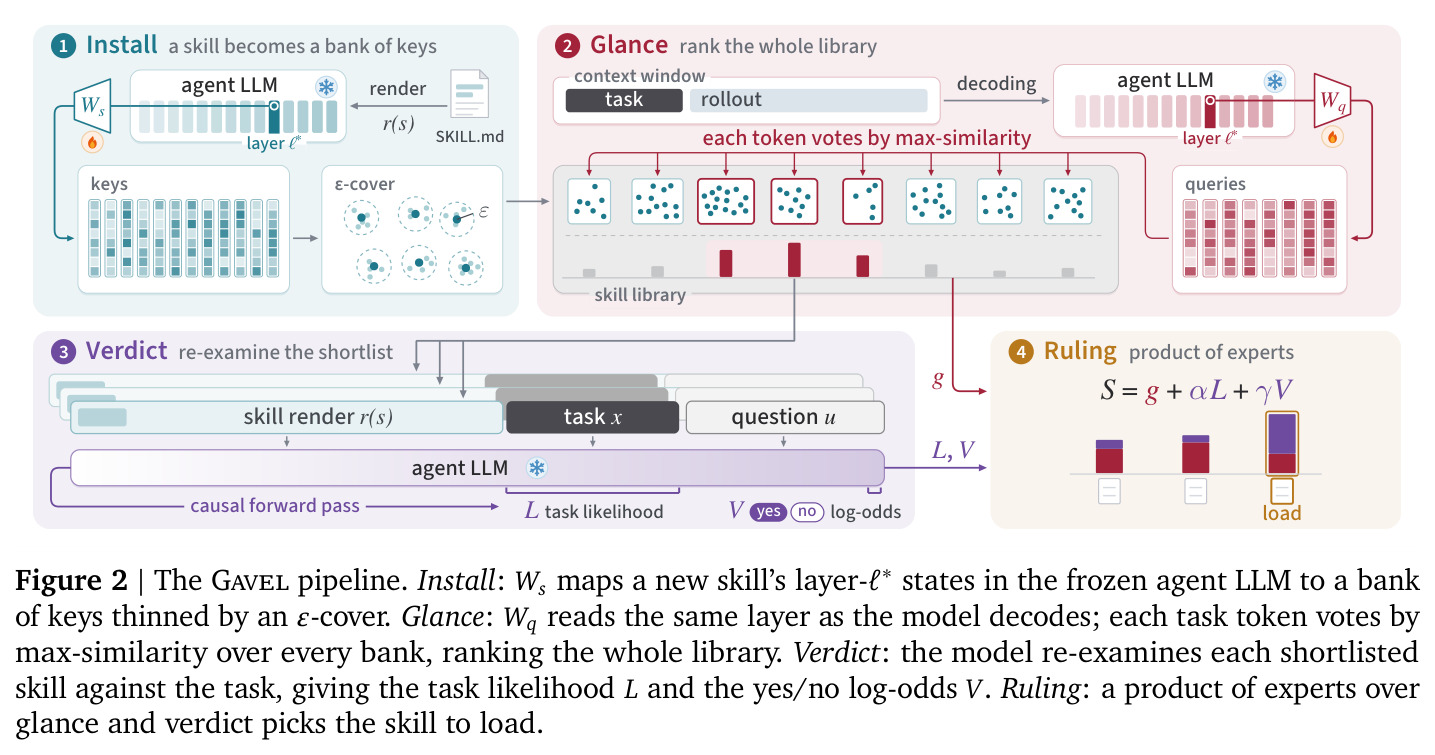
Gavel 的直觉是:智能体 LLM 在解码任务时,中间层已经想清楚了任务需要什么能力,只是没有现成接口把这个判断读出来用于技能排序。技术路线分两阶段。第一阶段 glance(扫视):安装技能时把 SKILL.md 渲染进固定提示词跑一次前向传播,用训练好的 key 映射 $W_s$ 把中间层($\ell^*=44$,64 层模型约 70% 深度)各 token 的隐状态投影为单位 key,构成该技能的 key 库并用 ε-覆盖压缩约 8.5 倍;路由时用查询映射 $W_q$ 读取当前上下文各 token 同层的隐状态,与每个技能的 key 库做 late-interaction 式逐 token 最大相似度,每个任务 token 为其最匹配的 top-k 技能投票,得到全库评分 $g$。第二阶段 verdict(裁决):对短名单(与最优分差 $\Delta=0.133$ 内,平均约 9 个候选)恢复安装时的前向传播并把任务接在其后,一次前向同时读出任务似然 $L$ 与 yes/no 判断 $V$。最后 ruling(裁定):按 $S=g+\alpha L+\gamma V$ 做乘积专家融合,得分最高者加载。部署时另有一个轻量门控(读取累积 glance 分数与末层状态)决定何时触发路由。
核心创新是把技能选择从上下文内迁移到前向传播内部,只花两个线性映射的成本。与渐进式披露的本质区别:技能文本完全不进上下文,注意力不被 $100n$ token 的菜单分散;与检索管线的本质区别:评分信号来自骨干自身——嵌入模型要为每个任务单独跑一次前向,而 glance 读取的是模型解码时反正要产生的隐状态,且骨干升级时路由免费变强。三个关键设计:(1) 逐 token 投票而非跨度均值——只有少数任务 token 指向正确技能,均值会被大量“对每个技能都有点像”的 token 淹没,式 (3) 让每个 token 只为其 top-k 技能投票并配合可调衰减 $w_i$;(2) ε-覆盖压缩——同一能力反复出现会留下方向几乎相同的 key 簇,由于评分只经过 max 算子(式 1),一个代表即可服务整簇,命题 1 证明压缩使分数至多降低 $\varepsilon$ 且绝不抬高,$\varepsilon=0.83$ 时库缩小约 8.5 倍、任何基准损失至多 1.6 分;(3) 三信号同为对数后验——glance 对比式地、似然 $L$ 生成式地、判断 $V$ 判别式地估计同一个 $\log p(s\mid x)$,因此可按乘积专家融合,任一专家都能否决其他两个仅勉强容忍的候选。
方法步骤详情
完整流程六步。步骤 1(安装):对每个新技能用固定模板渲染元数据与正文得 $r(s)$,冻结模型跑一次前向传播,在第 $\ell^*=44$ 层(第 45 块输出)取各 token 隐状态,经 $W_s$(768×5120,无偏置)投影归一化为单位 key $d^s_j\propto W_s\,h_{\ell^*}(r(s))_j$,再用 farthest-first 遍历构建 $\varepsilon=0.83$ 的覆盖,只保留互相距离至少 $\varepsilon$ 的代表。步骤 2(一次性训练):$W_q,W_s$ 共 7.9M 参数,在 SkillRet 的 51,104 条训练查询(Qwen3.5 生成,覆盖 9,084 个技能)上以多正例 InfoNCE(式 2,$\tau=40$)训练 24,000 步(AdamW,学习率 $10^{-3}$,梯度在隐状态处截断),库压缩后 $W_q$ 再以 $10^{-4}$ 微调 3,000 步。步骤 3(glance):$W_q$ 读取任务/轨迹 token 同层隐状态得单位查询 $q_i$,按 $m_i(s)=\max_j\langle q_i,d^s_j\rangle$(式 1)打分,每个 token 只为其 top-k($k=\min(10,\max(3,\mathrm{round}(0.1N)))$)技能投票,加权归一得 $g(s\mid x)$;中途路由时衰减为 $w_i=2^{-a_i/64}$($a_i$ 为距决策点的 token 数)。步骤 4(verdict):把任务接在 $r(s)$ 之后续写(安装前向成为可复用前缀),一次前向读出 $L(s\mid x)=\frac{1}{|x|}\sum_i\log p_M(x_i\mid r(s),x_{<i})$(式 4)与固定问题后 yes/no 对数几率 $V$(式 5)。步骤 5(裁定):$S=g+1.0\,L+0.025\,V$,glance 分数在 $\Delta=0.133$ 内的候选进入裁决,最高者加载;若最优候选 $V<0$ 则不加载。步骤 6(门控):训练线性分类器读取累积 glance 分数与末层状态,连续两个 token 为正才触发路由。
技术新颖性
新颖性可从四层评估。接口层面:首次证明冻结智能体自身的前向传播足以承载全库技能路由,只需 7.9M 参数的读出,而现役管线为此付出 1.2B–16B 外部参数且判断力与骨干脱钩;附录 A 的失败实验支撑这一主张——原生注意力 key、原生头初始化、训练检索 token 三种更原生的方案全部失败(0.001 对 0.918),说明训练投影是必要接口而非可有可无的微调。理论层面:给出 ε-覆盖压缩的失真上界(命题 1:max 分数至多降 $\varepsilon$、绝不升)与投票稳定性(推论 1:离开 top-k 边界带的 token 成员资格不变),库大小被覆盖数与填充数夹逼,即技能库规模由 token 张成的 $\varepsilon$-可分辨方向数决定而非文档长度。工程层面:层选择用矩阵熵谷这一无监督判据(第 44 层熵从 4.01 骤降至 1.83 后触底,训练扫描验证其 R@20 第一),换骨干(gemma-4-31b-it,第 34/60 块)全流程可复刻且结论不变。评测层面:构建 SkillTraj(372 条模拟轨迹,机器可校验的触发点与泄漏筛查),首次把需求在多轮执行中才浮现的真实场景纳入技能路由评测。
实验结果
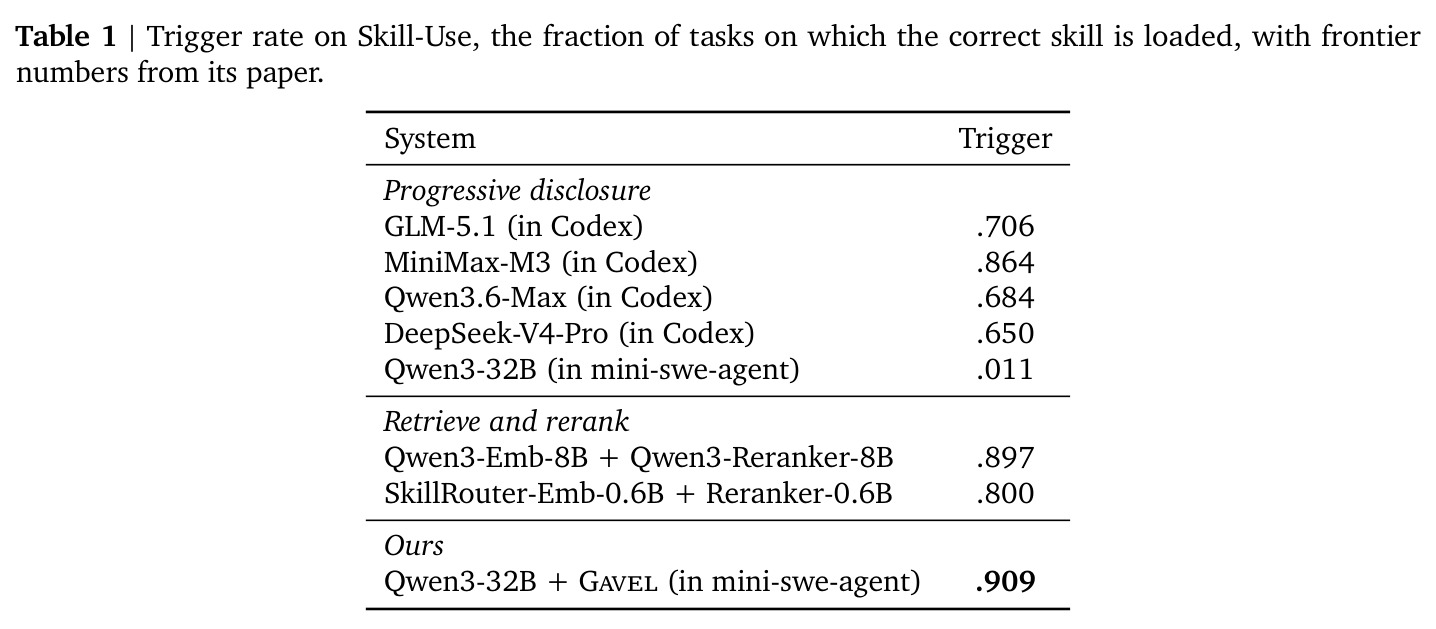
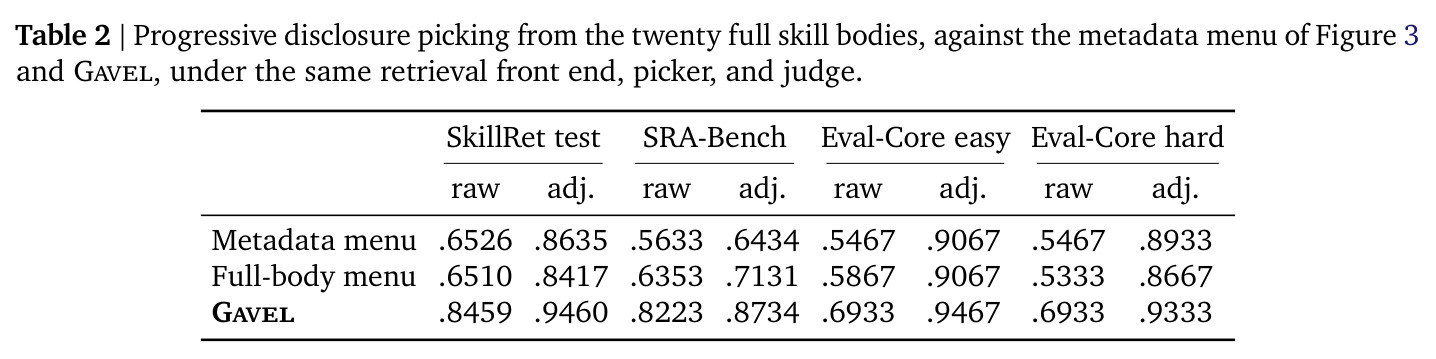
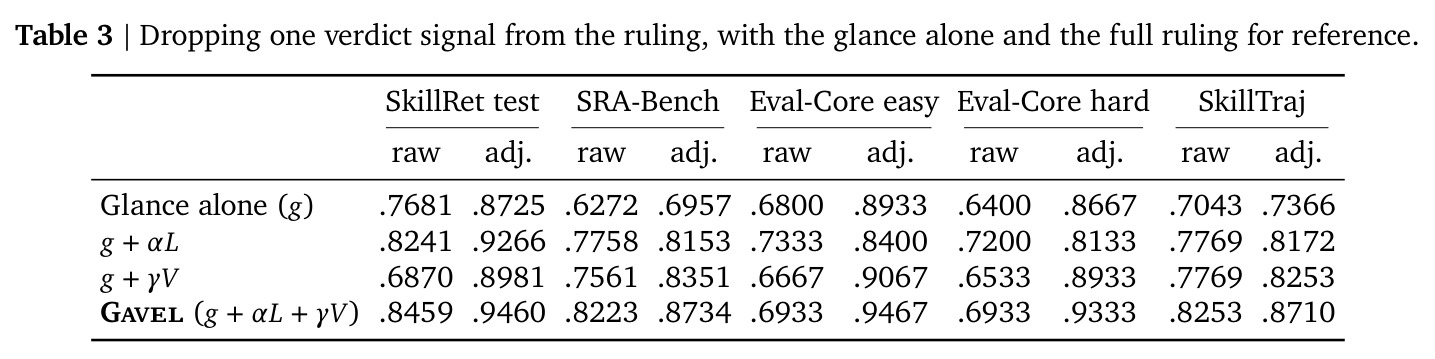
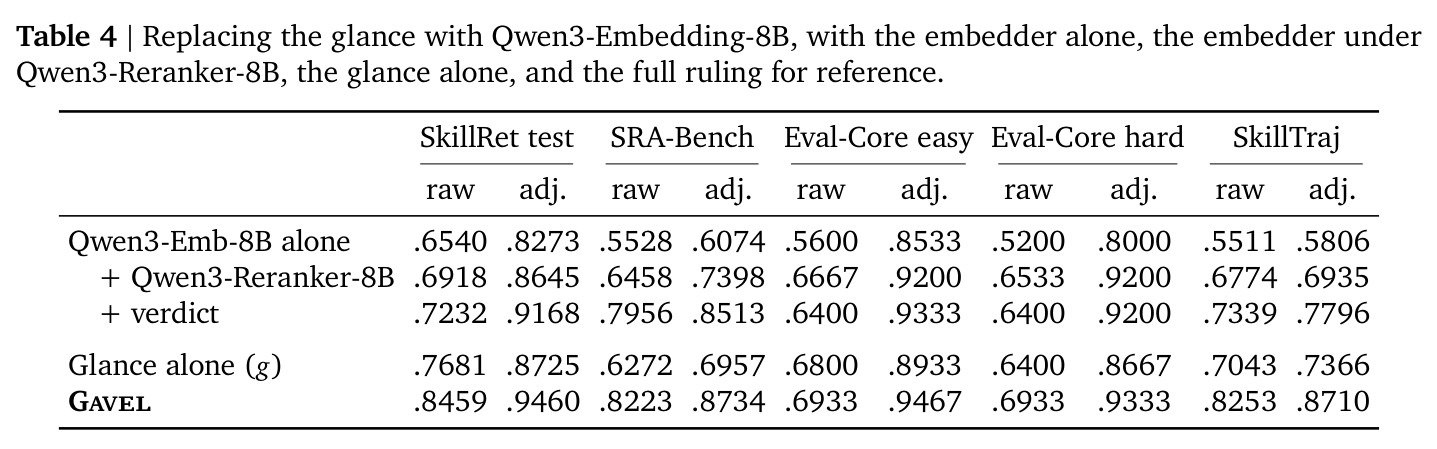
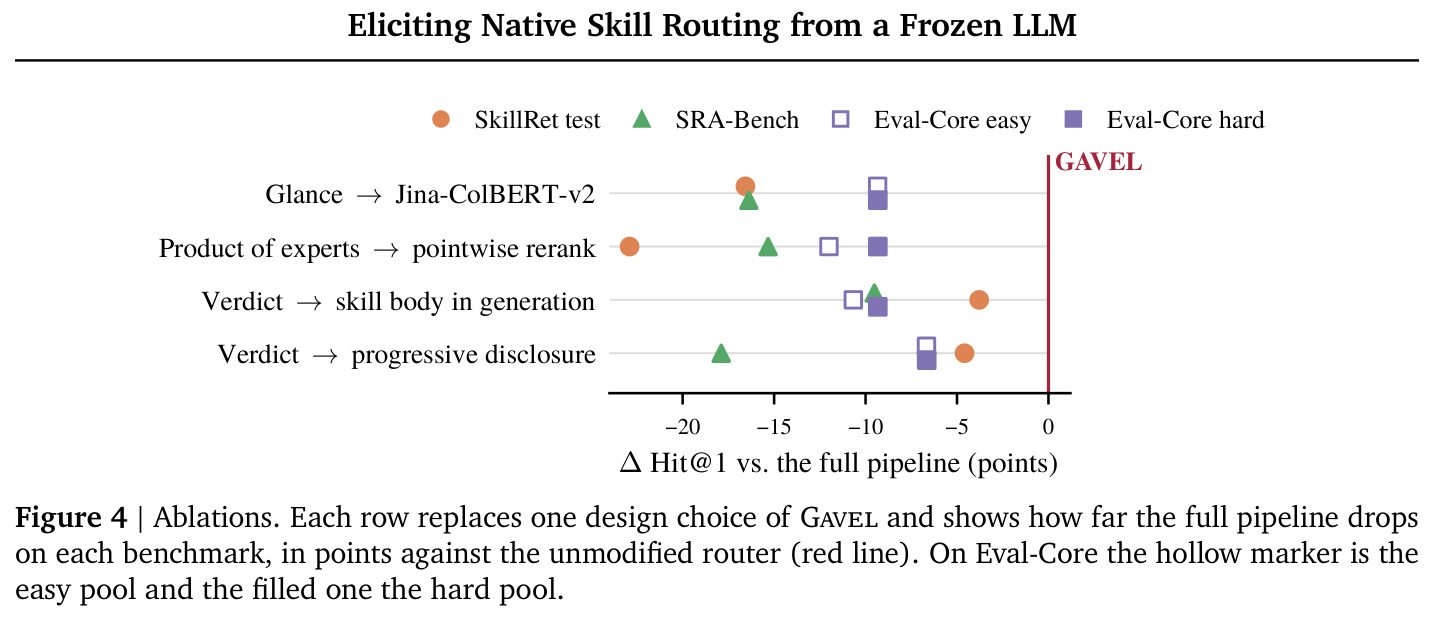
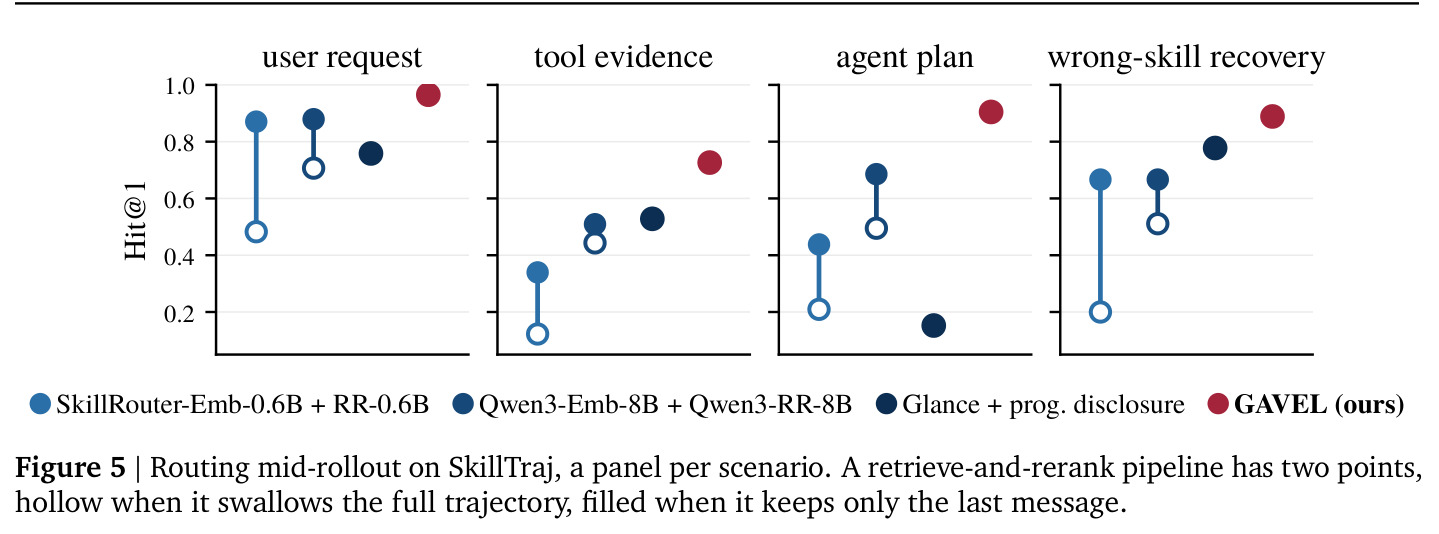
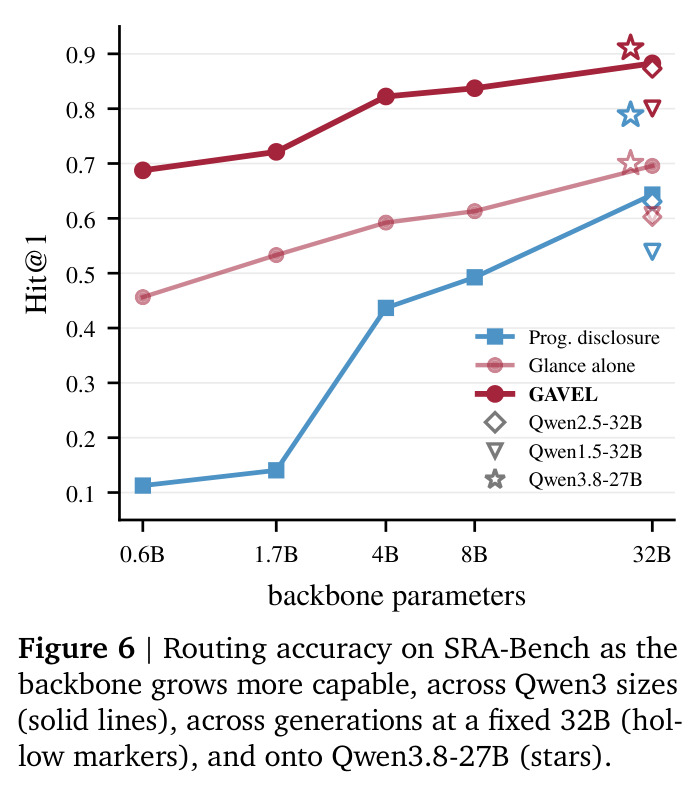
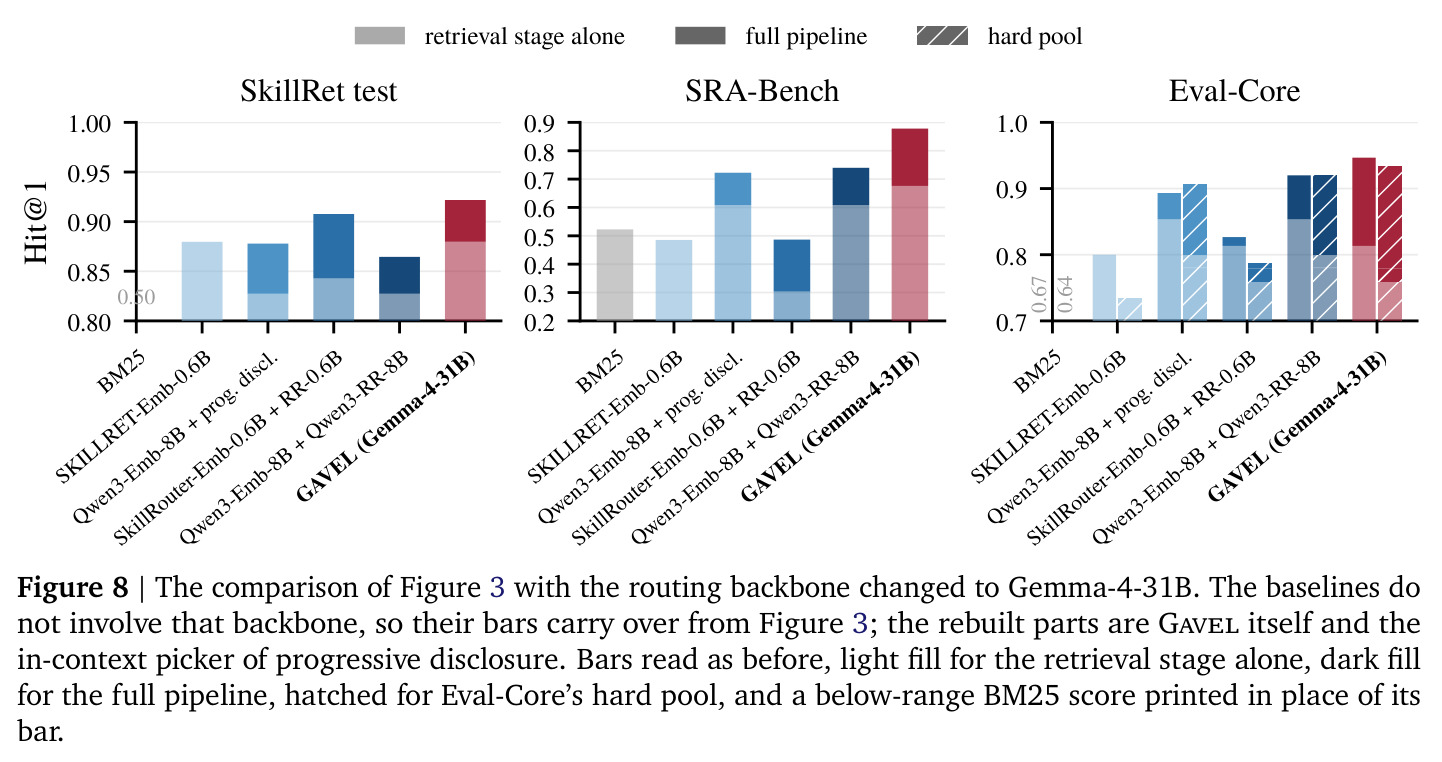
结果分四组。(1) 书面任务(图 3、表 6):adjudicated Hit@1 在 SkillRet test(4,997 查询、6,660 技能)上达 0.9460,超最强管线 SkillRouter-0.6B+RR 的 0.9077 约 3.8 分;SRA-Bench(861 任务、26,262 技能)达 0.8734,超 Qwen3-Emb-8B+RR-8B 的 0.7398 达 13.4 分;Eval-Core easy/hard 池(75 查询、约 7.8 万文档)为 0.9467/0.9333,超基线 2.7/1.3 分。glance 单独已是最强检索阶段(SRA-Bench R@20 0.9675),而域内训练的 SkillRouter 嵌入器在 SRA-Bench raw 仅 0.2462,跌破 BM25 的 0.4820。(2) 中途路由(图 5、表 8):SkillTraj 四场景全面领先 8.6–21.9 分——user request 0.9655、tool evidence 0.7264、agent plan 0.9048、wrong-skill recovery 0.8889(adjudicated);检索管线无论吞下全轨迹还是只取最后一条消息都明显更差。(3) 端到端(表 1):Skill-Use(177 任务、79 技能)上 Qwen3-32B 渐进披露触发率仅 0.011,接入 Gavel 后达 0.909,超过 Codex 中的 GLM-5.1(0.706)、MiniMax-M3(0.864)、Qwen3.6-Max(0.684)、DeepSeek-V4-Pro(0.650),也超过 0.897 的 8B 检索管线。(4) 消融与扩展:四种设计替换全部变差(SkillRet adjudicated 上逐点重排 -22.9、glance→Jina-ColBERT -16.6 分);两个 verdict 信号互补(SkillTraj:仅 glance 0.7366 → 全融合 0.8710);骨干从 0.6B 到 32B 路由单调提升,0.6B 的 Gavel 已胜过 32B 渐进披露,Qwen3.8-27B 菜单式选择仍落后同骨干 Gavel 12.2 分;gemma-4-31b-it 复刻在三个基准上同样第一。
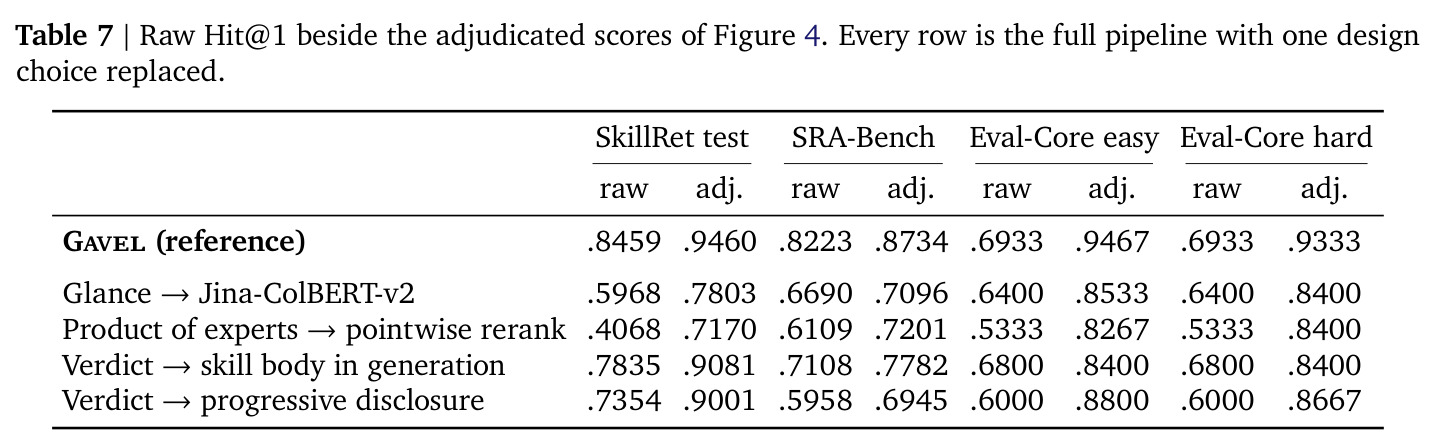
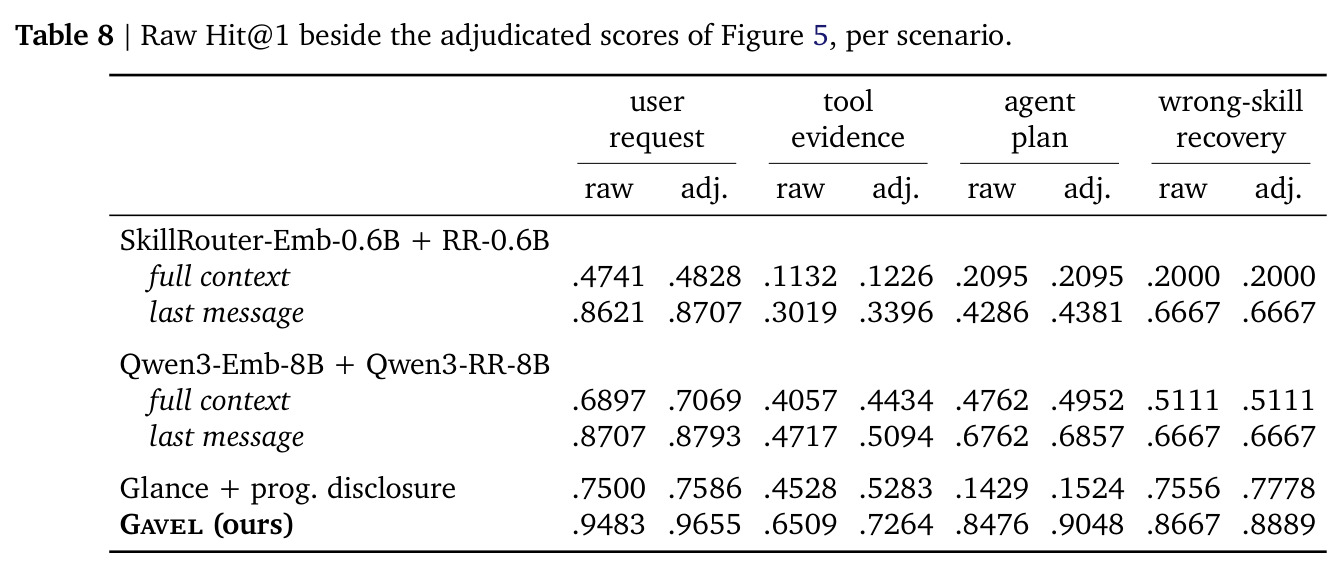
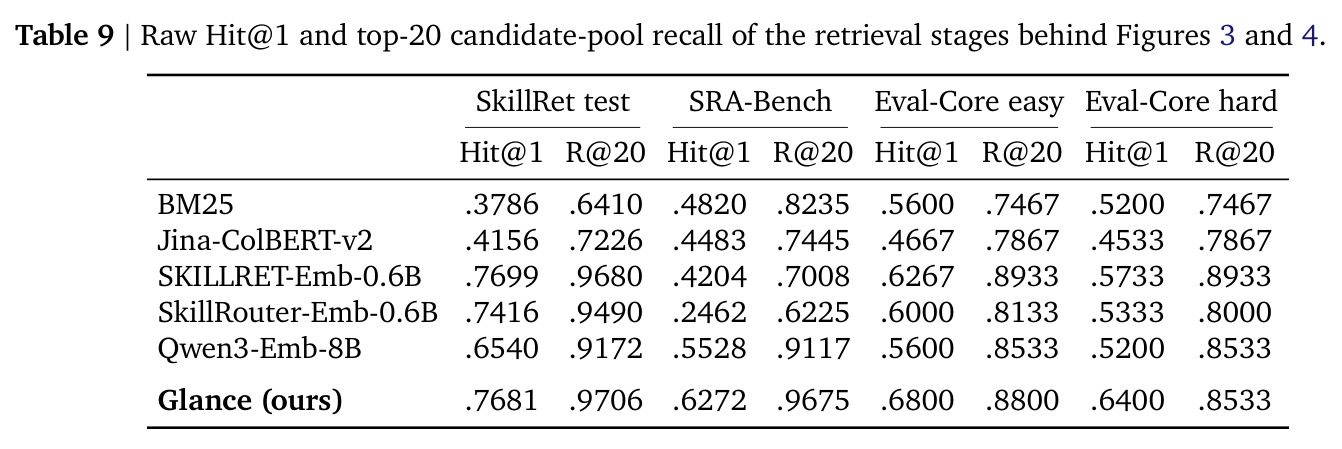
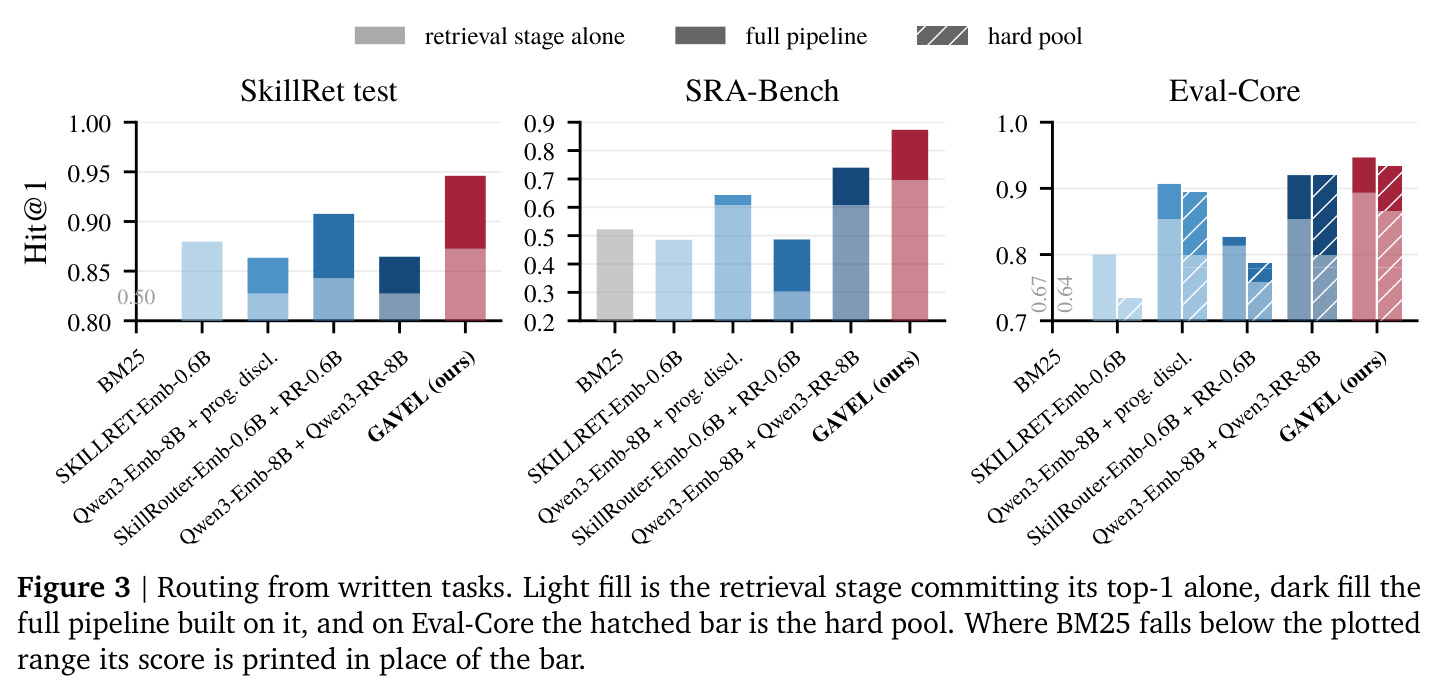
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SkillRet test(4,997 查询 / 6,660 技能)技能选择 | adjudicated Hit@1 | 0.9460 | 0.9077(SkillRouter-Emb-0.6B + Reranker-0.6B) | +3.8 分 |
| SRA-Bench(861 任务 / 26,262 技能)技能选择 | adjudicated Hit@1 | 0.8734 | 0.7398(Qwen3-Emb-8B + Qwen3-Reranker-8B) | +13.4 分 |
| Eval-Core easy 池(75 查询 / 78,361 文档) | adjudicated Hit@1 | 0.9467 | 0.9200(Qwen3-Emb-8B + Qwen3-Reranker-8B) | +2.7 分 |
| Eval-Core hard 池(另加 780 个对抗干扰文档) | adjudicated Hit@1 | 0.9333 | 0.9200(Qwen3-Emb-8B + Qwen3-Reranker-8B) | +1.3 分 |
| SkillTraj·user request(116 条轨迹,用户明说需求) | adjudicated Hit@1 | 0.9655 | 0.8793(Qwen3-Emb-8B + RR-8B,仅最后一条消息) | +8.6 分 |
| SkillTraj·tool evidence(106 条轨迹,工具结果揭示需求) | adjudicated Hit@1 | 0.7264 | 0.5094(Qwen3-Emb-8B + RR-8B,仅最后一条消息) | +21.7 分 |
| SkillTraj·agent plan(105 条轨迹,需求由智能体自己写出) | adjudicated Hit@1 | 0.9048 | 0.6857(Qwen3-Emb-8B + RR-8B,仅最后一条消息) | +21.9 分 |
| SkillTraj·wrong-skill recovery(45 条轨迹,带误导文档重路由) | adjudicated Hit@1 | 0.8889 | 0.7778(glance + 渐进披露菜单) | +11.1 分 |
| Skill-Use(177 个可执行任务 / 79 技能)端到端触发 | 正确技能触发率 | 0.909(Qwen3-32B + Gavel,mini-swe-agent) | 0.864(MiniMax-M3 in Codex,渐进披露);0.897(Qwen3-Emb-8B + RR-8B) | +4.5 分 / +1.2 分;同骨干渐进披露仅 0.011 |
局限与改进
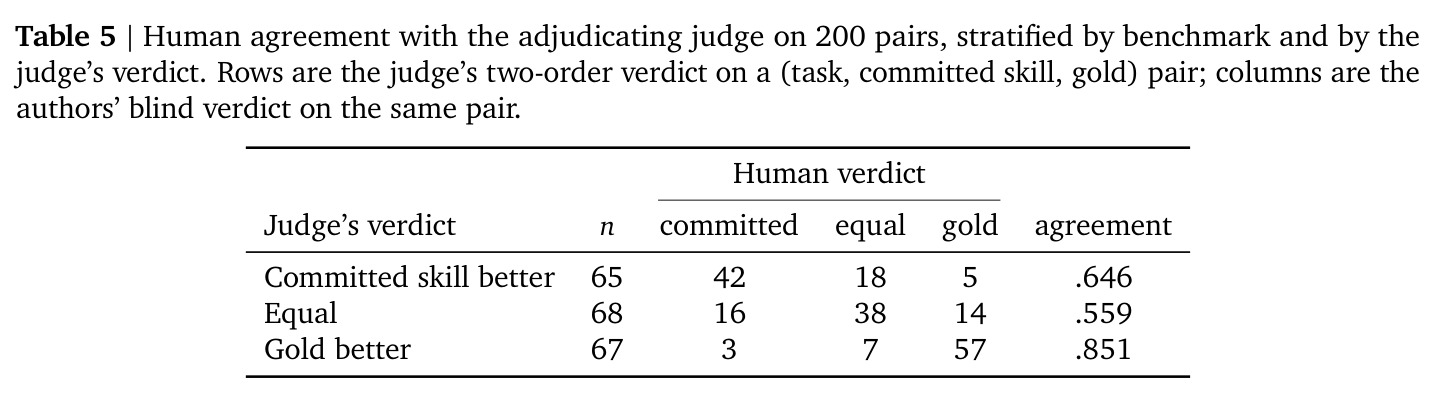
作者承认并展示的局限:verdict 是主要成本——每次触发约 9 个候选各需一次前向传播(每个约 2.2K token),现代服务栈上约半秒、约 0.08 美元(按 $4/M input 折算),高频触发场景延迟费用不可忽略;门控只是简单线性分类器,在 SkillTraj 上训练一次后未再打磨,触发时机可能误报漏报;评测依赖 GPT-5.6 Sol 裁判做 adjudicated Hit@1,虽然 200 对人工核对总体一致率 86%、所有 raw Hit@1 排序结论不变,但裁判判“提交技能更好”时与人工一致率只有 0.646,且存在向宽松方向的净偏差(9/200);训练数据是 Qwen3.5 合成的 51,104 条查询,与真实用户查询分布可能有差距,SkillTraj 轨迹也由 GPT-5.6 Sol 合成。我自己的观察:(1) 方法要求白盒访问隐状态,闭源 API 模型无法直接使用,附录 K 的提供商托管方案把路由器变成厂商功能,用户失去自主权;(2) 每换骨干都要重新选层、重训投影并重标定四个标量(Gemma 上 $\alpha=0.15$、$\gamma=0.003$ 与 Qwen 的 1.0/0.025 差一个数量级),迁移成本不为零;(3) 中途路由的衰减 $w_i=2^{-a_i/64}$ 是手工先验,附录 A 显示训练聚合器只学到近因性,触发点深埋长历史时的选择性聚合仍未解决;(4) “何时需要技能”这半个问题实际由合成数据训练的门控承担,其泛化论证较少。
独立分析的弱点
独立分析四个弱点。其一,verdict 的每候选一次前向在大库高频场景成本陡增:候选数由 $\Delta=0.133$ 剪枝控制在约 9 个,但该余量在 SkillRet 验证集标定,域偏移后可能需要更多候选;改进方向是用裁决分数作软标签把 verdict 蒸馏回 glance 头,或利用 per-skill 前缀 KV 缓存进一步压缩候选数与延迟。其二,三信号线性融合的 $\alpha,\gamma$ 是域内验证集标定的“汇率”,Gemma 实验显示同一对系数在不同骨干上要缩放一个数量级(0.15/0.003 对 1.0/0.025),暗示新域可能需重新标定;改进方向是按信号的经验分散度自适应归一(附录 E 已量化 nats 规模差异:$V$ 的组内标准差 14.8 对 4.5),或做分位数校准。其三,单技能提交(Hit@1)设定忽略多技能协同:Skill-Use 转录中出现过一次任务两次加载的案例(gold 之外又触发 API 安全技能),说明真实任务常需技能组合,但框架没有集合预测或边际效用目标;改进方向是对 top-k 候选做子模选择式组合排序。其四,训练语料只覆盖查询到技能文档的匹配,而真实库中存在功能重叠、版本分叉的文档(论文自举 mcp-builder 有两份拷贝的例子),库维护差时 verdict 的 yes/no 判断可能系统性偏向词面更像训练分布的文档;改进方向是在训练负例中加入近重复对抗样本。
未来方向
作者明确留下的方向:把同一读出机制扩展到工具、记忆、MCP 服务器的路由(结论段原文:whether the same read-out also routes tools, memories, or MCP servers is a question we leave open);云 API 场景由提供商托管路由器,投影随模型一起发布(如同 tokenizer),技能库像 prompt cache 一样由厂商建库;更好的门控——对 glance 分数历史做序列建模以观察需求逐渐积累,或微调骨干发出专用 skill-call token 把触发折叠进解码本身;以及“足够强的智能体仅凭 glance 完成路由、无需 verdict”的前景(附录 F.3 指出 glance 随骨干变强,R@20 已达 0.97)。基于其成果可延伸的方向:把 glance 头复用为通用的上下文-文档中间层注意力接口,用于 RAG 读出或上下文压缩;用 verdict 的生成/判别双信号做技能库自动清洗(检测冗余、过时与近重复文档);多智能体系统共享同一 key 库实现跨代理路由;以及把 SkillTraj 的机器可校验触发点协议推广为通用的能力触发评测基建。
复现评估
复现评估:论文为 2026 年 9 月的 arXiv 预印本,正文未提及代码开源(只引用了 mini-swe-agent 的 GitHub)。有利因素:核心资产描述得非常细——两个投影共 7.9M 参数,训练配方完整(AdamW、学习率 $10^{-3}$、24,000 步、$\tau=40$、每步 200K token 预算、每技能至多 8,192 个 key),训练语料 SkillRet(51,104 查询、9,084 技能)公开,四个标量($\varepsilon=0.83$、$\alpha=1.0$、$\gamma=0.025$、$\Delta=0.133$)与全部渲染/裁决/菜单提示词在附录 G 逐字给出;四个评测基准(SkillRet test、SRA-Bench 861 任务抽样、Eval-Core 75 查询、Skill-Use 177 任务)均可获得,SkillTraj 的构造协议(GPT-5.6 Sol 生成、Claude Sonnet 4.6 盲审、泄漏筛查、机器校验锚点)在附录 H.4 完整描述,可再生成。主要门槛:需要本地部署 Qwen3-32B 并截取第 44 层隐状态,训练前要为 9,084 个技能与全部查询预算并存储隐状态,显存与磁盘开销不小;六层深度扫描与各消融还需多次 32B 前向。总体难度中等:算法本身只是两个线性映射加标准对比训练,工程难点在于对大模型前向传播的插桩与隐状态批量存取,熟悉 vLLM/Transformers 的团队约一到两周可复现主干。
论文图表
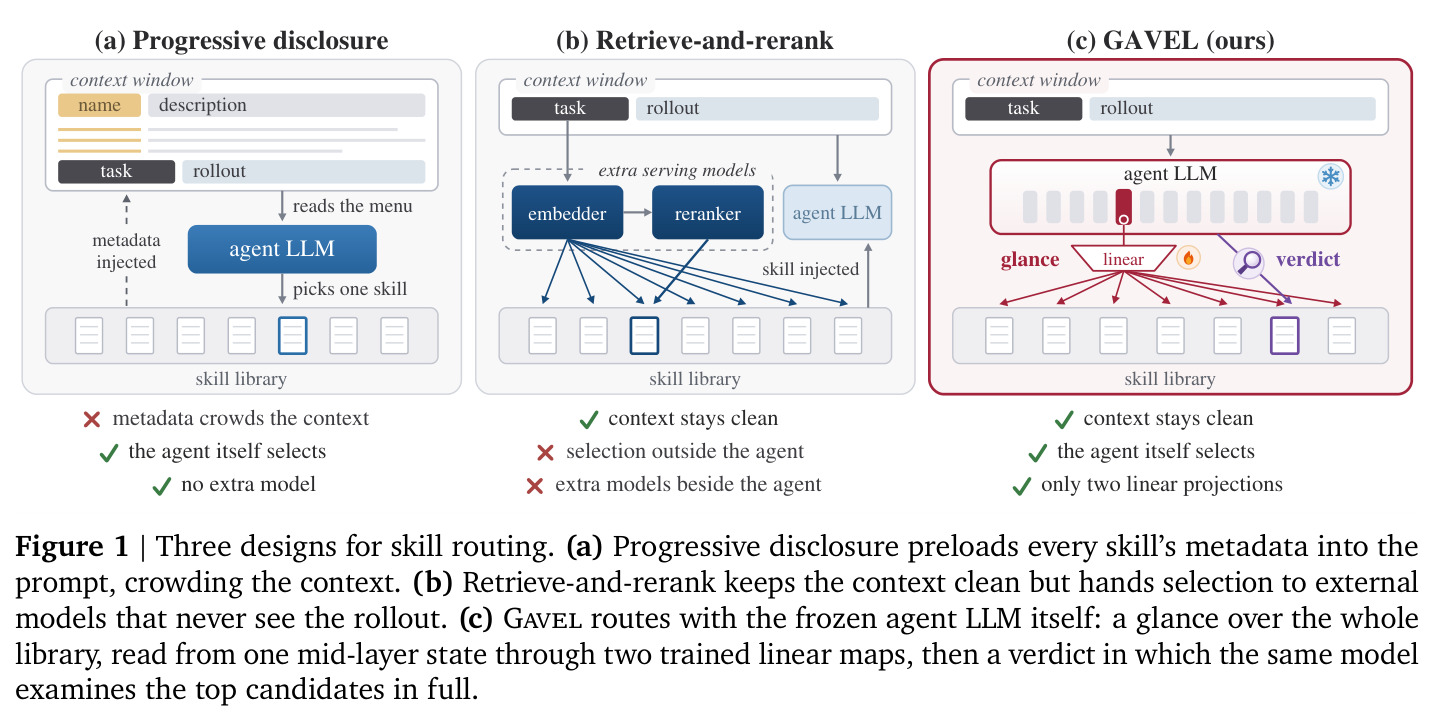
并排对比三种技能路由架构: 渐进式披露把所有技能元数据注入上下文、由智能体自己读菜单选技能,上下文被挤占; 检索-重排把选择交给嵌入器与重排器等外部服务模型,它们看不到 rollout; Gavel 用冻结智能体 LLM 自己路由——glance 经两个线性映射从中间层给全库打分,verdict 让同一模型完整审查入围者。图下标注各自代价:元数据挤占上下文 / 上下文干净但选择在智能体之外 / 上下文干净且只有两个线性投影。
一图看懂论文的问题空间与自身定位,是全文论证的骨架。