SkillSeek:在市场规模下重探智能体技能检索 SkillSeek: Revisiting Agent Skill Retrieval at Marketplace Scale
零LLM成本的两阶段检索器追平LLM循环检索,单试花费$51.30降至$27.54
前置知识
双编码器(Bi-encoder)
将查询和文档分别独立编码为向量(如 BGE-base 输出 768 维表示),用余弦相似度打分。文档向量可以离线预计算,查询时只需编码一次查询再做向量内积,因此能在数十万文档上毫秒级检索;代价是两段文本在编码时没有交互,判别精度有限。
SkillSeek 的第一阶段就是 1.1 亿参数的 BGE-base 双编码器,负责从 3.4 万技能池中快速筛出 top-20 候选,理解它的成本/精度权衡是理解整个两阶段设计的前提。
交叉编码器(Cross-encoder)
把查询和候选文档拼接后送入同一个 Transformer 联合编码,直接输出相关性分数。token 级深度交互使其判别力远强于双编码器,但每个候选都要单独跑一遍前向计算,代价高昂,所以实践中只用于对少量候选(如 20 个)做精排。
本文第二阶段用 5.68 亿参数的 bge-reranker-v2-m3 对候选重排,而'重排器容量带来的收益与首阶段未饱和召回成正比'正是全文的核心机制解释。
BM25
经典稀疏检索算法,基于词频、逆文档频率和文档长度归一化为查询-文档对打分,不需要任何神经模型和训练,是信息检索领域最常用的强基线,本实验用 rank_bm25 包实现(无词干化)。
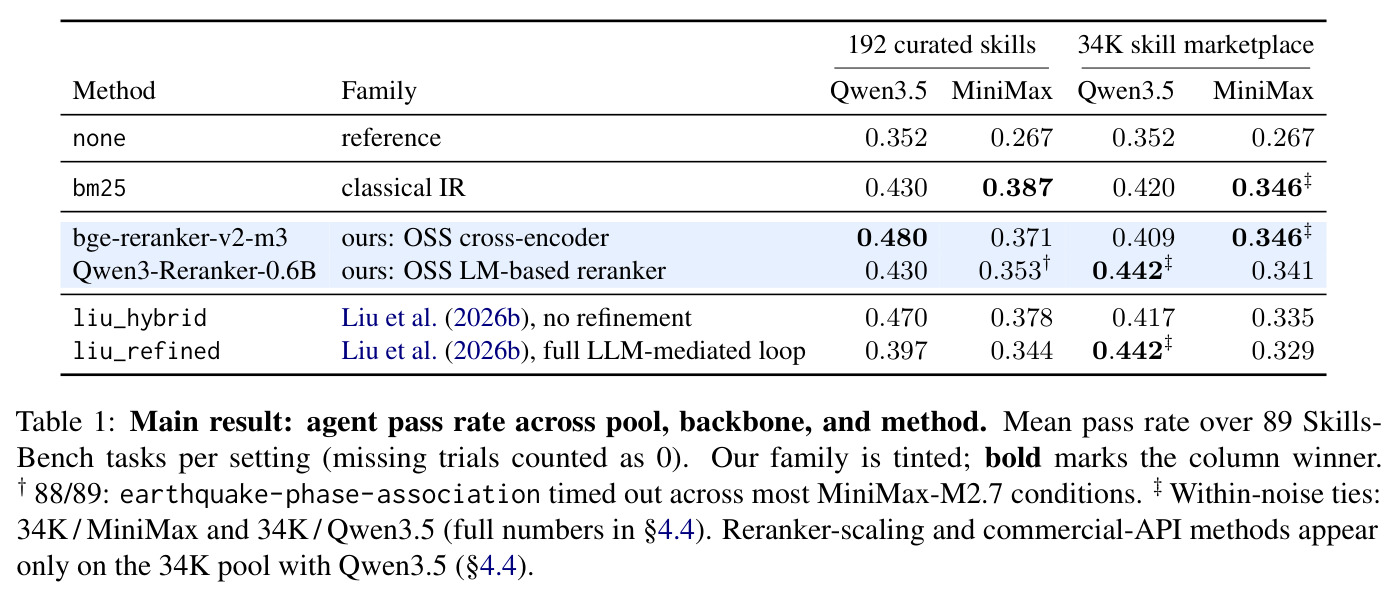
论文最反直觉的发现是:在四个实验设置中的三个,纯 BM25 的智能体通过率就不低于昂贵的 LLM 检索循环——这是作者论证'标准 IR 配方即可作为默认方案'的基石。
R@5(首阶段召回率)
衡量第一阶段检索器把'金标技能'(人工确认与任务相关的技能)纳入前 5 候选的比例。它不需要运行智能体 rollout 就能计算,是诊断检索系统瓶颈的廉价指标,但与端到端任务通过率不是一回事。
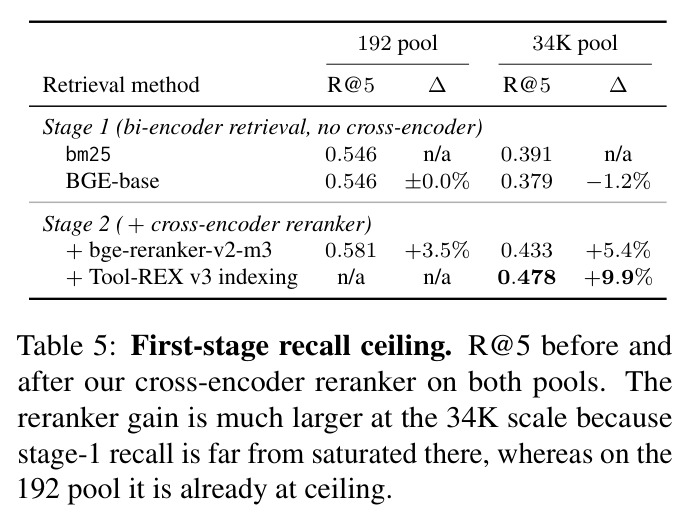
论文用'召回天花板'解释为何轻量重排器在小池够用、大池需要重模型:192 精选池 R@5 已近饱和(0.546),重排只 +3.5%;3.4 万池 R@5 仅 0.391,重排可 +9.9%。
MCP(模型上下文协议)
一个开放协议,让 LLM 智能体以统一方式调用外部工具服务器。任何原生支持 MCP 的宿主环境(Claude Code、OpenHands、Codex CLI 等)无需修改源码即可接入新工具,服务器暴露的工具对智能体表现为可调用的函数。
SkillSeek 以 MCP 服务器形式提供 skill_lookup / skill_load / skill_list 三个只读工具,并用 HTTP 头 X-Skill-Method 切换检索后端,使所有对比条件共享同一工具 schema、可直接 A/B 比较。
Agent Skills / SKILL.md
Anthropic 提出的把可复用程序性知识打包给智能体的机制:每个技能是一个目录,含渐进加载的 SKILL.md 文件——启动时只加载约 30 token 的元数据条目,被判定相关后才载入正文,脚本和资源按需加载。
整个研究的问题背景是:开源技能聚合已膨胀到 23.8 万条目,宿主每个任务只能加载少数技能,'谁来选技能'成为瓶颈——本文证明确定性检索器即可胜任这一角色。
研究动机
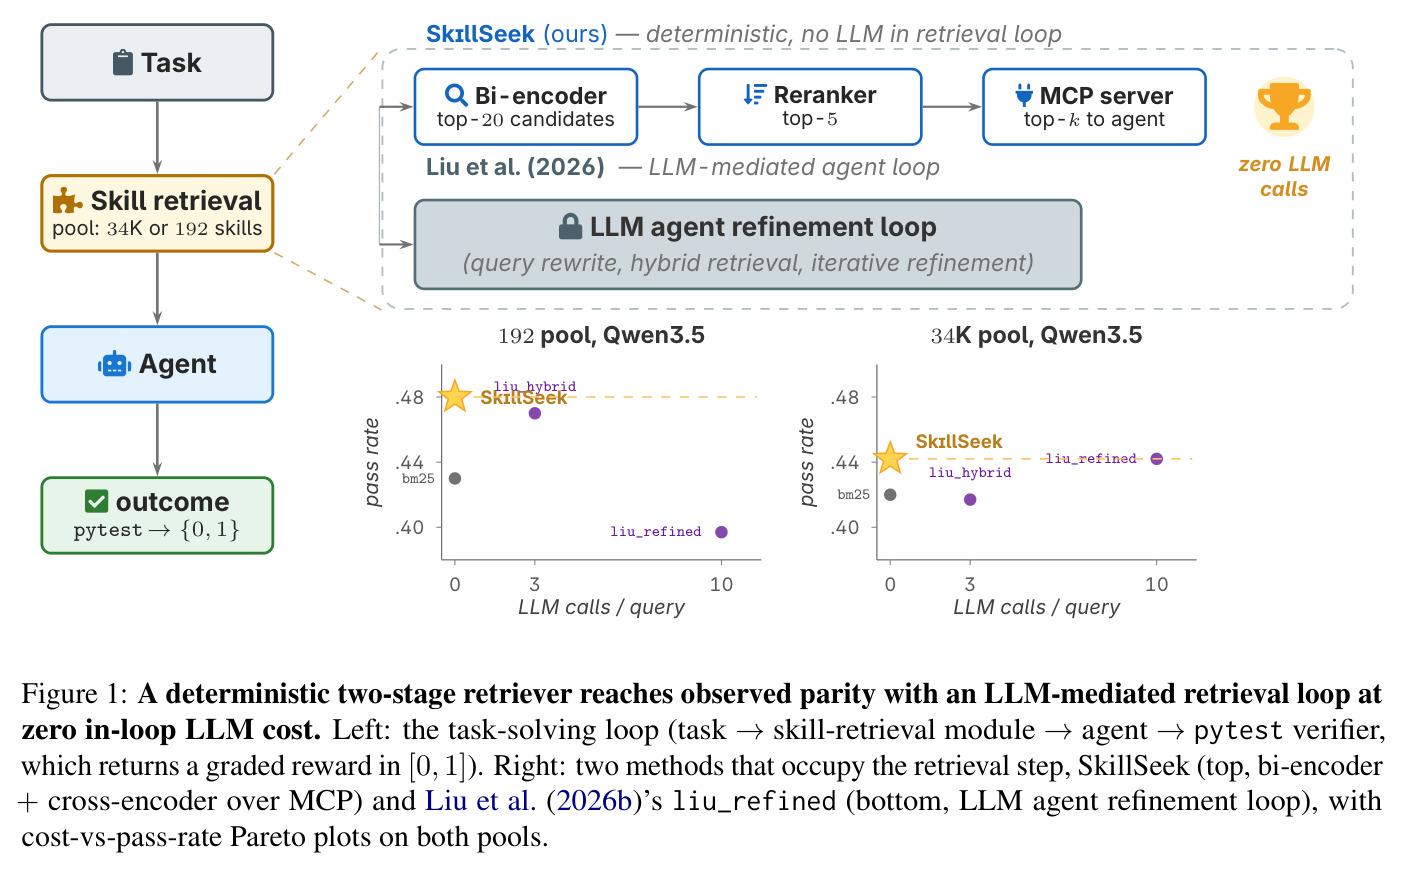
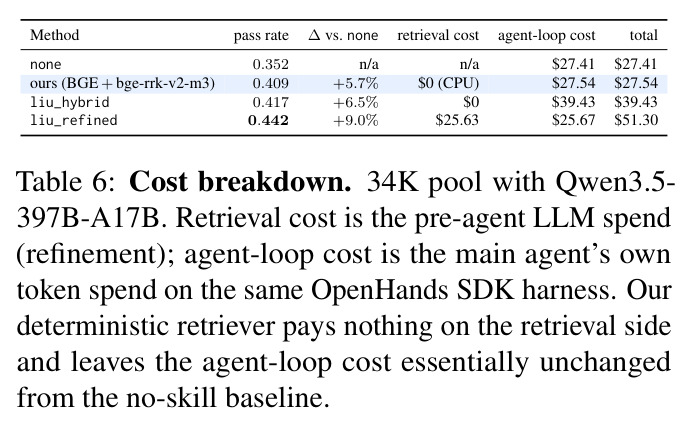
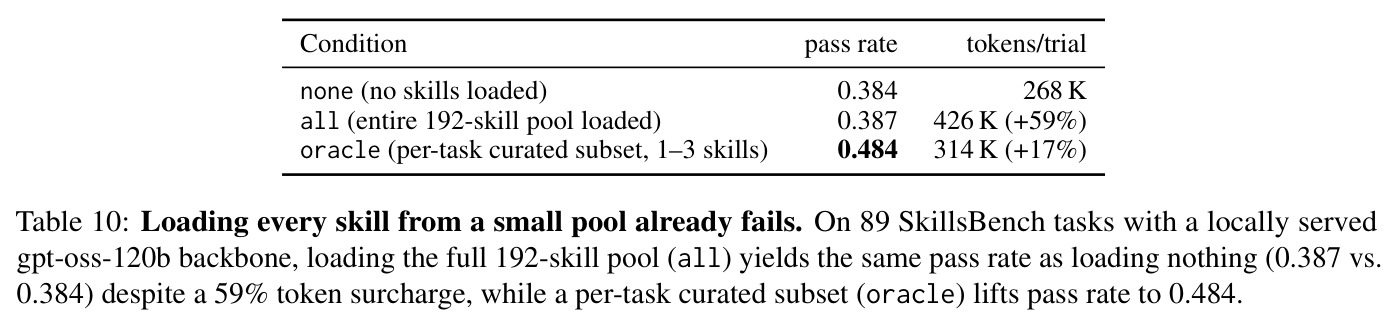
技能选择面临'多则惑'的两难。开源技能聚合已膨胀到 47,150 至 238,180 个条目的规模,把整池塞进上下文不可行:先导实验显示,即便只有 192 个技能,gpt-oss-120b 全量加载后通过率仅 0.387(与不加载的 0.384 持平),token 却暴涨 59%(268K→426K/试);SkillsBench 数据还表明技能加成非单调——1 个相关技能 +17.8%,2-3 个 +18.6%,4 个以上跌回 +5.9%,检索器必须'选得准'而非'召得多'。文献的标准答案是把选择外包给智能体自己的 LLM 循环:Liu 等人让智能体迭代改写查询、探索候选、合成精炼技能,确能完成静态检索器做不到的合成(如把张量并行的权重分片与自定义 autograd.Function 模式合并为新技能),但每个任务都要烧 token——liu_hybrid 使主循环开销膨胀 44%($39.43 vs 基线 $27.41),liu_refined 高达 $51.30/试,接近基线两倍;而在 192 小池上精炼反而把通过率从 0.470 拉低到 0.397。
本文的目标是本文要把'LLM 循环是否必要'当作一个此前被忽略的实证问题来回答:如果把技能选择从智能体的 LLM 决策循环中拿出来,用信息检索领域最标准的免训练配方——双编码器召回加小型交叉编码器精排——能否达到与 LLM 中介循环相当的智能体任务通过率?具体目标有三:(1) 构建并开源 SkillSeek,一个 BGE-base 双编码器接小型重排器、经 MCP 暴露的两阶段检索器;(2) 在 SkillsBench 89 个任务 × {192 精选池, 3.4 万市场池} × {Qwen3.5-397B-A17B, MiniMax-M2.7} 两个 backbone 构成的网格上,与 Liu 等人的 liu_hybrid / liu_refined 在同一 harness、同一任务预算、同一试验数下对齐比较;(3) 不只比精度,还要算清单次试验的 token 花费,并给出机制解释(首阶段召回天花板)说明何时轻量方法够用、何时需要更重的模型。
与已有工作不同的是,本文的独特切入角度有三层。第一,把'LLM 循环是否必要'从设计假设降格为可测量的实证问题:此前叙事强调 LLM 循环能合成'没有任何单一技能能提供'的新技能,本文不否认这种优势存在,而是追问它在实践中多常触发、值多少成本。第二,把成本作为与精度并列的一等公民:同时期的 SkillRouter(Zheng 等人)虽然也研究约 8 万技能规模的路由,但他们微调自己的 1.2B 模型,且只报告路由命中率(Hit@1 74.0%),既不与 LLM 循环对比也不计算 token 成本——而这恰是本文贡献所系的坐标轴。第三,评估方法学上的缺口:本文提出 helpfulness gap 诊断并证明路由命中与任务通过率可以反向移动(召回最高的 Voyage rerank-2.5 唯一 Δ 为负),揭示'检索精度 ≠ 任务收益'这一被普遍忽视的评估陷阱;同时用审慎的'观测到的持平'(observed parity)措辞替代统计等价声明,示范了单试评测下应有的克制。
核心方法
直觉上,技能的索引文本(名称+描述)通常已足够判别'哪个技能与任务相关',这类字面与语义匹配正是经典 IR 的拿手好戏,没必要为此支付 LLM token。技术路线是教科书式的两阶段:第一阶段用 BGE-base 双编码器(1.1 亿参数、768 维向量)对查询与全部技能的索引文本计算余弦相似度,取 top-20;第二阶段用 5.68 亿参数的 bge-reranker-v2-m3 交叉编码器对这 20 个(查询,技能)对联合精排,返回 top-5 给智能体。整个系统以 MCP 服务器形式部署,向智能体暴露 skill_lookup(query, k)、skill_load(name)、skill_list() 三个只读工具,任何支持 MCP 的宿主(Claude Code、OpenHands 等)无需改源码即可接入;服务器端用 X-Skill-Method HTTP 头切换检索后端且不改工具 schema,保证所有实验条件可直接对比。检索推理全部在 CPU 上进行,每次 skill_lookup 中位耗时 1.1 秒(p95 为 1.9 秒),检索侧零 LLM 调用。
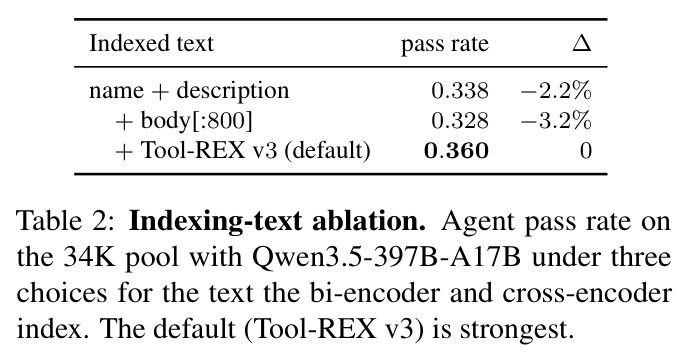
核心创新不是新模型,而是一个被验证的默认配方加两个关键工程细节。其一是 Tool-REX v3 索引扩展:每条技能只索引名称+描述,再由 LLM 离线生成恰好四个有序标签(文件类型、主操作、两个次操作),绝不包含库名。这是踩过两次坑后的第三版:v1 自由标签在 pdf-excel-diff 技能上丢掉 excel/xlsx 字面形式,R@5 从 1.0 跌到 0.5;v2 加入库名标签后,Python 库名劫持交叉编码器,court-form-filling 在 3.4 万池上 R@5 从 1.0 跌到 0.0。SKILL.md 正文不进索引——消融显示追加正文反而使通过率再降 3.2%,正文实现细节稀释了名称+描述的判别信号。其二是与 Liu 等人的本质区别:检索决策完全确定性、检索循环内零 LLM 调用。LLM 循环每次任务都要为查询改写和候选探索付费,而 SkillSeek 的索引一次构建、永久复用——3.4 万技能池的 Tool-REX v3 扩展总共不到 2 GPU 小时,之后每次检索只是 CPU 上的两次模型前向。
方法步骤详情
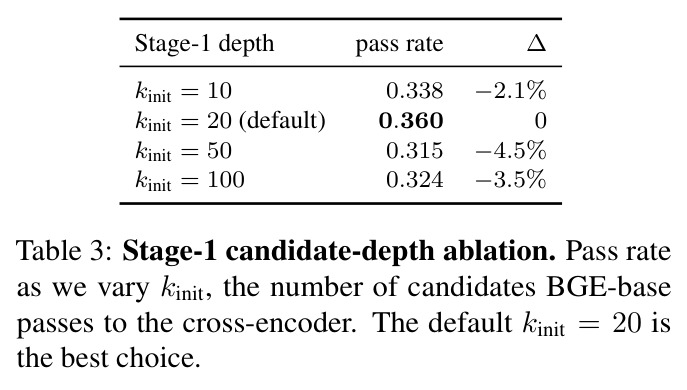
第一步(离线索引):对池中每个技能,用本地 vLLM 部署的 gpt-oss-120b 按固定提示生成四标签 Tool-REX v3 档案(形如 pdf-excel-diff 附标签 pdf, compare, excel, xlsx),与名称+描述拼接建索引;3.4 万池一次性构建约 2 GPU 小时。第二步(召回):智能体经 MCP 提交自然语言查询,BGE-base 对全池打余弦分,输出 top-20($k_{init}=20$)。第三步(精排):bge-reranker-v2-m3 对 20 个候选逐对联合编码打分,返回 top-5 为 name: description 行。第四步(智能体消费):系统提示与首条用户消息双重注入'必须先 skill_lookup(5-15 词查询)再 skill_load',把工具调用率从 40-60% 提到 95.5%;智能体约 65% 的任务直接采用 rank-1。第五步(评测):OpenHands 驱动,每试封顶 30 轮、600 秒,确定性 pytest 验证器给出 $[0,1]$ 分级奖励,89 任务平均即通过率,缺失试验计 0 分。
技术新颖性
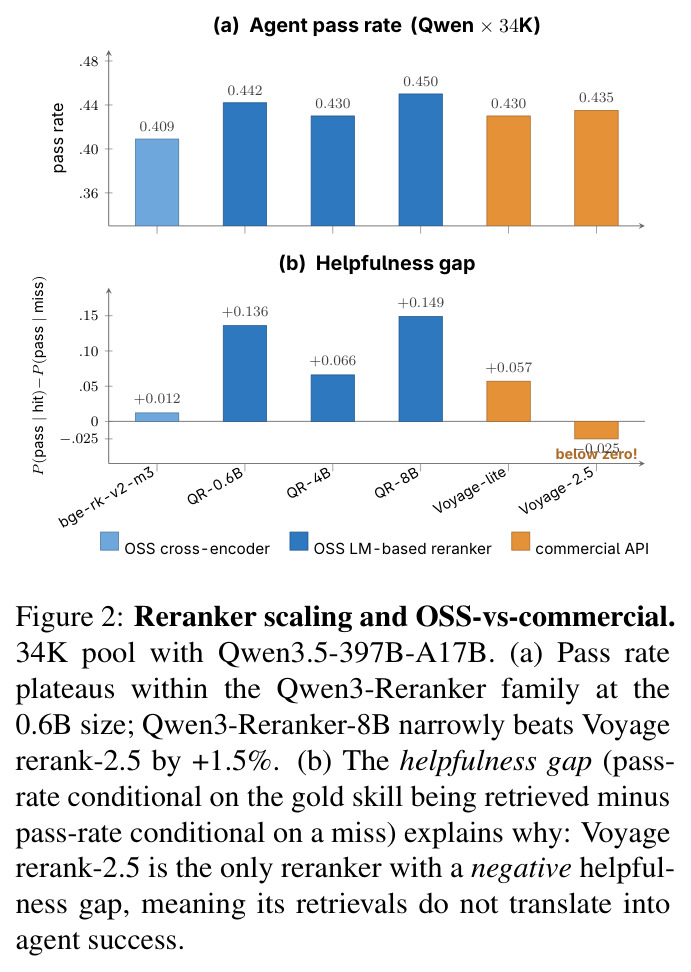
新颖性体现在四个层面。(1) 问题重构:把'技能检索'从'智能体能力问题'还原为'标准 IR 问题',证明免训练现成配方即可追平 LLM 循环——与同期 SkillRouter 需微调 1.2B 专用模型形成对照。(2) 机制解释:提出'首阶段召回天花板'——重排器收益与未饱和召回成正比:192 池 R@5=0.546 近饱和时重排仅 +3.5%,34K 池 R@5=0.391 时重排 +5.4%、加 Tool-REX 达 +9.9%,与 monoT5 跨域收益更大的经典发现一致。(3) 新诊断指标 helpfulness gap:$\Delta_m = \mathbb{E}_{t\in G_m}[\mathrm{pass}_t] - \mathbb{E}_{t\in \bar{G}_m}[\mathrm{pass}_t]$,发现召回最高的 Voyage rerank-2.5(72.2%)$\Delta=-0.025$ 唯一为负——检索到的'金标'反而伤害智能体,路由精度与任务收益可以反向移动。(4) 成本记账:首次分开计量检索侧与智能体侧花费,揭示'精度持平、成本减半'。
实验结果
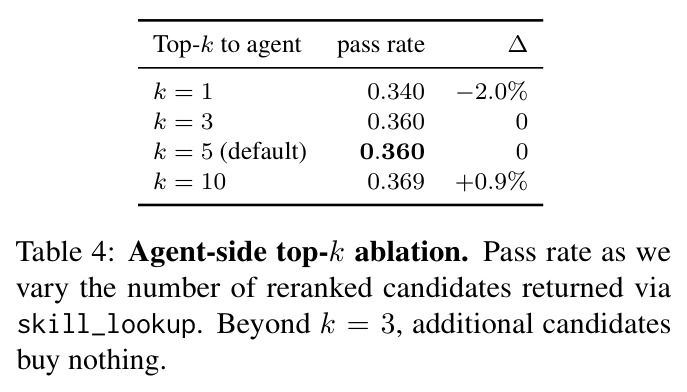
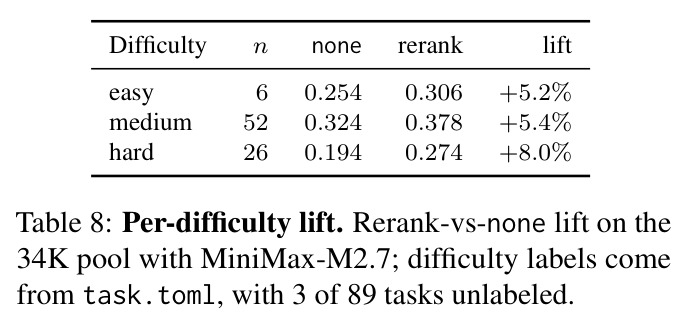
主网格(无技能基线 0.352/0.267):纯 BM25 在四个设置中的三个不低于 liu_refined(192/Qwen3.5 0.430 vs 0.397、192/MiniMax 0.387 vs 0.344 等),仅 34K/Qwen3.5 落后且由 Qwen3-Reranker-0.6B 以 0.442 补齐;192 池上最佳达 0.480,超 liu_hybrid 0.470 与 liu_refined 0.397。成本(34K/Qwen3.5):单试总花费 ours $27.54(检索侧 $0)vs liu_hybrid $39.43、liu_refined $51.30。消融:Tool-REX v3 索引最强(name+desc −2.2%,加正文再 −3.2%)、$k_{init}=20$ 最优、top-k=3 起饱和。机制:192 池 R@5=0.546 近饱和、重排仅 +3.5%;34K 池 0.391、重排 +5.4%、加 Tool-REX 达 +9.9%。缩放:0.6B→0.442、8B→0.450,13 倍参数仅 +0.7%。困难任务收益最大(+8.0%,0.194→0.274);最大损失是近义孪生选错。先导实验:全量加载 0.387≈不加载 0.384,token +59%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SkillsBench 89 任务,34K 市场池 + Qwen3.5-397B-A17B(头条设置) | 智能体通过率 / 单试总成本 | SkillSeek(Qwen3-Reranker-0.6B)0.442,$27.54,检索侧零 LLM 调用 | liu_refined(LLM 精炼循环)0.442,$51.30 | 精度持平,单试成本下降 46%(省 $23.76),且避免任何循环内 LLM 调用 |
| SkillsBench 89 任务,192 精选池 + Qwen3.5-397B-A17B | 智能体通过率 | bge-reranker-v2-m3 达 0.480 | 无技能 0.352;liu_hybrid 0.470;liu_refined 0.397 | 较无技能 +12.8 个百分点;超最强 LLM 基线 liu_hybrid +1.0 个百分点、超 liu_refined +8.3 个百分点 |
| SkillsBench 89 任务,34K 池 + Qwen3.5-397B-A17B | 智能体通过率(相对无技能基线) | 0.409(bge-reranker-v2-m3) | 无技能 0.352 | +5.7 个百分点,检索全程 CPU 运行,智能体侧花费与无技能基线相差不足 0.5 美元 |
| 首阶段召回质量,34K 池 | R@5(金标技能进入前 5 候选的比例) | 0.478(BGE-base + 交叉编码器重排 + Tool-REX v3 索引) | BM25 0.391 / BGE-base 0.379 | 重排 +5.4 个百分点,叠加 Tool-REX v3 索引共 +9.9 个百分点 |
| 全量加载 vs 检索选择(89 任务,gpt-oss-120b,3 试/任务) | 通过率 / 每试 token | oracle 每任务精选 1-3 技能:0.484 / 314K tokens | 全量加载 192 技能:0.387 / 426K tokens(+59%) | +9.7 个百分点且省 26% token,证明'选择'不可被'堆上下文'替代 |
| 重排器缩放与开源 vs 商用(34K 池 + Qwen3.5) | 智能体通过率 | Qwen3-Reranker-8B 0.450(开源 0.6B 已达 0.442) | Voyage rerank-2.5(商用 API)0.435 | +1.5 个百分点(13 胜 67 平 9 负);0.6B→8B 参数涨 13 倍仅 +0.7 个百分点,收益平台化 |
局限与改进
作者坦承:(1) 每格只跑一次单试,重跑标差约 1%,<2% 差异视为噪声,故只主张'观测到的持平'而非统计等价;(2) 缺失试验(网络错误/超时)计 0 分,压低所有方法绝对值;(3) MiniMax-M2.7 有 48-57/89 任务遭遇网络错误,绝对值被拉低 5-10%,只作辅助证据;(4) 192 精选池经人工策展(每任务保证有相关技能),小池数字混入策展偏差;(5) 首阶段替代方案只按 R@5 比较,而 R@5 高不等于通过率高;(6) 结论限于 OpenHands + 两个 backbone + 两个池。我的观察:liu_refined 是保守重实现(探索上限 10 条命令、精炼产出 1-3 技能、砍掉 skill-creator),作者承认忠实版会抬高其分数,34K/Qwen3.5 的持平可能是对 SkillSeek 偏乐观的读法;192/Qwen3.5 上精炼方向与原文献相反(本文 −7.3% vs 原文 +4.1%,另有 Kimi K2.5 的 −6.8% 旁证),复现缺口削弱部分跨池叙事;单试协议对重 rollout 评测本质上方差偏高。
独立分析的弱点
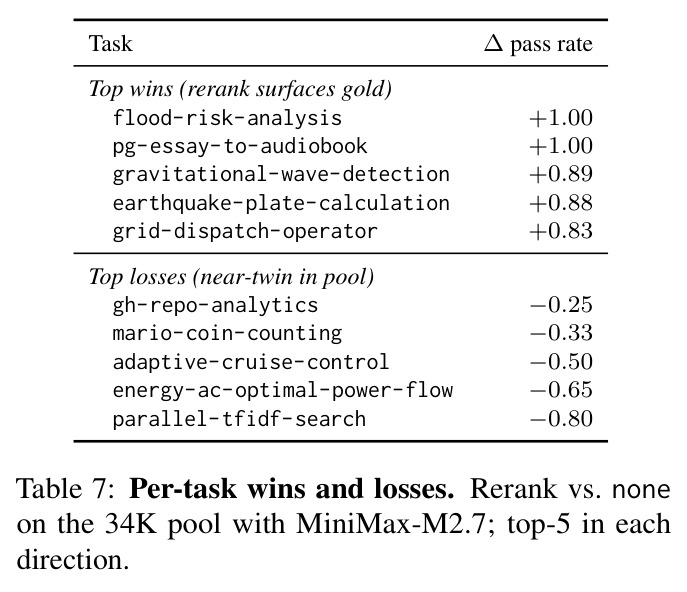
独立分析有五个弱点。(1) 单试验评测:0.442 vs 0.442 的持平在重复 rollout 下可能翻转,应对头条设置做 3-5 次独立重复加配对检验。(2) 检索指标与端到端收益脱节:文章自证 R@5 与通过率可反向(Voyage 召回 72.2% 却 Δ=−0.025),却没有把首阶段质量映射到任务收益的手段,可学习代理模型或直接以小样本任务收益做方法选择。(3) 近义孪生失败:描述相近的非金标技能被过度提升(parallel-tfidf-search −0.80、energy-ac-optimal-power-flow −0.65),因交叉编码器只有文本相关性、缺验证器感知信号;可在精排分中融入可执行性信号,或允许智能体低代价试载多候选。(4) 恶意技能风险全盘继承:检索器不审计不沙箱,投毒技能可与正常技能同池竞排并进入执行循环(已有攻击成功率 16-64%、94% 逃逸扫描器);可与预加载风险打分器(0.800 F1、每技能 0.6 美分)串联。(5) 依赖双重提示注入才达 95.5% 工具调用率,换 harness 或更强模型后检索器可能被绕过。
未来方向
作者提出的方向:(1) 重复独立 rollout 建立更强的等价性;(2) 让强首阶段方案跑过同一交叉编码器与智能体循环,厘清 R@5 与通过率的关系;(3) 迁移到 SkillRet(16,129 技能 × 4,392 查询)等独立基准和其他领域智能体;(4) 与预加载风险打分器组合成风险感知检索。可延伸的方向:(5) 把召回天花板变成预测定律——先测池子 R@5 再决定是否上重排器/LLM 循环,做成自动方法选择器;(6) 在索引文本注入可执行性或验证器感知特征,攻克近义孪生失败;(7) 与技能压缩(token 省 48%/39%)、技能编译为代码(+15.3%)、多目标技能优化正交组合;(8) 为 LLM 循环的合成优势建模触发条件——何时值得为 +4.5 个百分点付 87% 成本溢价,可做成按需升级的自适应检索策略。
复现评估
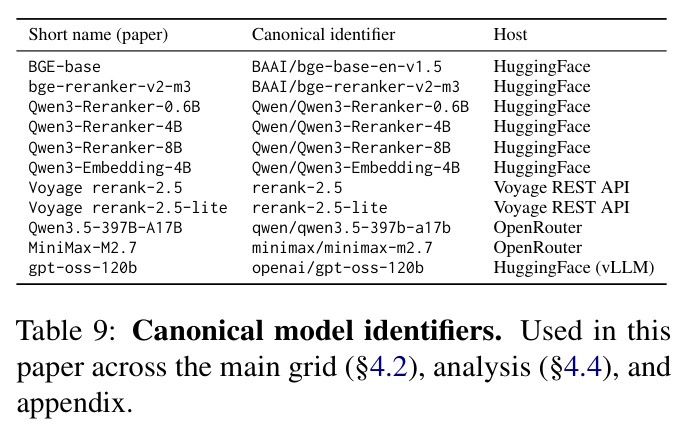
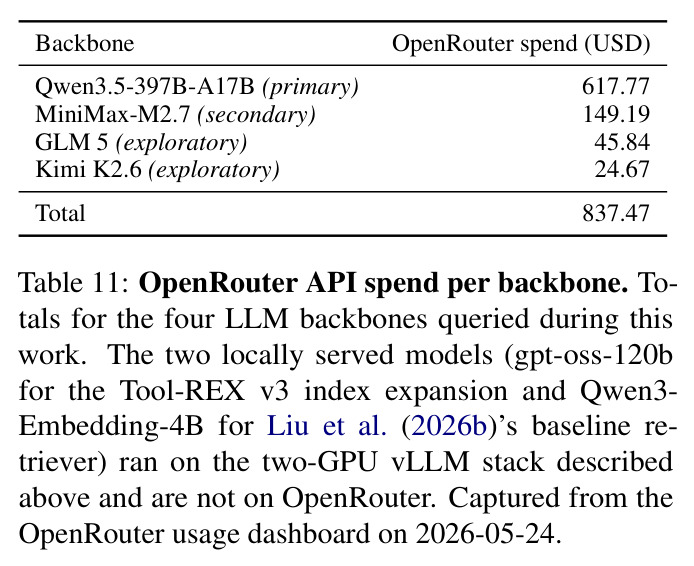
复现条件良好。代码全开源(github.com/guanqun-yang/SkillSeek),含复现每个数字的脚本;SkillsBench(Apache-2.0,89 任务+192 技能)与 3.4 万市场池均公开(后者无 license 文件,作者如实披露),仅作评测、无训练泄漏。模型全可获取:BGE 系列、Qwen3-Reranker 0.6B/4B/8B、Qwen3-Embedding-4B 走 HuggingFace,backbone 走 OpenRouter,商用重排器走 Voyage API。算力门槛低:两张 RTX 6000 跑 vLLM 即可,索引扩展不到 2 GPU 小时且每池一次,检索在 CPU 上中位 1.1 秒/次;全部 OpenRouter 花费 $837.47,Voyage 用 2 亿免费 token 额度即够。注意:单试协议有 ±1-2% 噪声,MiniMax 通道约 50-64% 错误率会压低绝对值,liu 基线是保守重实现(附录 D 列明偏差方向)。总体难度中等偏低,瓶颈在 API 费用而非算力。
论文图表
展示一条技能的实际索引文本格式:第一行技能名 pdf-excel-diff;随后是描述(对比 PDF 文档与 Excel 表格、标出数值有差异的单元格);最后一行是 Tool-REX v3 生成的四个标签:pdf, compare, excel, xlsx。
具象化全文最重要的单一工程细节:四个标签恰好恢复了交叉编码器需要的字面表面形式(excel/xlsx)——v1 自由标签版本因丢掉这些词使该任务 R@5 从 1.0 跌到 0.5。索引消融显示 Tool-REX v3 比 name+description 基线高 2.2 个百分点,是'索引文本主导设计空间'结论的实物证据。