超越检索:面向流式视频理解的渐进式潜在记忆演化 Beyond Retrieval: Progressive Latent Memory Evolution for Streaming Video Understanding
把检索到的历史证据内化为可演化的紧凑潜在记忆,指导流式视频推理
前置知识
流式视频理解
要求多模态大模型以严格因果方式处理持续到达的视频帧,并在任意时刻响应用户查询,同时受有限显存和上下文预算约束。与离线视频理解不同,它不能提前看到整段视频,只能维护一个有界的历史记忆来支撑实时问答。
本文的全部设计都围绕这一约束展开:如何在固定内存预算下保留有用历史、在查询到来时快速作答,是理解论文动机的前提。
潜在记忆令牌(LMT)
一组可优化的连续嵌入向量(本文每组 $K=2$ 个、维度等于 MLLM 隐层维度 $D$),以软提示形式插入冻结模型的输入序列。它们不对应任何真实视觉内容,而是通过迭代检索与梯度更新,把任务相关的历史证据吸收进模型潜空间。
LMT 是本文方法的核心载体,检索、内化、优化全部发生在这些 token 的嵌入上,理解它们才能看懂 retrieve-and-internalize 机制。
REINFORCE 策略梯度
一种无梯度的策略梯度方法:对连续状态 $U$ 施加高斯扰动 $U'=U+\xi,\ \xi\sim\mathcal{N}(0,\sigma^2 I)$ 构成探索策略,用奖励 $R(U')$ 加权扰动方向估计梯度 $\nabla_U J=\mathbb{E}[R(U')\xi/\sigma^2]$,从而对不可微的奖励信号做测试时优化。
本文用 REINFORCE 依据置信度进度奖励更新 LMT 嵌入,因为奖励基于模型预测熵,无法直接反向传播,必须借这类估计梯度的方法。
预测熵
模型在某个位置输出词表分布的不确定性度量。本文使用归一化 top-$\delta$ 熵:$E_g(U)=-\frac{1}{\log\delta}\sum_{j\in\Omega_g}\bar{p}_{g,j}\log\bar{p}_{g,j}$,只统计概率最高的 $\delta$ 个 token 并归一化,熵越低代表模型对该位置的预测越自信。
熵是本文构造奖励信号的原料——无需任何标注,仅凭模型自身置信度的升降即可判断内化后的记忆是否更有用。
Jenks Natural Breaks
一种数据驱动的聚类分段方法,通过最小化组内方差、最大化组间方差,自动在数值分布中找自然断点。本文对时间重要性分数做三类 Jenks 分割得到 Drop/Compress/Preserve 两个阈值 $(\tau_1,\tau_2)$,对空间距离分布做两类分割决定 token 合并与否。
分层记忆的构建完全依赖 Jenks 分割,它决定了哪些历史帧被丢弃、压缩或保留,直接影响后续检索的证据池质量。
OVO-Bench 与 StreamingBench
两个流式视频评测基准:OVO-Bench 考察时间戳感知的实时感知(OCR/ACR/ATR 等六项)与回溯检索(EPM/ASI/HLD);StreamingBench 考察连续视频流上的实时视觉理解。两者都要求模型在严格因果设定下边看边答。
论文的核心数字(OVO-Bench 64.2%、StreamingBench 76.9%)都来自这两个基准,知道它们测什么才能正确解读实验结论。
研究动机
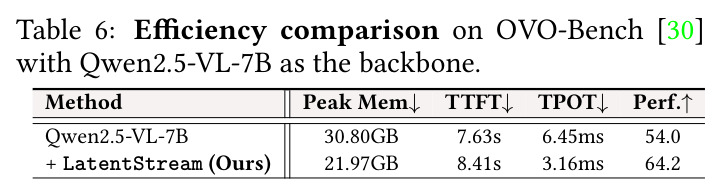
现有流式视频理解方法普遍采用 store-and-retrieve 范式:把持续到达的视觉观测压缩进外部记忆库(如 FluxMem 的分层记忆),查询到来时再检索与问题相关的历史证据,作为额外的变长视觉上下文拼进模型输入。这个范式有两个具体痛点。其一,检索到的证据始终是外部的、变长的上下文,占满上下文窗口并推高显存和解码开销——作为基线的 Qwen2.5-VL-7B 在 OVO-Bench 上总体仅 54.0%,峰值显存高达 30.80GB,每 token 解码延迟(TPOT)6.45ms。其二,查询无关的记忆管理与查询条件的推理过程松耦合:记忆库只解决『该访问哪些证据』,而访问到的证据如何被模型吸收利用完全没有被探索,历史信息无法内化为一个紧凑的、随推理持续演化的潜在状态。消融显示,即便直接把检索证据拼进上下文(OASIS/QueryStream 的做法),OVO-Bench 也只到 60.0%,说明外挂式证据利用已接近瓶颈。
本文的目标是本文的目标是回答一个核心问题:如何把外部流式记忆中的历史证据自适应地内化为一个紧凑的、查询条件的、持续演化的潜在记忆,用于流式视频推理。具体而言,要在完全不修改 Video-LLM 参数(冻结骨干)的前提下,构造一组固定长度的潜在记忆令牌(LMT),使其在查询到来后反复从分层记忆库检索任务相关证据、把证据吸收进自身嵌入,并用内化后的潜在记忆而非变长的外部上下文来引导最终作答;同时希望这个过程顺带压缩上下文,带来显存与解码效率收益,并在在线(OVO-Bench、StreamingBench)与离线(VideoMME、MLVU、LongVideoBench)五类基准上超越现有 training-free 方法。
与已有工作不同的是,本文的独特切入点是把流式记忆从 store-and-retrieve 推向 retrieve-and-internalize:主张模型自身的潜空间是连接外部记忆与推理的天然基底。与此前工作的本质差异有三点。第一,检索不再服务于『拼上下文』,而是服务于『喂给潜在记忆演化』——检索到的证据被注入候选前向计算中,经奖励信号转化为 LMT 嵌入的更新,随后在解码前被彻底移除。第二,潜在记忆是查询条件的且持续演化的:每轮内化后重新计算相关性,引导下一轮检索,形成检索-更新交替的闭环。第三,监督信号完全来自模型内部——用分层预测熵构造进度奖励做测试时优化,不需要任何标注或骨干参数更新。这填补了『查询无关记忆』与『查询条件推理』之间缺乏紧凑可演化工作记忆的空白。
核心方法
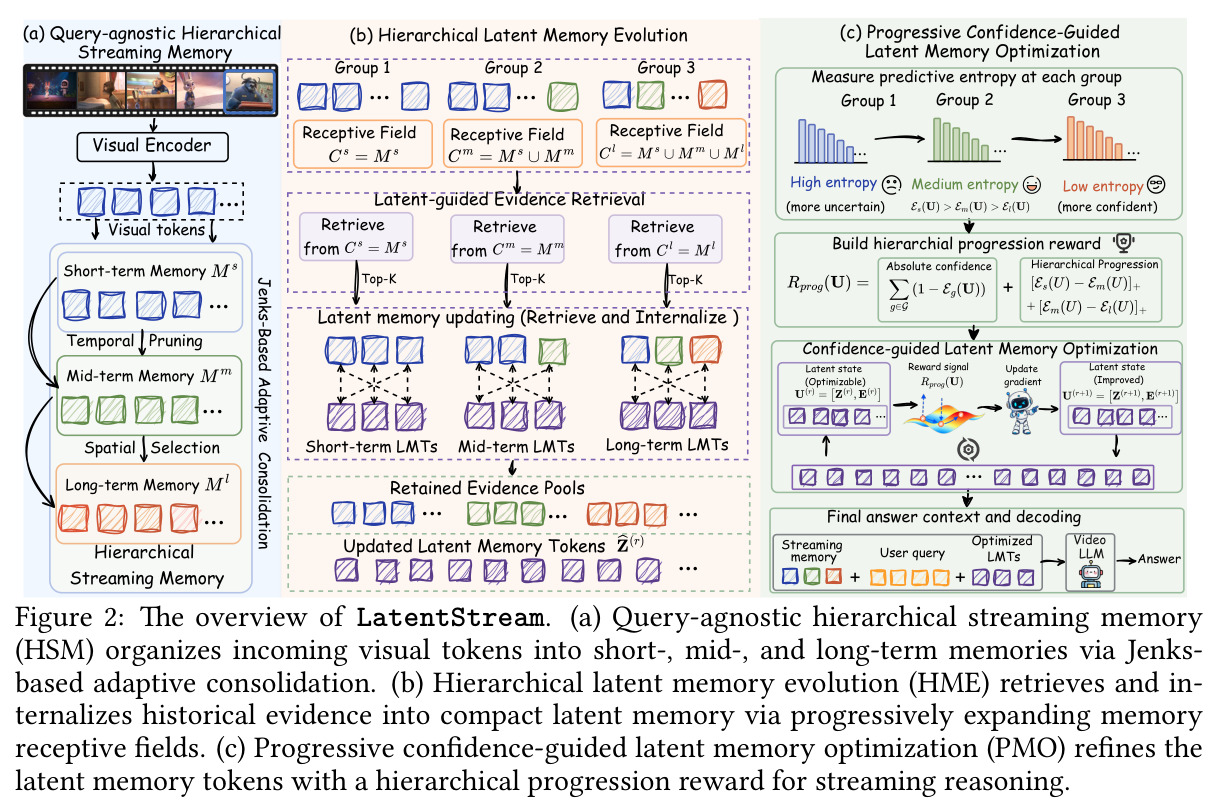
直觉上,LatentStream 想让模型『看完就记住要点』,而非答题时翻录像带。技术上由三个协调组件构成。其一,查询无关分层流式记忆(HSM):新帧密存短期记忆(8 帧),溢出后经 Jenks 三类分割路由到中期(64 帧),更早证据经空间合并压缩进长期,全局预算 2048 个视觉 token,查询前在线完成。其二,分层潜在记忆演化(HME):LMT 分三组,接受域嵌套递增 $C_s=M_s$、$C_m=M_s\cup M_m$、$C_l=M_s\cup M_m\cup M_l$;每轮各组从自己的接受域检索 Top-$B=8$ 个证据块,注入冻结 MLLM 前向计算。其三,渐进置信引导优化(PMO):用各组的归一化 top-$\delta$ 熵构造进度奖励 $R_{prog}$,以 REINFORCE 同时更新 LMT 嵌入与检索证据嵌入副本($\eta=10^{-3}$,$\sigma=10\%$,$R=4$ 轮),最终答案仅由 $[M; q; \tilde{Z}^{(R)}]$ 解码生成。
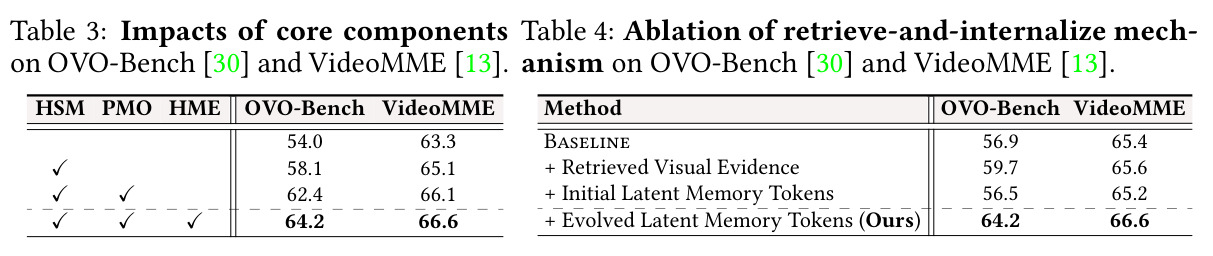
核心创新是『内化而非附加』:历史证据不再是拼在输入里的变长外部上下文,而是被压缩进固定长度的潜在记忆 token,在解码前检索证据被全部移除。这与已有方法的本质区别体现在三点。第一,OASIS、QueryStream 等检索式方法把证据当辅助上下文,消融显示这只带来 56.9→59.7 的提升;而演化后的 LMT 在同样移除检索 token 的条件下达到 64.2,证明信息确实被写入了潜状态而非依赖上下文堆叠。第二,潜在记忆与检索形成迭代 interplay:LMT 每次更新后重新计算与候选证据的最大余弦相似度 $a^{(r)}_{g,j}=\max_k \cos(m_j, \tilde{Z}^{(r-1)}_g)$,使『已内化了什么』反过来决定『接下来检索什么』,而传统方法是一次性静态检索。第三,监督来自模型自身的置信度结构:奖励同时要求绝对自信(各组 $1-E_g$ 之和)与层级递进($[E_s-E_m]^+ + [E_m-E_l]^+$,即接受域越宽应越自信),这是全新的测试时自监督信号设计。
方法步骤详情
第一步(查询前构建记忆):视觉编码器逐帧产出 token 密存短期记忆 $M_s$;溢出时对时间重要性分数 $\mathcal{S}_{temp}$(由相邻帧空间邻居的局部余弦距离变化估计)做三类 Jenks 分割得阈值 $(\tau_1,\tau_2)$,低于 $\tau_1$ 丢弃、居中时间压缩、高于 $\tau_2$ 保留;中期证据再对空间距离 $d_{ij}=1-\cos(v_i,v_j)$ 做两类 Jenks 分割,冗余 token 合并进长期记忆 $M_l$。第二步(初始化):查询到达时做 bootstrap 前向,让查询 $q$ 与固定外部记忆在组特定注意力掩码下语境化初始 LMT 嵌入,得到查询条件的 $\tilde{Z}^{(0)}$。第三步(迭代演化 $r=1..4$):各组从 $\mathcal{C}_g$ 检索 Top-$B=8$ 证据 $\mathcal{E}^{(r)}_g$,生成可优化副本插到对应 LMT 组之后构成候选状态 $U^{(r,0)}$;计算各组证据感知熵 $E_s,E_m,E_l$ 与进度奖励;高斯扰动 + REINFORCE 更新;候选奖励提升时才把新证据去重合并进保留池,否则丢弃。第四步(解码):移除全部注入证据副本,用 $[M; q; \tilde{Z}^{(R)}]$ 自回归生成最终答案。
技术新颖性
技术新颖性体现在四个层面。其一,范式层面:首次提出 retrieve-and-internalize,把流式记忆从『外部证据管理』转为『潜在工作记忆演化』,属范式级贡献而非组件改良。其二,结构层面:分组 LMT 配嵌套递增的接受域($\mathcal{C}_s\subset\mathcal{C}_m\subset\mathcal{C}_l$),既让远期证据可及又不丢近期细节,且与外部三层记忆一一对应,这种『外部记忆层级=内部记忆分组』的对齐设计是新的。其三,优化层面:奖励门控式证据累积(式 5)只保留能提升候选奖励的证据,避免无关证据污染记忆池;高斯扰动 + REINFORCE 让基于熵的不可微奖励得以反传到嵌入层面,全程冻结骨干。其四,效率层面:内化天然压缩上下文,使峰值显存从 30.80GB 降到 21.97GB、TPOT 从 6.45ms 降到 3.16ms(降 51%),即准确率与效率同升,而非以往方法常见的以算力换精度。消融表 4 中『未优化 LMT 仅 56.5』也证明提升来自演化机制本身而非 latent token 的正则效应。
实验结果
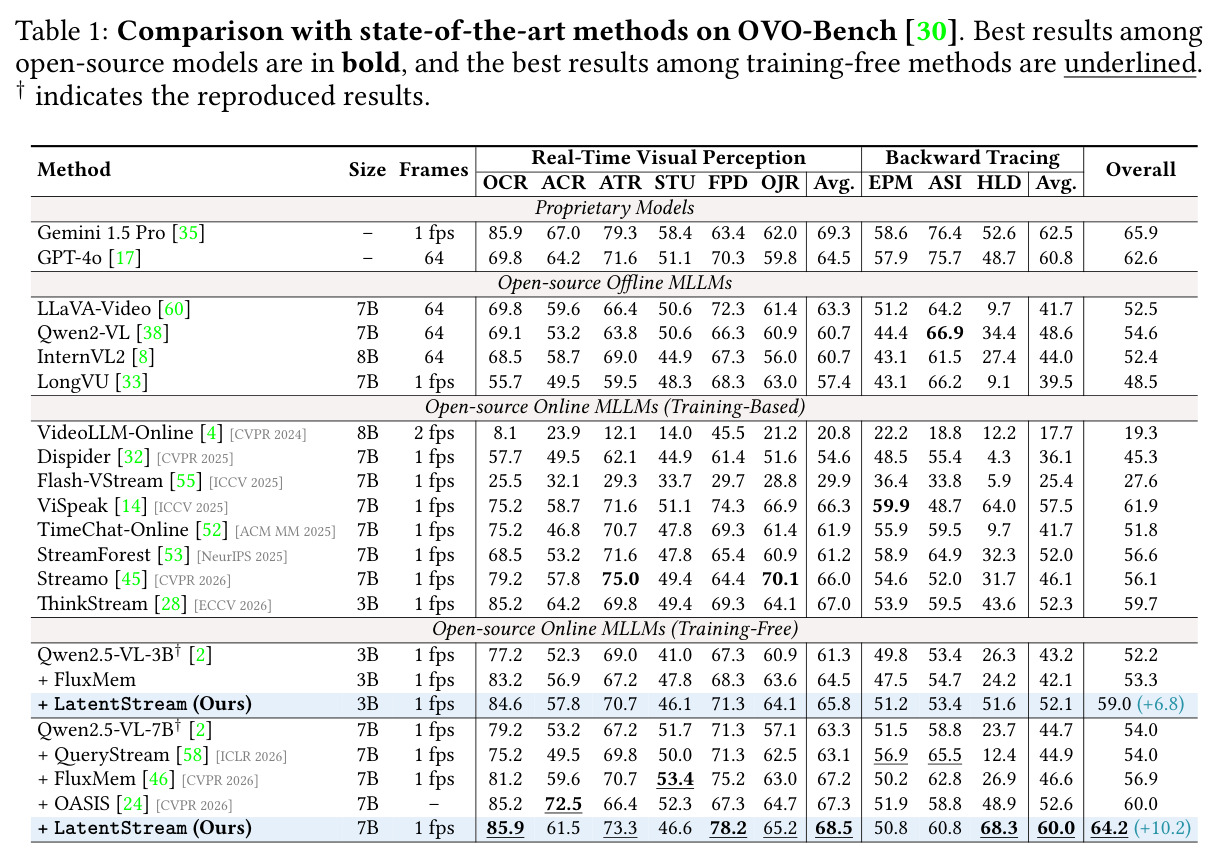
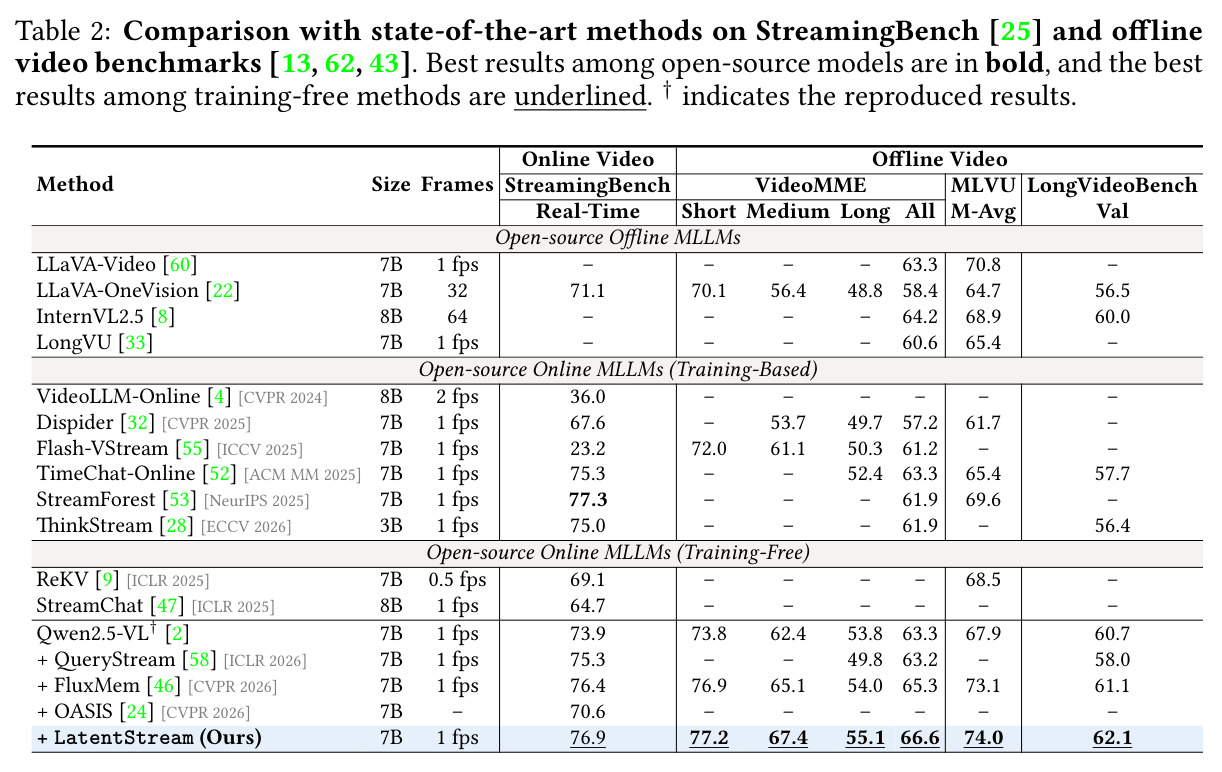
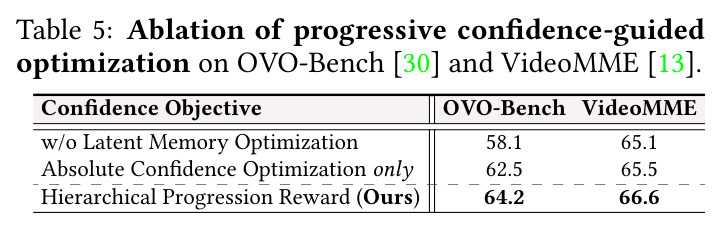
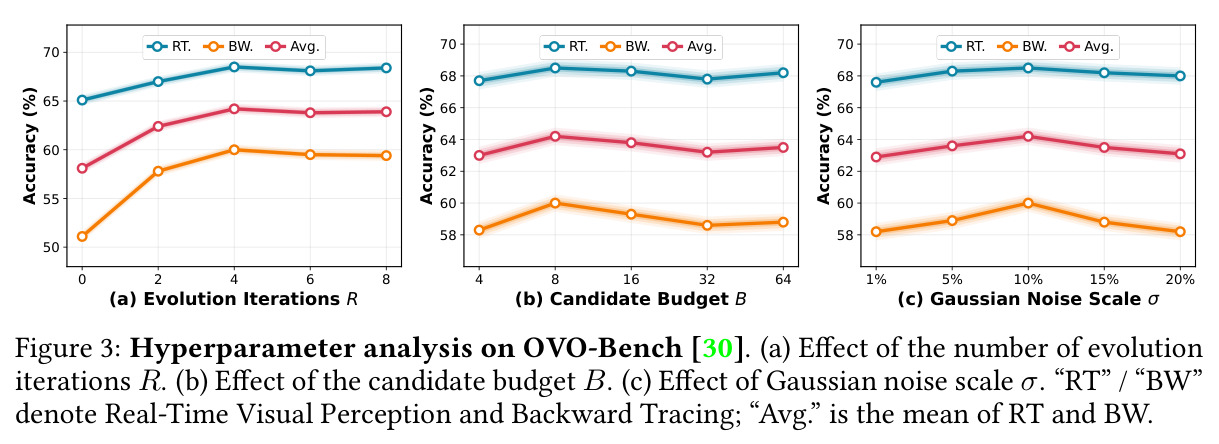
流式基准上,Qwen2.5-VL-7B 版 LatentStream 在 OVO-Bench 达 64.2%(基线 54.0%,+10.2):实时感知 63.3→68.5,回溯追踪 44.7→60.0,为开源最佳;3B 版 52.2→59.0(+6.8)。StreamingBench 达 76.9%(+3.0),超过 QueryStream 75.3、FluxMem 76.4 等全部免训练对手。离线基准上 VideoMME 66.6%(+3.3,短/中/长视频 77.2/67.4/55.1 全面提升)、MLVU 74.0%(+6.1)、LongVideoBench 62.1%(+1.4),并超过 Dispider、StreamForest 等训练类方法。组件消融(表 3):仅 HSM 58.1/65.1,加 PMO 62.4/66.1,全模型 64.2/66.6。内化机制消融(表 4):直接拼检索证据 59.7/65.6,未优化 LMT 仅 56.5/65.2,演化 LMT 64.2/66.6——且解码前检索 token 已移除,证实内化而非上下文效应。奖励消融(表 5):无优化 58.1/65.1,仅绝对置信 62.5/65.5,层级进度奖励 64.2/66.6。超参(图 3):$R$ 0→4 使均值 58.1→64.2 后饱和;$B$ 4→8 达峰 64.2 后退化;$\sigma=10\%$ 最佳。效率(表 6):峰值显存 30.80→21.97GB,TPOT 6.45→3.16ms(-51%),代价是 TTFT 7.63→8.41s。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式视频理解(OVO-Bench 总体) | 总体准确率 (%) | 64.2(7B)/ 59.0(3B) | Qwen2.5-VL-7B 复现基线 54.0;最强对比 OASIS 60.0 | +10.2(对基线);3B +6.8 |
| 流式回溯追踪(OVO-Bench Backward Tracing) | 平均准确率 (%) | 60.0(HLD 高达 68.3) | Qwen2.5-VL-7B 44.7;FluxMem 46.6 | +15.3(对基线) |
| 流式实时理解 | Real-Time 准确率 (%) | 76.9 | Qwen2.5-VL-7B 73.9;FluxMem 76.4 | +3.0(对基线) |
| 离线长视频问答 | VideoMME All (%) | 66.6 | Qwen2.5-VL-7B 63.3;FluxMem 65.3 | +3.3 |
| 离线长视频多任务 | MLVU M-Avg (%) | 74.0 | Qwen2.5-VL-7B 67.9;FluxMem 73.1 | +6.1 |
| 离线长视频理解 | LongVideoBench Val (%) | 62.1 | Qwen2.5-VL-7B 60.7;FluxMem 61.1 | +1.4 |
| 推理效率(OVO-Bench,7B 骨干) | 峰值显存 / TPOT / TTFT | 21.97GB / 3.16ms / 8.41s | Qwen2.5-VL-7B:30.80GB / 6.45ms / 7.63s | 显存 -28.7%,TPOT -51%;TTFT 增加 0.78s |
局限与改进
作者承认的局限:PMO 的测试时优化带来额外前向-反向开销,TTFT 从 7.63s 增至 8.41s,对强实时交互场景不友好;迭代数 $R>4$ 后收益消失且出现小幅波动,说明优化动态尚不稳定;候选预算 $B$ 超过 8 反而退化,反映证据池易被冗余污染。我自己的观察:其一,仅在 Qwen2.5-VL 3B/7B 两个骨干上验证,未证明对其他 MLLM 家族(如 InternVL、LLaVA)的普适性;其二,每组仅 $K=2$ 个 LMT,对多对象、多事件的长查询内化容量可能不足,且潜在记忆不可解释,无法审计到底内化了哪些信息,存在错误内化不可发现的风险;其三,Jenks 分割依赖启发式时间重要性分数(局部余弦距离变化),对场景切换缓慢、语义密度均匀的视频可能路由失准;其四,表中部分对比方法(FluxMem、OASIS、QueryStream 标注为 CVPR/ICLR 2026)结果疑为复现或自报,公平性需要第三方验证;其五,未评测主动响应类任务(何时开口回答),而这是流式场景的另一半核心问题。
独立分析的弱点
弱点一:测试时优化延迟。TTFT 增加 0.78s(7.63→8.41s),每轮迭代需完整前向-反向;改进方向是把演化蒸馏为单次前向的 amortized 推理头,或对相似查询缓存演化后的 LMT。弱点二:容量固定且极小。每组 $K=2$、每轮 $B=8$ 在简单基准够用,但面对一小时多事件直播,6 个 LMT 可能成信息瓶颈;可按查询复杂度自适应分配 $K$。弱点三:熵降低不必然等于内化正确——模型可能对错误答案也自信,进度奖励缺少正确性锚点;可加入答案一致性或与零样本预测的 KL 正则制衡。弱点四:Jenks 路由仅依赖启发式时间重要性分数(局部余弦距离变化),对 OCR 密集或静态镜头可能误丢关键帧;可引入 CLIP 语义显著性做混合评分。弱点五:离线增益(LongVideoBench 仅 +1.4)明显小于流式增益(OVO +10.2),价值集中在因果约束强的场景;且对比方法多为复现值,公平性需第三方验证。以上各点论文均未讨论,属独立分析。
未来方向
作者提出的方向:把 retrieve-and-internalize 确立为连接外部记忆与潜式推理的桥梁,暗示可推广到更广的潜空间推理(与 coconut 类潜思维一脉相承)。基于其成果可延伸的方向:其一,终身流式记忆——当前 LMT 随查询产生即丢弃,若能跨查询持久化并增量演化,可支撑全天候个人助理类应用;其二,与流式思考方法(ThinkStream 等)结合,让潜在记忆在无查询时也持续演化,实现『边看边想』;其三,将测试时内化蒸馏进骨干权重,消除 TTFT 开销,得到天然带潜在记忆的 Video-LLM;其四,奖励设计扩展——引入自一致性、工具验证或检索证据互证等多信号,缓解纯熵奖励的过自信风险;其五,迁移到具身智能与机器人操控,这类场景同样满足因果性、有限内存、实时响应三要素;其六,可解释性研究——训练线性探针解码 LMT 内容,量化『内化了什么』,为错误内化提供审计手段。
复现评估
实现细节披露相当充分:骨干 Qwen2.5-VL-3B/7B,在线基准 1fps 采样、至多 256 帧;短/中期记忆容量 8/64 帧,长期全局预算 2048 视觉 token;每组 $K=2$ 个 LMT,每轮注入 $B=8$ 个候选 patch,$R=4$ 轮迭代,$\eta=10^{-3}$,$\sigma=10\%$;离线基准至多 1024 帧、每帧 64 token;硬件为 8 张 NVIDIA H20。正文还给出熵公式(式 6)、奖励(式 7)、REINFORCE 梯度(式 9)等完整数学描述,算法复现的数学层面无障碍。不确定因素:提供的正文未包含代码或项目主页链接,开源情况未知;分层记忆构建的工程细节(Jenks 分割的批量实现、注意力掩码构造)被推到附录,正文未见;OVO-Bench 与 StreamingBench 的数据管道需要自行搭建,且部分对比基线为复现值,横向对比需谨慎。综合判断:对拥有 8 卡 A100/H20 级算力、熟悉 vLLM/transformers 视频推理栈的团队,复现属中高难度,预计 2-4 周;单卡环境只能跑 3B 骨干的小规模验证。
论文图表
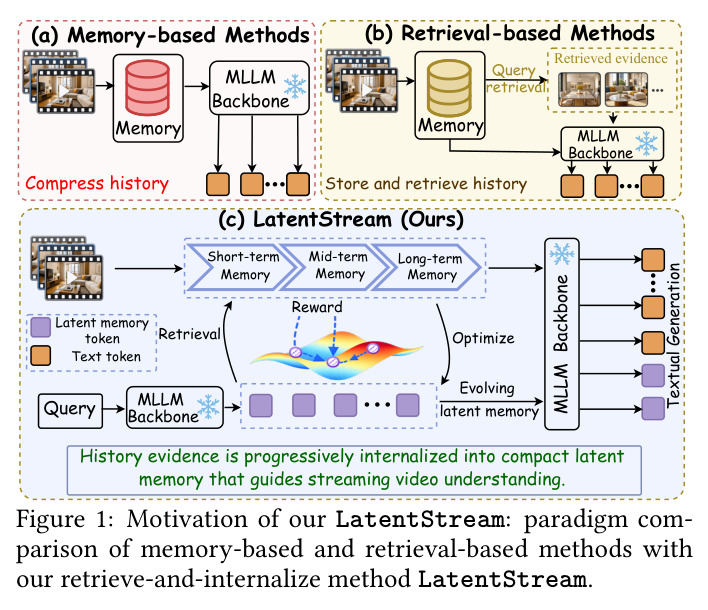
三栏范式对比图:(a) 记忆型方法将历史压缩后存入外部记忆库;(b) 检索型方法在查询到来时从记忆库检索证据拼为额外视觉上下文;(c) 本文 LatentStream:查询与骨干交互后,历史证据被渐进内化为紧凑的文本级潜在记忆 token,并配合奖励信号优化,直接指导流式生成。
一图讲清论文的核心立场——从 store-and-retrieve 到 retrieve-and-internalize 的范式跃迁,是理解全文动机和贡献定位的入口。
组件消融:基线 54.0/63.3(OVO/VideoMME);仅加 HSM 升至 58.1/65.1;再加 PMO 至 62.4/66.1;三者齐全达 64.2/66.6。值得注意仅 PMO(无检索注入)也带来 4.3/0.8 提升,说明置信优化本身即可精炼 LMT。
量化三组件的独立贡献与互补性,是判断哪个组件贡献最大、各组件是否缺一不可的直接依据。