记忆即权重:将长期历史内化于流式视频模型 Memory as Weights: Internalizing Long-Term History for Streaming Videos
用循环超网络把历史内化为持续演化的LoRA权重,流式VLM无需扩张上下文也能记住过去
前置知识
LoRA(低秩适应)
一种参数高效微调技术:不改动预训练模型的原有权重,只在目标权重矩阵旁挂载两个低秩矩阵 $A \in \mathbb{R}^{d \times r}$、$B \in \mathbb{R}^{r \times d}$(秩 $r \ll d$),前向时以 $\Delta W = BA$ 叠加生效。训练与存储开销极小,且现代推理框架普遍原生支持 LoRA 热插拔。
本文的核心主张就是把 LoRA 权重本身当作记忆载体:历史信息不再以 token 形式存在,而是被写入 $\Delta\theta_t$。不理解 LoRA 的机制就无法理解'记忆即权重'这一命题。
HyperNetwork(超网络)
生成另一个神经网络权重的网络。与传统网络'前向算输出'不同,超网络的前向输出是权重张量。本文的循环超网络 $f$ 每一步接收上一时刻隐状态与当前观测,一次前向就'算出'(而非通过梯度优化得到)一组 LoRA 权重,从而避免测试时训练的开销。
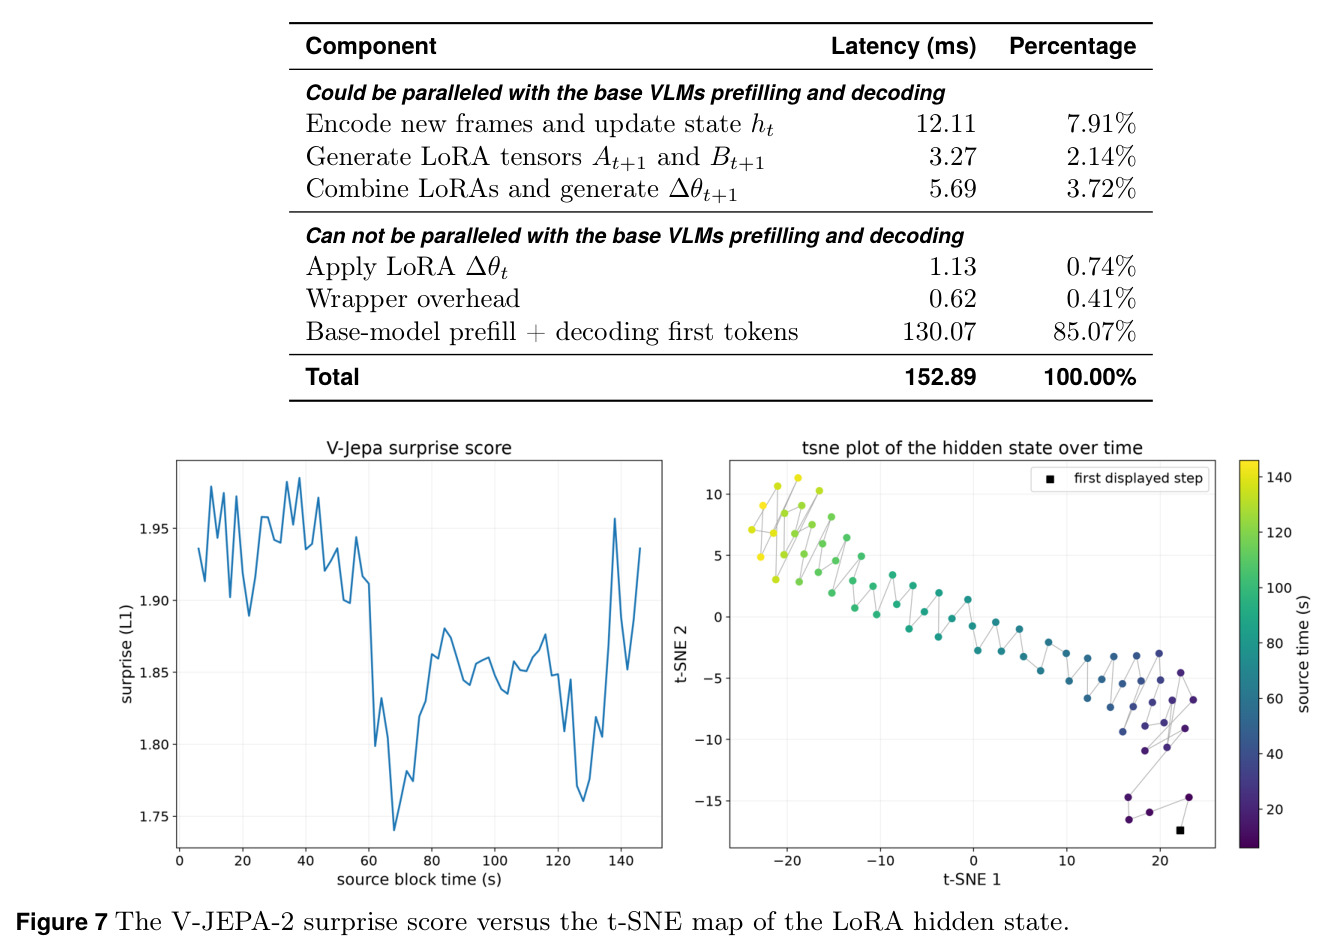
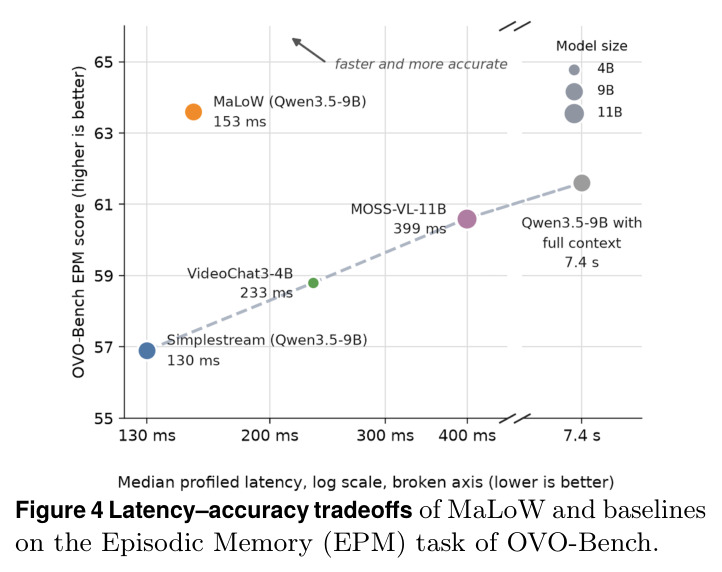
MaLoW 的记忆更新完全由超网络前向计算实现,这是它能把额外延迟压到约 23 ms、区别于测试时训练类方法的关键。
流式视觉语言模型(Streaming VLM)
持续接收视频流并在线响应用户提问的 VLM。与离线模型把整段视频一次性输入不同,流式模型必须增量处理不断到来的画面、在延迟与显存约束下实时回答,还要能回答'刚才发生了什么''接下来会发生什么'等跨越时间的问题。
本文的全部问题设定、方法设计与评测基准(OVO-Bench、StreamingBench、StreamArena)都围绕流式场景展开,'如何记忆'正是流式 VLM 区别于离线长视频理解的核心难题。
状态空间模型(SSM)与 DeltaNet
SSM 用一个固定大小的递归状态压缩序列历史,每步做线性更新,因此计算量与序列长度无关。DeltaNet 是带 delta 规则(写入时先擦除相似旧内容)的现代 SSM 变体,擅长在固定状态中保留关键信息。本文用 4 层 DeltaNet(隐藏维 512)建模观测流的局部时序动态。
MaLoW 隐状态的局部动态分支 $m_t$ 由 DeltaNet 实现,理解其'固定状态递归更新'的特性才能明白记忆为何可以恒定大小、增量演进。
OVO-Bench
流式视频理解基准,按提问时间把任务分三组:Real-Time(针对当前画面的感知,含 OCR/ACR/ATR/STU/FPD/OJR 六个子项)、Backward(回溯过去,含 EPM 情景记忆、ASI 动作序列识别、HLD 幻觉检测)与 Forward(预测未来),是检验'模型是否记得住过去'的标准考场。
论文的核心实验结论(如 Backward 分项领先 3.9%–11.8%)都来自 OVO-Bench,其中 EPM 与本文记忆机制的设计动机一一对应。
研究动机
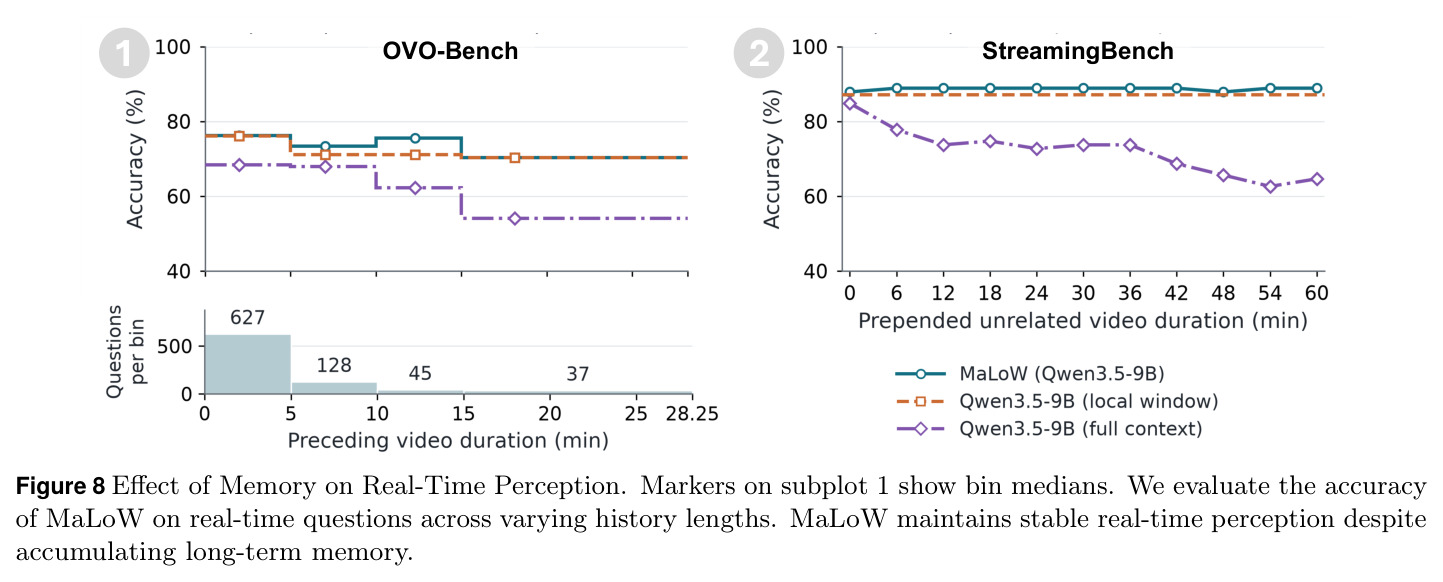
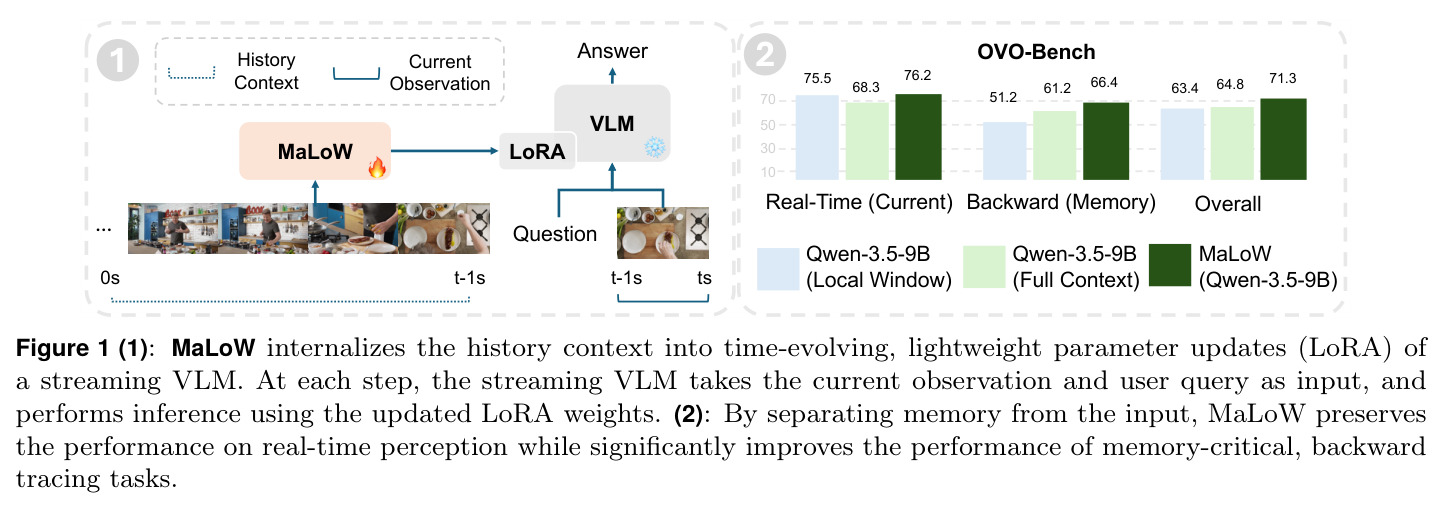
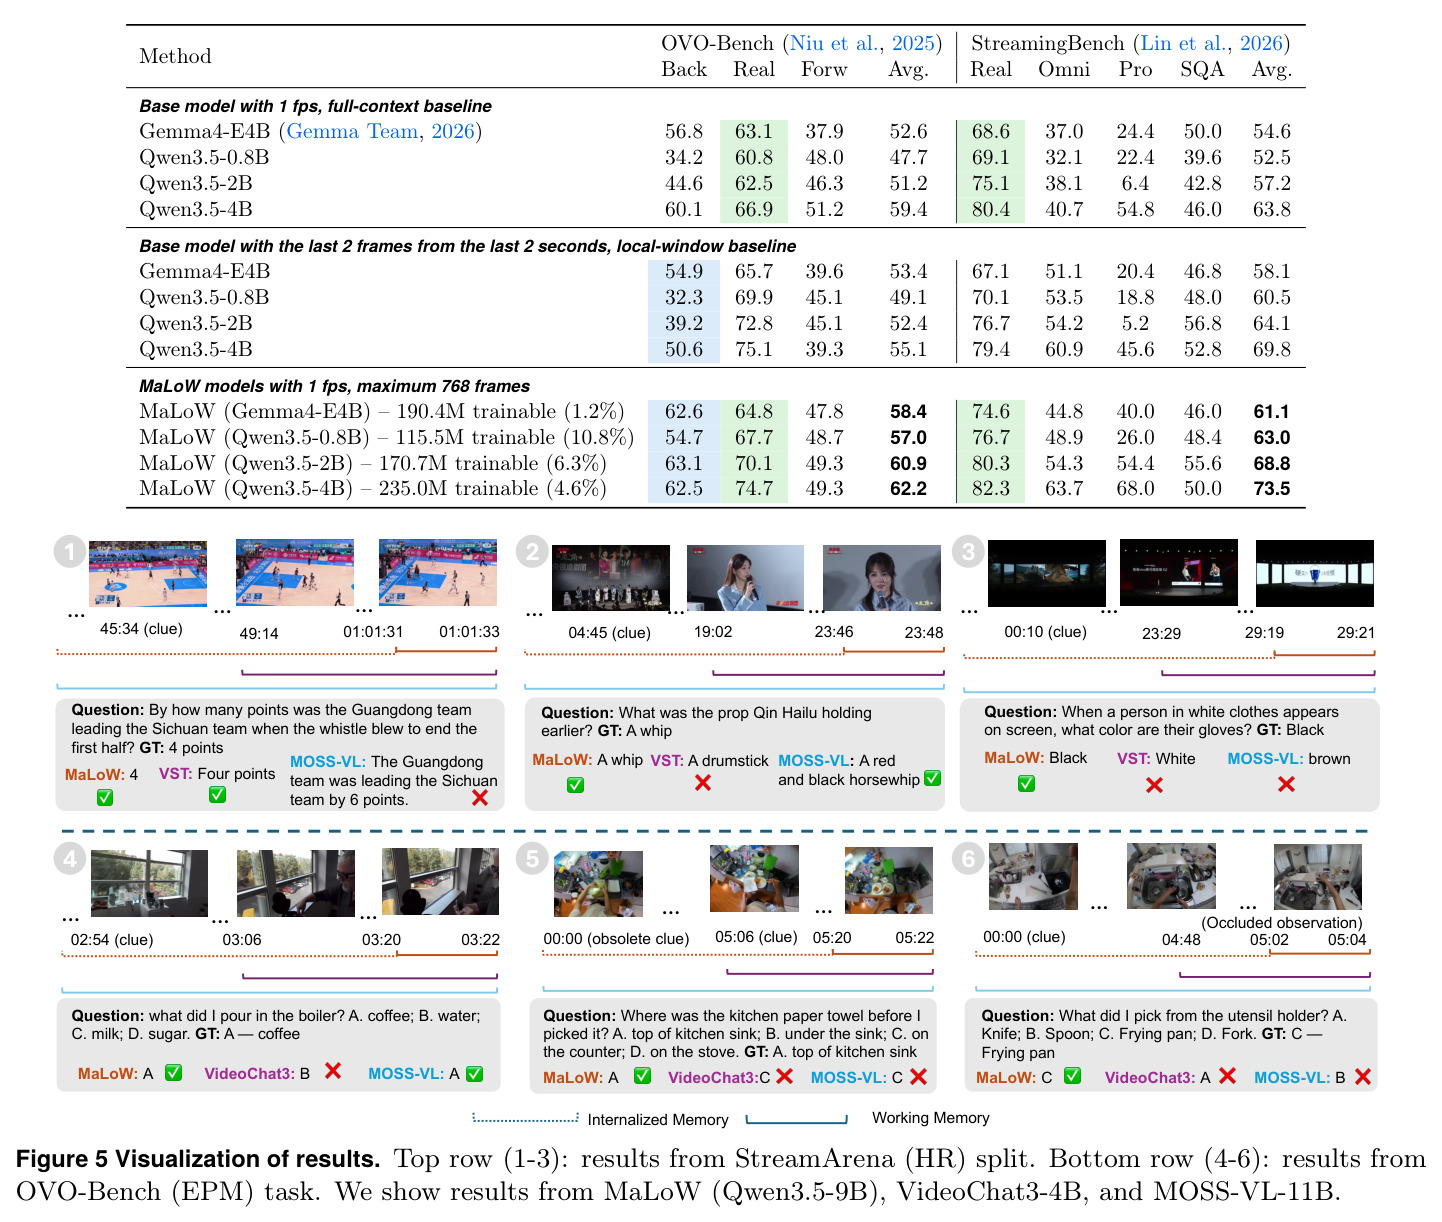
现有流式 VLM 的记忆方案几乎都是'把历史塞回输入上下文':或压缩成文本摘要(VST、ThinkStream),或对视觉 token 做聚类与合并(Flash-VStream),或建分层记忆结构(HERMES、OASIS),或维护固定大小缓冲区(Dispider、TimeChat-Online)。这带来两个根本矛盾:历史 token 与当前观测在同一上下文窗口里争夺有限预算,问'刚才发生了什么'时会挤压对当前帧的表征;反过来若只保留 4–30 秒的局部窗口,历史被直接丢弃。数据非常直观:Qwen3.5-9B 全上下文在 OVO-Bench Backward 平均可得 61.2,只给最后 2 秒局部窗口则掉到 51.2;加记忆机制的方案中最好的 OASIS-8B 也只有 57.2,Flash-VStream 低至 27.4。此外流式场景还要求记忆增量更新、不能反复重算全历史、推理开销尽量小,这三条约束现有方法很难同时满足。
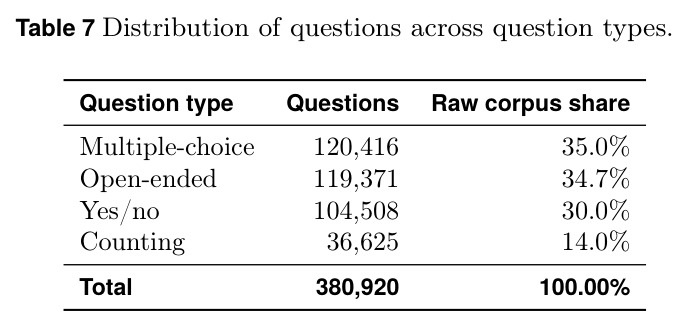
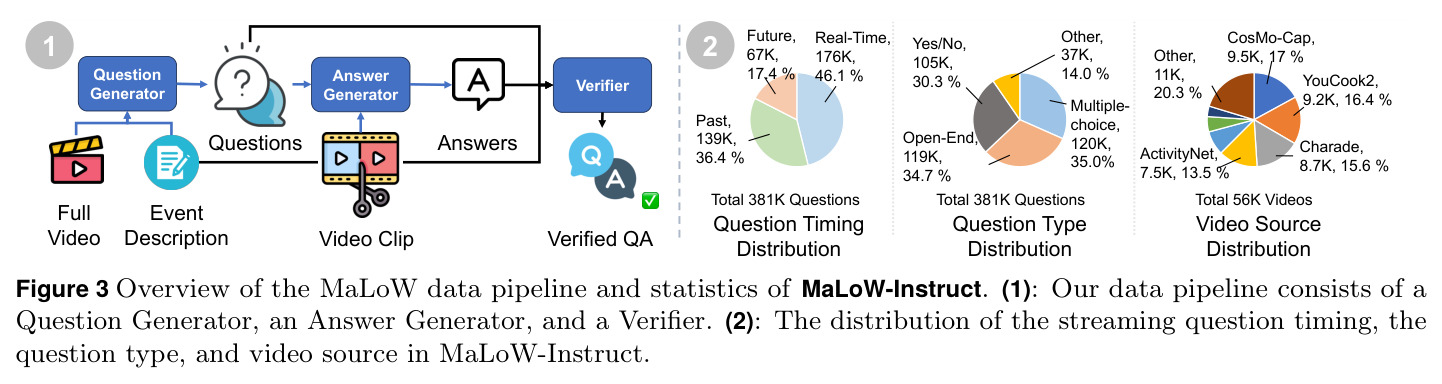
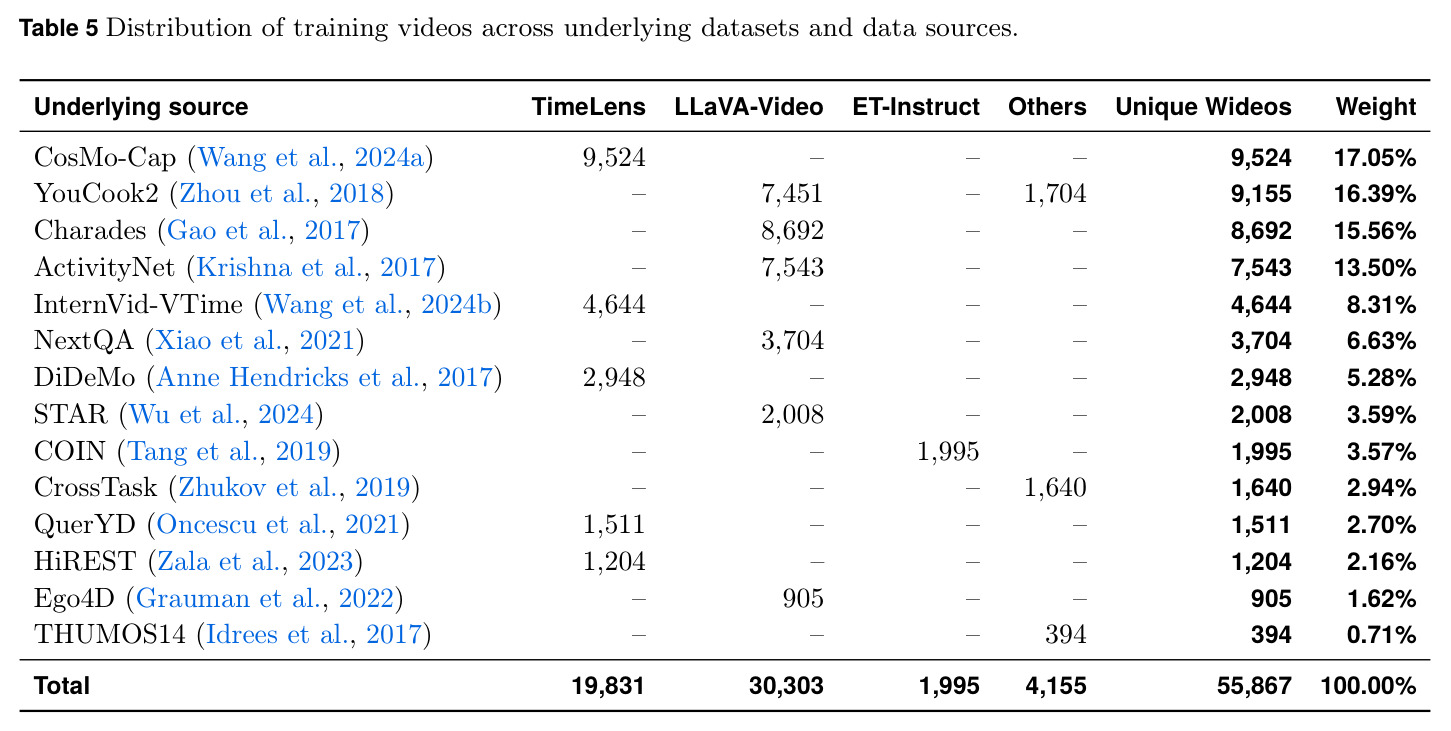
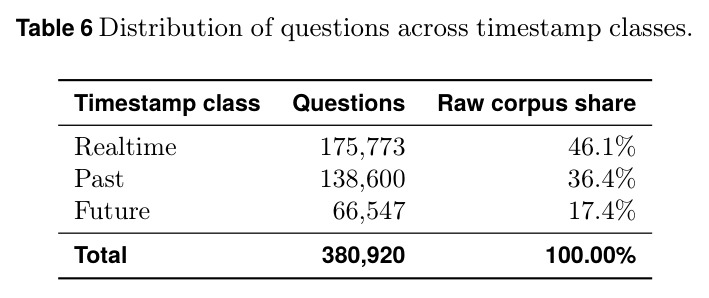
本文的目标是本文要回答'流式 VLM 应该如何记忆':设计一种记忆机制,把历史信息以增量方式压缩进固定大小的载体,彻底不占用输入上下文,从而同时保住实时感知与长期回溯两种能力。具体落点是 MaLoW 框架——历史被内化为随时间演化的轻量 LoRA 权重(新增可训练参数仅占基座模型的 1.4%–4.0%),基座 VLM 的架构与参数完全冻结。配套目标有三:构建大规模流式视频训练集 MaLoW-Instruct(56K 视频、381K QA 对),解决流式监督数据匮乏;在 OVO-Bench、StreamingBench、StreamArena 上做系统评测,覆盖 0.8B–11B 多个基座;并验证该记忆机制能否迁移到视觉-语言-动作(VLA)机器人规划等更广泛的交互场景。
与已有工作不同的是,切入点的独特性在于换了一个提问方式:前人都在问'存什么信息、怎么检索回来',本文问的是'记忆应该放在哪里'。既有方法一律把历史表示为 token 再注入上下文;并发工作 StreamTTT 虽把记忆移出注意力上下文,但仍需要一条独立的测试时训练(TTT)分支在线更新快速权重;δ-mem 与 Charakorn 等人的 LoRA 上下文工作要么推理时仍需访问全部历史原文,要么每遇到新模式都要额外做优化。MaLoW 则让历史直接长在 VLM 自己的参数里:由循环超网络前向一次生成低秩适配并叠加到冻结基座上,无需测试时训练、无需独立记忆分支、无需保留历史 token,且记忆大小恒定、不随流长增长。
核心方法
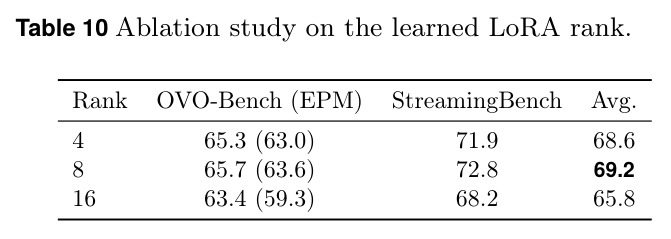
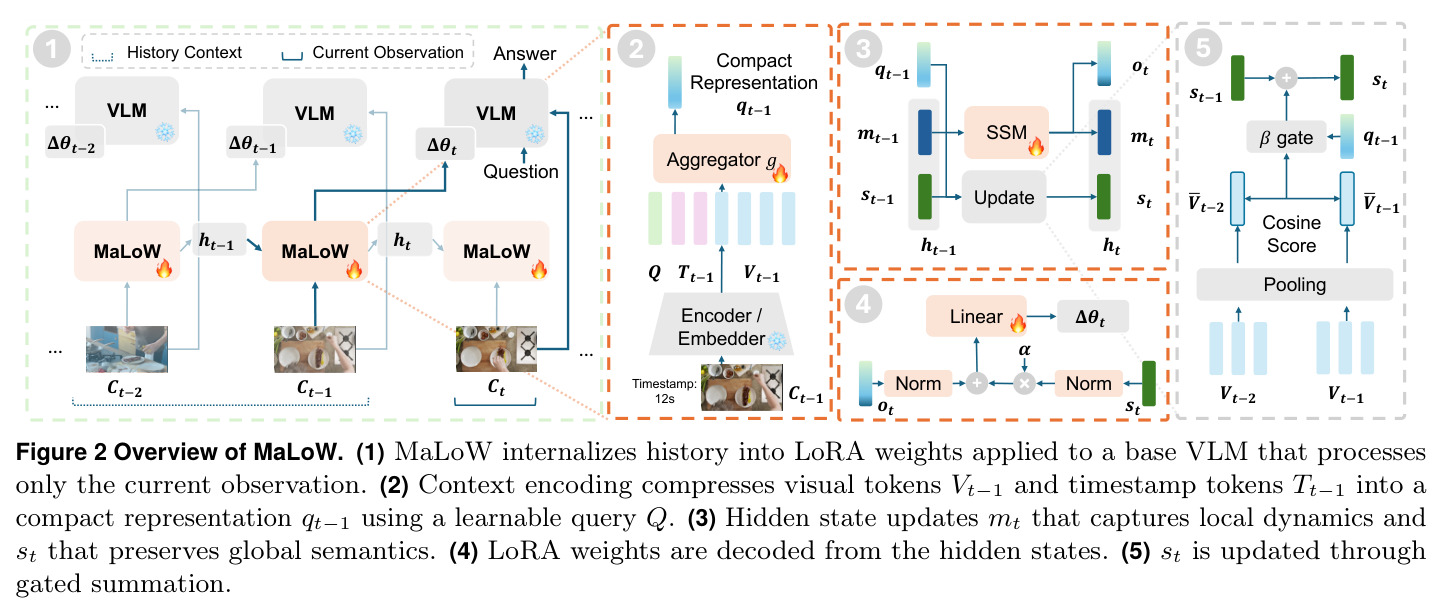
直觉是把'记忆'从输入侧搬到参数侧:过去发生的事不再以 token 形式躺在上下文里,而是被写进模型权重——如同人凭内化的经验答题,而不是反复翻看笔记。技术路线上,基座 VLM $M_\theta$ 全程冻结,另设一个循环超网络 $\Phi$ 负责把历史内化。形式化为 $\Delta\theta_t = \Phi(C_{0:t-1}; h_0)$,回答时 $R_t = M_{\theta+\Delta\theta_t}(I_t, C_t)$,即模型只接收当前观测 $C_t$(2 秒视频片段)与问题 $I_t$,全部历史仅通过生成的 LoRA 权重 $\Delta\theta_t$ 影响前向计算。$\Phi$ 被定义为单步更新 $f$ 的循环应用:$h_t, \Delta\theta_t = f(h_{t-1}, C_{t-1})$,隐状态 $h_t$ 是历史的紧凑表示。因此无论视频流多长,每步的计算量与显存占用都恒定,记忆是固定大小的一组秩为 8 的低秩矩阵。
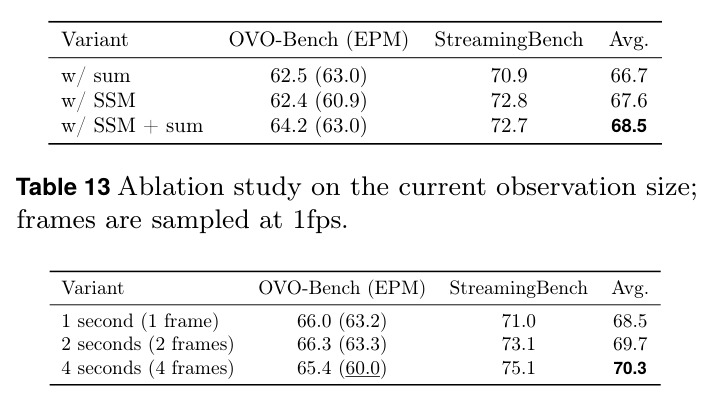
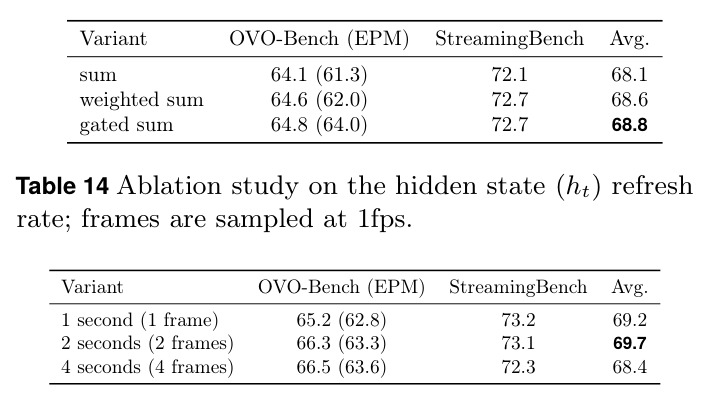
核心创新是'历史即权重、当下即输入'的表示分离。与所有先前方法的本质区别在于:过去记忆与当前观测共享同一注意力上下文、互相竞争,而 MaLoW 中二者物理隔离——历史改变参数(经由 $\Delta\theta_t$ 调制前向计算),当前观测独占输入窗口。实现上有两个巧思:其一,隐状态分解为 $h_t = [m_t; s_t]$,SSM 分支 $m_t$ 用 DeltaNet 捕捉局部时序动态,门控累积分支 $s_t$ 以跳连方式保留全局长期语义,兼顾'跟变化'与'存背景';其二,训练时预测损失直接穿过生成的 LoRA 权重反传到超网络($\mathcal{L} = \mathcal{L}_{\text{ntp}} + \gamma \mathcal{L}_{\text{LoRA}}$,后者按 $\mathrm{mean}|A_s| \cdot \mathrm{mean}|B_s|$ 正则权重幅度),逼迫超网络学会'该记什么、该忘什么',全程不需要测试时训练。附录 A 还给出理论分析,论证低秩参数更新足以表示历史诱导的特征变换。
方法步骤详情
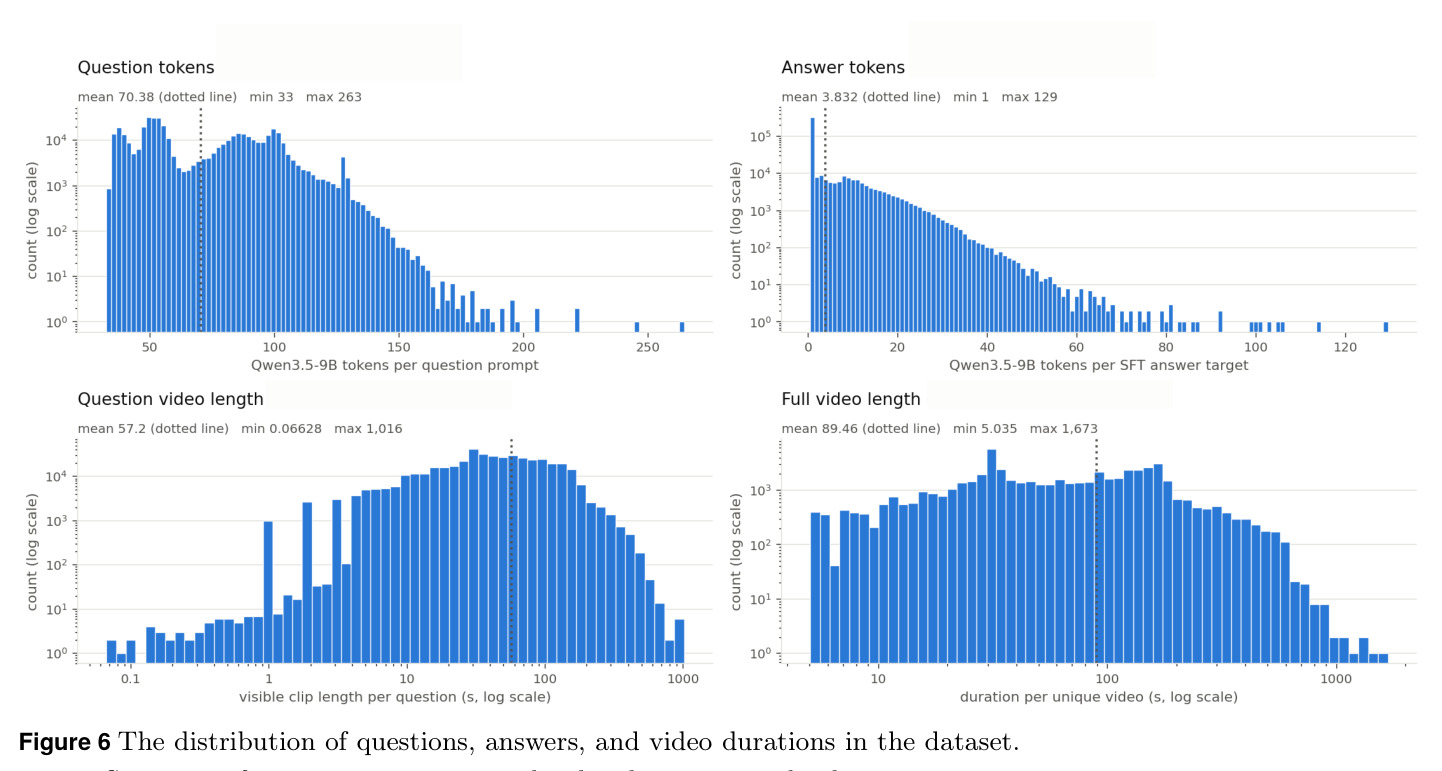
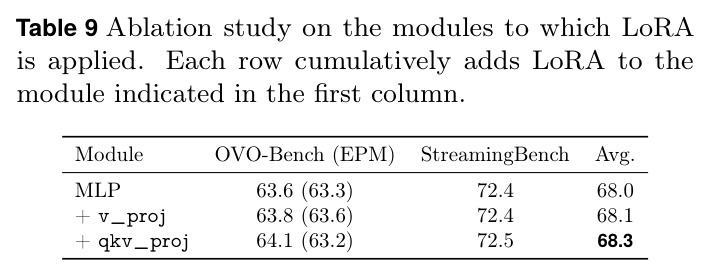
流程分五步。第一步上下文编码:将视频嵌入 $V_{t-1}$、时间戳文本嵌入 $T_{t-1}$ 与可学习查询 $Q$ 拼接,经 4 层自注意力聚合器(512 维、8 头)压缩为 $q_{t-1} = g([V_{t-1}; T_{t-1}; Q])$。第二步隐状态更新:$m_t, o_t = \mathrm{SSM}(q_{t-1}, m_{t-1})$(4 层 DeltaNet)捕捉局部动态;$s_t = s_{t-1} + \beta_{t-1} q_{t-1}$,门 $\beta_{t-1} = \mathbb{I}[\mathrm{sim}(\bar{V}_{t-1}, \bar{V}_{t-2}) \le \beta]$ 由相邻片段余弦相似度决定是否写入。第三步 LoRA 解码:$\Delta\theta = h(o_t, s_t)$,RMSNorm 后经逐模块线性投影输出,外加可学习门 $\alpha$;rank-8 LoRA 挂在注意力层 MLP 与 v_proj。第四步推理:以 $\theta + \Delta\theta_t$ 处理当前 2 秒片段与问题,1 fps。第五步训练:VLM 冻结,损失穿过 $\Delta\theta_t$ 反传至超网络,2800 步、batch 64、峰值学习率 $8 \times 10^{-5}$;数据由 Qwen3.5-122B-A10B 生成、Qwen3.5-397B-A17B 验证,约 36% 查询晚于事件结束以显式监督记忆。
技术新颖性
技术新颖性体现在四点。第一,记忆载体从 token 变为参数:与文本摘要、token 合并、分层记忆、固定缓冲等所有上下文内方案不同,MaLoW 的记忆是一组固定秩的 LoRA 矩阵,大小恒定,不随流长增长。第二,'生成权重'而非'训练权重':相比需要测试时优化的 LoRA 上下文工作(Charakorn 等)和依赖独立 TTT 分支的 StreamTTT,超网络一次前向即产出权重,记忆机制的额外延迟仅约 23 ms(<15% 总推理时间),且可与骨干推理并行。第三,双分支隐状态设计(DeltaNet 局部动态 + 余弦相似度二值门控的全局累加)针对流式内容的时间结构做了针对性建模,静态场景不重复写入。第四,基座完全冻结,方法成为即插即用的'记忆补丁':与主流 LoRA 推理框架兼容,不破坏预训练能力,且在 0.8B–11B、Qwen3.5/Gemma4/VideoChat3/MOSS-VL 等不同规模与家族的基座上均验证有效(可训练参数 115.5M–321.1M,占比 1.2%–10.8%)。
实验结果
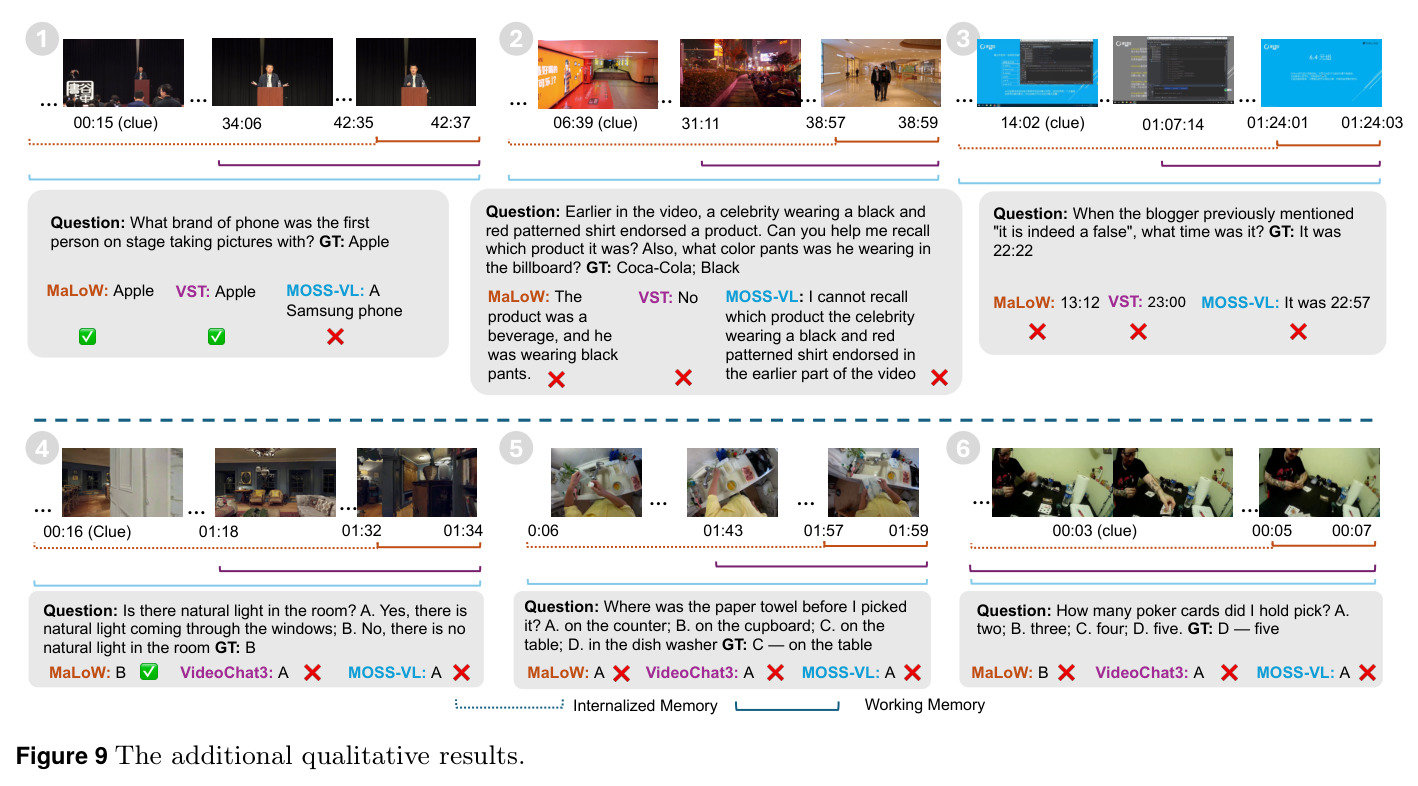
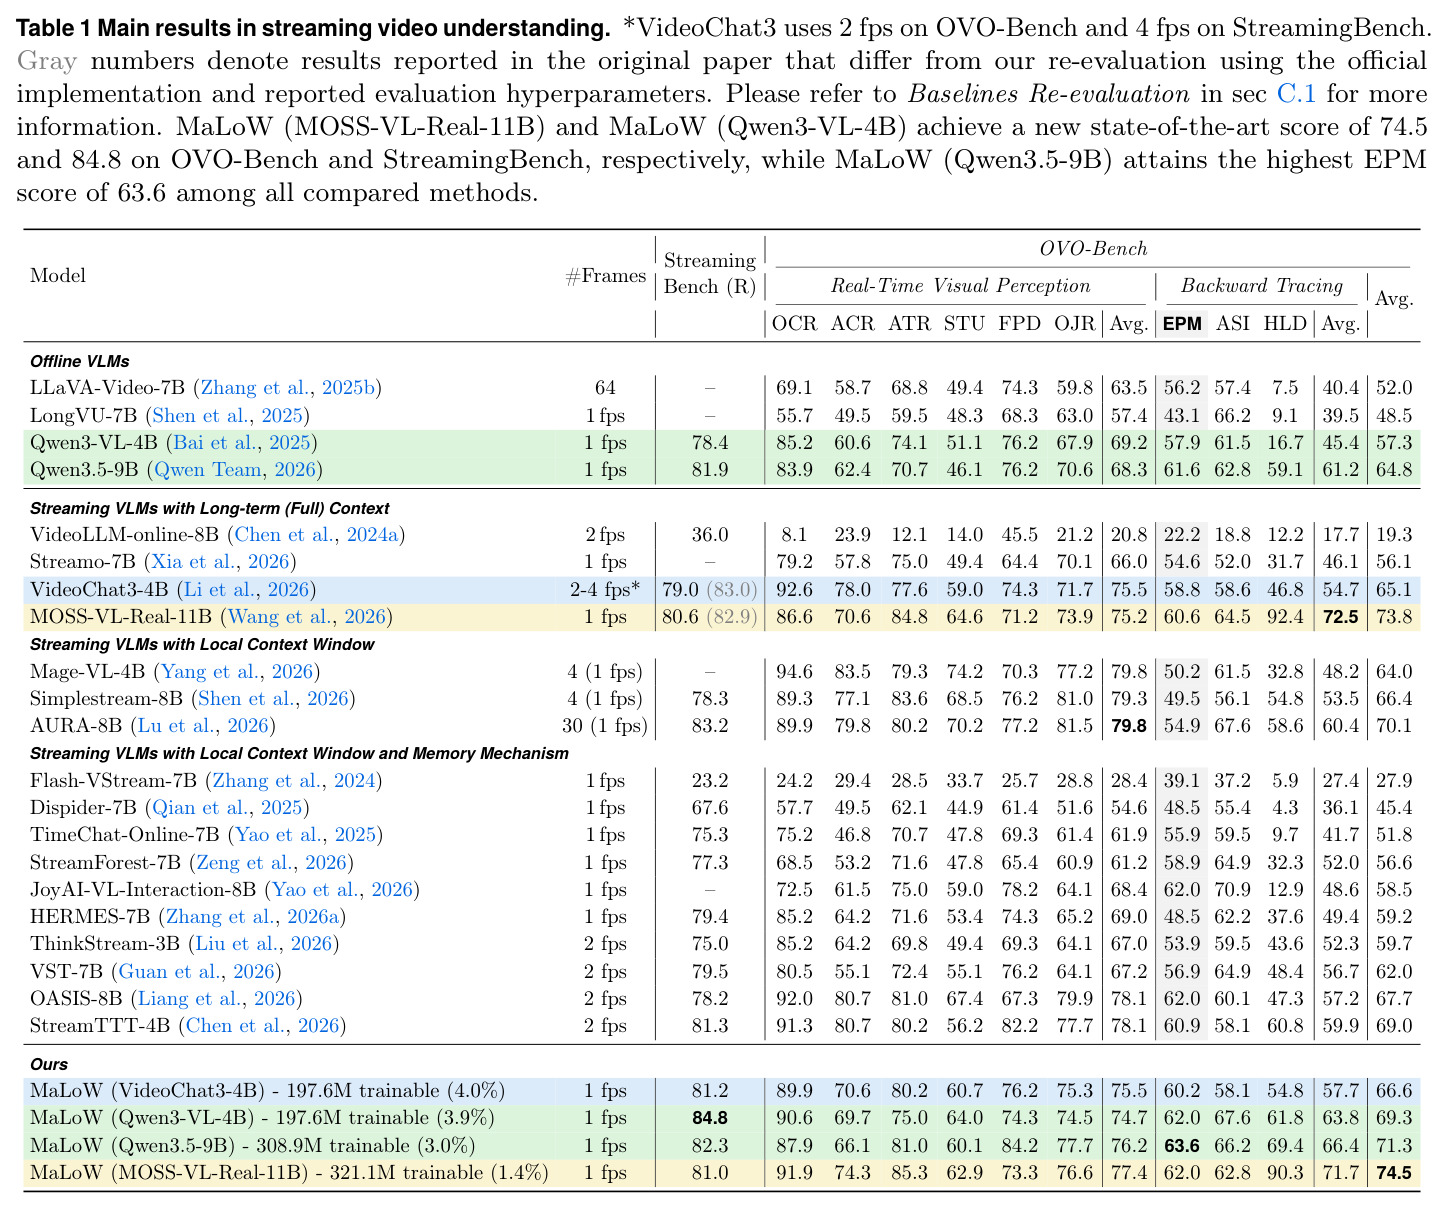
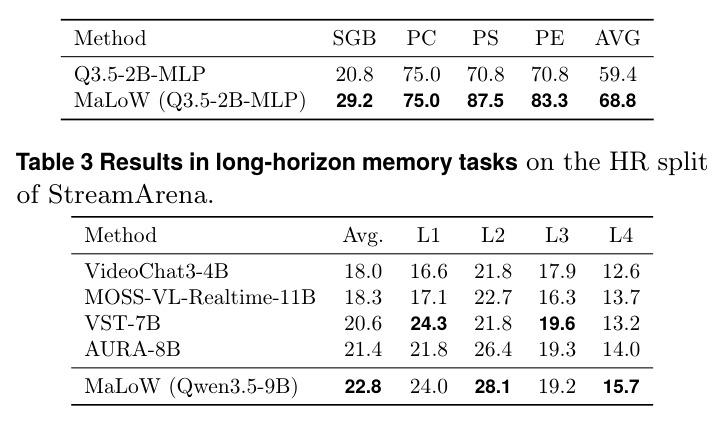
主实验(Table 1)全面刷新 SOTA:MaLoW(MOSS-VL-Real-11B) 在 OVO-Bench 得 74.5,MaLoW(Qwen3-VL-4B) 在 StreamingBench 得 84.8,MaLoW(Qwen3.5-9B) 拿下最高 EPM 63.6。记忆分项最亮眼:9B 版 OVO Backward 平均 66.4,超最强记忆基线 OASIS-8B(57.2)9.2 分、超局部窗口方法 AURA-8B 6.0 分;4B 版 Backward 63.8 超并发 StreamTTT-4B 3.9 分;跨基座合计领先先前记忆方法 3.9%–11.8%。记忆机制额外延迟仅约 23 ms(<15% 总推理时间,Figure 4)。长时程测试(Table 3):StreamArena HR 分项(查询-证据中位间隔 12.1 分钟)上得 22.8,超 VST-7B 2.2 分、MOSS-VL 4.5 分,样例显示能回忆 16/19/29 分钟前的细节并在画面遮挡时答对。跨规模(Table 4):Qwen3.5-4B 版 OVO 平均 62.2 高于全上下文 59.4 与局部窗口 55.1,实时分项 74.7 反超全上下文的 66.9,说明内化记忆解除了历史对实时感知的挤压。VLA 迁移(Table 2):Simpler WidowX 平均成功率 59.4%→68.8%(+9.4%),PS 任务 70.8%→87.5%。代价是实时感知略降:9B 版实时 77.7 低于 AURA 的 81.5。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OVO-Bench Backward(Qwen3.5-9B 基座) | Backward 三任务(EPM/ASI/HLD)平均分 | 66.4 | OASIS-8B 57.2(最强记忆机制基线) | +9.2 |
| OVO-Bench Backward(Qwen3-VL-4B 基座) | Backward 平均分 | 63.8 | StreamTTT-4B 59.9(并发 TTT 方法) | +3.9 |
| OVO-Bench EPM 情景记忆(Qwen3.5-9B) | EPM 得分 | 63.6 | OASIS-8B 62.0 / 全上下文 Qwen3.5-9B 59.1 | +1.6 / +4.5(所有方法中最高) |
| StreamingBench Real-Time(Qwen3-VL-4B) | Real-Time 分项得分 | 84.8 | StreamTTT-4B 81.3 | +3.5(新 SOTA) |
| StreamArena HR 长时程历史回溯(Qwen3.5-9B) | 平均分(查询-证据中位间隔 12.1 分钟) | 22.8 | VST-7B 20.6 / MOSS-VL-Realtime-11B 18.3 | +2.2 / +4.5 |
| OVO-Bench Overall(MOSS-VL-Real-11B 基座) | 总平均分 | 74.5 | MOSS-VL-Realtime-11B 73.8(全上下文) | +0.7(新 SOTA) |
| Simpler WidowX 机器人操作(VLA) | 四任务动作平均成功率 | 68.8% | Q3.5-2B-MLP 59.4% | +9.4% |
局限与改进
作者承认的局限:OVO-Bench 实时分项上 MaLoW(Qwen3-VL-4B/9B) 落后 StreamTTT-4B 与 AURA-8B,作者推测这些基线微调过基座 VLM 而 MaLoW 保持基座完全不动;11B 版相对其基座提升幅度较小(Real-Time +2.2、EPM +1.4)。我观察到的局限:其一,记忆容量受 LoRA 秩约束,定性样例最长只回溯到 29 分钟,小时级流未验证,StreamArena HR 绝对分仅 22.8 表明长时程记忆远未解决;其二,写入门是阈值 $\beta$ 手工设定的二值指示函数,只比较相邻两片段相似度,对缓慢渐变或周期性重复内容可能误判;其三,超网络为每个目标模块、每个秩分量学习独立投影,参数随模型宽度增长(0.8B 基座竟需 10.8% 可训练参数);其四,表格中灰色数字显示多个基线的官方复评值与原论文报告有出入,评测协议差异给对比带来不确定性;其五,VLA 实验仅在 SimplerEnv-Bridge 仿真环境进行,未涉及真实机器人。
独立分析的弱点
弱点一:实时与记忆的权衡未完全消失——9B 版 StreamingBench 82.3 略低于 AURA-8B 的 83.2,OVO 实时分项 77.7 低于 AURA 的 81.5 与 OASIS 的 79.9,说明 LoRA 调制仍会轻微干扰当前感知;改进方向是为感知相关层加正则或引入双通路解耦(记忆只调制部分层)。弱点二:rank-8 的表达上限——面对信息密集的小时级流(监控、直播),一组 197M–321M 的记忆参数可能饱和;可探索自适应秩或按信息量动态分配到关键层。弱点三:二值门只看相邻两片段的余弦相似度,'缓慢渐变+周期重复'场景(昼夜交替监控)会误判写入时机;可换成可学习的连续门或基于信息增益的门控。弱点四:超网络逐模块、逐秩分量的独立投影使参数随基座宽度膨胀,0.8B 模型需 115.5M(10.8%)可训练参数,小模型上性价比差;可共享投影或用低秩超网络生成低秩权重。弱点五:纯参数记忆不可检索、不可解释,答错时难以定位是'没记住'还是'记错';可与轻量 token 索引混合,提供可验证的证据链。
未来方向
作者提出的方向:将 LoRA 生成与骨干推理并行调度以进一步压缩延迟;把机制推广到更多 VLA 与交互式任务。基于其成果可延伸的方向:(1)小时级乃至天级持续流的记忆容量与遗忘机制,引入类似'睡眠巩固'的离线整理阶段;(2)权重记忆与检索记忆的混合系统——权重存'内化经验'、可检索外存放'可引用证据',兼顾推理流畅与答案可验证;(3)把内化过程视作持续学习中的权重更新,研究多任务流上的灾难性遗忘与防遗忘约束;(4)理论侧刻画低秩记忆的容量上界与信息瓶颈,回答'多长的历史能压进多小的秩';(5)与 TTT 类方法统一——MaLoW 的前向生成 $\Delta\theta$ 与 TTT 的在线梯度更新 $\Delta\theta$ 可能互补,前者快而后者适应性强;(6)扩展到音频、屏幕流等多源输入,以及具身智能体的在线长程规划。
复现评估
复现条件较好。代码在 GitHub(dragonlzm/MaLoW)开源,模型与数据在 HuggingFace 集合(zhuomingliu/malow)发布,论文承诺公开 MaLoW-Instruct 全集。训练本身不重:仅 2800 步、总 batch 64、约 1.9 亿–3.2 亿可训练参数,单节点多卡(8×A100 量级)即可完成;推理依赖主流框架的 LoRA 支持,工程门槛低,附录 C 给出完整超参(rank-8、聚合器 4 层 512 维、DeltaNet 4 层、峰值学习率 $8 \times 10^{-5}$ 等)。难点在数据管线:需调用 Qwen3.5-122B-A10B(问题/答案生成)与 Qwen3.5-397B-A17B(验证)等大教师模型,提示词细节虽在附录 B 描述,但完全复刻的 API 成本不低,且依赖 14 个源数据集的时间戳标注。评测侧需按官方实现重跑十余个基线(作者已发现原报告值与复评有差异),工作量可观但协议公开。总体难度中等:算法与训练复现容易,数据与评测复现较贵。
论文图表