ShallowStream:浅层索引、深层回答的流式视频理解 ShallowStream: Index Shallow then Answer Deep for Streaming Video Understanding
只用浅层编码视频流并建索引,查询时按需对检索证据做全深度计算
前置知识
KV 缓存与 prefill/decode 两阶段推理
Transformer 自回归推理分两阶段:prefill 阶段对输入 prompt 一次性并行计算,并把每层的 Key/Value 缓存下来;decode 阶段逐 token 生成并复用这些 KV。KV 缓存的大小与输入长度、层数成正比,prefill 的计算量也与层数线性相关。
本文的效率收益全部来自把流式阶段的 prefill 从全部 $L$ 层砍到浅层 $[0,P)$,深层 KV 根本不生成。不理解 KV 缓存的层结构,就无法理解浅层索引为什么既省计算又省显存。
流式视频理解(streaming video understanding)
与离线长视频理解不同,流式设定下帧因果地持续到达、未来内容不可见、用户问题可能在任意时刻提出。系统分两段:查询无关的流处理(持续编码并维护历史)和查询期回答(判断是否需要历史、检索证据、生成答案)。
流式负载是不对称的:帧是持续稳态负载、查询稀疏,所以每帧 prefill 是一阶成本。这是论文把优化目标放在流处理而非查询期的根本原因。
MLLM 浅层表示
多模态大模型由视觉编码器和语言 Transformer 组成。实证研究发现浅层和中层的隐状态已含丰富的语义匹配信号:本文在 LVBench 上扫描候选层发现,Qwen3-VL-8B(28 层)第 4 层、LLaVA-OneVision-7B(32 层)第 3 层就具备很强的视频-问题检索能力。
这是全文的核心假设:既然浅层足以判断哪段历史与问题相关,深层的计算在流式阶段就是纯浪费,可以推迟到查询时刻只对选中证据执行。
Q-K 注意力打分与 token 级检索
把问题最后一个 prompt token 在某层的 Query 与候选视觉 token 的 Key 做 RoPE 感知的缩放点积注意力,即可衡量每个视觉 token 与问题的相关度。保留 token 级打分(而非把一个视频单元压成单一相似度)能保留更细粒度的证据信号。
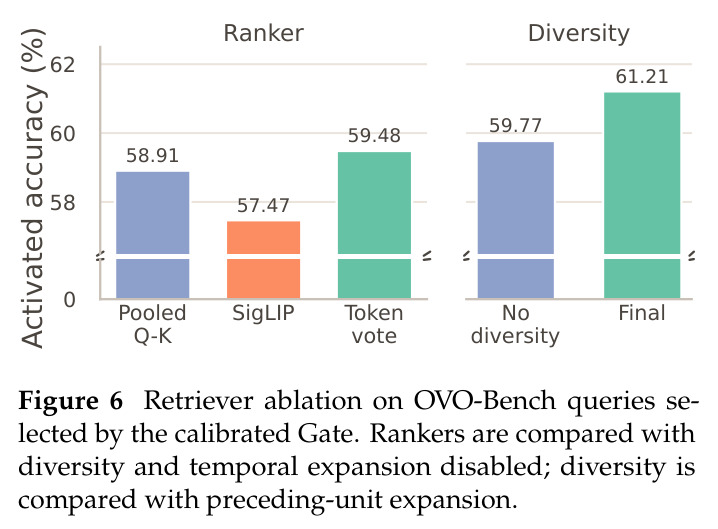
ShallowStream 的证据检索完全建立在浅层 Q-K 注意力上:每层取 Top-$M$=64 个 token、按所属单元累计投票 $v_t$,消融显示它优于池化 Q-K(61.21% vs 57.47%)和独立 SigLIP 编码器(58.91%)。
查询门控与按需检索(query-logit gate)
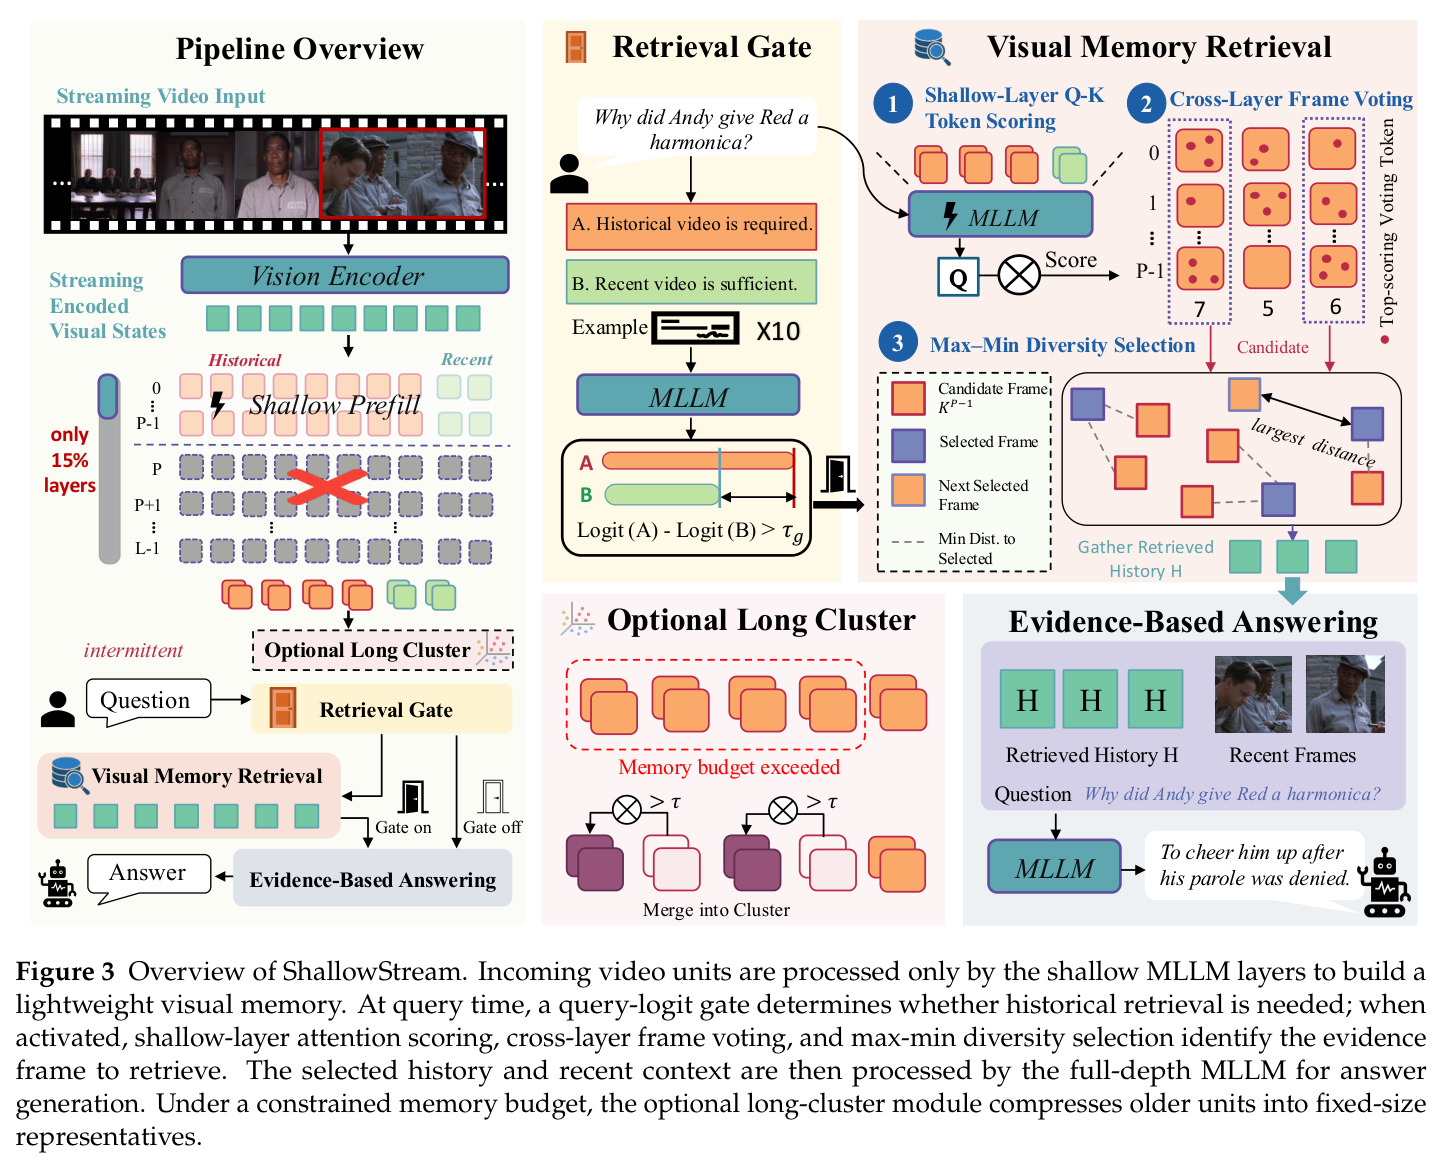
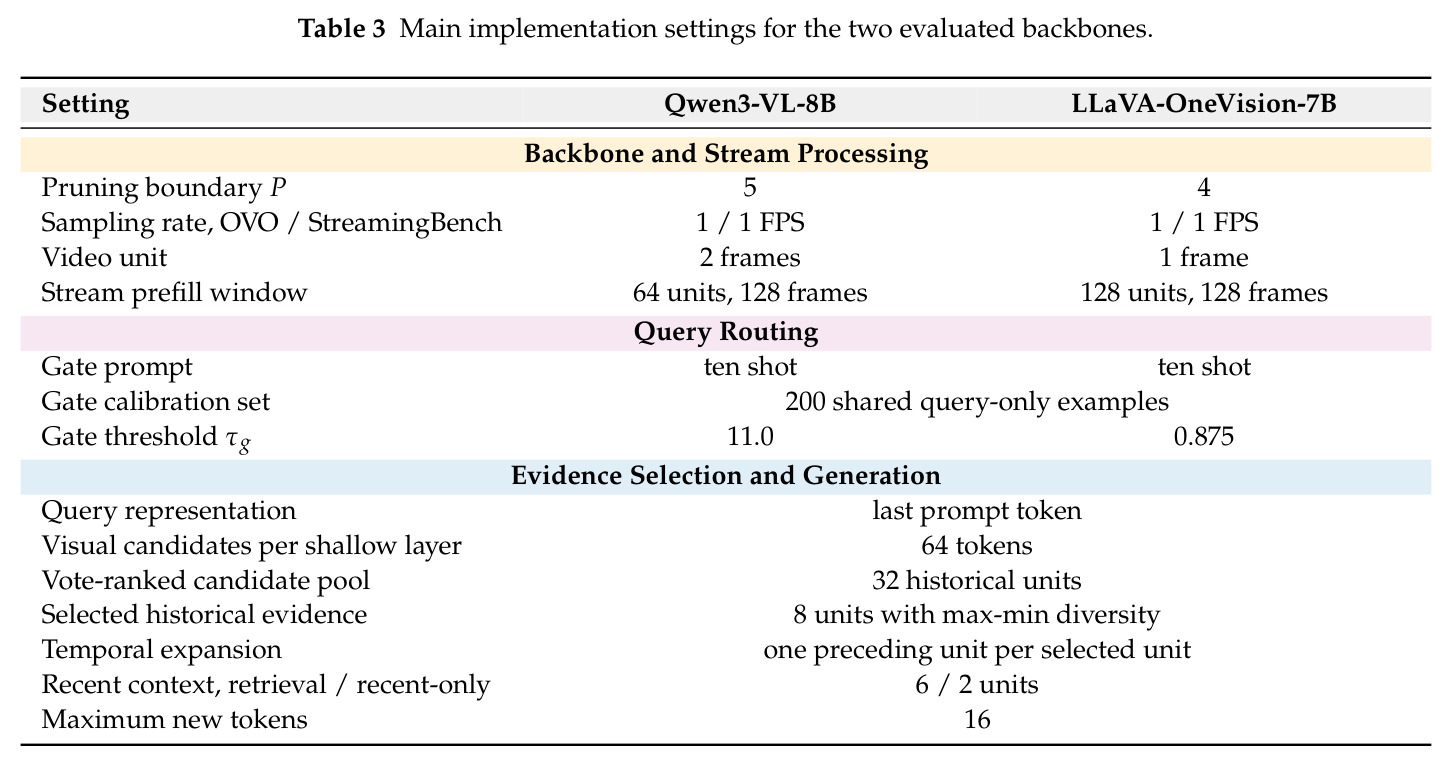
不是每个问题都需要检索全视频历史:追溯性问题需要早前证据,当前场景问题用近期帧即可。ShallowStream 用一个固定 10-shot 路由 prompt 让模型在单 token 选项 A(需要历史)/ B(近期足够)之间选择,以两选项 logit 差 $g(q)=\mathbb{1}[\ell_{ret}(q)-\ell_{recent}(q)\geq\tau_g]$ 做零训练路由。
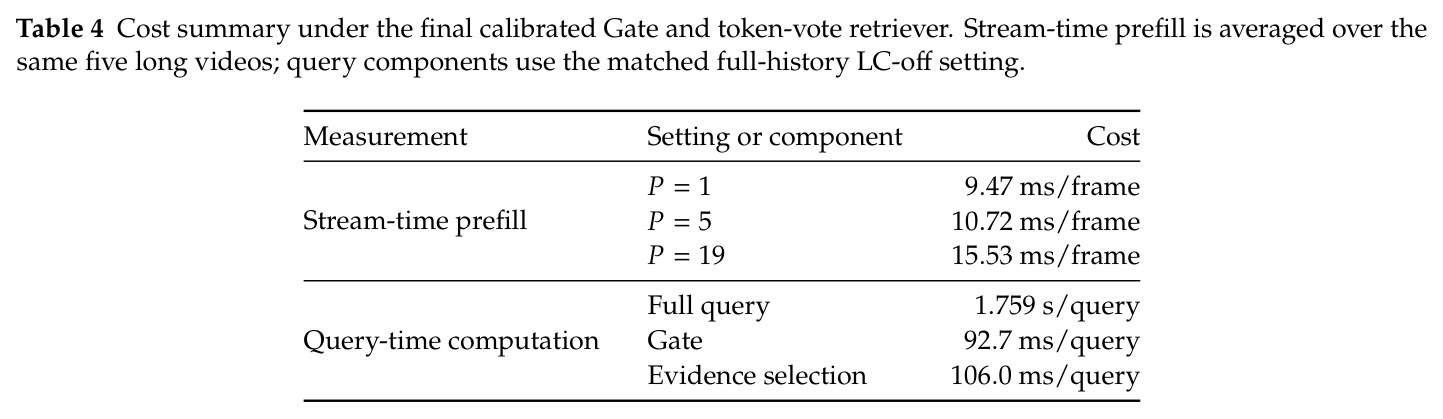
相比 OASIS、WeaveTime 需要一次答案级推理来路由,这个门控只需一次纯文本前向(92.7 ms),且阈值在 200 条基准无关的合成问题上按精度优先准则校准后冻结。
研究动机
流式视频理解要求多模态大模型(MLLM)因果地处理连续视频流:帧持续到达、未来内容不可见、问题可能在任意时刻提出。这带来极不对称的负载——视频帧是持续的稳态负载而查询稀疏,每帧 prefill 成为一阶系统开销。现有方法存在三个具体问题。其一,流处理昂贵:KV 中心方法(ReKV、StreamKV、HERMES 等)在不知道未来问题时就对每帧执行全部 $L$ 层 Transformer prefill,计算已经花掉,之后才做缓存缩减,且 KV 缓存增长速度与 prefill 深度成正比。其二,证据压缩有损:查询无关的压缩或逐出策略(StreamMem、InfiniPot-V 等)可能丢弃未来追溯性查询所需的关键证据,而保留完整视频状态又导致显存爆炸或依赖带宽受限的 CPU offload。其三,历史利用低效:总是拼接历史会推高延迟并干扰当前场景感知(SimpleStream),OASIS、WeaveTime 的按需检索又需要先做一次答案级推理来路由,激活时还要二次推理,延迟接近翻倍。
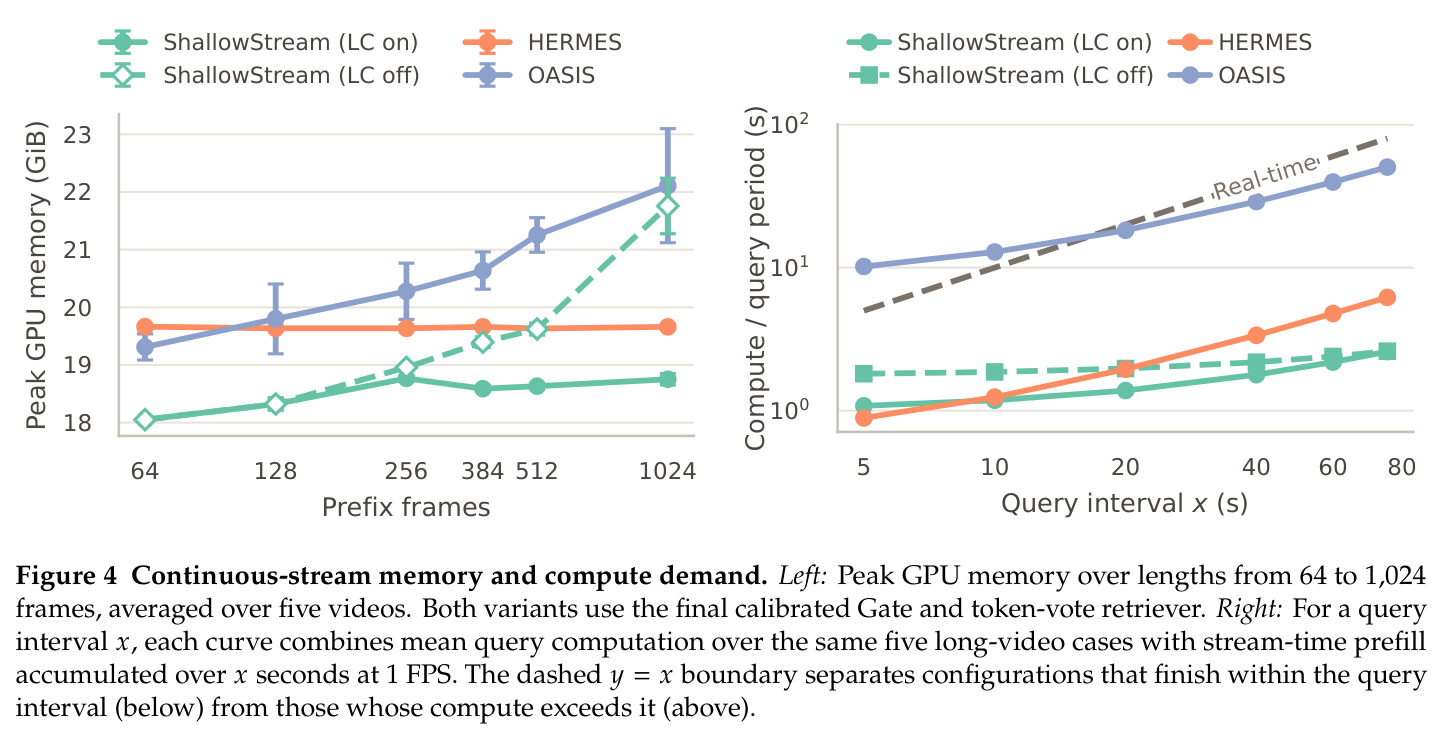
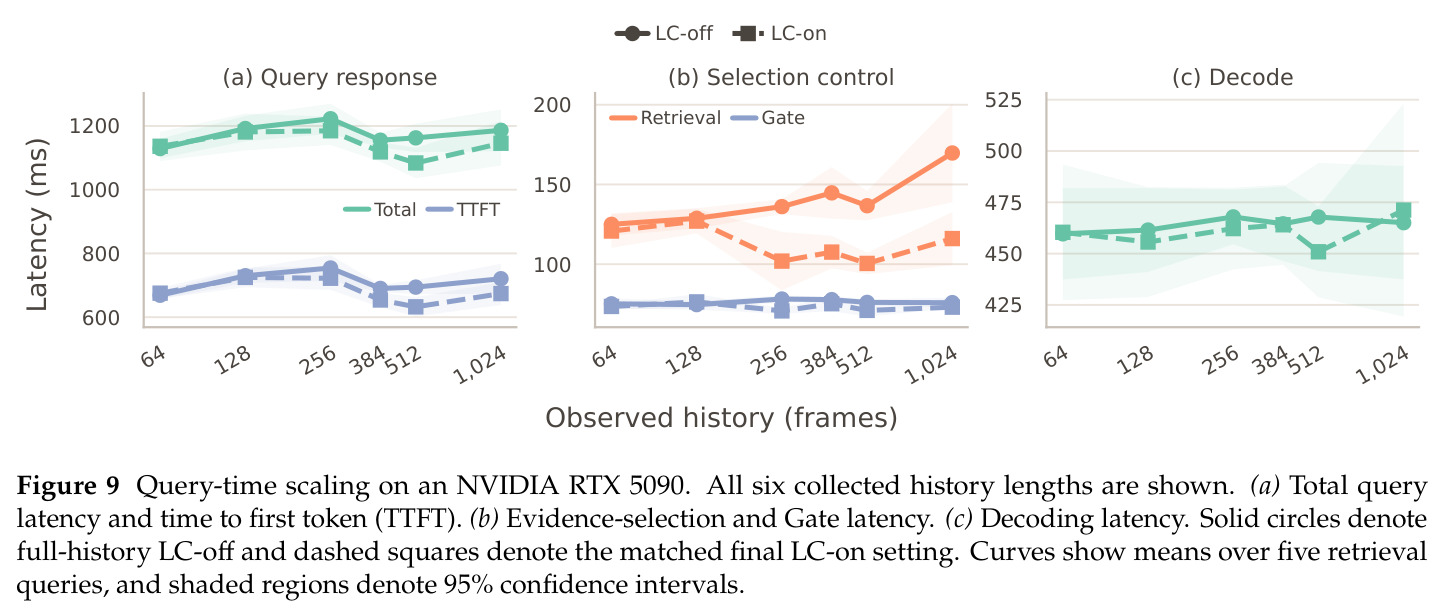
本文的目标是本文的目标是:在不做任何任务专用训练、不牺牲精度的前提下,把流式阶段的稳态成本从“全深度 prefill”降到“浅层 prefill”,并把昂贵的全深度计算严格推迟到查询时刻、只花在被检索出的相关证据上。量化目标是与最强流式方法性能持平的同时大幅降低每帧 prefill 与端到端延迟。最终达到的操作点是:OVO-Bench 上 Qwen3-VL-8B 变体达 69.5 分,与最强方法(OASIS 67.7)持平或更好;每帧 prefill 最高降低 52.1 倍、每 10 秒一个查询的端到端延迟最高降低 11.9 倍;配合可选长簇压缩,64–1024 帧长流下峰值 GPU 显存压平在约 18 GiB;80 秒查询间隔下总计算需求约 2.6 秒,远低于实时边界(HERMES 需 6.2 秒、OASIS 需 50.4 秒),从而为连续视频流建立一个高效且不失精度的运行点。
与已有工作不同的是,本文的独特切入是指出:现有工作全部聚焦于“视觉 token 数量”与“KV 缓存量”两个维度(剪枝、合并、量化、按需取帧、上下文 offload),而忽视了“模型深度”这一维度。作者的支撑观察是一个此前未被系统利用的实证现象:检索能力在浅层就已涌现——Qwen3-VL-8B 在第 4 层(共 28 层)、LLaVA-OneVision-7B 在第 3 层(共 32 层)就表现出很强的视频-问题匹配能力(Figure 2 在 LVBench 上验证),而流式 prefill 成本随深度持续增长($P=1$ 仅 9.47 ms/帧,$P=19$ 达 15.53 ms/帧)。既然浅层表示足以从长历史中选出与问题相关的视频单元,那么对流式阶段每一帧都执行全深度计算就是纯浪费:可以用浅层同时完成帧编码与检索索引构建,把模型深度作为一种“按需分配”的资源留给查询时刻被选中的证据。
核心方法
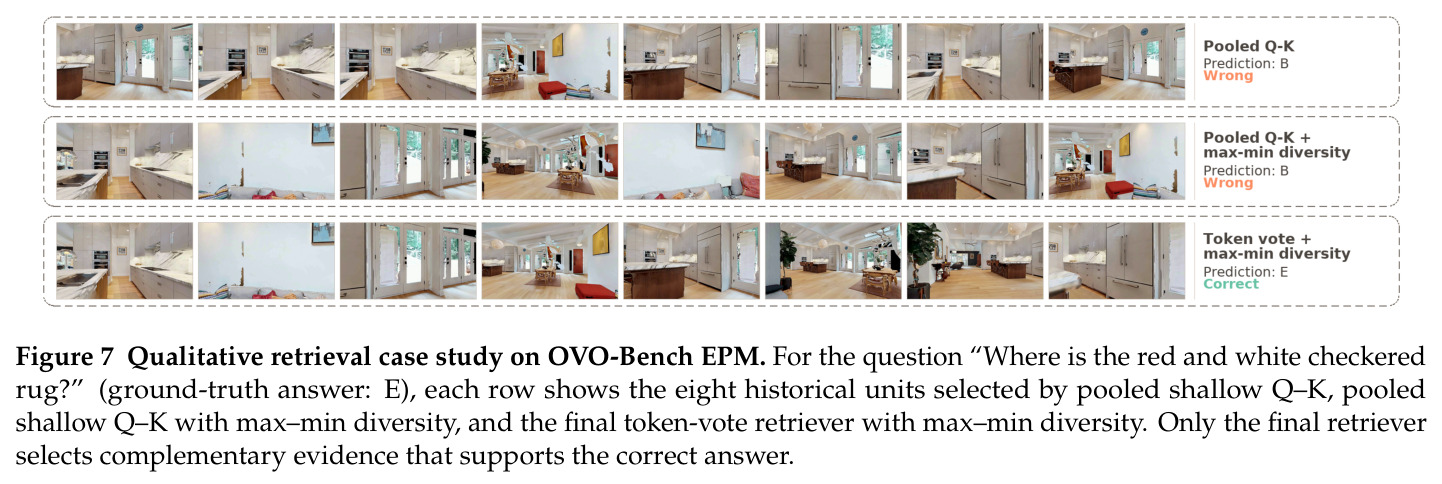
ShallowStream 把流式视频理解解耦为高频的“查询无关流处理”与低频的“查询期回答”。直觉是:流式阶段每帧编码只需服务两件事——知道“现在发生了什么”、为未来问题留一个可检索的索引——这两件事浅层就够了;全深度推理只发生在问题到来且证据被定位之后。技术路线:流处理阶段,每个视频单元 $x_t$ 经视觉编码器得 $H^0_t$,只通过浅层 $[0,P)$ 计算 $H^{i+1}_t, K^i_t, V^i_t = F_i(H^i_t; \mathcal{C}^i_{t-1})$,把浅层 KV 与输入级表示存入主机内存的轻量全历史索引(Qwen3-VL 取 $P=5$、LLaVA 取 $P=4$),可选长簇模块把久远历史压成固定尺寸代表。查询阶段三步:先用零训练的 query-logit 门控 $g(q)=\mathbb{1}[\ell_{ret}(q)-\ell_{recent}(q)\geq\tau_g]$ 判断是否检索历史;若激活,用浅层 Q-K token 投票加 max-min 多样性选出 $K=8$ 个证据单元;最后只对选中证据、近期上下文与问题执行全部 $L$ 层 prefill 并生成(上限 16 个新 token)。
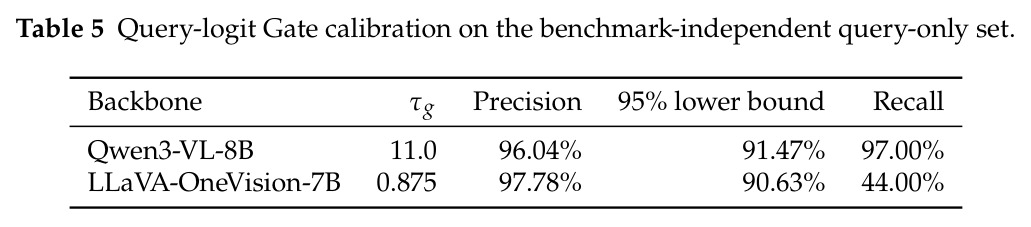
核心创新是“深度维度的解耦”:浅层持续建索引、深层按需做推理。与已有方法的本质区别有三。第一,与 KV 压缩方法(StreamMem、HERMES、InfiniPot-V)不同,它们先花满全深度计算再压缩缓存,成本无法追回;ShallowStream 从源头只跑 $P\ll L$ 层($P=5$ 时每帧 10.72 ms,比 $P=19$ 的 15.53 ms 省 31%),深层 KV 根本不存在,深层计算被推迟为“只对选中证据做一次完整 prefill”。第二,与按需检索方法(OASIS、WeaveTime)不同,它们需要答案级推理来路由、激活后还要二次推理;ShallowStream 的门控是单次纯文本前向中两个单 token 的 logit 差 $g(q)=\mathbb{1}[\ell_{ret}(q)-\ell_{recent}(q)\geq\tau_g]$,仅 92.7 ms,阈值在 200 条基准无关合成问题上按精度优先准则一次校准冻结(Qwen3-VL 精度 96.04%)。第三,浅层索引保留全历史的 token 级 KV 而非单元级单一相似度,检索是跨 $P$ 层的 token 投票加多样性选择,兼顾精确与互补覆盖。
方法步骤详情
方法分六步。步骤一(流式浅层 prefill):视频单元 $x_t$ 经视觉编码器得 $H^0_t$,只过浅层 $[0,P)$:$H^{i+1}_t, K^i_t, V^i_t = F_i(H^i_t; \mathcal{C}^i_{t-1})$,每帧 9.47 ms($P=1$)到 10.72 ms($P=5$)。步骤二(全历史缓存):存 $m_t=\{H^0_t,(K^i_t,V^i_t),t\}$ 到主机内存,用最后浅层 key 均值加 L2 归一化得描述子 $\boldsymbol{k}_t$;最新 $N_r$ 个单元为近期上下文,其余为历史。步骤三(可选长簇压缩):内存超预算 $B$ 时,$\boldsymbol{k}_t^\top\boldsymbol{c}_j\geq\tau$ 则并入簇并运行平均更新簇 KV,否则开新簇,每簇只留固定尺寸代表。步骤四(query-logit 门控):问题放入 10-shot 路由 prompt,单次文本前向比较选项 A(需历史)与 B(近期足够)的 logit 差与阈值 $\tau_g$(Qwen3-VL 11.0,LLaVA 0.875)。步骤五(证据检索):每浅层取最后 prompt token 的 Top-$M$=64 注意力 token,按单元累计投票 $v_t$,取 top-$4K$ 候选后做 max-min 多样性选出 $K=8$ 个单元并各扩展一个前驱。步骤六(选择性重 prefill 与生成):只把选中单元的 $H^0_t$(或簇代表)与近期上下文、问题拼装,从第 0 层执行全部 $L$ 层并生成至多 16 个新 token。
技术新颖性
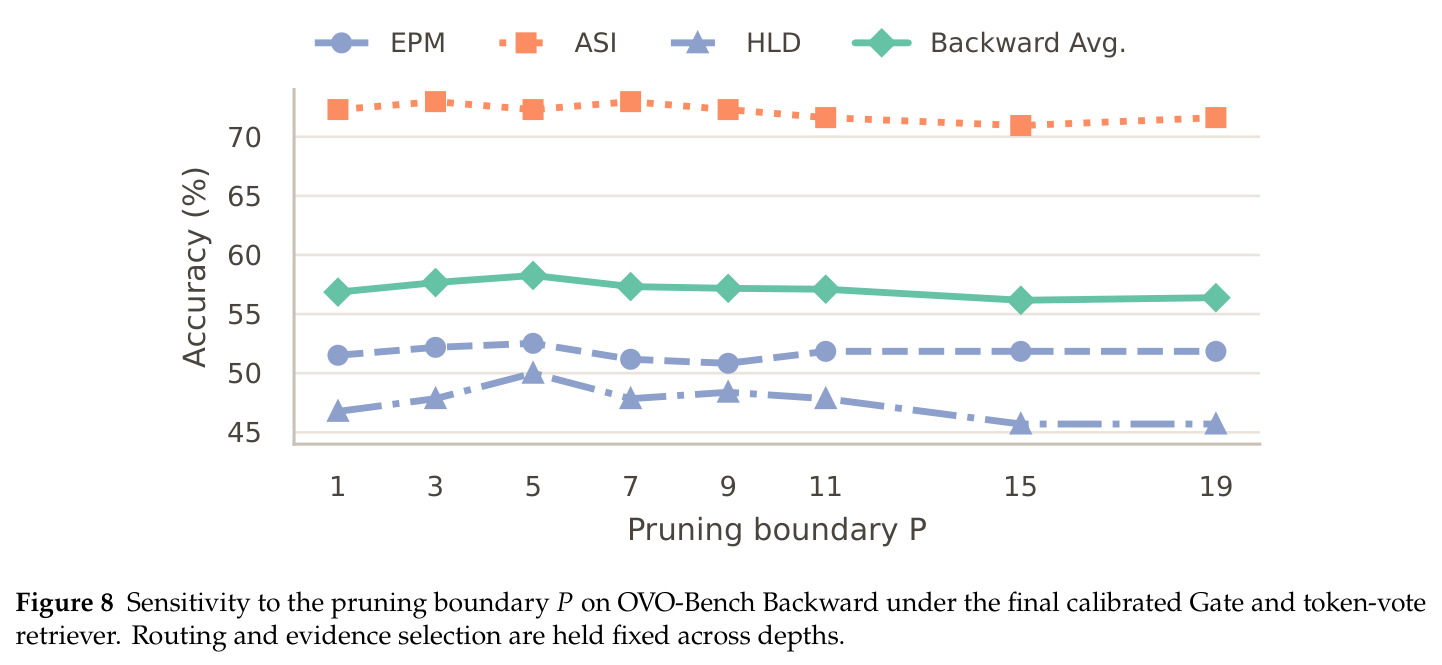
技术新颖性有四。一是首次把“模型深度”作为流式视频系统的首要优化维度,并用两组实验支撑“浅层即检索器”:LVBench 层扫描(Figure 2)显示检索能力在第 3–4 层涌现,OVO-Bench Backward 边界扫描(Figure 8)显示 $P=5$ 达最强 Backward 平均 58.27、加深到 $P=19$ 无收益。二是全历史浅层索引:以约 15% 层深维护完整时间线的 token 级 KV,配合固定尺寸簇代表,使 64–1024 帧范围峰值显存几乎恒定(约 18 GiB),区别于 ReKV 的全深度 KV offload 与 StreamMem 式有损压缩——既不丢细粒度证据信号,也不让显存随流长线性膨胀。三是零训练的 query-logit 门控:复用预训练模型输出空间中“A 需要更早记忆 / B 近期足够”的语义对立,用 200 条基准无关合成问题校准(附录 A.5、A.7 公开协议与 prompt),无需标签也无需训练路由器。四是检索算子组合的经验验证:token 投票(61.21%)优于池化 Q-K(57.47%)与 SigLIP(58.91%),多样性再增益(59.48%→59.77%)。
实验结果
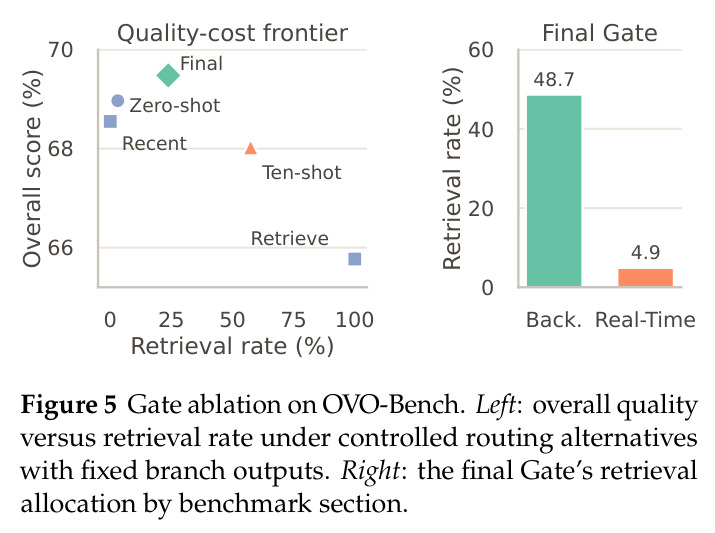
核心结果分四块。精度上,OVO-Bench(Table 1):Qwen3-VL-8B + ShallowStream 总平均 69.5,超 OASIS 67.7、SimpleStream 66.4、HERMES 57.2 与裸骨干 54.7;Real-Time 平均 80.9(OCR 92.0、ACR 83.5),Backward 平均 58.1(HLD 49.5 为各组最高,ASI 72.3 超 OASIS 的 60.1);LLaVA 变体 62.2,超 SimpleStream 60.3 与 HERMES 58.1。StreamingBench(Table 2):Qwen3-VL 变体 78.2 超 HERMES 76.6 与 SimpleStream 76.5;LLaVA 变体 75.5。效率上(Figure 1、4、9):单张 RTX 5090 上每帧 prefill 最高降 52.1 倍、10 秒端到端延迟降 11.9 倍;长簇压缩使 64–1024 帧前缀峰值显存稳定在约 18 GiB(无压缩 21.76 GiB);80 秒查询间隔仅需约 2.6 秒计算,对比 HERMES 6.2 秒、OASIS 50.4 秒;单次查询 1.759 秒中门控仅 92.7 ms、证据选择 106.0 ms。分析实验:$P=5$ 的 Backward 平均 58.27,比 $P=19$ 省 31% 每帧 prefill;门控在 Backward 与 Real-Time 上检索率显著分化,证明按需检索。
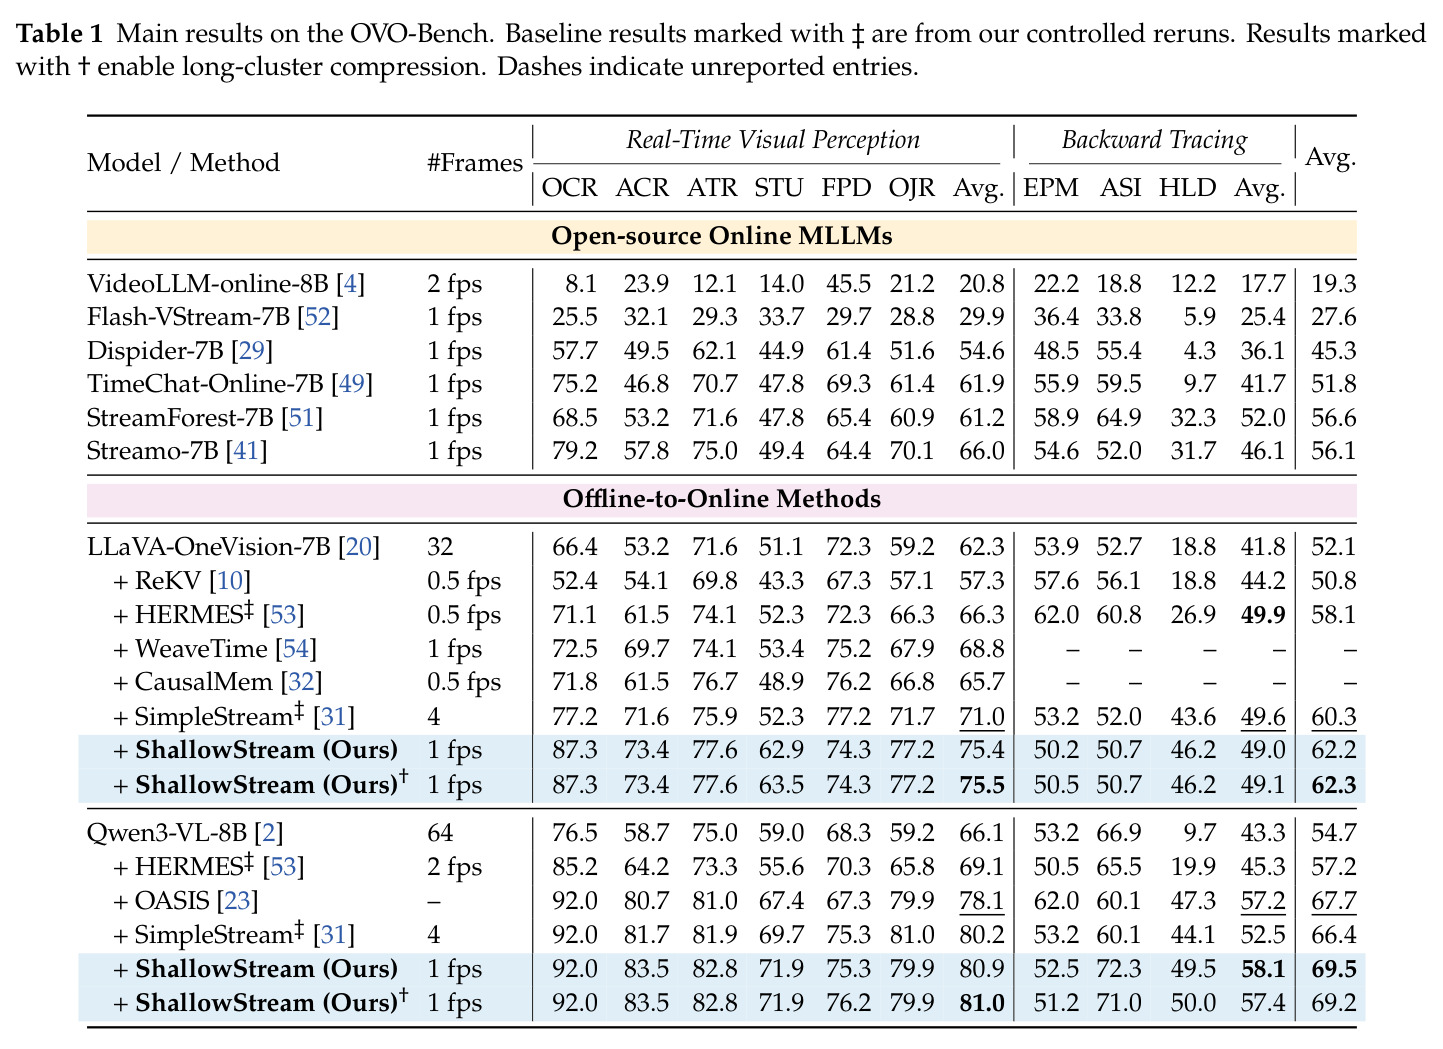
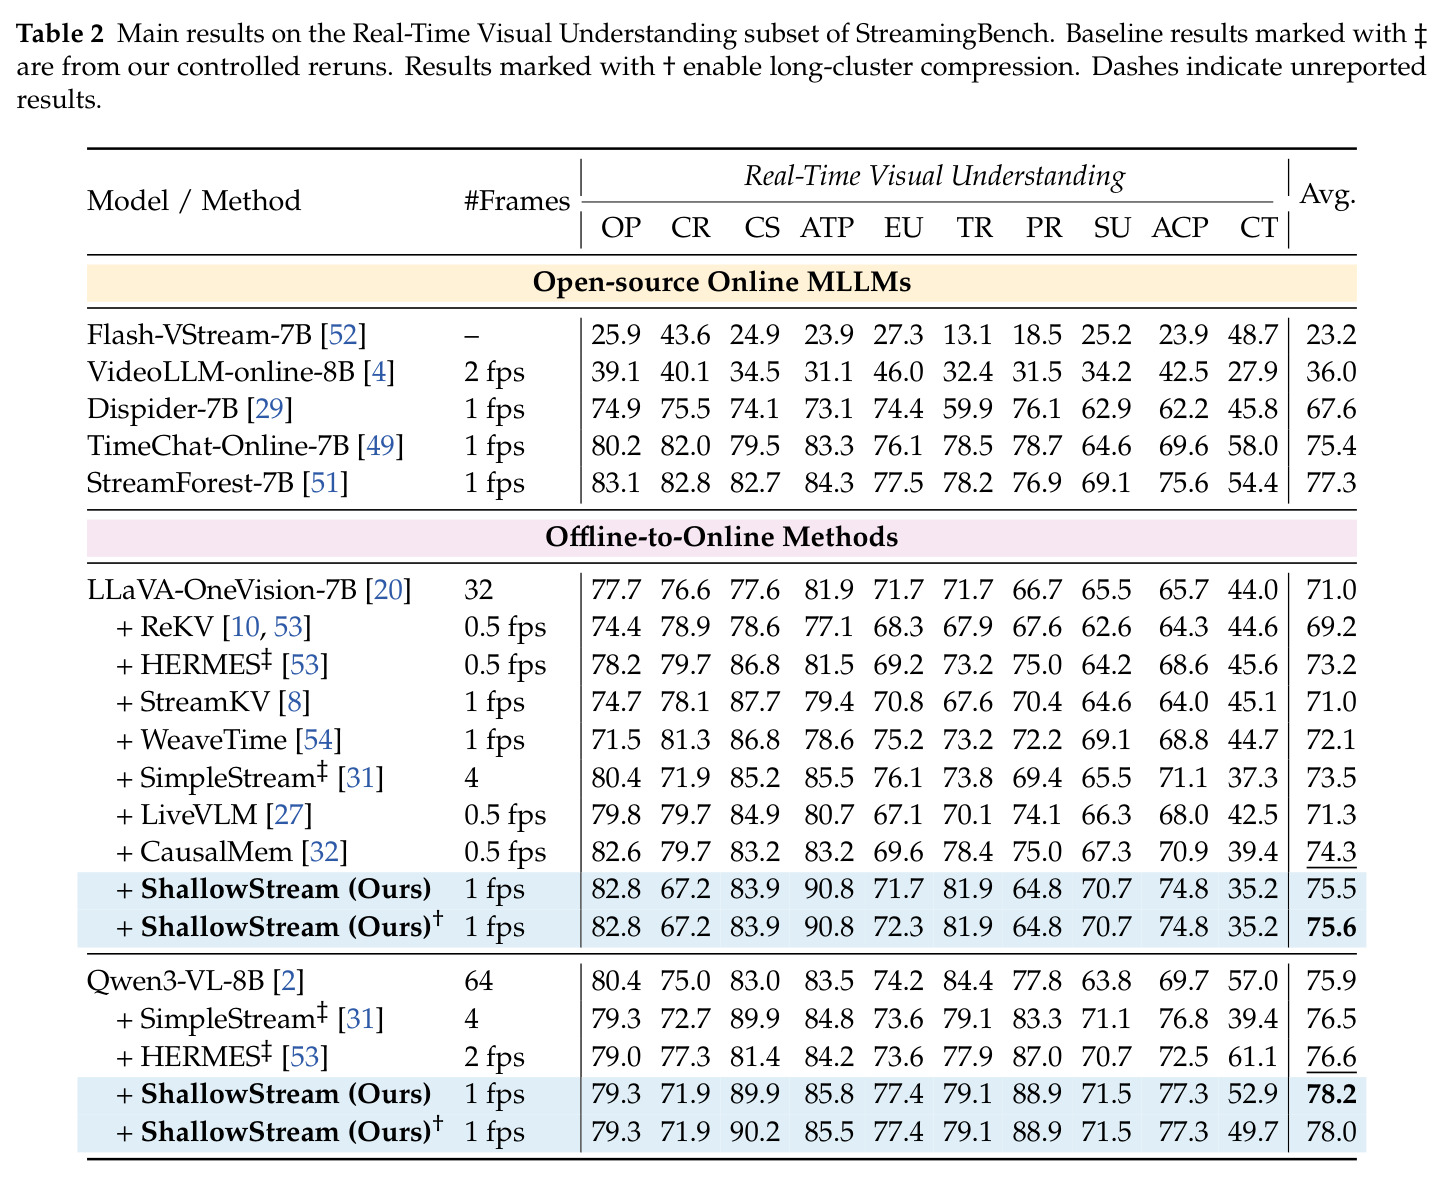
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OVO-Bench 全平均(Qwen3-VL-8B 骨干) | 总平均准确率 (%) | ShallowStream 69.5(开长簇压缩 69.2) | OASIS 67.7、SimpleStream 66.4、HERMES 57.2、裸 Qwen3-VL-8B 54.7 | 较最强基线 OASIS +1.8,较裸骨干 +14.8 |
| OVO-Bench 全平均(LLaVA-OneVision-7B 骨干) | 总平均准确率 (%) | ShallowStream 62.2 | SimpleStream 60.3、HERMES 58.1、裸 LLaVA-OneVision 52.1 | 较最强基线 SimpleStream +1.9,较 HERMES +4.1 |
| StreamingBench 实时视觉理解(Qwen3-VL-8B 骨干) | 十子任务平均准确率 (%) | ShallowStream 78.2 | HERMES 76.6、SimpleStream 76.5、裸 Qwen3-VL-8B 75.9 | 较最强基线 HERMES +1.6 |
| 连续流每帧 prefill 开销 | 归一化加速比 | 最高 52.1× 降低($P=5$ 时 10.72 ms/帧) | 代表性全深度流式方法(HERMES、OASIS 等) | 最高 52.1 倍 |
| 每 10 秒一次查询的端到端延迟 | 归一化加速比 | 最高 11.9× 降低 | 代表性流式方法 | 最高 11.9 倍 |
| 80 秒查询间隔下总计算需求 | 5 条长视频平均计算时间 (s) | 约 2.6 s(LC-on 与 LC-off 均如此) | HERMES 6.2 s、OASIS 50.4 s | 较 HERMES 快 2.4 倍、较 OASIS 快约 19 倍,均低于实时边界 |
| 64–1024 帧长流显存扩展 | 峰值 GPU 显存 (GiB) | 长簇压缩下约 18 GiB 且近乎平坦 | 无压缩 21.76 GiB,HERMES/OASIS 在长前缀下更高 | 显存随流长几乎零增长 |
局限与改进
作者承认这是 Work in Progress,并明确说明门控阈值是 backbone 特定的(Qwen3-VL 11.0 vs LLaVA 0.875),长簇压缩是近似——查询只消费单个簇代表而不还原簇成员。从数据看还有更深的局限:其一,LLaVA 门控召回仅 44.00%,意味着过半需要历史的追溯性问题只会拿到近期上下文,硬路由错判后无法恢复。其二,Backward 内部不均衡:EPM 仅 50.2–52.5,明显低于 OASIS 的 62.0,说明稀疏的 8 单元检索对“某事何时发生”类时间定位仍有短板。其三,回答阶段要从第 0 层重跑全部 $L$ 层(查询 1.759 s),浅层状态只用于检索、不能直接续写生成,固定 $K=8$ 加一个前驱扩展的证据预算对需大范围拼合证据的问题可能不足。其四,评估固定 1 FPS、16 个可见答案 token、仅 7B/8B 两个 backbone,跨模型与跨分布泛化未系统验证,也未讨论多路视频并发服务。其五,门控校准集虽与基准无关但由生成式 AI 合成,分布偏移对阈值的影响未量化。
独立分析的弱点
独立分析几个弱点。第一,门控的单点故障性:$g(q)$ 是硬路由,错判为 B 就永久失去历史证据机会,LLaVA 上 44.00% 的召回率在重追溯任务上直接构成精度上限,可把 logit 差当软权重同时喂给近期与检索分支,或在不确定带内双分支并行。第二,证据预算静态:$K=8$ 加一个前驱扩展对所有问题一视同仁,对“总结整场活动”类需广覆盖的问题不够,对“某个瞬间细节”类又浪费预算,可按门控 logit 差或问题类型自适应调整 $K$。第三,查询期重 prefill 的延迟下限:即使检索命中也要从输入重算全部 $L$ 层,1.759 s/查询在强交互场景偏慢,可探索以浅层状态为 draft 的推测解码,或逐层加深、按置信提前退出。第四,超参数耦合:浅层打分依赖复用 ReKV 的注意力 sink 窗口,$P$、$\tau_g$ 都是 backbone 特定值,换模型需重调,可研究自动选 $P$ 的无校准准则。第五,索引只覆盖视觉模态,未融合音频或字幕,且 EPM 类时间定位弱提示需要时间戳感知的检索特征。
未来方向
作者提出但未展开的方向:与流式专用训练方法(Streamo、StreamForest、StreamFormer 的因果时序注意力)结合,让浅层表示天生带检索能力;把门控推广到附录 A.1 讨论的主动交互场景(StreamMind 的事件触发调用、StreamBridge 的主动响应),即“何时调用深度计算”的通用机制。基于本文成果可自然延伸的研究:其一,把长簇压缩从时间相邻聚类升级为事件/语义级聚类,形成 EventMemAgent 式结构化长期记忆;其二,检索式 KV 复用——用浅层 KV 加少量深层修正近似全深度注意力,避免完整重 prefill,把查询延迟从 1.759 s 进一步压缩;其三,在线校准与持续适应,让 $\tau_g$、$P$、$K$ 随流分布漂移自适应更新,解决 LLaVA 低召回问题;其四,多用户并发流的系统级优化——浅层索引天然适合作为 GPU 常驻的轻量共享状态,可研究调度与批处理;其五,把 token 投票检索器迁移到离线长视频 agent 框架(VideoTree、WorldMM)作为廉价的第一阶段召回,以及扩展到音频-视觉联合索引的多模态流。
复现评估
复现条件良好。代码与实验配置承诺开源在 https://github.com/CURRENTF/ShallowStream;实现基于 PyTorch + Hugging Face Transformers + FlashAttention-2,骨干为公开的 Qwen3-VL-8B-Instruct 与 LLaVA-OneVision-7B;评测基准 OVO-Bench、StreamingBench、LVBench 全部公开,部分基线(HERMES、SimpleStream 等,表中以 ‡ 标注)为作者受控重跑,保证同协议可比。附录 A.2 给出完整配置表($P$、采样率、视频单元、流式窗口、门控阈值、检索预算等),附录 A.5、A.7 公开门控校准协议与完整 10-shot 路由 prompt。效率实验只需单张 NVIDIA RTX 5090,显存峰值约 18 GiB,普通实验室即可负担。主要工程难点在于浅层 KV 的主机内存归档、按单元注意力重构与选择性重 prefill 的上下文拼装,属中等工作量;校准集 200 条合成问题需自行复刻,阈值可能略有出入;方法免训练。
论文图表
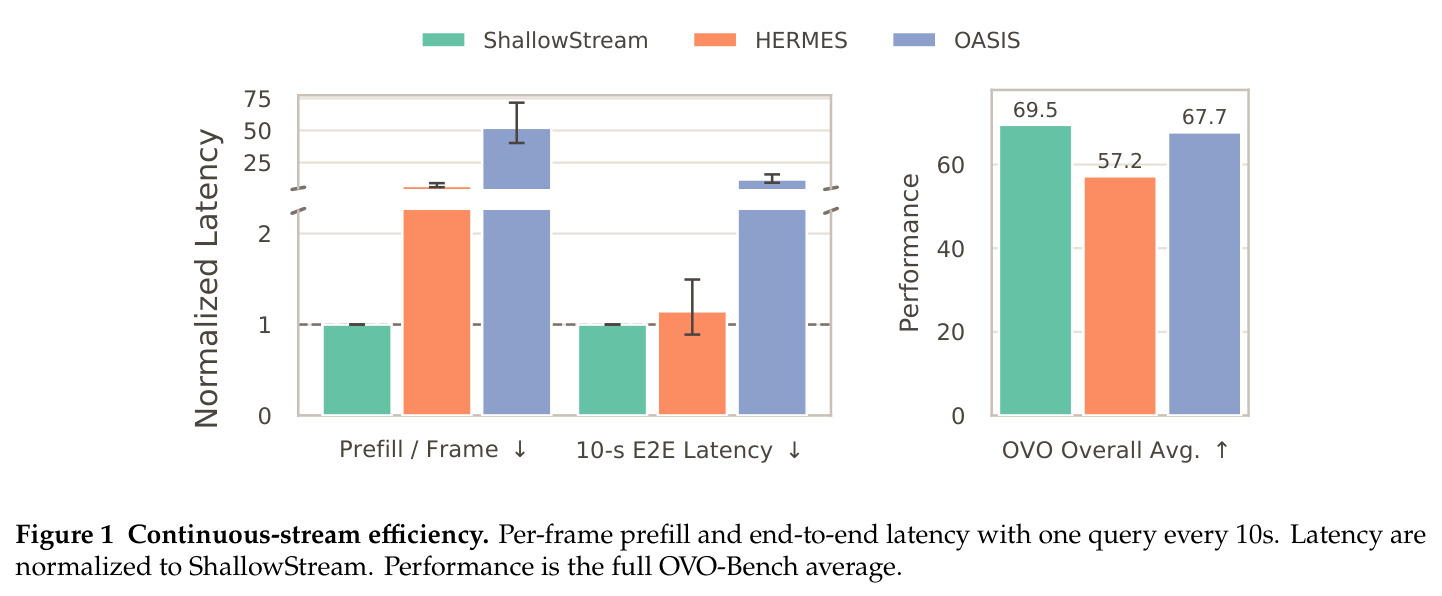
三联柱状图对比 ShallowStream、HERMES、OASIS:每帧 prefill 时间、每 10 秒一次查询的端到端延迟(归一化到 ShallowStream)以及 OVO-Bench 全平均性能。ShallowStream 性能 69.5 高于 HERMES 57.2 与 OASIS 67.7,同时每帧 prefill 与端到端延迟分别最高降低 52.1 倍和 11.9 倍。
一图概括论文核心卖点——精度持平或超过最强流式方法的同时,效率提升一到两个数量级,是理解论文动机与贡献定位的入口。
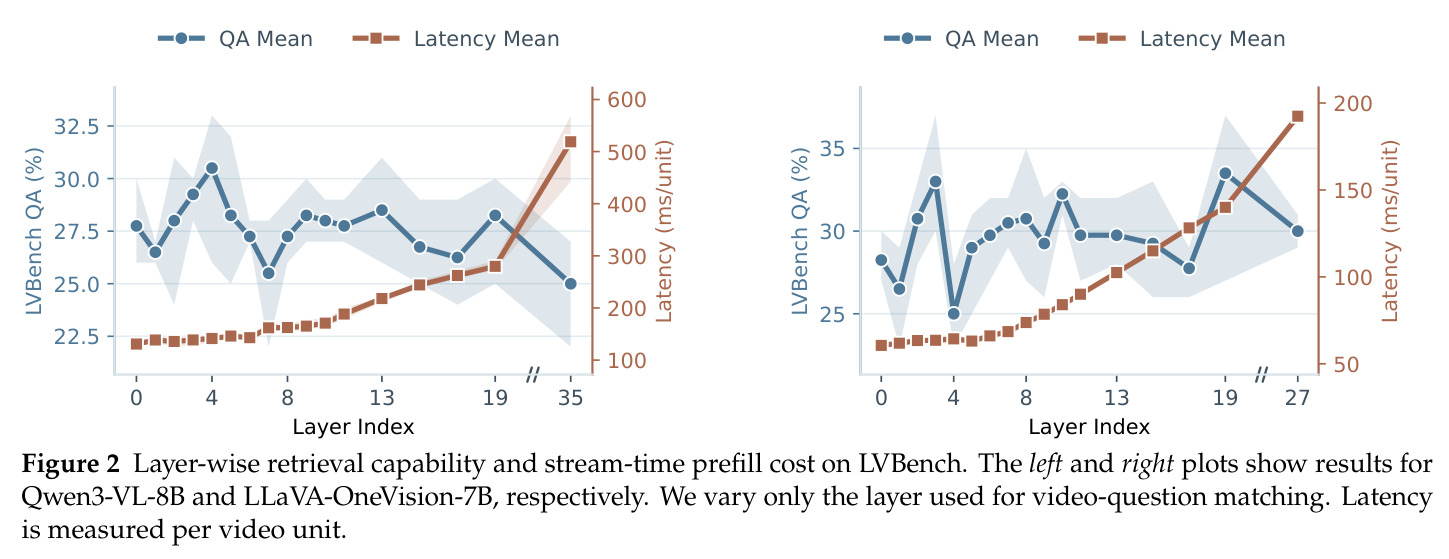
在 LVBench 上只改变用于视频-问题匹配的层,绘制检索 QA 均值与每单元流式 prefill 延迟:Qwen3-VL-8B 第 4 层(共 28 层)、LLaVA-OneVision-7B 第 3 层(共 32 层)的检索精度已接近最优,而成本随层深持续上升。
这是全文的核心观察——“浅层已足够做检索器”,直接支撑把流式 prefill 剪到浅层、把深度留给查询期的关键设计决策。