基于文字感知混合专家的全合一多语种场景文本识别 All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts
单模型覆盖10种文字229种语言,ScriptMoE准确率超越逐语言专家系统与大型VLM
前置知识
场景文本识别(STR)
从自然场景照片中读取文字的任务:输入含文字的裁剪图,输出文本串,需要同时对抗复杂背景、透视畸变、弯曲排版、光照变化与低分辨率。主流范式按解码方式分两大类:自回归(AR,逐字符生成,带语言先验但慢)与非自回归(NAR,一步并行输出,快但语言先验弱)。
这是本文的任务本身,所有实验指标(词准确率、1−NED)与15个STR对比基线都围绕它展开。
混合专家(MoE)
把Transformer中的稠密FFN替换为多个并列的“专家”网络,由路由器为每个输入计算softmax分数,只激活得分最高的Top-K个专家,其余专家参数闲置。这样总参数量可以很大,但每个样本的实际计算量可控,是大模型扩容的常用手段(如Mixtral)。
ScriptMoE的核心架构,理解图像级路由、Top-2激活、专家分组等所有设计都依赖MoE的基本机制。
共享专家(Shared Expert)
MoE中始终激活、不参与路由的公共FFN,负责吸收所有输入样本共用的通用知识;与按输入激活的路由专家互补,防止各专家各自为战、公共知识被碎片化。这是DeepSeek-MoE等工作推广的设计。
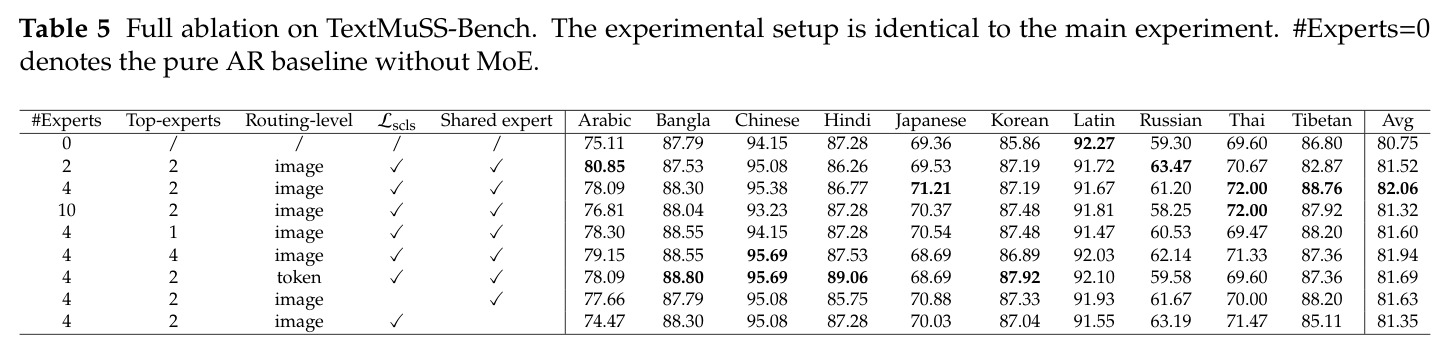
论文消融显示去掉共享专家平均掉0.71%,低资源文字阿拉伯语和藏文各跌约3.6个点,是方法不可缺少的组件。
词准确率与1−NED
词准确率(word accuracy)要求预测串与真值完全一致才计为正确,是最严格的应用导向指标;归一化编辑距离(NED)衡量两个字符串的字符级差异,1−NED越高表示字符级越接近。二者配合给出“整串全对率”与“接近程度”两个互补视角。
论文所有精度结论都用这两个指标表述,例如平均82.06%的词准确率对应1−NED为0.91。
合成数据引擎
在无文字的背景图上按布局模板渲染文本,并叠加阴影、扭曲、透视等效果,批量生成带精确标注的训练样本的技术。当某语言真实数据缺失时,它是保证语言覆盖、类别均衡与场景多样性的最实际手段,UnionST、SynthText是代表。
本文TextMuSS-10M的1000万样本全部由改造后的UnionST引擎合成,是论文数据贡献的基石。
端到端OCR(检测+识别)
完整OCR流水线先用检测器框出图中文本区域,再把裁剪出的文本图送入识别器转写。两个模块的误差会串联累积,因此在固定检测器的前提下,识别器的提升可以直接反映在整体F1上。CC-OCR是该设置下常用的多语种评测基准。
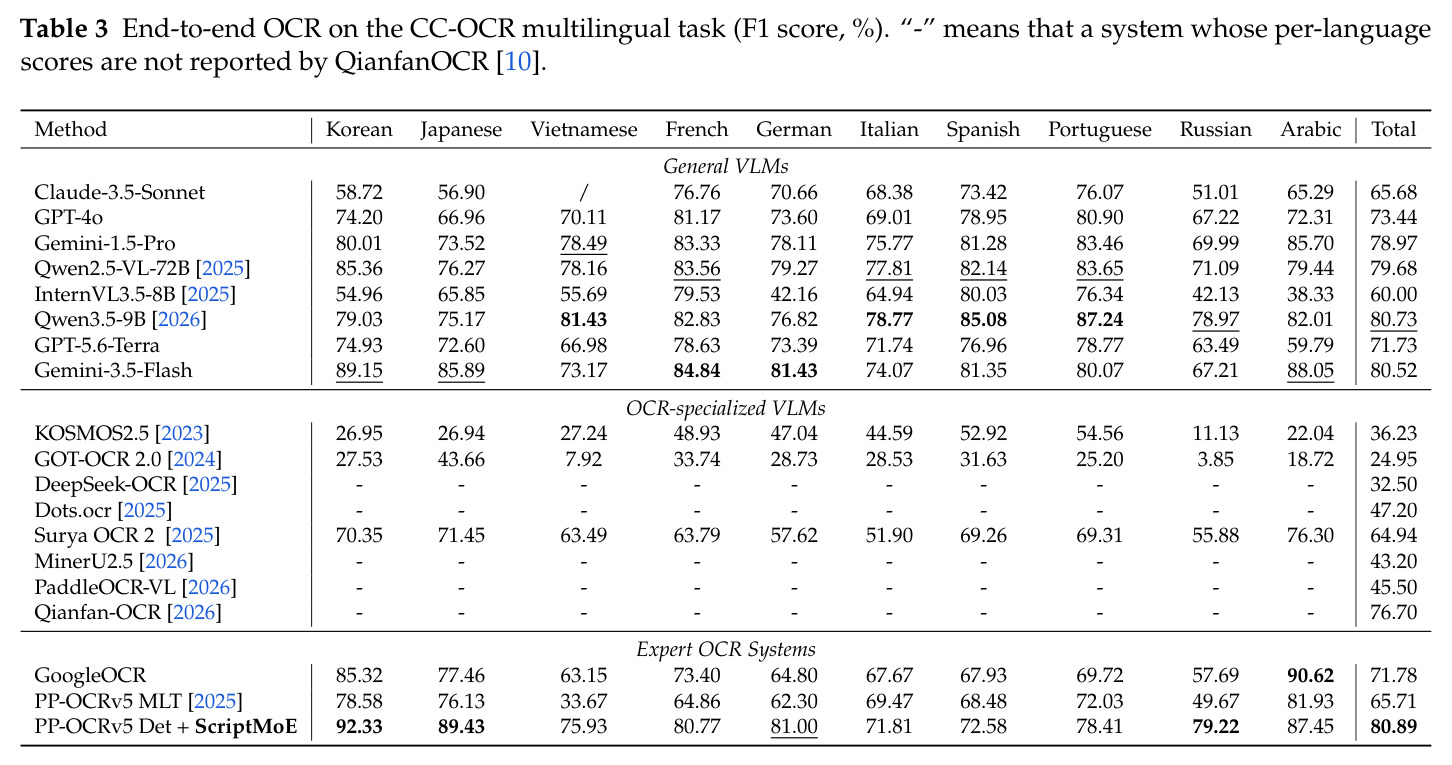
论文用固定PP-OCRv5检测器、只替换识别器的实验设计来隔离识别增益,F1从65.71%提升到80.89%。
研究动机
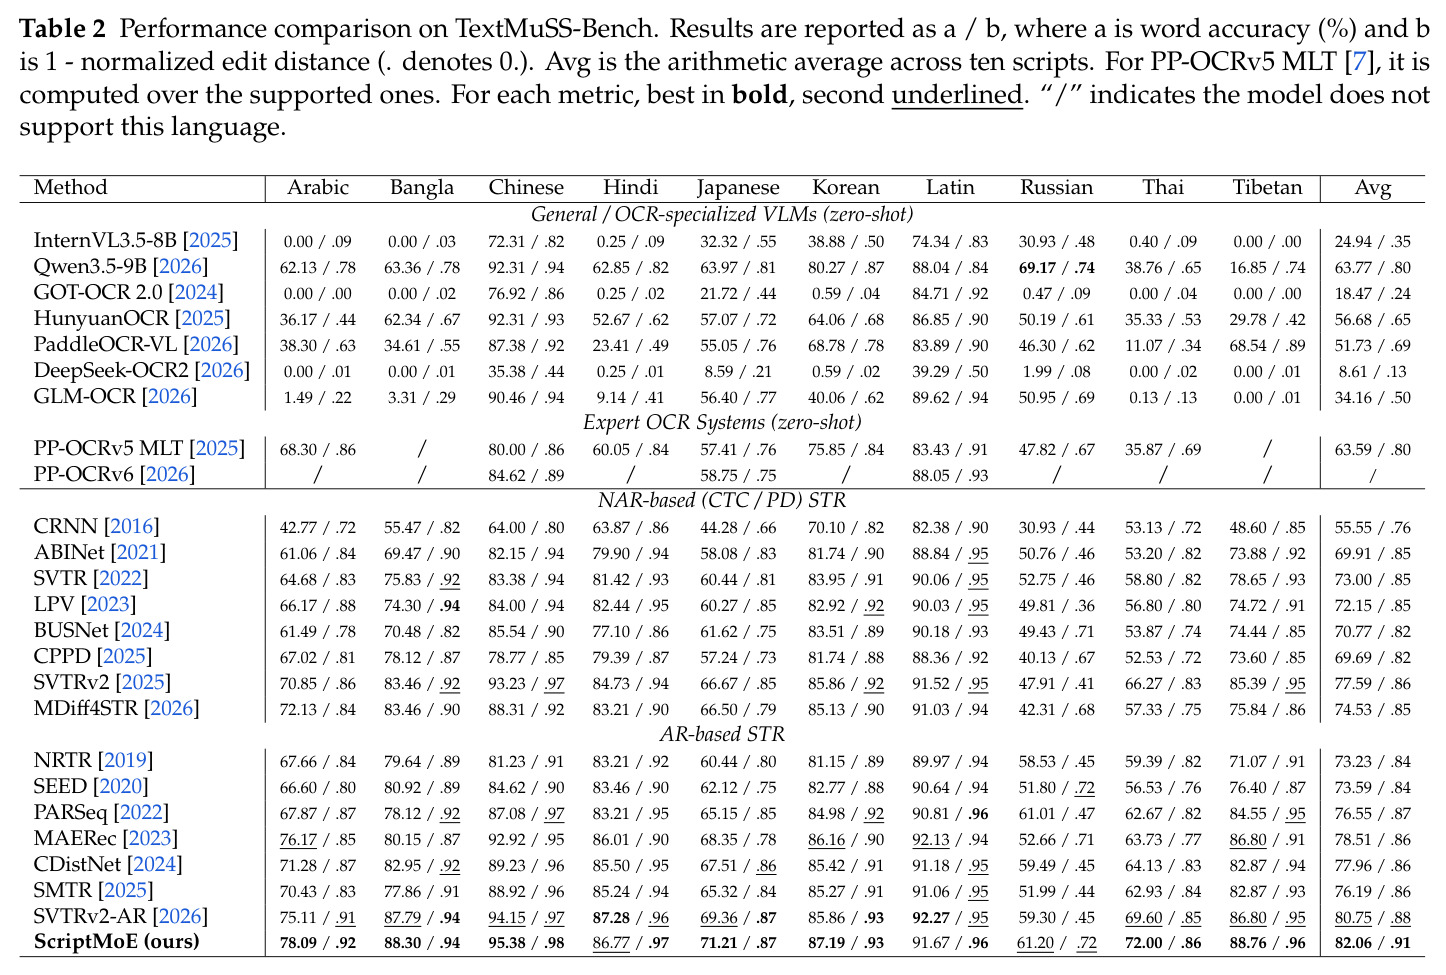
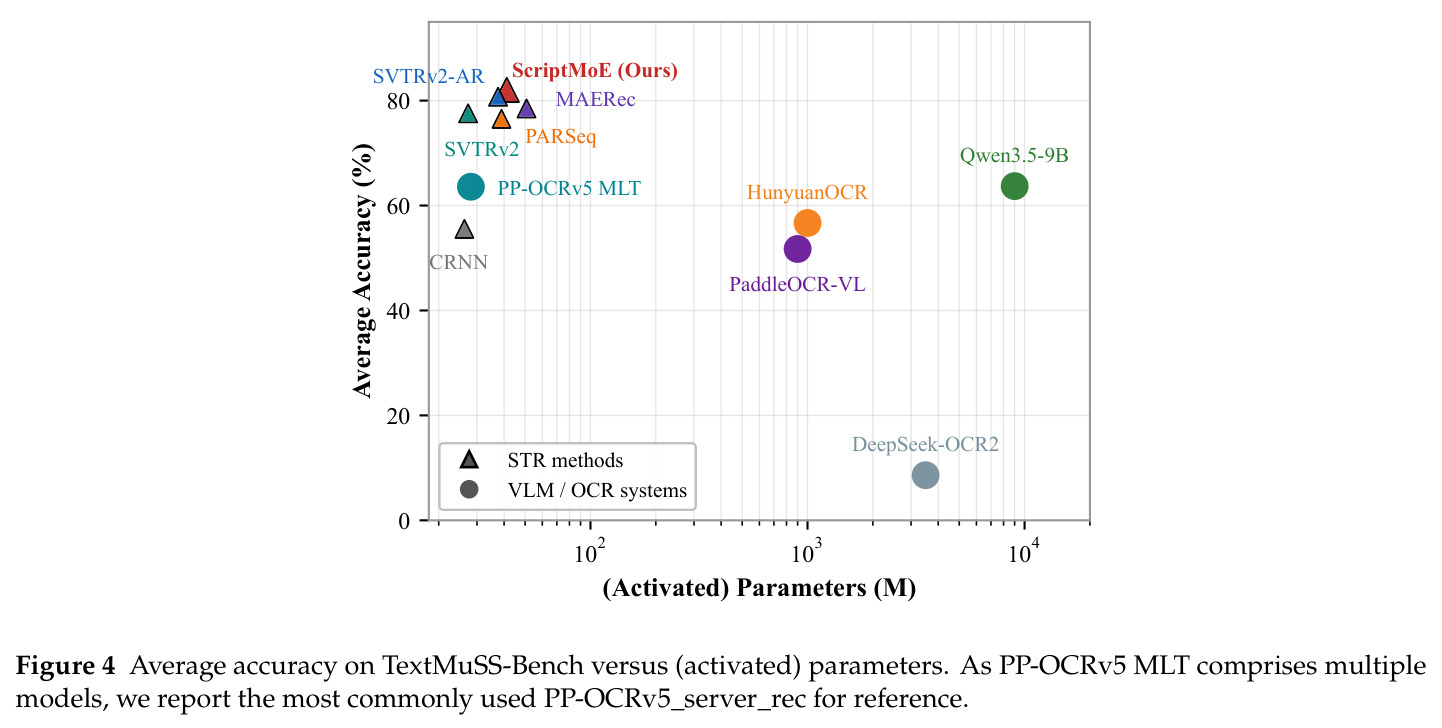
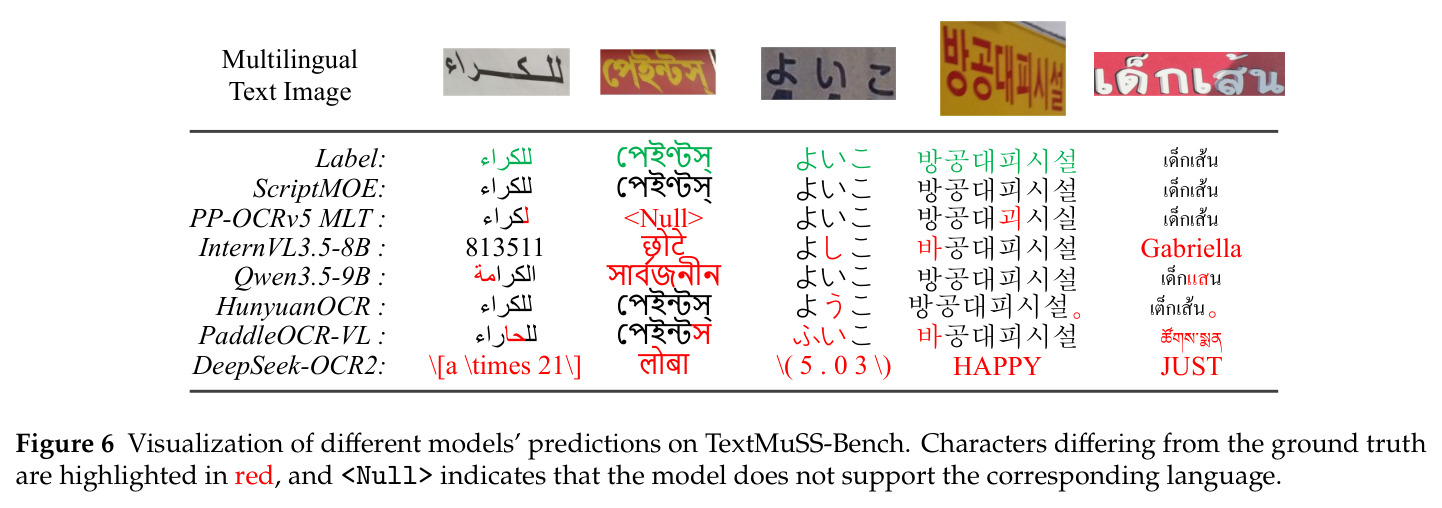
多语种场景文本识别长期被两道坎卡住。第一道是部署路线的困境:专家OCR系统沿用“一语言一识别器”的方案,例如PP-OCRv5 MLT用约十个按文字划分的模型覆盖106种语言,还需要额外的语言分类器为每张文本裁剪图选路,一旦语言分类出错下游无法挽回,训练与维护成本随语言数线性膨胀;另一条路是通用视觉语言模型(VLM),如Qwen3.5-9B、InternVL3.5-8B、GOT-OCR 2.0,参数量比STR模型大一到两个数量级,边缘部署困难,而且实测仍不准——在10种文字的评测上InternVL3.5-8B平均词准确率仅24.94%,DeepSeek-OCR2只有8.61%,GOT-OCR 2.0在阿拉伯语、孟加拉语、藏文上直接得0.00%。第二道是数据的坎:高质量真实STR数据高度集中于英语(Union14M)和中文(BCTR),其余文字几乎没有大规模真实语料,老牌合成集SynthMLT规模小、只覆盖10种语言,在其上训练的模型平均准确率仅47.94%。
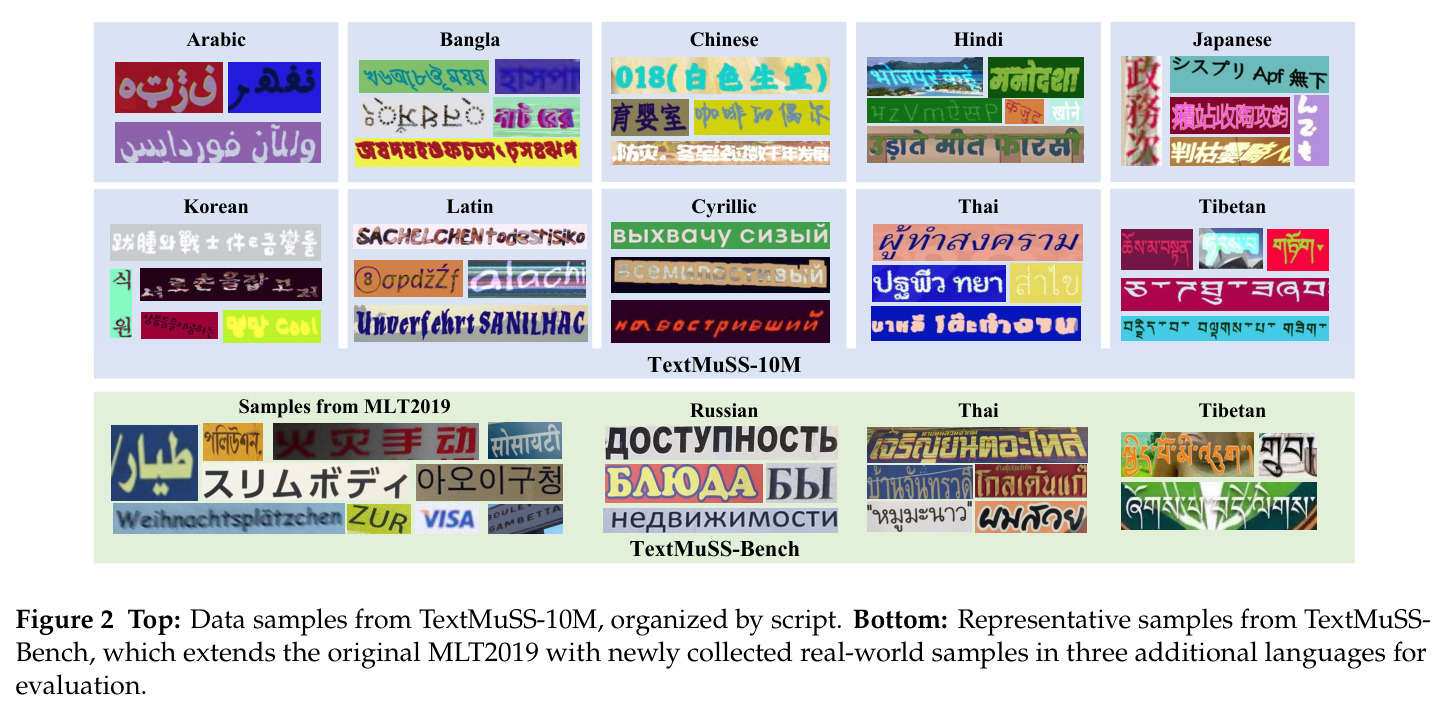
本文的目标是论文的目标是构建一个“全合一”(all-in-one)的多语种场景文本识别器:用单个模型覆盖10种代表性文字——拉丁、西里尔、中文、日文、韩文、阿拉伯文、天城文(印地)、孟加拉文、泰文、藏文——从而表示229种语言,并同时满足三个约束:比逐语言专家系统更简单(无需语言识别与多模型路由)、比VLM更轻(存储45.85M参数、每图激活41.13M,比通用大模型少一到两个数量级)、精度上比两者都高。为实现该目标,作者设定两条互补路径:数据上构建每文字100万样本、共1000万样本的均衡合成集TextMuSS-10M弥补真实数据缺失;模型上设计文字感知的稀疏MoE解码器ScriptMoE,让有限的参数预算按文字特化,而不是被所有文字均摊。
与已有工作不同的是,论文最独特的切入点是一个简单却未被充分利用的先验:“一图一文字”(single-image-few-script)——自然场景中的一条文本几乎只属于一种文字,最多中西混排。这意味着识别器不需要一个“同时精通所有文字”的稠密解码器,只需要“切换到正确专家”的能力,因此混合专家MoE是天然匹配:路由器面对的几乎总是无歧义决策。与增量式多语言识别MRN/IMLTR为每种语言维护独立特征提取器和分类头(参数随语言数线性增长)不同,ScriptMoE共享单一视觉编码器,按字形相似度把10种文字聚成4个专家组,用图像级路由一次决策服务整张图的所有输出token;与VLM路线不同,它把文字知识显式编码进专家分工,而非隐式压进百亿参数。“文字分组+图像级路由+常开共享专家”的组合是本文区别于已有工作的本质。
核心方法
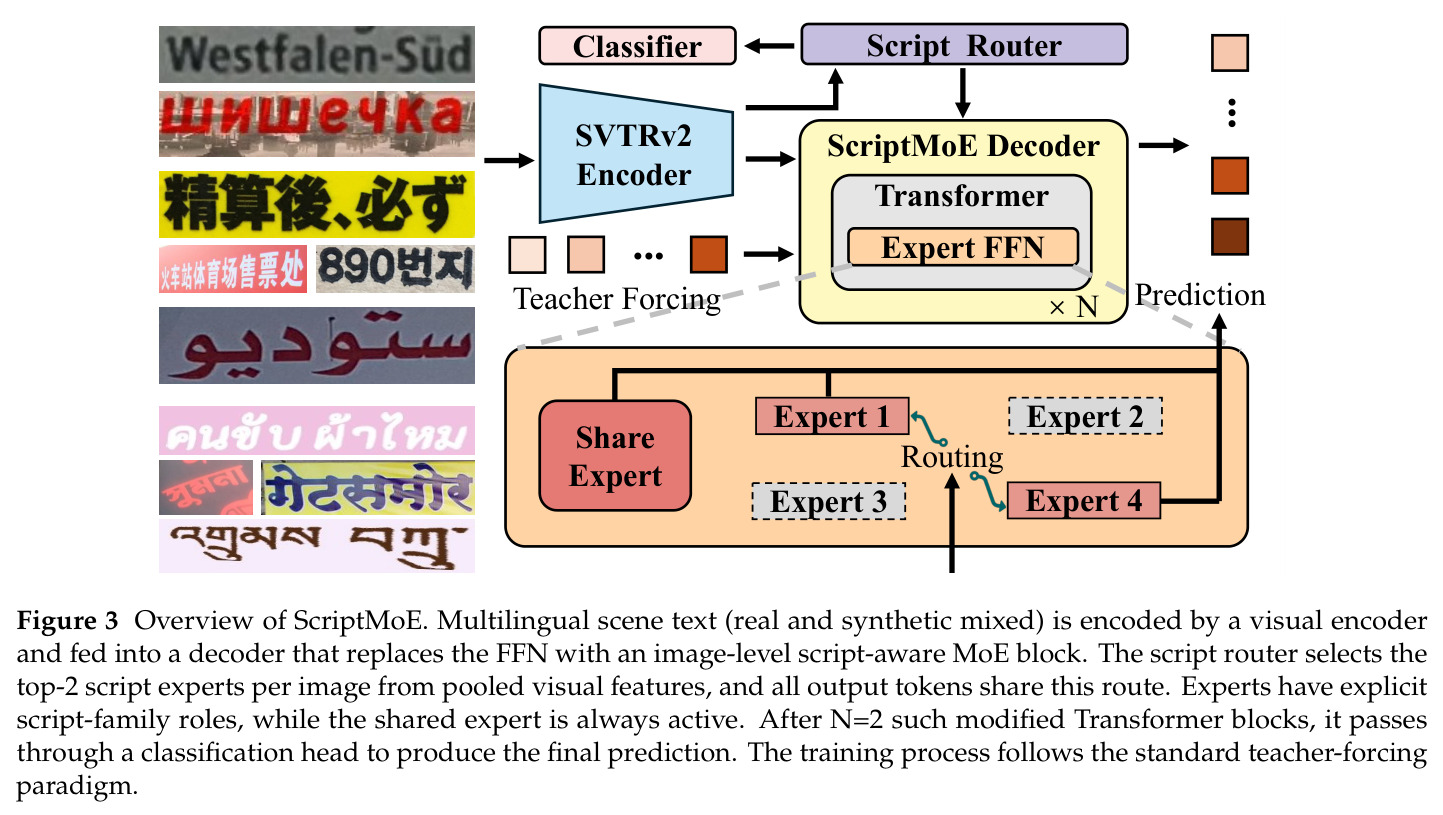
方案分数据与模型两条线。数据线:改造合成引擎UnionST,为10种文字各合成100万张场景文本图构成TextMuSS-10M,覆盖229种语言;语料按比例混合40%真实词表、20%字符乱序词、20%稀有字符过采样词、20%新闻句子,用8k背景图配合水平/垂直/旋转/弯曲模板渲染并叠加阴影、扭曲、透视效果,中日韩竖排占20%,阿拉伯文从右向左渲染。模型线:ScriptMoE用SVTRv2编码器输出视觉token序列$F$,接2层Transformer自回归解码器并把FFN替换为文字感知MoE:对视觉token均值池化得到图像级路由输入$\bar{F}$,路由器$p=\mathrm{softmax}(W_g\bar{F})$选出Top-2文字组专家,外加常开的共享专家,两支由可学习门$\alpha_t=\mathrm{sigmoid}(w_s^\top h_t)$加权求和,路由专家按门控$g_i$归一化混合;训练目标$\mathcal{L}=\mathcal{L}_{ar}+0.1\mathcal{L}_{scls}$,即自回归交叉熵加4分类文字组辅助损失。
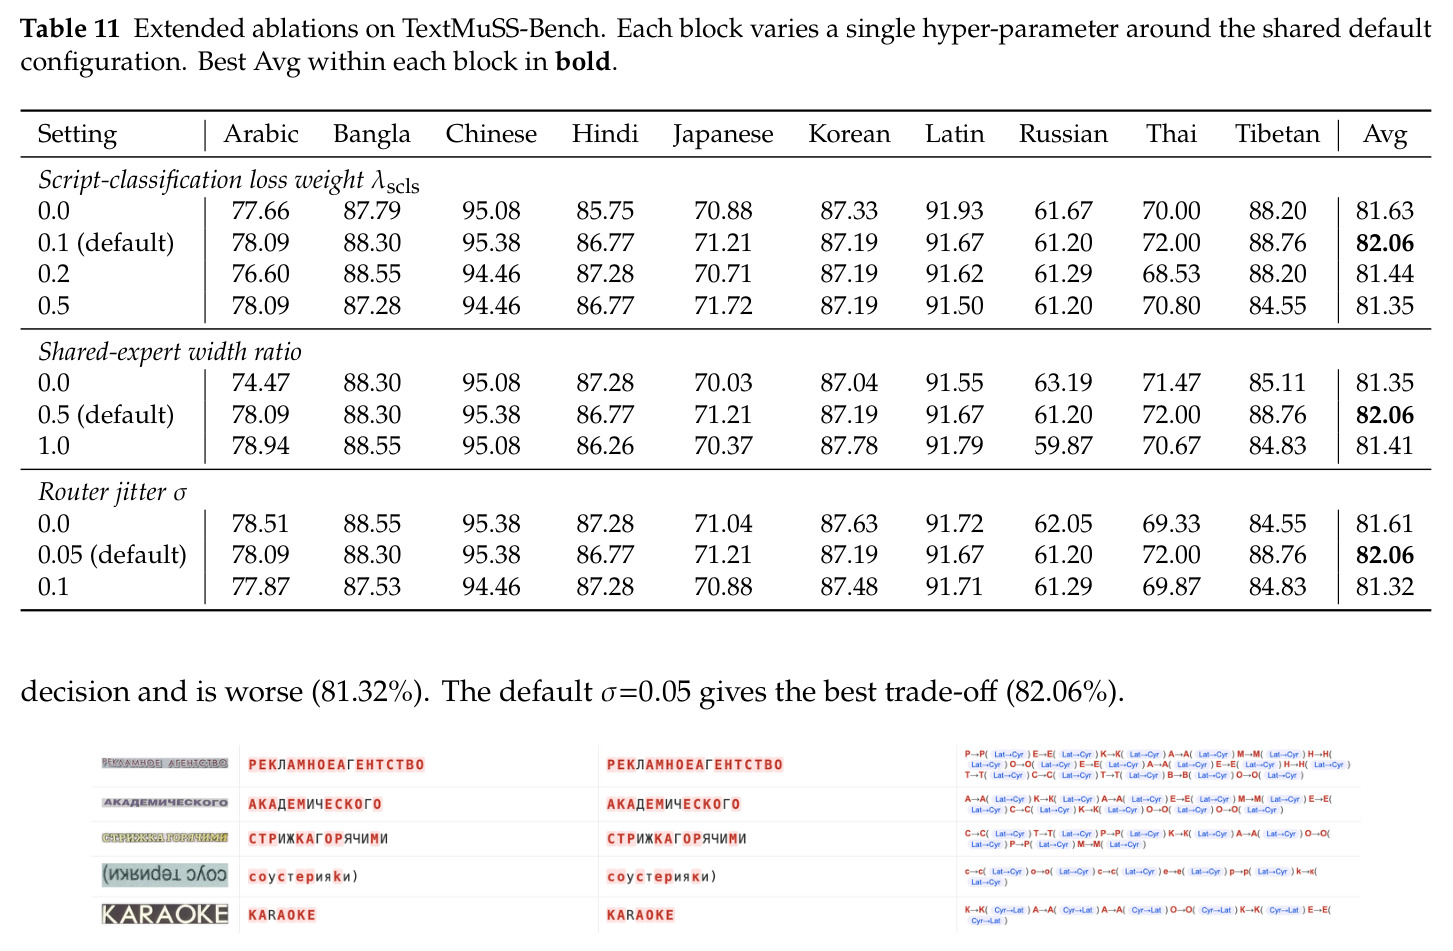
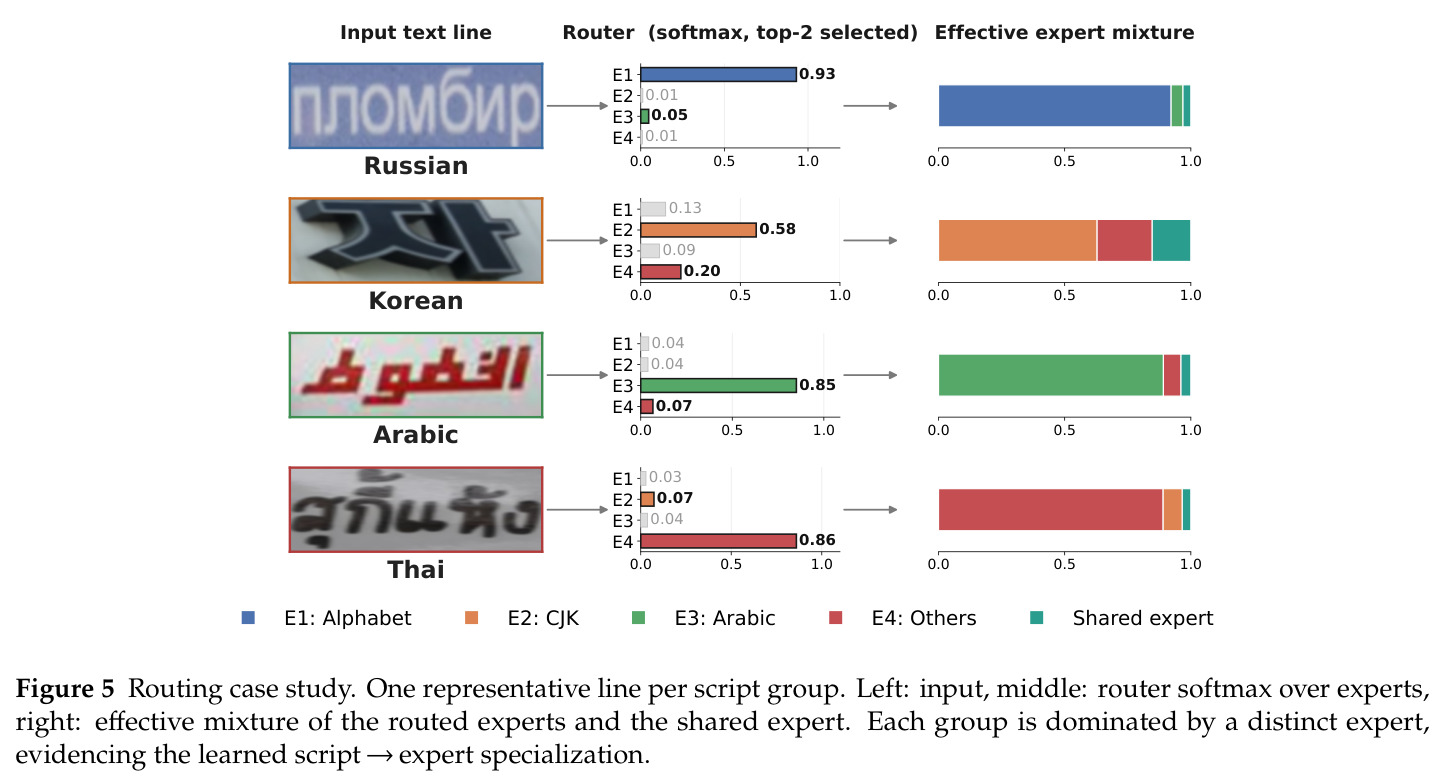
核心创新是把“文字即专家”这一结构先验嵌入MoE,并用三个设计把先验做实。第一,专家与文字组对齐:依据字形拓扑把10种文字分为字母组(拉丁+西里尔)、CJK组(中/日/韩)、阿拉伯组和其他组(印地/孟加拉/泰/藏),每个路由专家有明确的文字家族角色,可解释、可扩展。第二,图像级路由:路由输入$\bar{F}$每张图只算一次,同一图所有输出token共享同一路由结果,相比逐token路由既省计算,又避免token间“乒乓”导致的训练不稳,还让专家可直接读作文字专家——消融显示token级路由81.69%与图像级82.06%无显著差异,取图像级纯因成本更低、行为更稳。第三,常开共享专家承载跨文字共性(数字、标点、弯曲透视几何、中日共享汉字),配合可学习门$\alpha_t$平衡共享与特化两条支路;去掉共享专家平均掉0.71%,阿拉伯语和藏文分别跌3.62%和3.65%,证明它是低资源文字不被“专家孤岛”拖垮的关键。
方法步骤详情
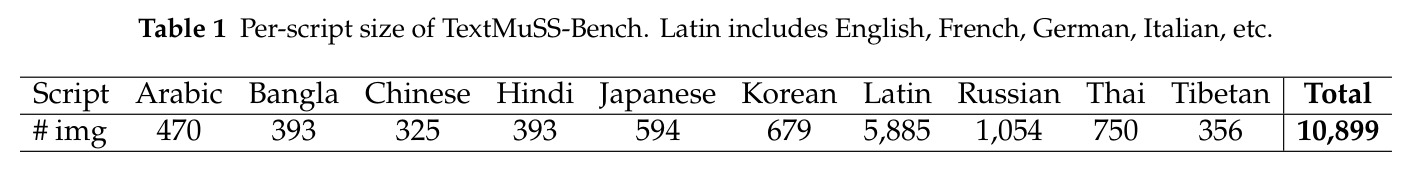
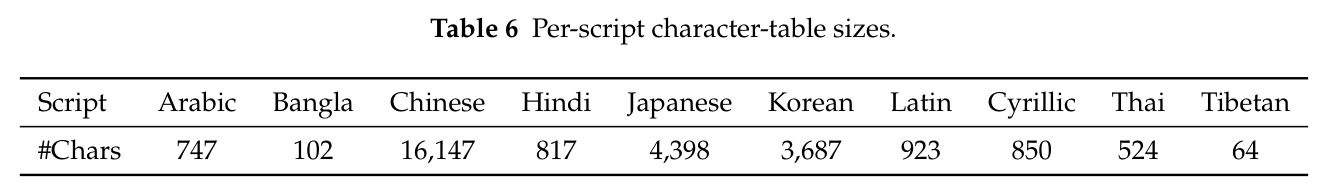
方法可拆成五步。步骤一,构建字符表与语料:收集每文字支持字符集(中文16,147字、日文4,398字、藏文仅64字),每文字收集10万至100万词,拉丁等多语言文字跨语言均衡采样并拼接成短语和句子。步骤二,合成TextMuSS-10M:8k背景图加模板渲染加效果叠加,每文字100万张共1000万张;字符表去重合并为19,684字符统一词表,加BOS/EOS/PAD共19,687。步骤三,组装TextMuSS-Bench:复用MLT2019测试集7种文字,自采俄语1,054、泰语750、藏文356张真实图,检测候选框人工校正后由各语言母语专家转写并质检,合计10,899张。步骤四,训练:AdamW峰值学习率$6.5\times10^{-4}$、权重衰减0.05、batch 1024、one-cycle加1.5 epoch预热、共2 epoch,8张V100耗时92.7 GPU小时;路由抖动$\sigma=0.05$、标签平滑0.1。步骤五,推理评测:贪心自回归解码,词级最大25字符(行级变体100),报告词准确率与$1-\mathrm{NED}$。
技术新颖性
技术新颖性体现在四处。其一,路由粒度创新:主流MoE(如LLM中的Mixtral)按token路由,本文利用“一图一文字”先验改为按图像路由,这是把任务结构性知识注入稀疏激活机制的干净示范,消融证明其与token级精度相当但路由开销更低、行为更稳定。其二,专家语义化:通过4组文字划分和共享路由输入但权重分离的辅助分类头$\mathcal{L}_{scls}$,让专家分工与人类可读的文字边界对齐——路由softmax可视化显示俄语由E1(字母组)以0.93主导、韩语E2为0.58、阿拉伯语E3为0.85、泰语E4为0.86,专家不再是黑盒。其三,容量分配的实证结论:4专家Top-2最优(82.06%),每文字独占一个专家的10专家配置反而降到81.32%,说明低资源文字更需要与结构近邻共享专家而非独占,这是对“专家越多越好”直觉的有力反例。其四,效率视角:45.85M存储参数中每图仅激活41.13M(89.69%),用约3.5M额外存储换取文字特化,V100上延迟541ms、吞吐473 img/s,远轻于VLM。
实验结果
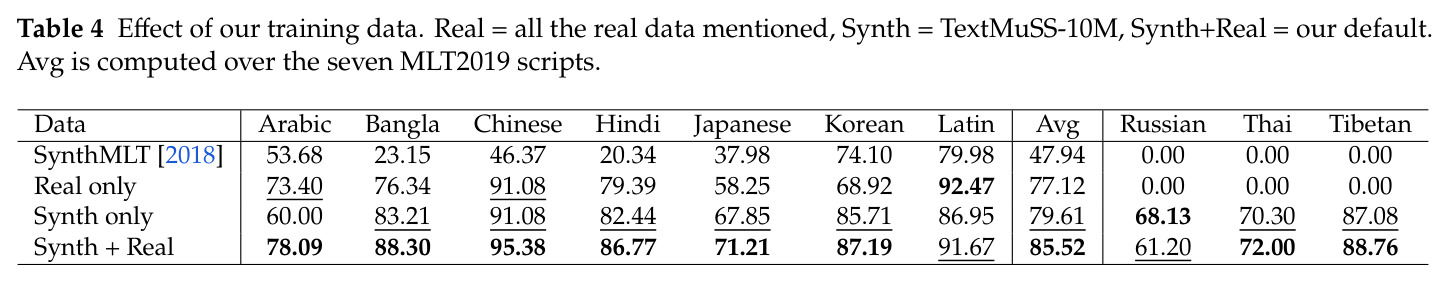
核心结果五组。第一,TextMuSS-Bench主实验:平均词准确率82.06%,超最强基线SVTRv2-AR的80.75%达1.31个点,增益集中在低资源文字:阿拉伯语78.09%(+2.98)、泰语72.00%(+2.40)、藏文88.76%(+1.96);VLM差距悬殊,InternVL3.5-8B平均24.94%,DeepSeek-OCR2仅8.61%,最强的Qwen3.5-9B也只有63.77%。第二,端到端CC-OCR任务:固定PP-OCRv5检测器只换识别器,F1从65.71%升至80.89%(+15.18),略超Qwen3.5-9B(80.73%)与GoogleOCR(71.78%),参数少约两个数量级。第三,消融:4专家Top-2最优82.06%;去脚本分类损失至81.63%;去共享专家至81.35%,阿拉伯语、藏文各跌3.62和3.65。第四,数据消融(MLT2019七文字均值):仅真实77.12%、仅合成79.61%、合成加真实85.52%。第五,参考基准:中文BCTR 86.85%(+0.92)、英文Union14M 88.95%(+0.28)。
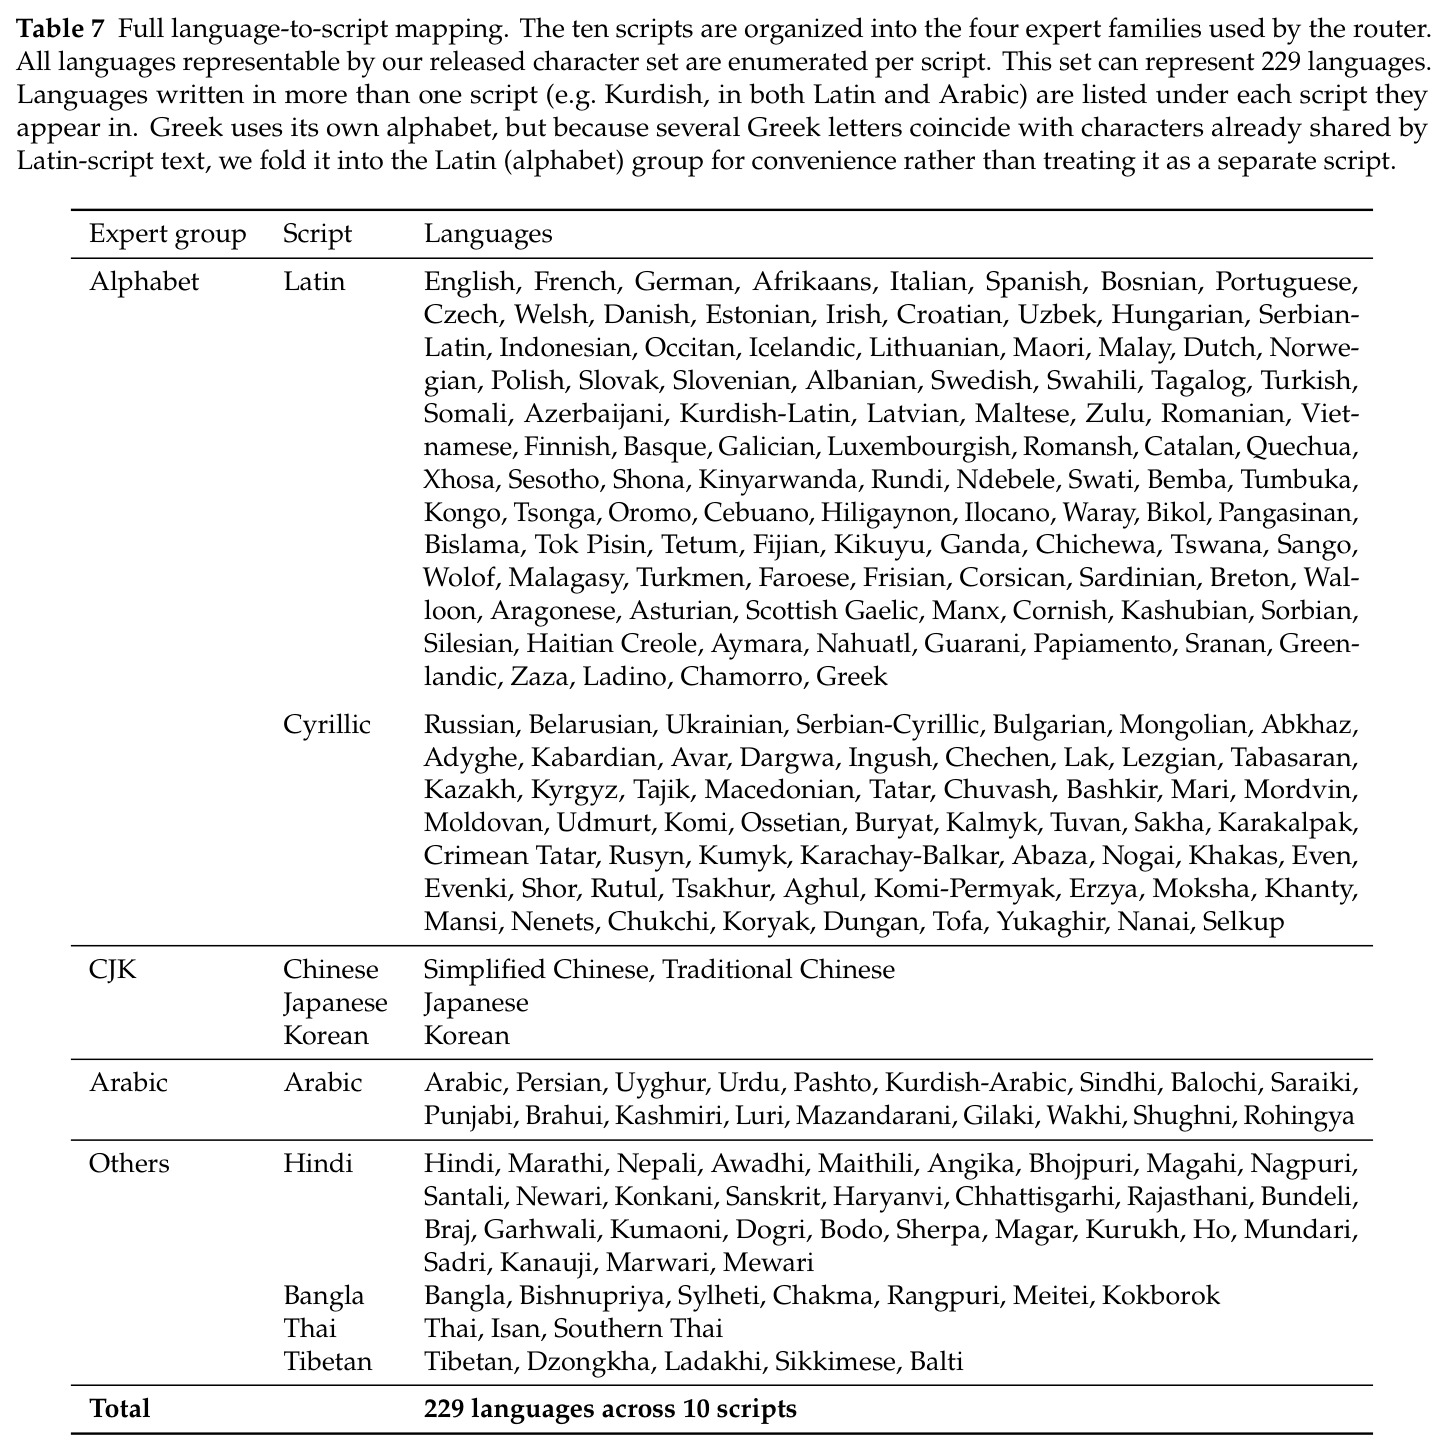
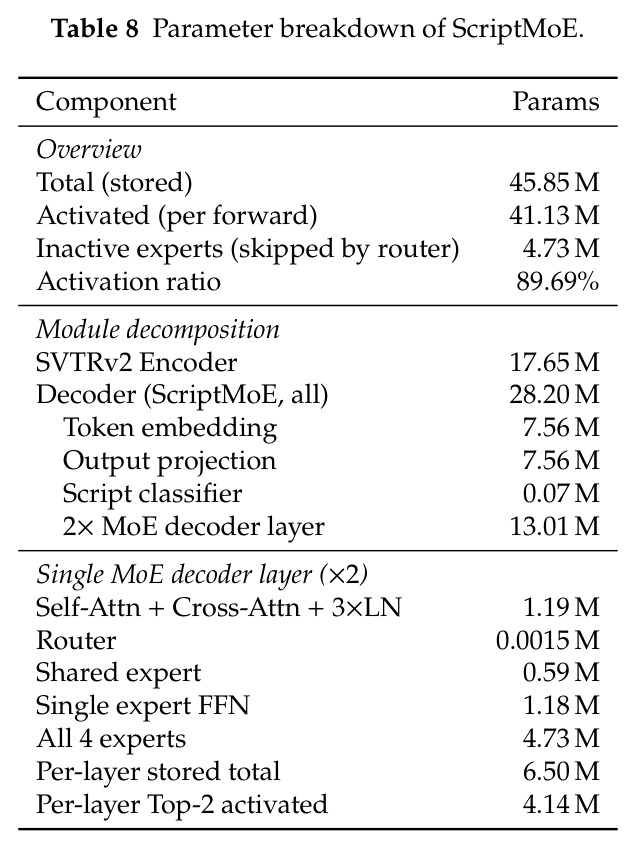
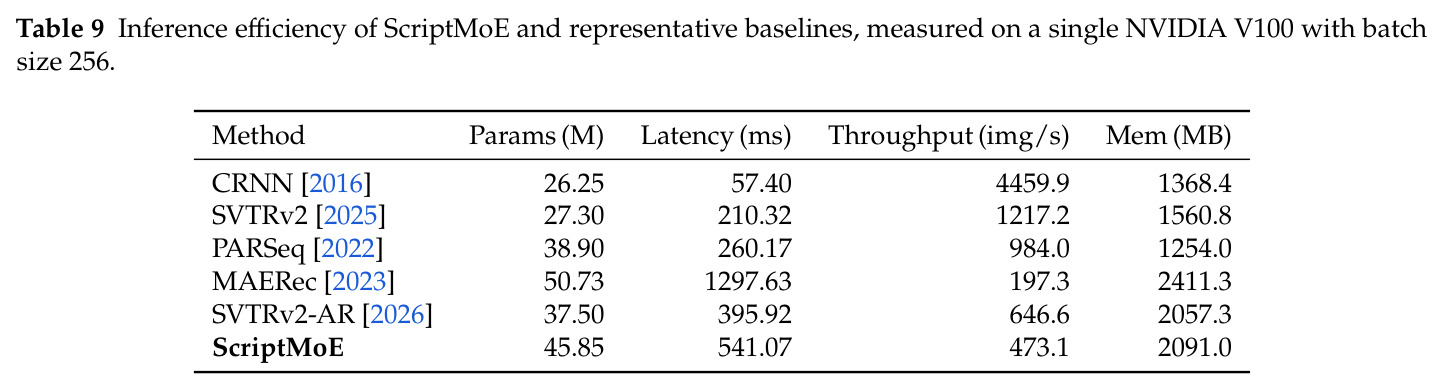
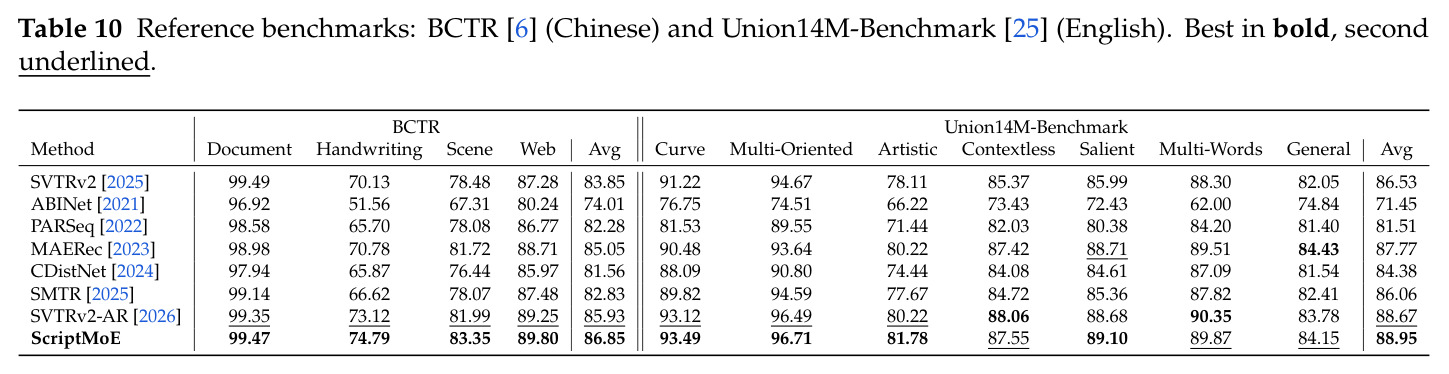
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多语种场景文本识别(TextMuSS-Bench,10种文字10,899张) | 平均词准确率(%) | 82.06 | SVTRv2-AR:80.75(最强STR基线) | +1.31,其中阿拉伯语+2.98、泰语+2.40、藏文+1.96 |
| 多语种STR对比通用VLM(TextMuSS-Bench) | 平均词准确率(%) | 82.06 | Qwen3.5-9B:63.77(最强VLM);InternVL3.5-8B:24.94 | 领先最强VLM 18.29个点,且激活参数少一到两个数量级 |
| 端到端多语种OCR(CC-OCR,固定PP-OCRv5检测器) | F1(%) | 80.89(PP-OCRv5 Det + ScriptMoE) | PP-OCRv5 MLT:65.71;GoogleOCR:71.78 | +15.18(对原识别器) |
| 端到端多语种OCR对比VLM(CC-OCR) | F1(%) | 80.89 | Qwen3.5-9B:80.73;Qianfan-OCR:76.70 | +0.16,参数量少约100倍 |
| 中文基准(BCTR) | 平均词准确率(%) | 86.85 | SVTRv2-AR:85.93 | +0.92 |
| 英文基准(Union14M-Benchmark) | 平均词准确率(%) | 88.95 | SVTRv2-AR:88.67 | +0.28 |
局限与改进
作者承认三点局限:一是合成TextMuSS-10M与真实图像仍有域差距,仅用合成训练时拉丁86.95%低于真实数据的92.47%;二是拉丁-西里尔同形字混淆未根治,俄语在完整方案下61.20%反而低于纯合成的68.13%,真实数据中拉丁占主导加剧了把西里尔字母误认成拉丁同形字;三是端到端性能受上游PP-OCRv5检测器封顶,漏检误检(尤其拉丁词级严格评测下)拖累总分。我的补充观察:其一,TextMuSS-Bench仅10,899张且拉丁5,885张占过半,平均指标被拉丁稀释,低资源文字每类只有三四百张,统计功效有限;其二,每个新增文字仅由单一母语专家标注,可能引入系统性转写偏差;其三,推理代价真实存在——延迟541.07ms、吞吐473.1 img/s,比稠密的SVTRv2-AR(395.92ms、646.6 img/s)慢约37%,对高并发场景不友好;其四,4专家组划分与$\lambda_{scls}$等超参都在这10种文字上整定,向更大文字空间扩展时Others组的可扩展性未经验证。
独立分析的弱点
独立分析出四个可改进的弱点。弱点一,同形字混淆:西里尔в/拉丁B、с/拉丁c等视觉相同但Unicode码位不同,模型在拉丁数据主导下系统性偏向拉丁输出,产生“拼写看似合理但文字错误”的转写。改进方向:引入字形感知对比损失或按码位加权的混淆惩罚,并扩充真实西里尔语料做课程微调,论文图8的分析框架可直接用于构造这类难例。弱点二,俄语从纯合成的68.13%跌到混合训练的61.20%,说明拉丁真实数据对结构近邻文字存在负迁移,可探索按文字分组的梯度隔离、专家级数据重加权或分阶段课程。弱点三,评测协议层面:词准确率要求整串全对,低资源类别样本少(藏文仅356张),单类波动可达数个点,建议报告按类置信区间或宏平均;同时CC-OCR得分受检测器上限约束,应补充oracle检测框下的识别上限实验以解耦检测与识别。弱点四,门控$\alpha_t$是逐token的而路由是逐图的,两者粒度不一致,同图不同token可能依赖不同混合比例,改成图像级门控做对照实验值得尝试。
未来方向
作者明确提出两个方向:一是持续学习,让新文字无需全模型重训即可加入——4组专家结构天然适合,可冻结既有专家、只训练新专家与路由器;二是与更强的多语种检测器集成以抬高端到端上限。基于本文成果还可延伸:其一,半监督利用真实多语种场景图,例如用ScriptMoE伪标注做自训练,弥合合成-真实域差距;其二,把Others组的拆分机制自动化,按字形聚类动态生长专家,支持229种语言之外的新文字(如希腊字母系统、缅文);其三,检测-识别联合训练或端到端可微流水线,消除现有两段式的误差累积;其四,把该轻量识别器作为VLM前端,用置信度估计让低置信样本回退到大模型,构建级联OCR系统,兼得成本与精度;其五,把图像级路由思想迁移到其他“每样本结构单一”的任务,如公式识别、乐谱识别等多模态OCR场景。
复现评估
复现条件相当友好。代码已在GitHub开源(YesianRohn/ScriptMoE与Topdu/OpenOCR),基于OpenOCR框架、PyTorch 2.2.0、CUDA 11.8、Python 3.8;TextMuSS-10M(1000万合成样本)、TextMuSS-Bench(10,899张)与19,684字符统一词表随论文发布,附录给出完整语言-文字映射与各文字字符表大小。训练配置完全公开:8张V100(32GB)、共92.7 GPU小时(约11.8小时墙钟)、全局batch 1024、AdamW峰值学习率$6.5\times10^{-4}$、权重衰减0.05、one-cycle加1.5 epoch预热、总计2 epoch;全部15个STR基线在相同数据与调度下重训重评保证公平,全局随机种子固定且路由抖动$\epsilon$亦加种子,声称可复现。VLM评测的统一prompt、各专用OCR模型默认prompt与输出归一化规则全部给出。门槛估计:推理单卡即可(45.85M参数),完整训练需8卡V100级算力,对学术实验室属中等偏易;主要工程量在千万级合成数据的存储与加载。
论文图表
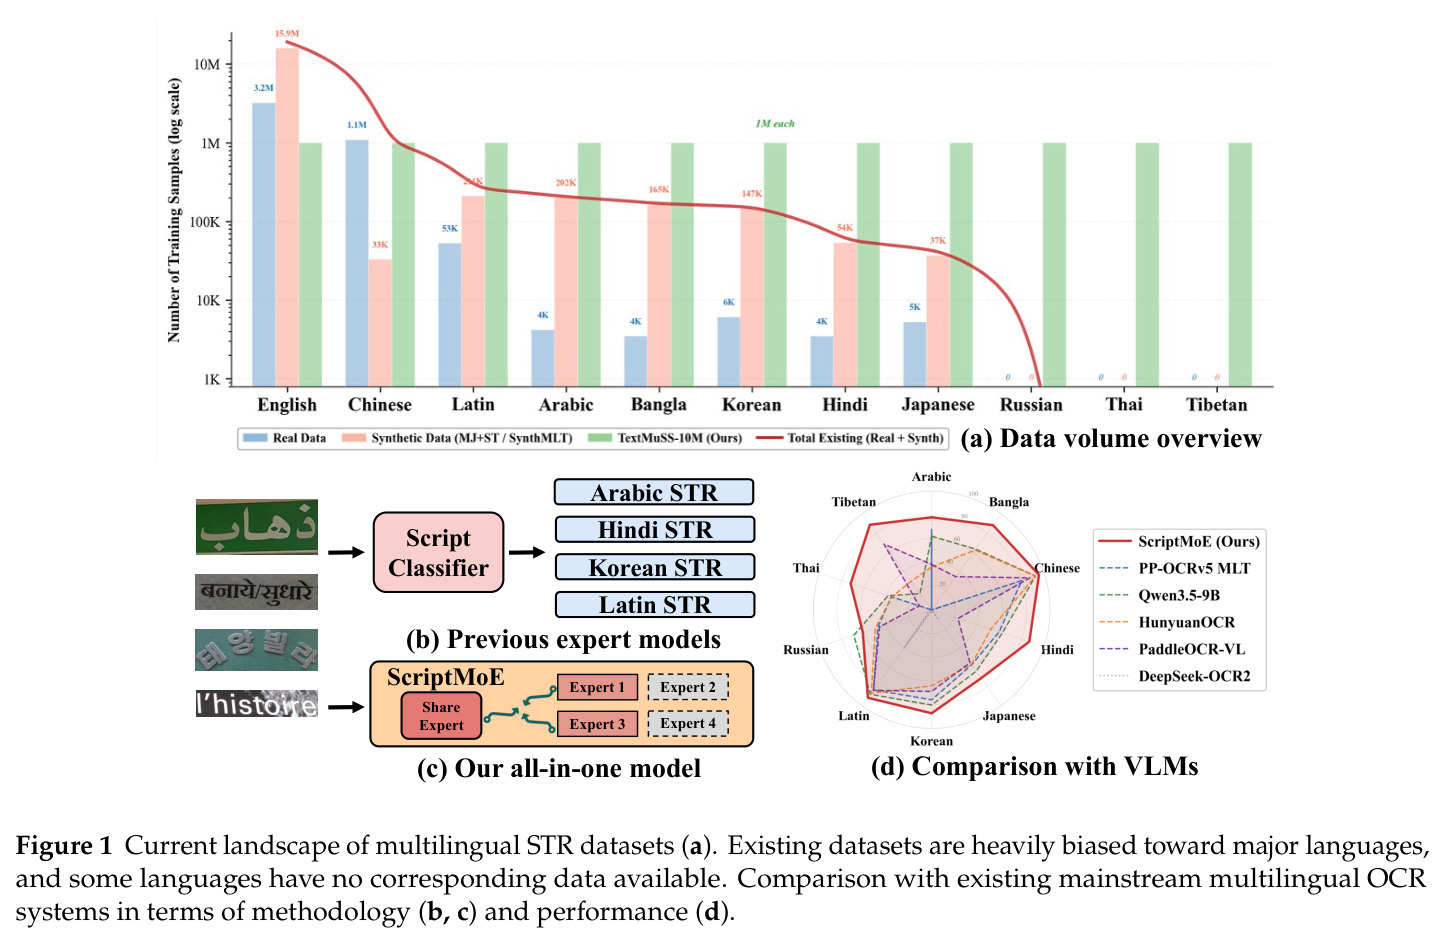
(a) 展示现有多语种STR数据集严重偏向英语、中文等主要语言,部分语言完全没有可用数据;(b) 旧式方案需要脚本分类器把裁剪图路由到各语言专用识别器;(c) 本文的全合一ScriptMoE架构;(d) 性能对比显示ScriptMoE超过PP-OCRv5 MLT、HunyuanOCR、Qwen3.5-9B等专家系统与VLM。
一图同时交代问题背景(数据失衡)与核心卖点(更准更轻),是理解论文动机与定位的入口。
展示俄语文本被误识别为拉丁同形字的典型案例:红色背景标出视觉相同但Unicode码位不同的字符替换,模型输出“拼写看似合理但文字体系错误”的跨文字转写。
揭示本文遗留的最典型失败模式(拉丁-西里尔同形字混淆),是理解局限性讨论的核心图。