无知还是无能:面向LLM智能体的知识门控可验证任务构造协议 Ignorance or Incompetence? Constructing Knowledge-Gated, Verifiable Tasks for LLM Agents
构造协议把几KB私有知识工件做成显式开关,使Opus通过率从0%跃升至68%
前置知识
RLVR(可验证奖励强化学习)
Reinforcement Learning with Verifiable Rewards 是当前推理与智能体后训练的主流范式:奖励不是来自人类偏好模型,而是来自可执行的确定性验证器(如单元测试、数值比对)。其核心要求是奖励信号必须有梯度——经验通过率饱和(全对)或绝对为零(全错)的任务不产生有效梯度,因此实践中会主动丢弃这两类任务。本文的校准筛选正是借鉴了这一思想作为离线质量控制规则。
论文的保留规则直接以通过率区间(0.6-1.0、0、不超过0.4)为筛选阈值,理解RLVR中'任务难度决定梯度信号'的原理,才能明白为什么作者要构造这种'有工件能过、没工件全挂'的任务剖面。
知识门控(Knowledge Gating)
指通过控制求解者能否访问某段知识,把'知识获取'从偶然的提示属性变成受控的实验变量。本文中每个任务配一个几KB的'知识工件'(领域规则、私有约定、参考表、工具算子),任务指令字节级一致地提供(+A)或扣留(-A)该工件,从而把性能差异完全归因于知识可及性,而非模型能力或其他因素。
这是全文的核心构造,标题'无知还是无能'正是在问:模型失败究竟是缺知识(ignorance)还是缺执行力(incompetence),而知识门控正是把这两种失败解耦开的实验开关。
Wilson置信区间
对小样本二项比例的区间估计方法。当试验次数很少(如 $n=5$)时,普通正态近似会给出越界或过窄的区间,而Wilson区间在 $\hat{p}=0$ 或 $\hat{p}=1$ 的退化情况下仍保持有限宽度,例如 0/5 的Wilson 95%区间是 $[0.00, 0.43]$ 而非点估计0。它比Clopper-Pearson精确区间更窄但仍保守。
论文Table 1所有任务级通过率都带Wilson区间。读懂它才能意识到:每格只有5次试验时单个结果翻转就改变20个百分点,任务级估计非常粗糙,作者对'边界案例'的谨慎态度由此而来。
约定门与算子门
论文提出的两类知识门。约定门植入私有的、不可推导的选择:内部阈值、固定别名表、归一化约定(如基准分母用235而非240),模型可以给出'合理'答案,但只有工件能决定哪个答案算对。算子门把难于手写的算法(如固定归一化约定的Brandes介数中心性、Garman-Klass波动率)放入工件的工具库,它不是严格不可推导,而是形成陡峭的能力屏障。
两类门的可证明性不同:约定门非可推导、对测试时自我改进更鲁棒;算子门可能被工具使用和扩展推理突破。论文的证据主张严格按门类型区分,混淆二者会误读论文结论。
配置相对校准(Configuration-relative Calibration)
智能体配置 = 模型 + 运行框架 + 工具 + 预算 + 提示策略。本文前沿配置用 Claude Opus 4.8 走 Claude Code 通道,第二配置用 Qwen3.6-Plus 走 OpenCode 通道,二者模型与框架都不同。因此任何任务保留与否的结论都只相对于这组具体配置成立,不能解释为模型本身的能力排名。
论文4.3节的背诵探针正是利用这一点:Qwen在全智能体框架下0%,但在单轮无工具条件下100%通过,证明低分可能源于框架(文件发现、工具调用、输出格式)而非模型知识缺陷。
研究动机
在专业领域(法务、金融、临床、航空)构造智能体任务存在一个根本张力:如果生成器/求解模型已经知道解决任务所需的全部规则,任务就无法测试超出其既有能力的东西——模型生成指令微调数据通常就卡在生成器自身的能力天花板;而如果相关规则真正不可得,任务又会欠约束,正确答案无从验证,奖励信号失去意义。现有基准很少控制被测智能体是否访问过某条领域约定:一条'有用但可推导'的背景知识只能带来十几到三十几分的边际提升(如τ2-bench手册让GPT-4.1从34.2%升到51.8%),无法区分'知识有帮助'和'知识必不可少'。传统数据集蒸馏把语料压成合成张量做权重空间更新,这种介质在推理时对一个正在跑的智能体完全不可达。于是核心困境是:如何让访问专业知识成为解题的必要条件,同时仍保有一个对正确解的精确、可执行的描述。
本文的目标是本文目标不是训练模型,而是把上述困境转化为一个可操作的构造问题:设计一套任务构造协议(construction contract),使得(1)任务指令与领域知识在物理上分离——指令字节级一致,知识封装在几KB的'工件'里;(2)对工件依赖是显式、可审计的——通过静态泄漏审计扫描指令和环境数据中暴露的门控内容;(3)验证完全自动化——结构化任务用确定性求解器重算精确参考解(浮点容差 $10^{-4}$),自由格式交付物用命名准则的rubric判定;(4)经验校准能筛除不合格候选——在'给工件/不给工件/中档模型给工件'三种条件下各跑5次,用保留规则筛出 exhibiting 预期行为剖面的任务。
与已有工作不同的是,本文的独特切入是把'构造时刻的不对称性'变成刻意设计的属性,而非评估时的偶然条件。三个不对称足以构造出这类任务:(i)构造特权——答案在构造时被人为植入(任意内部阈值、私有归一化表),从指令和环境不可推导,与求解者能力无关;(ii)廉价验证——对植入的ground truth核对结构化输出很容易,即便产出它很难;(iii)组合验证——对 $k$ 个命名准则的all-pass验证器让任务复杂度可增长而每个失败仍可归因。与近亲工作的区别同样明确:RAG和可移植技能文档提供的是'有帮助的、可推导的'上下文,本文植入的是'构造时固定、指令中不可推导'的私有规范并用泄漏审计把它变成受控变量;自动化基准审计(如参考文献[29])是寻找已有基准中不该存在的隐藏依赖,本文是反其道——故意构造私有规范并把它显式暴露为可审计的实验开关。
核心方法
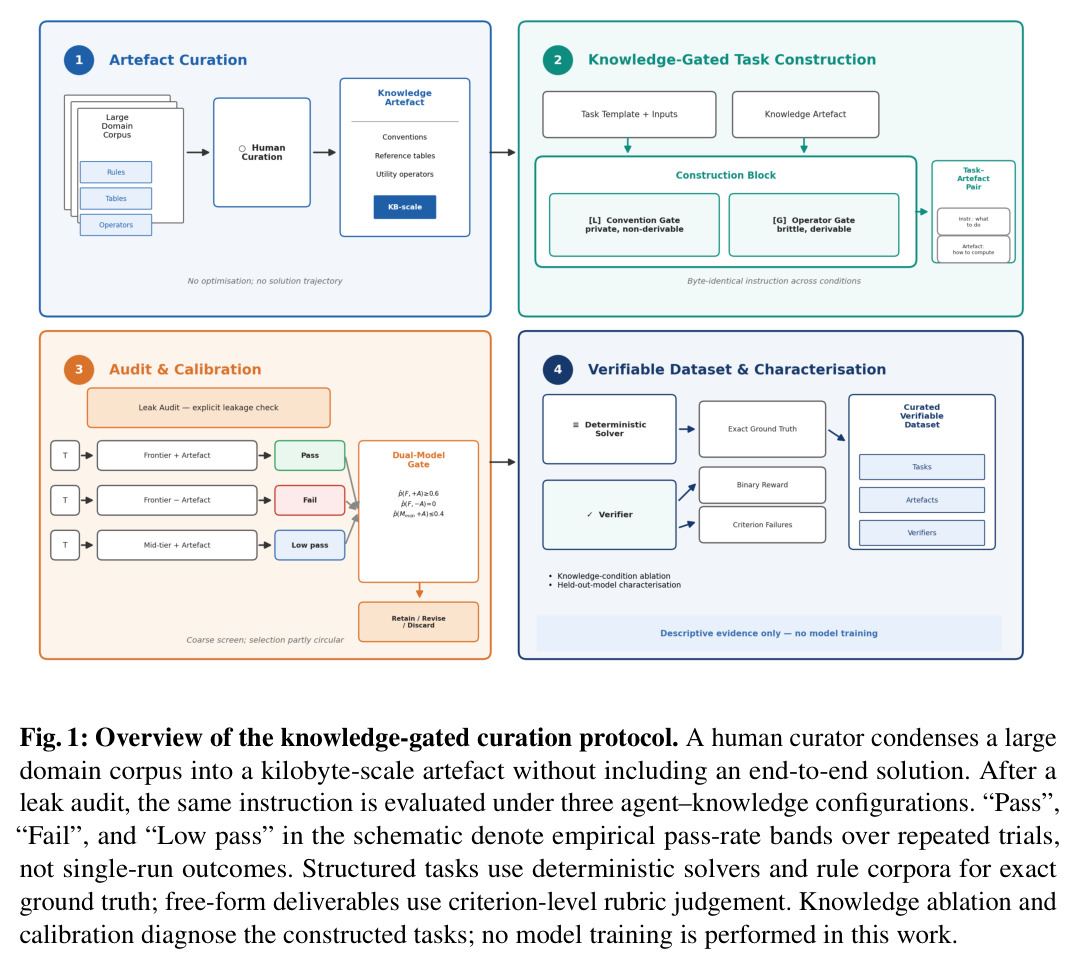
整体直觉:与其争论模型'会不会'某知识,不如在构造时造一个只有出题人知道答案的任务,再用实验证明答案只能来自工件。技术路线五层。第一层,任务/知识分离:每个策展单元是二元组——任务(输入、输出schema、格式要求、成功标准)与知识工件(领域约定、公式、参考表、工具算子,绝不含端到端解法);指令只说'做什么'且从不提及工件。第二层,泄漏审计:指令字节级一致,只以'既定的内部规范'指代约定并附回退条款,静态扫描指令与环境中的门控常量。第三层,两类门:约定门植入不可推导的私有选择,算子门放置难手写算法。第四层,验证:确定性求解器独立重算参考解并做 $10^{-4}$ 容差比对,或对 $K$ 个准则取全过语义 $R=\prod_{k=1}^{K} v_k$。第五层,校准筛选,保留规则为 $$\mathbb{I}_{\text{retain}} = \mathbf{1}\big[\hat{p}(A_F, +A) \geq 0.6 \wedge \hat{p}(A_F, -A) = 0 \wedge \hat{p}(A_{mid}, +A) \leq 0.4\big]$$ 其中 $A_F$ 为前沿配置(Opus 4.8/Claude Code)、$A_{mid}$ 为第二配置(Qwen3.6-Plus/OpenCode),每格 $n=5$ 次。
核心创新是把'知识可及性'从评估条件升级为构造属性,并用三层机制让这一依赖可测、可归因。首先,'构造特权'与求解者能力正交:无论模型多强,只要指令和环境都不泄露那个12%的复利开销率、235而非240的基准分母、缺失叶子价格记0.00等私有约定,它就不可能猜中唯一正确的数值答案——这直接回应了'合成数据受生成器能力上限约束'的老问题,因为出题人根本不需要会做题,只需要会埋答案。其次,泄漏审计+字节一致指令+回退条款保证 $-A$ 条件是真消融而非坏环境:没有工件的智能体会自信地按通用惯例给出可验证的错误答案,而不是弃权,于是性能剖面呈'全挂/大半过'的开关式翻转而非边际增益。最后,诚实的构造区分:约定门(非可推导)与算子门(可再推导但形成能力屏障)被明确区分,防止把两种本质不同的门控包装成同一构念;同时本文反复声明这是构造协议的行为验证,不是训练价值的证明。
方法步骤详情
步骤一,人工策展:从大语料(政策手册、内部规范)手工提炼几KB工件,只含约定、公式、参考表和工具算子;如bom-costing工件含12%逐级复利开销、缺失叶子价0.00、循环引用记-1.00等约定,legal-clause工件含关键词分值、条款上限和辖区乘子。步骤二,任务编写:指令描述输入、输出schema与排序要求,绝不引用工件,只写'遵循既定的内部规范'并附回退条款。步骤三,泄漏审计:静态扫描指令与环境数据中的门控常量和工件提及,15个任务中9个有可执行审计脚本。步骤四,验证器搭建:结构化任务用独立Python实现重算参考解(浮点容差 $10^{-4}$);自由交付物用命名准则rubric取 $R=\prod_k v_k$(本批15个任务全走确定性路径)。步骤五,校准rollout:BenchFlow管理的Docker沙箱中执行三条件各5次,2026-06-25至2026-08-20收集。步骤六,应用保留规则:三条阈值全满足才保留,否则修订或丢弃。步骤七,对照实验:扰动工件对照(bom-costing上改错三个约定)检验依赖是否跟踪内容正确性;背诵探针(两轮对话内联数据、无工具)定位失败层级。
技术新颖性
新颖性有四层。范式层面:受SkillsBench'有无技能文档配对评估'启发,但把技能可用性从评估条件前移到构造时刻——出题人刻意埋入不可推导的答案,使难度严格由知识门控而非推理能力决定;作者明确否认属于数据集蒸馏(无优化目标与过程,工件系手工编写、推理时上下文交付),也区别于提示压缩(压缩的是可推导内容)。机制层面:确定性见证给结构化输出提供精确核验,命名rubric准则给开放输出提供逐条失败归因——尽管全过乘积奖励 $R=\prod_k v_k$ 对RL探索指数稀疏,但每个 $v_k=0$ 都可归因到具体准则。实验诚实度层面:每个结论都被标注证据边界——'证据而非证明'、'配置相对而非模型排名'、'存在性证明而非一般压缩结果',且扰动工件对照证明效应跟踪内容而非mere presence。诊断层面:背诵探针把'知识缺陷'与'框架执行失败'解耦——同一模型同一任务,单轮内联100%、全框架0%,把失败精确定位到工具使用与文件发现,这一设计可迁移到其他智能体评测。
实验结果
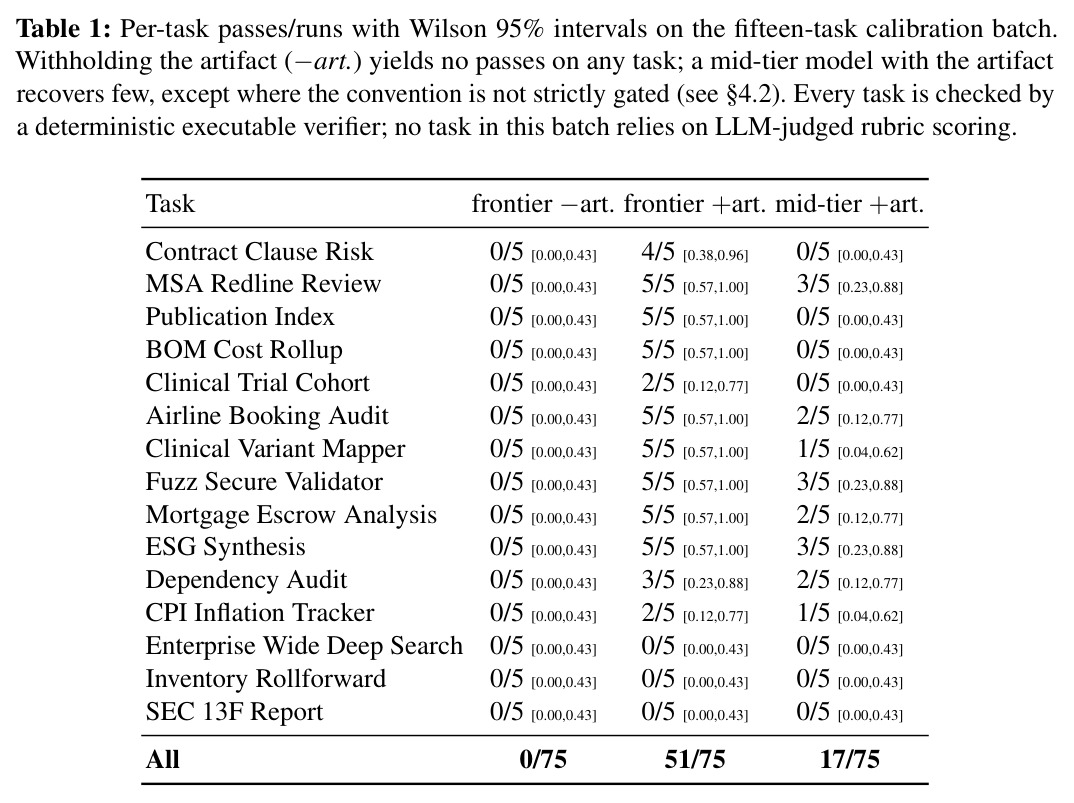
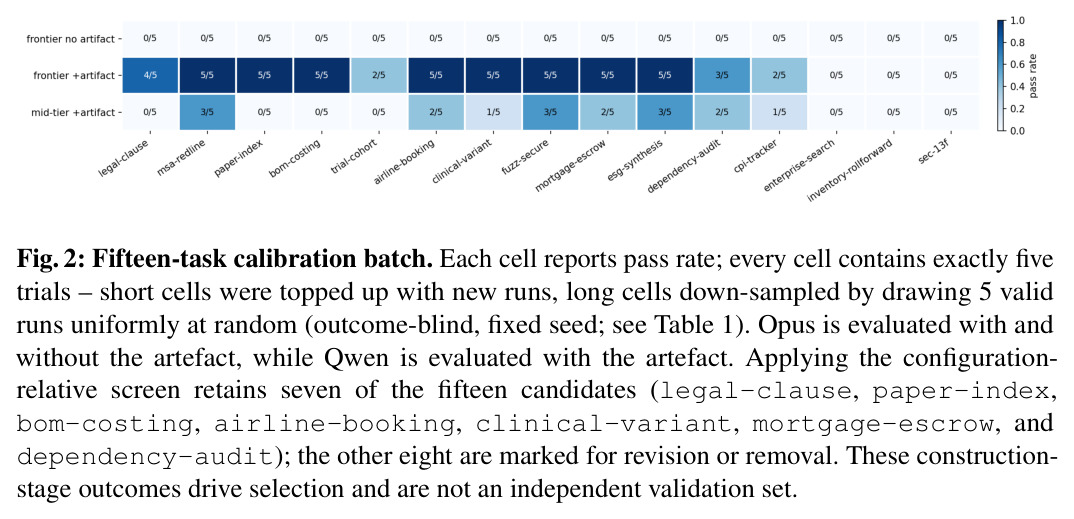
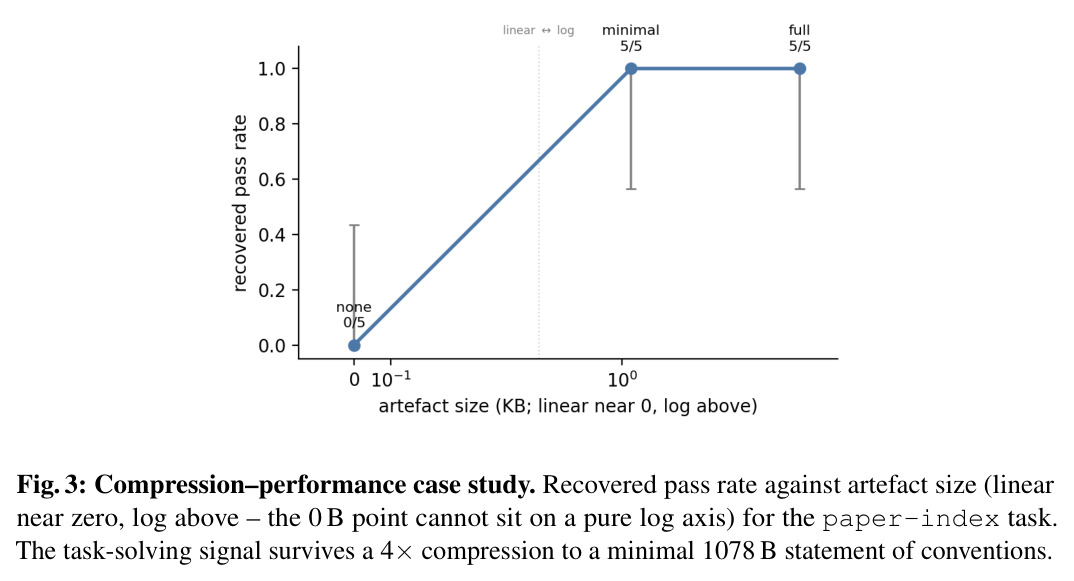
六组核心结果。(1) 主校准批:15个候选任务、每格5次试验,汇聚通过率为前沿+工件68.0%(51/75)、前沿-工件0%、中档+工件22.7%(17/75)——字节一致指令下,几KB工件使前沿配置从全挂翻转为大半通过,差68个百分点(对照:非门控任务的技能差值通常仅18-36分)。(2) 扰动工件对照:bom-costing上把三个约定改成似真错误值(12%→15%、0.00→兄弟均值、-1.00→0.00),Opus 5次全0%,与无工件一致、低于正确工件的100%——效应跟踪内容正确性而非文档存在性。(3) 筛选:保留7任务(legal-clause、paper-index、bom-costing、airline-booking、clinical-variant、mortgage-escrow、dependency-audit);8个淘汰——4个边界未过(trial-cohort仅2/5;msa-redline、fuzz-secure、esg-synthesis中档3/5超40%上限),4个严重失败(cpi-tracker仅40%;enterprise-search、inventory-rollforward、sec-13f有工件仍0%)。(4) 背诵探针:bom-costing与legal-clause共20次双轮对话,Qwen 100%复述约定且100%通过终验,同任务全框架下却0%——失败在工具调用、文件发现与输出格式而非知识。(5) 外部语境:τ2-bench手册把GPT-4.1从34.2%抬到51.8%、o4-mini从42.1%到59.4%;SciCode把Claude-3.5-Sonnet从26.0%到35.4%——方向一致但幅度远小于门控翻转。(6) 压缩案例:paper-index工件4379B与1078B(4×)均100%,0B为0%。方差审计:30个+工件格40.0%混合、均值方差0.088;保留集14格42.9%、0.091,基于选样后数据不作独立证据。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 15任务校准批(汇聚) | 通过率(每格5次试验) | 有工件 68.0%(51/75) | 无工件 0%(0/75);中档模型有工件 22.7%(17/75) | +68个百分点(前沿配置有无工件对比) |
| bom-costing 扰动工件对照 | 通过率 | 正确工件 100%(5/5);扰动工件 0%(0/5) | 无工件 0%(0/5) | 证明效应依赖工件内容正确性,似真错误文档与无文档等效 |
| 背诵探针(bom-costing + legal-clause) | 通过率(单轮内联数据、无工具) | Qwen 100%(20/20 次对话全过,约定复述全对) | 同任务全智能体框架下 0%(0/10) | 定位失败为框架级(工具/文件/格式)而非知识缺陷 |
| τ2-bench telecom(语境参照,非复现) | 官方四试验通过率 | GPT-4.1 34.2%→51.8%;o4-mini 42.1%→59.4%(加手册) | 无手册基线 34.2% / 42.1% | +17.6 / +17.3 个百分点;零基线任务被挽救 53% / 57% |
| SciCode(语境参照,非复现) | 子问题级通过率 | Claude-3.5-Sonnet 26.0%→35.4%;GPT-4o 25.0%→35.4%(加背景) | 无背景 26.0% / 25.0% | +9.4 / +10.4 个百分点,方向一致但幅度远小于门控式0→68翻转 |
| paper-index 工件压缩案例 | 通过率(每条件5次试验) | 4379B 与 1078B(4×压缩)均 100% | 0B(无工件)0% | 证明起作用的是约定本身而非周边文字,4倍压缩无损(存在性证明) |
局限与改进
作者承认的限制:校准池仅15任务、每格5次,一个结果翻转就改变20个百分点,保留决策对单次结果敏感(dependency-audit恰在60%阈值、三任务恰在40%上限,Wilson区间宽达 $[0.23,0.88]$);可执行泄漏审计只覆盖9/15任务,静态扫描无法排除语义改写或对抗性泄漏;两配置同时换模型和框架,低分无法定位于模型(背诵探针已实证),保留是配置相对的;最强验证保证只覆盖确定性交付物——本批全部任务走此路,rubric路径未被任何已报告数字行使;循环性——保留集正是用这些配置的结果选出的,42.9% vs 40.0%的混合率差异被作者明确拒绝作为证据。我的观察:论文成功度量的是'持有并应用一把提供的钥匙',与专业能力重叠但不等同(作者2.2节坦承);门控任务对评估有用,但训练价值完全未检验——保留规则甚至允许 $\hat{p}(A_F,{+}A)=1$,而RLVR文献恰恰丢弃饱和任务,筛选剖面与训练可用性之间存在未弥合裂缝;背诵探针只覆盖两个约定门任务、一个模型,paper-index这类算子门无法化归为单轮探针,框架级失败模式尚未被系统修复。
独立分析的弱点
四个可操作弱点。第一,统计功效不足:每格5次试验使阈值判定如同掷硬币边界(dependency-audit的3/5恰过线),改进方向是序贯筛选——边界任务自适应加试到15-20次,用贝叶斯后验而非点估计卡阈值。第二,模型与框架混杂:$A_F$ 与 $A_{mid}$ 同时换模型和harness,22.7%的中档汇聚分无解释力,改进方向是补'同harness换模型'交叉格,把两类失败在实验设计层面正交化,而非事后用背诵探针诊断。第三,泄漏审计覆盖不全且只查静态文本:9/15有可执行审计,语义泄漏(预训练语料可能见过类似行业惯例)完全未设防,改进方向是补齐全量审计并加canary探针——在门控约定里埋随机GUID式常量,无工件也能答对即证明数据污染。第四,筛选剖面与训练价值错位:规则允许前沿+工件达100%,而RLVR需要中间通过率才有梯度,$R=\prod_k v_k$ 全过语义又使多准则任务奖励指数稀疏,改进方向是把校准目标改为'训练剖面'——把任务难度调进学习区,或松弛为准则级部分奖励 $\sum_k v_k$。此外68%通过率意味着每三个rollout仍有一个失败且全归因到harness,值得先修输出格式容错层再复测。
未来方向
作者的方向分三层。近期是验证而非训练:补齐全部15任务的可执行泄漏审计;在筛选决策边界附近增加重复试验;用共同harness加held-out配置重跑筛选,消除配置相对性。中期是端到端后训练对比:用保留任务族与匹配的非门控/未筛选任务族做held-out训练实验,检验'校准任务改善学习'这一独立假设;配套训练/评估任务族物理隔离、canary字符串(随机GUID)检测污染、参数化再生成防精确记忆。长期是协议泛化:扩展到异构知识源、工具与环境共同决定成功的场景;探索对不可验证数据用证据下界(ELBO)类目标——但这会弱化精确验证这一核心保证。基于成果的三个延伸:其一,系统化压缩-性能曲线——附录只测了一个任务的三点(4379B/1078B/0B),可逐条消融约定,找出'承重约定'最小集并定量刻画信息量与门控强度的关系;其二,把背诵探针推广为智能体评测的标准诊断步骤——对任何低分配置先跑单轮内联探针,把'无知/无能'归因做成评测报告固定栏目;其三,实证检验5.2节耐久性猜想——约定门对测试时自我修正免疫,可用'探索+自我批判'智能体验证,并与算子门的可破解性对照。
复现评估
复现评估:中上可行性、中等成本。公开仓库(github.com/DatagridsAI/Knowledge-Gated-Task-Construction)发布7个保留任务中的5个:contract-clause、paper-index、bom-costing、airline-booking、mortgage-escrow,4个为研究专用合成数据、paper-index保留SkillsBench出处;仓库含数据许可与第三方声明,但不含论文源、评估轨迹和参考解,15任务池的汇聚数字(51/75等)无法从公开子集重建,3个改编自SkillsBench的任务未分发。算力:校准批约225次rollout(15任务×3条件×5次)加扰动对照5次、背诵探针20次,规模不大,但每次是带Docker沙箱、文件I/O的完整智能体会话;BenchFlow的轮次/token预算为继承默认值而非钉死数值,API成本主要由Opus 4.8的75次+工件长会话主导。复现难度:技术栈依赖具体版本——BenchFlow(commit 2a97db5)、OpenCode 1.17.7、claude-agent-acp v0.40.0,沙箱网络与模型API可用性是主要摩擦点;验证器为独立Python实现、容差 $10^{-4}$,数值部分可精确复现。总体:协议层面可复现,完整数字层面受限于5/15的任务发布量。
论文图表