面向空间因子模型的Wasserstein重心交互场:来自语言模型表示的证据 Wasserstein-Barycentric Interaction Fields for Spatial Factor Models: Evidence from Language-Model Representations
用新闻文本嵌入分布的Wasserstein重心重构构造公司交互场,赋予空间系数暴露调整解释
前置知识
二次Wasserstein距离(最优传输)
度量两个概率分布之间最小搬运成本的距离:$W_2^2(\mu,\nu)=\inf_{\pi}\int \|x-y\|^2\,d\pi(x,y)$,其中 $\pi$ 是边际分别为 $\mu,\nu$ 的耦合(运输计划)。对等规模的离散点云(经验分布),该问题退化为最优指派问题:逐一配对两簇点使平均平方位移最小。与只比较均值或质心的欧氏距离不同,它对整个分布的位置、形状和内部构成都敏感。
本文把每家公司表示为其新闻文章嵌入构成的点云(经验分布),公司间的距离与对齐全部建立在二次 Wasserstein 传输之上;不理解耦合与最优指派,就无法理解场构造的第一步。
Wasserstein重心与目标锚定重构
经典 Wasserstein 重心(Agueh–Carlier 2011)在固定输入分布与权重 $q_j$ 时,寻找使 $\inf_Q \sum_j q_j W_2^2(C_j,Q)$ 最小的自由中心分布 $Q$。本文的目标锚定变体反其道而行:目标分布固定、成对对齐固定,只在单纯形上优化哪些同伴以多大权重联合重构目标,输出的是分布张成权重而非新的中心分布。
论文的核心方法创新正在于此边界:$W_{ij}^\flat$ 大表示 $j$ 对重构目标 $i$ 有用,而不是 $j$ 离 $i$ 近。分清自由重心与固定目标重构是读懂第 4 节的前提。
空间自回归模型(SAR)与空间乘子
形如 $y=\rho Wy+x$ 的联立方程:$W$ 是外生交互矩阵,$\rho$ 度量同伴依赖强度;当 $\|\rho W\|<1$ 时约简形式为 $y=(I-\rho W)^{-1}x$,其 Neumann 级数 $\sum_k \rho^k W^k$ 累积直接与高阶迭代交互,即空间乘子。经典空间计量把 $W$ 视为已知并条件于它估计 $\rho$;若用同一份收益数据估计 $W$ 会产生机械的反射问题。
本文的空间闭包定理正是把暴露层面的 SAR 从二次调整目标推导出来而非直接假设,并先冻结文本场再做收益估计以避开反射问题;评估其贡献需要知道 SAR 的标准做法。
QMLE与伪真值
准最大似然估计(QMLE)在扰动项真实分布未知时,用一个错误但便于计算的工作似然(此处为球形同方差扰动)估计参数;其总体极限是最大化期望工作对数似然的伪真值 $\rho^\star$,一般不等于结构参数 $\rho$。集中掉截距与方差后目标函数含 Jacobian 项 $T\log|I-\rho W|$,对应空间同时性映射。
论文反复强调 $\hat\lambda=\hat\rho/(1-\hat\rho)$ 只是工作模型调整指数而非结构成本比或因果效应;不区分结构 $\rho$、伪真值 $\rho^\star$ 与样本 $\hat\rho$ 三个层次,就会误读全部实证结论。
因子模型与暴露向量
资产定价的因子模型把收益写成 $r_{it}=\langle B_i,F_t\rangle_{\mathcal H}+e_{it}$:$B_i$ 是公司对 $K$ 个(或希尔伯特空间中可数多个)共同因子的载荷即暴露,$F_t$ 是因子新息,$e_{it}$ 是截面不相关的特异部分。暴露刻画公司对共同冲击的敏感方向与强度,是风险分解与组合构建的基本对象。
本文全部理论围绕暴露展开:公司先有独立暴露 $\xi_i$,经同伴调整得 $B_i$;标量投影命题保证沿任一因子方向切片后 SAR 结构不变,从而把潜在暴露模型接到可观测收益上。
行随机矩阵与平稳分布
行随机矩阵指各行元素非负、行和为 1(再要求对角为零即不与自己交互),使 $Wy$ 的每一行是同伴的凸平均,保证尺度可比并使 Jensen 不等式可用。对有向(非对称)的行随机场,存在严格正的平稳分布 $\pi$ 满足 $\pi^\top W=\pi^\top$,$\pi_i$ 度量公司在反复同伴平均中的长期影响力。
构造出的交互场 $W^\flat$ 天然满足行随机加零对角(Definition 1),无需再归一化;衰减定理(Theorem 5)与散度证书(Corollary 3)的证明和权重选择都依赖 $\pi$。
平稳自助法(stationary bootstrap)
对时间序列按几何分布长度的随机块重采样(本文期望块长 21 个交易日)、以保留序列内时间依赖的重抽样方法。本文在每次重抽中保留完整截面(联合日期重抽),对 QMLE 做 2,000 次重估,用经验分位数给出 95% 区间;边界 QLR 检验的零分布也用受限拟合下的模拟来校准。
论文所有置信区间(如 $[2.89,4.17]$)与两个 $p=0.0005$ 的检验结论都建立在这套推断设计上,理解它才能判断数字的可靠性。
研究动机
空间资产定价模型(空间 CAPM/APT,如 Kou et al. 2018;把新闻共 mention 网络嵌入空间因子模型的 Ge et al. 2023)用一个外生给定的交互矩阵 $W$ 组织截面收益依赖,再用空间准似然估计空间系数 $\rho$。这一范式的威力从 $W$ 给定之后开始,但代价是把两个根本问题留在模型之外:其一,交互场从何而来——研究者从地理距离、行业分类、供应链或新闻共现计数中任选其一,而什么构成一条链接、边的计数权重为何能度量经济交互强度这些原语性问题从未被回答,例如共现网络用句子级共同提及次数定义边权,隐含提及越多交互越强却无机制支撑;其二,$\rho$ 除了条件于该场的收益依赖还度量什么,模型本身不含解释。更糟的是,表示层面普遍采用点式对象:每家公司被压缩为地理或特征空间中的一个点、或全部文本的平均嵌入。两家产品、技术、供应链布局截然不同的多元化公司可以有几乎相同的质心——就像平均门店坐标相同的两家连锁餐饮覆盖完全不同的区域——点式表示把足迹的离散度、多峰性与内部构成全部抹去。若再把 $W$ 与收益放在同一样本中估计,还会遭遇空间计量经典的机械反射问题。
本文的目标是论文的目标是把空间计量向上游推一层,具体分三步。第一步,改变公司的数学对象:用嵌入空间上的概率测度(信息足迹分布)代替点或平均分值,点式表示只是分布退化为单点质量的特例。第二步,从分布表示内生地构造可容许交互场:通过目标锚定 Wasserstein 重心重构得到行非负、行和为一、对角为零的有向场 $W^\flat$,且无需常规核带宽选择,从而回答谁应该是谁的同伴、权重多大。第三步,给空间系数以经济内容:用二次暴露调整问题平衡偏离自身独立暴露 $\xi_i$ 与偏离同伴平均暴露,推导出暴露层面的空间自回归 $B=\rho WB+(1-\rho)\xi$,使 $\rho=\lambda/(1+\lambda)$ 精确对应同伴错配惩罚与独立偏离惩罚之比 $\lambda$。经验上则要检验:这一冻结的文本场能否组织 2023–2026 年 885 个交易日的条件收益依赖;其拟合是否优于用同一批 Wasserstein 距离构造的 RBF 对照与等权支持对照;以及它与持久的新闻共 mention 场究竟是同一关系的冗余描述还是两条独立的调整通道。
与已有工作不同的是,独特切入角度体现在四个层面。表示层面:文本金融文献通常把文本压缩为一阶对象——注意力度量、文本因子或预测特征(Ben-Rephael et al. 2019;Cong et al. 2024),或用学习图把连通性直接映射为因子暴露(Son & Lee 2022);本文保留每家公司语料的完整截面分布,让图成为分布几何的输出而非起点。场构造层面:从成对距离到权重通常需要核函数、带宽或近邻规则这些外生粘合剂,本文改为联合的单纯形重构——不是谁离我最近,而是哪些同伴联合表示我——并在数学上与自由 Wasserstein 重心划清边界。机制层面:网络博弈文献(Ballester et al. 2006)用局部互补性解释收益层面的传播,本文把同样的二次权衡逻辑下移一层到暴露调整,从而推导而非假设空间滞后,并允许多个可容许场同时进入一个调整问题——重心场与新闻场成为同一嵌套族的内部点与边界点,待估对象从哪个 $W$ 赢变成调整如何在通道间分配。散度层面:截面信息异质性经载体约束传成暴露散度下限,再经空间闭包给出同伴调整至多能抹去多少的显式 bracket,把文本几何、暴露与均衡串成一条链。
核心方法
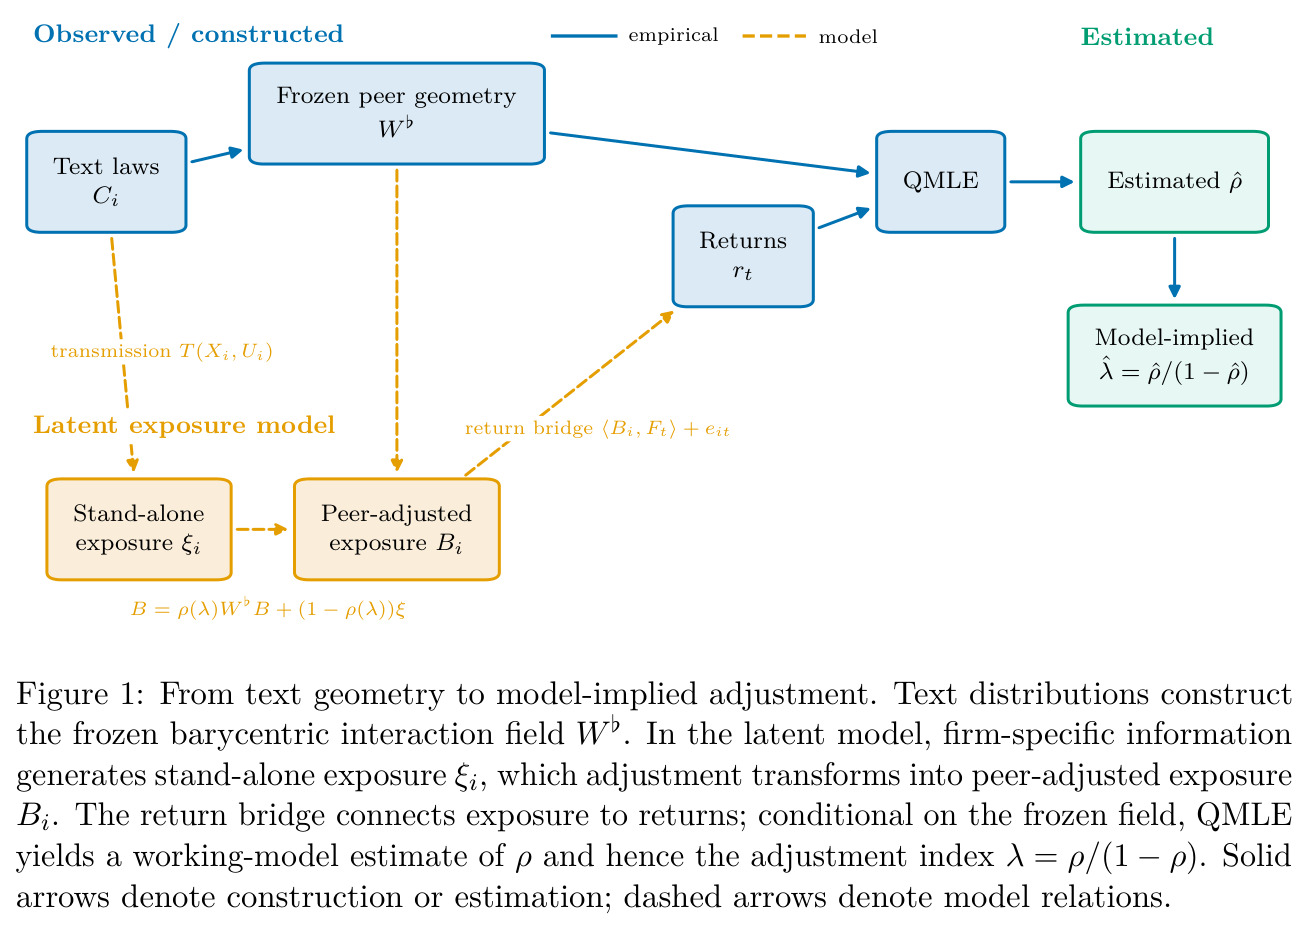
直觉版本是:一家多元化公司的新闻语料在语言模型嵌入空间里不是一团致密的点,而是一片有形状、有多个峰的足迹;要衡量两家公司的经济邻近,应当计算把一片足迹搬运对齐到另一片所需的最小语义位移,而不是比较两个平均分。技术路线分四步。第一步,语料与表示:从 Nasdaq 按 ticker 索引的公开新闻档案取 2018–2022 年文本,经年度覆盖筛(每公司每年至少 64 篇原始文章)后按 URL 哈希确定性截取每公司 128 篇,用 Qwen3-Embedding-8B 编码为 4096 维行归一化向量,构成等质量经验分布 $\hat C_i=\frac{1}{128}\sum_m \delta_{x_{im}}$。第二步,场构造:对每个有序对 $(i,j)$ 解平衡指派问题得到目标特定的文章级对应,固定这些对齐后在单纯形上最小化重构损失,得到行随机场 $W^\flat$ 并在收益窗口前冻结。第三步,理论闭包:解二次暴露调整问题,导出 $B=\rho WB+(1-\rho)\xi$ 与 $\rho=\lambda/(1+\lambda)$,经标量投影接到收益方程 $r_t=\rho W r_t+x_t$。第四步,估计与推断:对冻结场做池化 QMLE(集中似然含 $\log|I-\rho W|$),2,000 次期望块长 21 的联合日期平稳自助给区间;收益面板为 52 家公司在 2023-01-03 至 2026-07-15 的 885 个共同交易日,两场联合模型还用边界校准 QLR 检验通道必要性。
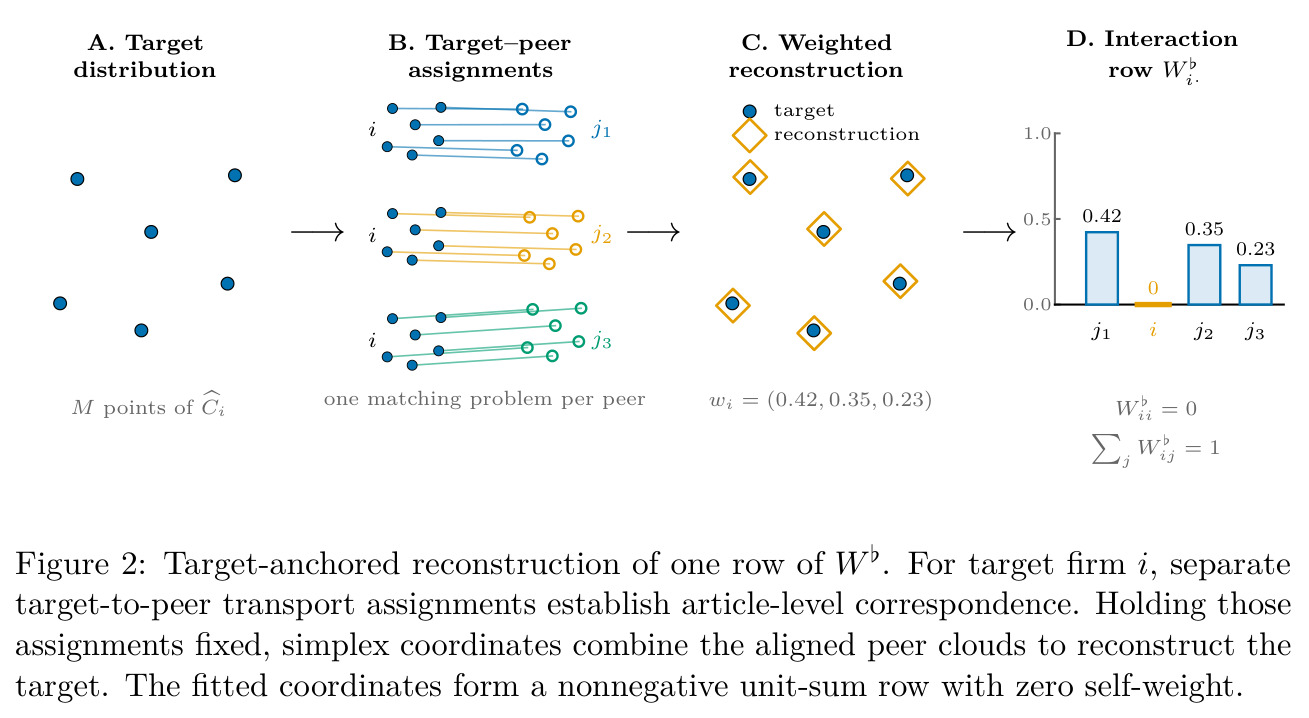
核心创新是把目标锚定 Wasserstein 重心重构变成空间暴露调整的可容许场,与既有方法的本质区别有三。其一,与自由 Wasserstein 重心(Agueh & Carlier 2011)不同:后者固定输入权重、优化一个全新的中心分布 $Q$;本文固定目标 $\hat C_i$ 与全部成对对齐,只优化单纯形同伴坐标 $w_i$。经济后果是可解释的方向性:大的 $W_{ij}^\flat$ 记录 $j$ 在可投资全集中对重构 $i$ 的条件有用性,而非仅仅 $j$ 离 $i$ 近,因此尽管 Wasserstein 距离对称,场却有向,方向记录重构相关性而非因果影响。其二,与核/带宽/近邻式距离转换不同:单纯形与留一约束让每一行自动满足非负、和为一、对角为零(Definition 1),核带宽选择被结构性消除——RBF 对照则把带宽选择重新摆上台面(取 $h$ 为离对角 $D_{ij}^2$ 的中位数)。其三,与假设空间滞后的空间 CAPM 不同:空间闭包定理从二次调整目标内部推出 $B=\rho WB+(1-\rho)\xi$,映射 $\lambda\mapsto\rho=\lambda/(1+\lambda)$ 是非负调整强度到 $0\le\rho<1$ 的严格递增双射,空间系数第一次有了相对调整强度的模型内解释;同一闭包允许多场并存,混合矩阵 $W(\theta)=\theta W^B+(1-\theta)W^N$ 仍可容许,把单场比较升级为通道分配问题。
方法步骤详情
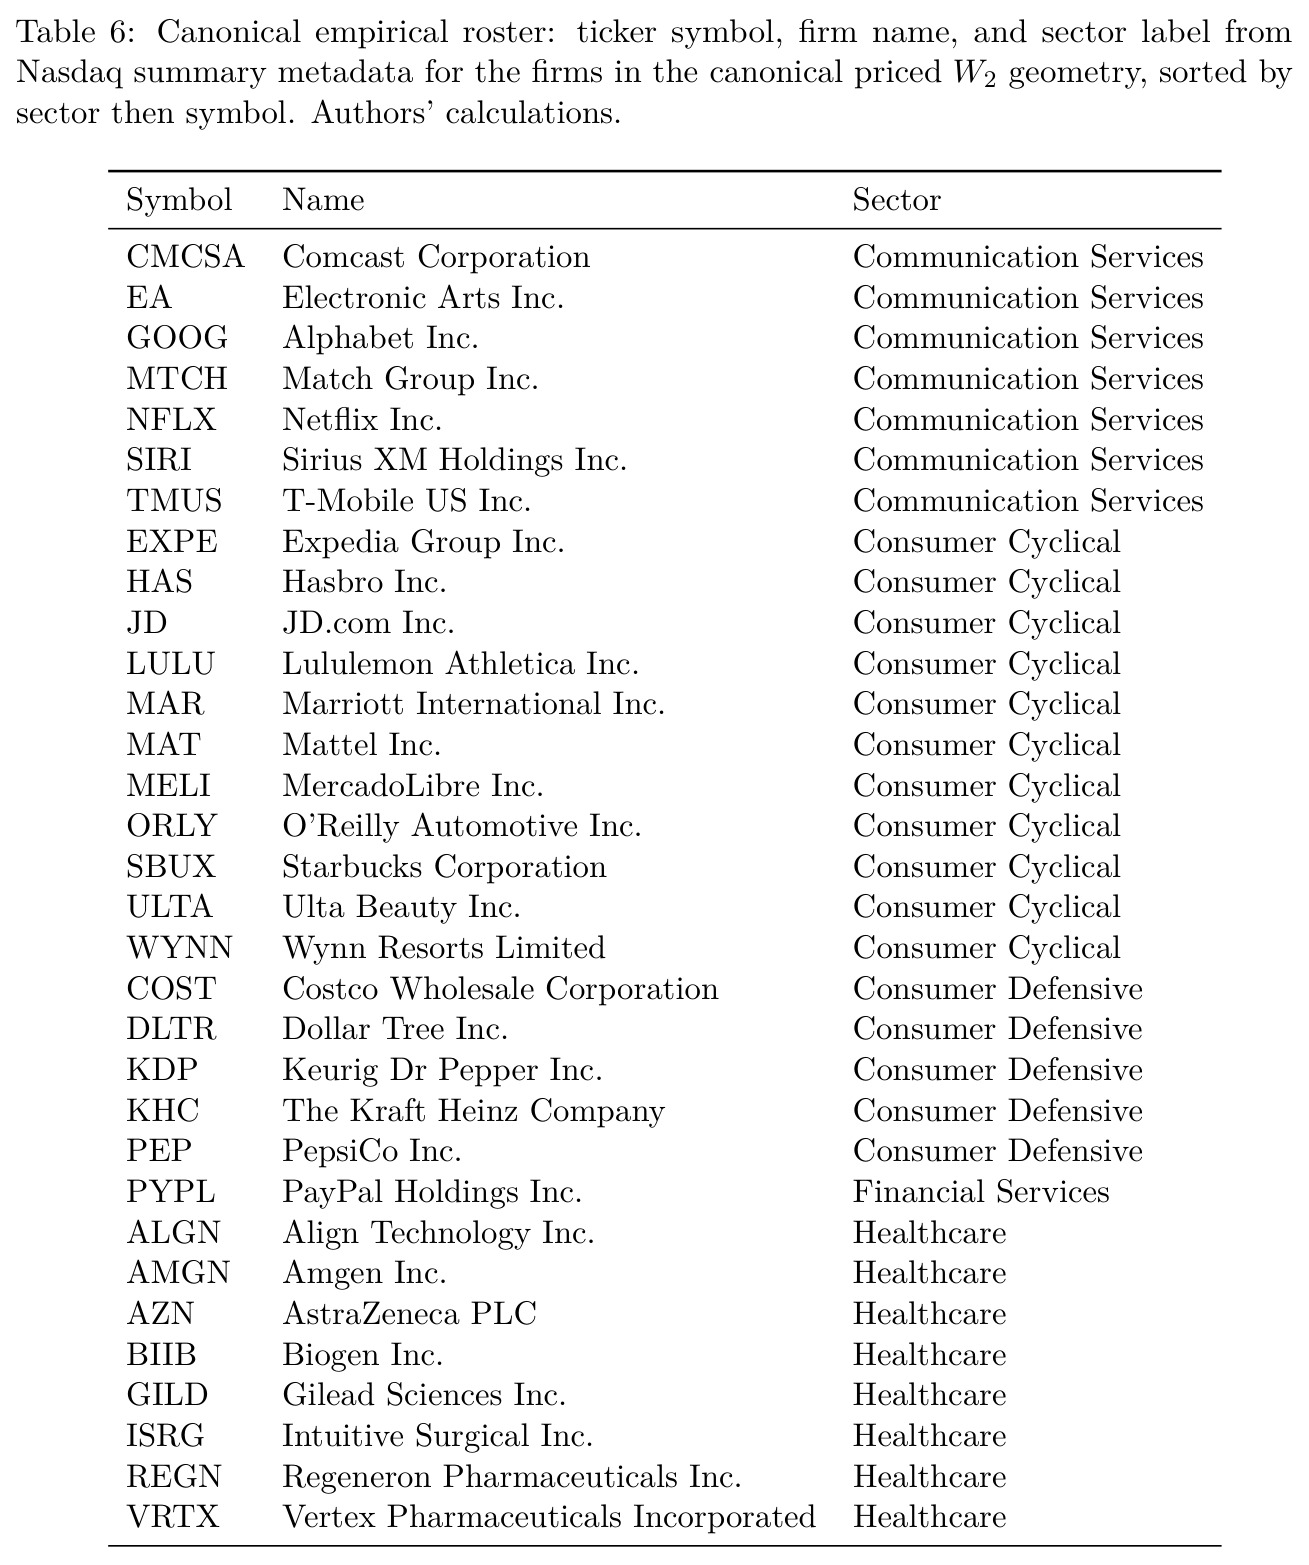
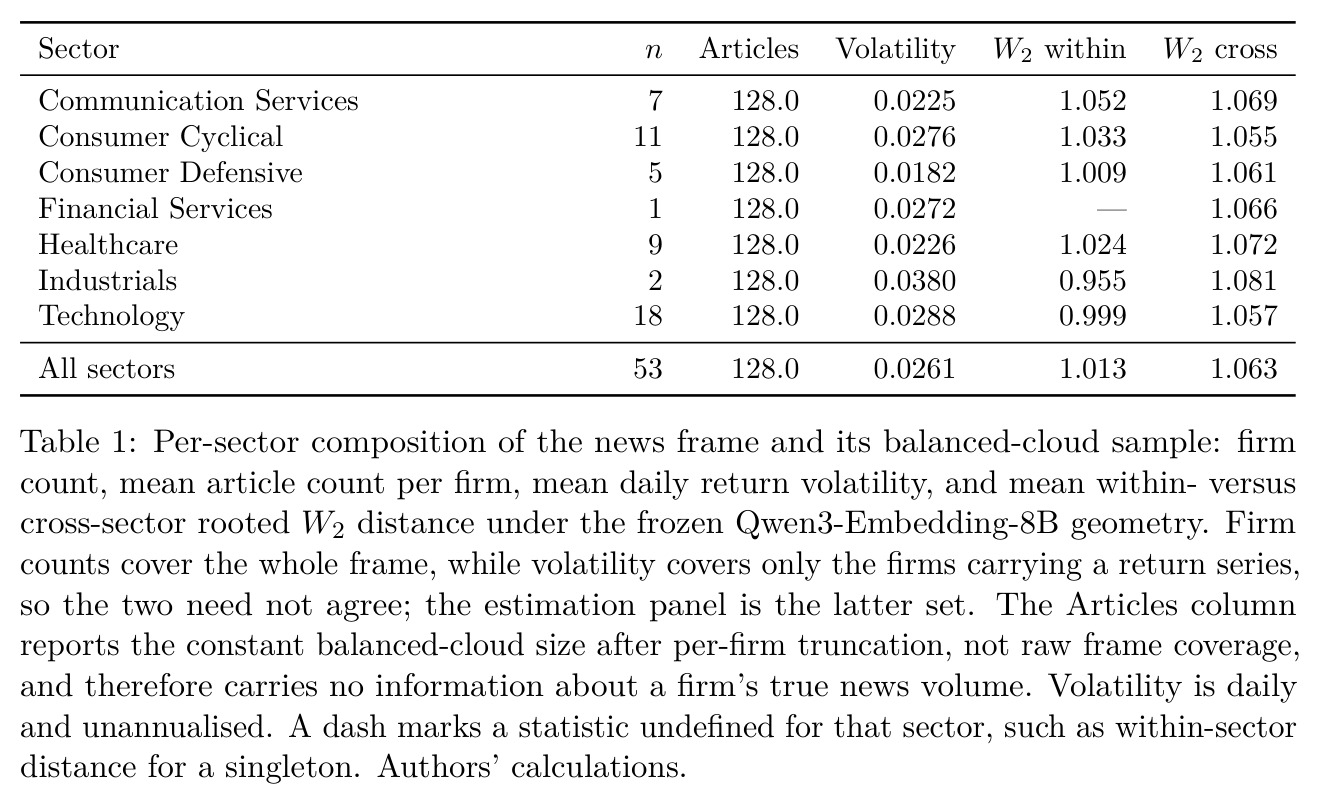
第一步(语料):输入 Nasdaq 公共 ticker 索引新闻档案,对 2018–2022 窗口施加每年至少 64 篇的覆盖筛得到 53 家公司(含无本地收益序列、后被剔除的 WBA),再按 URL 哈希确定性排序、每公司截取 128 篇形成均衡云——截断使几何跨公司可比,但刻意抹去新闻量信息。第二步(嵌入):用固定的 Qwen3-Embedding-8B 把每篇文章映射为 4096 维行归一化向量,公司即经验分布 $\hat C_i$。第三步(目标锚定对齐,式 11):对每个有序对 $i\neq j$ 解 $\pi_{ij}\in\arg\min_\pi \frac{1}{M}\sum_m \|x_{im}-x_{j,\pi(m)}\|_2^2$($M=128$,并列时按预定确定性规则选择),得到对齐同伴点 $y^m_{ij}=x_{j,\pi_{ij}(m)}$。第四步(单纯形重构,式 12):$w_i\in\arg\min_{w\in\Delta_{-i}} \frac{1}{M}\sum_{m=1}^M \|x_{im}-\sum_{j\neq i} w_j y^m_{ij}\|_2^2$,输出行 $W_{ij}^\flat=(w_i)_j$、$W_{ii}^\flat=0$,行非负且和为一,全部 52 个目标重复后得冻结场。第五步(空间闭包):解二次调整问题 $\min_a \frac12\|a-\xi_i\|^2+\frac{\lambda}{2}\sum_j W_{ij}\|a-b_j\|^2$,由引理 1 的一阶条件得定理 1 的 $B=\rho WB+(1-\rho)\xi$、$\rho=\lambda/(1+\lambda)$,在 $\|\rho W\|<1$ 下定理 2 给出唯一约简形式 $B=(1-\rho)(I-\rho W)^{-1}\xi$。第六步(收益桥与估计):命题 2 的标量投影给出 $r_t=\rho W r_t+x_t$;QMLE 以球形工作扰动集中出含 $T\log|I-\rho W|$ 的目标,在 $|\rho|<1$ 上搜索;两场情形进入 $r_t=\rho_B W^\flat r_t+\rho_N W^{news} r_t+x_t$,约束 $0\le\theta\le1$、$\rho_B+\rho_N<1$,边界 QLR 用受限拟合模拟零分布。第七步(推断):2,000 次联合日期平稳自助(期望块长 21),报告 95% 经验分位区间。
技术新颖性
技术新颖性可从四个维度评估。表示维度:这是把分布值公司特征推进到截面交互场构造的工作——作者的两篇姊妹论文用分布距离分别研究成对协方差包络与组合风险界、配置(Gawronsky & Huang 2026a,b),本文填补中间的多公司层级,把目标特定对应转成横截面场。几何维度:目标锚定重构在数学上严格区别于自由重心(固定目标与对齐、只优化坐标),并因此能产出有向场——对称距离输入、非对称场输出是构造的直接推论而非假设。计量维度:免带宽的行随机场与 QMLE 的对接保持了经典空间推断条件于已知 $W$ 的纪律,先冻结场再估计收益方程消除同样本反射;多场闭包(定理 3、命题 1)证明混合 $W(\theta)$ 可容许、$\rho_B+\rho_N<1$ 自动成立,且 $I-\rho_B W^\flat-\rho_N W^{news}=I-(\rho_B+\rho_N)W(\theta)$ 使集中目标无需新 Jacobian——单场拟合成为嵌套族的边界点,可用边界校准 QLR 做正式的通道剔除检验。理论维度:衰减定理 5 给出 $\left(\frac{1-\rho}{1+\rho}\right)^2 V_\pi(z)\le V_\pi(S_\rho z)\le V_\pi(z)$,不需要对称性或谱隙假设,用平稳分布加权范数与 Jensen 不等式即得;再与特征到暴露的转移不等式(式 14)复合成散度证书(式 18),把文本异质性到调整后暴露散度下限的整条因果链写成一个 display,每个环节方向已知。所有结果都明确标注为条件性陈述。
实验结果
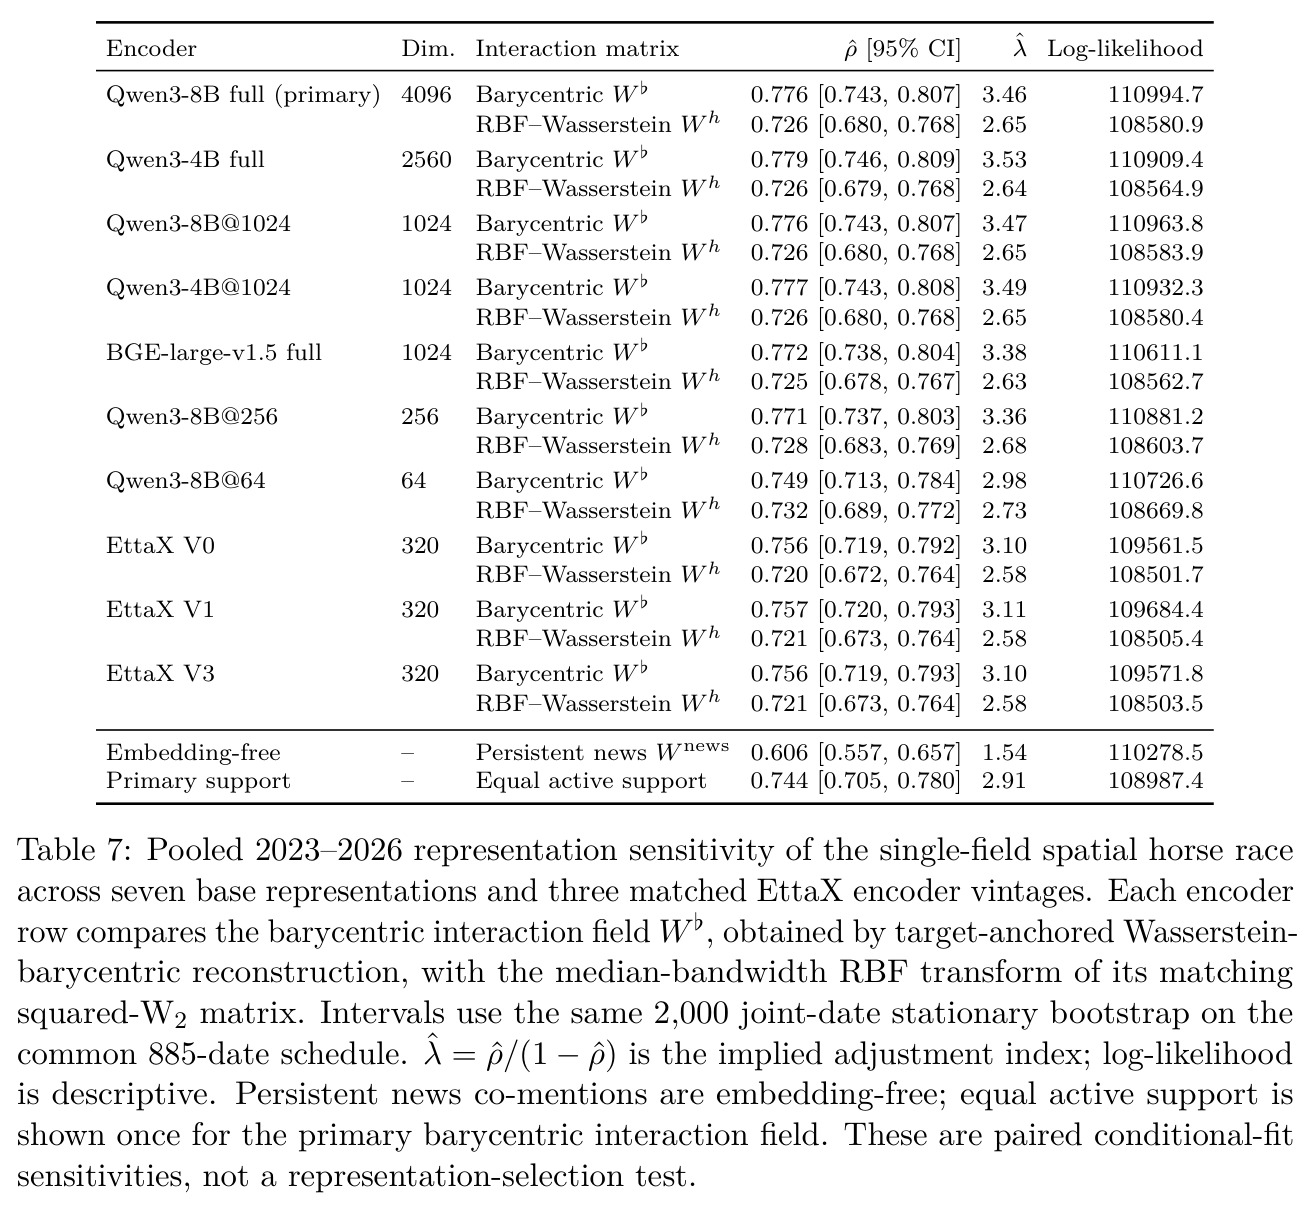
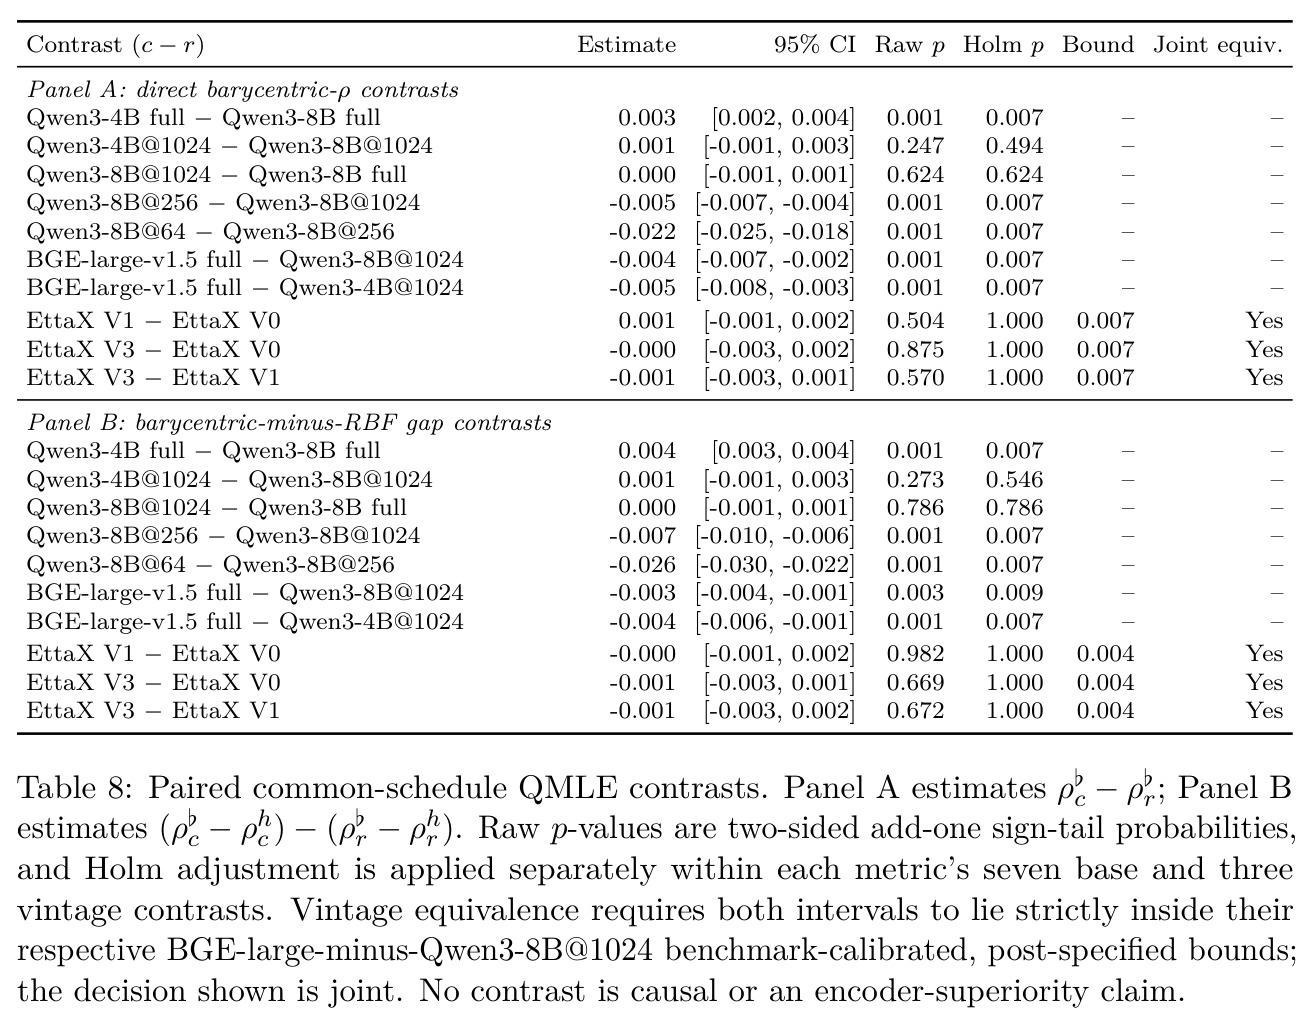
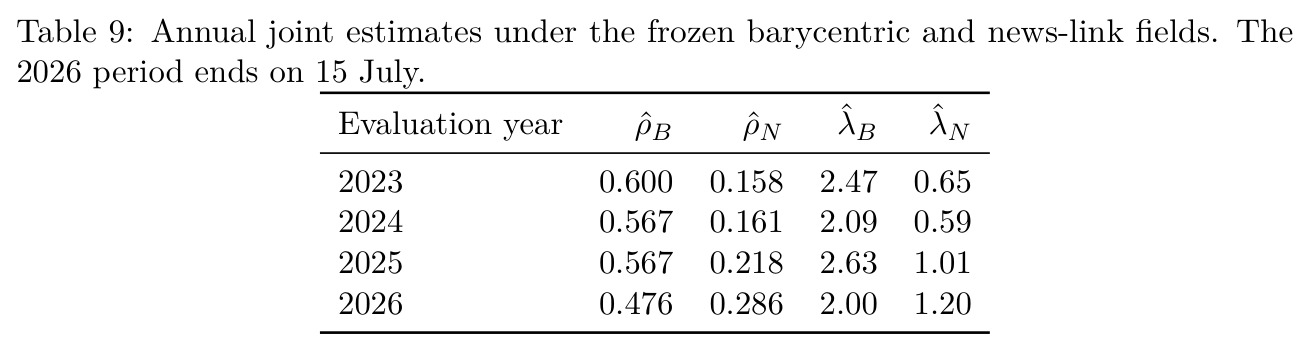
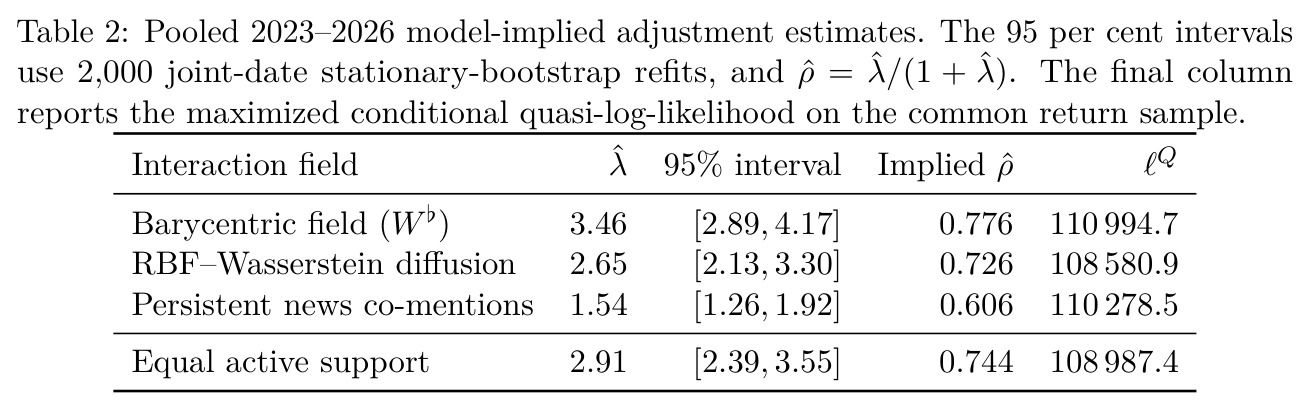
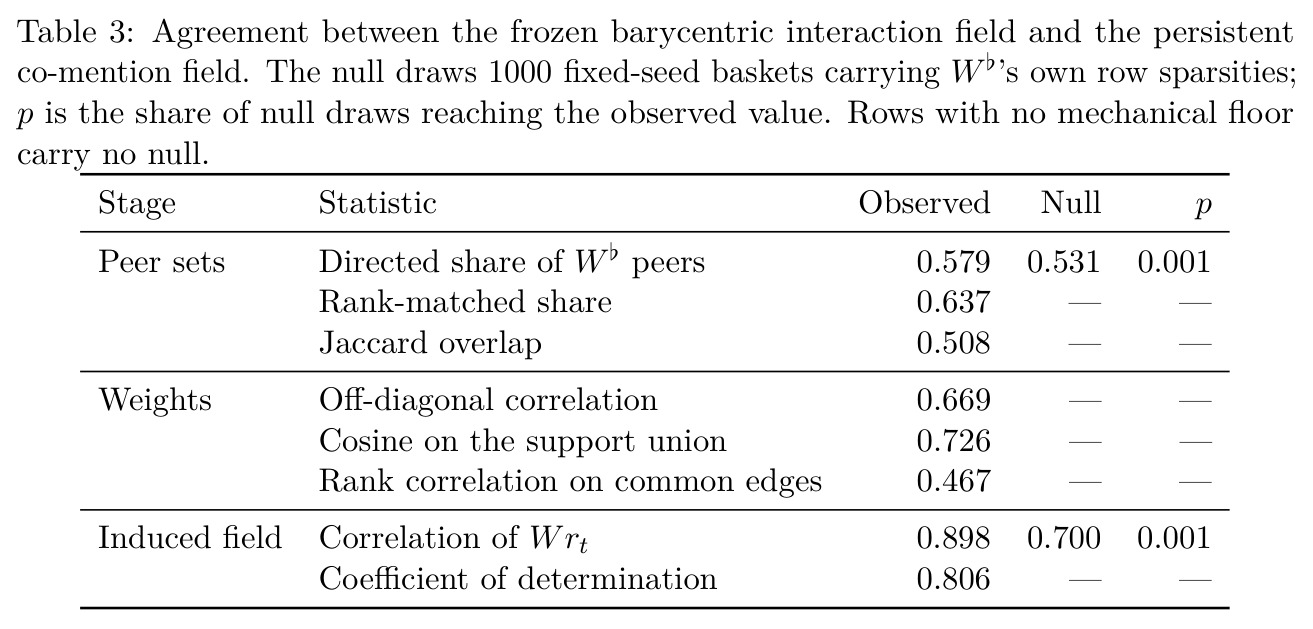
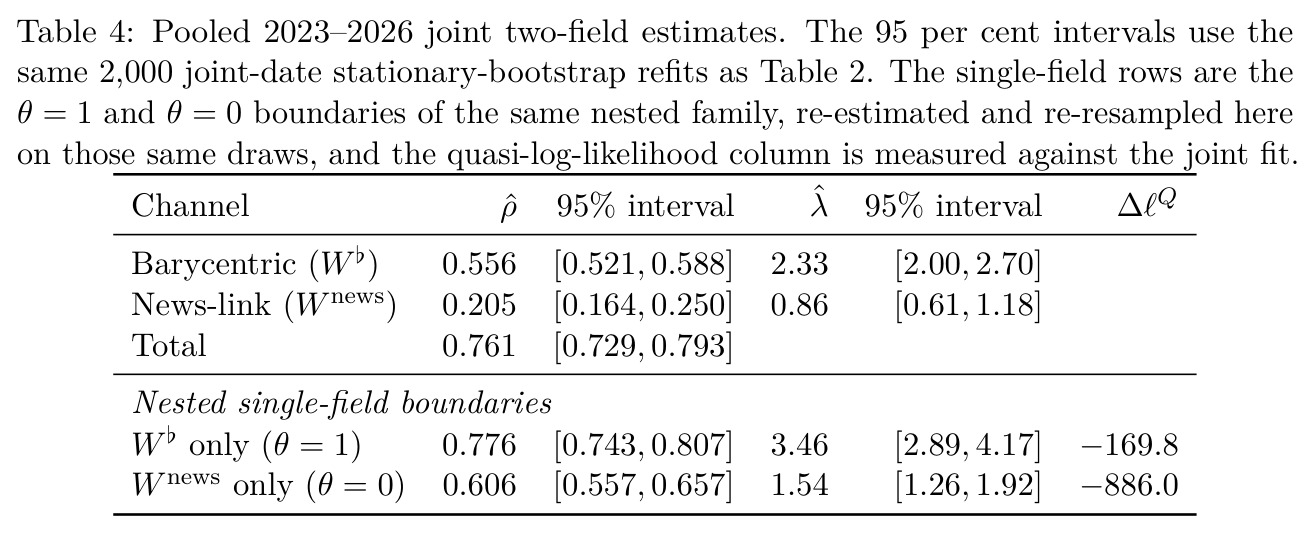
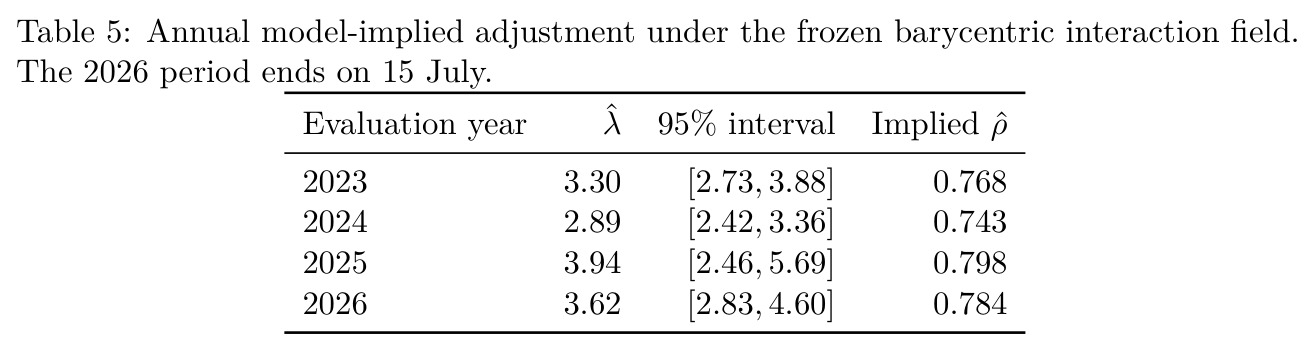
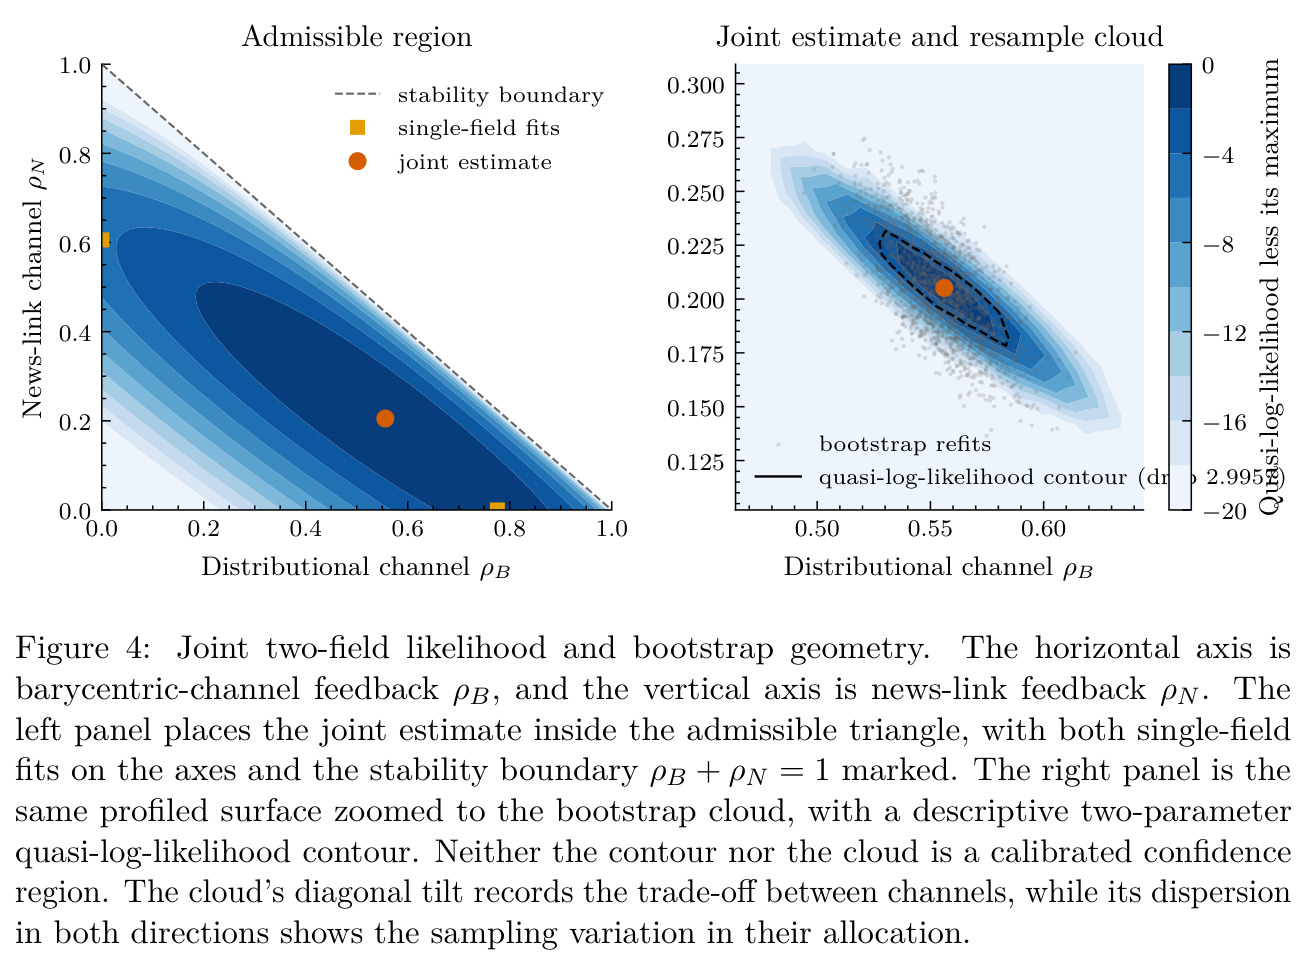
证据按四个递进问题组织,样本为 52 家公司、2023-01-03 至 2026-07-15 的 885 个共同交易日,所有场在 2022 年末冻结。其一,存在性(Table 2):重心场池化调整指数 $\hat\lambda=3.46$,95% 区间 $[2.89,4.17]$,隐含 $\hat\rho=0.776$,条件拟对数似然 $\ell_Q=110\,994.7$——工作模型中同伴错配惩罚约为独立暴露偏离惩罚的 3.5 倍。其二,机制(Table 2 对照行):用同一批 Wasserstein 距离构造的 RBF 扩散场只有 $\hat\lambda=2.65\,[2.13,3.30]$、$\ell_Q=108\,580.9$;保留 $W^\flat$ 支持集但换成等权的对照为 $\hat\lambda=2.91\,[2.39,3.55]$、$\ell_Q=108\,987.4$;重心场似然分别高出约 2,414 与 2,007,说明同伴选择与联合重构坐标各自都有增量。新闻共 mention 场单独估计 $\hat\lambda=1.54\,[1.26,1.92]$、$\ell_Q=110\,278.5$。其三,场间关系(Table 3):两场同伴有向重叠 0.579 对匹配随机地板 0.531($p=0.001$);重心行平均 38.8 个活跃同伴对新闻场 27.1;共同边秩相关仅 0.467;但诱导同行收益序列相关高达 0.898($R^2=0.806$,随机地板 0.700,$p=0.001$),公司级相关 0.553–0.973。其四,联合两场(Table 4):$\hat\rho_B=0.556\,[0.521,0.588]$、$\hat\rho_N=0.205\,[0.164,0.250]$,总反馈 0.761 $[0.729,0.793]$ 包含单场 0.776——联合估计是重新分配而非放大总反馈;$\hat\lambda_B=2.33\,[2.00,2.70]$、$\hat\lambda_N=0.86\,[0.61,1.18]$;边界校准 $\mathrm{QLR}_N=339.5$、$\mathrm{QLR}_B=1772.1$,均 $p=0.0005$;相对两个单场边界的原始似然增益为 169.8 与 886.0;通道系数自助相关 $-0.683$。其五,持久性(Table 5):冻结场下年度 $\hat\lambda$ 为 2023 年 3.30、2024 年 2.89、2025 年 3.94、2026 年(133 个交易日)3.62,四个区间全部高于零反馈基准。附录 B.2 的表示敏感性(宽度 1024/256/64、Qwen3-4B、BGE-large-v1.5、EttaX 时间快照)作为设计诊断报告。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 条件空间收益依赖(池化单场,52 家公司、885 个交易日,冻结场) | 调整指数 $\hat\lambda$(95% 平稳自助区间)与条件拟对数似然 $\ell_Q$ | 重心场 $\hat\lambda=3.46\,[2.89,4.17]$,$\hat\rho=0.776$,$\ell_Q=110\,994.7$ | RBF–Wasserstein 扩散(同距离、中位数带宽)$\hat\lambda=2.65\,[2.13,3.30]$,$\ell_Q=108\,580.9$ | $\ell_Q$ 高约 2,414;$\hat\lambda$ 高 0.81,说明联合重构优于纯距离衰减 |
| 重构坐标信息量(保留相同活跃同伴集) | 条件拟对数似然 $\ell_Q$ | 拟合张成权重 $\ell_Q=110\,994.7$($\hat\lambda=3.46$) | 等权活跃支持 $\hat\lambda=2.91\,[2.39,3.55]$,$\ell_Q=108\,987.4$ | $\ell_Q$ 高约 2,007,证明拟合坐标本身(而非同伴选择)携带信息 |
| 联合两场下的通道必要性(各自 $H_0: ho_k=0$) | 边界校准 QLR 统计量(受限零分布,$p$ 值) | $\mathrm{QLR}_B=1772.1$(剔除重心场)、$\mathrm{QLR}_N=339.5$(剔除新闻场) | 两个嵌套单场边界(对应受限拟合) | 两者 $p=0.0005$:每个场在另一个在场时仍显著改善条件拟合 |
| 通道分配(联合模型 vs 单场估计) | 通道调整指数 $\hat\lambda_k=\hat\rho_k/(1-\hat\rho_B-\hat\rho_N)$ | $\hat\lambda_B=2.33\,[2.00,2.70]$,$\hat\lambda_N=0.86\,[0.61,1.18]$,总 $\hat\rho_B+\hat\rho_N=0.761$ | 单场:重心 $\hat\lambda=3.46$、新闻 $\hat\lambda=1.54$ | 总反馈与单场 0.776 相当,重心通道占约 73% 的模型隐含同伴权重 |
局限与改进
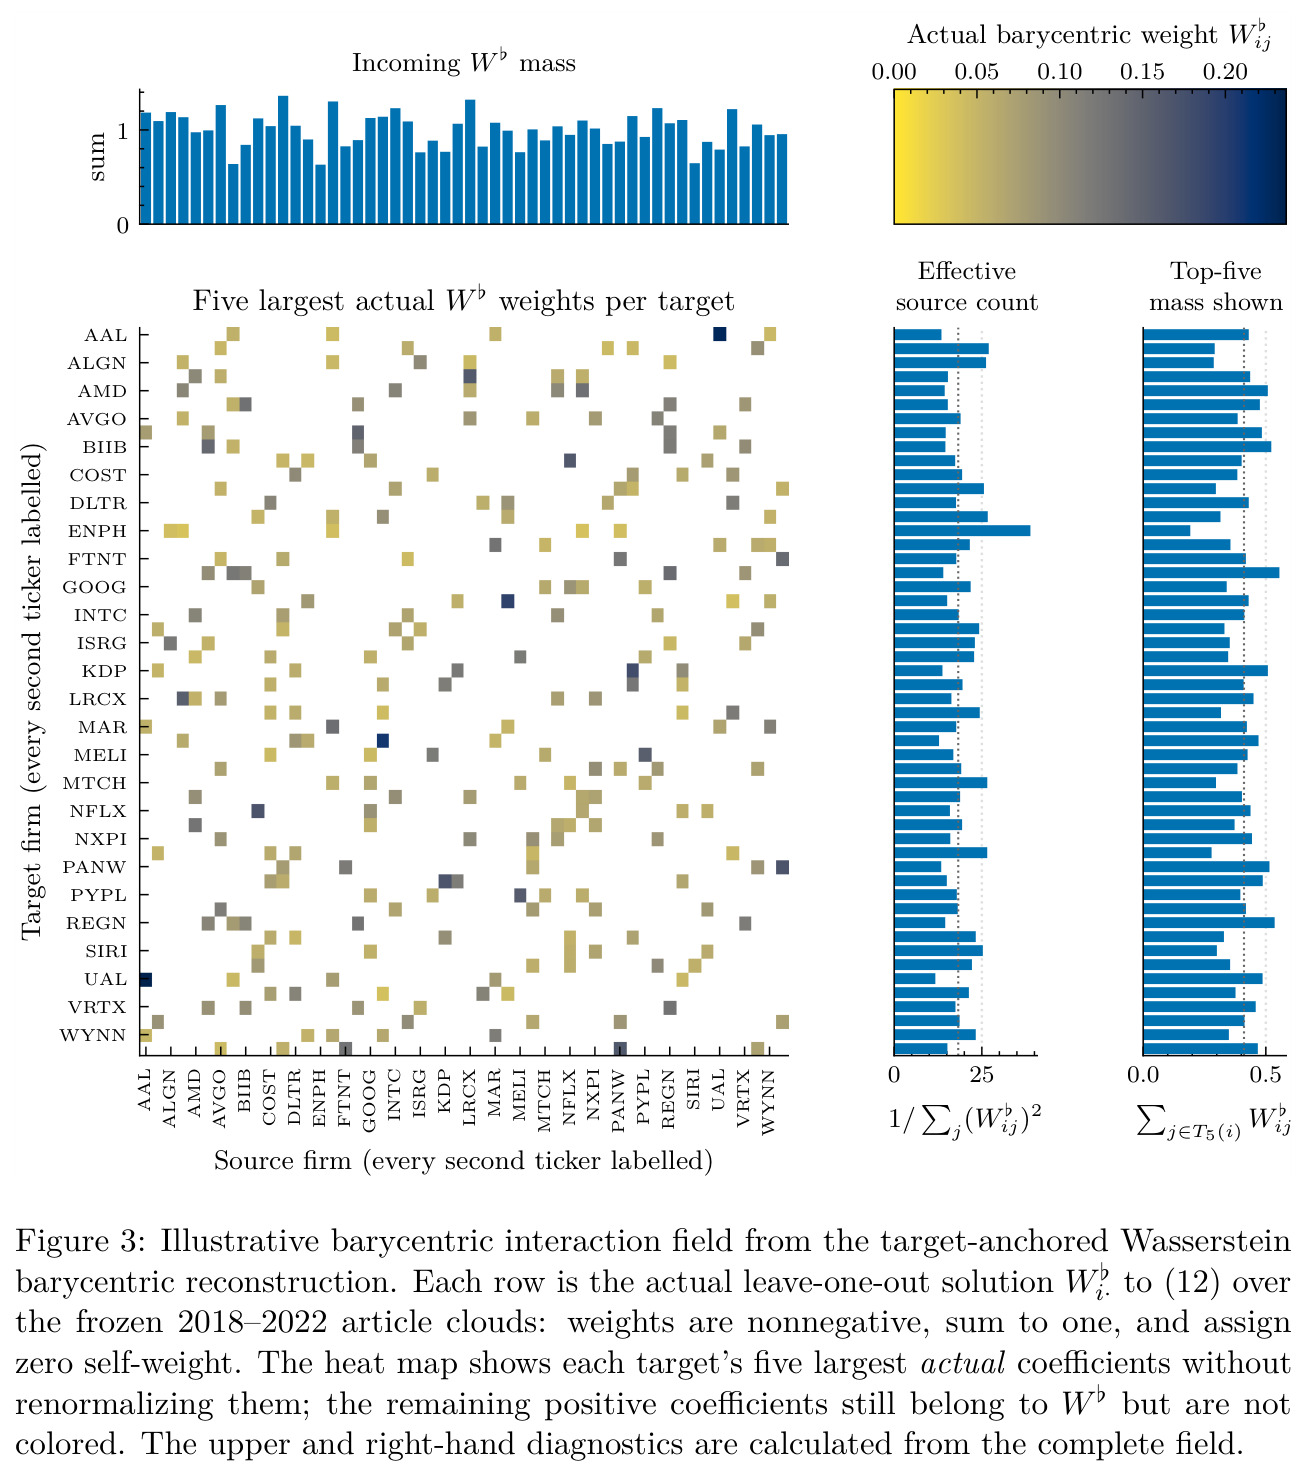
作者明确承认三层限制。识别层面:二次准则是 as-if 的约简表示,不声称经理真的观察 $W^\flat$ 或求解该优化;先冻结场只消除机械同样本反馈,并不能使文本外生于行业、技术、注意力与报道选择,$\hat\lambda$ 是工作模型调整指数,不是因果同伴效应、可观测管理成本或几何不变的结构参数——除非维持收益桥限制使伪真值 $\rho^\star$ 等于结构 $\rho$。测量层面:结果依赖固定表示与地面度量、均衡 128 篇截断(删除新闻量信息)、并列最优指派的预定选择规则(未证明其他最优选择不改变 $W^\flat$);跨几何似然比较是测量设计之争而非几何无关排名。外部效度层面:52 家大盘、幸存者条件化、科技占约三分之一(18 家)、两个行业不足 3 家;2026 年只有 133 个交易日。散度证书中的载体 $t$、常数 $L$ 与松弛 $\tau_i$ 均未校准,Corollary 3 只是条件性限制。我自己的观察补充四点:其一,重心行平均 38.8/51 个活跃同伴相当稠密,分布张成权重的经济含义被稀释,且同伴重叠对随机地板的优势只有约 5 个百分点;其二,重心场对 RBF 的优势来自非嵌套的描述性似然比较,没有正式检验;其三,生产用 Qwen 编码器训练时间晚于 2018–2022 文章窗口,存在表示层面的前视,vintage 对照(EttaX V0/V1/V3)受限于容量不匹配只能算诊断;其四,全文无经济价值评估(如多空组合、协方差预测改善),对投资者的可用性仍是空白;收益为原始简单收益(未减无风险利率),球形工作扰动也是强简化。
独立分析的弱点
以下弱点评述均附改进方向。其一,样本窄且偏科技:52 家持续高覆盖大盘股(科技 18 家、金融服务仅 1 家),结论对中盘、小盘、非美市场未知——应构建多个 ex ante 窗口与多市场面板,或用层次模型跨宇宙借用强度。其二,稠密场解释困难:平均 38.8 个活跃同伴意味着每家公司的同伴平均接近全市场平均,难以讲述具体的供应链或技术故事——可在单纯形上加 $L_1$ 或熵正则引入稀疏,或系统报告 top-$k$ 权重与行稳定性(图 3 的有效源数与 top-5 质量份额已是雏形)。其三,非嵌套比较无推断:重心对 RBF 的 $\ell_Q$ 差约 2,414 但作者自己承认是描述性诊断——可发展针对分布值几何的比较检验,如子采样一致性、预注册多种地面度量下的胜率统计。其四,表示前视:Qwen3-Embedding-8B 训练语料晚于文章窗口,云的几何可能吸收后见信息——应使用时点语料训练的同容量编码器,或给出多个同容量开源快照对照(EttaX 对照因容量不同而受限)。其五,识别空白:没有排除约束或冲击设计,$\lambda$ 的调整解释完全依赖维持假设——可结合分析师覆盖变动、供应链冲击等准实验检验通道。其六,可扩展性:$n(n-1)$ 个 $128\times128$ 指派在 53 家时廉价,但千级公司会昂贵——可用熵正则 Sinkhorn 与锚点近似。其七,推断稳健性:球形工作扰动忽略式 (19) 中真实的异方差与截面相关,负的统计解虽被正确解读为模型外,但可比较 GMM 或经验似然下的 $\hat\rho$。
未来方向
作者指出的方向包括:在连续的 ex ante 窗口中滚动重构场,检验跨信息机制与公司进出条件下条件模式的持久性;把样本扩展到历史较短的公司与更宽宇宙;尝试加权或非均衡云、其他地面度量与留出评估窗,观察场的哪些性质在测量选择下存活;扩展到多于两个场时报告联合不确定性与诱导信号共线性;对转移约束(载体 $t$、常数 $L$、松弛 $\tau_i$)做数值校准,把散度证书从条件性限制变成可测对象。基于其成果可自然延伸的工作:把 $W^\flat$ 输入协方差与组合问题,检验分布场能否改善最小方差组合或风险预测(直接衔接姊妹篇的成对协方差包络与风险界);把式 (12) 的最小重构残差定义为公司层面的不可表示性或独特性因子,检验其截面定价含义;让场随时间滚动、$\rho$ 随波动率或利率状态变化,构造状态依赖的空间闭包;在债券、加密资产或行业指数截面重复该构造,检验分布张成作为同伴定义的普适性;以及把该场作为先验用于注意力与传染研究,识别信息沿重构相关性传播的路径。
复现评估
可复现性中等偏上但当前不完整。数据端全部公开:Nasdaq 按 ticker 索引的公共新闻档案(受供应商条款限制不得再分发)、Yahoo Finance 通过固定版本 yfinance 客户端取调整价、嵌入经 OpenRouter 调用 qwen/qwen3-embedding-8b。作者承诺论文接收后存放含版本化代码、环境说明、派生交互场、估计输出与图表脚本的公开存档(DOI 待补),即当前代码尚未可得。算力需求很小:约 6,800 篇文章的嵌入 API 调用;$53\times52$ 个 $128\times128$ 平衡指派(POT 库或匈牙利算法即可);QMLE 是一维网格搜索加行列式项;最重的是 2,000 次联合日期自助重估,CPU 数小时量级。复现难点有三:并列最优指派的确定性选择规则必须精确照搬,否则 $W^\flat$ 可能在行级变动;覆盖筛与公司清单边界(如 WBA 因无本地收益序列被剔除)需逐条对齐;简单收益、缺失日删除而非插补等数据表细节会影响 885 日面板。技术上需要熟悉最优传输、空间 QMLE 的集中似然与 $\log|I-\rho W|$、平稳自助;行随机性、零对角、区间覆盖等性质都可用自动化测试验证。
论文图表