S-Space:探索多模态语言模型中的内部空间工作区 S-Space: Exploring Spatial Workspace in Multimodal Language Models
发现多模态大模型内部存在三维线性空间工作区,坐标可读出可编辑,空间推理瓶颈在视角变换计算。
前置知识
线性表征假设
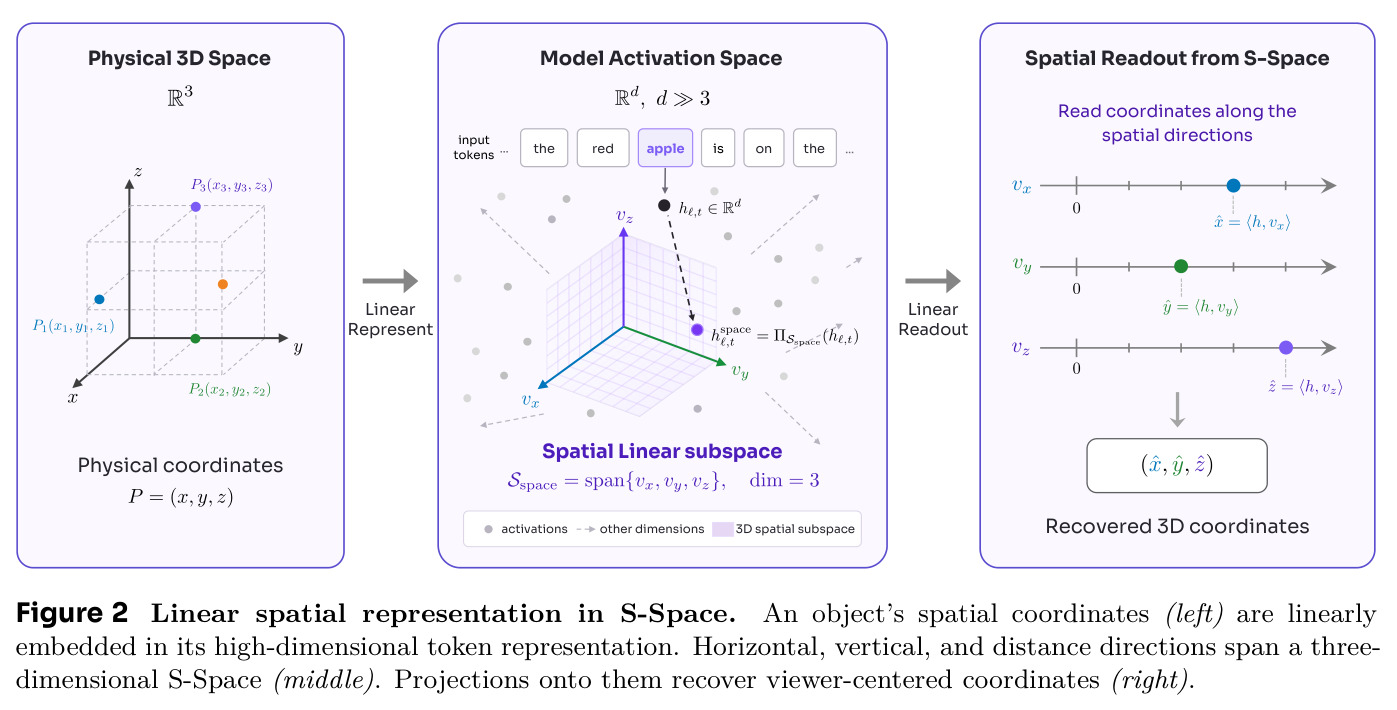
大语言模型内部被认为把语义概念以线性方向(激活空间中的向量)的形式组合存储。例如“左右”“情绪”“真伪”等概念常对应残差流中的固定方向:把激活投影到该方向可以读出概念强度,沿该方向加减向量可以编辑概念。本文把这一假设从离散概念推广到连续量,假设物体在观察者参考系下的三维坐标线性编码在物体名 token 的隐藏态中。
S-Space 的定义、识别与读出全部建立在该假设之上:三维线性子空间之所以能承载物体位置,正是因为坐标被假设为线性嵌入在 token 表征里。
残差流与中间层隐藏状态
Transformer 每一层把计算结果累加进残差流,token $t$ 在第 $\ell$ 层的隐藏状态 $h_{\ell,t}\in\mathbb{R}^{d_{model}}$ 是其当前表征。早层更贴近输入编码,晚层日益对齐下一词预测,中间层承载最丰富的抽象语义。本文把探针放在中间层,例如 Molmo2-ER 的 L17–L22、Qwen3.6-27B 的 L43。
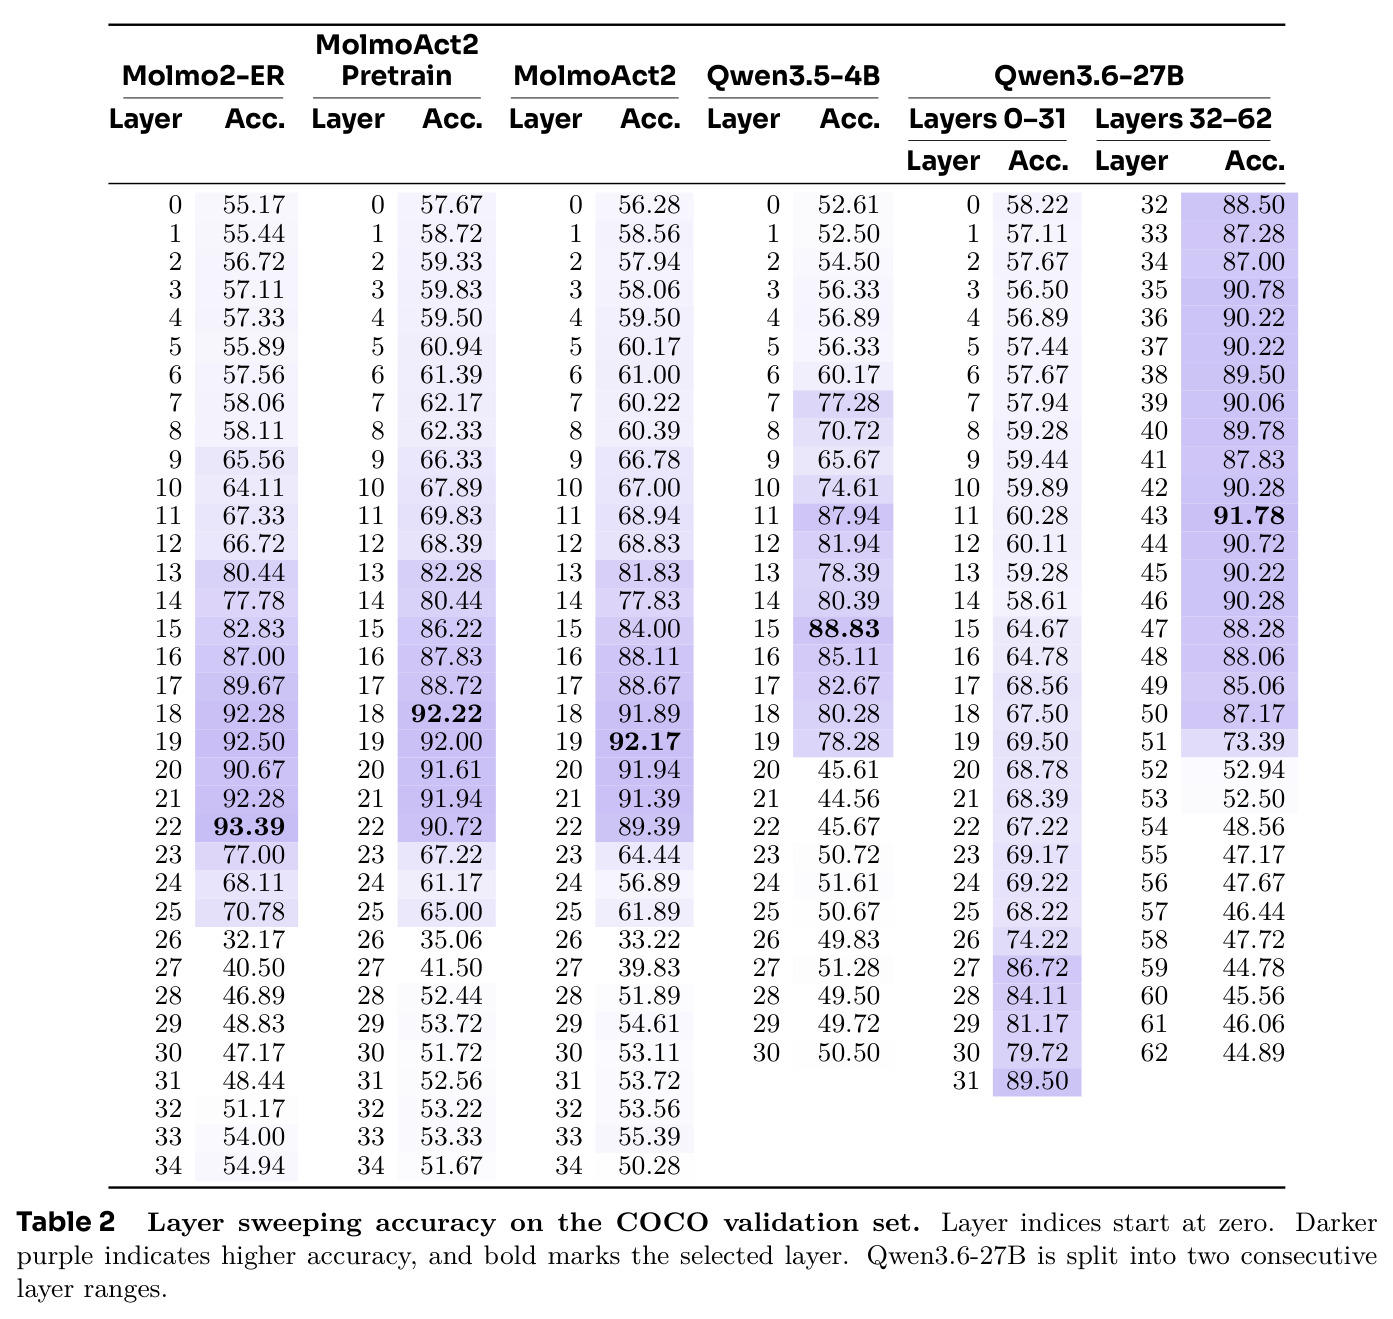
S-Space 被定义为特定层隐藏态的三维子空间,对该层内所有 token 位置共享;层选择直接决定读出精度,论文用整层扫描(Table 2)来挑最优层。
答案对比与梯度方向(Jacobian 视角)
对“左还是右”这类二选一问题,答案对比定义为 logit 差,如 $s_{p,x}=\text{logit}(right)-\text{logit}(left)$,度量模型当前偏向;对隐藏态求梯度 $\nabla_{h}s$ 给出“沿哪个方向扰动表征最能增大该偏向”。前作 J-Space 用这种 Jacobian 把中间激活映射到词表,从而把内部表征“翻译”成离散概念。
本文识别 S-Space 三条轴的核心运算就是对相对空间问题的答案对比求梯度,再对梯度做角色反对称组合;理解 logit 差与梯度方向才能看懂识别公式 Eq.(2)。
因果干预(激活编辑)
读出准确只说明表征“含有”信息,要证明模型真的“使用”它需要干预实验:直接修改隐藏状态后让模型继续生成,观察输出是否按预期改变。常见做法是 $B=V(V^\top V)^{-1}$、$h'=h+B(c'-c)$ 的最小范数编辑,只改动目标子空间内的分量、保持正交分量不变。
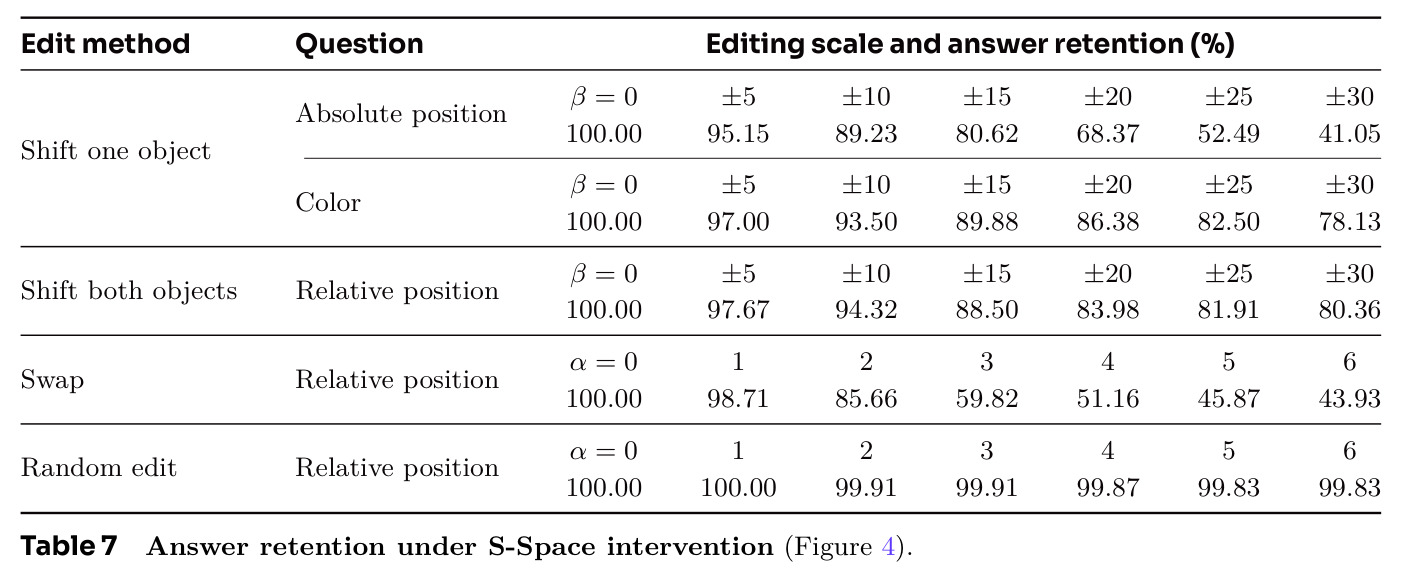
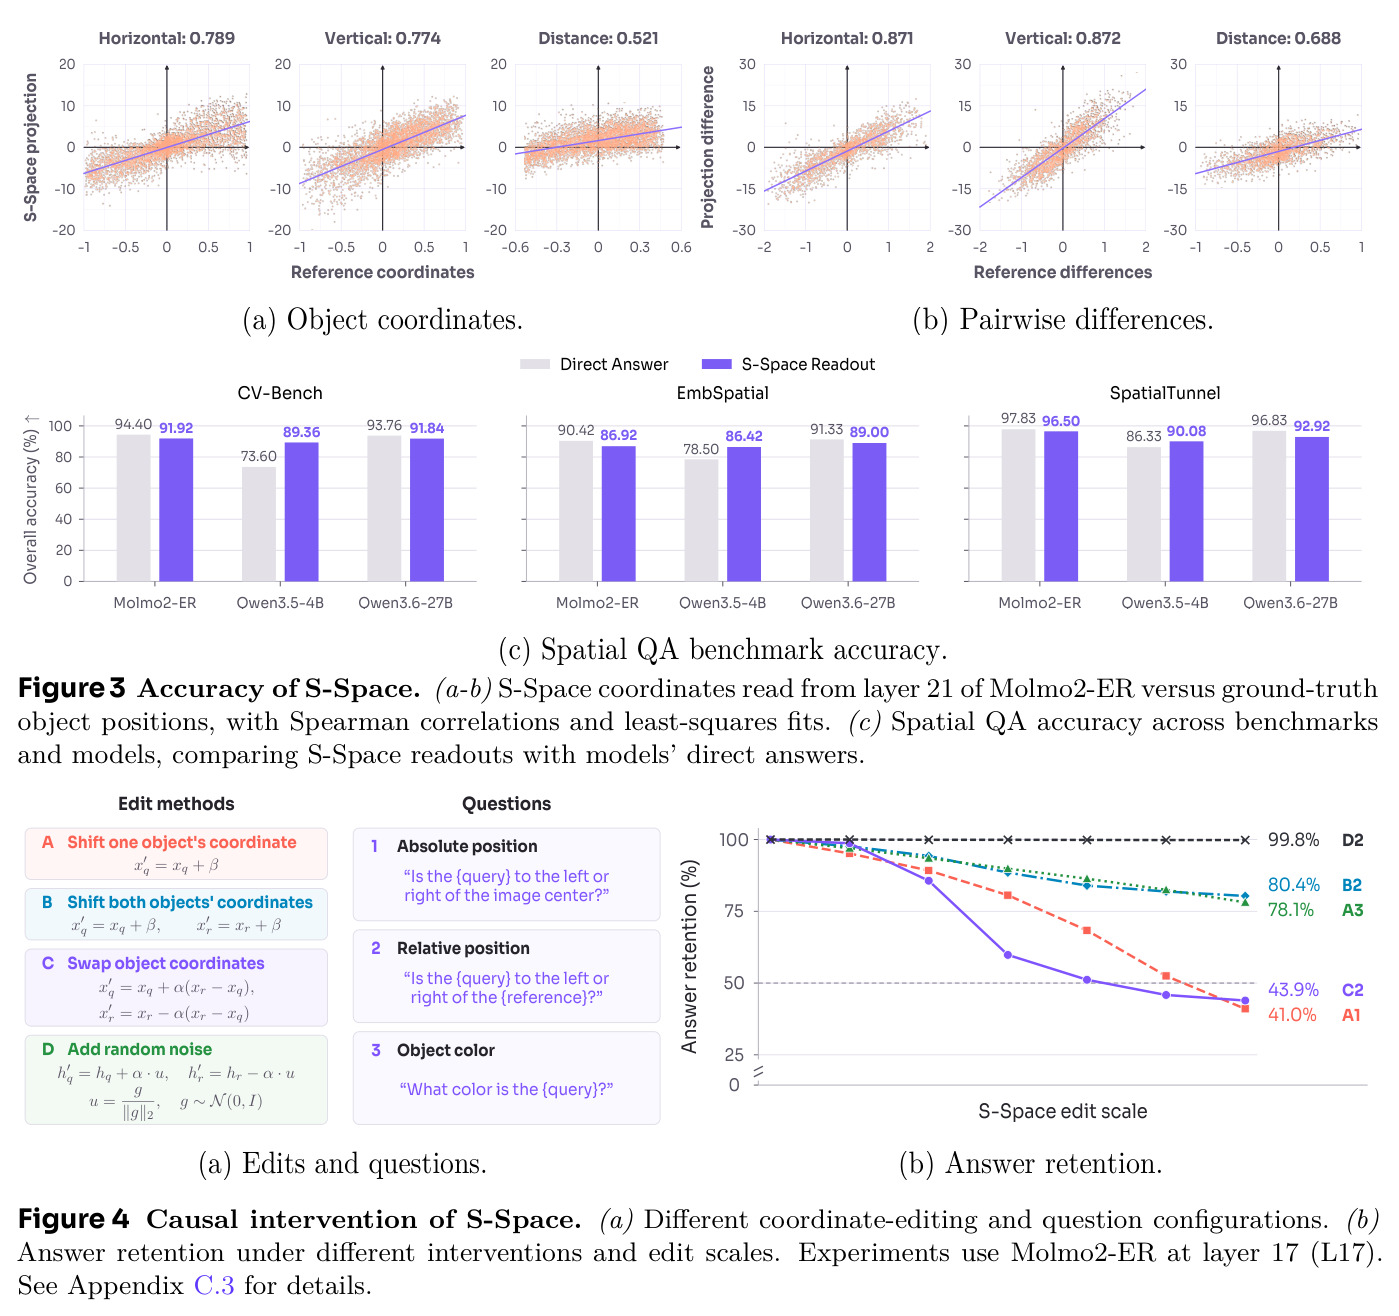
论文靠编辑 S-Space 坐标来改变空间判断、同时保留颜色等非空间判断(Figure 4),这是确立 S-Space 因果地位、而不仅是统计相关的关键证据。
观察者中心参考系
以相机/观察者为原点的自我中心(egocentric)坐标系:左-右、上-下、近-远都是相对观察者定义的方向,区别于世界坐标系或以某物体为中心的坐标系。认知科学中的心理旋转研究表明,人在视角转换任务中需要在参考系之间做 mental transformation。
S-Space 编码的正是观察者中心坐标;论文诊断出的核心瓶颈恰好是模型在不同参考系之间变换(如想象从左侧看场景)时失败,这一概念是理解全文诊断结论的前提。
研究动机
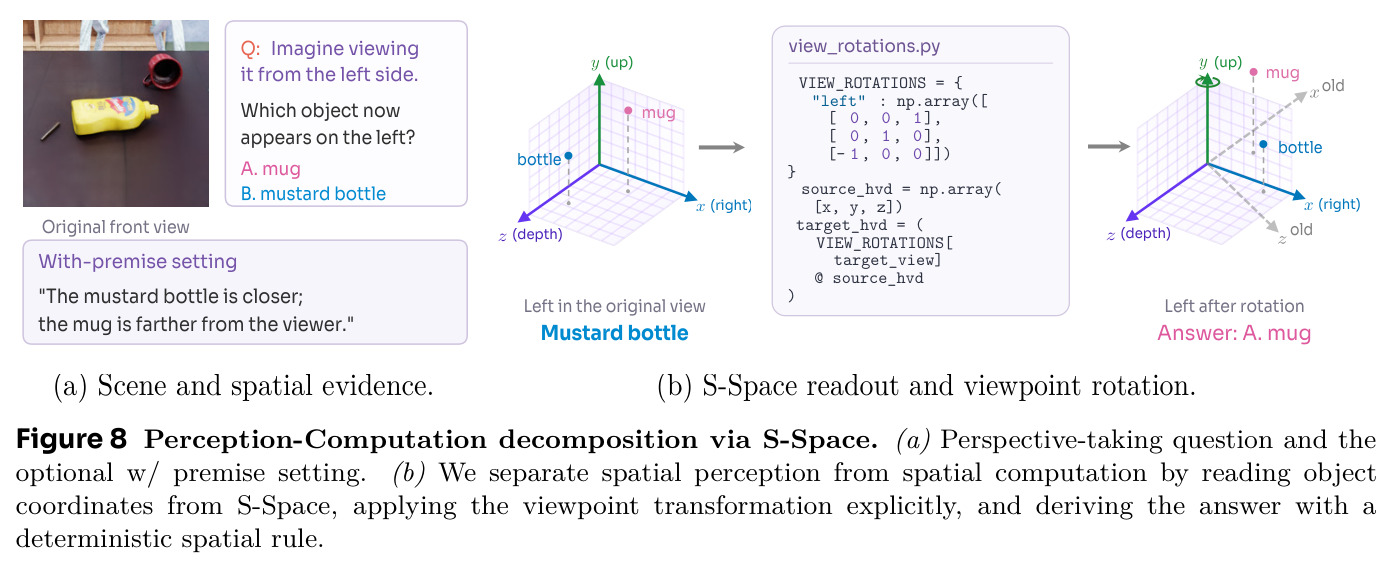
多模态大语言模型(MLLM)在重建、规划、导航、操作等物理世界任务上应用快速扩张,但稳健的空间推理仍是根本短板:在人类毫不费力就能完成的任务上持续存在巨大性能差距。更麻烦的是诊断缺位——仅看端到端行为无法定位失败来源:模型在视角转换问题上答错,可能是因为“没看清物体在哪”(感知失败),也可能是因为“看清了但在头脑中变换视角时算错”(计算失败),外部答案对这两种情况一模一样。前沿 VLM 在 SpinBench 这类看似简单的视角转换基准上直接回答只有 60% 左右,而内部到底哪里出了问题,此前没有工具能说清楚;已有工作要么只报告基准分数,要么只在合成场景中研究二维空间偏差,对真实场景下空间信息如何被编码、变换、并最终用于生成回答,缺乏统一解释。
本文的目标是本文要回答“空间信息在 MLLM 内部如何表示、如何被变换、如何塑造输出”。具体目标分三层:第一,验证 MLLM 是否拥有类似人类视觉认知中“心理工作空间(mental workspace)”的内部结构——一个可以被写入、维护和操作的空间表征;第二,找到这个结构并给出可操作的数学形式,证明它(1)高保真地编码物体连续坐标、(2)能被内部推理过程变换、(3)被语言输出因果地访问;第三,把它变成诊断空间推理失败的手术刀,把空间感知与空间计算干净地解耦,指出失败究竟发生在哪一环,为后续针对性改进指明方向。
与已有工作不同的是,已有研究的切入角度要么是评测与偏差观察(如空间绑定、垂直-深度耦合等,且多在合成数据、二维成对关系上进行),要么是机制可解释性中的离散概念读出(SAE 特征、J-Space 的 Jacobian 词表化)。本文的独特之处在于四个“转向”:从离散概念转向连续三维坐标;从合成场景转向真实 COCO 图像;从“当前 prompt 下可读”转向“跨数据集、跨任务、跨 prompt 固定且在非空间提问下依然可读”的内在结构——从而排除 prompt 诱导伪影的解释;从只读转向“读出-写入-追踪”的统一接口,不仅能量化模型知道什么,还能改写它、并观察它随思维链推理动态演化,把表征研究推进到“工作空间”层面。
核心方法
直觉很朴素:模型要回答“苹果在杯子左边还是右边”,内部必须以可被语言输出访问的形式编码两个物体的相对位置;线性表征假设预言这种编码应是激活空间中的线性方向。本文把 MLLM 某中间层隐藏态 $h_t\in\mathbb{R}^{d_{model}}$ 中的一个三维线性子空间定义为 S-Space:三条轴分别对应观察者参考系下的水平(left-right)、垂直(above-below)与距离(close-far)方向,对特定模型和层固定、对层内所有 token 位置共享。技术路线两步:识别——用基于梯度的角色反对称程序,从 COCO 构造的相对空间问题(每轴 1000 例、5 个模板 × 2 种物体顺序)的答案对比中提取三轴方向;读出——把物体名 token 的隐藏态投影到三轴得连续坐标 $c_t=V^\top h_t\in\mathbb{R}^3$,一次前向传播即可。层选择用不相交的 1800 张图像逐层扫描验证精度,最终 Molmo2-ER 选 L22、MolmoAct2-Pretrain L18、MolmoAct2 L19、Qwen3.5-4B L15、Qwen3.6-27B L43。
核心创新是“角色反对称梯度差”。相对空间判断对 query 和 reference 两个角色的处理是天然相反的:同一个表征扰动让 query 更靠右时应偏向答案 right,而完全相同的扰动加在 reference 上则应偏向 left。因此取 $a_{p,g}=\frac{\nabla_{h^q}s_{p,g}-\nabla_{h^r}s_{p,g}}{2}$ 能强化真正与空间关系绑定、随角色反号的信号;而物体身份、措辞、场景上下文等无关效应在单个例子中未必抵消,但在跨 prompt 模板、跨 query/reference 顺序交换、跨样本求平均后期望为零。附录 B 在三条假设(表征可分解为空间+非空间+上下文分量、梯度有对应分解、空间分量随角色反号且期望为正)下证明:该估计量期望上恢复潜在空间方向,即 $\mathbb{E}_p[a_{p,g}]=\mathbb{E}_p[\beta_{p,g}]\,u_g$,归一化后 $v_g=u_g$。这与 J-Space 把激活映射到词表读离散概念有本质区别——这里得到的是连续几何轴;也不同于以往在合成数据上训练二维空间探针——这里无需训练任何探针,得到的方向跨数据集、任务、prompt 固定。
方法步骤详情
第一步,构造识别数据:从 COCO-2017 训练集取 6000 张图像、每图一个物体对;水平/垂直真值取标注框中心归一化坐标,深度真值取 Depth Anything V2-Small 在实例掩码内的平均逆深度(值大表示更近)。第二步,定义每轴答案对比 $s_{p,x}=\text{logit}(right)-\text{logit}(left)$,$s_{p,y}=\text{logit}(above)-\text{logit}(below)$,$s_{p,z}=\text{logit}(close)-\text{logit}(far)$。第三步,在 5 个模板 × 2 种 query/reference 顺序下,对物体名末 token 的隐藏态求梯度,计算角色反对称差 $a_{p,g}=\frac{\nabla_{h^q}s_{p,g}-\nabla_{h^r}s_{p,g}}{2}$,跨配置与样本平均、归一化得 $v_x,v_y,v_z$,$\mathcal{S}=\text{span}\{v_x,v_y,v_z\}$。第四步,用不相交的 1800 张图像逐层评估读出验证精度选层。第五步,读出与判断:$V=[v_x,v_y,v_z]$,坐标 $c_t=V^\top h_t$;相对问题用 margin $m_g=v_g^\top(h^q-h^r)=c_{q,g}-c_{r,g}$ 的符号直接给出答案(正为 right/above/close),无需模型生成文字。第六步,因果干预:用 $B=V(V^\top V)^{-1}$、$h‘=h+B(c’-c)$ 把编辑后的坐标写回隐藏态,保持子空间外分量不变,再恢复生成观察行为变化。输入是图像+文本,中间产物是三条固定方向向量,输出是每个物体 token 的三维坐标及其导出的空间判断。
技术新颖性
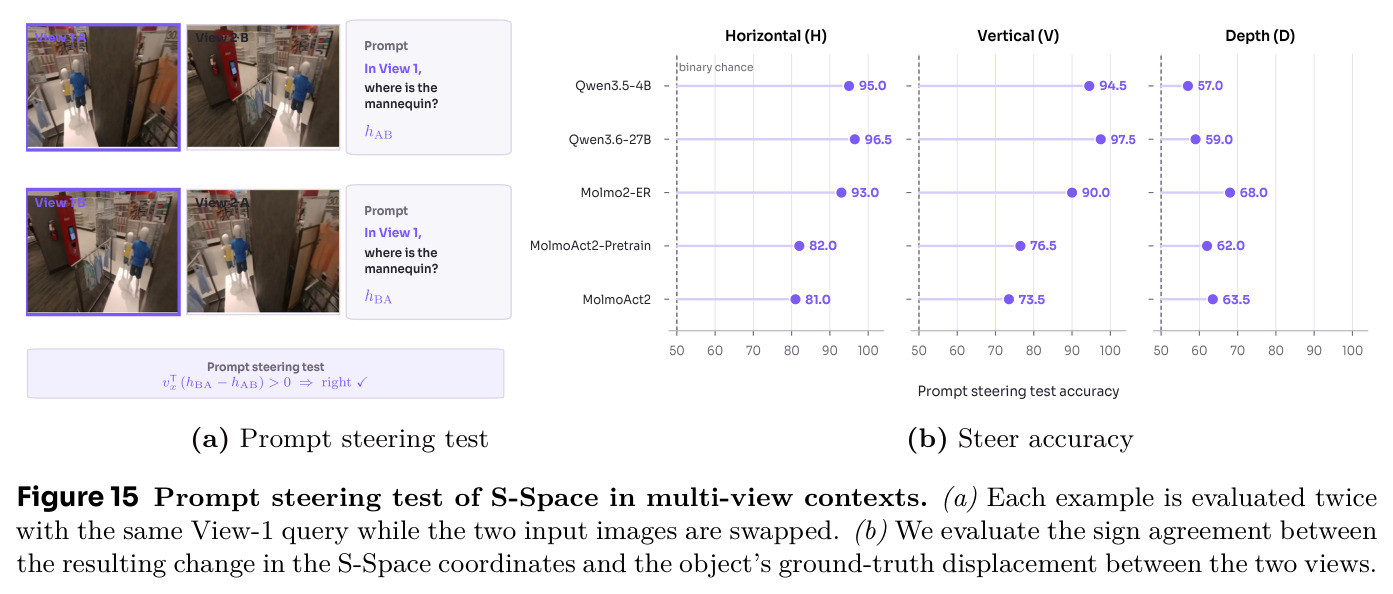
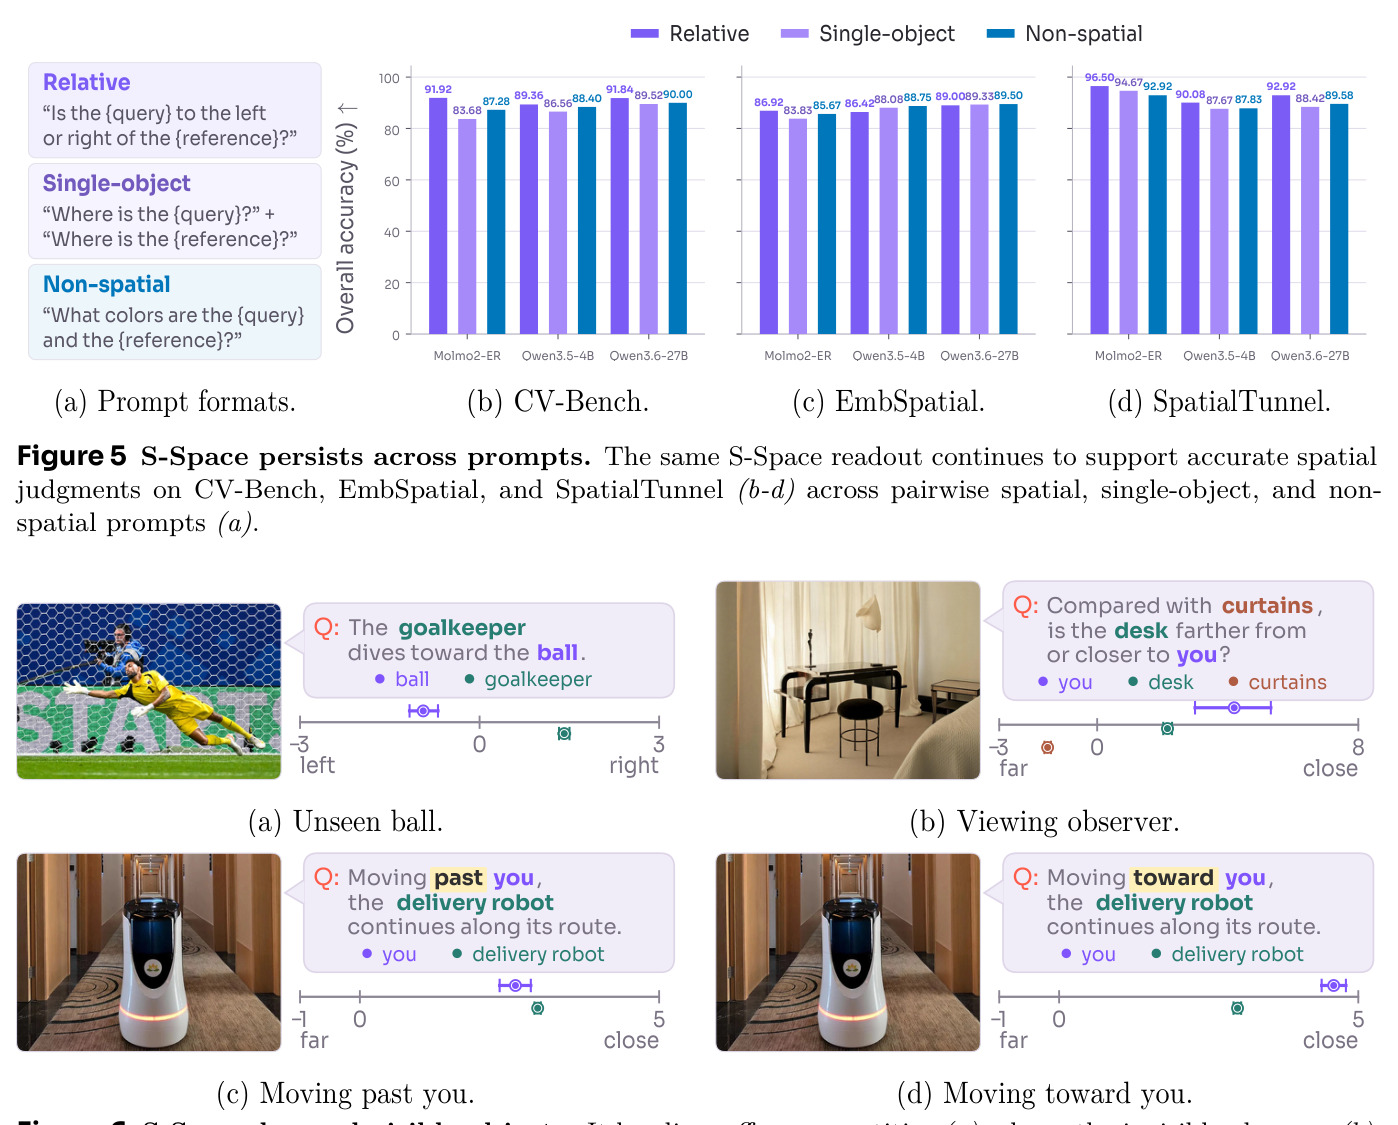
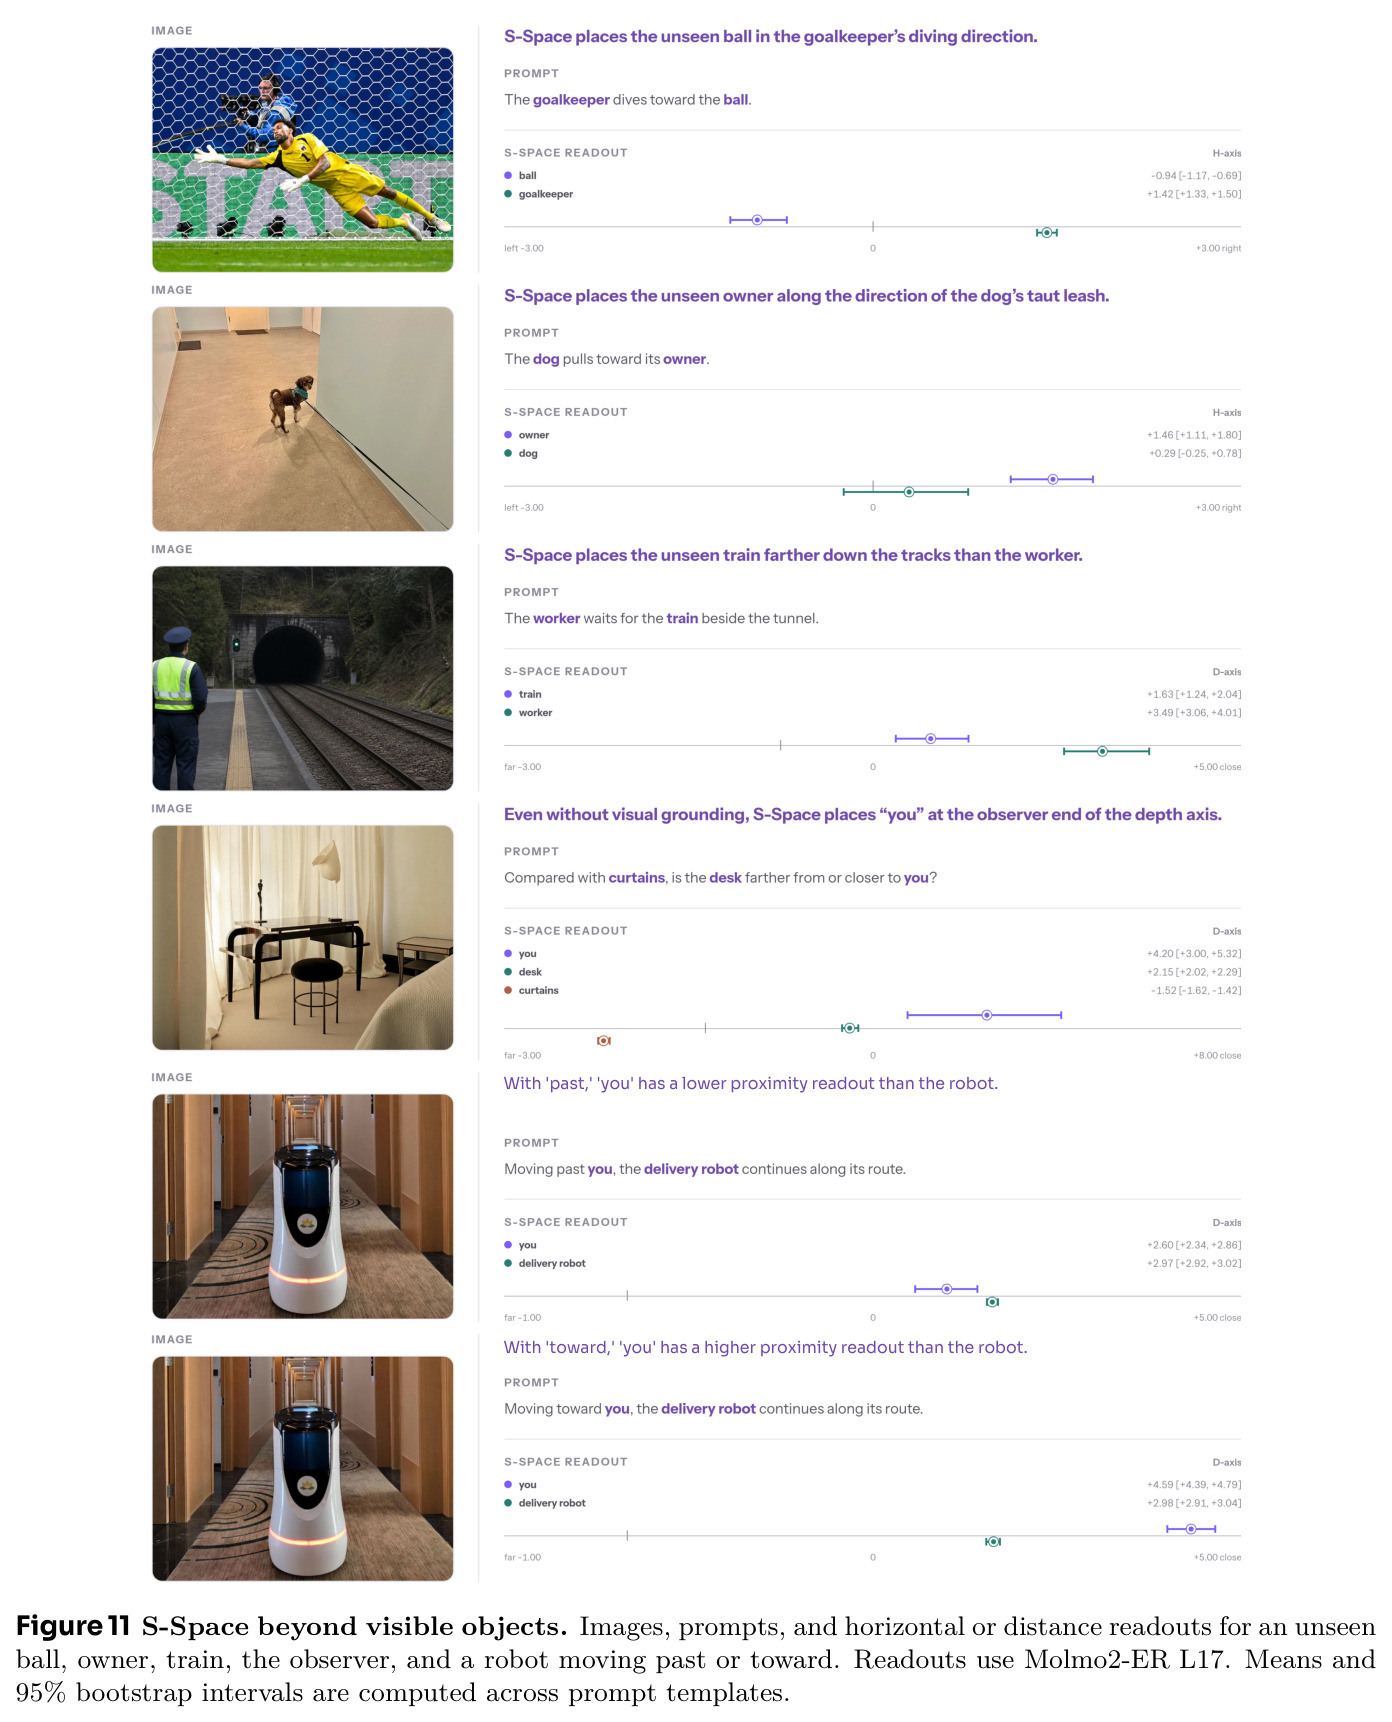
技术新颖性体现在四点。其一,对象新:首次在 MLLM 中系统识别并刻画“内部空间工作区”,把机制可解释性的对象从离散概念(SAE 特征、J-Space 的词表化读出)扩展到连续几何量,从文本模型扩展到视觉-语言模型的真实三维空间。其二,方法极简但有力:角色反对称化 + 多模板平均的梯度程序不需要训练探针或 SAE,识别出的方向跨数据集(COCO 识别、CV-Bench/EmbSpatial/SpatialTunnel 验证)、跨任务、跨 prompt 保持不变,且附录 B 给出了期望意义下的恢复保证。其三,性质强:证明 S-Space 是内在组织而非伪影——把相对比较 prompt 换成单物体提问甚至问颜色的非空间提问,同一组方向仍读出准确坐标(Figure 5);它还能被语言内容动态调节(“moving toward you” 使 you 的距离坐标变近)和被多视角 prompt 锚定(Figure 15),符合“工作区”的功能定义。其四,用途实:读出 + 人工旋转矩阵构成 oracle,首次在 MLLM 中把空间感知与空间计算干净分离;方位词读出则成为观察参考系混淆的显微镜。
实验结果
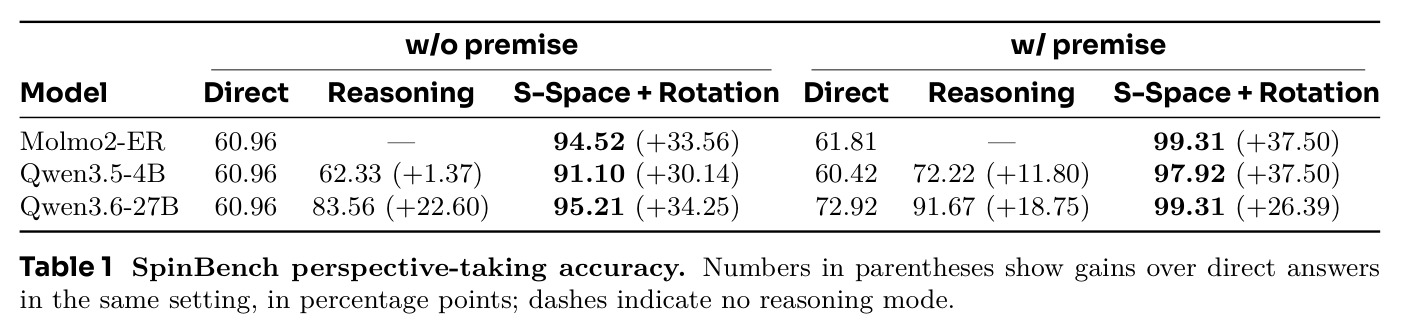
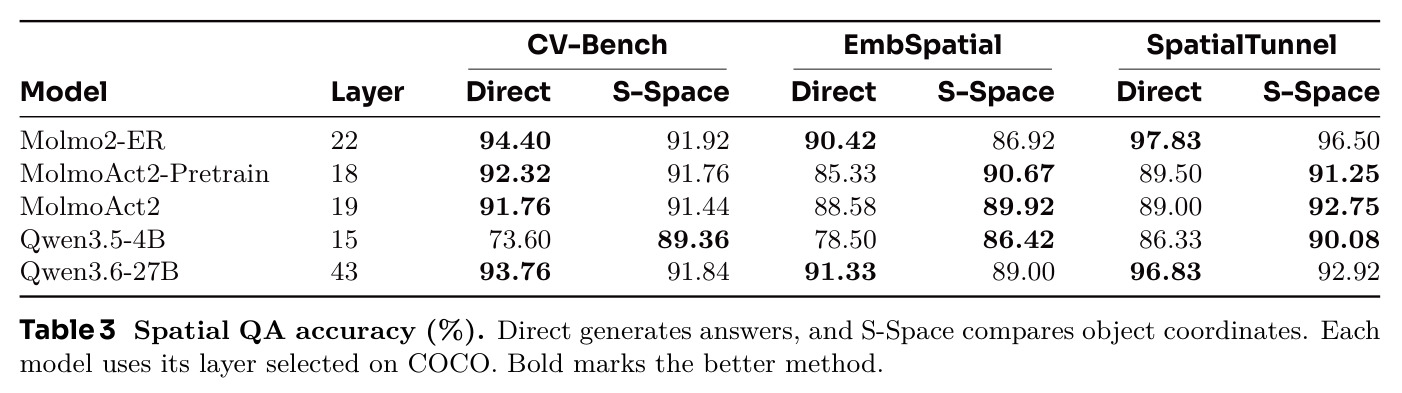
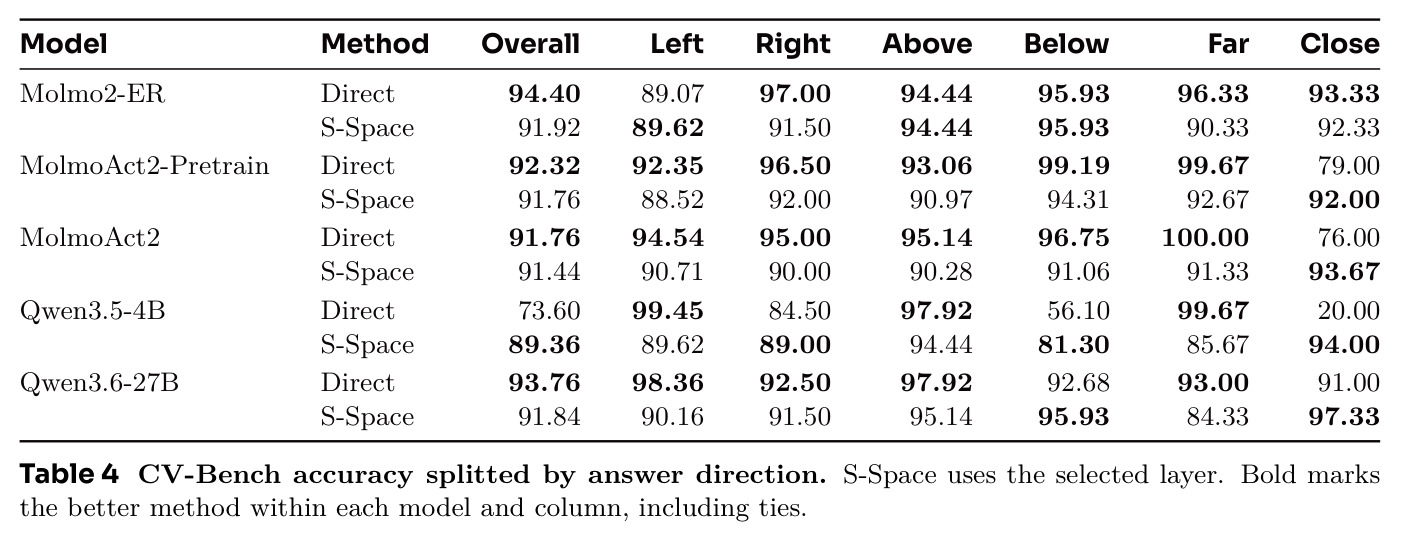
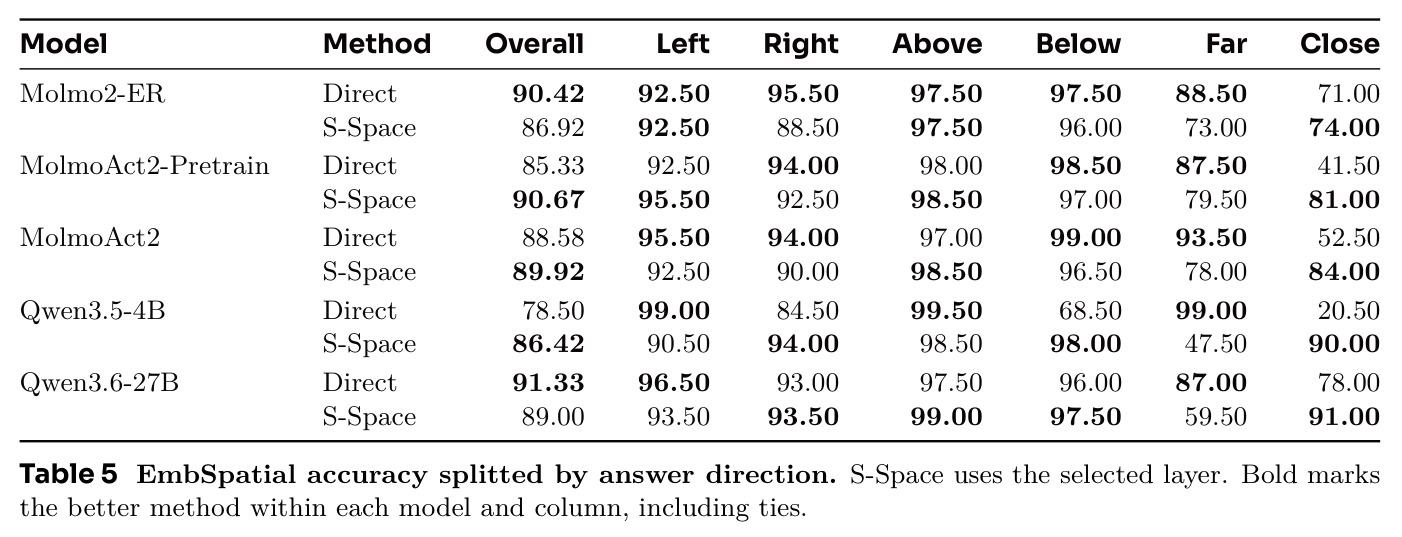
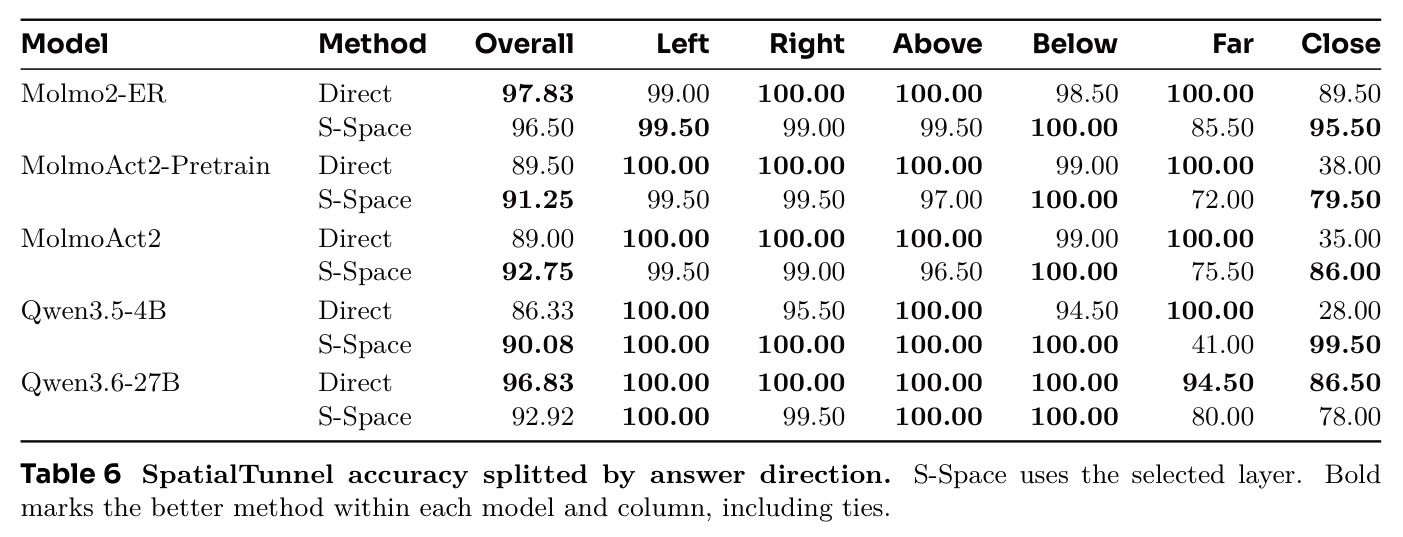
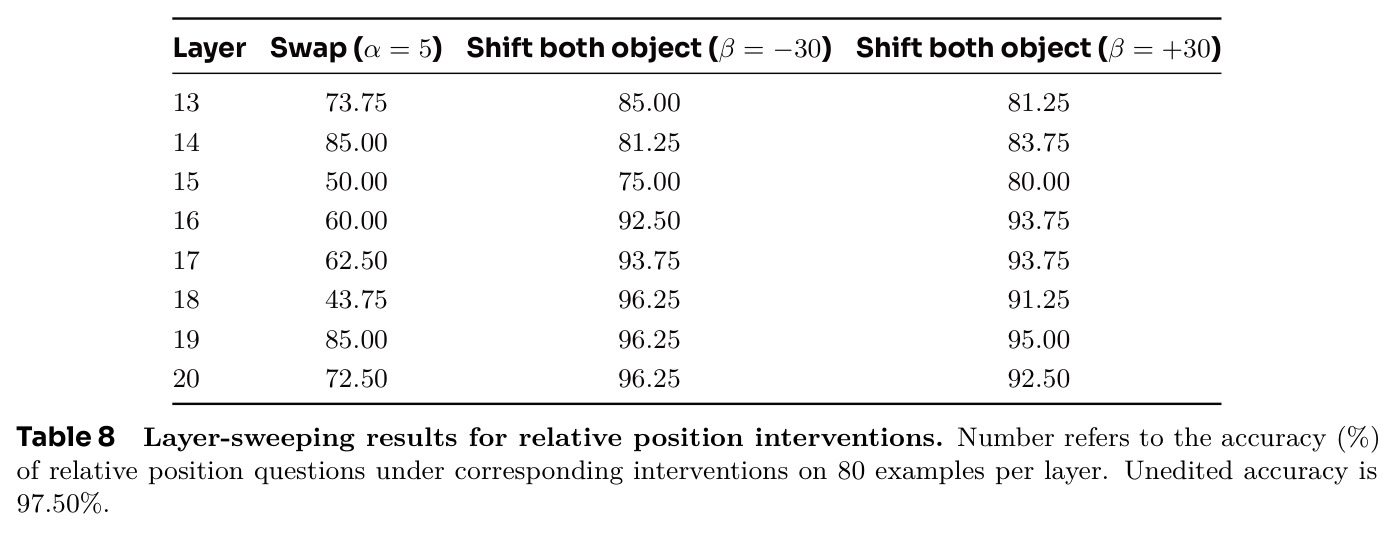
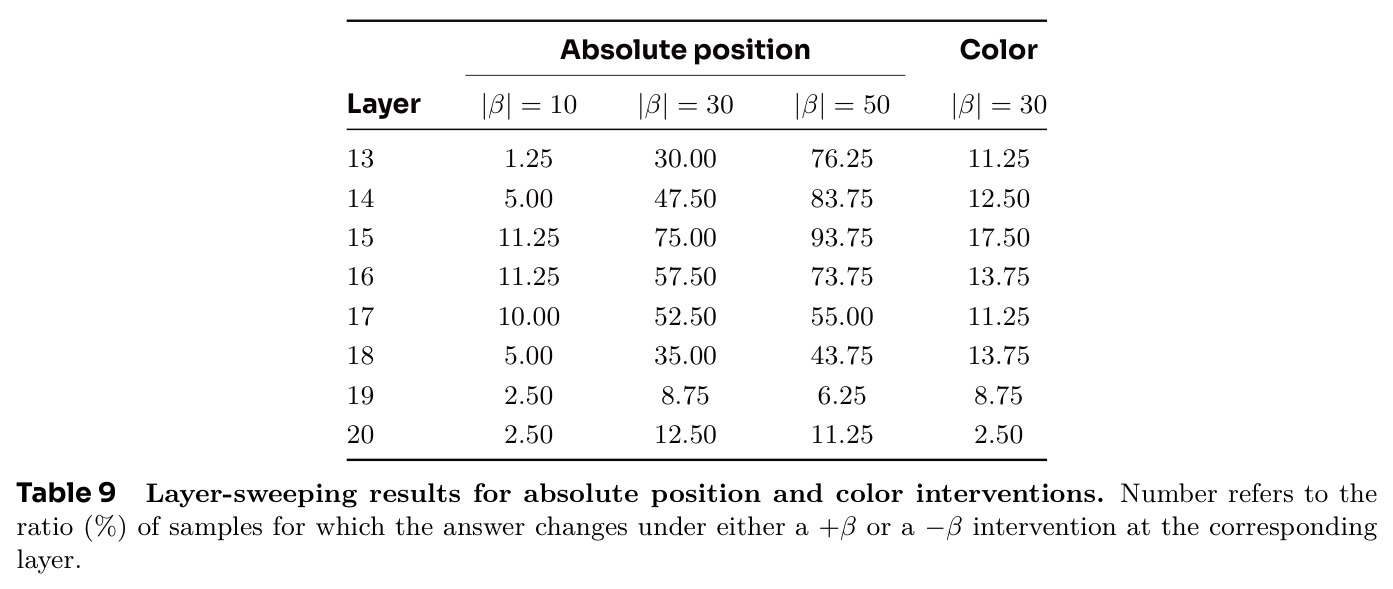
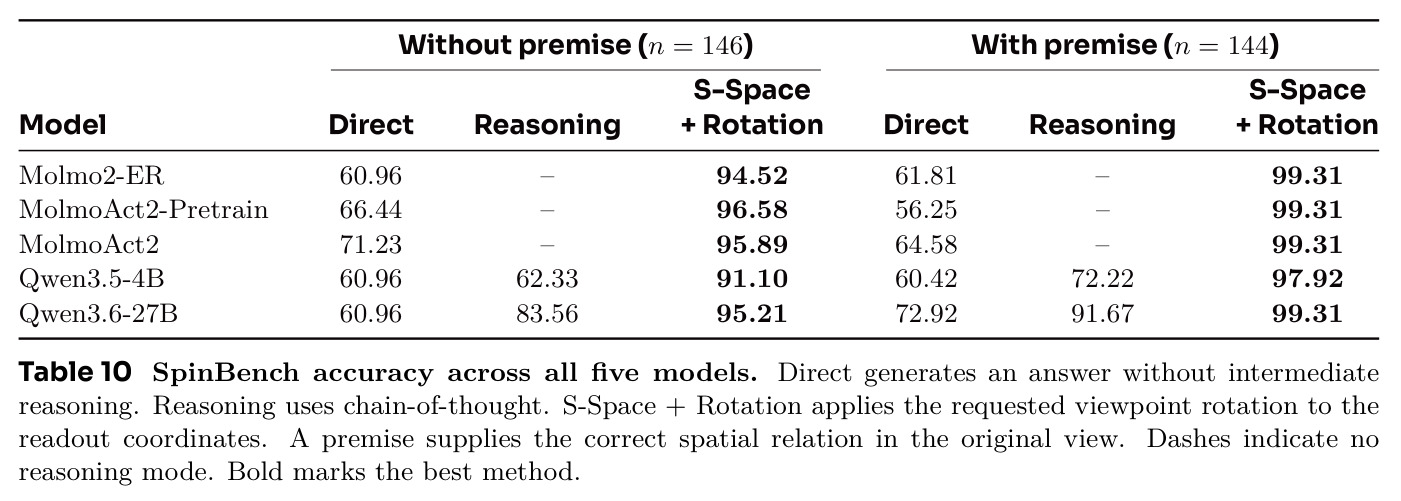
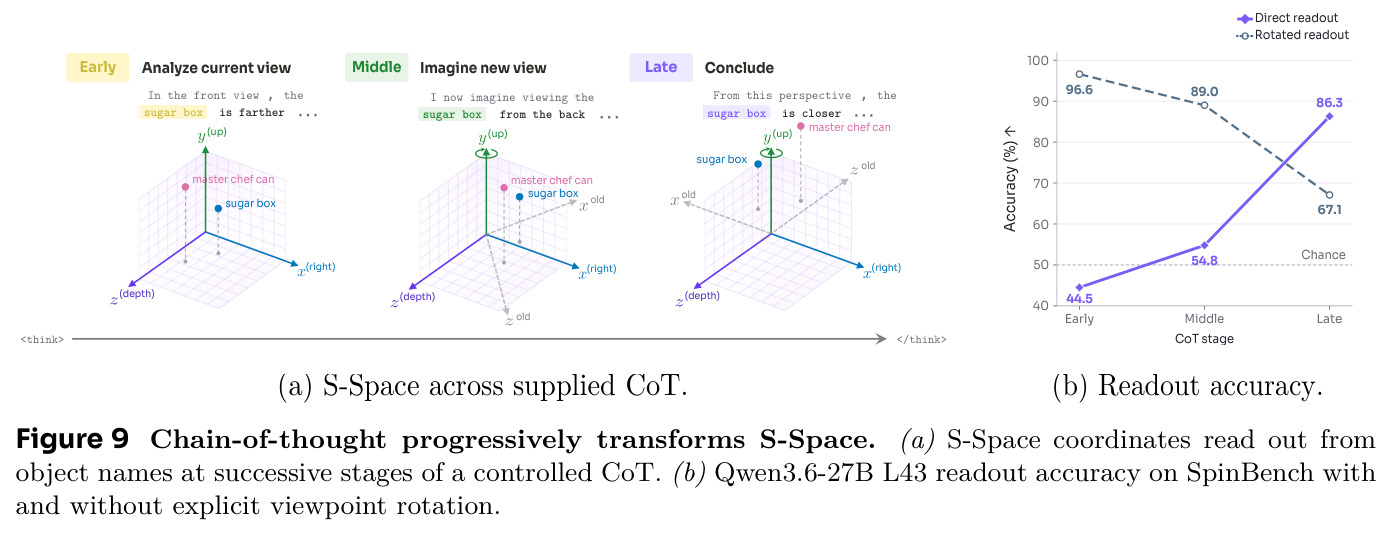
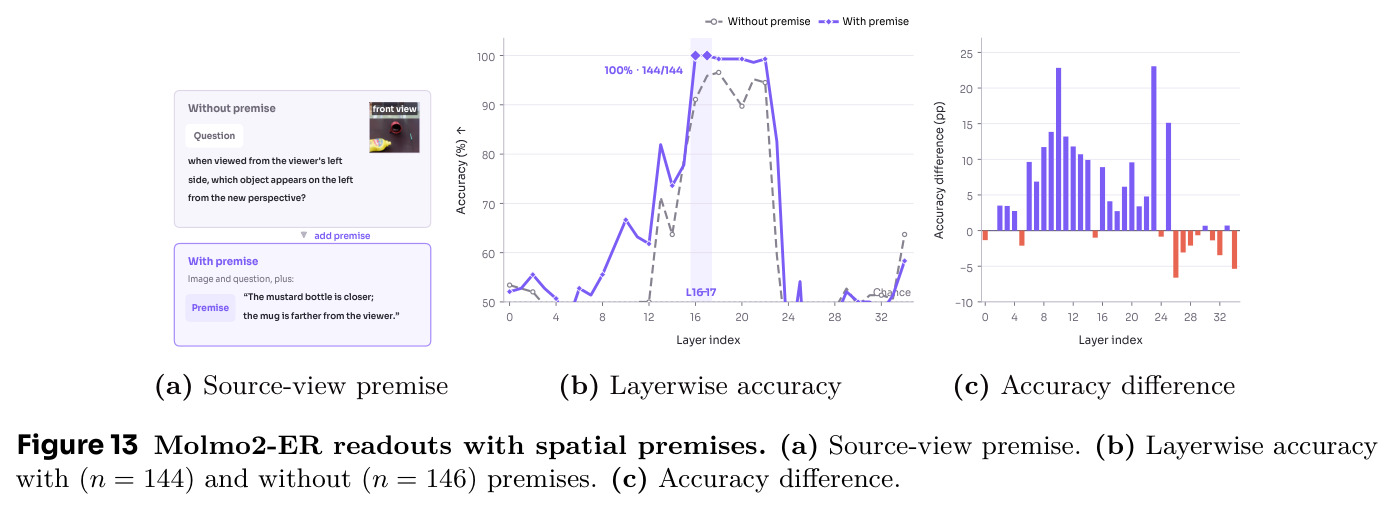
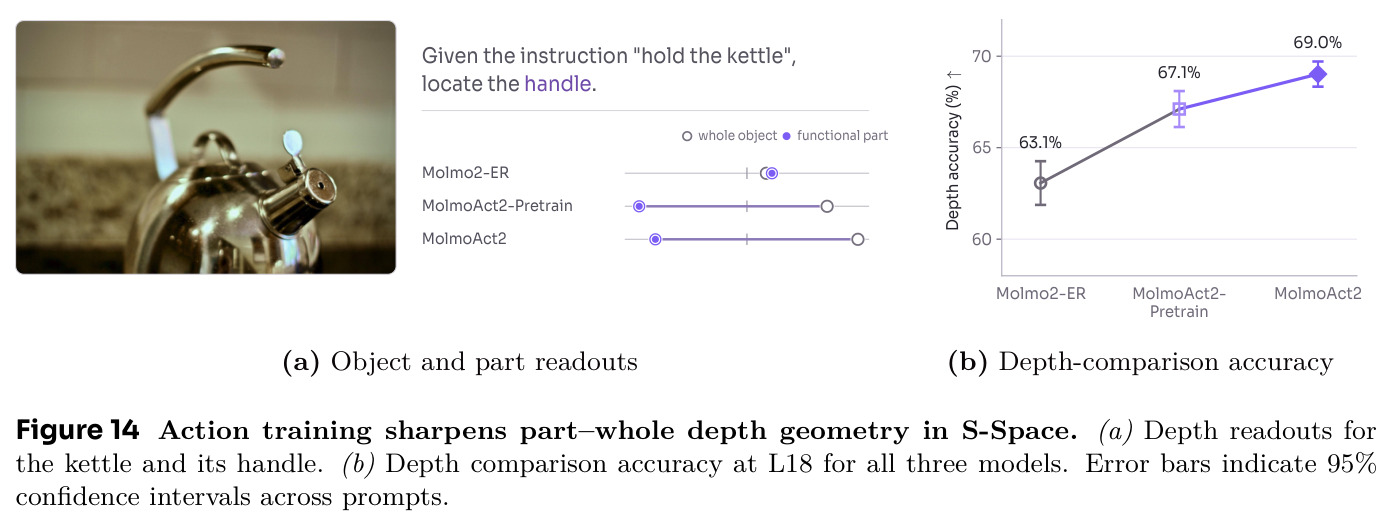
(1)编码精度:2116 个 held-out COCO 物体对上,Molmo2-ER L21 读出坐标与真值的 Spearman 相关为水平 0.789、垂直 0.774、距离 0.521;成对差升至 0.871/0.872/0.688——相对关系编码尤佳,距离轴偏弱。(2)空间 QA:仅凭坐标符号比较在 CV-Bench/EmbSpatial/SpatialTunnel 上与直接回答相当甚至更好;Qwen3.5-4B 最突出——CV-Bench 直接回答仅 73.60%(close 方向 20.00%),读出达 89.36%(close 94.00%),EmbSpatial 78.50→86.42、SpatialTunnel 86.33→90.08;Molmo2-ER 与 Qwen3.6-27B 读出略低 2–4 个点但仍达 87–97%,动作训练后的 MolmoAct2 在 EmbSpatial/SpatialTunnel 上反超直接回答。(3)因果性:交换编辑 α=3 时相对位置答案保留率降至 59.82%、α=6 时 43.93%,同强度随机编辑保留 99.83%;颜色判断基本不动(β=30 时保留 78.13%);共同平移两物体因保持坐标差仅降至 80.36%;层扫描显示效应集中在 L15–L18。(4)持久性:换成单物体甚至问颜色的非空间 prompt,读出仅小幅下降(Molmo2-ER 在 CV-Bench 上 96.50→约 92.9),证明是内在组织而非 prompt 伪影。(5)工作区内容:看不见的球被放在守门员扑救方向、you 位于距离轴近端、“moving toward you”使 you 的距离坐标变近而机器人不变、socialist/conservative 在五个模型中均投影到水平轴两端且保持排序。(6)诊断(核心发现):SpinBench 直接回答仅 60.96–72.92%,CoT 提升有限(Qwen3.5-4B 仅 +1.37 至 62.33%,Qwen3.6-27B +22.60 至 83.56%),S-Space 读出+显式旋转达 91.10–96.58%、有 premise 时 97.92–99.31%——即使拿到正确 premise 模型仍常答错而内部表征近乎完美,瓶颈在空间变换计算而非感知。CoT 追踪显示坐标确实逐步旋向目标视角(旋转后读出 96.6%→67.1%、直接读出 44.5%→86.3%)但不完美。(7)方位词耦合:MMSI-Bench 191 题中 1311 次方位词出现显示 east≈right、north≈above、northeast 兼具两者。(8)动作训练锐化几何:部分-整体深度比较 63.1%→67.1%→69.0%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 空间关系 QA(CV-Bench,Qwen3.5-4B L15) | 准确率 (%) | 89.36(S-Space 读出) | 73.60(模型直接回答) | +15.76(close 方向 20.00→94.00) |
| 空间关系 QA(EmbSpatial,Qwen3.5-4B L15) | 准确率 (%) | 86.42(S-Space 读出) | 78.50(模型直接回答) | +7.92 |
| 空间关系 QA(SpatialTunnel,Qwen3.5-4B L15) | 准确率 (%) | 90.08(S-Space 读出) | 86.33(模型直接回答) | +3.75 |
| 视角转换(SpinBench 无 premise,Molmo2-ER) | 准确率 (%) | 94.52(S-Space 读出 + 显式旋转) | 60.96(直接回答) | +33.56 个百分点 |
| 视角转换(SpinBench 有 premise,Molmo2-ER) | 准确率 (%) | 99.31(S-Space 读出 + 显式旋转) | 61.81(直接回答) | +37.50 个百分点 |
| 视角转换(SpinBench 无 premise,Qwen3.6-27B) | 准确率 (%) | 95.21(S-Space 读出 + 显式旋转) | 83.56(链式思维 CoT) | +11.65(直接回答仅 60.96) |
| 物体坐标编码(2116 个 held-out COCO 物体对,Molmo2-ER L21) | Spearman 相关(水平/垂直/距离) | 0.789 / 0.774 / 0.521(成对差 0.871 / 0.872 / 0.688) | —(无外部基线,距离轴显著弱于水平垂直轴) | 揭示了距离轴是当前表征最弱的一环 |
| 部分-整体深度比较(InstructPart,L18) | 准确率 (%) | 69.0(MolmoAct2,VLA) | 63.1(Molmo2-ER,VLM) | +5.9(动作训练逐步锐化空间几何) |
局限与改进
作者承认的局限:水平/垂直轴使用图像平面坐标而非世界坐标,未显式解耦深度相关的透视效应,故编码的是投影坐标加相对深度而非度量三维坐标;参考系并非固定——可被上下文语言引导(“In View 1”即可切换锚定视角)、也会随思维链推理逐步重定向,同一方向的语义依赖上下文。结果本身也暴露短板:距离轴系统性偏弱(Spearman 仅 0.521/0.688;多视角 steering 测试中距离轴只有 57.0–68.0%,远低于水平/垂直轴的 73.5–97.5%),far 方向读出在多个基准上明显差于直接回答(如 EmbSpatial 上 Qwen3.6-27B 的 far 读出 59.50% vs 直接回答 87.00%)。我的补充观察:交换干预需放大到 α=3–6 才产生显著行为改变,放大干预的物理意义含糊,可能同时扰动子空间外的计算;评估限于 Molmo 与 Qwen 两家族五个模型,对 GPT/Gemini 等闭源前沿模型是否成立未知;SpinBench 的 oracle 使用预设的 90° 正交旋转矩阵,向任意连续视角推广并不显然;物体表征取名字末 token,多物体、长名称与指代场景的鲁棒性未讨论;political 语义混入水平轴说明该几何被语言先验污染,把读出直接解释为纯空间量需谨慎。
独立分析的弱点
(1)距离轴最弱:深度在视觉编码器中天然是间接量,读出相关仅 0.521、多视角 steering 仅 57–68%。改进方向:训练中加入坐标一致性辅助损失把读出与深度真值对齐,或用度量深度模型蒸馏。(2)感知强、计算弱的断裂:内部表征足以支持 91–99% 的视角转换正确率,实际生成仅 60–84%。改进方向:训练模型在思维链中显式输出并操作中间坐标(“以坐标思考”),或用 S-Space 读出构造过程监督/过程奖励,惩罚推理中途的坐标漂移。(3)方位词与图像方向耦合源自预训练偏差——网络图文里罗盘方向几乎总出现在与水平/垂直轴对齐的地图式参考系中。改进方向:构造需要真正罗盘参考系(携带 GPS/罗盘元数据、非地图视角)的指令数据去偏,或在 S-Space 中正交化清除图像平面分量。(4)语言先验污染几何:socialist/conservative 混入水平轴说明抽象语义与物理空间共享方向,可能干扰纯几何应用;可在推理时用表征工程投影去除无关语义成分。(5)因果通路窄且脆弱:干预效果集中在 L15–L18 的窗口、写入坐标需放大倍数才生效,说明未必被后续层稳定消费;应研究各层如何读写 S-Space,找到更自然的写入位置与推理时实时纠错方案。
未来方向
作者在讨论部分提出的方向:其一,未来系统不必依赖单一 MLLM 在内部完成所有空间操作——agentic 空间推理可以把专用工具(视角变换、物理仿真、空间记忆)接入模型,把“有能力的感知”转化为“可靠的推理与行动”,S-Space 恰好提供了判断哪些操作该外置的依据;其二,此类机制分析帮助揭示哪些能力随规模涌现、哪些缺失,为不可靠能力定位缺失成分。基于本文成果可自然延伸的研究:把 S-Space 读出用作训练信号(坐标一致性正则、可读性奖励或蒸馏目标),主动塑造而非被动观测空间表征;推理时实时监控“内部坐标 vs 语言输出”的一致性,检测并纠正空间幻觉;把分析从单帧扩展到视频与世界模型,研究动态场景中工作区的更新机制;在 VLA 路线上做因果实验,确认动作数据对空间几何的塑造作用(论文已给出 63.1%→67.1%→69.0% 的相关证据);显式解耦多种参考系(观察者中心、物体中心、罗盘)并研究语言可控的切换机制;在更多模型家族(包括闭源模型的开放权重对等物)上检验 S-Space 的普适性。
复现评估
复现条件总体较好,属“一两周可复现主结果”级别。开源情况:代码发布于 github.com/mirros-lab/s-space,项目页 mirros.ai/blog/s-space;识别所用 COCO 图像 ID 与物体对记录随补充代码提供,轴识别与层选择数据可精确重建。数据与基准全部公开:COCO-2017(6000 张识别 + 1800 张选层,每轴 1000+300 例)、CV-Bench 1250 题、EmbSpatial 1200 题、SpatialTunnel 1200 题、SpinBench 146+144 题、MMSI-Bench 子集 191 题、InstructPart;深度真值用开源的 Depth Anything V2-Small。算力需求:轴识别需对 4B–27B 模型做前向+反传(每轴 1000 例 × 5 模板 × 2 顺序),单张 80GB 级 GPU 即可完成;日常读出只需一次前向传播;干预实验为单模型单层 800 例。难度中等:需熟悉 Transformer 中间层 hook、梯度反传与批量推理工程;主要坑包括各模型最优层差异大(L15–L43 不等,必须整层扫描)、答案对比要在正确输出 token 位置取 logit、深度真值构造细节(掩码内平均逆深度再减中位数居中)以及物体名取末 token 的约定。
论文图表
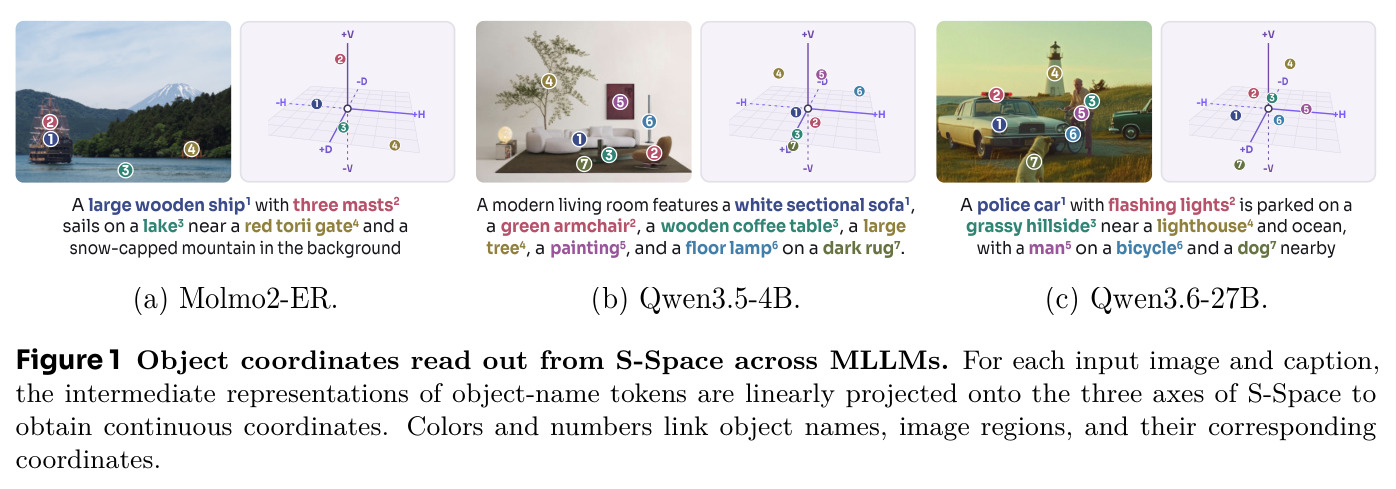
三个模型(Molmo2-ER、Qwen3.5-4B、Qwen3.6-27B)各给一张图配描述文本,把图中各物体名 token 的中间表征线性投影到 S-Space 三条轴上得到连续坐标,用颜色和数字把物体名称、图像区域与坐标值一一对应起来展示。
这是全文的开场演示:一图直观展示“从模型内部直接读出物体三维坐标”这一核心发现,并在不同模型上成立,是建立 S-Space 存在性的第一证据。
(a)(b) Molmo2-ER L21 读出坐标与真值的散点图及最小二乘拟合:物体坐标的 Spearman 相关为水平 0.789、垂直 0.774、距离 0.521,成对差相关为 0.871、0.872、0.688;(c) 三模型在 CV-Bench、EmbSpatial、SpatialTunnel 上 S-Space 读出与直接回答的准确率对比。
支撑“S-Space 高保真编码物体位置”这一核心主张的主实验图,同时暴露距离轴偏弱、Qwen3.5-4B 读出大幅超越自身直接回答等关键细节。
四个案例:(a) 守门员扑向看不见的球时,ball token 被放在扑救方向;(b) you token 投影到距离轴近端;(c)(d) 同一张送货机器人图片,“moving past you”改为“moving toward you”时 you 的距离坐标由远变近而机器人坐标几乎不变。
展示工作区内容超越直接可见物体:能定位屏外实体、安放观察者自身、并被语言含义动态改写,说明它是对周围空间世界的补全而非简单的检测器缓存。
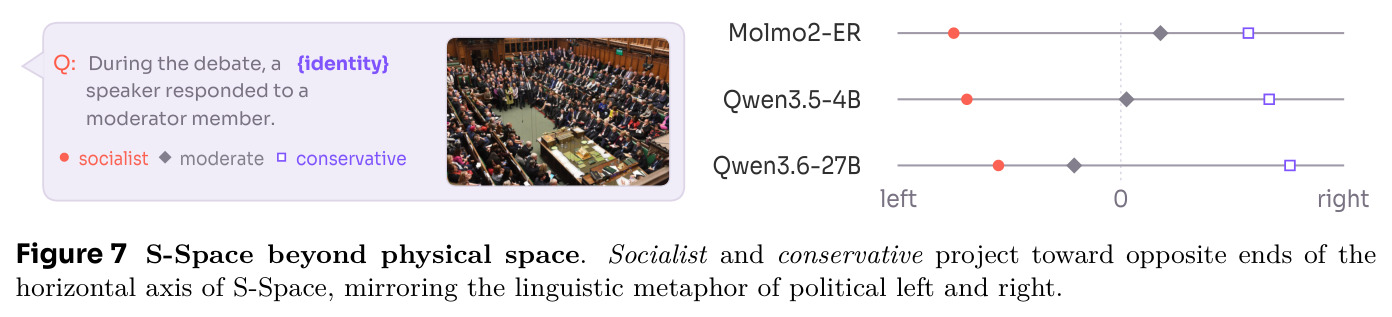
给模型辩论情境 prompt,读出 socialist、moderate、conservative 三个身份词的坐标:socialist 投影到水平轴左端、conservative 到右端,mirroring 政治语境中“左派/右派”的语言隐喻。
揭示大规模语言训练赋予 S-Space 的抽象语义遗产:物理方向与抽象语言意义共享同一几何,这既是能力也是需要警惕的局限。
(a) 两个 MMSI-Bench 上的代表性错误:模型把图像相对关系错误地当作罗盘方向使用(如把 right 当 east 推出 northeast,正确答案是 north);(b) 从 Qwen3.6-27B 思维链中收集的方位词 token 在 S-Space 中的坐标:east 与 right 对齐、north 与 above 对齐、northeast 兼具两个方向。
用内部表征直接解释了一类系统性推理错误的来源——基数方向与图像相对方向在 S-Space 中部分共享特征,是“诊断工具”价值的最佳例证。
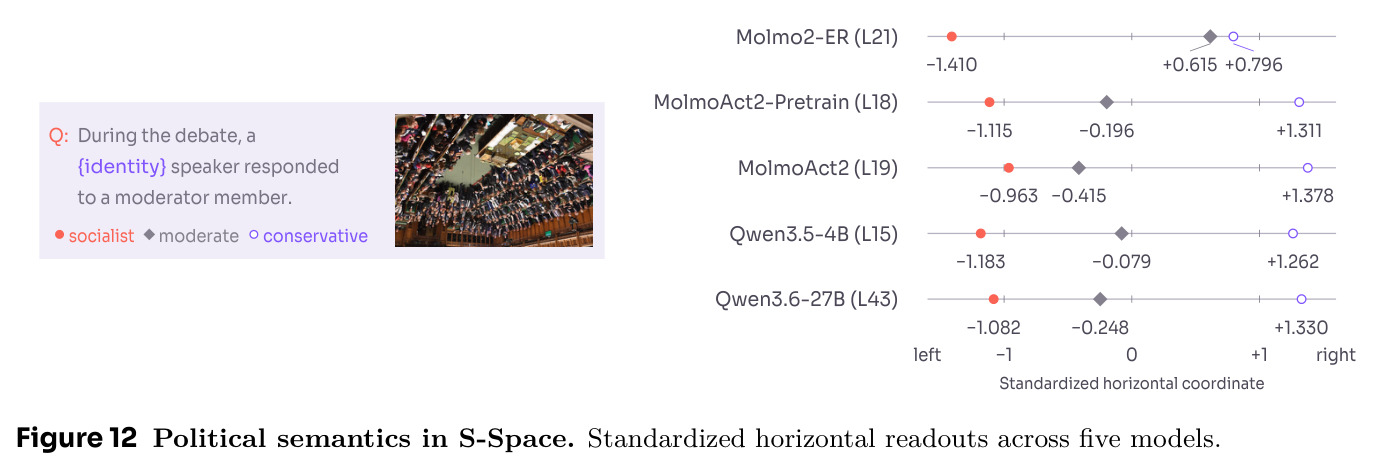
五个模型(含 MolmoAct2-Pretrain、MolmoAct2)上 socialist、moderate、conservative 的标准化水平坐标全部保持左-中-右排序,例如 Qwen3.6-27B 为 -1.082 / -0.248 / +1.330。
证明抽象政治语义与物理水平轴的耦合是跨模型家族的普遍现象,强化了关于语言先验污染空间几何的讨论。