无需跨资产收益协方差的投资组合风险界:来自语言模型表示的分布场 Portfolio Risk Bounds without Cross-Asset Return Covariances: Distributional Fields from Language-Model Representations
以新闻嵌入分布的 Wasserstein 分离构造组合方差上界,免估协方差即可选出低风险配置
前置知识
Wasserstein-2 距离(二次最优传输)
两个概率分布之间的距离:把一个分布的质量搬运成另一个分布所需的最小均方位移的平方根。对两家公司各自的“文章嵌入云”(行归一化文章向量的经验分布),$W_2(\mathcal{C}_i,\mathcal{C}_j)$ 是把公司 $i$ 的文章逐篇配对到公司 $j$ 的文章、使欧氏位移的均方根最小所得的值。它度量整个分布形状的差异,而非均值或单点代表向量的差异。
本文全部“可观测几何”就是公司间 $W_2$ 距离矩阵:证书 $C(q)$、配置规则和所有实证都建立在它之上,不懂数字背后的定义就无法理解“信息分离”的含义。
均值-方差组合与协方差估计困境
Markowitz (1952) 最小方差组合需要 $n$ 资产的收益协方差矩阵,含 $n(n+1)/2$ 个自由参数;而长度 $T$ 的去均值收益历史秩至多 $\min(T-1,n)$。短面板下样本协方差病态甚至奇异:最强的样本方向噪声大,优化器却对最弱方向最敏感,产生极端权重。Ledoit-Wolf (2004) 收缩与因子模型 (Kelly et al. 2019) 缓解了估计,但其跨资产信息仍全部来自联合收益。
这正是本文要绕开的瓶颈;理解协方差在高维短样本下为何不可靠,才能理解“不用协方差做风险界”的价值。
L-antilipschitz 载体与松弛半径
载体 $t:\mathcal{X}\to\mathcal{H}$ 是从信息空间到隐因子暴露空间的公共映射,满足 $d_{\mathcal{H}}(t(x),t(y))\ge L^{-1}d_{\mathcal{X}}(x,y)$,即不会把经济上不同的信息状态压缩成相同的系统性暴露;每家公司另有半径 $\tau_i$ 的同步松弛,允许其专属映射 $u_i$ 偏离公共载体。两者共同把观测到的信息距离转译为暴露分离的下界 $\ell_{ij}=[L^{-1}W_2(\mathcal{C}_i,\mathcal{C}_j)-\tau_i-\tau_j]_+$。
这是从“文本几何”到“组合风险”的维护传递假设;证书是否成立完全取决于它,也是论文局限性讨论的核心。
条件负定与 Schoenberg 准则
对称零对角矩阵 $d$ 若对一切满足 $\sum_i u_i=0$ 的 $u$ 有 $\sum_{i,j}u_iu_j d_{ij}^2\le 0$,称为条件负定;Schoenberg 准则表明这等价于平方距离矩阵可等距嵌入 Hilbert 空间,可直接对观测矩阵做特征值检验。
定理 5 用它证明标准差证书目标 $q\mapsto 1-C(q)$ 在单纯形上是凸的,使最小化问题成为凸规划;论文报告该条件对实际使用的 $W_2$ 矩阵成立。
文档嵌入与 Matryoshka 截断
嵌入编码器把文章正文映射为固定维向量(如 Qwen3-Embedding-8B 的 4096 维),训练使语义相近文档在向量空间更接近;行归一化后,一家公司全部文章向量构成等质量经验分布,保留了单一平均向量会抹掉的公司内异质性。Matryoshka 训练让前缀坐标保持有效,支持截断到 1024/256/64 维而无需重训。
论文用冻结编码器把新闻变成“分布场”,嵌入模型与维度的选择直接决定 $W_2$ 几何,第 6.5 节的表示敏感性阶梯全靠这一概念。
等风险权重与逆波动率组合
归一化风险权重 $q_i=1/N$ 通过映射 $q_i(x)=x_i\sigma_i/A(x)$(其中 $A(x)=\sum_i x_i\sigma_i$)对应资本权重 $x_i^{IV}\propto 1/\sigma_i$ 的逆波动率组合。它只用各资产的边际波动率 $\sigma_i$,不需要跨资产协方差,是“用第一个通道而不用第二个通道”的天然基准。
等风险权重是论文的核心比较对象(分位数 21.1%–28.6%);分清资本权重 $x$ 与风险预算份额 $q$ 是读懂标准化资产实证设计的前提。
研究动机
均值-方差配置需要可靠的跨资产收益协方差矩阵,但该矩阵恰恰在分散化最有价值的场景中最难估计:$n$ 资产的完整协方差矩阵含 $n(n+1)/2$ 个参数,而长度 $T$ 的去均值收益历史秩至多 $\min(T-1,n)$。以本文的样本为例:52 家公司、2018–2022 年仅 1207 个对齐日观测的短面板中,样本协方差的强方向充满噪声,而优化器偏偏对最弱的特征方向最敏感,导致最小方差权重极端不稳定。收缩估计与因子模型能缓解这一困境,但它们的跨资产信息仍然全部来自联合收益本身——收益历史短时没有额外信息源可用。另一路文献(文本金融)虽然证明新闻包含定价相关信息,但目标多停留在情绪指标、预期收益或因子构造,没有一个能给出“组合风险的相干上界”。于是出现一个空白:能否在估计任何协方差之前,就让可观测的公司信息对组合风险说出一些确定的话?
本文的目标是本文的目标是把“公司层面的分布型特征”变成组合风险的单侧证书。具体分三步:其一,把每家公司表示为其新闻文章嵌入的概率分布(分布场),用二次最优传输距离 $W_2$ 比较这些分布;其二,在维护的信息-暴露传递限制(antilipschitz 载体、公司松弛、相干联合律、收益桥)下,推导多公司形式的系统性组合方差上界 $\mathrm{Var}(R_q)\le 1-C(q)$,其中 $C(q)$ 是由观测 $W_2$ 几何认证出的“分散化减免”,并给出计算更简单的加权两两松弛形式与凸性、存在性等决策论性质;其三,把证书转化为无需预期收益、无需跨资产协方差的配置规则——最小化认证方差上界,并在 52 家公司 2018–2022 年面板上,于四个预指定的封顶可行组合总体内报告该配置的描述性方差排名。注意作者明确把目标限定为“认证与排名”,而非声称复制协方差知情的最优组合。
与已有工作不同的是,本文的分布式几何前作停留在邻近聚合层级:Gawronsky 与 Huang (2026a) 在两两层面由 Wasserstein 分离导出协方差包络,证明观测几何能限制两个隐系统性风险的对齐程度;Gawronsky 与 Huang (2026b) 用目标锚定的 Wasserstein 重心重构形成截面交互场,组织公司层面的暴露调整。但组合风险是一个联合对象:两两最优耦合未必是任何单一联合分布的边缘,可分别实现的协方差包络不能简单堆叠成相干的组合风险配置。本文的独特切入正是补上“组合聚合”这一步:让所有暴露边缘服从同一个联合律 $J$,定义加权多公司传输离散度 $D_q$,把信息分离在一个相干框架内聚合为 sharp 的方差证书,并首次把它变成可实施、可检验凸性的决策规则——这一组合层面的桥接是两篇前作都没有解决的问题。
核心方法
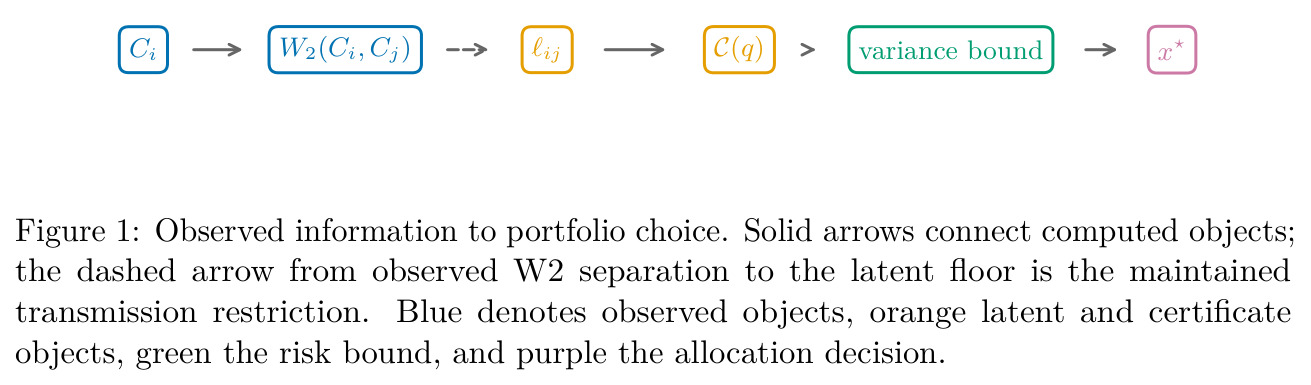
直觉:若两家公司的信息分布(文章嵌入云)语义上相距甚远,而信息差异必然传递为系统性暴露差异,那么两家公司的潜在风险不可能完全同向,持有两者必然带来相对完全正相关基准的分散化收益。本文把这个直觉数学化为三层结构:可观测信息律 $\mathcal{C}_i$(公司文章嵌入的经验分布)、潜在暴露律 $\mathcal{P}_i$($B_i=u_i(X_i)$ 在因子风险坐标中的分布)、以及连接两者的维护传递限制。技术路线:先由 antilipschitz 载体与松弛半径导出两两暴露分离下界 $\ell_{ij}=[L^{-1}W_2(\mathcal{C}_i,\mathcal{C}_j)-\tau_i-\tau_j]_+$,再用归一化风险权重聚合成证书 $C(q)=\tfrac12\sum_{i,j}q_iq_j\ell_{ij}^2$,经 Hilbert 空间极化恒等式与相干联合律得 $\mathrm{V}_{sys}(q)\le\sum_iq_iv_i-C(q)$(定理 1);用多公司传输离散度 $D_q$ 把松弛只在聚合层扣一次,得 sharp 证书(定理 2、3);经收益桥 $R_i=S_i+\varepsilon_i$ 得标题界 $\mathrm{Var}(R_q)\le 1-C(q)$;最后最小化认证方差目标 $CV(x)=A(x)^2\{1-C(q(x))\}$ 得配置 $x^\star$,其中 $A(x)=\sum_ix_i\sigma_i$ 是完全正相关下的波动基准。
核心创新是把“信息分布的分离”升级为“组合风险的认证”,与已有方法的本质区别有三层。与 Markowitz、Ledoit-Wolf 收缩和因子模型相比:风险信息的来源从联合收益换成了公司信息分布的几何($W_2$ 距离矩阵),且输出是单侧上界(证书)而非协方差点估计——它回答“最坏情形方差最多是多少”,不回答“方差估计是多少”。与作者自己的两两前作 (2026a) 相比:引入了相干性——所有暴露边缘服从一个联合律 $J$,定义 $D_q(\mathcal{C}_1,\ldots,\mathcal{C}_n)=\inf_{\gamma\in\Pi}\mathbb{E}_\gamma[\sum_{i<j}q_iq_j\,d_{\mathcal{X}}(X_i,X_j)^2]$(经自由中心 Wasserstein 重心表示 $\inf_Q\sum_i q_iW_2^2(\mathcal{P}_i,Q)$ 刻画),松弛以加权均方根 $\tau_q=(\sum_iq_i\tau_i^2)^{1/2}$ 在聚合层只扣一次,而两两形式每对扣 $\tau_i+\tau_j$ 且丢弃分离不足的对。此外还有一条漂亮的结构性结果:零松弛时 $C(q)=\tfrac{1}{2L^2}q^\top W^2q$,载波常数 $L$ 只改变认证掉的方差数量,不改变 $\arg\max$,即归一化配置完全由观测几何决定(推论 1)。
方法步骤详情
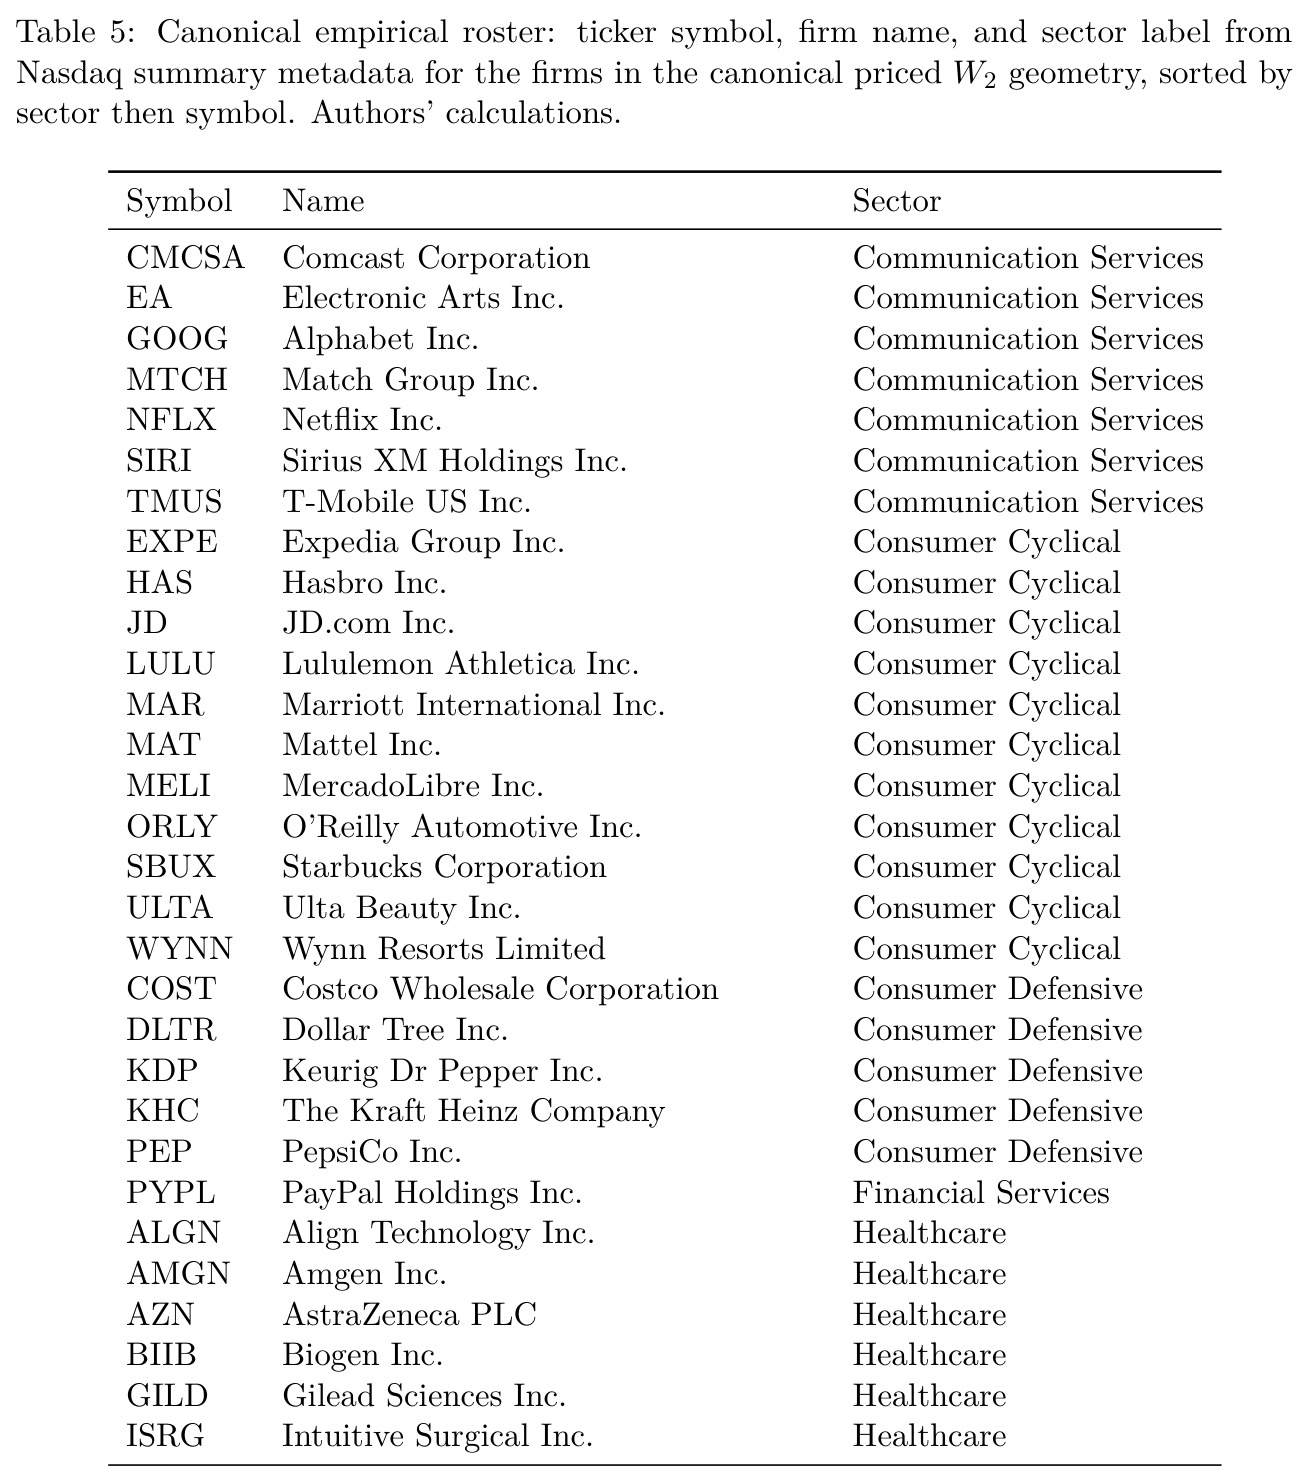
流程四步。第一步数据构建:取 Nasdaq 按代码索引的 2018–2022 年新闻,经年度覆盖筛选与均衡云规则(文章按 URL 哈希确定性排序后截成等规模集合,使新闻数量不进入距离),每家公司得到行归一化文章嵌入的等质量经验分布;收益取 Yahoo Finance 调整收盘价的简单收益率,精确对齐 1207 个交易日(2018-03-19 至 2022-12-30),剔除 WBA 后剩 52 家,逐列标准化到单位边际方差。第二步几何计算:用冻结的 Qwen3-Embedding-8B(4096 维)独立编码每篇文章,对两公司等规模文章云做均衡二次传输,最小化均方欧氏弦位移,得 $52\times52$ 的 $W_2$ 矩阵(证书边界处平方一次)。第三步配置求解:零松弛、单位边际尺度下 $A(x)=1$、$q=x$,news-only 配置为 $q^{news}\in\arg\max_{q\ge0,\mathbf{1}^\top q=1}\tfrac12q^\top W^2q$,即在长多单纯形上最大化加权平方距离和;定理 4 保证解存在,条件负定条件(对实际 $W_2$ 矩阵成立)保证问题是凸规划。第四步事后评估:构造完成后才用全样本标准化协方差 $\hat\Sigma_R$ 计算其方差,与四个预指定参考总体(各 20000 次 Dirichlet-封顶抽样:$(1,12.5\%)$、$(1,15\%)$、$(0.8,15\%)$、$(0.5,15\%)$)比较分位数,并用等风险权重与事后样本 GMV 校准绝对位置。
技术新颖性
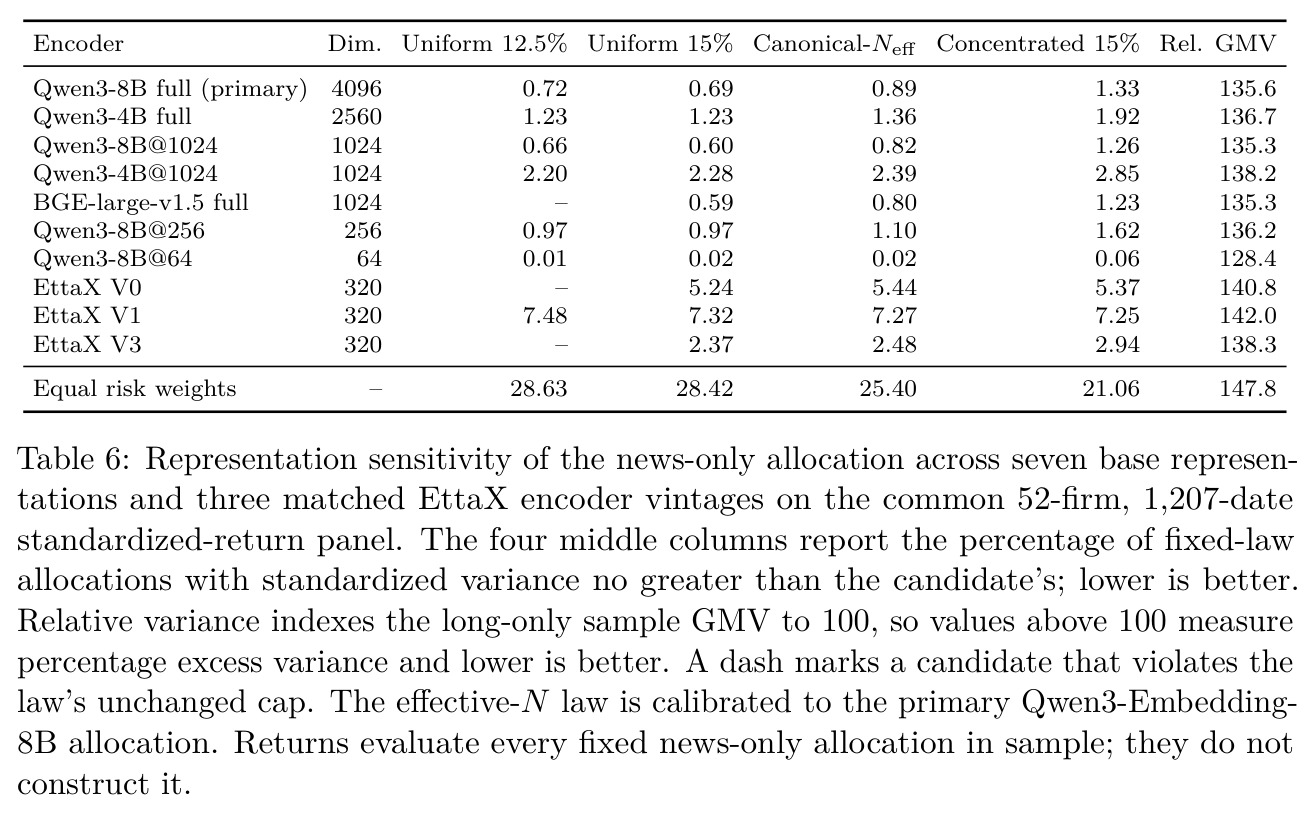
技术新颖性有四点。其一,用途新:最优传输的分布几何此前在文本领域用于相似度(如 Word Mover's Distance),本文转用于金融风险认证,输出是可以逐权重求值并最小化的方差上界,而非评分或预测。其二,组合层面的相干聚合是新的:定理 2 把整个多公司离散度对象(而非逐对)经载体转移,$D_q(\mathcal{P})\ge[L_q^{-1}D_q(\mathcal{C})-\tau_q]_+$,保住了联合兼容性;命题 2 进一步给出包络精确性——若存在达到离散度极小的相干律,则 $\sum_iq_iv_i-D_q(\mathcal{P})$ 就是所有相干联合律下可达的最大系统性方差,说明 sharp 形式不是启发式收紧。其三,决策论性质齐备且可检验:存在性(Weierstrass)、凸性(条件负定等价于等距嵌入 Hilbert 空间,可由观测矩阵直接验证)、零松弛载波不变性(分配与 $L$ 无关),三者把抽象证书变成良定义、可解、对声明的载波常数稳健的规则。其四,评估设计上的新意:利用嵌入的 Matryoshka 结构构造宽度阶梯、跨模型族与跨训练世代(EttaX V0/V1/V3)的表示敏感性阶梯,把“测量层选择”作为独立报告的维度,并以 64 维压力单元与事后样本 V3 作负对照,而不是只报告单点结果。
实验结果
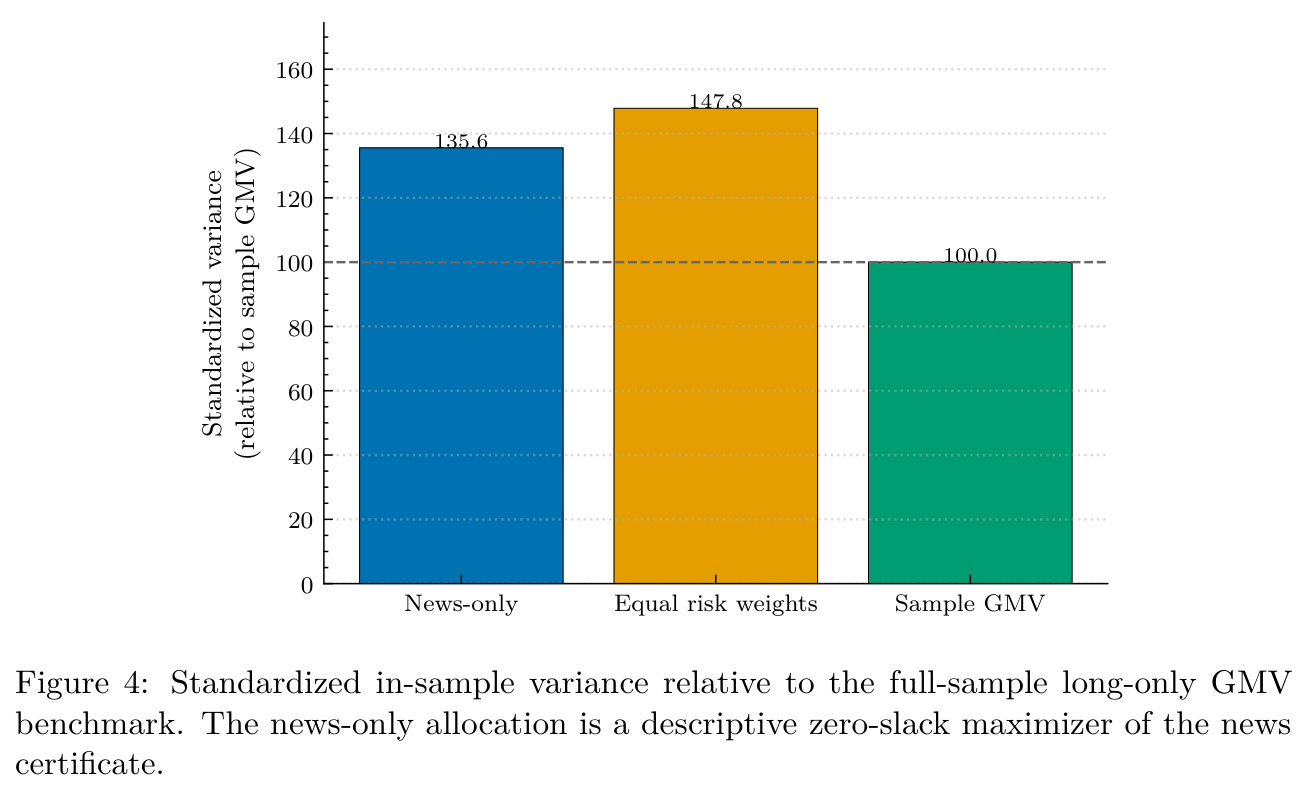
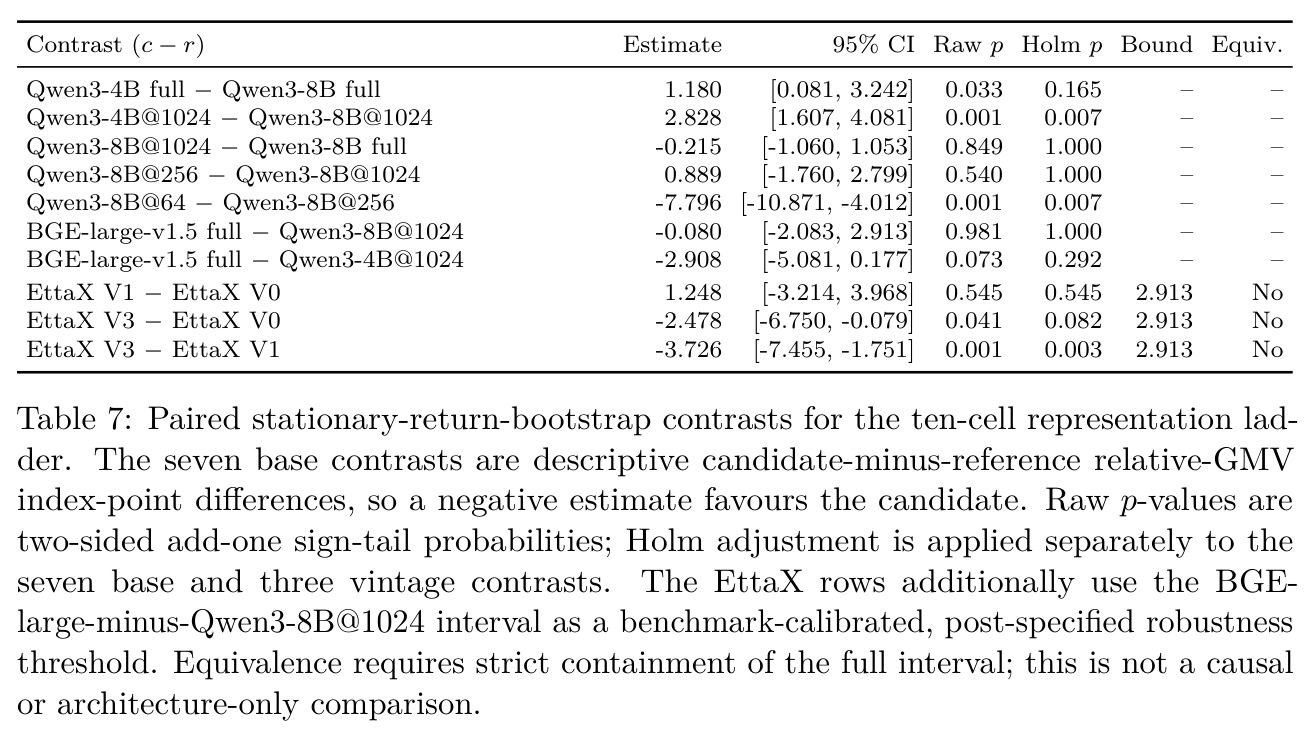
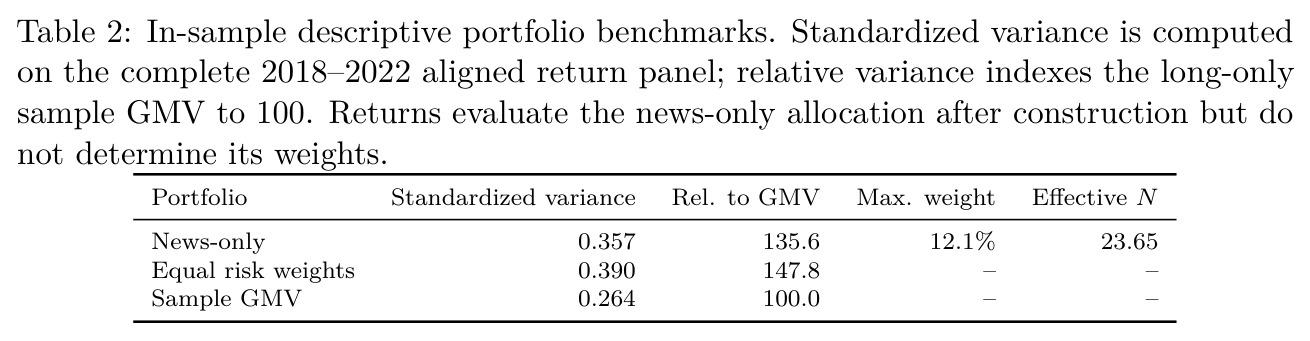
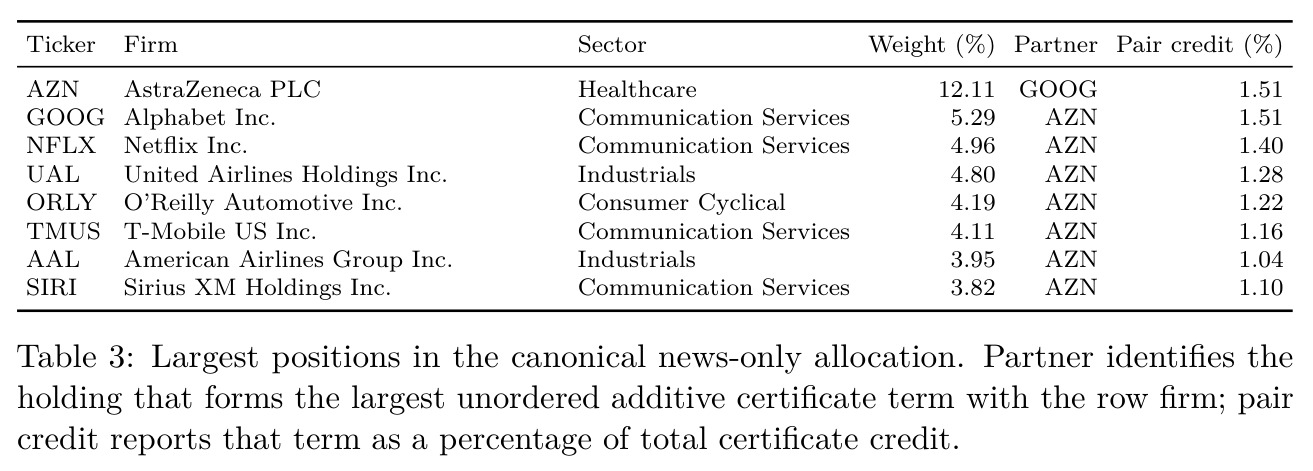
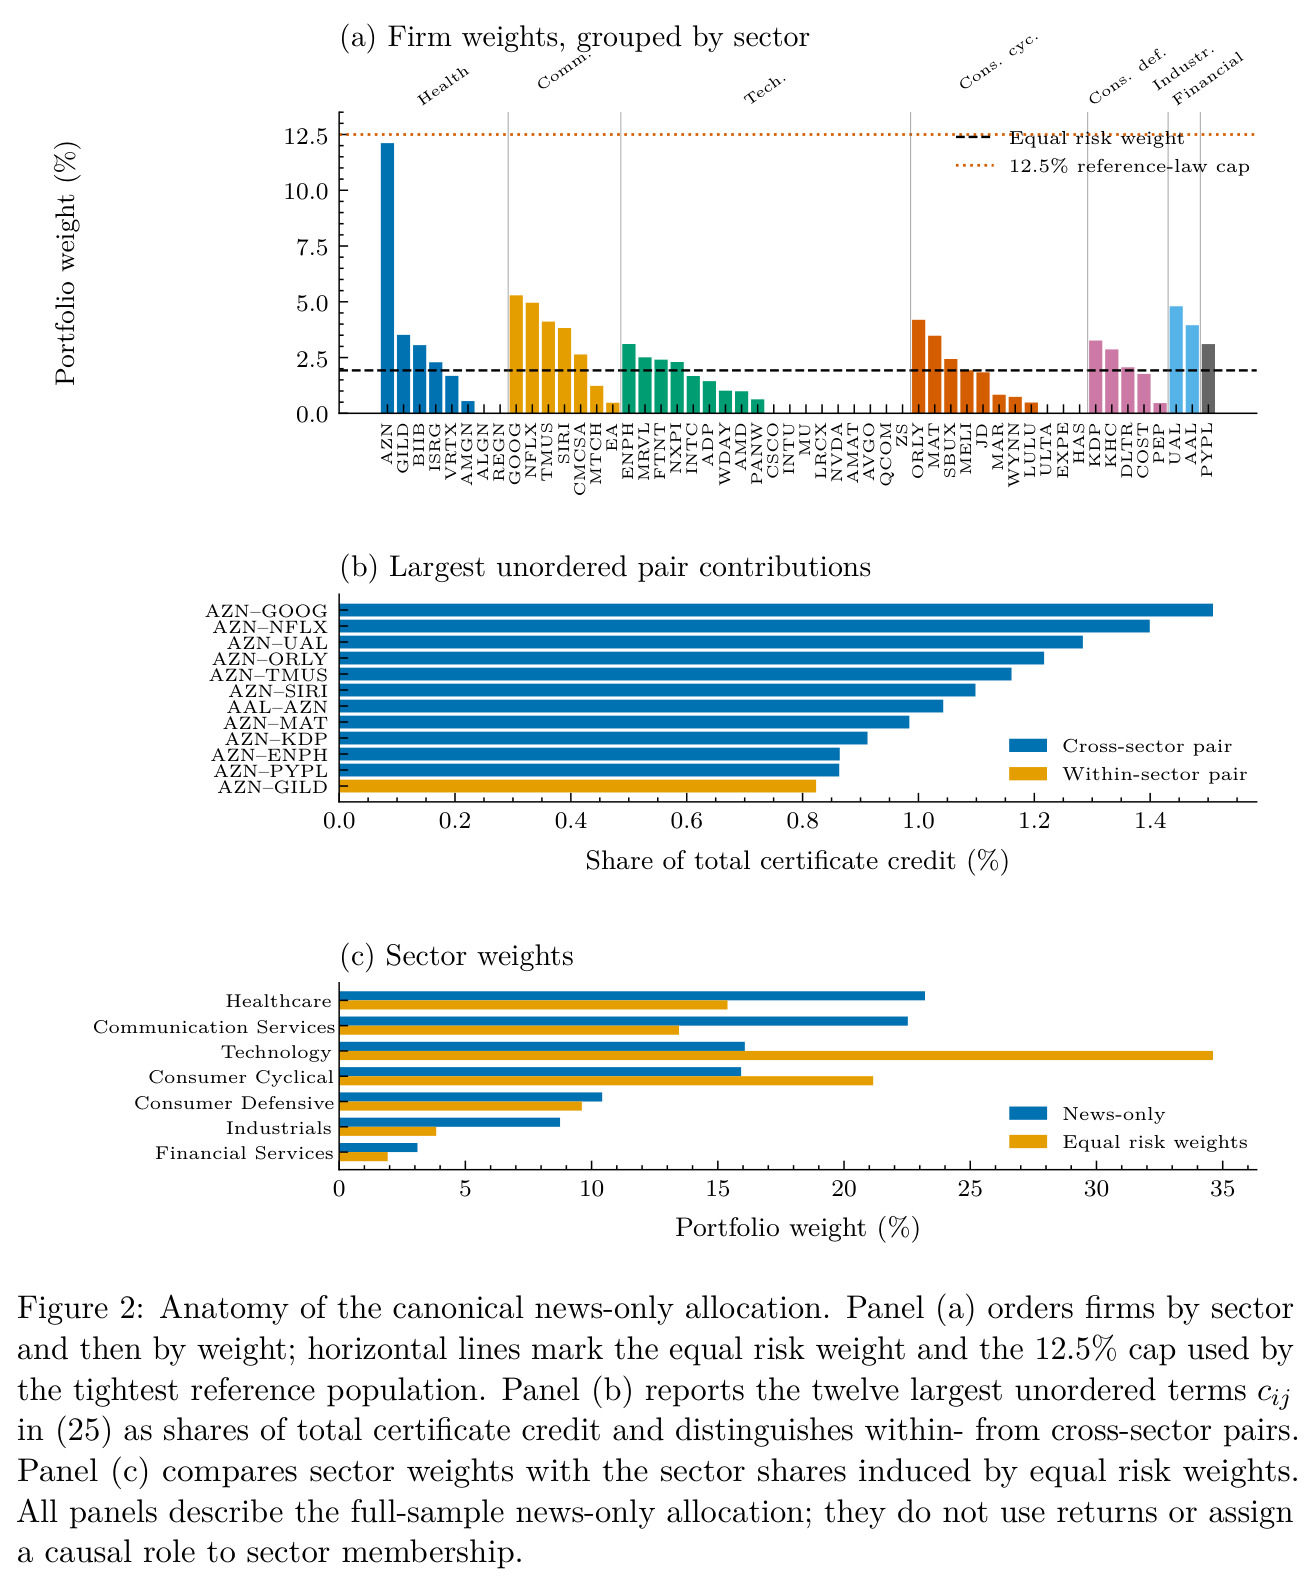
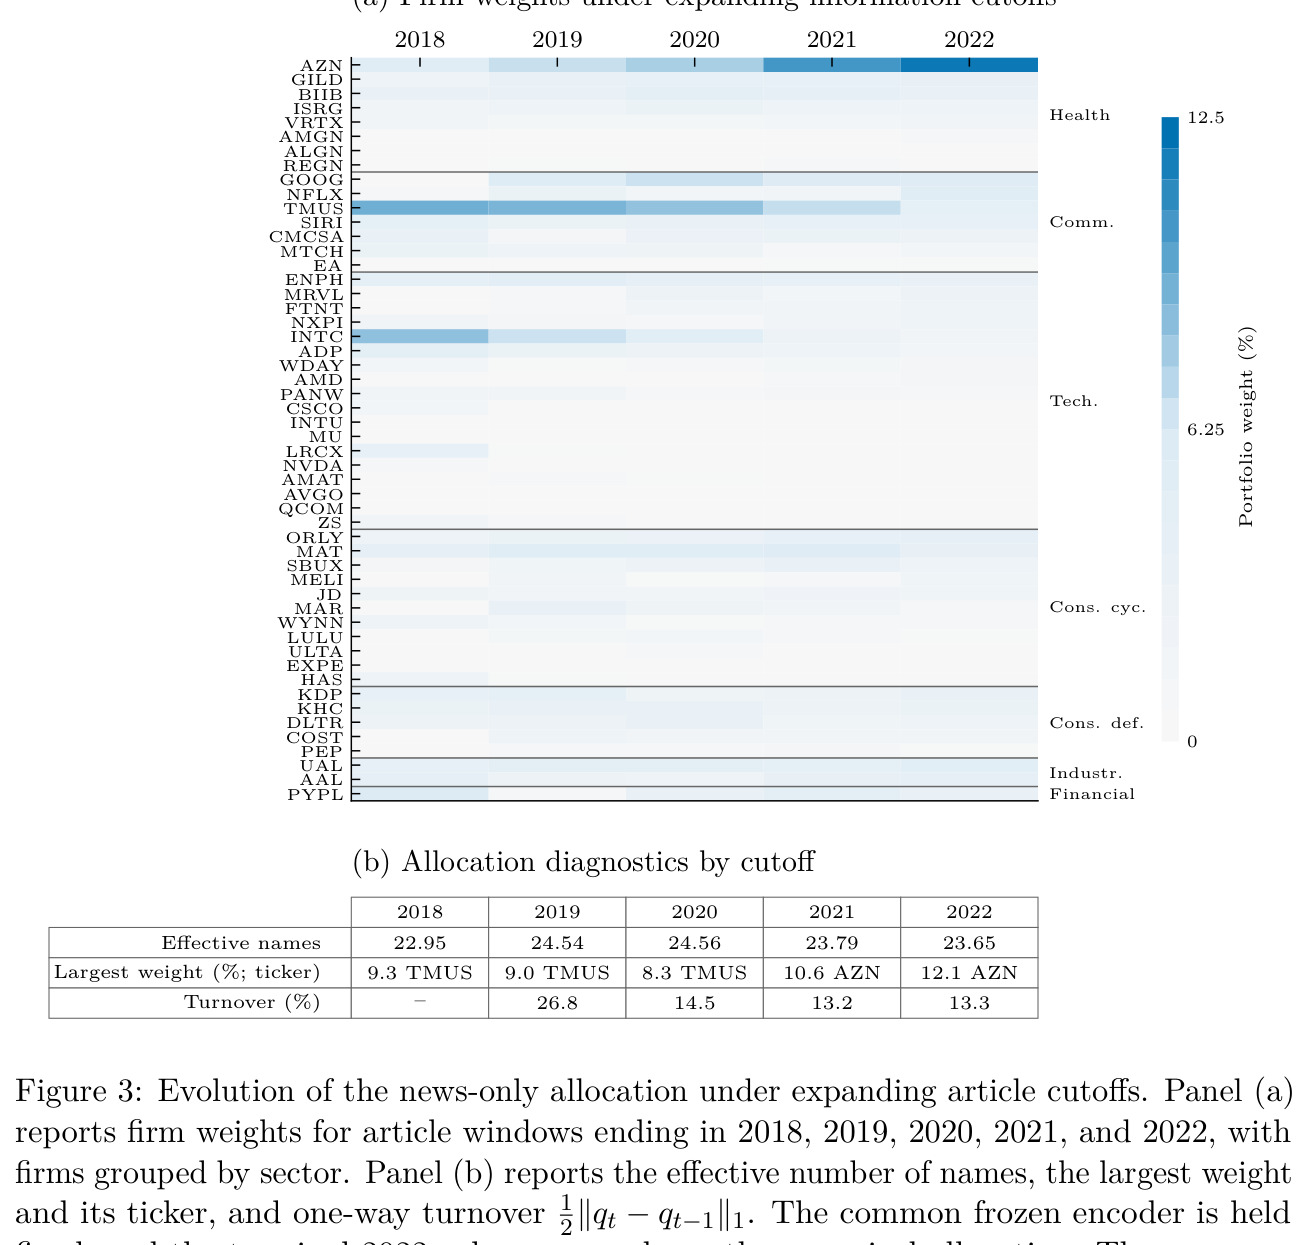
主结果(表 1):预指定的 Qwen3-Embedding-8B(4096 维)news-only 配置在四个预指定封顶参考总体中的标准化方差分位数介于 0.69% 与 1.33%——均匀 12.5% 封顶 0.72%、均匀 15% 封顶 0.69%、有效 N 匹配总体(均值 24.23,对候选的 23.65)0.89%、刻意更集中总体(均值 19.01)1.33%,每个总体 20000 次抽样;等风险权重对应为 28.6%、28.4%、25.4%、21.1%,全面落后,且在浓度被大幅改变的比较下低排名依然成立,排除了“只是更集中”的机械解释。与名义基准校准(表 2):news-only 标准化方差 0.357,比等风险(0.390)低 8.3%,但比事后多头样本 GMV(0.264)高 35.6%——落在可行分布极低位,却不及协方差知情最优。配置解剖(图 2、表 3):52 家中 38 家获正权重,最大持仓 AZN 12.11%,有效 N 23.65;配对信用项中 AZN–GOOG(1.51%)、AZN–NFLX(1.40%)、AZN–UAL(1.28%)居前,87.1% 的证书信用来自跨部门配对。扩张截止诊断(图 3):2018→2022 各截止的有效 N 在 22.95–24.56 之间,最大权重从 8.3%(TMUS)升至 12.1%(AZN),单向换手 13.2%–26.8%,2020 年无异常断裂。表示敏感性(表 4):Qwen3-8B 截到 1024 维几乎不变(0.82%,配对区间含零);同宽 Qwen3-4B 更差(2.39%,Holm 校正显著);BGE-large-v1.5@1024 接近(0.80%);64 维压力单元反而最低(0.02%),宽度阶梯非单调;EttaX V0/V1/V3 为 5.44%/7.27%/2.48%,V3–V1 对比 Holm 显著,等价性准则均不满足。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 可行组合总体内方差排名(52 股,2018–2022,各总体 20000 次封顶 Dirichlet 抽样) | 标准化方差分位数(越低越好) | news-only 配置:0.69%–1.33%(四总体) | 等风险权重:21.1%–28.6% | 排名低位约 20–28 个百分点 |
| 绝对方差位置 vs 等风险权重 | 全样本标准化方差 | 0.357 | 等风险权重 0.390 | 低 8.3% |
| 绝对方差位置 vs 协方差知情最优 | 相对长期样本 GMV 指数(GMV=100) | 135.6 | 样本 GMV 100.0 | 高 35.6%(落后于事后最优) |
| 嵌入宽度压缩敏感性(有效 N 匹配总体) | 方差分位数 / 相对 GMV | Qwen3-8B@1024:0.82% / 135.3 | Qwen3-8B 全宽 4096:0.89% / 135.6 | 统计上无差异(配对区间含零) |
局限与改进
作者承认五条边界:(1)识别性——证书条件于 antilipschitz 载体、公司松弛、一个相干联合律与收益桥,文本数据并不识别这些传递机制;$L$、$\tau_i$、$\delta$ 都是“声明的”参数而非估计的,证书的经济含义(低方差是否真由信息分离的风险削减造成)取决于维护假设是否为真。(2)表示依赖——文章选择、编码模型与输出宽度共同决定测得的分布;宽度阶梯非单调(64 维反而最好),EttaX 世代对比不满足等价性,没有证据支持几何对测量选择不变。(3)比较集设计——分位数只相对四个预指定的 Dirichlet-封顶总体成立,换成市值加权、因子倾斜或历史配置经验分布作参照,排名可能不同。(4)组合实施——实证只是标准化资产特例(单位边际尺度使 $x=q$),一般资本权重目标需要边际波动率 $\sigma_i$ 输入,标准化与可实施资本配置之间的差距未量化。(5)外部效度——52 家是覆盖筛选后的幸存者面板而非历史指数成员;新闻几何与收益评估同用 2018–2022 年,分位数是描述性的样本内排名,扩张截止序列因收益评估期不变而不构成样本外证据。我的补充观察:$C(q)$ 只是平方距离的加权二次型,对嵌入噪声的鲁棒性没有理论刻画;20000 次 Monte Carlo 的分位数估计未报告置信区间(配对 bootstrap 仅用于表示阶梯);证书尚未与协方差收缩结合成估计器;样本为单一市场、单一时段,且未计入交易成本与容量约束——考虑到 13%–27% 的年度换手与对等风险仅 8.3% 的方差优势,成本敏感性是不可忽略的疑问。
独立分析的弱点
独立分析的弱点:(1)传递假设不可检验且无标定来源——$L$、$\tau_i$、$\delta$ 全是声明值,零松弛虽使分配对 $L$ 不变,但方差界的数值与证书是否为正都随声明变化;改进方向:用横截面因子暴露回归、期权隐含波动率或分析师覆盖数据来校准 $\tau_i$ 与收益桥,使证书有经济标定。(2)均衡云规则人为性强——按 URL 哈希把每家公司截成等规模文章云,丢掉了新闻量差异(公司受关注程度本身可能有信息量);改进:采用不平衡最优传输保留质量差异,或对云规模做敏感性分析。(3)参照系是合成的 Dirichlet 抽样而非真实可选策略——分位数“低”的含义依赖这四个声明总体;改进:用历史最低波动率基金、指数成分的真实配置分布作参照。(4)对 $W_2$ 矩阵测量误差敏感——嵌入 API 版本漂移、语料增减都会改变几何(扩张截止显示 13%–27% 换手),而二次目标会放大距离矩阵的扰动;改进:对距离矩阵加入扰动做最坏情形(分布鲁棒)优化,或对 $C(q)$ 做正则化以稳定支持集。(5)忽视交易成本与容量——年度换手 13%–27% 在对等风险仅 8.3% 的方差优势面前可能吞噬全部净收益;改进:在目标中加入换手惩罚与流动性约束重新求解,并报告净成本后的方差-成本前沿。(6)分位数无不确定性度量——应给出 bootstrap 区间或精确的二项置信带,使“接近第一百分位”的表述可检验。
未来方向
作者明确提出的方向:第一优先级是点时(point-in-time)构建与真正样本外评估——冻结编码器、文章语料与 $W_2$ 几何之后再观察评估期收益;其次是识别或标定载体、公司松弛与收益桥的可辨识对应物;第三是把证书并入收缩或受约束的协方差估计器并研究其统计性质(论文明确说本文未做这件事);更广地,任何“经济对象可表示为分布场且存在可辩护传递限制”的场景(信用组合、其他资产类别)都可套用同一逻辑产生聚合风险的单侧限制。基于本文成果可以延伸:(1)把证书作为外部信息源构造收缩型协方差估计,形式化为 $\hat\Sigma$ 在证书约束下的投影并分析其误差性质;(2)将两两协方差包络(2026a)与本文相干组合界合并为“协方差带”,做区间优化而非点优化;(3)用多模态信息场(财报电话会纪要、公告、社交媒体)丰富 $\mathcal{C}_i$ 并检验几何的跨源稳定性;(4)研究时变 $W_2$ 几何下的动态配置与换手惩罚版本;(5)在因子模型坐标中直接对暴露律 $\mathcal{P}_i$ 做传输,检验证书与因子结构的一致性;(6)理论上刻画 $D_q$ 自由中心重心问题的求解复杂度,以及内层近似误差如何传入方差界。
复现评估
复现难度中等偏高,但有利的部分很多。方法完全可审计:三个生产编码器(Qwen3-Embedding-8B、Qwen3-Embedding-4B、BGE-large-en-v1.5)经 OpenRouter 的 OpenAI 兼容嵌入 API 公开可得,Qwen3 权重本身开源;Nasdaq 按代码的新闻档案与 Yahoo Finance 收益数据均公开;计算上只是 $52\times52$ 的均衡二次最优传输(POT/geomloss 类库即可)加单纯形上的凸二次规划,单 CPU 数分钟到数小时可完成,无需训练、无需 GPU 集群。不利条件:论文未提及发布代码或数据包;EttaX V0/V1/V3 是作者本地训练的 320 维编码器(外部无法获得同一权重),该部分的世代对比只能近似复现;Nasdaq 档案的文章集合随时间增删,要重建完全相同的均衡文章云需要在相同时点抓取;嵌入 API 的模型版本漂移也可能改变距离矩阵。总体判断:拿到相似新闻语料后,核心结果(news-only 配置、$W_2$ 矩阵与四个分位数排名)可在数天内近似复现;EttaX 世代阶梯与逐篇文章级距离则不可完全复现。
论文图表