Specter:量化驱动多步推测卸载的快速 MoE 推理系统 Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading
用量化目标模型自身做草稿,借推测解码多步前瞻预取专家,单卡 MoE 推理平均提速 1.50×
前置知识
MoE(混合专家模型)
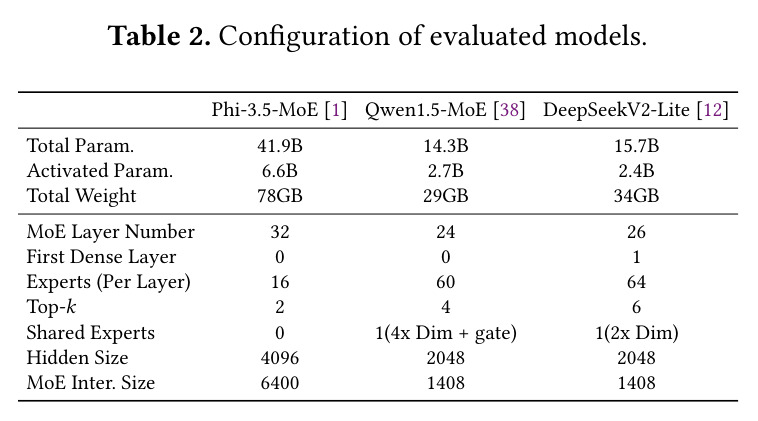
MoE 把 Transformer 中的稠密 FFN 替换为 $N$ 个并行『专家』网络加一个可训练路由器:每个 token 的隐状态经 router 打分后,只激活得分最高的 top-$k$ 个专家参与计算(如 Mixtral top-2、DeepSeekV2-Lite top-6)。这样模型总参数可以很大(Phi-3.5-MoE 达 41.9B)而每 token 实际计算量很小(6.6B),在不增加计算成本的前提下提升容量与精度。代价是全部专家权重必须能放进显存才能无阻塞推理。
本文处理的核心问题正是 MoE 权重超过单卡显存时的推理;路由的输入依赖性与专家显存占用是所有瓶颈(PCIe 卸载、专家爆炸)和设计(预取、缓存)的根源。
推测解码(Speculative Decoding, SD)
一种无损加速自回归解码的技术:先用轻量草稿模型快速连续生成 $K$ 个候选 token,再让目标模型用一次带因果掩码的前向传播并行验证,通过 accept/reject 采样决定接受多少个候选。拒绝采样机制在数学上保证最终输出分布与目标模型完全一致——草稿猜错只浪费时间,不影响生成质量。接受率高时一轮迭代可产出多个 token,等效大幅降低每 token 延迟。
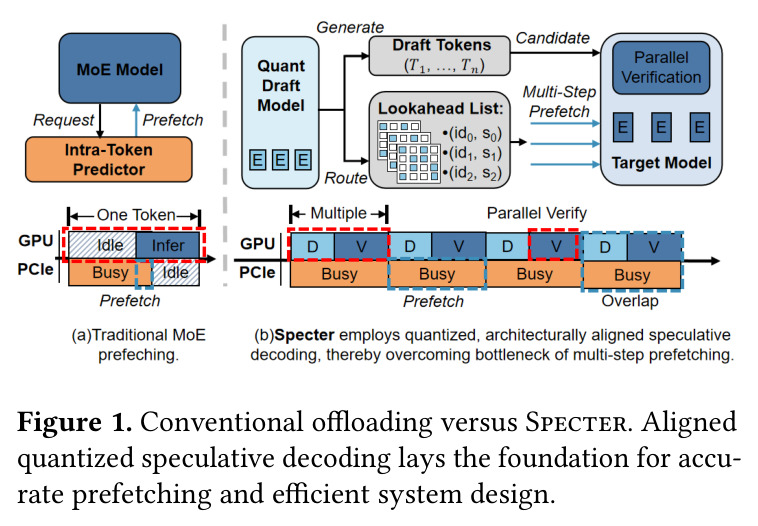
Specter 把 SD 反过来用:草稿连写 $K$ 个候选的时间天然构成『未来哪些专家会被激活』的多步预测窗口,预取调度与验证保真机制是整个系统设计的骨架。
专家卸载与 PCIe 瓶颈
当显存放不下 MoE 全部专家时,把不活跃专家放到主机内存,推理到某层需要某专家时再经 PCIe 总线从 CPU 内存搬入 GPU 显存(H2D 传输)。A100 配 PCIe 4.0 x16 的理论带宽约 31.5 GB/s,搬运 GB 级专家需要毫秒级时间,期间 GPU 只能空转,成为端到端延迟的主导因素。缓解手段包括按需加载、专家缓存与预取。
Specter 的首要目标就是把这段毫秒级 PCIe 传输延迟藏进草稿计算与验证计算之后;理解该瓶颈才能理解其三阶段预取与缓存驻留管理的设计动机。
GPTQ INT4 量化
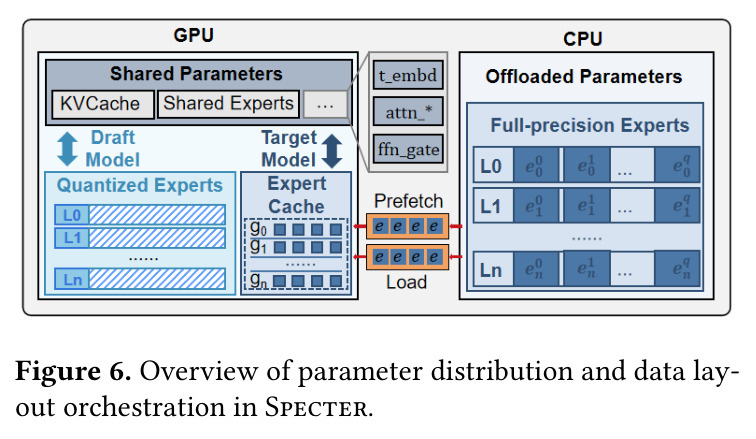
GPTQ 是一种训练后量化(PTQ)方法,把 FP16 权重逐层压缩为 4 位整数,典型按 group size=128 分组共享缩放因子,精度损失很小;配合 Marlin 等低比特 GEMM 内核可获得显著吞吐提升。需注意 router 对量化噪声敏感——logits 的微小扰动就可能改变 top-$k$ 选择,因此本文把 router、attention 等非专家参数留在 FP16,只量化专家 MLP。
『用量化后的目标模型自身当草稿』是全文最关键的洞察:量化既压缩草稿显存、加速草稿执行,又几乎不改变专家路由,使零训练成本的高保真路由预测成为可能。
TPOT(每输出 token 时间)
Time Per Output Token,自回归生成中平均每产出一个 token 所需的时间(ms/token),是衡量交互式推理延迟的标准指标,与首 token 延迟(TTFT)和吞吐(tokens/s)互补。单请求场景下 TPOT 直接决定用户感知的生成速度;批量场景下则取逐请求平均。论文还用缓存命中率(目标路由的专家已在显存缓存中的比例)衡量预取质量。
论文所有性能结论(平均 1.50×、最高 1.88× 加速、69.2 ms 等)均以 TPOT 为主要指标,辅以吞吐与命中率,读懂指标定义才能读懂实验部分。
研究动机
MoE 架构让模型容量摆脱计算量约束,但总权重动辄超出单卡显存:Phi-3.5-MoE 总参数 41.9B、权重 78GB,DeepSeekV2-Lite 15.7B、34GB,而常见工作站 GPU 只有 24–80GB 显存。通行做法是把不活跃专家卸载到主机内存,推理时按需经 PCIe 加载,但专家路由高度依赖当前 token 的隐状态且逐层、逐 token 严格串行,导致 PCIe 传输被钉在关键路径上。现有预取只能做 token 内预测——利用当前 token 前几层的隐状态预测后面层的路由,可利用的只有微秒级计算窗口;而 GB 级专家在 PCIe 4.0 x16(理论 31.5 GB/s)上传输需要毫秒级,两者相差约三个数量级,GPU 长期处于饥饿状态。若不做验证就按未确认的多步预测强行执行,路由误差会逐步累积并损害生成质量,因此现役卸载系统始终存在大量 GPU 停顿。
本文的目标是本文目标是构建一个面向显存受限单 GPU 的 MoE 推理系统:在不改变目标模型输出分布(数学上严格无损)的前提下,把推测解码提供的跨 token 多步前瞻转化为专家 I/O 调度窗口——在草稿生成 $K$ 个候选 token 期间,提前把验证阶段将要用到的专家经 PCIe 搬进显存,使毫秒级传输与计算深度重叠。同时必须系统性解决随之而来的三大瓶颈:草稿与目标双模型带来的显存争用(挤压专家缓存)、推测深度 $K$ 增大引发的『专家爆炸』式 I/O 需求激增、以及细粒度 MoE 矩阵导致的碎片化执行与流水线气泡,最终在真实硬件、多模型多数据集上把 TPOT 相对最先进系统平均降低 1.5 倍以上,让单卡跑大 MoE 变得实用。
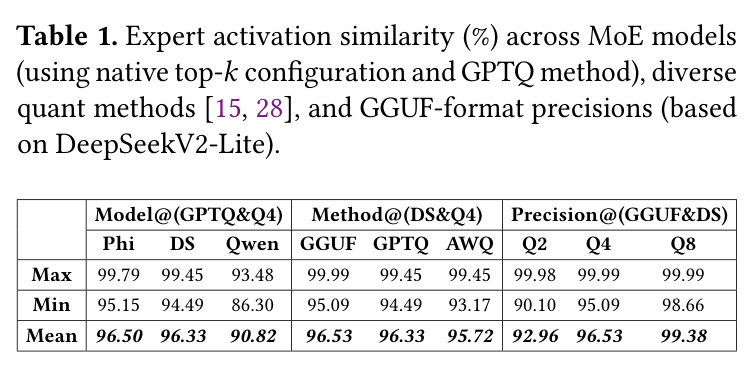
与已有工作不同的是,已有工作沿两条线推进但互不打通。专家预取方向(如 ProMoE、AdapMoE)局限于 token 内预测,前瞻窗口太短,无法覆盖毫秒级传输;推测解码用于 MoE 的方向中,MoE-Spec 与 SS-MoE 用限制或近似专家执行换取效率、显式引入质量-延迟权衡,SP-MoE 要求结构兼容的 draft–target 模型对,SpecMoEOff 虽做了推测 I/O 流水但调度与显存墙问题未解决。Specter 的独特切入是彻底放弃独立草稿模型,改用目标 MoE 自身的 INT4(GPTQ)量化副本当草稿:两者共享完全相同的路由架构与参数血统,零训练成本即可获得高保真路由预测——实测 Qwen1.5-MoE 的 top-4 专家 ID 匹配率全局均值 90.8%,Phi 与 DeepSeek 约 96.3–96.5%,从而把高度不确定的数据依赖路由问题转化为确定性的 I/O 预取调度问题。
核心方法
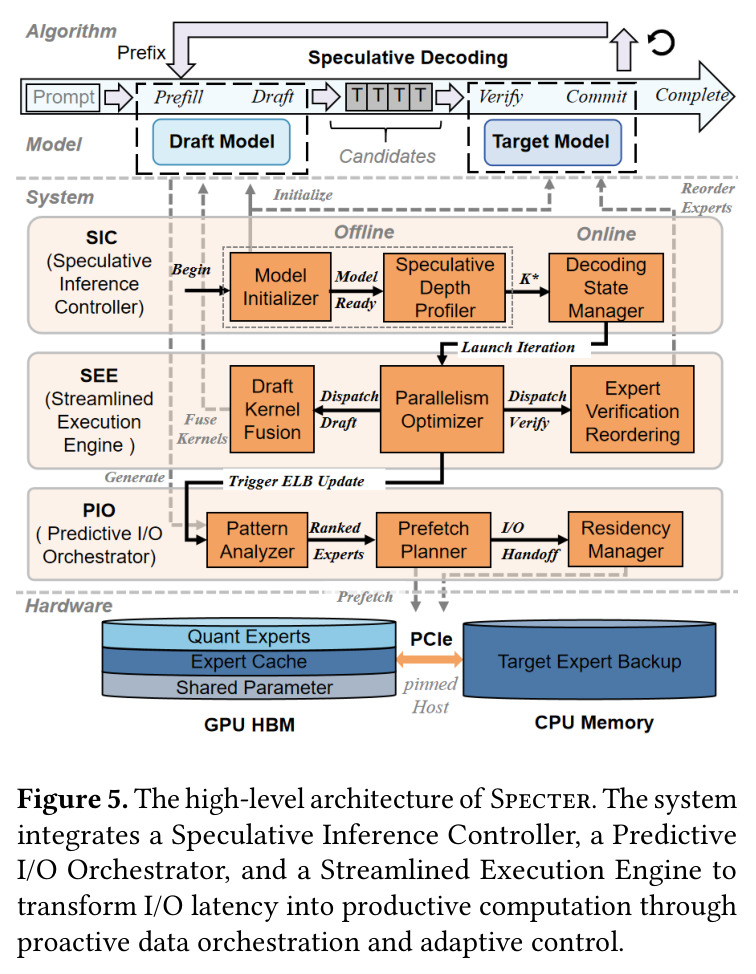
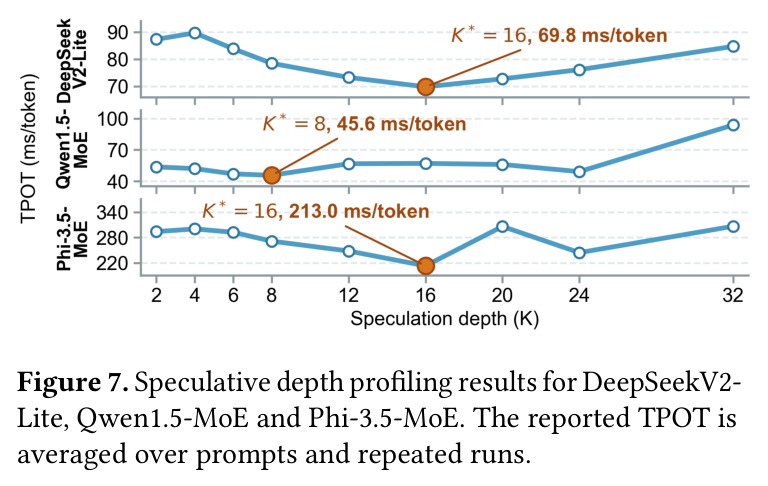
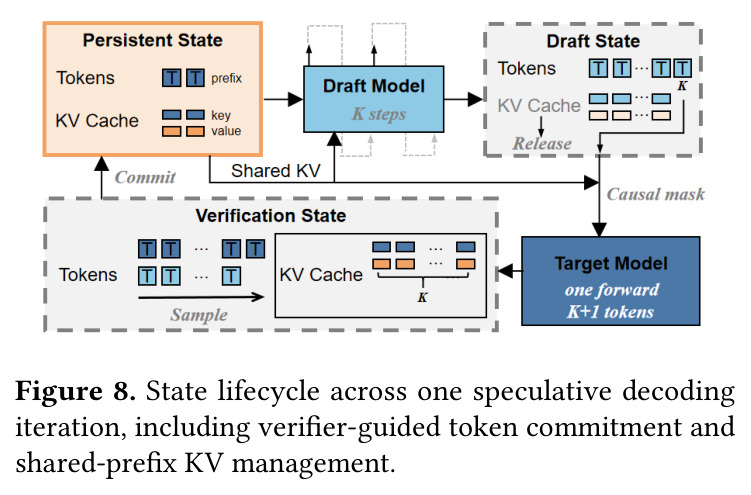
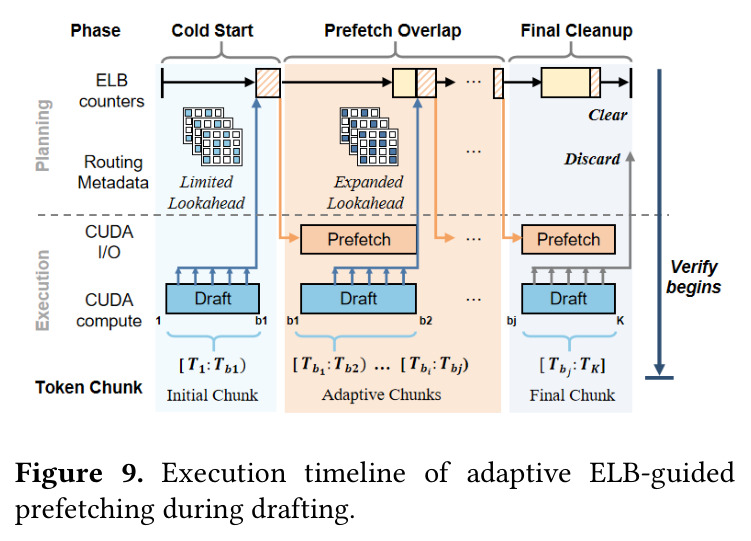
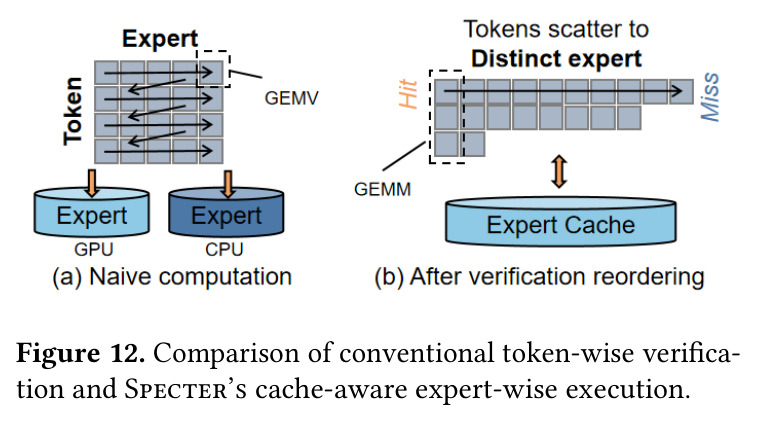
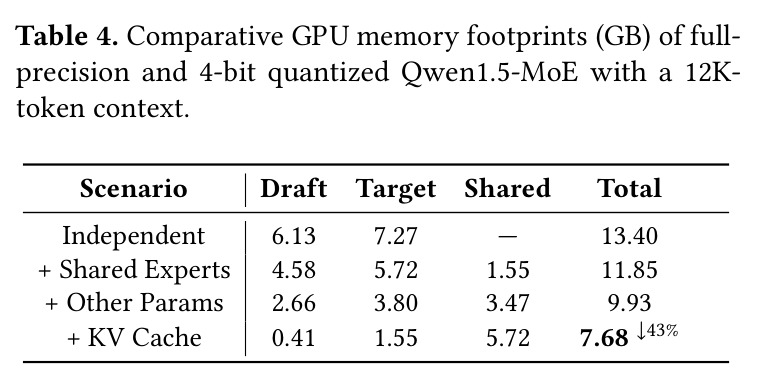
直觉上,既然推测解码反正要先让草稿连写 $K$ 个候选再交给目标验证,这段草稿时间正好可以用来提前搬运验证所需的专家——问题只在于谁来可靠预言未来路由。Specter 的答案是『量化自己』:用 GPTQ 把目标 MoE 的路由专家压成 INT4 作为草稿,它与非专家参数(embedding、attention、router,保持 FP16)及共享专家共享同一实例,双模型总显存比独立部署降 43%。系统由三部分组成:SIC 负责混合精度初始化、离线 profile 选推测深度 $K^* = \arg\min_K \mathrm{TPOT}(K)$(三模型分别取 16/8/16)及目标权威的解码状态管理;PIO 用专家前瞻缓冲 ELB 汇总草稿路由计数,按 Cold Start → Prefetch Overlap → Final Cleanup 三阶段在自适应 chunk 边界生成增量 H2D 预取批次,验证期再由驻留管理器让命中专家先算、缺失专家异步加载;SEE 用融合 INT4 多专家内核加速草稿、用缓存感知的专家维度重排把碎片化 GEMV 变成稠密 GEMM,并以 CUDA 流与事件消除同步气泡。
核心创新可概括为『量化即预言』。实测表明 INT4 量化几乎不改变专家选择:Qwen1.5-MoE 的 top-4 专家 ID 匹配率在 1000 条请求 × 24 个 MoE 层(24000 个请求-层对)上全局均值 90.8%,实例级、层级、请求级三种分布均稳定超过 90%;跨模型、跨量化方法的相似度均值也在 92.96%–99.38%(Table 1)。之所以如此,是因为 Specter 把对量化噪声最敏感的 router、attention 与共享专家都留在 FP16,只量化专家 MLP 的线性层。与传统 SD 相比,本质区别有三:其一,独立小模型完全没有路由机制、或路由空间与目标不对齐(隐藏维数、专家数不同),训练专属 MoE 草稿成本高且常路由失配,而量化副本零训练、路由空间天然对齐;其二,以往预取只有 token 内微秒窗口,Specter 用 $K$ 步跨 token 前瞻把 PCIe 传输提前到验证之前,把毫秒级 I/O 藏进计算;其三,严格的 draft-then-verify 机制保证即使路由预测错误也只是浪费预取带宽,绝不损害输出分布。
方法步骤详情
流程分六步。(1) 离线准备:对专家线性层做对称 INT4 GPTQ 量化(group size 128),用 25 条 prompt×3 次扫描 $K\in\{2,4,...,32\}$,按 $K^* = \arg\min_K \mathrm{TPOT}(K)$ 选深度;由接受率 $\bar{\alpha}=96.63\%$ 得 $E[A]=\bar{\alpha}/(1-\bar{\alpha})=28.7$,上限取 32。(2) 草稿:从目标权威前缀前进 $K$ 个候选 token,Analyzer 在 GPU 上累计每层计数 $\mathrm{ELB}(t)_{\mathrm{cnt}}[j,e]=\sum_{i=1}^{t}\mathbb{I}[e\in\mathrm{ELB\_route}[i,j]]$。(3) 预取:Planner 在边界 $b_i$ 快照 ELB,取每层 top-$M$ 专家打包成计划,批量 D2H 交给 CPU,并选 $b_{i+1}$ 使 chunk 计算时间近似等于 H2D 传输时间,计算流与 I/O 流并发。(4) 验证:目标 router 给出权威路由,驻留管理器让命中专家进计算队列、缺失专家进 I/O 队列边算边搬,使用中的专家不被换出。(5) 执行优化:草稿用融合内核单次 launch 完成全部专家子计算;验证按专家聚合 token 成 GEMM,先算驻留专家、异步拉缺失专家,再 scatter 回原位。(6) 提交:仅目标确认的 token 与 KV 进入共享前缀,草稿临时状态丢弃。
技术新颖性
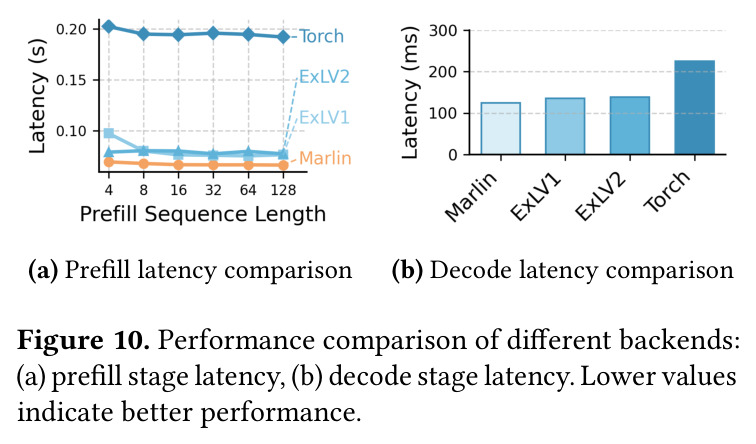
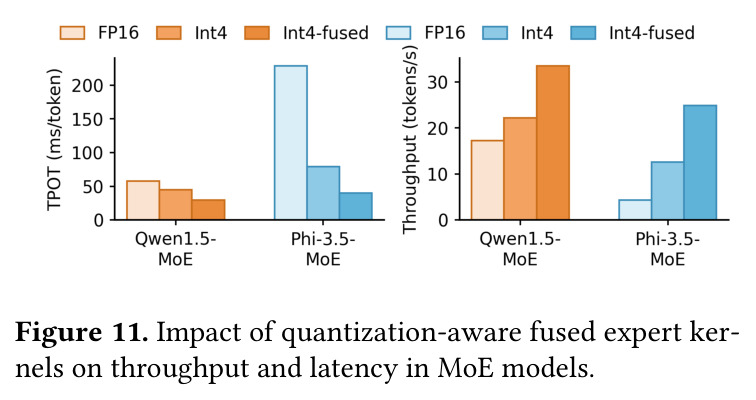
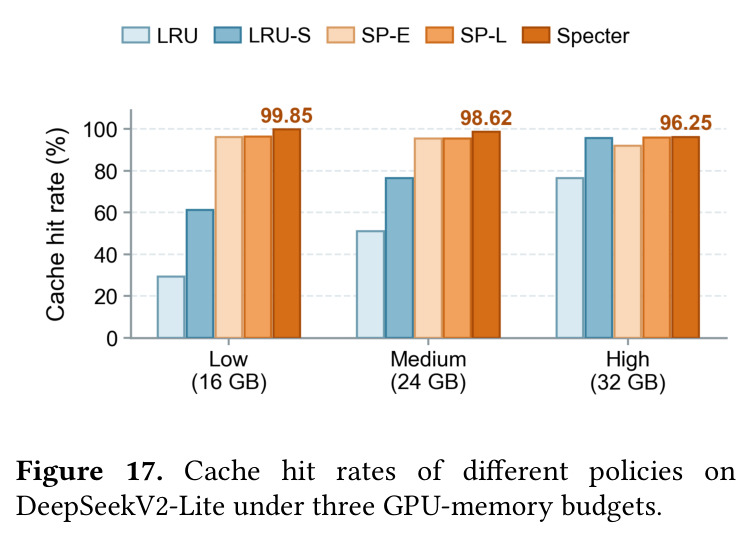
技术新颖性体现在三个层面。第一,现象的系统化发现与利用:『量化不改变路由』此前只是零散经验,Specter 首次跨 3 个模型、多种量化方法(GPTQ/AWQ/GGUF Q2–Q8)系统测量专家激活相似度(均值 90.8%–99.38%,Table 1),并把这一现象转化为系统级 I/O 调度原语,实现零训练成本的草稿-目标对齐——这与 SP-MoE 等要求专门训练结构兼容草稿的路线有本质区别。第二,调度机制:ELB 加自适应 chunk 边界把预取从一次性猜测变成滚动精化——每个边界快照累计计数、生成增量批次、并以传输时间配平计算时间,使缓存命中率达 96.25%–99.85%,显著超过反应式 LRU 及单次预取变体 SP-E/SP-L。第三,内核工程:识别出 Marlin 类内核面向 72K×18K 大 GEMM 优化、而细粒度 MoE 专家矩阵仅 2048×1408 或 4096×6400,导致量化执行反而可能慢于 FP16 的问题,设计单次 launch 的融合多专家内核,并做保证数学等价的专家维度验证重排(GEMV→GEMM)。三者共同把『理论前瞻』转化为端到端收益。
实验结果
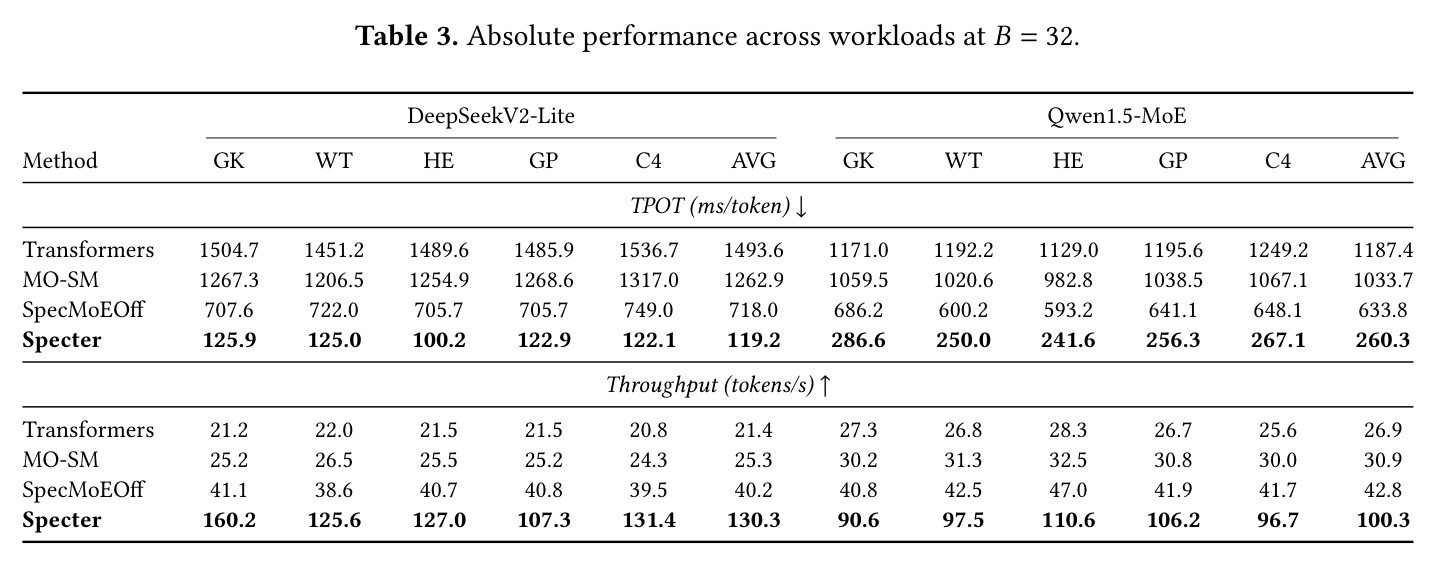
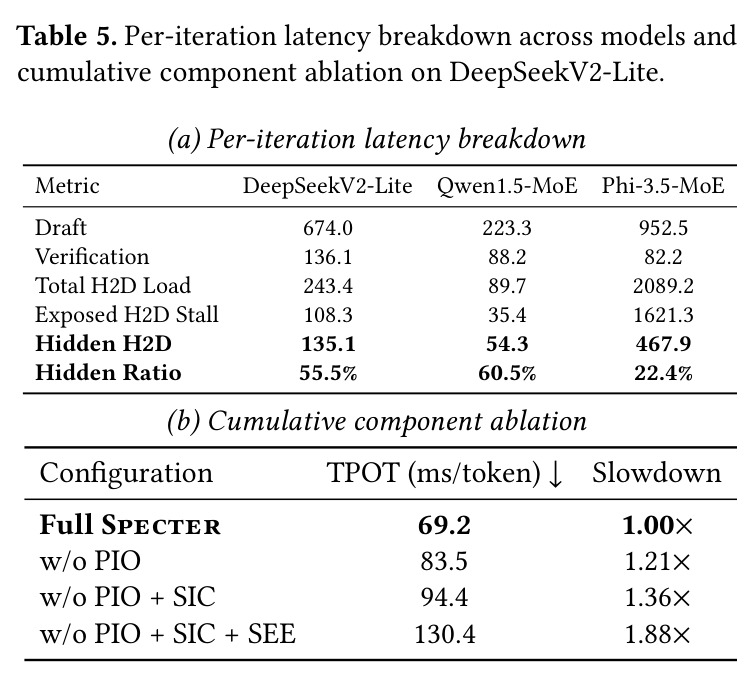
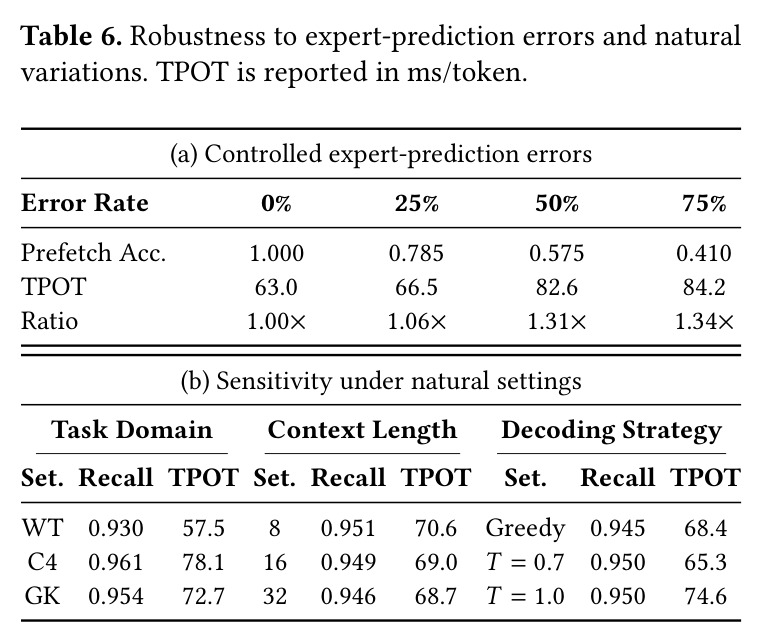
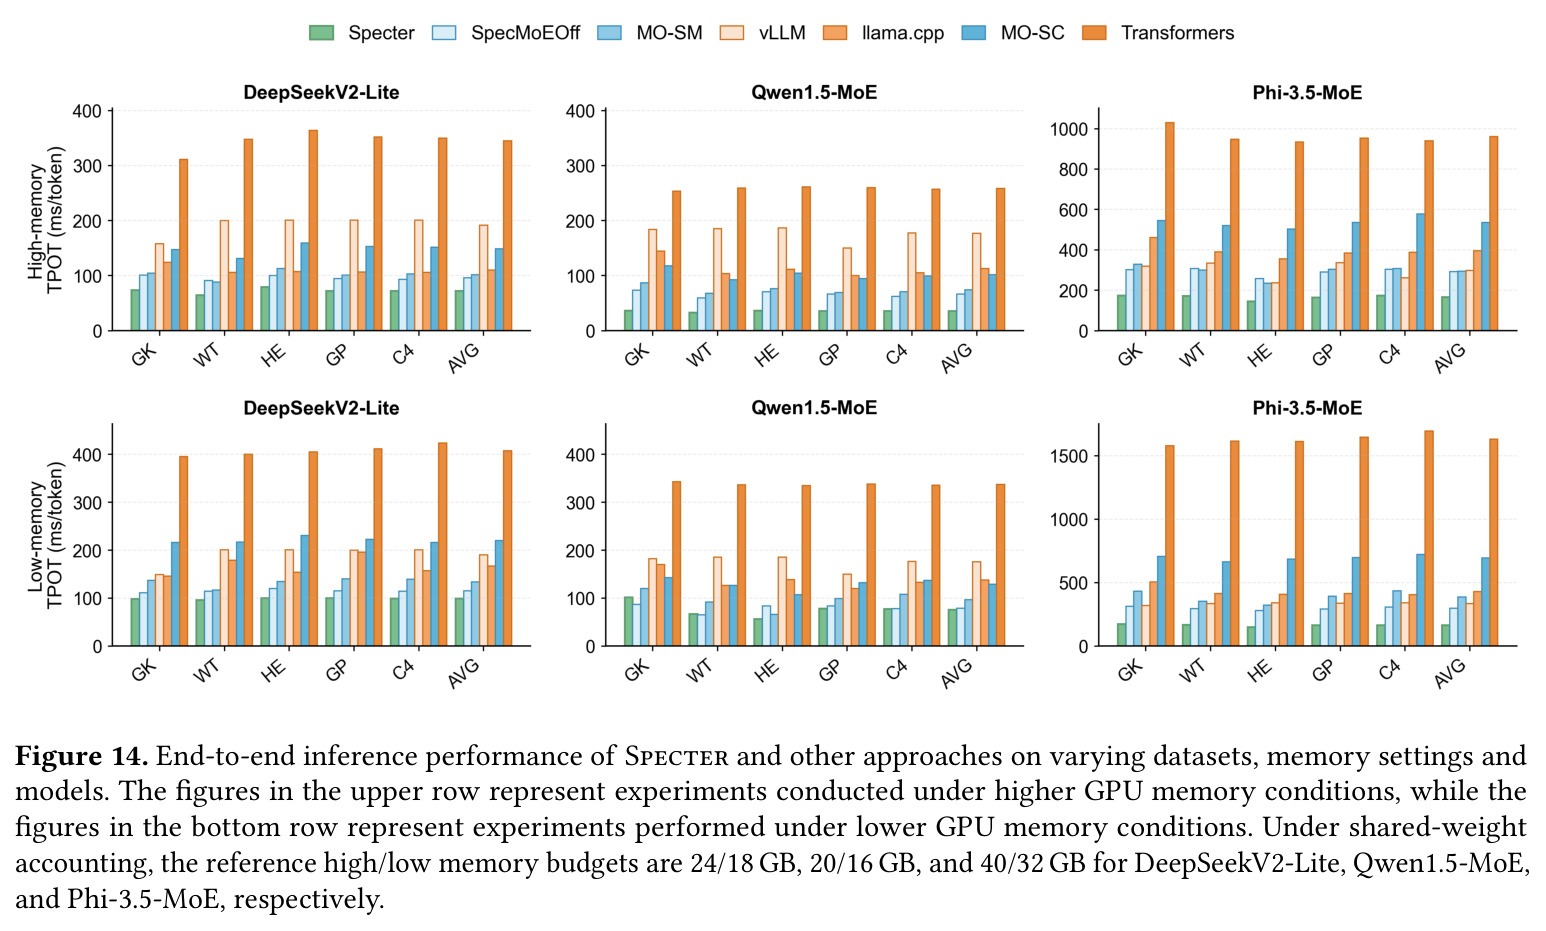
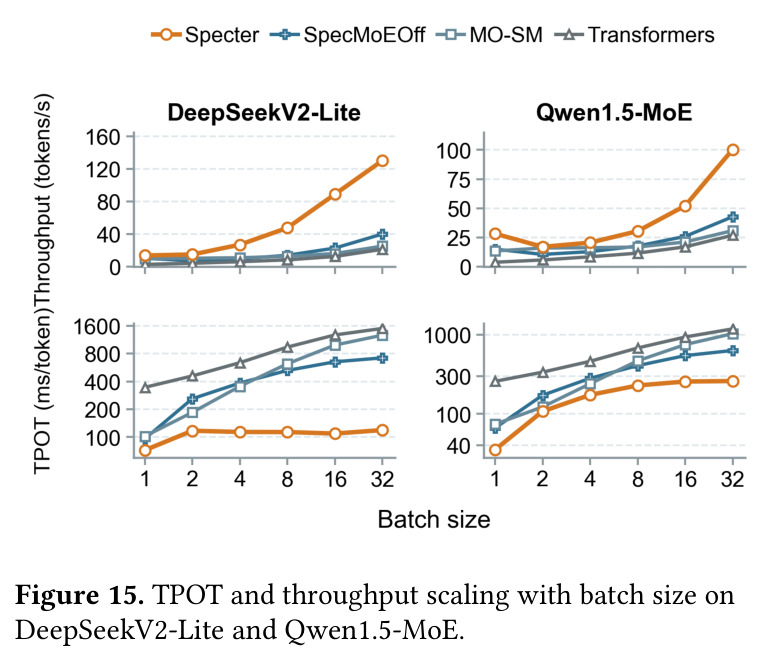
在单张 A100 40GB(PCIe 4.0 x16,31.5 GB/s)上,跨 Phi-3.5-MoE、Qwen1.5-MoE、DeepSeekV2-Lite 三模型、五数据集与高低两档显存预算:单请求对 SpecMoEOff 平均 1.50×、最高 1.88× TPOT 加速——Qwen 35.3 vs 66.4 ms/token(1.88×);Phi 163.3 vs 292.1(SpecMoEOff)、297.5(vLLM)、960.6 ms(Transformers,5.9×);DS 72.2 vs Transformers 344.9 ms;低显存档仍几乎全面领先。批量 B=32:DS 平均 TPOT 119.2 ms、吞吐 130.3 tokens/s,对 SpecMoEOff 的 718.0 ms/40.2 提升 6.02×/3.24×(吞吐峰值 3.89× 在 B=16);但 B=1→32 时 TPOT 膨胀至单请求的 1.65×/7.37×(DS/Qwen)。显存:共享设计把 Qwen 12K 上下文占用从 13.40 GB 压到 7.68 GB(−43%)。消融:完整系统 69.2 ms,去 PIO 83.5(1.21×)、再去 SIC 94.4(1.36×)、全去 130.4(1.88×);H2D 隐藏比例 DS/Qwen/Phi 为 55.5%/60.5%/22.4%。鲁棒性:预取精度从 1.000 稀释到 0.410,TPOT 仅从 63.0 升至 84.2 ms(1.34×),输出质量零损失;自然路由召回率稳定在 0.930–0.961。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单请求推理 · Qwen1.5-MoE(高显存档,5 数据集平均) | TPOT (ms/token) | 35.3 | SpecMoEOff 66.4 / MO-SM 74.2 / vLLM 176.6 / Transformers 258.2 | 对 SpecMoEOff 1.88×(全文最高单点加速) |
| 单请求推理 · Phi-3.5-MoE(高显存档) | TPOT (ms/token) | 163.3 | SpecMoEOff 292.1 / MO-SM 295.1 / vLLM 297.5 / Transformers 960.6 | 对 Transformers 最高 5.9×,对 SpecMoEOff 1.79× |
| 单请求推理 · DeepSeekV2-Lite(高显存档) | TPOT (ms/token) | 72.2 | Transformers 344.9(各基线中最强者差距更小,Specter 仍整体最优) | 对 Transformers 约 4.8× |
| 批量推理 B=32 · DeepSeekV2-Lite(5 数据集平均) | TPOT (ms/token) | 119.2 | SpecMoEOff 718.0 / MO-SM 1262.9 / Transformers 1493.6 | 对 SpecMoEOff 6.02×(批量 TPOT 峰值加速) |
| 批量推理 B=32 · DeepSeekV2-Lite | 吞吐 (tokens/s) | 130.3 | SpecMoEOff 40.2 / MO-SM 25.3 / Transformers 21.4 | 对 SpecMoEOff 3.24×;吞吐峰值增益 3.89× 出现在 B=16 |
| GPU 显存占用 · Qwen1.5-MoE(12K 上下文) | 显存 (GB) | 7.68(草稿+目标共享权重、共享专家、非专家参数与 KV cache) | 独立双模型部署 13.40 | 降低 43% |
| 专家缓存命中率 · DeepSeekV2-Lite(16/24/32 GB 预算) | 命中率 (%) | 99.85 / 98.62 / 96.25 | LRU、LRU-S、SP-E、SP-L(反应式或单次预取策略,均显著更低) | 所有预算下最高 |
局限与改进
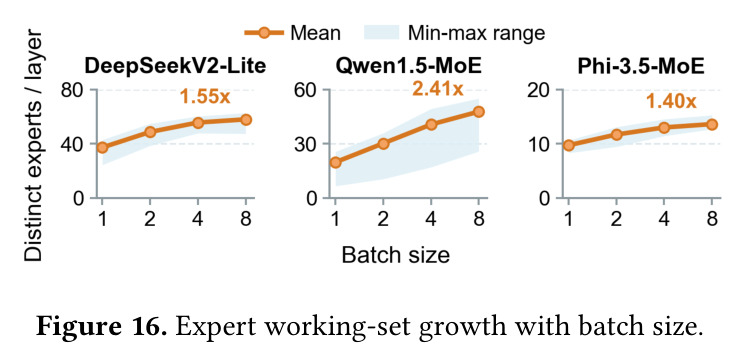
作者承认的局限:其一,Phi-3.5-MoE 的 I/O 隐藏比例仅 22.4%(总 H2D 2089.2、暴露停顿 1621.3),因其每层专家传输需求过大、缓存装不下,暗示权重更大或带宽更低时收益会缩水;其二,批量下 TPOT 随批规模明显恶化(Qwen 在 B=32 时为单请求 7.37×),根源是专家工作集随 B 扩张(Figure 16 中 Qwen 相对扩张 1.52×);其三,专家爆炸随 $K$ 非线性增长(DS 的 $K$ 从 1 到 16 时每层专家需求从 6.0 涨到 31.7,5.3×),限制可用推测深度。我的观察:评估仅限单卡 A100 + PCIe 4.0,未覆盖消费级 GPU(如 24GB 4090)、PCIe 3.0/5.0 或 CPU 较强的边场景;模型止步 41.9B,未验证 DeepSeek-V3(671B)级路由是否同样量化稳定;$K$ 由离线 profile 静态选定,分布外负载可能次优;top-6 的 DS 单 token 已需 6 专家,$K$ 步联合工作集更易溢出缓存,大 top-$k$ 模型的收益上限值得量化。
独立分析的弱点
独立分析五点弱点。(1) 方法前提是『量化保路由』:若目标模型 router 带强负载均衡约束或对扰动敏感,保真度(当前 90.8%–96.5%)会下滑并拖累命中率,改进方向是对 router 做轻量校准或路由头蒸馏。(2) 单请求收益显著但批处理 TPOT 恶化(B=32 时 Qwen 260.3 ms,为单请求 7.37×),请求间专家需求未合并调度,可做 batch 级 ELB 与请求感知的 $K$/缓存划分。(3) $K$ 靠离线 profile 一次选定,负载漂移后可能次优,可用在线多臂老虎机按实时 TPOT 自适应调 $K$。(4) 深推测前提是超高接受率($\bar{\alpha}=96.63\%$、$E[A]=28.7$);高温采样或更强目标模型下接受率下降时,大 $K$ 草稿开销可能得不偿失,应把 $K$ 与实时接受率联动收缩。(5) 错误预取不损质量但浪费 PCIe 带宽(预取精度 0.410 时仍慢 34%),可按 ELB 计数置信度设阈值,砍掉低置信传输、把带宽留给高置信专家。
未来方向
作者层面:结论与 artifact 暗示可扩展到更紧显存预算与更多主流 MoE(DeepSeek-V3、Qwen3-MoE 级别),并预留多模型 checkpoint 支持。可延伸方向:(1) 把 ELB 式前瞻推广到 KV cache 卸载与注意力调度,形成统一『权重+状态』预取框架;(2) 与 draft tree、动态推测深度(Dynamic Depth Decoding、MagicDec)结合,拉长前瞻窗口并按接受率在线调 $K$;(3) 引入 CPU 计算参与缓存未命中专家执行(借鉴 HybriMoE),把 PCIe 等待变为异构计算;(4) 系统化利用精度-保真度曲线——Table 1 显示 GGUF Q8 相似度 99.38%、Q2 仅 92.96%,可借鉴 MoE-APEX 做自适应精度专家:热专家高精度保保真、冷专家低比特省带宽;(5) 与 CXL/NVLink 或近存计算协同设计,从硬件层缓解专家爆炸(EARTH 已走专用加速器路线);(6) 把量化草稿路由预测推广到 MoE 训练/微调的参数与优化器状态调度。
复现评估
复现条件友好。代码开源(github.com/wwwwwf/specter_asplos),附 ASPLOS artifact 附录与 Zenodo 存档(DOI 10.5281/zenodo.22937478),含源码、wheel、数据集与校验和。硬件:1× A100 40GB、24 核 Xeon、256GB 主存、磁盘约 200GB;软件栈锁版本(PyTorch 2.7.0、CUDA 12.8、Transformers 4.53.3、GPTQModel 4.0.0.dev0、FlashAttention 2.8.1),提供 uv 安装脚本与配置检查。DeepSeek-V2-Lite 直接提供 FP16 target + GPTQ INT4 draft checkpoint,无需自行量化;Qwen 与 Phi 需另备 checkpoint。官方预估:环境准备约 1 小时(不含下载),主实验约 20 分钟,深度/前缀扫描各 20–30 分钟;参考配置高显存主实验约 70 ms/token,与论文 72.2 ms 一致。数据集随 artifact 提供,greedy 解码、每显存档 75 条记录。综合难度中低:脚本文档齐全,最大门槛是 A100 40GB 硬件;降级到 24GB 消费卡需自行调显存档位与每层驻留数。
论文图表
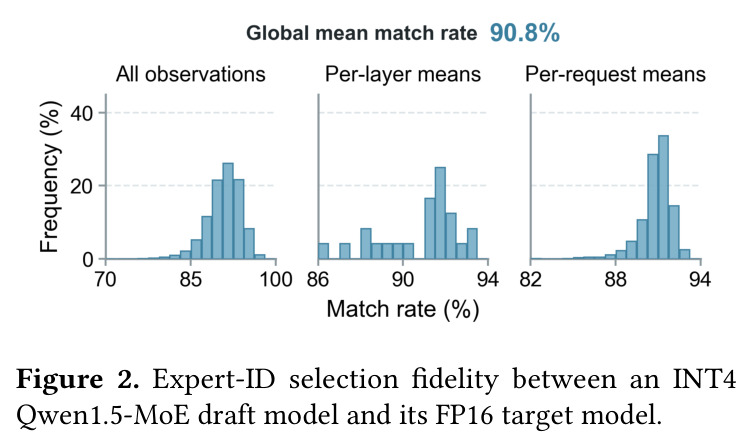
展示 INT4 草稿与 FP16 目标在 Qwen1.5-MoE 上 top-4 专家 ID 匹配率的三种分布:实例级、层级聚合、请求级聚合(1000 请求 × 24 MoE 层,共 24000 个请求-层对),所有分布峰值超过 90%,全局均值 90.8%。
这是『量化即预言』这一核心洞察最直接的实验证据,支撑了整个方法可行性的第一块基石。
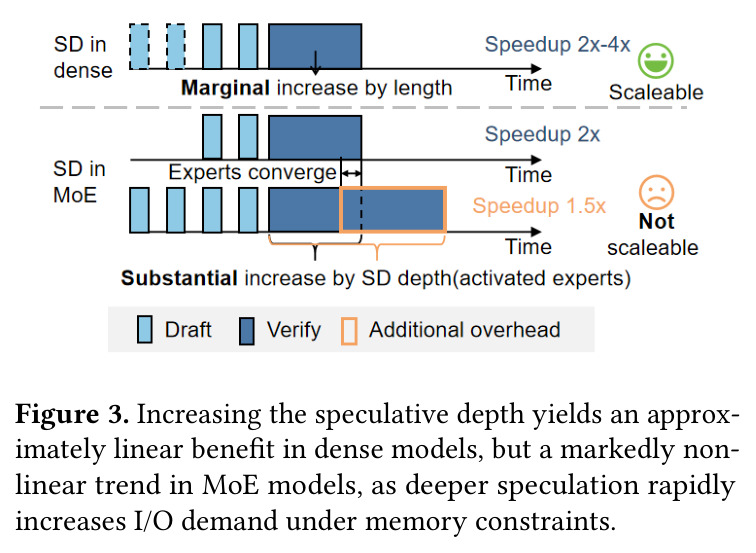
对比稠密模型与 MoE 模型随推测深度 $K$ 增加的收益曲线:稠密模型近似线性获益,MoE 模型则呈明显非线性——$K$ 增大后专家工作集激增,I/O 需求在显存约束下迅速吃掉收益。
解释了为什么把 SD 直接搬到 MoE 卸载会失效(专家爆炸),是引出 PIO 调度设计的关键动机图。
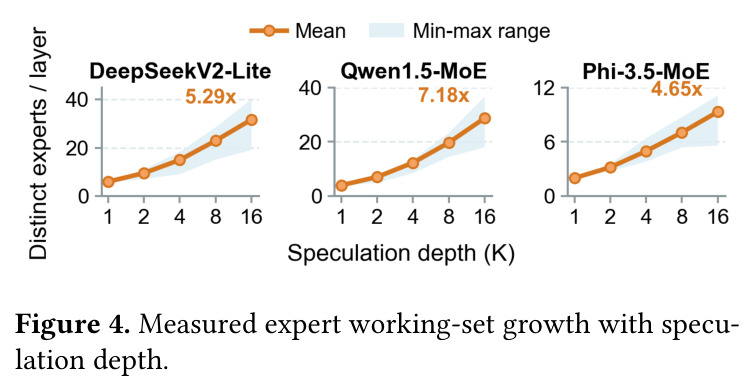
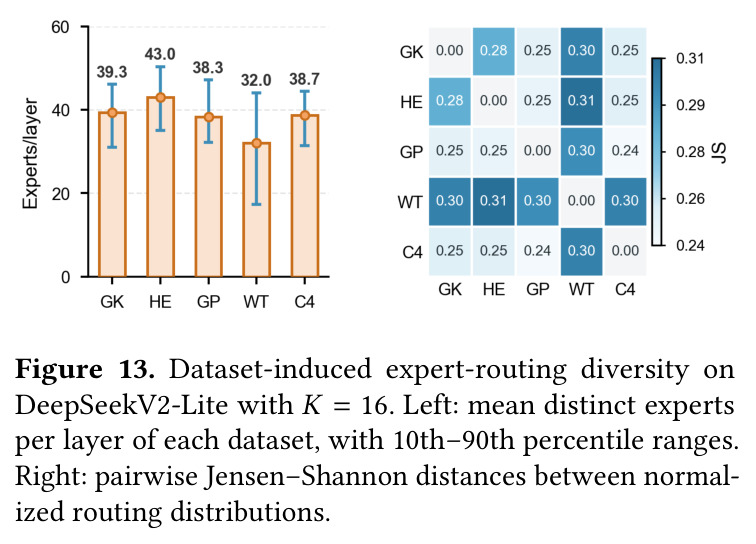
实测三个 MoE 模型每层专家工作集随 $K$ 的增长:DeepSeekV2-Lite 从 $K=1$ 到 $K=16$ 时每层专家需求从 6.0 涨到 31.7(5.3×,覆盖 64 个专家的近一半),Qwen1.5-MoE 与 Phi-3.5-MoE 呈类似趋势。
定量刻画『专家爆炸』的严重程度,是理解为何需要 ELB 增量预取与缓存驻留管理的量化依据。