记忆墙的另一半:用训练的路由预测从 SSD 伺服 35B MoE The Other Half of the Memory Wall: Serving 35B MoEs from SSD with Trained Routing Prediction
预路由器提前一步预测专家路由,24GB消费机从SSD流式伺服35B MoE达20 tok/s
前置知识
MoE 稀疏路由
混合专家(MoE)每层有 $E$ 个专家网络,路由器为每个 token 打分并只激活 top-$K$ 个(如 256 选 4),两大实现家族是 softmax-top-k 与 sigmoid 分组路由。稀疏性把每 token 激活参数从 35B 压到约 3B,但全部专家权重仍需驻留——省的是计算,不是存储字节。
本文的一切都围绕“路由集合”展开:预测它、按它加载专家、在它上面训练恢复 LoRA,不理解路由机制就无法理解系统的核心闭环。
解码算术强度与记忆墙
解码阶段每读一字节权重只执行几次 FLOP,远低于硬件 roofline 的 ridge point,瓶颈是字节搬运而非算力,即 Wulf 与 McKee 1995 年命名的记忆墙(memory wall)。内存里有两类数据:KV cache 是动态状态,权重是训练结束即固定的静态数据。
论文标题的“另一半”就是静态权重:业界用 MLA/稀疏注意力/线性状态模型压缩了动态 KV 侧,本文则攻击静态权重侧的存放问题。
int4 分组仿射量化
把权重压到 4-bit,每 64 个权重共享一组 scale 与 zero-point(group-64 仿射量化)。4-bit 是 GPTQ/AWQ 类训练后量化的实用下限,再低误差增长到模型不可用;35B 模型因此仍占 19.5 GB,而不是更小。
SSD 上存的就是 int4 专家张量,量化方案决定了磁盘上的字节布局;LoRA 不能合并的根源也是 4-bit 的量化步长远大于 LoRA delta。
LoRA 与知识蒸馏
LoRA 在冻结权重旁并联低秩分支 $y = Wx + \frac{\alpha}{r}BAx$,只训练 $A,B$ 两个小矩阵。蒸馏则用教师模型(这里是 fp16 原版基座)的输出分布指导学生训练,反向 KL 散度是 mode-seeking 的常用目标,不要求学生覆盖教师全部支撑集。
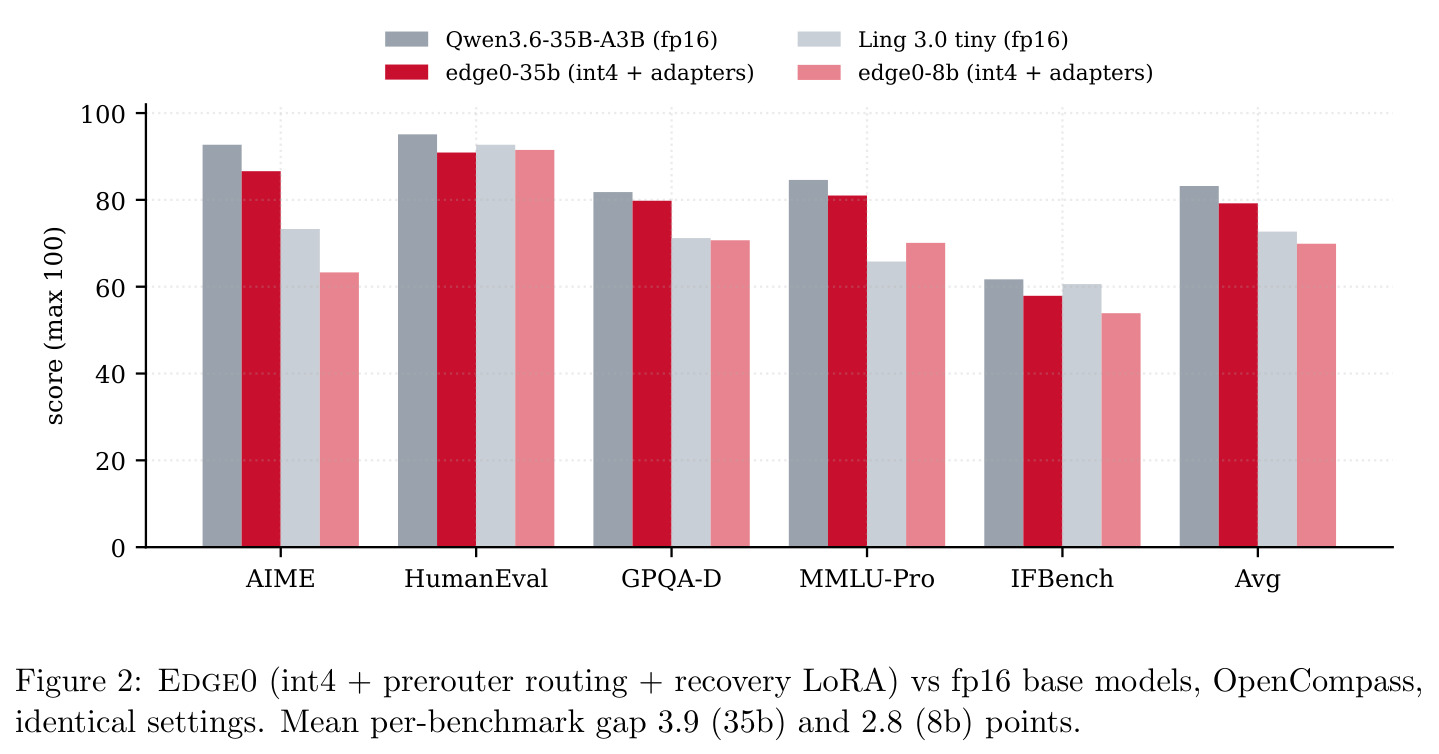
recovery LoRA 是在“预测路由的学生路径”上从 fp16 教师蒸馏出来的,这是质量能追到与 fp16 只差 3.9 分的关键机制。
mmap 与操作系统页缓存
内存映射文件让进程按需读取文件的字节范围,热数据由 OS 页缓存承载且可回收;进程 RSS 把文件映射页也计入,而应用自身的驻留分配(如 MLX 缓冲)不可回收,两者构成了不同的“内存账本”。
Edge0 的内存故事(峰值活跃 2.9 GiB vs RSS 5–6 GiB)与预取的隐性代价(不可回收驻留挤掉页缓存)都必须靠这套虚拟内存机制来理解。
研究动机
现有方案在 35B 规模同时失灵。量化一轴:GPTQ/AWQ 类训练后量化在 4-bit 已是实用下限,低于 4-bit 误差增长到模型不可用;MoE 稀疏一轴:35B MoE 每 token 只激活约 3B 参数,缩减的是计算量而不是必须驻留的字节数,19.5 GB 的 4-bit 权重仍要找地方放。在 24 GB 桌面机上全量驻留的结果是:mlx-lm 解码仅 3.9 tok/s,且 18.2 GiB 不可回收权重把 KV cache、操作系统和用户其他程序全部挤走,系统开始换页。朴素的 SSD 卸载也救不了:解码时第 $N{+}1$ 层的专家选择依赖第 $N$ 层的输出,而该输出尚不存在,读操作无法提前启动,磁盘延迟被串行进每一步的每一层。数据中心的答案(专家并行、分片伺服)对无数据中心的本地部署完全无效,这就是“记忆墙的另一半”。
本文的目标是本文的目标是在一台 24 GB 消费级设备(Mac mini M4 Pro)上以可用速度伺服 35B 级 MoE:解码约 20 tok/s,峰值活跃内存由活跃专家集而非参数总量决定(约 3 GiB,对比 19.5 GB 的 checkpoint),同时五个公开基准的平均质量与 fp16 基座只差几个百分点。配套目标包括:给出一个 8B tier(MLA+MoE 混合,4.5 GB checkpoint,28 tok/s,1.5 GiB)验证框架通用性;把路由宽度 K 做成“唯一同时移动速度与内存的旋钮”,换宽度只是换文件;框架、checkpoint、adapter 全部开源,让整套管线可在别人机器上复现。
与已有工作不同的是,独特切入是把“预取提示”升级为“预测即路由”。已有的 pre-gating 类方法在同 token 内预选下一块专家,推理时必须为预测错误兜底(fallback 加载、丢 token),永远背负 coverage-vs-quality 的运行时权衡;Edge0 让第 $N$ 层的 head 预测第 $N{+}1$ 层在下一 token 的路由,且预测直接被当作路由本身消费,staged 集合与 routed 集合构造上恒等,推理路径零兜底——近似的代价被转移到训练阶段,在 student path 上一次性付清(recovery LoRA)。另一个反直觉立场是不合并 LoRA:作者证明把 adapter 合并进 int4 再重量化会在算术上抹掉其大部分效果,因此 sidecar 必须以并行 delta 形态常驻。领先量取整整一个 token 而非一层,这一选择也有明确的定价实验支撑。
核心方法
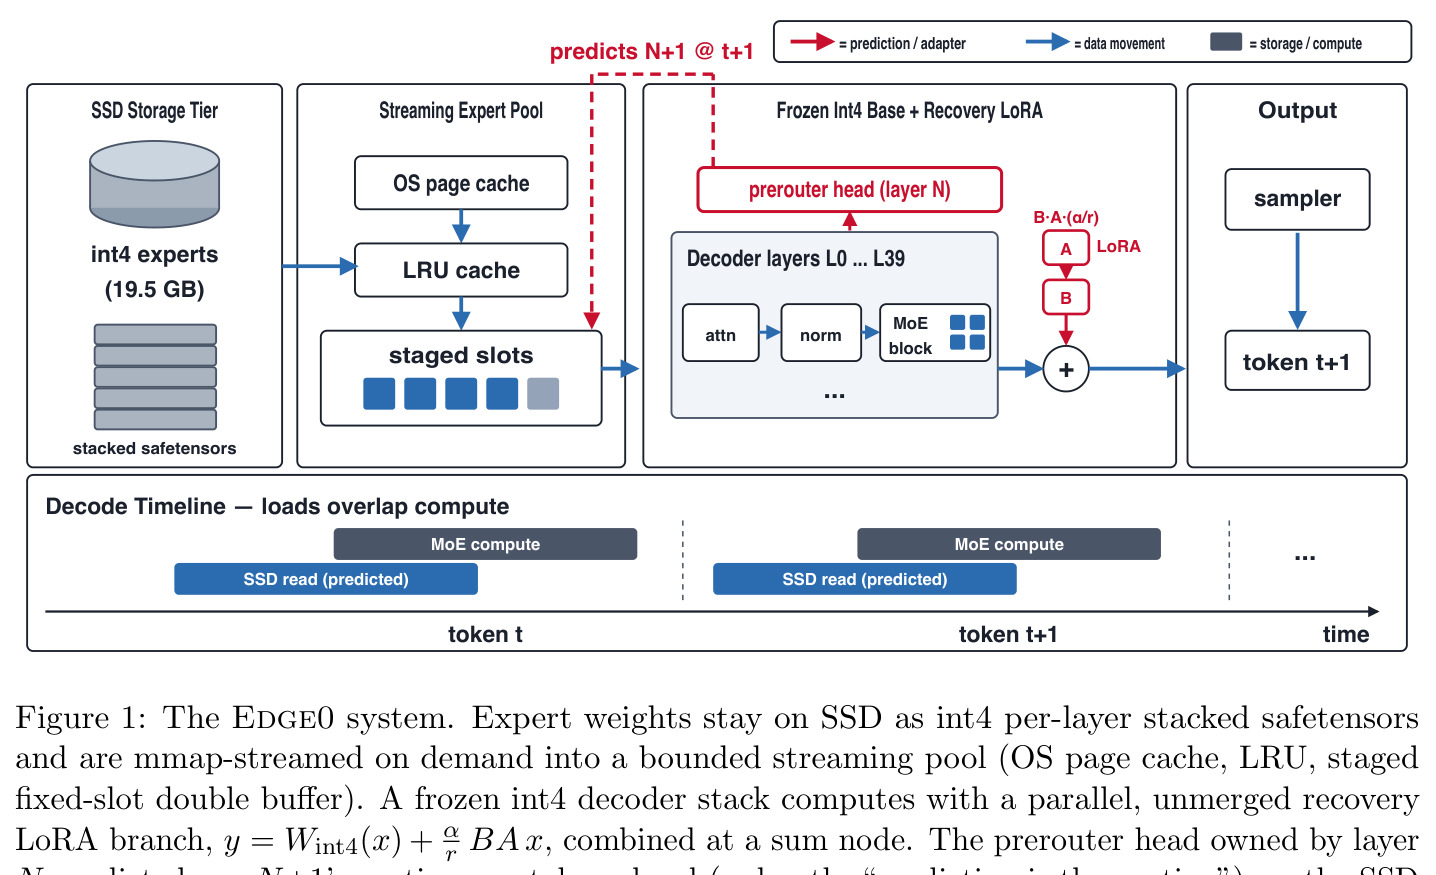
先给直觉:让“下一个解码步需要哪些专家”提前一个 token 被知道,SSD 读就能藏进当前步的计算里。技术路线分三块。(1) SSD 流式专家层:int4 专家按层堆叠为 safetensors 常驻磁盘(40 层 × 256 专家,共 18 GB),mmap 按需读入有界流式池(OS 页缓存 + LRU + staged 槽位双缓冲),四条 executor 路径共享数学契约 $\mathrm{down}(\mathrm{silu}(gate(x))\cdot up(x))$ 并对齐反量化参考。(2) prerouter:每层一个 $fc1 \to \text{erf-gelu} \to fc2$ 小头,输入 hidden state 与两个 top-k one-hot,领先一个 token 预测下一层路由,预测即路由。(3) 未合并 recovery LoRA:$y = W_{4bit}(x) + \frac{\alpha}{r}BAx$ 并行分支补偿 int4 与路由替换的质量损失。训练三阶段:蒸馏 head → student path SFT → on-policy 反 KL 蒸馏,基座全程冻结。
核心创新是“预测即路由”(prediction is the routing):prerouter 的预测不再是可以被放弃的预取提示,而是解码时实际生效的路由,因此 staged 槽位与实际路由集合恒等,构造上消除了 pre-gating 系统的 coverage-quality 权衡,近似代价由训练阶段一次性支付。与 Pre-gated MoE 的同 token 预选不同,Edge0 采用整整一个 token 的领先:同 token 变体需要逐层同步与 head 评估,每步 30–100 ms,作者测的每一次都低于朴素 LRU 基线;跨 token 领先把 head 评估移出每层关键路径,每步一次 flush 同时预测 32 个 staged 层。再加上“不合并 LoRA”的算术论证(LoRA delta 的 RMS $10^{-3}$ 低于 4-bit group step,合并再量化只保留 34%/2% 权重级效果、18% logits 级效果),三者构成闭环:预测解决读什么何时读,训练解决预测错了怎么办,未合并 sidecar 解决 4-bit 下质量账怎么付。
方法步骤详情
第一步,SSD 流式层:256 个 int4 专家按层堆叠成 safetensors,mmap 后按需读字节范围;执行器四条路径——exact(正确性基线)、staged(槽位双缓冲 + 增量 sticky-slot 栈,解码主力,只重写变化的专家)、hot(LRU 常驻热门专家)、whole-layer(预填充整层直读);测试保证各路径相对 L2 < 1%(残差约 0.24%)。第二步,训 prerouter:第 $N$ 层的 head 在 token $t$ 用该层 post-attention norm 输出预测第 $N{+}1$ 层在 token $t{+}1$ 的路由;输入维度 $d_{model} + 2E = 2048 + 2\times 256 = 2560$,隐宽 512,fp16;线性残差从下一层 router 权重热启动;35B 有 33 个 head,消费于第 7–38 层。第三步,三阶段训练:Phase 1 蒸馏 head 模仿下一层真实 router;Phase 2 在 student path 上对 LoRA(只挂 attention/线性注意力/shared expert)做 SFT,约 200 万行教师文本;Phase 3 on-policy 反 KL 蒸馏,约 20 万行收敛。第四步,解码:预填充走 whole-layer,解码逐 token 先一次 flush 预测所有 staged 层,再按预测填充槽位并与前向计算重叠。
技术新颖性
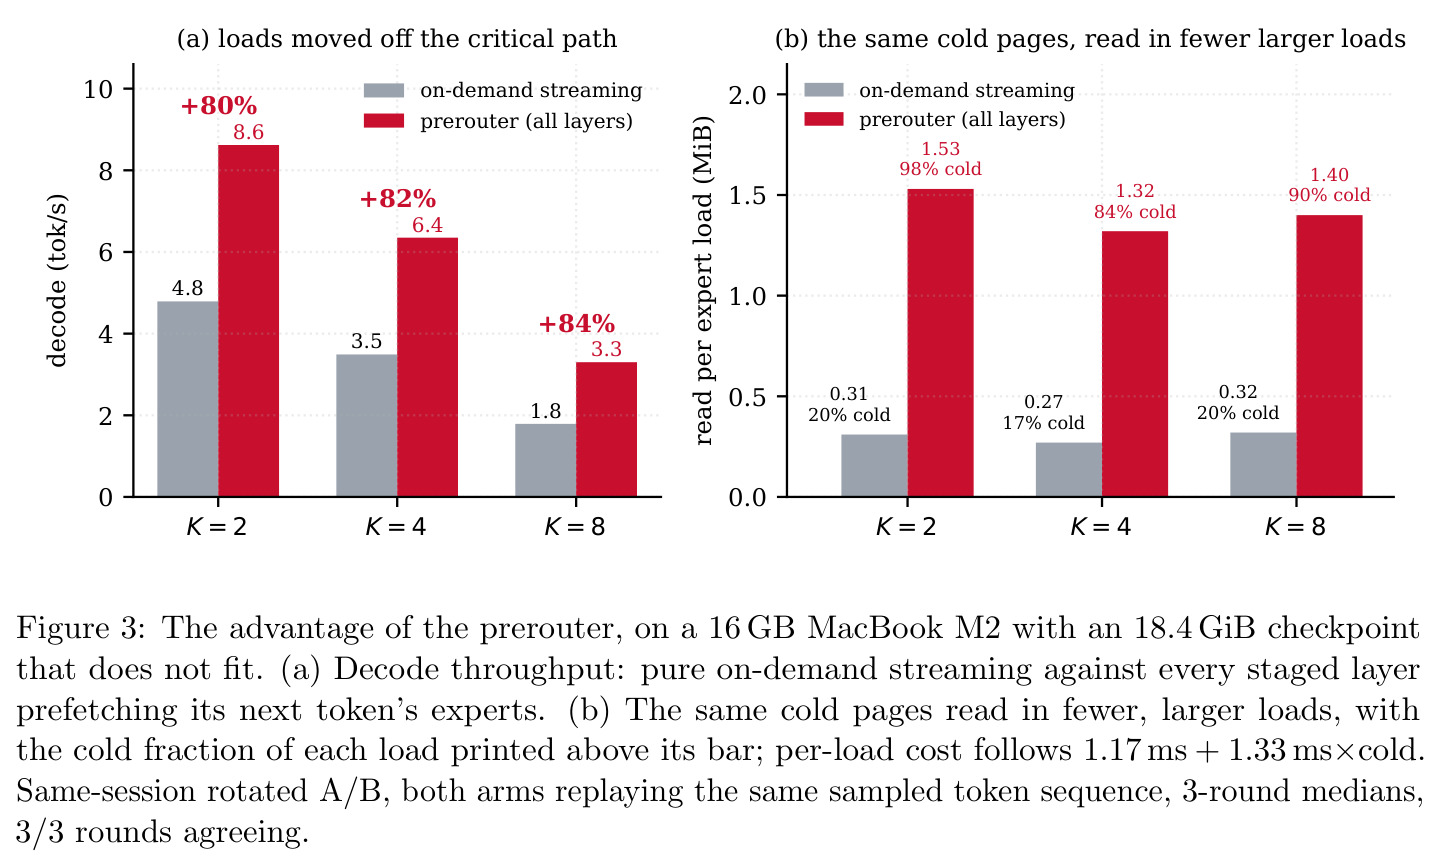
新颖性在于三件事的联动而非单点技巧。其一,把近似从推理时挪到训练时:以往预取/预门控系统在运行时为预测错误兜底(fallback 读、丢专家、质量退化),Edge0 用“预测即路由”把代价变成训练期一次性支出,推理路径零兜底,这是与 Pre-gated MoE、MoE-Infinity 等的本质区别。其二,跨 token 领先不是直觉选择而是定价实验的结论:同 token 方案每步 30–100 ms 的同步开销超过它能隐藏的加载时间,而一个 token 的领先恰好覆盖一个解码步的磁盘流量(K=4 时每层专家约 7 MB)。其三,未合并 LoRA 给出算术级论证与实测(attention 投影保留 34%、dense 投影 2%、logits 级 18%),澄清了 QLoRA 式“4-bit 基座 + adapter”在伺服阶段的正确形态。此外,冻结 int4 基座 + 文件化 sidecar 使 K 从 8 收窄到 4 只是换两个文件,却在 16 GB 机器上把解码从 3.3 提到 6.4 tok/s,让速度与内存第一次被同一个旋钮同时移动。
实验结果
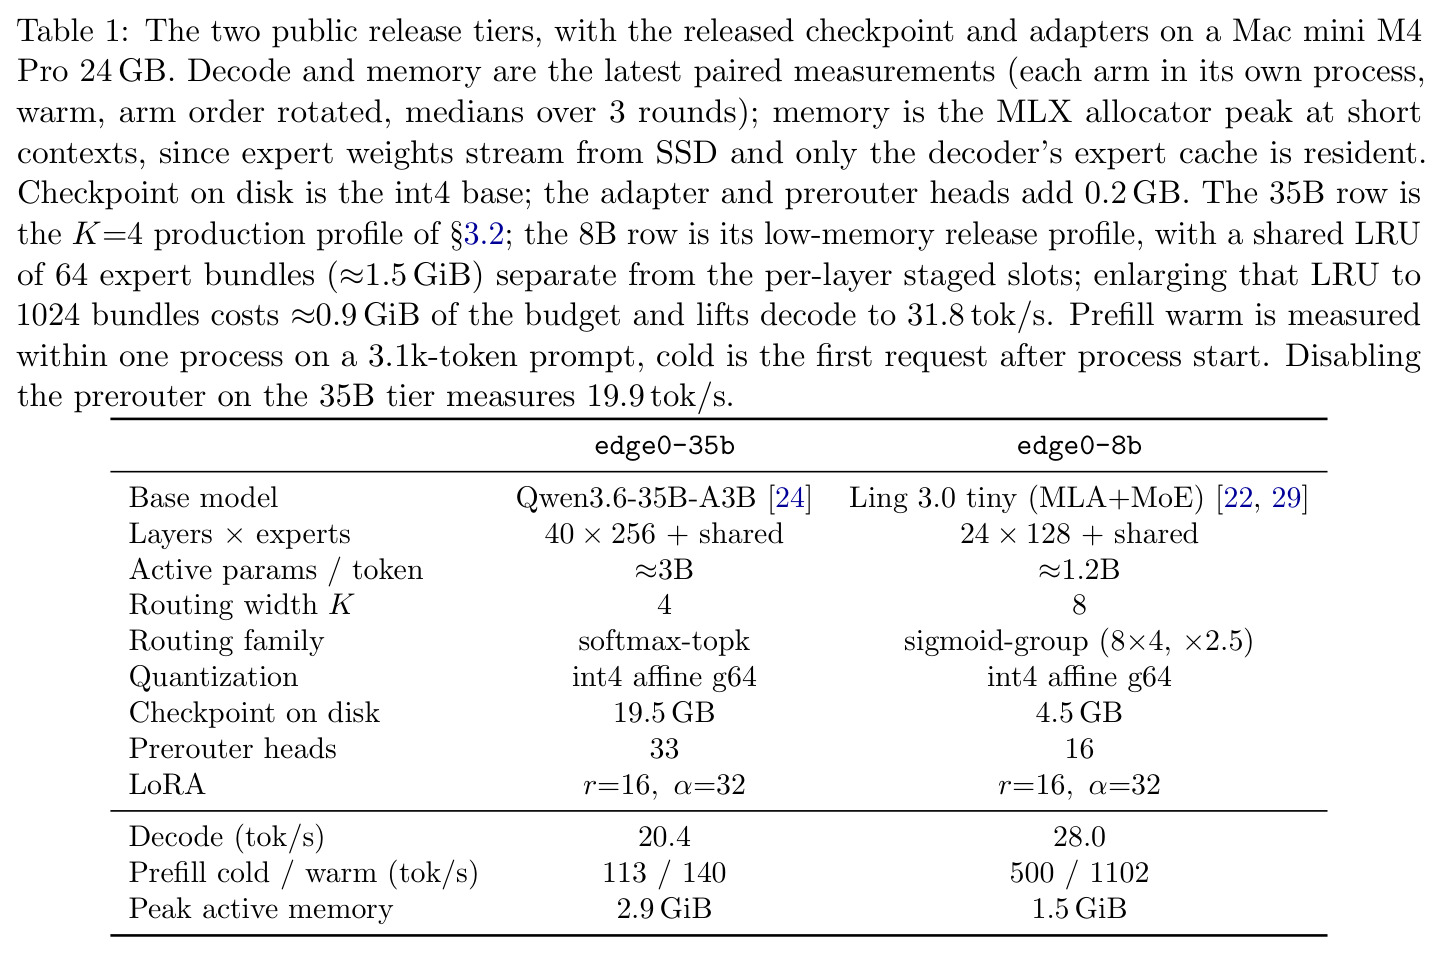
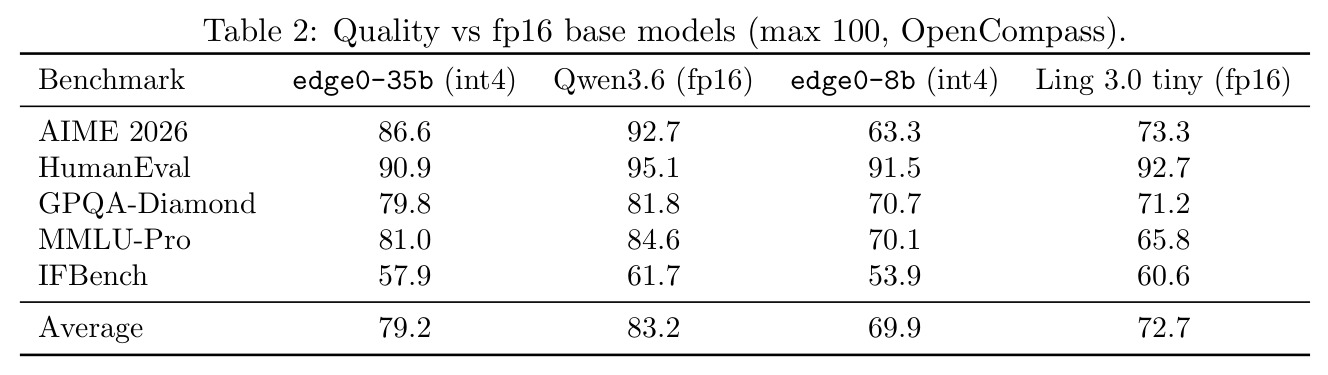
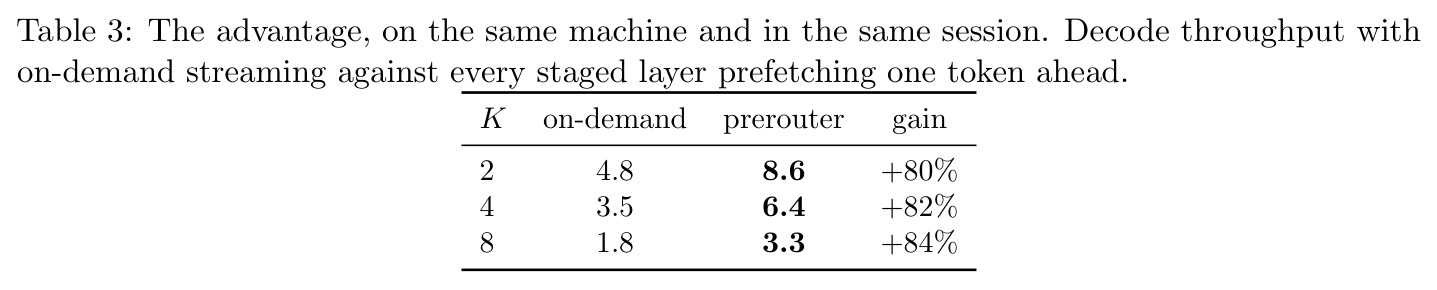
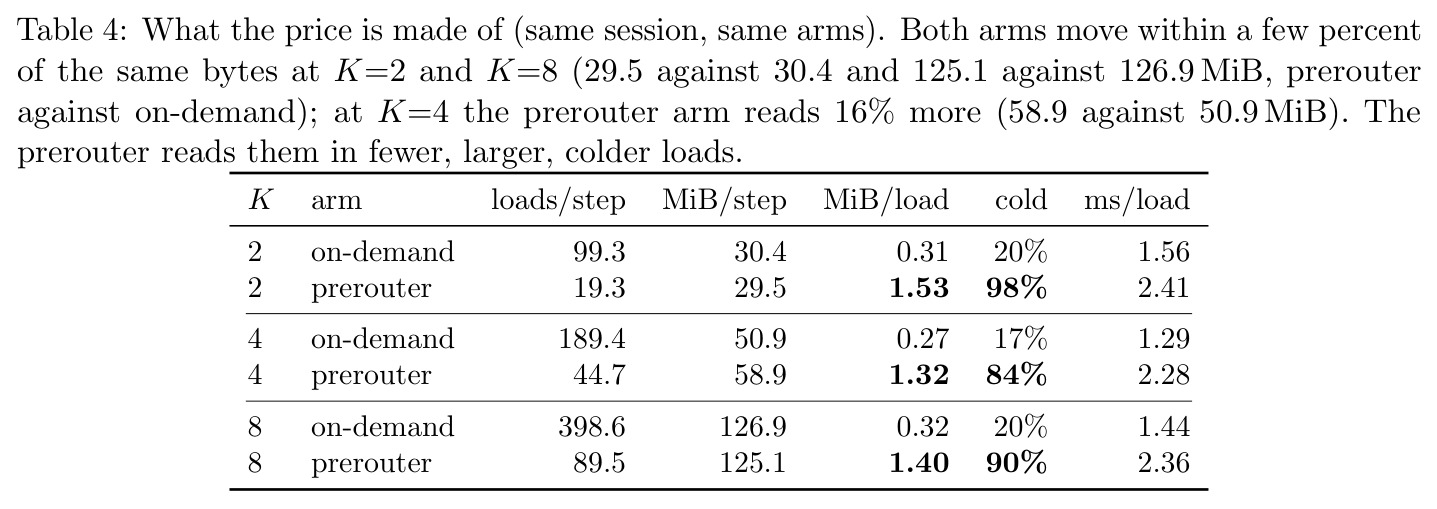
质量(Table 2,OpenCompass):35B tier 平均 79.2 对 fp16 基座 83.2(差 3.9 分),8B tier 69.9 对 72.7(差 2.8 分);35B 逐项 AIME 86.6 vs 92.7、MMLU-Pro 81.0 vs 84.6,8B 在 MMLU-Pro 反超 4.3 分(70.1 vs 65.8)。速度与内存(Table 1,Mac mini M4 Pro 24GB):35B K=4 解码 20.4 tok/s、峰值活跃内存 2.9 GiB(checkpoint 19.5 GB),全驻留 mlx-lm 仅 3.9 tok/s 且占 18.2 GiB;8B 解码 28.0 tok/s、1.5 GiB。Prerouter 消融(Table 3,16 GB M2 上 18.4 GiB 装不下):K=2/4/8 解码 4.8→8.6、3.5→6.4、1.8→3.3 tok/s(+80/82/84%),主线程阻塞在专家加载的时间从 244.0 降到 101.9 ms(K=4)。机制分析(Table 4):两臂每步读的字节几乎相同(K=8 为 125.1 vs 126.9 MiB),收益来自把冷读移出关键路径而非少读;per-load 成本拟合为 $1.17 + 1.33 \times \text{cold}$ ms;相邻 token 仅约 1/4 的层内专家集一致,收益上限由复用率决定。
局限与改进
作者承认的局限:单请求 FIFO 串行,并发与批处理未建模;解码瓶颈在 CPU 侧图构建(40 层前向约 44 ms/步是地板,存储侧优化无法移动);prerouter 收益随热缓存/快存储缩小,且受复用率限制(相邻 token 仅约 1/4 专家集一致,预取专家常只读一次、驻留却要付两次);质量损失集中在长链推理(AIME 35B 差 6.1 分、8B 差 10.0 分);仅 MLX 一个后端,CUDA 只是架构预留。我自己的观察:所有吞吐数据均来自 Apple Silicon 统一内存 + 页缓存环境,x86/独立显存或不同 NVMe 的行为未必可迁移;prerouter 使不可回收 MLX 分配从 1.72–1.79 GiB 涨到 2.33–3.22 GiB(K=2/4/8),K=8 时挤掉 1.15 GiB 页缓存,对多任务桌面是隐性成本;K=4 时预取臂多读 16% 字节;基座是 2026 年模型,AIME 绝对分数的普适性存疑;论文也缺少多机、网络存储与不同磁盘介质上的评估。
独立分析的弱点
弱点一,复用率封顶收益:相邻 token 仅约 1/4 的层内专家集一致,预取命中率天然受限,K=4 时还多读 16% 字节——改进方向是训练短程多 token 路由预测器、引入专家热度先验、或对未被消费的预取页做 drop-behind。弱点二,驻留不可回收:预测专家须在被需要前常驻,而 MLX 驻留内存不可回收,K=8 时比 on-demand 多占 1.43 GiB 并挤掉 1.15 GiB 页缓存——可探索 madvise 级“可回收预取”提示、统一 MLX 分配器与 OS 页缓存账本。弱点三,CPU 侧地板:44 ms/步的图构建与同步 fill(K=8 时 62.5 ms/步在主线程)不是存储问题——需要 kernel 级图摊销、fill 线程化,以及作者自列的去掉重复拷贝(回收约 0.45 GiB)。弱点四,单请求 FIFO 无法服务多用户,批处理会改变专家 working set——需要伺服层请求调度与共享槽位设计。弱点五,长链推理缺口(AIME -6.1/-10.0)暗示 student path 对误差累积敏感——可在蒸馏中给推理链加权或对 head 做温度校准。
未来方向
作者点名的两根近杠杆:去掉 stager 中 bundle 与 stacked 视图的重复拷贝(K=8 回收约 0.45 GiB)、把增量 fill 移出主线程(K=8 每步省 62.5 ms),两者都可能直接抬升收益且不必改训练。基于成果的延伸方向:其一,把 prerouter 与投机解码结合,一步的路由领先天然契合多 token 草稿-验证框架;其二,训练真正的多步路由预测器,把领先量从 1 个 token 拉到 2–3 个,正面攻复用率瓶颈,甚至利用路由分布的熵做置信度感知的预取深度;其三,实现 CUDA 后端填补架构预留,验证统一内存假设之外(x86 + NVMe + 独立显存)的可迁移性;其四,并发伺服层:按请求共享 staged 槽位、为批处理建立专家 working set 模型;其五,针对 AIME 类长链推理做定向蒸馏(链式数据增强、router 一致性正则);其六,把“预测即路由 + 未合并 LoRA”范式推广到 dense 模型的层间权重预取或多模态编码器的按需加载。
复现评估
复现条件相当友好。推理端:框架(github.com/Edge0-AI/Edge0)、两个 tier 的 checkpoint 与 adapter(HuggingFace 的 Edge0-35B-A3B-preview 与 Edge0-8B-A1B-preview)全部 Apache-2.0 开源,硬件只需一台 Apple Silicon(实测 Mac mini M4 Pro 24GB 与 MacBook M2 16GB)加 SSD,发布目录共 18.4 GiB。质量端:OpenCompass 在普通服务器上跑,无时序要求。训练端门槛较高:需要 fp16 教师基座、约 200 万行 SFT 文本与约 20 万行蒸馏数据,三阶段顺序敏感(heads→SFT→on-policy 蒸馏,顺序不可换),Phase 3 还需学生在 served path 上自生成再由教师打分;但冻结基座使换路由宽度(K=8→K=4)只是换两个 adapter 文件。测量协议扎实(same-session 轮换 A/B、双臂重放同一 token 序列、3 轮中位数),附录给出路由数学与 oracle 实验。综合:推理端复现容易,训练端中等偏难。
论文图表