用于增强图像分类与旋转目标检测的四元数近似网络 Quaternion Approximate Networks for Enhanced Image Classification and Oriented Object Detection
用实数运算近似四元数卷积,以极少量参数实现旋转感知的分类与旋转框检测
前置知识
四元数与 Hamilton 乘积
四元数是复数的四维推广,写作 $q = q_r + q_i i + q_j j + q_k k$,其中虚数单位满足 $i^2 = j^2 = k^2 = ijk = -1$。两个四元数的 Hamilton 乘积 $p \otimes q$ 共展开为 16 个实数乘法项,其结构天然编码了三维旋转,可避免欧拉角的万向节锁问题,且比 $3\times3$ 旋转矩阵更紧凑。
本文的核心是把四元数卷积的 Hamilton 乘积拆解为实数运算来近似,只有理解 Hamilton 乘积的符号结构,才能看懂论文中式 (7) 的可分离分解和混合矩阵 $M$ 的推导。
旋转等变性
指网络对输入旋转的响应具有可预测性:若输入图像旋转某个角度,特征表示也以确定的方式相应变换,而不是完全混乱。传统 CNN 使用轴对齐卷积核,不具备这一性质,因此对物体朝向的变化泛化差。群等变 CNN、可操纵 CNN 等通过群论构造等变性,但需要全新的架构设计。
QUAN 的卖点正是在不重构整个网络的前提下获得近似旋转等变性——论文声称四元数结构保留了旋转信息,这直接关系到机器人抓取这类依赖朝向的任务性能。
RGB 到四元数的 Poincaré 映射
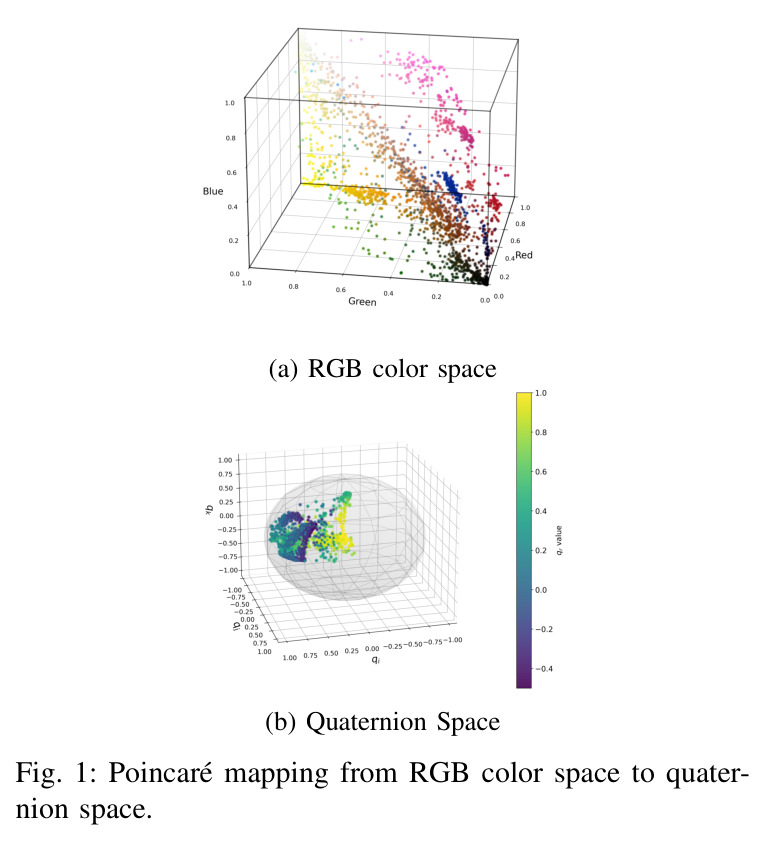
把 RGB 三通道颜色嵌入单位四元数球的映射:先计算范数 $\mathrm{norm} = \sqrt{r^2+g^2+b^2}$,再令 $q_r = \frac{1-\mathrm{norm}^2}{1+\mathrm{norm}^2}$,$q_i = \frac{2r}{1+\mathrm{norm}^2}$,$q_j$、$q_k$ 类似。这是双曲空间的 Poincaré 球模型,越靠近边界点间距离指数增长,能更好保留颜色的层级关系。
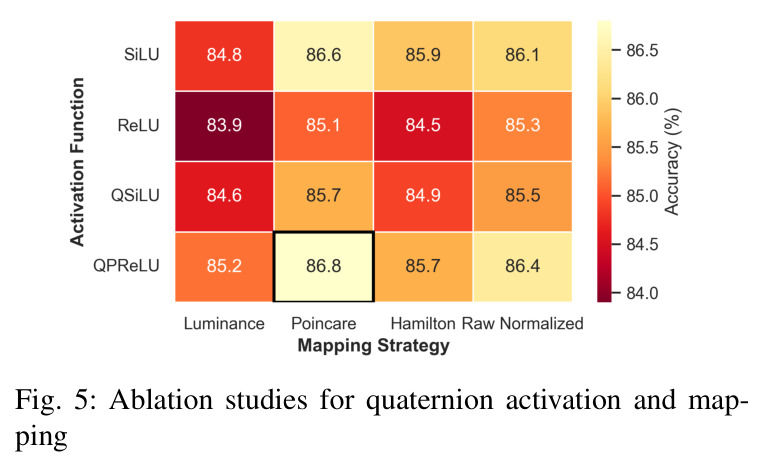
四元数网络必须先把 RGB 输入变成四元数形式,论文的消融实验(Fig. 5)证明映射策略对精度影响显著,Poincaré 映射优于亮度映射、均值亮度映射、原始归一化和 Hamilton 映射等备选方案。
旋转目标检测(OBB)与 YOLO 架构
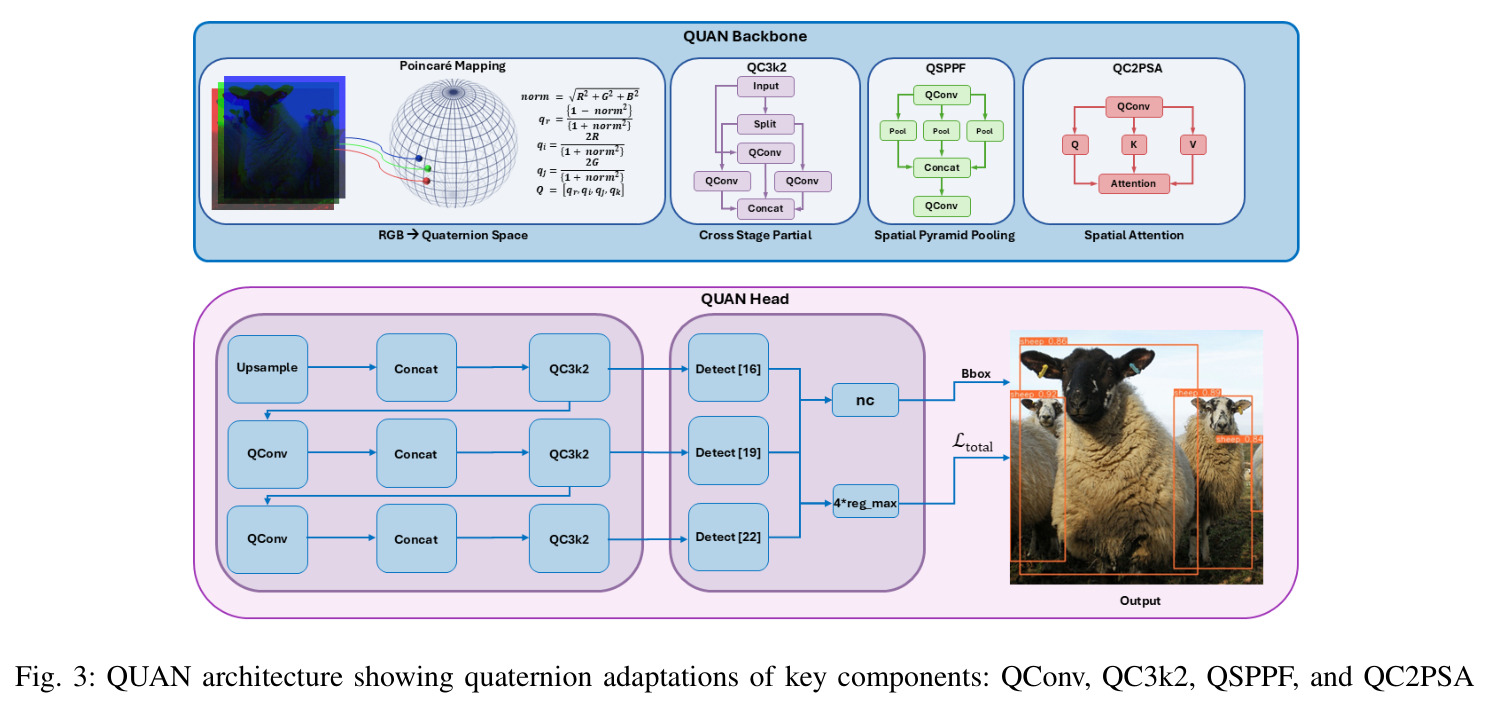
传统检测器输出轴对齐矩形框,会把旋转物体的朝向信息丢掉;OBB 检测输出带角度的旋转框。YOLOv11 的关键模块包括 C3k2(多尺度特征与梯度流)、SPPF(空间金字塔池化)和 C2PSA(空间注意力),本文将这三者全部改造成四元数版本 QC3k2、QSPPF、QC2PSA。
本文的检测实验是在 YOLOv11n 上做系统性四元数改造,理解这些模块的作用才能明白 QC3k2/QSPPF/QC2PSA 分别替换了什么、等变结构如何嵌入现有检测流水线。
研究动机
视觉机器人装配与抓取任务要求精确的物体检测、位姿估计和空间推理,而物体朝向是抓取规划的核心信息。主流检测器如 YOLO、Faster R-CNN、DETR 都输出轴对齐框,直接丢弃朝向信息。面向旋转检测的专用方法如 R3Det、Gliding Vertex 又依赖复杂架构和额外计算,难以在资源受限、要求实时性的机器人系统上部署。四元数代数虽然为三维旋转提供了无奇点的紧凑表示,Gaudet 与 Maida 的深度四元数网络、Parcollet 的四元数 RNN、Zhu 的四元数 CNN 也证明了参数效率,但纯四元数运算在主流深度学习框架里缺乏硬件支持——作者实测纯四元数操作延迟是实数操作的 3.8 倍;且四元数不存在有界非常量解析函数,激活函数设计和梯度计算都受限。这些工程障碍导致四元数网络长期停留在理论层面,此前从未有人把四元数方法成功用于实际旋转目标检测。
本文的目标是本文要构建一个既保留四元数旋转等变优势、又能在现有 GPU 框架上高效运行的深度学习框架 QUAN(Quaternion Approximate Networks)。具体目标包括四个层面:一是设计一种用实数张量运算近似四元数卷积的方法,保持几何性质的同时把计算复杂度从完整的 16 项 Hamilton 乘积降到 4 次卷积;二是解决训练稳定性问题,提出独立四元数批归一化 IQBN 替代严格的黎曼流形约束;三是把四元数操作系统性嵌入 YOLOv11 的关键模块(QC3k2、QSPPF、QC2PSA),实现端到端的旋转框检测,并设计融合四元数角度度量的检测损失;四是在分类(CIFAR-10/100、ImageNet)和检测(COCO、DOTA、自建机器人数据集)上验证参数效率与旋转感知能力,目标是资源受限机器人系统的实时旋转感知部署。
与已有工作不同的是,已有四元数网络路线都试图在四元数域内完成全部运算,需要专门的四元数反向传播、初始化方案和自定义算子,计算开销大且难以利用成熟硬件优化;另一条路线是群等变 CNN、可操纵 CNN、Harmonic Networks、Oriented Response Networks 等群论方法,它们通过离散群、连续群或滤波器主动旋转获得等变性,但都要求根本性的架构改动和专用实现,计算负担显著。QUAN 的独特切入是『近似而非严格遵守』:承认 Hamilton 乘积的完整交叉项在硬件上不划算,于是把四元数卷积分解为四个实数卷积加上符号混合,训练时也放松单位四元数约束 $\|q\|=1$(作者发现用 Geoopt 做黎曼优化反而降低性能)。这条『实用主义四元数』路线让四元数结构第一次以接近实数网络的代价跑通分类和检测全流程,并首次在旋转目标检测下游任务上为四元数 CNN 确立了 SOTA。
核心方法
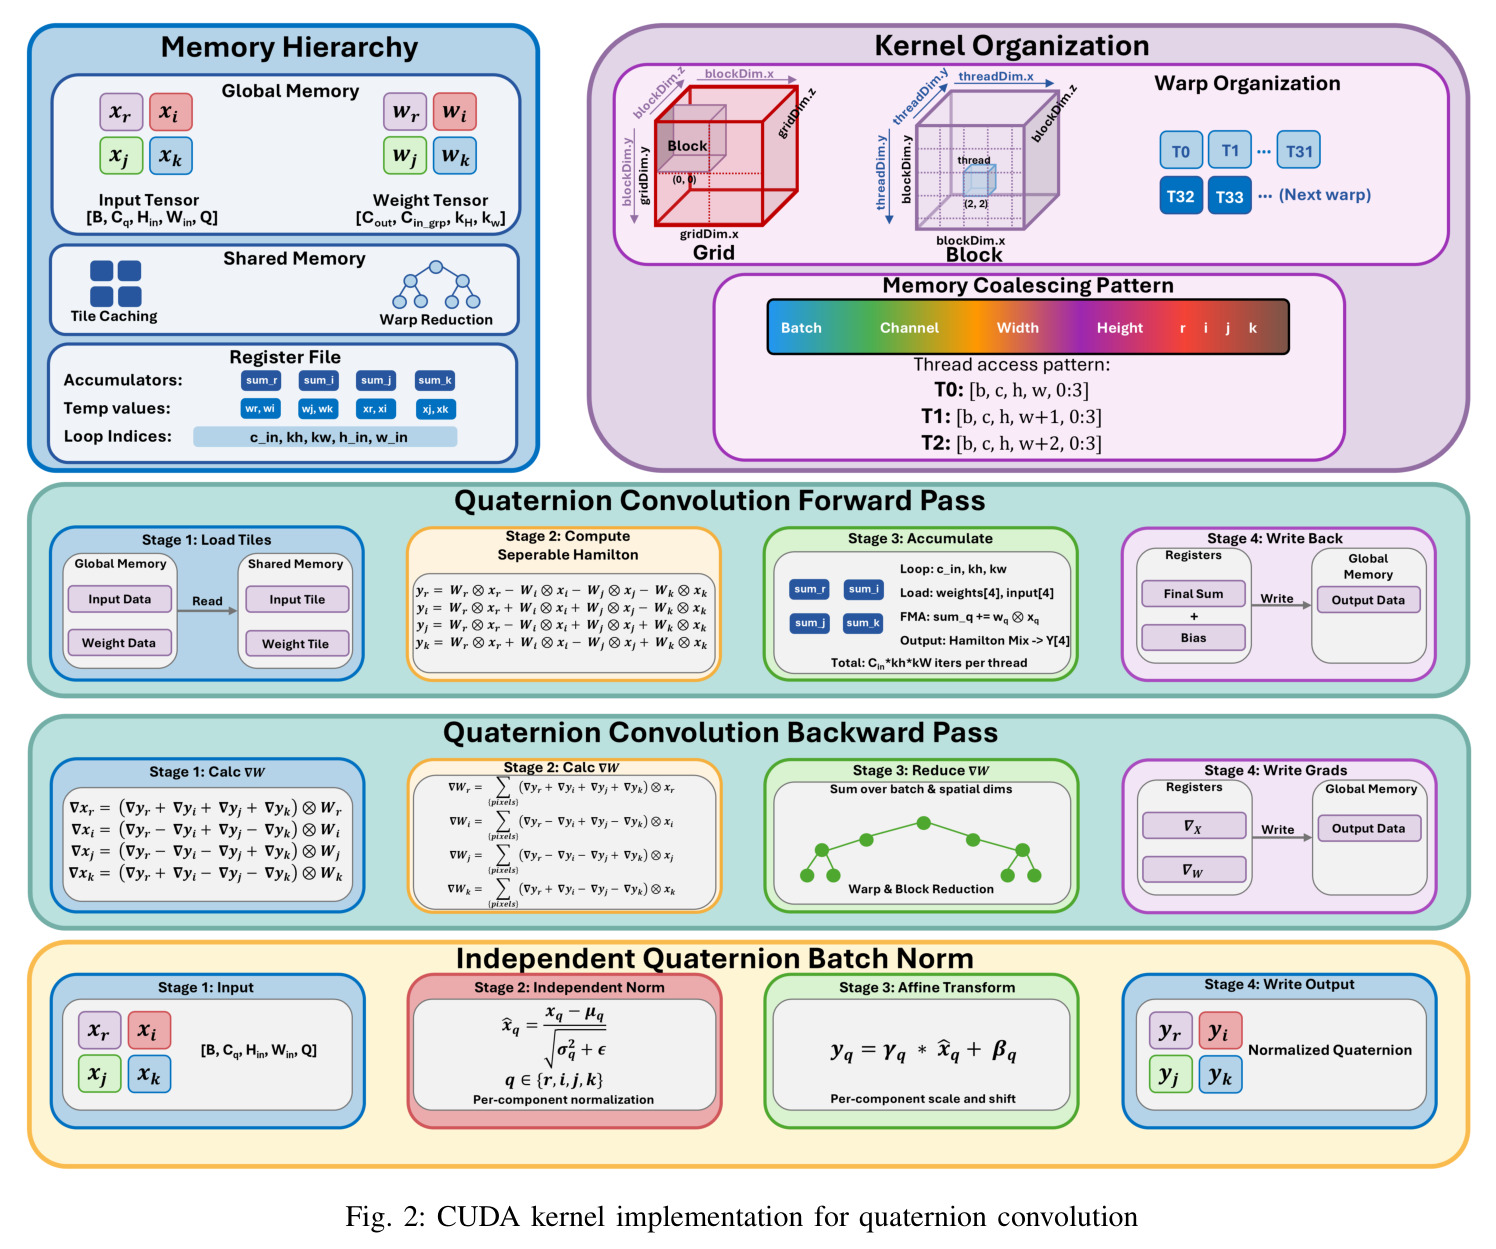
QUAN 的直觉是:四元数的价值在于其符号结构与旋转代数,不必在四元数域内做每个乘加。输入端用 Poincaré 映射把 RGB 嵌入单位四元数球($q_r = \frac{1-\mathrm{norm}^2}{1+\mathrm{norm}^2}$,虚部为 $\frac{2r,2g,2b}{1+\mathrm{norm}^2}$)。每层卷积把完整 Hamilton 乘积式 (5) 的 16 个交叉项做可分离近似:只保留 4 个分量卷积加符号混合,如 $y_r = W_r \otimes x_r - W_i \otimes x_i - W_j \otimes x_j - W_k \otimes x_k$,复杂度从 $O(16CHW)$ 降到 $O(4CHW)$。反向传播沿用同一结构,用混合矩阵 $M$ 累加梯度并融合进自定义 CUDA 核。训练稳定性由 IQBN 保证:四个分量各自独立批归一化,替代严格单位四元数约束。最后把算子移植进 YOLOv11 的 QC3k2、QSPPF、QC2PSA,配统一检测与朝向的四元数损失,得到 QUAN-YOLO11n。
核心创新是 Hamilton 乘积的可分离实数近似。纯四元数网络逐项计算 16 个交叉项,QUAN 只保留对四元数代数至关重要的符号模式(如 $W_r \otimes x_r$ 与 $-W_i \otimes x_i$ 的相对符号),牺牲 $W_i \otimes X_j$ 这类弱交叉项换取 4 倍计算缩减,且反向传播可由前向结构自洽推导,无需重造四元数反向传播。第二是 IQBN:传统四元数 BN 把四元数当整体归一化,IQBN 对 $x_q\ (q \in \{r,i,j,k\})$ 各分量独立计算 $\mu_q$、$\sigma_q^2$ 归一化后再统一缩放平移;作者发现用 Geoopt 黎曼优化严格维持 $\|q\|=1$ 反而降低性能,说明放松约束更利于优化。第三是把算子系统性移植进 YOLOv11:QC3k2 保持跨阶段部分连接、QSPPF 分量独立池化后 Hamilton 混合、QC2PSA 在注意力分支内保持四元数代数——四元数架构首次完整覆盖一个现代检测器的骨干与颈部。
方法步骤详情
第一步,输入映射:RGB 经 Poincaré 映射变为 $B \times C \times H \times W \times Q$($Q=4$)四元数张量,消融显示其优于亮度、均值亮度、原始归一化、Hamilton 四种备选。第二步,近似卷积:按式 (7) 计算 $y_r = W_r \otimes x_r - W_i \otimes x_i - W_j \otimes x_j - W_k \otimes x_k$ 等 4 个输出分量,均为实数张量切片;反向按式 (8)(10) 用混合矩阵 $M$ 的转置累加梯度,CUDA 核融合 Hamilton 混合以省显存带宽。第三步,IQBN:各分量独立做 $\hat{x}_q = \frac{x_q - \mu_q}{\sqrt{\sigma_q^2 + \epsilon}}$ 后统一缩放平移,训练中维护滑动统计。第四步,模块改造:QC3k2 用四元数瓶颈替换 C3k2,QSPPF 分量独立池化再混合,QC2PSA 拆分特征后仅一个分支做四元数空间注意力再重组。第五步,损失:$\mathcal{L}_{\mathrm{total}} = \mathcal{L}_{\mathrm{cls}} + \mathcal{L}_{\mathrm{CIoU}} + \lambda_1 \mathcal{L}_{\mathrm{angular}} + \lambda_2 \mathcal{L}_{\mathrm{reg}} + \lambda_3 \mathcal{L}_{\mathrm{smooth}}$,其中 $\mathcal{L}_{\mathrm{angular}} = 2\arccos(|\langle q_{\mathrm{pred}}, q_{\mathrm{target}} \rangle|)$ 处理双覆盖性,$\mathcal{L}_{\mathrm{reg}} = \|q\|^2 - 1$ 软性维持单位范数,$\mathcal{L}_{\mathrm{smooth}}$ 抑制角度抖动。
技术新颖性
本文的技术新颖性体现在三点。其一,『近似四元数』本身是对纯四元数网络(Deep QCNN、QCNN、QVGG 等)的直接反叛:后者坚持数学纯度,结果被 3.8 倍延迟拖垮;QUAN 证明只保留符号结构的松弛版本已足以捕获旋转特征,且反向传播可以复用前向的可分离结构自洽推导,无需重新设计四元数反向传播。其二,IQBN 与既有四元数归一化的差异明确:传统 QBN 平均比 IQBN 低 0.61% 的 CIFAR-10 精度,说明分量独立归一化在保留跨分量关系的同时给了优化更大自由度。其三,系统性的检测器改造是领域内首次——此前四元数网络只做过分类、去噪、音频、GAN 等任务,QUAN 的 QC3k2/QSPPF/QC2PSA 三件套加上统一四元数角度损失的检测头,第一次让四元数 CNN 在旋转目标检测上有了可比基准并确立了 SOTA。相比之下,群等变路线(G-CNN、Steerable CNN、Harmonic Networks、ORN)需要以群论重构整个网络,QUAN 把等变结构当作『插件』装进现成架构,这是工程哲学上的显著区别。
实验结果
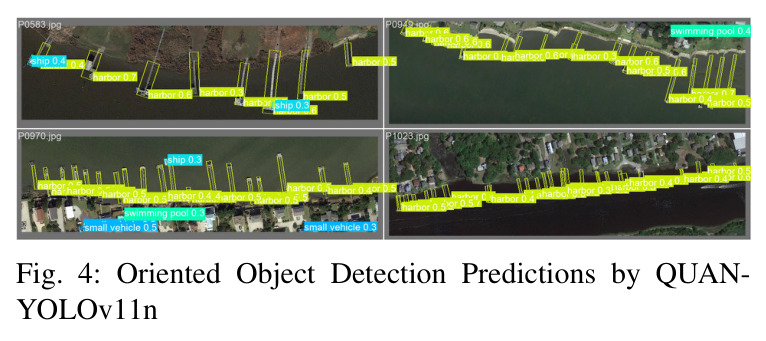
分类(Table I):QUAN-WRN 仅 717K 参数达 CIFAR-10 95.12%、CIFAR-100 76.83%,参数比 WRN-16-4(2.75M)少 74% 且精度更高(94.76%/76.09%),也超 Deep QCNN(932.8K,94.56%/73.99%);ImageNet 100 类子集上以 5.39M 参数对 ResNet34 的 21.8M 取得 74.28% 对 73.74%,训练时间平均只增 6.8%。轴对齐检测(Table II):COCO 上 QUAN(1.187M)mAP50-95 0.339 落后 YOLO11n 的 0.3908;机器人数据集上 QUAN(0.67M)以 25.3% 参数反超(0.955 对 0.951),推理多 36% 时间。旋转框检测(Table III):机器人数据集上 QUAN 以 0.69M 参数达 mAP50-95 76.4%,大幅超过 YOLO11n-obb 的 68.5%,推理快 3.7%;DOTA 上略降(60.8 对 61.4)。消融:Poincaré 映射最优,SiLU 优于 ReLU/QPReLU,传统 QBN 比 IQBN 平均低 0.61%。规律:小数据强旋转场景占优,大规模数据上容量不足导致泛化受损。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像分类 CIFAR-10 | Top-1 准确率 / 参数量 | QUAN-WRN 95.12% / 717K | WRN-16-4 94.76% / 2.75M;Deep QCNN 94.56% / 932.8K | 参数减少 74%,准确率提升 0.36-0.56 个百分点 |
| 图像分类 CIFAR-100 | Top-1 准确率 | 76.83% | WRN-16-4 76.09%,Deep QCNN 73.99% | 提升 0.74-2.84 个百分点且参数最少 |
| 图像分类 ImageNet 100 类子集 | Top-1 准确率 / 参数量 | 74.28% / 5.39M | ResNet34 73.74% / 21.8M | 参数减少 75%,准确率提升 0.54 个百分点 |
| 轴对齐检测 COCO2017 | mAP50-95 / 参数量 / 延迟 | QUAN-YOLO11n 0.339 / 1.187M / 1.68ms | YOLO11n 0.3908 / 2.65M / 1.5ms | 参数减少 55%,但 mAP50-95 下降 0.052、延迟增加 12% |
| 轴对齐检测 机器人数据集 | mAP50-95 / 参数量 | QUAN-YOLO11n 0.955 / 0.67M | YOLO11n 0.951 / 2.61M | 参数仅 25.3% 且 mAP50-95 反超 0.004,延迟增加 36% |
| 旋转框检测 DOTA-v1.0 | mAP50-95 / 参数量 | QUAN-YOLO11n 60.8 / 1.24M | YOLO11n-obb 61.4 / 2.66M | 参数减少 53%,mAP50-95 略降 0.6 |
| 旋转框检测 机器人数据集 | mAP50-95 / 参数量 / 延迟 | QUAN-YOLO11n 76.4 / 0.69M / 3.44ms | YOLO11n-obb 68.5 / 2.66M / 3.57ms | mAP50-95 大幅提升 7.9 个百分点,参数减少 74%,推理还快 3.7% |
局限与改进
作者承认三点局限:一是近似增加算术量,推理时间略升(COCO 上多 12%,机器人轴对齐检测多 36%),CUDA 核只能部分缓解;二是 Poincaré 映射虽在消融中最优,但未必对所有下游任务最优;三是算力限制导致无法用与原版模型相同的 batch size 和超参数训练,对比公平性打折。我的补充观察:COCO 和 DOTA 上一致的性能下降被归因于模型容量小,但这与『参数少 74% 还要精度持平』的叙事有张力,分类优势未在大规模检测上复现;IQBN 与 QBN 的对比仅在 CIFAR-10 上报告平均 0.61% 差距,无多种子方差;机器人数据集仅 1900 张俯视盒子图,7.9 个百分点的 OBB 优势可能部分来自任务旋转先验强;且该提升没有配套的角度误差分析,无法确认收益确实来自旋转建模而非数据集偏差。
独立分析的弱点
第一,近似的信息损失缺乏理论刻画:丢弃全部交叉项后旋转等变性何时被破坏没有量化。改进方向是对可分离分解做等变误差上界分析,或系统搜索不同的 Hamilton 矩阵找保等变性最强的稀疏模式。第二,大规模数据泛化崩塌:COCO 上 mAP50-95 从 0.3908 掉到 0.339,归因于模型太小,但更可能是 IQBN 在丰富语义特征上过度正则化。改进方向:做 QUAN-YOLO11s/m 的 scaling 实验,并消融 IQBN 与分量绑定归一化在大数据上的差异。第三,评估覆盖不足:机器人数据集仅 1900 张、单一盒子类别、俯视视角,DOTA 无逐类 AP,7.9 个百分点的提升缺角度误差指标佐证『旋转感知』卖点。改进方向:报告预测四元数与真值的平均 $\arccos$ 角度误差,在多类别真实抓取数据上复测。第四,部分配置下延迟不降反升,与『适合资源受限机器人』的定位矛盾,需更激进算子融合或 INT8 量化来兑现实时承诺。
未来方向
作者在结论中列出四个方向:一是用四元数表示做自监督学习,让旋转结构在无标签数据上预训练;二是对独特的 Hamilton 矩阵做系统优化搜索,为特定任务找到最优的符号混合结构(这直接回应了近似损失未知的理论缺口);三是把 LoRA 改造成四元数形式做参数高效微调,天然契合本文的省参数叙事;四是部署到真实机器人装配现场验证精确空间理解的价值。基于本文成果还可延伸:把 QC2PSA 的四元数注意力推广到 ViT 的自注意力,检验等变结构在 Transformer 上的收益;将 Poincaré 映射换成可学习的映射层并联合端到端训练,解决『映射未必最优』的问题;把 $\mathcal{L}_{\mathrm{smooth}}$ 的相邻帧一致性思想用于视频流上的时序位姿估计,抑制抓取抖动;以及在 6DoF 位姿估计(如 BOP 基准)上对标 QuatNet、PVN3D,把两阶段检测+位姿管线真正统一到四元数空间,这是论文相关工作中点名但未实现的目标。
复现评估
复现条件较好:代码开源(https://cwru-aism.github.io/QUANpaper/),自建机器人数据集发布在 Roboflow(1900 张俯视盒子图),CIFAR-10/100、ImageNet 子集、COCO2017、DOTA-v1.0 均公开。训练全在单张 RTX 4090 完成:分类用 AdamW + 余弦退火,batch size 256、初始学习率 0.1、300 epoch,增强为随机裁剪、水平翻转、AutoAugment;检测用 SGD、batch size 32、自动学习率调度、100 epoch,增强为 mosaic 和仿射变换。风险点:自定义 CUDA 核的编译兼容可能是门槛,但可分离结构意味着可直接用 PyTorch 张量切片复现(只是变慢);论文承认未能用与基线相同的 batch size 和超参,严格对齐时数字可能有出入;Table I 中部分基线(Shallow QCNN、QResNet34)只有文献值而非复现值。总体难度中等:有 GPU 的研究生按开源代码一周内可复现分类主线,检测部分需 YOLOv11 经验。
论文图表
分类主结果表:QUAN 以 717K 参数取得 CIFAR-10 95.12%、CIFAR-100 76.83%,全面超过 WRN-16-4(2.75M 参数,94.76%/76.09%)、Deep QCNN(932.8K,94.56%/73.99%)、QVGG11(3.8M,85.15%)等;ImageNet 子集上 5.39M 参数达 74.28%,超 ResNet34 的 73.74%(21.8M 参数)。
核心卖点『参数减 74-75% 且精度更高』的直接证据,同时列出了所有四元数基线的可比数字,确立四元数网络的分类 SOTA。
轴对齐检测结果:COCO2017 上 QUAN-YOLO11n(1.187M 参数)mAP50 0.478、mAP50-95 0.339、1.68ms,落后 YOLO11n(2.65M,0.547/0.3908/1.5ms);机器人数据集上 QUAN(0.67M)mAP50-95 0.955 反超 YOLO11n(2.61M)的 0.951。
诚实呈现 QUAN 的短板(大规模数据泛化受损)与长处(小数据+省参数),是理解『模型容量 vs 结构先验』权衡的关键表格。
旋转框检测结果:机器人数据集上 QUAN-YOLO11n 以 0.69M 参数取得 mAP50 92.4、mAP50-95 76.4、3.44ms,大幅超过 YOLO11n-obb(2.66M 参数)的 93.3/68.5/3.57ms;DOTA-v1.0 上 QUAN 60.8 略低于基线 61.4。
全文最强的实验证据:在旋转最关键的场景中 mAP50-95 提升 7.9 个百分点且推理更快,直接验证了四元数旋转先验在 OBB 任务上的价值,也是四元数 CNN 首次在检测下游任务确立 SOTA。