MACaQ:面向低精度权重与激活的快速、模型无关校准量化 MACaQ: Fast, Model Agnostic Calibrated Quantization for Low-Precision Weights and Activations
逐层独立的MXFP4 W4A4后训练量化:在线变换+Hessian翻转精修,量化快11倍且精度更优
前置知识
后训练量化(PTQ)
不重新训练模型,仅用少量校准数据统计激活分布后,把FP16/BF16权重与激活映射到低位宽(如4比特)表示的量化范式。相比量化感知训练(QAT)省去完整训练成本,但核心挑战是在极低位宽下控制层的输出重建误差,通常以逐层最小化 $\|XW^\top - X\hat{W}^\top\|_F^2$ 为目标。
MACaQ是一个纯PTQ方法,理解它与GPTQ、QuaRot、DuQuant++等对比对象的定位差异,必须先掌握PTQ的基本设定与校准流程。
MXFP4微缩浮点格式
OCP标准的4比特浮点格式:张量按每 $B=32$ 个元素分块,每块共享一个8位纯指数的E8M0缩放因子(2的幂),块内每个元素用4位E2M1码(1符号+2指数+1尾数)表示。FP4格点非均匀,靠近0处分辨率高。每元素约4.25比特。
这是本文全部实验的量化格式;块共享的2的幂指数正是Hessian加权指数筛选与Flip-Refinement算法设计的直接动因。
Hessian重建误差目标与GPTQ
层级量化把目标写成 $\min_{\hat{W}} \sum_i r_i H r_i^\top$,其中 $H = X^\top X$ 是校准激活的二阶统计量(输入Hessian),其对角元衡量各输入通道误差的重要性。GPTQ利用 $H$ 的分解按固定列序逐列量化,并用未量化权重补偿已产生的误差。
MACaQ的块指数筛选(式12)与翻转增益公式(式15)都建立在这个Hessian目标上;理解它与GPTQ的区别才能读懂Flip-Refinement。
基变换量化:Hadamard旋转与逐通道缩放
用正交矩阵 $M_{rot}$ 旋转权重与激活,$xW^\top = (xM_{rot})(WM_{rot}^\top)^\top$ 乘积不变,Hadamard变换元素为±1、可用 $O(N\log N)$ 快速实现,能把离群通道能量摊成近似高斯分布;再配合对角缩放 $M_{diag}$(SmoothQuant思想)在激活与权重间分摊量化难度。
MACaQ在线执行的两个轻量变换(逐通道缩放+块大小32的Hadamard旋转)正是这两类方法的组合,是全文方法部分的骨架。
跨层变换吸收
为消除在线变换的运行时开销,QuaRot、DuQuant等把激活侧变换 $P$ 数学上沿网络前向传播,吸收进前一层RMSNorm参数、投影矩阵或残差分支,使推理时无需显式变换;代价是引入层间依赖——量化或修改一个线性层必须同时改动其相邻算子。
这是MACaQ明确批评并绕开的现状做法;理解吸收机制的跨层耦合,才能体会本文'层局部性'这一核心卖点的价值。
vLLM推理与memory-bound解码
vLLM是主流LLM服务框架,支持CUDA graph与连续批处理。解码(decode)阶段每步只生成一个token,受显存带宽限制(memory-bound),把权重压到4比特可让吞吐提升接近带宽压缩比;prefill与大批量时则转为算力受限(compute-bound),加速比回落。
论文的2.3%端到端开销与3.06×加速都在vLLM中测量,需要decode/prefill、batch size等概念才能正确解读速度实验。
研究动机
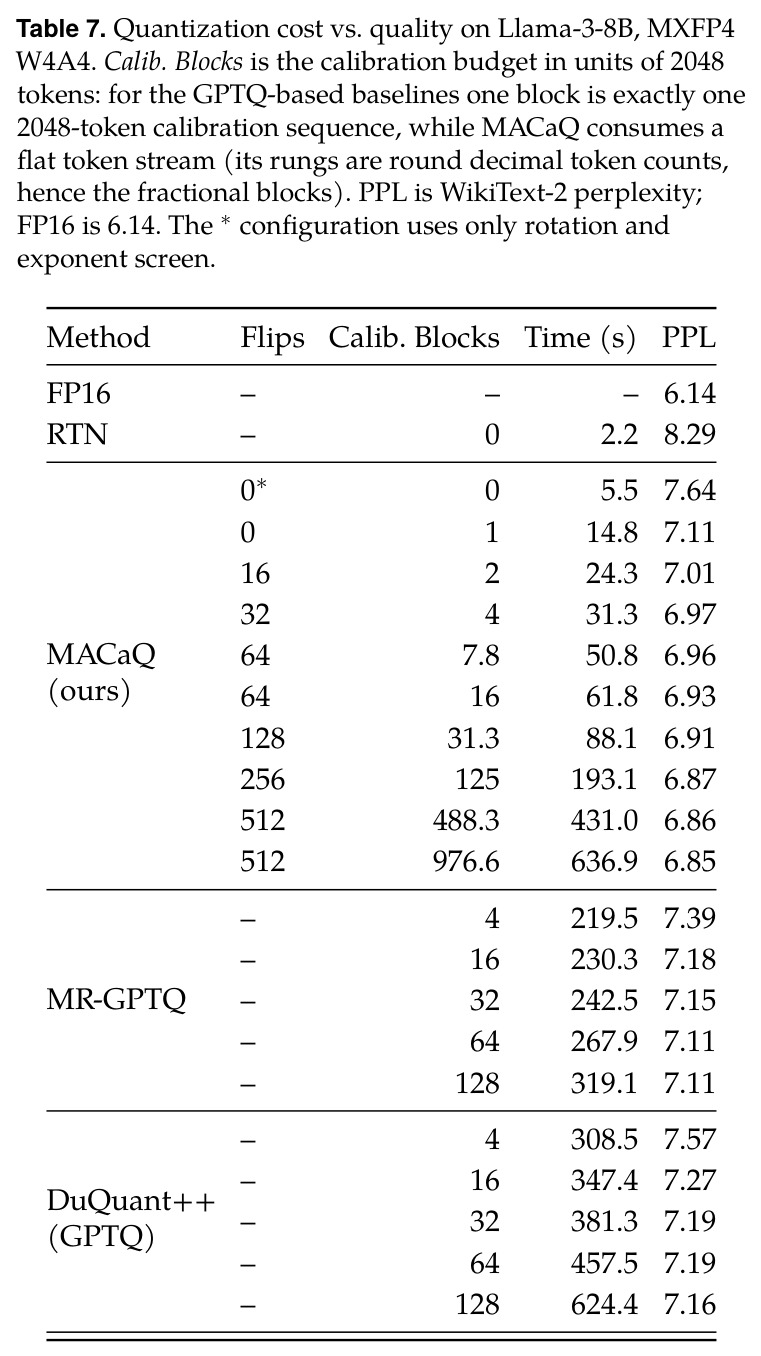
4比特权重-激活(W4A4)量化能大幅压缩显存与带宽,但激活中的离群通道让朴素舍入几乎不可用:Llama-3-8B上MXFP4 W4A4的RTN把WikiText-2困惑度从FP16的6.14推高到8.28-8.29。为此,QuaRot、FlatQuant、DuQuant++等方法引入基变换(Hadamard旋转+逐通道缩放)来摊平离群值。问题在于激活侧的变换必须在推理时在线执行,为消除这部分运行时开销,这些方法把变换沿网络传播、吸收进前一层的RMSNorm、投影或残差分支——每量化一层都要找到并修改它的'吸收目标'。这带来三重代价:一是工程复杂且与架构强耦合,换一种架构(如MoE、图像扩散模型)就要重新推导传播规则;二是量化时间被拉长且难以流式处理,基线方法在Llama-3-8B上需数百秒(DuQuant++(GPTQ)用128个校准块需624秒才能到7.16),量化超大模型还要求整模常驻显存;三是并非所有线性层都能吸收变换,部分层享受不到基变换带来的量化增益。此外GPTQ式的顺序列量化本身也慢且难以按层并行。
本文的目标是本文目标是构造一个'严格逐层独立'的MXFP4 W4A4训练后量化管线:每个线性层的缩放、旋转、校准与量化决策完全局部化,不改任何邻近层,不需要跨层传播基变换。具体量化指标包括:(1)输出质量达到或超过QuaRot、FlatQuant、MR-GPTQ、DuQuant++等SOTA方法;(2)量化时间最多缩短11倍,使122B参数模型(FP16约需244GB)能在单张96GB GPU上64分钟完成量化,峰值显存仅32.5GB;(3)在线变换只带来很小的推理开销(Qwen3-32B端到端2.3%),换来架构无关性——同一套代码无需修改即可用于Llama、Qwen语言模型和FLUX.2 Klein 4B图像扩散模型;(4)提供高效Triton内核,在vLLM中获得相对FP16最高3倍的端到端加速。
与已有工作不同的是,本文的独特切入点是'容忍在线变换'这一反主流的设计选择。先前工作把在线变换视为必须消灭的运行时开销,而作者先算了一笔账:逐通道缩放与块Hadamard的算术开销与输入维 $n$ 成正比,而后续矩阵乘法约需 $2Tmn$ 次运算、与输出维 $m$ 成正比,两者之比为 $C_{online}/C_{matmul} = (\log_2 B + 1)/(2m) = 3/m$($B=32$),层越大相对开销越小——Llama-3-8B最小输出维 $m=1024$ 时低于0.3%。保留在线变换换来完全的层局部性:各层可独立校准与量化、逐层懒加载、任意架构即插即用。第二个切入点是把GPTQ的'固定列序量化+顺序补偿'换成从RTN出发的贪心坐标下降(Flip-Refinement):只考虑相邻E2M1格点的移动,增益有闭式解,可按输出行大规模并行,专为W4A4的速度而设计。
核心方法
直觉上,MACaQ认为'每个线性层自己搞定自己的量化'比'全局优化的变换传播'更重要,为此宁可在推理时在线执行轻量变换。技术路线是把每个线性层的量化拆成四步:(i) 逐通道平衡缩放:$t_j = (\sigma^W_j)^\alpha / (\mathrm{rms}^x_j)^{1-\alpha}$($\alpha=0.75$),激活通道乘 $t_j$、权重列除以 $t_j$,未量化乘积不变,但衰减了大RMS的离群激活通道、同时拉平权重列;(ii) 块Hadamard旋转:块大小32与MXFP4微缩块对齐,$x' = (x \odot t)B$、$W' = (W \oslash t)B$,正交性保证 $X'DB\,(WD^{-1}B)^\top = XW^\top$ 乘积不变,且不把离群值摊到多个独立缩放的块里;(iii) Hessian加权块指数筛选:为每个权重行、每个32元素块在块最大值导出的标准指数附近评估 $\{+1, 0, -1\}$ 三个候选E8M0指数,最小化 $E_{i,B}(e) = \sum_{j \in B} (H_f)_{jj}(W'_{ij} - \hat{W}'_{ij}(e))^2$;(iv) Flip-Refinement:在岭正则化Hessian $H_f = H' + \lambda\,\mathrm{mean\,diag}(H')\,I$($\lambda=1.0$)下做坐标下降精修FP4码。推理时层计算为 $y = [(x \odot t)B]_{\mathrm{MXFP4}}\,\hat{W}'^{\top}_{\mathrm{MXFP4}}$,所有激活侧变换都留在层内。校准阶段用前向钩子按块累积 $H_\ell = \sum_k X_{\ell,k}^\top X_{\ell,k}$,逐层流式处理,GPU上一次只需驻留当前层。
核心创新有三点。第一,把'层局部性'作为第一设计原则:与QuaRot/DuQuant++把激活侧变换 $P$ 传播进前层吸收不同,MACaQ让轻量变换在线执行,彻底解除层间依赖;本质区别在于换了一个被忽略的自由度——用约 $3/m$ 比例的小算术开销买回架构无关、流式量化与全层受益,实测Qwen3-32B端到端仅2.3%开销。第二,Flip-Refinement取代GPTQ:GPTQ按固定列序一次性量化并补偿剩余权重,串行且实现复杂;Flip-Refinement从RTN出发回头'翻'单个FP4码——把码 $(i,j)$ 移到相邻E2M1格点、重构值改变 $\Delta$ 时,行目标下降量有闭式解 $\mathrm{gain}(i,j,\Delta) = 2\Delta g_{i,j} - \Delta^2 (H_f)_{jj}$,接受增益最大的正移动后增量更新 $g_i \leftarrow g_i - \Delta (H_f)_{:,j}$,避免每次重算矩阵-向量积;各输出行独立并行,无正增益即退出激活集。第三,把块共享指数的选择本身表述为Hessian加权优化问题(式12),而非惯例的块最大值取指数,让量化误差大的'重要通道'优先获得分辨率。
方法步骤详情
整个管线输入FP16模型与校准文本(WikiText-2训练集),输出打包的MXFP4模型。第0步校准:前向钩子按2048-token块累积每层 $H_\ell = \sum_k X_{\ell,k}^\top X_{\ell,k}$,同时得到逐通道激活RMS;权重留在主机内存,逐层懒加载,只有当前层及其校准输入需在GPU上。第1步逐通道缩放:输入 $W \in \mathbb{R}^{m \times n}$ 与激活RMS,计算 $t_j = (\sigma^W_j)^\alpha / (\mathrm{rms}^x_j)^{1-\alpha}$($\alpha=0.75$,范围截断保数值稳定),输出 $W \oslash t$ 与缩放表 $t$(推理时激活乘 $t$)。第2步块Hadamard旋转:输入缩放后权重,右乘块大小32的正交阵 $B$ 得 $W' = (W \oslash t)B$;推理时同一固定 $B$ 在线作用于激活,先缩放后旋转是因为通道重要性加权必须发生在未旋转域。第3步指数筛选:输入 $W'$ 与正则化Hessian $H_f = H' + \lambda\,\mathrm{mean\,diag}(H')\,I$,对每行每块在标准指数的 $\{+1,0,-1\}$ 偏移内选出最小化式(12)的E8M0指数并在精修期间固定。第4步Flip-Refinement(Algorithm 1):输入初始FP4码 $Q$、固定块尺度、$H_f$、最大迭代数 $K$;每轮对每个活跃输出行计算所有相邻格点移动的增益、接受最大正增益者并增量更新 $g_i$,行间并行、无正增益的行移出集合,直至无改进或达 $K$ 次。输出精修后的码并打包替换原层。主实验配置 $K=128$、20万校准token(Llama-3-8B约150秒量化完)。
技术新颖性
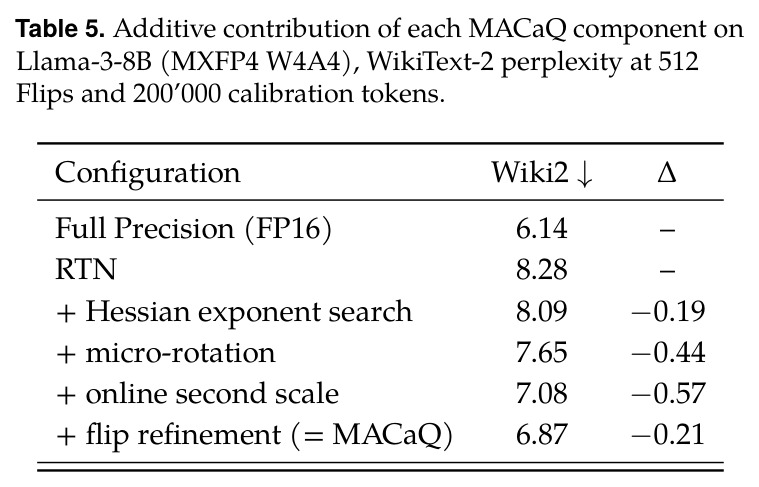
与已有方法的本质区别体现在三处。其一,变换的'住址':QuIP/QuaRot/DuQuant++把激活侧变换吸收进网络结构以消除运行时开销,MR-GPTQ与块旋转类工作虽然采用块局部旋转以适配微缩格式(避免离群值摊到多个独立缩放块),但仍需跨层传播;MACaQ是首个把'在线保留轻量变换+严格逐层独立'做到SOTA质量的MXFP4 W4A4方案——同一段代码未经架构修改即量化了FLUX.2 Klein 4B扩散模型,并在64分钟内流式量化了122B模型。其二,替代GPTQ的精修算法:QuantEase/CDQuant虽也是坐标下降,但面向纯权重量化且迭代开销大;Flip-Refinement专为W4A4速度设计——固定块指数、只考察相邻两个E2M1格点,使每次移动的收益闭式可算、可按行并行,并用增量梯度更新把单次代价压到 $O(n)$。其三,微缩格式的块共享指数此前几乎都按块最大值确定,本文首次将其写成带Hessian对角加权的离散优化并用±1偏移筛选。消融(Table 5)显示四个组件贡献同一数量级(分别约 $-0.19/-0.44/-0.57/-0.21$ 困惑度),说明是组合创新而非单点技巧。
实验结果
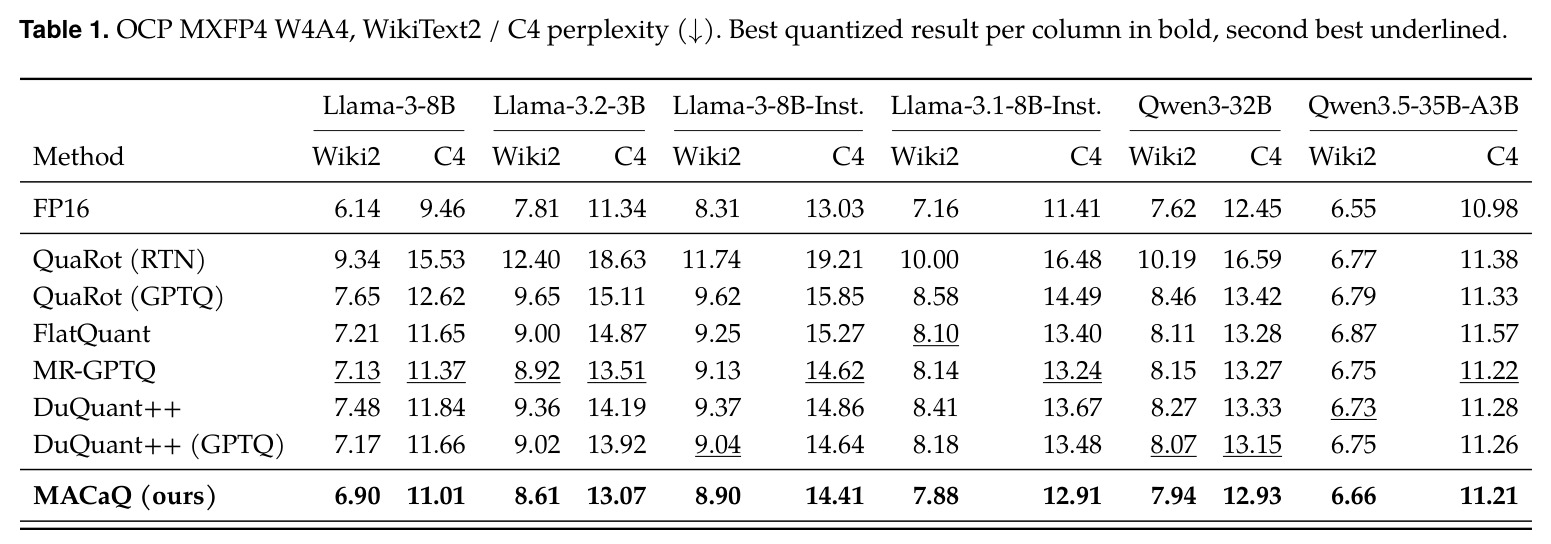
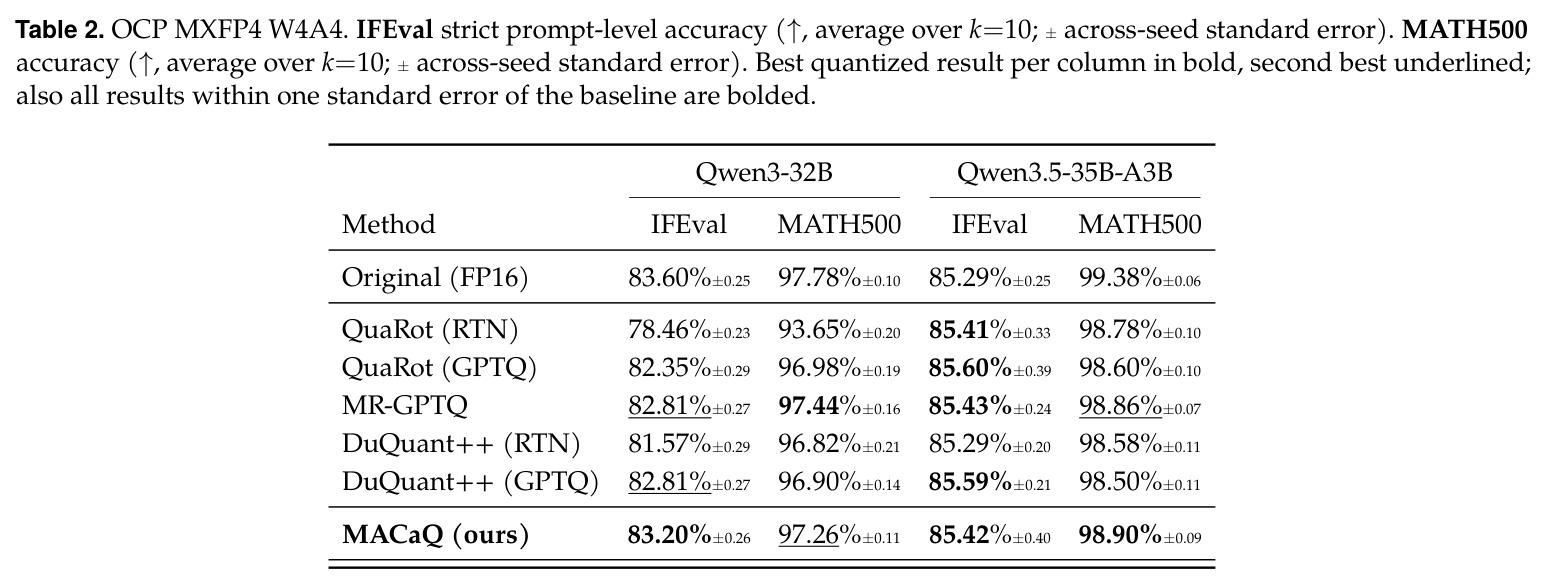
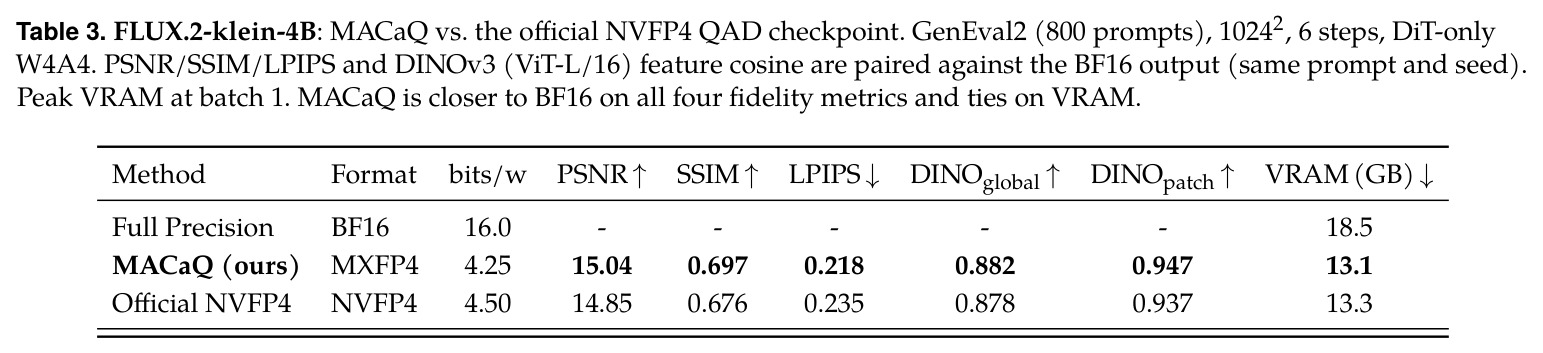
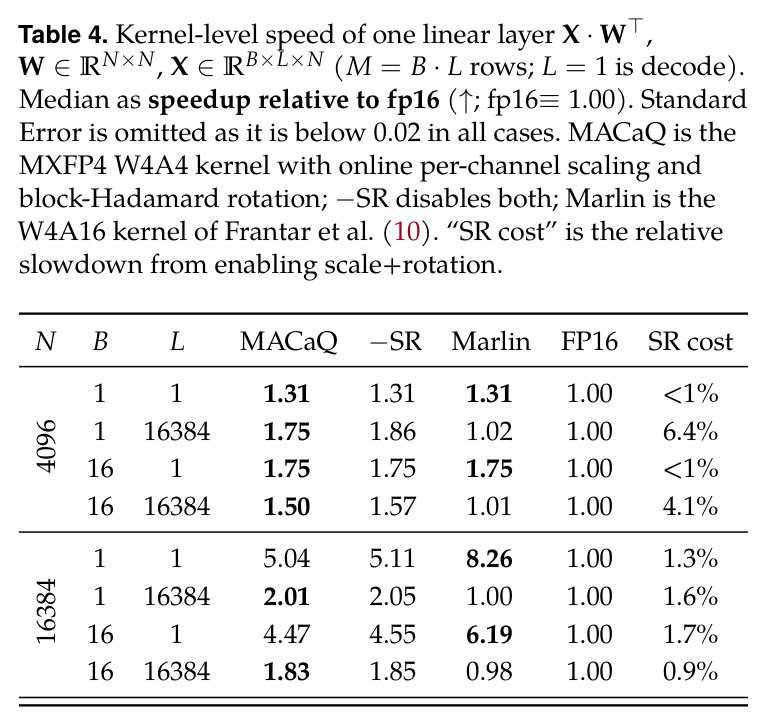
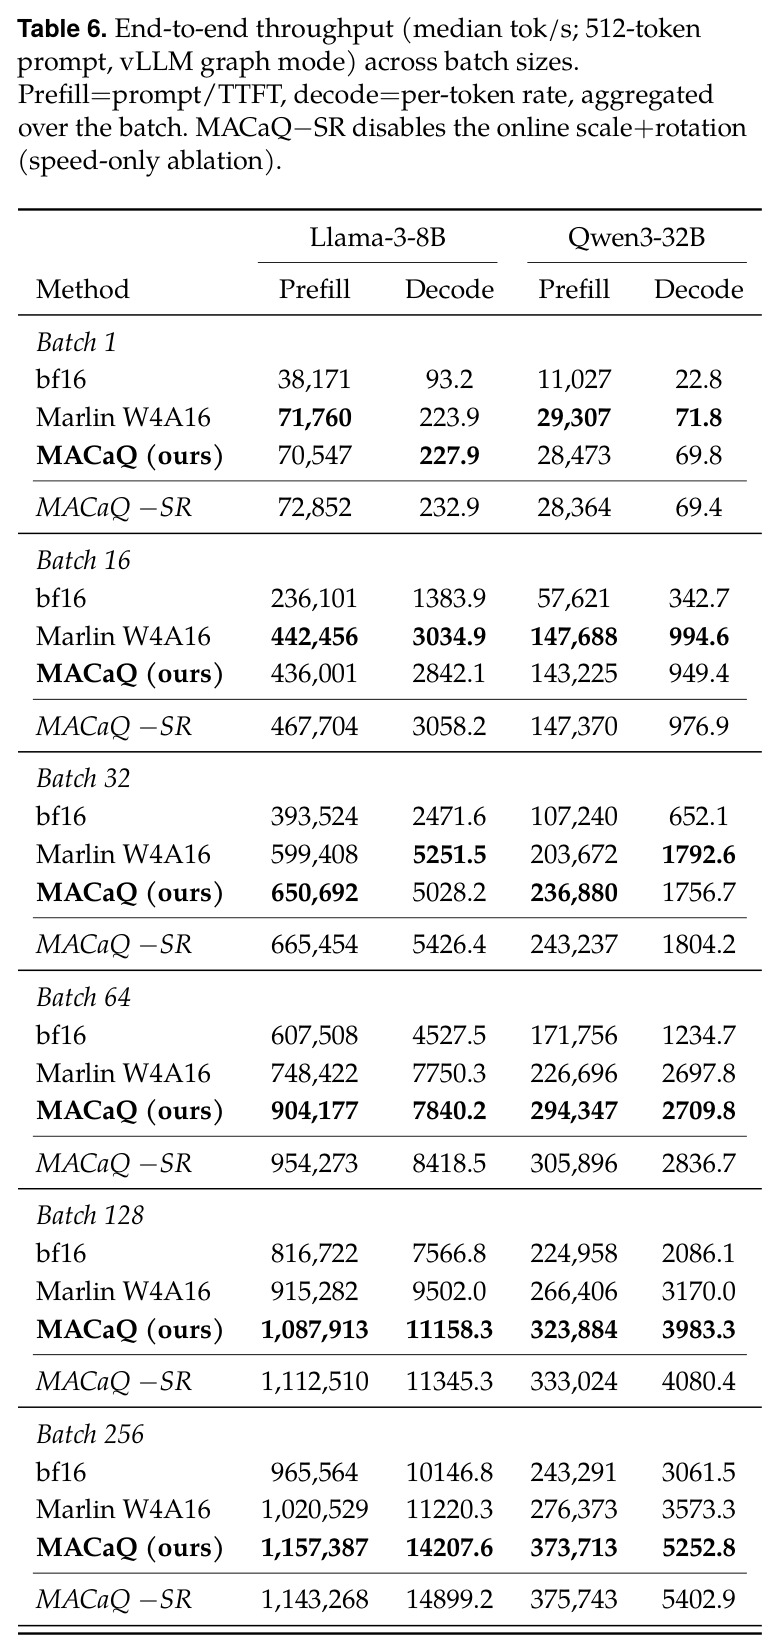
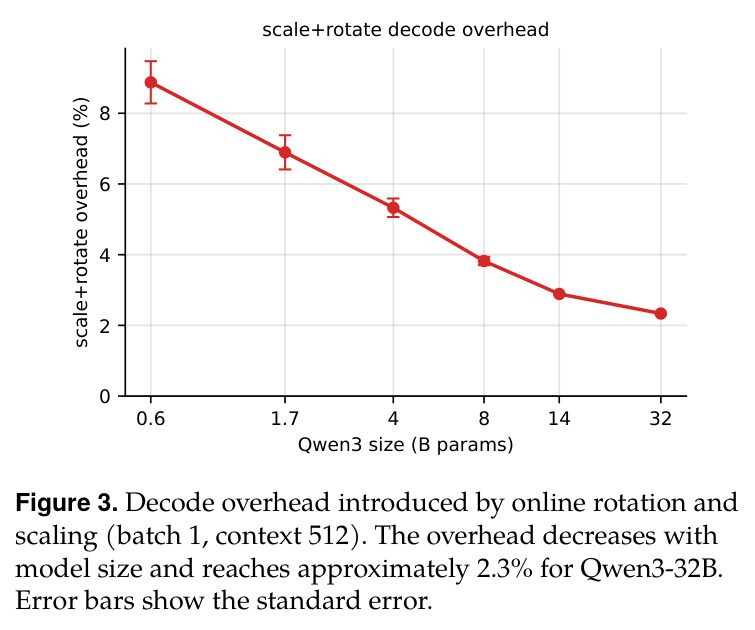
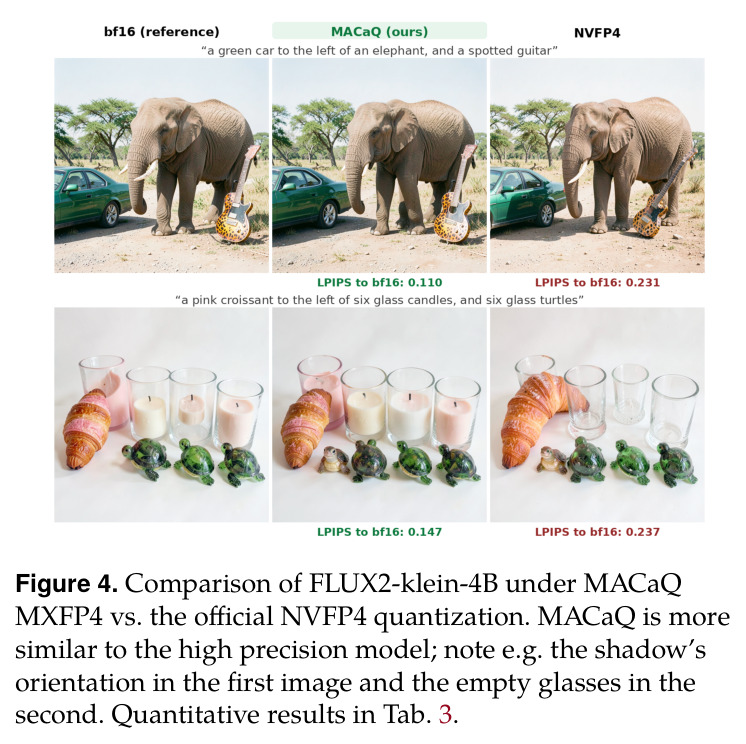
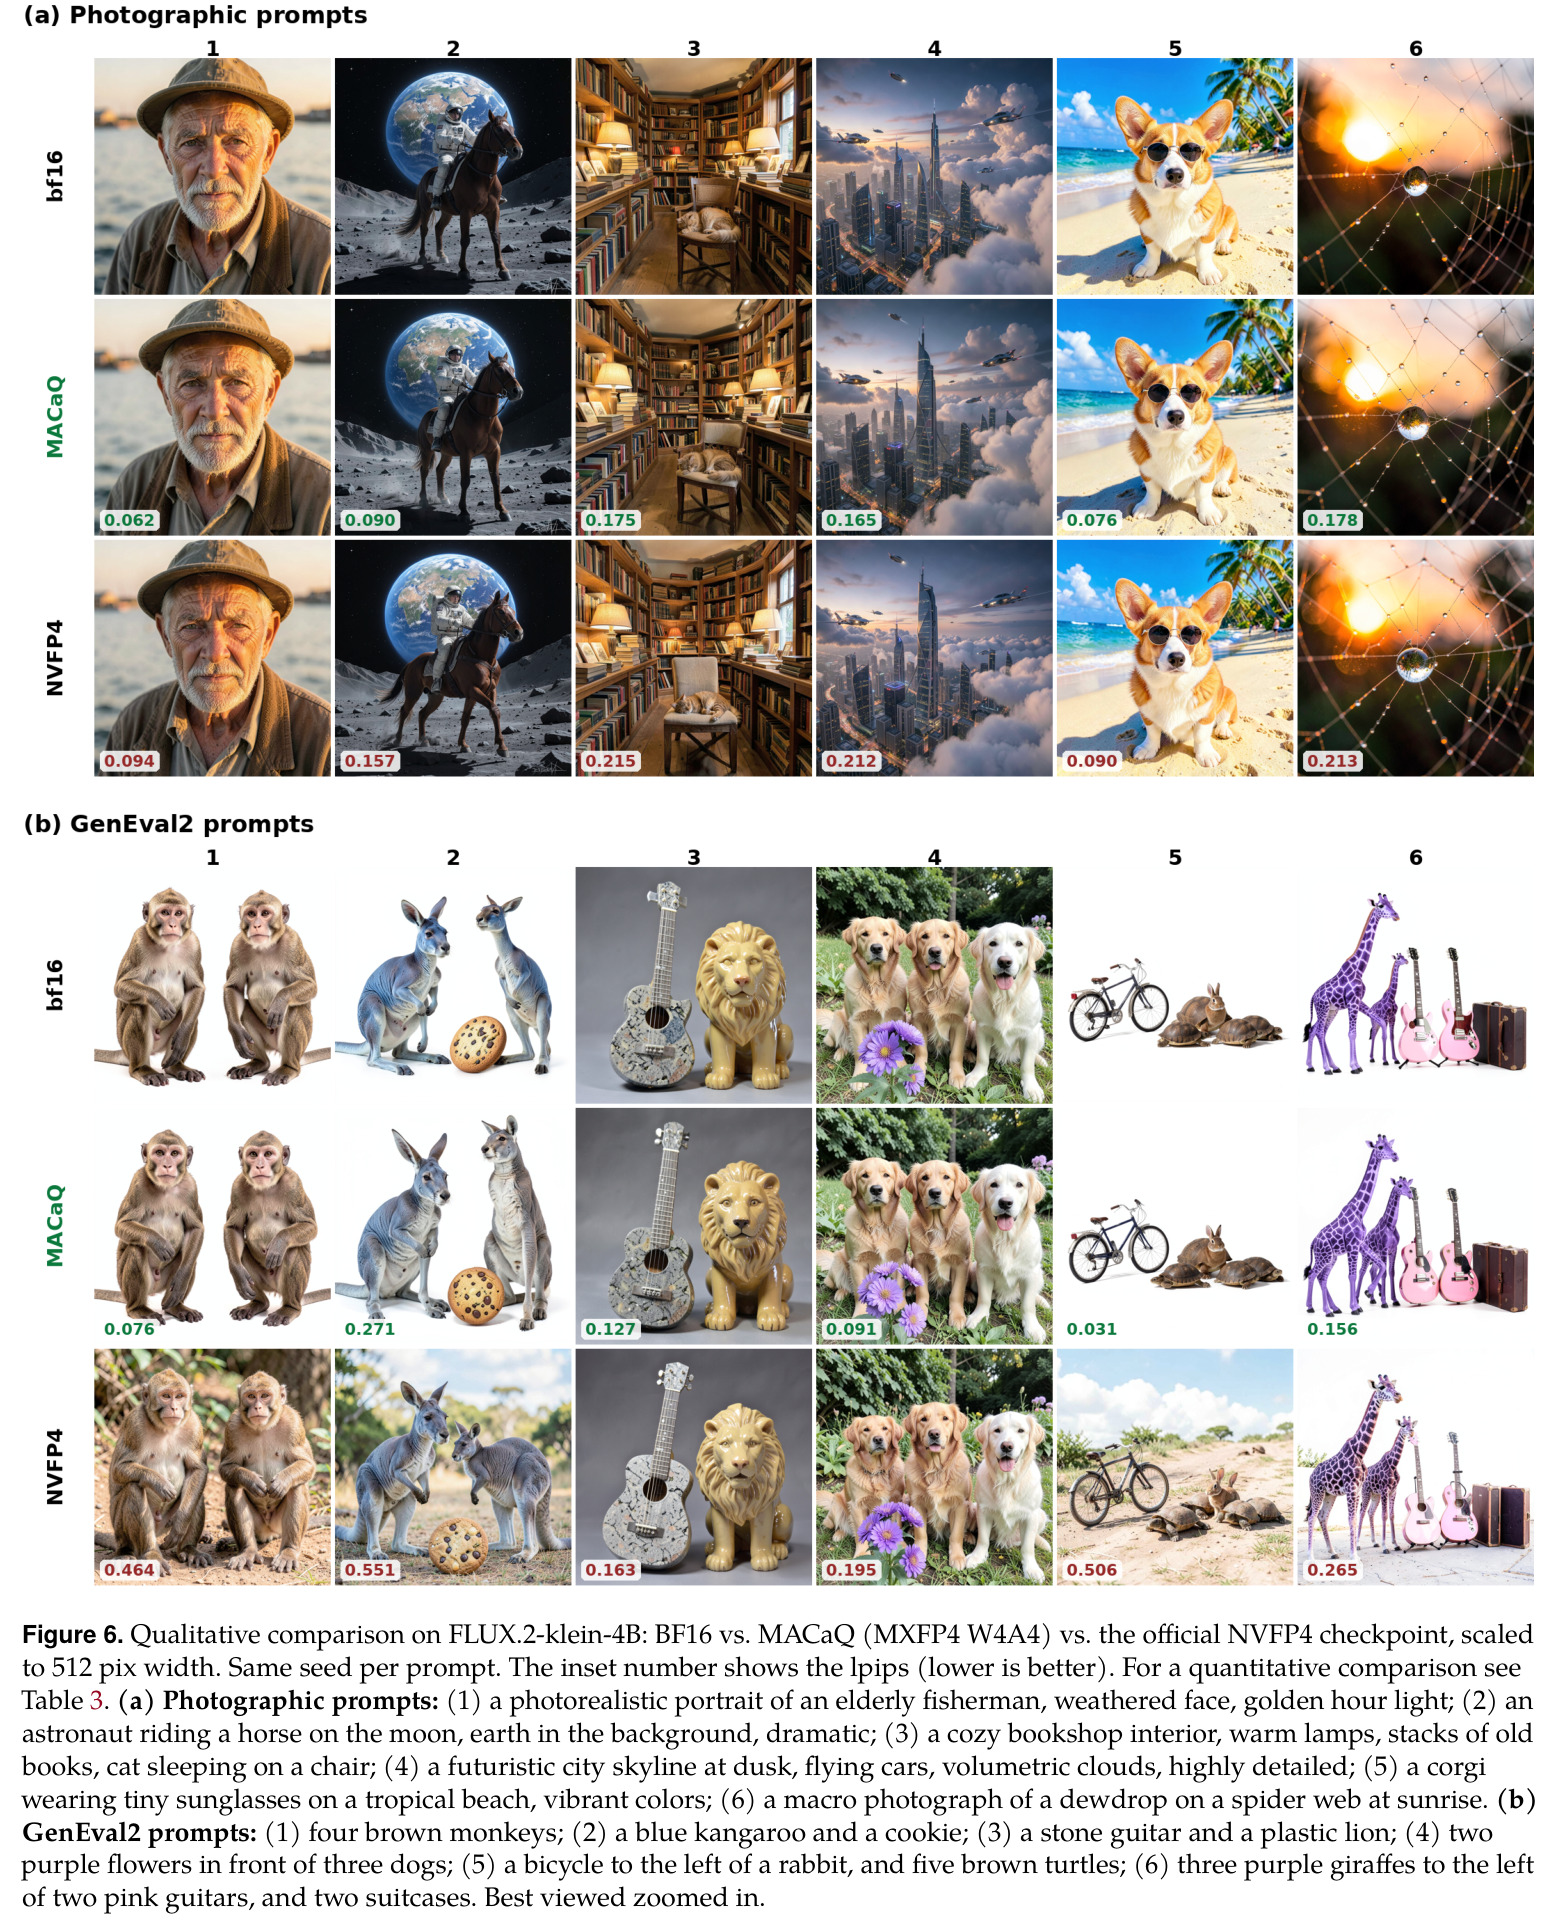
困惑度(Table 1,OCP MXFP4 W4A4,上下文2048):六个模型上MACaQ全部拿到最优。Llama-3-8B Wiki2/C4为6.90/11.01(FP16为6.14/9.46),优于MR-GPTQ的7.13/11.37、DuQuant++(GPTQ)的7.17/11.66、FlatQuant的7.21/11.65、QuaRot(GPTQ)的7.65/12.62;Llama-3.2-3B为8.61/13.07;Qwen3-32B为7.94/12.93(FP16为7.62/12.45);MoE模型Qwen3.5-35B-A3B为6.66/11.21。速度-质量帕累托(Fig.2与Table 7):MACaQ用64次翻转+16校准块仅61.8秒达6.93,已优于MR-GPTQ花319秒的7.11和DuQuant++(GPTQ)花624秒的7.16;512次翻转时431秒达6.86,摘要口径为'11倍更少时间匹配基线最佳困惑度'。生成任务(Table 2,k=10次采样):Qwen3-32B上IFEval 83.20%(FP16为83.60%)、MATH-500为97.26%(FP16为97.78%),均在一个标准差内;Qwen3.5-35B-A3B上IFEval 85.42%甚至略高于FP16的85.29%。图像扩散(Table 3):FLUX.2 Klein 4B的DiT做W4A4,MACaQ(4.25比特/权重)对BF16输出的PSNR 15.04、SSIM 0.697、LPIPS 0.218、DINOpatch余弦0.947,全面优于官方NVFP4检查点(4.50比特)的14.85/0.676/0.235/0.937,VRAM还更省(13.1 vs 13.3GB)。速度(Table 4/6、Fig.3):内核峰值加速为FP16的5.04倍($N=16384$、batch 1解码),缩放+旋转的开销小层最多6.4%、大层低于3%;Qwen3-32B端到端batch 1解码69.8 tok/s对FP16的22.8(3.06倍),batch 256为5252.8对3061.5 tok/s,与Marlin W4A16相当或更优;在线变换的解码开销从Qwen3-0.6B的约8%降到32B的约2.3%。超大模型流式量化:Qwen3.5-122B-A10B在单张96GB GPU上64分钟完成(32次翻转、51.2万校准token),峰值显存32.5GB,Wiki2困惑度5.14对FP16的5.06,产物74GB可装回同一GPU。消融(Table 5,512翻转+20万token):RTN 8.28 → +指数筛选8.09 → +微旋转7.65 → +在线第二缩放7.08 → +翻转精修6.87。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语言模型困惑度(Llama-3-8B, MXFP4 W4A4) | WikiText-2 perplexity (↓) | 6.90(FP16为6.14) | MR-GPTQ 7.13;DuQuant++(GPTQ) 7.17;FlatQuant 7.21;QuaRot(GPTQ) 7.65;RTN 8.28 | 较最佳基线MR-GPTQ降低0.23(约3.2%),为全部基线中唯一低于7.0的结果 |
| 语言模型困惑度(Llama-3-8B, 分布外) | C4 perplexity (↓) | 11.01 | MR-GPTQ 11.37;DuQuant++(GPTQ) 11.66 | 降低0.36(约3.2%),在全部6个模型的Wiki2/C4共12列中全部第一 |
| 量化时间-质量帕累托(Llama-3-8B) | 达到基线最佳质量所需量化时间 | 61.8秒达PPL 6.93(64翻转+16校准块);431秒达6.86(512翻转) | MR-GPTQ 319.1秒达7.11(128块);DuQuant++(GPTQ) 624.4秒达7.16(128块) | 更快且质量更好;论文摘要口径为'11倍更少量化时间匹配基线最佳困惑度' |
| 指令跟随(Qwen3-32B, MXFP4 W4A4) | IFEval strict prompt-level accuracy (↑, k=10) | 83.20%±0.26 | FP16 83.60%±0.25;最佳基线MR-GPTQ/DuQuant++(GPTQ) 82.81%±0.27 | 与FP16差距0.4个百分点(一个标准差内),超最佳量化基线0.39个百分点 |
| 数学推理(Qwen3-32B, MXFP4 W4A4) | MATH-500 accuracy (↑, k=10) | 97.26%±0.11 | FP16 97.78%±0.10;最佳基线MR-GPTQ 97.44%±0.16 | 近乎无损(-0.52个百分点),链式推理误差未出现放大 |
| 图像扩散生成(FLUX.2 Klein 4B, DiT-only W4A4) | PSNR ↑ vs BF16(GenEval2 800提示, 1024², 6步) | 15.04(4.25 bit/w) | 官方NVFP4检查点 14.85(4.50 bit/w) | 比特数更少仍+0.19dB;LPIPS 0.218 vs 0.235、DINOpatch 0.947 vs 0.937、VRAM 13.1 vs 13.3GB 全面占优 |
| 端到端解码吞吐(Qwen3-32B, vLLM, batch 1) | tok/s (decode) | 69.8 tok/s(含在线缩放+旋转,端到端开销2.3%) | FP16 22.8 tok/s;Marlin W4A16在Llama-3-8B上223.9 vs MACaQ 227.9 tok/s | 3.06×于FP16;内核级峰值5.04×(N=16384解码);无变换版本(-SR)232.9 tok/s说明变换仅损失约2% |
| 超大模型流式量化(Qwen3.5-122B-A10B, 单张96GB GPU) | 峰值GPU显存 / 量化时长 / 量化后质量 | 32.5GB / 64分钟 / Wiki2 PPL 5.14(FP16为5.06) | FP16权重约244GB,无法装入目标GPU;量化产物74GB可运行 | 使'装不下的模型'可量化部署,质量损失仅0.08困惑度 |
局限与改进
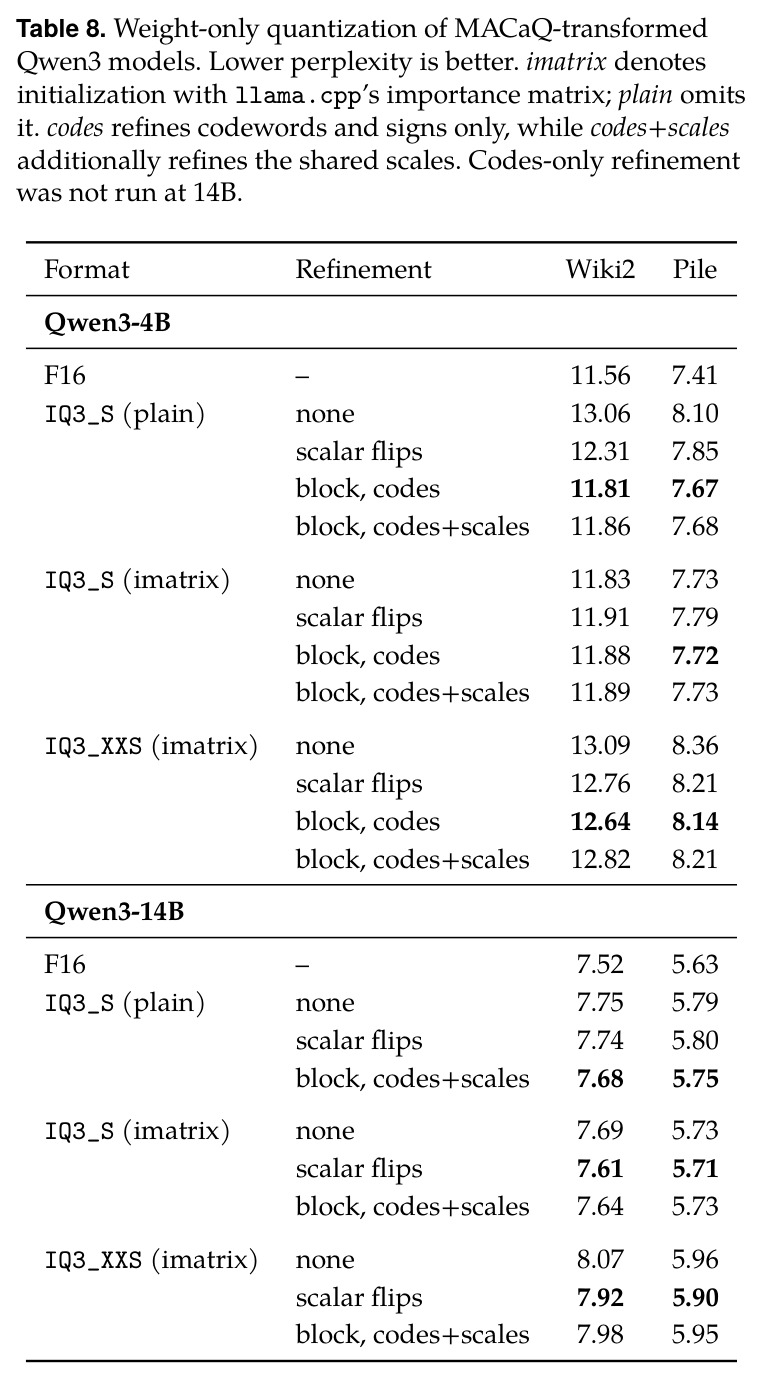
作者承认两点局限:层局部设计使跨层误差补偿不可能——若在MACaQ之上加一轮使用跨层统计的二次处理,就会重新引入其他方法的慢量化问题;MoE实验出于实用性只量化了专家层(基线亦然),注意力等其他部分的量化未测。此外最小的Qwen3-0.6B上在线变换开销升至8%,开始影响部分场景。我的补充观察:(1) 质量差距在小模型上放大——Llama-3.2-3B的Wiki2为8.61对FP16的7.81(相对差约10%),明显大于Llama-3-8B的6.90对6.14,说明逐层局部目标在小模型/小层上更吃亏;(2) 困惑度评估校准与测试同用WikiText-2(C4虽是分布外但仍是英文文本域),未测多语言、代码、超长上下文等漂移场景;(3) 层重建误差只是模型质量的代理指标——附录VQ实验中出现'块级精确最优反而不如标量翻转的困惑度'(Qwen3-4B IQ3_S上block 11.81 vs imatrix+scalar flips 11.91附近互有胜负),提示目标错位风险在主线方法同样存在;(4) 在线变换依赖定制Triton内核与vLLM集成,在不支持MXFP4在线旋转的引擎(尤其边缘NPU)上收益未必成立;(5) 2.3%开销是在504 TFLOPS FP16、1.79TB/s带宽的高端GPU上测得的,算力/带宽比不同的硬件上结论会移动;(6) 与DuQuant++原文数字存在细微差异,因其代码库默认允许非2的幂分数指数,本文全程用E8M0合规转换。
独立分析的弱点
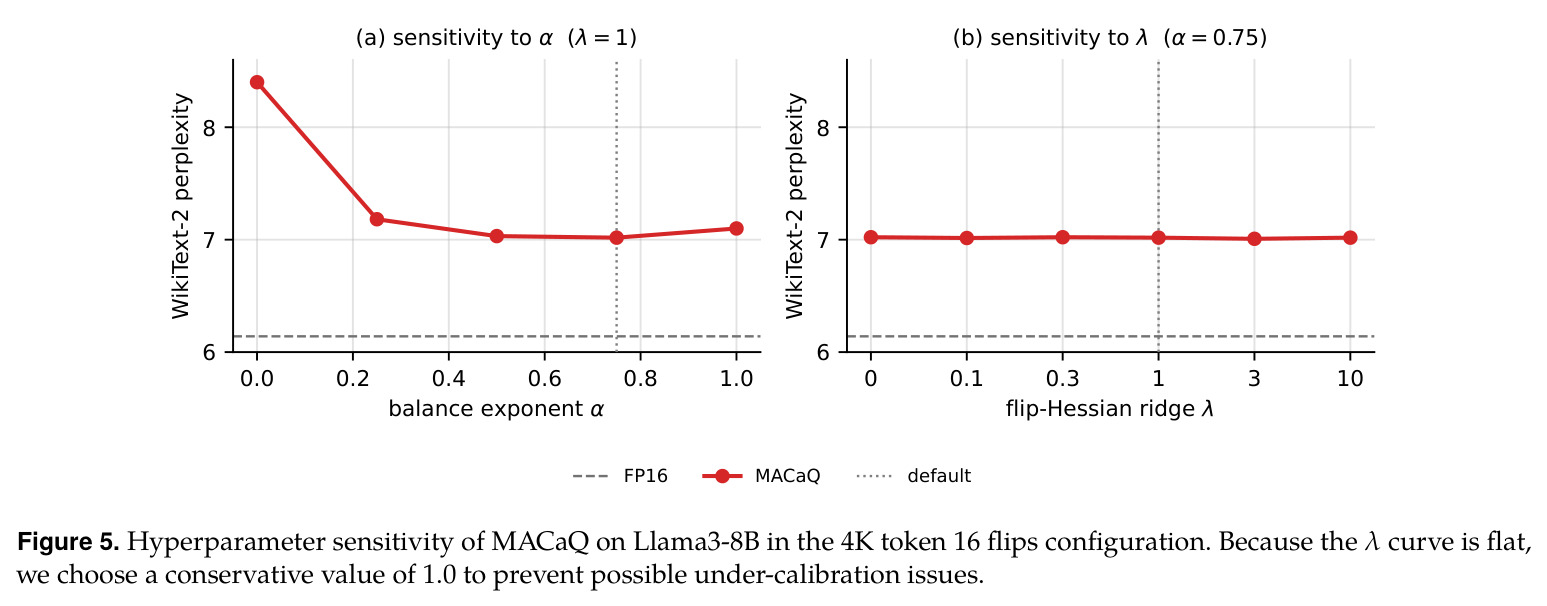
独立分析几点弱点并给出改进方向。(1) 小模型开销随层尺寸恶化:理论比值 $3/m$ 决定了0.6B模型开销达8%——可在'层内'把逐通道缩放吸收进紧邻的RMSNorm(这不违反层局部性),或对小层自动退化为W4A16无旋转模式。(2) 无跨层补偿能力:GPTQ类方法能按列吸收前序量化误差,MACaQ只能层内解决,小模型上约0.8的困惑度差距可能正源于此——可设计'选择性第二轮',仅对校准输出误差最大的少数层启用跨层统计精修,把时间预算控制在速度优势之内。(3) Flip-Refinement只看相邻格点:E2M1格点稀疏,单码移动易陷局部最优;附录已演示把码本精修当作k-means式最近邻搜索(IQ3_S上Qwen3-4B困惑度13.06→11.81),同样思路可搬到MXFP4做四码联合翻转。(4) 超参稳健性只在Llama-3-8B上验证(Fig.5显示 $\alpha$、$\lambda$ 曲线平坦),对MoE、扩散模型的迁移性未单独调参验证。(5) 只量化线性层:嵌入、lm_head、KV cache与MoE注意力仍为高精度,端到端显存/带宽收益被稀释。(6) 缺少与学习型旋转(SpinQuant/FlatQuant本质是学出来的变换)在同等训练预算下的对比,'不学习的逐层方案与轻量学习方案的质量差距'尚无定量答案。
未来方向
作者提出的方向:在层局部框架之上叠加一轮跨层统计的二次误差补偿(作者明确指出这会牺牲部分量化速度);把Flip-Refinement扩展到向量量化格式(附录已给出IQ3_S/IQ3_XXS的码本最近邻精修,式20-25,用'长度表+匹配项'的k-means式打分与精确梯度回补,8次sweep每大张量仅5-8秒);继续压低小模型的在线变换开销。基于其成果可延伸的方向:(1) 把块级码本搜索引入MXFP4,对每32元素块内的4个E2M1码联合优化,有望进一步逼近甚至超越GPTQ质量;(2) 统一支持微缩格式族——NVFP4(块16、4.50比特)只需换块大小与格点定义,FLUX.2实验已证明对官方NVFP4的质量优势;(3) 在线变换与RMSNorm/RoPE做核融合,把2.3%压向0;(4) 把'模型无关'主张推向语音、多模态、KV cache量化等更远领域;(5) 在TensorRT-LLM、llama.cpp等更多引擎复现端到端收益(附录的llama.cpp权重-only实验已是第一步);(6) 与极轻量微调(每层几步的旋转学习)结合,在保持逐层管线与流式量化的同时收窄小模型上的质量差距。
复现评估
论文来自华为苏黎世计算系统实验室,正文与附录均未给出开源代码链接(贡献点提到'提供高效Triton内核',但本版本未明确承诺发布),复现需自行实现。有利因素是方法描述异常完整:缩放公式、正则化Hessian、指数筛选、翻转增益与增量更新全部给出闭式表达,Algorithm 1给出Flip-Refinement伪代码,默认超参齐全($B=32$、指数偏移 $\{+1,0,-1\}$、$\alpha=0.75$、$\lambda=1.0$、$K=128$、20万校准token),附录给出帕累托曲线全部数值(Table 7)、端到端吞吐明细(Table 6)与超参敏感性(Fig.5)。数据与模型全部公开:WikiText-2、C4、Llama-3系列、Qwen3/3.5、FLUX.2 Klein 4B、GenEval2提示集。算力门槛低:单张96GB GPU(504 TFLOPS FP16、1.79TB/s)足够,量化Llama-3-8B约150秒、122B模型64分钟。真正的难点在工程而非算法:需实现带在线缩放+块Hadamard的MXFP4 Triton内核并接入vLLM graph模式,FLUX复现还需DiT的W4A4支持,吞吐数字对内核质量敏感(同一算法的-SR版本反而更快)。总体评估:算法核心一两天可出原型并验证困惑度量级(±0.05),完整复现端到端速度与全部表格需数周工程投入,难度中等偏上。
论文图表
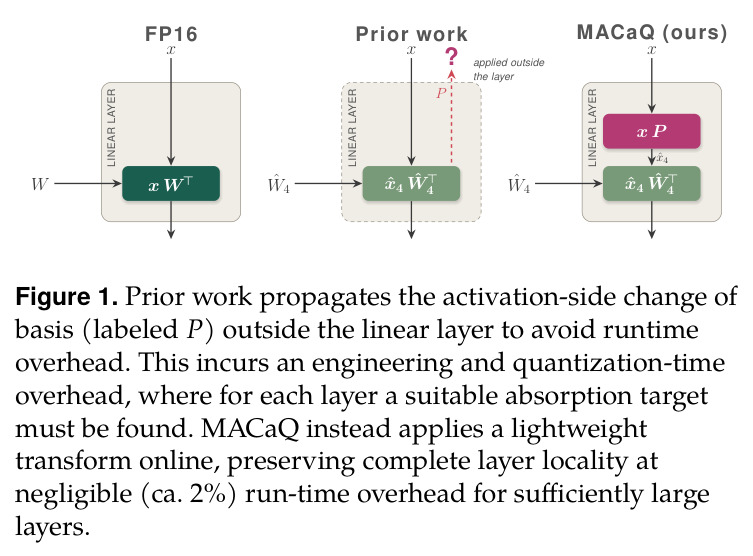
三联示意图对比FP16原始层、先前工作与MACaQ:先前工作把激活侧变换 $P$ 传播到线性层之外吸收进前序算子,推理图里没有显式变换但量化时要做跨层吸收;MACaQ把轻量变换(缩放+块旋转)画在线性层内部在线执行,层与层之间零耦合。
这张图一眼讲清了全文的立论:'变换放哪'是设计自由度,MACaQ选择放在层内在线执行,由此获得层局部性;理解它是理解标题中Model Agnostic与Fig.2速度优势的前提。
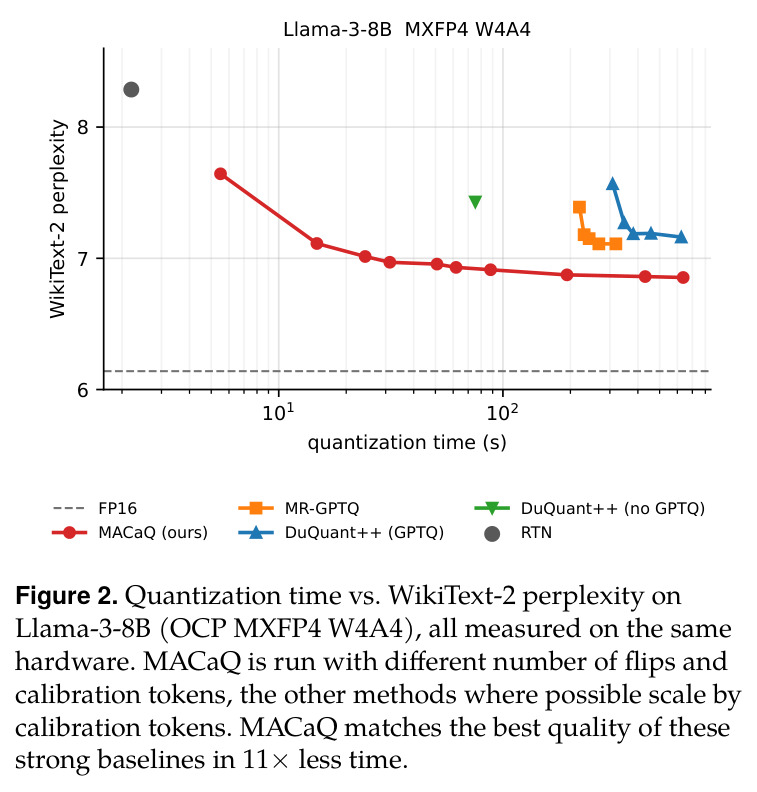
以量化时间(秒,对数横轴)为横轴、WikiText-2困惑度为纵轴的帕累托曲线:MACaQ通过扫描翻转次数与校准token数形成一条从RTN水平(约15秒、7.1+)到6.86(约431秒)的曲线,整体位于MR-GPTQ、DuQuant++(GPTQ/无GPTQ)等基线的左下方,即同等质量下快一个数量级。
这是全文最核心的实验主张——质量与速度同时占优——的可视化证据,'11倍更少时间匹配最佳困惑度'就出自这张图,也是审稿人判断贡献份量的第一依据。