面向量子增强扩散语言模型的电路超网络 Circuit Hypernetworks for Quantum-Augmented Diffusion Language Models
用超网络为每个 token 生成专属量子电路,使冻结扩散语言模型随比特数增加持续提升
前置知识
掩码扩散语言模型(MDM)
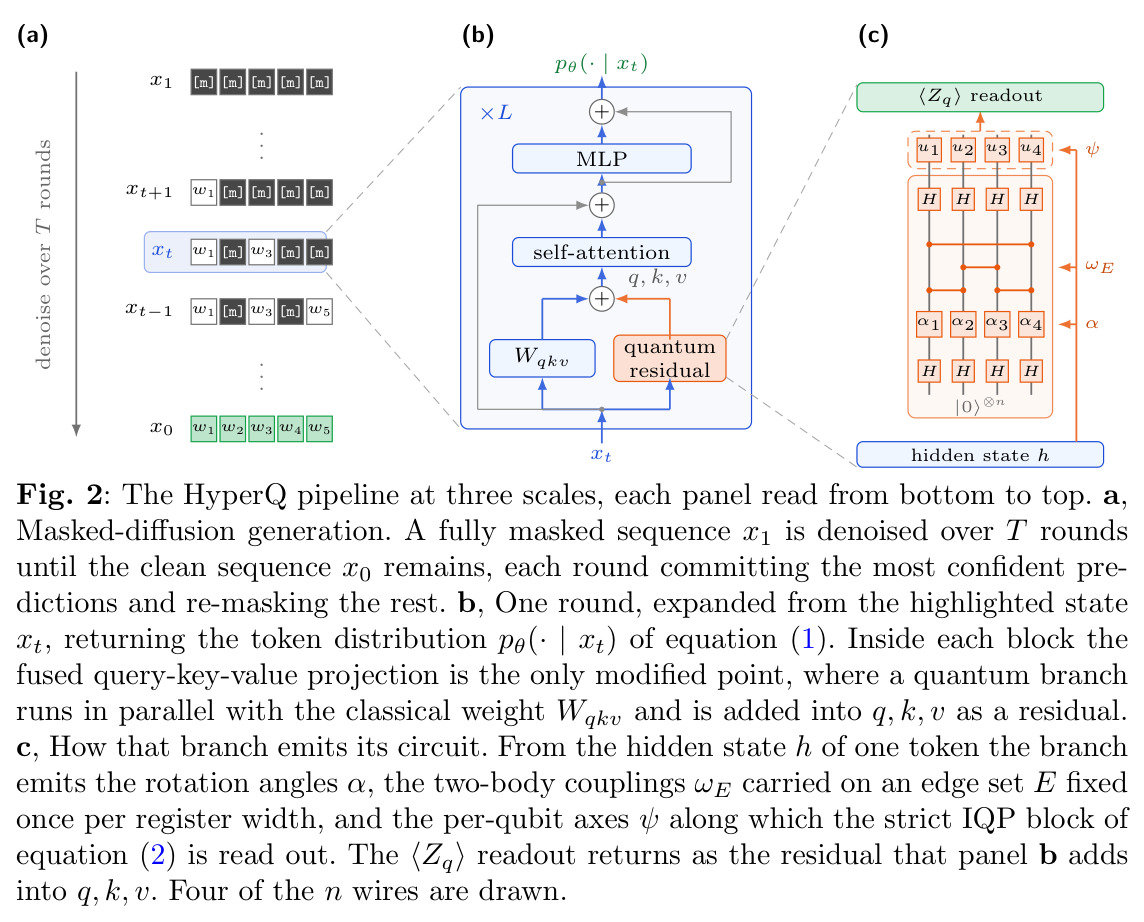
一种非自回归文本生成范式:训练时从 $(0,1]$ 均匀抽取掩码比例 $t$,把每个 token 以概率 $t$ 独立替换为 $[m]$,模型在双向注意力下并行预测所有被掩码位置,优化掩码交叉熵上界 $\mathcal{L}(\theta)=\mathbb{E}_{t,x^0,x^t}\sum_{i\in M(x^t)}-\log p_\theta(w_i|x^t)$;推理时从全掩码序列出发迭代 $T$ 轮,每轮提交置信度最高的预测并重掩码其余位置。LLaDA 是其代表开源模型。
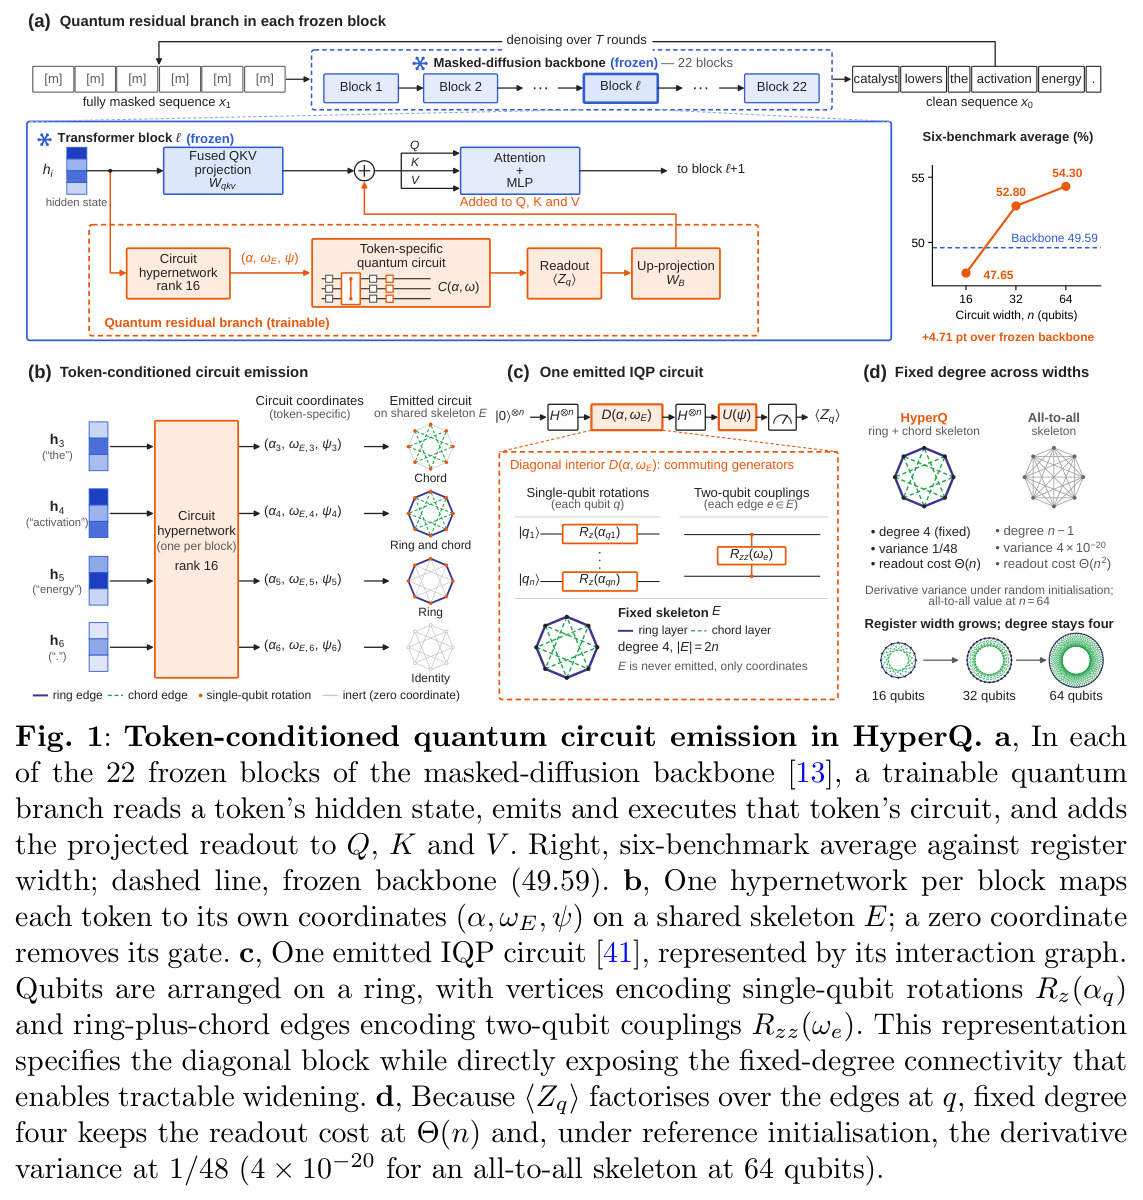
HyperQ 完全冻结 LLaDA-1.1B 骨干(22 个 transformer 块),只改块内部的表示计算,训练信号唯一来自掩码扩散目标。不理解这套去噪流程,就无法理解量子分支插在哪里、如何被端到端训练。
参数化量子电路(PQC)
由带可训练旋转角的量子门序列构成的电路,例如单比特旋转 $R_z(\alpha)$ 和两比特耦合 $R_{zz}(\omega)$,角度是连续优化变量;执行电路后测量得到期望值(如 Pauli-$Z$ 的期望 $\langle Z_q\rangle$)作为经典输出,再用经典优化器更新角度,即变分量子算法的基本循环。
HyperQ 的量子残差分支就是一个参数化电路,但其参数(旋转角、耦合强度、测量轴)不是对所有输入固定的一组数,而是由超网络按 token 动态生成——这是本文区别于传统变分量子电路用法的关键。
IQP 电路
瞬时量子多项式时间电路,形如 $C(\alpha,\omega)=H^{\otimes n}D(\alpha,\omega)H^{\otimes n}$,中间对角块 $D$ 只含相互对易的生成元(单比特 $Z_q$ 与两体 $Z_iZ_j$)。其输出分布的精确采样被相信经典难解,但当生成元权重不超过 2 时,单比特期望值有乘积形式的闭式解,可在 $\Theta(n)$ 时间内精确求值而无需构建 $2^n$ 维状态向量。
HyperQ 刻意把发射的电路限制在这个严格子族(权重 $\le 2$ 的生成元 + 固定边集),正是为了同时拿到闭式读出与常数梯度方差,这是全文在十亿参数模型内跑 64 比特电路的可行性基石。
荒芜平台(barren plateau)
变分量子电路随比特数 $n$ 增大,损失对参数的梯度方差可能随 $n$(或更精确地随电路的连接结构)指数消失,使优化陷入无法训练的平坦区。本文推导出两体 IQP 族内梯度方差为 $\mathrm{Var}=\frac{1}{3}2^{-|N(q)|}$,只依赖该比特在边集中的连接度 $\mathrm{deg}(q)$ 而非比特总数。
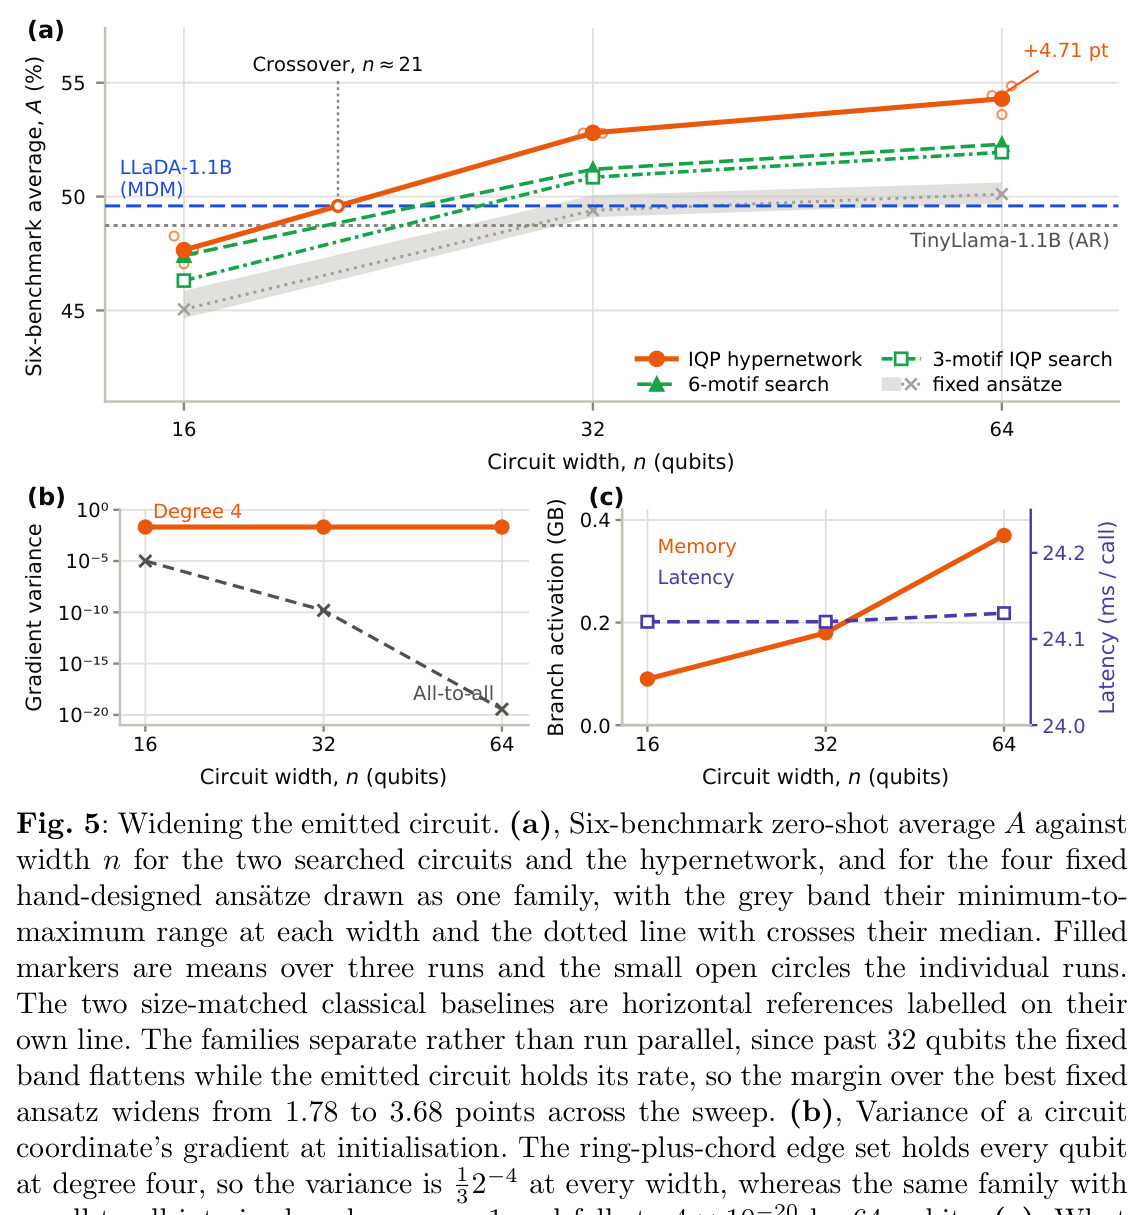
荒芜平台是挡在「电路变宽是否有用」面前的第一座大山;理解方差—度数关系,才能明白 HyperQ 为什么坚持让每个比特的度固定为 4(方差恒为 $1/48$),而全连接骨架在 64 比特时方差只剩 $4\times10^{-20}$。
超网络(hypernetwork)
生成另一个计算模块参数的网络。经典用法是为下游网络生成权重;这里低秩适配器把 token 隐状态 $h$ 映射为电路坐标 $\xi_t=(\alpha,\omega_E,\psi)\in\mathbb{R}^n\times\mathbb{R}^{|E|}\times(S^2)^n$,即每个 token 一套专属电路参数,整个「隐状态→电路→读出」路径端到端可微。
HyperQ 的名字与核心创新都来自它:把「选哪个电路」的离散搜索问题改写成「在连续坐标系中回归出一个点」的问题,零坐标即删除对应门,从而把结构选择与参数优化合二为一。
LoRA 低秩适配
冻结原模型权重,只训练插入的低秩矩阵乘积(秩 $r\ll d$)实现参数高效微调。本文用秩 $r=16$、缩放 $s=32$、dropout 0.05 的 LoRA 结构实现超网络的输入降投影 $W_A$ 与读出上投影 $W_B$,且只训练这 22 个块中的量子分支。
论文用它来隔离「增加适配器容量」与「量子电路本身」的贡献:同一冻结骨干加经典 LoRA 得 50.63,HyperQ 64 比特得 54.30,这 3.67 点差距才能归因于电路发射机制而非单纯加参数。
研究动机
现有把量子组件接入 transformer 的工作都停留在固定资源水平的点评估上,无法回答「比特数变多,语言模型是否变好」。具体有三条路线:其一把变分电路直接嵌入 transformer 计算,如 HyQuT 在 1.5 亿参数模型内嵌电路只追平经典质量,量子自注意力层也被同规模经典瓶颈层打平;其二用幺正结构约束参数更新,如 Cayley 幺正适配器让冻结 8B 模型困惑度改善约 1.4% 但明确否认量子优势;其三把量子组件与经典低秩/张量适配器结合(量子-张量混合适配器、Quantum-PEFT 等)。这些工作各自使用互不重叠的评测集——HyQuT 报对话质量、Cayley 报 WikiText 困惑度、量子-张量适配器报中文指令微调损失——没有任何一篇报告标准零样本常识/推理套件,彼此之间以及与经典基线都不可直接比较。而要做宽度研究还横着两座大山:一是可训练性,非结构化变分电路存在荒芜平台,梯度方差随 $n$ 指数消失;二是计算可行性,精确模拟 $n$ 比特纯态需要 $2^n$ 个振幅,在十亿参数模型内对每个 token 反复执行电路代价不可接受。此外手工固定电路无法响应每个 token 的上下文表示,天然缺乏 token 级适应性。
本文的目标是本文要检验一个此前无人测过的架构问题:把 token 条件化的量子电路层并联到冻结的掩码扩散语言模型内部后,电路宽度(比特数 $n$)从 16 增至 32 再到 64,语言模型质量是否持续提升?为使这一宽度扫描成立,必须同时满足三个约束:(1) 可训练性——电路坐标的梯度方差不随 $n$ 衰减;(2) 计算可行性——期望值读出不必构建 $2^n$ 状态向量,能在 1.1B 参数骨干内对每个 token、每个 transformer 块实时求值;(3) token 自适应性——电路随每个 token 的隐状态变化,而非全输入共用一个手工设计。最终量化目标是在标准六基准(ARC-e、HellaSwag、PIQA、BoolQ、RACE、GSM8K)零样本平均上,让 64 比特版本超过冻结骨干(49.59)和同骨干 LoRA 基线(50.63),并只用基线十分之一的微调数据(2 万对 vs 20 万对)逼近乃至超过 8 倍大的经典模型(Qwen3-8B 53.79、LLaDA-8B 53.37)。
与已有工作不同的是,本文的独特切入是把「任务级电路设计/搜索」替换为「token 级连续电路发射」。既有自动电路设计要么在离散结构目录中搜索(量子架构搜索、可微搜索、GFlowNet 逐门采样,每个候选结构还需独立做连续参数优化),要么为固定任务综合一个电路;HyperQ 让超网络把每个 token 的隐状态直接映到连续坐标空间中的一个点,坐标为零即删去对应门,$2^{2n}$ 个子图都成为同一连续图册内的坐标超平面,结构与参数在同一端到端目标下联合训练。配套的第二个独特点是用两个结构性约束换取可行性:把电路限制在严格 IQP 族(权重 $\le2$ 生成元)并固定骨架边集 $E$(环层+弦层,每比特度恰为 4,$|E|=2n$),从而同时获得 $\Theta(n)$ 的闭式读出与和 $n$ 无关的 $1/48$ 梯度方差。作者还刻意保持定位诚实:因为读出经典高效,全文不声称量子计算优势,只主张「token 条件化电路发射是一种可处理的架构偏置」——这种自我限定在以往量子 NLP 工作中并不多见。
核心方法
直觉上,HyperQ 在冻结的 LLaDA-1.1B(22 个 transformer 块)的每个块内,给融合 QKV 投影 $W_{qkv}$ 并联一个可训练的量子残差分支:token 的隐状态决定它自己的一个量子电路,电路的 $n$ 个测量期望值经低秩投影后作为残差加回 $q,k,v$。技术路线上,隐状态 $h\in\mathbb{R}^{2048}$ 先经秩 16 降投影 $W_A$ 得到编码 $b$,由三个头发射该 token 专属坐标 $(\alpha,\omega_E,\psi)$;执行 $U(\psi)\,C(\alpha,\omega)$,其中 $C=H^{\otimes n}D(\alpha,\omega)H^{\otimes n}$ 是严格 IQP 块(对角内部含单比特 $R_z(\alpha_q)$ 与固定边集 $E$ 上的 $R_{zz}(\omega_e)$,寄存器视角下经 Hadamard 共轭实为 $R_x/R_{xx}$),$U(\psi)$ 把每个比特的测量轴转到 $S^2$ 上的自适应方向;测得 $z_q=\langle Z_q\rangle$ 后经 $\Delta=rs\,W_Bz$ 注入 2560 维($2048+2\times256$)的 QKV 残差。可行性支柱是闭式读出 $z_q=\bigl(\psi_{q,z}\cos\alpha_q-\psi_{q,y}\sin\alpha_q\bigr)\prod_{k\in N(q)}\cos\omega_{qk}$:每 token 只需 $\Theta(n)$ 次乘法,反向传播用前缀/后缀乘积表同为 $\Theta(n)$。骨干全程冻结,只训练 22 个分支,用掩码扩散目标端到端优化。
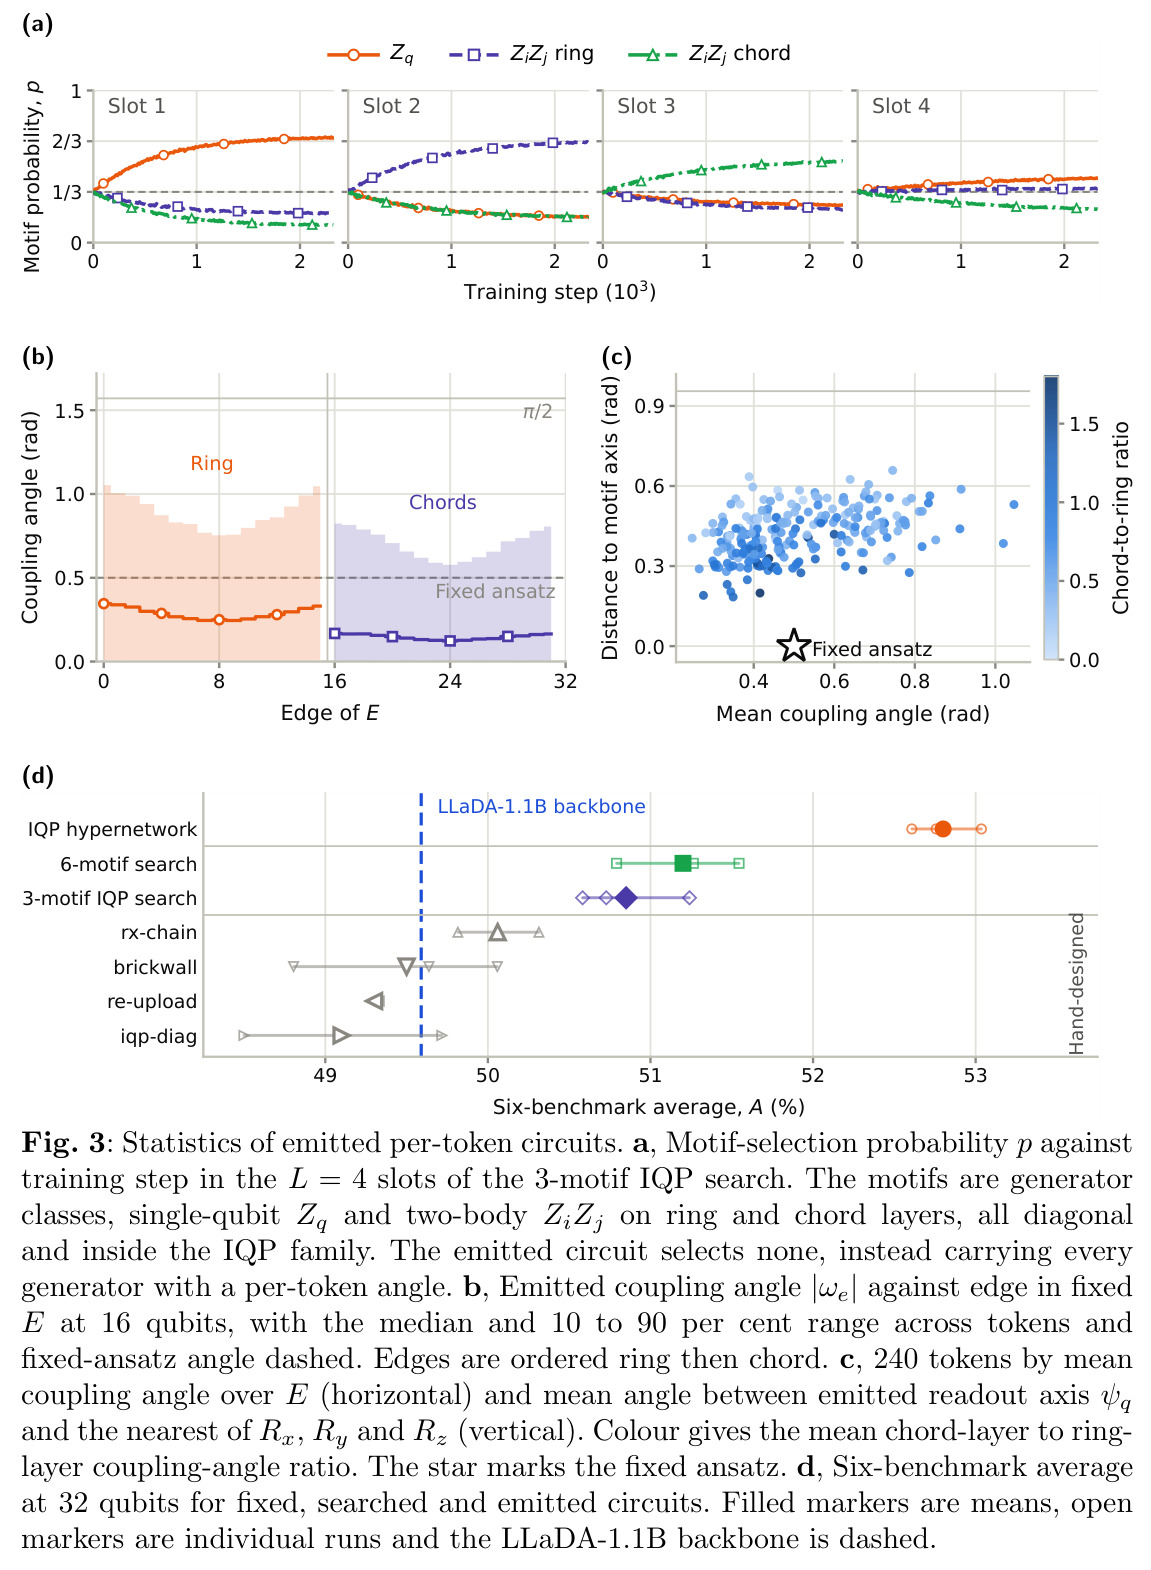
核心创新 = 「token 条件化连续电路发射」+「度数固定的可扩展电路族」,二者缺一不可。与已有方法的本质区别:此前的量子-Transformer 混合方案要么全输入共用一个手工 ansatz(固定角度、固定测量轴),要么用离散架构搜索在有限目录中选 motif 再单独优化参数(3-motif IQP 搜索每 token 只有 $3^4=81$ 种架构可选,6-motif 搜索可离开 IQP 族);HyperQ 让每个 token 在同一骨架 $E$ 上占据连续坐标空间的任意点,发射即前向、梯度自动回传,无需参数移位规则或采样估计器。固定边集(环层+固定步长弦层,每比特恰好 4 条耦合边,$|E|=2n$)源自一个新洞察:在这个两体 IQP 族内,梯度方差 $\frac13 2^{-\mathrm{deg}(q)}$ 由连接度而非比特数决定——度固定为 4 时方差恒为 $1/48$(16/32/64 比特皆然),而同样的族放到全连接骨架上度为 $n-1$,64 比特时方差 $4\times10^{-20}$,彻底荒芜。发射的耦合角还被压在 $(-\pi/2,\pi/2)$ 内($\omega_{\max}=1.2$ 弧度),避免某条耦合趋于 $\pi/2$ 时把同一比特上其余三条耦合的梯度压死(实测从 0.385 压到 $3.7\times10^{-5}$)。
方法步骤详情
第一步,前传取隐状态:掩码序列 $x^t$ 经冻结骨干到达第 $\ell$ 块,取出每个 token 的 $h\in\mathbb{R}^{2048}$。第二步,发射坐标:$b=W_Ah$(秩 16);单比特角 $\alpha=\pi\tanh b$ 限幅于 $(-\pi,\pi)$;耦合头输出 $\omega_E=\omega_{\max}\tanh(W_\omega b)$,$\omega_{\max}=1.2$;测量轴头输出每比特 2 个坐标映到 $S^2$($x$ 分量不出现在读出中,第三个坐标不可辨识)。每 token 共发射 $n+|E|+2n=5n$ 个实数,16/32/64 比特对应 80/160/320 个。第三步,执行电路:初态 $|0\rangle^{\otimes n}$,依次过 $H^{\otimes n}$、对角内部 $D(\alpha,\omega_E)$、$H^{\otimes n}$、读出旋转 $U(\psi)$;生成元集 $G=\{Z_q\}\cup\{Z_iZ_j\}_{(i,j)\in E}$ 两两对易,块非通用、仅当角度为 $\pi/2$ 整数倍时是 Clifford。第四步,闭式读出:$z_q=(\psi_{q,z}\cos\alpha_q-\psi_{q,y}\sin\alpha_q)\prod_{k\in N(q)}\cos\omega_{qk}$,前向 $\Theta(n)$;反向用前缀/后缀乘积表,同为 $\Theta(n)$ 且避免除以可能为零的余弦。第五步,残差注入:$\Delta=rs\,W_Bz$ 加到冻结的 $W_{qkv}h$ 上产生 $q,k,v$。第六步,训练:仅优化分支,损失为掩码交叉熵 (1);AdamW($\beta_1=0.9,\beta_2=0.95$,零权重衰减)、24 步 warmup 后峰值学习率 $2\times10^{-4}$、余弦调度、梯度范数裁剪 1.0、3 epoch、有效批 256、bf16,8×A100 80GB;20,000 对指令数据(基线的 1/10),每 epoch 78 步共 235 步,处理 $6.1\times10^7$ token。第七步,推理与硬件迁移:每 token 的编译电路在固定门数/深度预算下综合,骨架 $E$ 按宽度一次性路由到 IBM 156 比特超导芯片 ibm_quebec 的耦合图(无需逐 token 路由),经 Qiskit Runtime EstimatorV2 以 10,000 shots 执行,每基准 256 项做配对对比。
技术新颖性
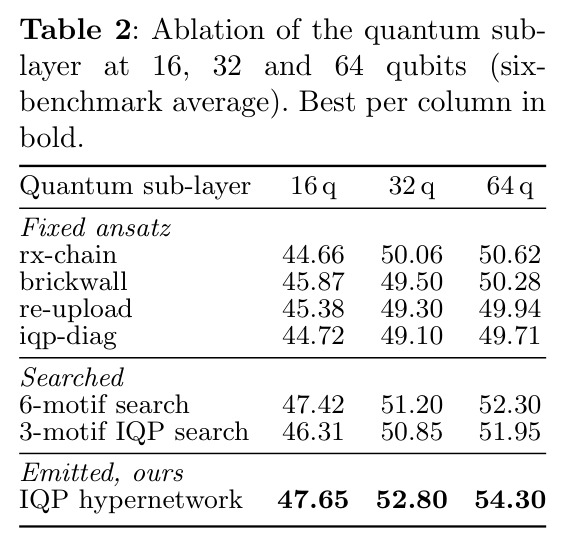
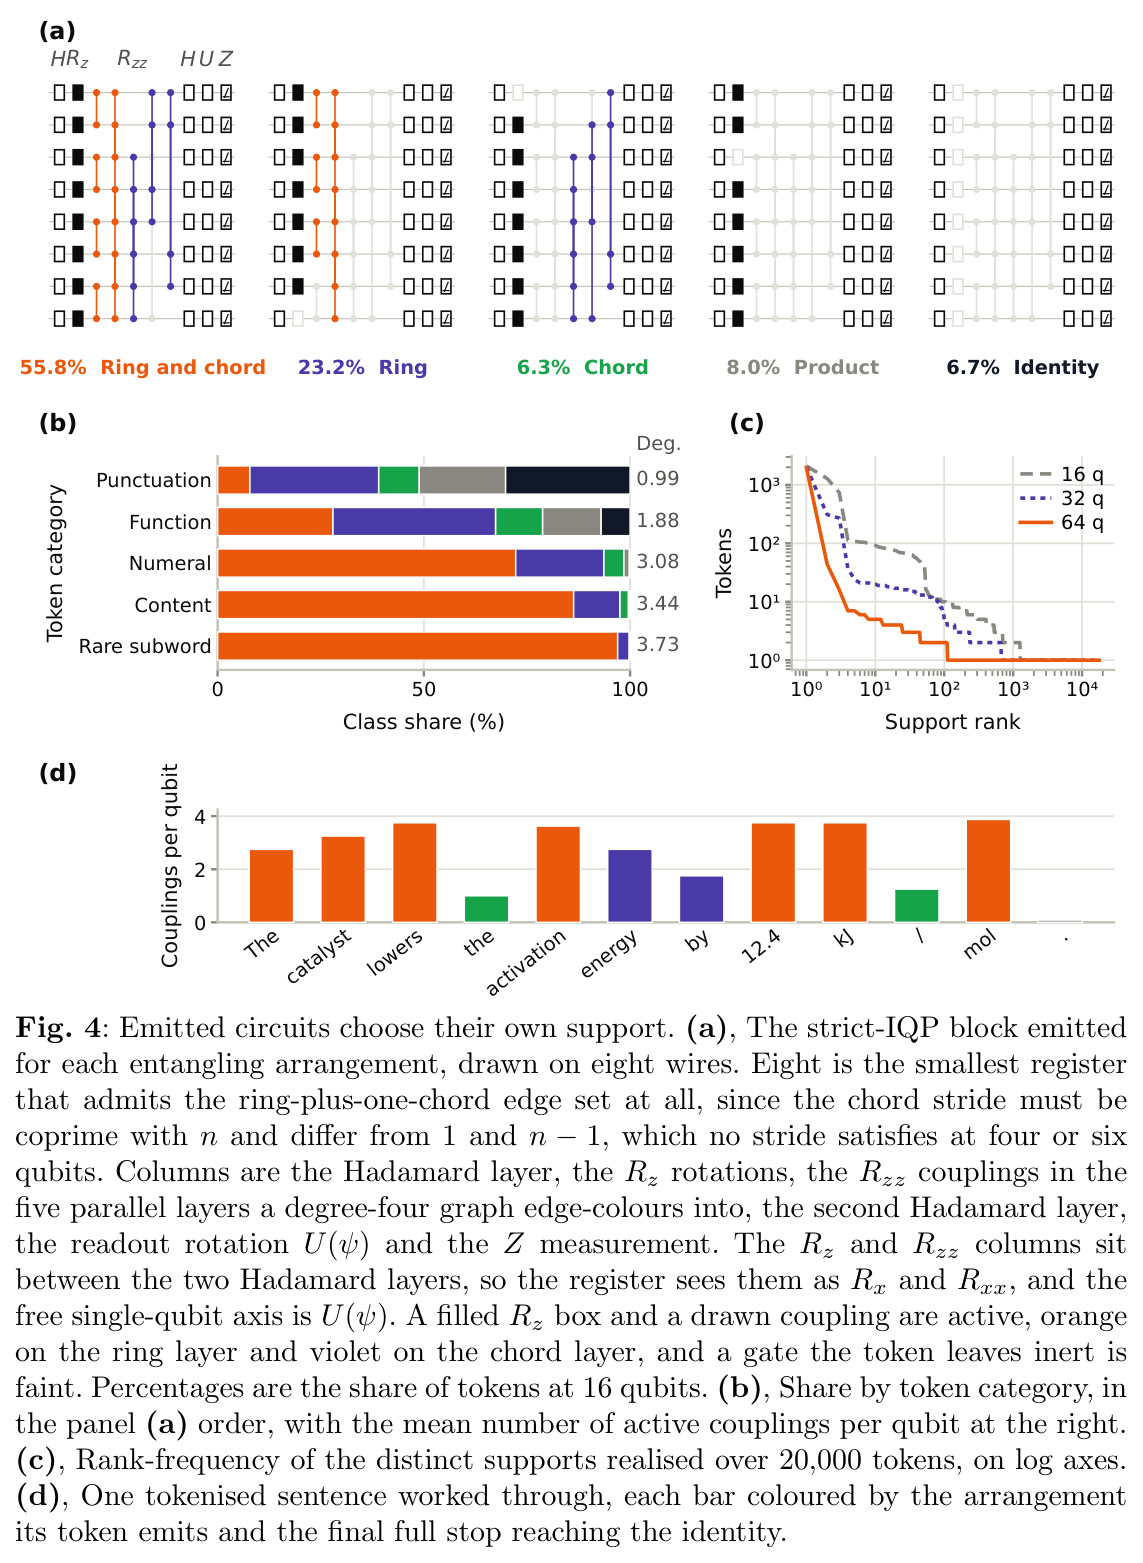
第一,据作者所述这是首次在语言模型内部做量子电路宽度扫描(16→64 比特),而非在固定资源点做一次性评估,直接回应了「比特变多是否有用」这一悬置问题。第二,把电路自动设计从「离散结构选择 + 连续参数优化」的两阶段范式改为单阶段连续发射:消融证明仅这一改动就超过能离开 IQP 族的 6-motif 搜索(54.30 vs 52.30),也超过同结构的固定 iqp-diag 达 4.59 点,且优势随宽度扩大(1.78→2.74→3.68)。第三,给出两体 IQP 族梯度方差的解析刻画 $\mathrm{Var}=\frac13 2^{-|N(q)|}$,把荒芜平台的成因归结为连接度而非比特数,并在 $n=4$ 到 8 上用暴力态矢量验证了公式 (5)(6);这与「多项式维动力学 Lie 代数(这里维数 $3n$)下无可训练性障碍与经典可模拟性可以共存」的理论 (Cerezo 等) 相互印证。第四,工程上是首次在十亿参数模型内对每 token、每块求值 64 比特电路:闭式读出 + JAX/TensorCircuit-NG 的 XLA trace 与 vmap 批处理(免去逐 token Python 循环)+ 固定骨架单次路由,使激活内存随 $n$ 线性增长而每次调用延迟基本持平(Fig 5c:16→64 比特内存项乘 4.00、全连接则乘 16.8)。第五,纠缠能力有量化保障:8 比特寄存器平衡割上平均 2.65 比特纠缠熵(上限 4,Schmidt 秩满 16),而全惰性时塌缩为 0——说明发射的耦合确实产生纠缠而非退化。
实验结果
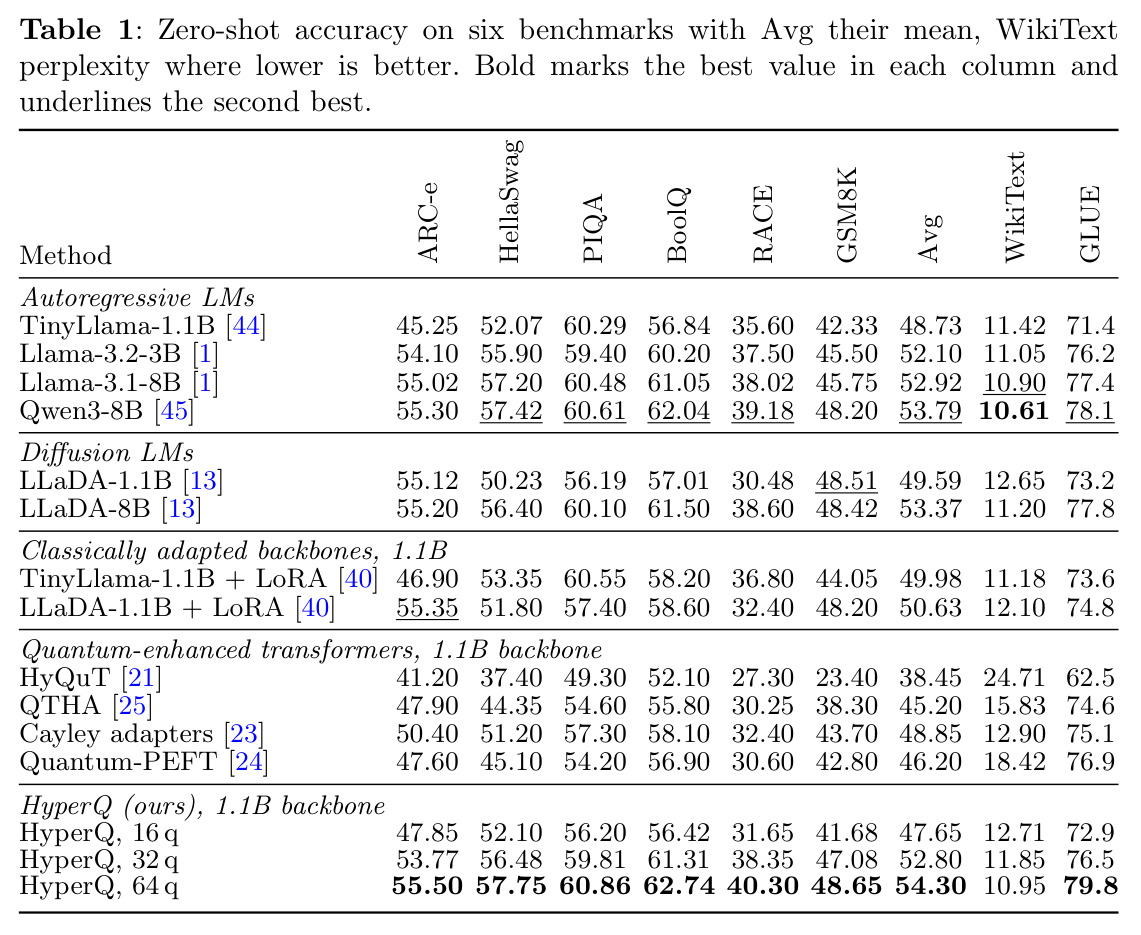
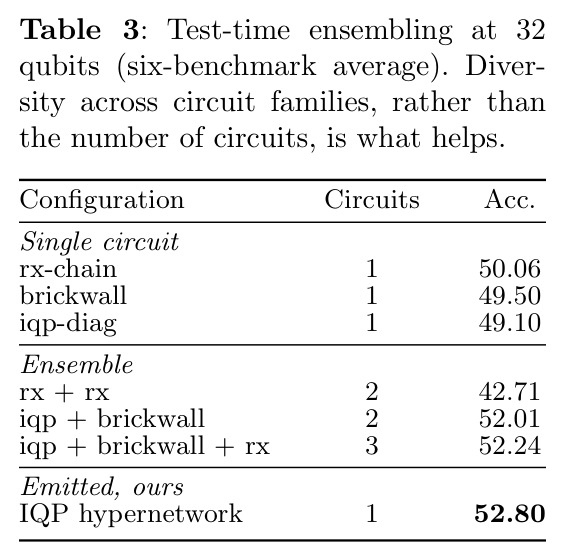
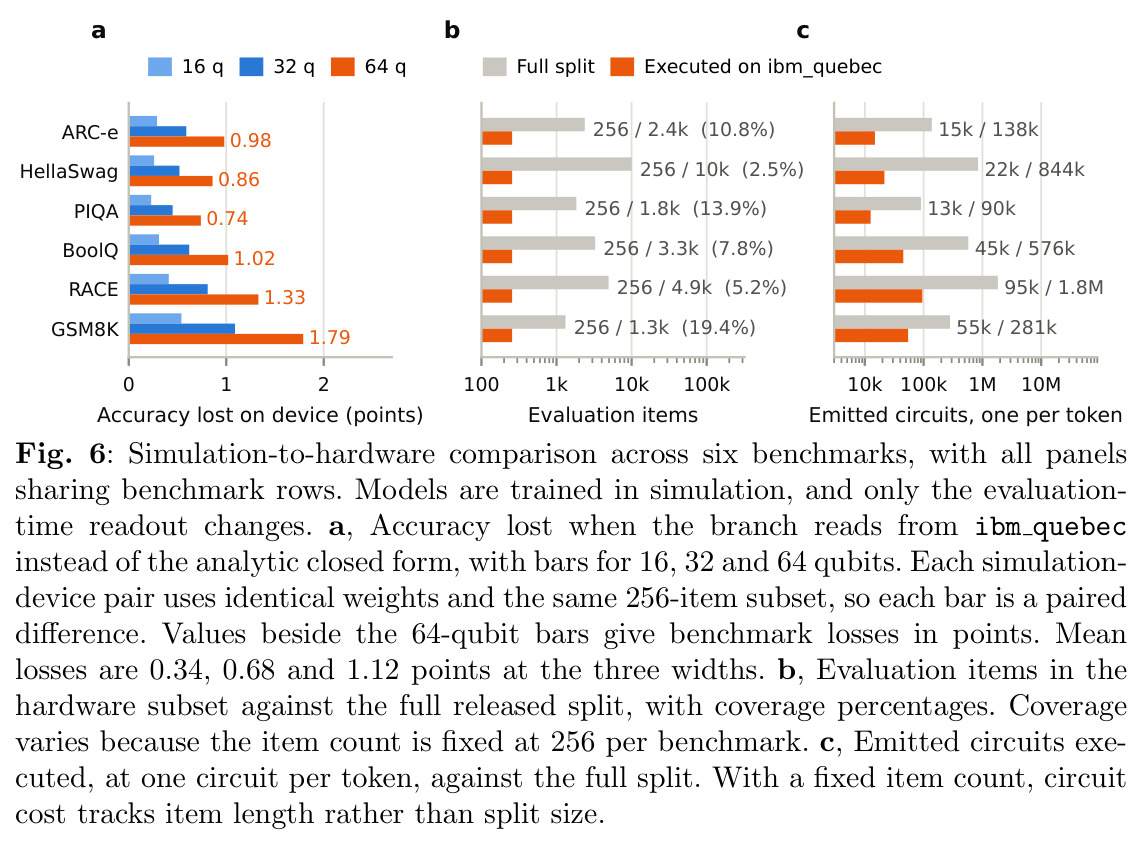
主结果(Table 1):六基准零样本平均随宽度单调上升——16 比特 47.65、32 比特 52.80、64 比特 54.30。64 比特超冻结 LLaDA-1.1B 骨干(49.59)+4.71 点、超同骨干 LoRA(50.63)+3.67 点,也超过 Qwen3-8B(53.79)、LLaDA-8B(53.37)、Llama-3.1-8B(52.92),而微调只用了 2 万对(基线 20 万对的十分之一)。交叉点约在 $n\approx21$:16 比特时 47.65 低于冻结骨干,收益只在变宽后出现。逐基准增益集中在 RACE +9.81、HellaSwag +7.52、BoolQ +5.73、PIQA +4.67,ARC-e +0.38 与 GSM8K +0.14 接近中性;唯一没赢的列是 WikiText 困惑度(10.95 vs Qwen3-8B 的 10.61)。消融(Table 2):发射路线在每个宽度都最优,64 比特上对最佳固定 ansatz rx-chain(50.62)+3.68、对 6-motif 搜索(52.30)+2.00、对 3-motif IQP 搜索(51.95)+2.35;对同 HDH 结构但手工定角的 iqp-diag 优势为 2.93/3.70/4.59,超过固定族之间约 1 点的总离散度。32→64 比特区间内最佳固定仅 +0.56、搜索 +1.10、发射 +1.50——固定电路饱和而发射持续受益。测试时集成(Table 3):32 比特下最佳三电路集成 52.24 仍不及单个超网络一次前向的 52.80,说明 circuit 多样性本身不如 token 条件化。电路行为(Fig 3/4):16 比特下发射耦合角按边的中位数 0.12–0.35 弧度、低于固定值 0.5;读出轴偏离最近 Pauli 轴 0.18–0.66 弧度(理论上限 $\arccos(1/\sqrt3)=0.955$),无 token 落在任何 Pauli 轴上。仅 6.4%(16 比特)到 0.1%(64 比特)的 token 保留全部 $2n$ 条边,平均每比特保留 2.58/4 条耦合;五类支撑占比为 Ring+chord 55.8%、Ring 23.2%、Chord 6.3%、Product 8.0%、Identity 6.7%;每比特活跃耦合数随词类递增:标点 0.99、功能词 1.88、数词 3.08、实词 3.44、稀有子词 3.73,标点 token 有 30.2% 走 Identity;20,000 个 token 中 16 比特有 9,130 个、64 比特有 17,778 个独占支撑。硬件迁移(Fig 6):在 ibm_quebec 上把解析读出换成真实测量(同权重、同 256 项配对),六基准平均掉 0.34/0.68/1.12 点(16/32/64 比特),GSM8K 掉最多(64 比特 1.79)、PIQA 最少(0.74);读出偏差从 $1.17\times10^{-2}$ 升到 $2.43\times10^{-2}$(shot 底噪 $1.0\times10^{-2}$)。继承能力(Fig 7):置信度顺序去掩码最佳;自回归基线在反序 QA 与 infilling 上大幅崩塌而扩散系模型稳定;每步并行提交更多 token 时 HyperQ 比骨干退化更慢。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六基准零样本平均(ARC-e/HellaSwag/PIQA/BoolQ/RACE/GSM8K) | 平均准确率 (%) | 54.30(64 比特);52.80(32 比特);47.65(16 比特) | 冻结 LLaDA-1.1B 49.59;LLaDA-1.1B+LoRA 50.63;Qwen3-8B 53.79;LLaDA-8B 53.37 | 对同骨干 +4.71、对 LoRA 版 +3.67、对最大经典对手 Qwen3-8B +0.51 点,且微调数据仅为基线 1/10 |
| 量子子层消融(64 比特同宽度) | 六基准平均 (%) | IQP 超网络(发射)54.30 | 最佳固定 ansatz rx-chain 50.62;6-motif 搜索 52.30;3-motif IQP 搜索 51.95 | +3.68 / +2.00 / +2.35 点;且该优势随宽度从 1.78 扩大到 3.68 |
| WikiText 困惑度 | PPL(越低越好) | 10.95(64 比特) | Qwen3-8B 10.61;LLaDA-8B 11.20;冻结骨干 12.65 | 对所有 1.1B 模型最优(骨干 12.65→10.95),但未超过 8B 自回归最佳,是唯一落败列 |
| GLUE | GLUE 分数 | 79.8(64 比特) | Qwen3-8B 78.1;LLaDA-8B 77.8;冻结骨干 73.2 | 对同骨干 +6.6 点,对最强 8B 经典模型 +1.7 点 |
| 模拟→硬件迁移(ibm_quebec,每基准 256 项配对评估) | 六基准平均准确率下降(点) | 64 比特平均掉 1.12 点(GSM8K 最多 1.79,PIQA 最少 0.74) | 同一权重的解析闭式读出 | 16/32 比特仅掉 0.34/0.68 点,表明大部分性能可在含噪真实硬件上保留 |
| 测试时电路集成对比(32 比特) | 六基准平均 (%) | 单个 IQP 超网络 52.80(一次前向) | 最佳三电路集成 iqp+brickwall+rx 52.24 | +0.56 点:电路族多样性的收益不如 token 条件化发射本身 |
局限与改进
作者明确承认的局限有四条。其一,不声称量子计算优势:读出经典可高效模拟,$\Theta(n)$ 闭式与多项式维 Lie 代数并存正对应「可训练性与经典可模拟性同源」的理论结果,因此这只是架构结果而非计算结果。其二,梯度方差 $1/48$ 只刻画初始时刻电路坐标的统计,不刻画冻结骨干,也不解释为何下游精度随宽度上升——即「为什么有用」没有机制性答案。其三,三个宽度上的持续改进不构成 scaling law,更宽处可能饱和。其四,硬件验证是受控小规模实验:每基准仅 256 项、只做推理不做硬件原生训练。我自己的观察补充如下:第一,存在 $n\approx21$ 的交叉点,16 比特(47.65)低于冻结骨干(49.59),说明该方法有最小规模门槛,窄寄存器场景不适用;第二,闭式读出只提取单比特期望 $\langle Z_q\rangle$,尽管 8 比特寄存器实测平均 2.65 比特纠缠熵,纠缠如何转化为语言收益缺少解释;第三,与既有量子模型的比较依赖作者在统一协议下的复现数字(HyQuT 38.45、QTHA 45.20 明显偏低),原始论文并无公共基准,公平性依赖复现质量;第四,64 比特下仅 0.1% 的 token 保留全部边、平均每比特只用 2.58/4 条耦合,实际起作用的支撑远小于名义宽度,高宽度的边际收益与内存开销(随 $n$ 线性)之间的性价比值得怀疑;第五,GSM8K 上增益几乎为零(+0.14)且硬件掉分最大(1.79 点),多步推理能力未随宽度提升。
独立分析的弱点
弱点一:收益机制不明。精度为何随 $n$ 上升没有任何解释(作者自己承认方差结果不回答此事),存在「量子读出只是多了一组可训练特征」的替代假说。改进方向:做经典对照消融——把闭式读出替换为同维随机非线性投影或可微模拟的「经典两体特征」,若增益消失则可归因于电路结构本身。弱点二:整条可行性被锁死在两体 IQP 闭式解上。一旦引入权重 $\ge3$ 生成元或非对易旋转(如把 $R_y$ 插进对易内部),乘积形式失效、代价回到 $2^n$;固定读出 Pauli 轴也已被证明劣于发射轴。改进方向:利用骨架的有界树宽探索张量网络近似(MPS/切割收缩)来支撑非对易或三体族,或采用「关键层用宽电路、其余层用窄电路」的混合预算。弱点三:每 token 一电路的执行开销在真实硬件上巨大——RACE 的 256 项子集就要执行 95k 条电路(全量 1.8M),逐 token 顺序执行延迟不可行。改进方向:对相似隐状态的 token 聚类共享电路、批量并行提交、或缓存高频 token 的电路坐标。弱点四:训练信号单一,只有掩码交叉熵,分支可能退化为昂贵的低秩特征映射。改进方向:加入辅助正则(最大化读出方差、支撑选择熵)或对比目标,并分析读出的可解释性。弱点五:数据协议不对称——HyperQ 用 20k 对而经典基线用 200k 对,虽然此设置对 HyperQ 不利、结论更保守,但也使「每个数据点的效率」这一卖点无法与「HyperQ+200k」的饱和曲线区分。改进方向:补一条 HyperQ 在 200k 对上的曲线。弱点六:状态读出与硬件噪声的敏感度不均——GSM8K 在 64 比特掉 1.79 点而 PIQA 仅 0.74,生成式输出对读出误差累积更敏感,提示需要噪声感知训练或错误缓解。
未来方向
作者提出的方向有二。其一,把「架构结果」升级为「计算结果」:寻找恒定深度量子电路可采样、但恒定轮数扩散语言模型可证明无法采样的分布(文中引用的 [47]),在其上构造任务并直接检验分离,但这要求离开当前可对易族并放弃闭式读出。其二,硬件原生训练——目前硬件只用于推理验证。基于本文成果可自然延伸的方向:第一,宽度超过 64 的扫描以确认或否定饱和,并尝试度数为 6/8 的骨架(方差 $\frac13 2^{-d}$ 仍解析、仍可检验),绘制「度—宽—性能」三维相图;第二,把发射机制迁移到自回归骨干、多模态编码器或语音/蛋白质序列模型,检验 token 条件化发射是否是架构无关的通用偏置;第三,把读出从一阶期望 $\langle Z_q\rangle$ 扩展到两体关联 $\langle Z_qZ_r\rangle$(仍是两体量,可能保有低多项式代价或借助骨架结构的高效收缩),增加读出信息量;第四,对发射支撑做因果性可解释研究——本文已发现每比特活跃耦合数随词类从标点 0.99 单调升到稀有子词 3.73、标点 30.2% 走 Identity,可进一步干预词类与位置验证因果关系;第五,噪声感知训练与错误缓解(如读出矫正、零噪声外推)缩小 sim-to-real 的 1.12 点差距,并测试更高噪声率的设备;第六,研究读出维度随 $n$ 增长时的经典下界,界定「量子分支至少提供了什么经典网络不易提供的统计量」。
复现评估
复现信息相当充分但未附公开代码链接(截至论文文本未见仓库)。有利因素:所有数据公开(ARC-e、HellaSwag、PIQA、BoolQ、RACE、GSM8K、WikiText、GLUE 及 LLaDA 的 SFT 语料协议,HyperQ 用其 2 万对均匀子集);骨干 LLaDA-1.1B 开源;核心数学全部给出闭式——电路定义 (2)、读出闭式 (5)、梯度方差 (6),且作者在 $n=4..8$ 上用暴力态矢量验证过,为正确性自检提供了路径;实现细节罕见地完整:8×A100 80GB SXM 单节点、bf16、AdamW $\beta_1=0.9/\beta_2=0.95$、峰值学习率 $2\times10^{-4}$ 余弦调度、24 步 warmup、梯度裁剪 1.0、3 epoch、有效批 256、LoRA $r=16/s=32$/dropout 0.05、seed 3407、序列上限 1024、$T=128$ 去噪轮、$\omega_{\max}=1.2$ 弧度、每 epoch 78 步共 235 步、$6.1\times10^7$ token。仿真栈为 TensorCircuit-NG + JAX(XLA trace + vmap),硬件栈为 Qiskit Runtime EstimatorV2、10,000 shots、ibm_quebec/ibm_brisbane。困难因素:需要 1.1B 骨干前传 + 分支训练的 8 卡 A100 级算力;硬件部分需要 IBM Quantum 配额(每个基准子集要执行 1.3 万到 9.5 万条电路,全量则到 28 万—180 万条);只报 3 个 run 的均值、未给方差细节;六个基准均值是作者定义的聚合口径。总体评估:对同时具备量子线路模拟(TensorCircuit/PennyLane)与大模型微调经验的团队,仿真部分中等偏难、约数周工作量;硬件复现受配额限制,难度高。
论文图表
从骨干继承的能力验证。a:三种解码顺序下的六基准平均——置信度顺序去掩码最佳,自回归基线只在从左到右位置有定义。b:顺序敏感探针——自回归模型在反序问答和文本填充上崩塌,两个扩散模型保持稳定且 HyperQ 全程最强。c:每次前向并行提交 token 数增多时精度下降,但 HyperQ(64 比特)比骨干退化更慢。d:64 比特下逐基准相对骨干的增益:RACE +9.81、HellaSwag +7.52、BoolQ +5.73、PIQA +4.67、ARC-e +0.38、GSM8K +0.14。
它证明量子分支没有破坏掩码扩散骨干的核心卖点(双向任意顺序解码、并行提交的吞吐换挡),同时给出增益的任务分布——这对判断方法适用于哪类任务是必要的。