Tree-Ising:用比特级伊辛编辑修复语言模型 Tree-Ising: Repairing Language Models with Bit-Level Ising Edits
将模型修复化为每行一个Ising问题,0.9美元完胜89.7M token的agent修复
前置知识
QUBO 与 Ising 模型
QUBO(二次无约束二值优化)在0/1变量 $x_a\in\{0,1\}$ 上最小化 $E(x)=\sum_a h_a x_a+\sum_{a\neq b}J_{ab}x_ax_b$;做代换 $s=2x-1$ 即得自旋为 $\pm1$ 的Ising模型, $H_a=\tfrac12 h_a+\tfrac12\sum_{b\neq a}J_{ab}$ , $I_{ab}=\tfrac12 J_{ab}$ 。这类问题没有梯度可用,需专用启发式求解器。
本文把每个输出行的权重复修精确分解成一个独立的行级QUBO/Ising问题,整个方法(目标函数、求解器、量子实验)都建立在这一形式之上,不懂QUBO就无法理解第3.4-3.5节。
BF16 浮点格式与状态树(state tree)
BF16由1位符号、8位指数 $e$、7位尾数组成。状态树把每64个连续权重分为一组,组内共享一个8位最大指数节点 $E$,每个权重只存4位状态 $D=E-e\in\{0,\dots,14\}$ 和含符号与尾数的叶节点(状态15是记录在侧表中的罕见逃逸)。这种表示可无损还原每个权重。
本文的可允许编辑动作(符号翻转、指数移位)是相对状态树定义的:只要不改变组最大值,共享指数节点就永远不被改写,比特改动量可以直接从树上读出,这是全文格式原生保证的基础。
推理循环(reasoning loop)失败模式
小尺寸推理模型在思考模式下会陷入短文本循环,重复生成已有内容直到撞上token上限。Qwen3.5-0.8B在32,768 token上限下有93%的MATH-500答案被截断,准确率仅7.9%;Qwen3.5-2B在greedy解码下77.9%的GSM8K生成被截断。判断循环的标准是尾部至少80%的8-gram重复。
这是本文要修复的具体失败模式:文中所有方向、token集合(R/P/Z/M)、剂量目标都是围绕『循环被触发』与『成功收尾』两类轨迹定义的。
模拟退火(SA)与模拟分裂(simulated bifurcation, SB)
模拟退火对每个自旋做Metropolis单翻转,温度从高到低几何下降以逃离局部最优;模拟分裂(dSB)是量子启发的经典Ising求解器,用耦合的分叉振子哈密顿动力学演化,从振子符号读出自旋,最后做单翻转下降精修。两者都能在GPU上把成千上万个小规模Ising问题批量并行。
本文两层模型共产生2,048个512自旋的行问题,默认用GPU退火16副本300次扫描求解,SB作为对照求解器;论文证明两种求解器结果统计不可区分,说明收益来自形式化本身。
QAOA(量子近似优化算法)
QAOA在量子处理器上制备 $p$ 层参数化线路,交替施加问题哈密顿量与混合哈密顿量,角度经经典优化后采样测量;理论上大 $p$ 时逼近组合优化最优解。当前硬件只够处理十几到几十个变量的实例。
第6节用IBM Heron处理器对一个从修复目标中提取的8变量子问题跑深度2的QAOA,110/1024 shots命中精确最优(均匀对照仅4次),是修复问题接入量子硬件的概念验证。
残差流方向与激活引导(activation steering)
Transformer每层向残差流写入向量;把循环token与正常token的平均残差做差并归一化,可以得到一个刻画『循环行为』的线性方向,类似的对比方向也可刻画『收尾行为』。引导类方法在推理时往残差流加减方向向量,而本文把干预折叠进权重。
本文的循环方向 $u_{\mathrm{loop}}$、收尾方向 $u_{\mathrm{end}}$ 及其组合方向 $u$ 全部由这类前向统计构造,是优化目标的灵魂;理解方向的来源才能理解剂量与附带损害的含义。
研究动机
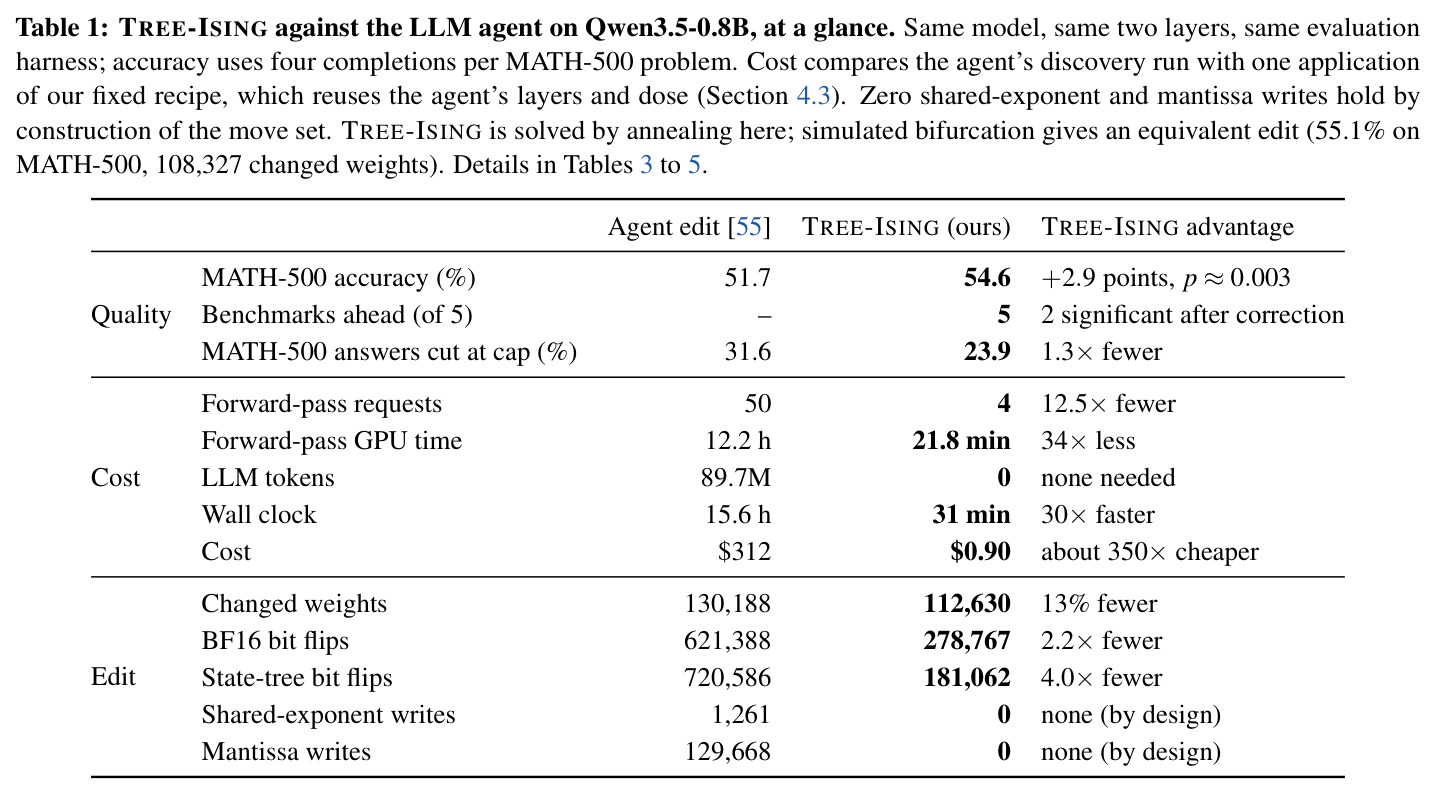
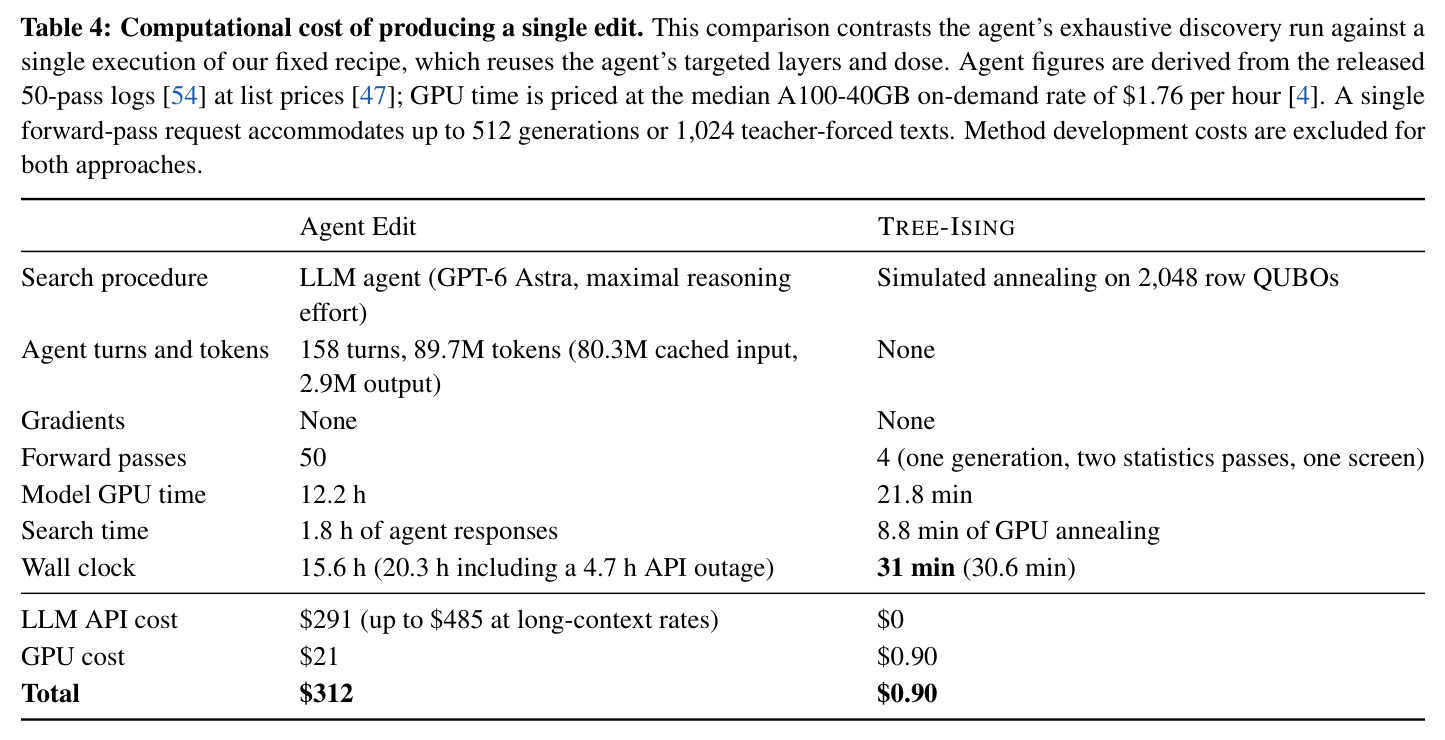
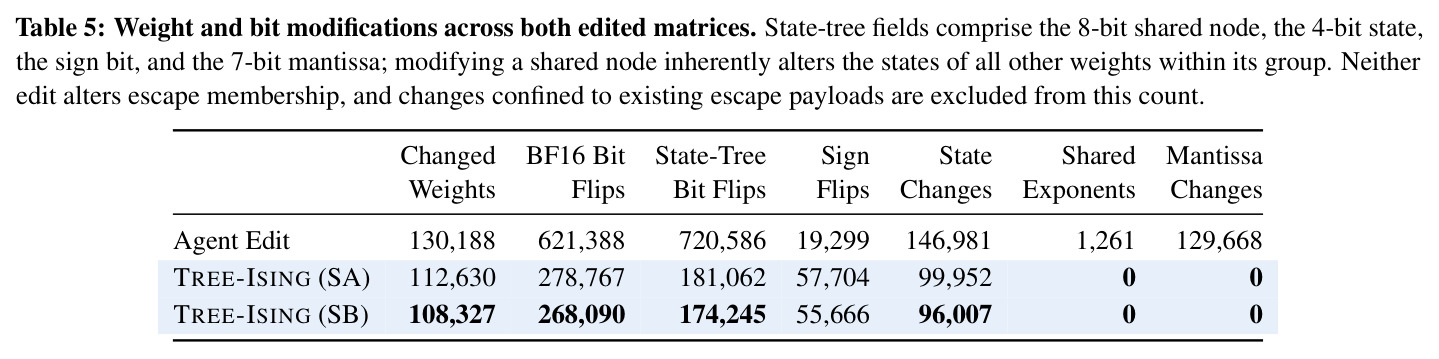
Qwen3.5-0.8B在思考模式下存在严重推理循环:93%的MATH-500答案会一直重复文本直到撞上32,768 token上限,准确率只有7.9%。MIT的Takehi等人展示了『权重空间编程』的可行解法:让GPT-6 Astra智能体读取网络权重、在练习题上做前向诊断,最终把循环追溯到第15和19层的MLP输出投影(down_proj),重写每层64列,MATH-500准确率升至48.1%,全程无梯度。但这条路线代价惊人:158轮智能体交互、89.7M token(80.3M缓存输入+2.9M输出)、50次前向请求消耗12.2 GPU小时、总耗时15.6小时、约312美元(早期10次和25次前向的失败尝试还额外烧掉270美元)。更本质的问题是:智能体每一步都依赖自然语言判断,没有任何机制保证写出的编辑是可用编辑中更好的那一个,而且它的稠密改写几乎重写了所有触及权重的尾数并改动了1,261个组内共享指数。
本文的目标是本文要把智能体凭直觉完成的修复改造成一个明确的数学优化问题:在模型原生BF16存储之上寻找稀疏的离散编辑,使目标函数(削弱循环方向、强化收尾方向、保护生产性token上的输出、限制改动量)可被精确求解。量化目标包括:在相同评测协议下超过智能体编辑的MATH-500 51.7%;同时改动更少权重和比特(尤其是零共享指数写入、零尾数写入);把前向请求从50次压到个位数、成本从312美元压到1美元以下;并且配方要能脱离智能体产物,仅凭基座模型自身完成层选择与剂量校准,迁移到更大的Qwen3.5-2B上。
与已有工作不同的是,现有路线要么产生连续权重更新(ROME类知识编辑、方向消融directional ablation),要么用LLM智能体做自然语言决策,二者都与权重存储格式脱节,也无法保证比特级最优。本文的独特切入点是利用状态树表示把无损BF16存储视为特例,从而定义一组『格式原生』的离散动作集合(符号翻转与指数移位),使编辑对共享指数和尾数的零改动成为构造性保证而非经验观察;再将目标函数精确分解为每个输出行一个独立的QUBO/Ising问题,天然接入模拟退火、模拟分裂、量子退火和QAOA这一整套Ising求解生态。这就把『LLM编程权重』改写成了『优化器编程权重』:同样的前向证据,换成了可复算、可求解、可校准的目标。
核心方法
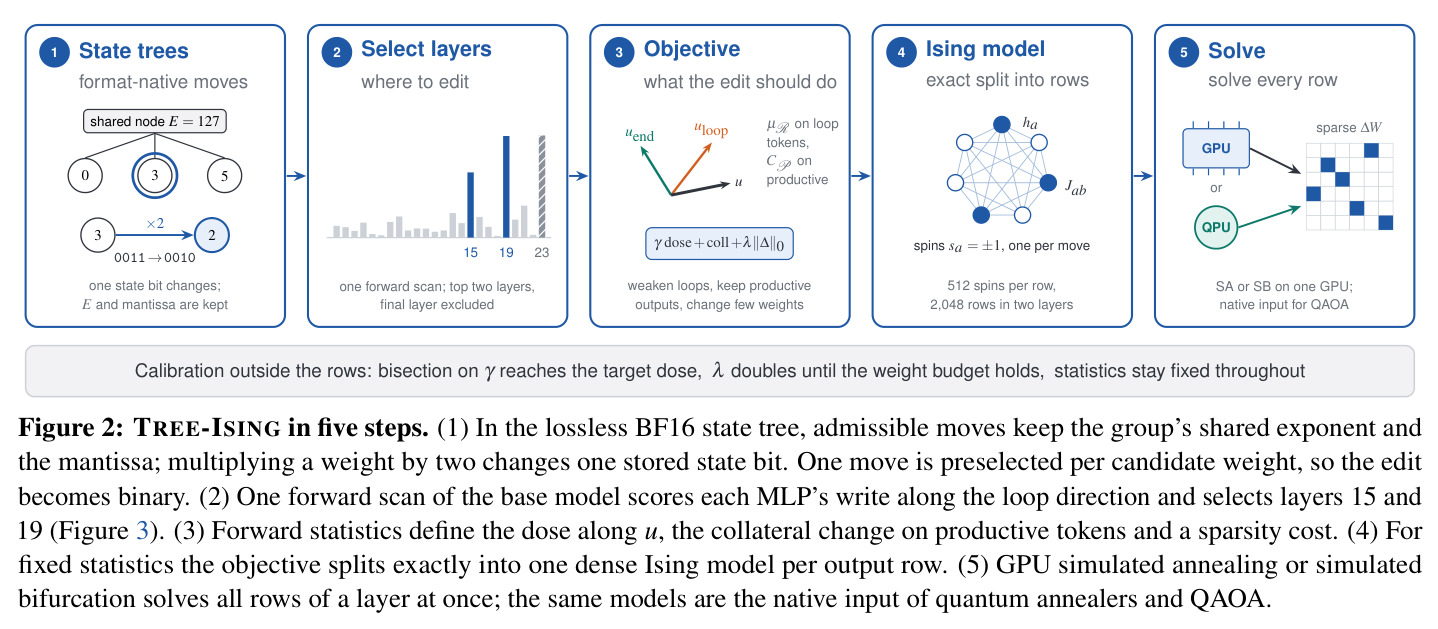
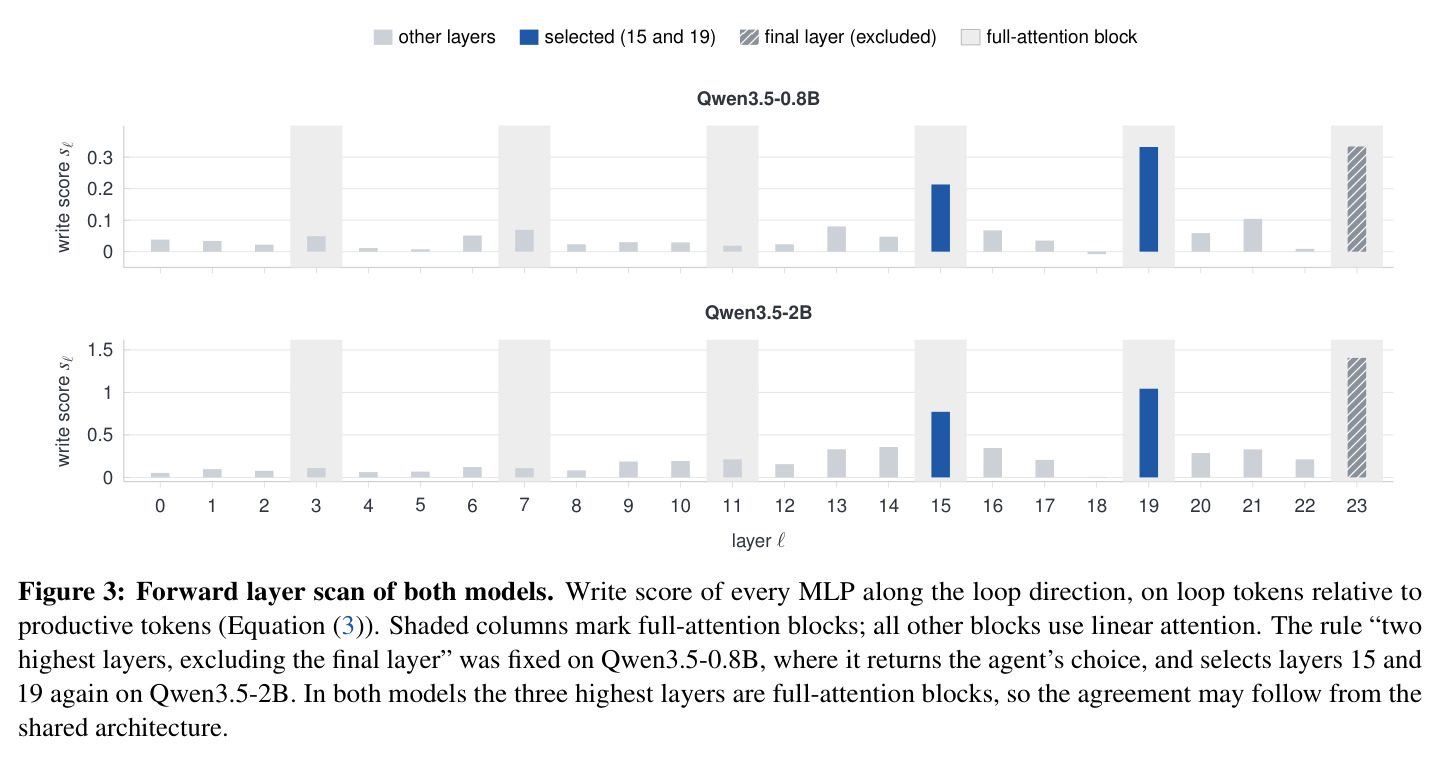
直觉上,循环失败对应残差流中一个稳定的『循环方向』:只要让目标层少往这个方向写、同时多往『收尾方向』写,模型就会停下来给出答案。技术路线分五步(Figure 2):第一步,用无损BF16状态树表示权重,把每个候选权重的编辑限定为乘以集合 $\mathcal{F}=\{-1,2,\tfrac12,4,-2,-4,-\tfrac12,\tfrac14\}$ 中的一个因子,只动符号位和4位状态 $D$;第二步,对基座模型做一次前向扫描,按写分 $s_\ell=u_\ell^\top(\bar m_{\ell,R}-\bar m_{\ell,P})$ 自动选出除末层外得分最高的两层(0.8B和2B都选出第15、19层);第三步,用循环、保护、收尾、继续四类token的前向统计定义目标函数;第四步,每层保留得分最高的 $K=512$ 列、每个权重预选一个动作后,目标精确分解为每行一个512自旋的Ising问题;第五步,两层共2,048个行问题在单张GPU上用模拟退火或模拟分裂批量求解,$\gamma$ 和 $\lambda$ 的校准在行问题之外完成。全程只需4次前向请求,无梯度、无LLM token。
核心创新是『格式原生+精确可分解』的组合。动作集只改符号位和4位状态 $D=E-e$,且增长要求 $D\ge k$、收缩要求 $D\ge1$ 且 $D-k\le14$,保证组最大值不变,因此共享指数与尾数零写入是构造性保证。由于每个权重预选恰好一个动作,编辑变成0/1开关向量 $x_a$,剂量 $u^\top\Delta\mu_R$ 对 $\Delta$ 线性、附带损害 $\operatorname{tr}(\Delta C_P\Delta^\top)$ 二次、稀疏惩罚 $\|\Delta\|_0$ 线性,三者都按行求和,于是对固定统计量目标精确分解为独立行QUBO $E_r(x)=\sum_a h_a x_a+\sum_{a\neq b}J_{ab}x_ax_b$,其中 $h_a=\gamma u_r\mu_{R,j_a}\delta_a+C_{P,j_aj_a}\delta_a^2+\lambda$,$J_{ab}=\delta_a\delta_b C_{P,j_aj_b}$。这把模型修复从梯度训练、连续编辑或LLM即兴改写,统一到了组合优化与Ising求解器的框架下,且行问题规模小(512自旋),经典GPU就足够。
方法步骤详情
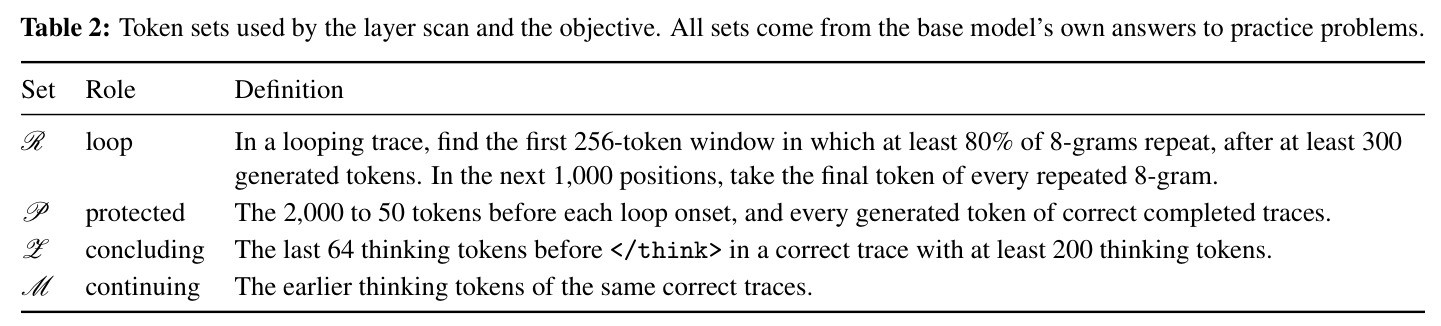
第一步(状态树):64个连续权重一组共享8位指数节点 $E$,每权重存4位状态与符号尾数叶;如0.125($E=127$,$D=3$)翻倍成0.25只改1个存储比特,动作需满足增长 $D\ge k$、收缩 $D\ge1$ 且 $D-k\le14$。第二步(选层):基座对384道练习题各生成一次,按Table 2定义四类token集——R(循环窗口内重复8-gram末token)、P(循环前2,000到50个token及正确答案全部token)、Z(收尾前64个思考token)、M(更早思考token);教师强制前向算写分,取除末层外最高的两层。第三步(目标):$u\propto u_{\mathrm{loop}}-\beta u_{\mathrm{end}}$($\beta=0.5$),最小化 $\mathcal{E}(\Delta)=\gamma u^\top\Delta\mu_R+\mathrm{tr}(\Delta C_P\Delta^\top)+\lambda\|\Delta\|_0$,剂量目标 $-\tau u^\top W\mu_R$(0.8B取agent的1.6倍,$\tau=6.7/6.1$;新模型 $\tau=6.5$)。第四步(行分解):每层保留 $K=512$ 个得分最高列,每权重预选单权重能量最低因子,$h_a=\gamma u_r\mu_{R,j_a}\delta_a+C_{P,j_aj_a}\delta_a^2+\lambda$,$J_{ab}=\delta_a\delta_bC_{P,j_aj_b}$。第五步(求解与校准):SA每行16副本300次扫描、温度从2几何降到 $10^{-4}\times$ 中位 $|h_a|$;dSB用1,200步;$\gamma$ 在 $[10^{-6},10^6]$ 二分到剂量达标,超预算则 $\lambda$ 翻倍重试至多六次(每层预算65,536个权重)。
技术新颖性
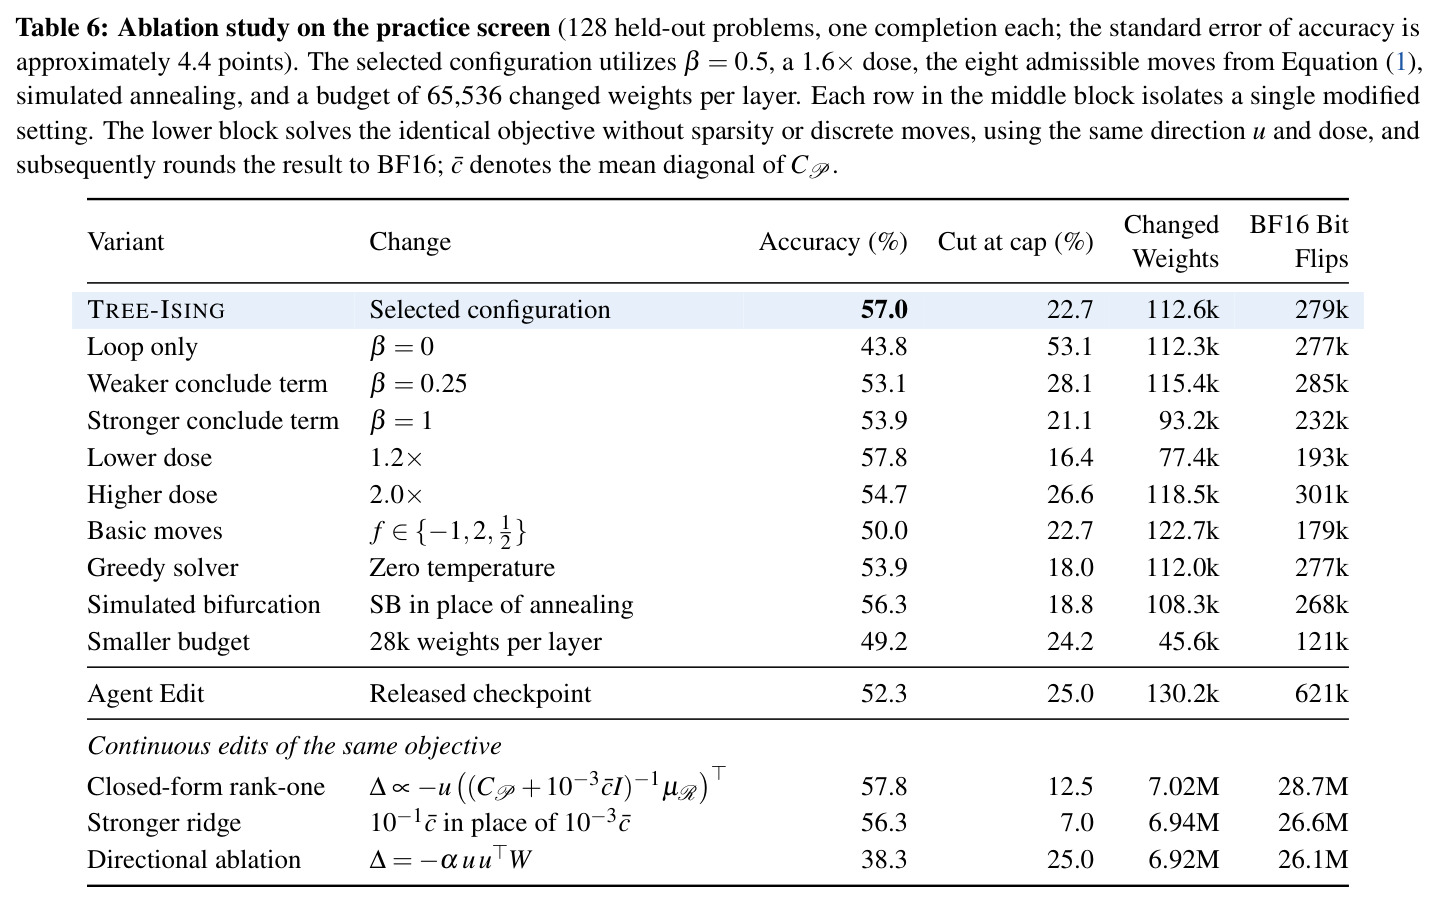
与智能体权重编程的本质区别在于:把agent的三个阶段——定位层、定义目标、搜索修改——分别变成写分扫描、前向统计目标、离散优化求解,全程零LLM token。与AdaRound及Muñiz Subiñas等量化QUBO相比,目标在层输出重建项之外加入了沿行为方向 $u$ 的剂量项,优化的是模型行为而非仅逼近原输出。与ROME类rank-one连续编辑相比,闭式解 $\Delta=-\gamma u(\mu_R^\top C_P^{-1})$ 在同等剂量下屏幕分数57.8%与本文相当,但需改写两矩阵96%的权重(702万次改动、2,870万次BF16位翻转),而Tree-Ising只改112,630个权重(少62倍),且所有改动原生写入存储格式。与bit-flip攻击利用比特敏感性破坏网络相反,本文利用同样的敏感性做精确修复。此外论文用SA与SB两求解器得到统计不可区分的结果(MATH-500上54.6%对55.1%,$p=0.62$),证明收益来自数学形式化而非特定求解器调优;简单贪心求解器则降至53.9%,说明搜索有一定价值但不是主因。
实验结果
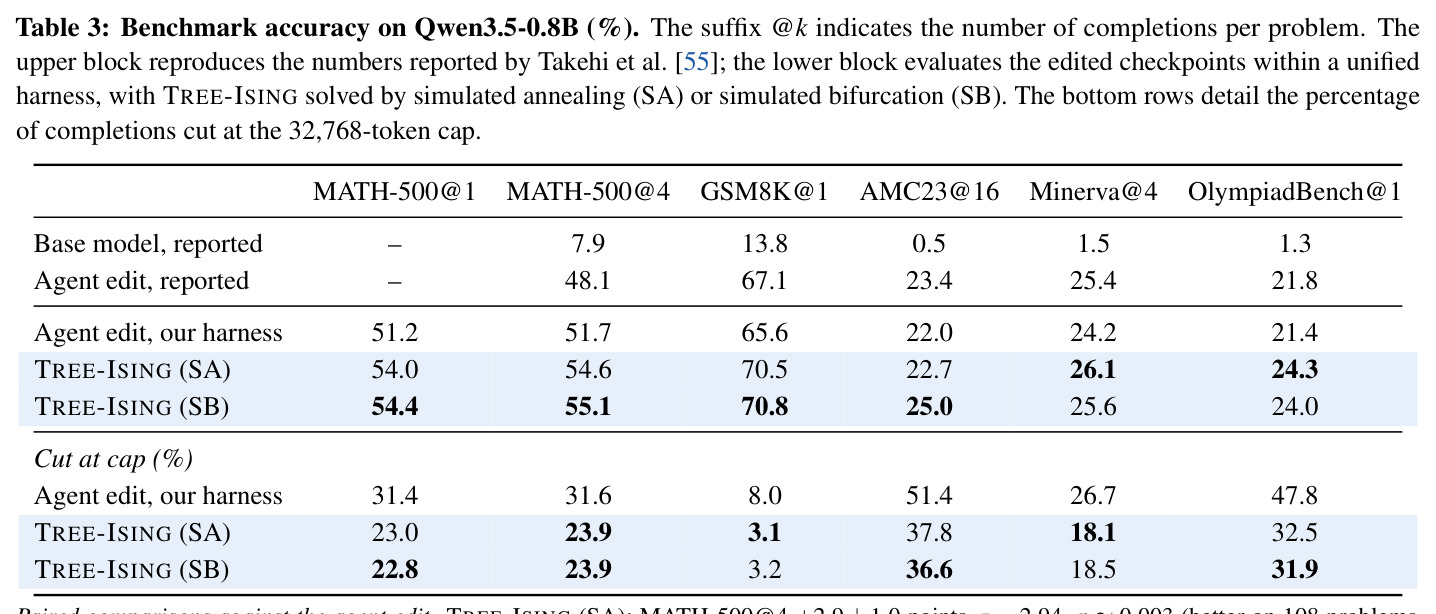
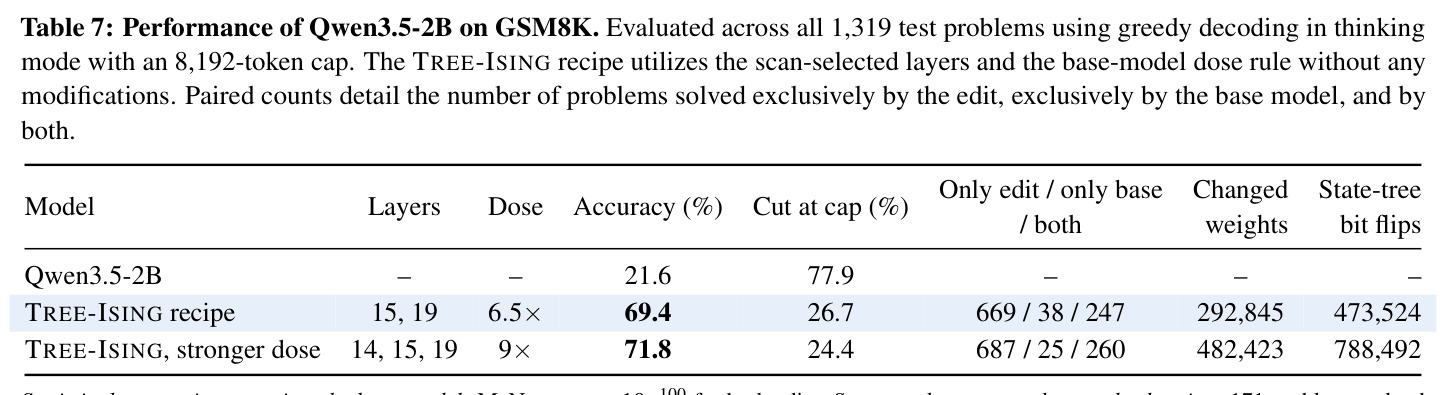
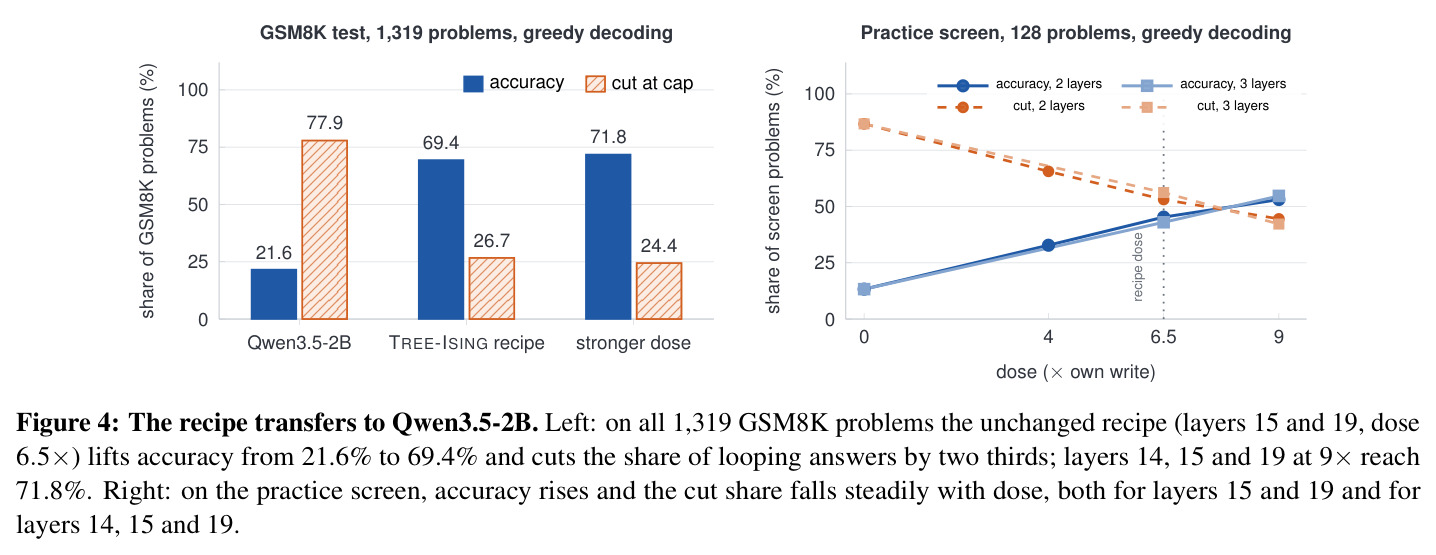
Qwen3.5-0.8B上(Table 3):MATH-500@4为54.6%(SA)/55.1%(SB),超过同协议下agent编辑的51.7%(基座7.9%),配对 $p\approx0.003$/$0.0005$,经12组比较Bonferroni校正后仍显著;GSM8K@1从65.6%升至70.5%/70.8%(155 vs 90题独解,$p=4\times10^{-5}$),五个基准全部领先。截断率大幅下降:MATH-500从31.6%到23.9%,GSM8K从8.0%到3.1%,OlympiadBench从47.8%到32.5%。编辑足迹(Table 5):112,630个权重比agent少13%,BF16位翻转278,767对621,388(2.2倍少),状态树位181,062对720,586(4倍少),共享指数与尾数写入均为0。成本(Table 4):4次前向+8.8分钟退火共31分钟、0.90美元,对agent的15.6小时、312美元(约350倍便宜)。消融(Table 6):$\beta=0$时准确率跌至43.8%、截断53.1%,证明收尾方向项关键;闭式rank-one解57.8%相当但改动702万权重(多62倍)。迁移(Table 7):Qwen3.5-2B无参考编辑,greedy GSM8K从21.6%升至69.4%(McNemar $p<10^{-100}$),层14/15/19加9倍剂量达71.8%。QAOA验证:8变量子问题在IBM Heron上110/1024 shots命中最优(均匀对照仅4次)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MATH-500@4(Qwen3.5-0.8B,思考模式,32,768上限) | 准确率(%) | 54.6(SA)/ 55.1(SB) | agent编辑 51.7(同协议);agent原报告 48.1;基座 7.9 | 对agent +2.9点($p\approx0.003$,Bonferroni校正后显著);严格held-out 400题上+2.9±1.1点 |
| GSM8K@1(0.8B) | 准确率(%) | 70.5(SA)/ 70.8(SB) | agent编辑 65.6;基座 13.8 | +4.9点(155 vs 90题独解,$p=4\times10^{-5}$,校正后显著);截断率8.0%→3.1% |
| AMC23@16(0.8B) | 准确率(%) | 22.7(SA)/ 25.0(SB) | agent编辑 22.0;基座 0.5 | +0.6~+3.0点(±1.0~1.5,统计不显著);截断率51.4%→37.8% |
| Minerva Math@4(0.8B) | 准确率(%) | 26.1(SA)/ 25.6(SB) | agent编辑 24.2;基座 1.5 | +1.9点(不显著);截断率26.7%→18.1% |
| OlympiadBench@1(0.8B) | 准确率(%) | 24.3(SA)/ 24.0(SB) | agent编辑 21.4;基座 1.3 | +2.9点(名义显著 $p=0.045$,校正后不显著);截断率47.8%→32.5% |
| GSM8K greedy(Qwen3.5-2B,全部1,319题) | 准确率(%) | 69.4(标准配方:层15/19,6.5×剂量);71.8(层14/15/19,9×剂量) | 基座 21.6 | +47.8点(McNemar $p<10^{-100}$);截断率77.9%→26.7% |
| 单次修复成本(0.8B) | 美元 / 墙钟时间 / 前向请求数 | 0.90美元 / 31分钟 / 4次前向 / 0 LLM token | agent:312美元 / 15.6小时 / 50次前向 / 89.7M token | 约350倍便宜、30倍快、12.5倍少前向;GPU时间21.8分钟对12.2小时(34倍少) |
局限与改进
作者明确承认:研究只覆盖推理循环这一种失败模式,只在共享『每四层一个全注意力块』混合架构的Qwen两个模型上、只在数学基准上验证;未测指令跟随(agent编辑曾把IFEval从21.0%提到62.3%)、通用语言建模与非数学任务,附带效应只在练习题token上用附带损害项约束。基座7.9%引用自原报告并未在本协议下复跑;早期探索变体曾在固定的100道MATH-500题上筛选,全量结果含开发期见过的题(不过400道严格held-out题上差距保持+2.9点);末层排除规则是看过0.8B扫描后才定下的;0.8B实验复用agent的层且剂量非严格匹配(1.6倍),没有跑过1.0倍的严格剂量匹配编辑;目标是一阶替代,忽略编辑对后续层输入的影响,列保留、单动作预选和行求解器都是启发式;每个求解器只以单seed运行一次,运行时间也非严格可比。我的补充观察:两层模型选出相同层可能只是共享架构布局的产物(Figure 3两模型最高分层都是全注意力块),缺乏第三种架构的独立证据;成本对比本质是『发现修复』对『执行配方』的不对称比较;greedy解码与GSM8K是按基座最差表现的200题探针挑选的,存在向易修复场景倾斜的风险。
独立分析的弱点
第一,层扫描规则(除末层外取最高两层)的可靠性依赖『只有全注意力能精确远距离复制』这一假设,而文中梯度归因在0.8B上选出的层(14/21/18/16)与实际失败层不符,说明该规则并非原理性保证——改进方向是在异构架构上做因果验证,例如对候选层分别施加小剂量编辑看屏幕分数。第二,剂量目标 $\tau$ 是关键超参但经验性强:消融显示1.2倍剂量屏幕57.8%高于默认1.6倍的57.0%,且权重少31%,默认配置可能系统性偏大——改进方向是用验证集上的终止率直接闭环校准剂量,或沿剂量做帕累托前沿选择。第三,保护集P只覆盖练习题token,指令遵循、多语言、安全等分布外行为完全未测,而编辑直接写进权重且不可在线关闭——改进方向是加入通用基准回归测试与更强的输出分布正则(如对更多任务token的 $C_P$ 采样)。第四,每权重预选单动作、$K=512$ 列独立保留都是启发式,放弃了联合优化空间(论文自己在第6节承认需要联合动作选择才能给量子求解器留出优势)——改进方向是把动作选择扩展为多变量或引入列间选择性耦合。第五,单一seed、单次运行使SA/SB的对比和消融的4.4点分辨率都较粗糙,小差异无法解读——改进方向是多seed重复与方差报告。
未来方向
作者提出的方向包括:把配方推广到更大模型、其他模型家族和其他行为失败模式(他们特别提到未测的指令跟随能力);在缺乏『每四层全注意力』布局的模型上检验层扫描;设计更难的Ising形式(联合动作选择、显式比特预算)使量子求解器有发挥空间;以及混合量子-经典细化——以GPU解为条件分块、沿用修复校准、在标准基准上评测下游精度。基于本文成果还可延伸:其一,把状态树比特会计与压缩检查点的直接补丁真正实现,形成『压缩存储+在线修复』的完整管线(目前只改了普通权重,压缩重编码尚未做);其二,对称扩展到ThinkEdit处理的『过早停止』失败,用一个目标同时调节循环与收尾两个方向的强度,可能得到通用推理长度控制器;其三,放宽行独立假设做跨行、跨层的联合优化,或用副本交换等更强退火研究行能量与最终精度的关系曲线(Equation 14已给出更快求解器的收益上界);其四,把该目标用于分析循环的机理成因,例如编辑后的神经元写入模式与注意力复制行为的对照研究。
复现评估
总体复现难度中等偏低,算力门槛是本文最大亮点。代码承诺发布于 https://github.com/TheQuantumGOAT/Tree-Ising(论文写作时标注为即将公开,尚未可用);384道练习题与128道筛选题来自agent作者随评测工具发布的配套数据,agent的50次前向日志公开,成本核算可逐条核对;评测协议完全沿用原工具(vLLM、思考模式、温度0.6、top-p 0.95、top-k 20、presence惩罚1.5、32,768上限、Math-Verify判分)。算力需求极小:单张A100上0.8B修复全程31分钟、约0.90美元,其中退火仅8.8分钟;2B迁移含层扫描和验证筛选共26分钟。复现的工程难点主要在三处:教师强制统计收集(四类token集的精确定义与实现)、$\gamma$/$\lambda$ 的二分校准流程、以及GPU批量SA/SB求解器的实现;量子部分需要IBM Heron访问权限,但仅是8变量演示,不做也不影响主结果复现。需要注意论文未公开基座7.9%的自测复跑,且早期变体与100道MATH-500题的开发污染无法完全剥离。
论文图表
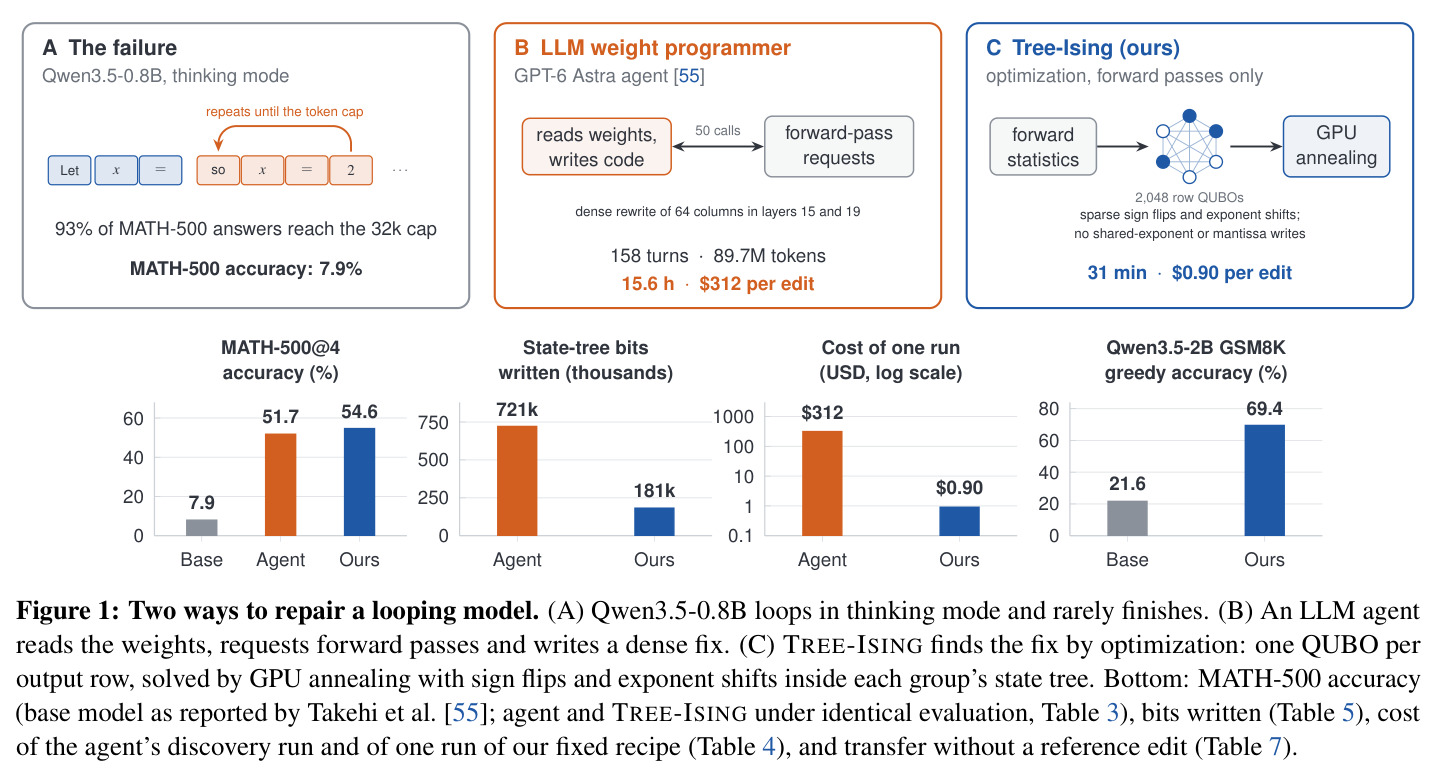
三栏对比:(A) Qwen3.5-0.8B在思考模式下93%的MATH-500答案撞上32k上限、准确率7.9%的失败;(B) GPT-6 Astra智能体读权重、发50次前向请求、写稠密修复,耗时158轮89.7M token、15.6小时312美元;(C) Tree-Ising只用前向统计加GPU退火,把问题拆成2,048个行QUBO,31分钟0.90美元完成稀疏符号翻转与指数移位。底部四个小图分别展示MATH-500@4准确率(基座7.9、agent 51.7、本文54.6)、写入的状态树比特数(agent 721k对本文181k)、单次运行成本对数轴(312美元对0.90美元)、以及Qwen3.5-2B上greedy GSM8K从21.6%到69.4%的迁移结果。
这是全文的电梯演讲:一张图同时呈现问题、两条修复路线的成本结构对比和全部核心数字,读者可以先建立整体图景再深入方法细节。