当模型编辑过度:论最小代码修复的编辑忠实度 When Models Edit Too Much: On the Fidelity of Minimal Code Edits
构建最小补丁已知的受控基准,量化LLM修复代码时的过度编辑,并证明可通过提示与RL习得最小编辑偏好
前置知识
AST(抽象语法树)
源代码的树状结构表示,把程序解析成由函数调用、运算符、条件分支等节点构成的树。AST 级别的代码改写直接在树上操作(如把 range(n) 改成 range(n+1)、翻转比较运算符),与纯文本替换不同,能保证语法正确并精确控制改动位置与语义类型。
本文通过向参考解注入受控 AST 级破坏来构造带已知最小补丁的修复任务,破坏族列表和最小修复=破坏逆操作这一定义都建立在 AST 操作之上。
Pass@1
代码生成与修复的标准功能正确性指标,衡量模型单次采样输出通过全部测试用例的比例。它只回答程序能否跑对,完全不关心模型改动了多少行代码、是否重写了无关逻辑。
论文的核心论点是在 Pass@1 之外必须增加编辑忠实度维度;全文所有实验都以 Pass@1 为正确性轴、以超额编辑距离和新增认知复杂度为忠实度轴做联合评估。
Token 级 Levenshtein 编辑距离
两个序列之间最少需要的插入、删除、替换操作数。本文在 Python 分词后的 token 序列(关键词、标识符、运算符各算一个单位)而非字符上计算,并用较长函数体的 token 数归一化,避免标识符长短带来的偏差。
论文两个核心度量都基于它:超额编辑距离 $ELev = D_{model} - D_{gold}$ 和 RL 奖励中的 $e(M) = d(M,C) - d(G,C)$,理解它才能理解如何量化模型比最小修复多改了多少。
认知复杂度(Cognitive Complexity)
SonarSource 提出的可维护性度量,按嵌套、分支、循环等控制流结构累加计分来衡量代码理解难度。本文用 Python AST visitor 计算,新增认知复杂度 = 模型输出的复杂度减去 gold 修复的复杂度,专门捕捉补丁虽短但结构变复杂这类过度编辑。
编辑大小无法涵盖所有过度编辑形式——短补丁也可能引入多余分支嵌套,认知复杂度是论文的第二把尺子,用于度量结构性开销。
SFT / rSFT / DPO / RL(GRPO)
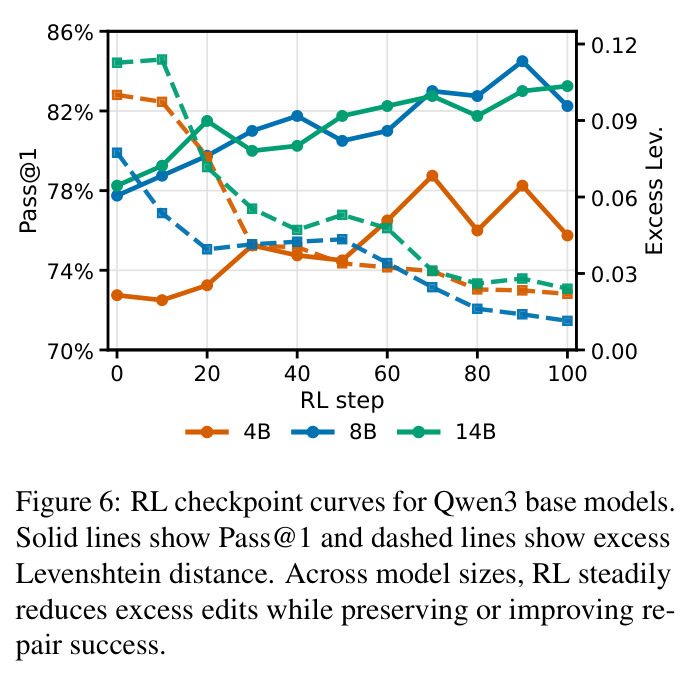
四种后训练范式:SFT 直接在 gold 修复上监督微调;rSFT(拒绝采样 SFT)每题采样多个候选、保留通过测试且编辑最小的几条做监督训练;DPO 在最小编辑与最大编辑补丁构成的偏好对上做离线偏好优化;RL 用 GRPO 式组相对策略优化,奖励为执行通过加分减去超额编辑距离惩罚。
第 4 节系统比较这四种方法学习最小编辑行为的能力,结论 SFT 过拟合训练破坏模式、RL 泛化最好且不伤通用能力,是本文训练侧的核心发现。
研究动机
LLM 越来越多地被用于修改既有代码,但在存量代码维护(brownfield)场景中,好补丁不仅要通过测试,还应易于评审、保留原意、不引入测试覆盖不到的回归。然而现有编码评测几乎只度量功能正确性:HumanEval、BigCodeBench 看 Pass@1/Pass@k,SWE-bench 等仓库级基准也只看测试是否通过,完全不度量模型改写了多少无关代码。论文用一个例子点破问题:BigCodeBench/663 中 range(len(x)) 少写 -1 的一行越界 bug,单行补丁即可通过全部 5 个测试,而 GPT-5.4(high) 却删 5 行、插 60 行,加入输入校验、dtype 强转、NaN 掩码和重采样——没有任何测试要求这些代码。对 20 个前沿模型的测量显示:在 5 次补全全部通过测试的模型中,中位补丁规模从 2 行到 60 行不等,且最新发布的模型并不比被其替代者更保守。这种过度编辑在只看正确性的评测下完全不可见,却直接推高评审成本与回归风险。
本文的目标是本文要把编辑忠实度(edit fidelity)确立为代码修复质量的一个独立可测维度,并回答四个研究问题:RQ1,强编码模型在补丁通过测试时是否仍会过度编辑;RQ2,仅靠提示词能否减少过度编辑;RQ3,推理档位与模型规模等因素如何与编辑忠实度交互;RQ4,模型究竟以何种方式过度编辑、该行为能否通过后训练习得。具体路径是构造每道题都带已知最小修复的受控基准,使超额编辑可以被精确定义和度量(而非在开放场景中无从定义什么算必要改动),系统测量 20 个前沿模型的默认行为,用人类研究验证指标与人类直觉的一致性,最后在 Qwen3-4B/8B/14B 上比较 SFT、rSFT、DPO、GRPO 式 RL 四种后训练方法,检验最小编辑能否作为持久偏好被学会而不损伤通用编码能力。
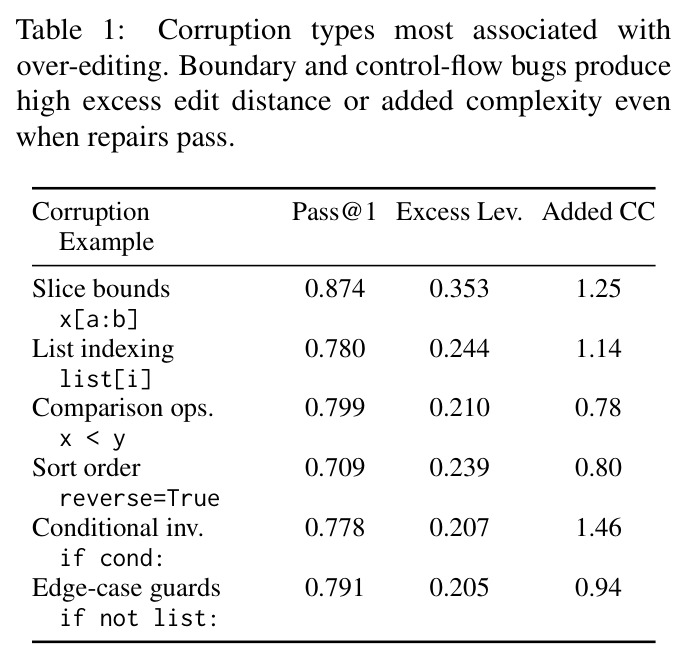
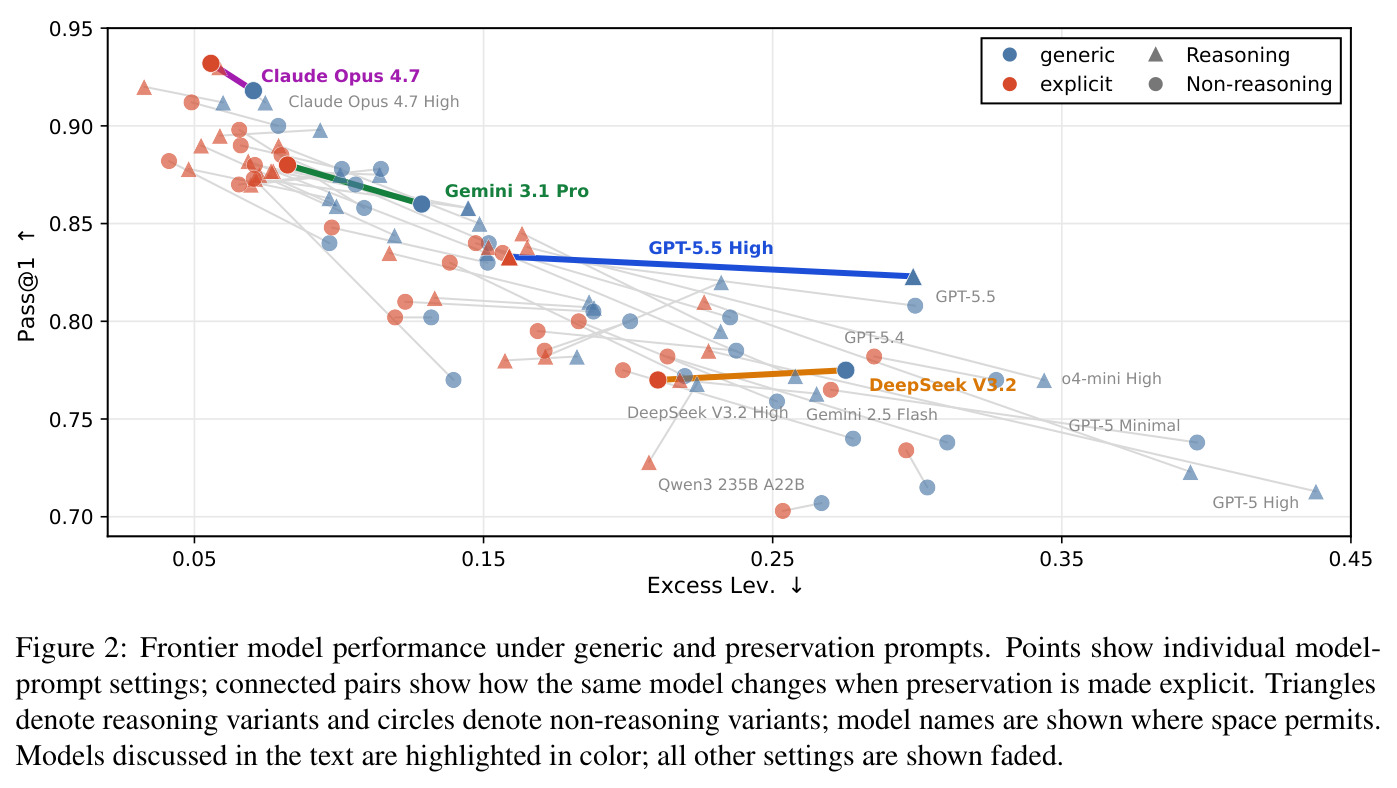
与已有工作不同的是,已有工作要么只测正确性,要么缺少已知最小解的受控设置:CanItEdit 报告过 ExcessCode(多余改动行),但任务按自然语言指令编辑、最小补丁未知;CREF、AdaPatcher、PAFT 与并行的 PRepair 在修复系统中追求更小补丁,却无法把过度编辑与任务难度干净分离。本文的独特切入是构造性已知最小解:从正确参考解出发,手工注入 1–2 个预定义列表中的 AST 级破坏,只保留破坏后确实未通过原测试的样例,于是 gold 补丁就是破坏的逆操作,天然已知且极小——50.2% 只需改 1 个 token,91.8% 最多 2 个,没有任何 gold 补丁触碰超过 2 行。度量上选 token 级编辑距离而非 CodeBLEU 等 n-gram 相似度:破坏是局部的,n-gram 会奖励表面词法重合而误判补丁大小。这套设计让过度编辑第一次成为可隔离、可复现、可训练的失败模式。
核心方法
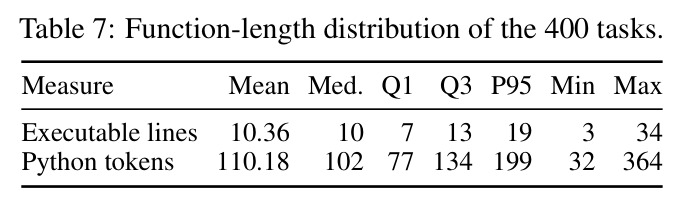
直觉上,要研究模型是否改多了,必须先知道最少要改多少。本文自建考题:从 BigCodeBench 抽 400 道带参考解和可执行测试的 Python 题(函数平均 10.4 行可执行代码),人工向参考解注入 1–2 个 AST 级破坏(取自 14 族预定义列表:翻转比较运算符、range 边界加减一、改变排序方向、修改累加器初值等),只保留破坏后确实挂掉原测试的样例,从而每题的 gold 最小补丁就是破坏的逆操作。评估沿三条轴进行:Pass@1 衡量能否修好;超额归一化 token 编辑距离 $ELev(M) = D_{model} - D_{gold}$ 衡量比最小补丁多改了多少;新增认知复杂度衡量是否引入多余分支嵌套。在此基准上先测 20 个前沿模型在 generic(只说修 bug)与 explicit(要求尽量保留原代码)两种提示下的表现,再从破坏类型、推理档位、模型规模、行为分类学四个角度切片;最后在 Qwen3-4B/8B/14B 上用四种后训练方法学习最小编辑,RL 奖励为 $r(M) = \lambda_{exec} - \lambda_{edit}\,e(M)$,并以 LiveCodeBench v6 与 Defects4J 检验副作用与跨语言迁移。
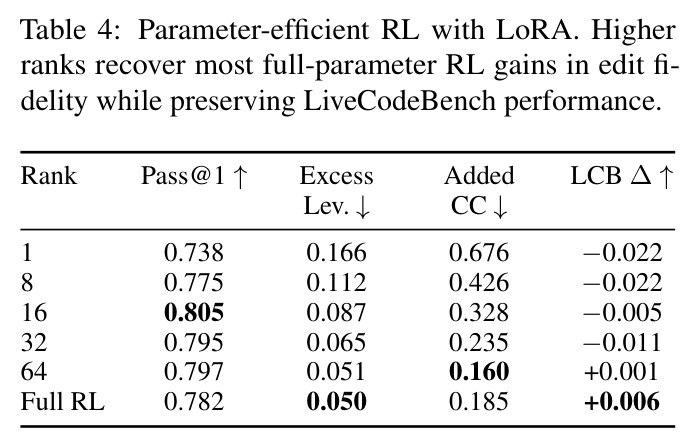
核心创新有二。其一是构造性已知最小解的基准设计:与既有编辑基准让模型按自然语言指令改代码、最小补丁未知不同,本文的破坏由研究者注入,gold 补丁就是它的逆,因此超额编辑 $ELev = D_{model} - D_{gold}$ 有干净的定义与零点——任何大于 0 的值都意味着模型比必需改得更多,过度编辑首次能被与任务太难分离开来度量。其二是把最小编辑当作可训练的偏好而非新技能:RL 奖励在执行通过(+0.1)之外对超额编辑 $e(M) = d(M,C) - d(G,C)$ 线性扣分,编辑过大($e(M) > 0.3$)的补丁得分甚至低于错误补丁的 $-0.2$,从策略层面直接惩罚改多了。实验证明这种偏好可用 LoRA r=64 的小适配器捕获、可跨破坏族(20 族 held-out OOD)和跨语言(Python 到 Java)迁移,且不损伤 LiveCodeBench 通用能力(+0.6),印证了最小编辑是一种风格偏好。
方法步骤详情
第一步,构造基准:对 400 题参考解做 AST 归一化后注入 1–2 个破坏(232 题注入 1 个、168 题注入 2 个,共 568 次),只保留破坏后未通过原测试的样例;gold 补丁即逆操作,归一化 gold 距离均值仅 0.017。第二步,定义指标:$D_{gold}=d(G,C)$、$D_{model}=d(M,C)$ 为按较长函数体归一化的 token 级 Levenshtein 距离,超额距离 $ELev=D_{model}-D_{gold}$;新增认知复杂度为模型输出与 gold 修复的 Campbell 认知复杂度之差,只在通过的修复上计算。第三步,人类验证:3 位 5–10 年经验工程师盲评 100 对通过测试的补丁,超额距离与人类更易评审、更忠实判断的一致率达 94.8%(κ=0.897)和 96.9%(κ=0.939);另对 100 个高超额补丁盲审,82.3% 确含非必要编辑。第四步,测前沿模型:20 个模型 × 两种提示、温度 1 采样,再做破坏类型关联与推理/规模消融,并用冻结的标注手册对 530 个高超额补丁做五类行为标注。第五步,训练实验:在 DeepCoder 4,141 样本上以每样本 1–10 个破坏构造语料,分别用 SFT、rSFT(8 选 3 最小编辑)、DPO(最小 vs 最大偏好对)、GRPO 式 RL(K=16,$r(M)=0.1-e(M)$,失败 $-0.2$)训练 Qwen3-4B/8B/14B,在 400 题同框架加 20 族 held-out OOD 破坏上评估,并用 LiveCodeBench v6 与 Defects4J 检验通用能力与迁移。
技术新颖性
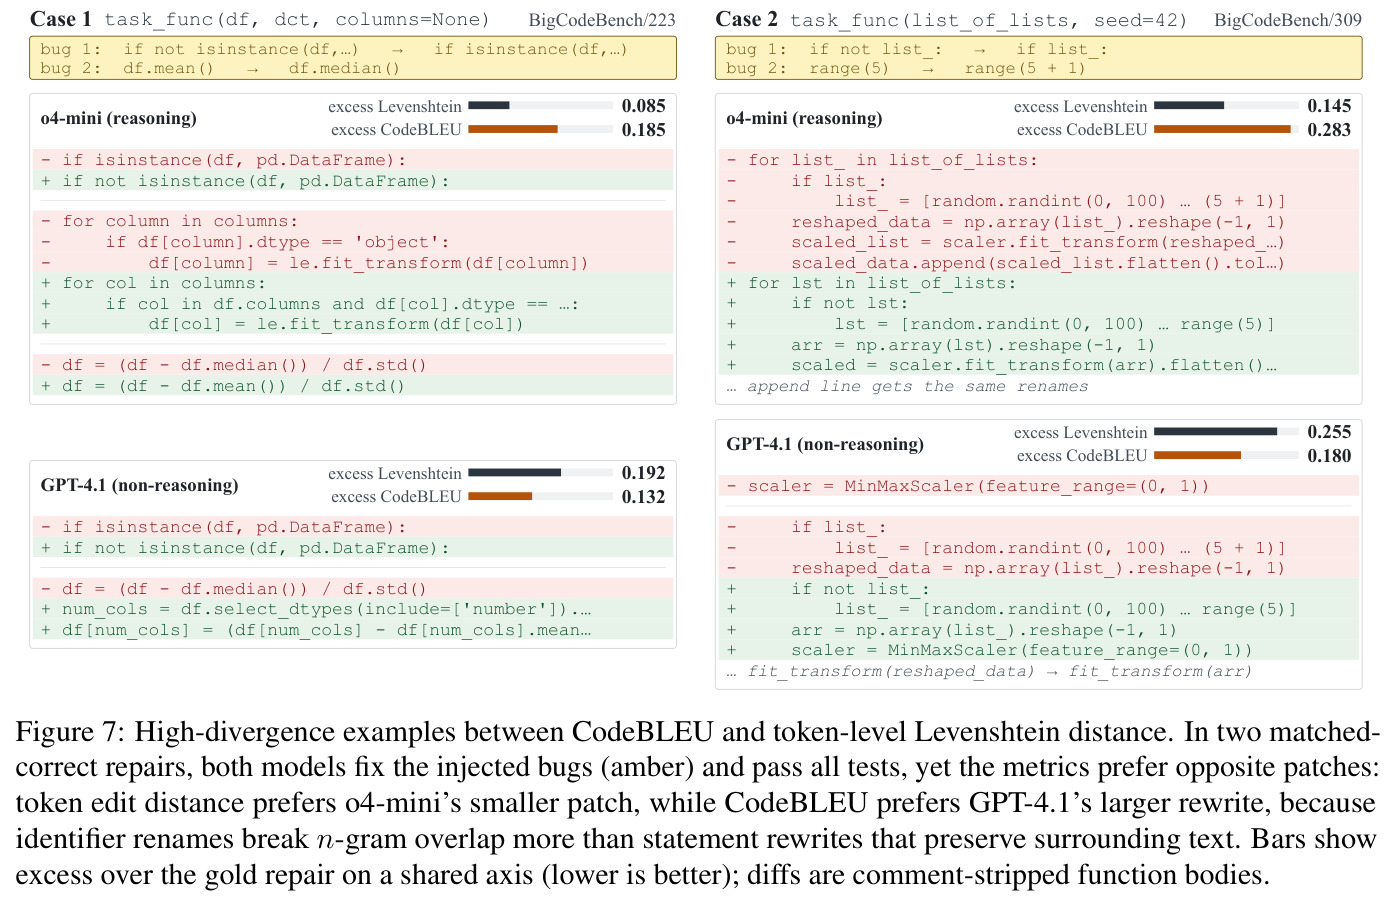
新颖性体现在四个层面。基准层面:首次在 frontier 级模型上以注入-可逆方式构造最小补丁已知的受控修复评测,把编辑忠实度从任务正确性中隔离出来,比 CanItEdit 的 ExcessCode、CodeEditorBench 等设置更干净。度量层面:论证并实证 token 级 Levenshtein 优于 CodeBLEU——Figure 7 的配对案例显示 o4-mini 做小补丁但重命名变量、GPT-4.1 整句重写却保留长 n-gram,CodeBLEU 会误判后者更小;同时用认知复杂度补足短补丁也可结构复杂的盲区,并用人类研究(κ=0.897/0.939)背书主指标。分析层面:给出首个过度编辑行为分类学(五类多标签),证明其与超额距离单调相关(超额 ≤0 时 98.3% 零标注)、可被五个独立前沿模型一致标注。训练层面:提供 SFT 与 rSFT/DPO/RL 的系统对照,发现 SFT 记住训练破坏族(OOD Pass@1 从 0.932 崩至 0.458)而 RL(0.782/0.050)在 LiveCodeBench 不掉点的同时泛化最好,与 SFT 记忆、RL 泛化的论断互证,并用 LoRA 秩扫描与 rollout 预算消融证明是学习目标而非采样预算造就优势。
实验结果
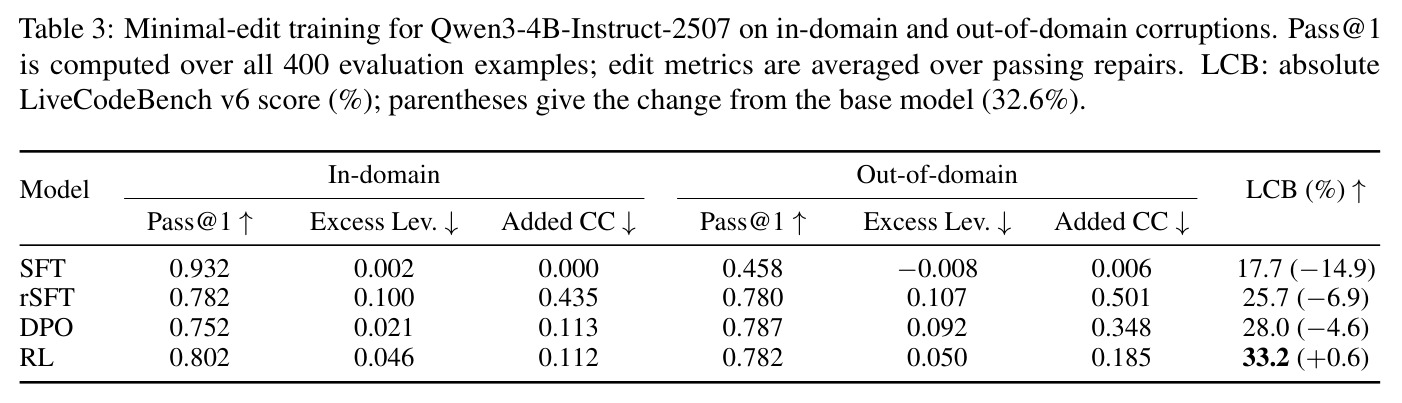
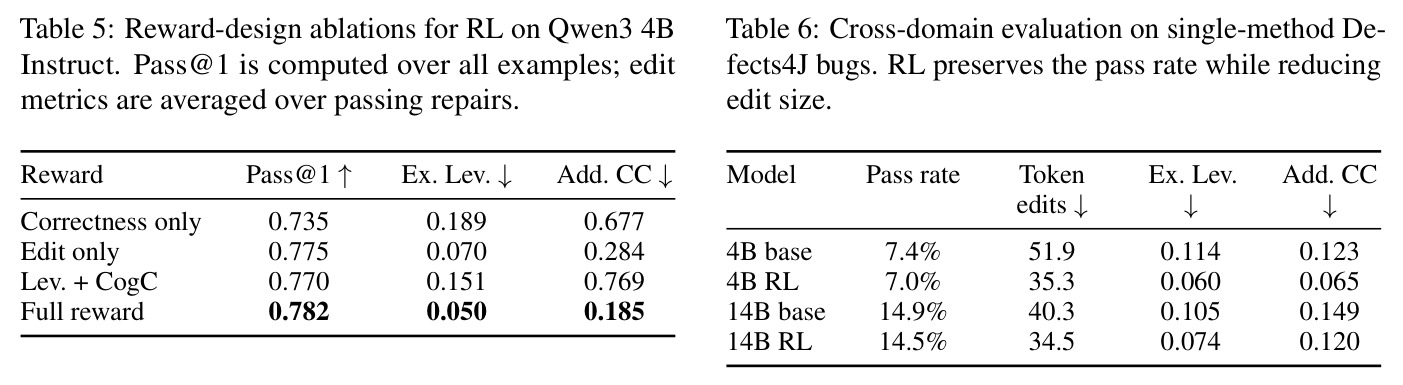
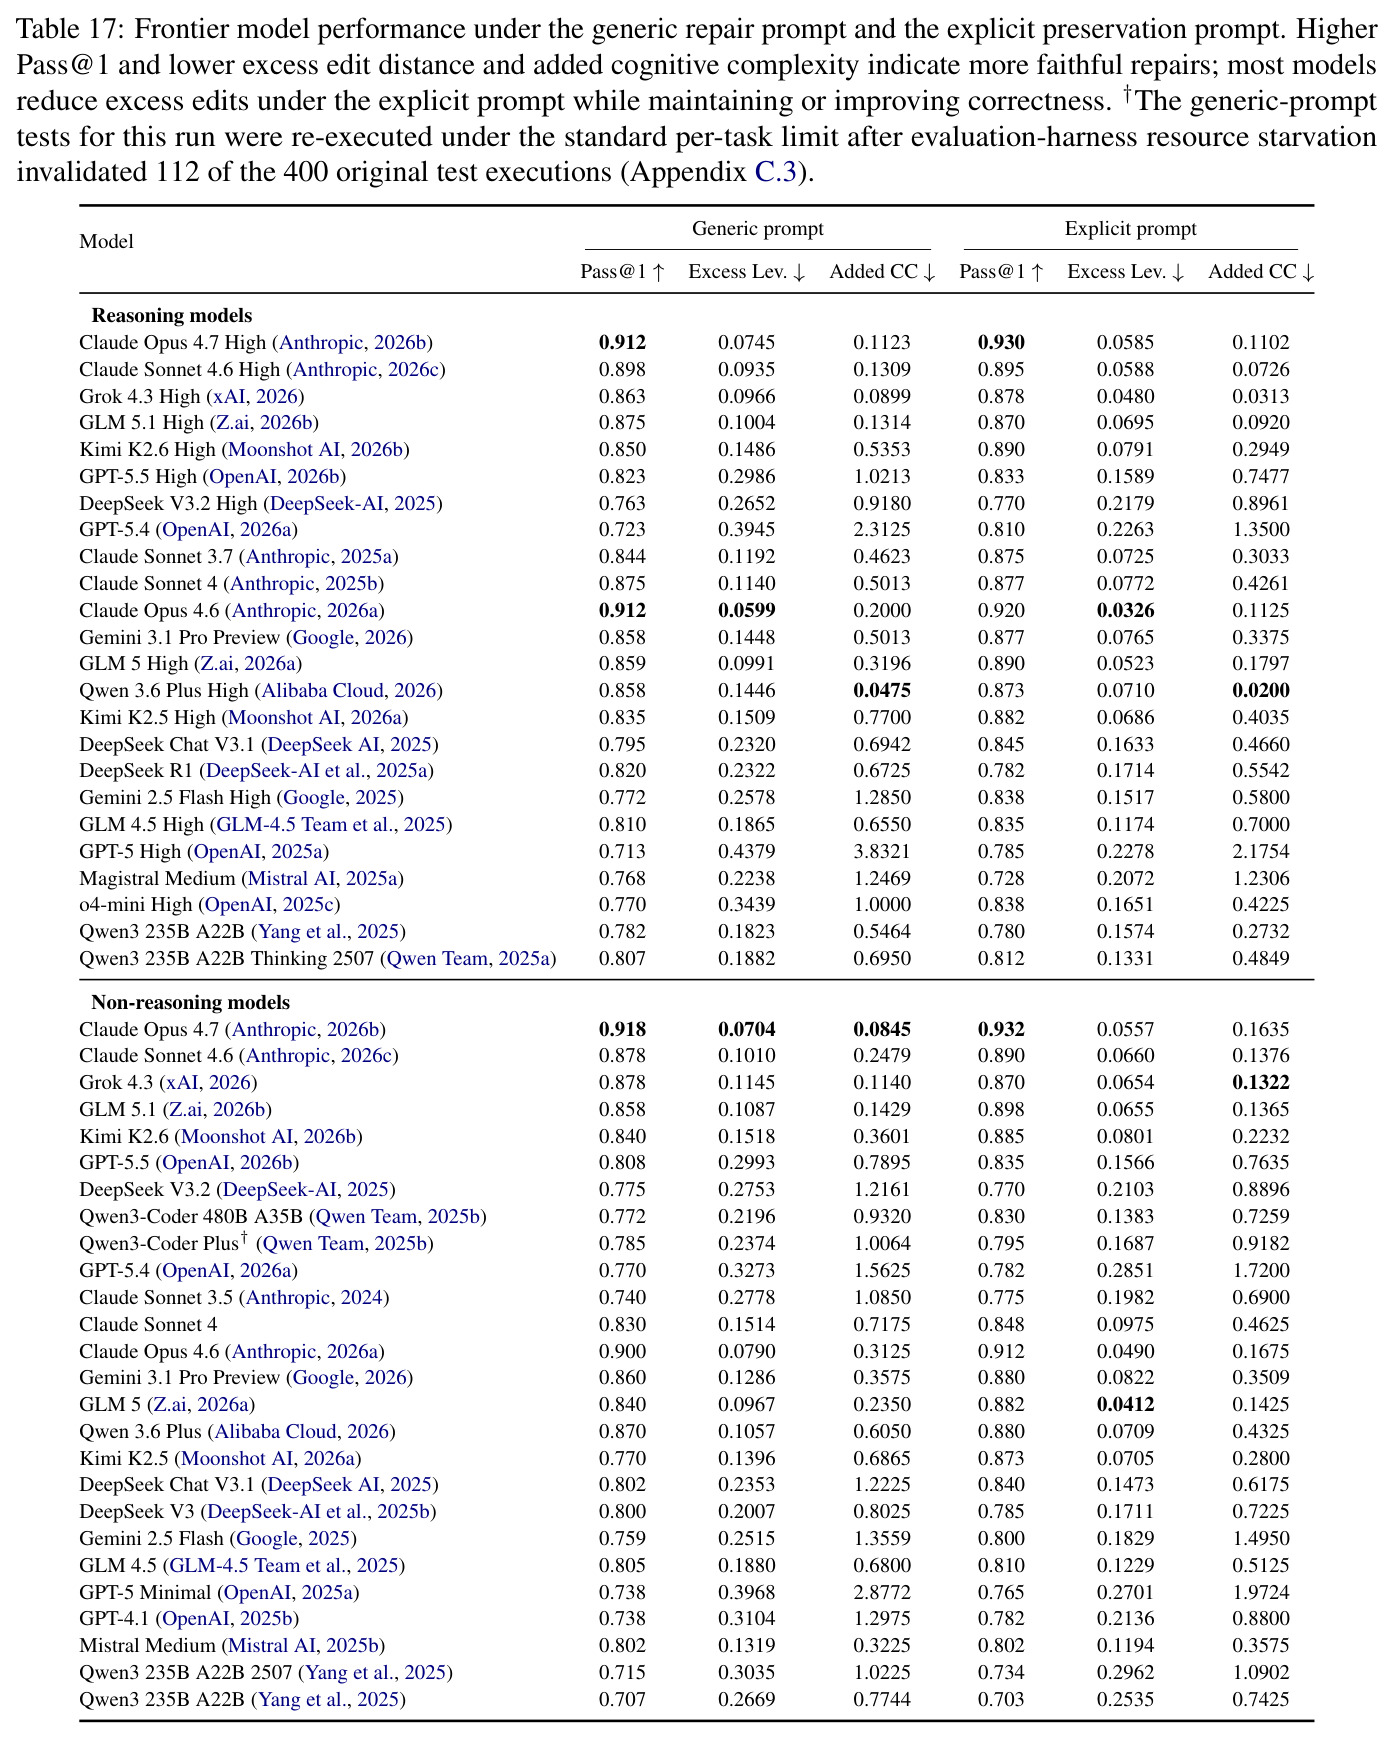
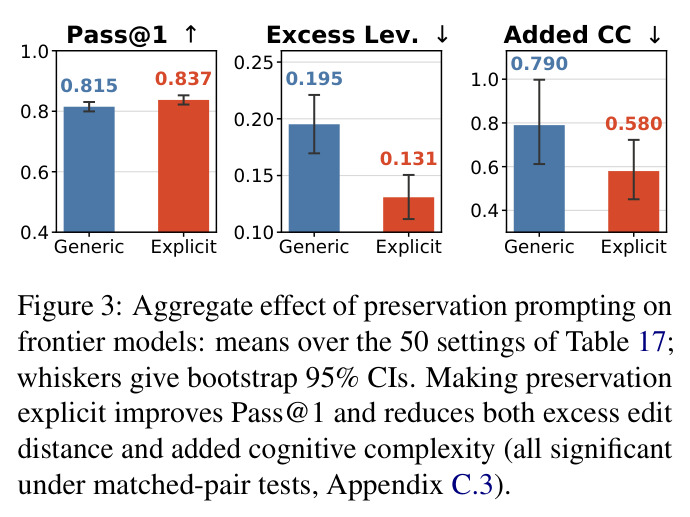
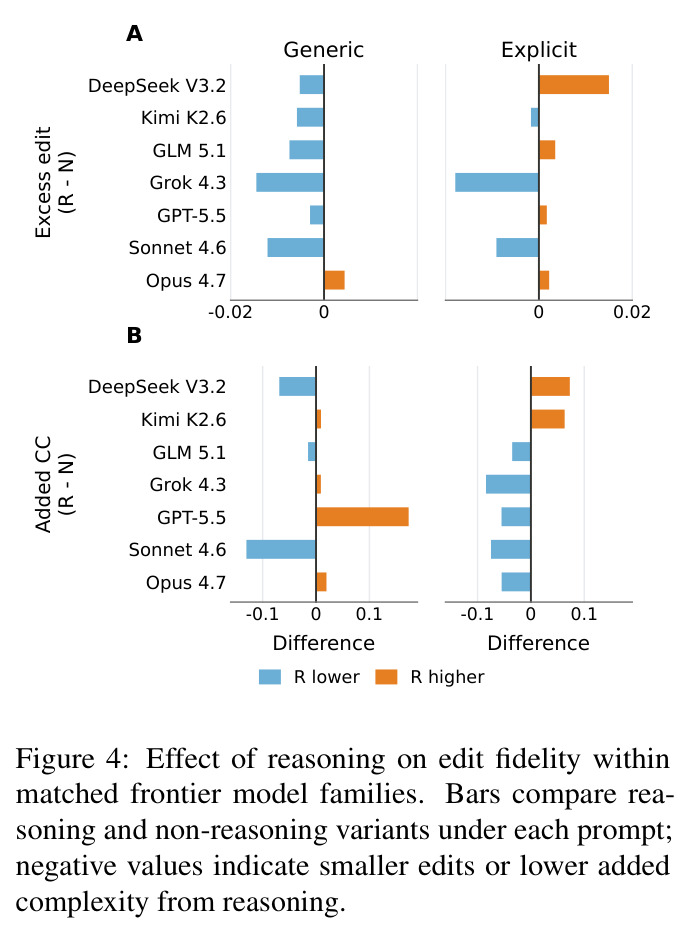
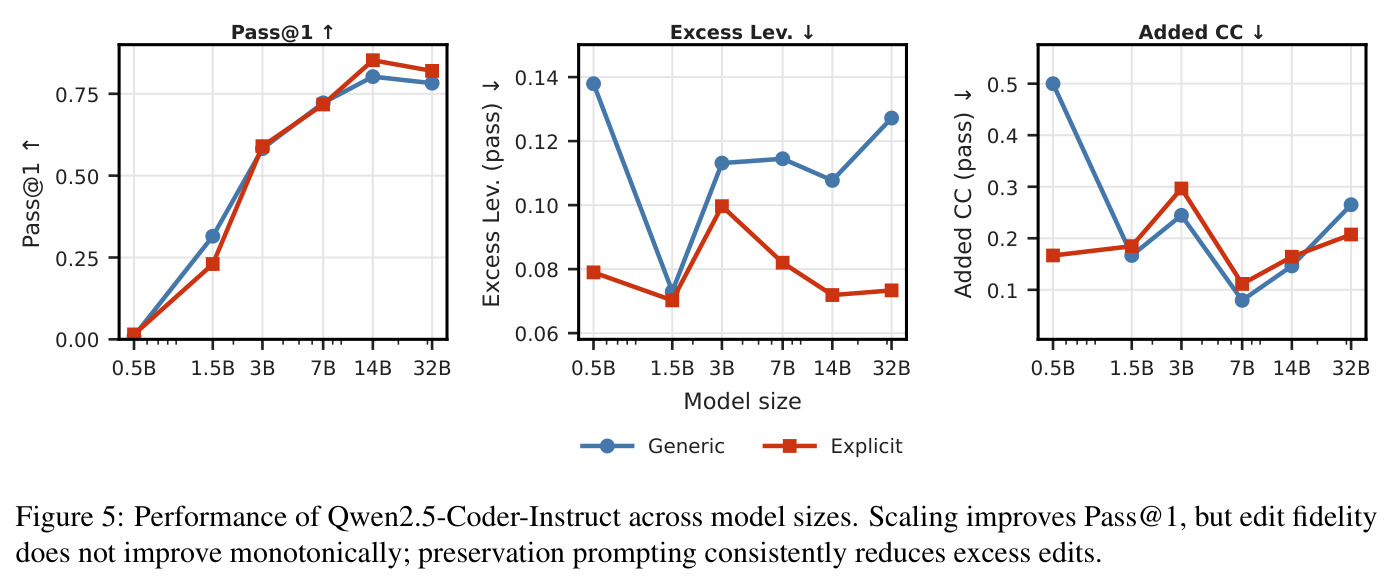
核心发现有四。第一,过度编辑普遍存在:generic 提示下 Claude Opus 4.7(非推理)权衡最佳(Pass@1 0.918、超额距离 0.0704、新增复杂度 0.0845),而 GPT-5.5 High 虽达 Pass@1 0.823,超额距离 0.2986 约为 Opus 的四倍、新增复杂度 1.0213;Figure 1 案例中 GPT-5.4(high) 为一行 bug 插入 60 行。第二,一条保持指令显著有效:聚合 50 组配对设置,超额距离从 0.195 降至 0.131,新增复杂度下降 26.6%($p<10^{-4}$),Pass@1 从 81.49% 升至 83.74%(+2.26 点,95% CI [+1.49, +3.05],40/50 设置改善);GPT-5.5 High 超额近乎减半(0.299→0.159);开源模型同受益(Qwen2.5-Coder-14B:Pass@1 0.803→0.853、超额 0.135→0.099);效果在重复采样与措辞改写下稳健。第三,推理与规模都不是解药:推理的影响是模型特异的(GPT-5.5 开推理反而使新增复杂度大增);Qwen2.5-Coder 0.5B→32B 的 Pass@1 上升但超额非单调(14B 的 0.108 回升到 32B 的 0.127);切片边界 bug 即使 Pass@1 最高(0.874)超额也最大(0.353),说明过度编辑与难度解耦。第四,最小编辑可训练:SFT 域内 Pass@1 0.932 但 OOD 崩至 0.458、LiveCodeBench 掉 14.9 点;RL 达 OOD 0.782、超额 0.050、复杂度 0.185,LiveCodeBench 反升 0.6(对 SFT 优势 $p<10^{-20}$);DPO OOD Pass@1 略高(0.787)但补丁更大(0.092/0.348);LoRA r=64 几乎追平全参 RL(0.797/0.051);Defects4J 真实 Java 缺陷上 RL 保持通过率(14B:14.5% vs 14.9%)同时把 token 编辑从 40.3 降到 34.5,证明偏好可跨语言迁移。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BigCodeBench 400 题最小修复(20 个前沿模型聚合) | Pass@1 | 83.74%(explicit 保持提示) | 81.49%(generic 提示) | +2.26 点,40/50 配对设置改善 |
| BigCodeBench 400 题最小修复(前沿聚合) | 超额 Levenshtein 距离(越低越好) | 0.131(explicit) | 0.195(generic) | 降低约 33% |
| BigCodeBench 400 题最小修复(前沿聚合) | 新增认知复杂度(越低越好) | explicit 提示 | generic 提示 | 降低 26.6%($p<10^{-4}$) |
| OOD 破坏族修复(Qwen3-4B,400 题) | Pass@1 | RL 0.782 | SFT 0.458 / 未训练基线 0.745 | RL 比 SFT 高 0.324($p<10^{-20}$) |
| OOD 破坏族修复(Qwen3-4B) | 超额 Levenshtein 距离 | RL 0.050 | DPO 0.092 / rSFT 0.107 | 约为 DPO 的一半,且新增复杂度 0.185 vs 0.348 |
| LiveCodeBench v6(通用编码能力保持检查) | 得分 %(基线 32.6%) | RL 33.2%(+0.6) | SFT 17.7%(−14.9)/ rSFT 25.7% / DPO 28.0% | RL 是唯一不掉点的方法 |
| Defects4J 真实 Java 单方法缺陷(跨语言迁移) | 超额 Levenshtein / 平均 token 编辑数 | 14B RL:0.074 / 34.5 | 14B 基线:0.105 / 40.3 | 通过率基本不变(14.5% vs 14.9%)下编辑量显著缩小 |
局限与改进
作者承认的局限:一是评测对象是受控的函数级破坏,比真实仓库级 bug 和多文件改动简单,gold 补丁的已知性依赖破坏可逆这一设定;二是主评测全部在 Python 上,训练实验局限于 Qwen 家族;三是人类研究规模小——指标验证只有 3 位标注者各评 100 对补丁,高超额补丁审计为单标注者 100 例;四是 Defects4J 迁移中绝对修复率很低(4B 7.0%、14B 14.5%),迁移结论仅在通过率不变、编辑变小层面成立。我的补充观察:其一,超额距离以 gold 为零点,但现实中最小修复往往不唯一,盲审中 17.7% 的高超额补丁其实是合理的替代修复,开放场景如何区分二者并未解决;其二,保持提示有效说明过度编辑部分是任务框架问题,基准上的改善未必等价于真实 IDE/Agent 场景中的行为改变;其三,认知复杂度与人类判断一致性仅中等(κ=0.455/0.386),作为第二指标可靠性偏弱;其四,闭源模型只测了 provider 默认解码(温度 1、单采样),未覆盖系统提示与工具调用等部署形态;其五,RL 奖励依赖已知的 $d(G,C)$ 作参照,线上部署时最小补丁并不存在。
独立分析的弱点
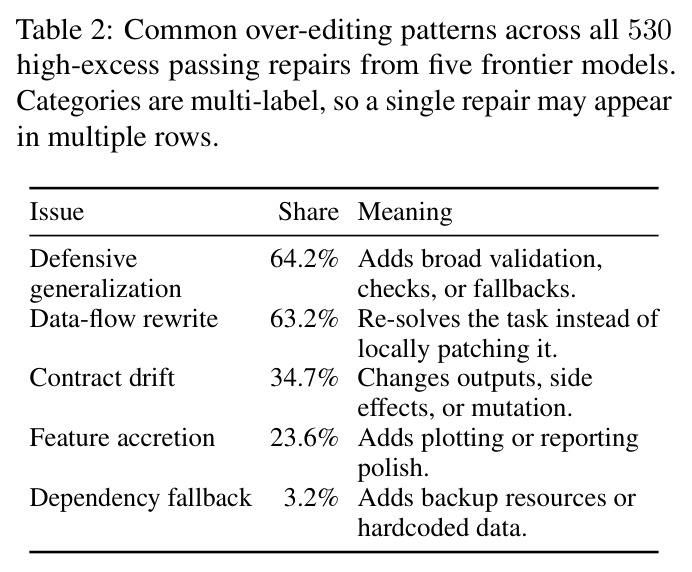
弱点一:合成破坏与真实缺陷的语义分布差异。注入的 14 族破坏都是局部、单点、可逆的,而真实 bug 常涉及需求误解、跨函数依赖和过时测试;在合成分布上学到的保持原代码偏好可能固化为不敢做大重构,对确实需要结构性修复的场景反而有害。改进方向:在奖励中加入改动必要性的反事实证据(如删除某段改动后测试是否仍通过),或混入真实 bug 数据。弱点二:奖励依赖已知 gold 补丁 $d(G,C)$,训练时可计算但无法直接用于没有参考解的开放维护任务。改进方向:学习补丁大小预测器,或用改动足迹(行数、影响函数数)加执行反馈构成无参考奖励。弱点三:正确性与忠实度都以原测试为完整规约,而过度编辑恰恰常发生在测试覆盖不到的地方——模型可能学会只改测试看得见的部分。改进方向:引入变异测试或差分测试检测行为溢出。弱点四:人类验证样本小且标注者为作者的熟人志愿者,κ 虽高但外推性有限,认知复杂度指标一致性仅中等。改进方向:扩大标注规模并引入独立第三方评审。弱点五:训练验证只在 Qwen 4B–14B 上进行,SFT 崩溃、LoRA r=16 饱和等结论对其他架构和更大规模是否成立未知,作者也自述受算力限制未做超参搜索。改进方向:跨模型家族复现并补充敏感性分析。
未来方向
作者明确提出的方向:把同样度量扩展到仓库级编辑、更多语言、更丰富的奖励设计和更大规模的人类评估;提升 Defects4J 等真实缺陷上的绝对修复率。基于成果可延伸的方向:第一,把编辑忠实度接入编码智能体的奖励与评审回路,例如在 RLHF 偏好数据中同时标注是否改多了,或在 code review 助手中自动报告超额编辑;第二,探索无参考解的最小性奖励(反事实回滚测试、改动足迹惩罚),使训练范式适用于真实仓库;第三,研究过度编辑与安全的关系——占 64.2% 的防御性泛化会不会在其他任务上引入新的攻击面或掩盖回归;第四,把五类行为分类学变成训练期的可解释信号做针对性 RL;第五,探索推理时引导(如先输出最小 diff 计划再执行)能否在不训练的情况下获得类似 RL 的忠实度收益,鉴于论文显示推理预算与保持指令的交互是模型特异的;第六,将该基准作为持续追踪工具,监控新发布模型的过度编辑趋势——论文已观察到新模型不必然更保守,推动把编辑忠实度写进模型卡与评测报告。
复现评估
复现条件较好。代码已开源(github.com/nreHieW/over-editing);基准完全由公开数据构造——BigCodeBench(Apache 2.0)提供 400 题参考解与测试,破坏注入是确定性 AST 操作,14 族破坏列表、generic/explicit 精确提示词及变体、API 解码设置在附录 A 完整给出。训练侧用 DeepCoder(MIT)4,141 样本;SFT/rSFT/DPO 用 LlamaFactory(lr $10^{-5}$、3 epochs、DPO β=0.1),RL 用 PRIME-RL(lr $10^{-6}$、K=16、$\lambda_{exec}=0.1$、$\lambda_{edit}=1.0$、失败 $-0.2$),超参全部写明。算力门槛低:4B RL 100 步约 8×A100 3 小时,LoRA r=64 可进一步压缩,学术实验室可承受。闭源 frontier 部分需 API 费用(20 模型 × 400 题 × 2 提示,另加多采样稳健性检查),但结论主要来自聚合统计。风险点:GPT-5.5、Opus 4.7 等专有 API 迭代快,附录 C.1 逐模型数字难以精确复现;3 位人类标注者不可再生,但作者给出了完整 κ 统计与标注协议。总体难度中低:基准与训练管线可直接重跑,frontier 测量是唯一成本项。
论文图表
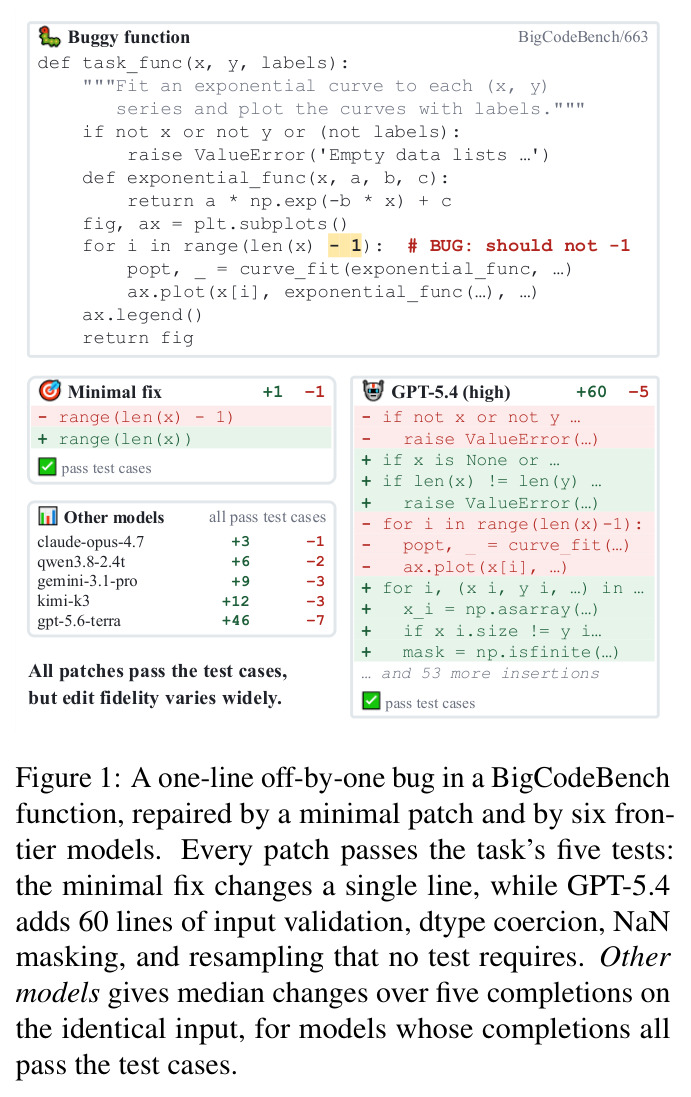
以 BigCodeBench/663 为例:原函数在 for i in range(len(x) - 1) 处有一行越界 bug,最小修复只改这一行(+1/−1)即可通过全部 5 个测试;而 GPT-5.4(high) 给出 +60/−5 的补丁,加入输入校验、dtype 强转、NaN 掩码与重采样,claude-opus-4.7 为 +3/−1,qwen 系列与 gemini 介于 +6/−2 与 +12/−3 之间,所有补丁都通过同样的测试。
这是全文的动机缩影:一行的 bug 引出从 2 行到 60 行不等的修复,直观展示过度编辑现象以及为什么 Pass@1 无法反映这种差异。