探索权重空间编程:能力、泛化与局限 Exploring Weight-Space Programming: Capabilities, Generalization, and Limitations
AI智能体直接读写模型权重,改动1023个参数使数学成绩提升29.45个百分点
前置知识
权重空间编程 (Weight-Space Programming, WSP)
让推理型智能体通过持久Python环境和前向推理工具,直接检查、解读并修改神经网络权重参数的模型适配范式。智能体不使用梯度或优化器,而是基于对模型失败机理的诊断(如重复推理循环),构造稀疏修改、秩一更新、注意力头缩放等有针对性的权重干预,并通过生成评估与教师强制探针迭代验证,最终选择提交编辑版或保留原权重。
本文全部实验都围绕WSP展开:16条编辑轨迹、7个基准、2个模型尺度。不理解"智能体直接改权重"这一操作模式,就无法理解论文关于能力、泛化与局限三大问题的设定。
MLP下投影与注意力输出投影的结构
Transformer每层MLP的下投影矩阵 $W_l$ 把中间激活 $a$ 写回残差流:$W_l a = \sum_j a_j W_l[:,j]$,因此第 $j$ 列就是中间单元 $j$ 的残差流写入方向;注意力输出投影 $O_l$ 按256列一块划分给各注意力头,$O_{l,h}$ 即头 $h$ 的输出块。改动某列或某个头块,等于精确增删一条信息通路。
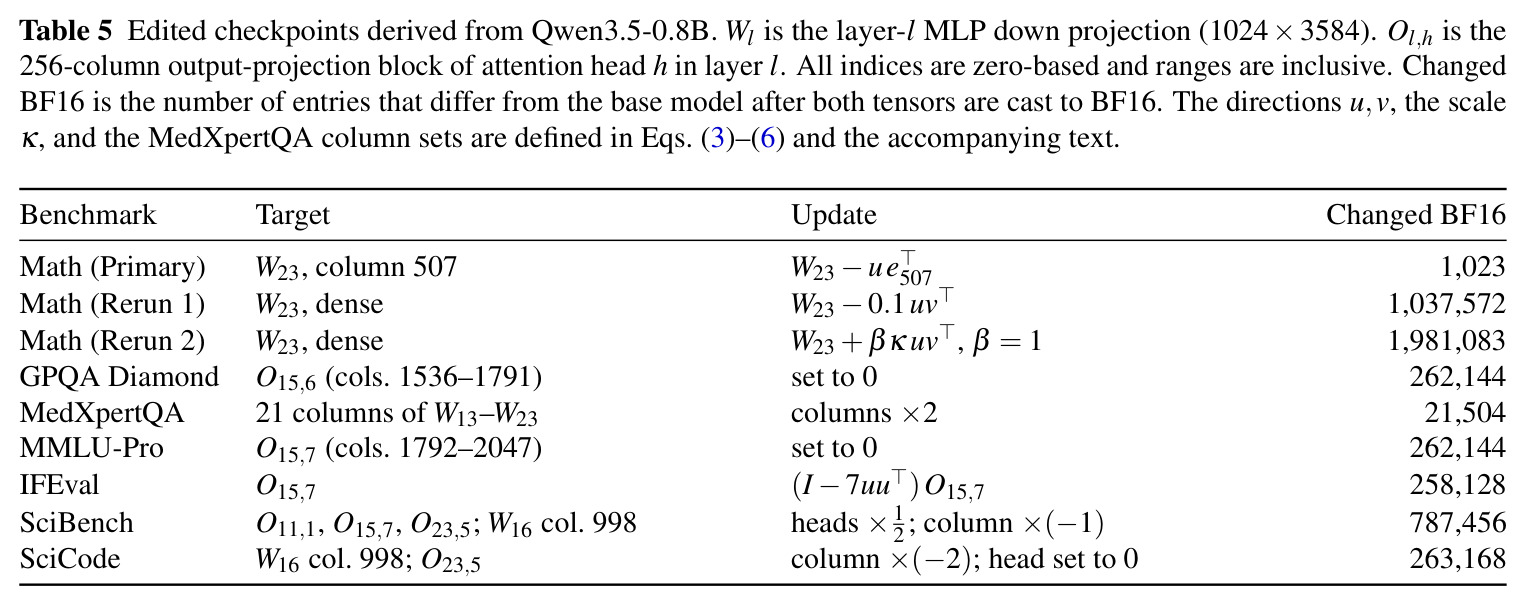
论文几乎所有编辑都作用于这两类张量:如0.8B数学编辑只改 $W_{23}$ 第507列的1023个值,GPQA编辑把 $O_{15,6}$ 整块置零。不懂列/头块的几何含义,就无法读懂附录C的具体干预公式。
教师强制与激活探测
教师强制指把给定文本喂给模型、只读取每个token的对数概率和中间激活而不做自回归采样。它是机理分析的标准工具:可对参考答案、模型的重复片段等做稠密测量,定位某个方向(如"犹豫词"读出方向)在哪些层、哪些位置被激活,为权重编辑提供因果依据,且比生成评估便宜得多。
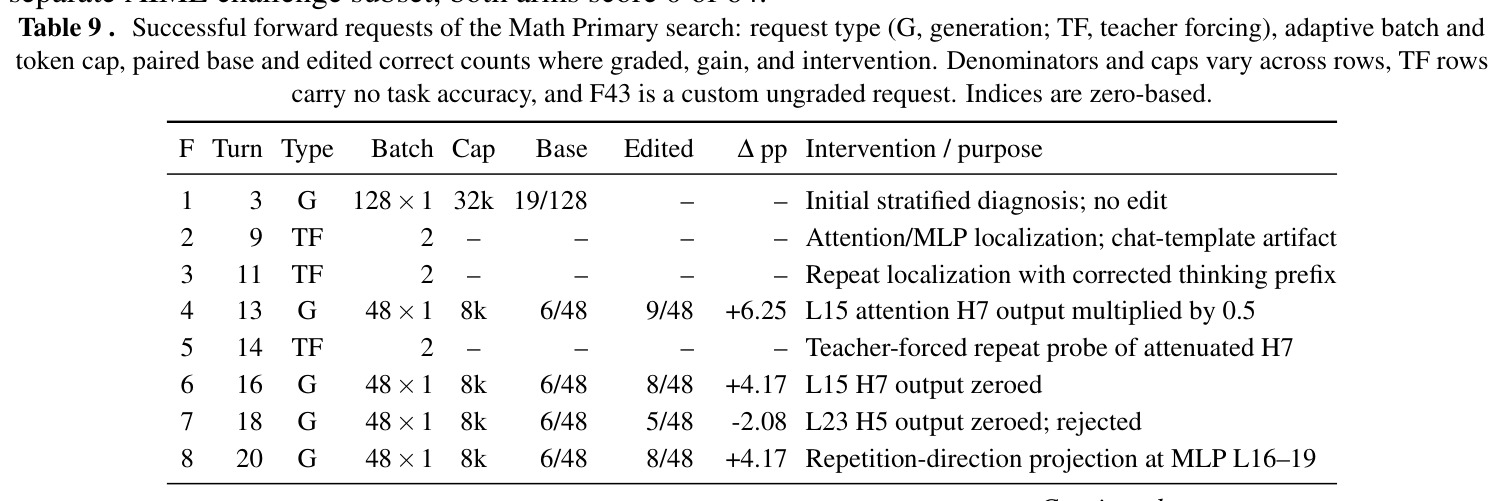
编辑智能体50次前向预算中有18次用于教师强制分析;Math Rerun 1/2 的读取方向 $v$ 完全来自重复推理片段在layer-23 MLP处的激活统计。没有这一概念,附录中的方向构造公式无法理解。
BF16数值精度与有效读出
BF16用8位指数加7位尾数表示浮点数,同一数量级下相邻可表示值间隔较大。论文的编辑在float32中计算、存回BF16:若加性更新小于该数量级的间隔,存储值不变——这就是名义1024个值只实际改变1023个的原因。有效读出 $r(t) = E_t \odot (1+\gamma)$ 指token嵌入行乘上最终RMSNorm增益,是模型实际"读出"该token语义的方向。
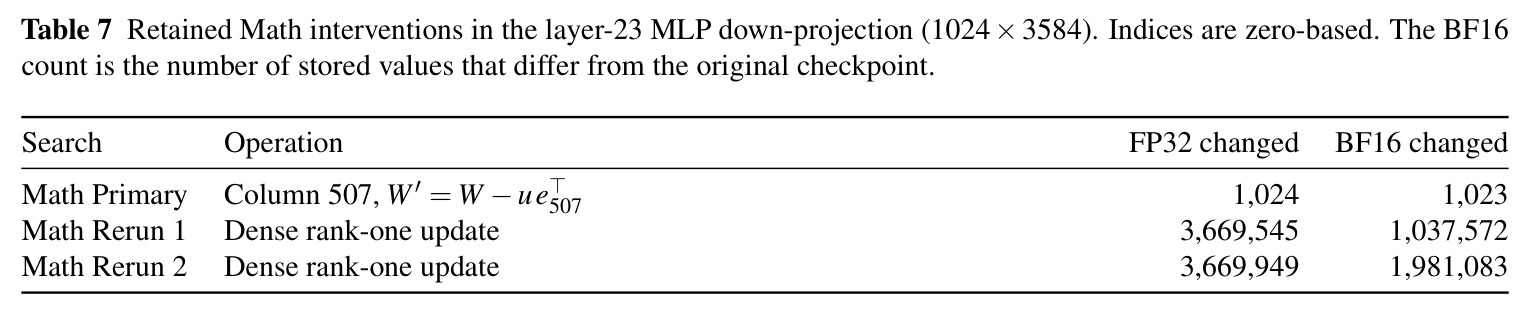
理解BF16才能看懂"Changed BF16"计数与名义编辑足迹的差异(如Rerun 1名义全矩阵、实际只改1,037,572个值);$r(t)$ 是Math Primary编辑方向 $u$ 的构造原料。
配对评估与聚类标准误
比较原模型与编辑模型时,在同一批问题上用相同随机种子生成,按问题聚类计算配对差 $d_q = \frac{1}{n_q}\sum_s (y^{\theta^\star}_{q,s} - y^{\theta_0}_{q,s})$,均值 $\bar\Delta = \frac{1}{Q}\sum_q d_q$,标准误按问题聚类校正,95%区间为 $\bar\Delta \pm 1.96\,\hat{SE}$。配对设计能大幅消除题目难度带来的方差。
论文中"+4.42这样的小增益是否可信"、"9B数学候选为何被弃用"都取决于统计功效:前向工具每次返回配对差及其标准误,智能体据此决定保留或回退权重,这是全文可靠性结论的统计基础。
知识编辑与任务向量(相关工作)
知识编辑指定位并修改网络中存储特定事实的参数(如ROME/MEMIT类方法);任务向量指对同一模型在不同任务上微调后取权重差并做算术组合。两者都预设固定编辑流程或依赖梯度训练,编辑范围与目标事先确定。
论文引言把WSP定位为这两条路线之外的第三条路:由通用推理智能体开放式地诊断、设计并验证干预。且模型编辑文献中"局部修改成功不必然带来整体行为改善"的已知现象,正是本文泛化实验的动机。
研究动机
让预训练模型适配任务的主流方式是梯度优化(如LoRA参数高效微调),依赖任务数据、训练流程与算力;已有的直接权重干预(知识编辑、任务向量算术)则依赖预定义编辑流程。新近提出的权重空间编程(WSP)让推理智能体直接检查并修改参数:原研究中GPT-6 Astra仅修改Qwen3.5-0.8B约0.016%的参数,就把MATH-500准确率从7.9%提升到48.1%,主要修复了导致模型陷入推理循环、无法完成回答的失败模式。但同一研究也报告:对没有此类可识别失败模式的模型收效有限。由此引出根本问题——推理驱动的权重干预究竟是通用的模型适配手段,还是只能修复特定行为缺陷?其能力边界、跨任务泛化、以及独立执行编辑过程的可靠性都缺乏系统刻画:编辑是否可复现、任务编辑能否迁移、开发集增益能否预测留存表现,均无答案。
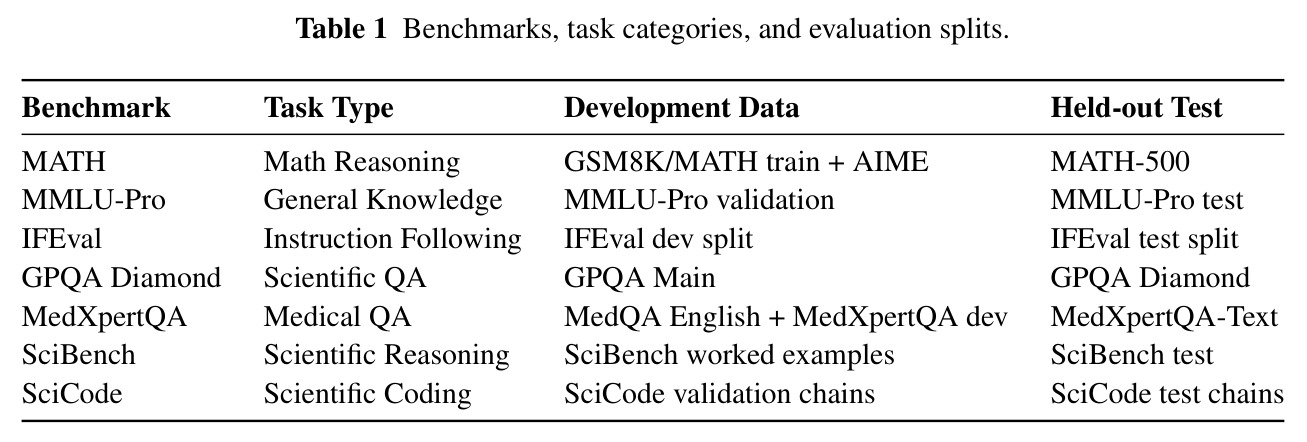
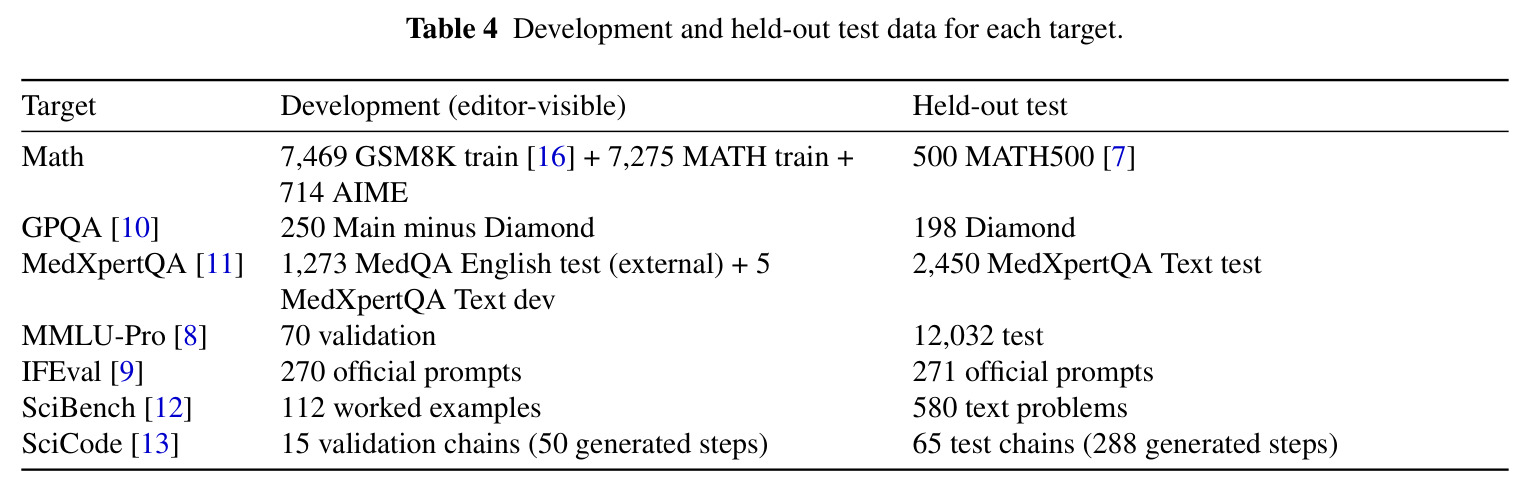
本文的目标是本文目标是把WSP从单点演示推向系统实证,沿三个互补维度提问。能力维度:WSP能否有效改进不同能力?干预的结构与规模如何影响结果?泛化维度:任务专属编辑得到的checkpoint能否在不做任何进一步修改的情况下迁移到其他能力,还是效果局限于目标任务?局限维度:智能体发现、验证并选择有效干预的可靠性如何?编辑结果在不同轨迹与模型尺度间如何变化?为此,作者在Qwen3.5-0.8B与Qwen3.5-9B两个尺度上执行16条编辑轨迹,覆盖MATH-500、MMLU-Pro、IFEval、GPQA Diamond、MedXpertQA、SciBench、SciCode七个基准族;每条搜索从原始checkpoint出发,预算50次前向请求,智能体仅凭开发集反馈决定提交编辑权重或保留原权重,最后在从未见过的留存测试集上与原模型配对评估。
与已有工作不同的是,原WSP研究只展示了单条轨迹的戏剧性成功,属于方法演示而非科学测量。本文的独特切入是把WSP本身当作被研究的对象:第一,对同一模型同一任务做三条独立的数学编辑搜索,检验干预的可复现性与路径依赖;第二,把四个任务编辑后的checkpoint零修改地放到其他基准上,直接测量跨任务迁移的方向与幅度;第三,同时覆盖0.8B与9B两个尺度,分离"基线能力与提升空间"对编辑结果的塑造作用;第四,完整记录智能体的50次探索轨迹与保留/回退决策,把"候选发现、留存验证、最终选择"三个决策环节分开评估。这使论文的问题从"WSP能不能用"升级为"WSP何时有效、为何失效",为这一新范式提供了第一份系统性体检报告。
核心方法
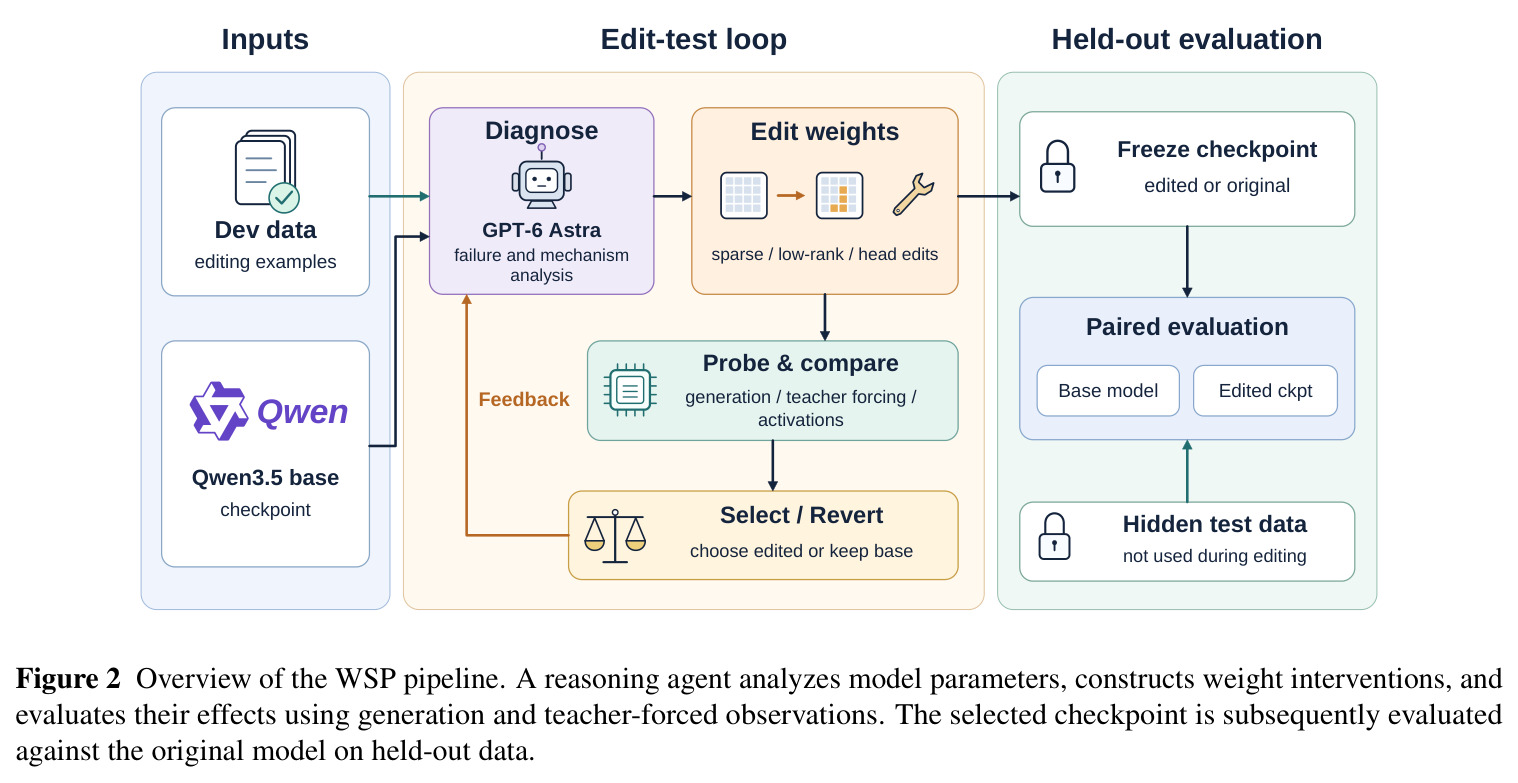
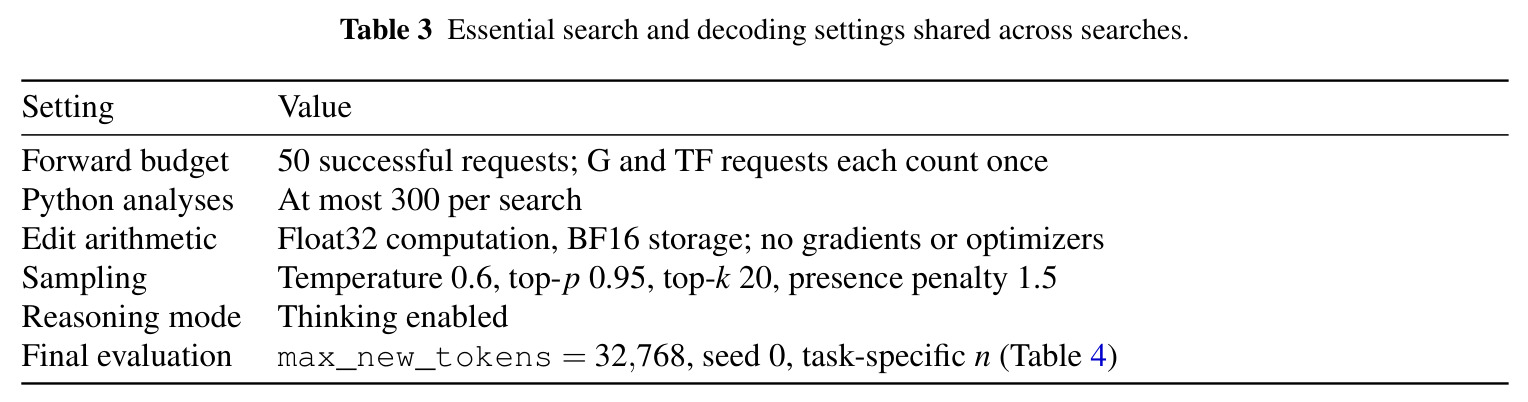
整体流程是一条"编辑-测试循环加留存评估"流水线。编辑智能体GPT-6 Astra(最大推理强度)面对目标模型Qwen3.5-0.8B或9B,拥有两件工具:一是持久Python内核(无GPU、无梯度),可加载任意张量、计算并保存编辑,每条搜索最多300次分析;二是前向工具,每条搜索共50次成功请求,分生成请求(按评测协议采样最多512个答案并自动判分,可同时跑original/edited做配对比较)与教师强制请求(读入最多1024段文本,返回token对数概率、top-k、指定层隐状态与MLP激活)。每轮迭代按 $\theta_{t+1} = \mathrm{bf16}(\theta_t + \Delta\theta_t)$、$\Delta\theta_t = E_t(\theta_t, H_t)$ 应用编辑,float32计算、BF16存储;只允许改transformer块内参数,token嵌入、最终归一化、LM头与架构固定。搜索结束后,选定checkpoint与原模型在隐藏测试集上按相同协议做配对评估。
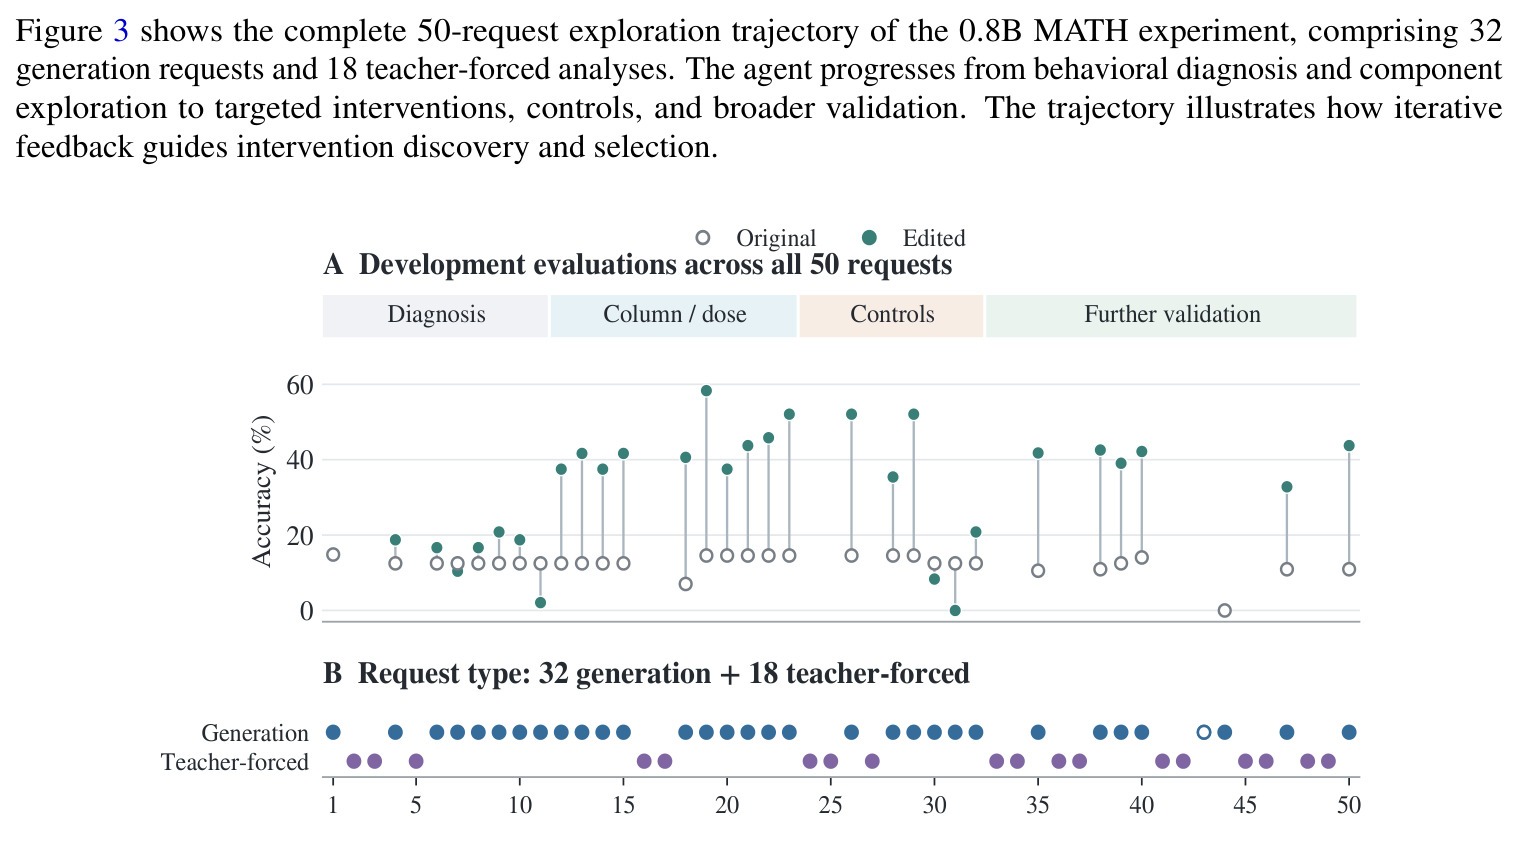
核心思想是"先诊断机理、再构造有依据的干预、最后靠因果验证决定去留",与梯度微调有本质区别:不用损失函数拟合权重,而是让智能体提出失败机理假设并用实验证实。以0.8B数学编辑为例:智能体从诊断发现128个样本中111个撞上32k token上限,判断主因是重复犹豫的推理循环;再用教师强制定位到layer-23 MLP;然后构造方向 $u$——用"犹豫类"词(Wait/However/But/Maybe/Perhaps)与"推进类"词(Therefore/Thus/So/Now/The/First/Next/Let)的有效读出 $r(t)=E_t\odot(1+\gamma)$ 之差归一化得到——只修改 $W_{23}$ 第507列:$W_{23}' = W_{23} - \alpha u e_{507}^\top$。随后做剂量扫描($\alpha\in\{0,0.5,0.75,1,1.5,2\}$,峰值在$\alpha=1$)、消融与随机方向对照,最后在1152道未用于选择的开发题上确认后提交。若候选改进无法可靠验证,智能体有权保留原权重——16条轨迹中有6条如此选择。
方法步骤详情
完整步骤以0.8B Math Primary为例。第一步诊断:一次128题生成请求显示19/128正确、111个样本截断,锁定"长推理不收敛"症状。第二步因果定位:教师强制探测加小规模头编辑实验,先试L15头7(+4.17到+6.25),再深入layer-23 MLP;改第40列有害(-10.42),被拒绝。第三步编辑构造:把犹豫词与推进词读出对比方向 $u$ 写入第507列,第12次请求即得+25.00。第四步对照实验:8192 token上限下,定向编辑20/48,对比消融4/48、反向$\alpha=-0.5$得0/48、等范数正交随机方向10/48;32k上限剂量扫描依次7/22/25/28/21/18(每48题),峰值$\alpha=1$。第五步广泛确认:在六个不相交开发集A–F共1152题上,正确数从126升到484(10.94%→42.01%),377个救援、19个回退;AIME挑战子集双方均0/64。第六步提交与留存评估:智能体仅凭开发反馈选择checkpoint,随后在MATH-500隐藏测试上配对评估(8.35→37.80),差值按问题聚类计算标准误与95%区间。
技术新颖性
技术新颖性体现在四点。其一,干预构造是"机理驱动"的:方向 $u$、$v$ 不是优化出来的,而是由激活统计与词元读出对比解析地构造,如Rerun 1的读取方向 $v$ 是重复推理片段后三次检查周期与首次检查周期的平均激活差再做正交投影 $v = \mathcal{N}(P^\perp_{S_v} d)$ 剔除生产性控制;写入方向 $u$ 与所有受保护token(数字、运算符、\boxed、Therefore等)的读出正交,保证不破坏关键计算通路。其二,验证协议严谨:配对生成(同题同种子)、剂量-响应曲线、消融与随机方向对照,构成无梯度世界的因果推断替代品。其三,保留/回退机制:编辑必须"增益明显大于标准误"才被保留,六条轨迹因此选择原权重,9B数学候选虽开发集+29.69却被弃用(实测-0.35)。其四,全部16个干预以解析式完整公开(附录C),每个checkpoint与基座的差异都可由张量名、零基索引与公式精确重建。
实验结果
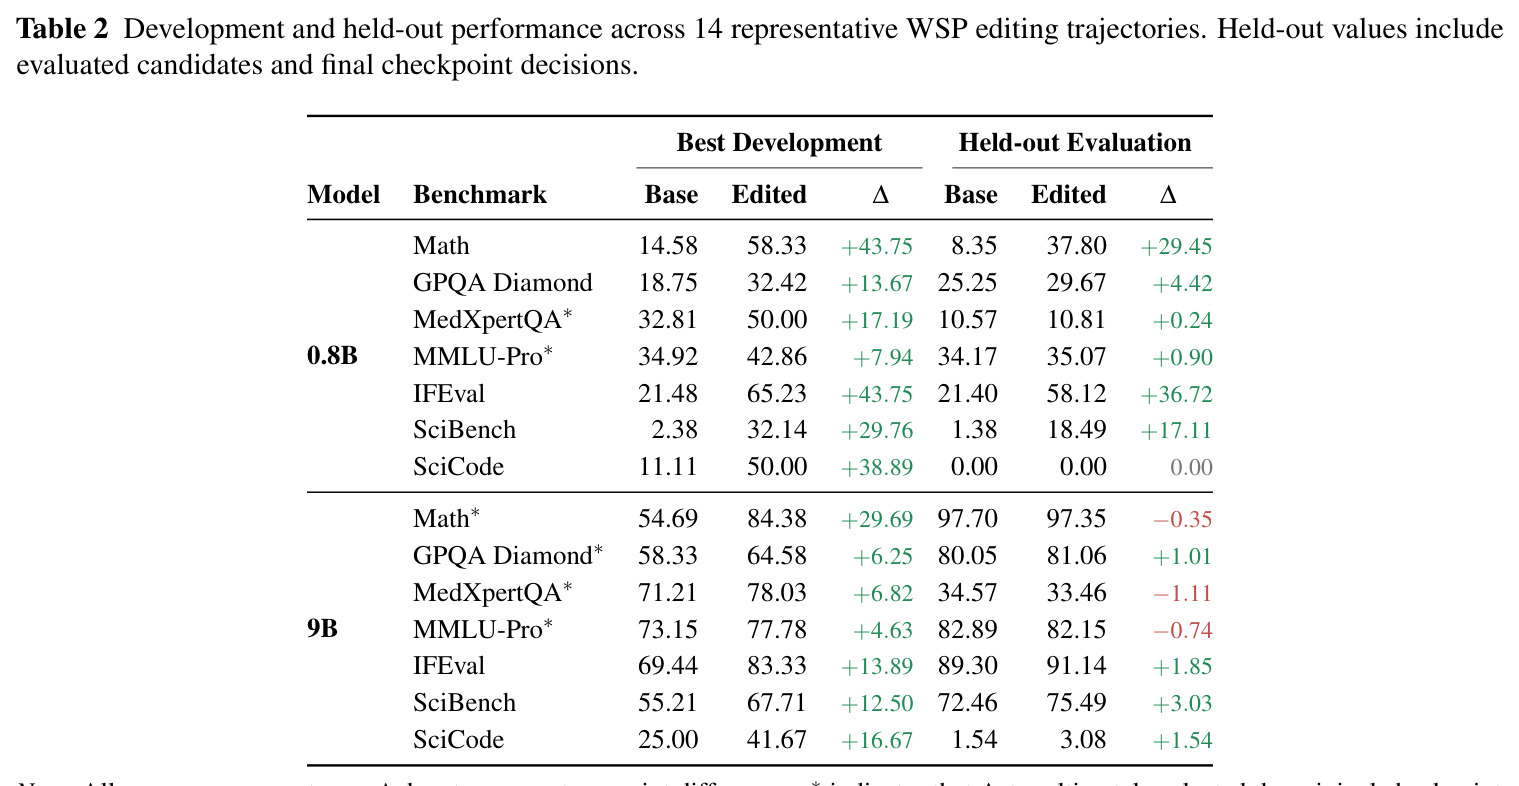
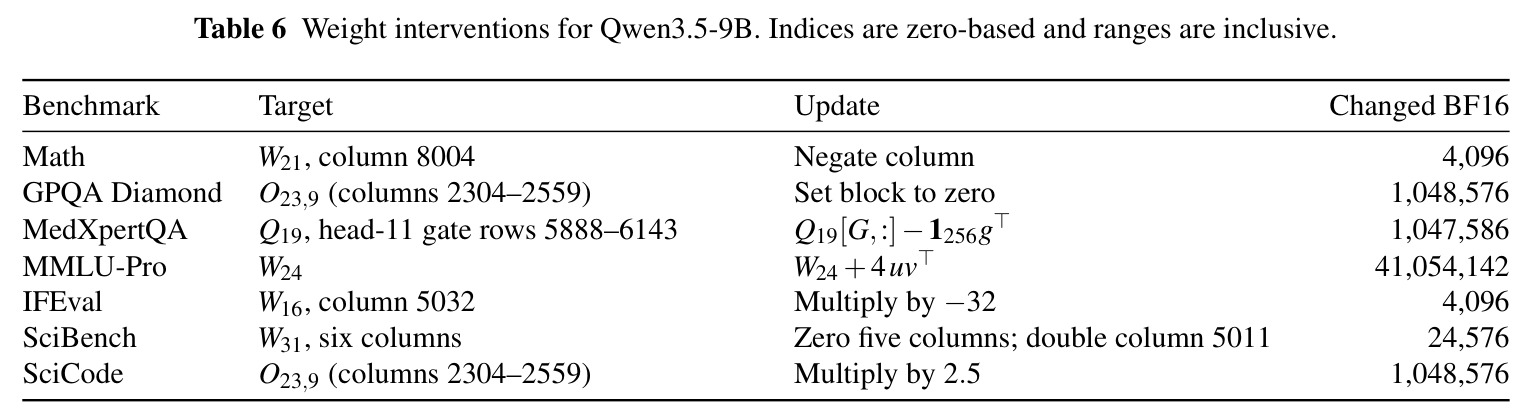
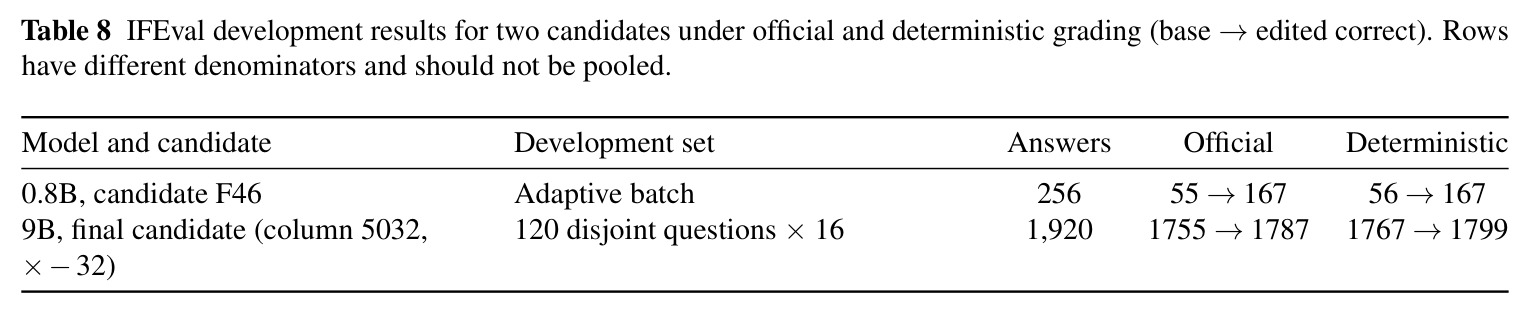
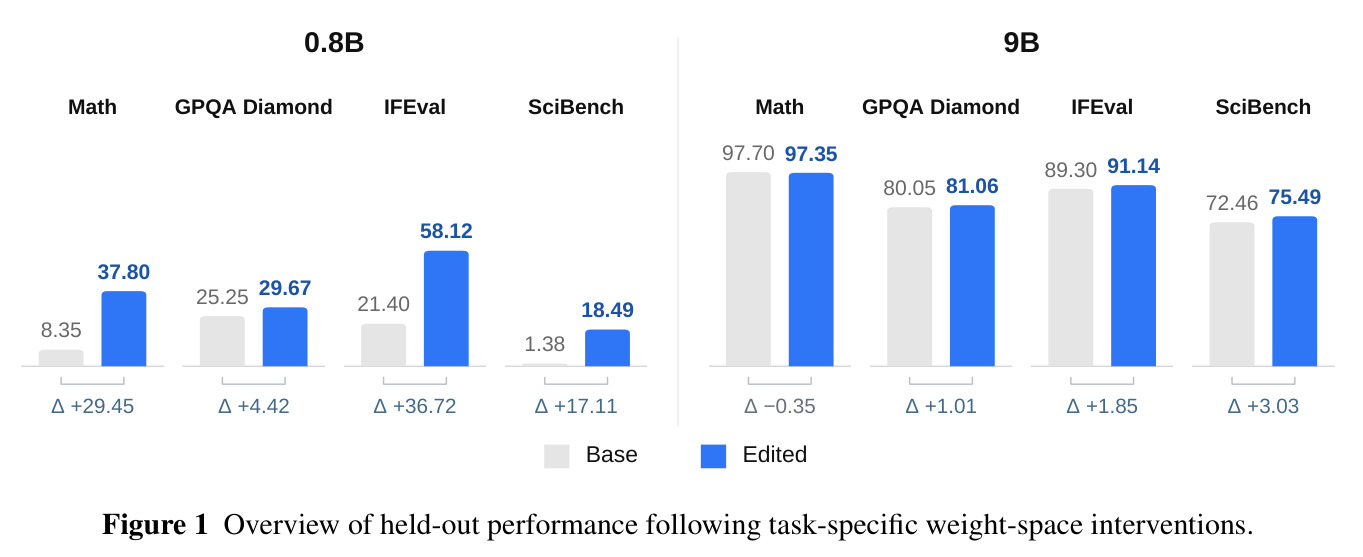
论文给出四层核心发现。第一,能力提升显著且高度局部化:0.8B留存测试上MATH-500从8.35升至37.80(+29.45个百分点,仅改1023个BF16值)、IFEval从21.40升至58.12(+36.72)、SciBench从1.38升至18.49(+17.11)、GPQA Diamond +4.42;9B提升温和,三项分别为+1.85、+3.03、+1.54。第二,干预结构重于规模:三条独立数学搜索都改layer-23 MLP下投影,改1023个值得+29.45,改1,037,572个值只得+5.00,改1,981,083个值得+27.30。第三,跨任务迁移不均匀:0.8B数学编辑零修改提升GPQA +3.03、IFEval +12.18、SciBench +20.10;9B SciBench编辑使IFEval达91.51,但部分任务回退。第四,可靠性是瓶颈:16条轨迹中6条保留原权重,9B数学候选开发+29.69却实测-0.35,0.8B SciCode开发+38.89但测试0→0;0.8B增益在七个类别全面大于9B,说明基线越强、提升空间越小。
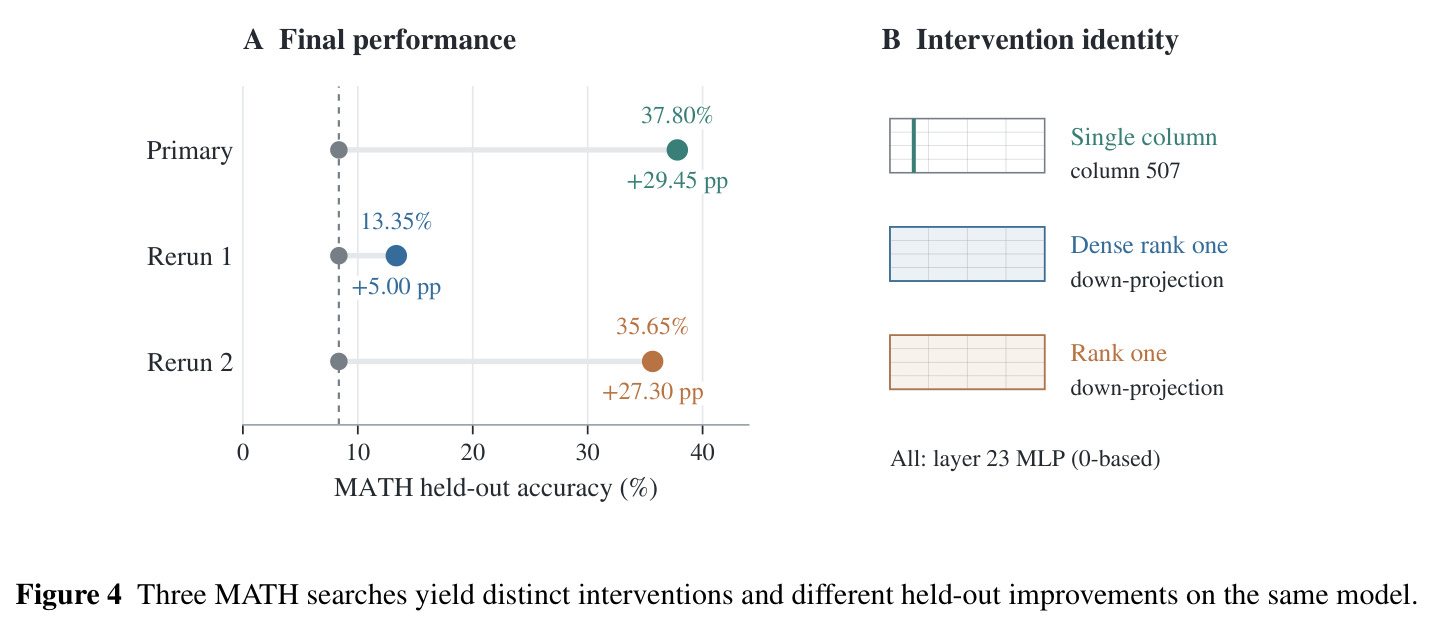
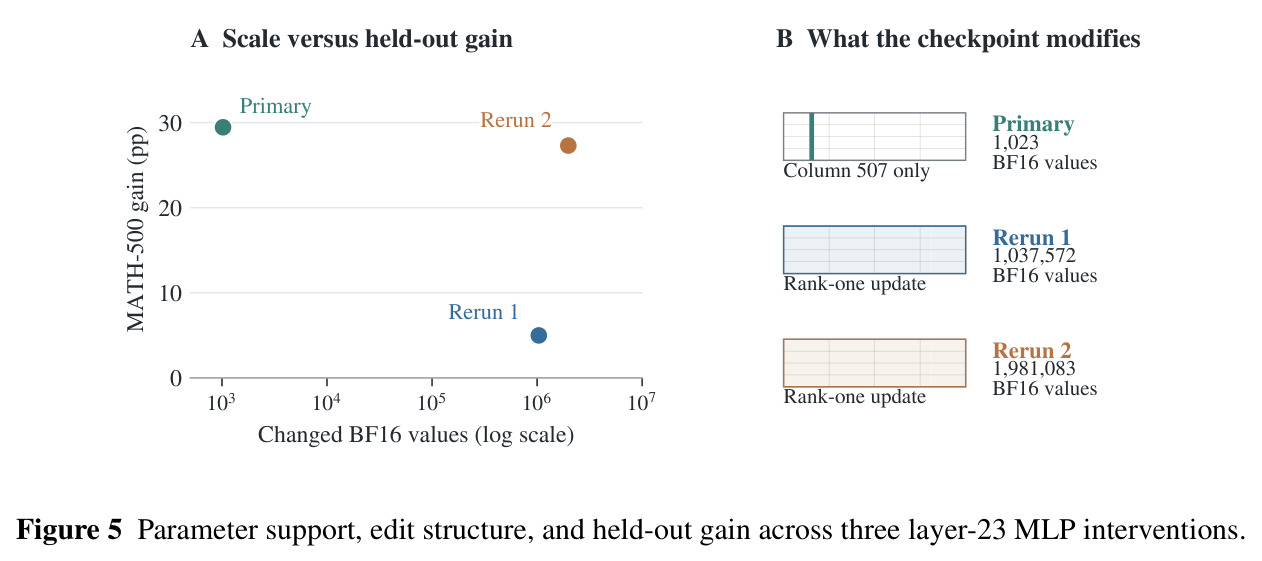
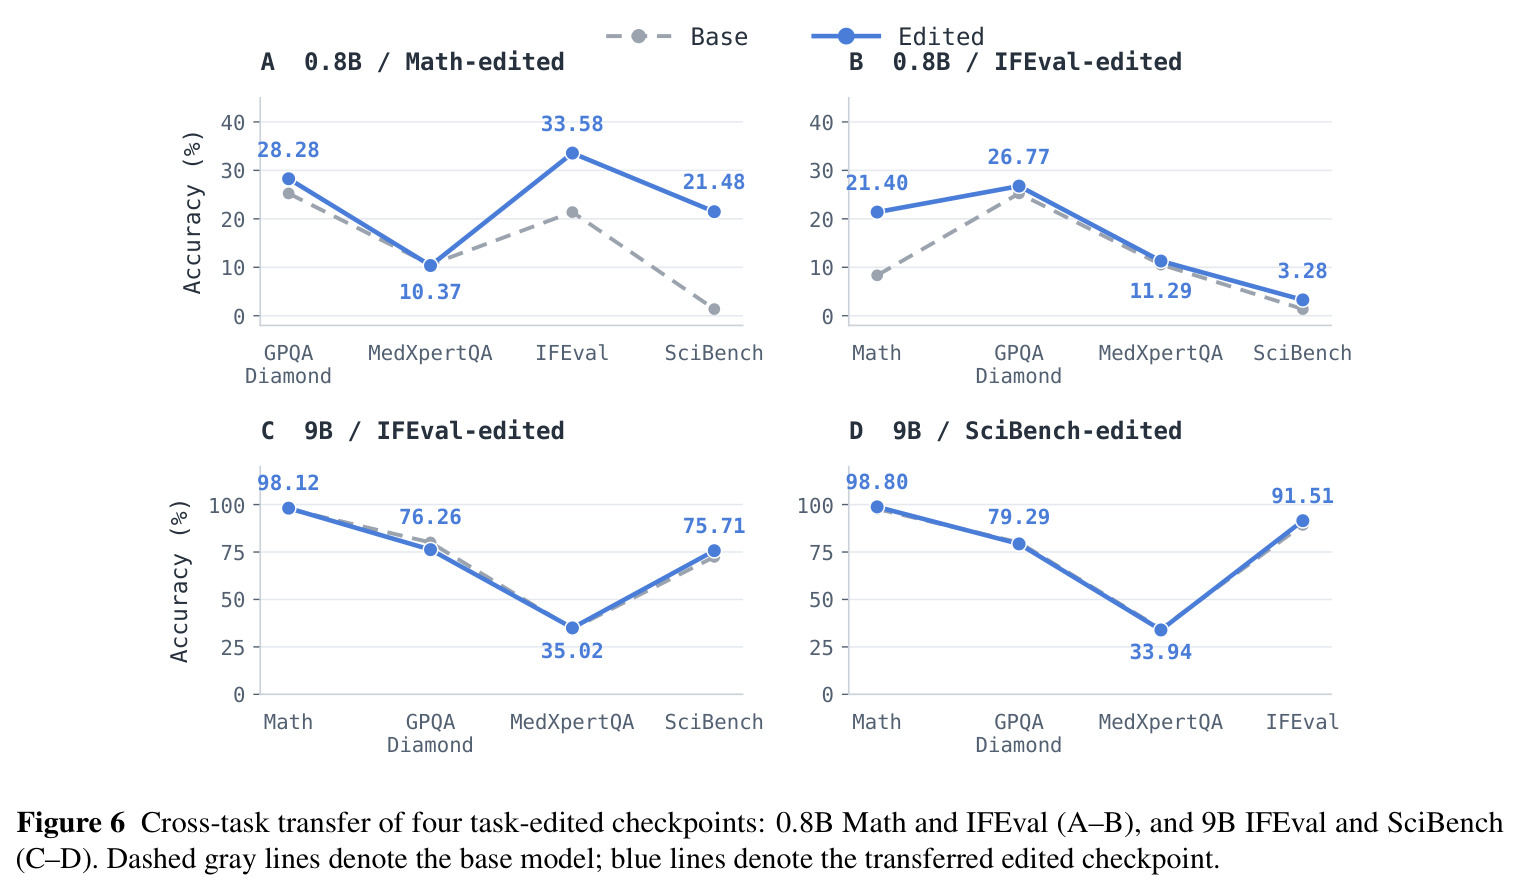
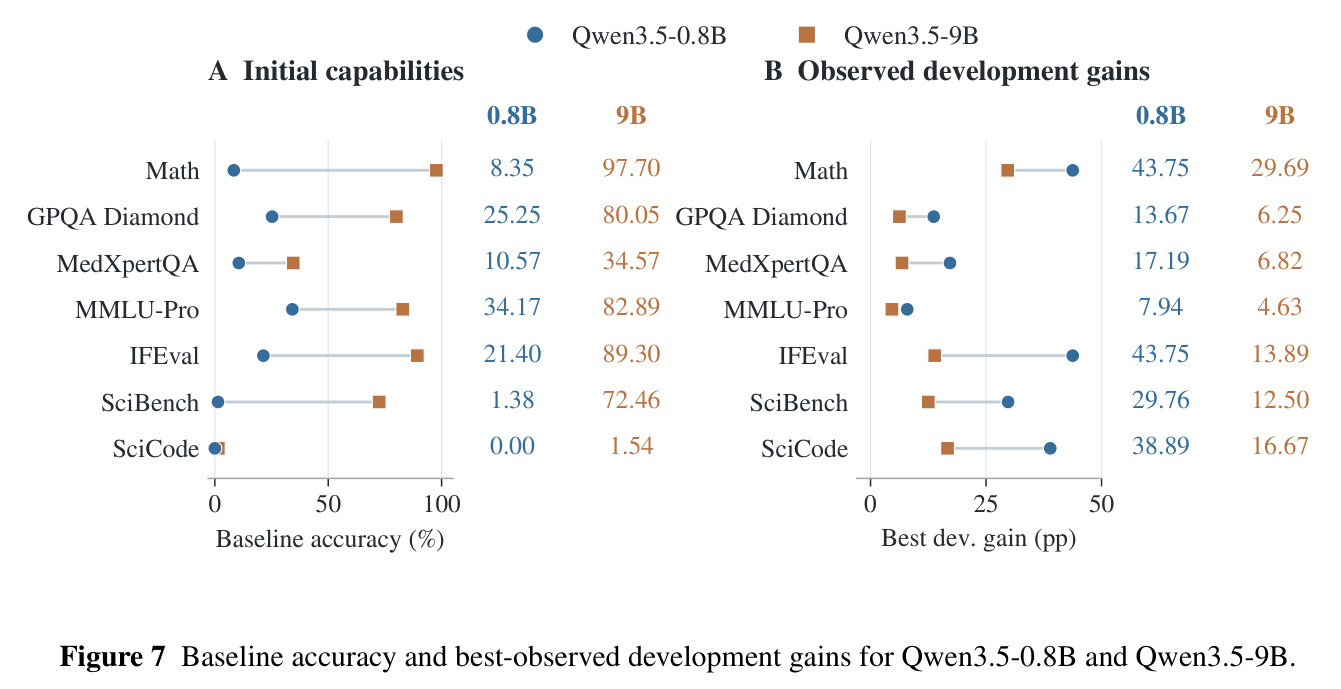
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MATH-500(数学推理,Qwen3.5-0.8B) | 准确率(%),500题留存测试 | 37.80(开发集 14.58→58.33,+43.75) | 原模型 8.35 | +29.45个百分点,仅修改1023个BF16参数($W_{23}$ 第507列) |
| IFEval(指令跟随,0.8B) | 官方严格准确率,271条留存提示 | 58.12(编辑为 $O'_{15,7}=(I-7uu^\top)O_{15,7}$,改258,128个值) | 21.40 | +36.72个百分点 |
| SciBench(科学推理,0.8B) | 数值答案准确率(5%相对容差,580题) | 18.49(联合缩放三个注意力头并取反 $W_{16}$ 第998列) | 1.38 | +17.11个百分点 |
| GPQA Diamond(科学问答,0.8B) | 准确率,198题 | 29.67(置零 $O_{15,6}$ 整块,262,144个值) | 25.25 | +4.42个百分点 |
| IFEval(Qwen3.5-9B) | 官方严格准确率 | 91.14(最终编辑为 $W_{16}$ 第5032列乘-32,仅4096个值) | 89.30 | +1.85个百分点,截断从58降到2 |
| SciBench(Qwen3.5-9B) | 数值答案准确率 | 75.49($W_{31}$ 六列修改,24,576个值) | 72.46 | +3.03个百分点 |
| SciCode(Qwen3.5-9B) | 完整代码链通过率(65链/288生成步) | 3.08($O_{23,9}$ 乘2.5) | 1.54 | +1.54个百分点 |
| MATH-500(Qwen3.5-9B,候选被弃用) | 准确率 | 保留原权重97.70(候选开发集+29.69被否决) | 97.70 | 弃用候选实测-0.35,体现选择环节的保守可靠性 |
| MATH-500 三条独立搜索(0.8B) | 留存准确率 | 37.80 / 13.35 / 35.65 | 8.35 | +29.45 / +5.00 / +27.30,同一张量上不同干预结构导致增益差异巨大 |
局限与改进
作者承认的局限:开发增益不必然转化为可靠的留存提升(9B数学候选开发+29.69、测试-0.35;9B GPQA确认阶段从261/360降到259/360);固定50次请求预算内智能体可能无法发现并验证足够有效的干预,六条轨迹保留原权重;重复评估计算代价高昂;成功编辑与泛化的机理仍不清楚,包括联合修改多个位置的影响、开发数据规模与多样性的作用;WSP尚未在长程推理与复杂智能体任务上评测。我的补充观察:部分留存集太小(GPQA Diamond仅198题、0.8B数学编辑的+4.42很难说远超噪声);0.8B SciCode在50步验证链开发集上+38.89而288步测试链0→0,暴露开发/测试分布落差;Qwen3.5-9B数学基线已达97.70的近饱和水平,9B上增益微弱更多反映headroom枯竭而非方法失效;且全部实验只用单一编辑智能体,结论对其他智能体是否成立未知。
独立分析的弱点
独立分析出四个弱点。第一,选择环节统计功效不足:发现集常为48题,+6.25这类增益的标准误约7个百分点,9B数学的+29.69开发增益经1152题确认支持却仍在测试翻车,说明开发/测试分布差异比采样噪声更危险;改进方向是引入序列检验、跨域确认批次或在提交前强制跑一个"伪留存"集。第二,无梯度基线对照:论文没有回答"同样算力下LoRA微调能否做得更好或更差",WSP的真实价值缺少一个成本对齐的比较;改进方向是报告LoRA在同等GPU小时与数据量下的成绩。第三,编辑器单点依赖:全部实验只用GPT-6 Astra一个智能体,轨迹方差巨大(同任务+5.00到+29.45),无法区分增益来自方法还是运气;改进方向是多编辑器、多随机种子的大规模重复并报告分布。第四,0.8B SciCode测试0→0说明单点权重编辑难以修复链式复合任务的失败,编辑可能只缓解表面症状;改进方向是按依赖链逐级干预或组合多个checkpoint。另如0.8B MedXpertQA把截断从502降到296但准确率-0.65,提示"更完整的回答"与"更正确的回答"需要分开优化。
未来方向
作者提出的方向:更可靠的干预选择(建立开发集收益与留存收益的预测关系);更高效的评估以降低重复前向的算力成本;对成功编辑与迁移机理的深入理解(多位置联合编辑、开发数据规模与多样性的影响);把WSP扩展到长程推理与智能体任务。基于本文成果可延伸的研究:一是把16个解析式checkpoint当作"任务向量库",研究编辑算术——数学编辑与IFEval编辑叠加能否兼得两者收益、方向 $u$ 的线性组合有何语义;二是用保留/回退协议研究"何时该信任开发集",发展带提前停止的贝叶斯checkpoint选择;三是把WSP与可解释性工具(电路发现、稀疏自编码器)闭环,让智能体的假设空间受机理图谱先验约束;四是在更大尺度或MoE模型上检验"基线越强编辑越难"的headroom规律是否仍成立;五是系统测量编辑的副作用与持久性,如数学编辑在训练或分布漂移后是否稳定、对未测能力是否有隐性损害。
复现评估
复现条件分两档。低门槛档:项目主页wsp-scope.github.io与GitHub仓库WSP-Scope/WSP-Scope-Project公开,附录C把16个checkpoint的编辑写成精确公式(张量名、零基索引、更新式与改变值计数,如Math Primary为 $W_{23}' = W_{23} - u e_{507}^\top$,$u$ 由式(3)从token嵌入与最终RMSNorm增益构造),任何人加载Qwen3.5权重即可在几分钟内重建全部编辑并复跑留存评估;数据切分也完全确定(IFEval用random.Random(20261104)洗牌分为270开发/271测试,SciCode用官方可执行fixture)。高门槛档:复现智能体搜索本身需要GPT-6 Astra最大推理强度权限、带GPU worker的前向工具基础设施,单条搜索50次前向(一次完整生成可达约半小时、答案最长32,768 token)加最多300次Python分析,且结果路径依赖明显,重跑大概率得到不同干预。总体评估:验证论文结果容易,复现发现过程昂贵且不确定。
论文图表