WorldFoundry:迈向世界智能的统一开源基础设施 WorldFoundry: Towards Unified Infrastructure for World Intelligence
用“持久状态+干预动力学+观测反馈”闭环定义世界模型,并构建统一的推理与证据化评测底座
前置知识
世界模型(World Model)
对环境运作规律的内部可学习模型:系统从观测历史推断环境的隐藏状态,预测该状态在自然演化与外部干预下的变化,并生成不同动作分支下可能出现未来观测。概念源自强化学习中的 World Models、PlaNet、Dreamer 系列,如今扩展到视频生成、3D/4D 重建与具身控制等视觉领域。
全文的定义、能力分级框架和基础设施设计都围绕“什么才算世界模型”展开,不掌握这一概念就无法理解论文的判据与野心。
潜空间动力学与 q–p–g 三算子
把世界建模写成三个概率算子:状态推断 $q(z_t \mid h_t)$ 从交互历史估计潜状态,转移模型 $p(z_{t+1} \mid z_t, c_t)$ 预测施加动作后的状态演化,观测解码 $\hat{o}_{t+1} \sim g(\cdot \mid z_{t+1})$ 把状态渲染回可观察输出。这是 PlaNet/Dreamer 一脉 latent dynamics 的抽象化,与具体网络架构无关。
论文的核心形式化定义(公式 1)直接建立在这三个算子上,是它区分“基础生成模型”与“生成式世界模型”的技术依据。
闭环交互与反事实一致性
闭环指“动作→环境变化→观测→状态修正→再预测”的循环:干预的效果必须在状态中持久留痕,新观测要能反过来修正状态。反事实指在同一状态下比较不同动作分支的后果。论文主张只有两者同时成立,世界建模回路才算闭合。
“回路是否闭合”是论文划出的世界模型与普通生成模型的分界线,也是它批评现有基准只测感知质量的核心论点。
视频扩散模型与交互式世界模型
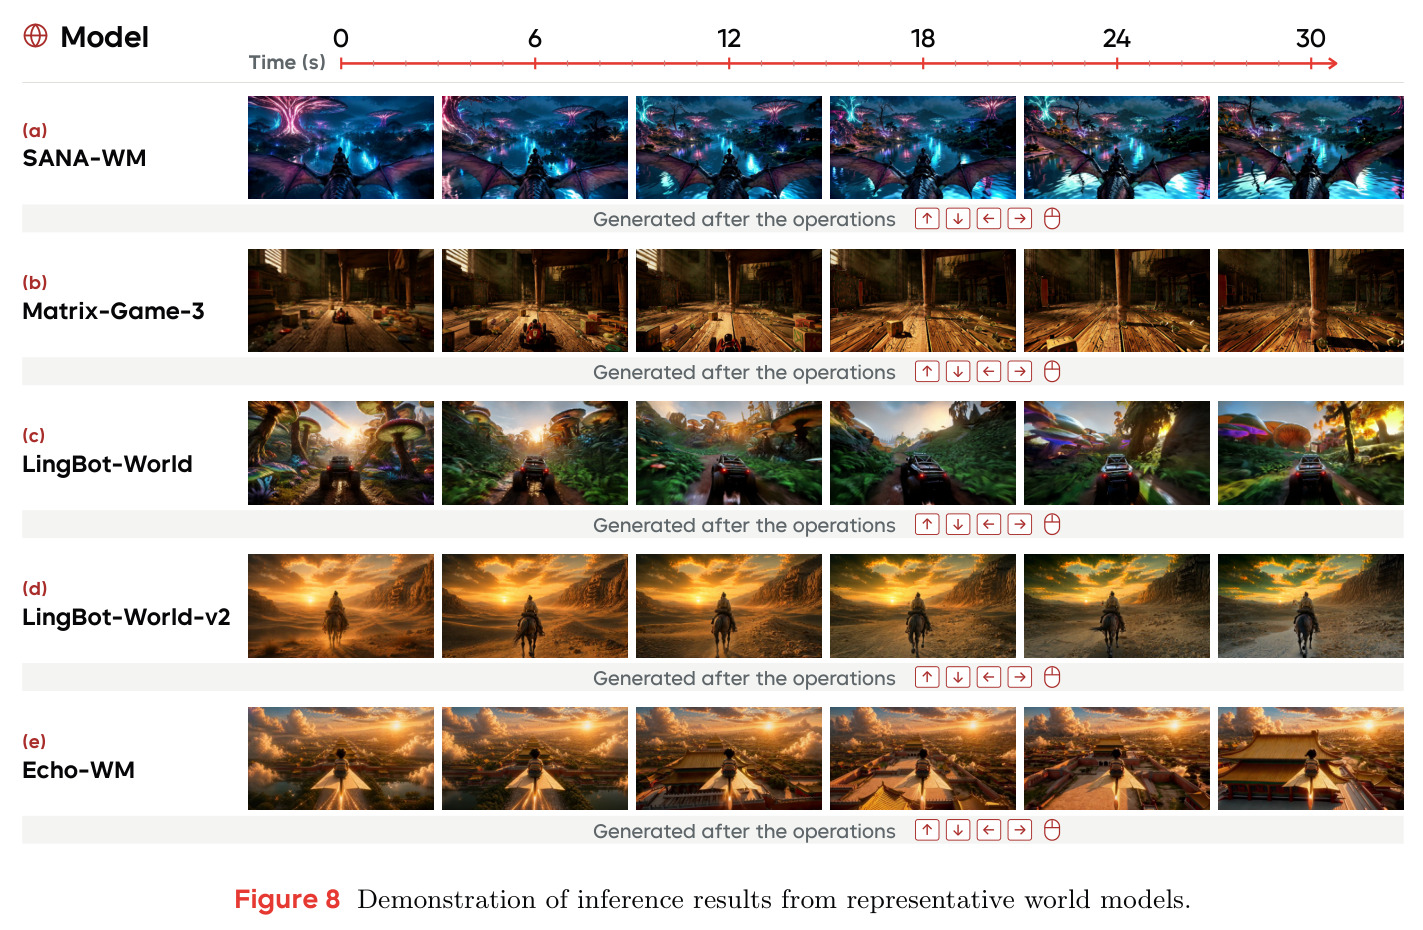
视频扩散模型(如 Wan、HunyuanVideo、CogVideoX、LTX)通过去噪学习时空先验做文本/图像条件生成;交互式世界模型(如 Matrix-Game、LingBot-World、YUME、SANA-WM)以自回归方式接受键盘/鼠标动作流逐帧演化出可导航环境,通常维护会话状态以支持连续交互。
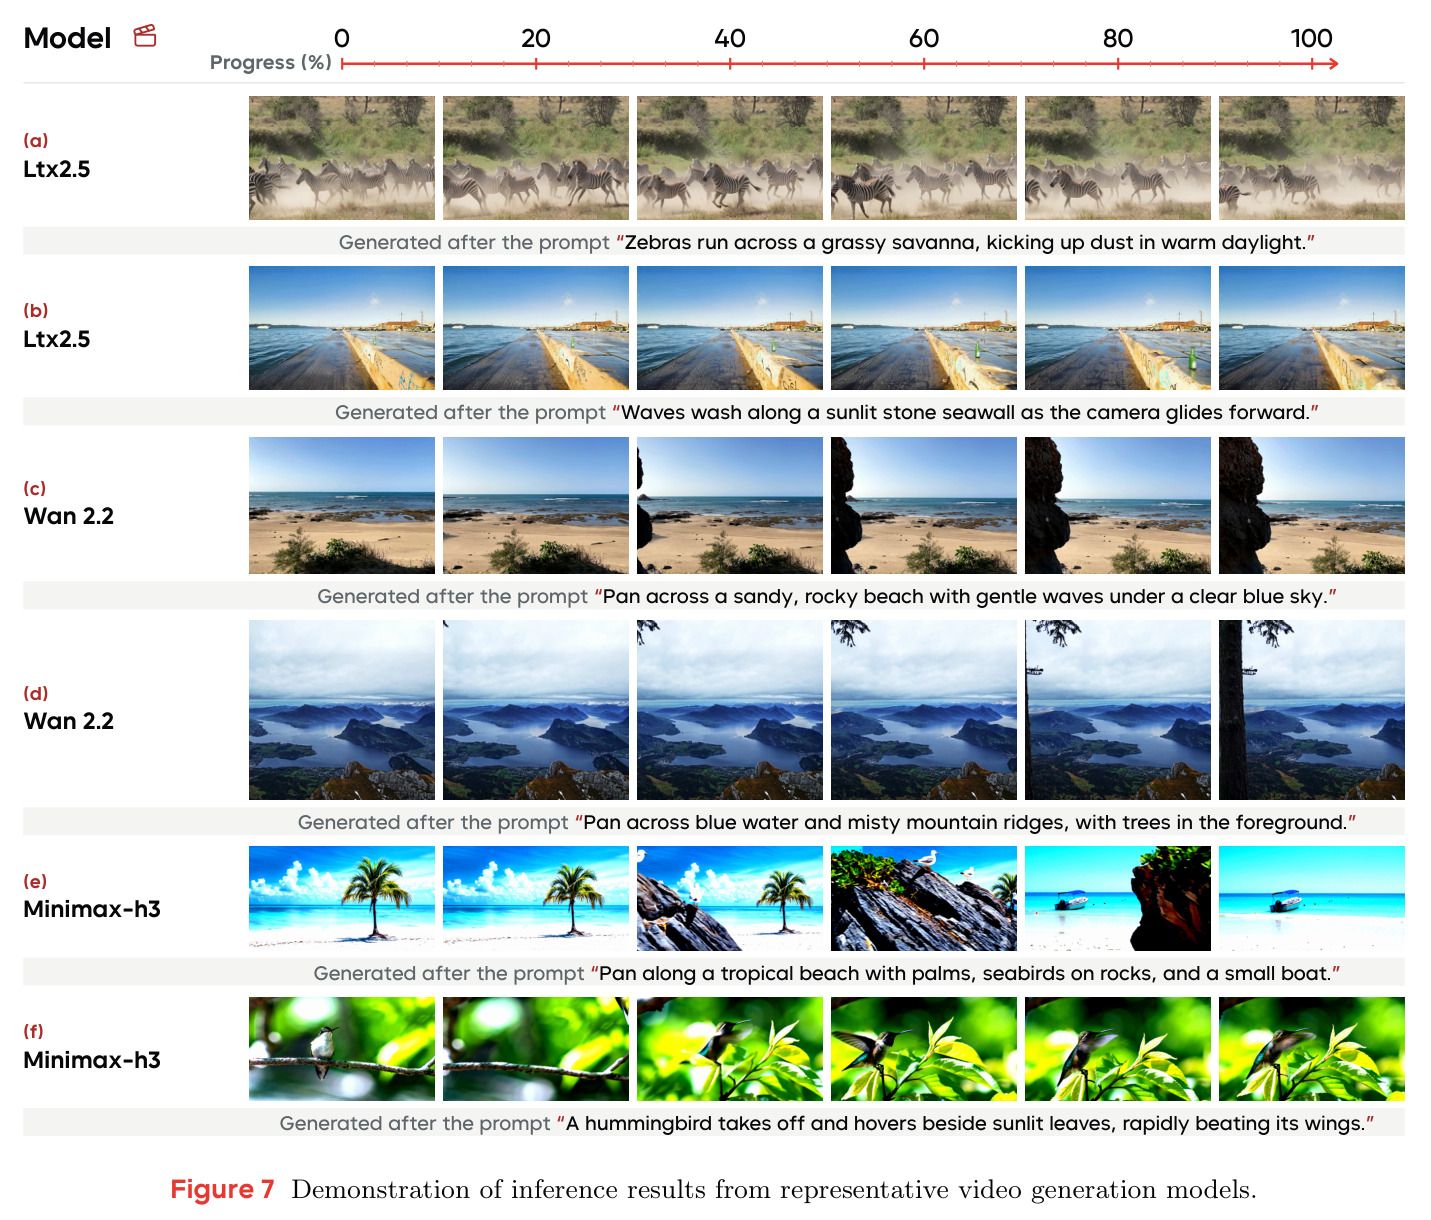
它们是 WorldFoundry 集成的两大模型家族,实验部分(图 7 视频生成、图 8 三十秒交互 rollout)的定性分析全部围绕这些系统展开。
3D/4D 场景表示(点图与高斯泼溅)
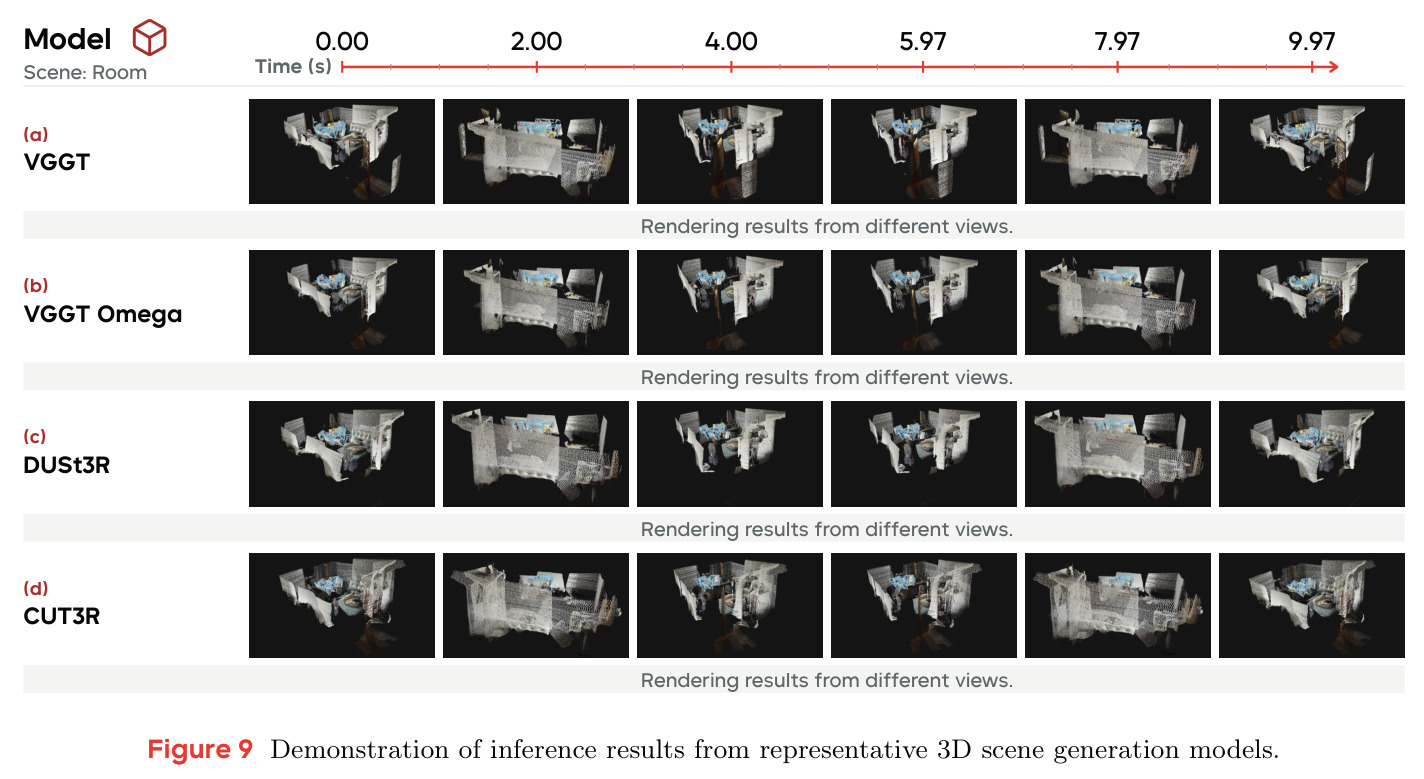
点图(point map)把每个像素映射回 3D 坐标,DUSt3R/VGGT 以此做前馈重建;3D 高斯泼溅(3DGS)用各向异性高斯表达外观,支持实时新视角渲染(Splatt3R、FlashWorld);4D 表示在此基础上引入时间维度,建模动态场景(MonST3R、NeoVerse、Lyra)。
3D/4D 是 WorldFoundry 统一适配的四个模态之一,图 9 的同场景对比实验与工件契约(几何类工件)都依赖这些表示。
VLA 与具身策略闭环评测
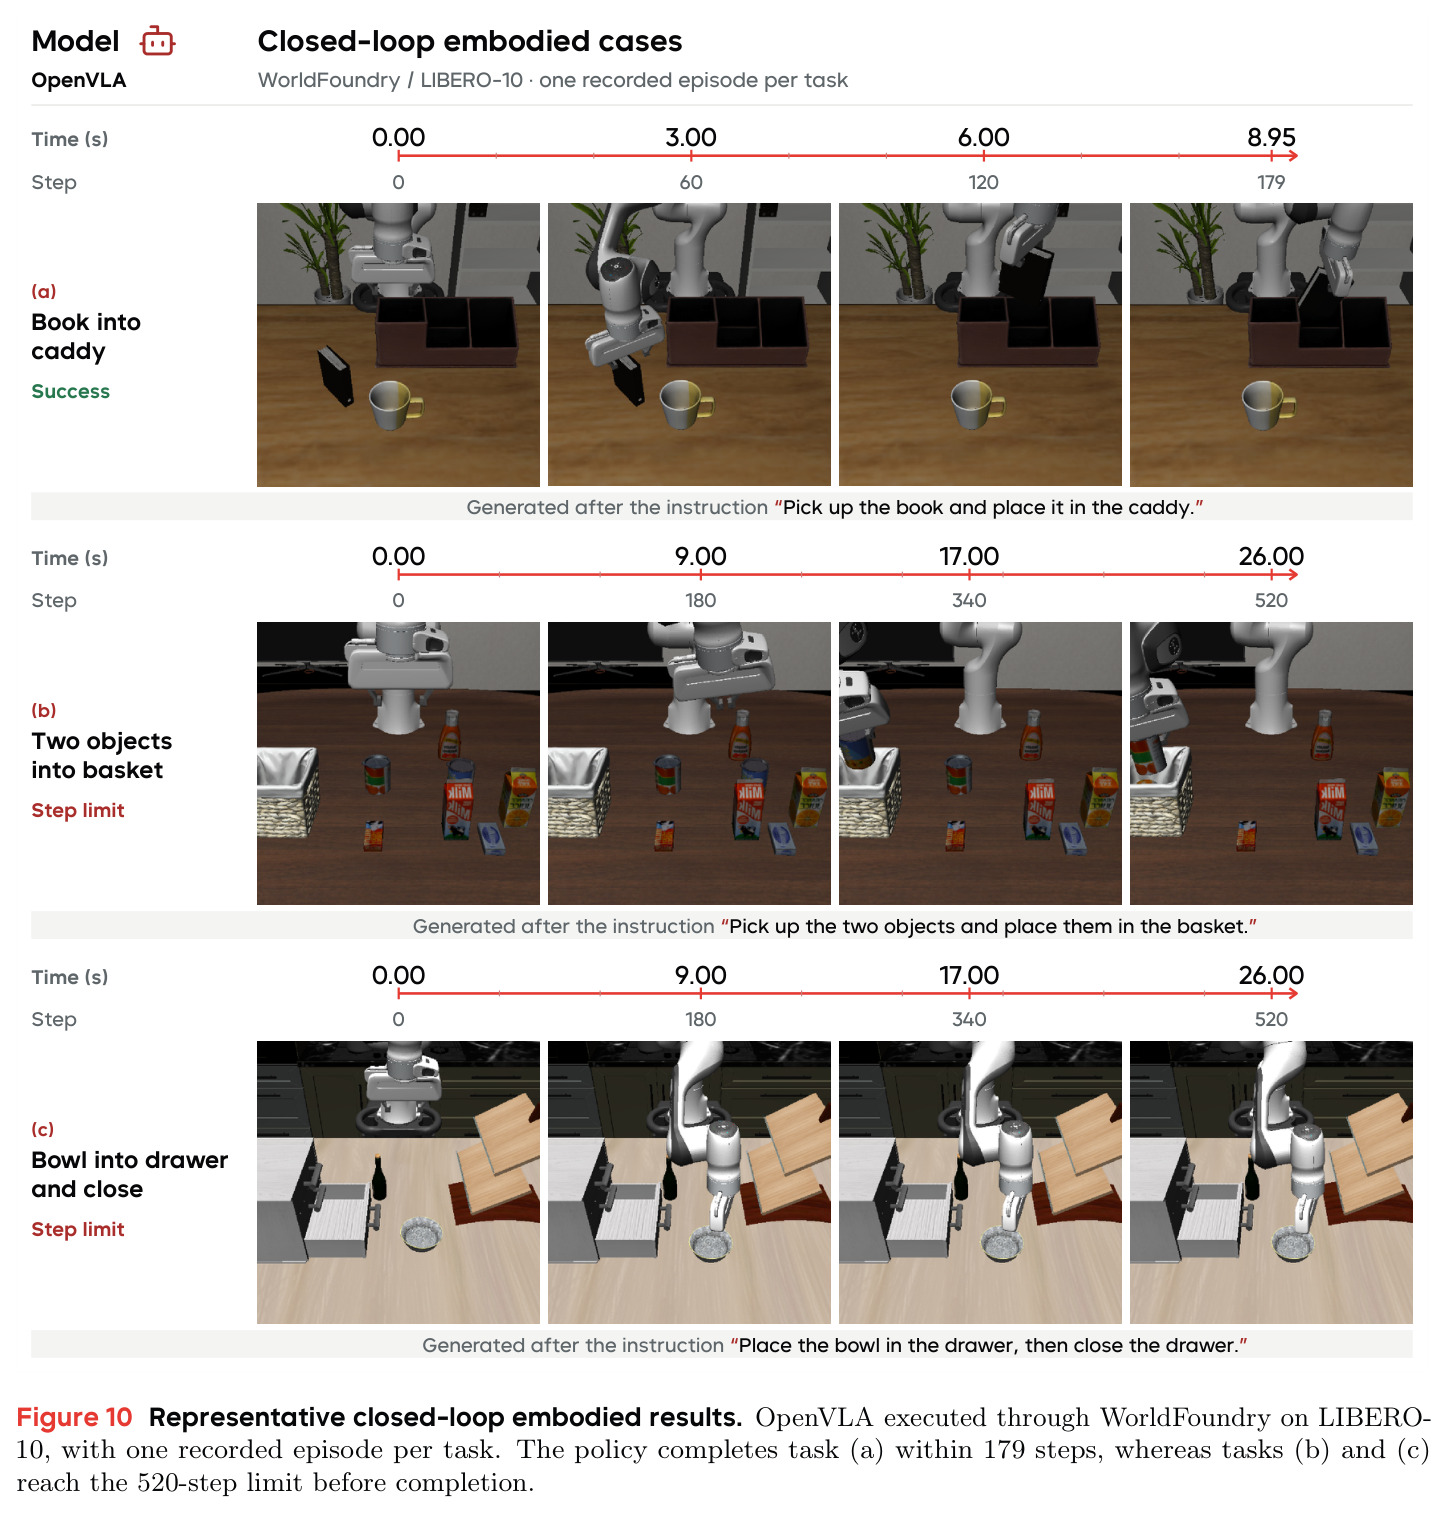
Vision-Language-Action(VLA)模型把视觉观测与语言指令映射为机器人动作(如 OpenVLA、RoboFlamingo);Vision-Action(VA)仅用观测;World-Action(WAM)进一步耦合环境演化预测。评测分两条线:离线动作预测准确率,以及在 LIBERO、RoboTwin 等环境中的闭环任务成功率。
具身是论文验证的第四个模态,图 10 用 LIBERO-10 闭环执行说明“闭环完成率而非离线动作准确率才是关键度量”这一核心观点。
声明式清单与工件契约(Manifest & Artifact Contract)
Manifest 是描述模型或基准的元数据文件:依赖、许可、资产、运行时绑定、已知阻塞项;工件契约用 JSON 可序列化的 GenerationRequest/GenerationResult/ArtifactRef 记录每次执行的输入、输出、内容哈希与来源,使产物可持久化、可审计、可脱离原模型重新评分。
这是 WorldFoundry 工程设计的基石,论文“每条评测主张可追溯到工件证据”的全部机制都建立在这些契约之上。
研究动机
视觉生成能力正在掩盖一个根本混淆:输出逼真不等于建模了世界。论文指出,一段生成视频可以画面平滑、主体可辨,却违反接触关系(物体穿插、悬空)、完不成指定变换;一个交互式世界模型可以在重访场景时恢复出熟悉画面,却不能保证你离开视野后打开的门仍然开着、被移动的物体还在新位置——近期物理与世界导向基准(VBench、WorldModelBench、WorldScore、WorldArena 等)反复暴露这一鸿沟。评测侧同样失衡:VBench 以 16 个维度度量感知质量与语义对齐,WorldScore 聚焦相机条件可控性,WorldArena 与 World-in-World 才开始触及闭环策略效用,但各自覆盖面都窄。工程侧则碎片化:表示(像素帧、点云、高斯、动作序列)、运行时、接口与评测协议互不兼容,能力难以组合、结果难以复现、朝真正世界模型的进展难以度量。更隐蔽的问题是语义污染:研究者常把“目录里收录了”“能跑通推理”“做过部分验证”“完整复现了基准”四种完全不同的主张混称为“模型支持”。论文的判断是:瓶颈不仅在算法,更在基础设施。
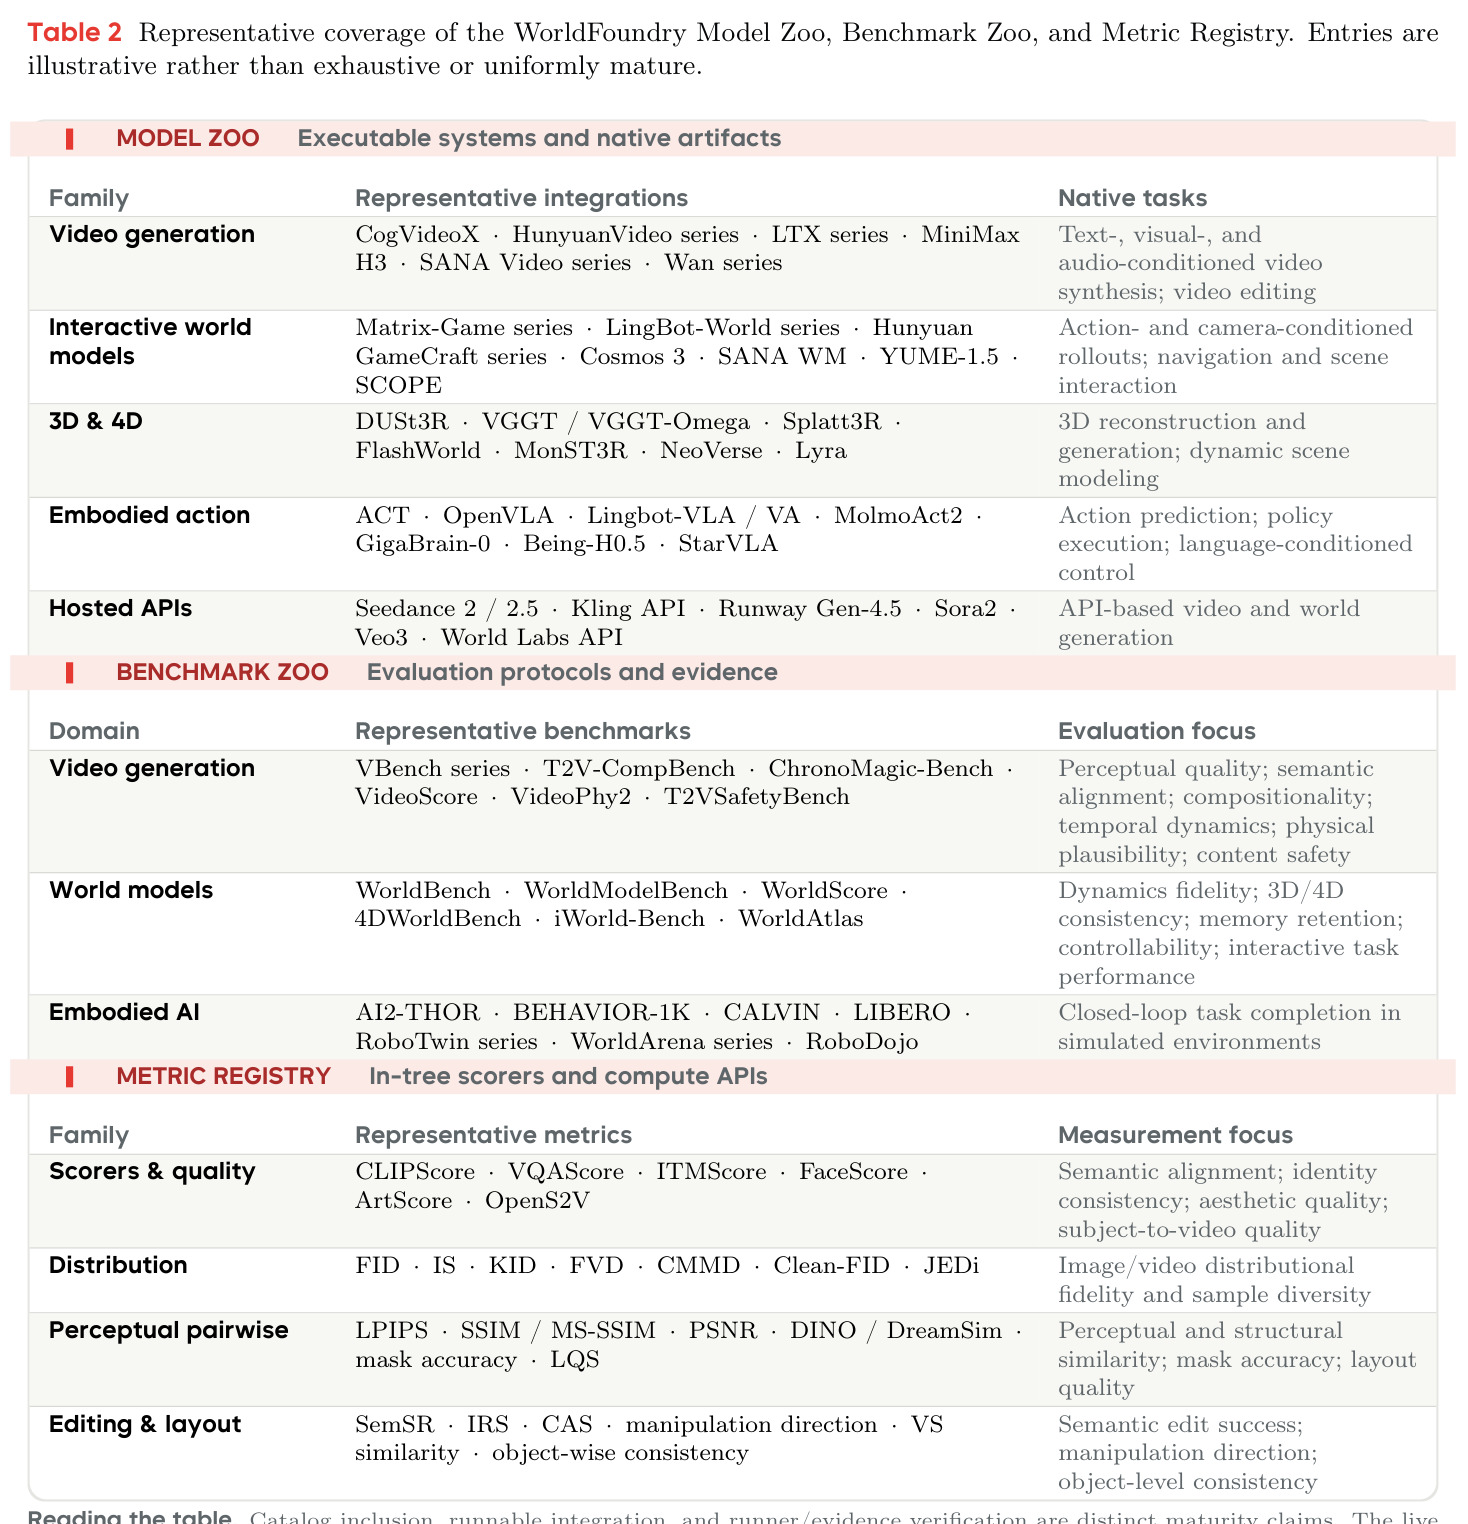
本文的目标是论文设定了两个互补目标。概念层面:给出一个不依赖具体架构、可在操作上检验的生成式世界模型定义——以持久状态、干预条件化动力学与观测反馈的耦合为判据——并提供一条从感知到智能的能力进阶框架,让视频生成器、3D/4D 方法、交互世界模型与具身策略能放进同一套词汇比较。工程层面:构建开源基础设施 WorldFoundry,覆盖研究全生命周期——模型与基准发现、运行时与资产准备、执行编排、工件管理、评测与交互可视化——并保证每次推理可复现、每条评测主张可追溯到支撑工件。当前版本已集成 270 个模型条目、74 个基准与 62 个注册指标,每个模型运行器都通过文档化的端到端参考工作流完成验证,把孤立的单次生成演示变成可累积、可审计的证据,推动领域从感知合成走向可度量的世界智能。
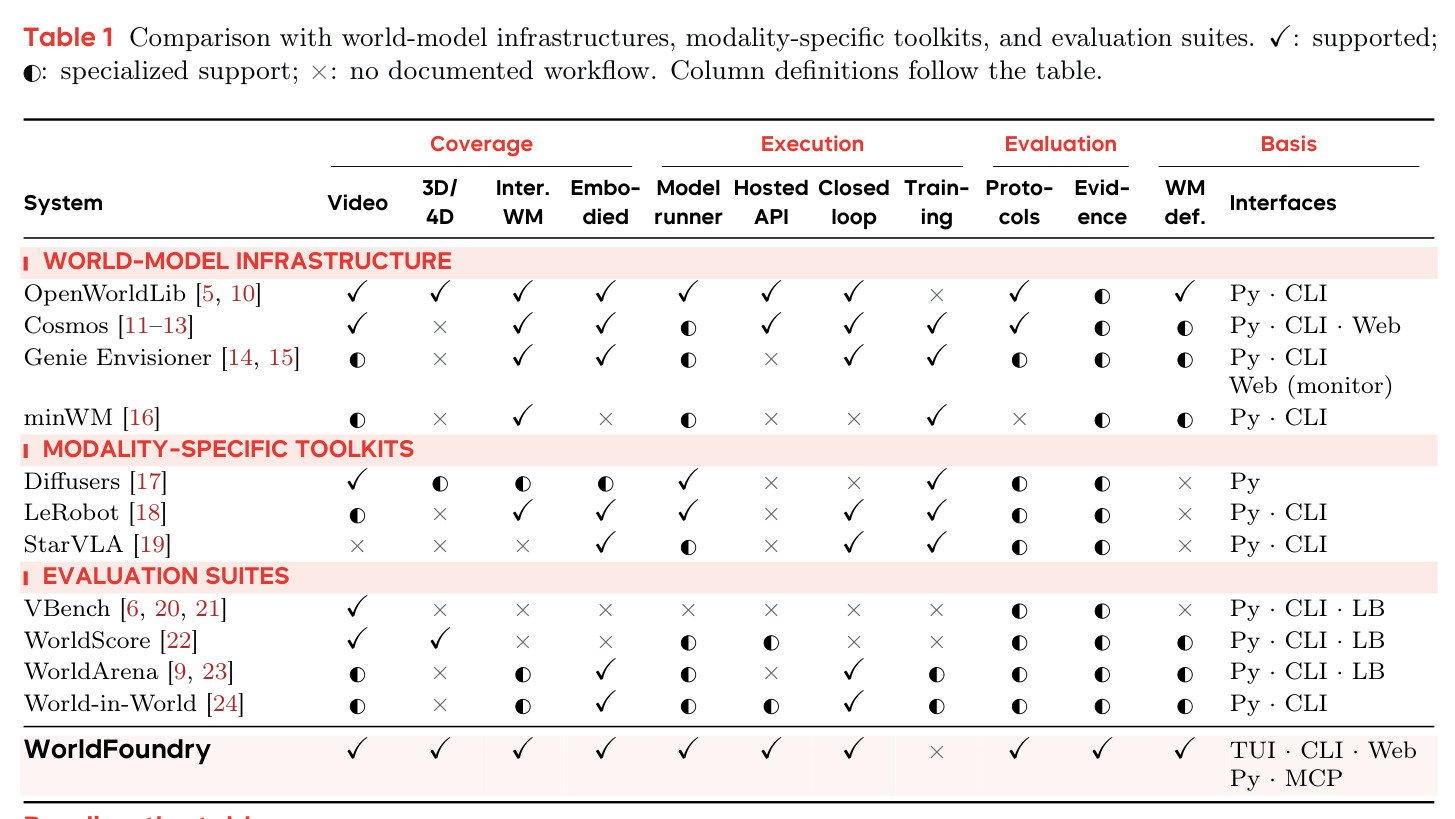
与已有工作不同的是,独特切入有三点。其一,抽象做在函数层面而非架构层面:世界建模被分解为状态推断、前向模拟、交互响应三个算子,潜状态 $z_t$ 可以是循环态、物体中心、几何或 token,论文不强迫任何系统实现全部三者,只按“实现了哪些算子、能力画像如何”归类比较。其二,分界判据从“视觉逼真”换成“回路是否闭合”:视觉逼真只是观测解码器 $g$ 的属性,既非必要也非充分;只有干预效应在状态中持久留痕、且新观测能修正状态,才称得上生成式世界模型,否则再强的基础生成模型也只是“合成或变换观测而不闭合回路”。其三,把“证据”做成一等公民:scorecard 将支持声明分为诊断性、基准可比、精确复现三级,目录收录、可运行集成、有界验证、基准复现是四种独立主张。相比 OpenWorldLib 强调感知/交互/记忆的模块化集成、Cosmos 面向物理 AI 的开发训练管线、各评测套件各自为政,WorldFoundry 用显式执行契约把模型调用、工件管理与评测连成一个可审计的实验生命周期。
核心方法
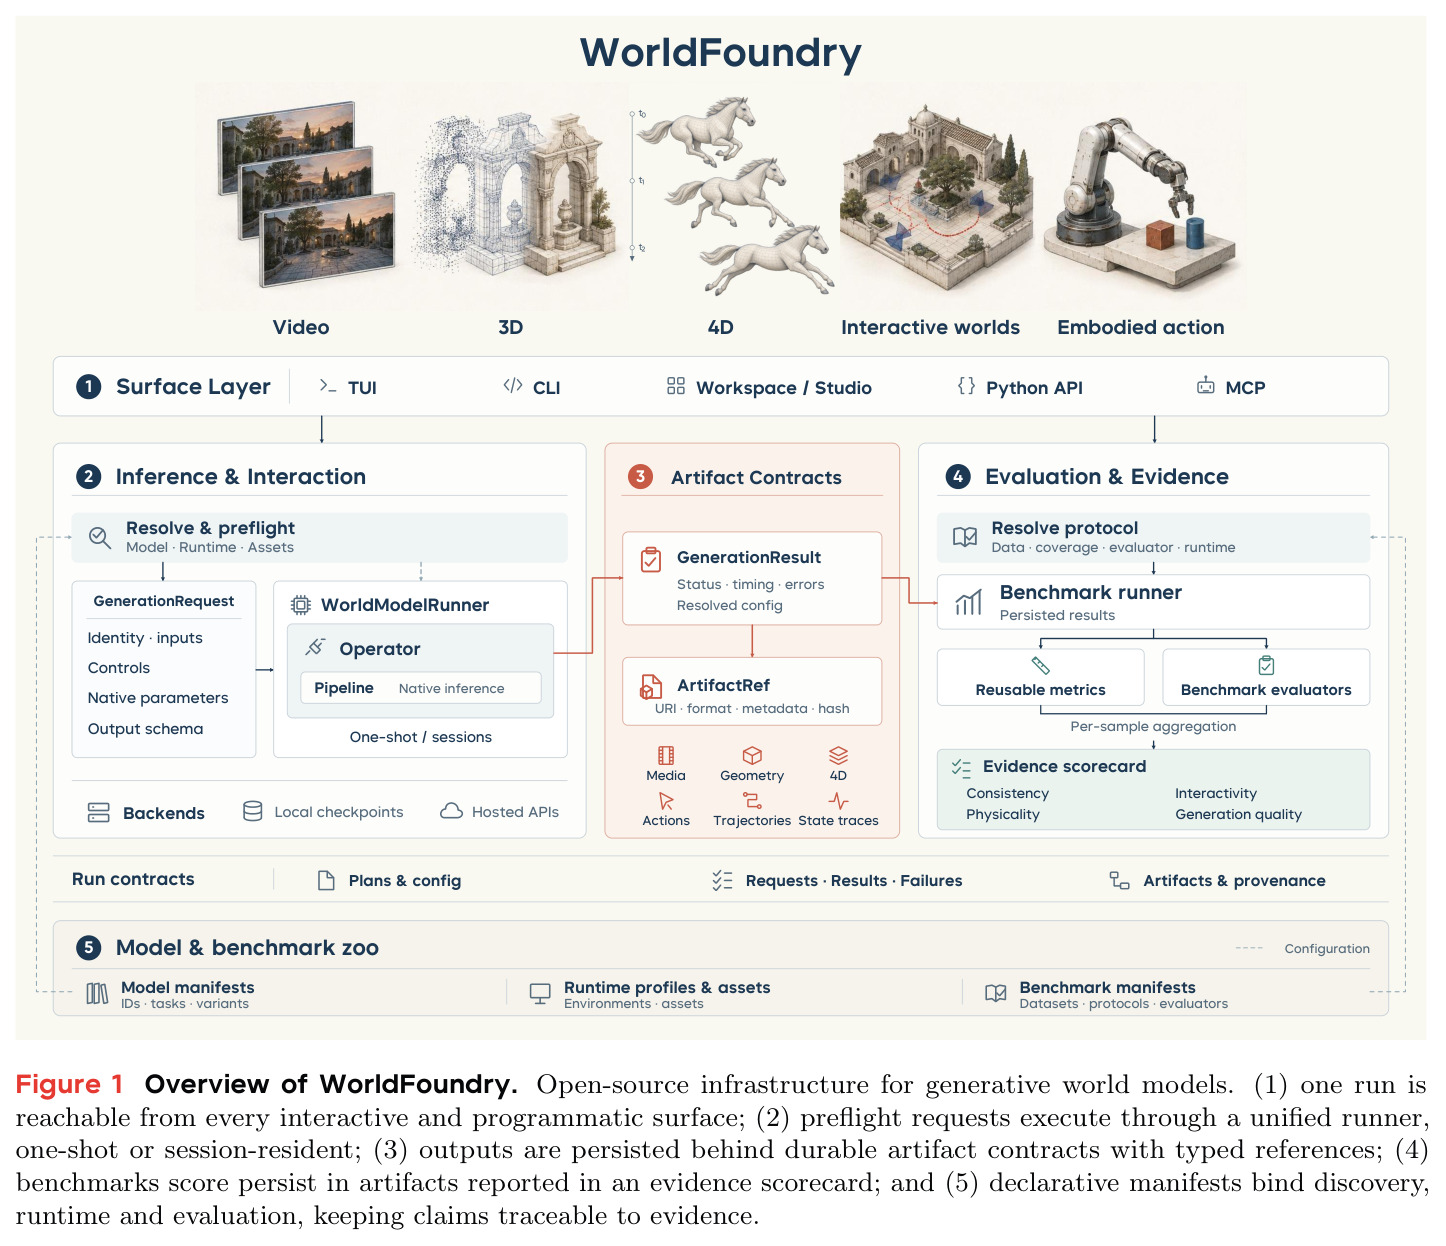
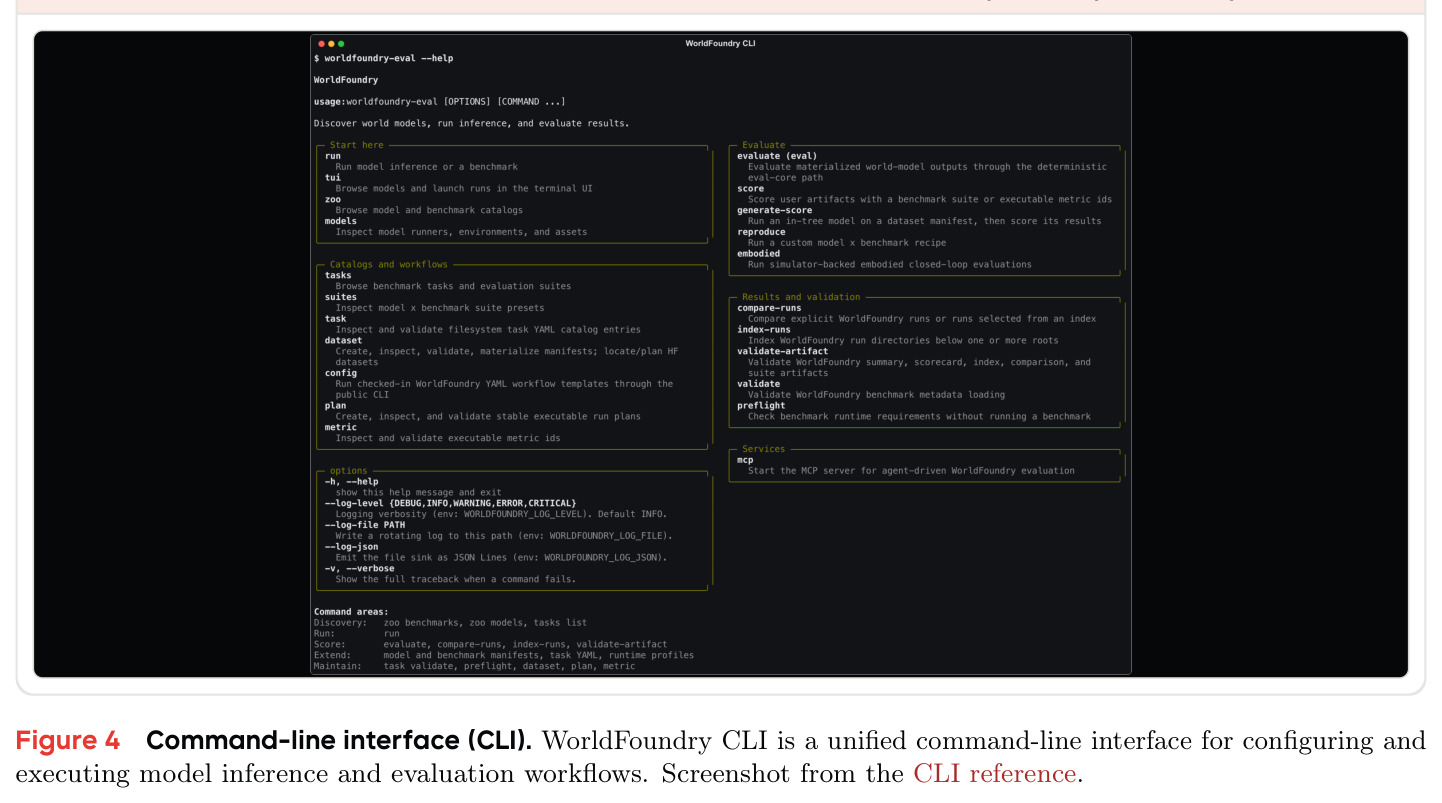
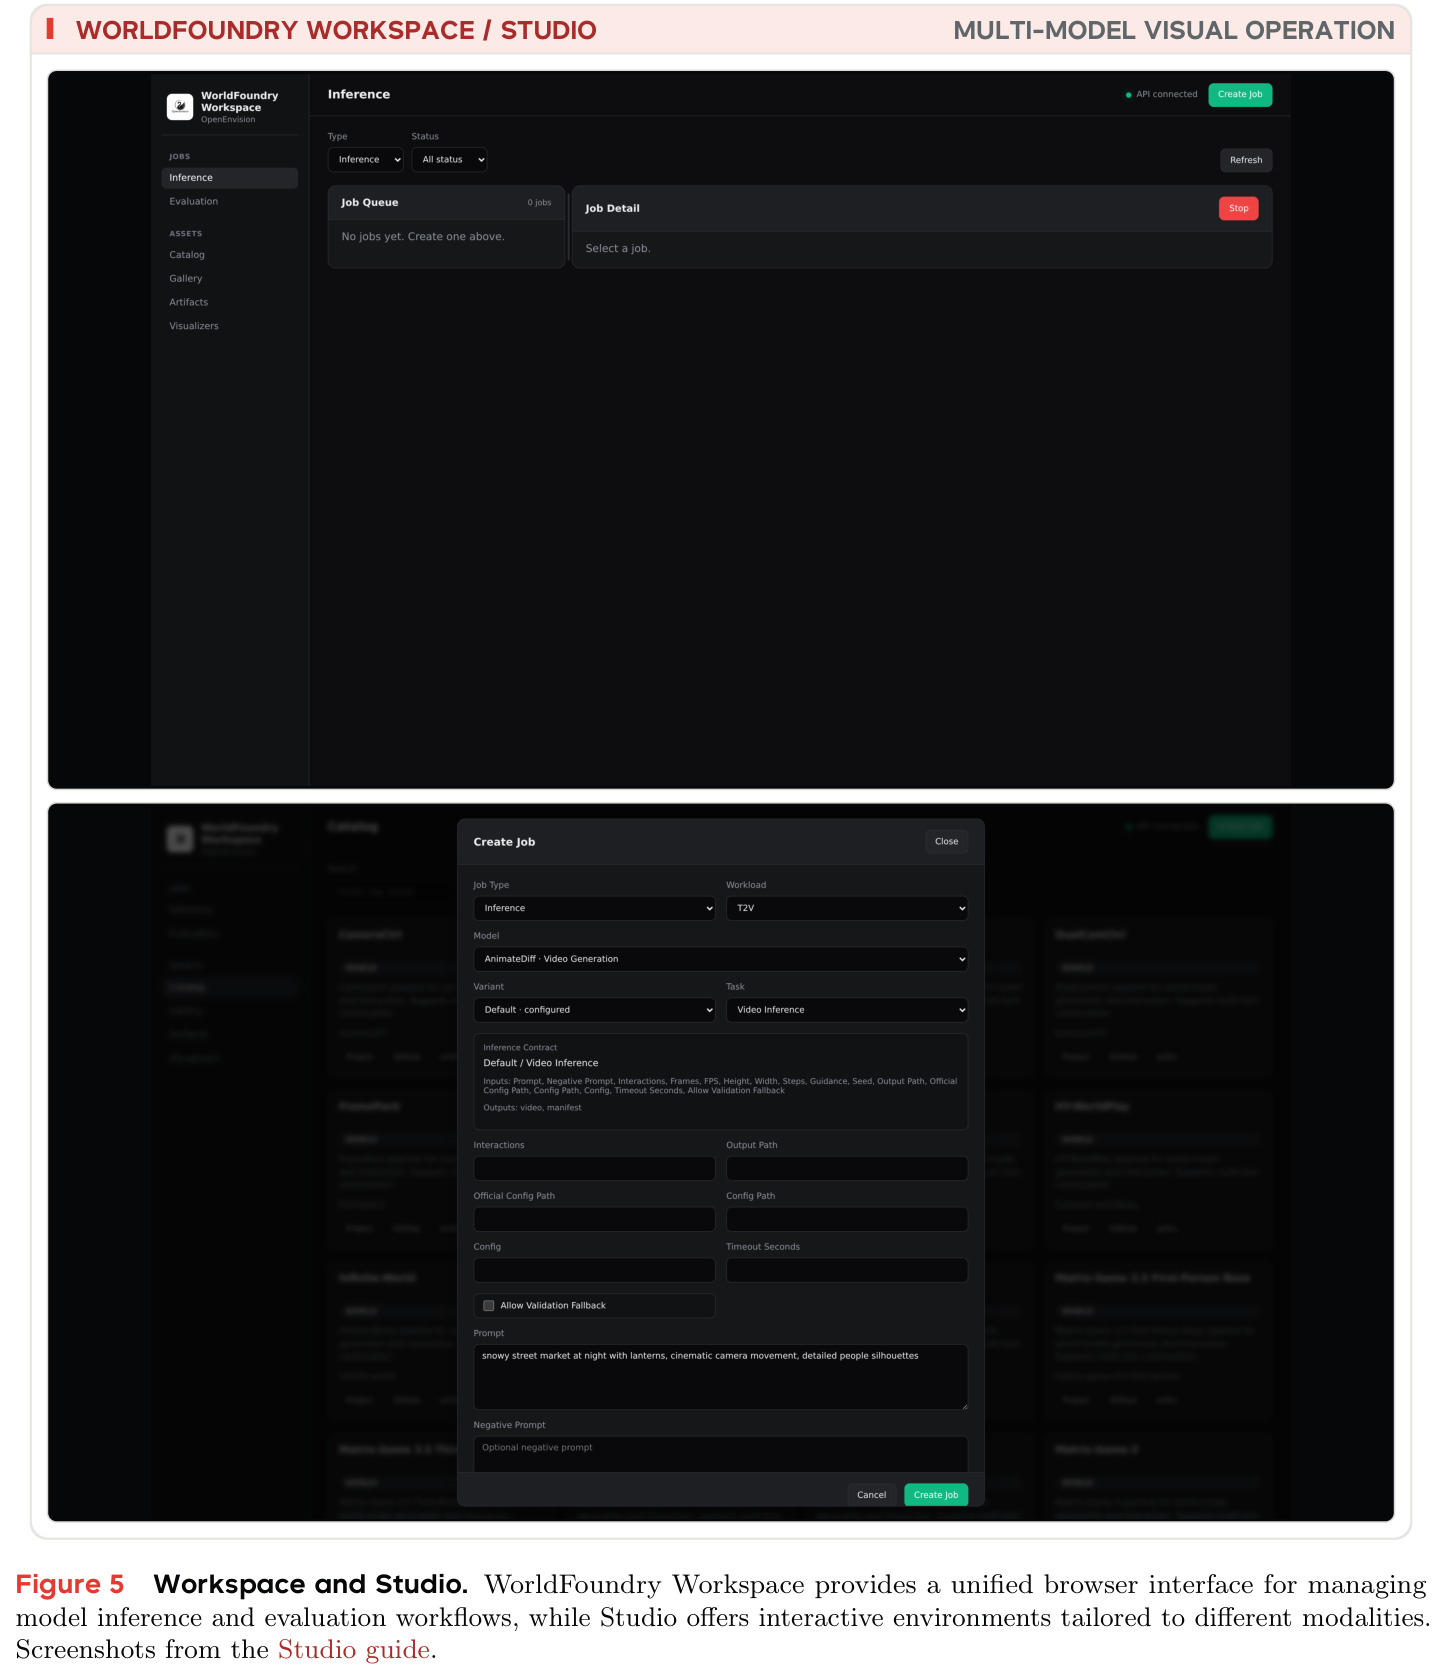
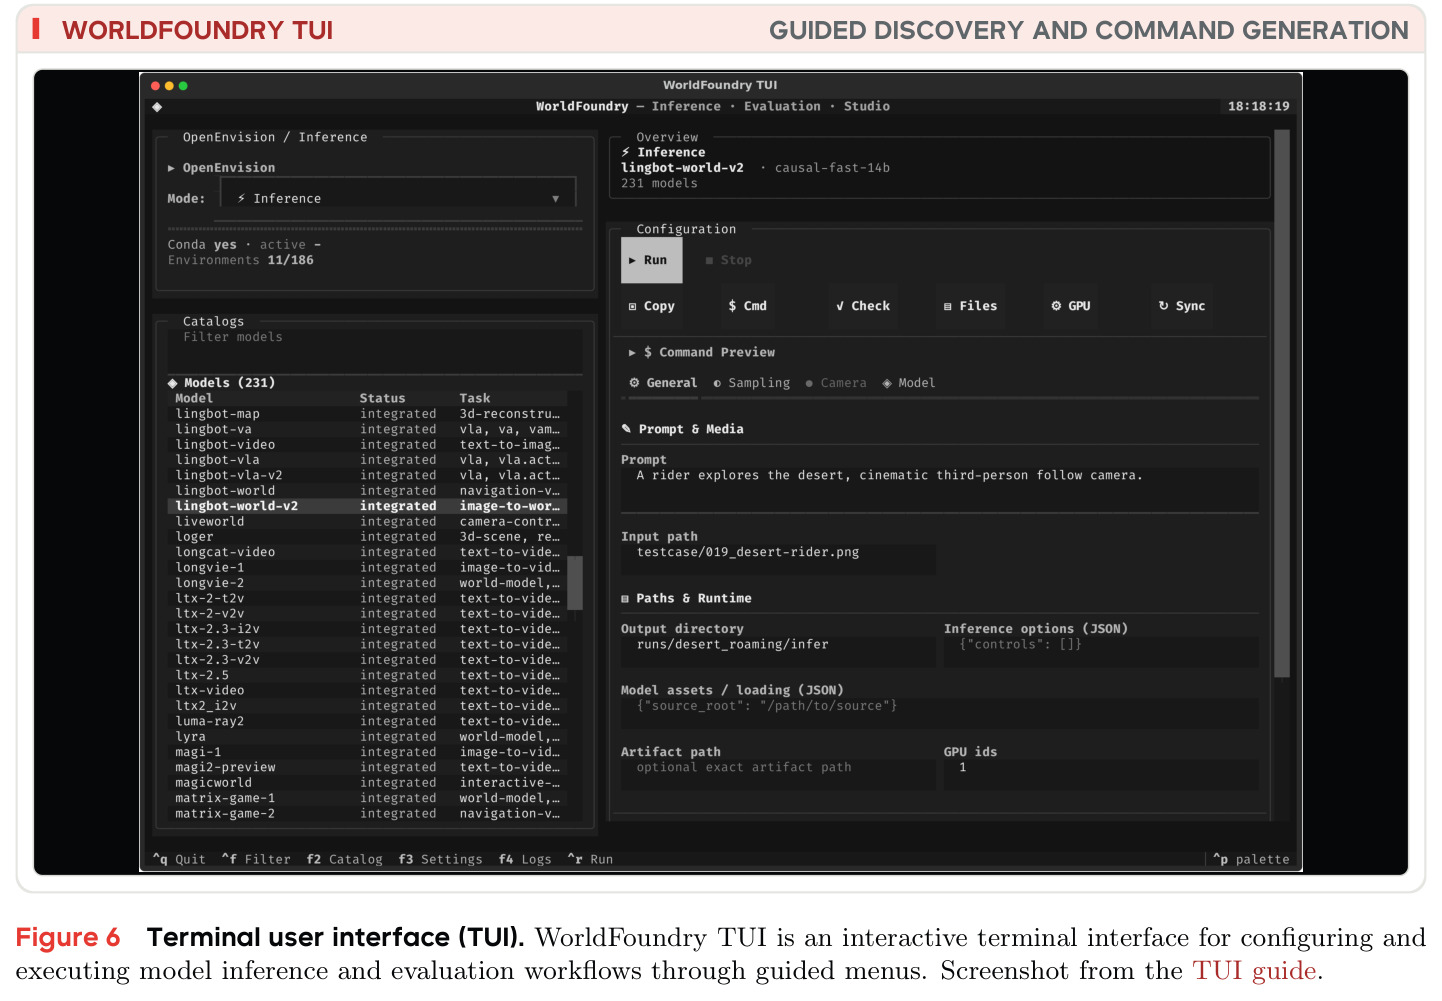
直觉上,WorldFoundry 像是给世界模型研究配的“包管理器 + 实验记录本”:任何模型,无论输出视频、几何还是动作,都走同一条“发现→准备→执行→工件→评测”的生命周期,同时不抹平各自的差异。系统由五个组件构成。(1) Surface Layer 提供 TUI、CLI、浏览器 Workspace/Studio、Python API 与 MCP 五种入口,全部翻译成同一套规范化请求、共享同一编排路径,保证不同入口发起的运行可比较;Studio 还为各模态提供专门的可视化(Viser 点云/网格、Spark 高斯查看器)和常驻交互会话。(2) 统一推理与交互层把模型 ID 解析为清单条目,预检环境与资产后编码为 GenerationRequest,由 WorldModelRunner 协调执行,返回带工件引用的 GenerationResult;交互式系统保留常驻 Pipeline 与会话状态,连续动作无需重复加载检查点。(3) 工件契约层用 JSON 可序列化的请求/结果/ArtifactRef 把输出变成持久、可检查、带内容哈希的产物,并以 execution_plan.json、requests.jsonl、results.jsonl、sample_ledger.jsonl、artifacts.jsonl、run_manifest.json 组织运行记录,失败请求也显式入账。(4) 评测与证据层对工件计算指标与基准协议,产出 scorecard.json 作为分数有效性的权威机读记录。(5) Zoo 层维护模型、基准、指标、运行时的清单驱动注册表与就绪状态、已知阻塞项。
核心创新是把两件通常被混在一起的事情显式拆开,再用可机读契约重新连接。第一是概念创新:生成式世界模型被定义为“学习到的、以历史和控制为条件的潜变量动力学系统”,形式化即公式 (1):$z_t \sim q(z_t \mid h_t)$,$z_{t+1} \sim p(z_{t+1} \mid z_t, c_t)$,$\hat{o}_{t+1} \sim g(\cdot \mid z_{t+1})$,其中 $h_t = (o_{\le t}, c_{<t})$ 为交互历史。判据不是输出好不好看,而是状态持久性:干预必须在状态中留下约束后续预测的痕迹,每个新观测必须反过来修正状态,两者同时成立回路才闭合;在替代干预下生成时,各分支从共享状态出发,干预后果约束后续输出。第二是工程创新:持久工件成为执行与评测之间的显式边界——昂贵的一次生成可以被检查、重评分、跨模型比较而无需重新加载原模型;证据分级强制区分“能跑”与“跑出的分数可信”,防止成功执行被冒充为基准有效。与已有方法的本质区别在于:Diffusers 只统一执行、VBench 只统一评测、OpenWorldLib 统一接口但不做操作性判据与证据分层,WorldFoundry 第一次把操作性定义、执行契约与证据审计焊成一个整体。
方法步骤详情
完整流程分七步。第一步,清单解析:用户给出模型 ID 或别名,系统映射到规范条目,其 manifest 声明来源、许可、任务与变体、检查点引用、输入输出模态、运行时绑定、硬件要求与已知阻塞项。第二步,预检:验证 Python/CUDA 版本、依赖约束、资产可用性,不满足则显式报告阻塞而非默默替代。第三步,请求编码:构造 GenerationRequest,包含 inputs(文本、源媒体或任务观测)、controls(动作序列、相机轨迹等控制信号)、generation_kwargs(随机种子、帧率等模型原生参数)与 output_schema(期望工件类型),各模态保留原生语义——视频保留时序与媒体条件,3D/4D 保留相机与坐标系,具身保留观测-动作模式与模拟器契约,交互世界保留会话状态与顺序控制。第四步,执行:WorldModelRunner 把任务适配交给 Operator(输入校验、预处理、翻译为模型原生参数、后处理、转框架工件),把生命周期交给 Pipeline(模型构建、检查点加载、设备放置、运行时配置、分布式执行、调用原生推理)。第五步,工件落盘:GenerationResult 记录执行状态、计时、错误与解析后的配置,每个输出由 ArtifactRef 以语义角色 + URI + MIME + 哈希标识;运行级文件完整留痕,失败请求保留在结果与台账中以保证覆盖率可核算。第六步,评测:基准清单把数据条目映射为带稳定样本 ID 与划分的请求;metrics 计算每样本测量与聚合统计(语义对齐、质量、分布相似度、感知比较、编辑与布局),benchmarks 另行规定数据、覆盖、预处理、工件布局、评估器资产、judge 配置与聚合规则;不可用资源显式记为 skipped/failed。第七步,证据归档:per_sample.jsonl、summary.json、run_manifest.json(含可复现性指纹)汇入 scorecard.json,按协议保真度分为诊断、基准可比、精确复现三级;排行榜资格还要求规定数据覆盖、验证过的评估器、兼容运行时证据与无取消资格的阻塞项。
技术新颖性
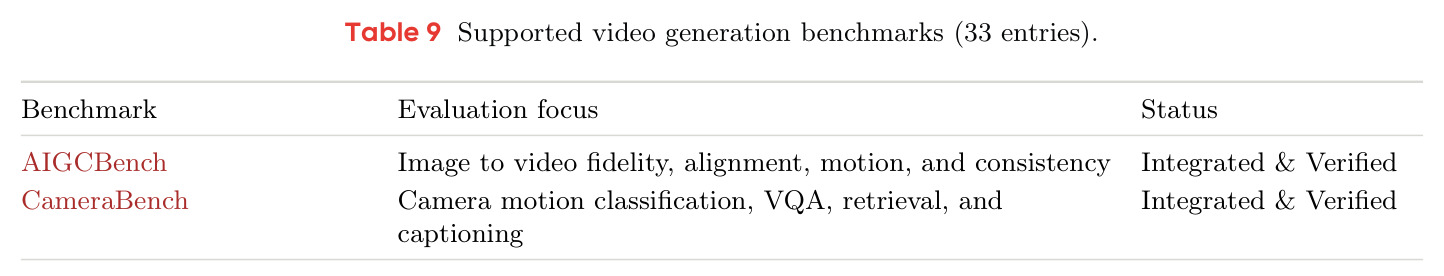
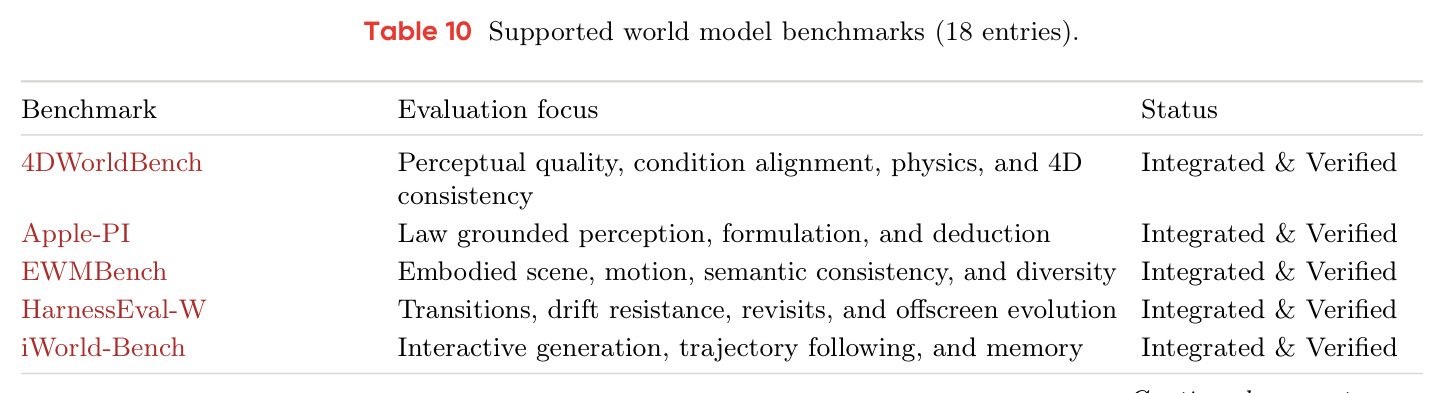
技术新颖性体现在四处。其一,定义的可操作性:此前领域讨论“什么是世界模型”多停留在直觉与愿景,论文把判据落到状态持久性、干预条件化动力学、观测反馈三个可检验条件上,并据此划分基础生成模型与生成式世界模型,给出能力画像而非单一标签——感知地基作基础,持久状态建模→动力学感知预测→闭环交互构成“世界模型主轴”,可控变换是可叠加于任何阶段的正交能力。其二,证据分级的评测治理:diagnostic / benchmark-comparable / exact reproduction 三档主张在评测基础设施工作中少见——导入官方结果只验证解析归一化,有界评估器运行只验证集成可操作性,均不构成完整复现;这种防伪设计直接针对排行榜污染与“支持”一词的语义滑坡。其三,适配器哲学:不强加统一输入输出,而是为视频、3D/4D、具身、交互世界分别保留原生条件机制、坐标系与渲染语义、动作词表与会话语义,统一只发生在编排与记录层。其四,规模化的就绪度审计:270 个模型条目全部经过端到端参考工作流验证并逐一记录验证范围,74 个基准全部 Integrated & Verified,这把“支持某模型”从口号变成了可审计的工程事实,是同类基础设施中首次做到的。
实验结果
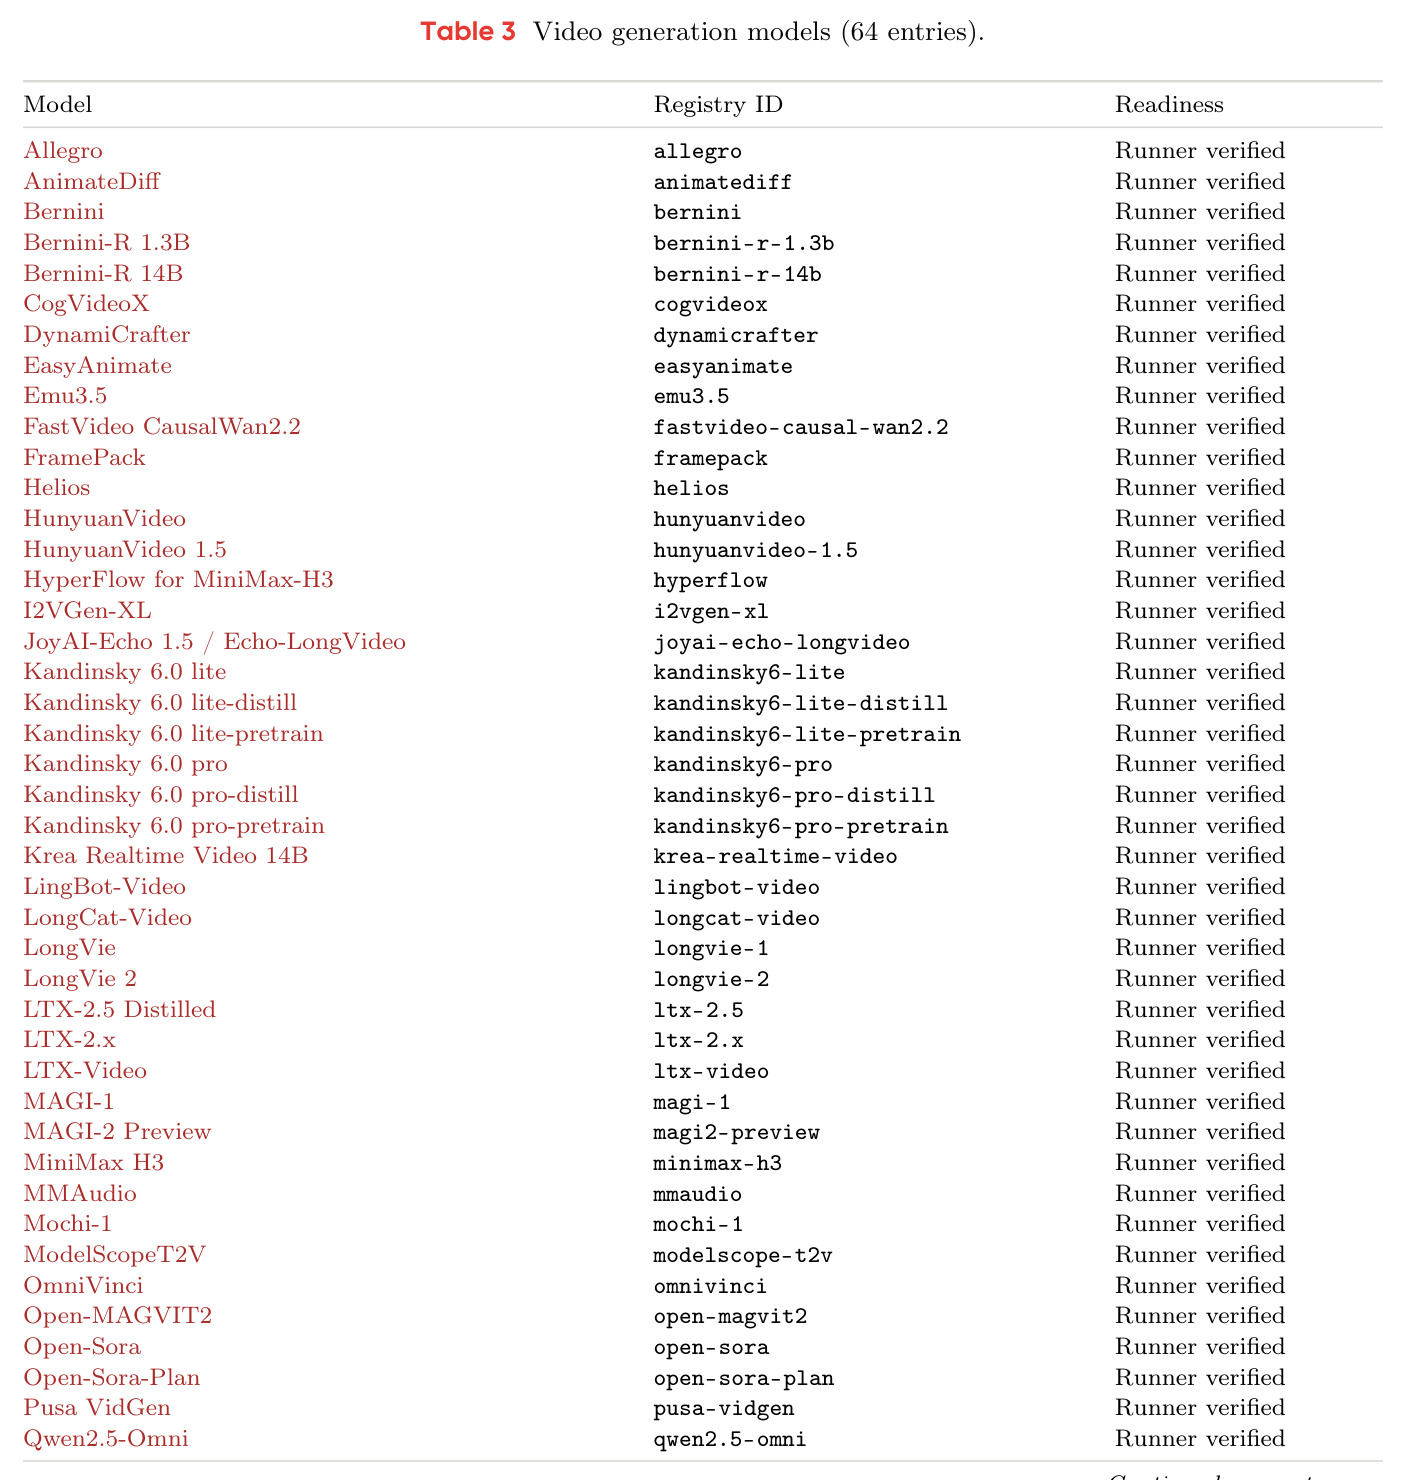
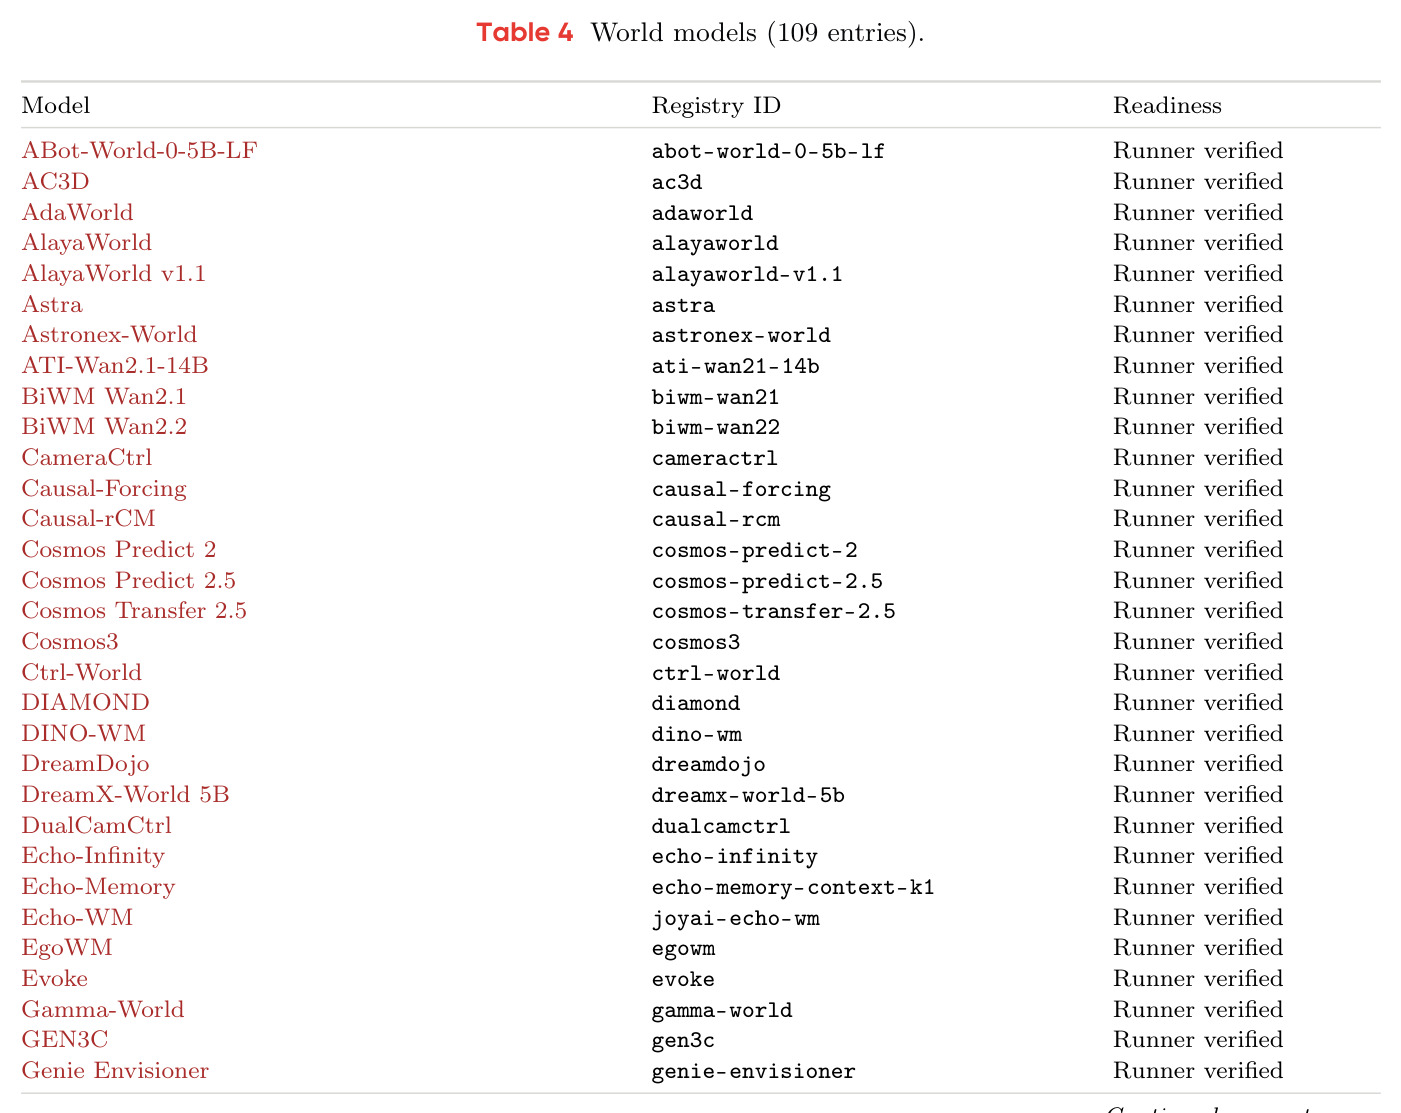
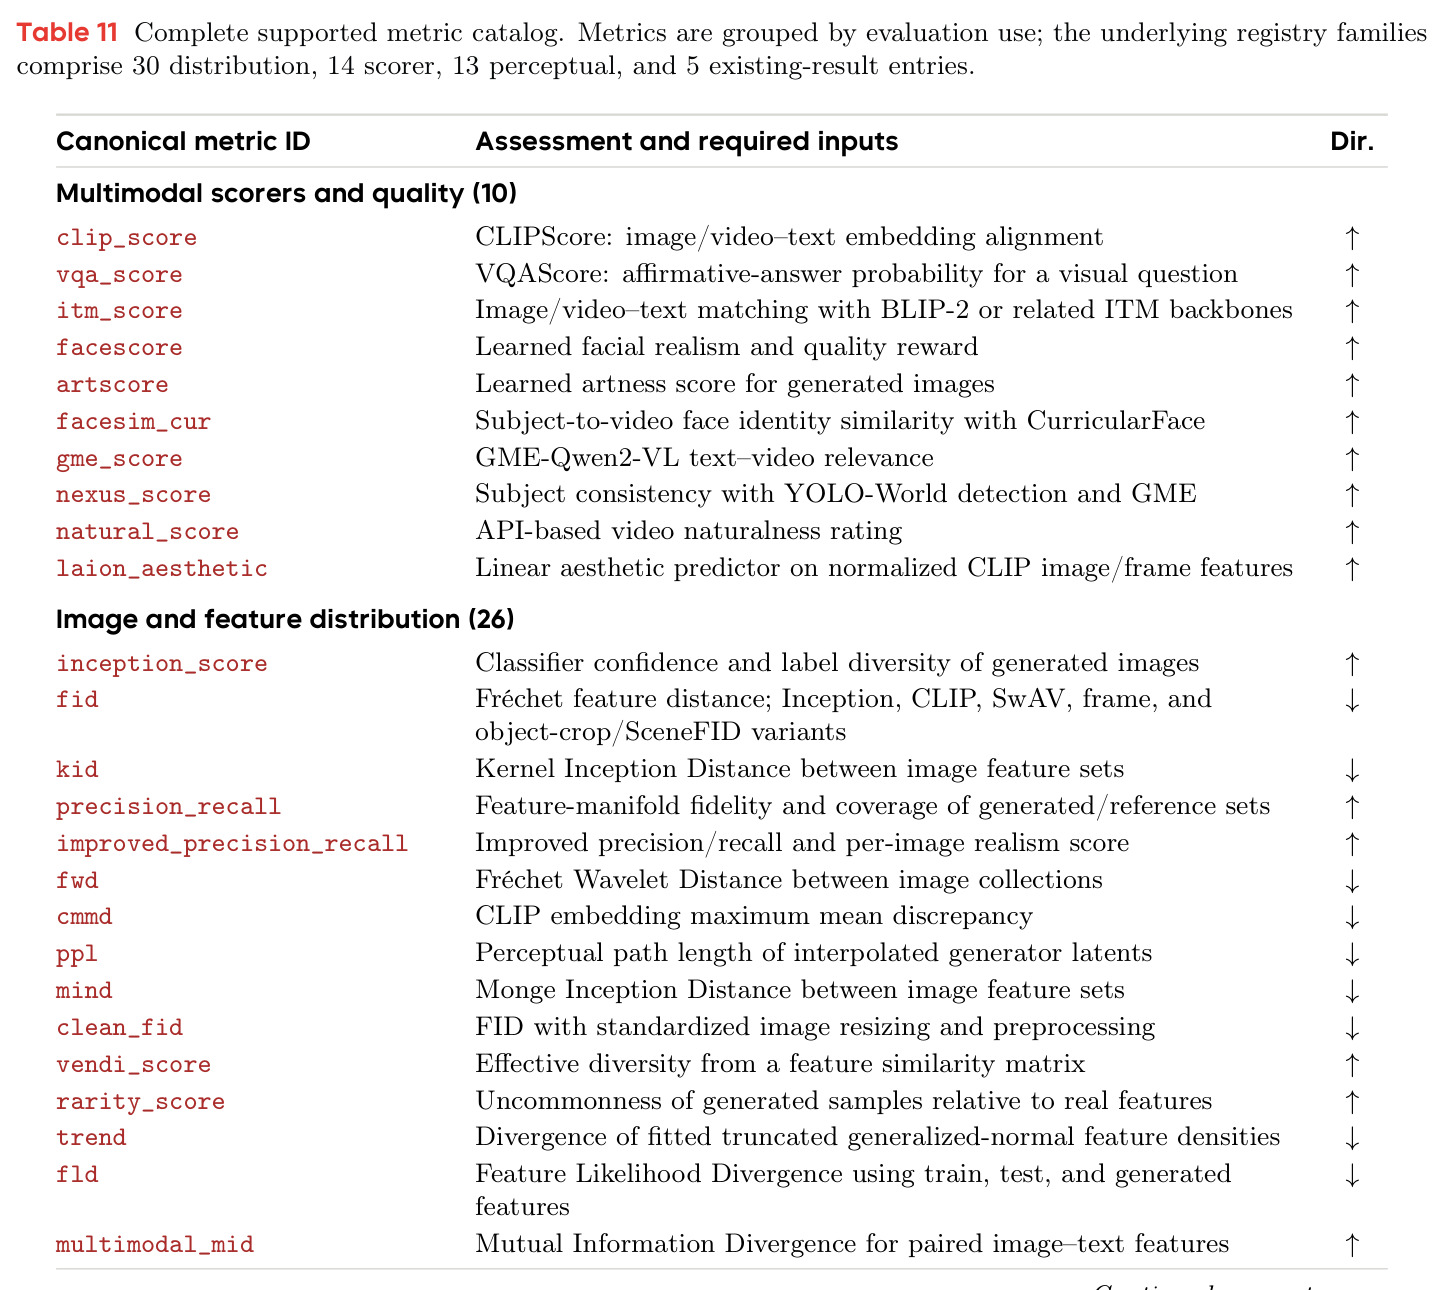
验证在 128 张 A100/H100(80GB)GPU 上进行,目标是检验框架是否保留原生输入输出语义、跨 CLI/Python/网页入口行为一致、并把异构输出存为持久工件,而非给模型排名。目录规模:270 个模型(64 视频生成、109 世界模型、34 个 3D/4D、53 个具身、10 个托管 API)全部 Runner verified;74 个基准(23 具身 AI、33 视频生成、18 世界模型)全部 Integrated & Verified;62 个指标分为多模态/质量打分(10)、图像/特征分布(26)、视频分布(3)、感知/布局(11)、编辑(7)、既有结果工具(5)。视频生成(图 7,LTX-2.5、Wan 2.2、MiniMax H3 的文本到视频样例):CogVideoX 与 Vchitect-2.0 能抓住构图与宏观运动,但复杂运动与多对象交互暴露身份、细节与空间关系不一致;HunyuanVideo 1.5 与 Wan2.1 短序列连贯,但遮挡或大形变下外观保持并不转化为合理运动;Wan2.2 官方报告较 Wan2.1 改进运动生成与美学控制;LingBot-Video 后训练减少物体形变、穿插与过早释放;MiniMax H3 展示外观/运动/音频跨源组合,但组合灵活不等于可靠物理动力学。交互世界(图 8,五个系统 30 秒方向移动+鼠标视角 rollout):Matrix-Game 2.0 响应快但长时程外观漂移;LingBot-World 1.0、Hunyuan GameCraft、YUME-1.5、HY-WorldPlay 在受检案例中视觉连贯;Matrix-Game 3.0 引入长时记忆,3.5 与 ReWorld 以几何感知检索/位姿地标实现场景召回;关键洞察是场景召回≠动作结果持久。3D/4D(图 9,同一室内房间场景下 VGGT、VGGT-Omega、DUSt3R、CUT3R 从共同视点序列渲染):视觉可信≠几何准确,重建观测≠预测演化。具身(图 10,OpenVLA 经 WorldFoundry 在 LIBERO-10 闭环执行):单物体拾放任务 179 步(约 8.95 秒)成功完成,而“两物体入篮”“碗入抽屉并关门”两个多阶段任务均达 520 步上限未完成——证明闭环完成率而非离线动作准确率才是相关度量。跨家族结论:视觉保真、场景一致性、动作响应互补但不能证明世界建模;现有评测很少度量干预持久性与反馈同化。
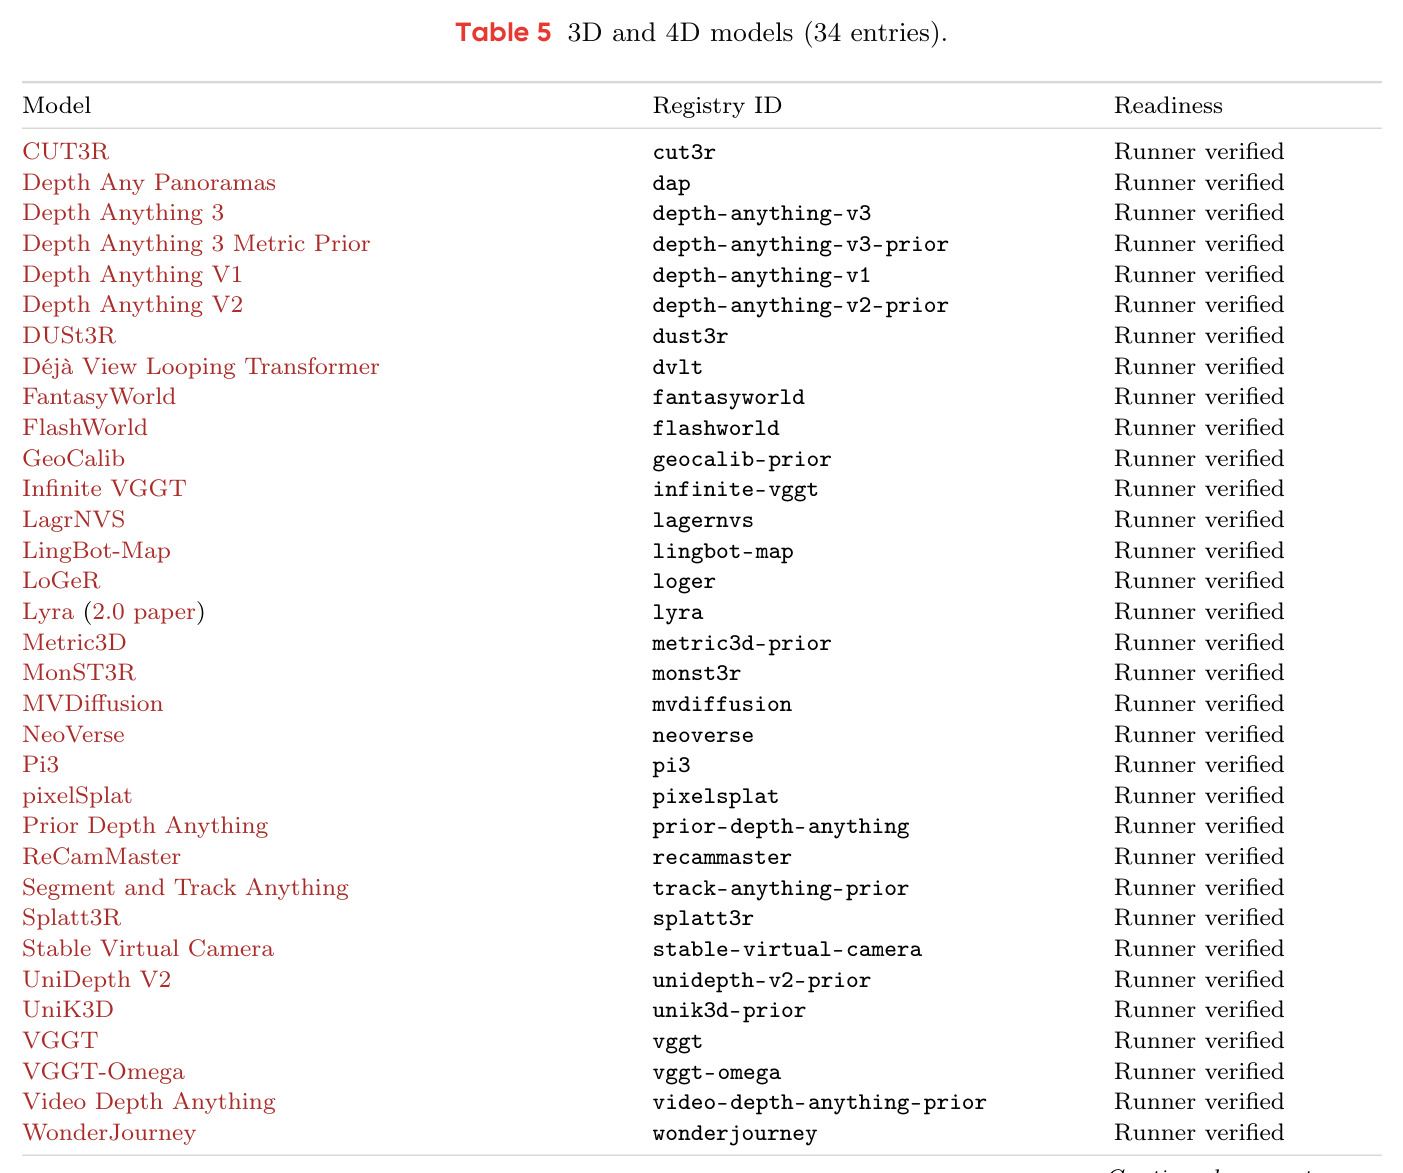
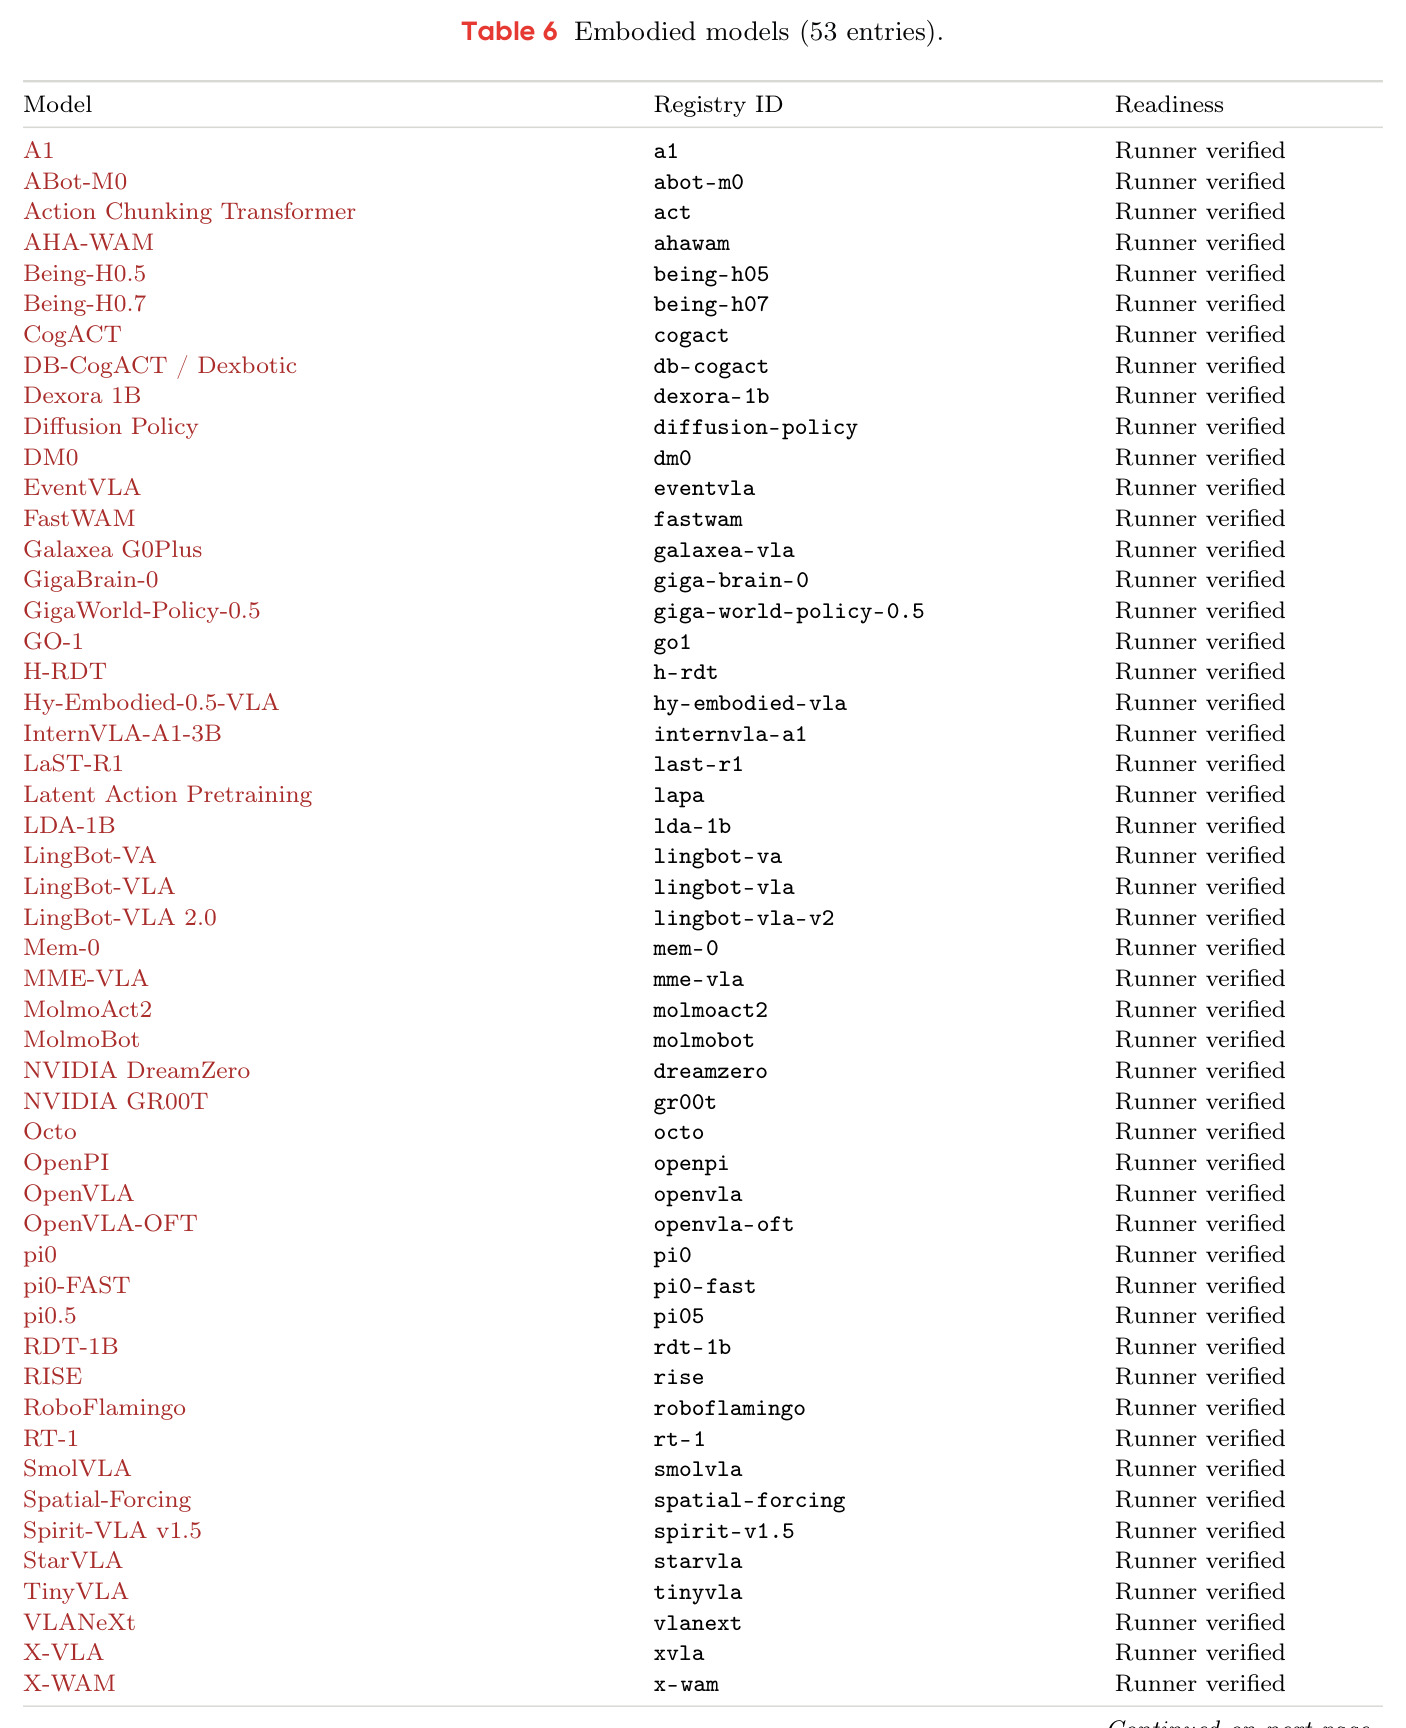
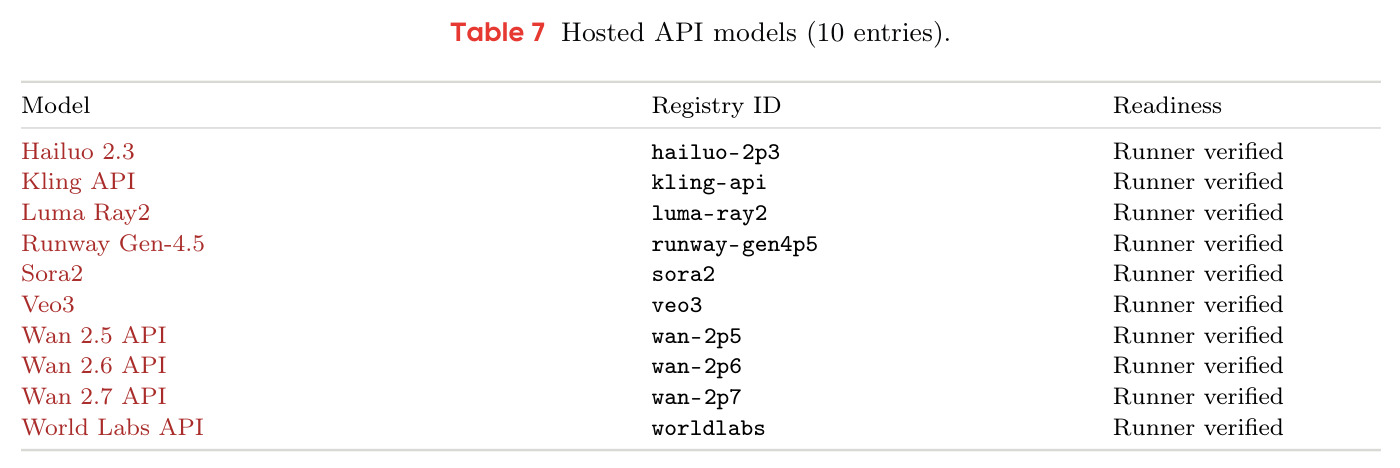
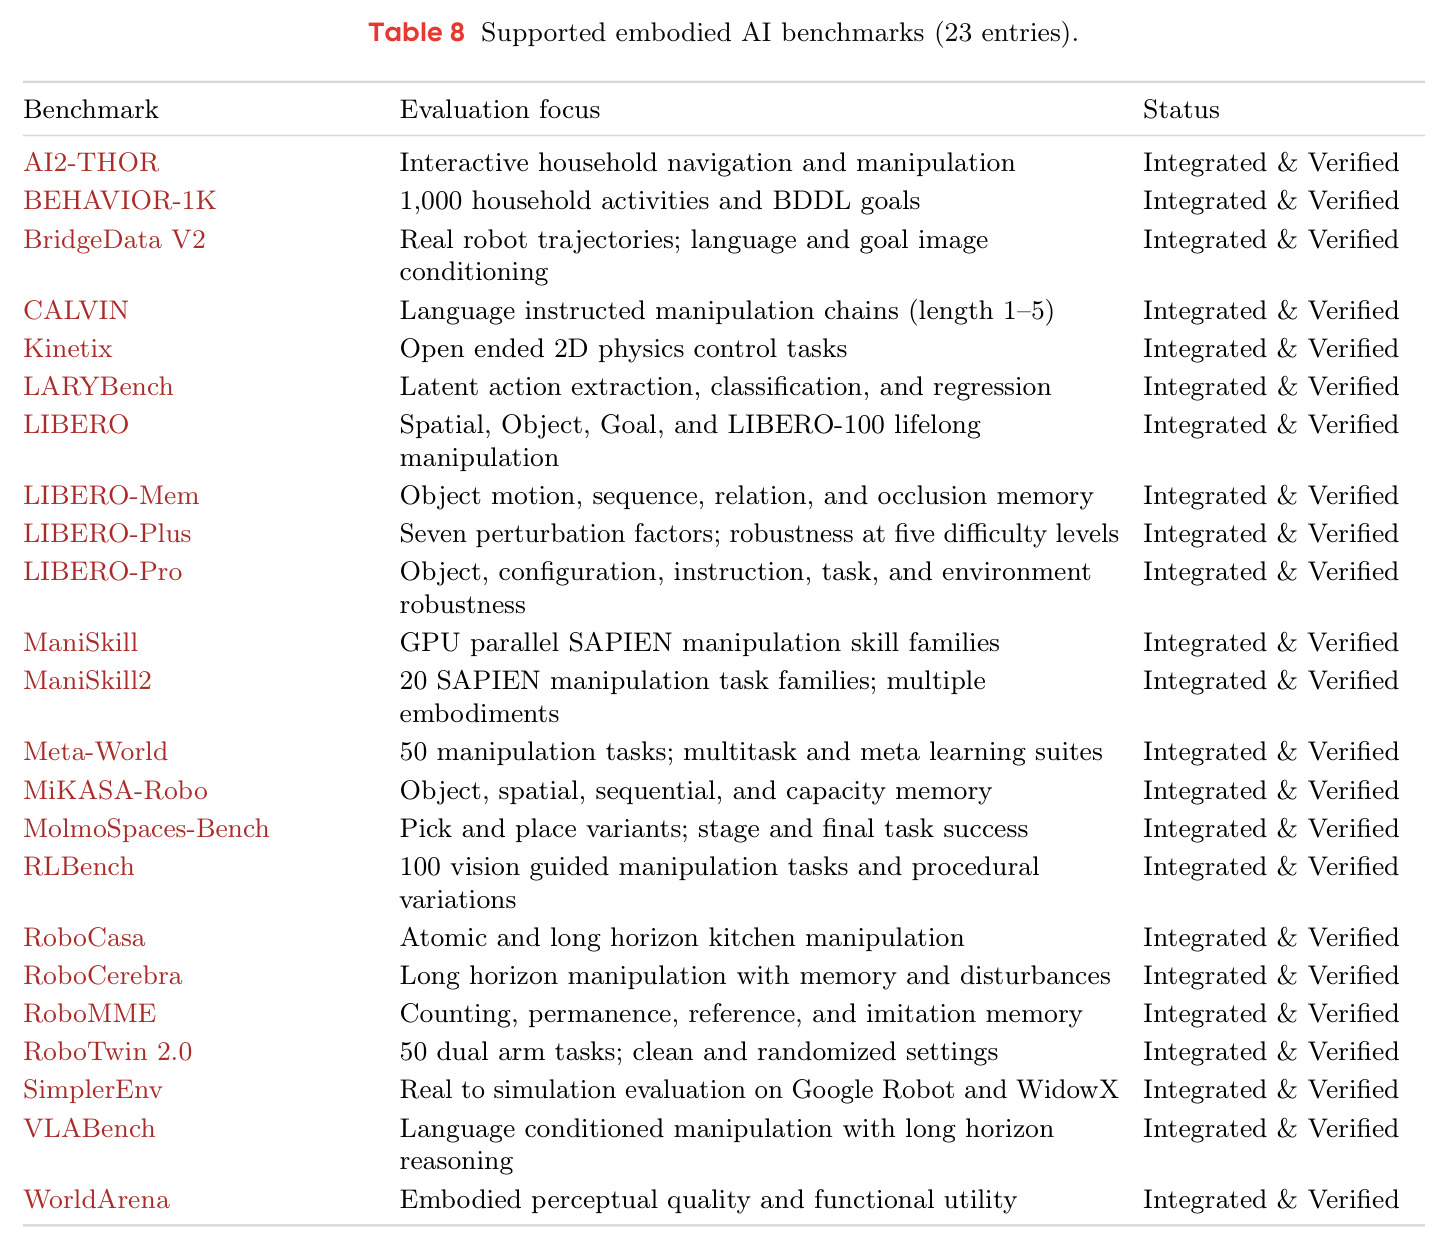
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 模型目录规模与验证 | 集成模型条目数 / 验证状态 | 270 条(64 视频 + 109 世界模型 + 34 3D/4D + 53 具身 + 10 托管 API),全部 Runner verified(经端到端参考工作流) | OpenWorldLib、Cosmos、minWM 等未披露同口径的全量逐条验证 | 首个对全部条目遍历可执行路线并独立记录验证范围的统一基础设施 |
| 基准覆盖 | 集成基准数 / 验证状态 | 74 个(23 具身 AI + 33 视频生成 + 18 世界模型),全部 Integrated & Verified | VBench 系列仅覆盖视频质量,WorldScore 仅相机可控性,WorldArena/World-in-World 仅闭环具身 | 跨五模态统一接入,并按协议保真度分级(诊断/基准可比/精确复现) |
| 指标注册表 | 规范指标条目数 | 62 个(打分 10、图像/特征分布 26、视频分布 3、感知/布局 11、编辑 7、结果工具 5) | AIGVE-Tool 等模块化评分组件,不与执行来源绑定 | 指标计算与 scorecard 证据链绑定,缺失依赖显式记为 skipped/failed 而非静默替代 |
| 闭环具身执行等价性 | LIBERO-10 任务步数 / 完成状态 | OpenVLA 单物体拾放 179 步成功(约 8.95 秒);两个多阶段任务达 520 步上限未完成 | OpenVLA 原生实现的观测/动作语义 | 验证 WorldFoundry 执行保持原生语义,闭环行为与原生部署一致,且暴露了离线准确率掩盖的多阶段失败 |
| 交互世界 rollout 可复现性 | 30 秒方向移动 + 鼠标视角控制的轨迹留痕 | SANA-WM、Matrix-Game-3、LingBot-World v1/v2、Echo-WM 均可统一执行并记录控制、观测与运行时配置 | 各模型原有独立脚本,控制词表与生成调度互不兼容 | 统一控制词表与会话状态记录,使轨迹级对比分析可复现 |
| 验证算力规模 | 验证用 GPU | 128× A100/H100(80GB) | — | 机构级算力背书的大规模验证声明;其他硬件的评估留待后续工作 |
局限与改进
作者承认的局限:(1) 覆盖成熟度不均——目录收录、可运行集成、本地资产就绪、官方运行时验证、基准资格是五个不同状态,外部检查点、许可数据集、托管服务与模拟器资产使部分条目长期处于 planned/blocked;(2) 架构与硬件差异使单一优化策略无法同惠所有家族——FlashAttention 2/3、SageAttention、xFormers、SDPA、Triton kernel 注册、NVFP4 量化、多 GPU 上下文/序列并行等机制尚未系统表征,验证以 A100/H100 为主,缺少 B200/B300 级硬件;(3) 训练基础设施缺位,上游训练代码与运行时包有意分离,通用训练支持留作未来方向。我的补充观察:(1) 实验以定性验证为主,正文没有给出跨框架量化的延迟/显存开销表或与原生实现的数值一致性指标(如 FVD 差值),“语义等价”的主张主要靠设计叙述支撑;(2) “闭环判据”目前更多是分类框架,论文自己也承认缺少直接探测干预持久性与反馈同化的评测,如何自动化判定一个系统“状态留痕”仍未解决;(3) “Runner verified”只覆盖被测路线、变体与配置,不保证所有变体在所有硬件上同样工作,引用附录状态时应注意验证范围注脚;(4) 270 条目录的持续维护成本极高,上游模型迭代迅速,清单与证据的时效性依赖社区长期运营。
独立分析的弱点
独立分析的弱点与改进方向:(1) 缺少量化系统基准——等价性、延迟、显存开销应有硬数字(例如与原生实现对比的 FVD/LPIPS 差值、交互每步延迟毫秒数),改进方向是为每个模型家族发布标准化 profiling 报告并纳入 scorecard;(2) 闭环判据尚不可自动执行——目前依赖人工判断系统是否维持持久状态,改进方向是设计“干预持久性探针”(开门后离开视野再回访、移动物体后再观测)作为内置诊断任务,自动生成留痕证据;(3) 定性结果主观性强——图 7–10 的分析以文字叙述为主,改进方向是配套已集成的 WorldScore、iWorld-Bench、MemoBench 等基准给出量化对照,把“召回≠持久”变成可测分数;(4) 证据分级仍留有主观空间——诊断/基准可比/精确复现的判定依赖配置比对,改进方向是把协议保真度检查做成机器可验证的断言清单并随 run 自动核验;(5) 能力画像与指标尚未一一映射——五能力(感知/建模/操控/动力学/交互)缺少各自的最小可测量代理指标,改进方向是为每个能力阶段定义标准探针,自动生成新模型的能力体检报告;(6) 硬件生态窄——消费级 GPU 与新加速器缺少验证,改进方向是分层硬件配置档与保真感知量化白名单,让小团队也能低成本复用框架。
未来方向
作者提出的方向:(1) 评测研究——开发直接探测干预持久性与反馈同化的基准,把“回路是否闭合”从定义变成可测量的分数;(2) 推理优化——自动后端选择、编译与缓存复用、保真感知量化(NVFP4 等)、更高效的显存管理与分布式执行;优化仅在输出与未优化路线的保真差处于声明容差内才被采纳,并通过模块化后端适配器接入专用 serving 引擎,以端到端延迟、吞吐、显存、扩展效率与可复现性为验收标准(明确指出 kernel 级加速不等于应用级收益);(3) 更广硬件验证——覆盖 B200/B300 级与消费级设备;(4) 训练支持——版本化数据集 manifest、分布式训练、微调与后训练、检查点谱系、实验恢复、检查点直注册 Model Zoo,并显式对齐训练/推理的预处理、条件化、归一化与坐标约定,保证可复现训练不因部署偏差失效。基于其成果可延伸的方向:以 scorecard 为底座建跨模型排行榜生态;利用 MCP 接口让 agent 自动设计“同初始状态、不同干预序列”的对照实验,直接测量反事实一致性;把 WorldArena、iWorld-Bench 等闭环基准与“干预持久性探针”组合成下一代世界模型评测;以及让能力画像与基准矩阵自动配对,任何新模型接入即生成能力档案。
复现评估
复现条件较好但门槛不低。开源情况:代码在 GitHub(OpenEnvision/WorldFoundry)开源,项目页为 openenvision.org/WorldFoundry,模型/基准/指标清单与运行配方公开,附录逐条列出 270 个模型、74 个基准、62 个指标的稳定 ID、上游引用与就绪状态;每次运行自动生成 run_manifest.json,含环境、代码版本与解析配置构成的可复现性指纹。数据与资产:多数模型权重需从官方源下载,部分需要凭证或许可(HuggingFace gated repo、托管 API key),受保护资产不随仓库分发,通过显式引用解析;基准复现需要规定数据集、评估器检查点、judge 配置与模拟器资产,缺失时显式记为 skipped/failed 而非静默替代。算力:官方验证在 128× A100/H100 80GB 上进行,完整复现全部 270 条验证显然是机构级工程;但单模型单基准的推理评测对拥有 1–8 张高端 GPU 的团队可行,小型具身策略门槛更低,交互式大世界模型与 4D 方法门槛较高。综合评估:使用层面难度中等(声明式清单 + TUI 引导 + Studio 可视化显著降低上手成本),完整审计层面难度高(需自备资产、凭证与算力);另需注意附录就绪状态只对被测路线与配置负责,引用时应核对验证范围说明。
论文图表
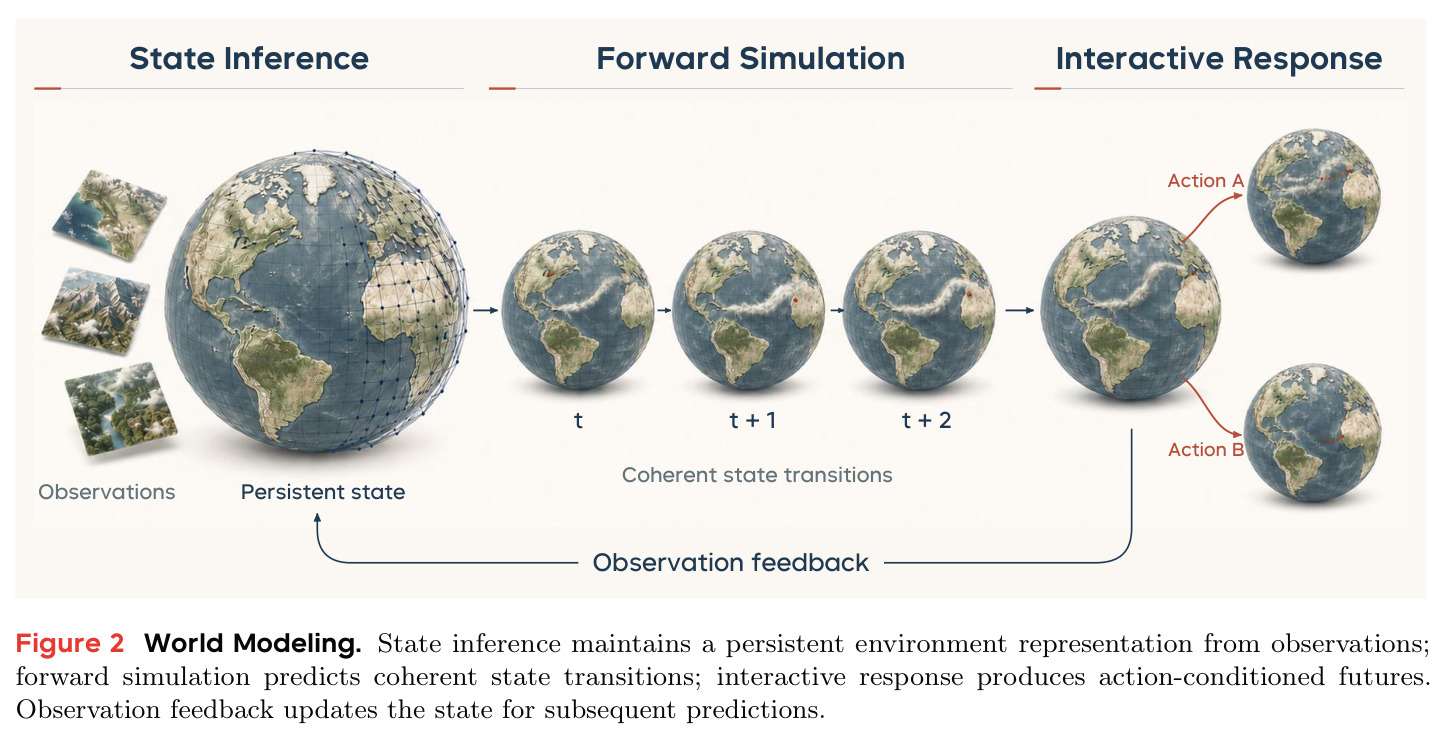
图示世界建模的三个算子如何耦合:观测经状态推断维护持久环境表示,前向模拟预测一致的状态转移($t, t+1, t+2$),交互响应在同一状态下产生动作 A 与动作 B 两种不同的条件化未来;观测反馈回过头更新状态供后续预测使用,形成闭合回路。
它把论文公式 (1) 的抽象定义可视化为“共享状态 + 分支未来 + 反馈闭环”,是理解世界模型操作性判据的核心插图。
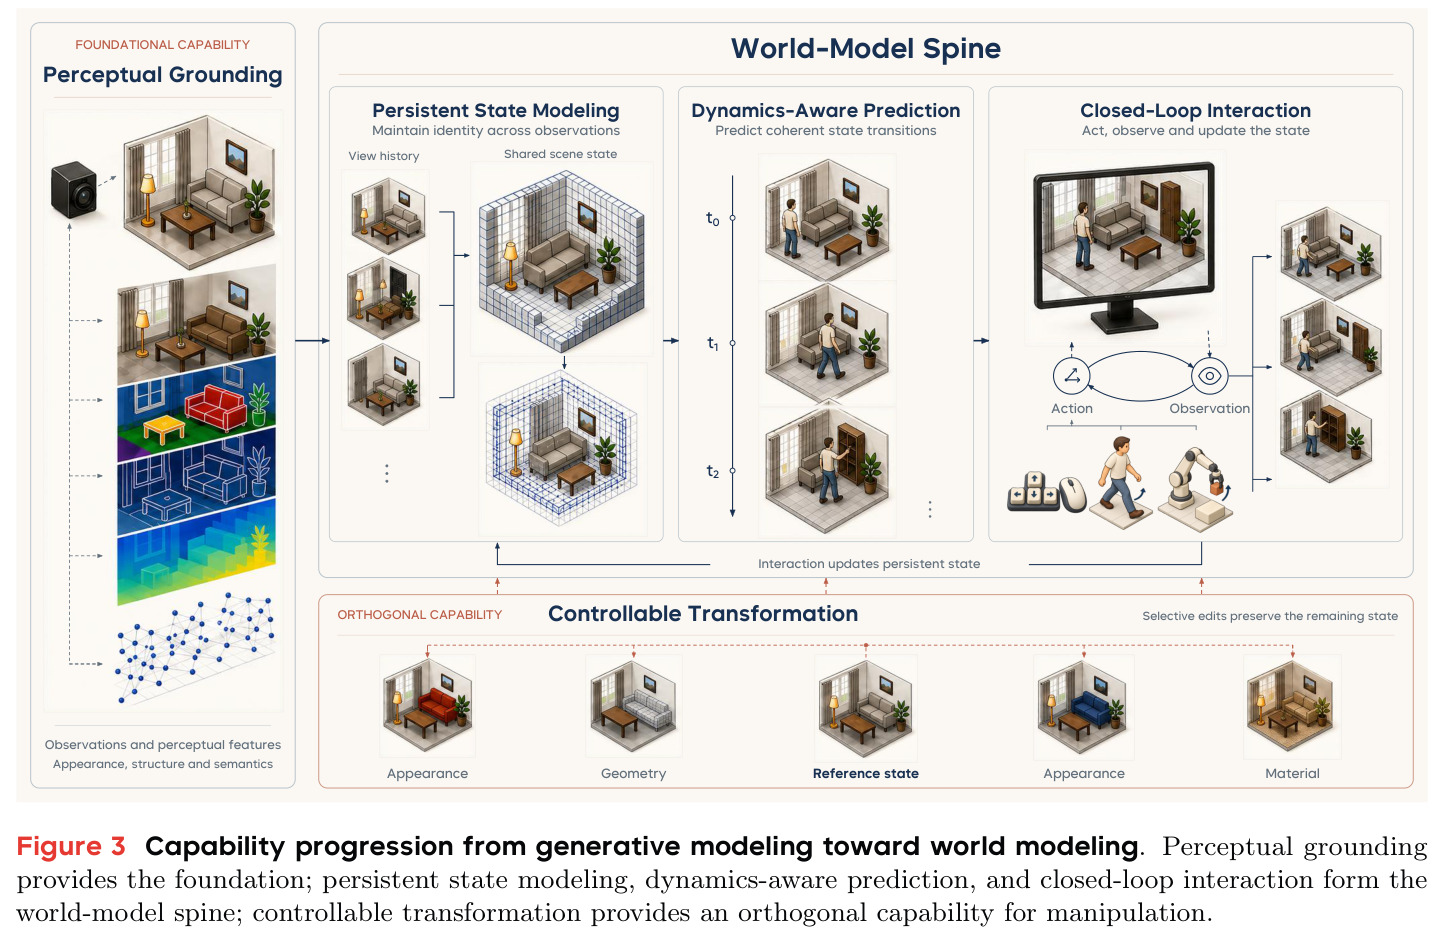
能力进阶图:感知地基(解释/重建/合成观测)是基础;世界模型主轴由三段构成——持久状态建模(跨观测维护同一场景状态)、动力学感知预测(预测一致的状态转移)、闭环交互(动作→观测→状态更新);可控变换(选择性编辑保留其余状态)是与主轴正交的能力,可叠加于任一阶段。
它给出了论文给现有系统“定位画像”的坐标系,理解视频/3D/交互/具身系统各自处在哪一阶段全靠这张图。