TRACE:面向 MoE 大模型 FP4 强化学习的滚动引导量化感知训练 TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
用滚动端量化结果引导训练端FP4舍入,直接对齐训练-滚动两条量化路径
前置知识
量化感知训练(QAT)
在前向传播中插入“伪量化”算子,模拟 FP4 的舍入与数值截断行为,反向传播仍用 BF16 高精度、以直通估计器更新权重,使模型在训练中逐渐适应量化损失,部署精度远好于训练后量化(PTQ)。
TRACE 的主体就是在 RL 训练阶段做 FP4 QAT,但它进一步用滚动端的真实量化结果改写训练端的舍入决策;理解“伪量化+直通估计”机制是看懂其训练流程的前提。
NVFP4 与 E2M1 码本
NVFP4 是 NVIDIA 的 4 位浮点格式,尾数编码为 E2M1(2 位指数、1 位尾数),可取值只有码本中有限个离散值;配合全局 scale 与每块 block scale 缩放后,实数按 round-to-nearest(RTN)归到最近码字。输入值越靠近舍入边界,微小差异越可能落成不同码字。
论文的核心观察——0.48 的 BF16 差异经缩放后被放大为 24——正源于 E2M1 码本的舍入边界效应,理解码本离散性才能理解训练-滚动分歧的来源。
训练-滚动路径分歧
RL 中策略模型在两条路径执行:训练端(Megatron,BF16 主干+FP4 伪量化)与滚动端(SGLang,FP4 kernel 生成轨迹)。两路径即使各自量化误差都小,量化取值仍可能不同,导致重要性比率 $p_{train}/p_{rollout}$ 偏离 1,破坏策略梯度无偏性,严重时训练崩塌。
本文全部设计围绕“直接压小两条量化路径的差异”展开,这是它区别于以往“各自提升量化精度”路线的核心概念。
MoE 专家路由敏感性
混合专家(MoE)模型每层由 router 依门控分数把 token 分给少量专家。激活的微小数值扰动会改变 router 分数排名、激活不同专家,误差被级联放大,因此 MoE 对训练-推理数值不一致远比稠密模型敏感。
论文实验全部在 4 个 Qwen MoE 模型上进行,FP4 滚动与专家路由的交互正是 FP4 RL 在 MoE 上格外困难、也是 TRACE 主打该场景的原因。
KV cache 量化
自回归生成时历史 Key/Value 张量常驻显存,256K 级长上下文下成为瓶颈;把 KV 量化为 FP4 可大幅省显存和带宽。但 KV 数值差异会改变注意力输出,进而放大与训练端(BF16 KV)的差异。
TRACE 做的是 FP4 权重/激活(W4A4)加 FP4 KV 的“全 FP4”滚动,其量化信息缓存有一半来自 FP4 KV cache,这直接决定了其数据流水线设计。
研究动机
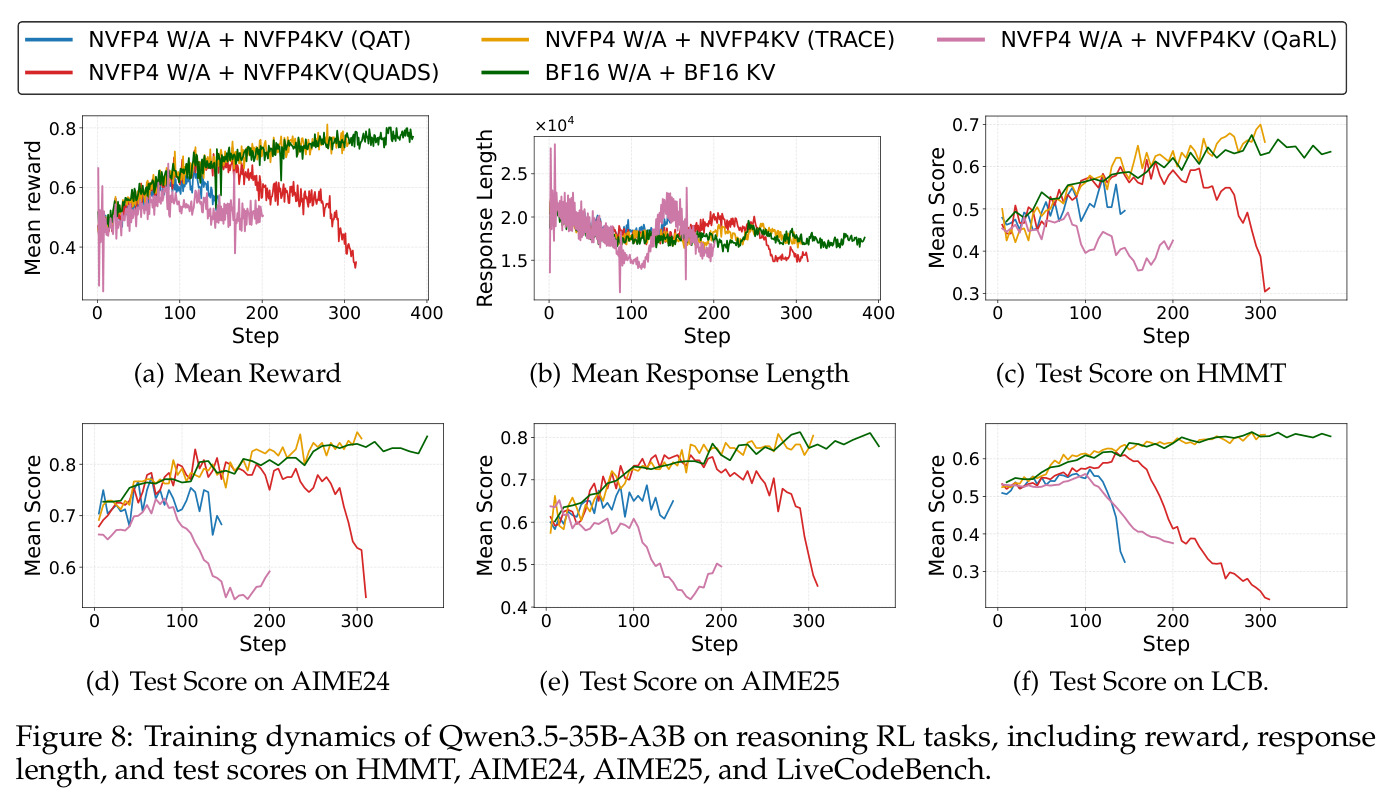
RL 后训练已成为提升 LLM 推理与编码能力的主流范式,但 rollout 生成占大头算力与显存开销,业界转向 FP8 乃至 FP4(W4A4)低精度滚动。问题在于 FP4 粗糙的量化空间使训练路径(BF16 主干+伪量化)与滚动路径(FP4 kernel)产生显著数值分歧:两路径即使各自量化误差都小,量化取值仍可能落在 E2M1 码本舍入边界两侧——训练激活 60.24、滚动激活 59.76,BF16 下仅差 0.48,经同一组 scale 后为 2.51 与 2.49,被舍入到 3 和 2,差异放大为 24。既有方法(QAT、QaRL、QUADS 等)只在各自路径上最小化对高精度参考的误差 $\|X-Q(X)\|_F$,不直接压小跨路径差距;如 QUADS 把单路径误差从 0.09 修到 0,跨路径差异却从 0 升到 0.10,另一例仍达 0.99。MoE 上数值扰动还会改变专家路由进一步放大失配:vanilla FP4 QAT 的 log-prob 差随训练增至约 2.0,Qwen3.8-Flash-Next 在 Terminal-Bench 2.1 上从约 0.66 崩塌至 0.45。
本文的目标是目标是让大规模 MoE 语言模型在“全 FP4”滚动(NVFP4 权重/激活 W4A4 + NVFP4 KV cache)下稳定完成 RL 训练,同时保持与 BF16 滚动相当的任务性能与训练动态。具体有三点:(1)直接以两条量化路径取值差异 $\|Q_{train}^{FP4}(X_{train})-Q_{rollout}^{FP4}(X_{rollout})\|_F$ 为优化对象,而非分别优化各路径量化精度;(2)把滚动引导引入训练所需的存储与通信开销压到可忽略——全量信息在 Qwen3.5-35B-A3B、每步 4096 条轨迹、256K 响应长度下高达约 51 TB,必须压缩 6 倍以上;(3)保留 FP4 效率红利,争取最高 5.4 倍解码加速、端到端步时开销低于 10%,并使最终 FP4 策略优于“BF16 训练+事后 PTQ”流水线(75.3 对最优基线 71.4)。
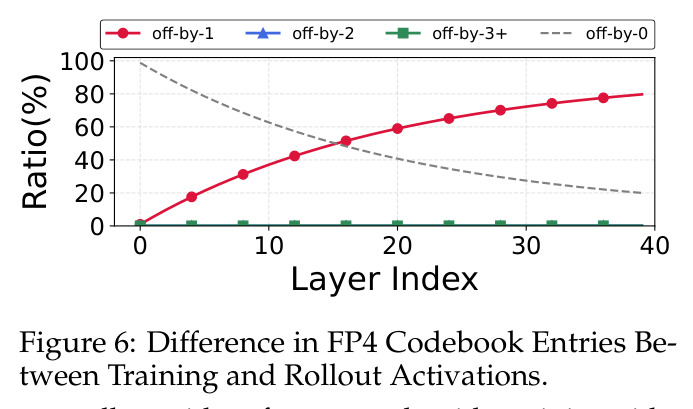
与已有工作不同的是,独特切入是把“逐路径量化精度”与“跨路径一致性”解耦:作者证明二者并不等价,并通过统计发现 99% 以上的失配量化值只差相邻一个 FP4 码字——因此无需传输完整量化值,只需 1 位尾数加摊销 scale 即可判断训练端应向哪个相邻码字舍入;又发现“向下修正”集中于深层,故只缓存后半 20/40 层。这与 QUADS/Rollout-ResQ 的激活残差补偿、QaRL 的匹配低精度 kernel、Score Centering 的优化层纠偏都不同:那些方法即便执行匹配,微小激活差仍会跨过舍入边界产生不同码字,TRACE 直接在舍入决策层面封死这条放大路径,并以式(3)给出位点级“不增加差异”的构造性保证。
核心方法
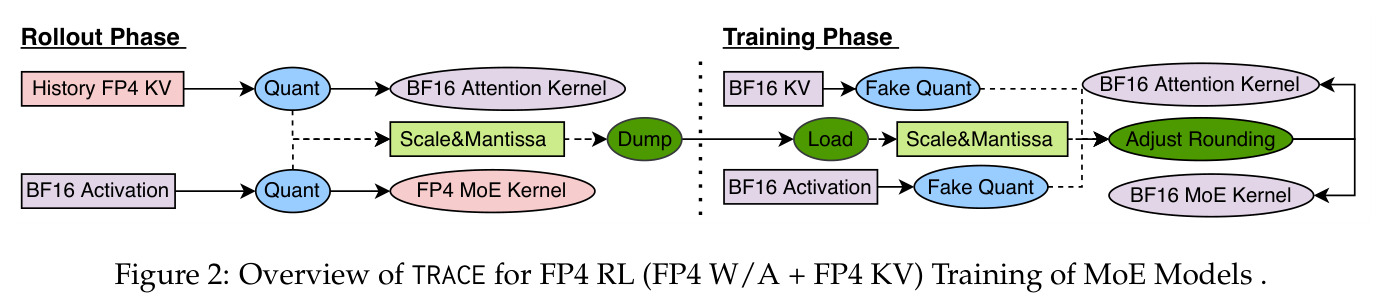
直觉:训练端与滚动端对应激活绝大多数落在同一或相邻 FP4 码字上,若让训练端直接“抄”滚动端的舍入答案,就能消灭舍入不一致造成的无谓放大。技术路线:滚动阶段,SGLang 在执行 FP4 MoE kernel 与 FP4 attention 时,把路由专家激活与 KV 的量化信息(码字尾数与 scale)写入临时 GPU buffer 并异步 offload 到 CPU,请求结束后序列化落盘;训练阶段,Megatron 前向做 FP4 伪量化时,按(轨迹、token 位置、量化位点)三元组配对加载滚动记录,重构紧凑参考并用它改写标准 RTN 舍入,反向传播仍走 BF16。量化范围上只对 MoE 路由专家与 KV cache 施加 FP4,其余模块保持 BF16。整体搭建在 VeRL(异步协调)+ Megatron(训练后端)+ SGLang(滚动引擎)的 disagg 架构上,配 GRPO 优化、R3 路由重放、token 级重要性比率裁剪(上界 5)与 max_version_diff=3 的陈旧度控制,在 4 个 Qwen MoE 模型上端到端训练 50–400 步。
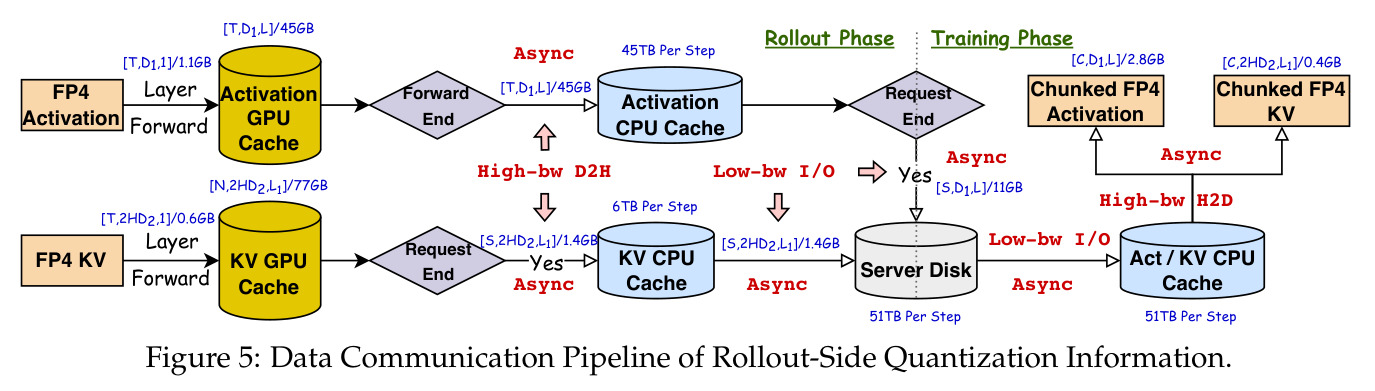
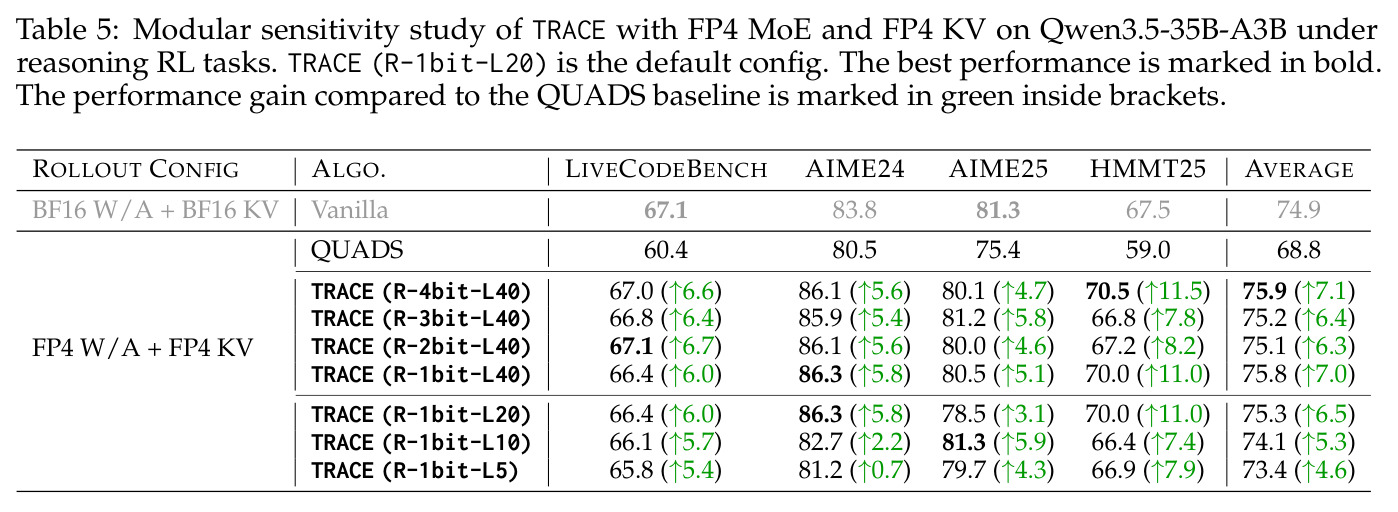
核心创新是“滚动引导的量化感知训练”:对每个训练侧激活,取滚动侧 scale 下两个相邻 E2M1 码字 $\{q^-, q^+\}$,在已知滚动端码字 $q_{rollout}$ 时不做 round-to-nearest,而是选 $q_{TRACE}=\arg\min_{q\in\{q^-,q^+\}}|q-q_{rollout}|$;由构造有 $|q_{TRACE}-q_{rollout}|\le|q_{RTN}-q_{rollout}|$,即每个位点都不增加局部量化差异。与已有方法的本质区别在优化目标:QUADS 等最小化逐路径误差,TRACE 直接最小化跨路径差异。第二创新是尾数-only 通信:利用 off-by-1 失配占比超 99% 的观察,每量化值只传 1 位尾数加摊销 scale,且只保留后半 20 层(深层更常需向下修正),每 token 缓存从约 50 KB 降至 7.5 KB($2048\times20\times1.5=61440$ bit),压缩约 6 倍,平均分仅从 75.8 降到 75.3。作者亦指出该位点级保证不蕴含全网络差异的单调下降。
方法步骤详情
步骤一(滚动端采集):SGLang 生成时,路由专家 FP4 激活量化信息写入临时 GPU buffer,forward 后异步 offload 到 CPU,buffer 复用;FP4 KV 本就在持久 cache 中,请求结束后 gather 至 CPU,再序列化落盘。步骤二(压缩通信):只保留后半 20 层的 1 位尾数与摊销 scale,每 token 约 $2048\times20\times1.5=61440$ bit ≈ 7.5 KB,对比全量每 token 约 50 KB、每步约 51 TB,压缩约 6 倍。步骤三(训练端配对):QAT 前把 microbatch 对应记录 reload 进 CPU、切片上传 GPU,按轨迹、token 位置、量化位点三元组与训练侧激活配对。步骤四(引导舍入):前向伪量化时在候选集 $\{q^-,q^+\}$ 内选 $q_{TRACE}=\arg\min|q-q_{rollout}|$ 替代 RTN。步骤五(RL 更新):GRPO 配合 R3 路由重放与重要性裁剪(上界 5),反向走 BF16;每步采样 256×16 至 64×8 条轨迹,推理 RL 上限 32K、编码/长程 RL 上下文 256K。
技术新颖性
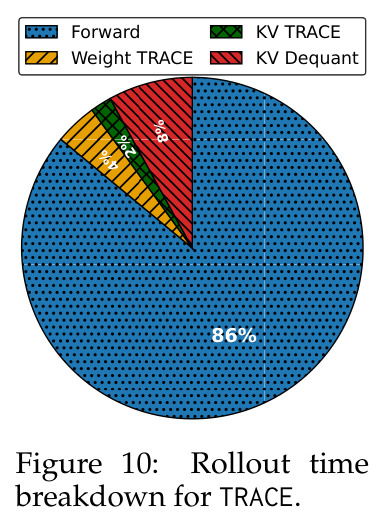
新颖性有三层。问题层面:首次把 FP4 RL 的失败模式归因为“量化精度与训练-滚动分歧的错配”,并提出可度量的相对超额差异 $(D_{FP4}-D_{BF16})/D_{BF16}$,逐层量化 vanilla NVFP4 引入的额外分歧(图 4b 显示 40 层普遍存在)。算法层面:把舍入决策本身作为对齐变量,给出位点级构造保证(式 3),区别于 QaRL 的 kernel 匹配、QUADS 的激活补偿、Rollout-ResQ 的稀疏残差与 Score Centering 的优化纠偏——后四者即便在执行或优化层对齐,微小激活差仍可跨过舍入边界产生不同码字,TRACE 恰好封死这条放大路径。系统层面:用两个经验统计(off-by-1 占比超 99%;向下修正集中于深层)把全量 51 TB/步的引导数据压缩到 7.5 KB/token,使算法增益与 5.4 倍滚动加速共存,E2E 开销仅 7.4%,并在 NVFP4 与 MXFP4 两种格式上验证了通用性。
实验结果
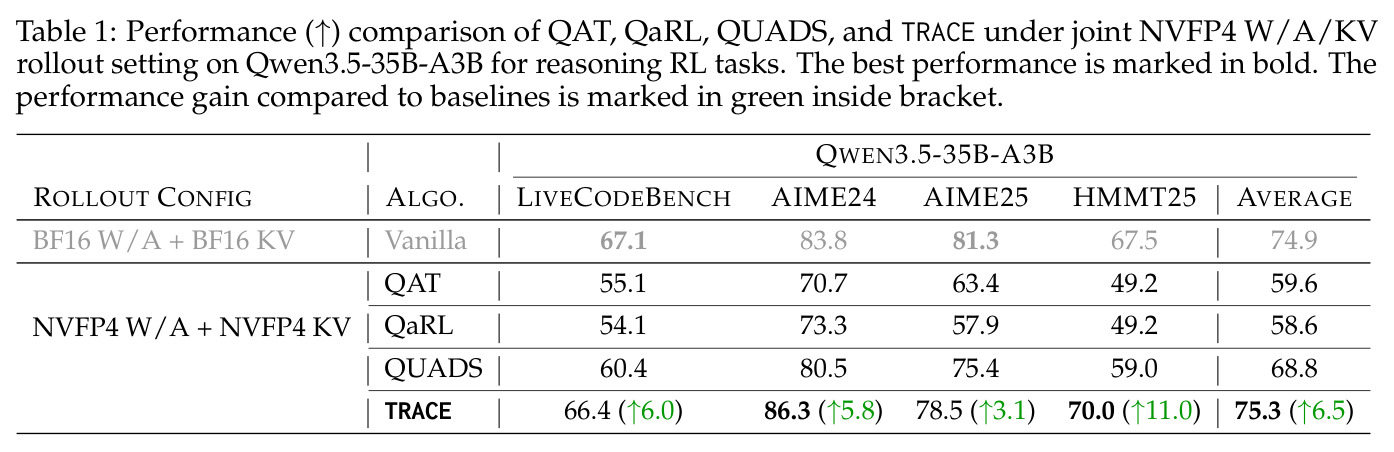
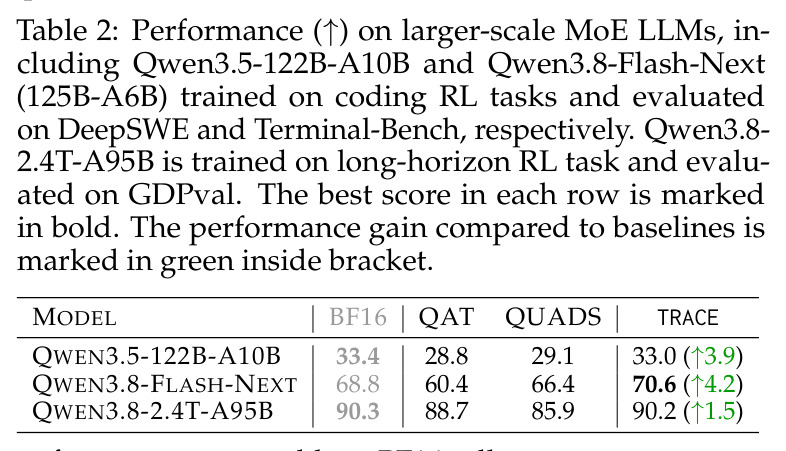
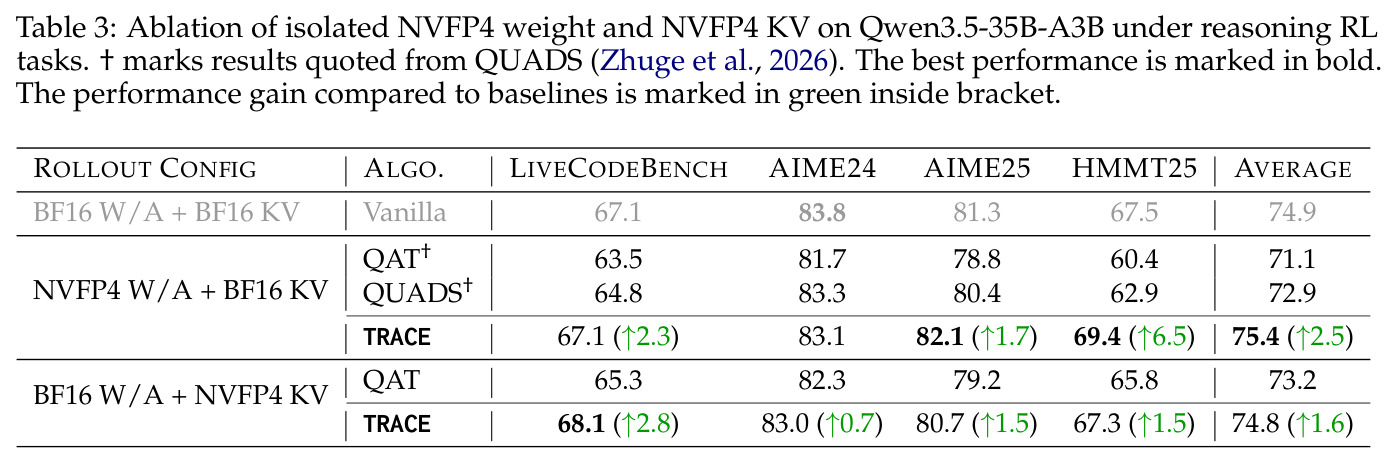
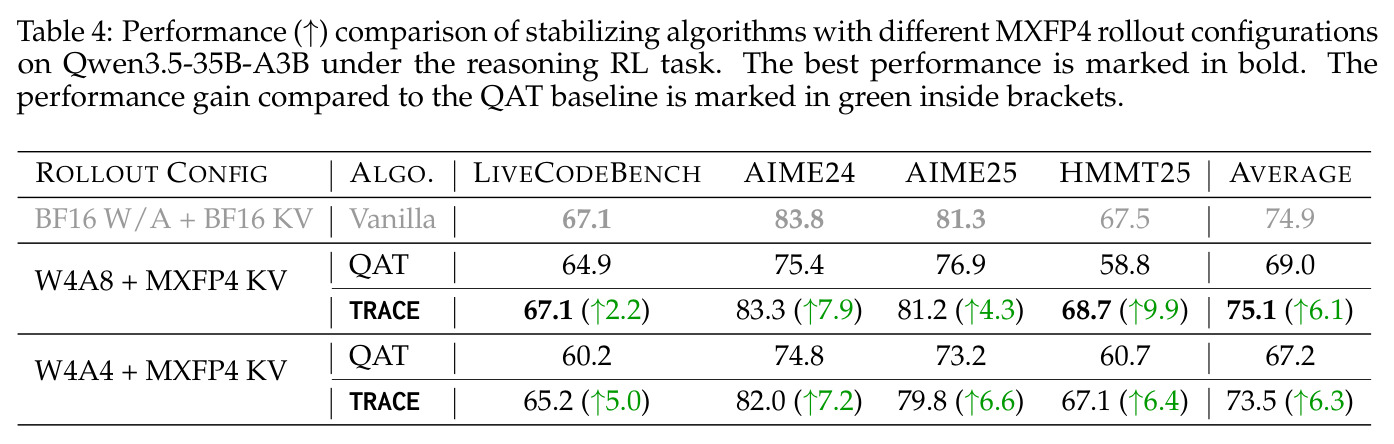
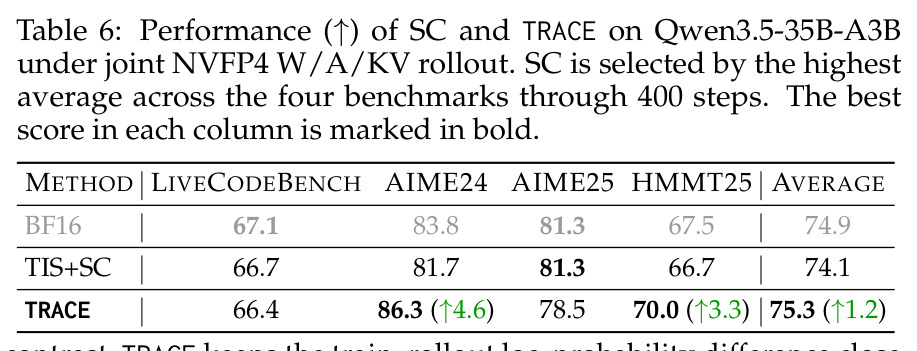
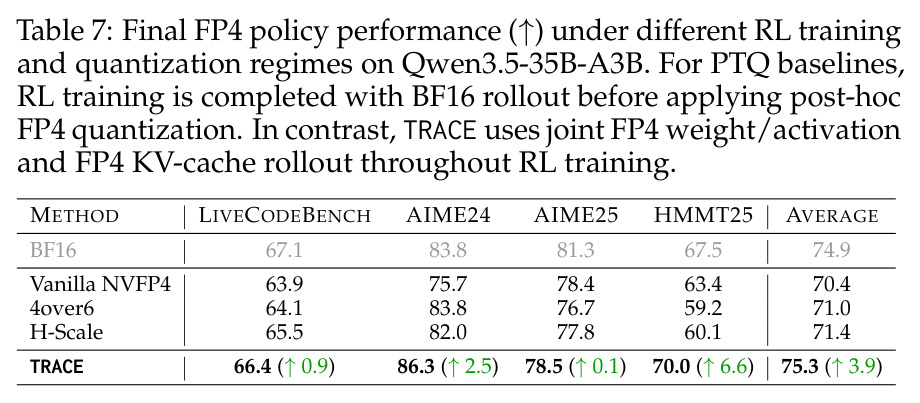
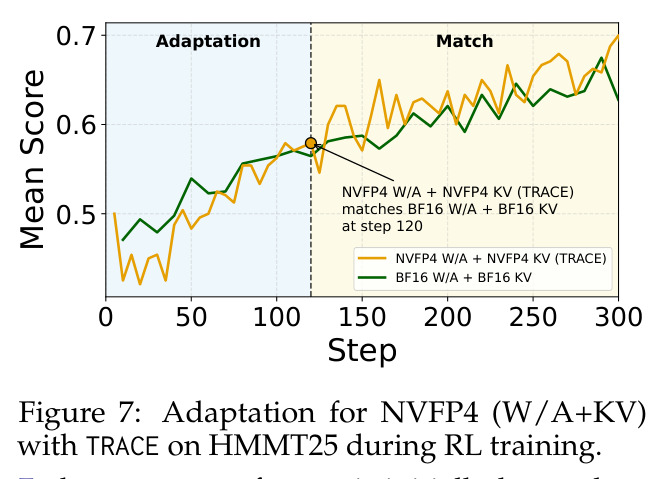
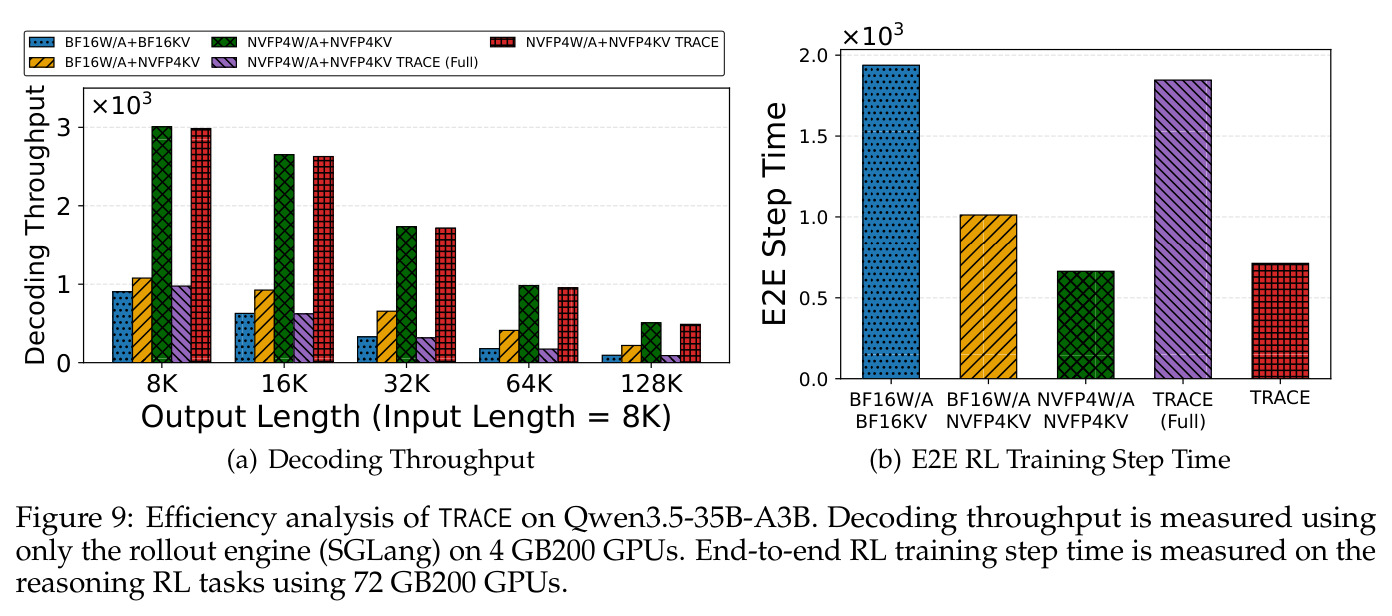
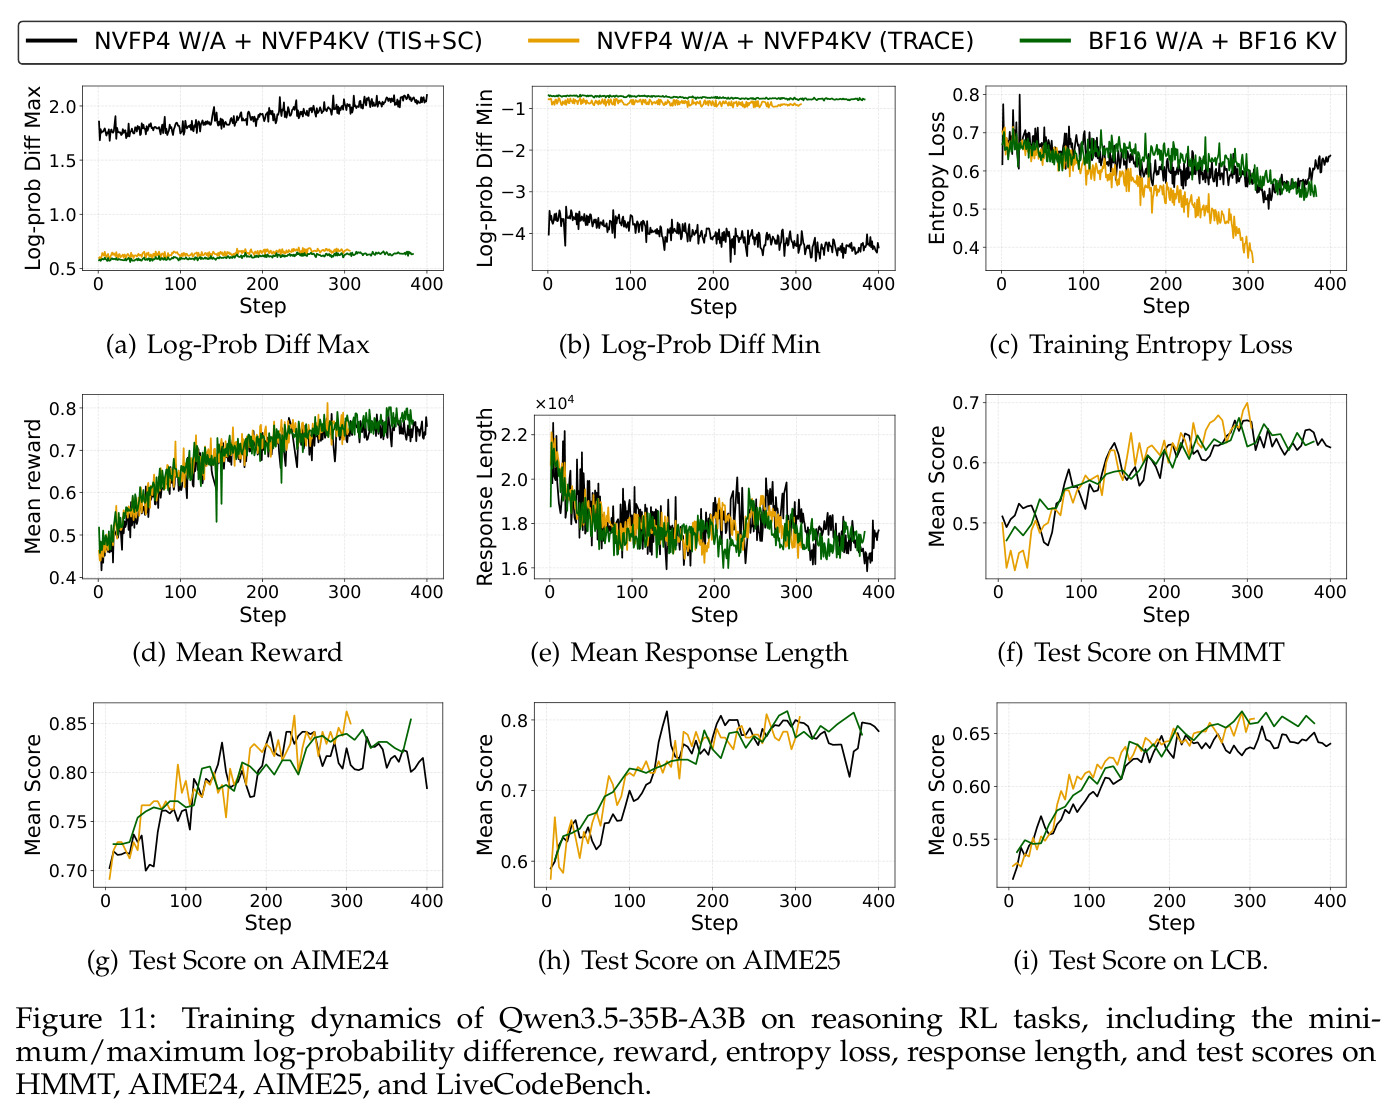
推理 RL(Qwen3.5-35B-A3B,NVFP4 W/A+KV 四基准平均):BF16 74.9,QAT 59.6、QaRL 58.6、QUADS 68.8,TRACE 75.3,其中 HMMT25 从 59.0 升至 70.0(↑11.0)、AIME24 达 86.3(↑5.8),追平 BF16。更大规模:122B-A10B 在 DeepSWE 得 33.0(BF16 33.4、QUADS 29.1);Flash-Next 在 Terminal-Bench 得 70.6 超 BF16 的 68.8;2.4T-A95B 在 GDPval 得 90.2 对 90.3。消融:单独 NVFP4 权重 TRACE 75.4、单独 KV 74.8,联合 FP4 远比单独难。MXFP4:W4A8 得 75.1、W4A4 得 73.5,对 QAT 分别提升 6.1 与 6.3。敏感性:R-1bit-L40 75.8、默认 L20 75.3、L10 74.1、L5 73.4。对比 Score Centering:TIS+SC 平均 74.1,TRACE 75.3 且 log-prob 差更贴近 BF16。对比事后 PTQ:Vanilla 70.4、4over6 71.0、H-Scale 71.4,TRACE 75.3。效率:128K 输出解码吞吐对 BF16 最高 5.4×,E2E 步时 664→713 秒(+7.4%)。适应性:TRACE 初期低于 BF16,HMMT25 约 120 步、Terminal-Bench 约 240 步追平甚至反超。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 推理 RL(Qwen3.5-35B-A3B,LiveCodeBench v6/AIME24/AIME25/HMMT25) | 四基准平均分(pass@1) | 75.3 | BF16 滚动 74.9;最强 FP4 基线 QUADS 68.8 | 对 QUADS +6.5,追平 BF16 |
| 编码 RL(Qwen3.8-Flash-Next,Terminal-Bench 2.1) | 任务平均分(10 次运行) | 70.6 | BF16 滚动 68.8;QUADS 66.4;QAT 60.4 | 对 QUADS +4.2,超 BF16 +1.8 |
| 编码 RL(Qwen3.5-122B-A10B,DeepSWE v1.1) | 任务平均分(4 次运行) | 33.0 | BF16 滚动 33.4;QUADS 29.1 | 对 QUADS +3.9,与 BF16 基本持平 |
| 长程 RL(Qwen3.8-2.4T-A95B,GDPval) | 任务平均分(3 次运行) | 90.2 | BF16 滚动 90.3;QUADS 85.9 | 对 QUADS +1.5,与 BF16 持平 |
| 滚动解码效率(Qwen3.5-35B-A3B,128K 输出,4×GB200) | 解码吞吐加速比 | 最高 5.4×(TRACE) | BF16 W/A+BF16 KV;TRACE(Full) 全量引导版吞吐明显退化 | 尾数缓存版吞吐接近纯 FP4 滚动 |
| 端到端 RL 步时(Qwen3.5-35B-A3B,72×GB200) | 每步时间(秒) | 713 | 纯 FP4 滚动 664 | 仅 +7.4% 开销 |
局限与改进
作者承认的局限:(1)TRACE 不消除策略陈旧引起的底层激活差异——异步训练中训练策略比生成策略新,式(2)只在同候选集下保证不增加局部差异,全网络差异与下游非线性变换后的策略级分歧并无单调下降保证;(2)效果依赖“失配多为相邻码字”的经验统计,若模型或格式变化使失配更远离相邻码字,1 位尾数可能不足——敏感性表中层覆盖降到 L10/L5 后分数降至 74.1/73.4 已见端倪。我自己的观察:(1)实验只在 Qwen 系 4 个 MoE 模型与 GRPO 上验证,未覆盖稠密模型、其他 RL 算法或 INT4 等量化格式,泛化性未知;(2)方法需深度改造训练-滚动两侧引擎(量化记录 dump/load、按位点配对),工程侵入性远高于 Score Centering 这类纯优化层方法;(3)全量估算显示 5 GB/s 存储带宽下落盘需约 3 小时,轨迹更长或更多时 I/O 可能非线性恶化,需要分布式缓存方案;(4)“策略适应 FP4”的追平现象(120/240 步)机制未深入解释,早期量化损失能否避免仍是开放问题。
独立分析的弱点
弱点一:对训练-滚动配对的时间一致性依赖较强——max_version_diff=3 意味着训练侧激活与滚动记录来自不同版本策略,引导只能消除舍入放大而不能消除策略漂移本身;改进方向是把引导与策略版本差显式建模,或对陈旧样本降权。弱点二:尾数-only 缓存的层选择是硬编码的“后半 20 层”,缺乏自适应准则;改进方向是根据在线测得的 $(D_{FP4}-D_{BF16})/D_{BF16}$ 动态选择需保留信息的层与位宽。弱点三:KV 引导仍需 8% 的 KV 反量化时间且须等请求完成才能 gather,对 256K 级长上下文是延迟来源;改进方向是分块流式传输 KV 记录或在滚动引擎内直接输出紧凑码。弱点四:所有记录要落盘再 reload,依赖存储带宽(5 GB/s 下全量约 3 小时),在云上弹性环境易成瓶颈;改进方向是滚动-训练同址部署、共享内存环形缓冲或只对失配位点做差分记录。弱点五:评估全为 Qwen MoE + GRPO,结论外推需谨慎,应补充跨模型家族与算法的消融。
未来方向
作者方向的延伸:把滚动引导舍入推广到 FP6/FP8 及更多 MXFP 格式,并覆盖注意力投影、embedding、lm_head 等更多模块的全低精度 RL;探索更低通信下限(0 位尾数、只传 scale 或 1 位符号修正);深入研究“策略适应低精度执行”现象的理论解释与加速手段。基于成果可延伸:其一,把引导信号从“抄码字”升级为可微的分布对齐目标,例如在 QAT 损失中加入 $\|Q_{train}(X_{train})-Q_{rollout}(X_{rollout})\|_F$ 正则,摆脱对逐位点硬配对的依赖;其二,与异步 RL 的陈旧度处理(TIS、GSPO 式序列级比率)联合设计,统一建模量化失配与策略陈旧两类失配;其三,把缓存方案迁移到滚动与训练同集群的在线场景,用 RDMA/共享内存消除落盘瓶颈;其四,表 7 显示 FP4 环境中训出的策略最终 FP4 性能更强(75.3 对 H-Scale 71.4),可深挖“quantization-aware RL as regularization”的机理,反过来指导量化友好的预训练。
复现评估
复现难度较高。论文未提及开源代码或模型权重(正文无仓库链接);实验需要 4–72 张 GB200 级 GPU(吞吐测量 4×GB200、端到端 RL 72×GB200),并深度整合 VeRL+Megatron+SGLang disagg 架构,要在 SGLang 加量化记录 dump、在 Megatron 加位点配对与引导舍入 kernel,工程量大。基准数据均公开(LiveCodeBench v6、AIME 2024/2025、HMMT 2025、DeepSWE v1.1、Terminal-Bench 2.1、GDPval),训练配置交代较细(每步轨迹数、响应长度 32K/256K、步数 400/50、裁剪上界 5、max_version_diff=3、R3 重放),协议可复现;但 Qwen3.8-Flash-Next 与 2.4T-A95B 权重获取可能困难。小团队可行路径:先在 35B 级模型上用 NVFP4 fake quant 复现表 1 的相对排序与图 4(b) 的逐层差异测量,再决定是否投入完整系统工程。
论文图表
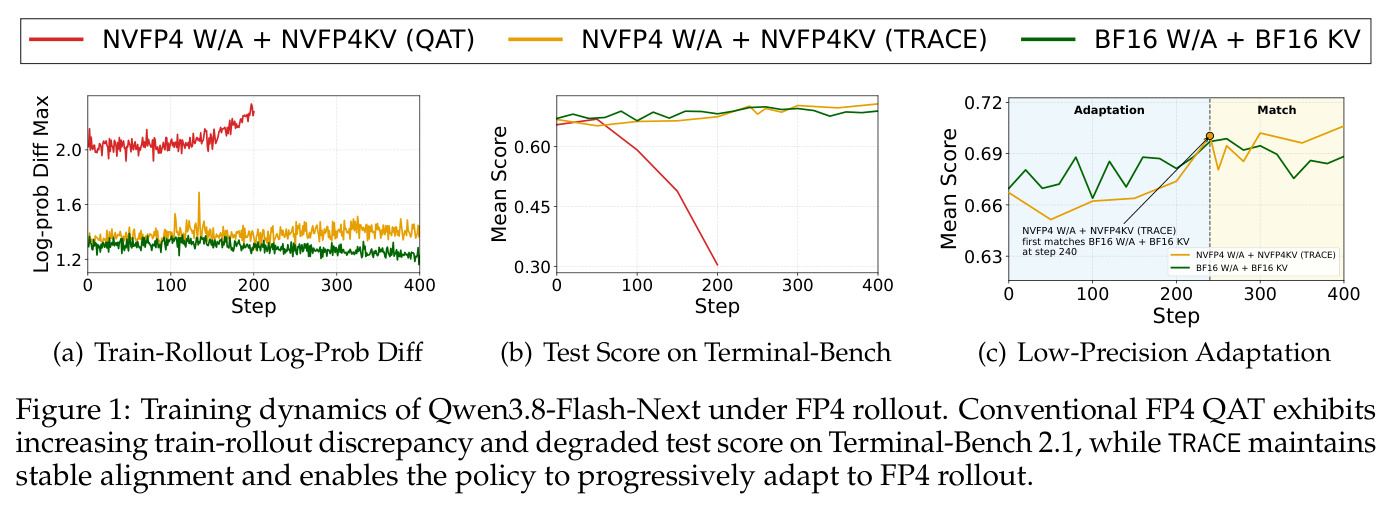
三联图: 常规 FP4 QAT 的 train-rollout log-prob 差随训练攀升至约 2.0,Terminal-Bench 2.1 分数从约 0.66 崩塌至 0.45; TRACE 的 log-prob 差保持稳定,约 240 步首次追平 BF16; TRACE 的低精度适应曲线显示分数从 0.63 逐步升至 0.72,最终超过 BF16。
这是全文的动机图:一图同时展示了现有方法崩塌、TRACE 对齐、以及“策略适应 FP4”三大卖点,是理解论文问题与贡献的入口。
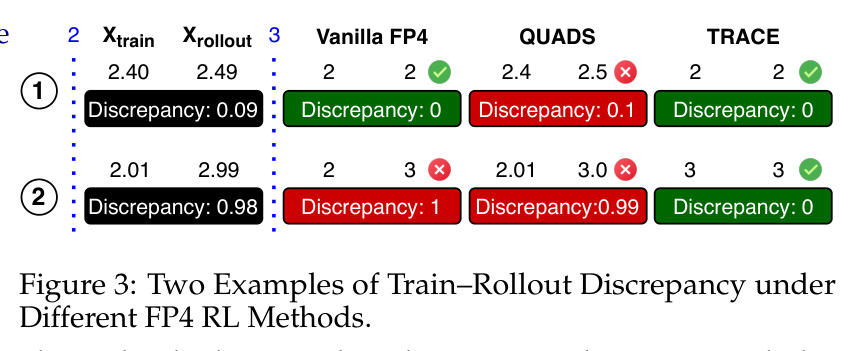
两组数值例子:例➊中训练/滚动激活为 2.40/2.49,Vanilla FP4 都舍入到 2、差异 0,QUADS 重构为 2.50 后差异反升到 0.10,TRACE 差异 0;例➋中 2.01/2.99,QUADS 差异仍达 0.99,TRACE 归零。
用最小反例直观证明“提升单路径量化精度不等于缩小跨路径差异”这一核心论点,是动机部分最关键的说理图。
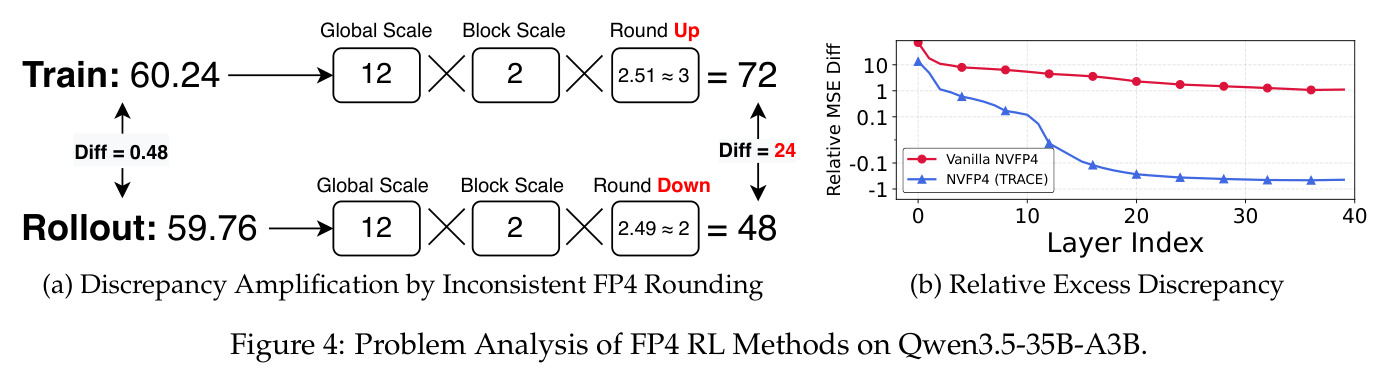
(a) 展示舍入边界放大:60.24 与 59.76 差 0.48,经 global/block scale 后为 2.51/2.49,被舍入到 3 和 2,差异放大为 24;(b) 给出 40 层的相对超额差异 $(D_{FP4}-D_{BF16})/D_{BF16}$,vanilla NVFP4 各层普遍引入大量额外差异。
定量刻画了 FP4 舍入不一致的危害随层分布的情况,为“只缓存深层”的设计决策提供了经验依据。