SoloQ:面向扩散语言模型的免校准量化框架 SoloQ: Calibration-Free Quantization for Diffusion Language Models
用K-RPBH随机旋转把激活变为可预测分布,无需校准数据即实现dLLM的4bit量化与加速
前置知识
扩散大语言模型(dLLM)
与自回归(AR)模型从左到右逐 token 生成不同,dLLM(如 LLaDA、Dream)采用掩码扩散:训练时按概率 $\alpha_t$ 把 token 替换为掩码 $[M]$,推理时从全掩码序列出发,模型基于双向上下文并行预测所有被掩码位置,经多步去噪逐步还原整个序列。块扩散(block-diffusion)变体(Fast-dLLM v2、Nemotron-Labs-Diffusion)则按块去噪,已提交块的 KV 状态被缓存复用。
本文的量化对象就是 dLLM;其掩码状态和去噪步数在推理中不断变化,导致激活分布漂移,这正是量化困难的根源,也是作者提出免校准方案的动机。
后训练量化(PTQ)与激活离群值
PTQ 指训练完成后直接把模型权重/激活从 FP16 压到低位宽(如 4bit),无需重新训练。LLM 激活中存在少数幅值极大的离群通道,直接按最大值定标会使其余通道的有效分辨率骤降,因此需要 GPTQ、AWQ、SmoothQuant、QuaRot 等技术通过缩放、旋转或 Hessian 加权重构来缓解。
SOLOQ 属于旋转类 PTQ,但它对比的全部基线(RTN/AWQ/QuaRot+GPTQ/DLLMQuant/STaR-Quant)都是 PTQ 方法,理解 PTQ 的基本目标和离群值问题才能理解各方法的差异。
校准数据(calibration set)
传统 PTQ 需要一小批代表性文本(如 WinoGrande、MMLU 的若干样本)前向传播以统计激活分布,据此确定缩放因子、量化网格或重构目标。校准集与真实任务分布不匹配时,量化参数会过拟合到校准分布,导致其他任务掉点。
本文标题的 calibration-free(免校准)即指摆脱这一依赖:论文 Figure 1(c) 实证了换校准集会改变精度,而 SOLOQ 的量化器完全由解析分布决定、不需要任何数据。
随机旋转与可预测边际分布
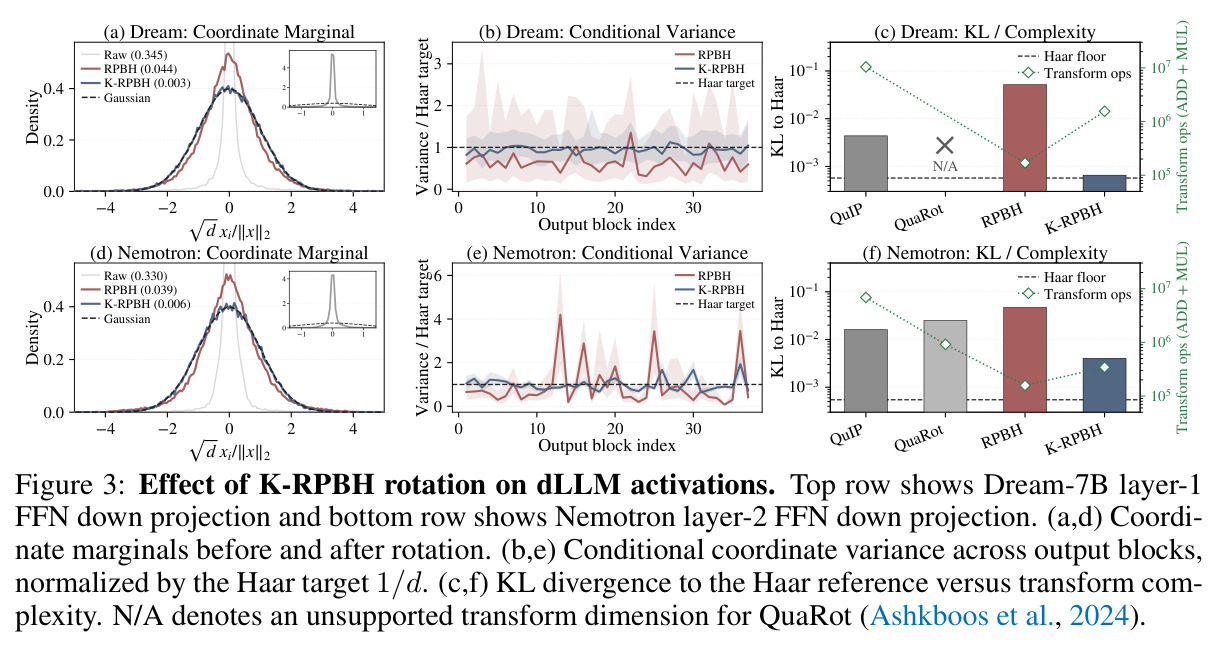
把非零向量归一化为方向 $\tilde{x}=x/\|x\|_2$ 后,Haar 随机正交旋转 $z=R\tilde{x}$ 在单位球面上均匀分布,与原方向无关,每个坐标服从固定球面边际 $f_d(u)=\frac{\Gamma(d/2)}{\sqrt{\pi}\Gamma((d-1)/2)}(1-u^2)^{(d-3)/2}\approx\mathcal{N}(0,1/d)$。既然旋转后分布已知,量化器(码本、网格)就可以离线解析设计,无需统计真实激活。
这是 SOLOQ 全部理论的地基:K-RPBH 旋转就是这一原理的高效结构化实现,理解它才能理解为什么免校准量化在数学上成立。
Walsh–Hadamard 变换与 RPBH
Hadamard 矩阵 $H_h$ 是元素 $\pm 1$ 的正交矩阵,可用 $O(h\log h)$ 快速变换,常用来打散激活离群值。RPBH(randomized permuted block-Hadamard)先做全局随机置换 $P$ 平衡各块能量,再对每个 $h$ 维块独立做带 Rademacher 符号翻转的 Hadamard 变换,总代价仅 $O(d\log h)$。
K-RPBH 是在 RPBH 基础上加跨块混合得到的,论文证明了 RPBH 的两个缺陷(对离群敏感的块平衡、无跨块校正),理解 RPBH 才能看懂 K-RPBH 的改进点。
NVFP4 与码本量化
NVFP4 是 NVIDIA 原生支持的 4bit 浮点格式:数值用 E2M1(2 位指数+1 位尾数)表示,配合每 16 个元素一个 E4M3 块缩放因子和全局 tensor 缩放,可直接在 RTX Pro 6000 等 GPU 的 Tensor Core 上硬件加速。码本量化则把数值映射到预先设计的有限点集:Lloyd–Max 是标量最优码本,E8P 是基于 $E_8$ 格的晶格码本,两者可在同样比特数下比均匀 INT 更贴近目标分布。
SOLOQ 有两条量化路径:SOLOQ-C 用分布匹配码本(Lloyd+E8P),SOLOQ-N 用硬件原生 NVFP4,理解二者决定了对效率实验(8bit kernel vs 原生 4bit kernel)的解读。
块扩散的 KV-cache 与 commit 机制
全序列 dLLM 每个去噪步都重算全部 KV,不维护持久缓存;块扩散模型则一次去噪一个块,块内 token 确定后该块的 KV 状态被「提交(commit)」进持久 KV-cache 供后续块复用,缓存随上下文线性增长,成为长上下文下的显存瓶颈。
SOLOQ 针对 block-diffusion 的核心增量就是 commit-time KV 量化:只在提交那一刻量化 KV,正在去噪的活跃块保持全精度,理解 commit 机制才能理解该设计的巧妙之处。
研究动机
扩散大语言模型(dLLM)的推理成本比自回归模型更棘手:全序列 dLLM(LLaDA、Dream)每步去噪都要对整个序列做完整 Transformer 前向,计算被反复支付;块扩散模型(Fast-dLLM v2、Nemotron-Labs-Diffusion)虽靠 KV 缓存复用降低计算,却引入随上下文线性增长的持久 KV-cache。作者对 Fast-dLLM v2 的剖析(Figure 1a)显示:短上下文时显存由权重主导,长上下文时激活与 KV-cache 占比持续上升,注意力延迟也随序列激增,且这些成本要乘上去噪步数,仅压权重远远不够,必须对权重、激活、KV-cache 同时低比特量化。但 dLLM 上的 PTQ 更难:掩码扩散解码中模型不断经历不同掩码比例与去噪时刻,Figure 1(b) 实测 down-projection 输入激活尺度随去噪步逐层显著漂移,固定量化参数难以适配所有扩散状态。现有 dLLM PTQ 方法(QuantDLLM、DLLMQuant、STaR-Quant、FAIR-Calib)全部依赖校准数据来补偿这种时变分布,而校准集选择本身就会引入偏差——Figure 1(c) 显示把校准数据从 WinoGrande 换成 MMLU 就会改变各基准精度,说明校准式方法难以跨任务泛化。
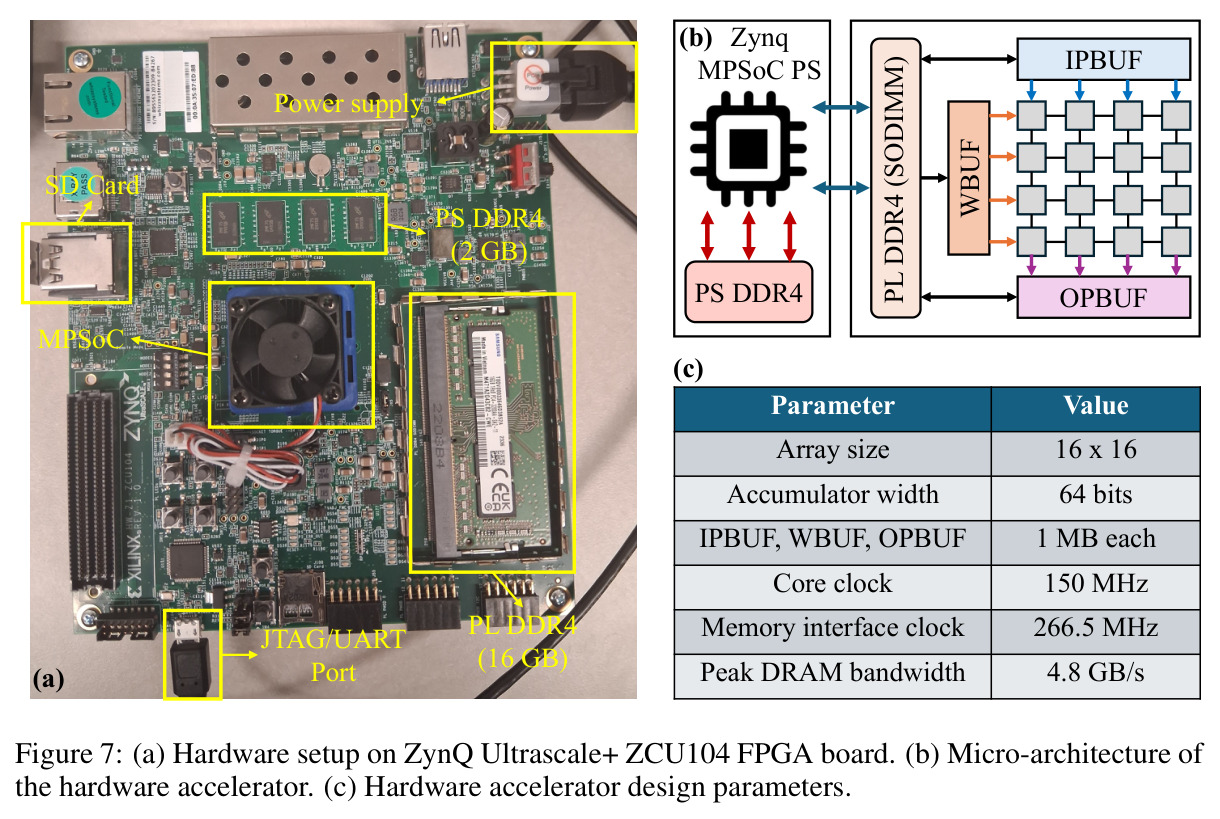
本文的目标是本文的目标是构建一个完全不需要校准数据的 dLLM 量化框架,在摆脱校准集依赖的前提下达到甚至超越校准式方法的精度,并同时覆盖三类压缩对象:权重、激活、以及块扩散模型的持久 KV-cache。具体而言:(1) 把权重和激活变换到一个统计性质完全已知、与输入数据无关的表示空间,使量化器可以离线解析设计、在所有掩码状态和去噪步之间共享;(2) 该空间要同时支持两条部署路径——分布匹配码本(软件路径)和硬件原生 NVFP4(GPU Tensor Core 路径);(3) 支持任意 Transformer 维度(如 Dream 的 FFN 维度 $d=18944=512\times 37$ 这类非标准分解);(4) 在 4bit 设定下给出可测量的系统收益:峰值显存降低和端到端加速,并在 FPGA 上验证边缘部署可行性。
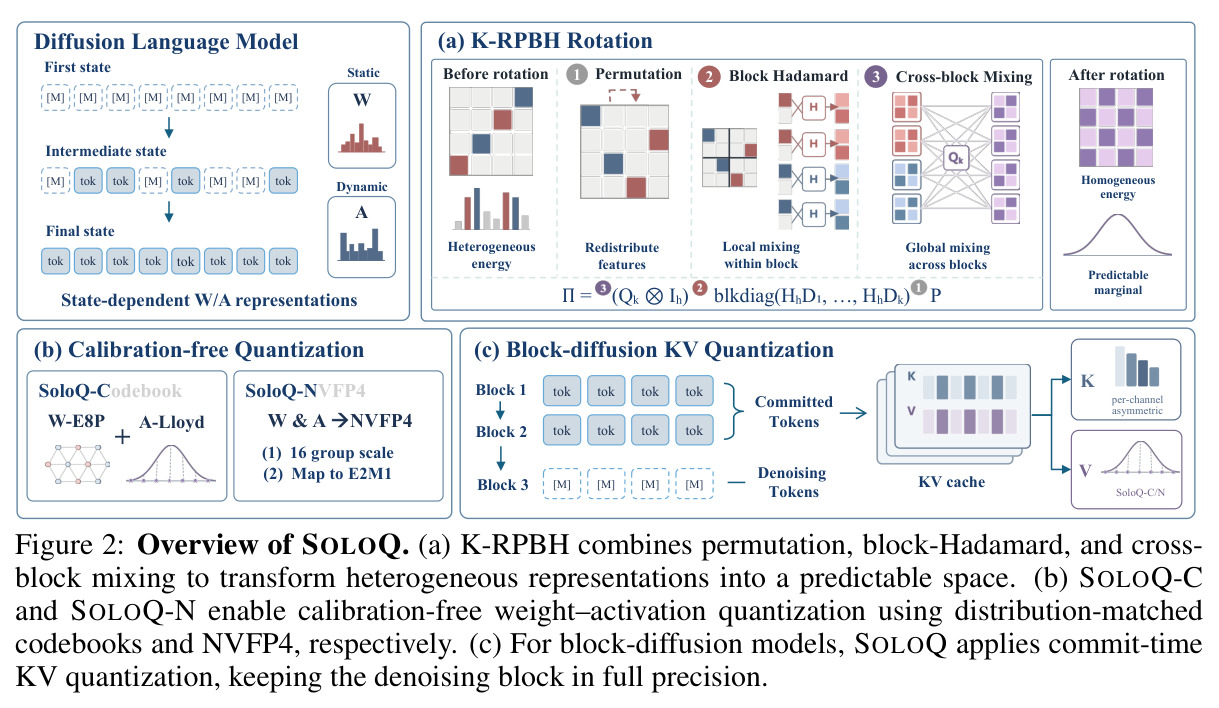
与已有工作不同的是,现有 dLLM 量化工作的共同思路是「追踪」:用校准数据模拟掩码过程(QuantDLLM 的 masked calibration simulation)、对时间步和掩码状态分别建模(DLLMQuant)、处理状态相关激活差异与误差累积(STaR-Quant)、或加权校准脆弱的 token 提交状态(FAIR-Calib)。它们都在追赶一个不断变化的分布。SOLOQ 的独特切入是反其道而行——既然分布在变、追不上,那就用随机旋转把任意表示变换到一个只依赖维度 $d$、与数据无关的可预测边际分布(近似 $\mathcal{N}(0,1/d)$),让量化器一次设计、处处适用。这个「分布整形取代分布追踪」的原理源自 TurboQuant/OrbitQuant 一脉,但本文第一次把它带进 dLLM:针对 dLLM 的高维重尾表示,扩展 RPBH 引入 Kronecker 跨块混合(K-RPBH)并证明方差平均化保证;针对块扩散,首次给出免校准的 commit-time KV-cache 量化。据作者所述,这是首个同时覆盖全序列与块扩散 dLLM、且免校准的权重-激活-KV 全栈量化框架。
核心方法
直觉上,SOLOQ 的哲学是:与其适配变化莫测的激活分布,不如把所有表示都搬进一个统计性质已知的「标准空间」。数学出发点是:单位向量 $\tilde{x}=x/\|x\|_2$ 经 Haar 随机旋转后 $z=R\tilde{x}$ 均匀分布于单位球面,每个坐标服从固定的球面边际 $f_d(u)\approx\mathcal{N}(0,1/d)$(Eq. 3),与原始方向和掩码状态都无关。技术路线分四步:(1) K-RPBH 旋转:对线性层 $y=Wx$,离线把权重旋转为 $W'=W\Pi^\top$,在线把激活旋转为 $x'=\Pi x$,其中 $\Pi$ 是结构化的 K-RPBH 正交阵;(2) 免校准量化:在归一化后的旋转表示上,SOLOQ-C 用激活侧 Lloyd–Max 标量码本 + 权重侧 E8P 晶格码本,SOLOQ-N 直接用硬件原生 NVFP4(E2M1 + tensor/块缩放);(3) 只缩放偏置校正:用一个标量 $c_{bc}(z)$ 恢复被量化破坏的沿原向量方向的分量,零额外比特开销;(4) 块扩散扩展:KV-cache 只在块提交(commit)时量化,正在去噪的活跃块保持全精度,键用 KIVI 式逐通道非对称量化,值走 SOLOQ 激活路径。整套流程不需要任何校准样本或预统计激活数据。
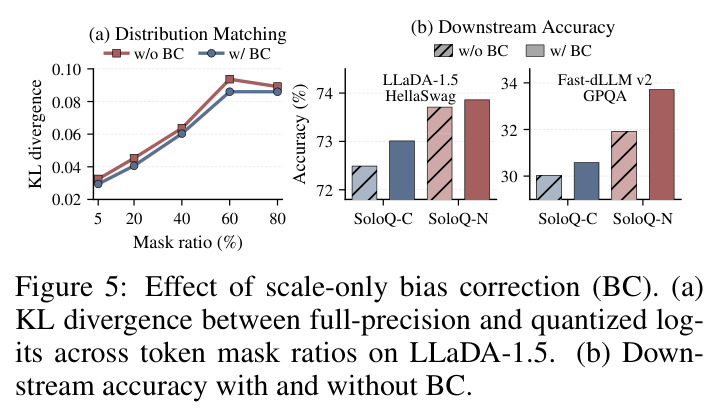
核心创新是「分布整形取代分布追踪」:把量化器建立在解析已知的事后分布上,而非数据统计上。两个关键设计区别于已有方法。其一是 K-RPBH 旋转:$\Pi=(Q_k\otimes I_h)\,\mathrm{blkdiag}(H_hD_1,\ldots,H_hD_k)\,P$,其中 $d=kh$($h$ 为 2 的幂),$P$ 是全局随机置换,$D_i$ 是 Rademacher 对角阵,新增的 $Q_k\otimes I_h$ 是 Haar 随机正交跨块混合级。相比 RPBH 只能靠初始置换平衡各块能量、块间无信息交流,K-RPBH 直接把对应坐标跨所有 $k$ 个块混合;命题 1 证明条件方差 $\mathrm{Var}_D[\hat{z}^{(r)}_\ell\mid P,Q_k]=\frac{1}{h}\sum_j Q_{rj}^2M_j$,在 $Q_k$ 取 Haar 期望时恰等于 $1/d$,块间能量不均被平均消除。其二是 scale-only 偏置校正:$c_{bc}(z)=\|z\|_2^2/\langle q(z),z\rangle$ 使 $\langle c_{bc}(z)q(z),z\rangle=\|z\|_2^2$,精确恢复被量化破坏的原方向分量,并被吸收进既有 per-token/per-row 缩放因子,零额外比特开销,区别于 TurboQuant 需要额外 QJL 残差 sketch 的校正路径。
方法步骤详情
流程如下(Algorithm 1)。离线阶段:对每个旋转维度 $d$ 采样生成 K-RPBH 矩阵 $\Pi_d$;对每个线性层计算 $W'=W\Pi_d^\top$ 后量化——SOLOQ-C 取行归一化因子 $s_{W,i}=\|w'_i\|_2$,用 E8P 晶格码本量化单位向量(离线可负担搜索);SOLOQ-N 计算全局幅值 $a_g$ 与 16 元素块幅值 $a_j$,缩放因子 $s_g=f_g(a_g)$、$s_j=f_{E4M3}(a_j)$ 后映射到 E2M1 集合;偏置校正标量 $c_{bc}$ 并入已有 per-row 缩放。在线激活阶段:输入 $X$ 先做 $X'=X\Pi_d^\top$,归一化 $s_x=\|x'\|_2$ 后用 Lloyd–Max(SOLOQ-C)或 NVFP4(SOLOQ-N)量化,再乘 $c_{bc}$ 校正。块扩散 KV 阶段:活跃块 $(K_B,V_B)$ 保持全精度去噪;块提交时,键用逐通道非对称 4bit 量化,值先做 $V_B\Pi_{d_v}^\top$ 再走 SOLOQ 激活路径,写入持久缓存。评测设置:全序列(LLaDA-8B-Base、LLaDA-1.5、Dream-7B)各 9 个基准,块扩散(Fast-dLLM v2、Nemotron-Labs-Diffusion)10 个基准;SOLOQ-C 在 H200 用 8bit Tensor Core kernel,SOLOQ-N 在 RTX Pro 6000 用原生 NVFP4 kernel。
技术新颖性
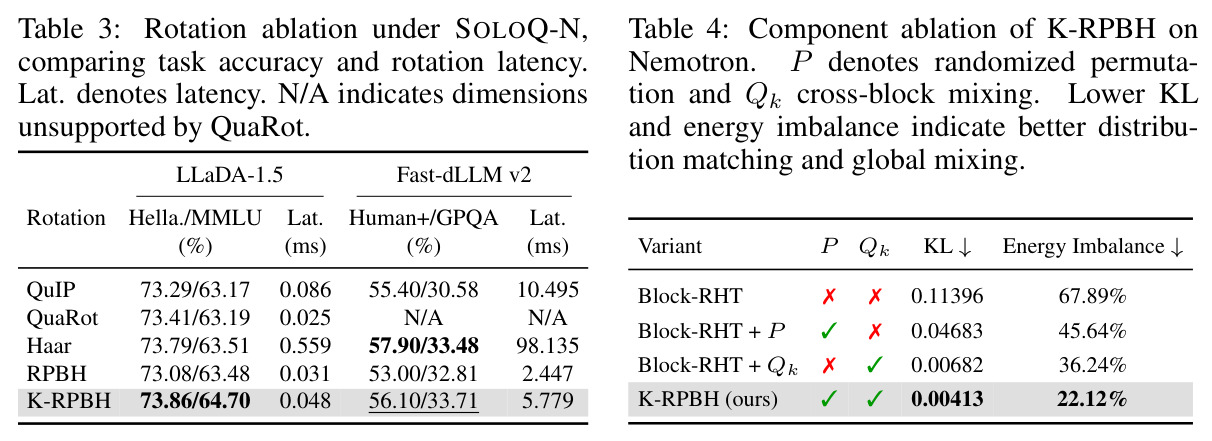
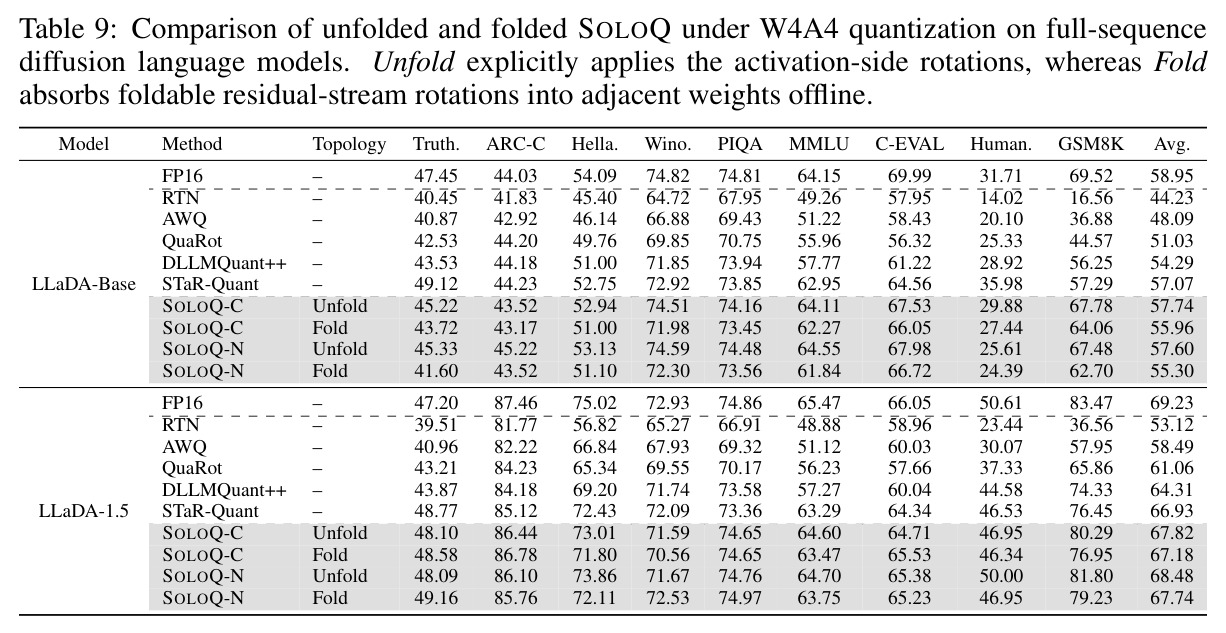
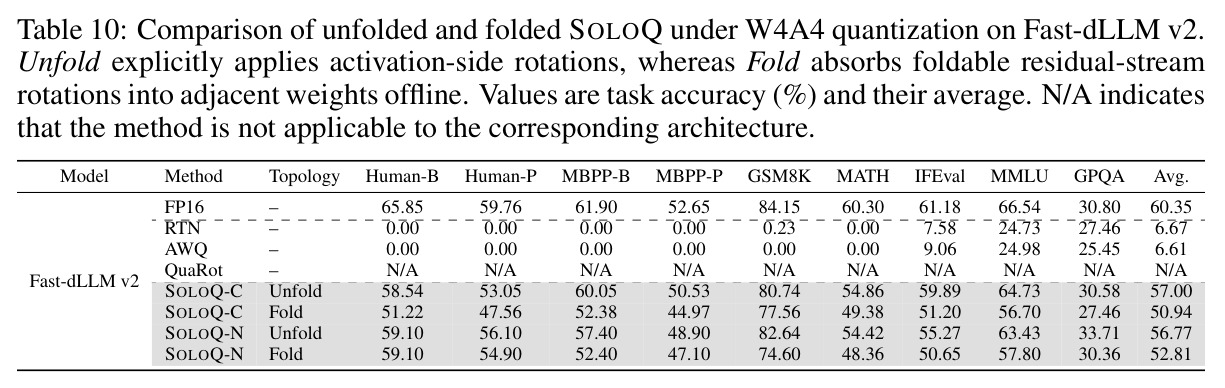
新颖性体现在四个层面。第一,问题层面:这是首个免校准的 dLLM PTQ 框架——此前所有 dLLM 量化方法(QuantDLLM、DLLMQuant、STaR-Quant、FAIR-Calib)都依赖校准数据,且首个支持块扩散模型 KV-cache 量化的免校准方案。第二,理论层面:K-RPBH 首次在 RPBH 家族中引入 Kronecker 跨块混合并给出命题 1 的方差平均化证明,把 RPBH 遗留的块能量不均衡从 $67.89\%$ 降到 $22.12\%$、KL 散度从 $0.114$ 降到 $0.0041$,同时保持 $O(d\log h)$ 的结构化代价——比 QuIP 的稠密 Kronecker 变换便宜得多,在支持的维度上比 QuaRot 需要更少变换操作(旋转延迟 $5.779$ms vs Haar 的 $98.135$ms,Fast-dLLM v2)。第三,工程层面:同一旋转表示同时兼容分布匹配码本(Lloyd–Max/E8P,存 INT8 的质心)与硬件原生 NVFP4(E2M1/E4M3),外加零开销的 scale-only 偏置校正(区别于 TurboQuant 的 QJL sketch)。第四,系统层面:用 dLLM 静态 RMSNorm 增益可折叠的性质分析了 QuaRot 式折叠拓扑(Eq. 22),并实证指出折叠在量化下不再保精度(Eq. 23),为部署提供了明确权衡依据。
实验结果
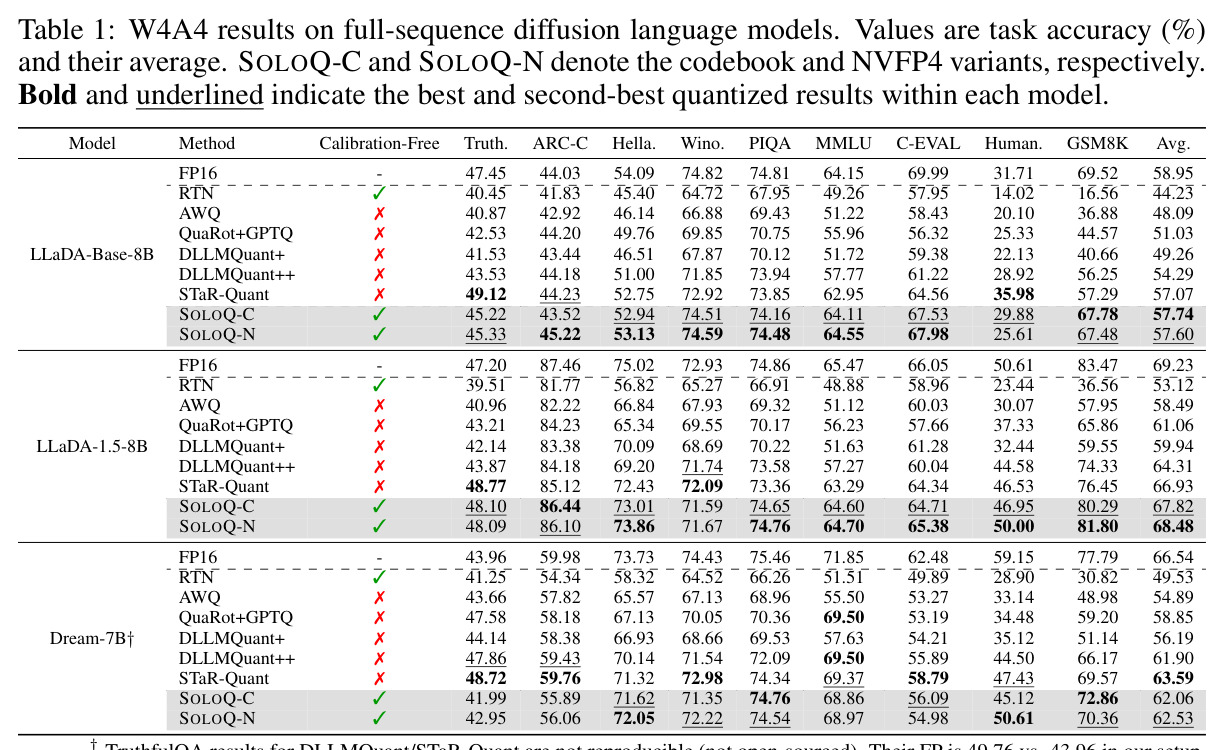
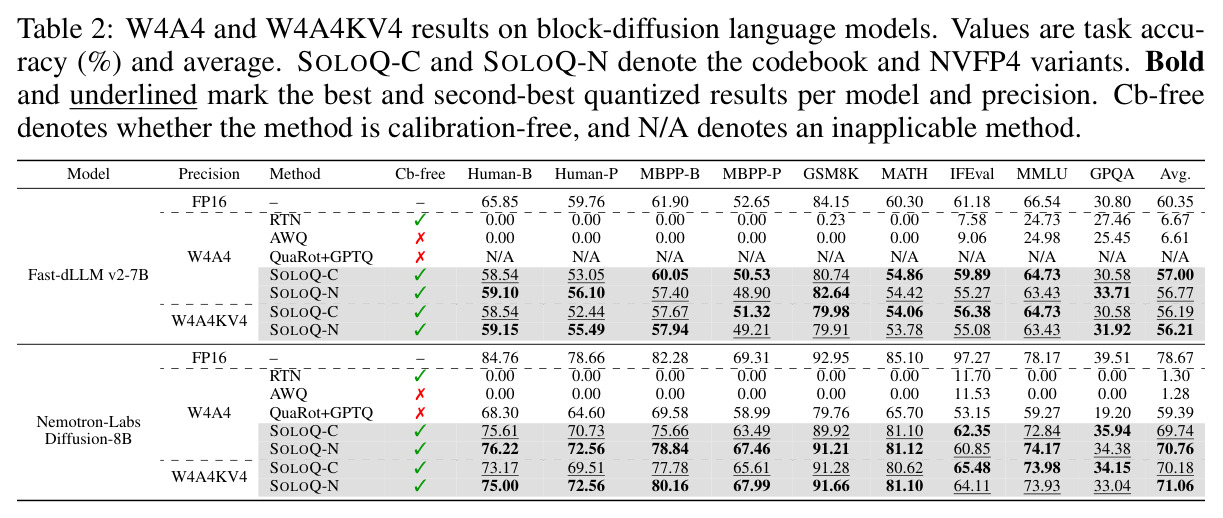
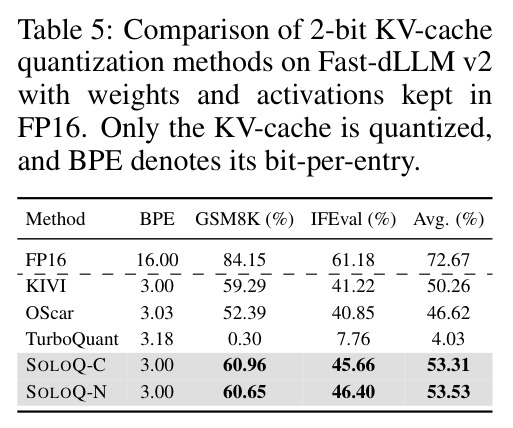
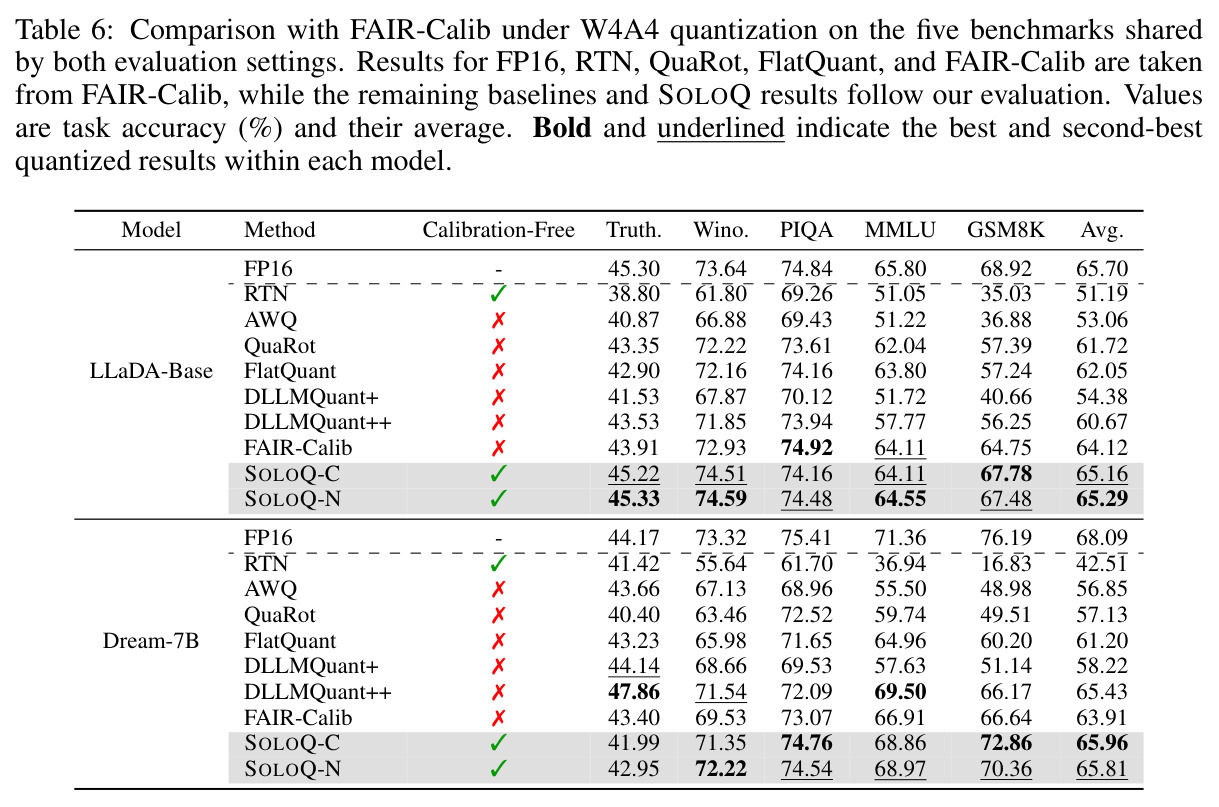
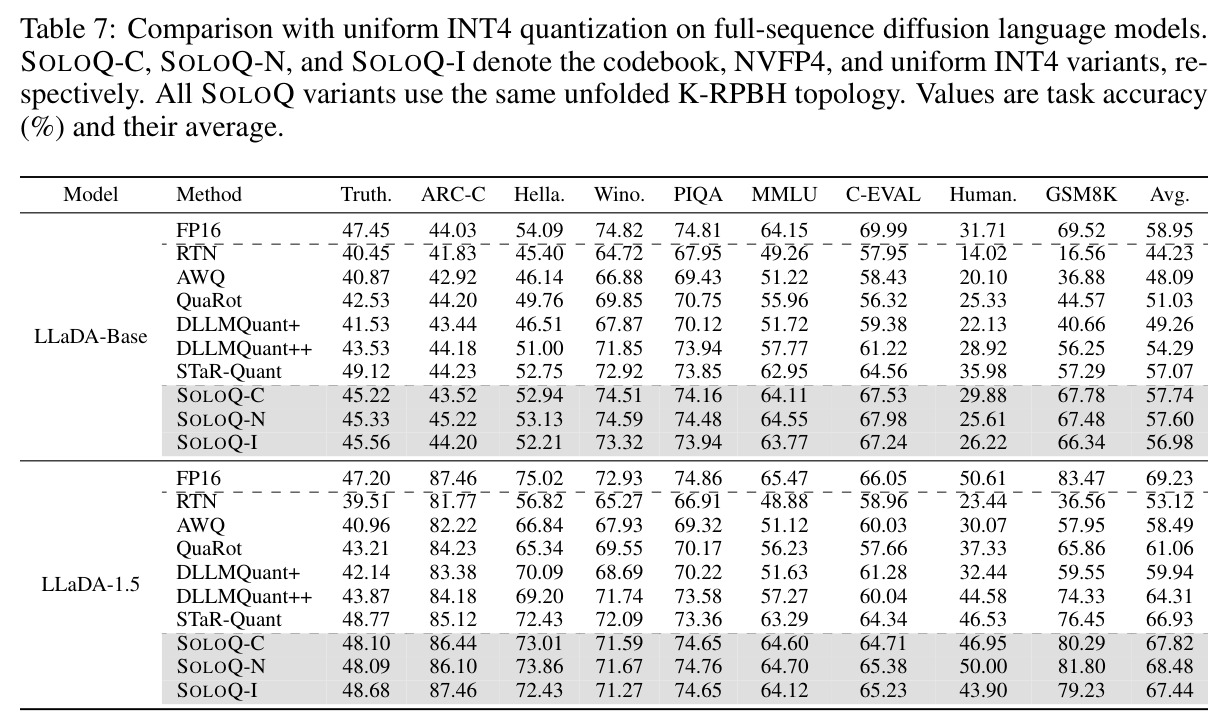
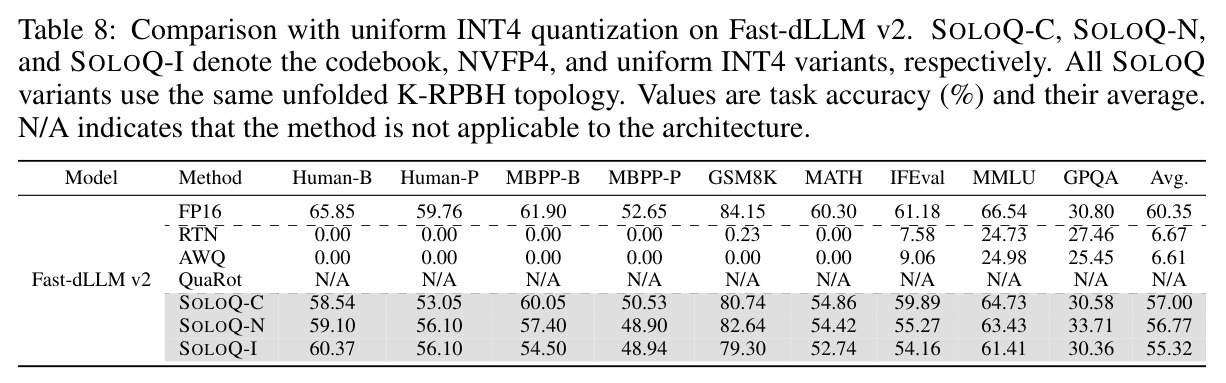
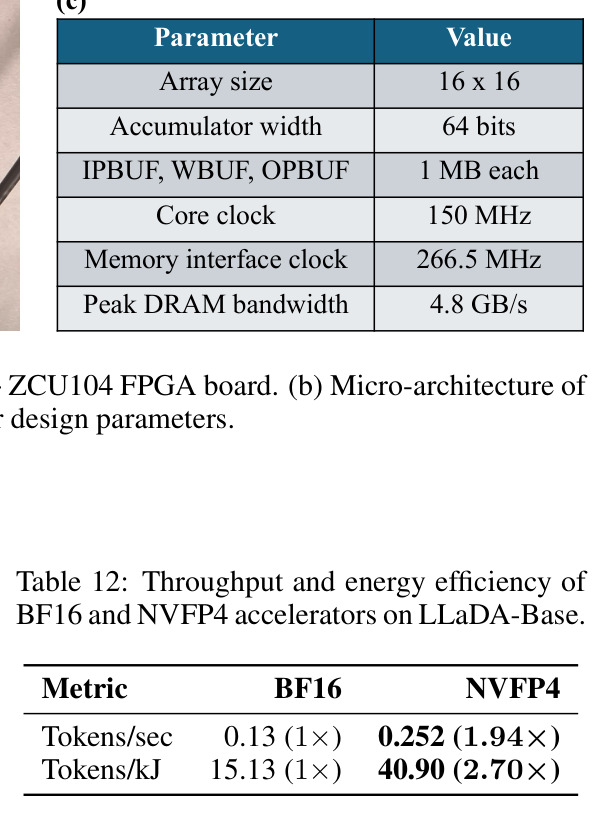
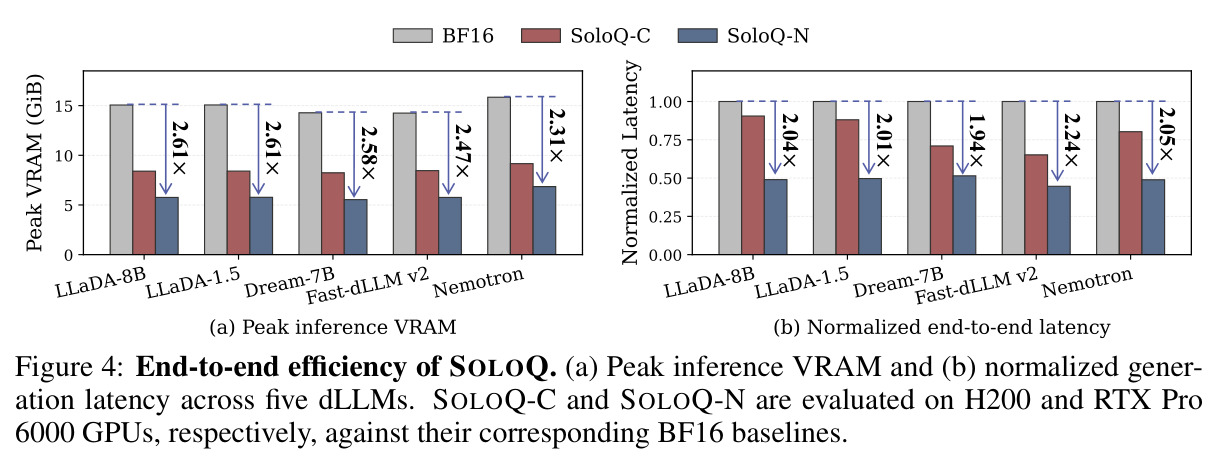
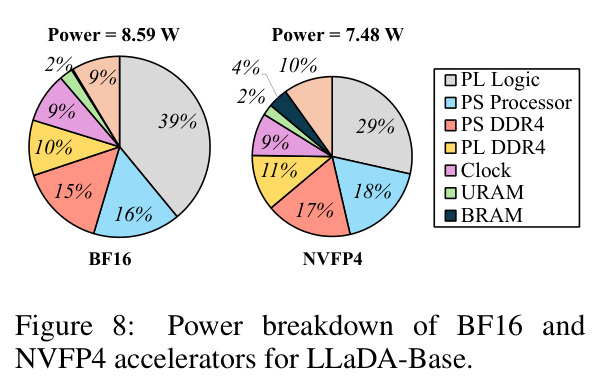
全序列 W4A4(Table 1):LLaDA-Base-8B 上 SOLOQ-C/N 平均 $57.74/57.60$,距 FP16($58.95$)仅约 $1.2$ 分,超最强校准基线 STaR-Quant($57.07$)与 DLLMQuant++($54.29$,领先 $3.45$ 分);LLaDA-1.5 上 SOLOQ-N 达 $68.48$(FP16 $69.23$),超 DLLMQuant++ $4.17$ 分、超 STaR $1.55$ 分;Dream-7B 上 SOLOQ-N $62.53$ 超 DLLMQuant++($61.90$)但低于 STaR($63.59$)。块扩散(Table 2):Fast-dLLM v2 上 RTN/AWQ 崩溃($6.67/6.61$)、QuaRot 维度不支持,SOLOQ-C 达 $57.00$(FP16 $60.35$),加 KV 4bit 后仍保 $56.19/56.21$;Nemotron 上 SOLOQ-C W4A4 达 $69.74$,超 QuaRot $10.35$ 分,W4A4KV4 下 SOLOQ-N 达 $71.06$(FP16 $78.67$)。系统效率(Figure 4):SOLOQ-N 峰值显存降 $2.31\times$–$2.61\times$,端到端加速 $1.94\times$–$2.24\times$。消融:Table 3 显示 K-RPBH 兼得 Haar 精度与 RPBH 速度(旋转延迟 $5.779$ms vs Haar $98.135$ms);Table 4 显示 P+Qk 把 KL 从 $0.114$ 降到 $0.0041$、能量不均衡从 $67.89\%$ 降到 $22.12\%$;Figure 5 显示偏置校正把 Fast-dLLM v2 GPQA 从 $31.92$ 提到 $33.71$。KV 对比(Table 5):2bit KV 下 SOLOQ-C/N 平均 $53.31/53.53$,超 KIVI($50.26$)、OScar($46.62$)、TurboQuant($4.03$)。附加:对 FAIR-Calib(Table 6)五个共享基准上 LLaDA-Base $65.29$ vs $64.12$、Dream $65.96$ vs $63.91$;纯 INT4 的 SOLOQ-I 仍达 $56.98/67.44/55.32$,说明收益主要来自旋转;FPGA 上 NVFP4 实现 $1.94\times$ 加速、$2.70\times$ 能效($15.13\to40.90$ tokens/kJ)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LLaDA-Base-8B 全序列 W4A4(9 基准平均) | 平均准确率 (%) | 57.74 (SOLOQ-C) | FP16 58.95;最强校准基线 STaR-Quant 57.07 | 免校准下距 FP16 仅 1.21 分,超最强校准基线 0.67 分、超 DLLMQuant++ 3.45 分 |
| LLaDA-1.5 全序列 W4A4(9 基准平均) | 平均准确率 (%) | 68.48 (SOLOQ-N) | FP16 69.23;STaR-Quant 66.93;DLLMQuant++ 64.31 | 较 STaR-Quant +1.55 分,较 DLLMQuant++ +4.17 分 |
| Dream-7B 全序列 W4A4(9 基准平均) | 平均准确率 (%) | 62.53 (SOLOQ-N) | FP16 66.54;DLLMQuant++ 61.90;STaR-Quant 63.59 | 超 DLLMQuant++ 0.63 分,但低于 STaR-Quant 1.06 分 |
| Fast-dLLM v2-7B 块扩散 W4A4(10 基准平均) | 平均准确率 (%) | 57.00 (SOLOQ-C) | FP16 60.35;RTN 6.67;AWQ 6.61;QuaRot 不适用 | 基线全部崩溃或不适用,SOLOQ 是唯一可用的 W4A4 方案,距 FP16 仅 3.35 分 |
| Nemotron-Labs-Diffusion-8B 块扩散 W4A4(10 基准平均) | 平均准确率 (%) | 69.74 (SOLOQ-C) | FP16 78.67;QuaRot 59.39;RTN 1.30 | 较 QuaRot +10.35 分 |
| 峰值推理显存(五个 dLLM,SOLOQ-N vs BF16) | 显存降低倍数 | 2.31×–2.61× | BF16 | 最高降低 2.61× |
| 端到端生成延迟(五个 dLLM,SOLOQ-N vs BF16) | 加速倍数 | 1.94×–2.24× | BF16 | 最高加速 2.24× |
| Fast-dLLM v2 2bit KV-cache 量化(权重激活保持 FP16) | GSM8K+IFEval 平均准确率 (%) | 53.53 (SOLOQ-N) / 53.31 (SOLOQ-C) | FP16 72.67;KIVI 50.26;OScar 46.62;TurboQuant 4.03 | 较 KIVI +3.27 分,约 3 bits-per-entry |
| 对 FAIR-Calib 五个共享基准 W4A4(Dream-7B) | 平均准确率 (%) | 65.96 (SOLOQ-C) | FAIR-Calib 63.91(FP16 68.09) | 免校准领先校准式 SOTA +2.05 分 |
| FPGA(ZCU104)边缘部署 LLaDA-Base-8B | 加速倍数 / 能效 (tokens/kJ) | 1.94× 加速;40.90 tokens/kJ | BF16 加速器:1×;15.13 tokens/kJ | 能效提升 2.70×,功耗降 15% |
局限与改进
作者在附录 G 承认三点:(1) K-RPBH 的激活侧旋转必须在线执行,带来额外开销;折叠进权重虽省时却掉精度,块扩散模型尤其严重(Fast-dLLM v2 SOLOQ-C 从 $57.00$ 跌到 $50.94$,Table 10);(2) SOLOQ-C 的码本质心需 INT8 无损存储,无法用原生 4bit Tensor Core,只能跑 8bit kernel,加速低于 SOLOQ-N;(3) SOLOQ-N 的延迟收益依赖原生 NVFP4 硬件,无此支持的设备加速会缩水。我的补充观察:其一,Dream-7B 上 STaR-Quant($63.59$)仍高于 SOLOQ-N($62.53$),免校准并非处处占优,TruthfulQA 也有 $1$–$2$ 分下滑($43.96\to42.95$);其二,代码生成掉点普遍偏大:LLaDA-Base HumanEval 从 $31.71$ 降到 $25.61$,Fast-dLLM v2 HumanEval 从 $65.85$ 降到 $58.54$,代码场景需谨慎;其三,K-RPBH 要求块尺寸 $h$ 为 2 的幂,极端维度仍可能需填充;其四,随机旋转的多种子稳定性未报告;其五,各模型沿用各自官方评测栈,跨模型绝对数值可比性有限;其六,正文只验证 4bit 权重激活,更激进的 W2/W3 场景未覆盖。
独立分析的弱点
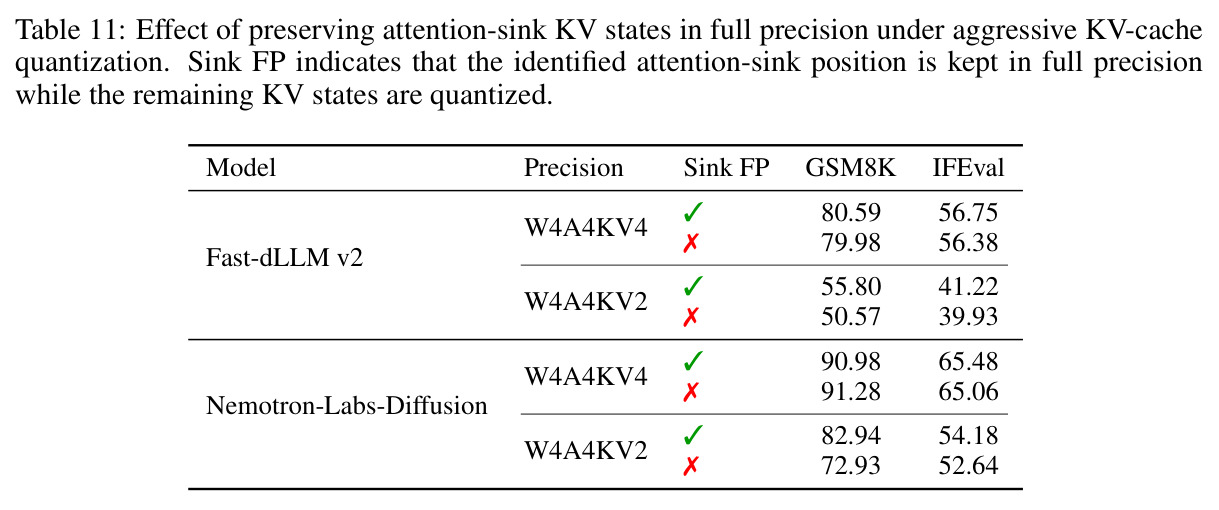
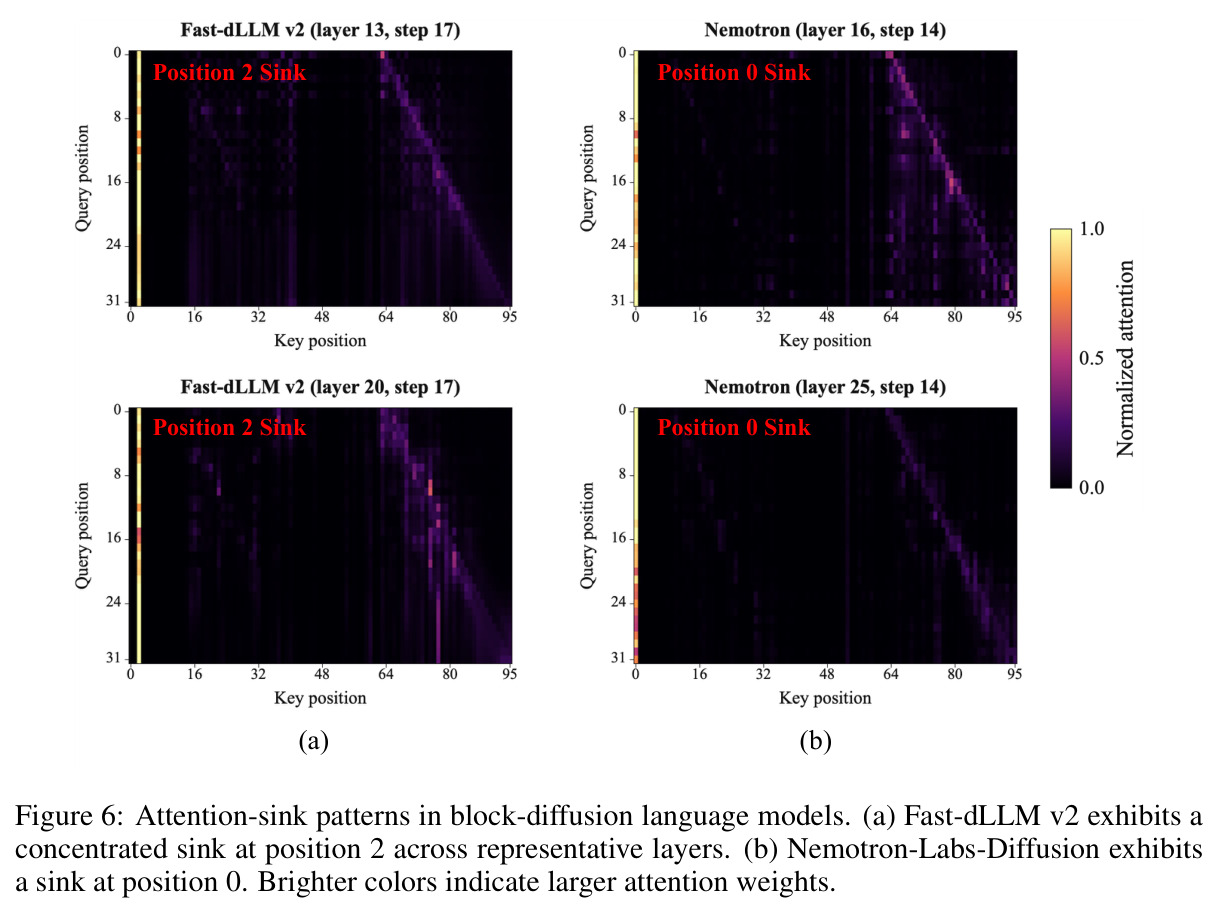
独立分析以下弱点。(1) 在线旋转开销与折叠掉点的两难:折叠使 Fast-dLLM v2 平均分跌 $6$ 分以上,不折叠则每层付旋转延迟;改进方向是部分折叠(只折静态 RMSNorm 增益)或量化感知的可折叠旋转。(2) SOLOQ-C 被钉在 8bit kernel:码本质心 INT8 存储使其无法用 4bit Tensor Core;可设计直接映射到 NVFP4/MXFP4 网格的分布匹配码本,或查表 + INT4 GEMM 混合执行。(3) 归一化对离群敏感:方差保证建立在 $\|x\|_2$ 归一化上,个别 token 范数异常会压缩其余通道分辨率;可引入 per-token 截断或双缩放稳健化。(4) 代码任务掉点偏大(HumanEval/MBPP 普遍掉 $5$–$7$ 分,对单 token 错误零容忍):可按层敏感度分配混合位宽,或对输出头附近层保更高精度。(5) 2bit KV 下注意力 sink 需保护(Table 11:W4A4KV2 保留 sink 使 Fast-dLLM GSM8K $50.57\to55.80$、Nemotron $72.93\to82.94$),目前靠离线识别,可做在线 sink 检测的混合精度 KV 管理。(6) 随机旋转的种子敏感性与 run-to-run 方差未报告,部署需固定最优种子或证明方差足够小。
未来方向
作者在结论中把「可预测表示整形」定位为低比特 dLLM 推理的通用基础,由此可延伸多个方向。(1) 更低位宽与混合精度:目前权重激活为 4bit,可把同一 K-RPBH 空间推广到 W2A4/W4A8,结合 Table 11 的 sink 保护和层敏感度分析做自动位宽搜索。(2) 与 dLLM 特有加速技术正交组合:如与并行去噪、缓存阈值跳步、自投机解码(Nemotron 的 tri-mode)叠加,研究量化噪声与跳步策略的交互。(3) 可学习的旋转参数:把 Haar 随机 $Q_k$ 换成轻量可学习正交阵但保持免校准(如以解析分布为目标的闭式更新),有望在 retain 免校准属性的同时进一步压 KL。(4) Kernel 与编译栈:把旋转、归一化、量化融合成单个 kernel,减少在线旋转的显存往返;把 NVFP4 路径扩展到更多硬件(Blackwell 之外的 MXFP4、INT4 tensor core)。(5) 边缘系统化:论文的 FPGA 原型($2.70\times$ 能效)只是开始,可扩展到完整 SoC 流水线、多块 KV 分页管理。(6) 模态与任务外推:把 commit-time KV 量化推广到 DNA/分子等其它离散扩散模型,以及多模态扩散 LLM;(7) 理论深化:目前命题 1 只平均了方差,可进一步推导旋转后量化误差的端到端界,把「免校准何时优于校准」形式化。
复现评估
复现条件总体友好。代码已开源(GitHub: Intelligent-Computing-Lab-Panda/SoloQ);五个模型全部公开可得:LLaDA-8B-Base、LLaDA-1.5、Dream-7B、Fast-dLLM v2-7B、Nemotron-Labs-Diffusion-8B;评测全部基于标准工具(LM Evaluation Harness、OpenCompass、EvalPlus、NeMo-Skills),附录 C 逐一给出每个模型的生成长度、去噪步数、块长、CFG、few-shot 设置与判分方式,这是复现精度表的关键信息且写得相当细。算力方面:精度评测在 NVIDIA H200 上进行,效率评测另用 RTX Pro 6000(原生 NVFP4);8B 模型 4bit 量化后权重约 4–5GB,单张 24GB 消费卡即可跑推理,但完整复现全部基准(含 128 次 Monte Carlo 采样似然任务、C-EVAL 等)需要可观的 GPU 时。难点提示:(1) 部分基线未开源——DLLMQuant 与 STaR-Quant 的 Dream TruthfulQA 数字被标注为不可复现,作者自己重跑的数字与原文有出入(FP 为 $49.76$ vs $43.96$),交叉验证这些基线需要自己实现;(2) 各模型官方评测栈不同,复现 Table 6 这类跨论文对比时要注意协议差异;(3) FPGA 部分(ZCU104 + 自研脉动阵列)需要硬件工程能力,普通软件团队难以复现,但结论可由 GPU 数据独立验证。总体评级:软件路径复现难度中等,社区积极性高的情况下数周内可验证主表。
论文图表
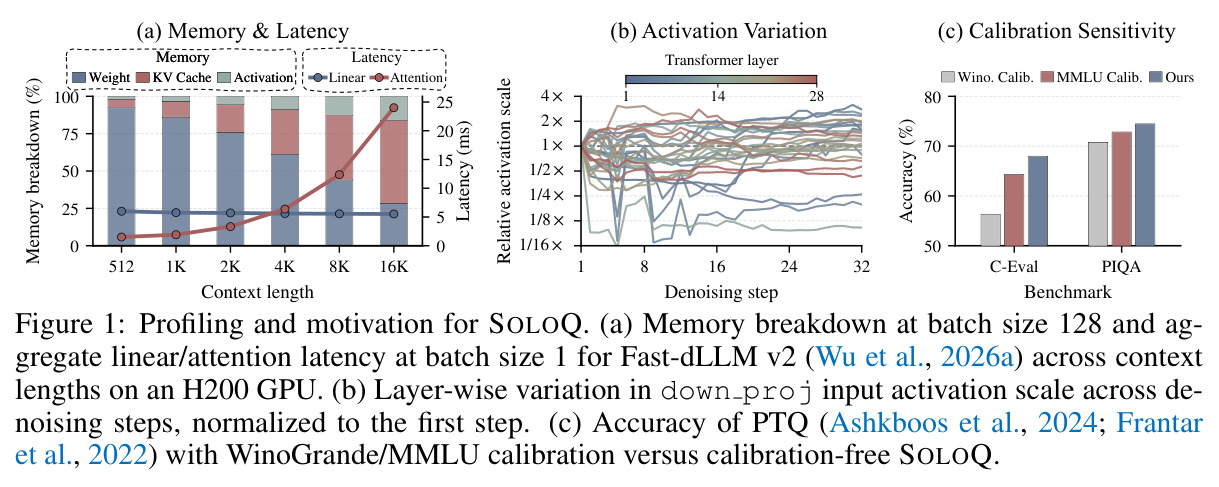
三联动机图:(a) Fast-dLLM v2 在 H200 上的显存构成(batch 128)与线性/注意力总延迟(batch 1)随上下文长度的变化,显示短上下文时权重主导显存、长上下文时激活和 KV-cache 占比上升且注意力延迟激增;(b) down-projection 输入激活尺度随去噪步逐层漂移(归一化到第一步),证明 dLLM 激活分布是时变的;(c) 校准式 PTQ 换校准集(WinoGrande↔MMLU)会改变各基准精度,而免校准的 SOLOQ 不受此影响。
这张图完整给出了论文的问题动机:dLLM 推理瓶颈在哪(a)、为什么传统 PTQ 在 dLLM 上失效(b)、校准依赖为什么不可靠而免校准是出路(c)。读懂它就理解了整篇文章的立意。
K-RPBH 组件消融(Nemotron):从 Block-RHT 出发,KL 0.11396、块能量不均衡 67.89%;加置换 P 降到 0.04683/45.64%;只加跨块混合 Qk 降到 0.00682/36.24%;两者都用(完整 K-RPBH)达到 0.00413/22.12%,证明 P 与 Qk 互补。
把 K-RPBH 的增益归因到具体组件,并用「块能量不均衡」这一可解释指标量化了 RPBH 的跨块缺陷与 Kronecker 混合的修复效果,是理解方法设计的必备证据。