Longtail-SWE:面向小众编程语言的高质量仓库级软件工程任务基准 Longtail-SWE: High-Quality SWE Tasks for Underrepresented Languages
用求解器-裁判-修复器流水线为13门小众语言抢救并打磨出202个可靠仓库级SWE任务
前置知识
仓库级问题解决(Repository-level Issue Resolution)
让编程智能体在一个真实代码库中读取 issue 描述、理解现有架构,最终产出能通过测试套件的代码补丁。与函数级代码生成不同,它要求跨文件导航、理解构建系统和依赖,任务由问题描述、基础提交(pre-fix 版本)、参考补丁和测试补丁四部分组成。
本文的整个基准构建与评测都围绕这一设定展开,不理解任务的四元组结构就无法理解 F2P/P2P 校验、修复循环和 Pass 指标的含义。
F2P 与 P2P 测试
FAIL_TO_PASS(F2P)测试指在基础提交上失败、打上参考补丁后通过的测试,用于验证功能确实被实现;PASS_TO_PASS(P2P)测试在两个状态下都通过,用于防止回归。智能体的解法必须同时通过全部 F2P 和 P2P 测试才算成功。
这是 Longtail-SWE 判定任务成败的唯一标准,也是环境构建中'严格执行验证'的校验对象,论文大量数据(如修复前后对比)都基于这套判定。
Pass@1 / Pass@k
Pass@1 是单次尝试的通过率;Pass@k 是每任务允许 $k$ 次尝试、至少成功一次的任务比例,衡量模型能力的上限;All-3 则是三次尝试全部成功的比例,衡量稳定性。论文还用无偏估计量从 10 次尝试估算 $ ext{pass@}k$ 曲线。
论文的核心结果表全部由这三个指标构成,理解它们的差异才能读懂'能力高但不稳定'这类结论。
求解器-裁判-修复器流水线
一种用智能体自身行为来审计任务的机制:求解器真实解题并留下轨迹,裁判对照轨迹、测试结果、任务描述与参考补丁,判断失败是智能体错误还是任务缺陷(描述欠规范、测试过严或过松),修复器据此修订测试并在描述后追加说明,循环直到多个裁判一致验收。
这是本文的中心贡献,方法、消融和人工审计章节全部围绕这条流水线的设计与效果展开。
测试过拟合与假阳性/假阴性
基准测试可能被'过拟合':PR 专属测试可能强制参考实现的具体写法(假阴性,拒绝正确解法),也可能覆盖不足让错误补丁通过(假阳性)。自动化程序修复和 EvalPlus、UTBoost、SWE-ABS 等工作都在研究如何增强测试以同时避免这两类错误。
论文把任务缺陷精确定义为这两类测试错误,修复器的工作目标、63 任务配对实验(Pass@1 从 29.1% 到 67.2%)都在量化这两类缺陷的影响。
研究动机
仓库级基准长期集中在 Python 与少数主流生态:SWE-bench 只覆盖 Python,Multi-SWE-bench、SWE-PolyBench、SWE-Bench Pro 虽扩展了语言,但 Clojure、Elixir、Haskell、OCaml 等大量生态几乎缺席,无从评估智能体在不同工具链下的能力。扩展到小众生态面临双重困难:其一候选稀缺——论文统计的候选池仅 3,261 个 PR,沿用 SWE-rebench V2 只保留 A 类(描述与测试对齐)任务就剩 1,096 个,且要求描述清晰、测试无歧义的过滤会系统性偏向小改动;其二历史 PR 的测试并不能保证评测可靠:参考补丁能通过测试不代表测试正确,PR 专属测试可能拒绝合理的替代实现,描述可能省略无法推断的隐含要求,测试不足又会放行错误解法。作者用单个 GPT 5.6 Luna 裁判审计 SWE-rebench V2 产出的 364 个任务,发现 328 个(90.1%)有质量问题:82.4% 的隐藏测试要求未写明的 API 或精确输出,88.7% 测试覆盖不足。直接丢弃这些可修复的任务,会让本就稀少的小众语言任务池雪上加霜。
本文的目标是论文的目标是为 13 门在现有仓库级基准中覆盖不足的语言(Clojure、Dart、Elixir、Erlang、F#、Haskell、Julia、Kotlin、Lua、OCaml、R、Scala、Swift)构建一个高质量、可可靠评测的 issue 解决基准 Longtail-SWE,最终包含来自 129 个仓库的 202 个任务。具体目标分三层:其一,任务恢复——与其过滤掉有缺陷的候选,不如设计一条求解器-裁判-修复器流水线,利用智能体的真实解题尝试来诊断并修复任务描述与测试中的缺陷,把'可修复'而非'完美'的任务保留下来;其二,质量保障——修复后的任务需通过 GPT 5.6 Luna、GPT 5.6 Terra、Kimi K3 三个不同配置裁判的依次验收,并用 65 个任务的人工审计校验裁判协议本身的可靠性;其三,实证分析——用九个模型配置(含 Opus 5.5、GPT 6.1 Sol、Kimi K3、Qwen 3.8 27B 等)评估解题性能、多次尝试的一致性与资源消耗,并额外发布一套更简单的伴随任务集以支持小模型评测。所有实例、可执行环境、构建与评测工具、智能体轨迹全部开源。
与已有工作不同的是,已有工作要么做'过滤',要么做'单向增强':SWE-bench Verified 靠人类专家剔除问题任务,SWE-Bench ProMax 由专家修订描述并删除强制实现细节的测试,UTBoost 和 SWE-ABS 分别通过追加测试和变异分析强化测试,SWE-Marathon 用先导轨迹区分智能体失败与任务缺陷。但把'求解器轨迹'作为缺陷诊断信号、对描述与测试进行协同修复、并在迭代闭环中用多裁判依次验收的完整方案此前并不存在,尤其没有人在小众语言这种候选稀缺、每丢弃一个任务都代价高昂的场景下系统验证过这条路线。本文的独特切入是:参考补丁全程不变、描述只允许追加说明(addendum)、环境在循环内固定,从而在修测试缺陷、补描述要求的同时锁定任务意图不漂移;并用 65 个任务的双人标注金标定量检验了裁判协议(96.1% 召回、87.5% 精确率),使'修复是否忠实于原意'第一次有了可度量的答案。
核心方法
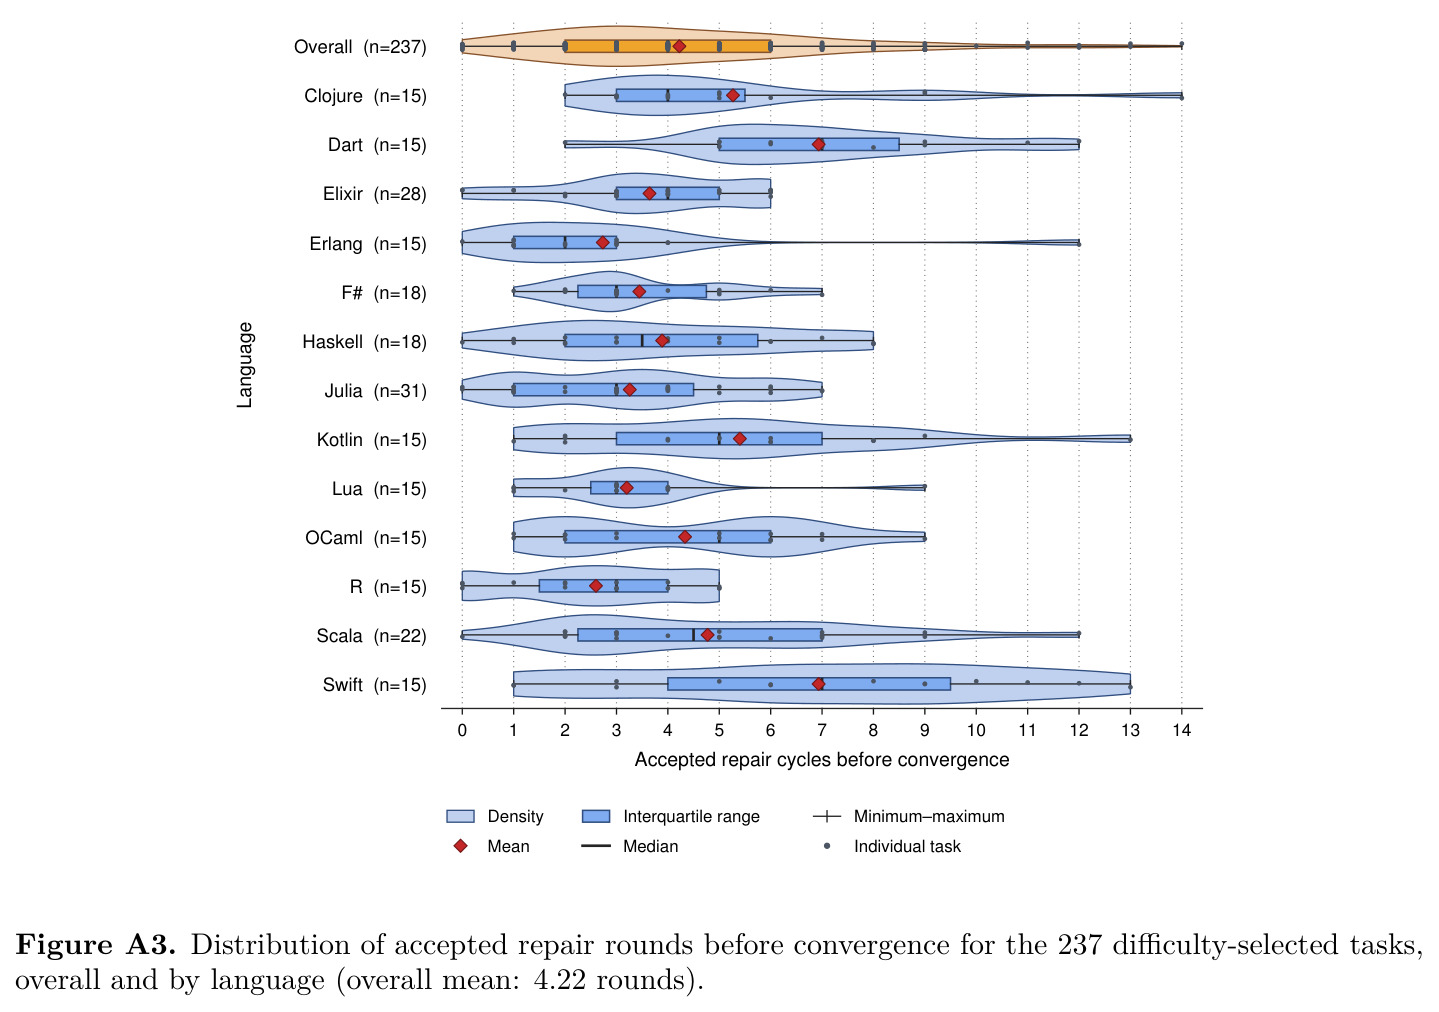
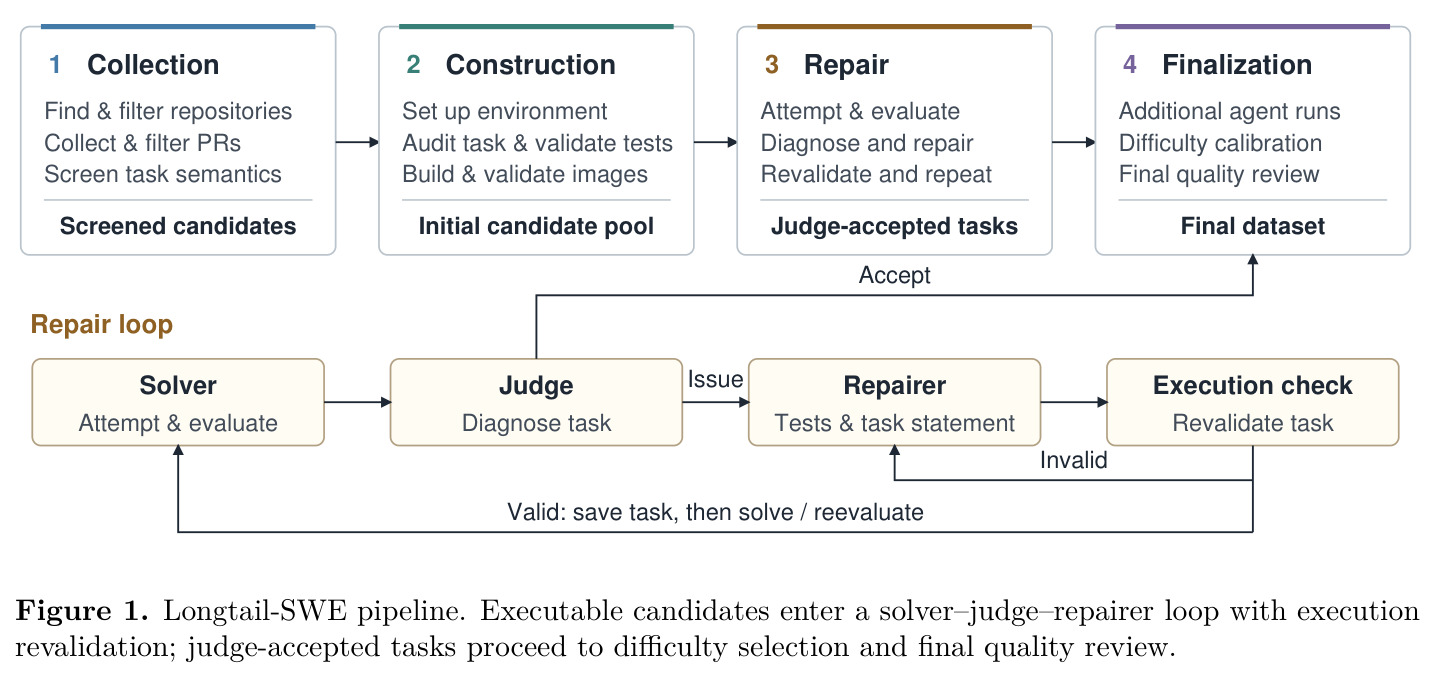
直觉上,判断一个任务是否可靠,最好的探针就是让智能体真的去做一遍:如果合理思路的解法被测试拒绝,说明测试过严;如果错误解法通过了测试,说明覆盖不足。论文在 SWE-rebench V2 之上构建四阶段流水线:收集(GitHub API 抓取合并 PR 并语义筛选)、构建(搭 Docker 环境并识别 F2P/P2P 测试)、修复(求解器-裁判-修复器迭代循环)、定稿(难度校准与终审)。从 3,261 个候选出发,语义筛选保留 A、B2、B5 三类共 2,640 个,严格执行验证通过 1,247 个,镜像重建验证后剩 1,201 个进入修复循环;循环中每个任务按最多 5 轮一组迭代,直到 GPT 5.6 Luna (xhigh)、GPT 5.6 Terra (high)、Kimi K3 (high) 三个裁判依次全部接受,平均修复 4.2 轮(中位数 4,范围 0-14),共验收 533 个任务;随后用 Qwen 3.8 27B 三次尝试做难度筛选得到 237 个,再基于 5,688 条存储的解题尝试做终审,剔除 35 个后得到最终的 202 个任务。
核心创新是'以求解器在环的诊断驱动协同修复'。裁判同时审视求解器的轨迹、补丁、测试结果,以及任务描述、参考补丁与测试,据此区分三类问题:智能体自身实现错误(任务无辜)、描述欠规范(要求无法从上下文推断)、测试缺陷(过严拒绝合理实现,或过松放行错误解法)。与既有工作的本质区别有三点:第一,修复是协同的——测试修改与描述追加在同一个闭环中协调进行,而 UTBoost/SWE-ABS 只改测试、SWE-bench Verified 只做人工过滤;第二,修复是受限的——初始审计后的描述文本(含 [HIDDEN] 替换)保持不可变,只能通过附录式 addendum 追加对可观察行为的约定,参考补丁全程不动,修复器不得借测试补丁夹带产品代码修改,从机制上防止任务意图漂移;第三,验收是串行多裁判制——只有三个不同配置的裁判全部接受才放行,且描述修改触发新的求解器尝试、仅测试修改则复用旧补丁重新评测,使修复效果可以被低成本验证。
方法步骤详情
第一步收集:对每门语言用 GitHub API 找 stars≥10、活跃、许可宽松仓库中'合并且只关联一个 issue'的 PR,要求参考与测试补丁非空可分离、生产补丁至少 5 行新增;Kimi K3 做语义筛选,保留 A(现状可用)、B2(测试依赖描述未给出的名称或签名)、B5(测试可能依赖参考实现的偶然细节)三类,共 2,640 个候选。第二步构建:每语言准备版本化基础镜像,审计智能体检查文档与 CI 确定安装/构建/测试命令、装依赖并验证,可把描述中的实现提示替换为 [HIDDEN] 并修订测试;随后在干净容器中从零复装复测,要求至少一个 F2P 测试在基础提交失败、打上参考补丁后全部指定测试通过,再构建任务镜像二次复核。第三步修复循环:求解器尝试任务,裁判对照轨迹与测试结果验收或给出修复意见,修复器据此修改测试补丁或追加 addendum;修订后的测试须重新满足执行标准,失败则回滚;每组最多 5 轮,直到三个裁判依次全部接受或发现参考补丁有错而丢弃。第四步定稿:Qwen 3.8 27B 三次尝试做难度筛选(三次全解则剔除,除非某语言不足 15 个),再结合 5,688 条历史尝试做终审,得到最终 202 个任务。
技术新颖性
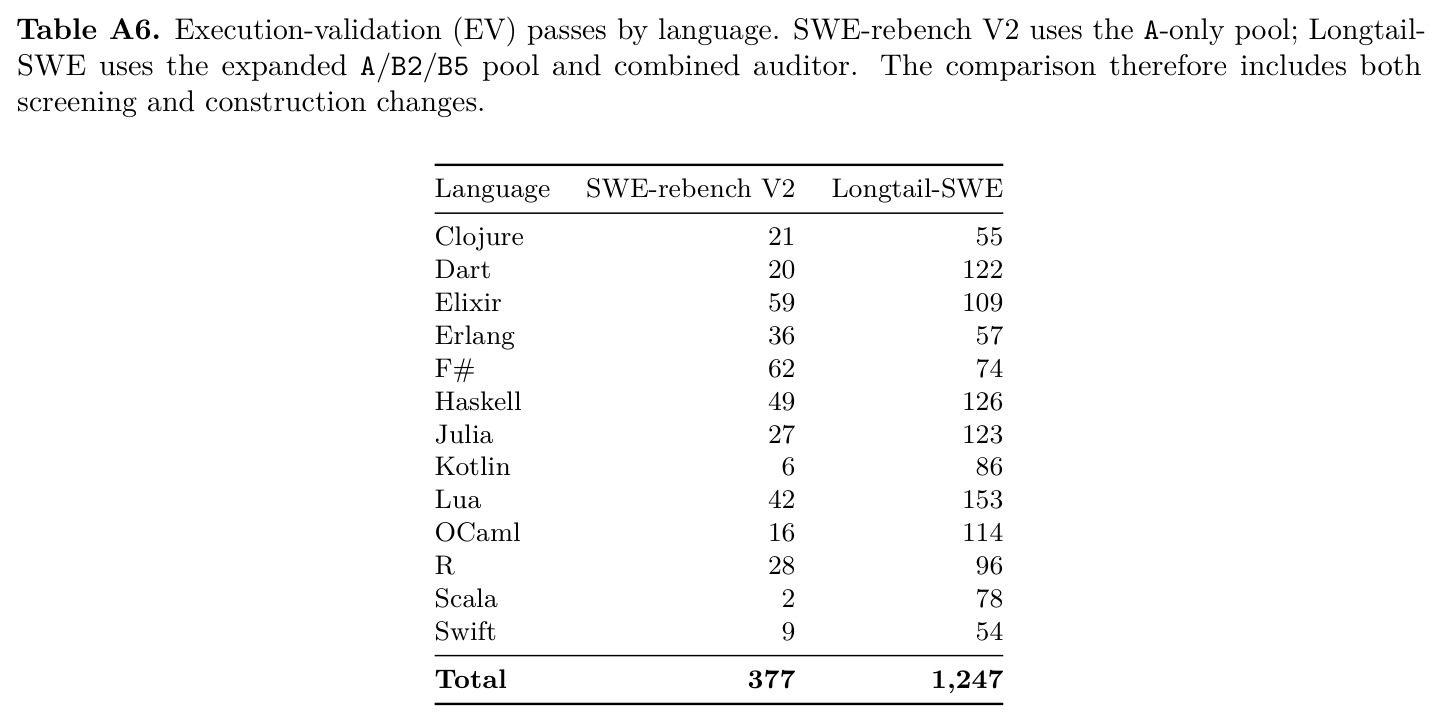
技术新颖性体现在四点。第一,候选保留策略:不把语义筛选中的 B2/B5 类任务当作废料,而是视为可修复资源,使候选池从 1,096 扩到 2,640(+140.9%),严格执行验证通过数从 377 提到 1,247,Kotlin、Scala、Swift 分别从 6、2、9 个涨到 86、78、54 个——对小众语言这是能否成库的生死线。第二,求解器轨迹作为缺陷证据源:相比依赖人工审阅或静态规则,轨迹能同时暴露假阴性(正确实现被拒)与假阳性(错误实现通过)两类测试缺陷,论文用配对实验证明仅修测试就把 Opus 5.5 在 63 个描述未变任务上的 Pass@1 从 29.1% 提到 67.2%。第三,串行三裁判验收协议并用人工金标校准:65 个任务的双人标注(初始一致性 Cohen's $\kappa = 0.15$,共识金标 14 接受/51 拒绝)显示该协议召回 96.1%(49/51)、精确率 87.5%。第四,全程可审计:所有中间修订、轨迹、裁判结论均保留并随基准发布,使基准构建本身成为可复现的研究对象。
实验结果
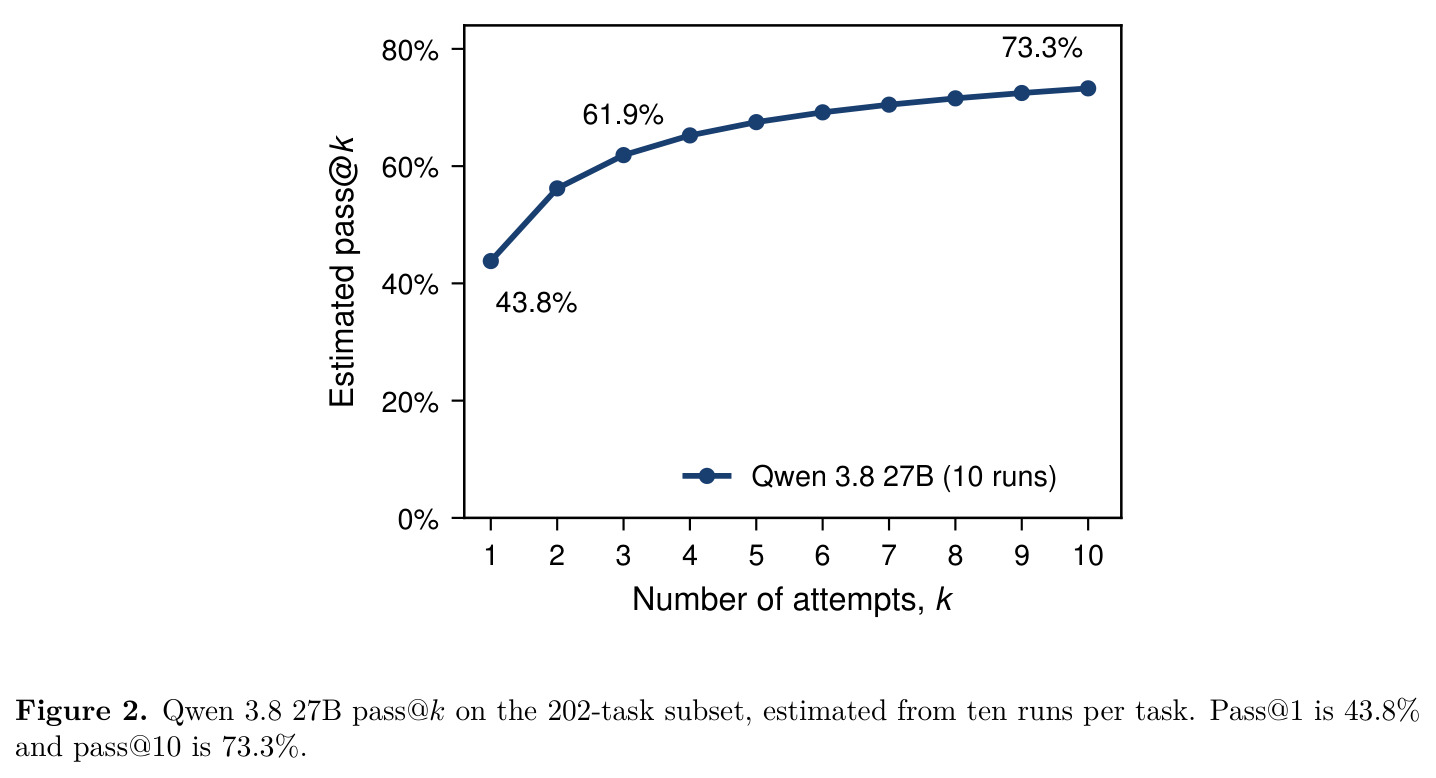
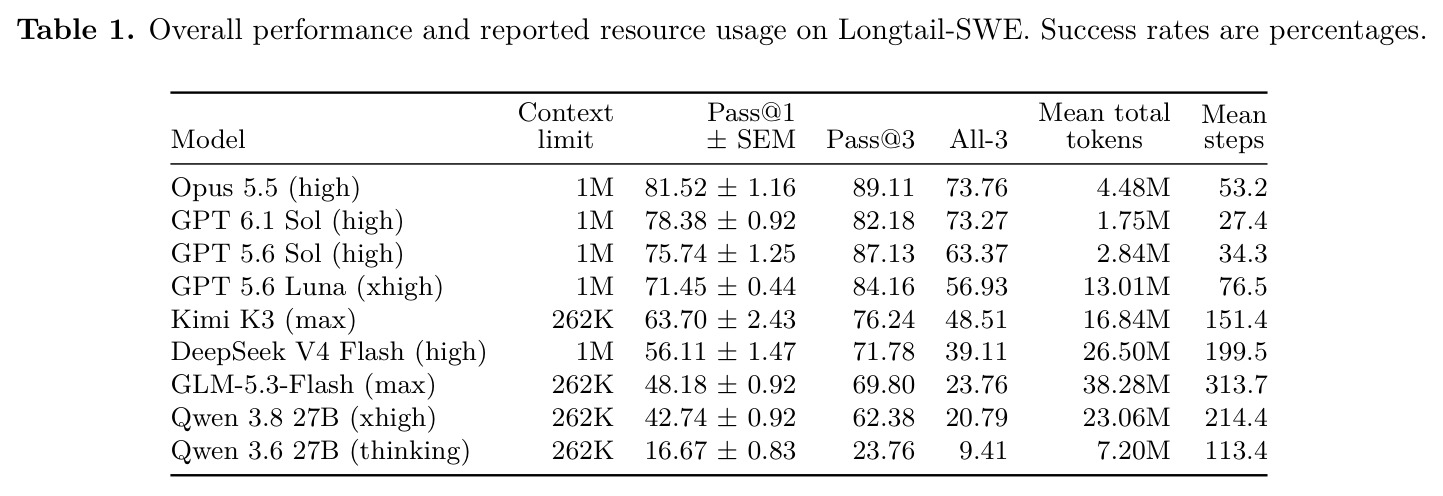
评估涵盖九个模型配置(每任务三次尝试,SWE-agent 风格脚手架)。Opus 5.5 (high) 全面领先:Pass@1 81.52%±1.16、Pass@3 89.11%、All-3 73.76%(平均 4.48M token),仍有 10.89% 任务三次全败;GPT 6.1 Sol 78.38% 且最省资源(1.75M token);GPT 5.6 Sol 75.74%;Luna 71.45% 却耗 13.01M token;GLM-5.3-Flash 48.18% 资源最高(38.28M token);Qwen 3.6 27B 仅 16.67%。分语言看,Erlang 平均最高(73.5%)、Haskell 72.8%、R 69.0%,Clojure(48.1%)、F#(50.2%)、Elixir(50.4%)最低。一致性上,Qwen 3.8 27B 每任务 10 次尝试的 $\text{pass@}k$ 从 43.8% 升到 73.3%,仍有 26.7% 未解。消融:组合审计员使 A 类严格 EV 通过率从 34.4% 升到 49.2%(377→539,61.4% 改过测试补丁);保留 B2/B5 后通过数达 1,247;最终漏斗保留 202 个(6.2%),而 SWE-rebench V2 路径只剩 68 个(2.1%)。63 个描述未变任务的配对实验中,同一批 Opus 轨迹修复后 Pass@1 从 29.1% 涨到 67.2%(+38.1 点)。裁判人工审计(65 任务金标:14 接受/51 拒绝):协议召回 96.1%(49/51)、精确率 87.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 202 任务仓库级 issue 解决 | Pass@1 | 基准评测:最佳配置 Opus 5.5 (high) 81.52% | 次优 GPT 6.1 Sol (high) 78.38% | +3.14 个百分点 |
| 任务构建漏斗(3,261 候选) | 最终任务保留数 | 202(6.2%) | SWE-rebench V2 路径 68(2.1%) | 约 2.97 倍 |
| 63 个描述未变任务的配对评测 | Pass@1(Opus 5.5 同一批轨迹) | 修复后 67.2% | 修复前 29.1% | +38.1 个百分点 |
| 构建阶段严格执行验证(A 类候选) | EV 通过数/通过率 | 组合审计员 539(49.2%);扩展到 A/B2/B5 后 1,247 | SWE-rebench V2 安装智能体 377(34.4%) | 通过率 +14.8 个百分点,通过数 3.3 倍 |
| 裁判协议人工审计(65 任务金标) | 问题任务召回率(拒判为正类) | 96.1%(49/51) | 无对比方法(作者也报告精确率 87.5%) | 漏检仅 3.9% |
| Qwen 3.8 27B 多次尝试一致性 | Pass@10(每任务 10 次) | 73.3% | Pass@1 43.8% | +29.5 个百分点 |
局限与改进
作者自己承认的局限:其一,构造效度——追加式描述修复仍可能改变任务契约,且 63 任务配对实验只隔离了测试修改的贡献,描述修改的效果未被单独评估;其二,裁判协议特异性低——人工金标上只正确接受 7/14(50.0%),会把不少合格任务送进不必要的修复循环,推高构建成本,且两位标注者初始一致性很低($\kappa=0.15$);其三,Qwen 3.8 27B 既做难度校准又作为被评模型,其报告分数可能被模型依赖的选择偏差污染,部分被评模型(GPT、Kimi)也参与了构建,可能从任务解读中获益;其四,污染风险——任务来自公开 issue/PR,无法排除已进入训练数据;其五,外部效度——每语言仅 12-27 个任务,语言间差异反映的是这批任务与被评配置,而非语言固有难度。我补充几点:202 个任务总量偏小,Pass@1 约 $\pm 1$ 个百分点的 SEM 在语言子集上会放大到不可忽略的水平;所有评估只用一种 SWE-agent 风格脚手架,结论对脚手架的敏感性未知;修复循环平均 4.2 轮、多配置裁判与求解器的构建成本相当可观,论文未给出总开销估算。
独立分析的弱点
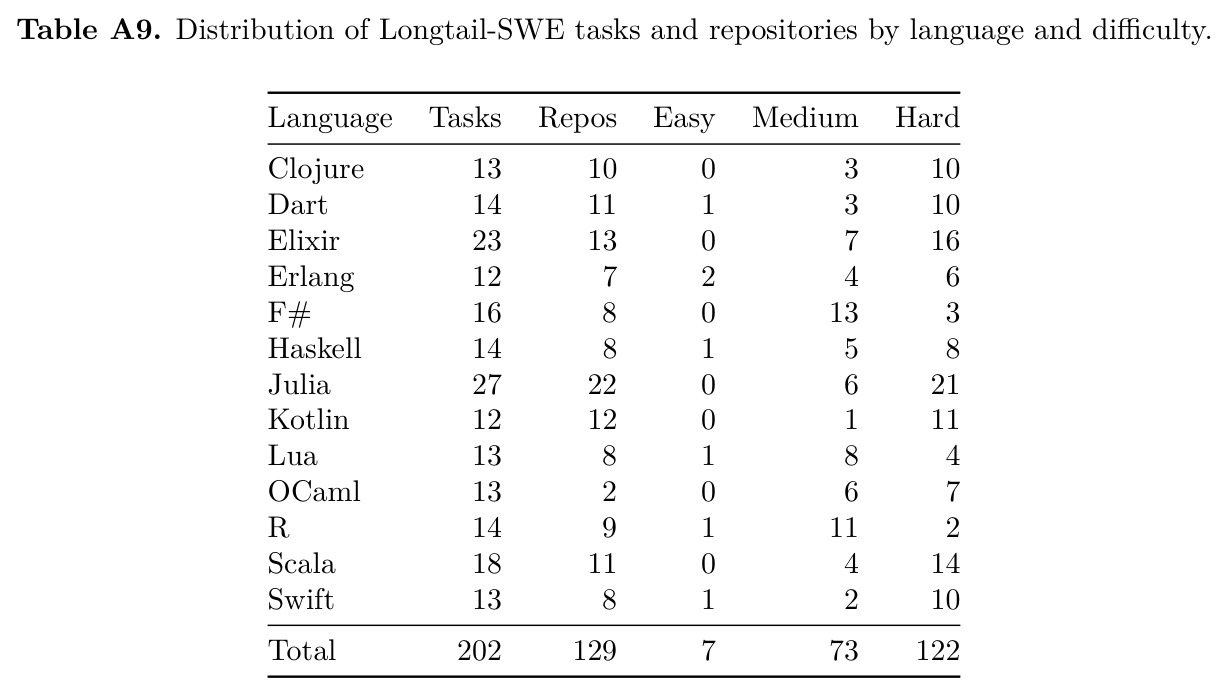
独立来看,本文有几个值得警惕的弱点。第一,模型自涉:GPT 5.6 系列与 Kimi K3 既是构建者(求解器、裁判、修复器)又是被评对象,尽管构建期使用的任务解读不直接进入最终题面,但修复后测试的断言风格、addendum 的措辞习惯仍可能系统性偏向参与构建的模型家族,改进方向是用与构建完全无关的模型做留存测试,或在发布时按'构建参与度'分层报告分数。第二,每语言样本太小:12-27 个任务难以支撑语言级结论(论文也承认),但 Table 2 仍诱导读者做跨语言比较,改进方向是扩大每语言规模或改用层次化置信区间。第三,裁判特异性的经济代价:50.0% 的特异性意味着近半合格任务被反复送修(平均 4.2 轮),可引入轻量级预筛或让裁判输出置信度以分层处理。第四,评测协议单一:仅一种智能体脚手架、三次尝试,无法回答'换脚手架结论是否成立',可补不同脚手架的交叉实验。第五,难度标签由 LLM 标注而非实测,Table A9 中 Hard 占 122/202,但其与实际通过率的关系未被验证,可用人工解题时间抽样校准。
未来方向
作者明确提出的研究方向是:考察模型参与基准构建对其分数的影响,即量化'自涉偏差'。基于本文成果还可延伸:其一,把修复后的高质量任务用作 RL 训练环境——论文在相关工作中已指出指令与测试对齐是忠实 RL 奖励的前提,Longtail-SWE 的三裁判验收恰好提供了这种对齐保障,13 门语言为多语言策略训练提供了新鲜生态;其二,利用管线'只收集指定日期之后创建的任务'的能力,与各模型训练截止日期联动构建抗污染的动态基准;其三,把人工审计升级为滚动扩充的金标集,持续改进裁判协议的特异性并降低修复成本;其四,扩展到更多长尾生态(如 Zig、Solidity、Verilog)及非 issue 型任务(重构、栈迁移);其五,利用随附的更简单伴随任务集研究小模型的能力边界与蒸馏效果,以及 pass@k 曲线(Qwen 3.8 从 43.8% 到 73.3%)背后的'不可靠但可解'现象对测试时采样策略的启示。
复现评估
复现条件非常好。基准全套开源在 GitHub(SWE-rebench/Longtail-SWE):202 个任务实例、可执行 Docker 环境、更简单的伴随任务集、全部构建/审计/修复/评测工具、完整智能体轨迹、原始与修订后的描述和测试、容器镜像;代码 MIT、数据 CC BY 4.0。想'使用'这个基准做模型评测,难度低:按仓库脚本启动任务镜像、套用 SWE-agent 风格脚手架每任务跑三次即可对齐论文协议;主要成本是推理费用——评估一个配置约需 202×3=606 次尝试,前沿配置单轨迹 1.75M-4.48M token,小模型可达 38.28M token,单配置总消耗约 27 亿到 230 亿 token。想'重建'整条流水线则很贵:需要多语言 CI 级别的 Docker 构建能力、Kimi K3 与 GPT 5.6 多个配置的裁判/修复器 API、平均每任务 4.2 轮的迭代预算,以及审计员约 2.8M、裁判约 0.7M、修复器约 3.3M token 的单轨迹开销;不过作者保留了全部中间产物与轨迹,复刻者可基于现成轨迹做离线分析而无需重跑。
论文图表
分语言的严格 EV 通过数对比:SWE-rebench V2 路径合计 377,本文路径合计 1,247。提升最悬殊的是 Kotlin(6→86)、Scala(2→78)、Swift(9→54);Lua(42→153)、Dart(20→122)、Haskell(49→126)、Julia(27→123)提升也很大。
它直观展示'任务恢复'对小众语言意味着什么:若干语言若走旧管线几乎无任务可用(如 Scala 只有 2 个),根本无法支撑有统计意义的评测。
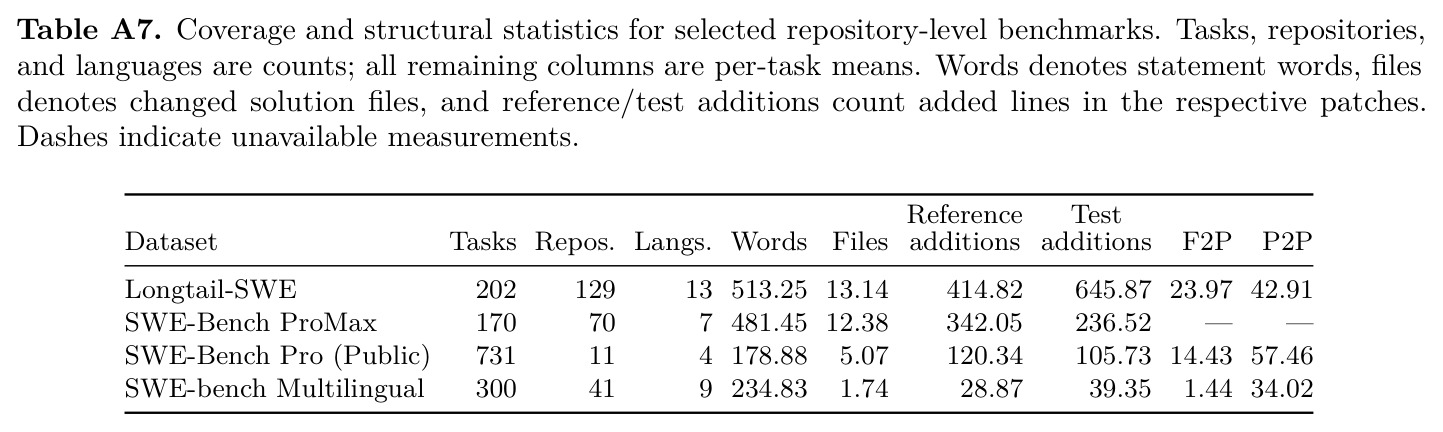
与 SWE-Bench ProMax、SWE-Bench Pro (Public)、SWE-bench Multilingual 的结构对比:Longtail-SWE 在任务数(202)、仓库数(129)、语言数(13)上仓库与语言覆盖最广,每任务平均描述词数 513.25、修改文件 13.14、参考补丁新增 414.82 行、测试新增 645.87 行、F2P 测试 23.97 个,均显著大于对比基准(如 Multilingual 平均仅改 1.74 个文件、参考补丁 28.87 行)。
它证明 Longtail-SWE 不只是'语言更多',任务本身也更重、更接近真实工程(改动更大、测试更多),回应了'过滤偏向小改动'的行业痛点。
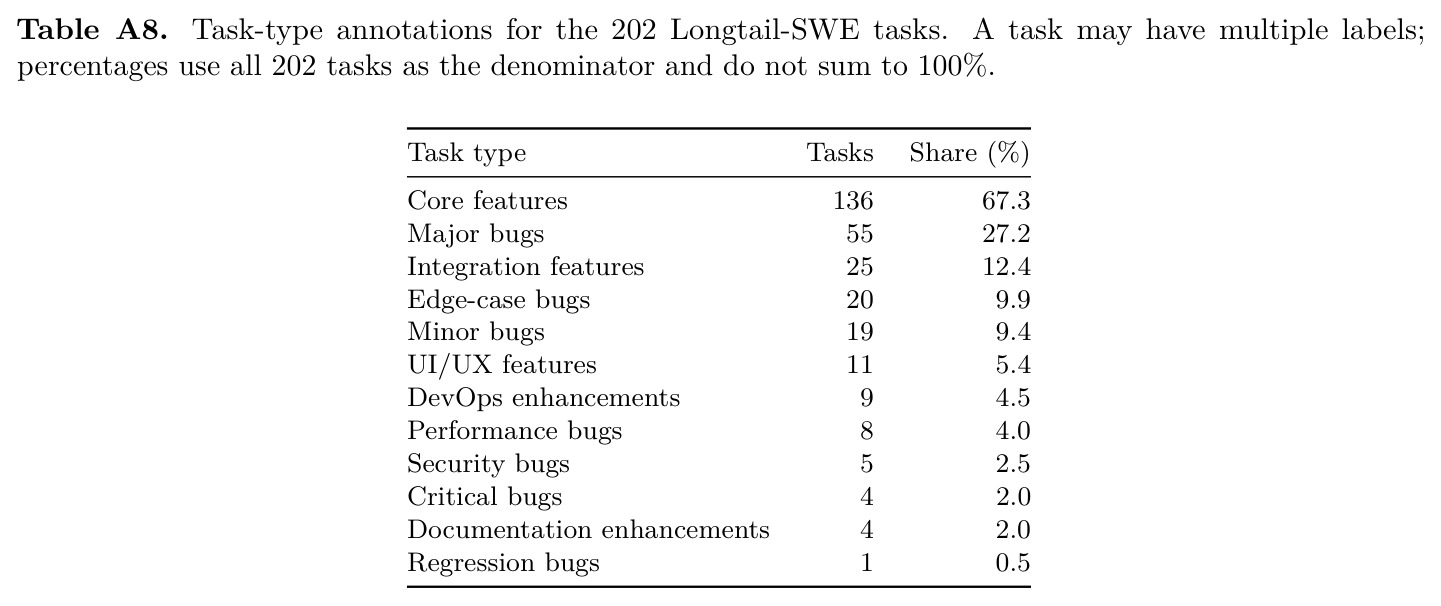
任务类型标注分布(标签不互斥):核心功能开发 136 个(67.3%)、重大 bug 修复 55 个(27.2%)、集成功能 25 个(12.4%)、边界 bug 20 个(9.9%),另有 UI/UX、DevOps、性能、安全、关键 bug 等小类。
说明基准的构成以真实的功能开发为主而非琐碎小修,配合 Table A7 的大补丁统计,共同刻画了任务的工程复杂度画像。
按语言统计任务数、仓库数与难度分布:总计 202 个任务、129 个仓库,难度标注为 Easy 7、Medium 73、Hard 122;Julia 任务最多(27 个、22 个仓库),OCaml 仅用 2 个仓库就贡献了 13 个任务,Elixir 23 个任务中 16 个为 Hard。
提供数据集构成的完整明细,既显示语言间规模与难度的差异,也提示难度标签来自 LLM 标注(7 个 Easy 任务的存在与'三次全解才剔除'的筛选规则相呼应)。