RealSWE:真实用户请求下代码智能体的组合式评测基准 RealSWE: A Compositional Evaluation of Coding Agents under Realistic User Requests
将SWE-Bench任务改写成真实用户风格,揭示榜单成绩高估智能体实战6.4个百分点。
前置知识
SWE-Bench 系列基准
由真实 GitHub issue 及其对应修复 commit/PR 构建的仓库级代码任务基准,模型需在目标仓库中生成补丁并通过可执行测试才算解决该题。Verified 是人工验证的高质量子集,Pro 将任务扩展到更大规模、更长程的复杂仓库。其榜单分数是当前比较 LLM 编码能力的事实标准。
RealSWE 的全部任务族都从 SWE-Bench Verified+Pro 的 1229 个问题陈述衍生而来,共享同一金补丁。只有理解其『每个任务绑定单一规范化 issue 描述』的构造方式,才能明白本文要修正的『理想化输入』偏差从何而来。
编码智能体与执行脚手架
能在仓库中自主读代码、改代码、跑测试的 LLM 系统,以『任务说明 + 工具调用循环』方式运行。本文统一使用 mini-SWE-agent v2 脚手架:仅提供纯 Bash 界面、不依赖厂商专属工具调用,每任务最多 100 步、无费用上限,核心指标是解决率(resolution rate,即通过全部测试的任务比例)。
实验设定直接约束结论:纯 Bash 脚手架会自行执行 python --version 等命令探测环境,这解释了为何环境信息字段 $[E]$ 没有可测收益;理解脚手架才能正确解读表 3 的成本与步数数据。
信息分类学与字段记号
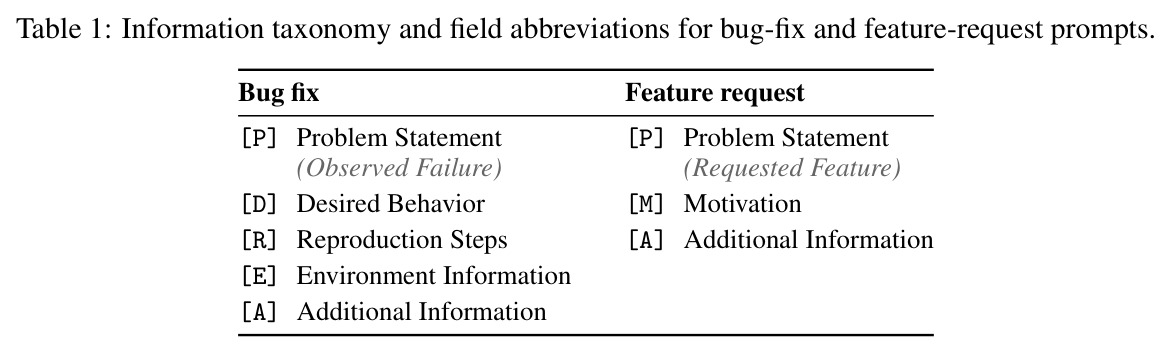
论文参照 GitHub issue 模板定义的字段体系:bug 修复类请求含 $[P]$ 问题陈述(观察到的故障)、$[D]$ 期望行为、$[R]$ 复现步骤、$[E]$ 环境信息、$[A]$ 附加信息;功能请求类含 $[P]$(想要的功能)、$[M]$ 动机、$[A]$。一个请求被表示为字段集合,如 $[PA]$ 表示只有问题陈述加少量上下文。
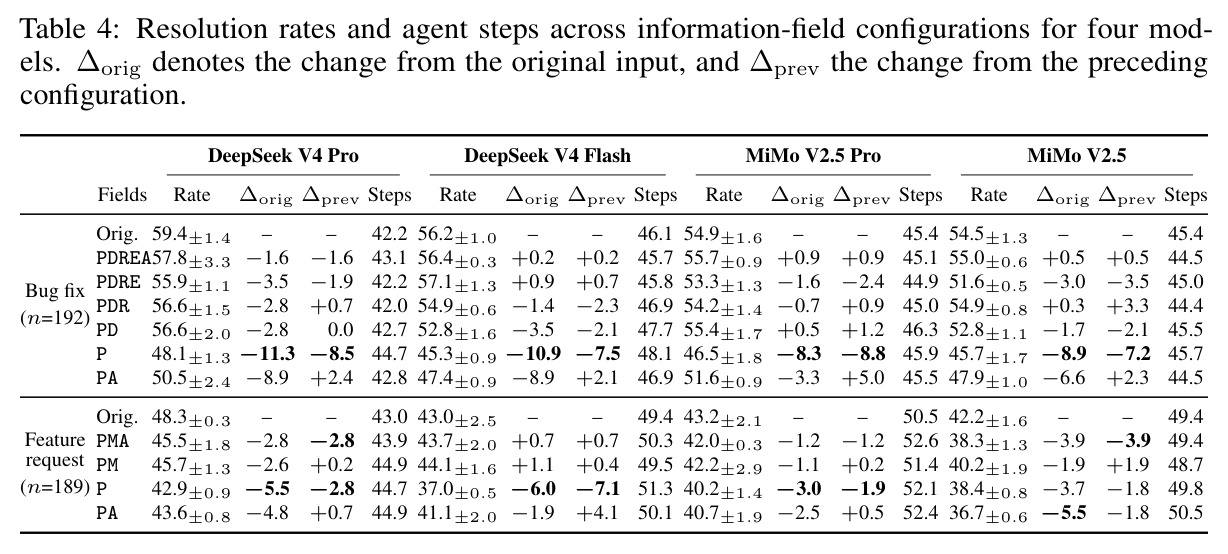
全文的分析、变体生成与消融实验都以这套字段记号为语言,表 1 定义记号,表 4 用记号展示各配置的解决率。不掌握记号就无法读懂核心实验。
多变体任务族与受控消融
对同一底层任务与同一金补丁,生成多个仅在信息组成或语言风格上不同的输入变体;通过固定其余维度、每次只操纵一个维度的对照实验(消融)把性能变化归因到被改变的那个因素。统计上每个『模型×条件』跑 3 次报告均值与标准差,多重比较用 Holm 校正 p 值。
这是本文方法论的核心创新,也是 RQ2(风格是否有影响)与 RQ3(哪个字段最有价值)结论可信的前提——先理解『控制变量』的设计,才能理解为什么作者敢说 $[D]$ 值 8 个百分点而 $[R][E]$ 几乎不值钱。
SWE-CHAT 数据集
公开的大规模真实开发者—编码智能体会话数据集,含 6000 多个会话。论文取每个会话的首条用户请求,剔除闲聊、工具输出等不可执行内容后得到 718 条真实提示词,作为『现实用户输入长什么样』的实证基准。
论文所有关于真实性的量化主张——88% 的稀疏请求、87% 随意语气、51% 祈使句、平均 1427 字符长度、$[P]/[PA]$ 的采样比例——全部建立在对这 718 条请求的标注统计之上。
研究动机
现有代码智能体评测几乎完全依赖 SWE-Bench 系列,其任务源自精心整理的 GitHub issue:信息完整、结构规整、篇幅长,通常同时包含故障描述、复现步骤、环境信息和期望行为。但真实用户与编码助手的日常交互远非如此。论文对 SWE-CHAT 中 718 条真实开发者请求的标注统计显示:仅含问题陈述 $[P]$ 或只附加少量上下文 $[PA]$ 的请求占 88%,而 SWE-Bench Verified 与 Pro 的 1229 个问题中这一比例仅 7%;语言上 86.8% 的真实请求语气随意、51.3% 使用祈使句,而基准问题 84.8%(Verified)到 100%(Pro)为正式书面语、约 89% 为陈述句。描述长度上真实请求平均 1427 字符,传统基准却达 1672–2776 字符。这构成系统性的『基准—现实』鸿沟:榜单成绩可能高估模型实战表现。已有的填补尝试要么闭源不可检验(CursorBench),要么用截断、注入歧义等启发式手段改写任务,虽证明差距存在却无法定位差距由哪种信息成分或语言属性造成。
本文的目标是本文要构建一个数据驱动、可系统控制的真实用户请求评测体系,并回答三个递进的研究问题:RQ1——当基准问题被替换为真实风格的用户输入时,智能体性能变化多大、排名是否稳定;RQ2——语言风格本身(与内容无关)是否影响解决率;RQ3——请求中的哪些信息字段对解题真正有价值、价值差多大。具体交付两件东西:REALSWE-BENCH,一个固定配置、精确匹配 SWE-CHAT 实测分布的 381 题开源评测集;REALSWE-FRAMEWORK,一个可任意指定信息组成(如 $[P]$、$[PD]$、$[PDREA]$)与语言风格(正式/随意、祈使/陈述/疑问等)的可控评测框架。作者希望通过同一底层任务、不同输入变体的受控对比,把『沟通方式』这一此前与其他因素混杂的变量独立出来量化,并产出用户与智能体界面可直接落地的写作指引。
与已有工作不同的是,与已有工作的本质区别是『受控分解』视角。SWE-Bench 系列把每个可执行任务绑定单一规范化 issue 描述,从不改变沟通形式;基于真实会话的 CursorBench 等输入虽然真实,但任务、仓库、难度与沟通方式同时变化,沟通的独立效应无法分离;SAVE THE SWE-BENCH 一类工作用真实交互模式变换任务,但一次变换同时改动多个属性,同样难以归因。RealSWE 的独特切入是两段式:先对真实请求做信息分类学与语言维度的实证刻画,测出真实分布长什么样;再把每个基准任务展开为共享同一金补丁的多变体任务族,族内变体之间只在信息组成或语言风格上相差受控的维度。这使得逐字段消融、任意组合配置、分布匹配评测都成为可执行的实验设计,把『性能差异源自沟通差异』从猜想变成可测量、可归因的对照实验。
核心方法
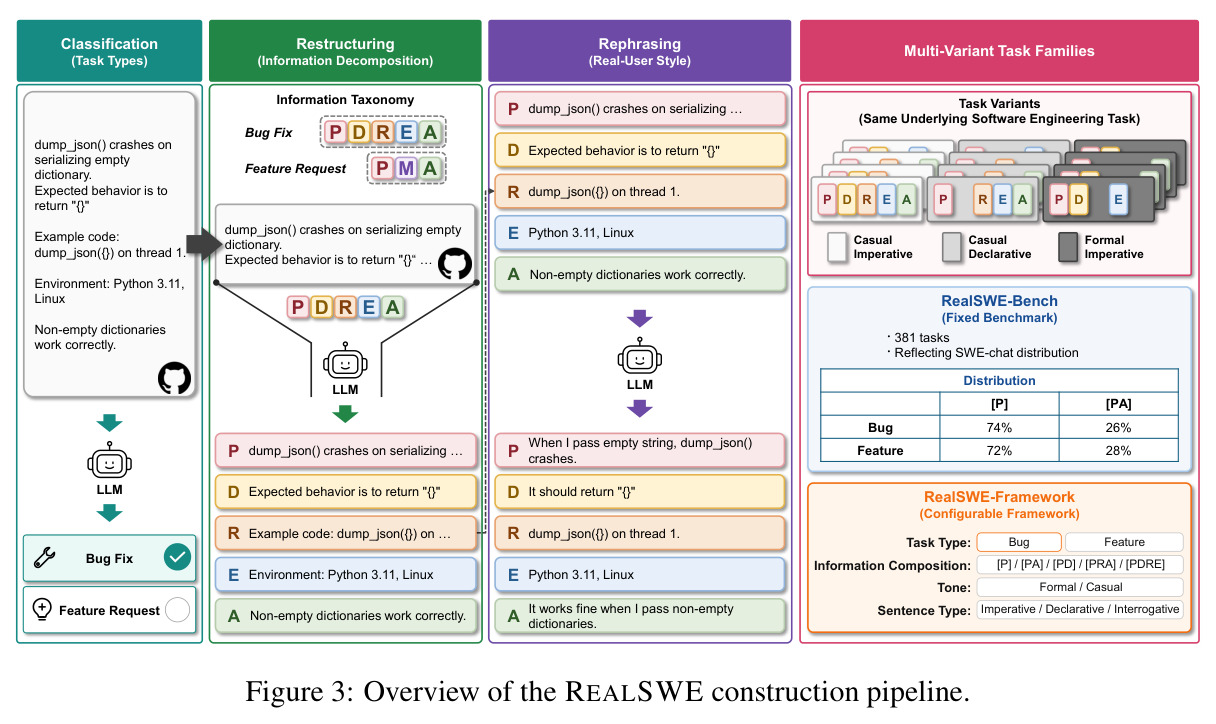
核心直觉是把『向智能体下达软件工程任务』分解为两个正交轴:说什么(信息组成)与怎么说(语言风格)。技术路线四步。第一步建立刻画体系:参照 GitHub issue 模板定义任务类型专属的信息分类学——bug 修复为 $[P]$ 问题陈述、$[D]$ 期望行为、$[R]$ 复现步骤、$[E]$ 环境信息、$[A]$ 附加信息,功能请求为 $[P]$、$[M]$ 动机、$[A]$;外加正式度、句式、确定性、人称四个语言维度。第二步实测分布:用该体系(LLM 辅助)标注 SWE-CHAT 的 718 条真实请求与基准的 1229 个问题陈述,量化差距——$[P]/[PA]$ 占比 88% 对 7%,随意语气 87% 对 94% 正式。第三步构造变体:GPT-5.4 驱动的三段流水线(任务分类→信息拆分→真实风格改写)把 403 个信息齐全的问题改造成多变体任务族,人工质控后保留 381 族(192 修复 + 189 功能)。第四步发布两种形态:固定分布采样的 REALSWE-BENCH 与暴露全部变体的 REALSWE-FRAMEWORK,供分布匹配评测与自定义消融。
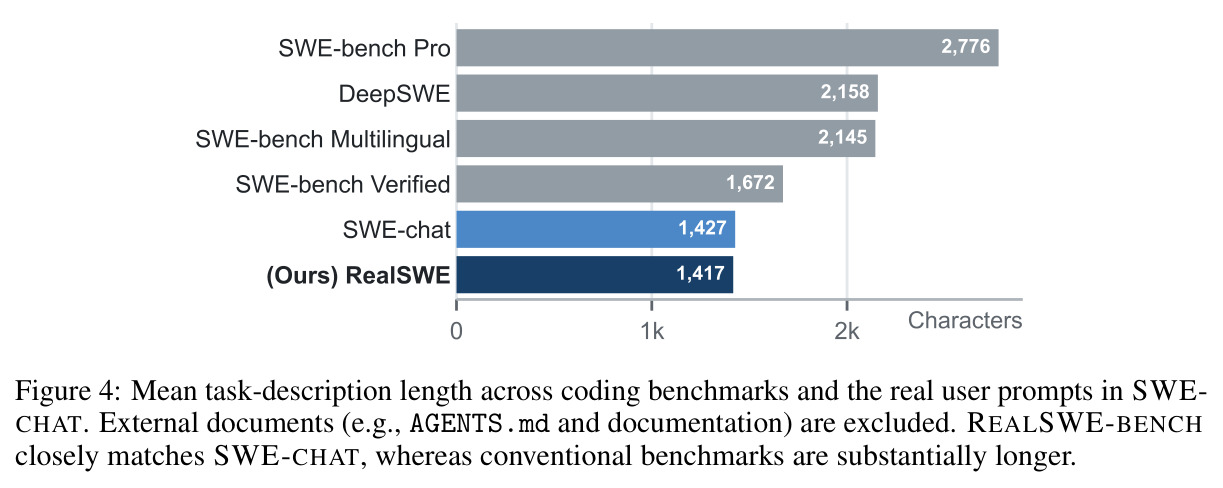
核心创新是多变体任务族设计:对同一底层任务与同一金补丁,生成仅在信息组成或语言风格上不同的多个输入变体。与已有工作的本质区别有两点。其一,信息重分布而非截断或注入歧义:流水线把原始问题陈述逐句拆分归入 $[P]/[D]/[R]/[E]/[A]$ 字段,且只重新分配文本、不重写内容,保证拆分不改变信息量;改写阶段强制保留代码块、报错信息、回溯、文件路径等技术字面量,只改变表达方式。其二,信息轴与风格轴完全解耦:可在固定信息组成下只切换风格,或固定风格下只增删字段,任何一次性能变化都能唯一归因到被操纵的维度。论文还用 SWE-CHAT 实测分布(bug 修复 $[P]$ 74%、$[PA]$ 26%;功能请求 $[P]$ 72%、$[PA]$ 28%)采样固定基准,使 REALSWE-BENCH 平均描述长度 1417 字符几乎精确对齐真实请求的 1427 字符,远低于传统基准的 1672–2776 字符,从长度维度验证了真实性。
方法步骤详情
构建流水线三步加人工质控。第一步任务类型分类:输入 SWE-Bench 问题陈述,先剥离 GitHub 模板脚手架(Markdown 标题、HTML 标签)但保留全部用户文本,再用 GPT-5.4 判定 bug 修复或功能请求(1229 题中仅 2 题两者皆非被剔除),该步相对人工真值准确率 0.95。第二步信息拆解:将陈述分句,把每句分配到分类学字段——如『dump_json() 序列化空字典时崩溃』归 $[P]$,『期望返回 {}』归 $[D]$,『Python 3.11, Linux』归 $[E]$——只重分配不重写;信息齐全的 403 题进入候选集。第三步真实风格改写:以实测各语言维度的众数类别(随意语气、祈使句等)为条件改写成 SWE-CHAT 风格。质控:两名标注者对每阶段 100 样本建立人工真值,GPT-5.6 Terra 以相同三级量规审计全部候选(拆解准确率 0.97、macro-F1 0.83;改写准确率 0.99、macro-F1 0.75),剔除任一关键维度最低分的 22 题,得到 381 族。评测统一 mini-SWE-agent v2 脚手架、100 步上限、每条件 3 次,并验证入选与落选 848 题在解决率、补丁规模、仓库分布上无系统差异。
技术新颖性
技术新颖性体现在三个层面。数据层面:首次用统一的字段分类学同时标注真实用户数据(SWE-CHAT)与主流基准(Verified+Pro),给出可复现的鸿沟量化(88% 对 7%、87% 对 94% 正式),而非停留在定性观察。构造层面:『同任务多变体』的基准组织方式是新的——以前基准把任务与单一描述绑死,RealSWE 把描述变成任务的可配置投影,信息拆解保证无信息增益/损失,风格改写保证语义与字面量不变,两者都可被 LLM 裁判按量规审计。实验层面:把消融方法论从模型结构移植到『请求沟通』本身,用累积消融路径 $[PDREA]\to[PDRE]\to[PDR]\to[PD]\to[P]$ 度量每个字段的边际价值,并用 Holm 校正控制多重比较,附录用更广的字段组合验证 $[D]/[M]$ 效应的稳健性。这使论文从『又一个改写基准』升级为一台可归因的实验仪器,框架本身(按需组装任意配置的数据集)是可复用的社区基础设施。
实验结果
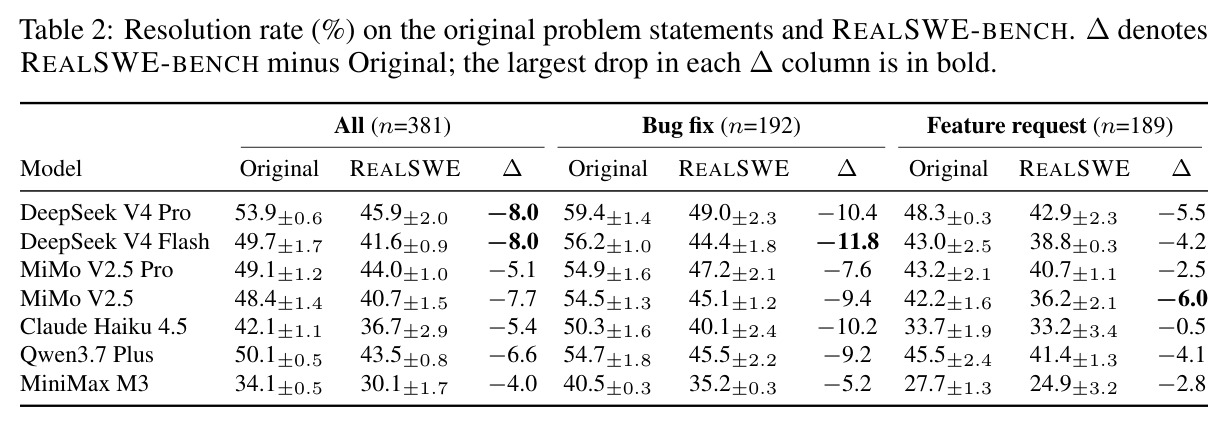
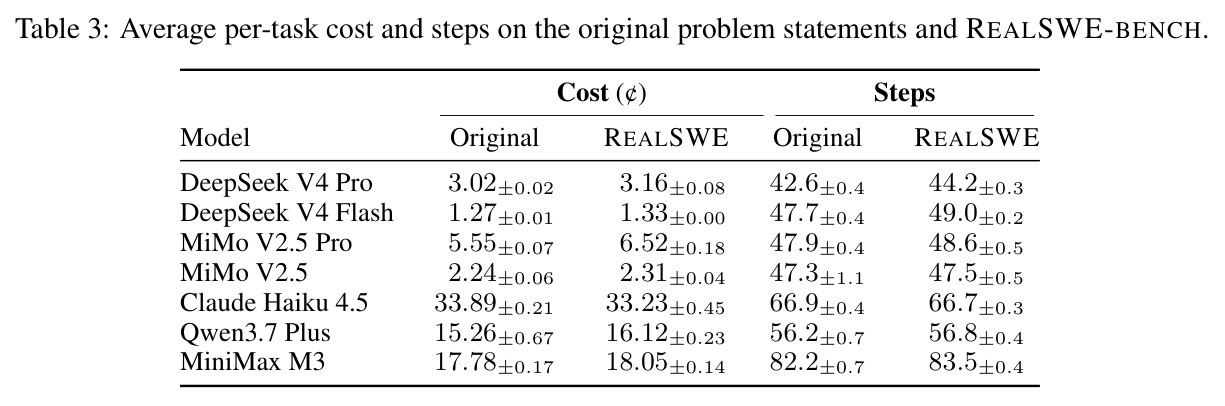
RQ1(表 2):七个模型在 REALSWE-BENCH 上无一幸免,平均下降 6.4 个百分点:DeepSeek V4 Pro 53.9%→45.9%(−8.0),DeepSeek V4 Flash 与 MiMo V2.5 各 −8.0/−7.7,Qwen3.7 Plus −6.6,MiniMax M3 34.1%→30.1%(−4.0);相对降幅 10.3–16.2%,均值 13.6%。成本平均升 6.2%、步数升 1.8%(表 3)——智能体靠额外探索补偿缺信息但补不回来。排名被重排:MiMo V2.5 Pro 从第四升至第二、反超 Qwen3.7 Plus(差距移动 +3.7 pp,95% CI $[+0.7,+7.3]$),且每任务 6.5 美分仅为 Qwen(16.1 美分)的四成——按原榜单选型会选到更贵且实战更差的模型。bug 修复平均降 9.1 pp,功能请求仅降 3.7 pp。RQ2:固定信息只改风格,bug 修复变化 −1.6 至 +0.9 pp(均值 0.0),功能请求 −3.9 至 +0.7 pp(均值 −1.8),八个对比 Holm 校正后全部不显著($p\ge .35$)。RQ3(表 4):bug 修复从 $[PDREA]$ 依次去掉 $[A][E][R]$ 仅变动 1.8 pp(无一显著,MiMo V2.5 去 $[R]$ 反而 +6.2 pp);但从 $[PD]$ 去掉 $[D]$ 使四模型降 7.1–8.9 pp(均值 8.0,全部 $p<.01$),是前三个字段总和的四倍。功能请求从 $[PM]$ 去掉 $[M]$ 平均降 3.4 pp(95% CI $[+0.2,+8.2]$),仅 DeepSeek V4 Flash 显著(−7.1 pp,$p=.001$)。决定性对比:$[PD]$ 比真实用户最常发的 $[PA]$ 高 3.8–6.1 pp,$[PM]$ 高 1.4–3.5 pp,而真实请求中仅 5% 写明期望行为或动机。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-Bench Verified+Pro 原始问题陈述 vs REALSWE-BENCH(381 题,真实用户分布) | 解决率 resolution rate (%) | REALSWE-BENCH 下七模型平均 40.2%,平均下降 6.4 pp(相对 13.6%);DeepSeek V4 Pro 45.9%,MiniMax M3 30.1% | 原始问题陈述下平均 46.6%;DeepSeek V4 Pro 53.9%,MiniMax M3 34.1% | 非提升型结论:真实输入导致 −4.0 至 −8.0 pp 的下降,证明原基准高估实战表现 |
| bug 修复任务(n=192):期望行为字段的价值 | 解决率变化(从 $[PD]$ 去掉 $[D]$) | 四模型平均 −8.0 pp(范围 −7.1 至 −8.9),全部 Holm 校正 p<.01 | 去掉 $[A][E][R]$ 三字段合计仅 −1.8 pp 且不显著(p≥.44) | $[D]$ 的边际价值是 $[R][E][A]$ 总和的四倍以上;$[PD]$ 比 $[PA]$ 高 3.8–6.1 pp |
| 功能请求任务(n=189):动机字段的价值 | 解决率变化($[PM]$ vs $[P]$) | 四模型平均 −3.4 pp,95% CI $[+0.2,+8.2]$;DeepSeek V4 Flash −7.1 pp(p=.001) | $[M]$ 是功能请求中唯一平均效应可区分于零的字段;$[PM]$ 比 $[PA]$ 高 1.4–3.5 pp | 证实动机是功能请求中的关键但模型依赖性较强的信号 |
| 语言风格影响(固定信息,原始 vs 改写) | 解决率变化(pp),Holm 校正显著性 | bug 修复均值 0.0 pp(−1.6 至 +0.9),功能请求均值 −1.8 pp(−3.9 至 +0.7) | 八个对比全部不显著(p≥.35) | 非提升型结论:风格本身几乎不影响成绩,『说什么』远比『怎么说』重要 |
局限与改进
作者承认的局限有三。其一,模型覆盖不足:七个模型虽含万亿级的 DeepSeek V4 Pro 与 MiMo V2.5 Pro,但不含 GPT-5.6、Opus 5、Kimi K3 等当前榜单最强的前沿系统,结论对顶级模型的外推性存疑。其二,单轮设定:沿用 SWE-Bench 的一次性任务书模式,无法刻画真实产品里靠多轮追问澄清来缓解信息稀疏的交互,而这恰是缓解本文发现的问题的自然手段。其三,任务池缩水:1229 题中仅 403 题信息齐全、质控后剩 381 题,虽有选择偏差检验仍可能存在分布偏移。我的补充观察:变体由 GPT-5.4 生成、由 GPT-5.6 裁判审计,生成器与被测模型同属前沿 LLM 生态,改写风格可能引入未被量规覆盖的隐性偏置;$[E]$ 无收益的结论可能与 mini-SWE-agent 自带环境探测强耦合,换脚手架未必成立;风格实验只测了各维度众数组合(随意+祈使等),未覆盖 4 个维度的长尾组合;每条件仅 3 次重复,对 2–3 pp 量级的差异统计功效有限;成本以美分计价未报 token 数,跨模型可比性打折。
独立分析的弱点
独立分析后我认为有五个具体弱点。第一,主结论依赖单一累积消融路径($[PDREA]\to[PDR]\to[PD]\to[P]$),而字段间可能存在交互效应——$[D]$ 在有无 $[R]$ 时的价值未必相同;附录 E.1.2 的组合实验虽缓解了这一担忧,但主表只呈现路径结果,容易让读者高估结论的普适性。改进方向是把字段级析因设计(全因子或部分因子)作为主实验。第二,『$[E]$ 环境信息无收益』可能与 mini-SWE-agent 纯 Bash 脚手架强耦合:智能体会自行探测环境,换用带缓存或受限工具的脚手架结论可能反转,应做脚手架×字段的交互实验。第三,风格维度只锁定众数组合(随意+祈使),未回答『正式的随意请求』『疑问句功能请求』等长尾情形,四维全组合的稀疏采样实验值得补做。第四,每条件仅 3 次重复,若干 ±2–3 pp 差异虽经 Holm 校正,功效仍有限,且族内方差未在主表呈现。第五,成本只报美元未报 token,且不同模型的推理预算未对齐,『MiMo 更划算』的结论可能受定价策略影响而非能力差异。
未来方向
作者明确提出的方向:把 RealSWE 扩展到受控多轮对话设定,研究智能体在稀疏请求面前应优先追问哪类信息——既然期望行为与动机最稀缺(仅 5% 请求写明)也最有价值,可以在实现前让界面主动提出针对性澄清问题,或让智能体从仓库上下文推断缺失的 $[D]/[M]$ 回填任务书后再动手。基于本文成果还可延伸:其一,把字段价值发现转化为自动提示改写器,输入稀疏请求、输出补全高价值字段的请求,可直接接入现有编码助手;其二,用 FRAMEWORK 研究信息组成与模型规模、推理预算的交互,回答『小模型配好提示能否逼近大模型配差提示』;其三,扩展到非英语请求与多语言用户的真实风格;其四,把信息分类学推广到数据科学、运维等其他智能体任务类型;其五,把多变体思想用于训练时数据增强,让模型在训练阶段就适应信息稀疏输入,而非只在评测时暴露短板。
复现评估
可复现性总体较好。开源承诺明确:REALSWE-BENCH(381 题固定集,按实测分布采样)与 REALSWE-FRAMEWORK(全部变体的配置接口)均开源;底座任务来自公开的 SWE-Bench Verified/Pro,执行容器直接复用源基准发布的镜像;脚手架为公开的 mini-SWE-agent v2;附录 H 提供三段流水线的完整提示词,附录 B–G 给出剥离模板规则、分类学定义、样本筛选、量规与推理设置。复现评测的门槛主要在费用:每『模型×条件』跑 3 次、每任务最多 100 步,Claude Haiku 4.5 单任务约 33.9 美分、MiniMax M3 平均 82 步以上,完整复现表 2(14 个条件)加表 4(4 模型 × 约 10 配置)的 API 预算粗估在数千美元量级。构建流水线依赖 GPT-5.4 与 GPT-5.6 Terra,提示词虽公开但模型版本迭代可能改变生成细节;718 条 SWE-CHAT 请求的筛选规则在附录 C 有描述。对个人研究者,先复现单模型 × 少数配置的对比即可验证主要结论。
论文图表
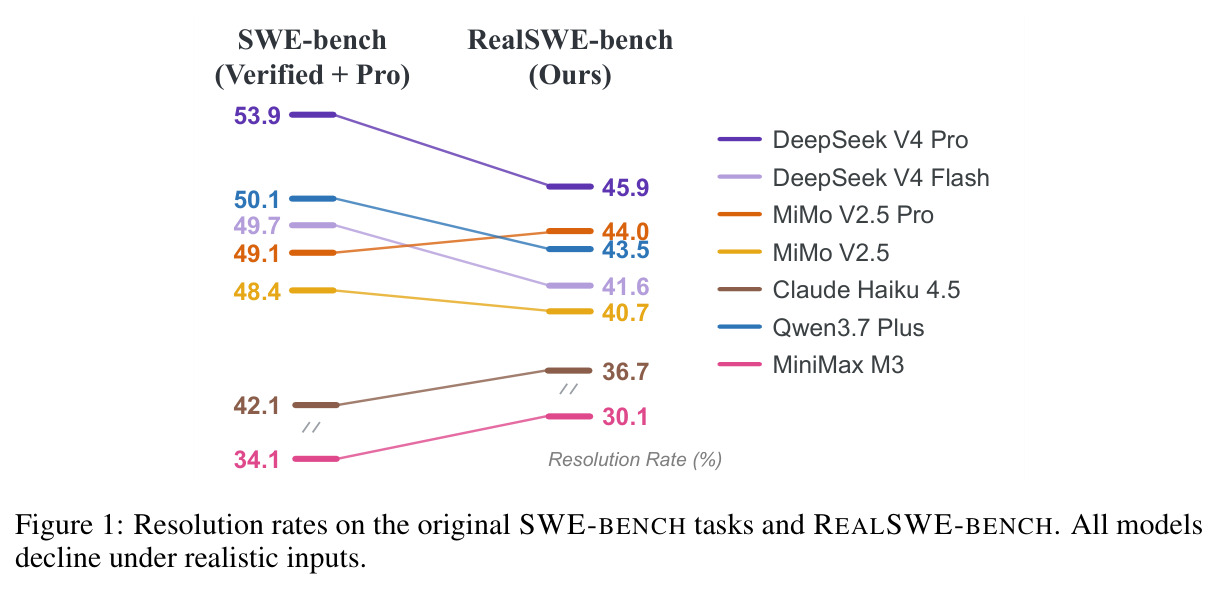
七个模型(DeepSeek V4 Pro/Flash、MiMo V2.5 Pro/MiMo V2.5、Claude Haiku 4.5、Qwen3.7 Plus、MiniMax M3)在原始 SWE-Bench 任务与 REALSWE-BENCH 上的解决率对比条形图。所有模型在真实输入下全部下降:DeepSeek V4 Pro 53.9%→45.9%,Qwen3.7 Plus 50.1%→43.5%,DeepSeek V4 Flash 49.7%→41.6%,MiMo V2.5 Pro 49.1%→44.0%,MiMo V2.5 48.4%→40.7%,Claude Haiku 4.5 42.1%→36.7%,MiniMax M3 34.1%→30.1%;且 MiMo V2.5 Pro 的排名从第四升至第二。
这是全文的钩子图,一图同时呈现两个核心信息:基准—现实差距普遍存在(无一模型幸免),以及模型排名在真实输入下会被重排。理解这张图就抓住了论文的研究动机和 RQ1 的答案。
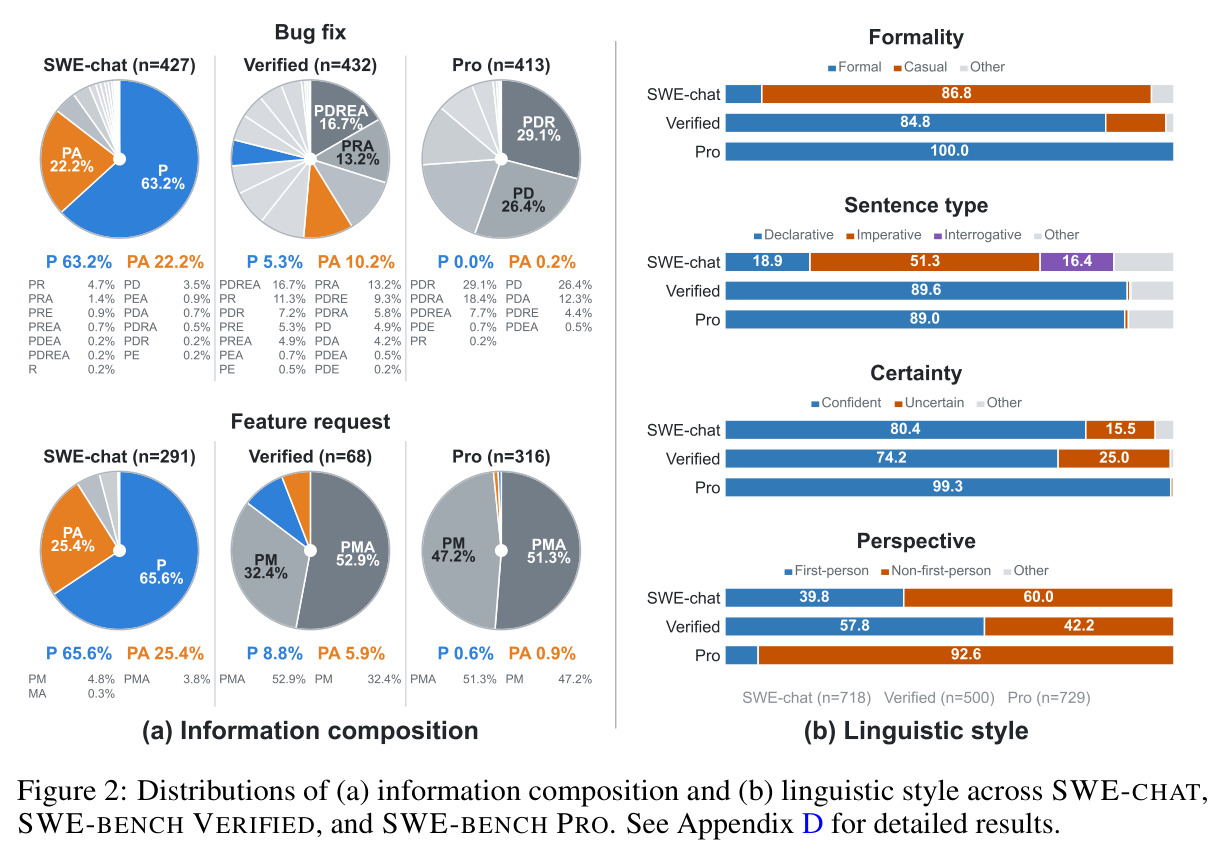
三个数据源(SWE-CHAT 真实请求、SWE-BENCH VERIFIED、PRO 的问题陈述)在两个轴上的分布对比。(a) 信息组成:真实请求中 $[P]$ 与 $[PA]$ 合计占 88%(bug 修复 85.5%、功能请求 91.1%),而基准问题仅 7%,基准普遍含 $[R][E]$ 等真实用户几乎不提供的字段。(b) 语言风格:86.8% 真实请求随意、51.3% 祈使句,基准 84.8–100% 正式、约 89% 陈述句;确定性与人称两维无一致区分。
这张图提供了论文全部定量动机:它把『基准与现实不一样』的直觉变成可复现的分布数据,且这些实测分布直接决定了后面 REALSWE-BENCH 的采样比例与改写条件,是连接动机与方法的枢纽。