Video-Coder:用智能体编程强化视频生成 Video-Coder: Reinforcing Agentic Coding for Video Generation
训练编码智能体写Blender代码构建3D草稿视频,引导下游生成器提升物理一致性
前置知识
Agentic RL(智能体强化学习)
让 LLM 智能体在真实环境中多轮交互——调用工具、观察反馈、修正动作——并用基于结果的奖励通过强化学习优化整条轨迹的策略。与单轮 RLHF 不同,奖励作用于完整的多步行为序列(写代码-执行-看结果-修改),典型代表有 Search-R1、ReTool、ARPO。
本文的核心训练范式就是 harness 原生的 agentic RL:Video-Coder 在 Blender 执行环境中通过 GRPO 直接优化多轮编码行为,读懂 3.3 节训练配方的前提是理解这个范式。
GRPO(组相对策略优化)
DeepSeek 提出的免价值网络 RL 算法:对每个 prompt 采样 G 条轨迹,用组内统计量把奖励归一化为优势 $A_i=(R_i-\text{mean}(\{R_j\}))/\text{std}(\{R_j\})$,再按 PPO-clip 式裁剪目标加 KL 正则更新策略,省去额外训练一个 critic。
论文公式 (4)(5) 用 GRPO 做最终策略优化,组大小为 8;理解组内相对优势才能明白为什么稀疏的执行奖励也能在 RL 早期起作用。
Blender Python 程序化建模(bpy)
Blender 是开源 3D 建模与渲染软件,提供 Python API:脚本可以创建几何体、设置材质、打关键帧动画、配置物理仿真与相机,然后离屏渲染成视频序列。一段程序即可精确描述'三个球从不同高度同时落下'这类约束。
智能体输出的'程序'就是 Blender Python 脚本,整个方法(数据合成、Harness、奖励计算)都围绕'代码→动态 3D 场景→渲染视频'这条链路展开。
白模/草稿视频(white-model draft video)
只包含几何结构、物体运动与相机信息的无纹理渲染视频:所有场景统一用灰色黏土材质、固定分辨率和帧率渲染,因此画面里只剩'什么物体、在哪、怎么动、相机怎么拍',不含任何外观纹理。
这是本文的关键中间表示——把'结构与运动'从'外观'中解耦出来,下游生成器只需在草稿约束下补全外观,这是全文一切设计与结论的基础。
视频扩散/自回归生成模型
Sora、CogVideoX、HunyuanVideo、Wan、Kling 等端到端模型,在像素或潜空间直接拟合视频分布,视觉保真度高,但对物体数量、空间关系、物理规律等显式约束的服从性差,且难以精确编辑和复现。
它们既是本文的对比基线(PhyGenBench 上多数只有 0.33-0.54),也是本文的下游生成器(MiniMax-H3),理解其结构控制短板才能理解论文动机。
Harness(智能体执行环境)
为智能体训练和推理搭建的统一交互环境:提供沙箱化的代码执行、工具调用接口(如静态检查、运行渲染)以及结构化反馈(错误信息、内容检查、渲染帧图像),并负责最终结果的验证与接受。
Video-Coder Harness 集代码执行、3D 渲染与执行反馈于一体,是数据合成、SFT、RL rollout 三者共用的基础设施,被称为 harness-native 训练的关键。
研究动机
端到端视频生成模型(Sora、CogVideoX、HunyuanVideo、Wan、Kling、Seedance 等)在像素或潜空间直接拟合视频分布,从不显式建模底层 3D 世界。当 prompt 涉及精确空间关系、多物体交互或物理规律约束的运动时,生成视频经常出现物体数量和位置错误、遮挡关系不一致、运动轨迹不合理、物体形变或凭空消失等问题;Kang 等人的研究进一步表明单纯扩大模型规模不足以学到这些物理规律。此外端到端生成的视频难以编辑和复现,用户只能反复试错改写 prompt。量化来看问题很普遍:PhyGenBench 物理一致性基准上,HunyuanVideo 仅 0.33、Kling 0.49、Gen-3 0.51,最强的 MiniMax-H3 也只有 0.61;VBench-2.0 物理维度上 Sora 只有 56.84%、MiniMax-H3 仅 54.58%。物理一致性与可控性仍是视频生成的普遍短板。
本文的目标是本文要训练第一个代码驱动的视频生成智能体:给定文本 prompt,模型自主编写并执行 Blender Python 代码构建动态 3D 场景,渲染成白模草稿视频,为下游视频生成器(MiniMax-H3)提供显式的结构与运动信号,使生成过程可控、可解释、可验证。为此作者设计了专门的数据构建管线,产出 Video-Coder-SFT-6k 与 Video-Coder-RL-2k 两个数据集,并构建集成代码执行、3D 场景渲染与执行反馈的 Video-Coder Harness;随后用 SFT 加 harness 原生智能体强化学习(双奖励反馈加退火策略)训练基于 Qwen3.5-9B 的 Video-Coder,并把数据、模型、代码全部开源,作为代码驱动视频生成方向的开放基础。
与已有工作不同的是,已有两条线的工作都没走到这一步。代码驱动视觉生成一侧:早期工作用 LLM 生成 2D 布局指导扩散模型,无法描述 3D 几何、遮挡和相机运动;BlenderGPT 类工作用 LLM 生成场景代码;GPT4Motion 用 Blender 脚本化物理运动;Video-CoCo 把代码作为物理一致生成的思维链。但它们大多只是在固定 prompt 管线里调用冻结的、往往闭源的大模型,单轮生成、不根据执行反馈修正代码、更不针对最终视频质量优化模型本身。智能体 RL 一侧:Search-R1、ReTool、SWE-RL、ARPO、AdaTooler-V、Gen-Searcher 分别覆盖搜索、代码修复和多模态工具调用、图像生成,但用 agentic RL 训练面向物理一致且时序连贯视频生成的编码智能体仍是空白。本文的独特切入是把视频生成重构为 agentic 编程任务,在可执行可验证的 harness 里端到端优化最终视频质量。
核心方法
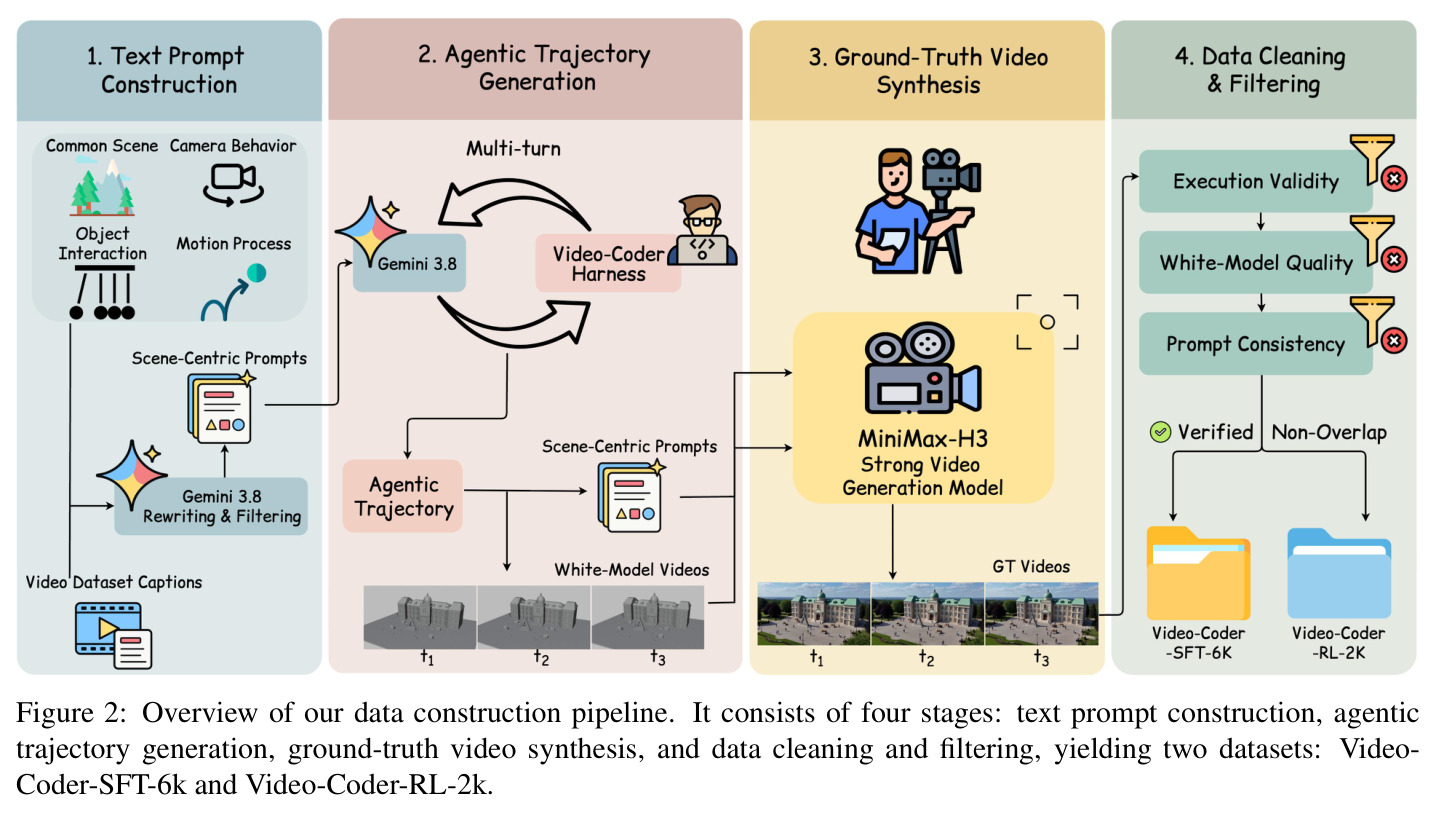
直觉上,让'会写代码的 LLM'先用几何原语把场景搭出来:物体种类和数量、空间布局、运动过程、相机轨迹全部由一段可执行的 Blender 程序精确规定,渲染成只有结构和运动、没有纹理的白模草稿视频;再让视频扩散模型在草稿约束下补全外观,数量与运动错误就从源头消除。技术路线:先四阶段构建数据——收集改写 prompt,用 Gemini 3.8 Flash 接入 Harness 生成多轮编码轨迹,再用 prompt 加草稿视频喂给 MiniMax-H3 合成参考视频,三级过滤后得到 SFT-6k 和 RL-2k;然后两阶段训练——Qwen3.5-9B 先在 SFT-6k 上学会规划场景、写 bpy 代码、调用工具、读懂执行与视觉反馈,再在 RL-2k 上做 harness 原生 GRPO 训练;奖励取 $R=\alpha\cdot R_{\text{video}}+e^{-steps/T}\cdot R_{\text{exe}}$($\alpha=0.5$),执行奖励保证程序可执行,视频奖励评估最终质量,退火让二者随训练阶段接力。训练用 8 张 H100 跑约 3 天,生成器全程冻结。
核心创新是把'结构与运动'从'外观'中解耦出来交给可执行代码,并让 RL 直接在真实执行环境中优化最终视频质量。与直接生成相比,场景由程序定义,生成变为可控、可解释、可验证;Harness 还会把最终脚本在干净目录里从头重跑一遍,只有独立复现再次通过所有检查才接受该 episode,保证每个结果都能由代码复现。与已有 LLM 生成 3D 场景代码的工作相比,本文不是冻结模型加固定管线,而是训练多模态编码智能体在写-跑-改循环中多轮迭代。奖励设计上,execution reward 是二值的:所有工具调用格式正确且最终 Blender 程序执行成功并通过全部环境检查得 1,否则得 0;video reward 由 Qwen3.8-omni-flash 评估最终视频与 prompt 及参考视频在物体类别、空间布局、运动动态、相机行为上的一致性并归一化到 [0,1]。两者用退火权重 $e^{-steps/T}$ 动态平衡:早期执行奖励主导(稳定学会工具调用与代码生成),后期视频奖励逐渐接管(直接优化生成质量)。消融证明该设计必要:固定权重只有 0.65,去掉任一奖励掉到 0.63-0.64。
方法步骤详情
第一步,prompt 构建:从公开视频数据集 caption 收集候选,LLM 改写成明确物体数量、布局、运动与相机的场景中心描述,并过滤人脸表情类 prompt。第二步,轨迹生成:Gemini 3.8 Flash 在 Harness 隔离沙箱(灰色黏土渲染)中执行写-跑-改循环:写 bpy 脚本,check_script 静态检查,run_blender 执行渲染;每轮返回执行错误、内容检查与采样帧反馈,结束时重跑最终脚本验收。第三步,真值合成:草稿加 prompt 喂 MiniMax-H3 合成外观真值。第四步,三级过滤:执行有效性、白模质量、prompt-视频一致性(Seed2.0 阈值),切分出 SFT-6k 与 RL-2k。第五步 SFT:学习率 $1\times10^{-5}$,batch 8。第六步 RL:GRPO,学习率 $1\times10^{-6}$,组大小 8,最多 100 轮,上下文 120K;奖励 $R=\alpha R_{\text{video}}+e^{-steps/T}R_{\text{exe}}$,按组归一化优势做 PPO-clip 加 KL 更新。
技术新颖性
第一,范式新颖:这是第一个被训练出来的视频生成编码智能体,此前同类工作(GPT4Motion、Video-CoCo、BlenderGPT 类)都停留在提示冻结模型,而本文用 SFT 加 agentic RL 真正改写模型的多轮编程策略。第二,harness-native RL:rollout 就是智能体在真实 Blender 执行环境里的完整多轮交互,奖励直接来自环境(执行检查、MLLM 视频评分),而不是离线偏好标注,这使行为策略和环境约束天然对齐。第三,双奖励加退火解决了两类奖励的阶段性矛盾——可执行性是稀疏二值信号但早期不可或缺,视频质量是细粒度信号但早期难以获得,$e^{-steps/T}$ 让二者像课程学习一样接力,这是消融中贡献最大的设计之一(0.65 对 0.67)。第四,从头重跑的验收机制保证 RL 数据与部署行为一致、每个样本可由代码复现。第五,结构/外观解耦带来可迁移性:仅用 MiniMax-H3 做 rollout 训练的智能体,换到 OmniWeaving 上仍能从 0.48 提升到 0.51,说明学到的是通用结构先验而非对特定生成器的过拟合。
实验结果
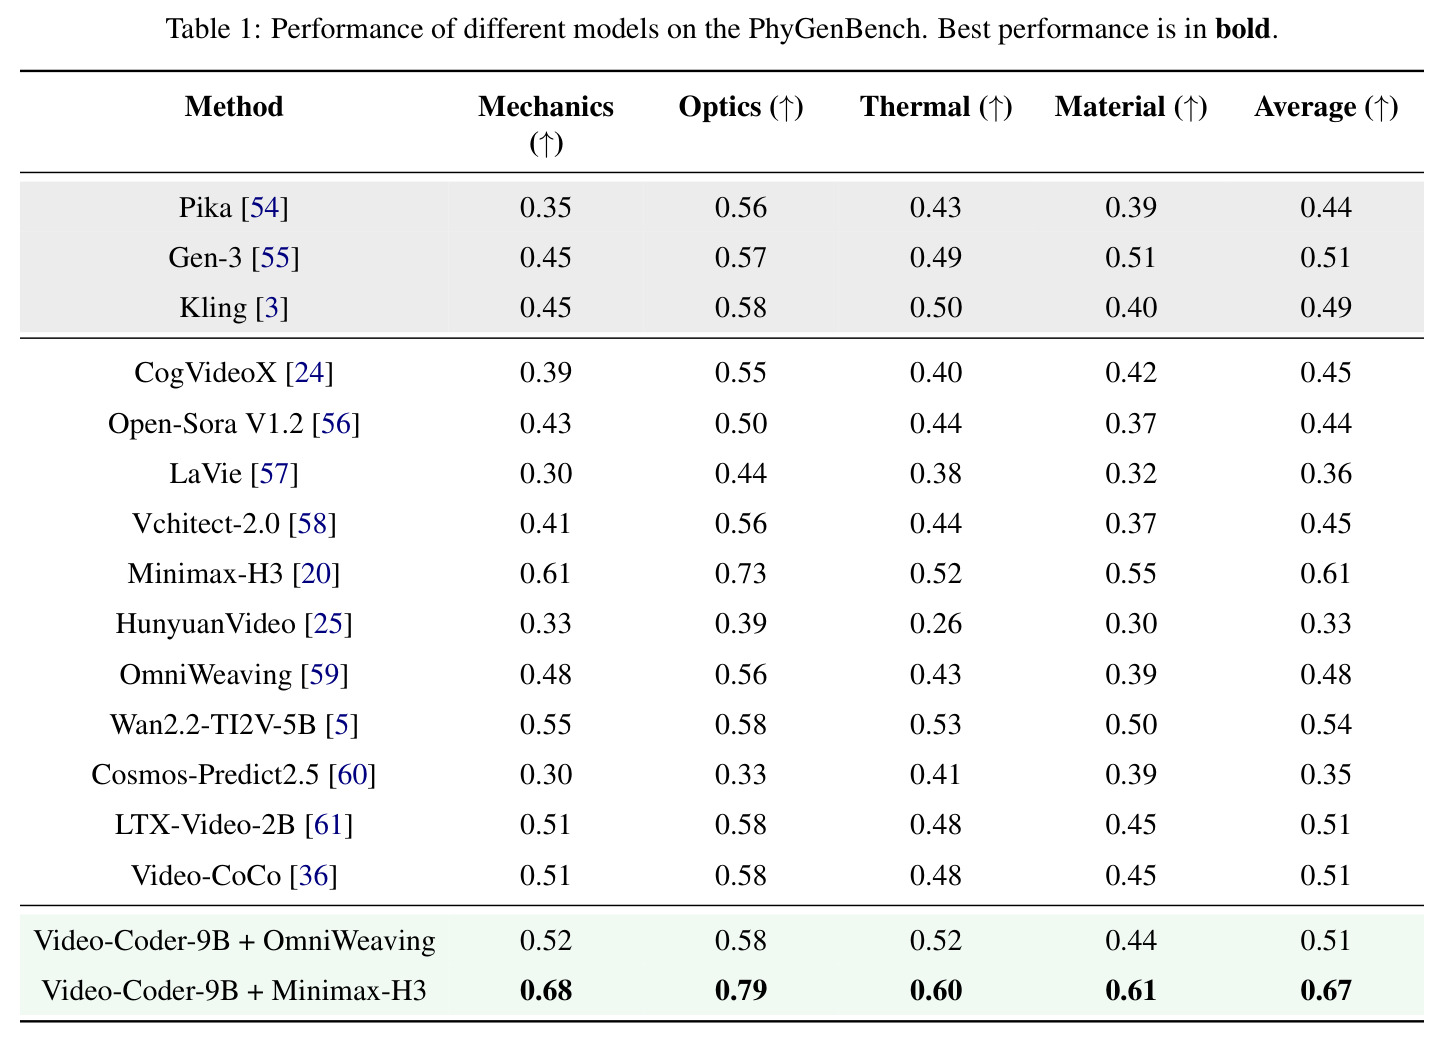
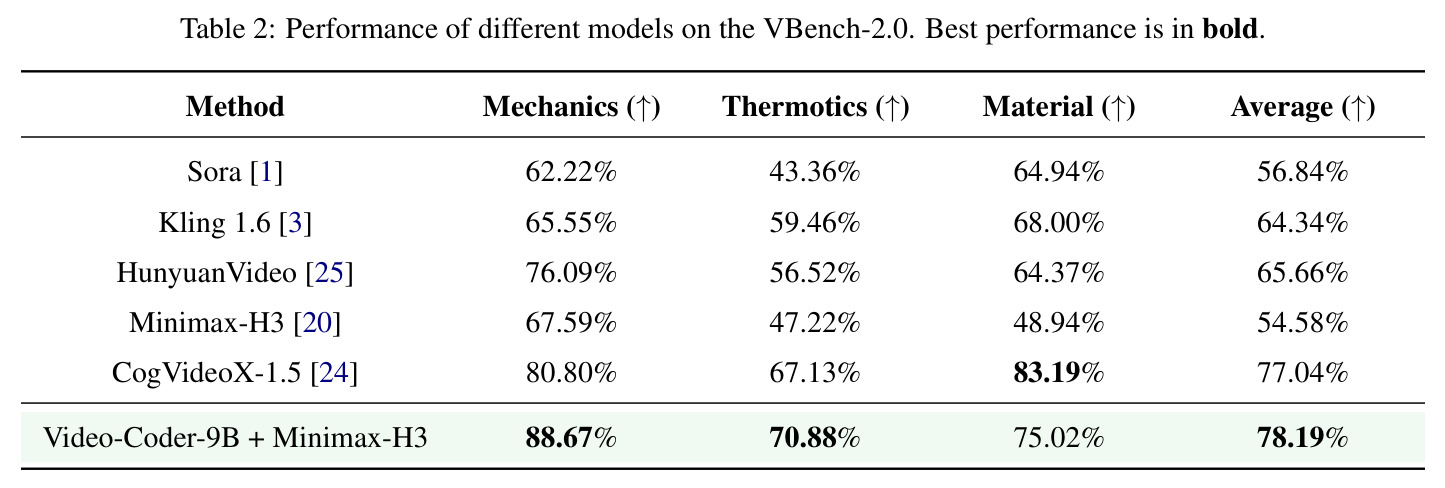
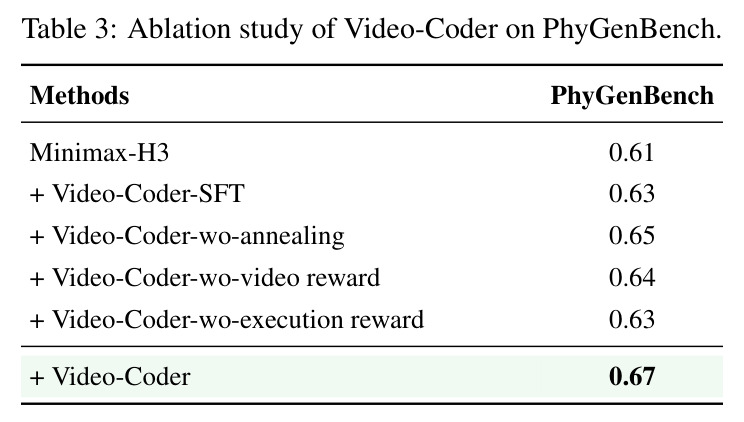
PhyGenBench(GPT-4o 判分):Video-Coder-9B+MiniMax-H3 平均 0.67 全场最佳,比裸基座的 0.61 高约 6 个点,四类别全部第一——Mechanics 0.68、Optics 0.79、Thermal 0.60、Material 0.61,超过 Wan2.2-TI2V-5B(0.54)等全部基线。迁移性:换 OmniWeaving 仍从 0.48 提到 0.51。VBench-2.0:平均合理度 78.19%,比基座 54.58% 高约 24 个点,超过 CogVideoX-1.5(77.04%);Mechanics 88.67%,较 CogVideoX-1.5 +7.87、较基座 +21.08 个点;Thermotics 70.88% 最佳;Material 75.02% 优于基座 48.94% 但落后 CogVideoX-1.5 的 83.19%。消融:SFT 0.61→0.63,RL 0.67;去退火/视频奖励/执行奖励分别为 0.65/0.64/0.63,两奖励互补($\alpha$=0.5~0.6 最佳)。
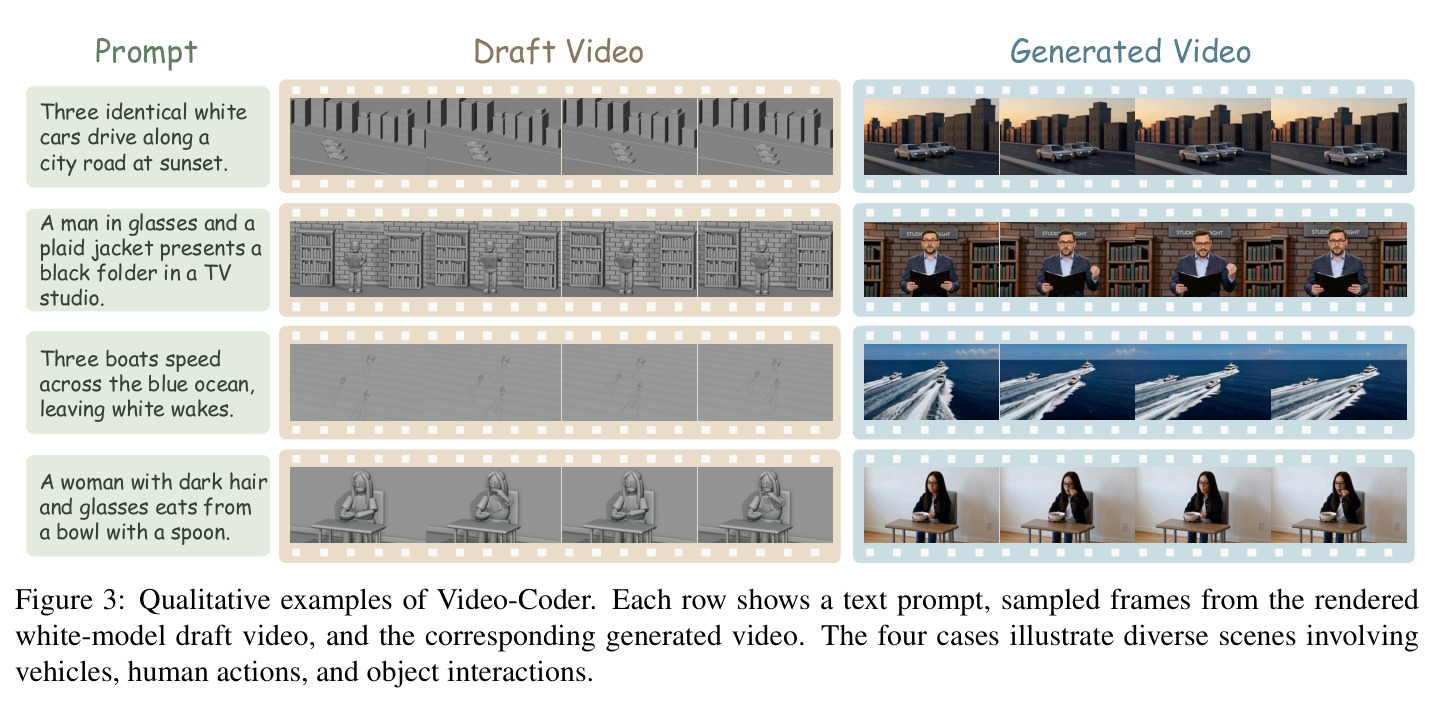
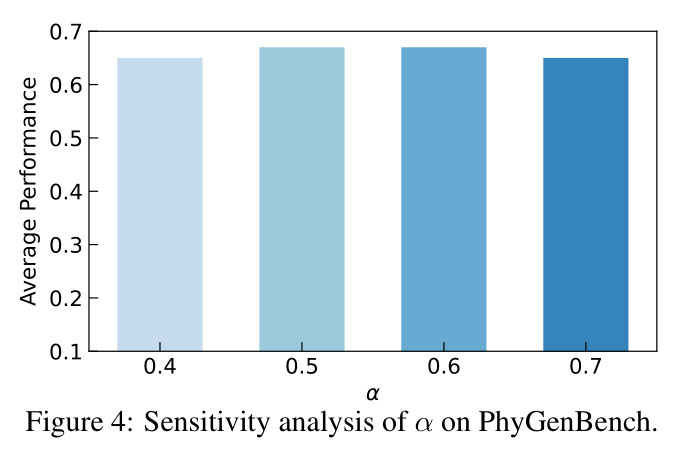
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PhyGenBench 物理常识视频生成 | 四类平均一致性得分(GPT-4o 判分,[0,1]) | 0.67(Video-Coder-9B + MiniMax-H3) | MiniMax-H3 直接生成 0.61 | +6 个点,全场第一;也超过最强开源 Wan2.2-TI2V-5B(0.54)与商业系统 Gen-3(0.51) |
| PhyGenBench Mechanics(力学) | 力学一致性得分 [0,1] | 0.68 | MiniMax-H3 0.61 | +7 个点,四个类别全部第一(Optics 0.79、Thermal 0.60、Material 0.61 亦为最佳) |
| VBench-2.0 物理维度 | 平均合理度(百分比) | 78.19% | MiniMax-H3 54.58% | +23.61 个点(论文称约 24 点),超过最强基线 CogVideoX-1.5 的 77.04% 与 Sora 的 56.84% |
| VBench-2.0 Mechanics(力学) | 力学合理度 | 88.67% | CogVideoX-1.5 80.80%(MiniMax-H3 67.59%) | +7.87 个点(相对基座生成器 +21.08 个点),考察下落、碰撞、滚动等机械运动 |
| 跨生成器迁移(PhyGenBench) | 平均一致性得分 | Video-Coder-9B + OmniWeaving 0.51 | OmniWeaving 直接生成 0.48 | +3 个点,证明 RL 学到的结构先验可迁移到训练时未用的生成器 |
局限与改进
作者承认的局限:Material 维度只拿到 75.02%,落后 CogVideoX-1.5 的 83.19%——因为白模视频刻意只编码结构与运动,材质类现象高度依赖细粒度外观和材质响应,这个设计先天吃亏。我的补充观察:其一,管线对大模型生态依赖很重——轨迹靠 Gemini 3.8 Flash、参考视频靠 MiniMax-H3、奖励靠 Qwen3.8-omni-flash、过滤靠 Seed2.0、评测靠 GPT-4o,任何一环的偏差都会级联传导,且训练奖励与评测都依赖 MLLM 判分,存在被'应试'优化的风险。其二,数据规模小(SFT 6k、RL 2k),且刻意排除人脸表情和细粒度外观,适用域限于可用几何原语加关键帧表达的场景。其三,退火因子 $e^{-steps/T}$ 只从 1 衰减到 $1/e\approx0.37$,执行奖励后期权重仍不可忽略,论文未解释为何不衰减到零。其四,论文数字自相矛盾:摘要写 SFT-6k/RL-2k,实验节却写 SFT-10k/RL-4k。其五,评测只聚焦物理维度,未报告外观美感、时序一致性等通用指标;若草稿结构有错,下游也难纠正。
独立分析的弱点
第一,video reward 依赖单一 MLLM(Qwen3.8-omni-flash)打分,智能体在数万次 rollout 中可能学到迎合评判器的模式(比如戏剧化的运动或构图)而非真实物理正确,这在长训练中尤其危险;改进方向是用多评判器集成,或把 Blender 物理引擎的仿真轨迹与生成视频的跟踪轨迹做对比,构造可验证的客观物理奖励。第二,外观与材质盲区是白模设计的结构性缺陷,Material 维度 75.02% 对 83.19% 的差距说明纯结构信号对材质类目标不够;可以让代码额外输出 PBR 材质与光照参数,或训练一个独立的材质补全 agent。第三,数据管线封闭依赖 Gemini 3.8 Flash 和 MiniMax-H3 这类强模型,成本高且管线本身不可复现;可用开源模型重建管线并量化蒸馏损失。第四,最多 100 轮交互、120K 上下文使 RL 成本高昂(还需 16 张 H100 跑 rollout 生成器);可引入草稿帧选择性保留、上下文压缩或学习提前终止策略。第五,评测判分(GPT-4o)与训练奖励同为 MLLM,存在循环性风险;应加入小规模人工标注金标集做校准。
未来方向
作者提出的方向:把 Video-Coder 作为代码驱动视频生成的开放基础,未来扩展到更丰富的场景类型(人物动作、表情、材质外观)、更大规模数据与更强基座模型。基于成果可以自然延伸的方向包括:其一,交互式编辑——场景由代码定义,用户改几行代码即可精确修改视频中的物体数量、轨迹和相机,天然支持可复现的迭代创作,这是直接生成做不到的;其二,长视频与多场景叙事——把代码作为维护'世界状态'的载体,保证跨镜头的物体与运动一致性;其三,4D 资产与具身智能——白模视频本质上就是仿真资产,管线可反哺机器人仿真数据合成;其四,奖励建模——用学习到的 reward model 或物理仿真误差替代 MLLM 判分,消除应试风险并降低判分开销;其五,训练效率——探索 off-policy 或异步 rollout 方法,减少 16 卡部署 MiniMax-H3 的开销;其六,把 execution reward 与 video reward 的退火推广为更一般的多目标奖励课程学习框架。
复现评估
开源情况良好:论文给出 GitHub 仓库(CYWang735/Video-Coder)和 HuggingFace 主页(Video-Coder),承诺完全开放数据、模型和代码,两个数据集(SFT-6k、RL-2k)与 Video-Coder Harness 都包含在内,基座 Qwen3.5-9B 公开。算力门槛较高:SFT 加 RL 需要 8 张 H100(约 3 天),RL 阶段还需额外 16 张 H100 部署 MiniMax-H3 支持 rollout 视频生成——若该生成器不可获取,复现 RL 需替换为等价开源视频模型并接受结果波动。真正的难点不在训练而在工程:Harness 需要沙箱化 Blender 渲染、check_script 静态检查、内容检查(空帧/静态/出画检测)和从头重跑验收机制,数据管线还依赖 Gemini 3.8 Flash 与 Seed2.0 等外部模型。建议路径:先下载开源权重跑推理验证场景编程能力,再用 SFT-6k 微调开源 9B 模型复现第一阶段(单机可做),最后逐步搭建 RL 环境;总体难度中等偏高,RL 复现受外部模型可用性制约最大。
论文图表
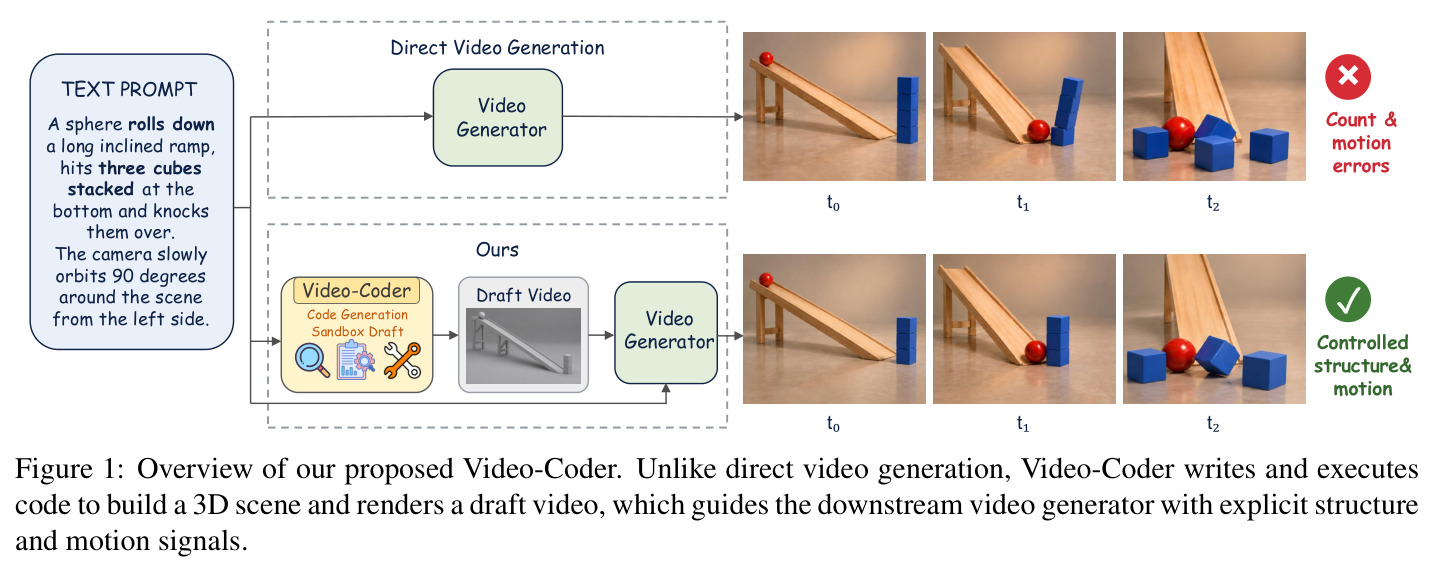
对比'直接视频生成'与本文方法两条路径:同一个 prompt(斜坡上滚下的球撞击底部三个叠放的立方体,相机从左侧缓慢环绕 90 度),直接生成在 t0/t1/t2 出现数量与运动错误(画叉),而 Video-Coder 先写代码、在沙箱执行构建 3D 场景、渲染草稿视频,再引导生成器得到受控结构与运动的正确视频(画勾)。
这是全文的范式宣言:一张图讲清'视频生成被重构为 agentic 编程任务'的核心思想,以及草稿视频如何从源头消除数量与运动错误,是理解后续所有设计的入口。