视频生成遇上智能体执行框架:智能体视频生成、智能体世界建模与递归自我改进 Video Generation Meets Agent Harness: Agentic Video Generation, Agentic World Modeling and Recursive Self-Improvement
以智能体执行框架为分析单元,综述视频生成走向自主生产、世界交互与自我改进的三大方向。
前置知识
扩散模型与流匹配(Diffusion & Flow Matching)
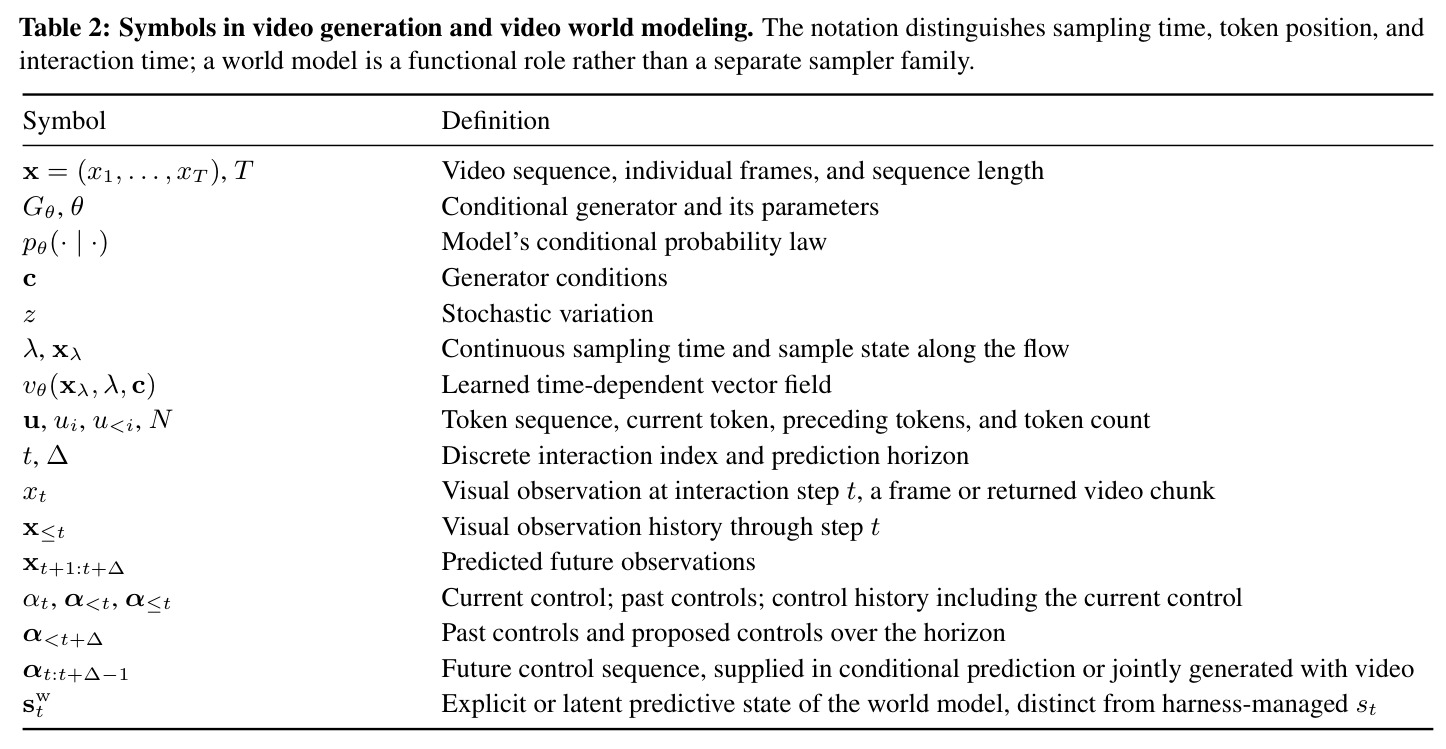
扩散模型学习逆转一个逐步加噪的腐蚀过程,通过反复去噪生成数据;流匹配则学习一个时间相关的向量场 $v_\theta(x^\lambda, \lambda, c)$,满足 $\frac{dx^\lambda}{d\lambda} = v_\theta(x^\lambda, \lambda, c)$,把简单分布的样本沿向量场输运到数据分布。现代大规模视频生成器(如 HunyuanVideo、Wan)通常在压缩的潜空间中用 Transformer 去噪器实现这两种范式之一。
本文所有讨论的基座都是这类条件视频生成器 $G_\theta$,建模 $x \sim p_\theta(x \mid c, z)$。理解条件 $c$ 可以被智能体拆解、构造和修订,是理解 harness 如何介入生成过程的前提。
自回归视频生成与流式执行
自回归范式把视频离散化为 token 序列 $u$,按 $p_\theta(u \mid c) = \prod_{i=1}^{N} p_\theta(u_i \mid u_{<i}, c)$ 逐段预测。流式(streaming)是一种执行模式:在完整视频生成完毕之前就逐帧/逐块输出,允许在生成间隔之间观察结果并更新控制信号,如 Self Forcing 和 Matrix-Game 2.0 的少步自回归扩散。
流式输出让 harness 有机会在生成过程中观察与干预,是交互式世界模型的接口基础;理解它才能区分"能流式输出"与"真正支持交互控制"这两个本文反复强调的不同性质。
智能体与执行框架(Agent & Harness)
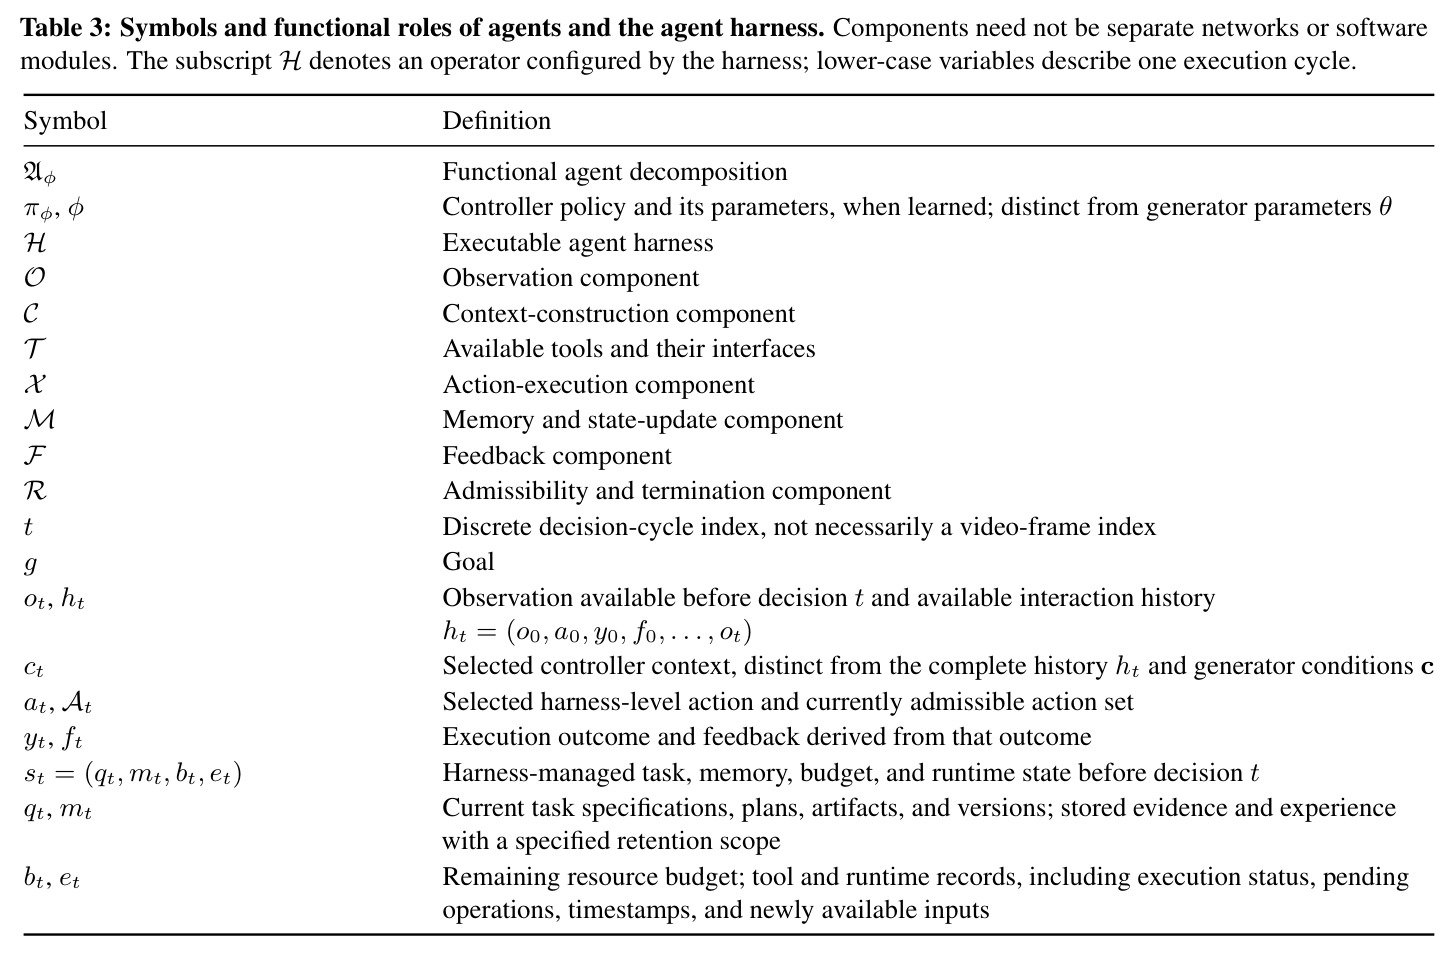
智能体是目标条件决策过程 $a_t \sim \pi_\phi(\cdot \mid g, h_t, A_t)$,可用 LLM 实现。Harness 则是围绕模型的**可执行运行时**:构造上下文、暴露工具接口、调度执行、维护状态、路由反馈、强制权限与预算,本文形式化为 $\mathcal{H} = (\mathcal{O}, \mathcal{C}, \mathcal{T}, \mathcal{X}, \mathcal{M}, \mathcal{F}, \mathcal{R})$,管理的状态为 $s_t = (q_t, m_t, b_t, e_t)$(任务、记忆、预算、运行时记录)。两者不可混为一谈:智能体提议做什么,harness 决定什么能真正运行、什么会持久化。
这是全文的分析单元。作者的核心立场是:应当以"围绕视频生成器的 harness"而非生成器本身来组织综述,理解这套记号系统是读懂三个核心章节的钥匙。
视频世界模型
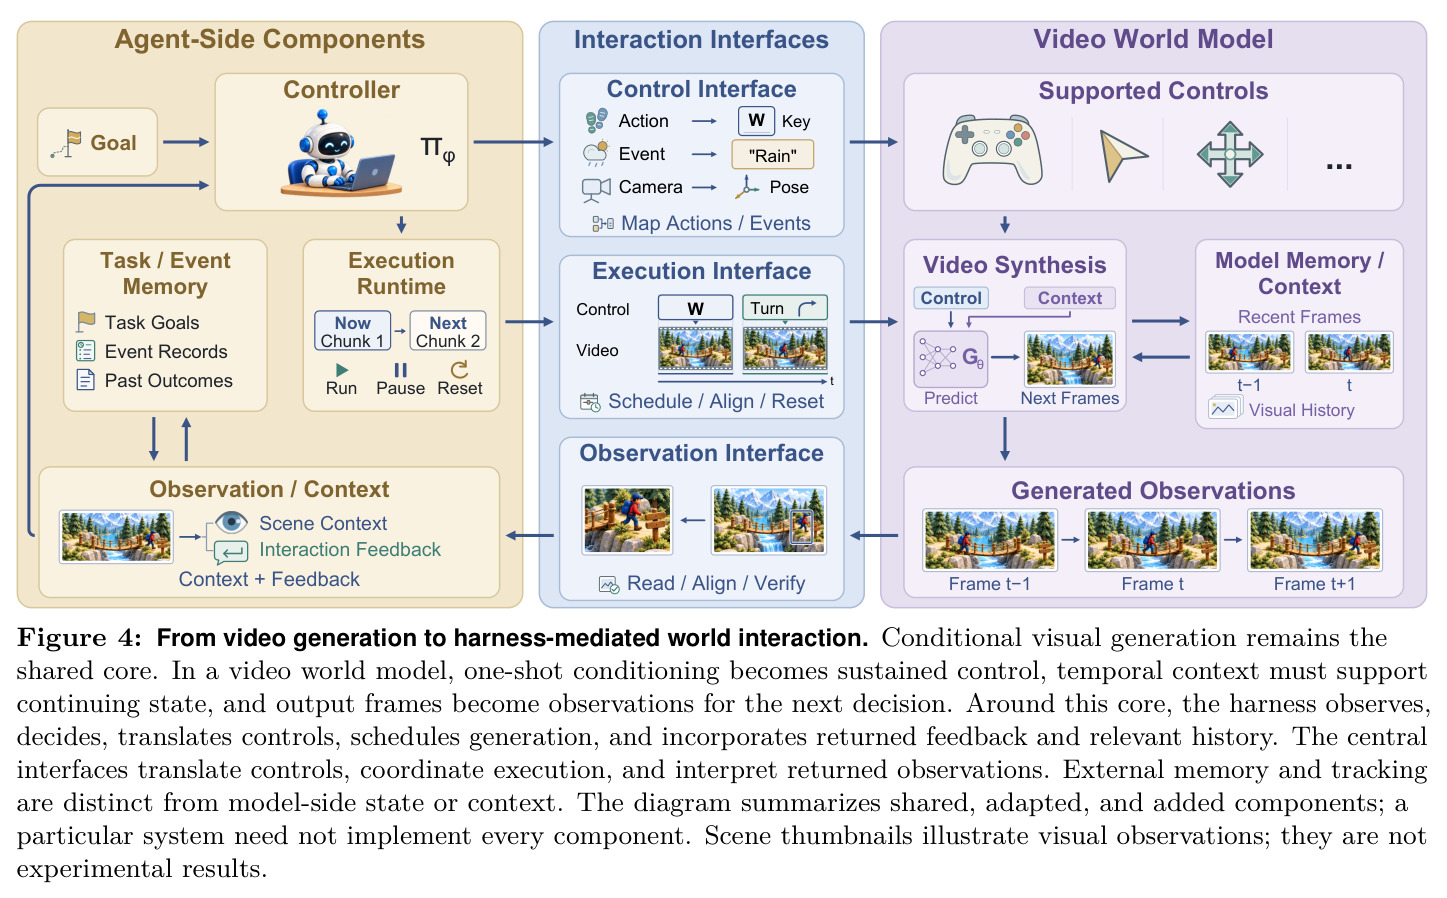
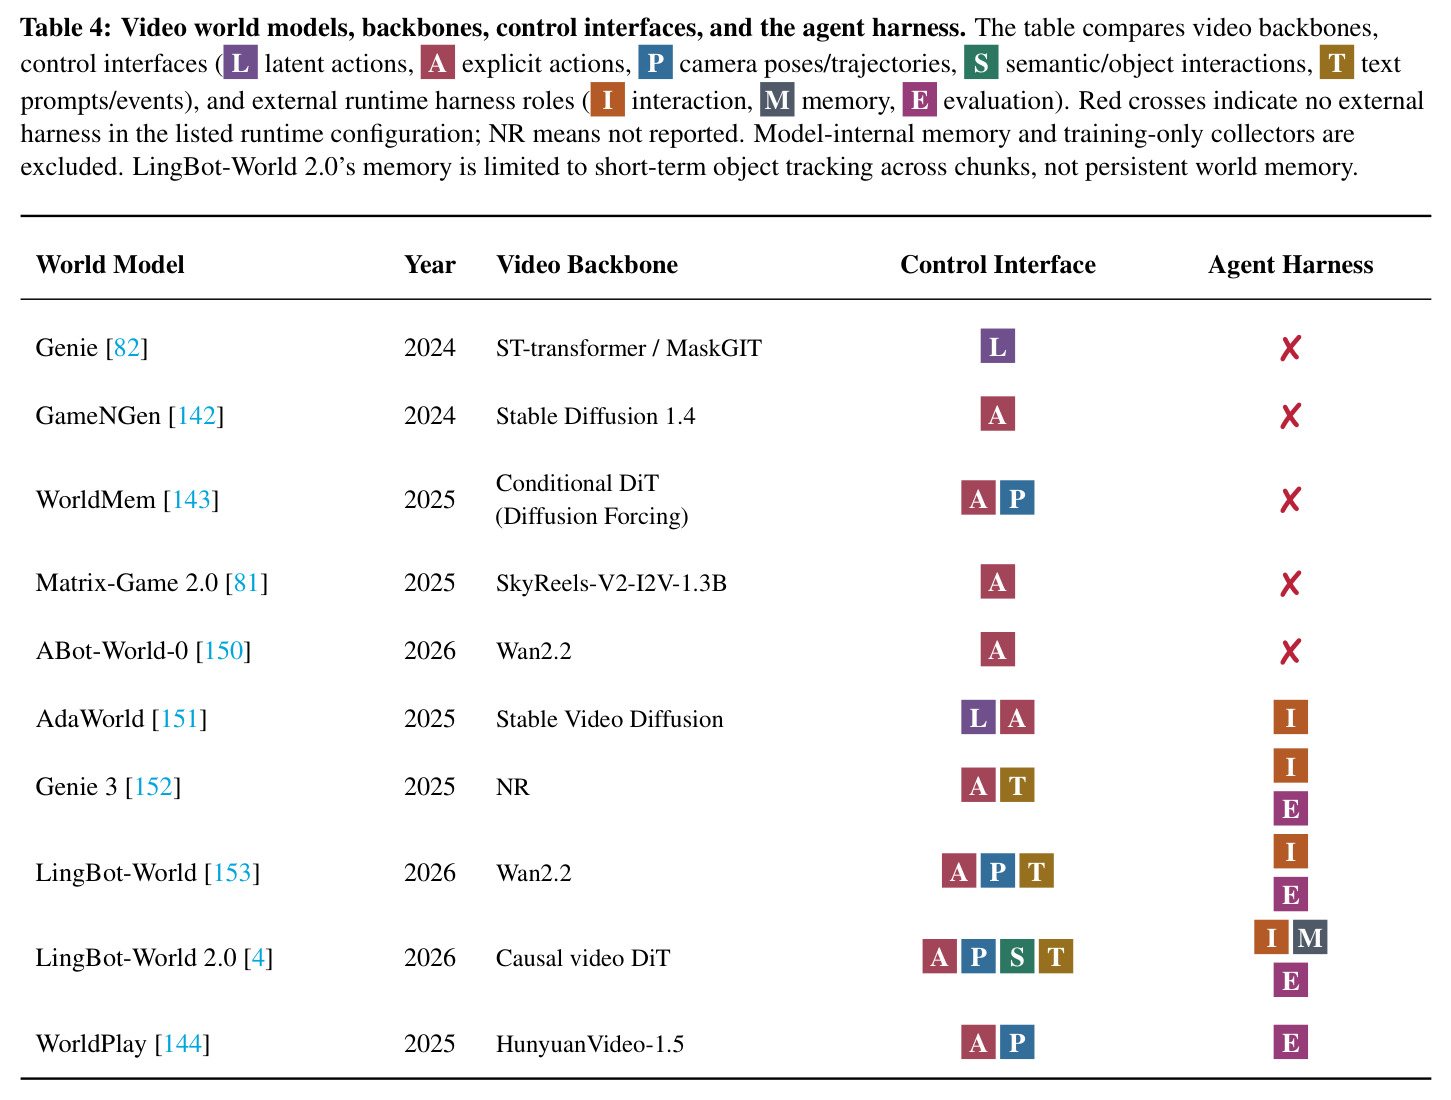
指从视觉历史与控制信号预测未来视觉观测的学习模型:$x_{t+1:t+\Delta} \sim p_\theta(\cdot \mid x_{\le t}, \alpha_{<t+\Delta}, c)$,其中 $t$ 是交互步索引而非采样步,控制 $\alpha$ 可以是键盘输入、相机轨迹、机器人指令或隐动作。代表系统包括 Genie(学习隐动作)、GameNGen(扩散模型模拟游戏)、LingBot-World 2.0 等。长而逼真的视频本身不构成世界模型,控制保真度与交互后果的连续性必须被经验验证。
第二核心章节讨论 harness 如何把生成器组织成可持续交互的环境,以及如何评估这种交互的可靠性(长时程一致性、干预敏感性、约束一致性)。
递归自我改进(Recursive Self-Improvement, RSI)
指系统能改进"产生后续改进的流程本身"。本文用 $\xi_k$ 表示第 $k$ 轮的持久状态(数据、模型、critic、可复用 harness 状态),$\rho_k$ 表示开发流程(测试、数据选择、更新规则),形式化为 $(\xi_{k+1}, \rho_{k+1}) = U(\xi_k, \rho_k; L_k, F_k, B_k)$。关键区分:固定 $\rho_k$ 重复执行是迭代改进;只有对 $\rho_k$ 的修改被独立评估证实能让后续轮次更有效,才构成 RSI。
这是全文最具批判性的概念工具。作者用它证明:当前所有已调查系统都没有实现真正的 RSI——没有系统修订过训练和验证生成器的流程。
显式世界状态与生成式渲染
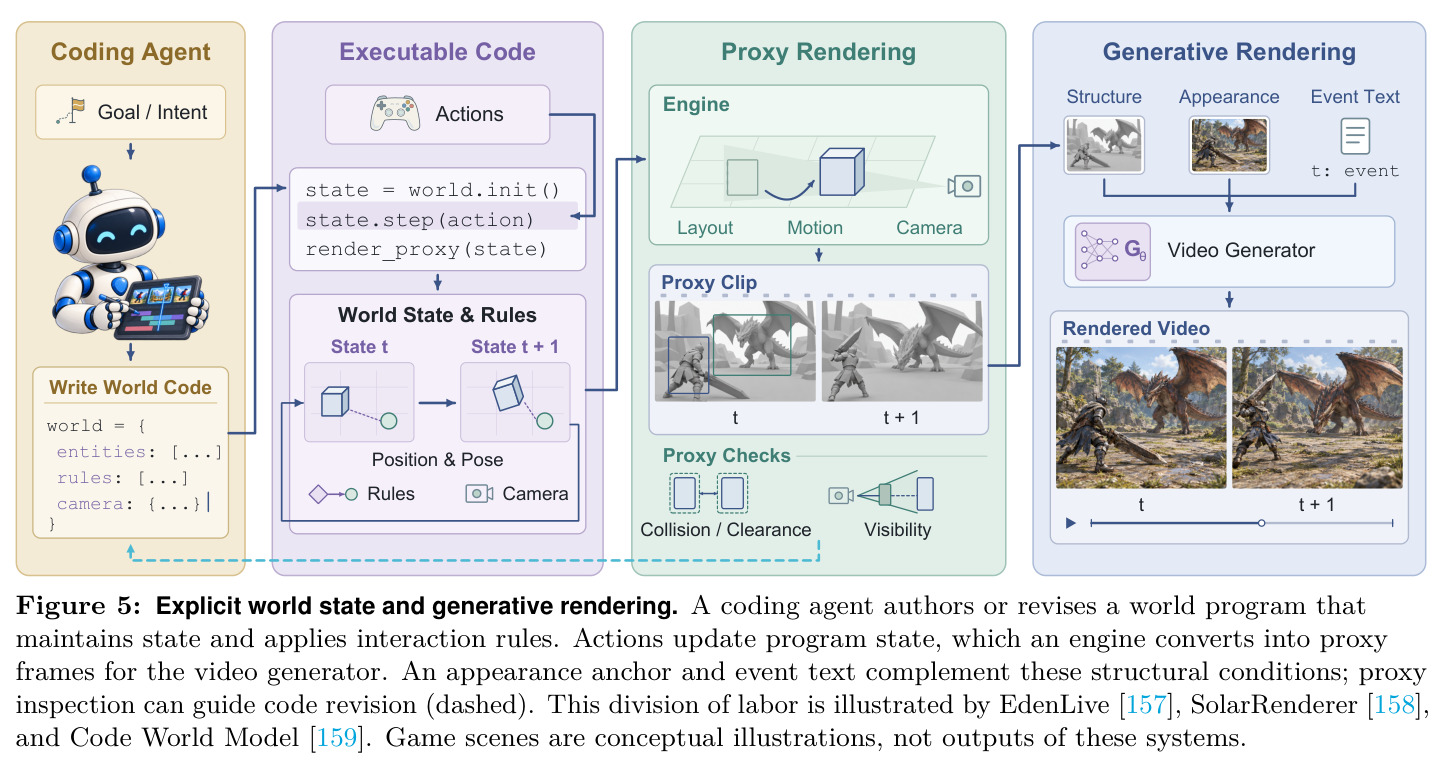
一种新的分工设计:游戏引擎、模拟器或编码智能体编写的程序持有世界状态并执行交互规则,视频模型只负责把引擎产出的粗结构(低多边形帧、G-buffer、语义图、3D 包围盒)渲染成逼真画面,即 $x \sim p_\theta(\cdot \mid (c_{base}, \mathrm{Render}(\mathcal{P})), z)$。生成器从"模拟器"降格为"渲染器",harness 可直接读写程序状态而非从帧中估计。
这是 2025–2026 年涌现的最重要范式转变(Matrix-Game 4.0 称之为可执行游戏 harness),也是理解混合代码-像素生成这一未来方向的基础。
研究动机
视频生成器已经能产出日益逼真、可控、时间连贯的片段,但单独一个生成器无法组织完成视频任务所需的完整决策链:一份创意简报必须被拆解成连贯的镜头序列;角色参考资产必须跨场景持久存在;每个候选镜头(take)需要被检查;剪辑必须保留已正确的部分。更麻烦的是,视频把决策在时间上强耦合——参考会影响后续镜头,动作会改变后续观察,而局部修复可能破坏别处的时间一致性。一段视觉上合理的片段仍可能违反叙事要求或未能实现预期的动作效果,因此单一的画质分数几乎无法指出"下一步该做什么"。在交互场景下,视频还必须支持基于观察的连续动作,而不只是产出一段成品。作者指出,现有综述各自覆盖生成模型、时空一致性、后训练对齐、世界模型或智能体系统,但没有一个以"围绕视频生成器的 harness"为分析单元,统一覆盖内容生产、世界交互与模型开发这三个场景。
本文的目标是本文要建立一个以 agent harness 为中心的统一框架,回答三个递进的问题:第一,harness 如何组织智能体视频生成——协调规划、执行、工具调用、记忆、剪辑与水印,以及评估这类系统时必须区分什么;第二,harness 如何整合进视频世界模型——在观察、控制、执行、事件组织与状态管理的哪些位置介入,特别是引擎或编码智能体所写程序持有世界状态、视频模型负责渲染的设计;第三,视频生成系统如何走向递归自我改进(RSI)——基础模型改进、harness 改进与评估如何反馈进产生后续模型改进的流程,以及需要哪些机制和证据。最终目标是给出一份覆盖生产、交互、开发三个设置的导航图,并明确评估要求与开放挑战。
与已有工作不同的是,与已有工作的关键差异在于分析单元的选择。Wu et al. 等能力阶梯视角把智能体生成和世界建模视为生成器的连续演进阶段,而本文把生成器周围的 harness 当作分析单元,用一个框架同时覆盖三种设置。此外,本文引入了一套此前综述缺失的概念区分:反馈在不同时间尺度上改变不同对象——修订当前产物(改 prompt 或换 take)、保留技能服务后续任务、更新数据集/critic/生成器参数影响未来模型版本、修改产生后续更新的流程本身,这些不应混为一谈;修好当前一段视频并不等于未来能力提升。由此本文形式化了 RSI(对开发流程 $\rho_k$ 的经验证修改),识别出改进可以重入视频开发的四个通道(失败诊断、数据策划、训练、验证),并给出一个关键论断:截至该综述,没有任何已调查系统实现了对"训练与验证生成器流程"的修订——这为整个领域的现状提供了一个清醒的基线判断。
核心方法
直觉上,这篇综述的出发点是:视频生成正从端到端合成走向智能体生成,而转变的枢纽不是新模型架构,而是围绕生成器的可执行运行时——harness。作者先建立统一词汇:视频生成为条件时空建模 $x \sim p_\theta(x \mid c, z)$,覆盖扩散/流匹配、自回归 token 模型与流式执行;harness 形式化为 $\mathcal{H} = (\mathcal{O}, \mathcal{C}, \mathcal{T}, \mathcal{X}, \mathcal{M}, \mathcal{F}, \mathcal{R})$,其状态 $s_t = (q_t, m_t, b_t, e_t)$ 分别承载任务与工件版本、记忆证据、剩余预算、运行时记录。一个决策周期为:构造观察 $o_t = \mathcal{O}_H(g, s_t)$ 与上下文 $c_t = \mathcal{C}_H(g, o_t, s_t)$,确定可容许动作 $A_t = \mathcal{R}_H(g, s_t; \mathcal{T})$,控制器采样 $a_t \sim \pi_\phi(\cdot \mid c_t, A_t)$,执行得 $y_t$,路由反馈 $f_t$,最后提交 $s_{t+1} = \mathcal{M}_H(s_t, a_t, y_t, f_t)$。随后把这个循环映射到三个设置:生产($q_t$ 是含需求、计划、资产、候选视频的项目)、世界交互($q_t$ 是生成观察与场景状态)、开发($q_t$ 是数据、监督、checkpoint 与评估记录),分别对应第 3、4、5 章。
核心创新在于两点。其一是用一套统一记号把"智能体决策"与"harness 执行"清晰分离:控制器提出做什么,harness 决定什么能真正运行、什么会持久化,工具和环境产生后果。这带来精确的归因能力——改变生成器参数 $\theta$、控制器参数 $\phi$、harness $\mathcal{H}$ 或预算,都可能提升端到端效果,但原因各不相同;运行时反馈可能在 $\theta$ 和 $\phi$ 都固定的情况下修订上下文、计划或记忆。其二是把"改进"按对象分级:修订当前输出(within-task)、更新 harness 持久状态 $\xi_k$(记忆、规则、技能、训练出的控制器权重)、更新生成器参数与评估器、最后是修订产生后续更新的开发流程 $\rho_k$。RSI 只属于最后一级,且要求修改被保留并在后续任务或开发轮次上独立评估。本质区别是:过去综述把"智能体生成"和"世界建模"当作生成器的能力阶梯,本文证明它们其实是 harness 在不同设置下的不同实例化,而改进是否"递归"取决于修改的是数据与模型还是流程本身。
方法步骤详情
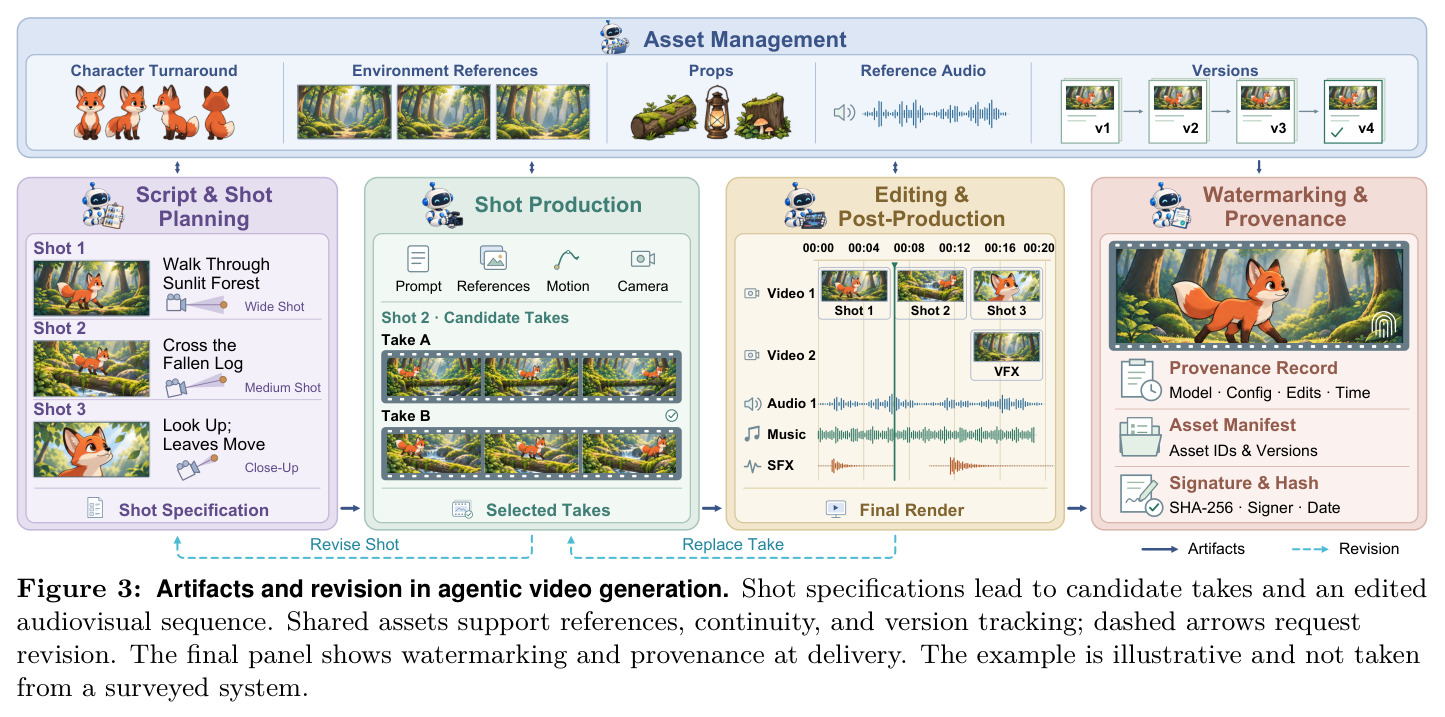
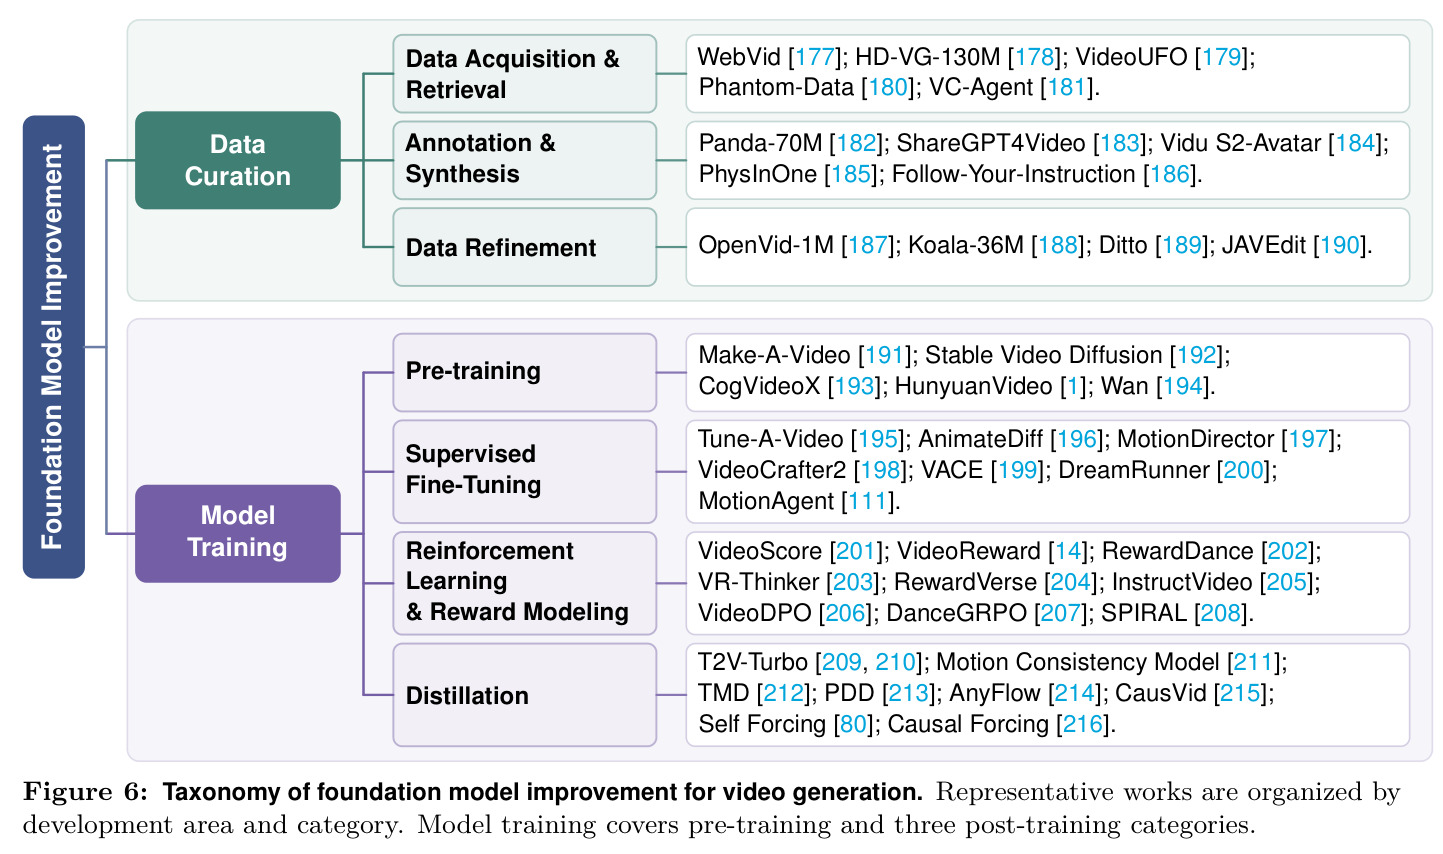
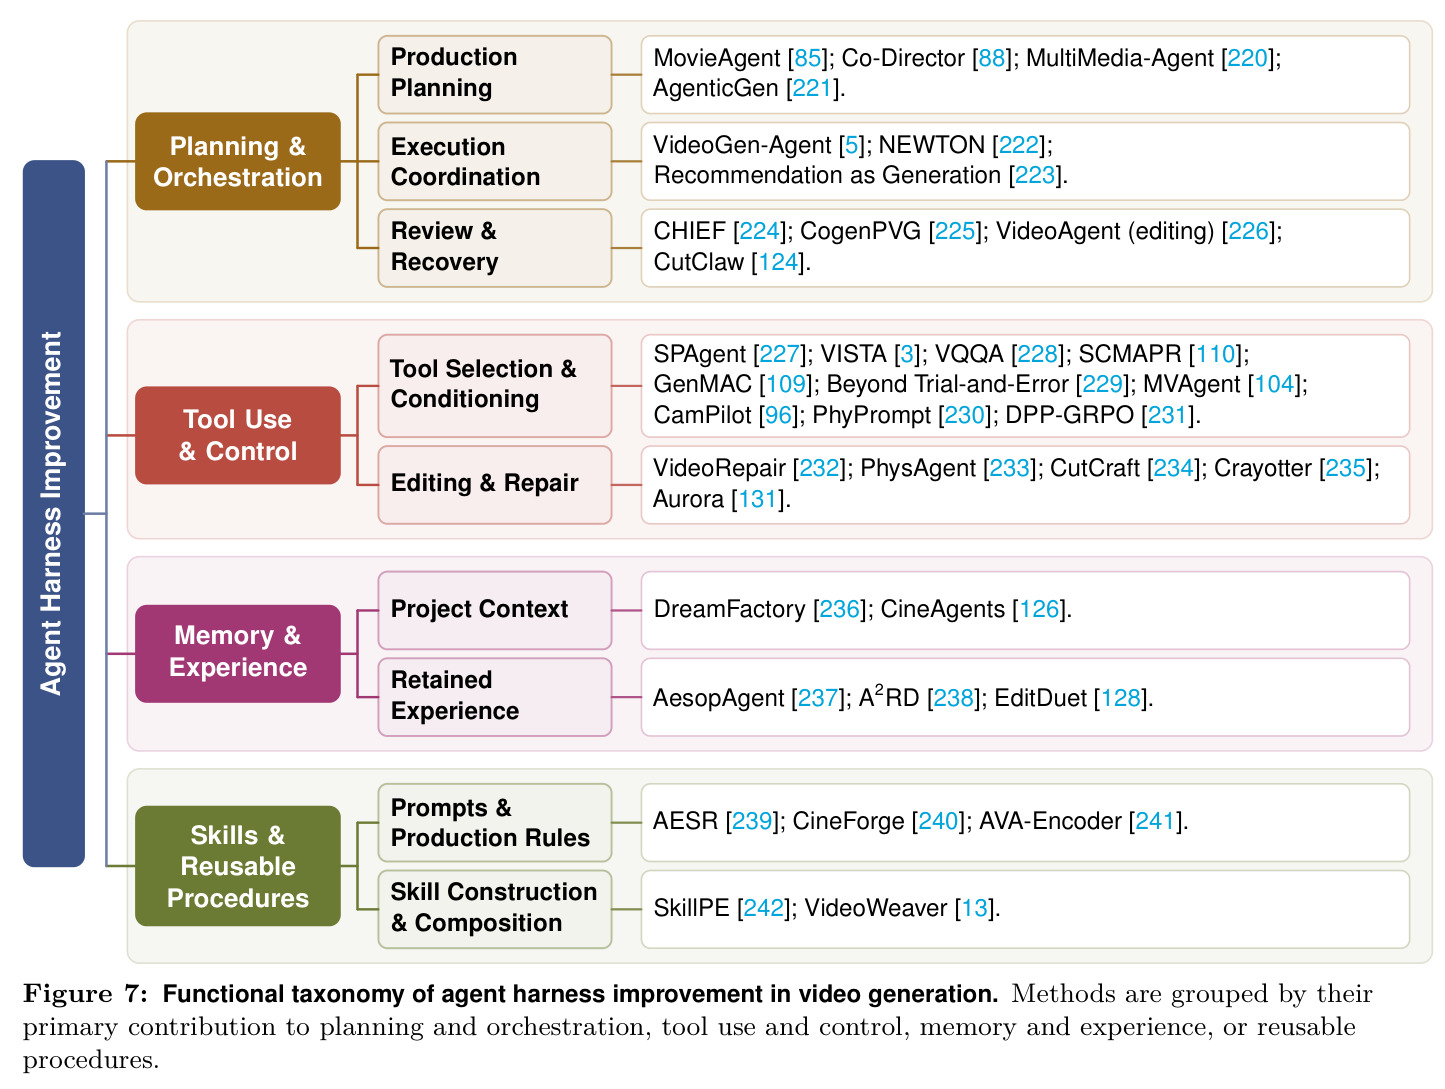
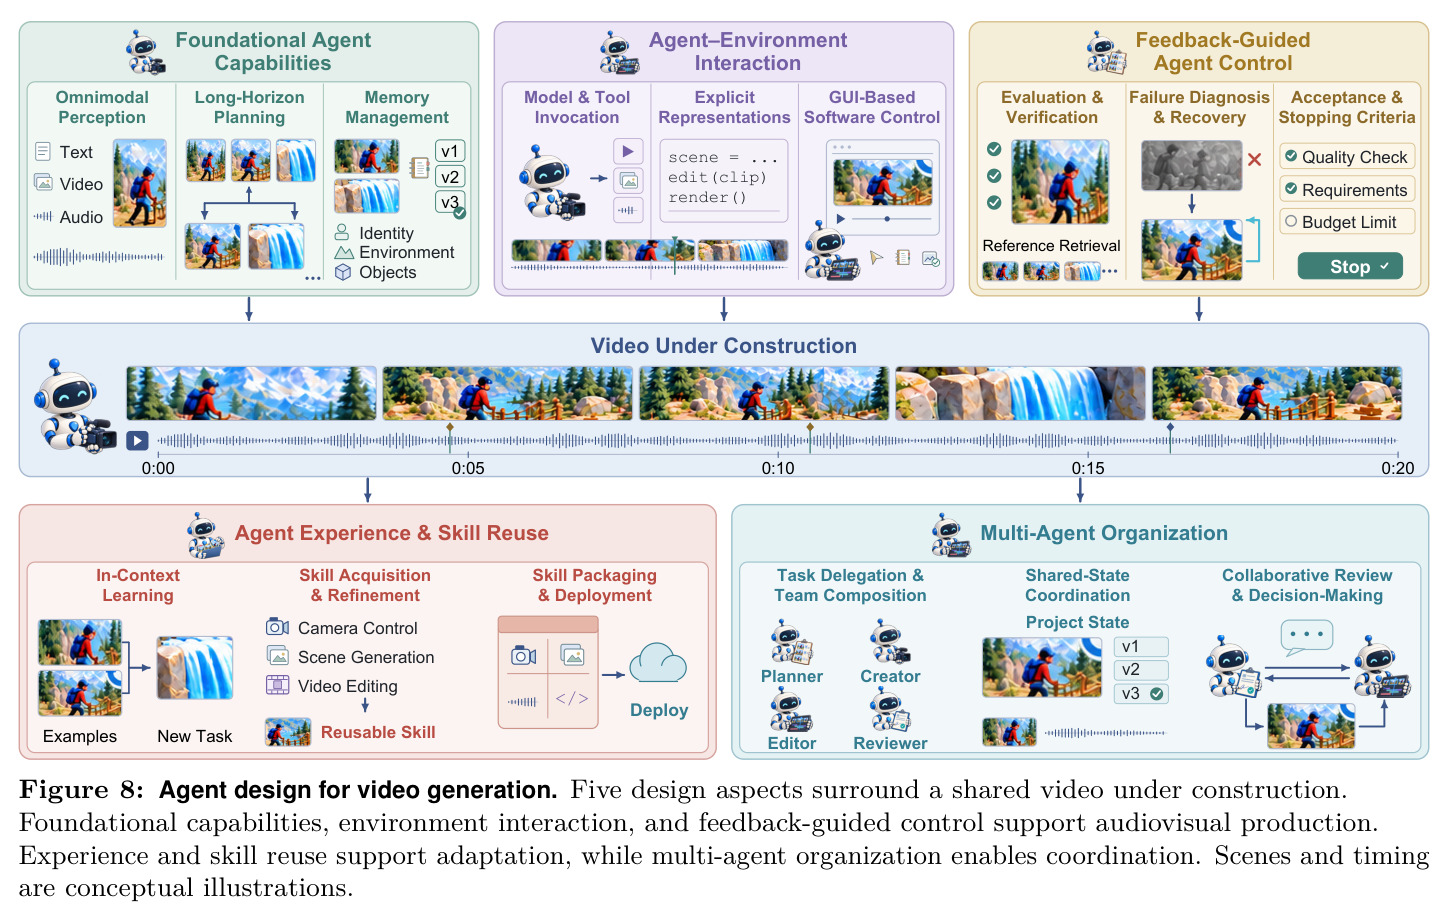
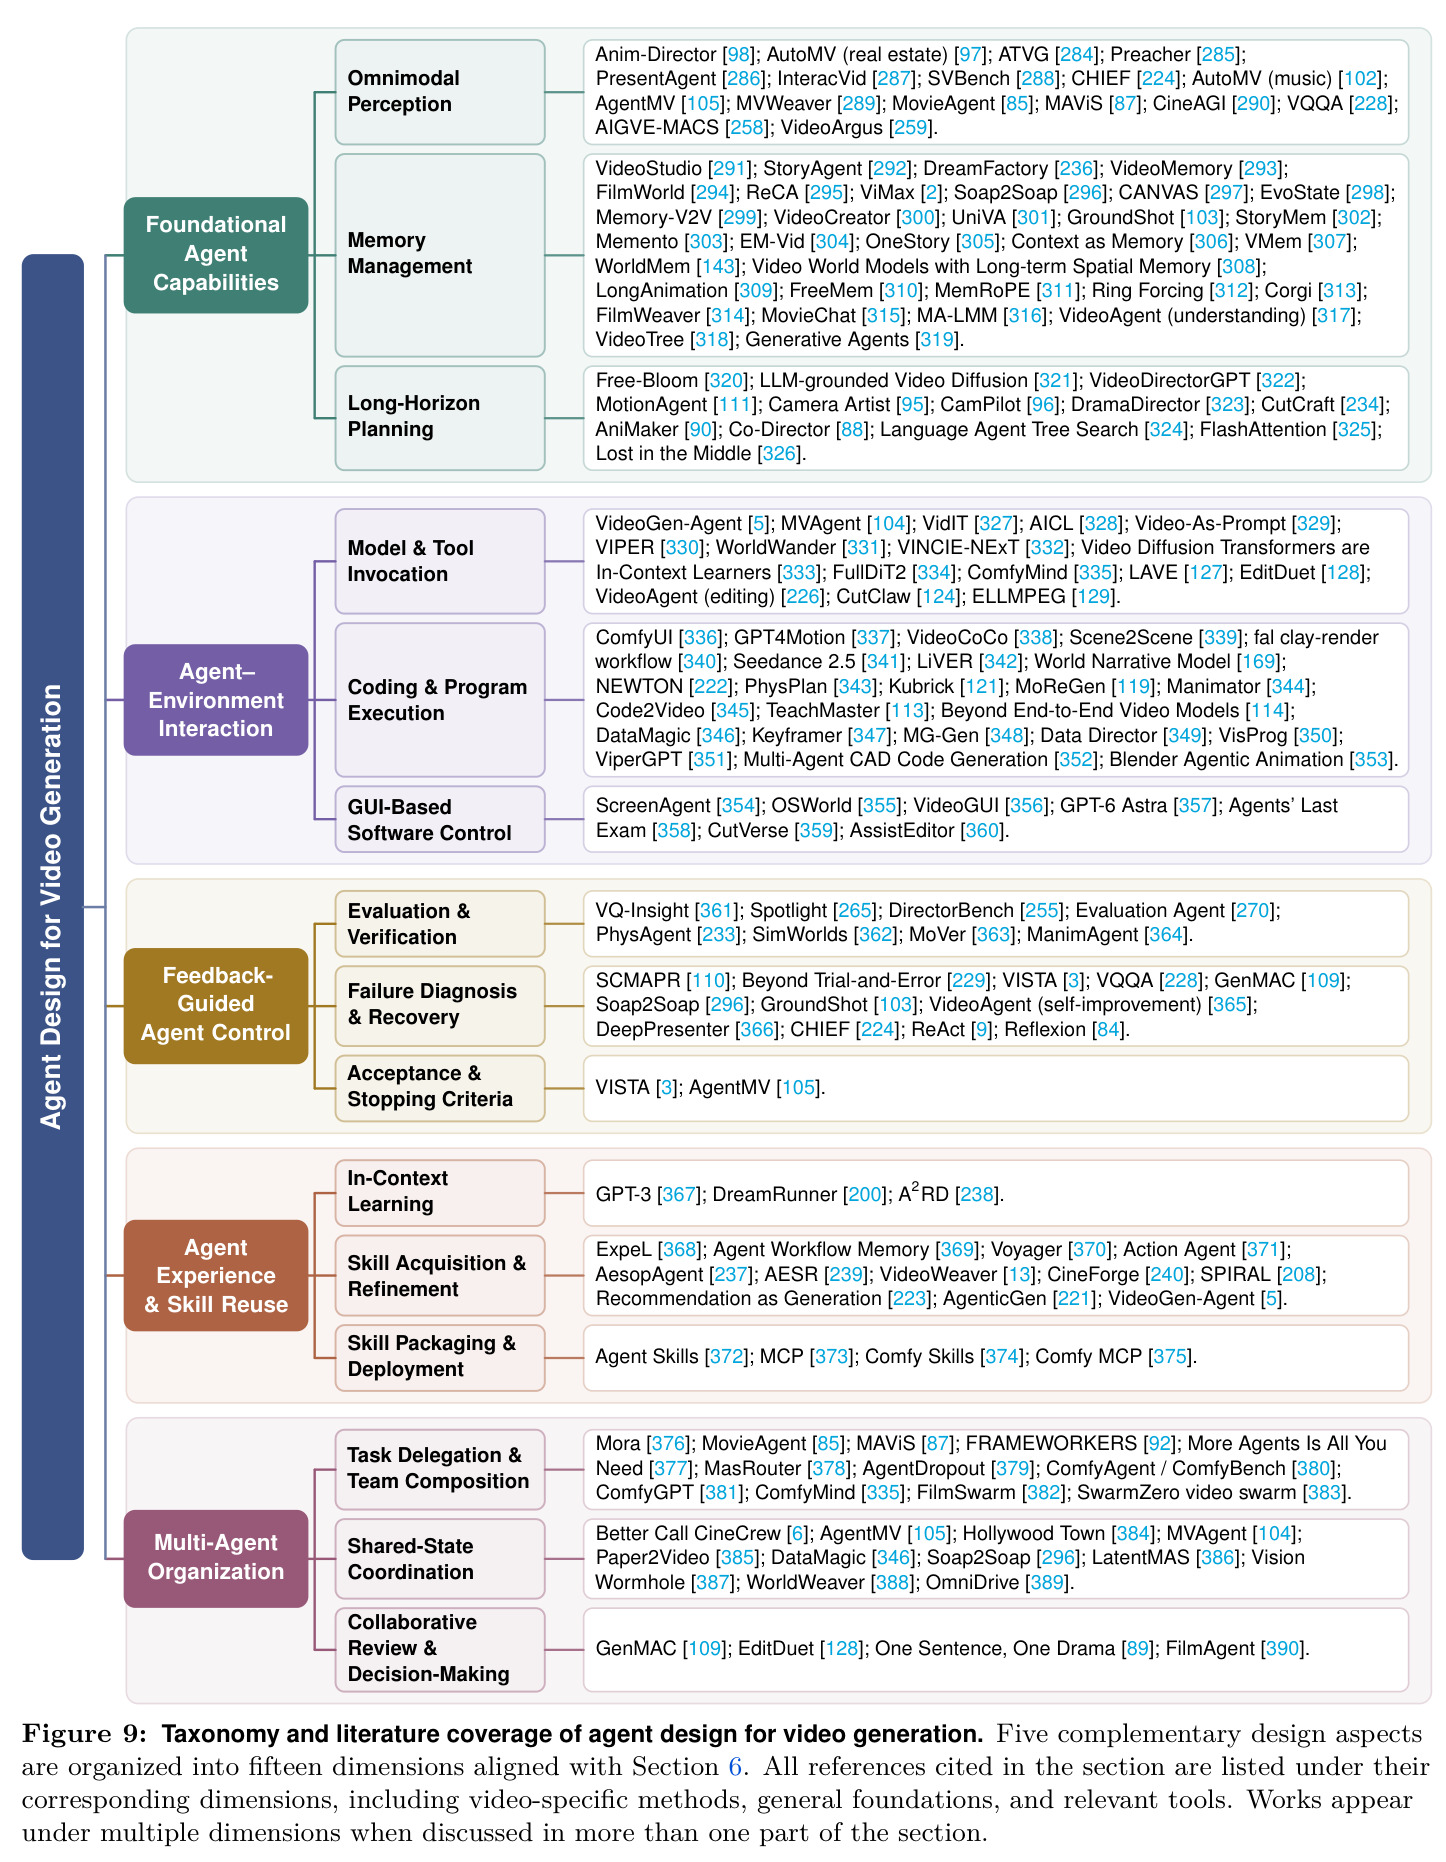
论证分五步。第一步(第 2 章)确立基础:区分采样时间 $\lambda$、token 位置与交互索引 $t$,定义世界模型预测 $x_{t+1} \sim p_\theta(\cdot \mid x_{\le t}, \alpha_{\le t}, c)$ 及带显式预测状态的 $s^w_{t+1} \sim p_\theta(\cdot \mid s^w_t, \alpha_t, c)$,并划分内部 critic(终止前提供诊断供策略调整)、外部评估器(报告但不控制运行)、奖励模型(给标量但不指定动作)与编辑器(属工具 $\mathcal{T}$,改工件而非产证据)的角色边界。第二步(第 3 章)按工作流功能组织智能体视频生成:剧本与镜头规划、资产管理、镜头生产(模型生成/代码动画/3D 仿真)、剪辑与后期、水印与溯源,并对比一致性放在 harness 记录(可检可修可复用、允许单镜头重生成)与模型上下文(无需记录簿但受注意力限制)两条路线。第三步(第 4 章)按干预接口组织世界建模:语义/事件机制、状态/反馈机制,以及显式世界状态+生成式渲染设计——编码智能体写世界程序,引擎产代理帧并做碰撞、遮挡等渲染前检查,视频模型只负责渲染。第四步(第 5 章)按改进对象组织 RSI:数据策划、模型训练(预训练/SFT/RL 与奖励/蒸馏)、harness 四组件(规划编排/工具控制/记忆经验/技能复用)、评估双视角。第五步(第 6 章)归纳五大智能体设计方面共十五个维度,最后提出七个开放挑战。
技术新颖性
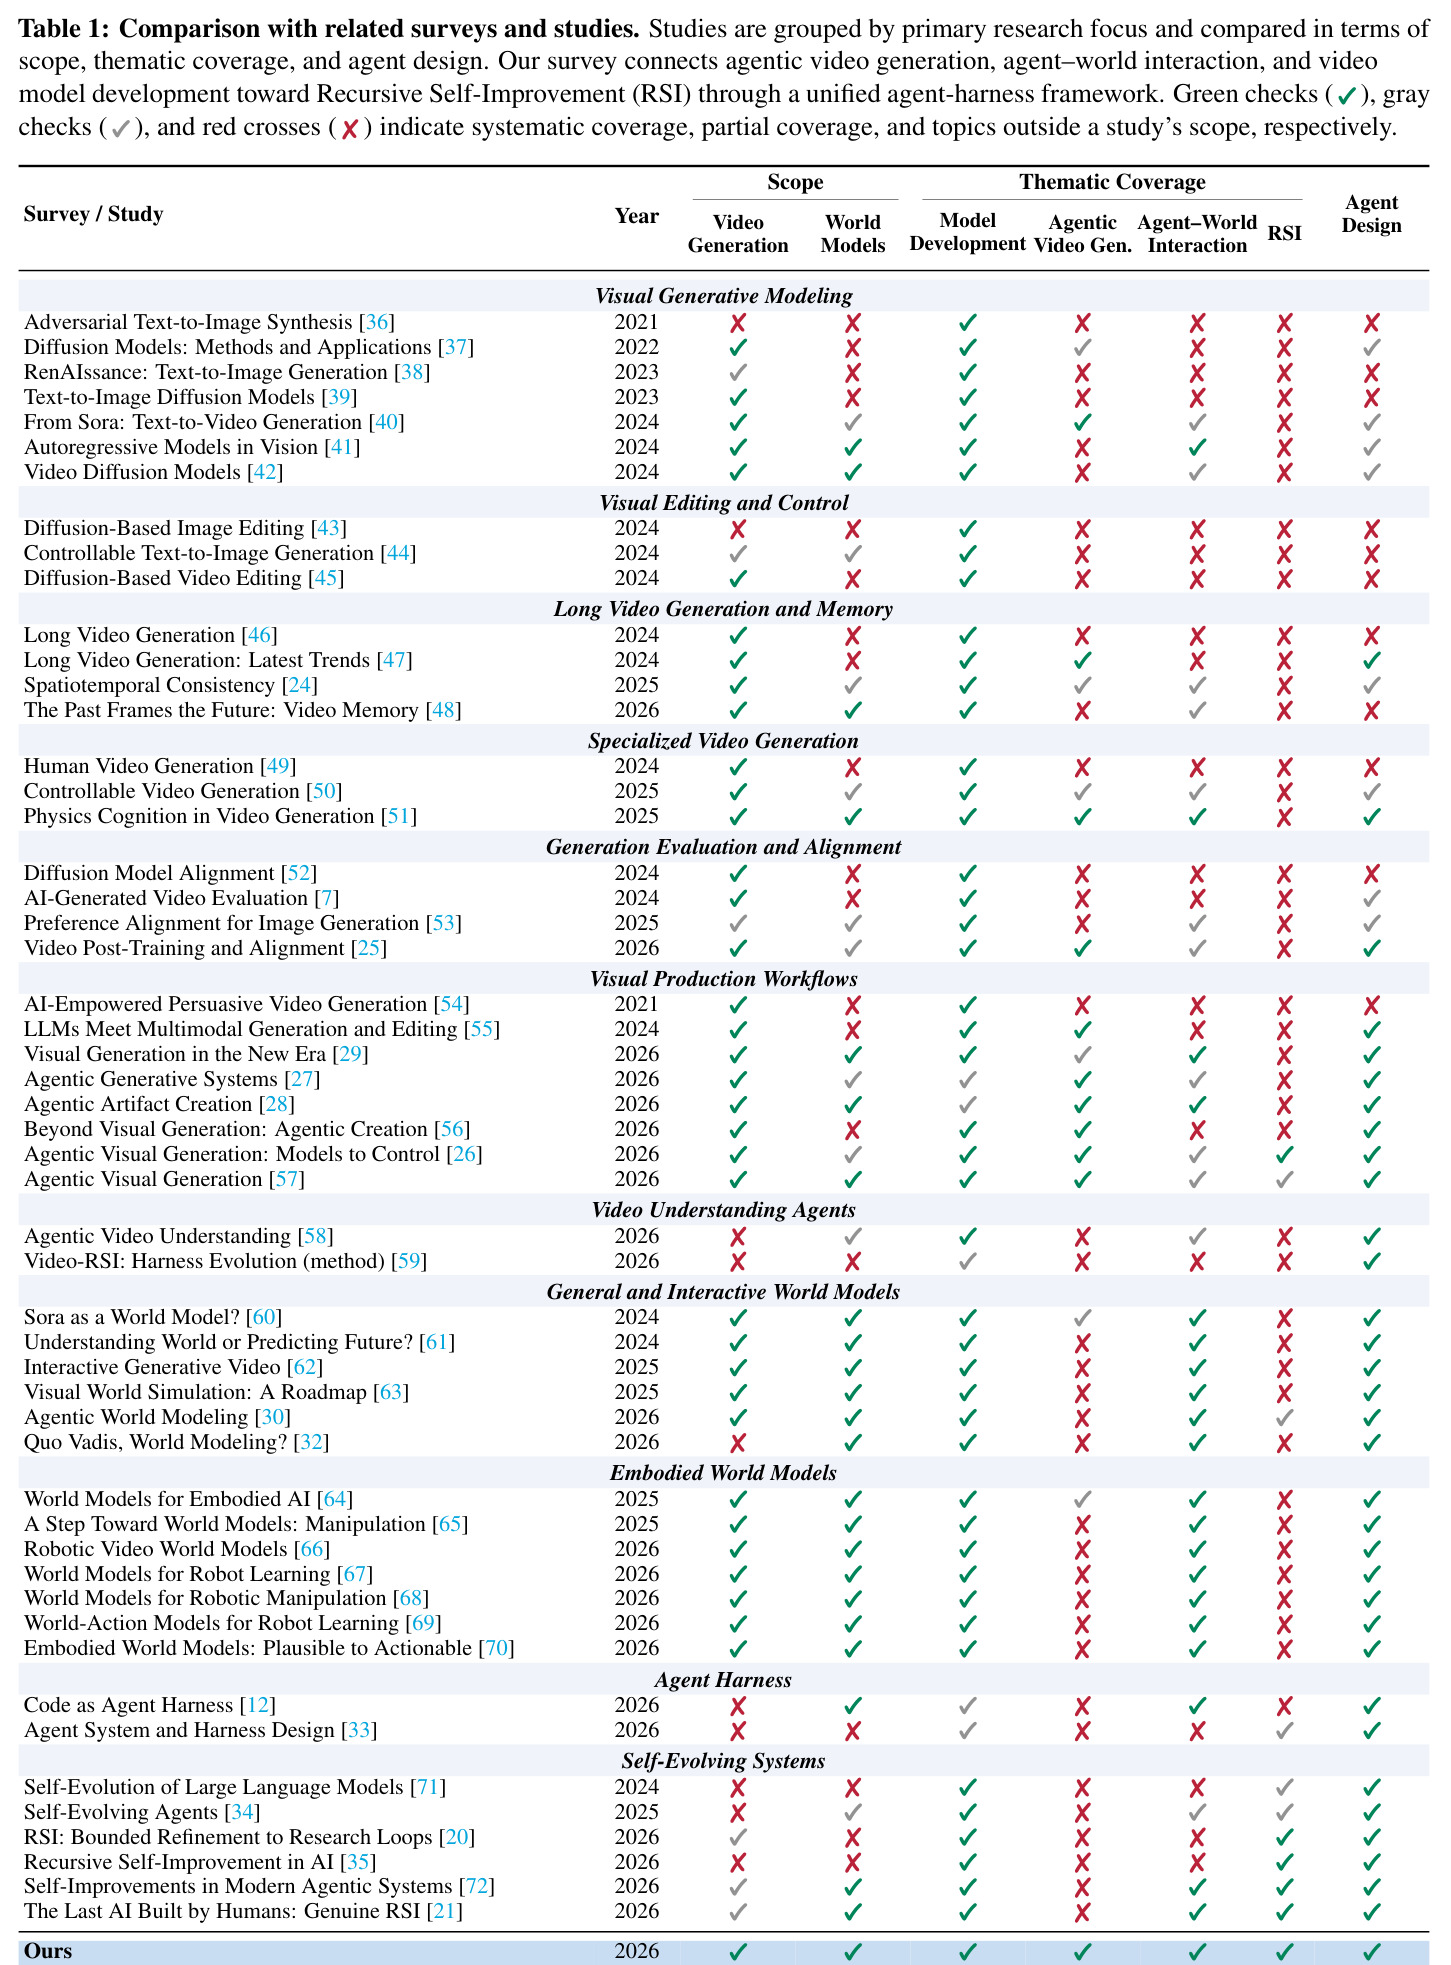
新颖性体现在三个层面。首先是分析单元的转移:Table 1 对比了约 50 篇相关综述(从 2021 年对抗式文生图到 2026 年 RSI 专论),此前没有任何一篇同时系统覆盖智能体视频生成、智能体-世界交互与视频版 RSI;能力阶梯视角把两者当作生成器的演进阶段,本文证明它们其实是 harness 在不同设置下的实例化。其次是概念工具的新:$\mathcal{H}$ 七元组分解、$s_t$ 四元组状态、critic/评估器/奖励模型的角色边界、以及 $(\xi_k, \rho_k)$ 的开发过程形式化,为跨系统比较提供了共同语言,使归因成为可能——运行时反馈可以在 $\theta$ 和 $\phi$ 都固定的情况下修订上下文、计划或记忆。第三是批判性定位的新:作者明确断言已调查系统均未修订开发流程 $\rho_k$——JAVEdit(保留验证过的流水线修复)和 VideoWeaver(creator skills 构建进一步工作流)只是最接近的方向;通用领域的 Darwin Gödel Machine 与 RRSI 修订的是智能体自身代码,尚未延伸到视频生成器的训练与验证流程。此外,本文系统地把 2025–2026 年涌现的"显式世界状态+生成式渲染"设计(Matrix-Game 4.0、EdenLive、Magpie、Code World Model 等)纳入统一框架,指出其中干预变成对程序状态或规则的编辑、观察接口可直接读程序状态、视野外对象持久存在。
实验结果
作为综述,其"结果"是一系列结构性发现与批判性判断。发现一:智能体视频生成的一致性可放在 harness 记录或模型上下文中维护——多镜头生成器(Long Context Tuning、HoloCine 用窗口交叉注意力整场景生成)无需记录簿但受限于可注意的场景范围;harness 方案(GroundShot 按"作为未来参考的价值"调度镜头并验证后再入库、MVAgent 把持久外观参考与镜头末状态分离)把一致性放进可检查、可修正、可复用的显式记录,代价是每条记录都要正确供给生成器。发现二:显式世界状态+生成式渲染范式已具备实时能力——Magpie 在单张 H100 上约 32 FPS(基于 300 小时 Unreal Engine 交互游玩数据),端到端响应约 1.55 秒;AgentGarten 四步去噪超 35 FPS;EdenLive 在消费级 GPU 上至少 24 FPS;Matrix-Game 4.0 在单张 RTX 5090 上以一到两步去噪渲染四帧块,480p 下 60 FPS、按键到显示仅 112 毫秒;AlayaRenderer-Flash 把 G-buffer 渲染器从 0.56 提升到 31.54 FPS。发现三:RSI 尚未在视频生成中实现——现有系统大多在固定流程下更新开发状态 $\xi_k$,JAVEdit 保留验证过的流水线修复是最接近流程修订的例子,但没有系统证明修订后的流程能让后续开发轮次更有效。发现四:评估存在系统性缺陷——DirectorBench 发现单元间转场是长视频工作流得分最低的部分;"Don't Read the Log"发现被测 Qwen-VL 裁判存在执行日志偏差;当裁判同时提供训练反馈时,需独立评估区分真实质量提升与奖励过优化。
局限与改进
作者自己承认的核心局限是证据薄弱:第 4 章明确写道大多数 harness 机制只在单一系统中演示或仅作为设计提出,很少有研究报告可归因于 harness 本身的增益——例如 LingBot-World 2.0 的 Director–Pilot 框架只有交互演示,没有可归因于 harness 的孤立量化增益。其次,部分文献覆盖不足:agent swarm 类项目(FilmSwarm、SwarmZero)只确立了整合模式而非受控证据,不构成去中心化智能或最终视频质量提升的证明。第三,混合动态(programmed + learned dynamics)如何在一个世界中结合仍是开放问题:程序世界只能表达程序所代表的内容,规则外事件需要新代码或回退到学习动态。我自己的观察有四点:一是记号系统庞大(Table 2、Table 3 共数十个符号),形式化虽然优雅,但 $\mathcal{H}$ 的七元组分解在具体系统对比中的操作性存疑——多数被调查系统并未按这套记号报告,读者需自行映射;二是分类按"主要贡献"放置系统,多功能系统(如 VideoGen-Agent 同时涉及规划、工具、记忆、参数训练)的归类带有主观性,图 7 的分类学更像组织工具而非可检验假设;三是"改进重入通道"的识别停留在概念层面,每个通道现有证据的强弱、验证协议应如何设计只有定性讨论;四是对"RSI 尚未实现"的判断依赖当前文献快照,视频领域迭代极快,这一结论的时效性可能很短。
独立分析的弱点
独立分析这篇综述的弱点:第一,它完全不提供量化对比实验,所有数字(32 FPS、112ms、0.56→31.54 FPS 等)都是转述各原始系统在各自设置下的报告,彼此没有统一口径,读者无法据此判断哪个 harness 设计更优——讽刺的是,这正是综述自己在 5.3 和 7.5 节批评的现象(缺少统一成本核算协议)。改进方向:按其框架对若干代表性系统做受控复测。第二,harness 概念缺乏可度量的操作化定义:$\mathcal{H}$ 的七元组描述了职责,但没给出测量各组件贡献的协议,"归因于 harness 的增益"在实践中难以剥离——综述建议匹配采样预算、控制模型与工具版本,却没有给出具体实验设计。改进方向:为每个 harness 组件定义消融套件,如关闭记忆检索或固定反馈路由后的性能对比。第三,对 RSI 的讨论偏保守:识别出的重入通道(失败诊断、数据策划、训练、验证)只指出改进可以重入的位置,对每个通道现有证据强度、达到 RSI 所需的最小验证协议缺少可执行路线图。改进方向:给出一个最小可行的流程修订实验——如允许系统根据失败诊断自动修改数据过滤规则,并在独立任务集上验证后续轮次更新的质量与成本。第四,术语密度过高且部分自造(executable game harness、proxy checks 等),对初学者门槛偏高,GitHub awesome 列表提供了导航但没有分级阅读路径。
未来方向
作者在第 7 章提出七个开放挑战:一是完全端到端视频制作——从创意到成片全程自主,当前最大缺口是跨单元转场质量(DirectorBench 证实这是最低分环节)和基于创作意图与预算的验收/停止标准;二是终身记忆——需区分项目特定记录(已接受的角色参考、事件历史)与可迁移经验(成功的工具配置、修复策略),记忆条目应保留来源、时间范围与工件版本;三是混合代码-像素生成——Genie 4 公告已明确把混合世界模型列为方向(Gemini 负责场景结构与叙事规划、Genie 负责视听仿真),关键挑战是保持程序状态、智能体记忆与生成观察三者对齐;四是无人类自主开发——harness 独立诊断弱点、获取数据、设计实验、验证候选,最大暴露点是评估器同时负责选数据和接受更新,需要独立验证与可恢复的模型版本;五是效率——需要统一核算协议,把生成、审查、被拒候选与验证全部计入;六是溯源与安全——把工具-工件记录扩展为每个已接受版本的签名溯源(类似 C2PA),并把身份资产的复用授权绑定到资产本身;七是新兴任务——自动游戏创作(从可玩轨迹到完整规则的鸿沟)、自适应交互叙事、智能体测试场景生成。基于这些成果可延伸的方向:为 harness 组件建立标准消融基准、设计 RSI 验证的独立任务集协议、把程序化世界与学习动态的混合做成生成器原生接口。
复现评估
作为综述,本文没有需要复现的模型或实验,"复现"的意义在于使用其框架和资源。可复用资源相当充足:项目网页(agentic-videogen.github.io)和 GitHub 仓库(awesome-agentic-videogen)持续维护被调查工作的分类列表,论文内 Figure 2 的进化图、Figure 6/7/9 的三张分类学图谱本身就可以当作文献检索的索引使用。不需要任何算力,阅读与梳理成本主要来自庞大的覆盖面(约 390 篇引用、9 张图、4 张表)。若研究者想复现其中的论断而非结论,难点在于:多数被引用系统未开源或只在各自私有设置下报告数字,验证"没有系统修订开发流程"这类否定性论断需要持续跟踪新文献;验证 harness 干预的增益(如 GroundShot 的参考验证、MVAgent 的类型化条件组合)需要拿到原系统代码并在匹配预算下做消融,这在实践中门槛较高。总体而言:导航价值极高、可直接零成本复用;作为研究基座的复现难度为中等,主要瓶颈是被调查系统本身的开源程度参差不齐。
论文图表
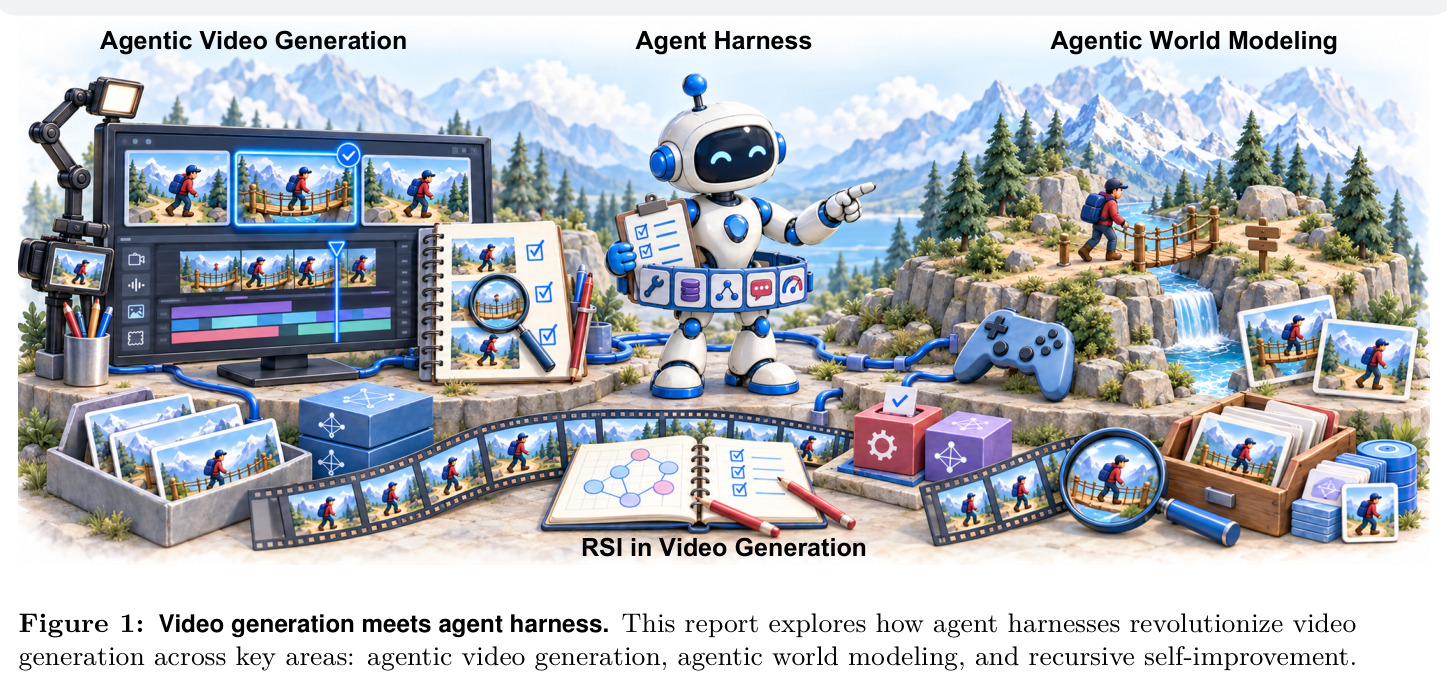
全文总览图:中央是 Agent Harness,向左连接 Agentic Video Generation(智能体视频生成),向右连接 Agentic World Modeling(智能体世界建模),下方是 RSI in Video Generation(视频生成中的递归自我改进),展示 harness 作为枢纽贯穿三个方向。
一眼看清全文结构:harness 是连接生产、交互、开发三设置的中心单元,是整篇综述分析单元选择的视觉宣言。
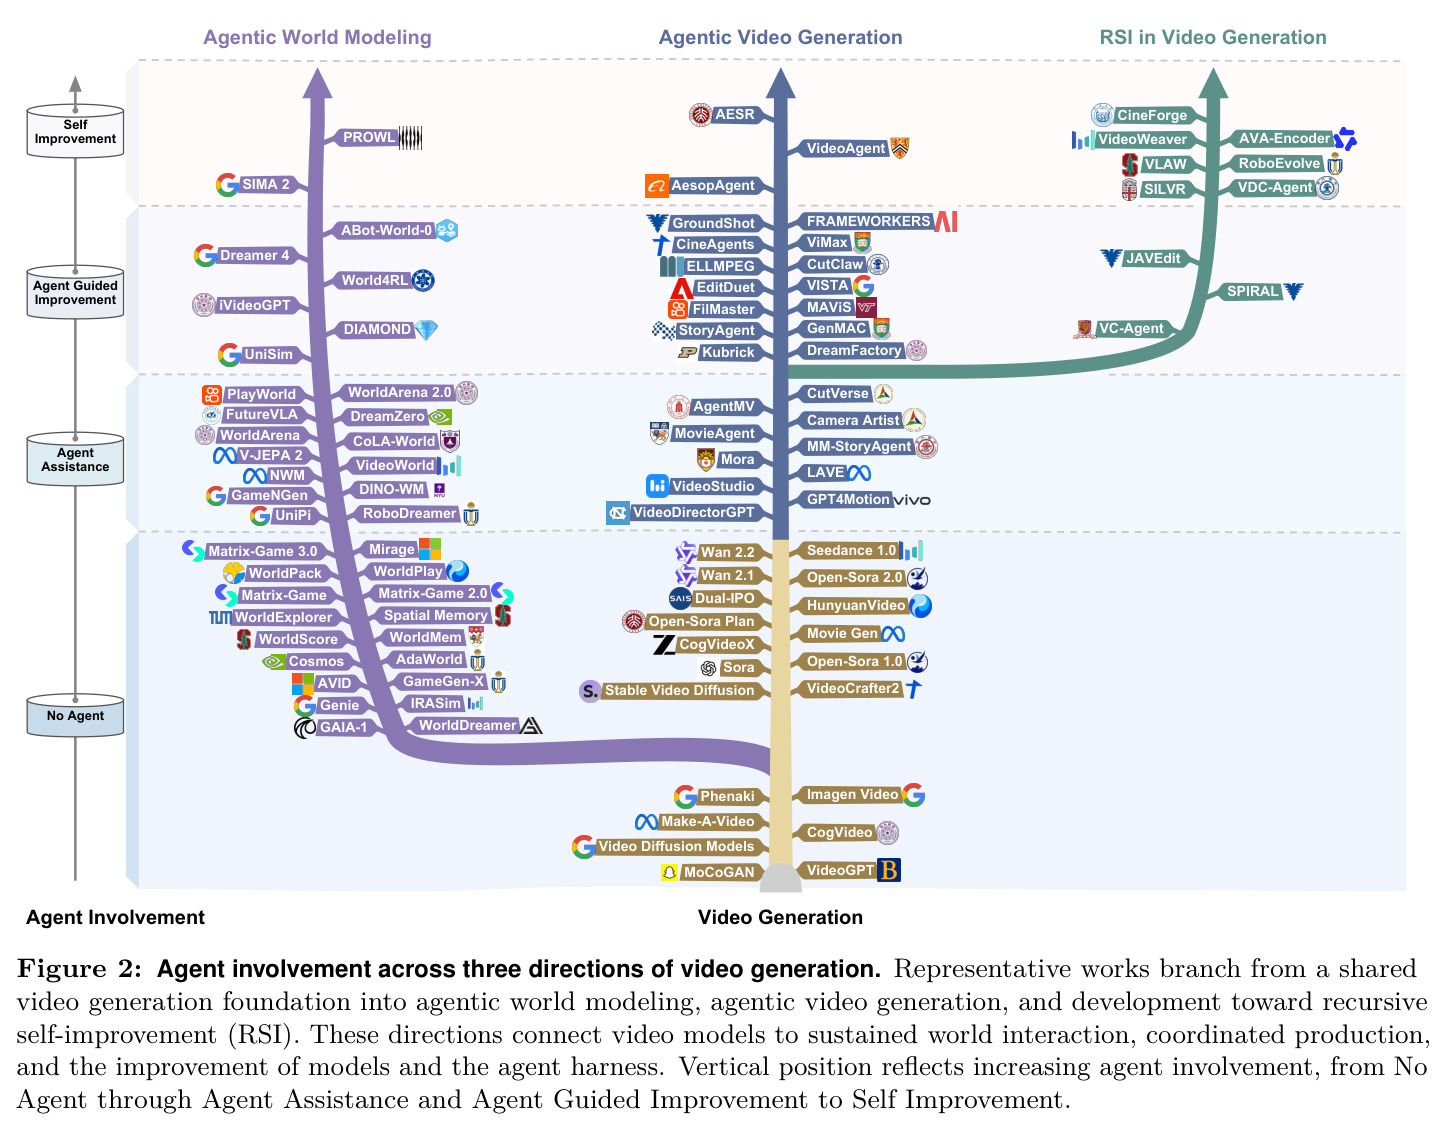
代表性工作的演化图谱:从共享的视频生成基础(Video Diffusion Models、MoCoGAN、VideoGPT、CogVideo、Make-A-Video、Sora、Movie Gen、Wan 2.x 等)分出三支——agentic world modeling(Genie、GameNGen、Dreamer 4、UniSim、Matrix-Game 系列、LingBot-World、SIMA 2、PROWL 等)、agentic video generation(VideoAgent、AesopAgent、CineAgents、ViMax、MAViS、FilMaster、VideoWeaver 等)与 RSI 方向(AESR、CineForge、VLAW、RoboEvolve、VDC-Agent 等)。纵轴表示智能体参与度递增:No Agent → Agent Assistance → Agent Guided Improvement → Self Improvement。
这是全文最有导航价值的图:把约百个系统按方向和智能体参与度定位,读者可据此快速找到任意系统的坐标,也是"领域正从无智能体走向自我改进"这一核心叙事的可视化。