SAE 解读 MoE:稀疏自编码器揭示 MoE 专家具有人类可解读的细粒度专业化 SAE Interprets MoE: Sparse AutoEncoders Reveal That MoE Experts Exhibit Human-Interpretable Fine-Grained Specialization
在 MoE 层输出上训练 SAE,将潜变量激活精确分解到各专家,揭示专家按特征而非领域细粒度分工
前置知识
Mixture-of-Experts (MoE,混合专家)
MoE 层包含 $N$ 个专家网络和一个路由器。路由器为每个 token 的隐状态打分,选出 top-$k$ 个专家并对门控权重 $g_j$ 重归一化($\sum_j g_j = 1$),层输出是被激活专家输出的加权和 $y^{(t)} = \sum_{j \in A(t)} g_j^{(t)} u_j^{(t)}$。它以远小于同规模稠密模型的单 token 计算量,承载巨大的总参数量。
本文要回答“单个专家到底负责什么”,全部推导都建立在“MoE 层输出可写成专家加权之和”这一结构之上。
稀疏自编码器 (SAE)
SAE 把模型激活 $y \in \mathbb{R}^d$ 编码到远超完备的潜空间($m \gg d$,本文 $m = 2^{20}$),用 TopK-ReLU 只保留少量非零激活,再解码重建 $y$。潜变量(latent)近似模型真实使用的单语义特征,缓解神经元多义性;重建质量用未解释方差比例 FVU 衡量。
本文的分析单元——潜变量——由 SAE 无监督学出,专家专业化完全是在这个特征空间中度量的。
专家—潜变量贡献精确分解
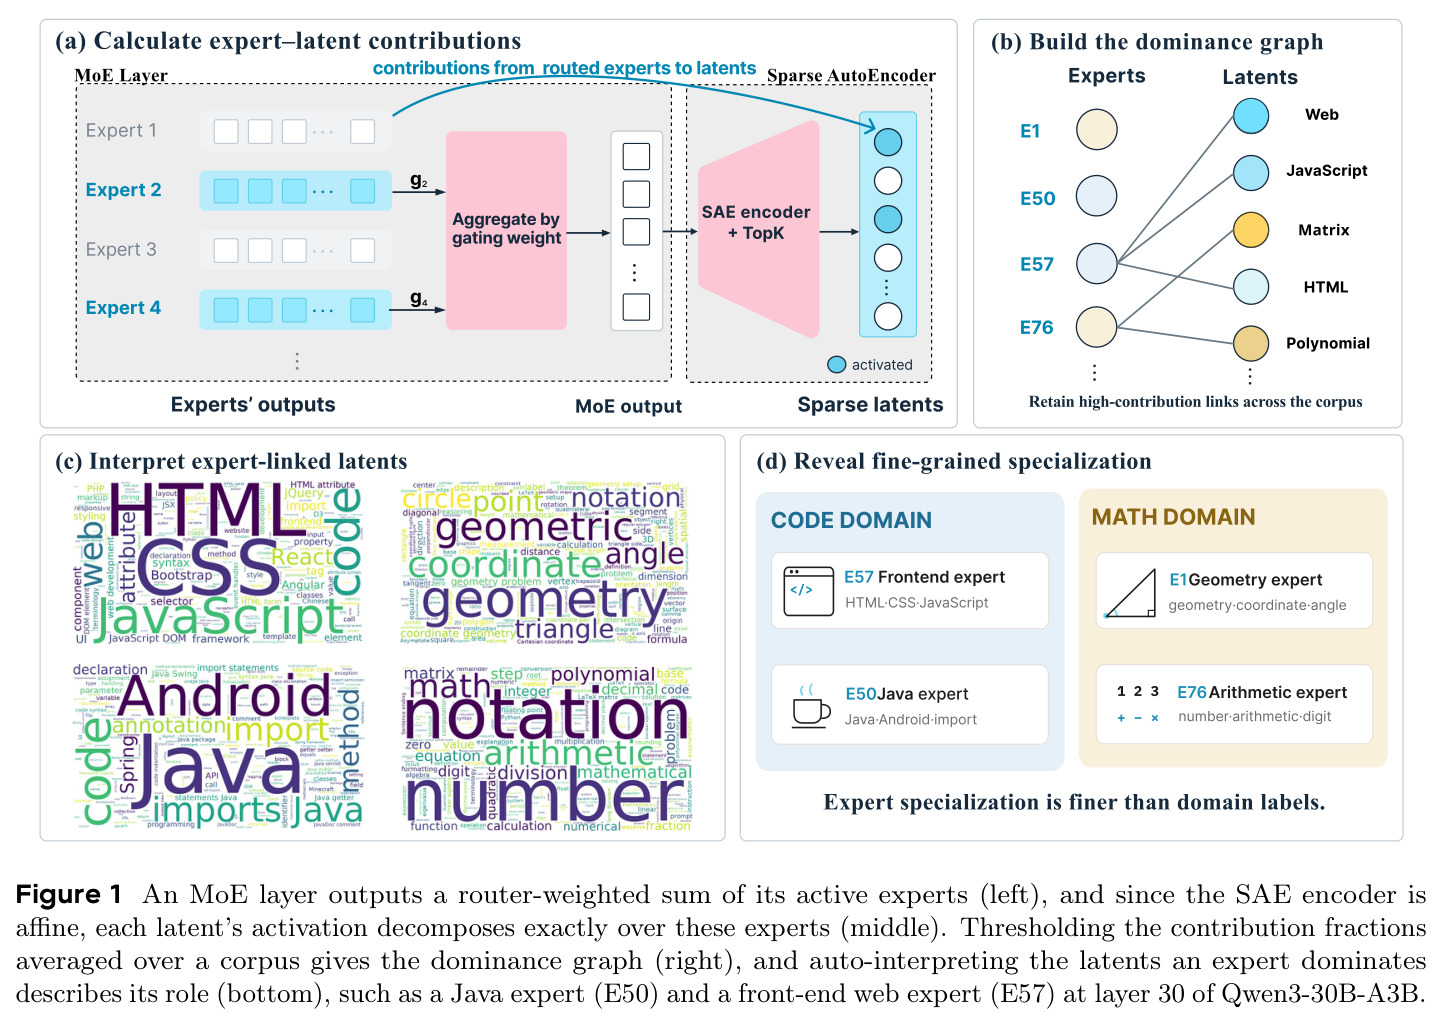
SAE 编码器是仿射映射,潜变量 $i$ 的预激活为 $f_i = W_{enc,(i)} \cdot y + b_{enc,(i)}$;代入 $y = \sum_j g_j u_j$ 得 $f_i = \sum_j g_j W_{enc,(i)} \cdot u_j + b_{enc,(i)}$,激活被精确(而非近似)分解为各专家贡献加偏置。取正部 $c(j,i,x_{1:t}) = \mathrm{ReLU}(g_j^{(t)} W_{enc,(i)} \cdot u_j^{(t)})$ 作为贡献。
这是全文的技术核心:理解这个代数恒等式,才能明白主导集与贡献占比从何而来、为何是无估计误差的精确会计。
Jaccard 相似度
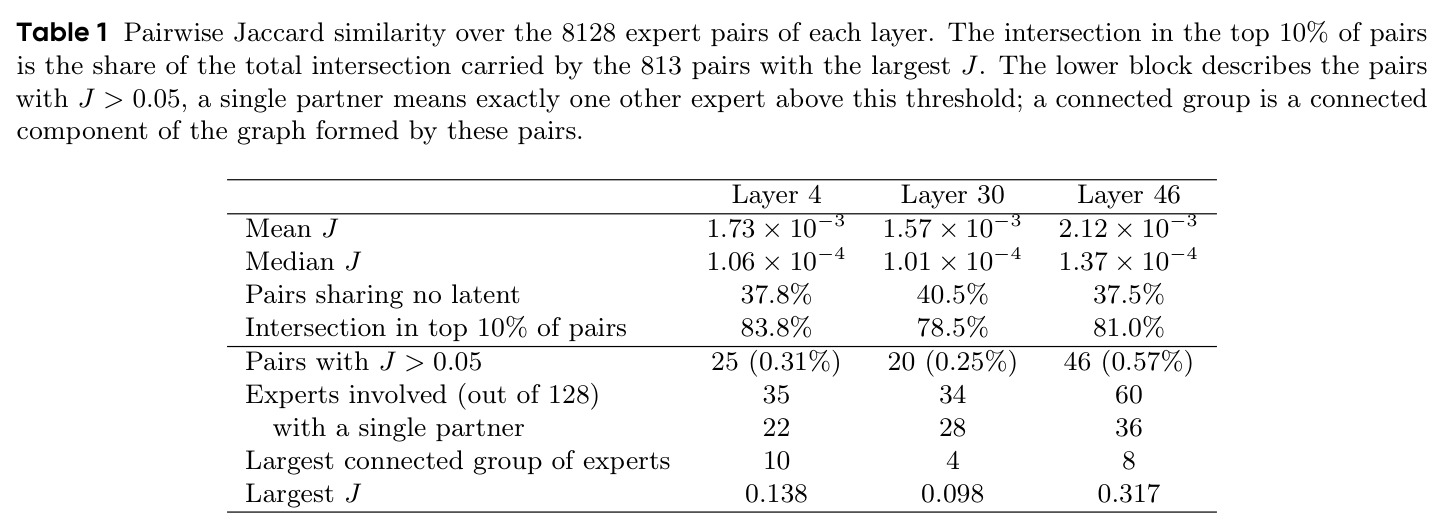
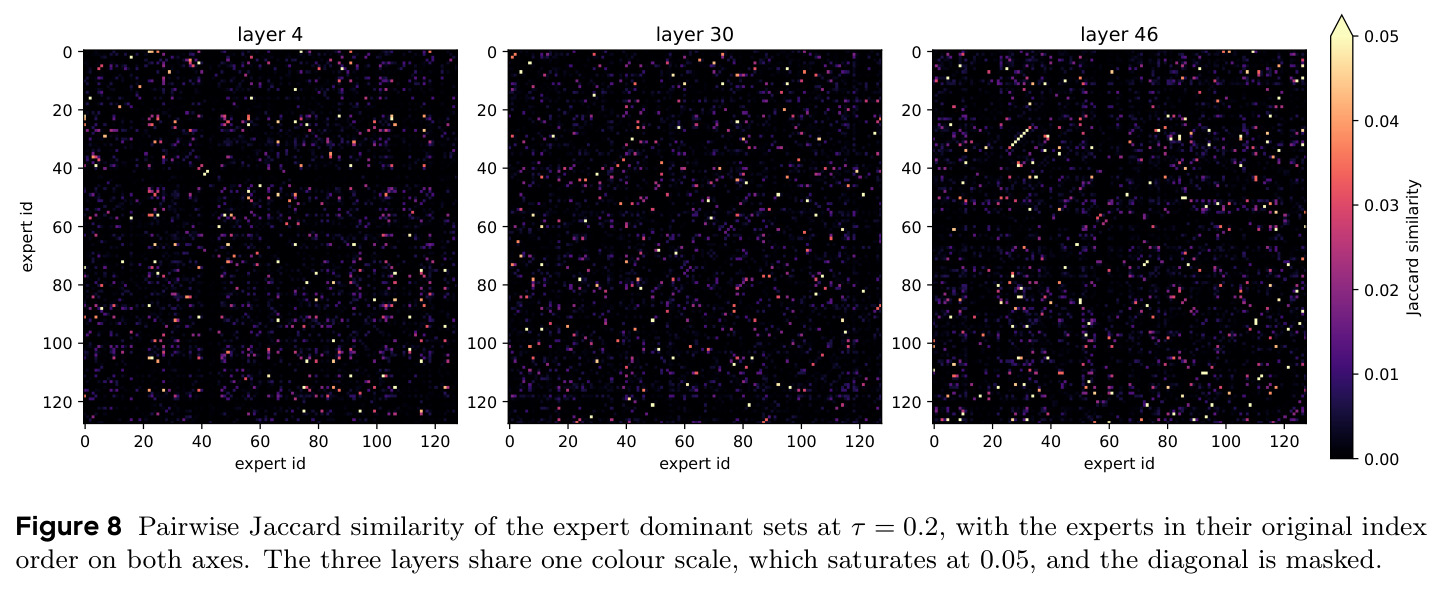
衡量两个集合重叠程度的指标,$J(A,B) = |A \cap B| / |A \cup B|$,取值 0(完全不相交)到 1(完全重合)。论文用它度量每层 $\binom{128}{2} = 8128$ 个专家对的主导集重叠,从而判断专家分工是否互斥。
“主导集几乎不相交、重叠集中在少数专家对”这一关键结论完全依赖该指标的分布统计。
自动可解释性与 logit lens
用 LLM 为 SAE 潜变量写自然语言解释:提供最强激活上下文(64-token 窗口,top-5 加随机 5 个)、logit lens 投影(把解码器向量过 LM head,取提升/抑制最多的各 top-10 token)以及层深度先验,让解释器输出 2-6 词短语、置信度,或在证据不足时输出 Uninterpretable。
专家标签与领域划分全部来自潜变量的自动解释;没有这一步,主导集只是无意义的潜变量编号集合。
研究动机
现有 MoE 专家专业化分析几乎都在“人工标注领域的语料上数专家被选中的频率”,且证据互相矛盾:一些工作报告专家按领域特化(如代码、数学语料上优先激活),另一些则结论称路由与人类领域概念无关、由 token 身份等表面属性驱动。这套测量工具有四个缺陷:(a) 分类体系是分析者预先强加的,而非从模型中恢复,只能验证模型分工是否符合预设划分;(b) 语料级标签太粗,通常只有代码、数学等寥寥几类,远细于单层动辄上百个专家应有的分工粒度;(c) 标签挂在语料上而路由决策按 token 进行,例如数学题面中的大量叙事性框架 token 全被计入“math”,恰好模糊了想检测的差异;(d) 激活频率只记录“是否被选中”,完全忽略门控系数——一个专家可以在某 token 上被选中,却对该层在此处的计算几乎毫无贡献。
本文的目标是本文要换一把测量工具:直接在模型层自身的特征空间里研究专家分工。具体目标是:在 MoE 层输出上训练稀疏自编码器,利用编码器的仿射性把每个潜变量的激活精确分解到各专家,在大规模验证集上聚合出每个专家“主要负责驱动的潜变量集合”(主导集),构建专家—潜变量二部支配图;再自动解释这些潜变量,用模型自己的词汇而非预设类别描述每个专家的职责;并量化支配结构的集中度、专家间重叠度,以及专家在领域间的配置是否均衡。
与已有工作不同的是,本文的独特切入有三点。第一,分析单元从“分析者定义的领域”换成“SAE 无监督学出的潜变量”,因此专业化发生在哪个粒度上本身成为实验结果,而不是先验假设——这是与所有基于领域标签计数的研究的根本区别。第二,测量量从“被选频率”换成“逐 token、逐专家的贡献分数”,既测量功能性贡献而非共现,又避免把整篇文档归入单一领域。第三,与近期用 k-sparse probing 给专家自动打标签、再在手工设定簇数的输出嵌入聚类上计算特化分数的工作相比,本文的分解是由线性性推出的代数恒等式(精确)而非统计相关(近似),专家的角色是“读出”的而不是与固定划分“匹配”的。
核心方法
直觉:专家的职责应从它驱动的特征去读,而不是从它收到的 token 去猜——token 是路由选的,信息却加在层输出特征上。路线:(1) 对 Qwen3-30B-A3B(每 MoE 层 $N=128$ 专家、每 token 激活 $k=8$、无共享专家)的第 4、30、46 层输出各训练一个 $2^{20}$ 潜变量的 TopK SAE;(2) 由 $y^{(t)} = \sum_j g_j^{(t)} u_j^{(t)}$ 与编码器仿射性,把潜变量预激活精确分解 $f_i^{(t)} = \sum_j g_j^{(t)} W_{enc,(i)} \cdot u_j^{(t)} + b_{enc,(i)}$,定义正贡献 $c(j,i,x_{1:t}) = \mathrm{ReLU}(g_j^{(t)} W_{enc,(i)} \cdot u_j^{(t)})$;(3) 在 1.5B token 验证集上取期望并归一化得贡献占比 $s(j,i)$;(4) 以 $\tau = 0.2$ 阈值构建支配图 $S(j) = \{ i \mid s(j,i) \ge \tau \}$;(5) 从每专家主导集采样至多 2000 个潜变量,GPT-5.5 自动解释并聚合成词云与标签,最后把 128 个标签分组为领域。
核心创新是把“专家是什么”转化为一个可以精确计算的会计问题。与已有方法的本质区别有三:(1) 分解是精确的代数恒等式而非近似归因——因为 MoE 层输出对专家输出线性、SAE 编码器对该输出仿射,潜变量预激活恰好等于各专家贡献之和加偏置,没有任何估计或拟合误差;(2) 主导集几乎互斥(中位 Jaccard 仅约 $10^{-4}$),因此一个专家的主导集就是只属于它自己的描述,这是“直接读出角色”得以成立的结构前提;(3) 只统计正贡献——足够强的负贡献会把潜变量压灭使其不可观测,对负贡献做统计会有系统性偏差。相较“数被选频率”的旧范式,本文同时更换了分析单位(学到的潜变量 vs 人工领域)和分辨率(逐 token 贡献 vs 语料级频次)两个维度。
方法步骤详情
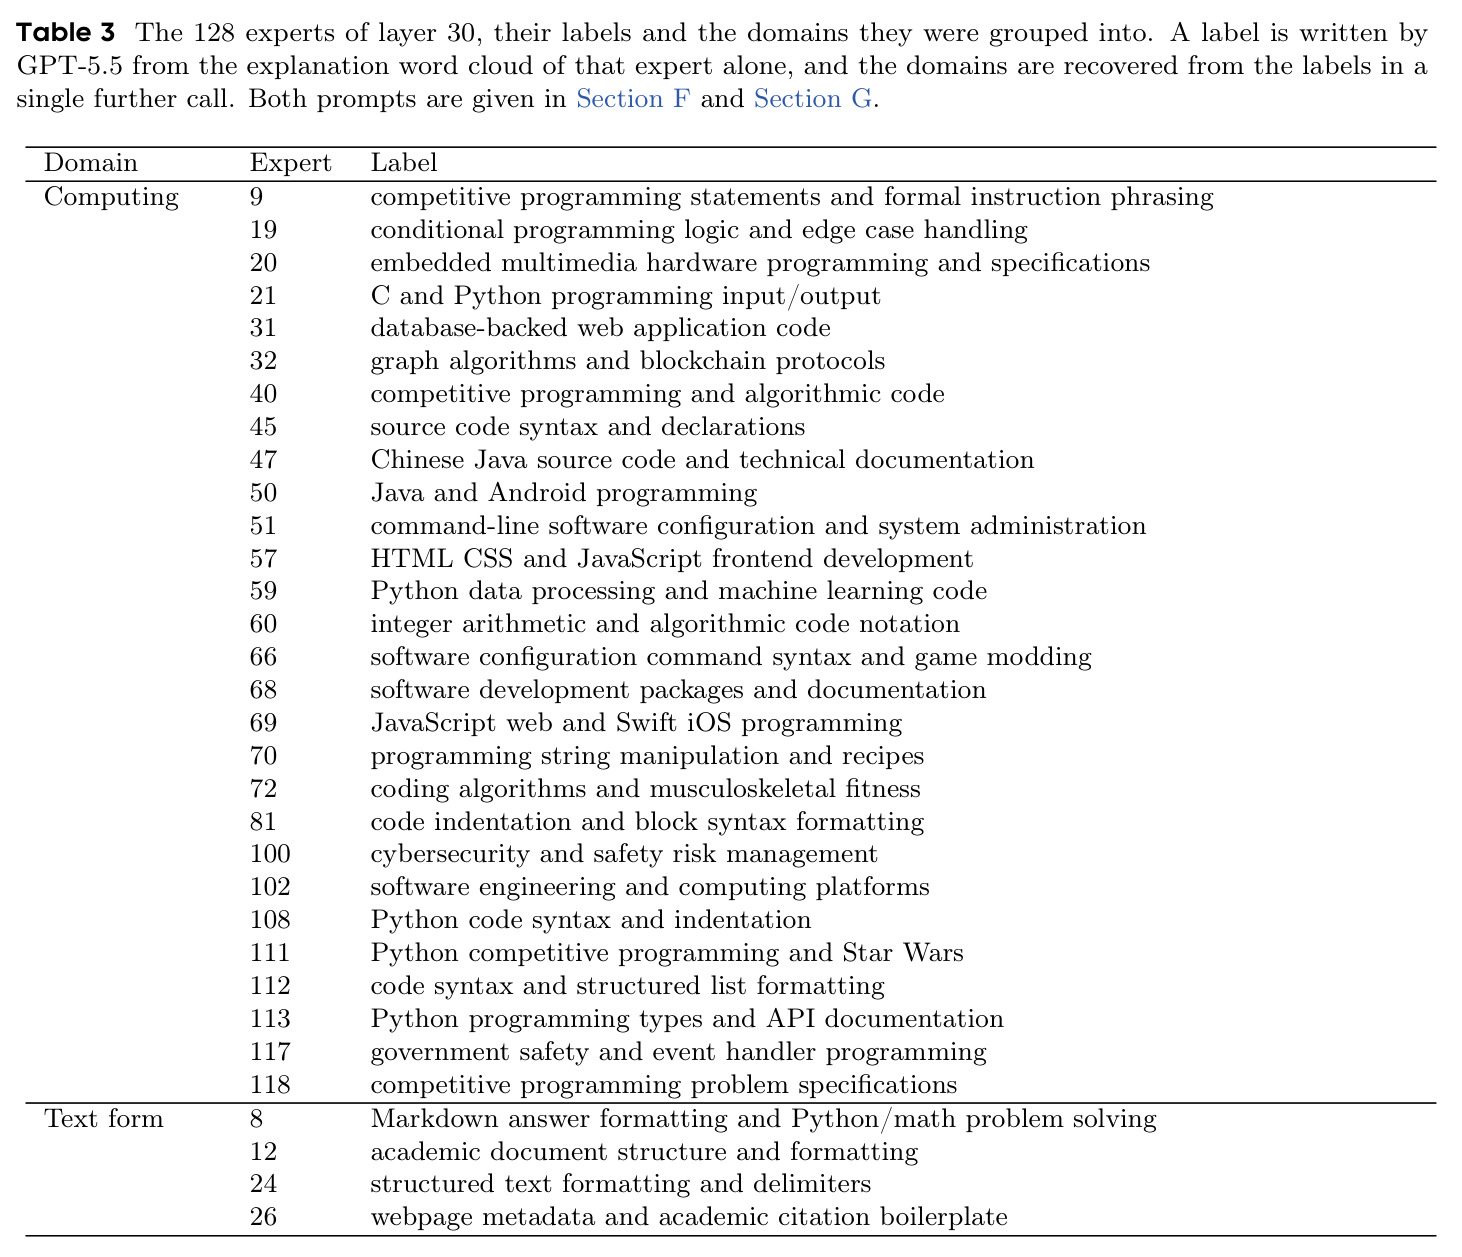
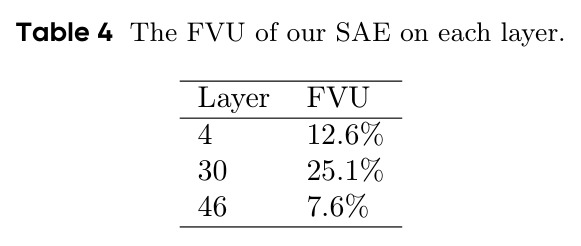
第一步,训练 SAE:激活取自 Olmo 3 语料(5/8 预训练、1/4 思维链、1/8 指令微调),全量前向转储后每样本随机留 512 条;batch 8192、约 3.2B token,$\kappa$ 从 1000 衰减到 100,峰值学习率 $8 \times 10^{-5}$,最终 FVU 为 12.6%/25.1%/7.6%(层 4/30/46)。第二步,算贡献:在与训练无重叠的 1.5B token 验证集上,对每个(前缀,激活潜变量)对计算 8 个激活专家的正贡献并归一化,取期望得 $C(j,i)$,再按式 (9) 归一化得 $s(j,i)$。第三步,建支配图:$s(j,i) \ge 0.2$ 连边,远高于均匀分配的 $1/128 \approx 0.008$。第四步,解释:每专家从主导集采样至多 2000 个潜变量,GPT-5.5 依据激活上下文(top-5 加随机 5 个)、logit lens 提升/抑制 token 与层深度先验输出 2-6 词短语加置信度,按词频汇成词云。第五步,命名与分组:GPT-5.5 先从词云给每专家写不超过 9 词的标签,再一次调用把 128 个标签划成 6-13 组,实际得到 11 个领域。
技术新颖性
技术新颖性体现在四处。(1) 据作者所述,这是首个把 SAE 特征分解用于 MoE 专家归因的工作;其归因方向与 sparse feature circuits、attribution graphs 不同——后者以潜变量为节点跨层追踪计算,本文则在单层内部把一个潜变量的激活分解到产生它的专家上。(2) 精确性:分解由线性性代数推出,与基于探针或聚类的近似打分有本质差别;近期工作在手工设定的簇数网格上计算特化分数,只能回答“哪个预设分辨率拟合最好”,而本文中“模型实际在哪个粒度分工”是输出而非输入。(3) 对负贡献的 censoring 论证(被压灭的潜变量不可观测,统计负部必然有偏)是统计上自觉的处理,说明了为何只用正部。(4) 方法极其通用:只需专家输出与层输出上的一个 SAE,适用于任何输出为专家加权和的 MoE 层,可直接用于比较不同路由目标与负载均衡损失塑造的分工。
实验结果
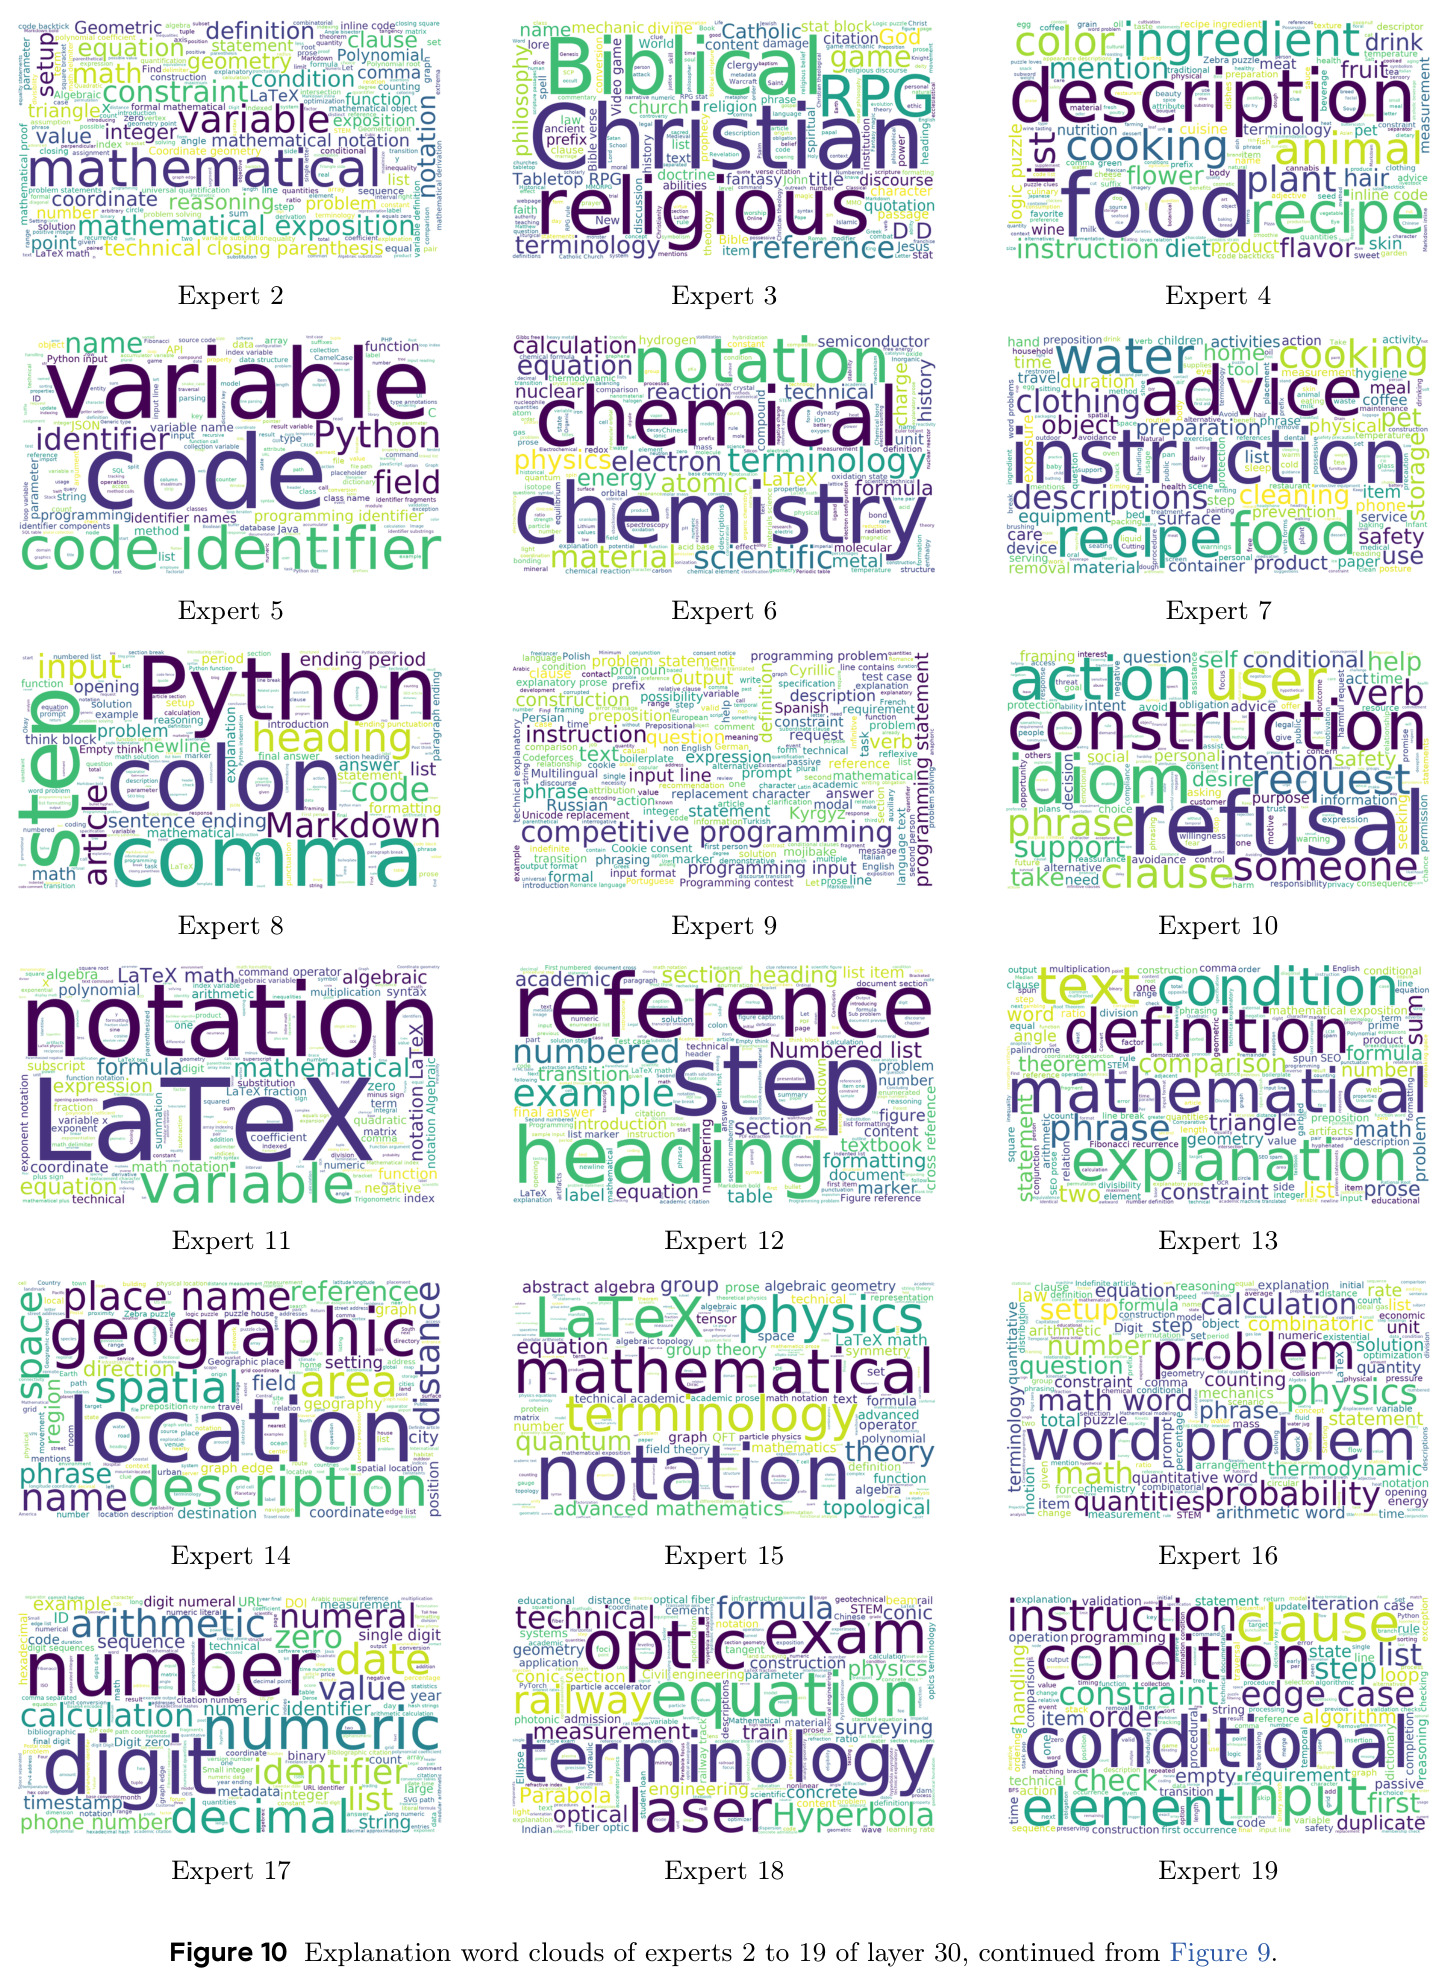
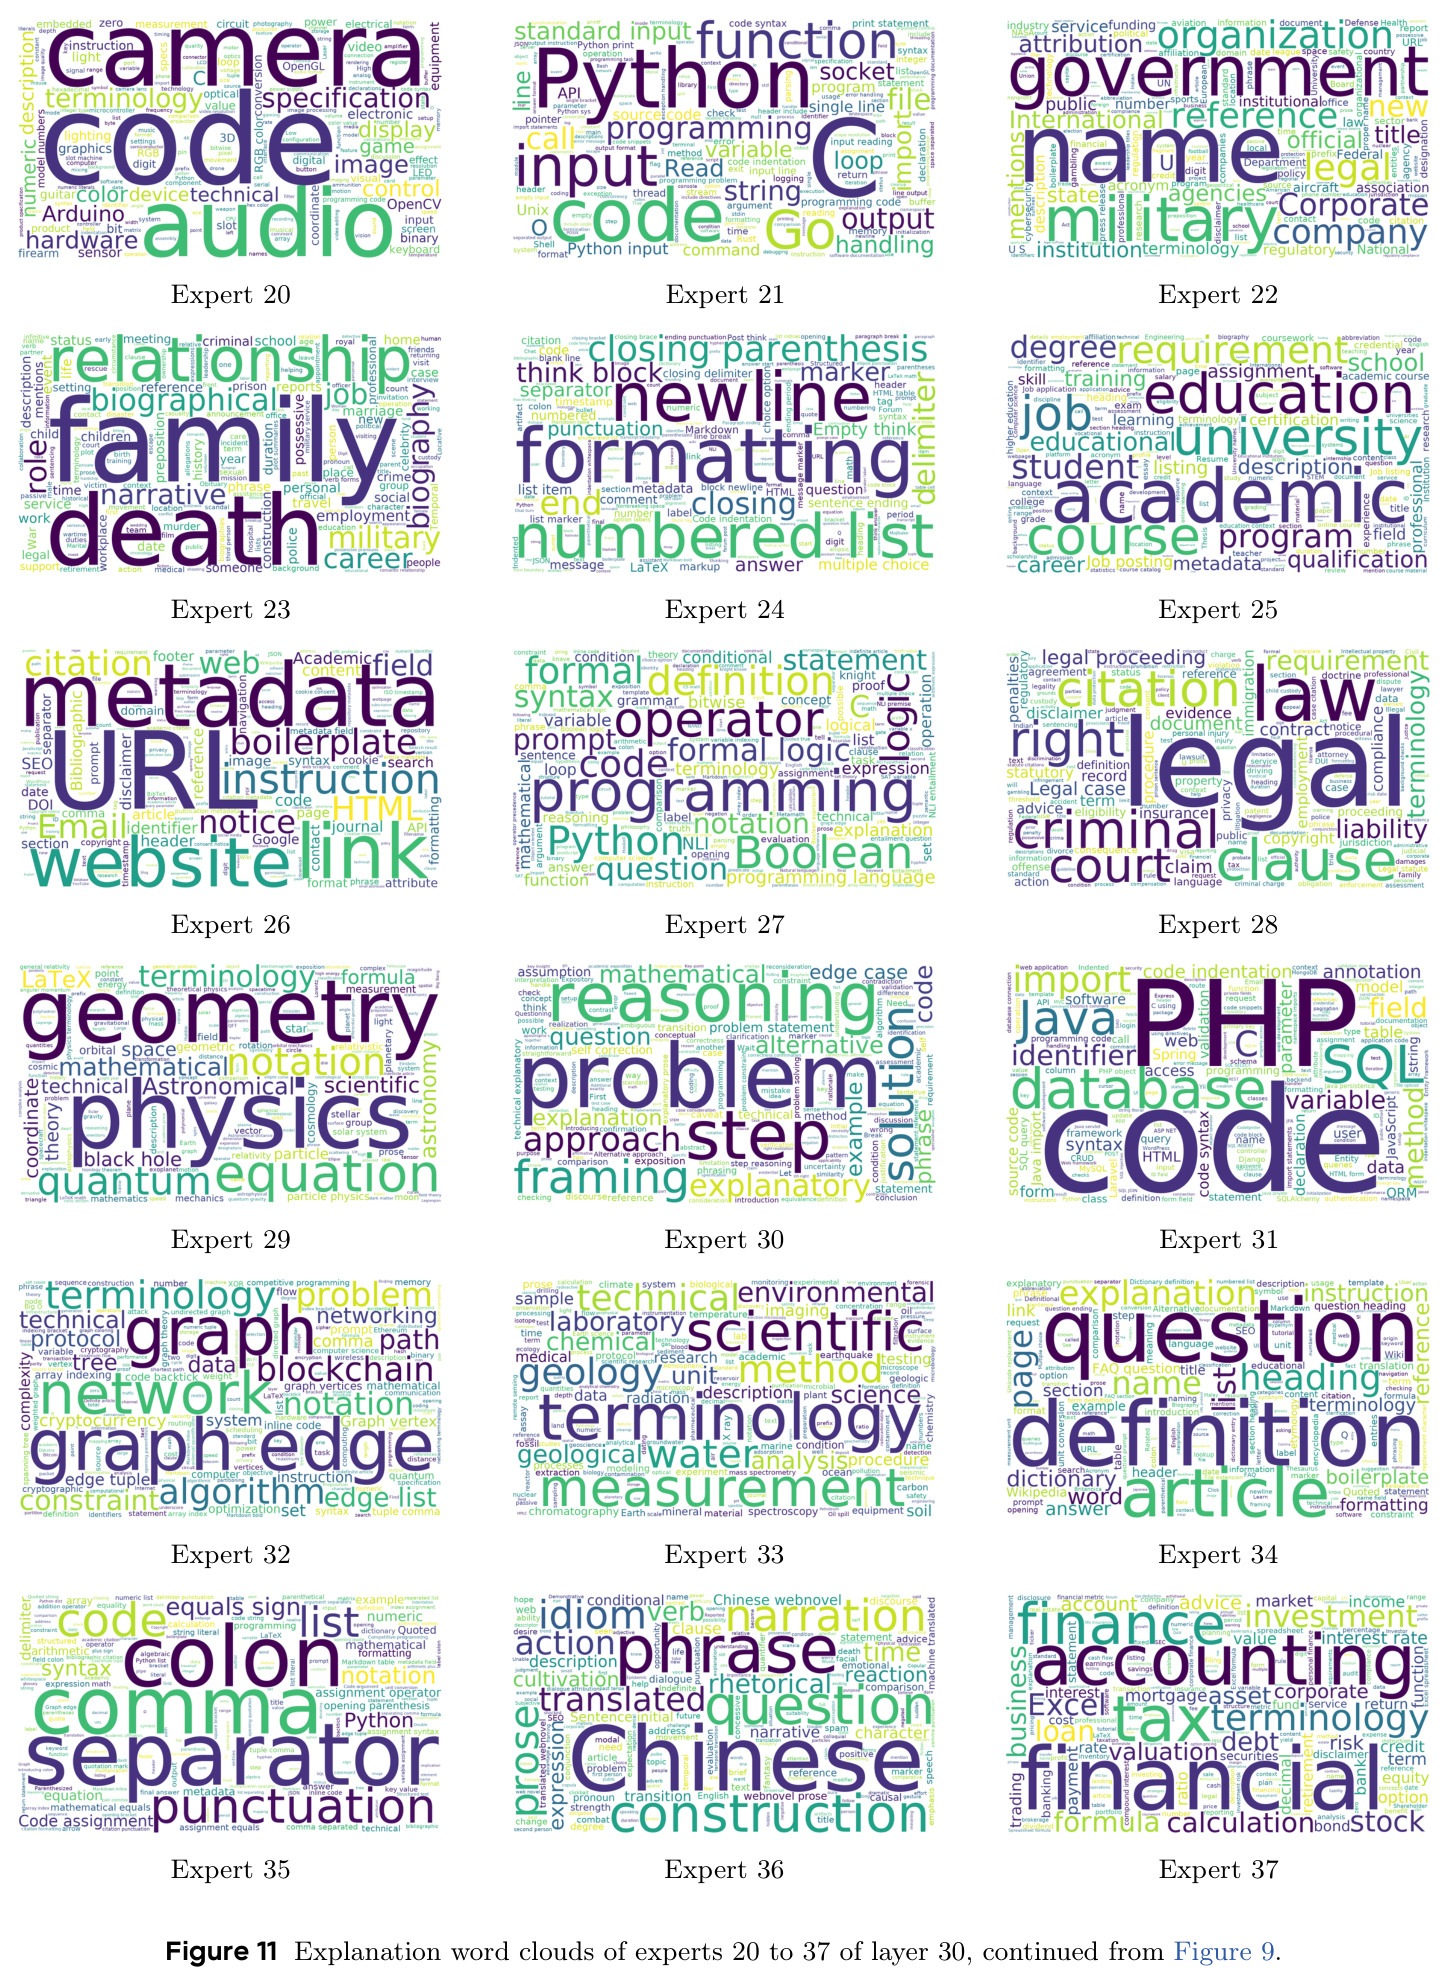
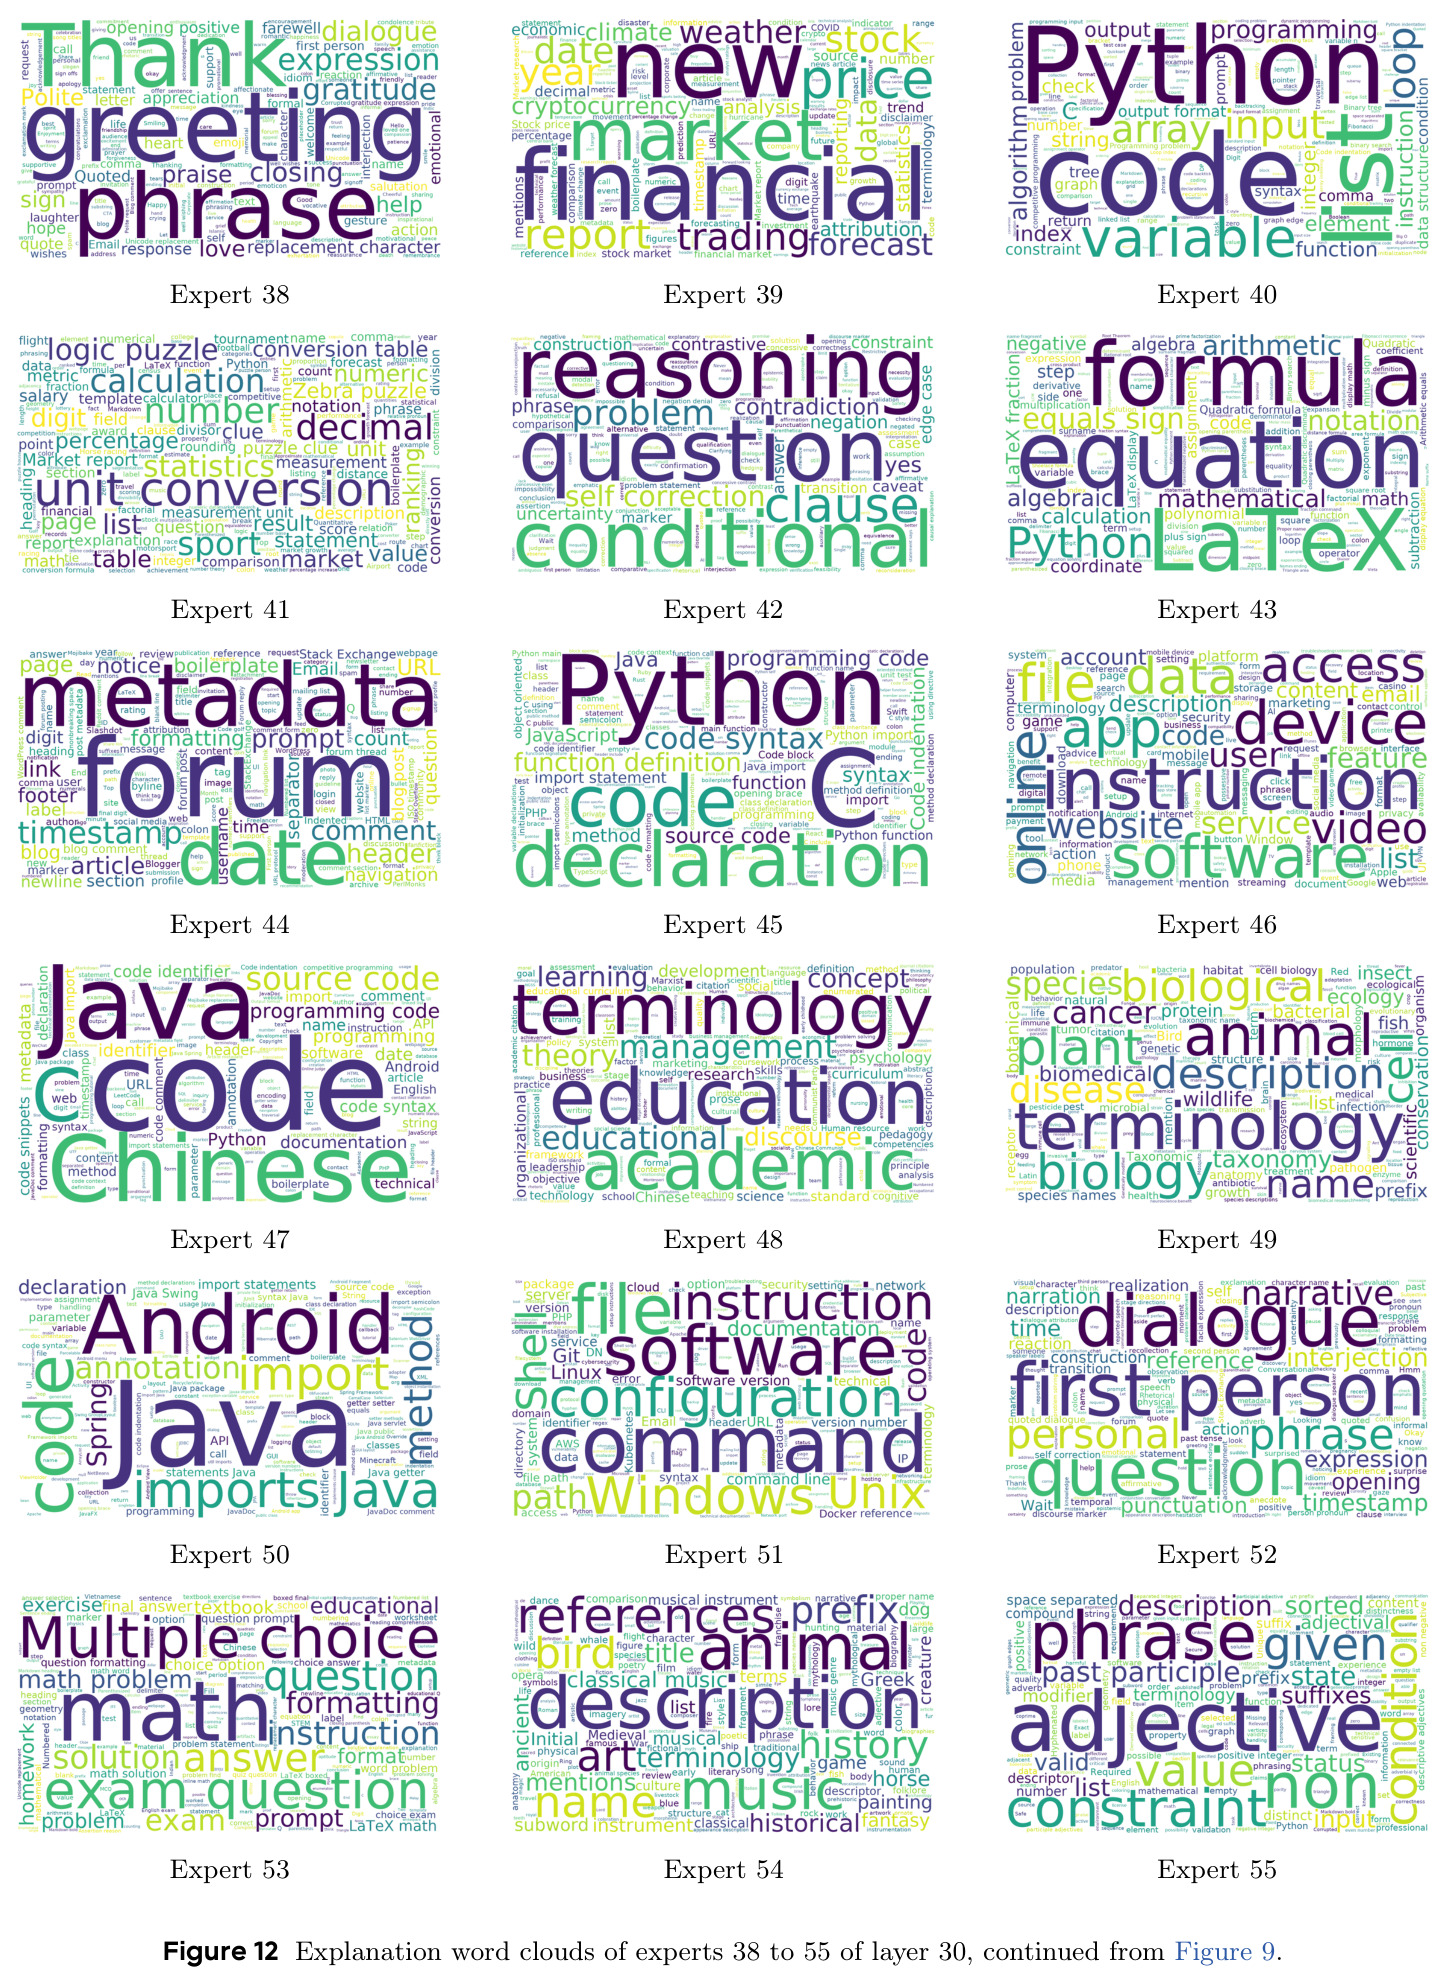
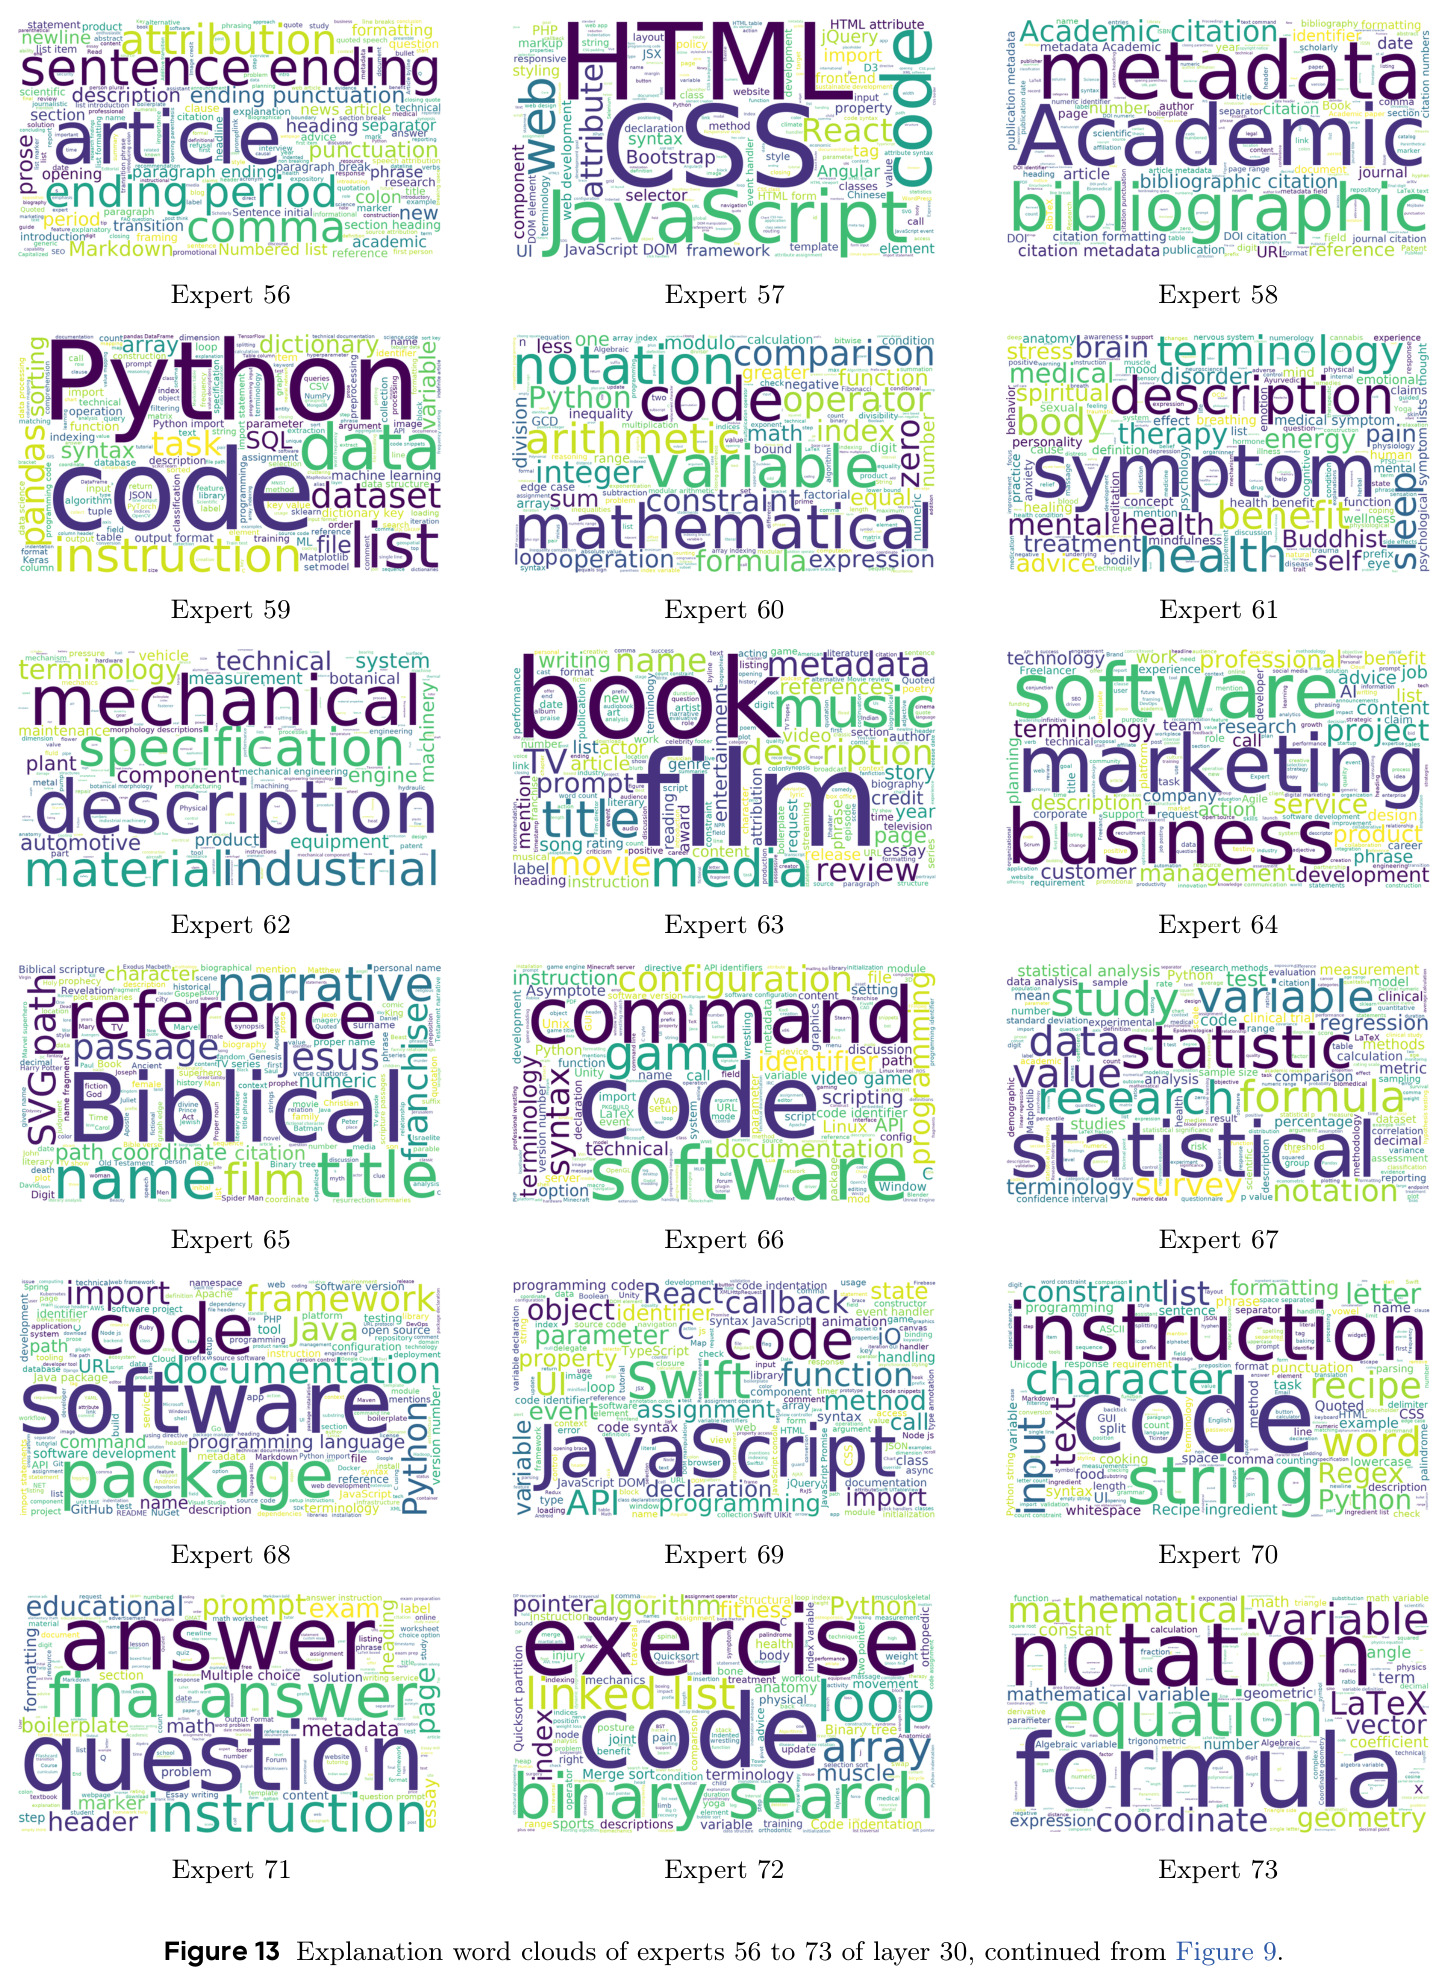
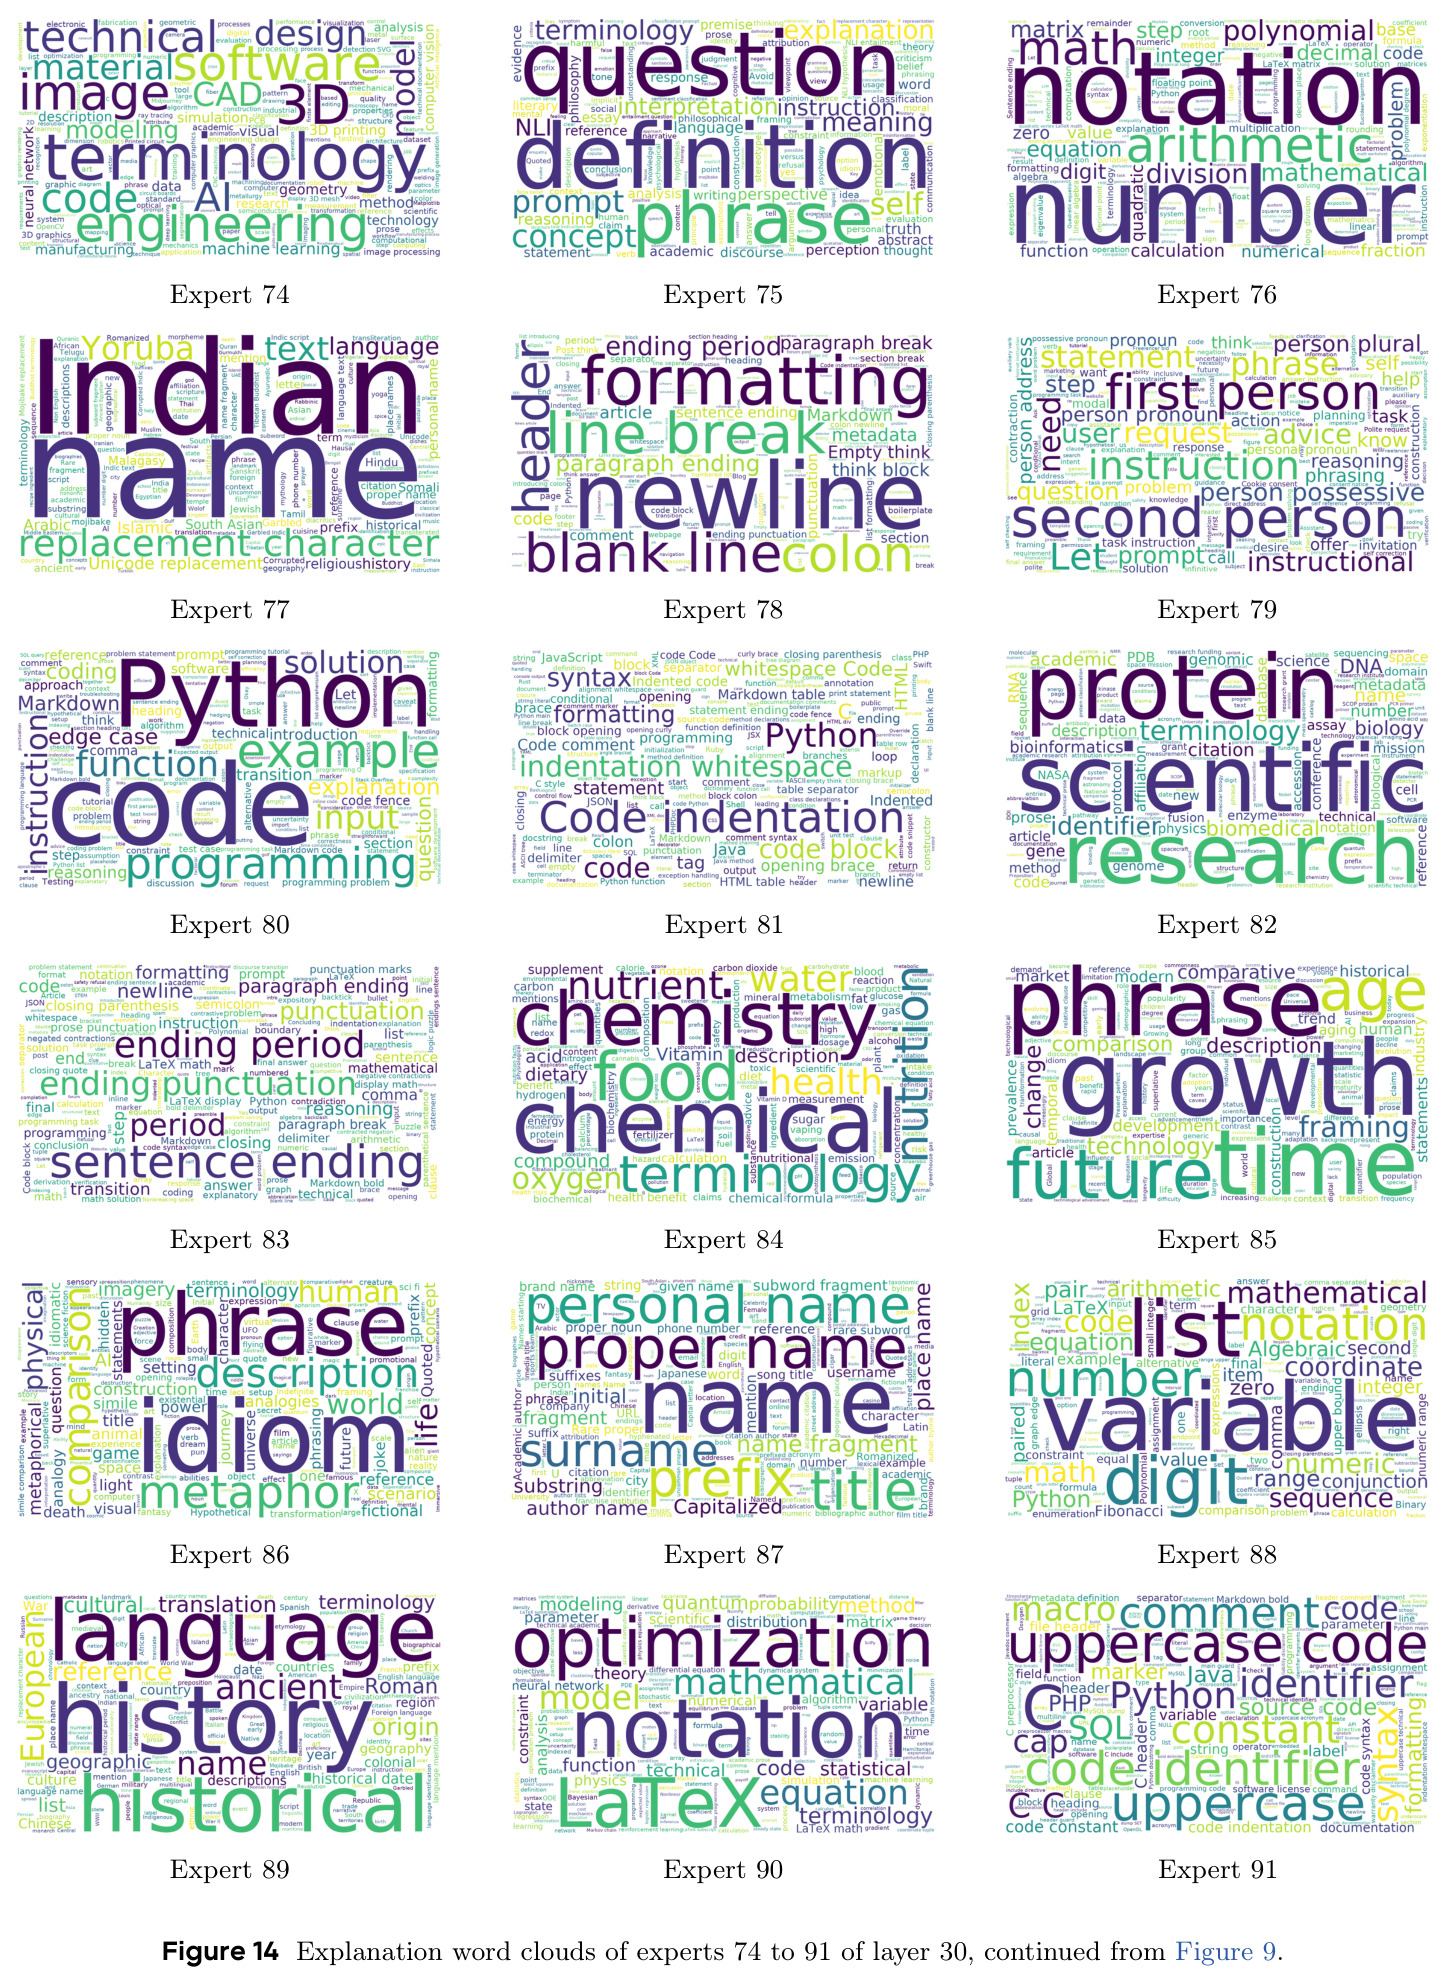
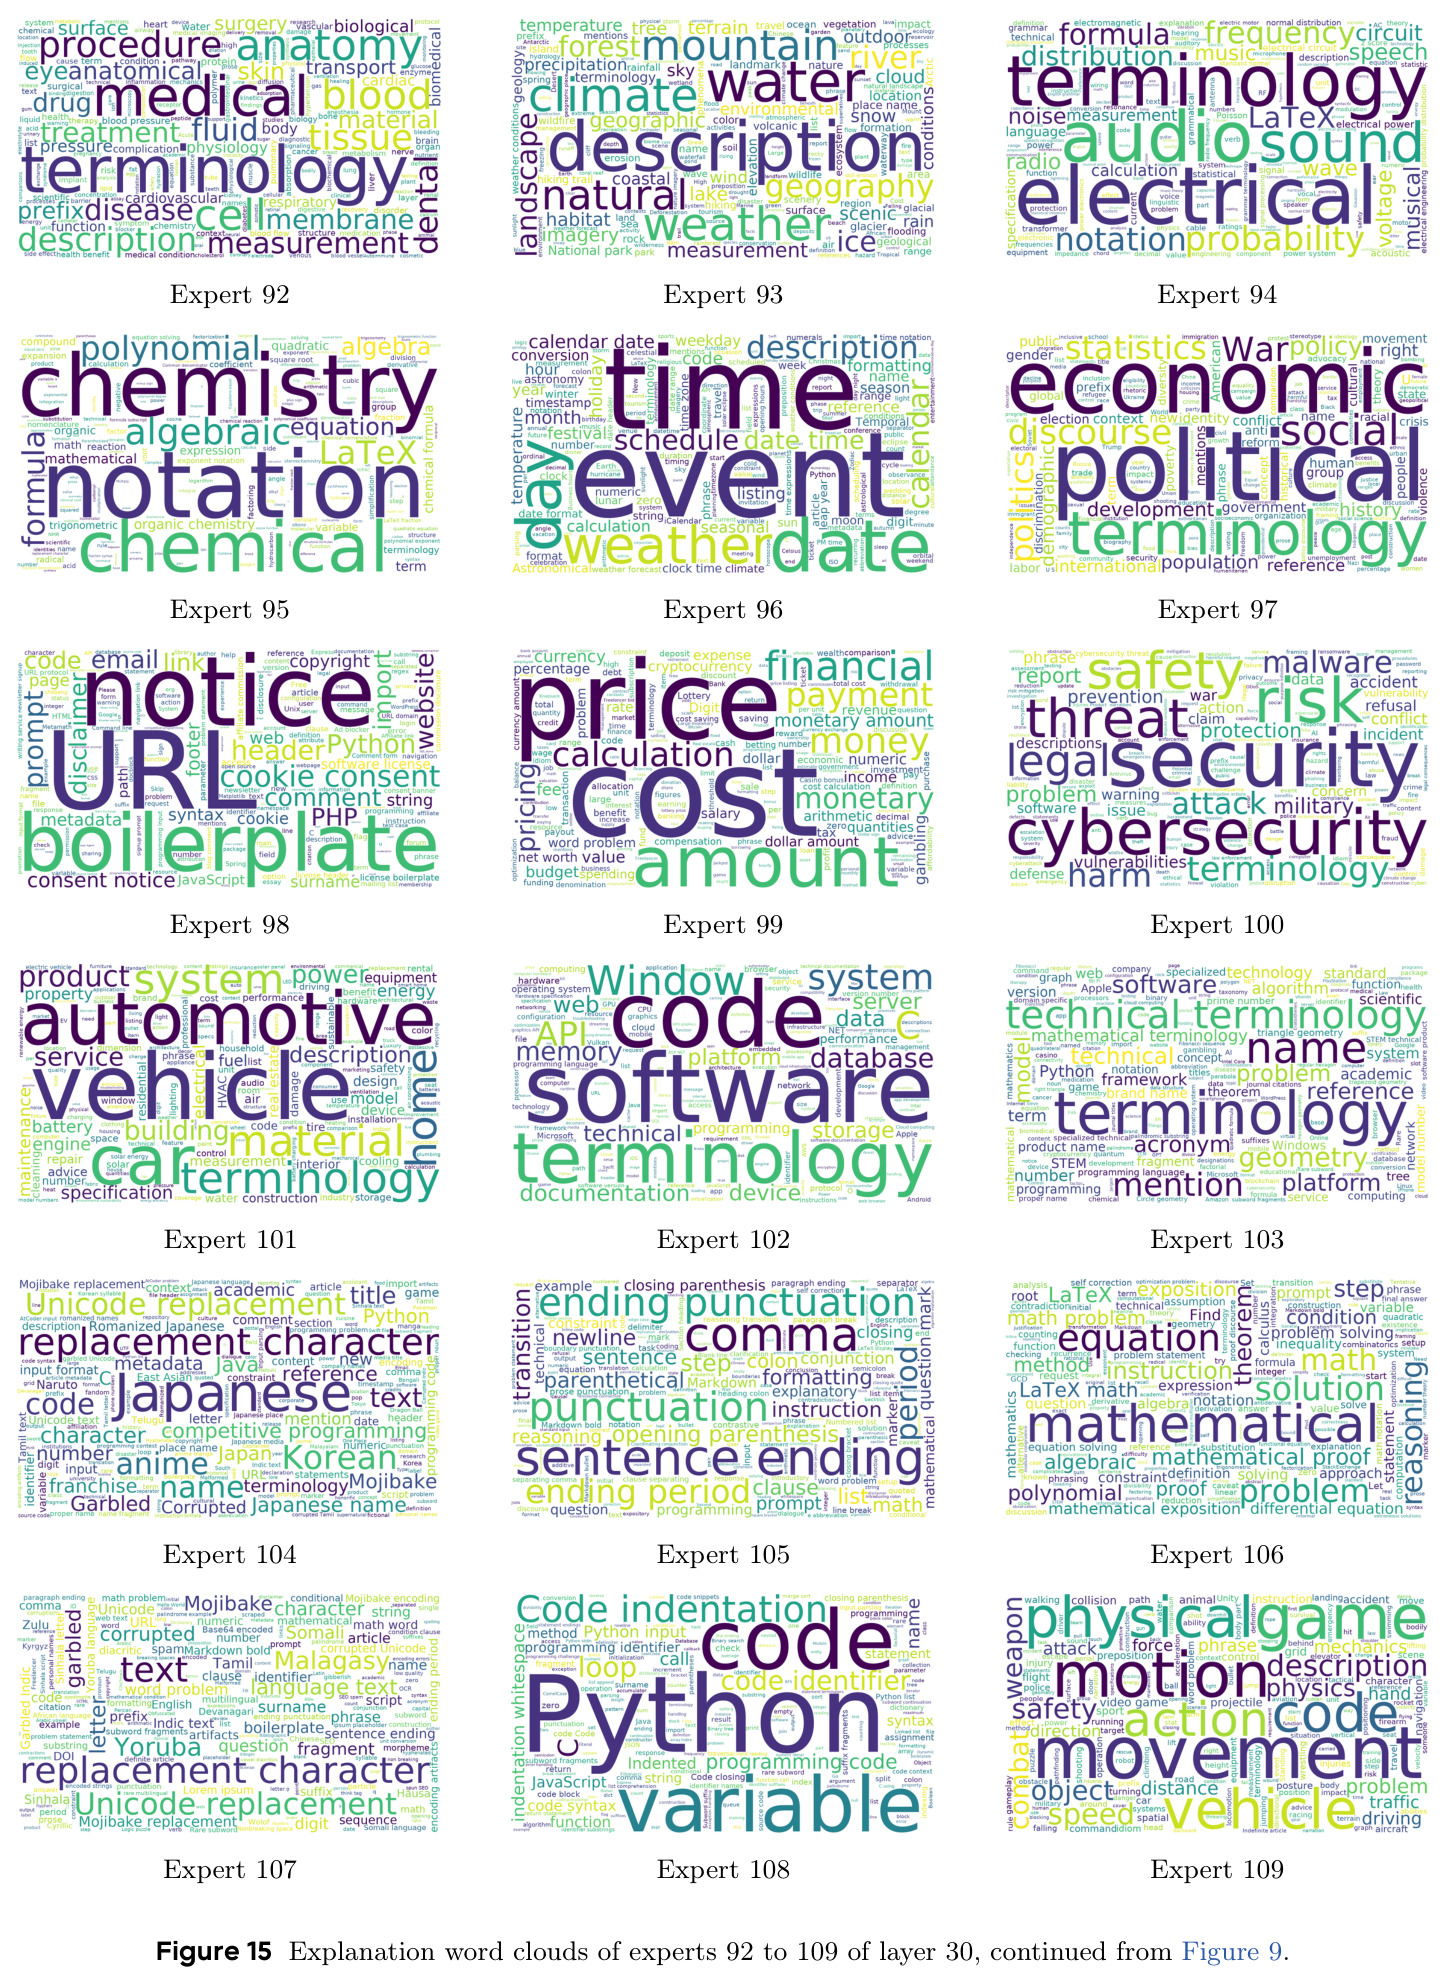
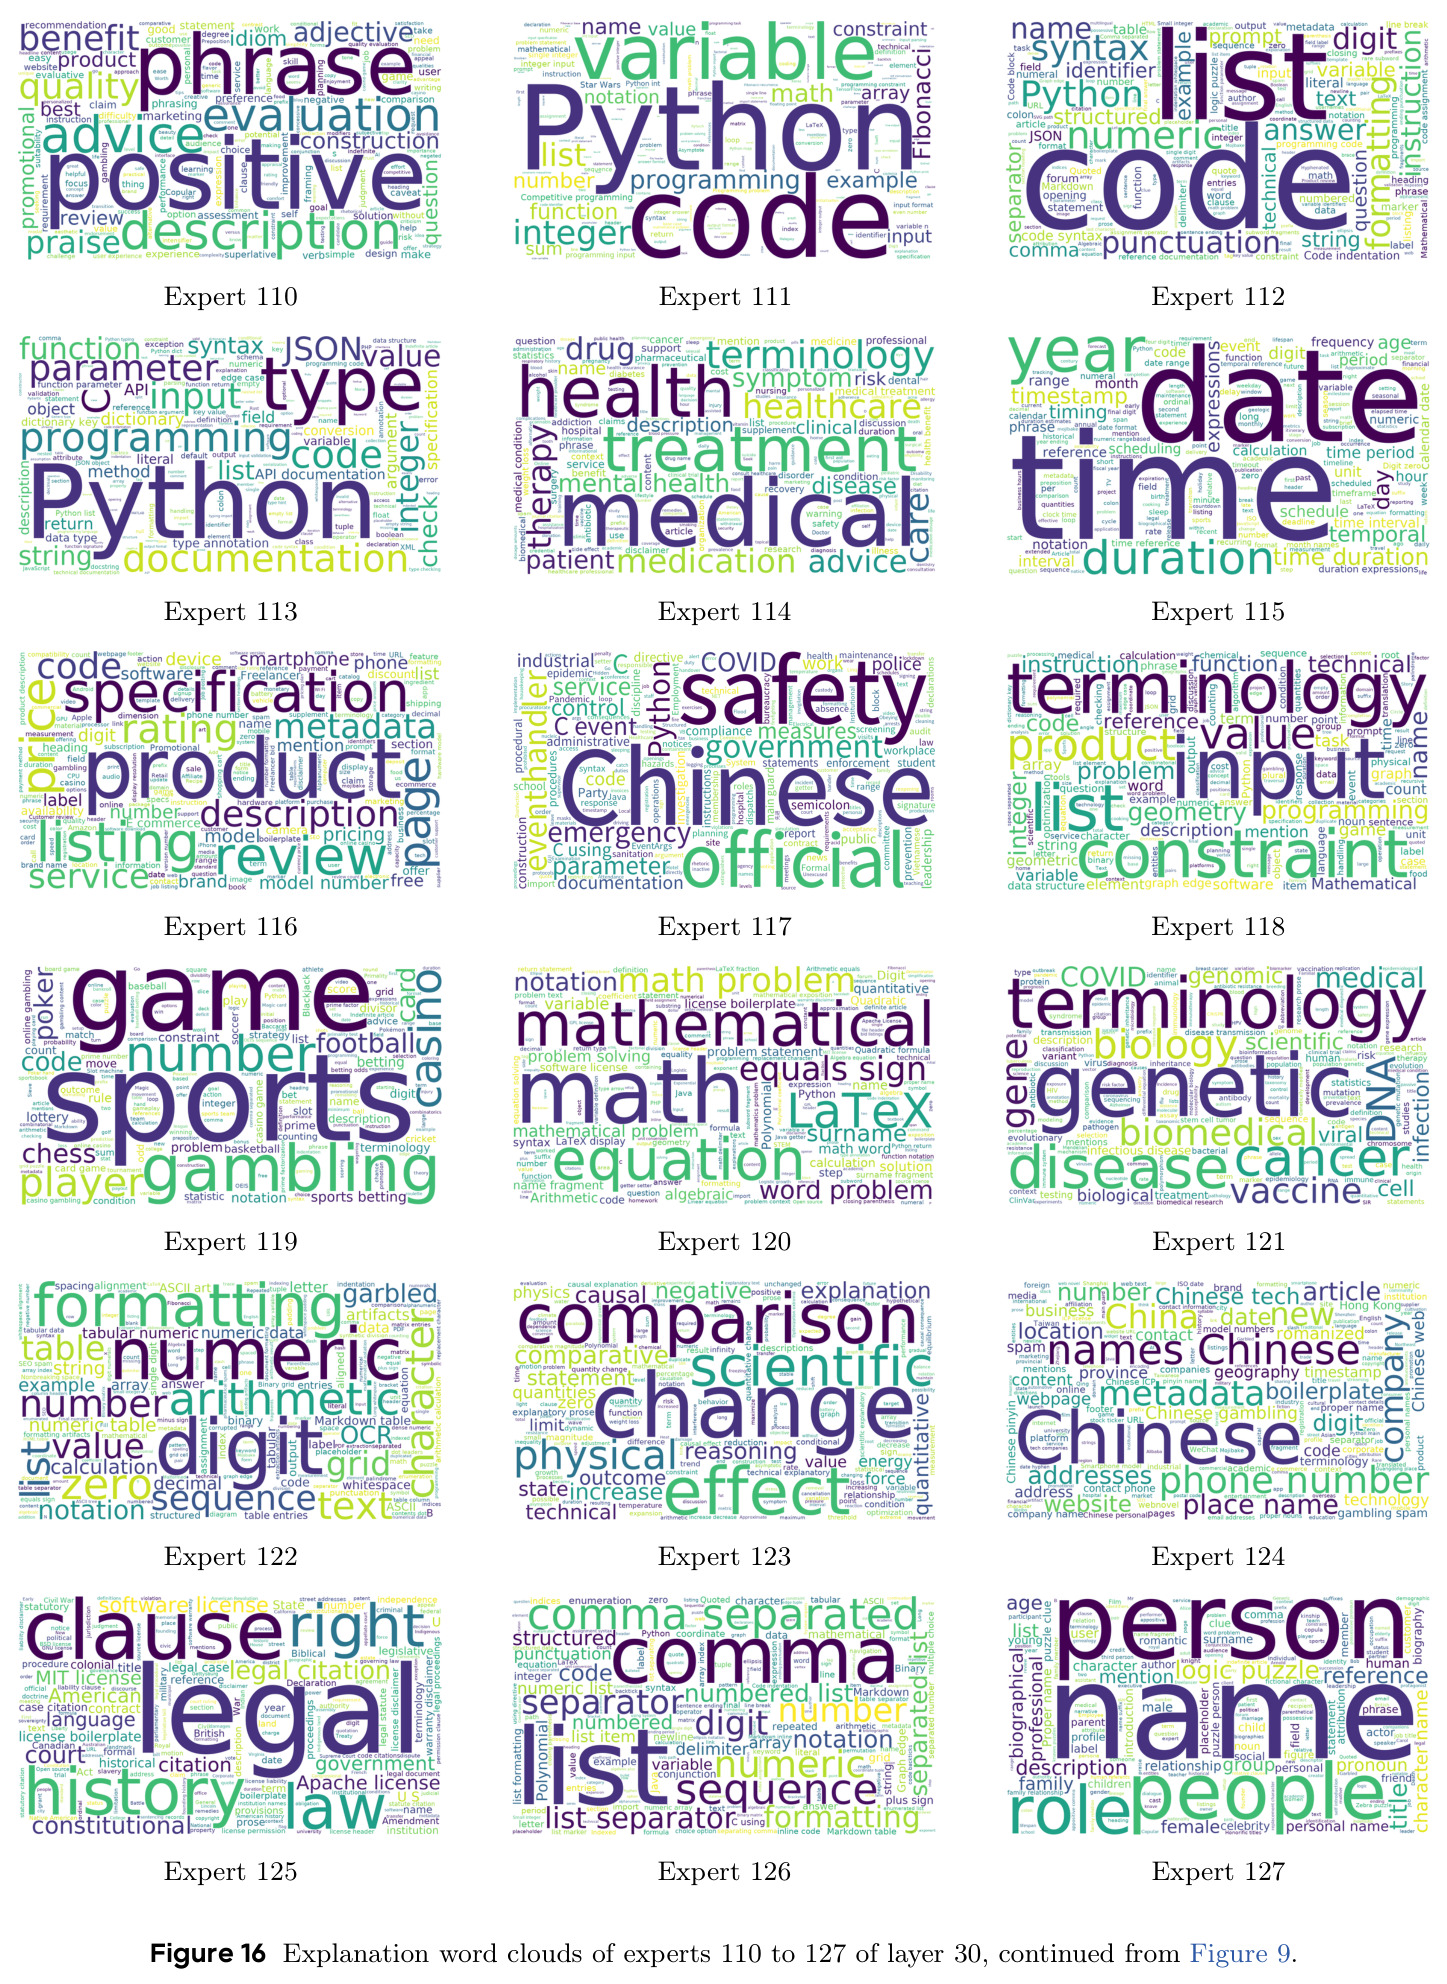
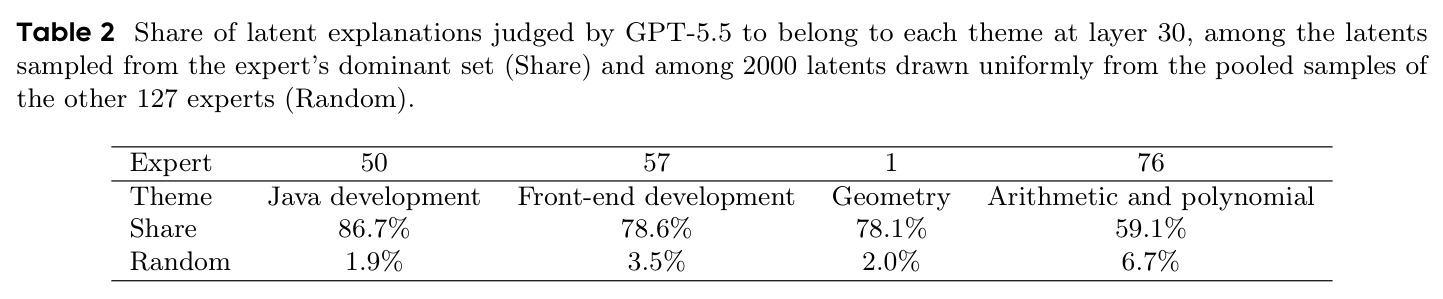
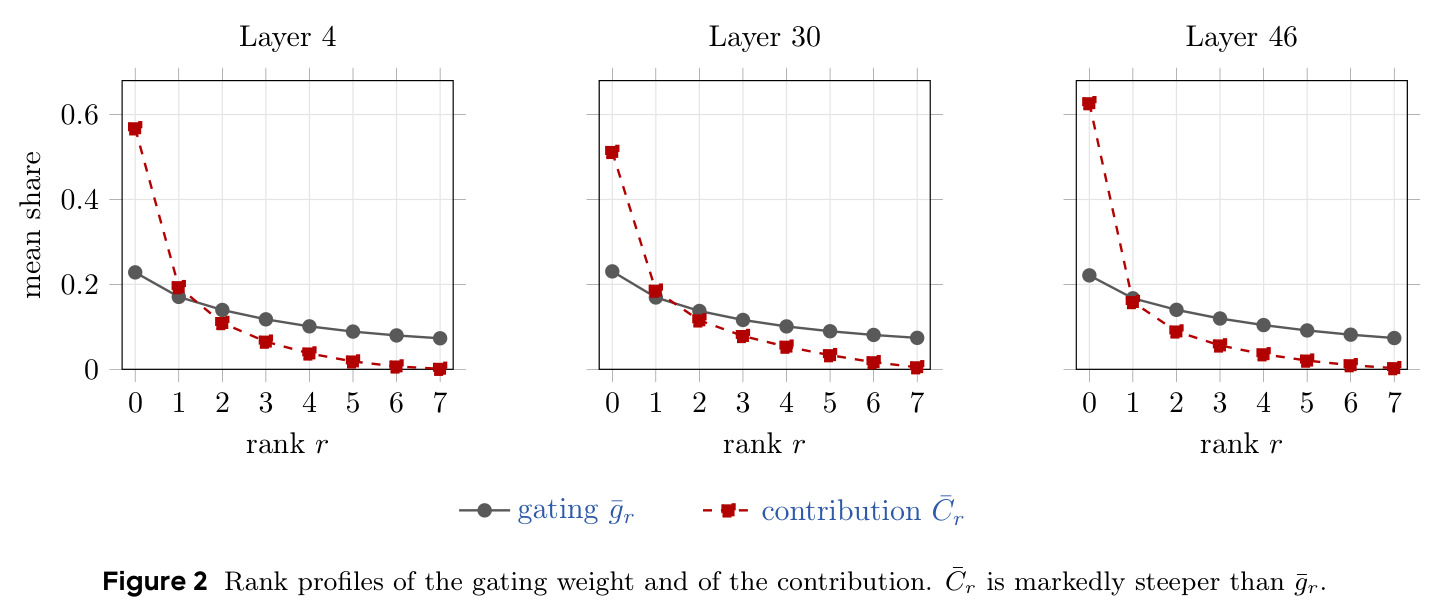
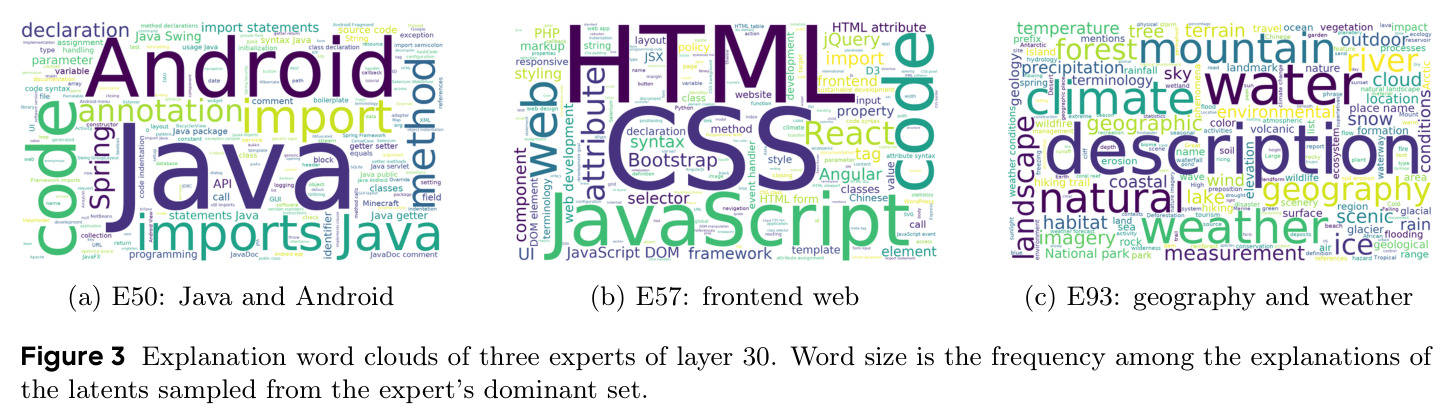
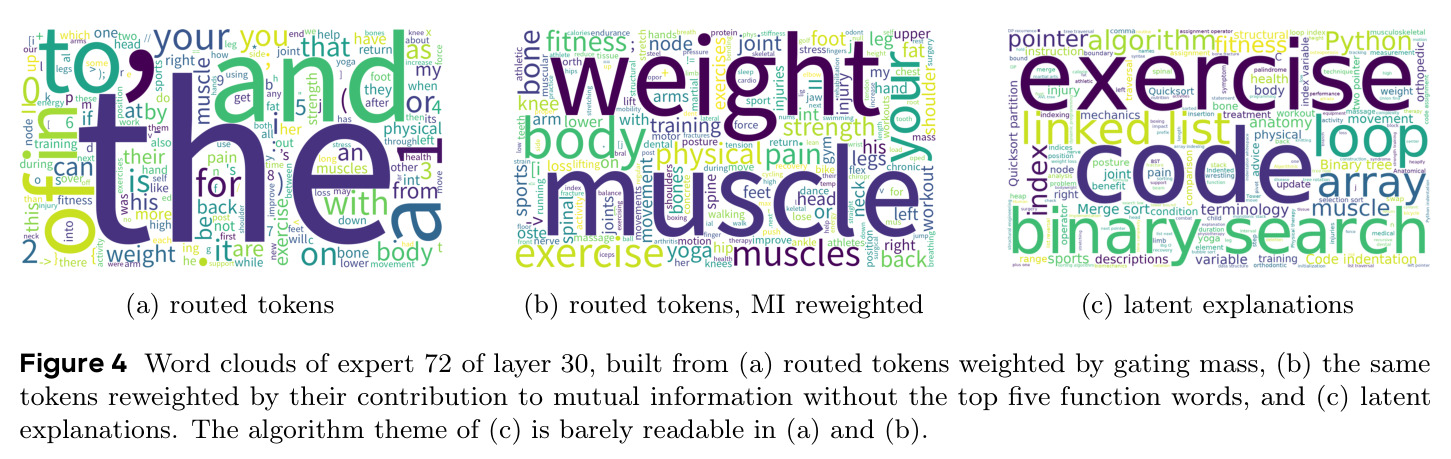
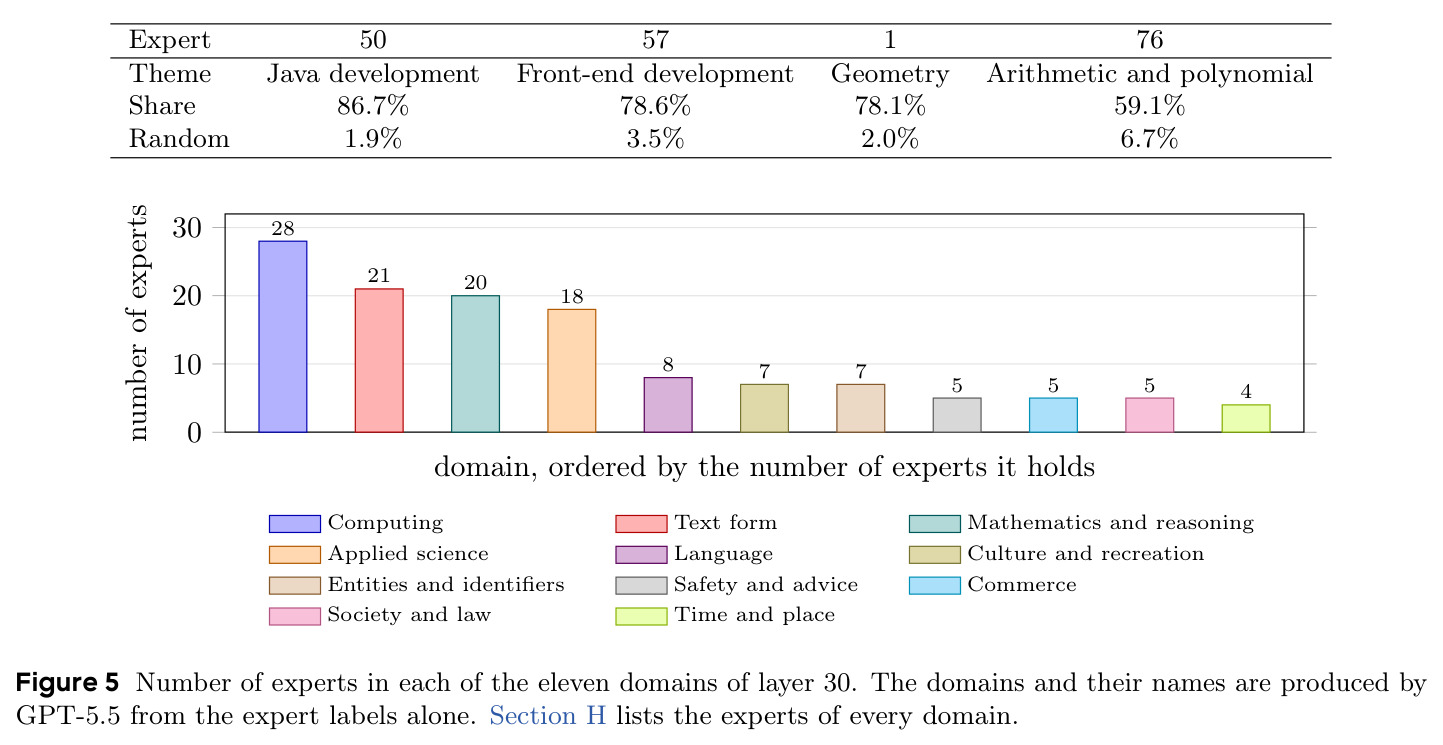
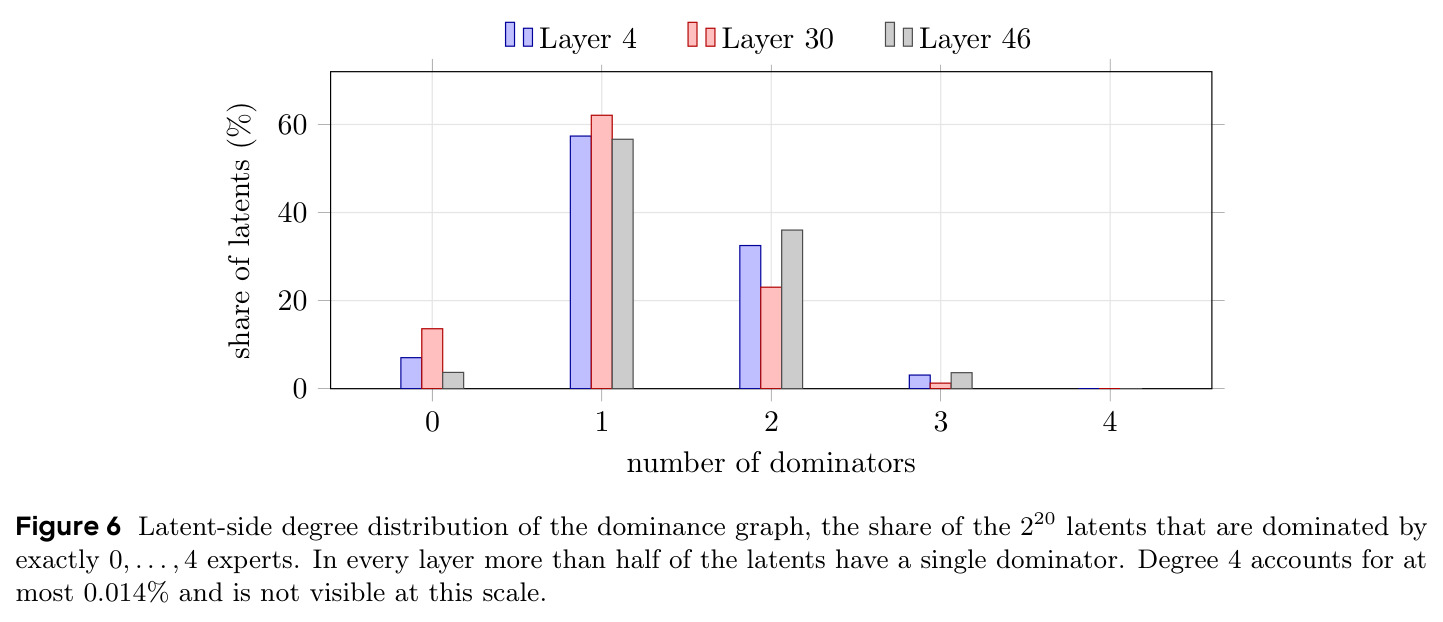
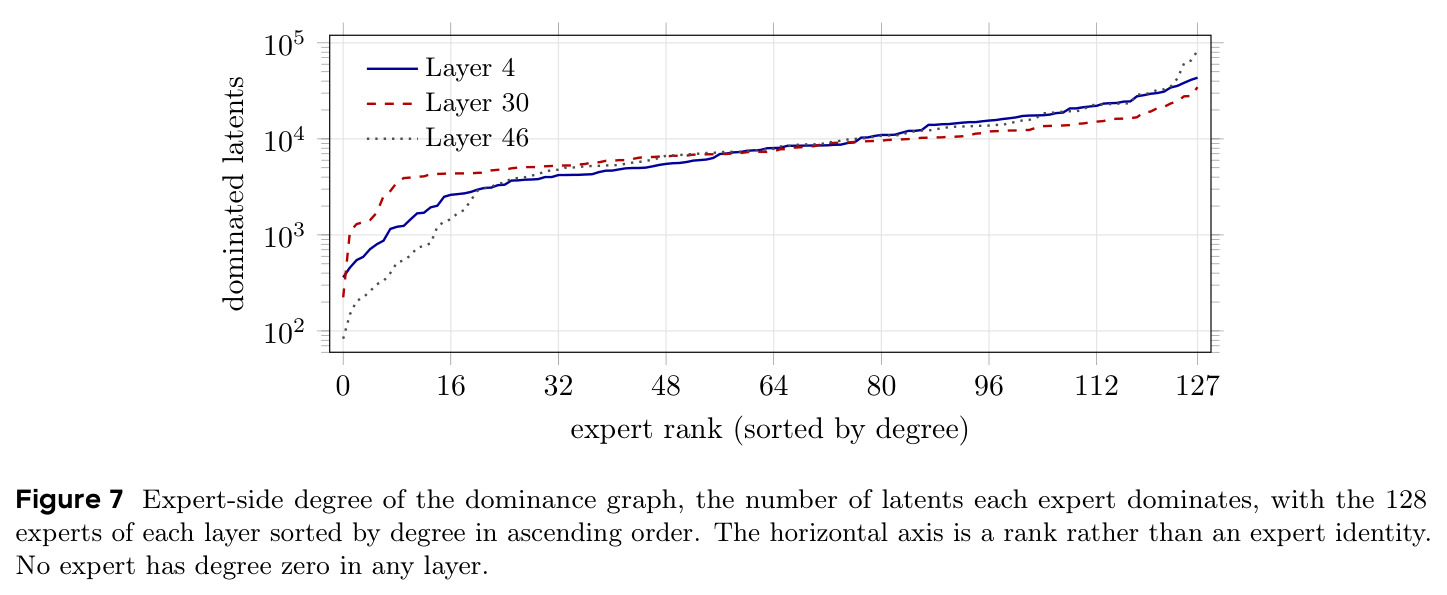
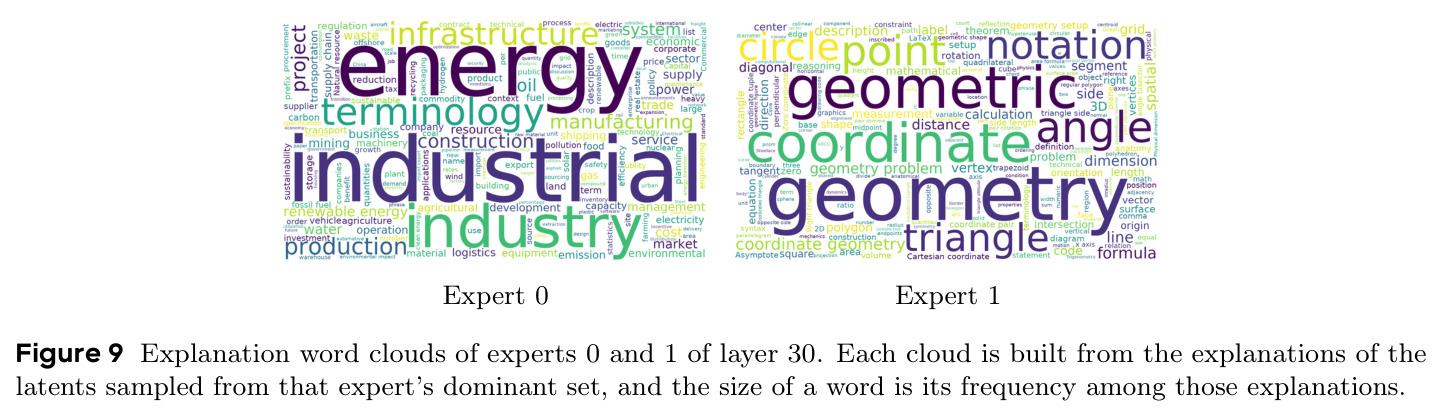
论文在 Qwen3-30B-A3B 的层 4/30/46 上有四组发现。(1) 贡献远比门控集中:层 30 按排名平均,门控前三 0.231/0.169/0.137,贡献前三 0.512/0.185/0.115、首位独占过半,$r=7$ 时 $\bar{C}_7=0.005$ 对 $\bar{g}_7=0.074$;ReLU 截断平均仅影响 2.09/1.29/1.64 个专家,排除人为陡化。(2) 潜变量支配集中:57.4%/62.1%/56.7% 的潜变量只有一个主控者,含两个达 89.9%/85.1%/92.7%,度 ≥3 不超过 3.7%;128 个专家全部有非空主导集,度前十的专家至多持 30.1% 的边(均匀应 7.8%)。(3) 重叠集中成对:8128 个专家对的中位 Jaccard 约 $10^{-4}$,37.5%-40.5% 完全不共享,重叠最大 10% 的对承担 83.8%/78.5%/81.0% 的总交集;$J>0.05$ 仅 25/20/46 对,层 30 最大 20 对中 19 对同域(基率 12.8%);每专家主导集 46%-59% 为其独占。(4) 语义解读:E50 为 Java 专家(86.7% 解释属 Java 开发,随机基线 1.9%)、E57 前端 Web(78.6% 对 3.5%)、E1 几何(78.1% 对 2.0%)、E76 算术与多项式(59.1% 对 6.7%);E72 的 token 词云只剩 the/and/of 功能词,潜变量词云却呈现“算法+运动健康”双主题,潜变量 F97783 只在二分查找的 <= 处激活;128 专家聚成 11 个领域:计算 28、数学推理 20(合计 37.5%)、文本形式 21,艺术仅 1/128。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 专家贡献 vs 门控集中度(层 30) | 按排名平均的首位占比 | 贡献 $\bar{C}_0 = 0.512$ | 门控 $\bar{g}_0 = 0.231$ | 首位贡献约为首位门控的 2.2 倍,且 $r=7$ 时 0.005 对 0.074,集中度差距进一步拉大 |
| 潜变量主控专家数量(层 4/30/46) | 单一主控者潜变量占比 | 57.4% / 62.1% / 56.7% | 若激活均匀来源于 128 个专家,单专家份额约 1/128 ≈ 0.8% | 绝大多数潜变量的激活集中于 1-2 个专家而非 8 个被选专家 |
| 专家主题纯度:E50(Java 开发) | 主导集潜变量解释属主题比例 | 86.7% | 其余 127 专家潜变量随机抽样 1.9% | +84.7 个百分点 |
| 专家主题纯度:E57(前端)/ E1(几何)/ E76(算术与多项式) | 主题归属比例(GPT-5.5 判定) | 78.6% / 78.1% / 59.1% | 随机基线 3.5% / 2.0% / 6.7% | 分别高出约 75 / 76 / 52 个百分点 |
| 主导集重叠结构(层 4/30/46) | 重叠最大的 10% 专家对承担的总交集份额 | 83.8% / 78.5% / 81.0% | 均匀分布时应为 10% | 重叠极度集中于少数成对专家($J>0.05$ 的对仅占 0.25%-0.57%) |
| SAE 重建质量(层 4/30/46) | 未解释方差比例 FVU | 12.6% / 25.1% / 7.6% | 无外部基线;中间层最难重建,与 Gao et al. 的观察一致 | 层 30 误差较大,是该层结论的主要质量短板 |
局限与改进
作者承认三点局限:其一,分析继承 SAE 的不完美——层输出重建有误差(层 30 的 FVU 高达 25.1%),且一个真实特征可能被拆分到多个潜变量或被吸收进别的潜变量,潜变量不是干净基;其二,统计基于自选语料(Olmo 3 混合数据)而非 Qwen3 未公开的预训练数据,因此“专家领域分配反映训练数据配比”(借 Llama 3 公开的约 25% 数学推理 + 17% 代码配比旁证)只是猜想;其三,只报告了单个模型,结论普适性未知。我补充自己的观察:解释潜变量、判定主题归属、命名专家、划分领域四步全部由 GPT-5.5 完成,存在“用 LLM 验证 LLM 读数”的循环风险;仅分析了 48 层中的 3 层;$\tau = 0.2$ 和每专家 2000 潜变量的采样没有做鲁棒性扫描;方法只统计正贡献,意味着“抑制型”专家角色在结构上不可见;全文没有任何因果实验(如删除专家)来验证主导集确实对应功能影响。
独立分析的弱点
独立分析的弱点:(1) 缺乏因果验证——“移除或编辑专家主要影响其主导潜变量”只是作者留下的可检验假设,改进方向是做专家剪枝、合并与引导实验,直接测量下游表现与被支配潜变量激活的变化。(2) 评估闭环——GPT-5.5 既当解释器又当裁判又当汇总器,86.7% 对 1.9% 的纯度差可能部分来自解释器风格自一致而非模型结构;改进方向是抽样数百条解释交人类标注一致性,或换用不同模型做裁判。(3) 词频词云可能稀释低频关键主题——作者自己演示了 token 词云会淹没算法主题,按词频聚合的解释词云同理;改进方向是用主题聚类替代词频。(4) 层覆盖薄——仅 3/48 层,而中间层 SAE 的 FVU 最高(25.1%),恰是最脆弱的一层承担了大部分语义展示。(5) 贡献度量含 $g_j$ 因子,门控极小的专家即使方向高度对齐也难主导潜变量,可能低估低门控专家的专用功能;改进方向是补充剥离门控尺度的方向对齐度对照。(6) 静态语料统计未覆盖分布外输入(多语言、长上下文),无法回答 OOD 下分工如何迁移。
未来方向
作者提出的方向:把分析扩展到更多、更大的 MoE 模型以检验哪些观察具有普遍性;用同一工具比较不同路由目标与负载均衡损失如何塑造分工;改进 MLP 的特征分解方法以锐化 MoE 层的图景。基于本文成果可以自然延伸的方向:(1) 用主导集指导专家剪枝与合并——$J > 0.05$ 的成对专家(如层 30 的 83/105 标点对、77/107 乱码对)是合并的天然候选,可验证压缩后性能保持;(2) 特征级模型编辑与引导——定向增强或抑制某专家以精准影响其主导特征所对应的行为;(3) 大规模相关性研究,把专家-领域配比与多种模型的公开训练配比对照,检验“分配反映数据混合”假说;(4) 把支配图用作训练时的诊断与正则信号,鼓励或打散特定粒度的特化;(5) 扩展到有共享专家或细粒度专家的架构(如 DeepSeek-V3 的 256 专家),检验架构差异对分工粒度的影响;(6) 在预训练过程中周期性计算支配图,监控分工随训练的演化动态。
复现评估
开源程度较高:SAE 权重与分析代码已在 GitHub 公开(ByteDance-Seed/SAE-Interprets-MoE),模型 Qwen3-30B-A3B 公开可得,激活数据来自公开的 Olmo 3 语料(5/8 预训练、1/4 思维链、1/8 指令微调)。附录 I 给出全部训练细节(batch 8192、约 3.2B token、$\kappa$ 由 1000 衰减到 100、峰值学习率 $8 \times 10^{-5}$),附录 E-G、J 完整复刻了全部 GPT-5.5 提示词(解释、主题判定、命名、分组)。算力需求:需对 30B 模型前向约 3.2B token × 3 层转储激活,并训练三个 $2^{20}$ 潜变量的 SAE(单个编解码各约 20 亿参数),属多 GPU 数天级工程;解释阶段需对海量潜变量调用 GPT-5.5(每专家至多 2000 个 × 128 专家 × 多层),API 费用可观。总体难度中等偏上:流程与提示词齐全、无需训练原模型,但转储与解释开销不小;GPT-5.5 为商用 API,版本漂移可能使标签细节无法逐字复现。
论文图表