稀疏自编码器表示的行为可组合性 Behavioral Compositionality of Sparse Autoencoder Representations
提出SAR指标量化SAE特征行为交互,学习坐标比旋转更可加但pairwise项仍不可或缺
前置知识
稀疏自编码器(SAE)
一种无监督字典学习模型,把语言模型激活 $h\in\mathbb{R}^d$ 编码为高维稀疏特征激活 $z$,再用线性解码器 $\hat h=\sum_i z_i d_i$ 重建激活,目标是让每个解码方向 $d_i$ 对应一个可解释概念。Gemma Scope 等公开 SAE 使其成为机械可解释性的标准工具。
本文研究的正是:线性解码保证的重建可加性能否延续到下游行为效果的可加性。
联盟干预与集合函数
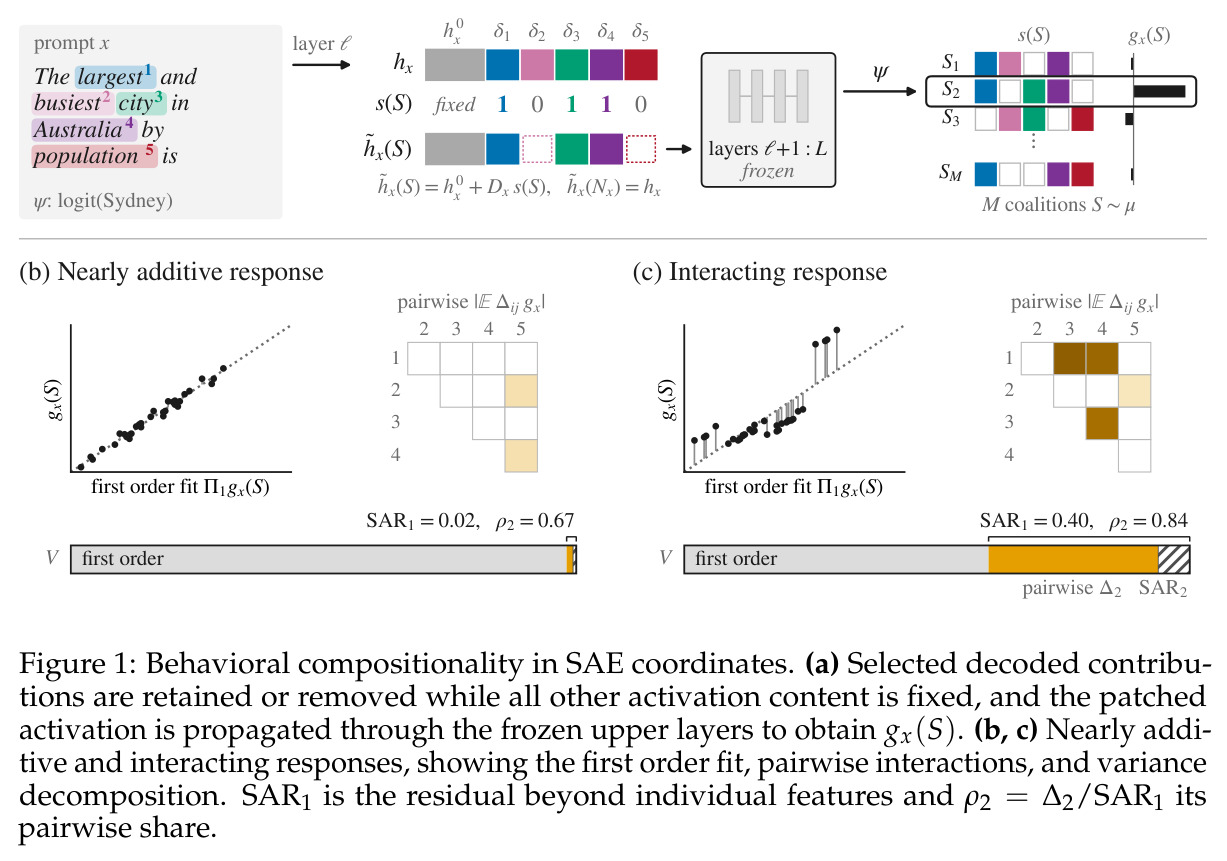
把一组特征视为博弈中的玩家:对每个 prompt 取 top-$K$ 活跃特征的解码贡献,保留子集 $S$、移除其余并冻结剩余激活内容,经冻结的上层传播得到标量行为读数 $g_x(S)$。这是定义在 $2^K$ 个子集上的集合函数,实际用子集采样代替穷举评估。
SAR、交互分解、联盟排序误差全部定义在这个受控响应 $g_x(S)$ 上,是全文度量的对象。
交互指数(Shapley 类分解)
刻画多玩家联合效应的经典工具,如 SHAP、Shapley-Taylor 交互指数,用差分算子 $\Delta_B g(S')=\sum_{C\subseteq B}(-1)^{|B|-|C|}g(S'\cup C)$ 度量集合 $B$ 内玩家在背景 $S'$ 上的联合贡献,其平方和构成方差分解。
Theorem 1 用这类交互项给出 SAR 的精确等价形式,附录 C 讨论了与交互指数文献的联系。
导向向量与引导干预
通过向激活加入固定方向来改变模型行为的干预手段。CorrSteer 等方法从 SAE 特征导出可用于引导的方向,单方向效果容易测量,但多方向组合叠加时效果是否可加此前缺乏检验。
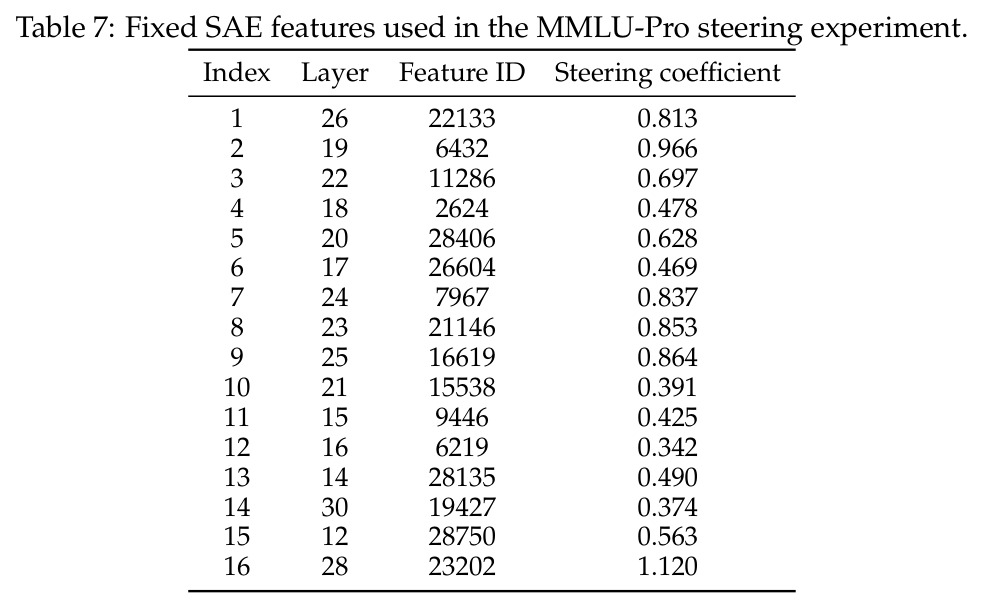
4.6 节的组合引导实验直接检验:单独测得的引导效果能否相加预测组合引导结果。
研究动机
稀疏自编码器(SAE)已成为解释语言模型内部计算的标准工具:它把激活分解为稀疏的线性解码特征,被广泛用于构建特征电路、多特征联合解释和行为干预(如 Marks et al. 2025 的 attribution graphs、Ameisen et al. 2025 的 feature circuits)。但这里存在一个被普遍忽视的缺口:线性解码器只保证激活层面的重建是可加的,$\tilde h=h^0+\sum_i\delta_i$;特征贡献经过剩余几十层非线性计算后,其行为效果可能相互增强、抑制或条件依赖。现有 SAE 评估只覆盖重建误差、稀疏性和单特征可解释性(Karvonen et al. 2025、Engels et al. 2025 等),完全无法回答\u201c已知各特征单独效果后,联合效果能否用求和预测\u201d这一实践问题——而这恰恰是把多个特征组合成电路、联合解释或引导干预时最需要的保证。
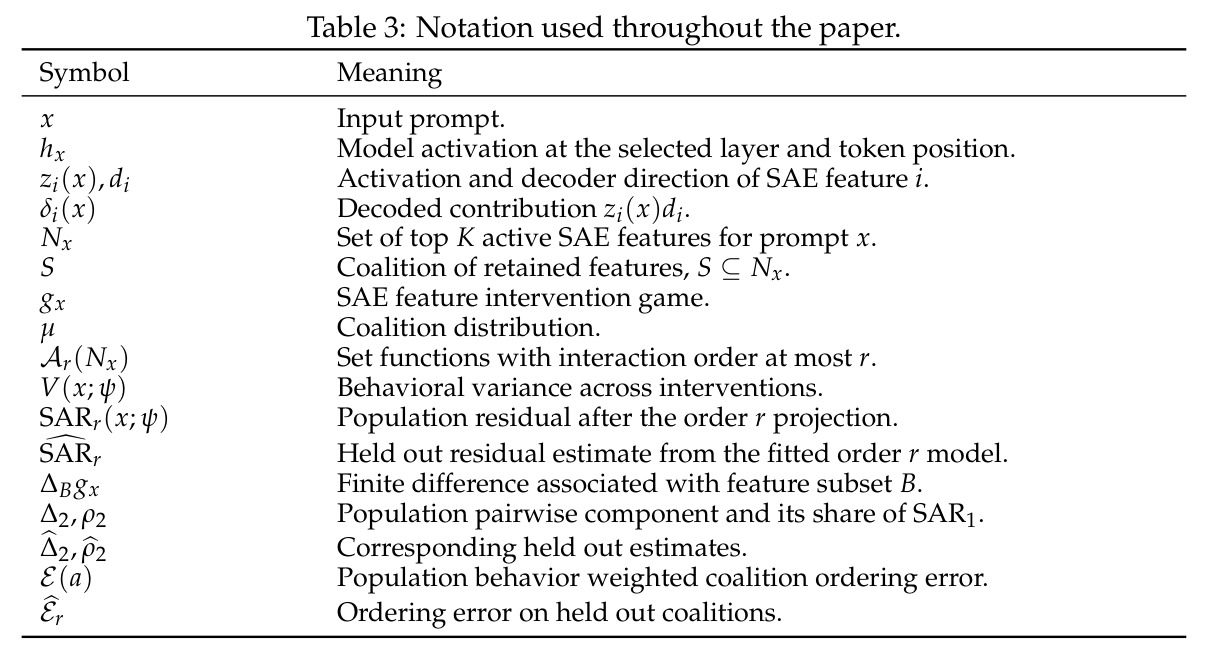
本文的目标是本文要建立一个直接测量 SAE 坐标\u201c行为可组合性\u201d的框架。具体目标分三层:(1) 对每个 prompt 定义受控子集响应 $g_x(S)$,引入 SAE Additivity Residual(SAR),量化在选定交互阶 $r$ 之上仍未被解释的行为方差比例,$SAR_r=\|g_x-\Pi_r g_x\|^2_\mu/V(x;\psi)$;(2) 把低阶逼近误差与显式高阶交互的能量、以及联盟排序误差联系起来,给出可解释的理论界;(3) 用和保持随机旋转做对照,判断可组合性到底是子空间加下游计算的属性,还是学习坐标本身的属性,并检验 pairwise 交互项能否实际改善联合解释与引导预测的忠实度。
与已有工作不同的是,已有工作分三条线,都没有覆盖这个问题:SAE 评估刻画重建与单特征性质(重建残差保留结构、概念跨 latent 吸收、多维特征);多项式 SAE(Koromilas et al. 2026)在解码器里显式加入高阶项,但改变的是表示本身而非测量固定 SAE 组合后的行为;交互指数文献(SHAP、Shapley-Taylor 等)有交互度量但玩家不是学习的稀疏特征。本文的独特切入是:在\u201c玩家是 SAE 特征\u201d这一结构化场景中直接对下游行为响应测量交互的阶分布,并用 $D_x^Q=D_xQ$($Q$ 正交且 $Q\mathbf{1}=\mathbf{1}$)的和保持旋转把坐标选择与子空间、总贡献、下游计算严格解耦。这是第一个把\u201c特征组合后行为是否可加\u201d当作可精确分解、有统计保证的量来研究的工作。
核心方法
直觉上,作者把 SAE 特征当作联盟博弈里的玩家,把模型行为当作收益函数,问一阶(个体效应)逼近能在多大程度上解释真实收益。流程四步。第一步构造受控干预:对 prompt $x$ 取 SAE top-$K{=}16$ 活跃特征的解码贡献 $\delta_i(x)=z_i(x)d_i$,保留子集 $S$ 得 $\tilde h_x(S)=h_x^0+D_x s(S)$($h_x^0$ 固定含重建残差),传播过冻结的第 $\ell{+}1{:}L$ 层得标量读数 $g_x(S)=\psi(\mathcal{F}_{\ell\leftarrow\tilde h_x(S)}(x))$,如 logit(Sydney)。第二步用不超过 $r$ 阶的集合函数类 $\mathcal{A}_r=\{a(S)=\sum_{|B|\le r}\theta_B\mathbf{1}\{B\subseteq S\}\}$ 做最小二乘逼近,$SAR_r=\|g_x-\Pi_r g_x\|^2_\mu/V(x;\psi)$。第三步证明理论性质:独立伯努利采样时 $SAR_r$ 恰等于 $r$ 阶以上交互的归一化能量,且 $E(\Pi_r g_x)\le SAR_r$ 控制联盟排序误差。第四步每 prompt 采 384 个联盟(256 拟合、128 评估),报告 held-out 残差、rank fidelity 与 selection regret。
核心创新有两点。其一是 SAR 的精确交互分解(Theorem 1):当特征以概率 $p$ 独立进入子集时,$c_B=[p(1-p)]^{|B|/2}E[\Delta_B g_x]$,从而 $SAR_r=\sum_{|B|>r}[p(1-p)]^{|B|}(E[\Delta_B g_x])^2/V(x;\psi)$。也就是说 SAR 不是黑盒拟合误差,而恰好是 $r$ 阶以上所有交互项的归一化能量;均匀采样($p=1/2$)时 $\Delta^2=SAR_1-SAR_2=\frac{1}{16V}\sum_{i<j}(E[\Delta_{ij}g_x])^2$,$\rho_2=\Delta^2/SAR_1$ 给出 pairwise 交互占一阶残差的份额。其二是对坐标选择的因果对照:和保持旋转 $D_x^Q=D_xQ$ 保持所选子空间、总贡献($Q\mathbf{1}=\mathbf{1}$)、固定余量与下游模型全部不变,只打乱坐标,此时 SAE 与旋转的 SAR 差距只能归因于学习坐标本身。这两个设计把\u201c是否可加\u201d从模糊的定性判断变成了有分解定理和对照实验支撑的定量科学问题。
方法步骤详情
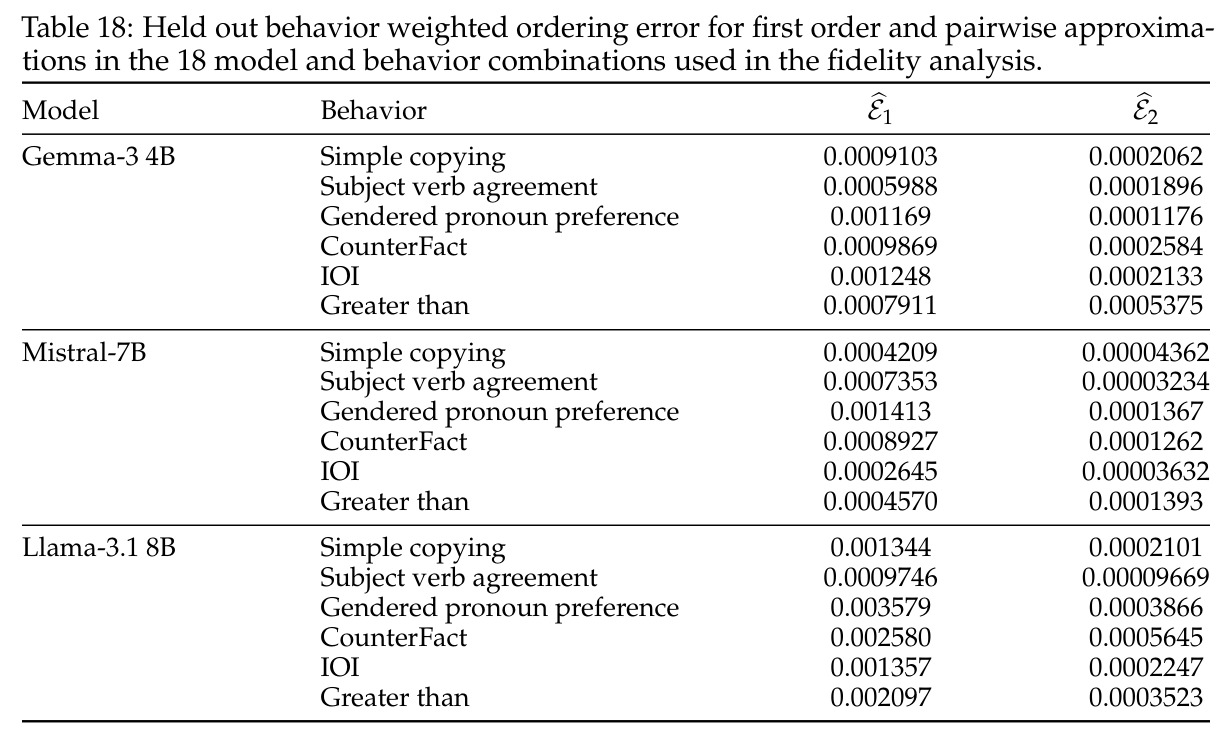
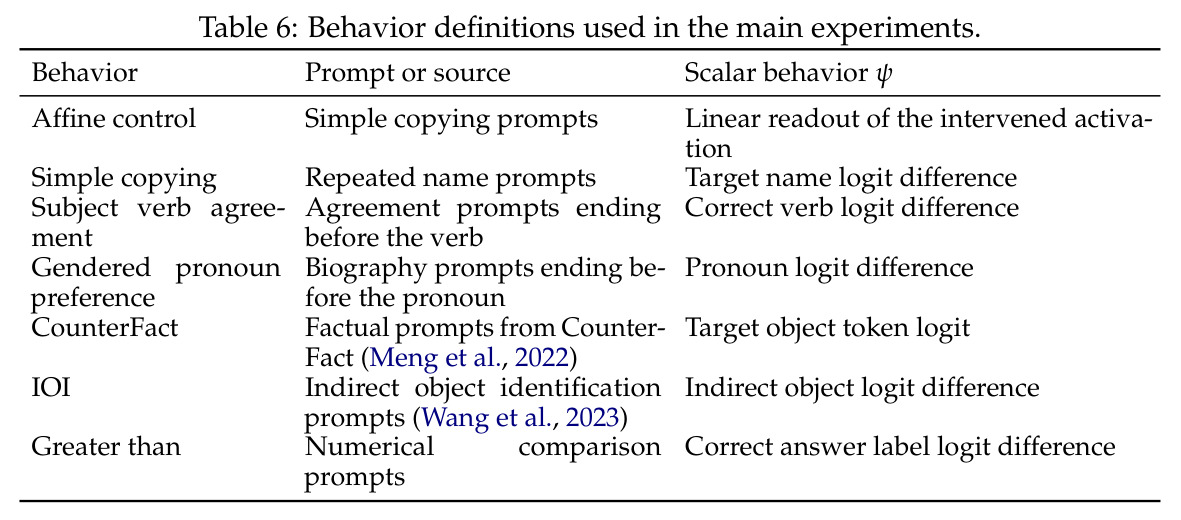
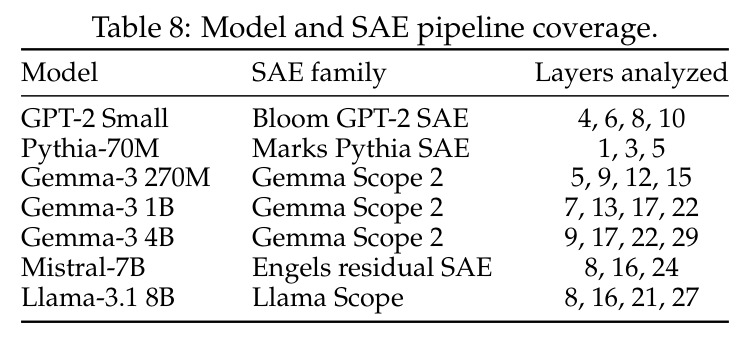
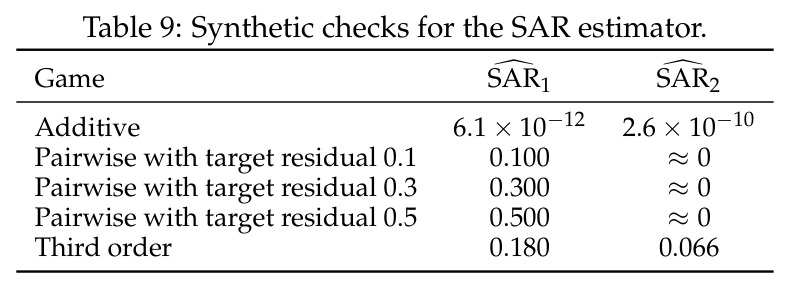
完整流程:(1) 选干预点:在模型第 $\ell$ 层某 token 位置取激活 $h_x$,用该处 SAE 得特征激活 $z_i(x)$,保留 top-$K{=}16$ 得贡献矩阵 $D_x$ 与基座 $h_x^0$。(2) 采样联盟:从 $\{0,1\}^{16}$ 均匀采 384 个子集,每个 $S$ 构造 $\tilde h_x(S)=h_x^0+D_x s(S)$,冻结第 $\ell{+}1$ 到 $L$ 层传播完整 prompt,读出标量行为 $\psi$(如正确答案 logit、性别代词偏好差)。(3) 拟合低阶模型:在 256 个拟合子集上最小化 $\sum_m(g_x(S_m)-a(S_m))^2$,分别拟合 $r=1,2$ 的 $\mathcal{A}_r$,另拟合仿射对照验证数值零。(4) 评估:在 128 个 held-out 子集上计算 $\widehat{SAR}_r=\widehat{L}_r/(\widehat{V}+\epsilon)$、Spearman rank fidelity、行为加权排序误差 $\widehat{E}_r$、sign error 与 selection regret。(5) 对照:每个 SAE 基配多个和保持随机旋转重复全程;引导实验用 16 个 CorrSteer 方向在 MMLU-Pro 的 1024 个组合上重复。(6) 主设置覆盖 Gemma-3 4B、Mistral-7B、Llama-3.1 8B 三条流水线乘 6 种行为共 18 个设置。
技术新颖性
与既有工作的本质区别:多项式 SAE 修改表示结构以容纳交互,而本文保持 SAE 不变、测量其坐标在下游行为中残留的交互,回答的是\u201c现有 SAE 何时够用\u201d;SHAP 类交互指数面向任意玩家,本文利用 SAE 的稀疏 top-K 结构使 $2^K$ 空间的采样评估可行,并通过乘积测度把交互能量与 SAR 精确等价(而非近似归因);attribution graphs 等多特征解释工作隐含假设效应可组合,本文首次给出该假设的定量检验与破坏程度度量。Theorem 2 的排序保证也是新的:$E(a)\le Var_\mu(g_x-a)/V(x;\psi)\le\|g_x-a\|_\mu^2/V(x;\psi)$ 说明小 SAR 直接转化为联盟比较的可信度,这在把特征组合用于引导干预的实践场景中有直接意义。
实验结果
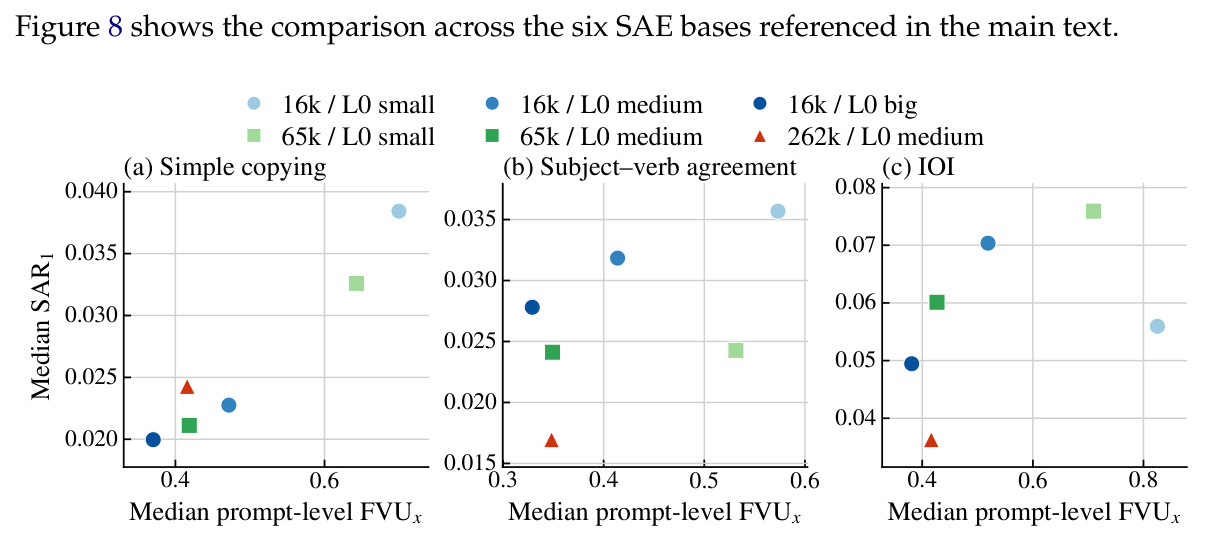
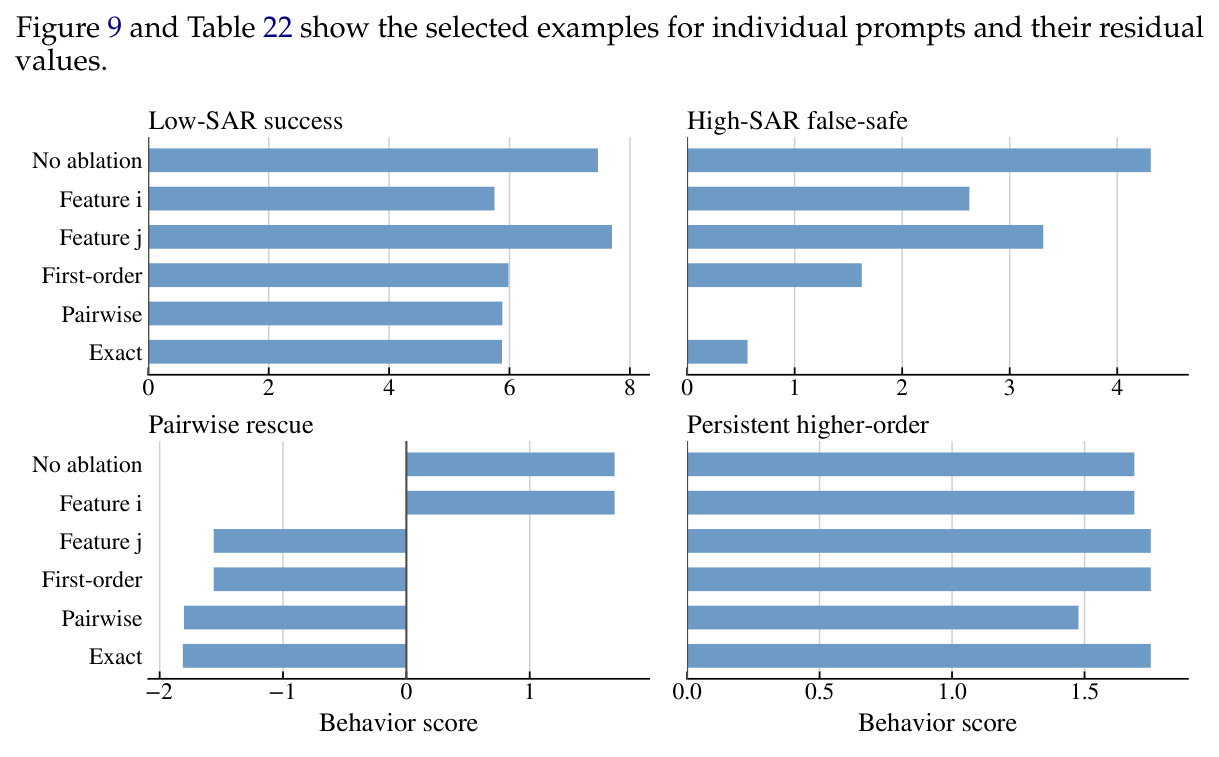
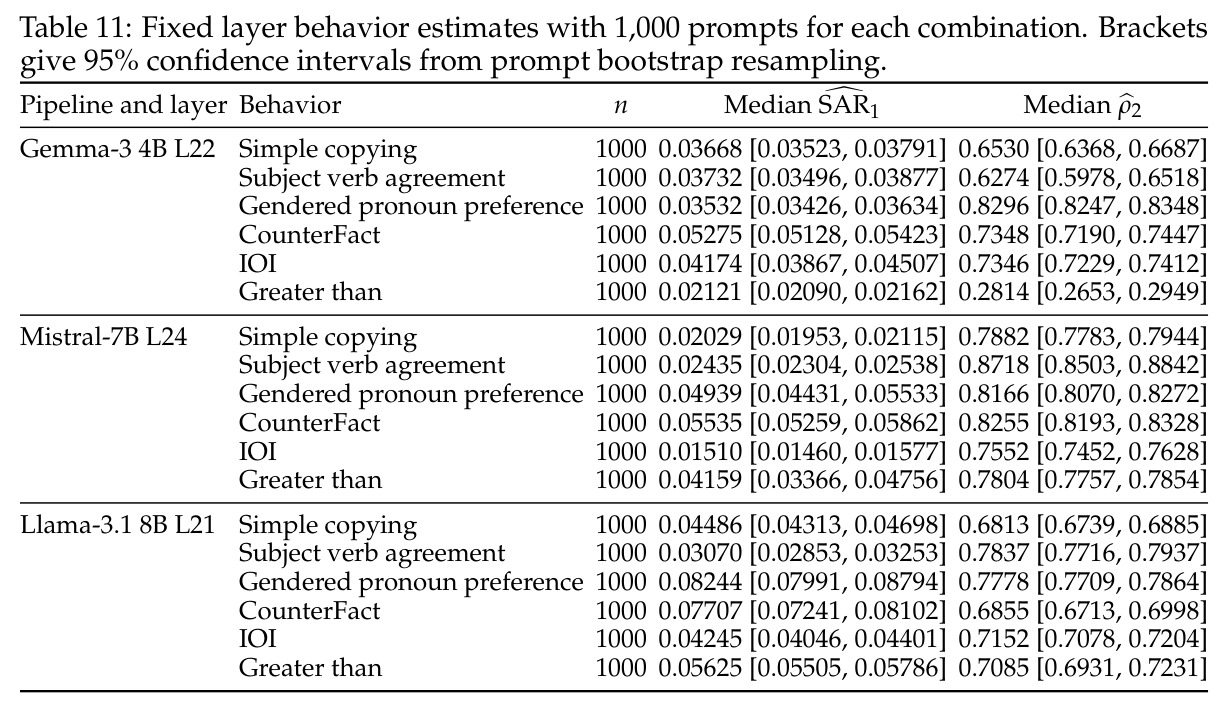
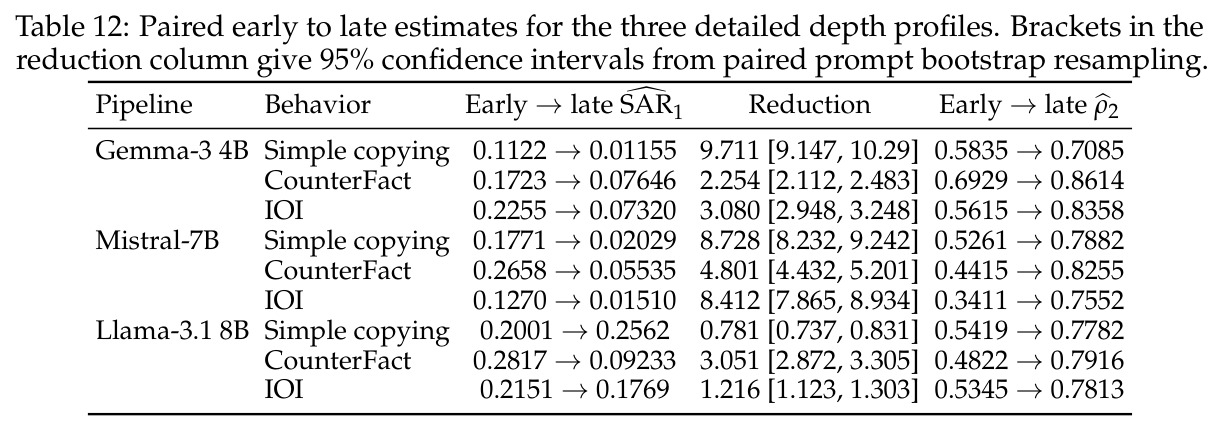
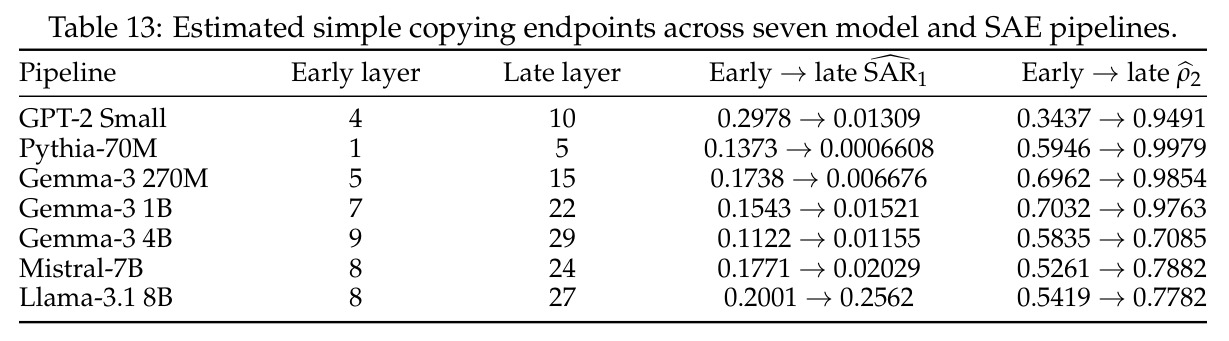
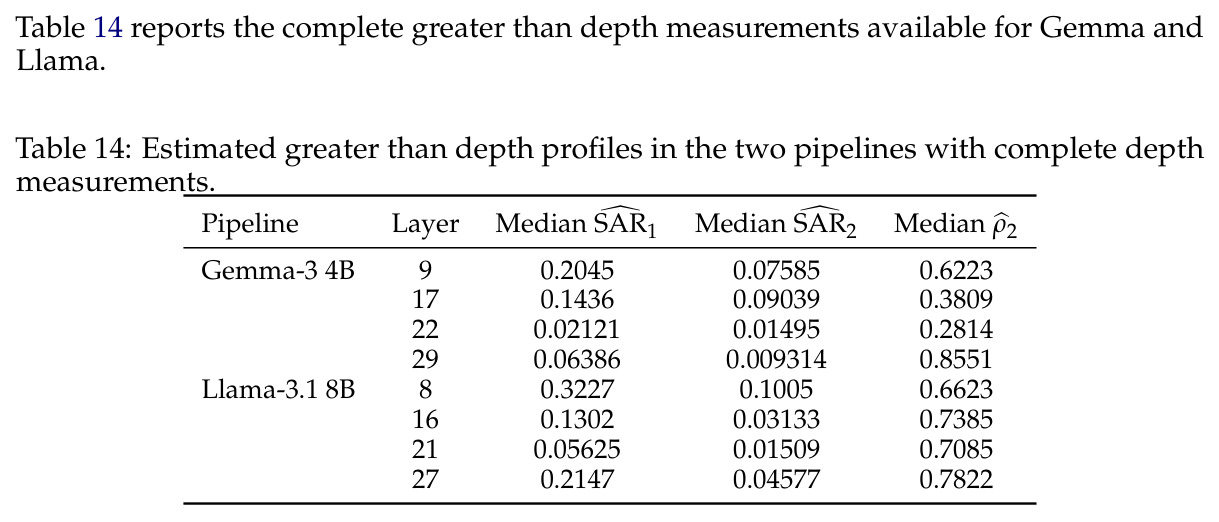
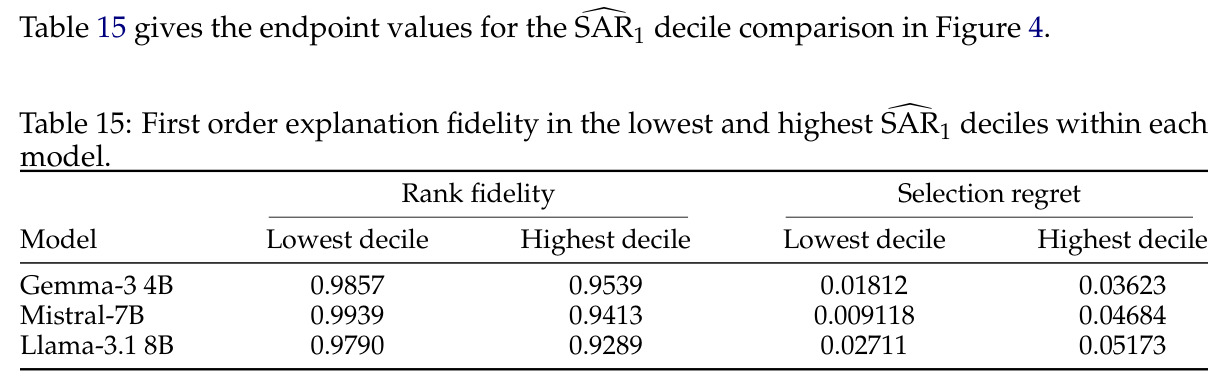
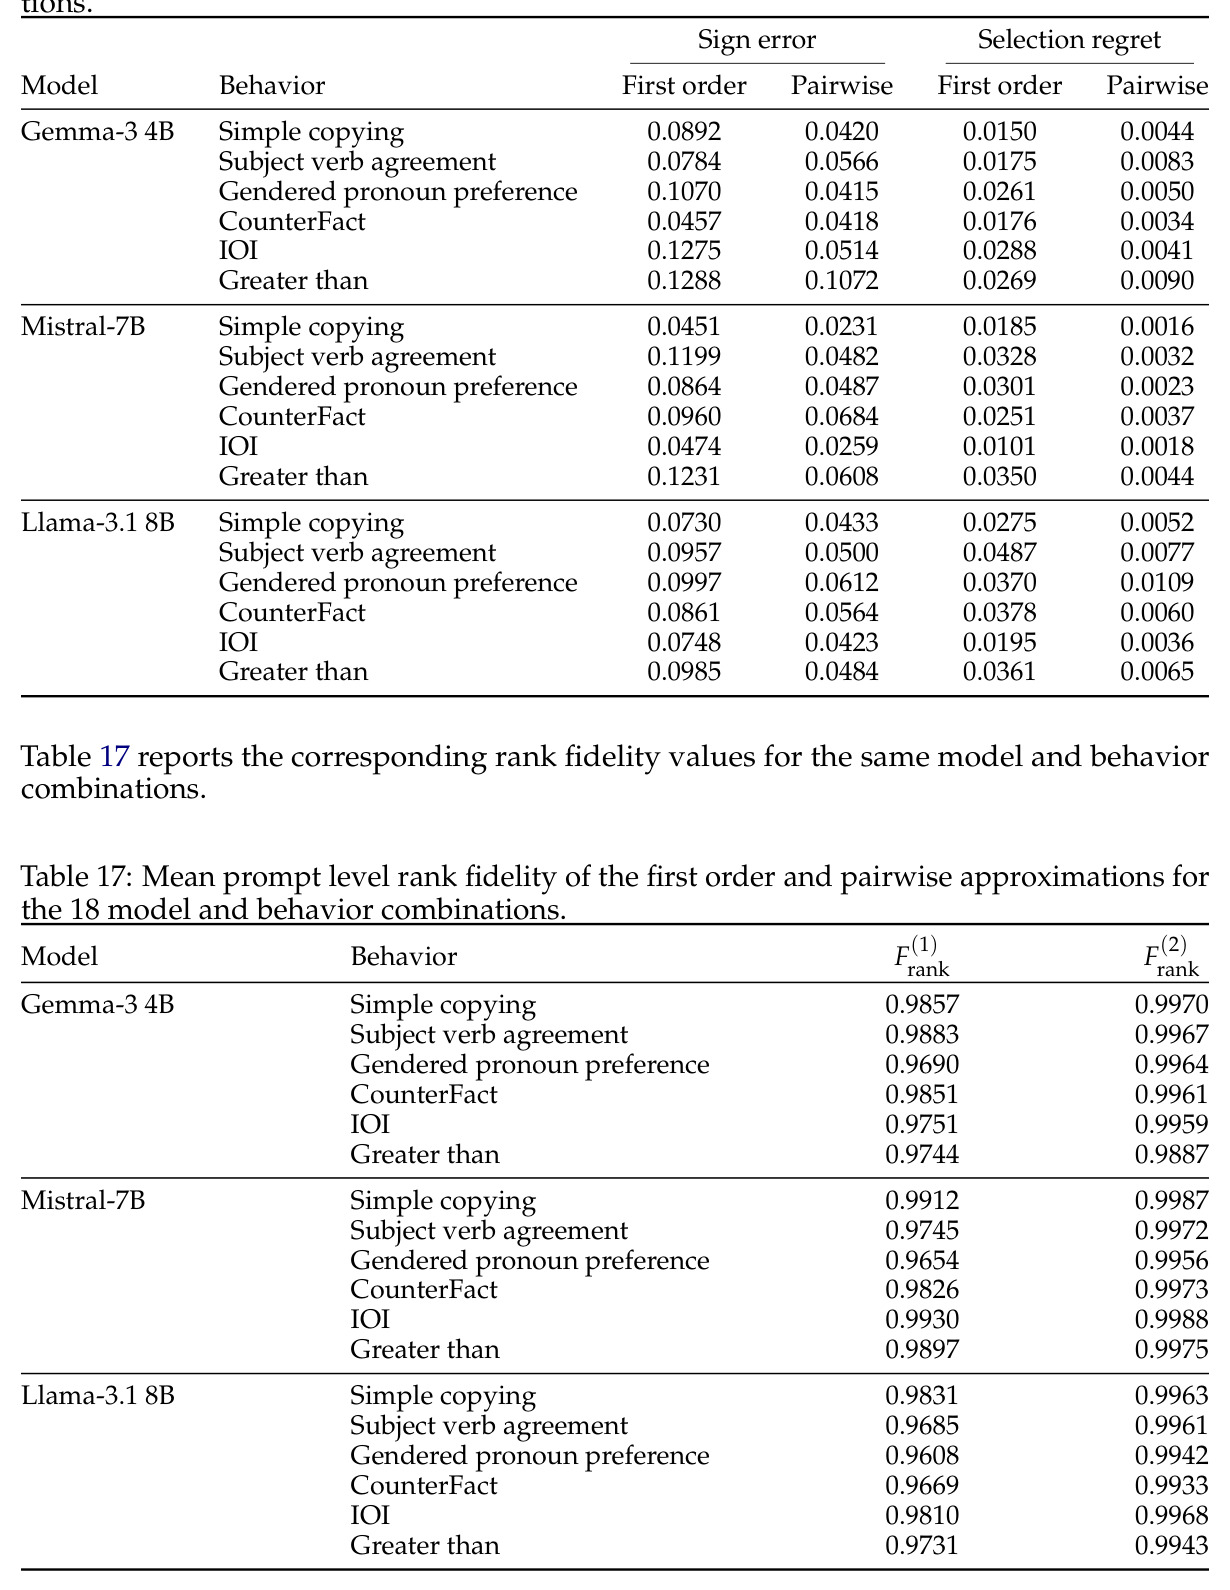
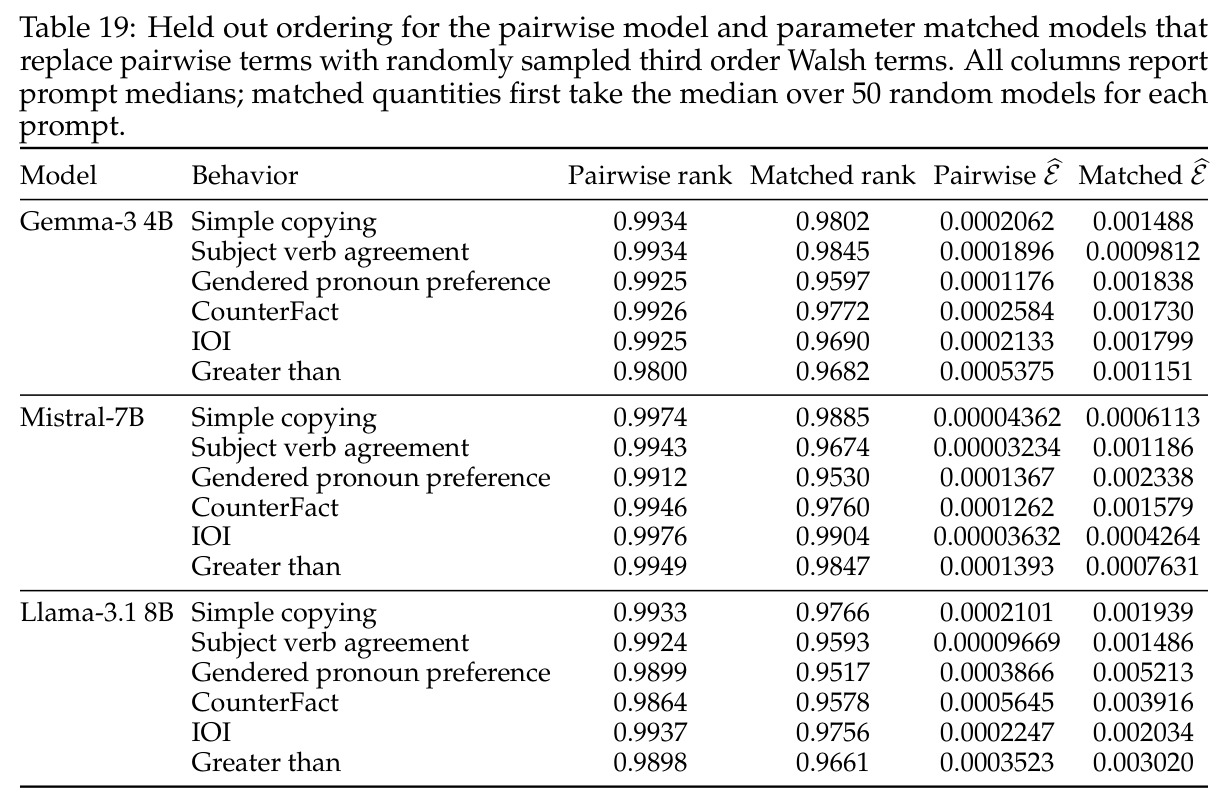
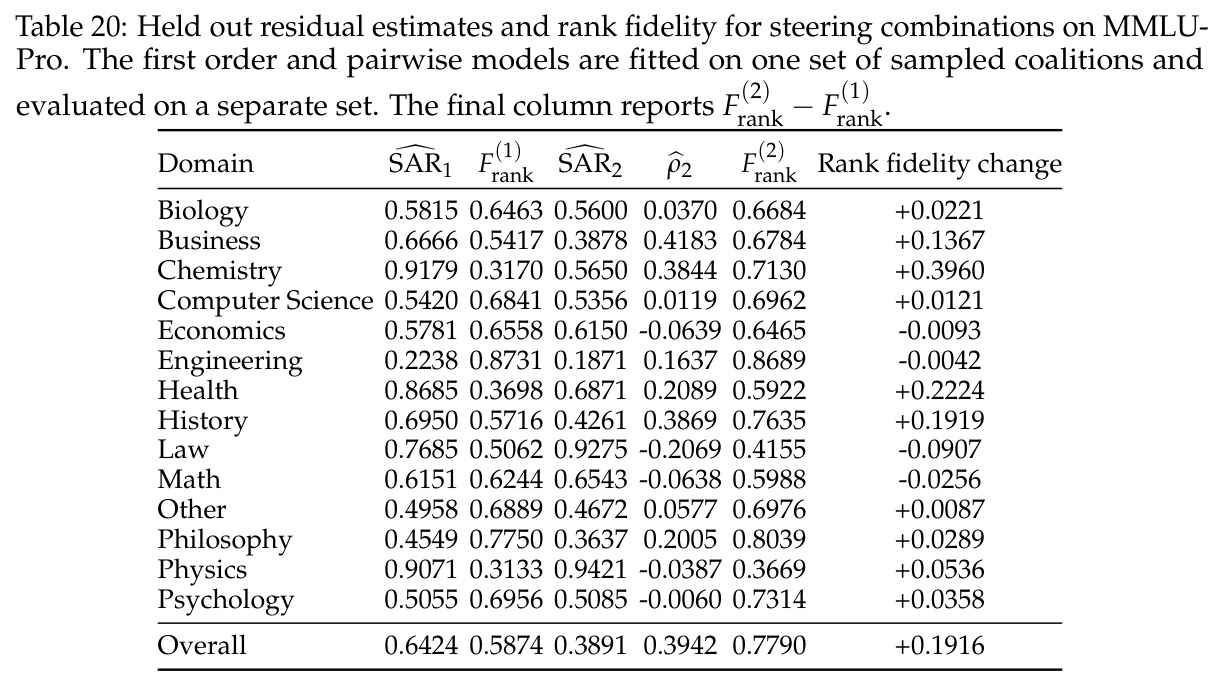
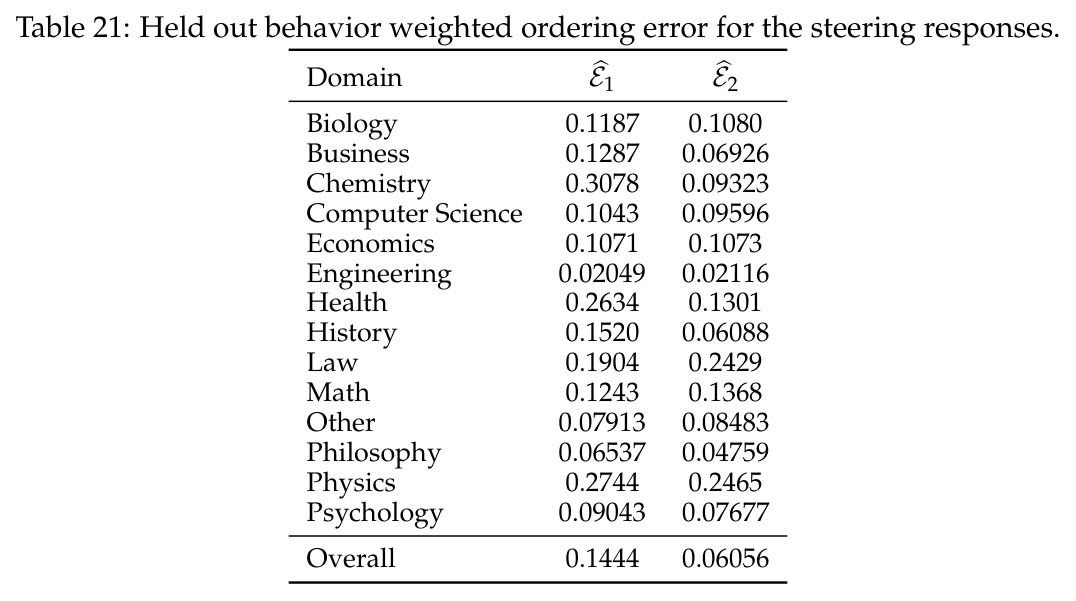
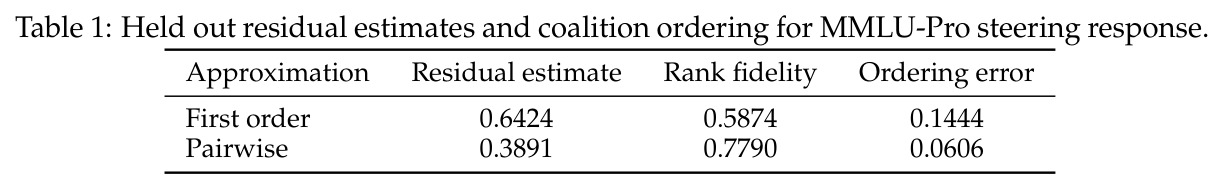
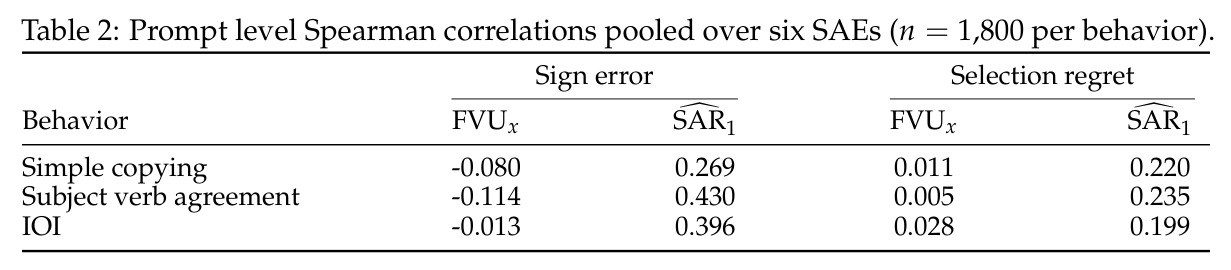
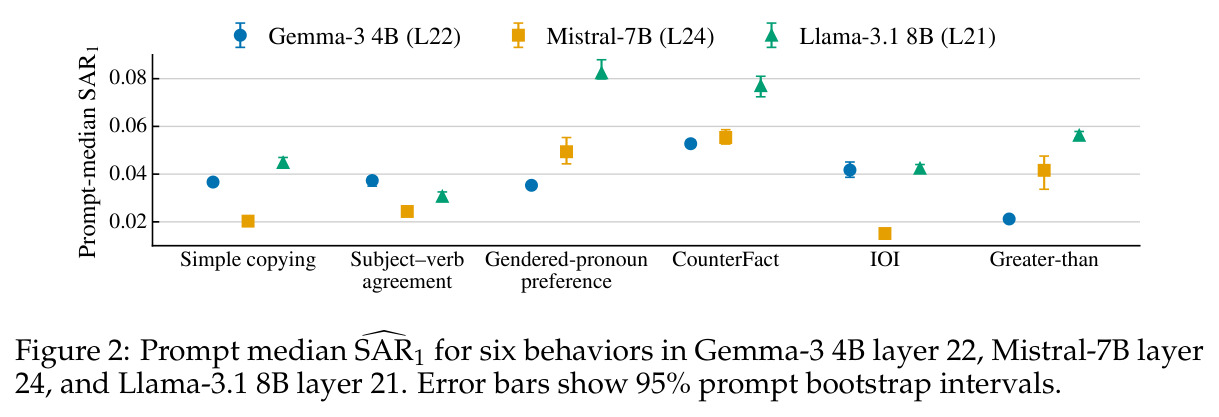
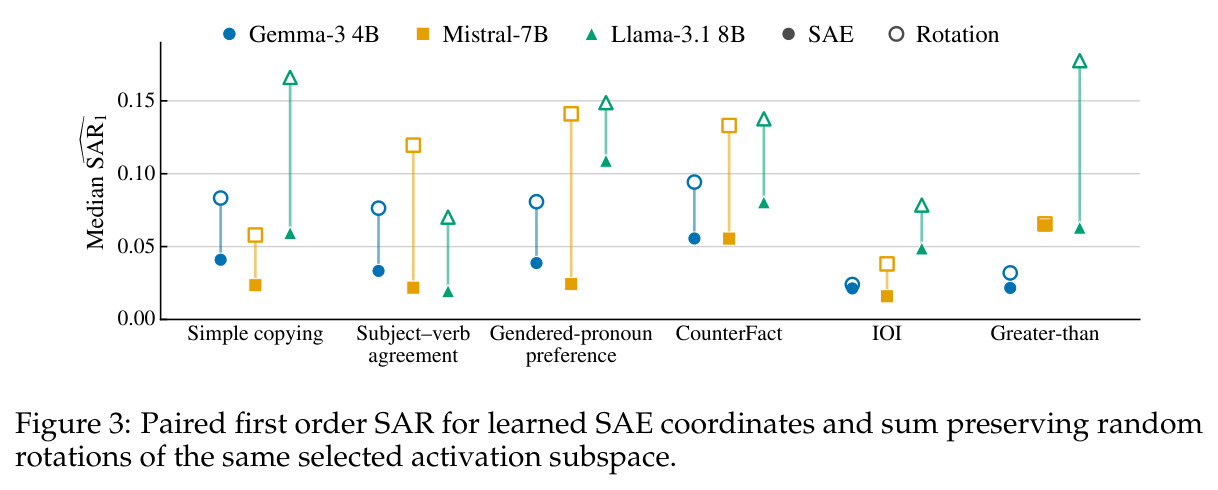
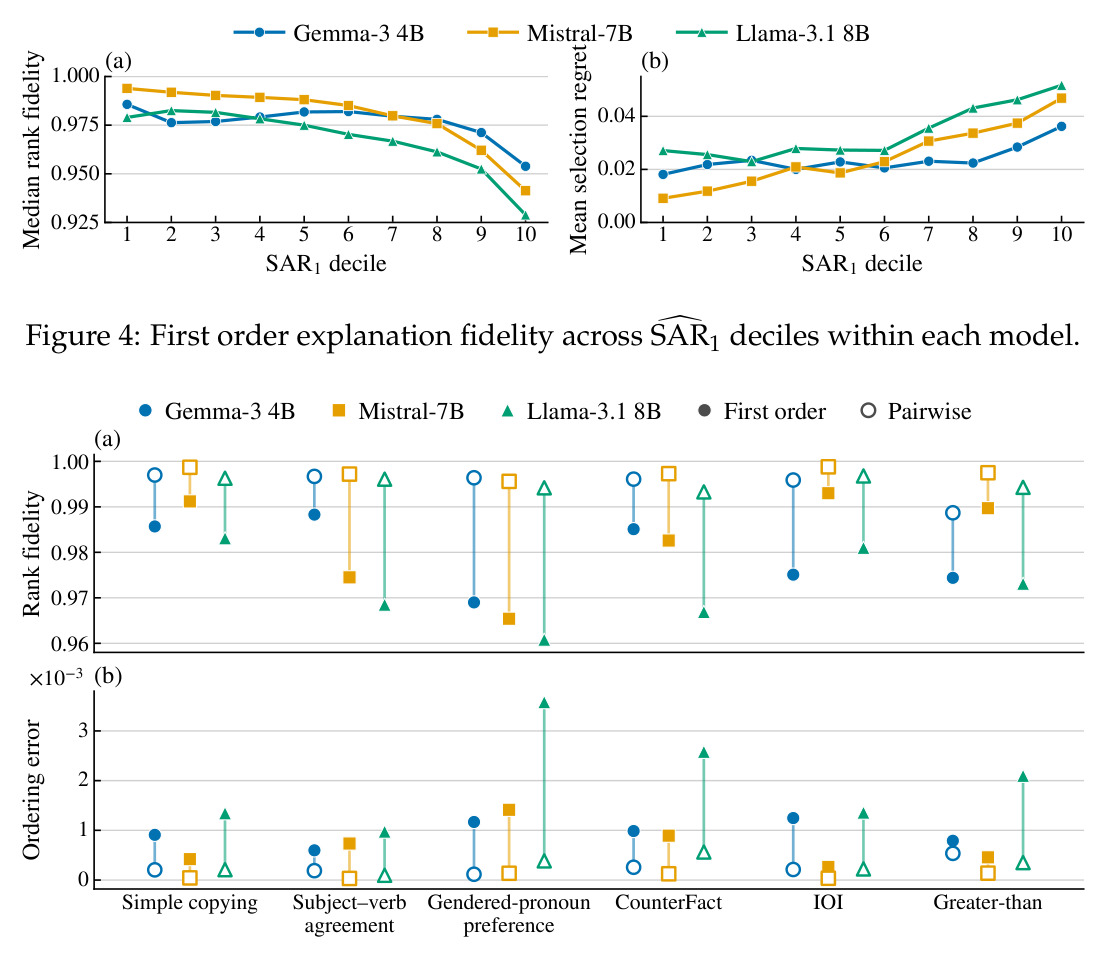
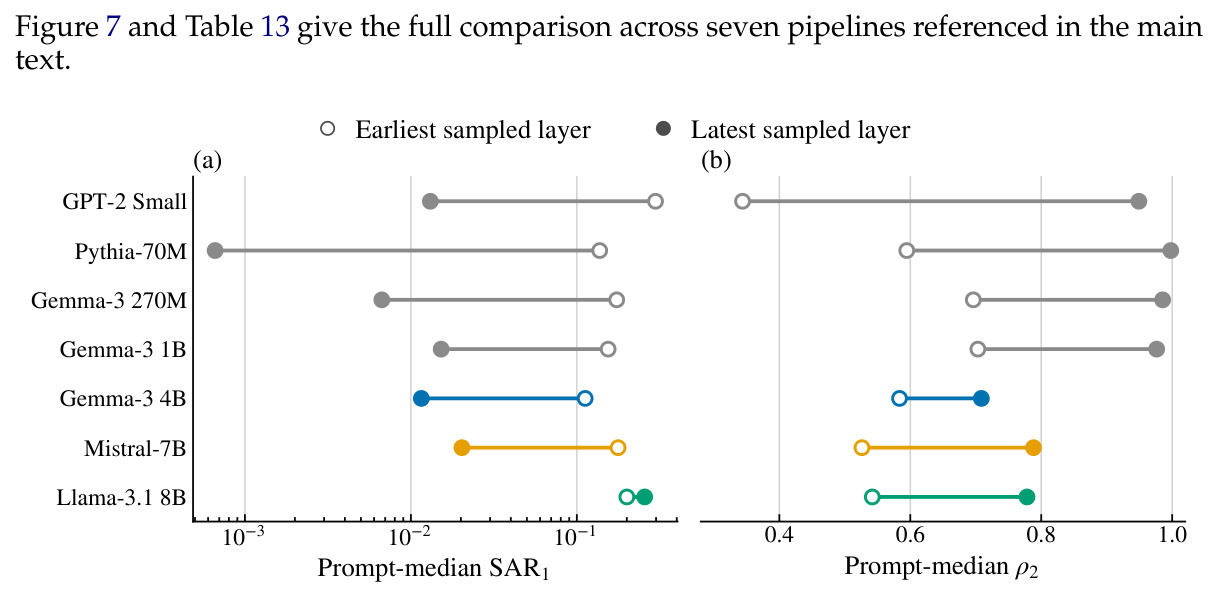
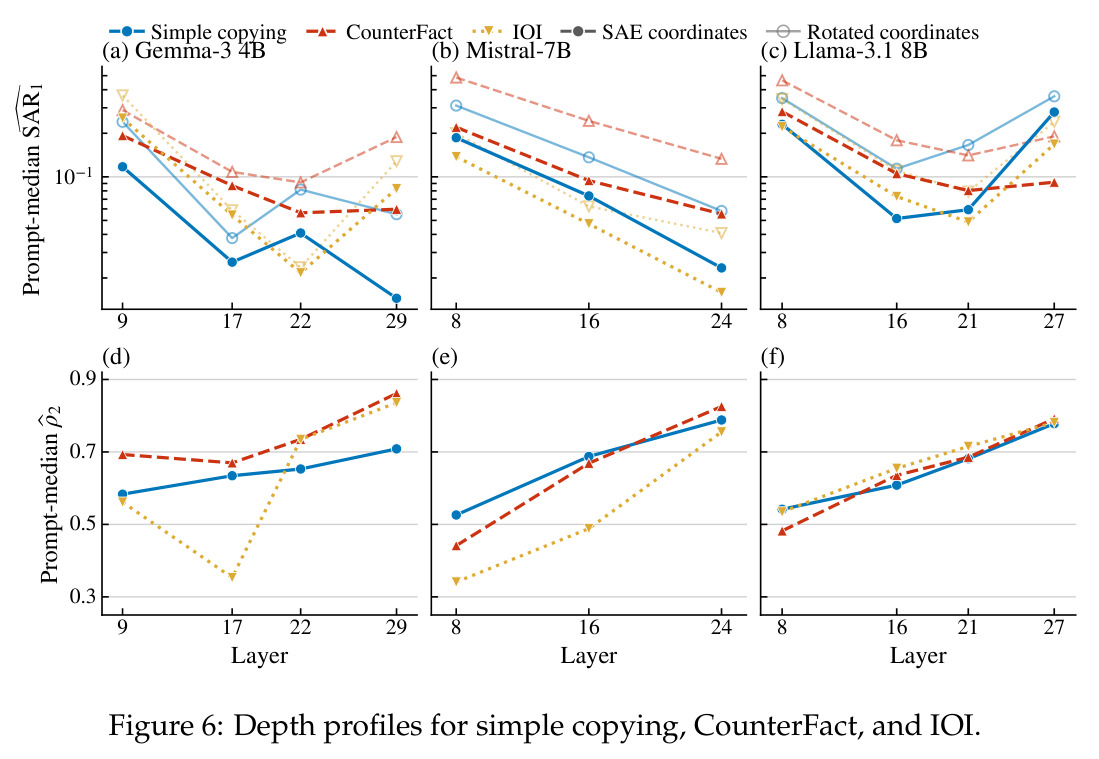
六个实验环环相扣。(1) 一阶可加性普遍不成立:57 个模型-层-行为组合的 prompt 中位 $\widehat{SAR}_1$ 全部为正(仿射对照数值为零),简单复制与主谓一致最低,CounterFact 在三条流水线中都最高。(2) 坐标选择确实重要:18 个设置中学习 SAE 坐标的 $\widehat{SAR}_1$ 全部低于随机旋转,如 Mistral 主谓一致 0.0218 对 0.1196,差距约 5.5 倍。(3) SAR 与解释质量校准:按 $\widehat{SAR}_1$ 十分位从低到高,rank fidelity 下降、selection regret 上升(Gemma/Llama 约翻倍、Mistral 约 5 倍);18 个设置中 17 个 prompt 级相关为负、14 个至少 $-0.6$。(4) pairwise 结构真实存在:18/18 设置中 rank fidelity 平均 0.9782 提升至 0.9959,selection regret 0.0272 降至 0.0051,并胜过参数量匹配的随机三阶项对照 18/18。(5) 组合引导:Llama-3.1 8B 用 16 个 CorrSteer 方向、1024 个组合、1400 题 MMLU-Pro,rank fidelity 0.5874 升至 0.7790,排序误差 0.1444 降至 0.0606,残差 0.6424 降至 0.3891。(6) SAR 与重建质量正交:Gemma-3 1B 同址 6 个匹配 SAE(每行为 n=1800),SAR 与 sign error 相关 0.20–0.43 而 FVU 为 $-0.114$–$0.028$;深度上 $\widehat{SAR}_1$ 在 9 个比较中 8 个下降、$\widehat{\rho}_2$ 全部上升,但旋转同样下降(8/9),说明部分趋势来自剩余计算更短。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 联盟排序预测(18 个模型×行为设置,held-out 子集) | 平均 rank fidelity / selection regret | 0.9959 / 0.0051(pairwise 模型) | 0.9782 / 0.0272(一阶模型) | 18/18 设置全部提升,选择后悔值平均降约 5.3 倍,且胜过参数量匹配的随机三阶对照 18/18 |
| SAE 坐标 vs 和保持随机旋转(同子空间配对比较) | prompt 中位 $\widehat{SAR}_1$ | 学习 SAE 坐标全部更低(如 Mistral 主谓一致 0.0218) | 和保持随机旋转(同例 0.1196) | 18/18 设置一致,最大差距约 5.5 倍;跨 33 个模型-行为-层比较 SAE 一致更低 |
| 组合引导预测(Llama-3.1 8B,16 个 CorrSteer 特征,MMLU-Pro 1400 题,1024 组合) | rank fidelity / 排序误差 / held-out 残差 | 0.7790 / 0.0606 / 0.3891(pairwise) | 0.5874 / 0.1444 / 0.6424(一阶) | 保真度提升 +0.19,排序误差与残差均约减半 |
| 行为保真与重建质量解耦(Gemma-3 1B 同址 6 个匹配 SAE,每行为 n=1800) | prompt 级 Spearman 相关(对 sign error) | $\widehat{SAR}_1$:0.269 / 0.430 / 0.396(复制 / 主谓一致 / IOI) | FVU:-0.080 / -0.114 / -0.013 | SAR 正相关而 FVU 为零或负,二者刻画不同的表示属性 |
局限与改进
作者明确承认:所有结论都依赖于所选贡献集合、行为读数和干预分布,而非 SAE 字典的全局属性——换个读数或采样分布结论可能改变。我补充几点:(1) 干预幅度设置特殊——整个 top-16 贡献被硬性保留或移除,作者自己显示减半移除会显著降低 $\widehat{SAR}_1$ 并改善一阶保真(9 个设置中 8 个),说明结论对干预强度敏感;(2) 基线偏弱——和保持随机旋转只是众多坐标变换中的一种,未与学习到的其他稀疏基变体或 PCA 坐标比较;(3) 行为读数限定为标量 $\psi$,多 token 生成、文本级行为如何定义 $g_x$ 尚不清楚;(4) SAR 是描述性与预测性指标,文中未证明它与真实电路忠实性有因果关系;(5) 深度趋势的混淆未完全排除——旋转基线显示部分趋势来自剩余下游计算更短而非表示变化;(6) 计算成本高,每个 prompt 需 384 次冻结上层的前向传播,扩展到更多特征或层会受限。
独立分析的弱点
(1) $K{=}16$ 的硬截断:top-16 之外的特征全部归入固定余量,长尾特征间的交互被系统性忽略;改进方向是对 $K$ 做更系统的敏感性分析(附录 I 已有初步结果)并纳入软权重、连续缩放式干预。(2) 均匀子集采样 $p=1/2$ 与真实激活分布脱节:实际特征共激活高度相关,均匀采样可能高估高阶交互能量;可推广到数据驱动的共激活乘积测度。(3) 旋转对照的统计性质未解析:随机正交矩阵平均意义下的 SAR 能否解析预测?给出零假设分布会让 18/18 的结论更硬。(4) 标量读数限制了应用范围:跨 token 的序列级行为需要新的集合函数定义。(5) 引导实验只覆盖一个模型、一种方法(CorrSteer)、一个评测集,泛化性待验证。(6) SAR 与下游任务性能(而非行为读数保真)的关系未测,而实践者最关心的其实是干预后的任务准确率变化。
未来方向
作者暗示的方向:把 SAR 嵌入 SAE 训练或模型选择流程,用交互分解自动标注 attribution graphs 中哪些边需要 pairwise 项,用 SAR 筛选\u201c可安全组合\u201d的特征子集用于引导。基于成果可延伸:(1) 可组合性感知的 SAE 训练——把 $\widehat{SAR}_1$ 作为正则项与重建 FVU 联合优化,或作为 SAE 选型标准;(2) 检验多项式 SAE(Koromilas et al. 2026)的显式高阶项是否真能降低行为 SAR,形成方法闭环;(3) 把均匀测度推广到特征共激活的图结构测度,连接特征共现网络分析;(4) 在所有和保持旋转中寻找 SAR 最优者,探索\u201c行为最可加\u201d的坐标是否对应更简单的电路描述;(5) 扩展到多 token 行为、注意力头级干预与真实下游任务评测;(6) 系统比较 SAR 与自动可解释性评分、Ravel 等现有指标的相关性,建立 SAE 评估的多维指标体系。
复现评估
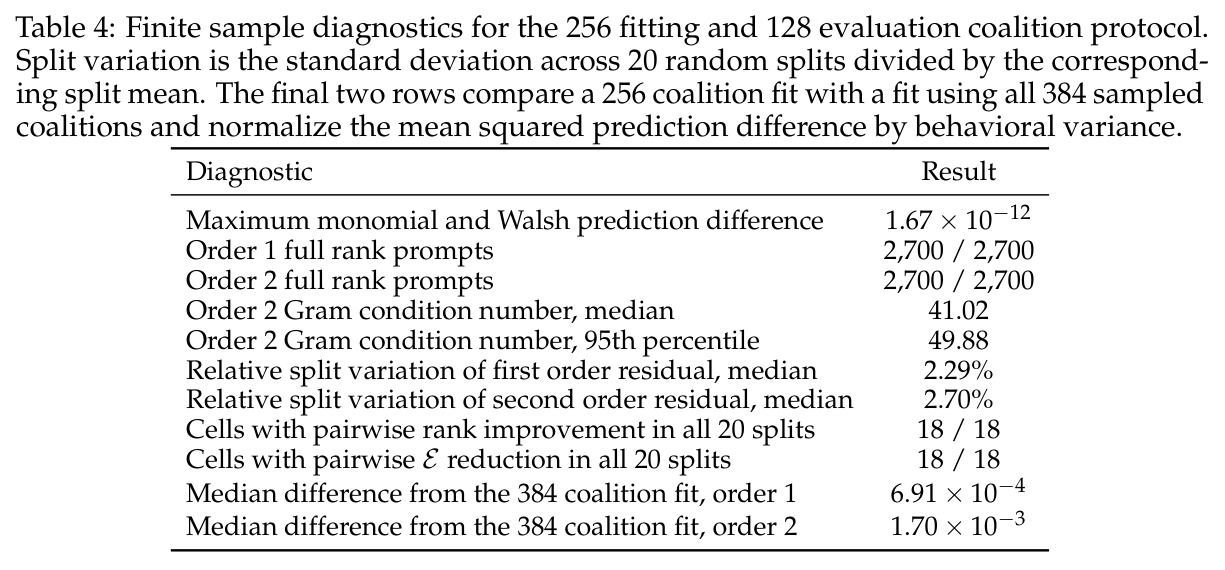
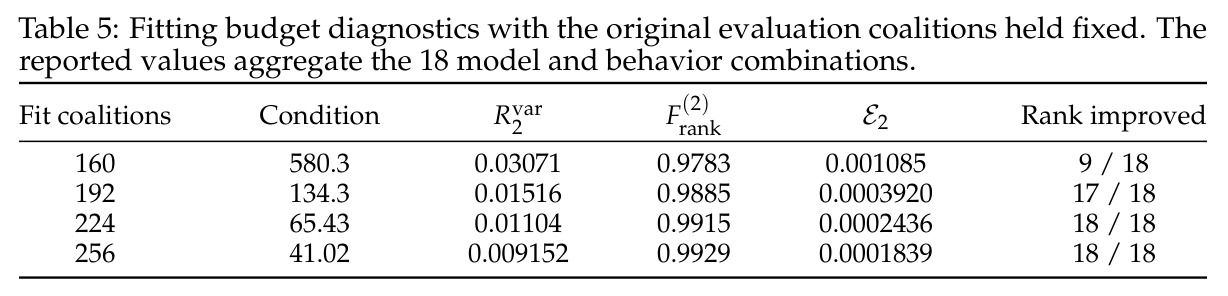
代码已开源(https://github.com/OpenSAE/SAE-Behavioral-Compositionality)。模型全部公开:Gemma-3 4B、Mistral-7B、Llama-3.1 8B、Gemma-3 1B;SAE 使用公开发布版本,主分析固定层为 Gemma-3 4B L22、Mistral-7B L24、Llama-3.1 8B L21,附加分析覆盖七条流水线;引导方向取自已发表的 16 个 CorrSteer 特征;行为数据(CounterFact、IOI、MMLU-Pro 等)均为标准数据集,无需自建标注。主要计算成本在联盟干预:每 prompt 384 次冻结上层前向传播,各设置使用 100/100/800/150 个 prompt(层景观/旋转/保真/pairwise),规模适中,单张 A100/H100 级 GPU 数天可复现主表。附录 B 提供条件数、划分稳定性(20 次重复划分)和拟合预算诊断,便于核对。总体复现难度中等偏低:流程明确、数据公开,主要门槛是组织多流水线的 SAE 推理基础设施。
论文图表