从像素到动作:迈向原生视觉-语言-动作策略 From Pixels to Actions - Towards Native Vision-Language-Action Policies
去掉视觉编码器,让动作专家直接读取主干不同深度的视觉表征,实现更强更稳的操控。
前置知识
VLA(视觉-语言-动作模型)
把相机图像和自然语言指令映射为机器人动作序列的策略模型。主流做法(RT-2、OpenVLA、π0)以预训练视觉-语言模型为底座:图像先经 CLIP/SigLIP/DINOv2 等编码器压缩成视觉 token,再由语言主干和动作头输出动作——动作既可以是离散 token,也可以是扩散/流匹配生成的连续控制量。
本文的核心立场就是反对这一「编码器在前」的标准接口,理解它是读懂全文动机的前提。
Encoder-free / 原生多模态架构
不使用单独预训练的视觉编码器、图像 codebook 或自编码器,图像经轻量卷积 patch embedder 直接映射进语言主干的 token 空间,视觉与语言 token 在同一主干中逐层联合演化,代表工作有 Fuyu、EVE、NEO 系列。本文的「原生」专指结构意义上没有独立视觉模块,不涉及训练目标。
NEO-VLA 建立在 NEO 原生 2B 主干之上,判断它与「给编码器模型开中间特征」的区别需要这一概念。
Flow Matching(流匹配)
一类生成建模方法:训练网络预测把噪声分布输运到数据分布的常微分方程速度场。本文对动作 $a$ 采样 $ au=0.999u$($u\sim\mathrm{Beta}(1,1.5)$),构造带噪动作 $a_\tau=(1-\tau)\epsilon+\tau a$,网络预测速度、回归目标为 $a-\epsilon$;推理时从 $\tau=0$ 到 1 做 10 步 Euler 积分得到连续动作块。
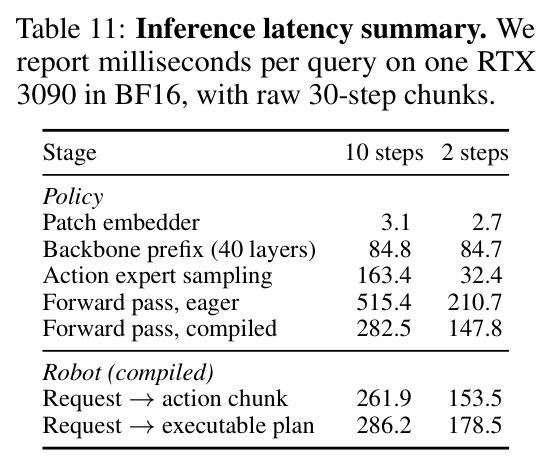
动作专家靠流匹配输出 30 步连续控制块,这决定了方法细节和推理延迟(专家采样占 163.4ms)。
Layer map(层映射与跨深度 KV 读取)
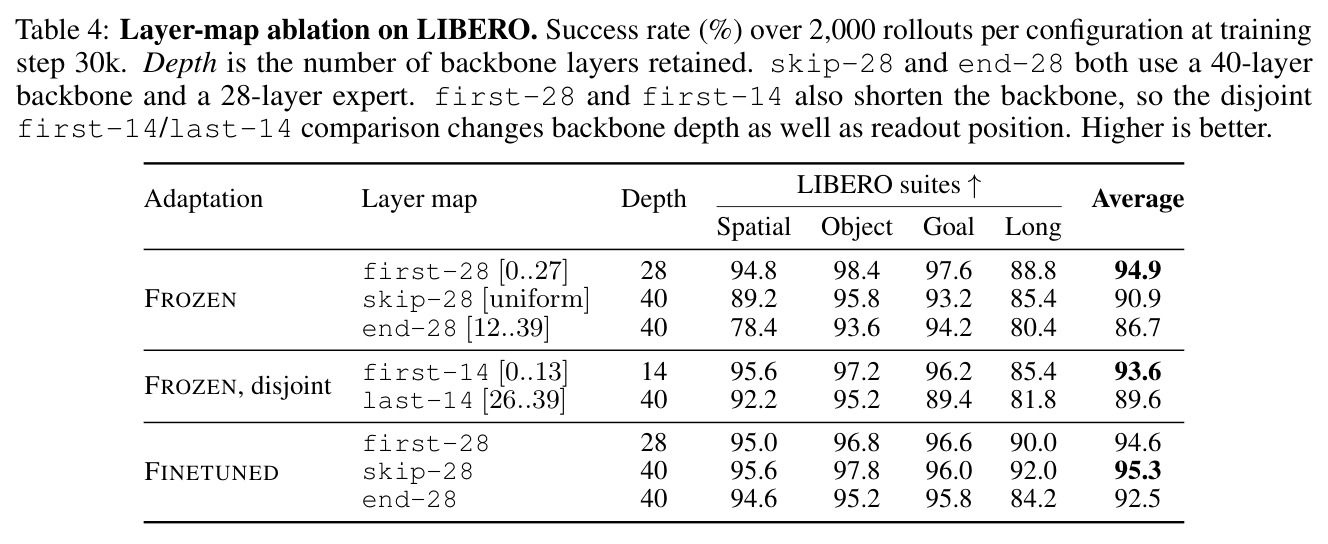
把「动作专家的每一层应该读主干哪一层」形式化为层映射 $M=(m_1,\dots,m_d)$:主干前向时缓存各层前缀的键/值(K/V),动作专家第 $j$ 层对第 $m_j$ 层的缓存做交叉注意力。四种配置——first-28、skip-28、end-28、full-40——使视觉读取深度成为显式架构选择。
这是论文最重要的实验旋钮,5.2 节全部结论和「动作信息在早层出现」的核心发现都围绕层映射消融展开。
LIBERO 与 LIBERO-plus 基准
LIBERO 是仿真桌面操作基准,含 Spatial/Object/Goal/Long 四套任务、每套 500 个 episode,报告成功率;LIBERO-plus 在其上沿相机、机器人、语言、光照、背景、噪声、布局七个轴注入分布偏移,按轴与总分衡量鲁棒性,是区分「刷分会」与「真稳健」的关键测试。
论文的主干对比、层读取消融、鲁棒性主张分别由这两个基准支撑,是理解实验部分的坐标系统。
研究动机
现有 VLA 模型几乎都建立在同一个隐含前提上:感知先被压缩、动作推理在后。图像先经过 CLIP、SigLIP 或 DINOv2 等预训练编码器压缩成固定视觉特征,语言主干和动作头只能看到编码器的最终输出,产生这些特征的整个视觉计算层级被接口隐藏了。但机器人操控恰恰依赖最容易在这种一次性抽象中丢失的信号——局部几何、物体边界、深度和细微的状态变化。近年证据不断指向这条视觉通路是瓶颈:VLM4VA(Zhang et al., 2026b)发现视觉模块是 VLA 性能的主要制约;参数剪枝研究(Zhang et al., 2026a)显示视觉编码器、语言主干和投影层是最敏感、剪掉损伤最大的组件;Kachaev et al. (2025) 则证明在动作数据上微调会退化预训练的视觉表征。换言之,策略只能被动接受一个为语义理解而非控制优化的固定视觉端点。
本文的目标是本文想回答一个根本问题:动作策略应该继承一个固定的视觉端点,还是应该直接访问主干中逐步演化的视觉计算?具体目标有三:第一,构造结构上原生的 VLA 策略 NEO-VLA,不依赖任何单独预训练的视觉编码器、图像 codebook 或自编码器,让像素经轻量卷积直接进入语言主干;第二,把「动作读取哪一层视觉表征」变成显式的架构选择,用参数量匹配的层映射消融系统定位动作关键信息出现在哪些深度;第三,证明该设计在受控比较与真实基准上都更强更稳——冻结主干下 LIBERO 平均成功率 90.9%(超过两个编码器基线全参微调后的成绩)、LIBERO-plus 总分 89.7 为开源模型最高、RoboTwin 2.0 Clean2Rand 69.4 展示强抗随机化能力。
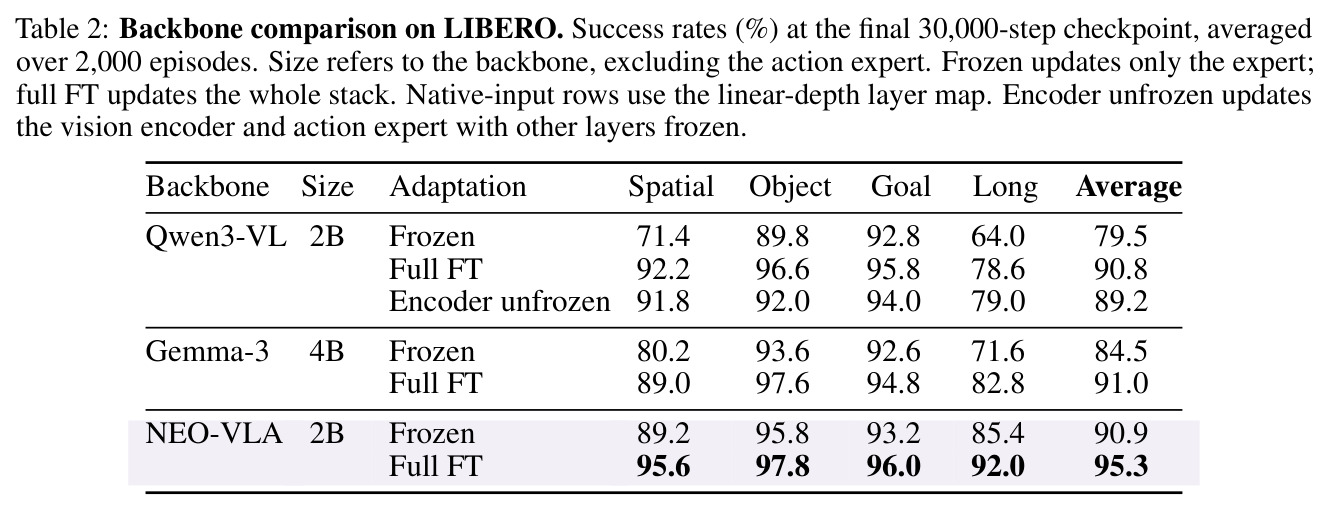
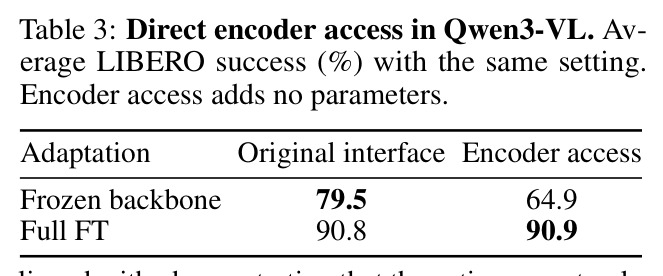
与已有工作不同的是,多数 VLA 工作在动作侧做文章——从离散动作 token(RT-2、OpenVLA)演进到扩散/流匹配动作头(π0、GR00T)——但视觉通路基本保持不变。另一条线是原生多模态模型(Fuyu、EVE、NEO),去掉编码器做理解与生成,但此前没人把它推进到机器人控制并追问「动作该读哪些层」。本文的独特之处在于换掉视觉通路本身、同时冻结其余变量:用相同的动作专家、相同的机器人训练语料,将原生主干与 Qwen3-VL-2B、Gemma-3-4B 受控对比;再用层间探针与干预实验(交换某层 KV、掩码某输入)绘制动作关键信号的深度分布。Table 3 尤其点睛:让 Qwen3-VL 直接访问中间 ViT 特征并不能复制原生主干的优势,冻结成功率反而从 79.5 跌到 64.9——说明关键不在「能否访问早层」而在「表征如何形成」。
核心方法
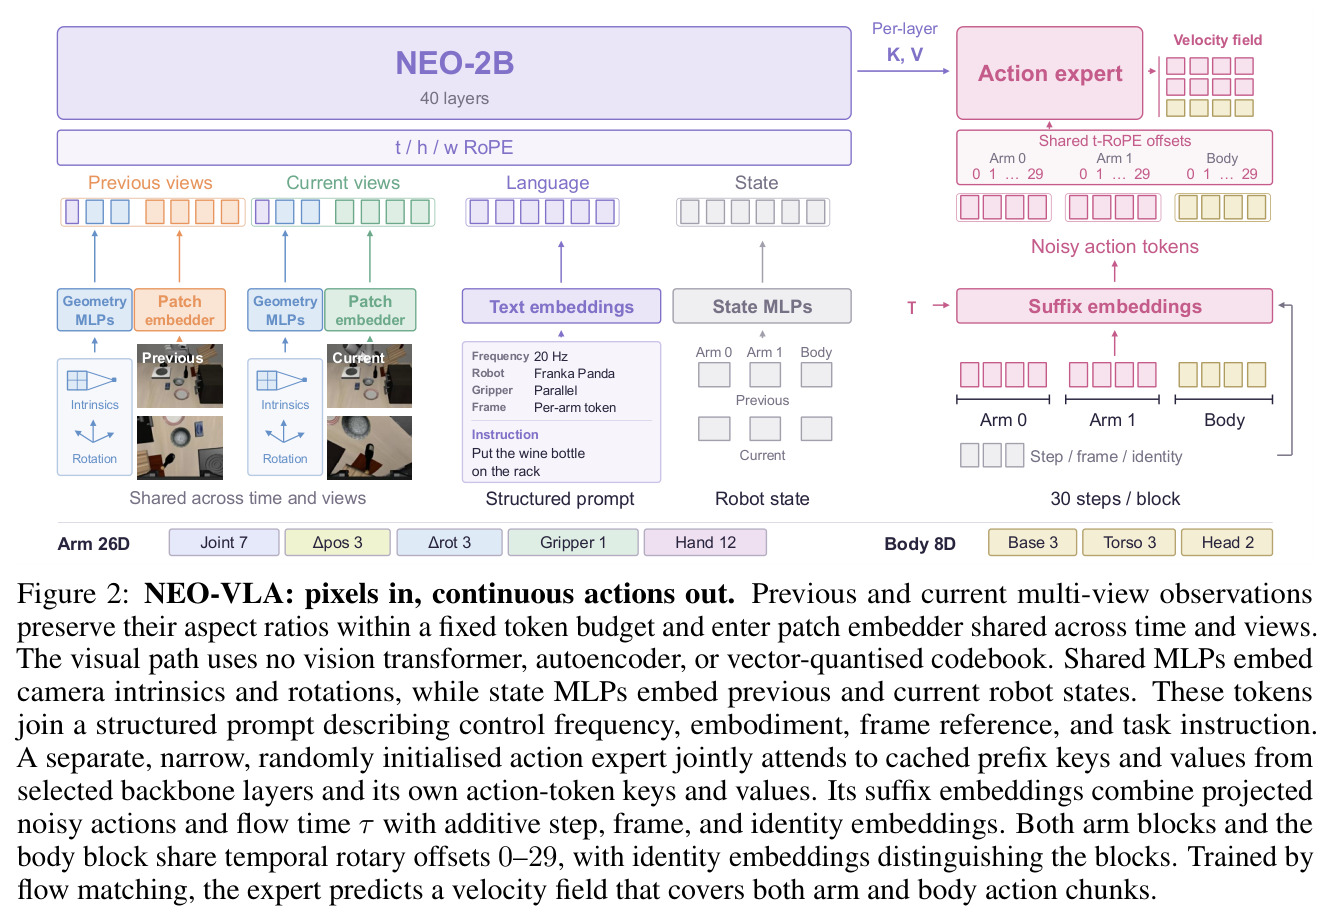
直觉上,NEO-VLA 把「看」和「动」放进同一个躯体:视觉信息不再先被另一个器官加工成成品再送进来,而是以原始像素形式进入大脑,在层层计算中与语言共同演化,控制中枢可以在任意深度伸手取用。技术路线由三部分组成。其一是原生视觉接口:两级卷积 patch embedder(总步距 32)把每个 32×32 像素区域变成一个视觉 token,每视图在不超过 88 个 token 的预算内保留原始长宽比,全程没有 ViT、自编码器或量化 codebook。其二是 40 层、2B 参数的原生主干:采用时间-高度-宽度分解的 Native RoPE,文本 token 走因果注意力、每个视觉块内部双向注意力,视觉与语言表征逐层共同演化,动作专家因此能从细粒度早期特征到语义晚期表征之间自由选择读取深度。其三是窄而随机初始化的流匹配动作专家:读取主干选定层缓存的前缀 K/V 与自身动作 token 的 K/V,预测覆盖双臂与身体的 30 步连续动作块,推理时前缀 KV 缓存只算一次、10 步 Euler 求解速度场。
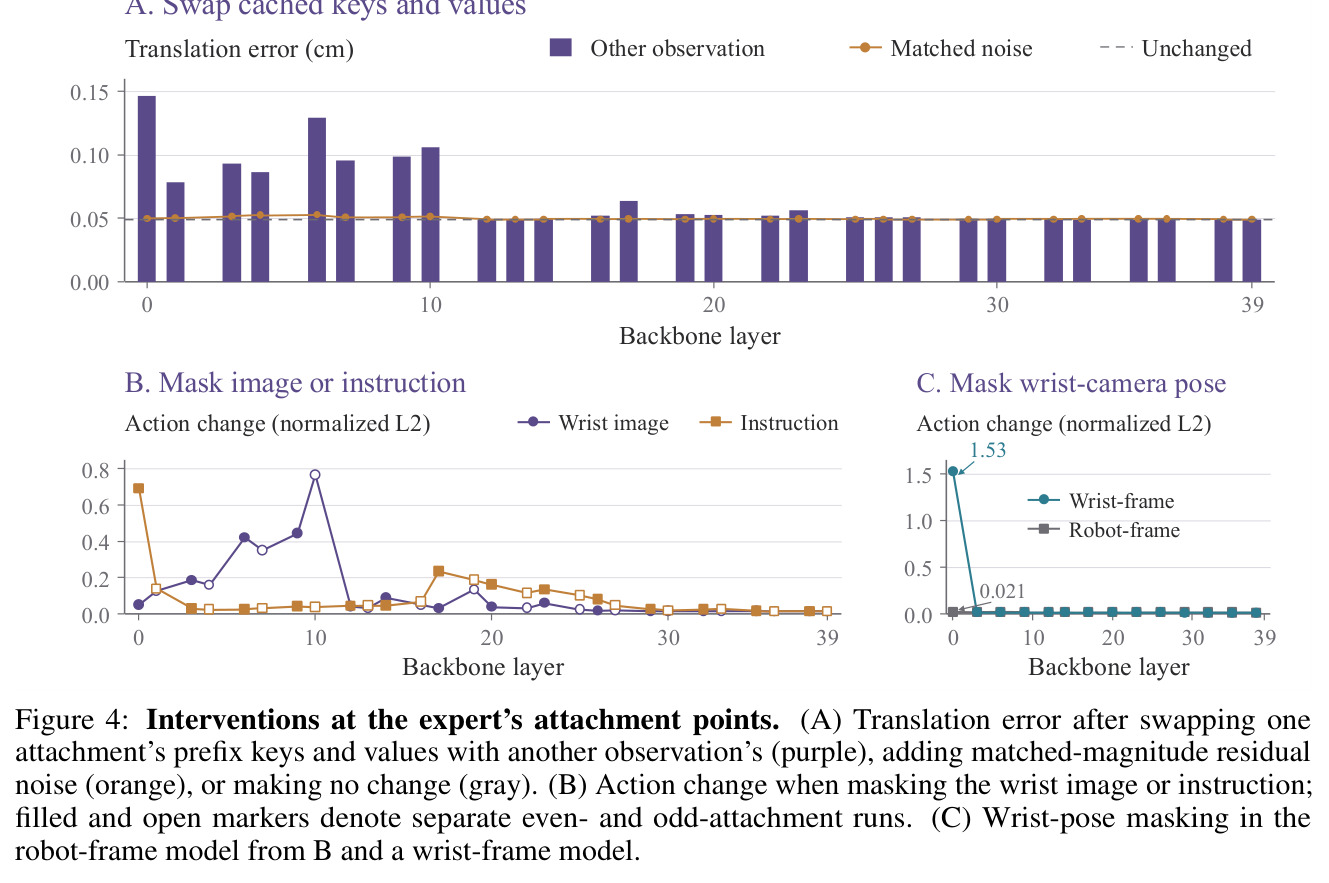
核心创新是把「视觉读取深度」从隐含的架构副作用提升为显式的策略选择。作者定义层映射 $M=(m_1,\dots,m_d)$:动作专家第 $j$ 层交叉注意力读取主干第 $m_j$ 层缓存的键值。四种配置——first-28 读 [0..27]、skip-28 在 40 层中均匀采样 28 层、end-28 读 [12..39]、full-40 全读——前三种使用完全相同的 28 层专家与隐藏宽度,参数量几乎一致,从而把「读哪里」与「模型多大」两个变量隔离。这带来一个此前做不到的实验:动作关键信息到底在主干哪一层达到峰值?答案是显著早于最终层:冻结主干时 skip-28 得 90.9%、只读晚层的 end-28 只有 86.7%;干预实验显示交换第 0-10 层 KV 造成的平移误差远大于后层,而幅度匹配的残差噪声影响不超过 0.004cm,证明这是内容效应而非扰动强度效应。与 π0 等把动作头挂在主干末端的方法本质不同:控制需要的是贯穿计算层级的访问权,而非单一语义成品。
方法步骤详情
训练分四步。第一步构建统一多模态前缀:每个时间块最多 3 个相机视图,由跨时间与视图共享的 patch embedder 在每视图 88 token 预算内动态切图;几何 MLP 编码相机内参与旋转,state MLP 编码双臂与身体的前/当前状态,后接规定 20Hz 控制频率、本体构型与任务指令的结构化 prompt,全部前缀 token 用 $t/h/w$ 三维旋转位置编码联合处理。第二步三阶段训练:阶段 1 冻结视觉-语言主干、只训动作专家与条件模块(113,400 步、batch 8192、峰值学习率 $2\times10^{-4}$);阶段 2 全参解冻再训 75,000 步(主干学习率 $5\times10^{-5}$,隔步混入理解数据、辅助下一词预测损失权重 0.1);阶段 3 用自有动作数据再微调 75,000 步;2000 步 warmup 后余弦衰减至峰值 10%。第三步流匹配训练:对目标动作块(双臂 $\mathbb{R}^{2\times30\times26}$、身体 $\mathbb{R}^{30\times8}$,各 30 步)采样 $\tau=0.999u$、$u\sim\mathrm{Beta}(1,1.5)$,构造 $a_\tau=(1-\tau)\epsilon+\tau a$,专家预测速度场、回归目标 $a-\epsilon$,四个动作组按 $(2,1,1,1)$ 加权 MSE。第四步推理:固定前缀 KV 缓存,从 $\tau=0$ 到 1 做 10 步 Euler 积分得到动作块,反归一化后执行。
技术新颖性
新颖性有三层。结构上,这是第一个把原生(encoder-free)多模态主干系统推进到机器人操作控制的工作——NEO 系列此前用于理解与生成,本文证明「像素直接进主干」对动作学习同样更有效。方法论上,层映射 $M$ 的形式化与等容量消融是新的实验范式:skip-28 与 end-28 共享 28 层专家从而隔离读取位置,first-14/last-14 对照进一步区分「读哪层」与「主干多深」;配合三种干预(交换 KV、掩码图像/指令、掩码腕部位姿)绘制出不同模态在深度轴上的分布——腕部图像敏感峰值在 6-10 层、指令在第 0 层(17 层有次峰)、腕坐标系模型中位姿掩码在第 0 层产生 1.53 的归一化响应。结论性上,Table 3 反证了「给编码器模型开放中间特征」这条捷径:Qwen3-VL 加 encoder access 后冻结性能反降 14.6 分,说明优势源于 encoder-free 预训练对表征形态的塑造,而非浅层特征的可得性;这与给 VLA 加第二条视觉通路的 UAM 路线形成鲜明对照。
实验结果
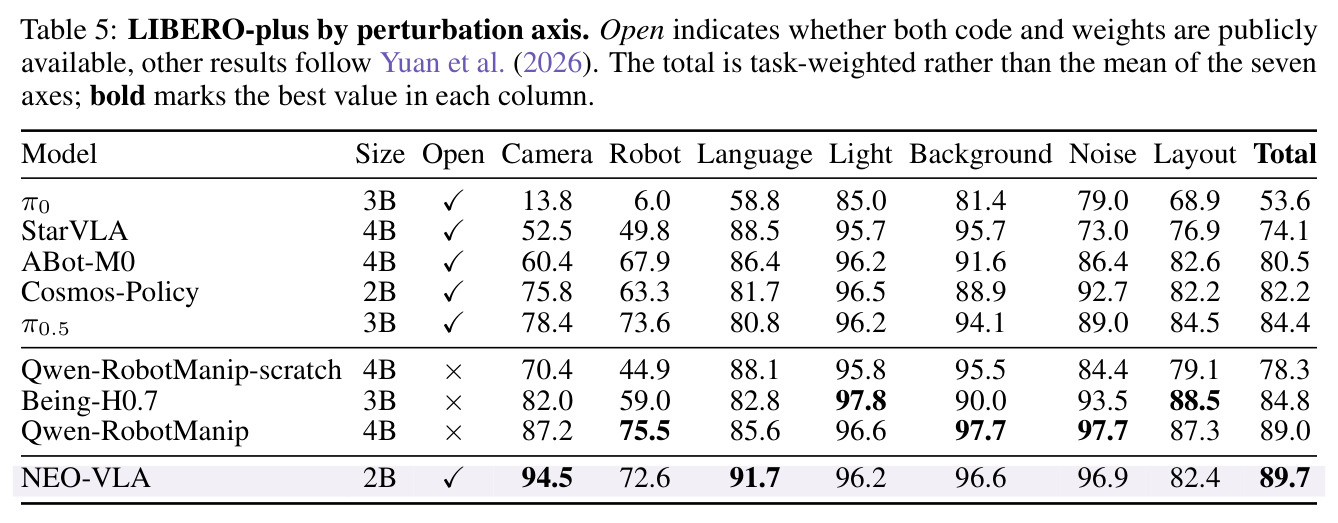
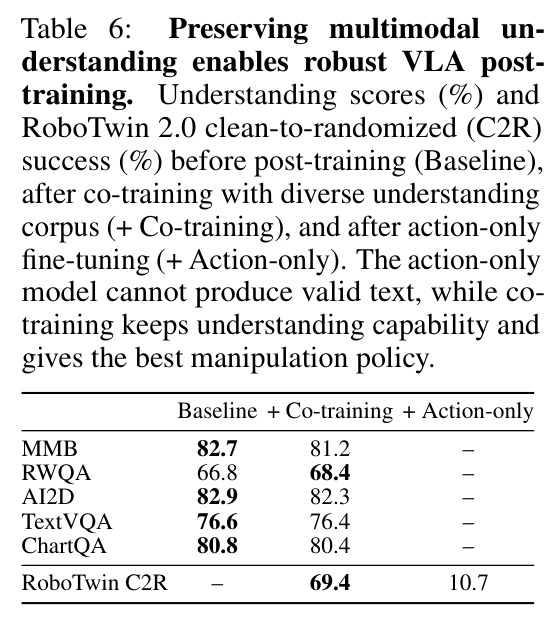
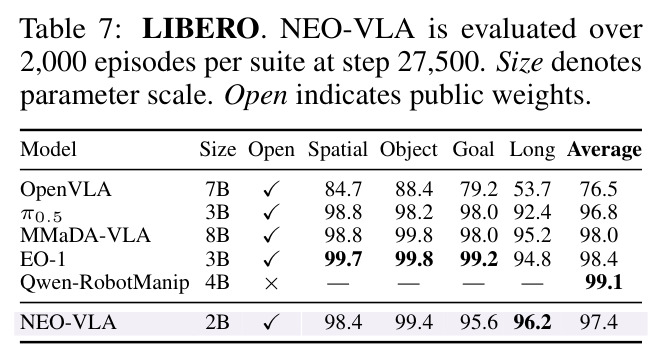
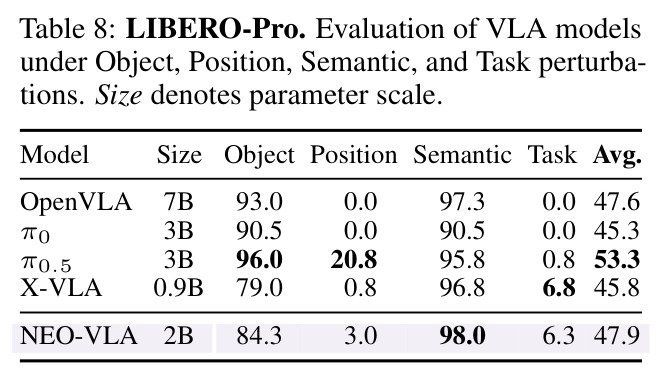
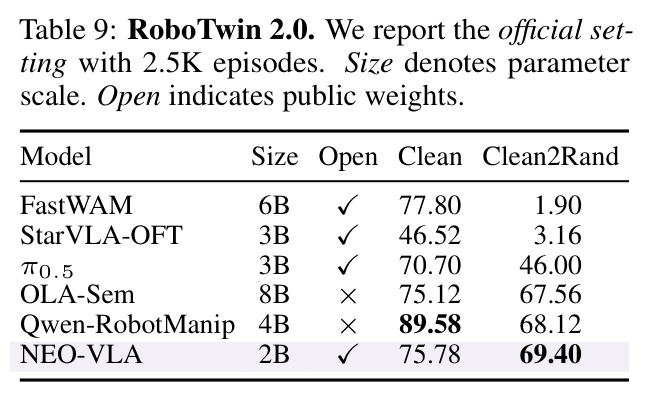
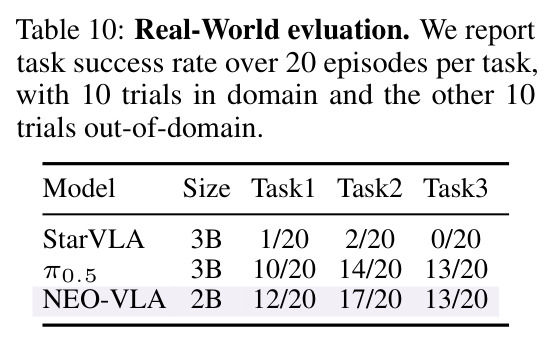
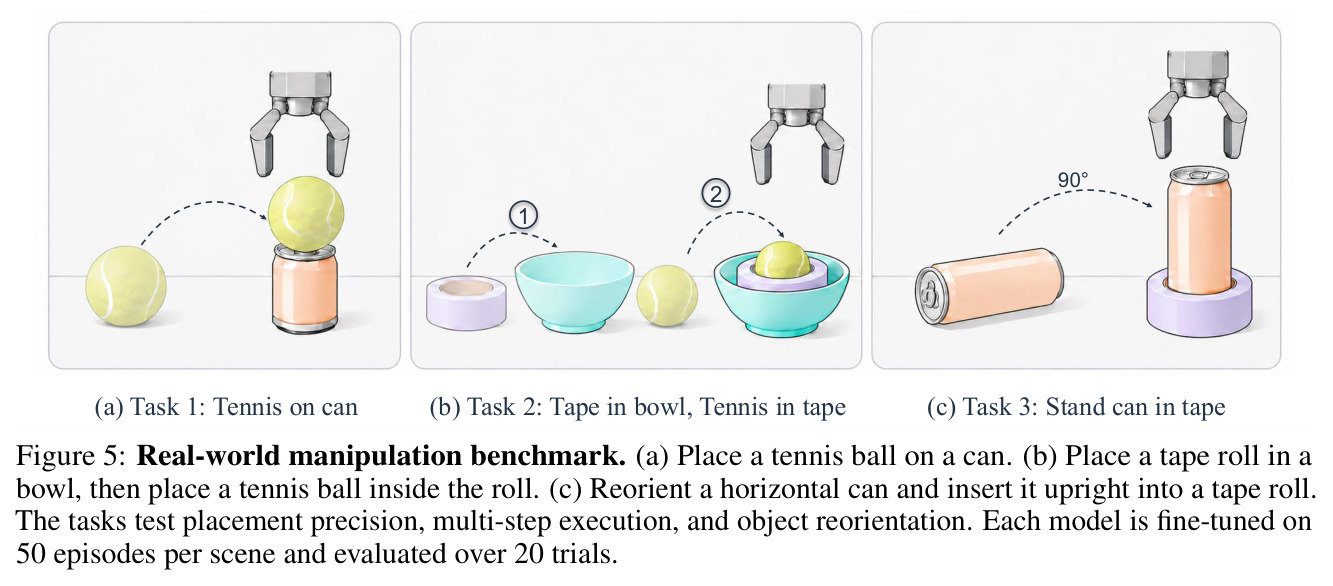
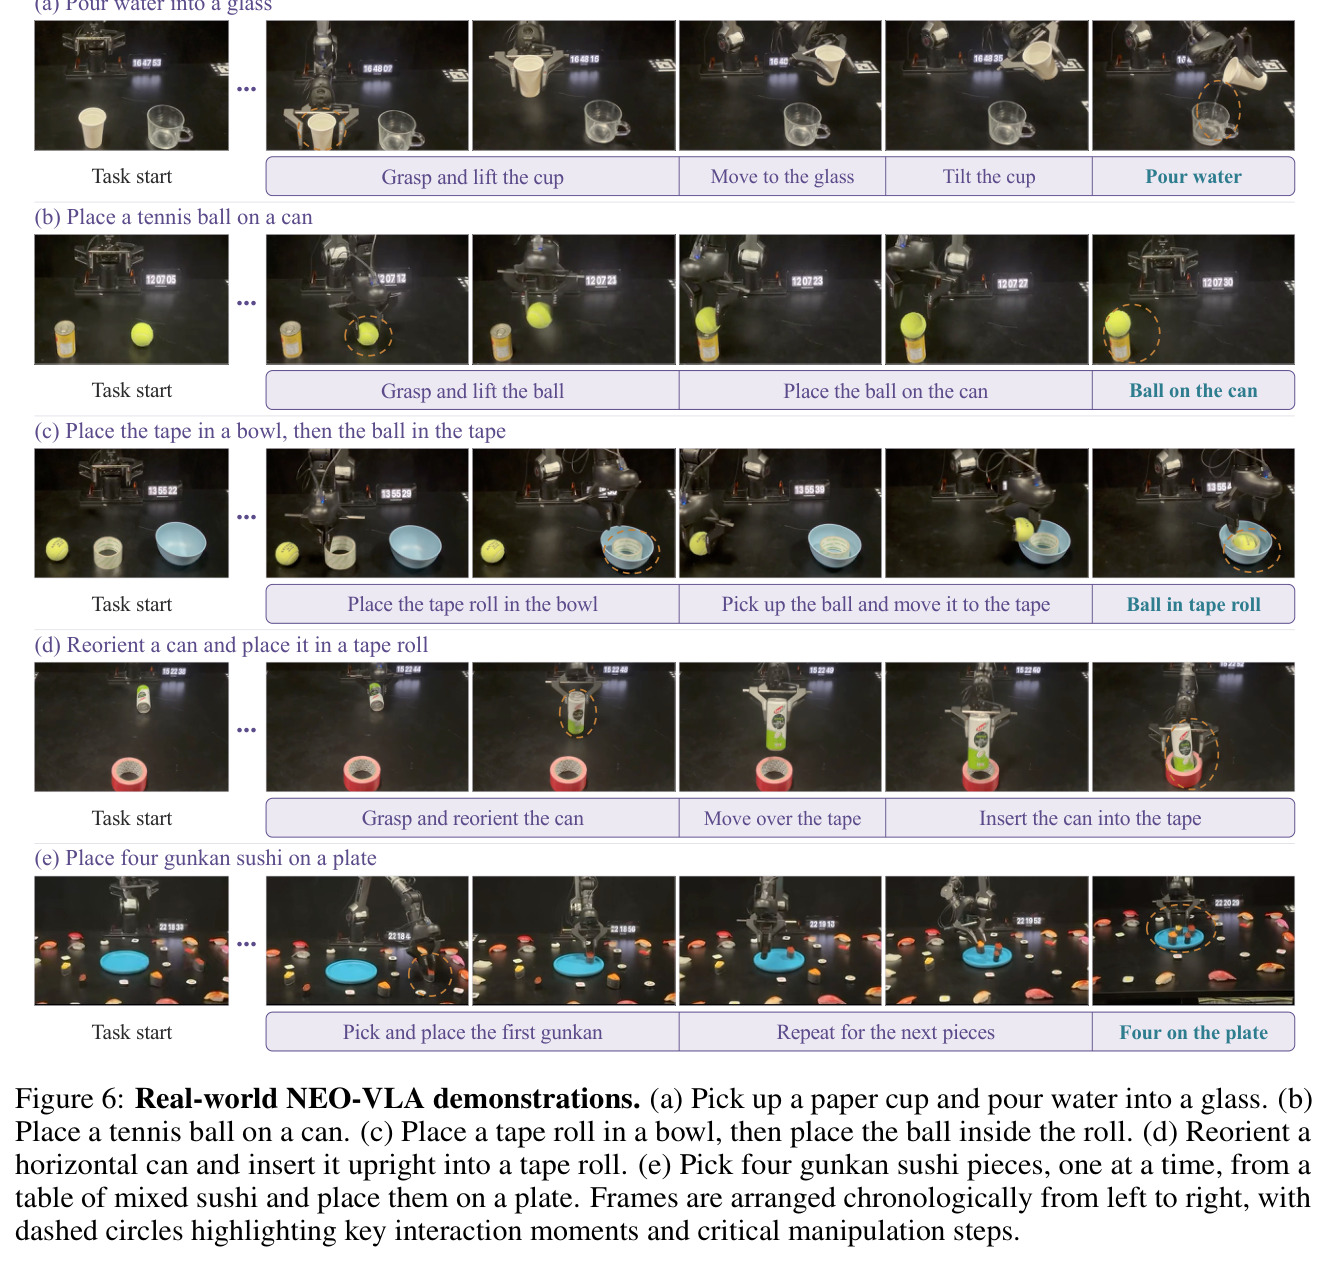
证据链分四环。环一(主干对比,Table 2):冻结主干时 NEO-VLA 在 LIBERO 平均成功率 90.9%,高于 Qwen3-VL-2B 的 79.5% 和 Gemma-3-4B 的 84.5%,甚至超过两者全参微调后的 90.8%/91.0%;全参微调后 NEO 达 95.3%。环二(深度分析,Table 4 + Figure 4):冻结下 first-28 94.9% > skip-28 90.9% > end-28 86.7%,first-14 93.6% vs last-14 89.6%,一致表明早层对控制更关键;交换第 0-10 层 KV 引起最大平移误差,幅度匹配噪声影响 <0.004cm;微调后 skip-28(95.3%)反超 first-28(94.6%),分布式读取在全微调下最优。环三(理解共训,Table 6):与理解数据共训保住 MMBench 81.2(基线 82.7)并取得 RoboTwin C2R 69.4%,纯动作微调则丧失文本能力且 C2R 崩至 10.7%。环四(基准与实机):LIBERO 平均 97.4%(π0.5 96.8、EO-1 98.4);LIBERO-plus 总分 89.7 为开源模型最高(π0.5 84.4、π0 仅 53.6),其中相机扰动 94.5、语言 91.7;RoboTwin 2.0 clean 75.78、Clean2Rand 69.40 为开源最强(π0.5 仅 46.00);LIBERO-Pro 语义扰动 98.0 全场最高,但位置 3.0、任务目标 6.3 暴露短板;实机三任务 12/20、17/20、13/20,追平或超过 π0.5(10/14/13),StarVLA 仅 1/2/0;单张 RTX 3090 上请求到可执行计划 286.2ms,其中 10 步 Euler 专家采样占 163.4ms、主干前缀 84.8ms。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO(主干对比,冻结) | 平均成功率 % | NEO-VLA 2B:90.9 | Qwen3-VL 2B:79.5;Gemma-3 4B:84.5 | +11.4 / +6.4 分,且超过两个基线全参微调后的 90.8/91.0 |
| LIBERO(主干对比,全参微调) | 平均成功率 % | 95.3 | Qwen3-VL 90.8;Gemma-3 91.0 | +4.5 / +4.3 分 |
| LIBERO(层映射消融,冻结) | 平均成功率 % | first-28 94.9;skip-28 90.9 | end-28 86.7 | 早层读取最高提升 8.2 分 |
| LIBERO(SOTA 对照) | 平均成功率 % | 97.4(Spatial 98.4 / Object 99.4 / Goal 95.6 / Long 96.2) | OpenVLA 7B 76.5;π0.5 96.8;EO-1 98.4 | 超过 π0.5 与 OpenVLA,2B 参数与 EO-1 3B 相当 |
| LIBERO-plus | 七轴扰动加权总分 % | 89.7(相机 94.5、语言 91.7、光照 96.6、噪声 82.4) | π0.5 84.4;π0 53.6;闭源 Qwen-RobotManip 89.0 | 开源模型最高,超 π0.5 5.3 分 |
| LIBERO-Pro | 语义/位置/任务扰动成功率 % | 语义 98.0(最高);位置 3.0;任务 6.3 | π0.5 语义 95.8、位置 20.8 | 语义+2.2,但位置/任务显著落后,暴露短板 |
| RoboTwin 2.0 | Clean / Clean2Rand 成功率 % | 75.78 / 69.40 | π0.5 70.70 / 46.00;Qwen-RobotManip(闭源)89.58 / 68.12 | 随机化下开源最强,比 π0.5 高 23.4 分 |
| 实机操作(3 任务 × 20 次) | 成功次数/20 | 12/20、17/20、13/20 | π0.5 10/14/13;StarVLA 1/2/0(每任务仅 50 条演示微调) | 全面追平或超过 π0.5,参数量仅一半 |
| 推理延迟(RTX 3090, bf16) | 请求→可执行计划 | 286.2ms(10 步 Euler)/ 178.5ms(2 步) | 未编译前向 515.4ms | torch.compile 将前向 515.4 压至 282.5ms |
局限与改进
作者坦承两点:其一,LIBERO-Pro 上位置扰动仅 3.0%、任务目标 6.3%,原生主干带来的是感知与语义鲁棒性,而非空间配置或意图层面的适应力;其二,LIBERO-plus 中 robot(72.6)与 layout(82.4)两轴提升有限,因为它们改变本体或场景配置而非视觉观测,与「强化感知」的作用机制正交。作者也强调预训练配方差异使「增益全部来自去编码器」的归因不完全严格。我的补充观察:每视图 88 token 的预算(32×32 像素一 token)在插孔、小物体等亚厘米精度任务下可能限制空间分辨率;full-40 的容量效应未与 28 层专家严格对齐,深度结论在更高容量下未验证;LIBERO 上最强方法差距已缩到 1 分内,区分度正在失效;实机每任务仅 50 条演示、20 次试验,统计功效有限;位置/目标泛化的失败暗示动作表征可能过拟合演示分布,而非真正理解几何关系。
独立分析的弱点
第一,空间-意图泛化断层:位置扰动 3.0% 意味着物体挪个位置策略就失效,指向训练数据缺少空间组合多样性,改进方向是中间训练注入空间关系增强(随机化布局、指令-位置重组合)或引入显式几何推理模块。第二,读取深度与训练状态强耦合:冻结时早层最优(first-28 94.9%)、微调后分布式最优(skip-28 95.3%),但层映射部署前必须固定、无法按任务自适应,可让专家学习每层的软门控权重,按输入动态分配读取深度。第三,分辨率瓶颈:88 token/视图对穿针类精细操作不足,可借鉴动态分辨率或多尺度 token 化,在高价值区域自适应加密 token。第四,对照规模有限:只与 2B/4B 编码器模型比较,「原生优势随规模放大还是消失」没有答案,应在 7B+ 尺度补实验,并控制原生与编码器模型的预训练 token 数严格一致。第五,推理时延结构:10 步 Euler 的专家采样占 282.5ms 前向中的 163.4ms,2 步虽降至 178.5ms 总时延但会改变采样动作、且论文成功率全部基于 10 步,高精度任务可能承受不起,一致性蒸馏式的少步化值得一试。
未来方向
作者指出的方向:具身智能的下一瓶颈可能不再是感知,而是「把感知理解转化为变化几何与意图下的灵活动作」——即空间配置与任务目标层面的泛化;原生 VLA 建模是迈向「不仅语义有意义、而且本质上对控制有用」表征的一步。基于本文成果可延伸:其一,自适应层读取,把层映射从固定超参变为学习目标,按任务难度在 first-28 与 skip-28 之间软插值;其二,把第 5.2 节的深度归因方法(KV 交换、输入掩码探针)推广为 VLA 可解释性标准工具箱,用于诊断任何策略的失败模式;其三,原生主干天然支持视频与多视图($t/h/w$ RoPE),可接入预测性世界模型,让专家在想象中预演动作后再执行;其四,身体通道已预留 8 维(底盘/躯干/头部),可扩展到全身人形与移动操作;其五,在更大的原生主干上检验动作迁移的 scaling law,回答「原生优势是否随规模增长」。
复现评估
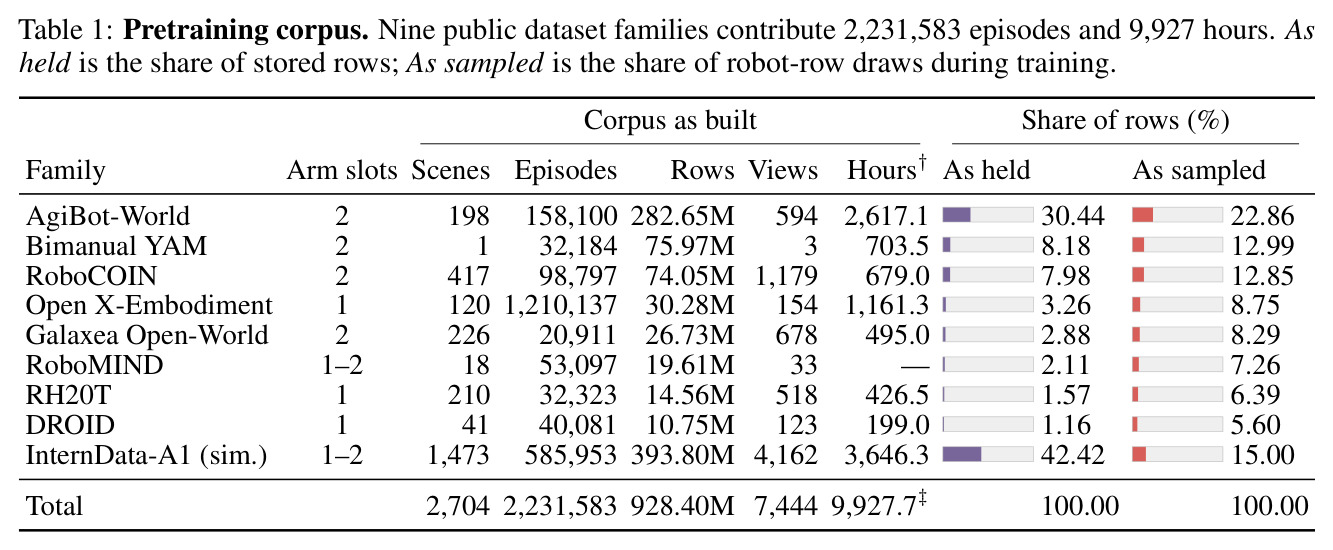
开源程度很高:模型权重(HuggingFace weepiess2383/NEO-VLA)、动作预训练数据集(NEO-VLA-Action-Pretrain)、代码库(EvolvingLMMs-Lab/NEO)均公开,LIBERO/LIBERO-plus/RoboTwin 2.0 亦为公开基准。但完整复现预训练成本不低:动作侧用了 9 个数据集族、223 万 episode、9927 小时语料,三阶段共约 26 万优化步、batch 8192、bf16 混精度,估计需数十张 A100/H100 级算力与数周时间。可行路径是跳过主干预训练,直接用官方权重在 LIBERO 或自有机器人上做后训练微调——动作专家是随机初始化的窄模块,微调开销可控。推理门槛友好:单张 RTX 3090(24GB)即可实时运行,编译后前向 282.5ms。主要复现风险在实机部分:自建三任务基准依赖特定硬件(pika、Franka Panda)与标定,论文未给完整实机训练脚本,第三方完全复刻 12/17/13 成功率的难度较大。
论文图表
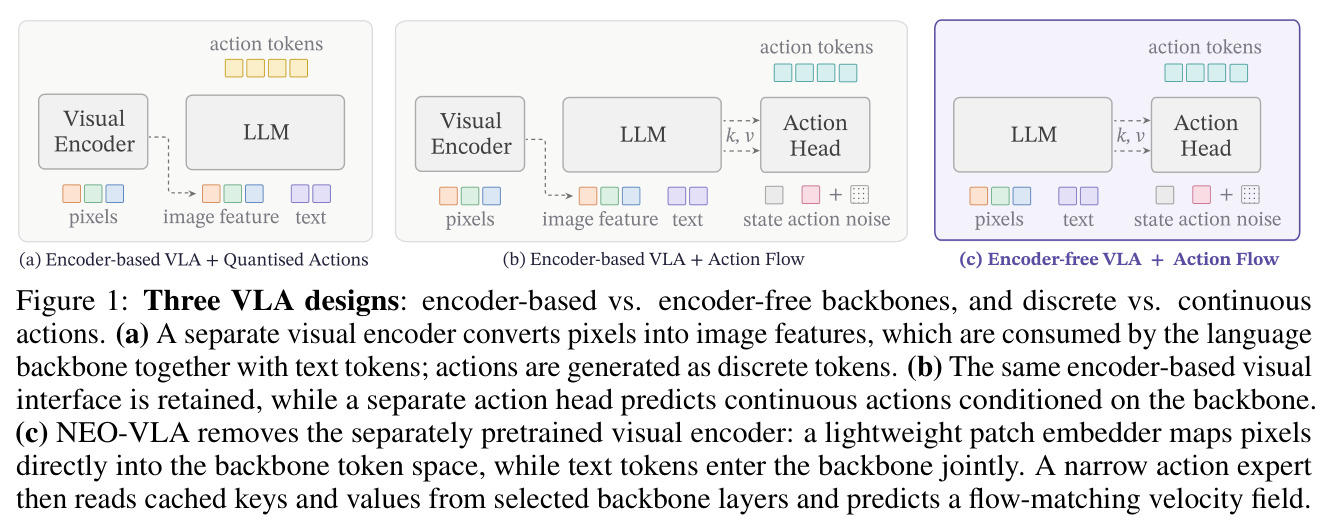
对比三种 VLA 设计:(a) 编码器式主干+离散动作 token,(b) 编码器式主干+流匹配动作头,(c) NEO-VLA 去掉预训练视觉编码器、轻量 patch embedder 直接把像素映入主干 token 空间,窄动作专家读取选定主干层的缓存 K/V 预测流匹配速度场。
一张图讲清论文在「视觉通路×动作表示」二维设计空间中的位置,是理解全文定位的入口。