MambaAct:面向流匹配视觉-语言-动作模型的高效 Mamba 动作专家 MambaAct: Efficient Mamba Action Experts for Flow-Matching Vision-Language-Action Models
用10倍小的Mamba动作专家替换π0.5,去噪延迟降64.8%,LIBERO成功率反升1.08点
前置知识
VLA 模型(视觉-语言-动作模型)
VLA 模型以相机图像和语言指令为输入,直接输出机器人连续控制动作,是通用机械臂操作的主流范式。代表工作 π0/π0.5 用 PaliGemma 这类预训练视觉-语言模型(VLM)作骨干:VLM 先把观测编码成前缀表征(prefix),再由独立的动作专家(action expert)把它转译为未来若干步的连续动作块。
本文的全部改动都发生在 π0.5 的动作专家内部,理解“VLM 前缀 + 动作专家”的两段式结构是读懂其架构设计与延迟分析的必要前提。
流匹配(Flow Matching)
流匹配是连续动作生成范式:训练时从干净动作 $A_0$ 构造带噪样本 $X_t = t\epsilon + (1-t)A_0$($\epsilon\sim\mathcal{N}(0,I)$),让网络预测速度场目标 $V^\star=\epsilon-A_0$;推理时从纯噪声 $X_1$ 出发,用欧拉法迭代 $X_{t-\Delta t}=X_t-\Delta t\,\hat{V}_\theta(X_t,t,o)$ 积分回 $X_0$。
流匹配需要多步去噪、动作专家被反复调用(本文 10 步),这正是延迟瓶颈与加速收益的来源;MambaAct 完全保留该公式,只换掉预测速度的网络。
Mamba / 选择性状态空间模型
Mamba 用选择性状态空间递归替代 Transformer 的成对自注意力:序列每经过一个 token,就以输入依赖的门控更新一个固定维度隐状态,天然编码顺序信息,参数与计算量远小于注意力。本文采用 Mamba-3 形式,把动作 token 序列送入选择性扫描(selective scan)得到输出。
Mamba 是本文核心构件——动作块是长度为 $H$ 的有序、强相关序列,作者认为选择性递归是比注意力更匹配的归纳偏置,也是压缩 10 倍后性能不降的关键。
FiLM 条件化与门控调制
FiLM(Feature-wise Linear Modulation)用条件向量经小 MLP 生成逐特征缩放 $\gamma$ 与偏移 $\beta$,对目标特征做 $(1+\gamma)\odot U+\beta$ 式仿射调制。本文再加残差门 $\rho$(用 $\sigma(\rho)$ 控制注入幅度)并零初始化,使新分支初期只轻微扰动预训练表征。
新的 Mamba 专家与预训练 VLM 之间没有逐 token 交叉注意力,视觉-语言条件全靠门控 FiLM 传递;消融显示它显著优于交叉注意力,是理解方法有效性的关键。
动作分块(Action Chunking)
动作分块指一次策略查询预测未来多步动作(本文仿真 $H=10$、真机 $H=50$),机器人执行其中一部分后再重新规划。它使控制更平滑、降低查询频率,但也意味着同一动作块内的 token 高度时间相关。
动作专家处理的正是这种有序且强相关的序列;是否擅长建模这种结构,直接决定小模型能否顶替大 Transformer 专家。
LIBERO / LIBERO-Plus 基准
LIBERO 含 SPATIAL、OBJECT、GOAL、LIBERO-10 四个仿真操作套件(每套件 10 任务,本文每任务 50 次试验),是 VLA 微调标准测试场。LIBERO-Plus 在其上构造 10,030 个测试实例,从 CAMERA、ROBOT、LANGUAGE、LIGHT、BACKGROUND、NOISE、LAYOUT 七类扰动考察零样本鲁棒性。
压缩到 29.7M 参数的专家是否牺牲精度与鲁棒性,正是靠这两套基准加双 UR5 真机实验来回答的。
研究动机
π0、π0.5 等流匹配 VLA 在通用机械臂操作上表现强劲,但推理延迟成为实时控制的瓶颈,关键在其推理结构的不对称性:每次策略查询时,视觉-语言前缀只需编码一次,而动作专家必须在整个去噪轨迹上被反复调用——本文设 $N_{\text{denoise}}=10$ 步欧拉积分,动作生成成本随去噪步数线性放大。作者在 LIBERO 上实测(单张 H100):π0.5 端到端延迟约 228.6 ms,其中 10 步去噪占 70.1%;即便换成小得多的 SmolVLA 骨干,去噪仍占端到端延迟的 86.4%。也就是说,动作生成而非视觉-语言编码才是延迟大头。已有加速工作大多在“少算几次”或“砍前缀”上做文章:SnapFlow 用渐进自蒸馏把 10 步压成 1 步;Shallow-π、π0-CLP 蒸馏或剪除 VLM 冗余层;FastV、DivPrune、LightVLA、ADP、SpecPrune-VLA 剪视觉 token;SmolVLA、CogVLA、EfficientVLA 重设计更小的整体架构。然而被反复求值的动作专家本身的架构设计,作为一个独立的效率维度几乎未被探索。
本文的目标是本文的目标非常聚焦:在不改动预训练视觉-语言骨干、不改变标准流匹配公式、不引入额外预训练或蒸馏阶段的前提下,把 π0.5 中那个 311.5M 参数、每次策略查询要被求值 10 次的 Transformer 动作专家,替换成一个紧凑得多的动作生成模块,并要求:(1)仿真与真机的任务成功率不降反升;(2)去噪与端到端延迟显著下降;(3)与“前缀侧”加速手段(如减少 VLM 深度)可组合而非互相替代;(4)该替换可迁移到 π0.5 之外的流匹配 VLA(SmolVLA),证明这是一条通用效率轴而非一次性技巧。最终落点是:仅 29.7M 参数的 Mamba 动作专家,配合一个把 VLM 前缀压成紧凑条件的轻量接口,在标准下游微调中与骨干联合训练,单张 H100 约 14 小时完成。
与已有工作不同的是,本文的独特切入角度是把效率优化的矛头从“调用频率”转向“被调用模块本身的架构”。此前所有方案都默认动作专家结构是给定的:要么减少调用它的次数(SnapFlow 压缩去噪轨迹),要么压缩它读取的输入(视觉 token 剪枝、VLM 层剪枝),要么推倒重来造端到端小模型(SmolVLA)。而 MambaAct 保留 π0.5 的预训练 PaliGemma 骨干和流匹配目标,只换掉反复求值的动作专家。选 Mamba 作替代还有一层更深的假设:动作块是长度 $H$ 的有序、强相关序列,Mamba 的选择性状态空间递归恰好提供“沿序列传播信息”的紧凑归纳偏置——作者假设这比同参数量的无约束两两注意力更适合流匹配动作生成,消融(同 30M 参数下 Mamba 门控 98.4% 对 Transformer 门控 85.7%)支持了该假设。此外,与需要自蒸馏的 SnapFlow、需要教师模型的 Shallow-π 不同,MambaAct 在标准微调中一步完成,无需任何额外训练阶段。
核心方法
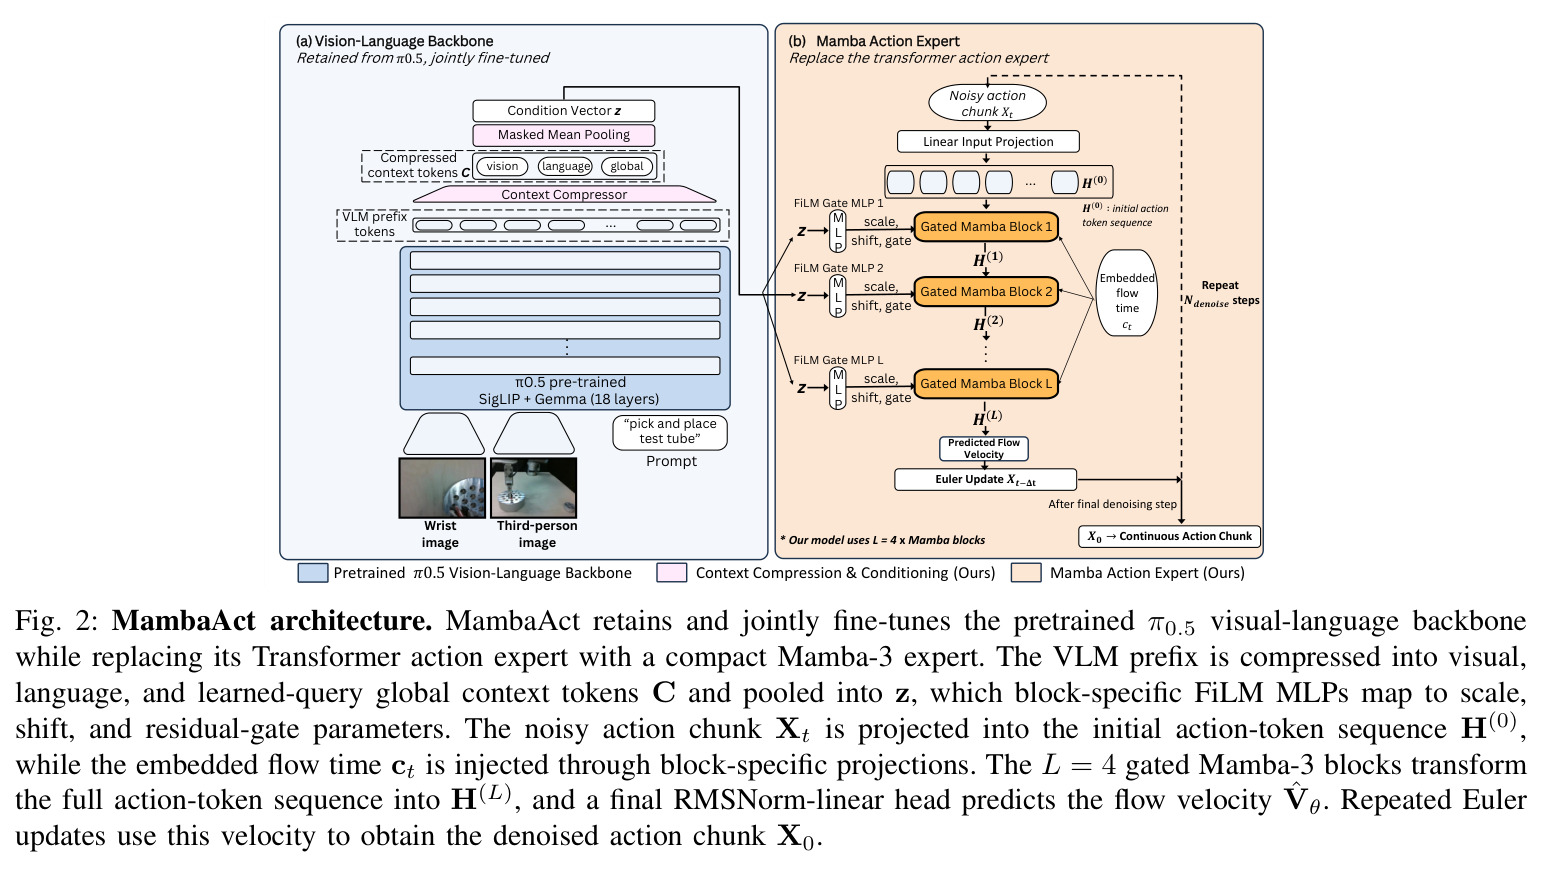
MambaAct 的整体思路可概括为“保留大脑,更换小脑”:预训练 π0.5 的视觉-语言骨干(PaliGemma:SigLIP 视觉编码器 + Gemma 前缀编码器,执行全部 18 层)被原样保留并与新专家联合微调,而其 311.5M 参数的 Transformer 动作专家被替换为仅 29.7M、由 $L=4$ 个门控 Mamba-3 块组成的动作专家(宽度 512、状态维度 64、扩张因子 1、头维度 64)。由于新专家不再逐 token 对 VLM 前缀做交叉注意力,作者配套设计两个组件:其一,Context Compressor 把 $N$ 个 VLM 前缀 token $P=f_{\text{VLM}}(o)\in\mathbb{R}^{N\times d_{\text{vlm}}}$ 压成 $K=64$ 个上下文 token(44 视觉段、16 语言段、4 可学习全局查询),再池化为条件向量 $z\in\mathbb{R}^d$;其二,每个 Mamba 块用独立的 FiLM Gate MLP 把 $z$ 映射为缩放、偏移和残差门参数,对动作表征调制。噪声动作块 $X_t$($H=10$、padding 到 $d_a=32$)投影为初始 token 序列,流时间注入每个块,末端 RMSNorm+线性头输出流速度,按标准流匹配损失与骨干联合微调 3 万步。
核心创新有三层。第一层是问题重构:把流匹配 VLA 的延迟瓶颈明确定位为“被反复求值的动作专家”,并首次把“替换动作专家架构”确立为与去噪步数压缩、视觉 token 剪枝、VLM 深度裁剪正交的效率轴。第二层是架构选择:用 Mamba 的选择性状态空间混合器替代注意力——注意力对 $H$ 个动作 token 做无约束的两两交互,而 Mamba 通过选择性递归状态沿有序序列传播信息,这种归纳偏置与“动作块内强时间相关”的数据结构天然匹配,使专家压缩 10 倍后性能不降反升。第三层是条件接口设计:与 SUREFlow、Mamba Policy 等构建紧凑端到端策略不同,MambaAct 必须让“从零初始化的小专家”与“预训练大 VLM”对齐,作者用门控 FiLM 实现这一点——特征级缩放/偏移把动作表征适配到视觉-语言条件,残差门 $\sigma(\rho)$ 控制条件更新幅度;配合零初始化(FiLM 恒等、门初始 $\log(0.2/0.8)$ 即残差乘子 0.2)保证训练初期新分支只轻微激活。消融证明接口本身也有价值:同样的 Mamba 混合器,门控条件化比交叉注意力平均成功率高 1.7 个百分点且更快(107.61 对 119.66 ms)。
方法步骤详情
方法可拆成五步。第一步,前缀编码:给定腕部图 $I_w$、第三人称图 $I_e$ 与指令 $\ell$,保留的 π0.5 骨干输出前缀 $P=f_{\text{VLM}}(o)\in\mathbb{R}^{N\times d_{\text{vlm}}}$,每次查询只算一次、整个去噪过程复用。第二步,上下文压缩:前缀先投影到专家宽度 $\tilde{P}=PW_c+b_c$;视觉 token 按连续分段掩码均值池化成 $K_v=44$ 个段向量,语言 token 池化为 $K_\ell=16$ 个,另用 $K_g=4$ 个可学习查询经交叉注意力提取全局摘要;三组向量加模态嵌入、过 MLP 精炼后池化为条件向量 $z\in\mathbb{R}^d$。第三步,动作块初始化:噪声块 $X_t$($H=10$、padding 到 $d_a=32$、无机器人状态 token)经线性投影 $H^{(0)}=X_tW_{in}+b_{in}$ 变成 $H$ 个动作 token,流时间编码为 $c_t=\text{MLP}_t(\phi(t))$。第四步,门控 Mamba 块堆叠 $L=4$ 次:每块先加时间项得 $\bar{H}^{(l)}$;FiLM Gate MLP 从 $z$ 生成缩放 $\gamma^{(l)}$、偏移 $\beta^{(l)}$ 与残差门 $\rho^{(l)}$;Mamba-3 处理 RMSNorm 后的序列得 $U^{(l)}$,经 $(1+\gamma^{(l)})\odot U^{(l)}+\beta^{(l)}$ 调制后以 $\bar{H}^{(l)}+\sigma(\rho^{(l)})\odot U^{(l)}$ 门控注入,再过 FFN 进入下一块;FiLM 参数跨去噪步复用。第五步,预测与训练:末端 RMSNorm+线性头输出 $\hat{V}_\theta$,目标 $V^\star=\epsilon-A_0$,最小化流匹配损失 $\mathcal{L}_{\text{FM}}$;视觉编码器、VLM、压缩器与专家全模型单阶段联合微调 30,000 步(batch 16、AdamW、余弦学习率 $5\times10^{-5}\to5\times10^{-6}$、bfloat16),单张 H100 约 14 小时。
技术新颖性
从技术新颖性看,MambaAct 的贡献不在发明新算子,而在确立并验证一条新效率轴,并给出三个维度的受控证据。(1)架构替代而非蒸馏压缩:与 SnapFlow(保留 311.5M 专家但压成 1 步)、Shallow-π/CLP(蒸馏或剪层)不同,本文直接缩小“每步都要算”的那部分网络,节省随每次去噪步累乘,且无需教师模型、蒸馏损失或额外预训练。(2)归纳偏置的受控验证:Table V 的 $2\times2$ 消融把动作混合器与条件接口解耦——同 30M 参数下 Mamba+门控 98.4% 对 Transformer+门控 85.7%,差 12.7 个百分点,说明小尺寸下选择性递归确实比注意力更适合动作序列,而非参数量或条件化的副产品。(3)接口的极简性:把条件压成 64 个 token、再池化为单个向量 $z$,配合块级 FiLM,完全避免了去噪过程中的逐 token 交叉注意力,这挑战了“动作专家必须细粒度访问 VLM 表征”的默认假设,并与 FiLM 及扩散 Transformer 自适应调制的已有研究一致。此外整套方案原样搬到 SmolVLA(专家 98.25M→64.31M)仍提升 3.65 个百分点,证明这是骨干无关的通用设计。
实验结果
论文证据分五组。其一,LIBERO 主实验(Table I,微调种子 {17,27,42}):MambaAct 平均成功率 97.80%±0.43,较 π0.5 基线 96.72%±0.14 提升 1.08 个百分点,四套件全面领先(Spatial 98.73 对 98.00、Object 99.60 对 98.33、Goal 98.60 对 97.73、L-10 94.27 对 92.80);动作专家 311.5M→29.7M(↓90.5%),总模型 3.62B→2.96B,H100 上去噪延迟 160.26→56.40 ms(↓64.8%)、E2E 228.6→107.6 ms(↓52.9%),压缩器仅使前缀 40.76→46.61 ms。其二,横向对比(Table II):97.80% 在列出的高效 VLA 中排第二,仅次于一步蒸馏的 SnapFlow(98.8%、3.30×),但 MambaAct 无需蒸馏且保留标准 10 步流匹配,相对自身基线加速 2.12×,远超 π0-CLP(93.9%)、SpecPrune-VLA(93.5%)、EfficientVLA(88.9%)、SmolVLA(87.3%)。其三,LIBERO-Plus 零样本鲁棒性(Table III):总分 79.7% 列表第一(π0.5 为 78.7%),机器人初始位姿扰动 70.9→77.6,光照 95.2% 与布局 86.4% 均为最高,唯噪声扰动 77.4→73.5 下降。其四,真机双 UR5(Table IV):两任务 ID 均 100%,OOD 上倒坚果 86.5→95.2、放试管 76.9→82.7,RTX 5090 去噪延迟降 58.8%、E2E 降约 33%,GFLOPs 降 10.2%。其五,消融:同尺寸下 Mamba+门控 98.4% 远超 Transformer+门控 85.7%;门控优于交叉注意力(98.4% 对 96.7%);与 VLM 深度裁剪组合(L12)LIBERO 仍 97.5%、真机 E2E 83→74 ms;迁移 SmolVLA 后专家缩至 64.31M,同预算成功率 +3.65 个百分点、去噪延迟降 63.3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO 四套件平均成功率 | 成功率(3 微调种子 × 每任务 50 试验) | 97.80% ± 0.43 | π0.5:96.72% ± 0.14 | +1.08 个百分点 |
| 动作专家参数量 | 参数量 | 29.7M | π0.5 Transformer 专家:311.5M | ↓90.5%(约 10× 压缩) |
| LIBERO 去噪延迟(H100) | 10 步去噪延迟 | 56.40 ms | 160.26 ms | ↓64.8% |
| LIBERO 端到端延迟(H100) | E2E 延迟 | 107.6 ms | 228.6 ms | ↓52.9%(2.12× 加速) |
| LIBERO-Plus 零样本鲁棒性 | 7 类扰动总体成功率 | 79.7% | π0.5:78.7% | +1.0 个百分点,列表最高 |
| 真机倒坚果(UR5,OOD) | OOD 成功率 / E2E 延迟(RTX 5090) | 95.2% / 82.97 ms | π0.5:86.5% / 125.49 ms | +8.7 个百分点 / ↓33.9% |
| 真机放试管(UR5,OOD) | OOD 成功率 / E2E 延迟(RTX 5090) | 82.7% / 83.26 ms | π0.5:76.9% / 124.84 ms | +5.8 个百分点 / ↓33.3% |
| Mamba 专家迁移到 SmolVLA(LIBERO) | 平均成功率 / 去噪延迟 | 84.95% / 59.89 ms(专家 64.31M) | released SmolVLA:81.30% / 163.15 ms(专家 98.25M) | +3.65 个百分点 / 去噪↓63.3% |
| 与 VLM 深度裁剪组合(L12) | LIBERO 平均成功率 / E2E 延迟 | 97.5% / 102.91 ms(训练 10.81 h) | 完整 MambaAct:98.4% / 107.6 ms(训练 13.78 h) | 训练时间↓21.6%,E2E↓4.4% |
局限与改进
作者明确承认三点局限:真机实验仅限两个 UR5 桌面任务,且分布偏移主要是空间性的(10×10 cm 训练网格上的蓝/红位置划分);与视觉 token 剪枝、去噪步数压缩等其他效率技术的兼容性尚未评估;门控条件化与选择性 Mamba 状态动力学缺少更深入的机制分析。我的补充观察:(1)LIBERO 基线已饱和(基线 96.72%),+1.08 个百分点的提升空间有限,且种子间方差(±0.43 对 ±0.14)不小,提升的统计说服力一般;(2)门控对交叉注意力的优势受参数量混淆——门控版专家约 30M 而交叉注意力版仅 17-18M,作者自己也承认精度贡献“部分被容量混淆”;(3)条件被两级压缩到单个向量 $z$,在观测噪声扰动下成功率降 3.9 个百分点(77.4→73.5),可能暗示细粒度空间信息有损失;(4)Table II 的加速比跨硬件、跨实现混排(引用值与自测 H100 值并列),且各方法与各自基线比,横向可比性有限;(5)仅验证流匹配 VLA,对自回归 VLA(如 OpenVLA)不直接适用;(6)前缀侧反而变贵(40.76→46.61 ms),压缩后延迟结构改变,继续优化的边际收益需重新核算。
独立分析的弱点
独立来看,我认为有四个值得警惕的弱点。第一,基准天花板效应:LIBERO 平均已到 96.7%,剩余 3 个百分点里挤着多少方法差异很难说清,应转向长程、多阶段、稀疏奖励的基准(长视野任务或真实家庭场景)来放大差异。第二,条件接口的容量混淆:要干净地证明“门控 FiLM 优于交叉注意力”,应做严格参数匹配对照(给交叉注意力版补 FFN 或加深到同等 30M),目前的 98.4% 对 96.7% 只能算方向性证据,而 98.4% 对 85.7% 的 Mamba 优势结论更扎实。第三,信息瓶颈风险:64 个上下文 token、再池化为一个 $z$ 向量的两级压缩,在 224×224 双相机输入下够用,但换成多相机、更高分辨率或需要精细接触操作的任务时可能成为瓶颈,改进方向是保留少量逐 token 通道或让压缩率随去噪步自适应。第四,加速可组合性未验证:去噪延迟降 64.8% 后只占 E2E 的约 52%(56.4/107.6 ms),前缀反而从 40.76 ms 涨到 46.61 ms,成为新的相对瓶颈;MambaAct 与 SnapFlow 式单步化、视觉 token 剪枝的组合是显而易见的下一步,但组合后的精度-延迟帕累托前沿完全未知。此外,真机是双 UR5 静态基座加桌面网格设置,对移动操作、大范围关节运动、非结构化场景缺乏证据。
未来方向
作者提出的后续方向包括:扩展真机任务数量与分布偏移类型、评估与视觉 token 剪枝和去噪步压缩等其他效率技术的兼容性、深入分析门控条件化机制与 Mamba 选择性状态在动作生成中的动力学。基于其成果可自然延伸的研究有:(1)叠加式加速——把 MambaAct 与 SnapFlow 的单步蒸馏叠加,专家变小后蒸馏也可能更稳定,有望逼近 20 ms 级端到端延迟;(2)规模定律研究——系统扫描块数 $L$、宽度、状态维度与任务复杂度的关系,回答“多大的动作专家才够”这一基本问题;(3)把“紧凑条件向量 + 块级门控调制”接口推广到自回归或扩散类 VLA,检验其是否为通用的预训练-新模块对齐模式;(4)机制层面解释选择性递归为何适合动作序列,例如可视化状态记忆的时间尺度与任务节奏的对应关系;(5)研究压缩与鲁棒性的关系——本文噪声扰动下降 3.9 个百分点值得追查是否源于条件信息损失;(6)结合量化与编译优化,把 2.96B 模型推到消费级 GPU 上实现实时控制。
复现评估
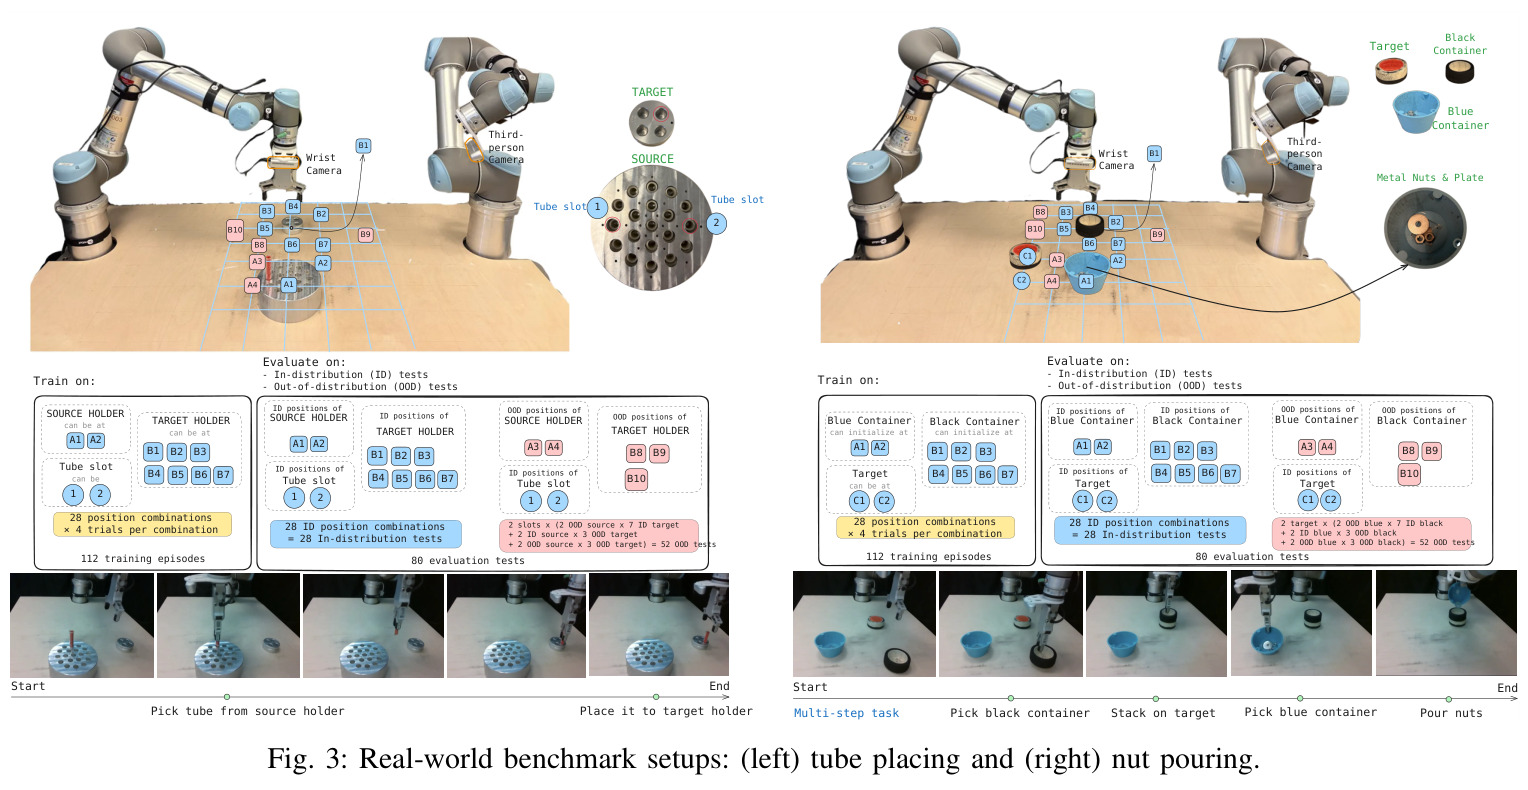
复现条件相当友好。代码与模型权重已在 GitHub 公开(github.com/giakhuyendihoc/MambaAct),基座是开源的 OpenPI π0.5,训练完全在单张 NVIDIA H100 上进行:30,000 步、batch 16、bfloat16、梯度检查点,约 14 小时/次;协议完全确定(微调种子 17/27/42,评估种子 7),LIBERO 评测每任务 50 次试验、四套件共 2,000 集,LIBERO-Plus 遵循官方协议每实例 1 次 rollout。仿真部分的复现门槛主要是一张大显存 GPU 和数天评测机时,且官方权重可直接加载评测。真机部分难度显著更高:需要双 UR5 机械臂、两个 RealSense 相机(腕部 + 第三人称)、30 fps 640×480 采集、30 Hz 控制,每个任务要采集 112 条演示(28 个配置 × 4 条),部署 GPU 为 RTX 5090。总体判断:仿真复现容易(代码、权重、超参齐全),真机复现需要实验室级硬件与遥操作数据采集能力,属于中等偏难;论文报告数字细致(前缀/去噪/E2E 分列、多种子均值±标准差),可核对性强。
论文图表
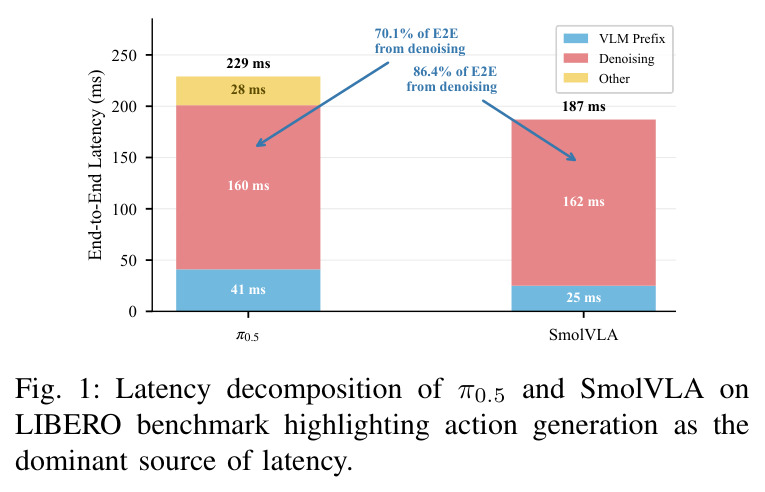
π0.5 与 SmolVLA 在 LIBERO 上的端到端延迟分解柱状图,把每次策略查询拆成视觉-语言前缀编码、10 步流匹配去噪与其余开销三段。π0.5 端到端约 250 ms,其中去噪占 70.1%;SmolVLA 端到端约 187 ms,去噪占比更升至 86.4%。
这张图是全文动机的量化依据:即便换用小得多的视觉-语言骨干,被反复求值的动作专家仍主导延迟,说明“替换动作专家架构”是被忽视的效率轴。
主结果表:MambaAct 四个套件成功率全面超过 π0.5(Spatial 98.73 对 98.00、Object 99.60 对 98.33、Goal 98.60 对 97.73、L-10 94.27 对 92.80),平均 97.80%±0.43 对 96.72%±0.14;模型从 3.62B 降至 2.96B,去噪延迟 160.26→56.40 ms(↓64.8%),E2E 228.6→107.6 ms(↓52.9%)。
这是支撑核心主张“压缩 10 倍且性能反升”的主表,同时给出性能与延迟两侧证据。
与各类高效 VLA 方法的横向对比:去噪步压缩(SnapFlow 98.8%、3.30×)、深度蒸馏/剪枝(Shallow-π 97.0%、π0-CLP 93.9%)、视觉 token 剪枝(LightVLA 97.4%、ADP 94.4%、FastV 93.3% 等)、路由稀疏化(CogVLA 97.0%)、多轴混合(EfficientVLA 88.9%)、紧凑架构(SUREFlow 92.5%、SmolVLA 87.3%、OpenVLA 76.6%)。MambaAct 以 97.80%、2.12× 加速位列平均成功率第二。
把“动作专家替换”与五大类既有效率方法放在同一坐标系,凸显本文作为新效率轴的定位与竞争力。
七类扰动下的零样本鲁棒性:MambaAct 总分 79.7% 高于 π0.5 的 78.7%,为列表最高;机器人初始位姿 70.9→77.6、光照 95.2%、布局 86.4% 均为最佳或并列最佳;相机 61.5 基本持平(π0.5 为 61.6);唯一下降是观测噪声 77.4→73.5。表中还列出 OpenVLA(15.6%)、π0(53.6%)等十余个已发表方法的对比。
回答“激进压缩是否牺牲鲁棒性”这一关键质疑,是主结果之外最重要的稳健性证据。
真机结果:两任务 ID 成功率均为 100%;OOD 上倒坚果 86.5→95.2、放试管 76.9→82.7,最终成功率(含部分得分)分别 91.3→96.9 与 85.0→88.8;模型 3.62→2.96B(↓18.2%)、GFLOPs 5001.2→4488.8(↓10.2%)、去噪延迟 74.82→30.84 与 75.42→31.11 ms(均↓58.8%)、E2E 降约 33%。
证明效率收益与 OOD 鲁棒性提升能从仿真迁移到物理部署,是方法实用性的关键证据。
$2\times2$ 消融(Mamba/Transformer 混合器 × 门控/交叉注意力条件化):Mamba+门控 98.4%(0.030B,107.61 ms)> Mamba+交叉注意力 96.7%(0.017B,119.66 ms)> Transformer+门控 85.7%(0.030B,74.22 ms)> Transformer+交叉注意力 75.6%(0.018B,85.60 ms)。
这是归因核心:同参数量下 Mamba 比 Transformer 高 12.7 个百分点,说明性能来源是选择性递归这一归纳偏置,而非压缩或条件化本身;同时暴露门控对比中的参数量混淆。
组合实验:只执行 12/18 层 VLM 的 MambaAct-L12 在 LIBERO 平均 97.5%(99.2/99.8/98.0/94.0),训练时间 13.78→10.81 小时,E2E 107.6→102.91 ms,仅比完整版低 0.9 个百分点。
证明动作专家替换与前缀侧加速(VLM 深度裁剪)可以正交叠加,支撑“通用效率轴”的论断。
真机组合实验:L12 把部署模型从 2.96B 降至 2.30B,RTX 5090 延迟 83→74 ms;两任务 ID 仍 100%,倒坚果最终 95.0%(OOD 92.31)、放试管最终 90.0%(OOD 84.62,甚至高于完整版的 82.7)。
表明前缀侧压缩与专家替换在物理部署上同样可叠加,且进一步压缩后真机性能几乎无损。
迁移实验:把 SmolVLA 的 Transformer 动作专家(98.25M)换成 4 块 Mamba 专家(64.31M,↓34.5%)。在与 released SmolVLA 相同的 25k 步、batch 32 预算下,成功率 81.30→84.95(+3.65 个百分点),去噪延迟 163.15→59.89 ms(↓63.3%)、E2E 188.69→90.61 ms(↓52.0%);最大增益在 L-10(70.2→77.8)与 SPATIAL(76.6→82.6)。
证明动作专家替换是骨干无关的通用设计,而不依赖 π0.5 的特定结构,显著拓宽了方法的适用范围。