EmoReward:面向情感视频生成强化学习的自进化奖励校准 EmoReward: Self-Evolving Reward Calibration for Emotional Video Generation RL
用实例级反思门控与跨轮次奖励记忆,自适应校准多源情感奖励的信任权重
前置知识
GRPO(组相对策略优化)
一种生成模型后训练强化学习算法:对同一提示采样一组候选输出,用组内奖励均值 $\mu_G$ 与标准差 $\sigma_G$ 把每个输出标准化为相对优势 $A_i=(R(x_i,p)-\mu_G)/(\sigma_G+\epsilon)$,再做带裁剪与 KL 正则的策略更新,无需绝对奖励标定。
EmoReward 的情感奖励直接作为 GRPO 的组内奖励信号。理解优势标准化才能明白为什么固定融合的常数项在组内会抵消、而权重的相对变化会改变策略学习方向(论文 3.1 节的推导正是建立在这上面)。
Reward Hacking(奖励破解)
强化学习中策略找到让奖励函数打高分、却未真正完成预期目标的捷径。在情感视频生成里表现为:生成夸张表情、高饱和色彩等能讨好固定评分器的模式,而非符合提示的真实细腻情感,视觉清晰、时序稳定却毫无情感传达。
固定多奖励融合会把有效、缺失、饱和的信号混在一起,正是 reward hacking 的温床;EmoReward 的实例级门控与跨轮记忆校准就是为了堵住这些打分捷径,这是论文动机的核心。
VAD 情感模型与面部动作单元(AU)
VAD 用效价、唤醒度、支配度三个维度刻画情感;面部动作单元是 FACS 对面部肌肉运动的编码(如 AU6+AU12 表示微笑)。本文 EmoScript 含效价/唤醒目标 $v^\star,a^\star$、目标 AU 强度 $q^\star_{AU}$、身体线索与表达窗口 $\Omega$。
Plan 阶段要把抽象情感意图翻译成这些可度量标准,Act 阶段的多个 provider(面部 AU、R1-Omni 等)据此评估视频。不懂这套情感表示,就看不懂奖励是如何从'悲伤'这种抽象词落地为可计算分数的。
扩散/流生成模型的 RL 后训练
扩散或流匹配生成器(如 HunyuanVideo 1.5、SD 3.5、FLUX)先经预训练学会生成,再用 RL(DanceGRPO、FlowGRPO、SAGE-GRPO 等)配合奖励模型做后训练:每步采样一批候选视频/图像,由奖励信号引导策略在去噪轨迹上的更新。
EmoReward 是插入这类 RL 算法中的奖励组件,论文实验横跨三种视频优化器与两个图像骨干。理解这个背景才能体会'优化器无关的奖励插件'这一定位,以及 rollout 成本为何决定了实验规模。
KL 正则化分配与闭式最优
分配权重时加入与基准分布的 KL 散度惩罚以防止偏离先验。带截断效用时仍有闭式解:$w_k \propto w^0_k e^{\Delta_k}$,$\Delta_k=\mathrm{clip}(A^{rel}_k/\tau,-c,c)$,softmax 形式既有界又最优。
RewardMemory 的乘子公式 $w^{RM}_k(z)=w^0_k e^{\Delta_k}/\sum_j w^0_j e^{\Delta_j}$ 正是该闭式解(附录 F),说明记忆校准不是启发式调权,而是有优化论根据的设计——这是评价本文技术贡献深度的关键。
研究动机
GRPO 等强化学习方法在代码、数学等可验证领域已非常成功,因为正确性本身提供直接的学习信号;但视频质量——尤其情感表达——的评估依赖主观美学,没有唯一正确目标。现有视频 GRPO 方法通常用固定的视觉质量、运动质量与文本对齐奖励,难以捕捉情感意图,还容易被 reward hacking:策略会利用打分捷径而非真正提升情感保真。RLHF 虽能处理主观目标,但人工标注难以规模化,个体审美差异又使面部、肢体动作与色彩线索在不同叙事情境下的校准变得复杂——面部线索要求画面里有可见人脸,强烈运动反而破坏克制的悲伤,高饱和色彩可能只是风格而非情感意图。把有效、缺失、饱和的信号混进同一固定融合公式,会让策略更新钻评分器的空子,偏离真实情感目标。
本文的目标是本文要构建一个面向情感视频生成 RL 的自进化奖励校准机制 EmoReward,回答一个核心问题:当前视频中哪些情感证据值得信任、应该给多大权重。具体路径是:先从情感提示规划可度量的评估线索(Plan),用异构信号原语为生成视频打分(Act),在实例层面校准各证据的贡献(Reflect),并在一次完整训练运行结束后,从奖励-结果轨迹中蒸馏每个 provider 在各情感 regime 下的可靠性,以有界乘子的形式固定下来指导下一轮训练的多奖励权重分配(Evolve)。全程不更新任何奖励模型参数,生成器是唯一接收梯度更新的组件,校准表在轮内完全冻结。
与已有工作不同的是,本文的独特切入是在两个互补层面同时做奖励校准:实例级(评估当前视频中哪些线索有效)与跨轮次(从一次已完成的训练运行学习这些线索应有多大影响力)。作者把奖励权重分配形式化为情感上下文 $z$ 上的决策问题:providers 是动作,融合权重构成策略,存储的参考结果 $y$ 提供非参数化的可靠性信号。与 RLHF 依赖人工偏好、与固定融合假设全局可信度恒定不同,EmoReward 只利用训练中自然产生的 rollout 轨迹,把'训练经验在轮次级别可复用'确立为多模态基础模型后训练的新范式;与 JitRL 从检索到的动作优势推导策略更新不同,它转移的是跨训练轮次的奖励-结果证据。
核心方法
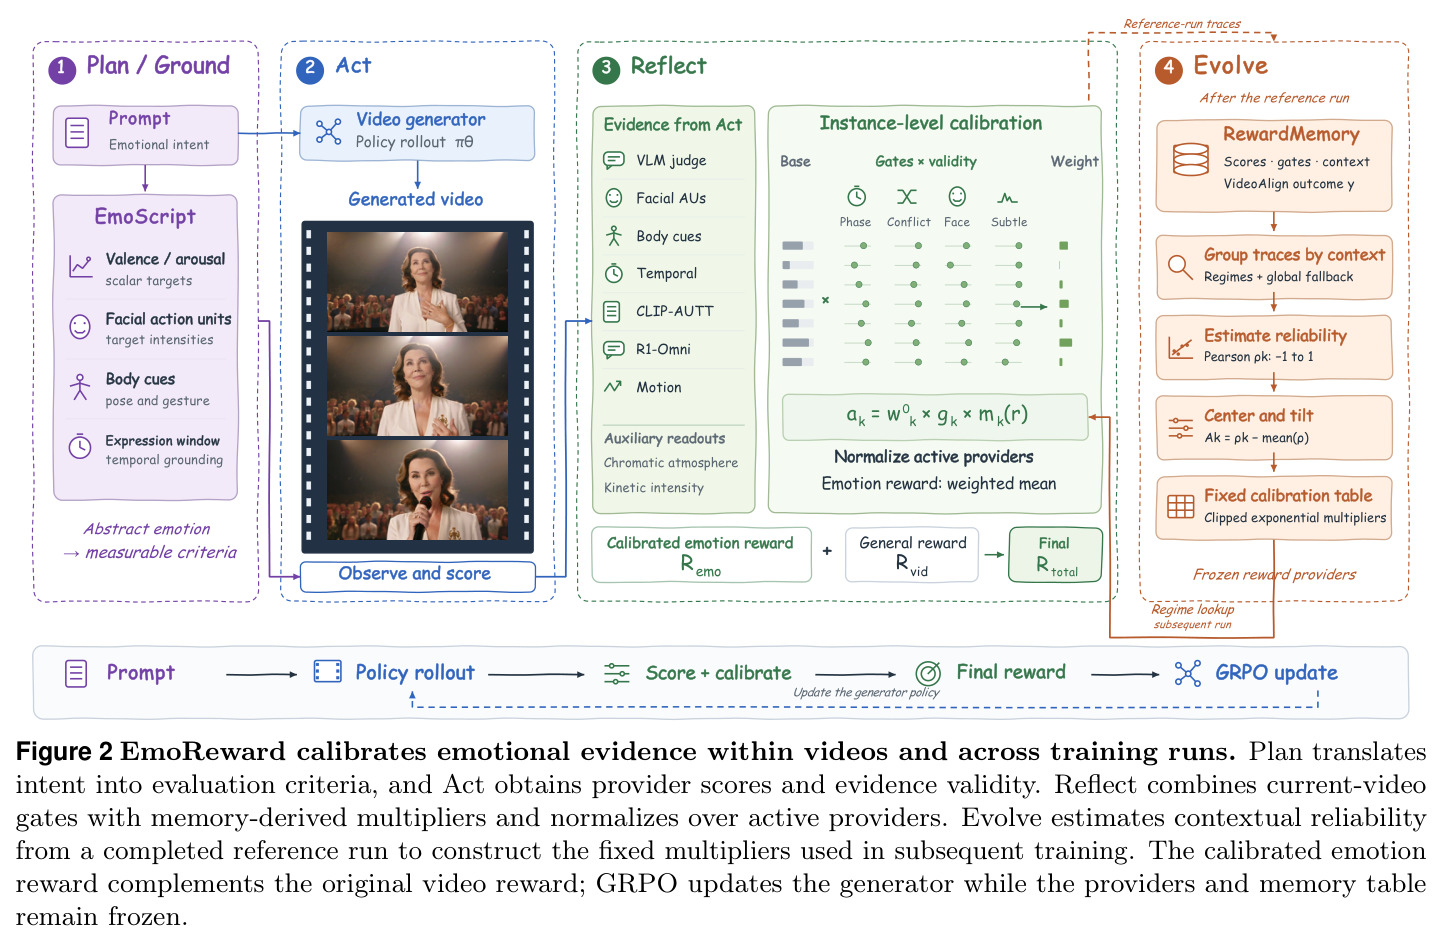
EmoReward 是 Plan→Act→Reflect→Evolve 四阶段流水线:先明确要评估什么,再观察视频证据,然后按当前情况分配信任,最后从历史训练学习长期信任分配。Plan 把提示转化为 EmoScript $e(p)=(v^\star,a^\star,q^\star_{AU},b^\star,\Omega)$,含效价/唤醒目标、面部 AU 强度、身体线索与表达窗口。Act 用 7 个融合 provider(VLM judge、面部 AU、身体线索、时序证据、CLIP-AUTT、R1-Omni、运动自然度)加 2 个辅助读数打分,返回准则分 $s_k$ 与有效性 $u_k\in[0,1]$。Reflect 在活跃集上归一化融合出 $R^{emo}$,按 $R_{total}=(\alpha R_{vid}+\beta R^{emo})/(\alpha+\beta)$ 与 VideoAlign 混合,实验取 $\alpha=\beta=0.5$。Evolve 在参考轮后从轨迹构建 RewardMemory 查找表,为下一轮提供冻结乘子。
核心创新是把'信任哪些证据、给多少权重'变成可跨训练轮次学习的决策问题,与固定融合和 RLHF 有本质区别。第一,provider 输出分解为准则分 $s_k$ 与有效性 $u_k$,缺失人脸通道不算证据。第二,实例级 Reflective Reward Gating 用门控 $g_k=g^{phase}_k g^{conflict}_k g^{face}_k g^{subtle}_k u_k$ 处理当前视频——记忆再偏好某 provider 也无法激活无效证据,校准只通过相对贡献起作用。第三,RewardMemory 用 Pearson 相关 $\rho_k(z)=\mathrm{Cov}(s_{k,i},y_i)/(\sigma_{s_k}\sigma_y+\epsilon)$ 度量 provider 与参考结果的一致性,经截断指数映射 $w^{RM}_k(z)=w^0_k e^{\Delta_k}/\sum_j w^0_j e^{\Delta_j}$ 归一化——这是带截断效用的 KL 正则化分配的闭式最优解;无记忆条目时退化为 Reflect-only 融合。
方法步骤详情
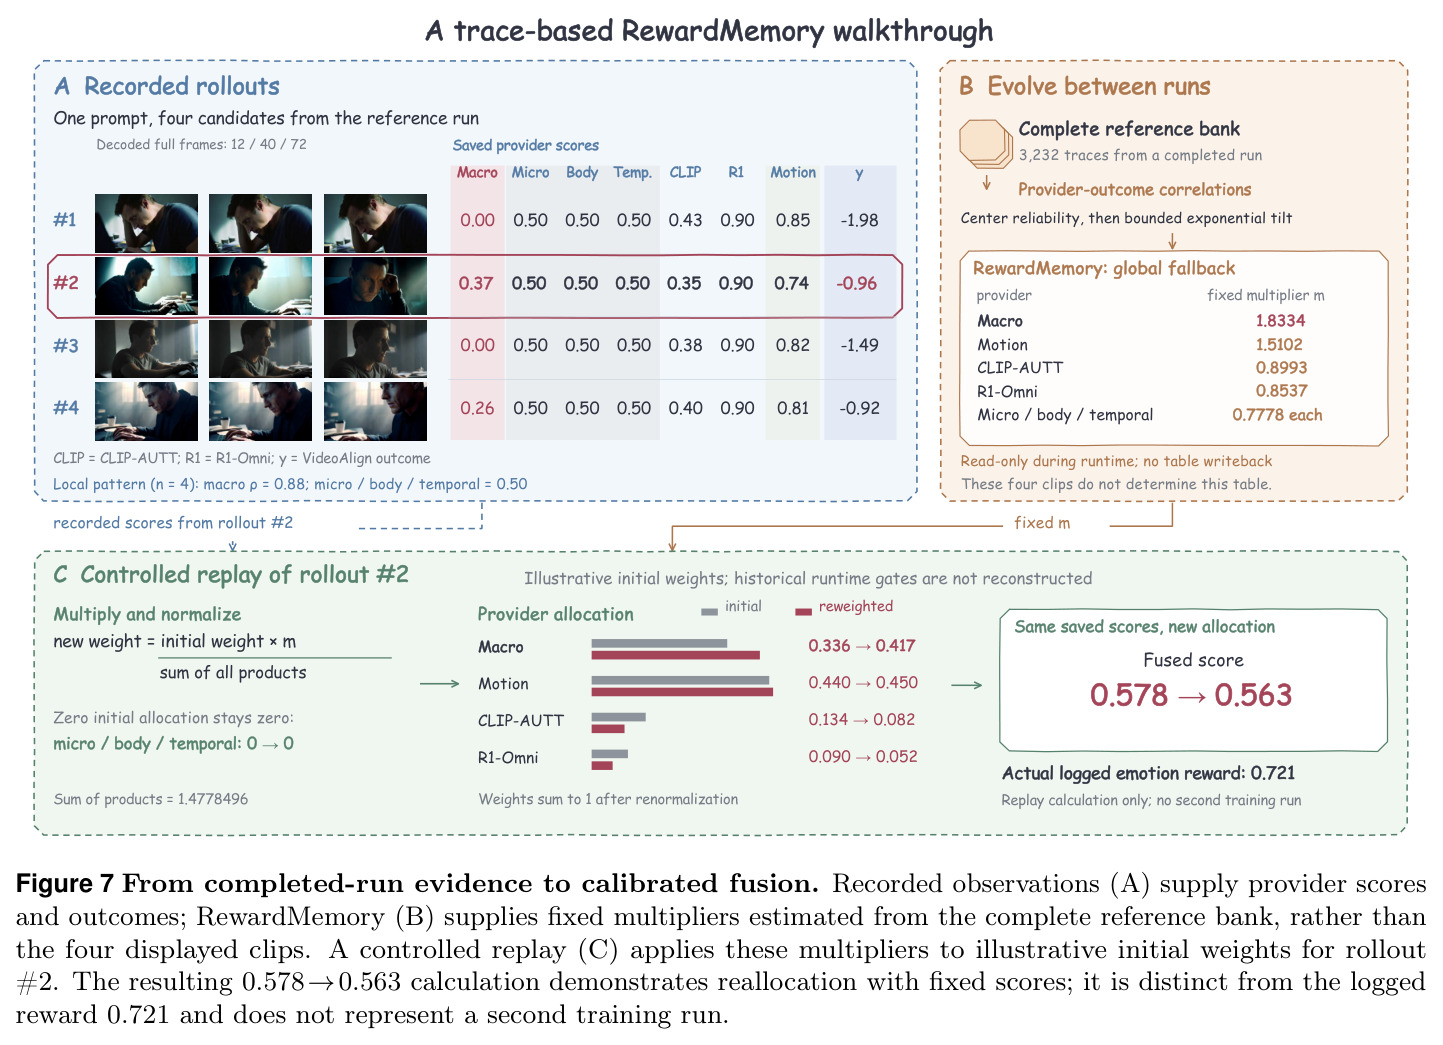
算法 1:构建 EmoScript $e(p)$→各 provider 输出 $(s_k,u_k)$→计算门控 $g_k$(阶段 warmup、人脸置信、语义冲突、微妙度加 $u_k$)→形成签名 $z$ 查 regime $r(z)$,无匹配则冷启动 $m_k\leftarrow 1$→$a_k\leftarrow w^0_k m_k g_k$,在活跃集 $A=\{k:a_k>\epsilon_g\}$ 上归一化融合,无效证据不分配质量→混合 $R_{total}$、记录轨迹并冻结 $T_M$。算法 2:参考轮后按上下文分组轨迹 $m_i=(z_i,\{s_{k_i}\},\{g_{k_i}\},w_i,R_i,y_i)$,支持不足(少于 $n_{min}=20$ 条)回退全局集合;逐 provider 算 $\rho_k$(常量分数取 0),中心化 $A^{rel}_k=\rho_k-\bar\rho$,乘子 $m_k=\exp(\mathrm{clip}((\rho_k-\bar\rho)/\tau,-c,c))$,实验取 $K=7,\tau=0.5,c=1$;导出后整轮冻结。
技术新颖性
技术新颖性有三点。其一,据作者所知这是首个面向情感视频生成 RL 的自进化训练机制,也是首个为视频生成多奖励系统设计的记忆:经验不存进生成器参数,而是存进奖励分配表,奖励模型参数始终不变。其二,与 JitRL 从检索到的动作优势推导闭式策略更新不同,EmoReward 跨越已完成的训练轮次转移奖励-结果证据,把'训练经验可在轮次级别复用'确立为后训练多模态模型的新范式;与静态融合假设所有场景共享同一信任分配不同,它按情感 regime 条件化。其三,四个门控因子(阶段、人脸、冲突、微妙度)按规则计算而非学习(附录 D),记忆乘子有严格的优化论解释(KL 正则化分配闭式解,附录 F),机制兼具可解释性与理论依据;全局回退与冷启动设计保证系统在无记忆时仍能正常工作。
实验结果
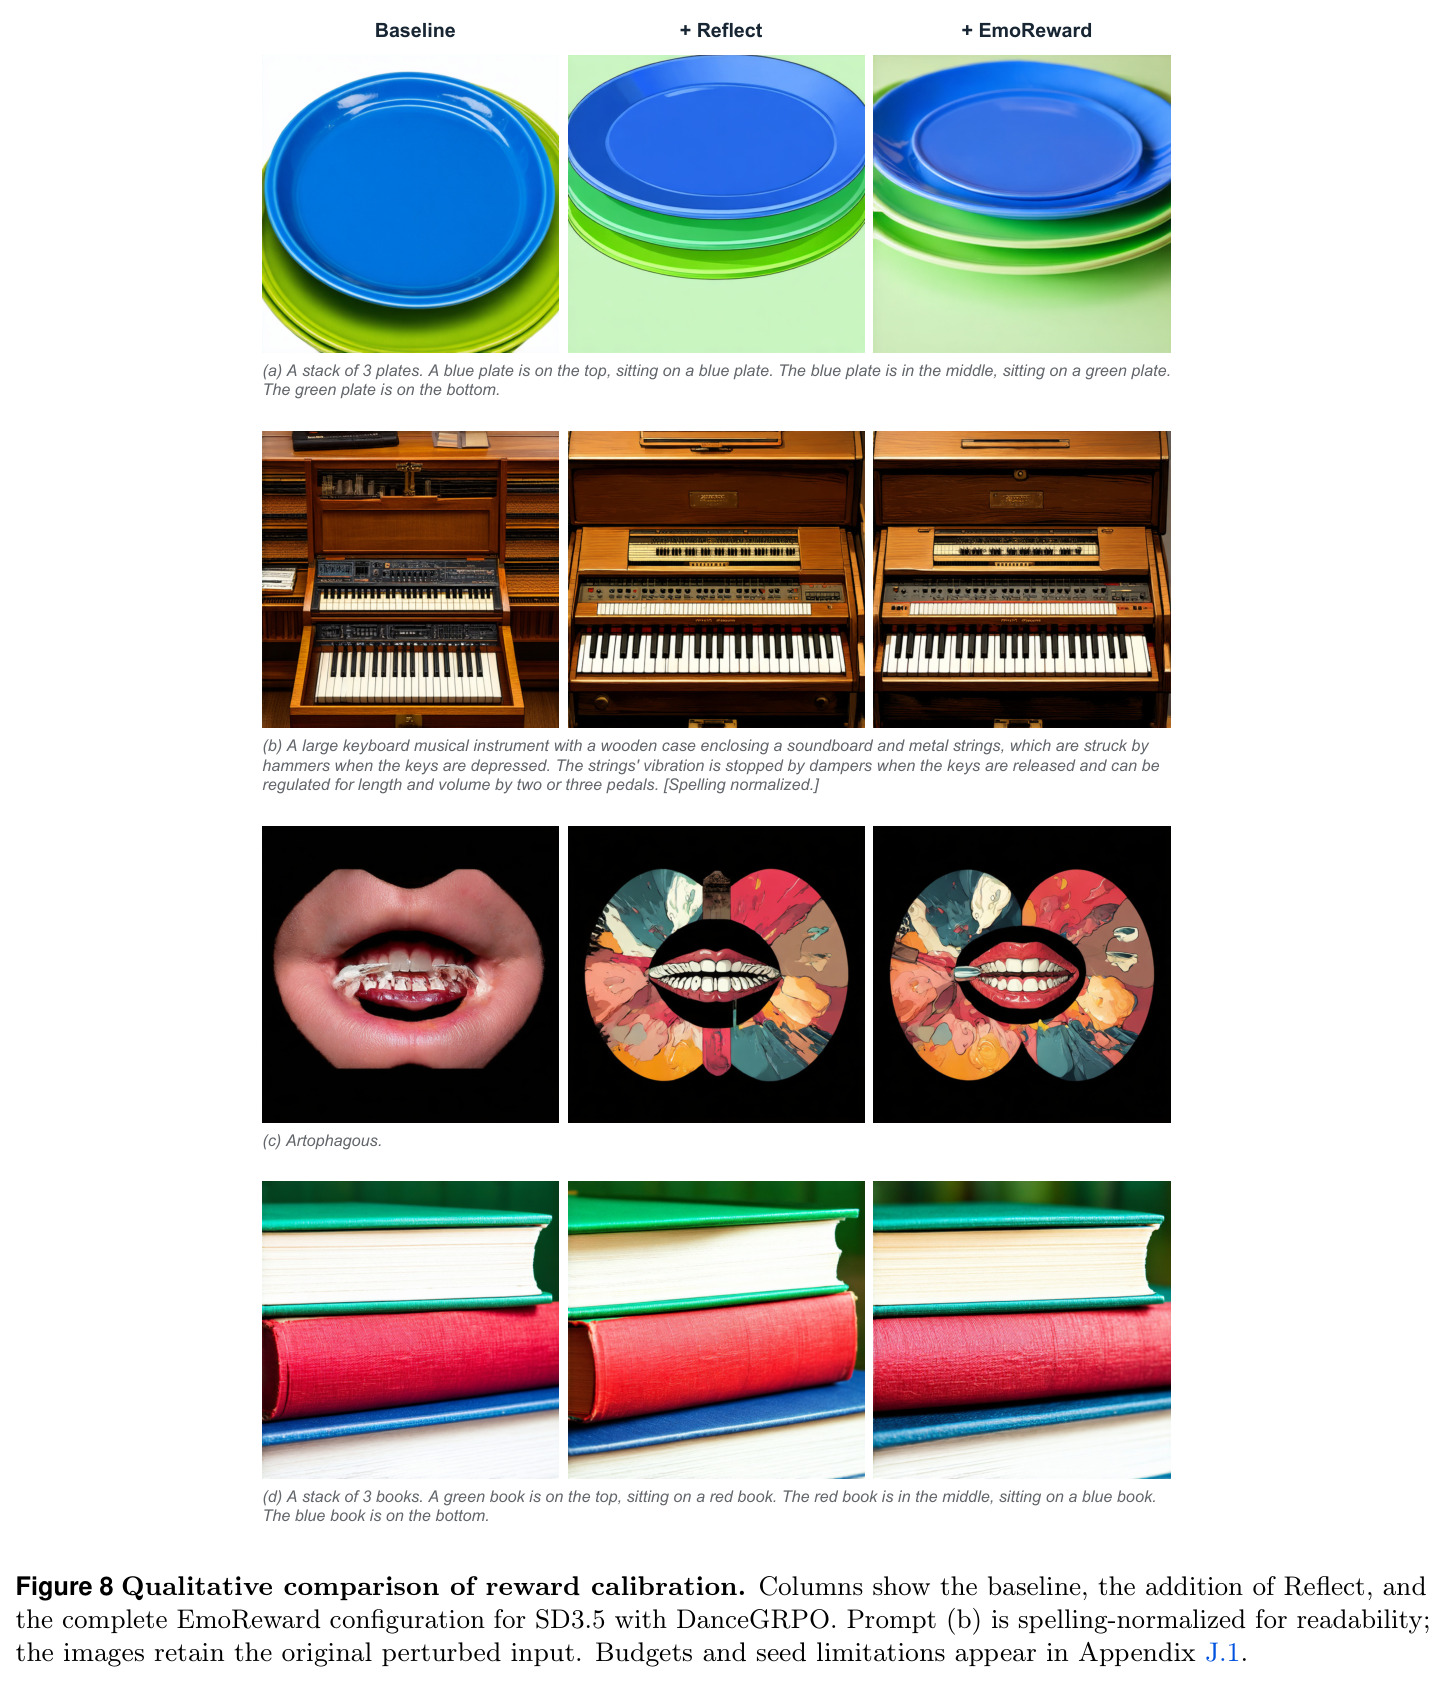
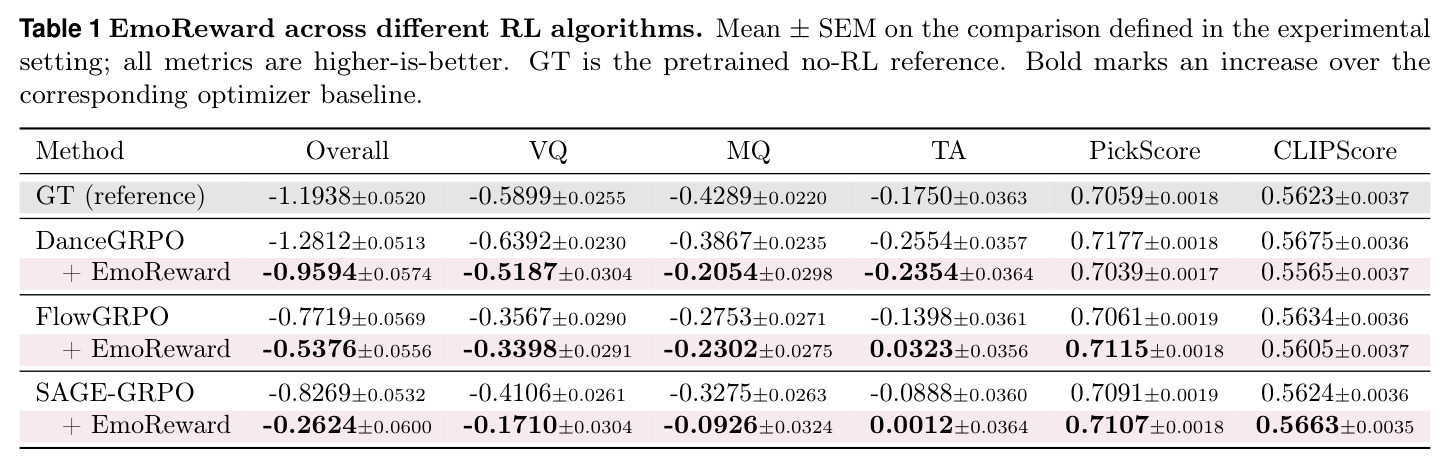
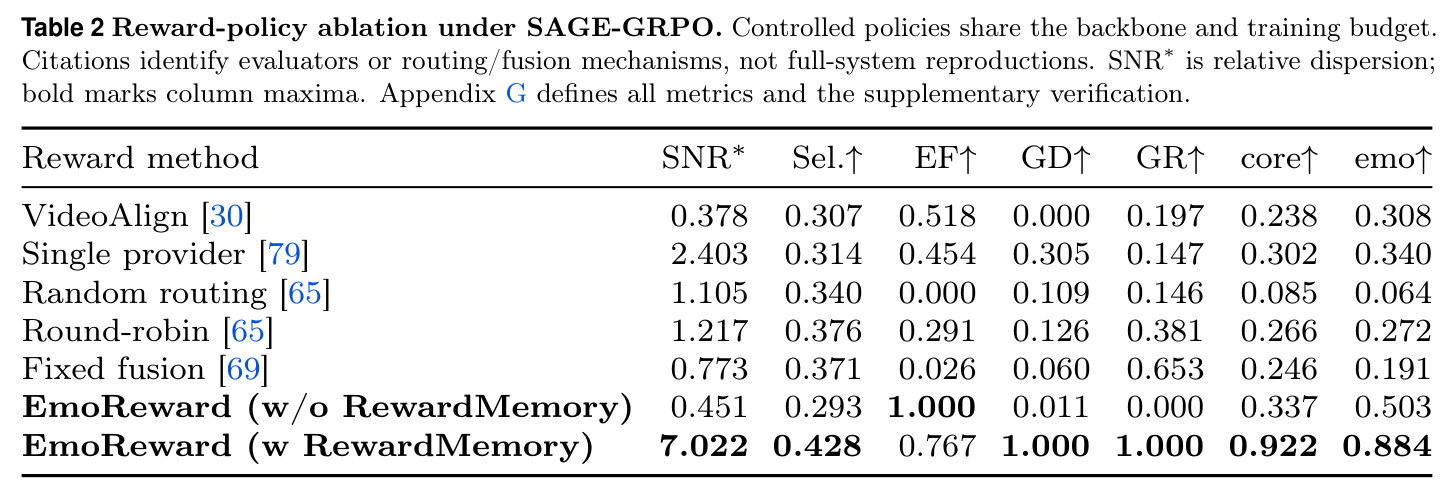
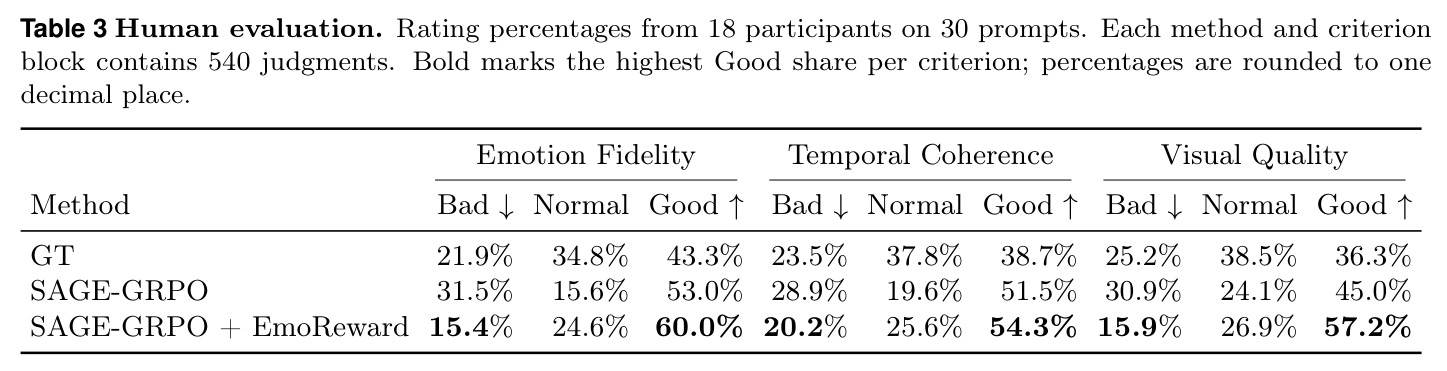
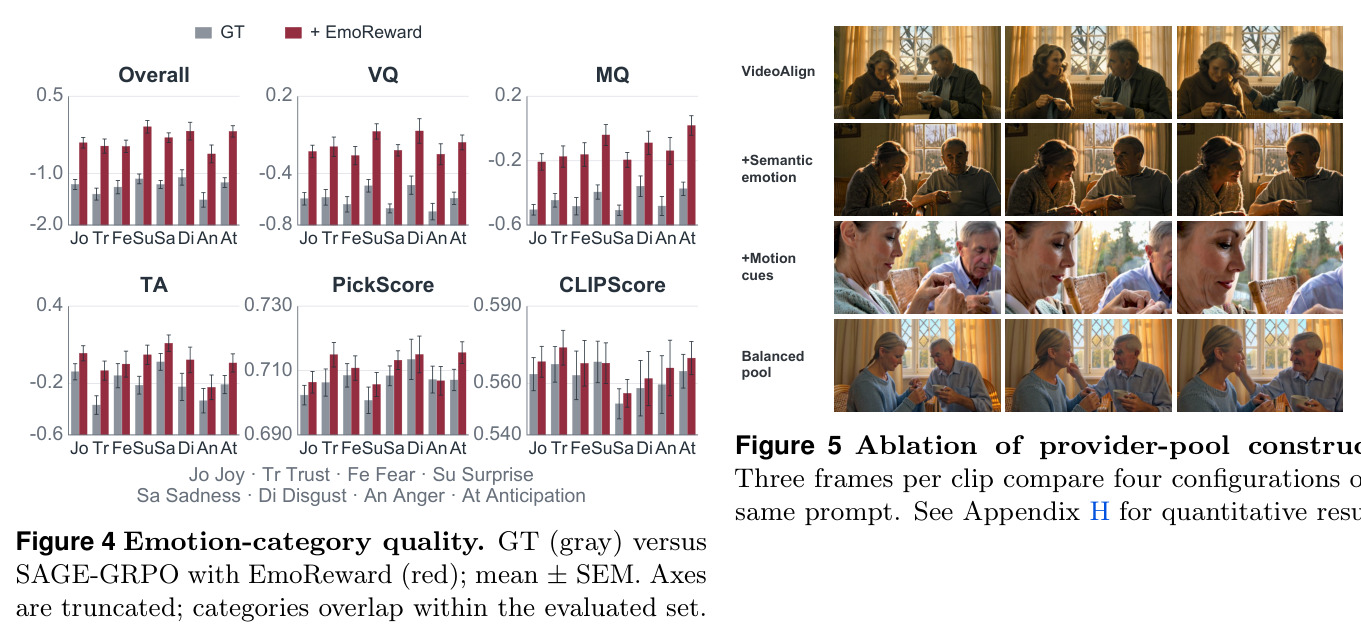
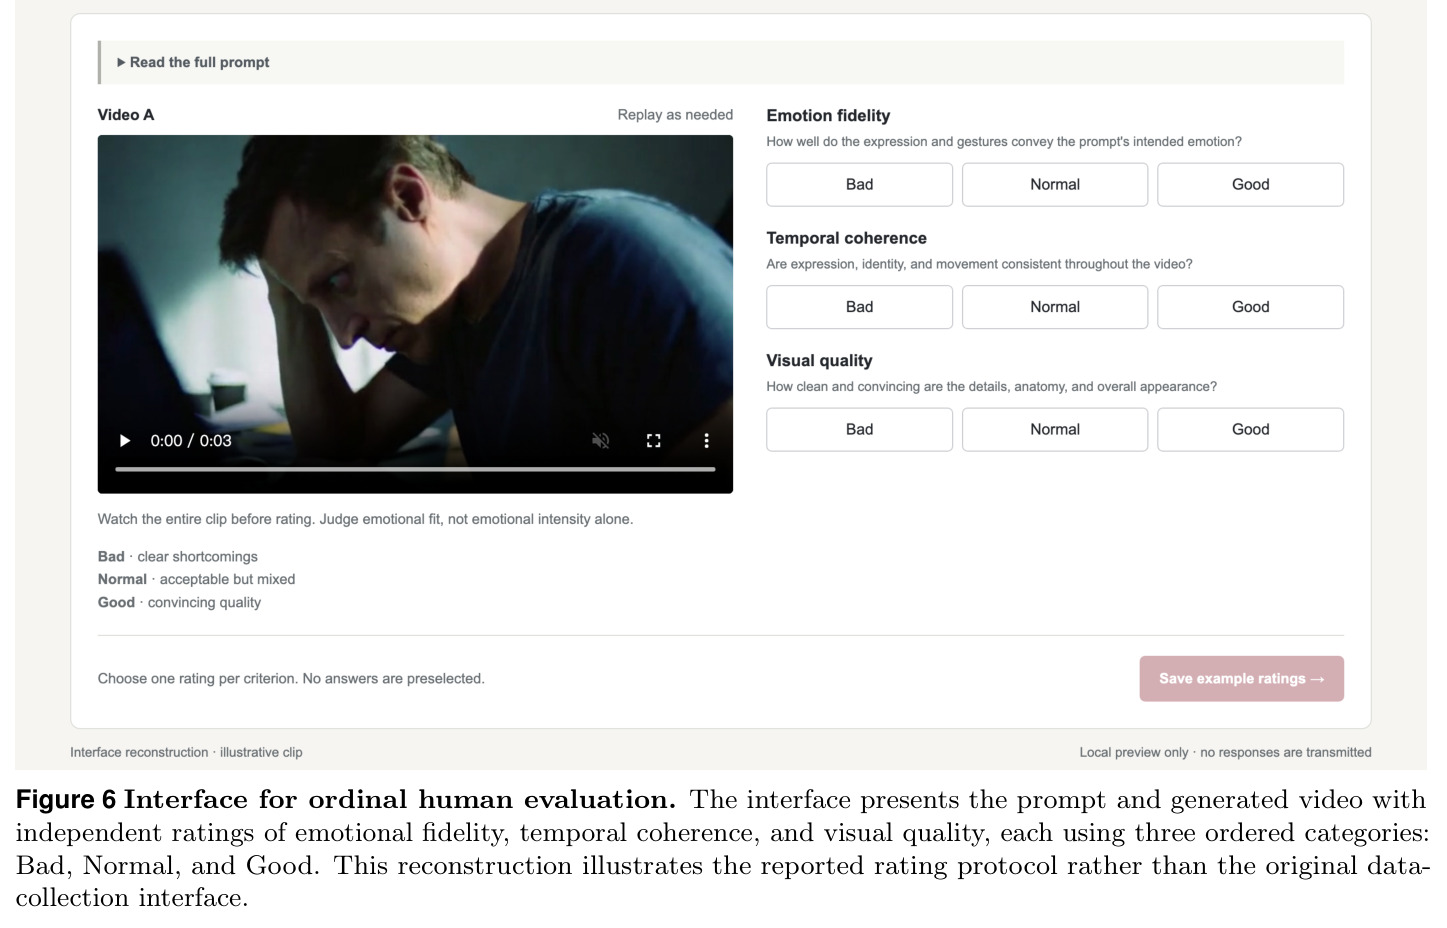
HunyuanVideo 1.5 上以 DanceGRPO、FlowGRPO、SAGE-GRPO 训练,302 个与训练不重叠的情感提示上评估。Table 1:VideoAlign Overall 相对基线提升 DanceGRPO +0.3218、FlowGRPO +0.2343、SAGE-GRPO +0.5645,四个 VideoAlign 头全面上升,TA 改善最明显(FlowGRPO -0.1398→0.0323)。Figure 4:八个情感类别上四个 VideoAlign 头全部超 GT。Table 2 七策略对照:完整系统 Sel 0.428、core 0.922、emo 0.884、SNR* 7.022 全面领先;记忆乘子 macro 1.833、motion 1.510 最大,三个常量通道仅 0.778。Table 3 人类评估(18 人×30 提示):Good 份额最高 60.0%(三维度均最高)、Bad 份额均最低,SAGE-GRPO 的 Bad 份额反而全面高于 GT。迁移呈目标依赖权衡:SD3.5-DanceGRPO 在 HPSv3 提升,FLUX 基线仍最强。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 情感视频生成 RL(SAGE-GRPO 优化器) | VideoAlign Overall(302 情感提示,mean±SEM) | -0.2624±0.0600 | SAGE-GRPO:-0.8269±0.0532 | +0.5645 |
| 情感视频生成 RL(FlowGRPO 优化器) | VideoAlign Overall | -0.5376±0.0556 | FlowGRPO:-0.7719±0.0569 | +0.2343 |
| 情感视频生成 RL(DanceGRPO 优化器,仅加 Reflect) | VideoAlign Overall | -0.9594±0.0574 | DanceGRPO:-1.2812±0.0513 | +0.3218 |
| 七策略奖励消融(SAGE-GRPO,固定骨干与预算) | 选择性 Sel.↑ / 复合分 core↑ / emo↑ | Sel 0.428、core 0.922、emo 0.884、SNR* 7.022 | VideoAlign-only:Sel 0.307、core 0.238、emo 0.308;无记忆版 Sel 0.293 | Sel 较最强基线 +0.052,core/emo 大幅领先且 SNR* 从 0.378 升至 7.022 |
| 人类评估(18 人 × 30 提示,每块 540 次判断) | 情感保真 Good 份额(另有时序连贯、视觉质量) | 60.0%(时序 54.3%、视觉 57.2%;Bad 份额均最低 15.4%/20.2%/15.9%) | SAGE-GRPO:53.0%/51.5%/45.0%;GT:43.3%/38.7%/36.3% | 情感保真 Good +7.0pp,三个维度 Bad 份额均最低 |
| 图像迁移(SD3.5-DanceGRPO / FLUX) | HPSv3 | SD3.5 加校准后 HPSv3 提升 | 各自无校准基线;FLUX 的 HPSv3 优化基线 | 目标依赖的权衡:SD3.5 提升,FLUX 上基线仍最强(预算不等,附录 J) |
局限与改进
作者明确承认多条限制:VideoAlign 既是 $R_{vid}$ 的来源又是参考结果 $y$,因此记忆可靠性度量的是与该目标的一致性而非独立的情感保真度,macro 通道与评估器共享信息、其相关性反映目标一致性;PickScore/CLIPScore 只是帧平均代理且变化不均;SD3.5/FLUX 迁移实验训练预算不等,限制因果归因;人类评估只是 18 人×30 提示的描述性统计,缺乏考虑重复判断的参与者级与提示级不确定性估计;八个情感类别在评估集内有重叠;作者还指出 matched global-memory 对照实验仍是分离上下文校准净收益的必要工作。我的补充观察:系统必须先完整跑一次参考轮才能构建记忆表,训练成本近似翻倍;表在轮内冻结,无法适应训练过程中的分布漂移;核心结论建立在 302 个情感提示的子集上,泛化边界尚不清楚。
独立分析的弱点
独立分析发现几个弱点。第一,参考轮开销:必须先完成一次带 Reflect 的完整训练来收集轨迹,两轮串行成本高,改进方向是让多项目共享/复用记忆表,或用少量 step 的 pilot run 近似估计可靠性。第二,参考结果的循环性:$y$ 来自 VideoAlign、与优化目标同源,可靠性可能只是'学会迎合评估器',有放大评估器偏差的风险,改进方向是引入独立指标或小规模人类偏好作 $y$ 并交叉验证。第三,门控规则(阶段、人脸置信、冲突、微妙度)全部手工设计,阈值与适用范围依赖先验知识,改进方向是把门控参数也纳入轨迹驱动的校准,甚至让它随 regime 条件化。第四,冻结表无法在轮内响应分布变化,若训练早期与后期最优信任分配不同,固定乘子可能次优,可探索带严格幅度限制的保守在线写回。第五,图像迁移结论 objective-dependent 且预算不等,跨模态与跨基座的泛化证据还不足,需要在同等预算下重做。
未来方向
作者提出把'已完成训练轮次指导下一轮奖励分配'作为跨轮次自进化范式的研究基础。可延伸方向:将连续 VAD 轨迹与支配度目标纳入 EmoScript(当前实现只支持标量目标);执行作者指出的 matched global-memory 对照实验以隔离上下文校准的净收益;在轮内引入保守的记忆更新以适应分布漂移,并分析其稳定性;把 regime 概念推广到非情感维度(构图、物理合理性、镜头语言),让同一框架服务更广的多奖励系统;从理论上分析乘子截断 $c$ 与温度 $\tau$ 的敏感性、跨轮次迭代的收敛性与不动点性质;扩大人类评估规模,做参与者与提示层面的统计推断;探索跨模型家族(如 HunyuanVideo→其他视频基座)的记忆迁移与冷启动加速,以及多个 completed run 的记忆聚合。
复现评估
开源情况较好:论文给出项目页(emoreward-project.github.io)与 GitHub 仓库(github.com/Tencent-Hunyuan/EmoReward),附录 C–I 规定了奖励接口、校准规则、数学推导、评估协议、完整对比表与定性示例,并声明提供可编辑图与表格构建脚本。关键超参数全部公开:$\alpha=\beta=0.5$、batch size 2、组大小 $G=4$、$K=7$、$\tau=0.5$、乘子上限 $c=1$、最小支持 $n_{min}=20$,评估集为 302 个与训练不重叠的情感提示。但复现门槛高:需要 HunyuanVideo 1.5 级别的视频生成模型做 GRPO 训练,rollout 开销巨大;必须先完成一次参考轮训练才能构建 RewardMemory,等于两轮训练成本;七个 provider 依赖具体模型(VLM judge、CLIP-AUTT、R1-Omni 等)的部署;附录也承认图像迁移实验预算不等。综合评估:高难度复现,更适合有大规模 GPU 集群的团队。
论文图表
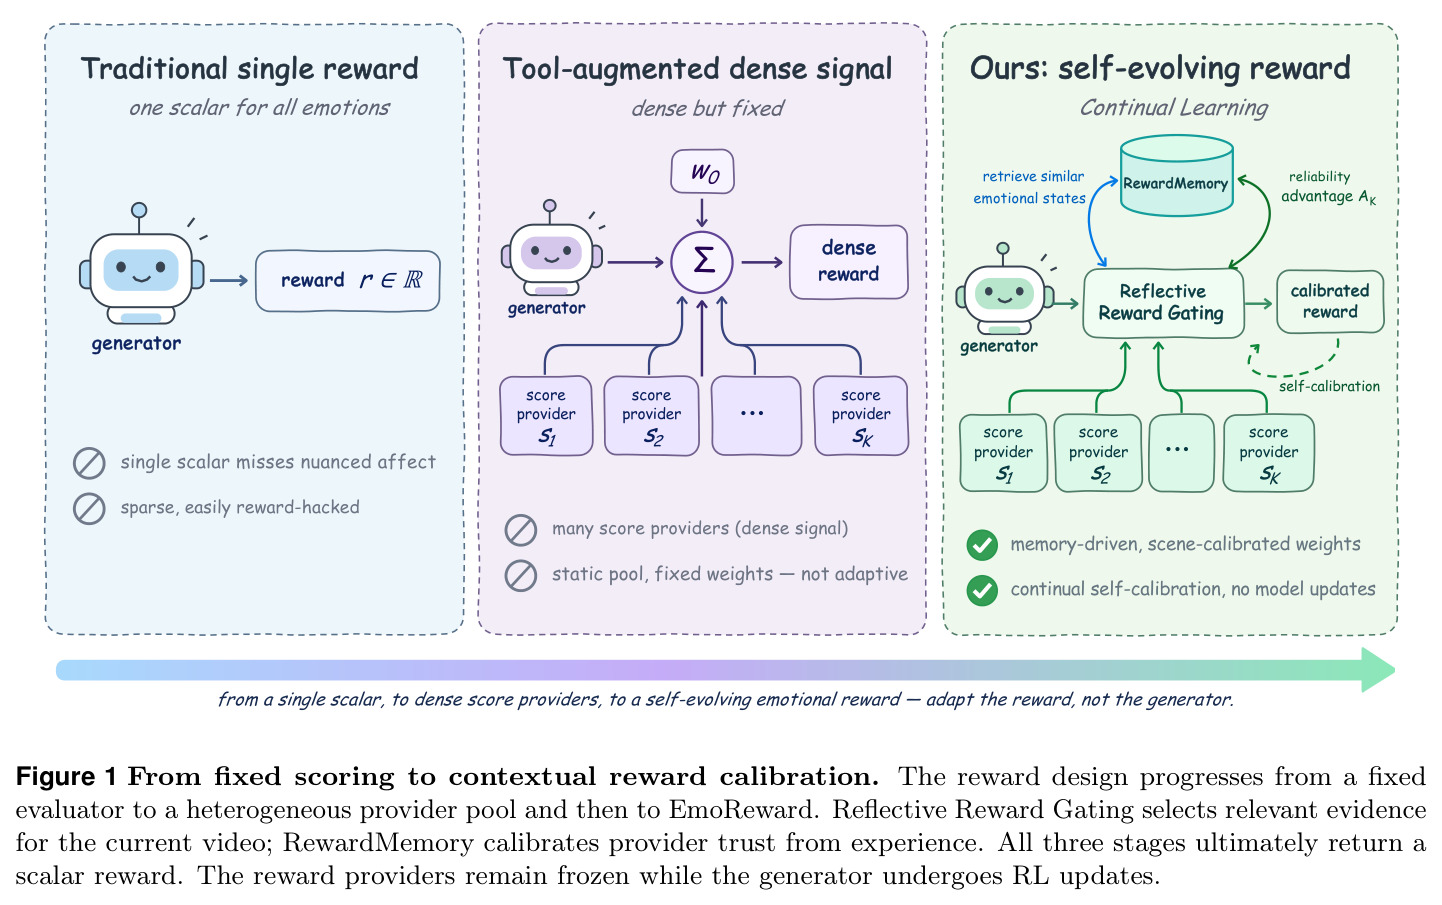
展示奖励设计的三阶段演进:传统单一标量奖励(对所有情感用一个标量,稀疏、易被 hack);工具增强的密集信号(多个 score provider 提供密集信号,但静态池、固定权重、不自适应);本文自进化奖励(RewardMemory 检索相似情感状态、从优势 $A_K$ 得到可靠性、记忆驱动且场景校准权重、持续自校准且无需模型更新)。三个阶段最终都返回标量奖励,奖励 provider 冻结而生成器做 RL 更新。
一图读懂论文定位:EmoReward 处于'固定评估器→异构 provider 池→自进化校准'演进谱系的最右端,核心口号是'适应奖励,而不是适应生成器',为全文动机提供直观框架。