多轮强化学习究竟提升了大模型智能体的什么能力 What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?
多轮智能体RL的收益依赖充分交互预算,优势源于纠错恢复与长程韧性而非单步决策质量
前置知识
多轮智能体强化学习(Agentic RL)
指让 LLM 智能体在环境中持续多轮交互(工具调用、代码执行、终端操作等)并用强化学习优化的训练范式。形式化地,在第 $t$ 步,智能体根据交互历史 $h_t$ 采样动作 $a_t \sim \pi(\cdot \mid h_t)$,环境返回观测 $o_{t+1} \sim P(\cdot \mid h_t, a_t)$;一条轨迹 $\tau_{\le T}$ 在最多 $T$ 轮内完成,由终局验证器给出奖励 $R(\tau_{\le T})$。常见算法包括只看最终结果的 GRPO,以及带步级信用分配的 GiGPO、训练 critic 的 PPO 等。
全文的问题都围绕'多轮 RL 相比基座模型到底改变了什么'展开,必须先理解这一训练设定与轨迹级稀疏奖励的结构,才能看懂各章节的实验设计。
Pass@K 与 Pass@(K,T)
Pass@K 衡量独立采样 $k$ 条解答后至少一条成功的概率,是探测模型'能力边界'的标准指标,对应测试时扩展的'采样广度'维度,常用无偏估计 $\widehat{\mathrm{Pass@}k} = 1 - \binom{n-c}{k}\big/\binom{n}{k}$。交互式智能体还多出一条正交维度:每条轨迹允许的最大交互轮数 $T$('交互深度')。二者合并为 $\mathrm{Pass@}(K,T) = \Pr\big[\exists\, i \in \{1,\dots,K\}: R(\tau_{\le T}^{(i)}) = 1\big]$。
Pass@(K,T) 是全文的核心度量工具,论文正是靠固定 $K$ 扫 $T$,才发现了'收益依赖交互预算'这一核心现象。
GRPO 与组相对优势
GRPO 是一种免价值网络的结果导向 RL 算法:对同一任务实例采样 $G$ 条轨迹(本文 $G=16$),用组内奖励归一化得到相对优势 $A_i = (R_i - \mathrm{mean}(R))\big/(\mathrm{std}(R)+\epsilon)$,据此更新策略并配合对参考策略的 KL 正则(系数 0.001)。它不需要训练 critic,是本文的主要基线算法,训练超参为学习率 $1\times 10^{-6}$、权重衰减 0.01。
论文主实验用 GRPO 训练 Qwen3-4B/8B,并在同一框架下对比 GiGPO、PPO 与 BudgetMix 变体,理解 GRPO 的组采样机制才能读懂实验设置与公平比较的含义。
过程监督与步级信用分配
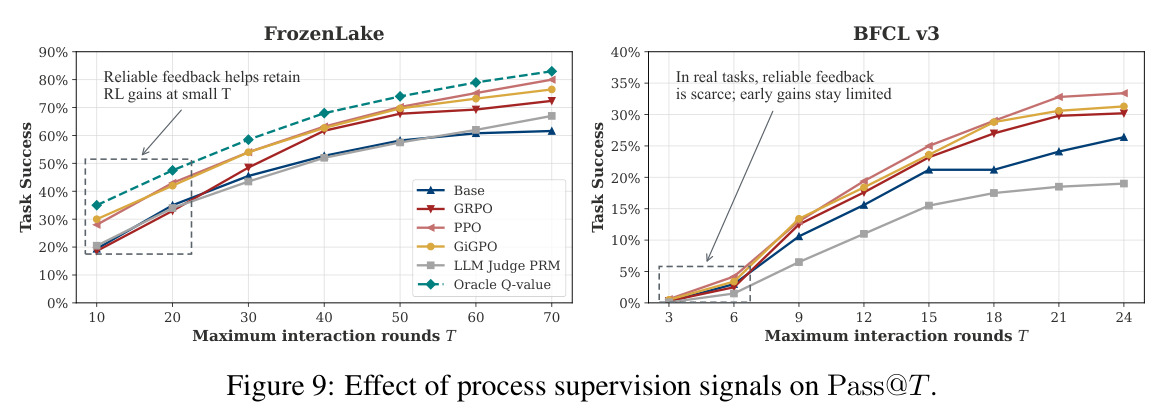
轨迹级稀疏奖励难以告诉模型'哪一步走错了'。过程监督提供步级信号:GiGPO 通过重复出现的锚定状态(anchor state)从结果奖励中推导步级优势 $A_{i,t} = A_i^E + \omega A_{i,t}^S$;PRM 类方法用奖励模型直接为每步打分。高质量过程信号(如 FrozenLake 中用 $\gamma=0.95$ 动态规划算出的 oracle $Q$ 值)能显著改善步级决策,但在真实任务中往往不可得。
论文第 5 节讨论的缓解方案(oracle Q 值、GiGPO、PPO、LLM judge)以及'步级质量退化'的诊断与修复,全部建立在这组概念之上。
交互预算(Interaction Budget)
指一条轨迹允许的最大交互轮数 $T$。它既是部署中的真实约束(API 成本、响应时限、不可逆操作前的步数上限),也是测试时扩展的一个独立维度。本文通过在系统提示中显式注入最大轮数 [MAX TURNS]、已完成轮数 [CURRENT TURN] 与剩余轮数 [REMAINING TURNS],把预算变成模型可见的条件变量。
'预算依赖性'是本文最核心的实证发现,而 BudgetMix 的全部设计就是把预算从评估维度转化为训练维度,理解该变量是读懂全文的钥匙。
研究动机
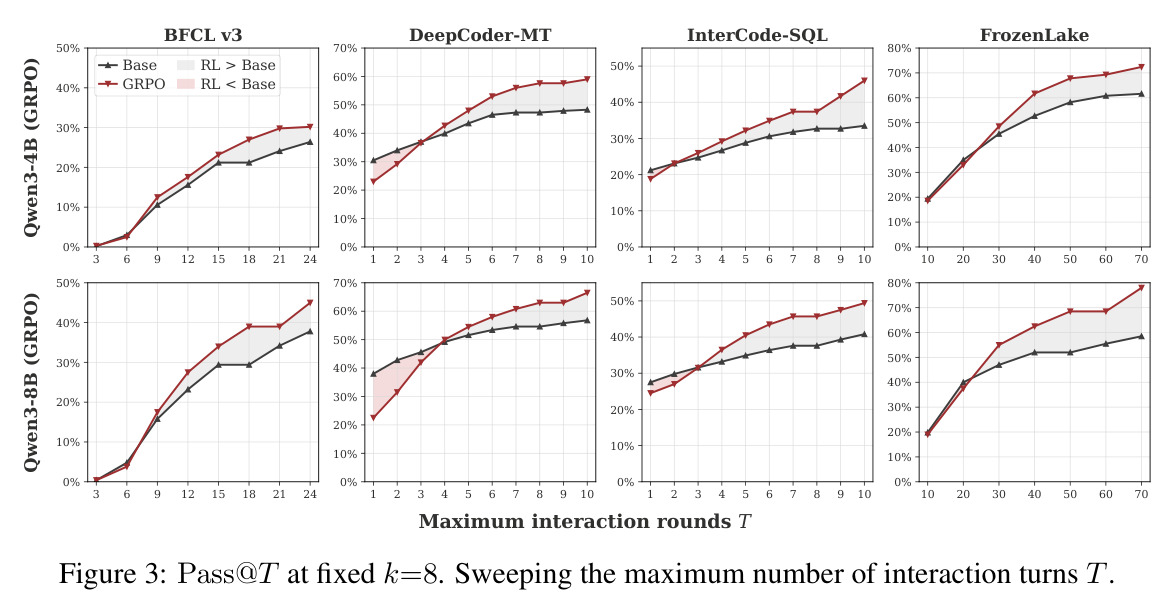
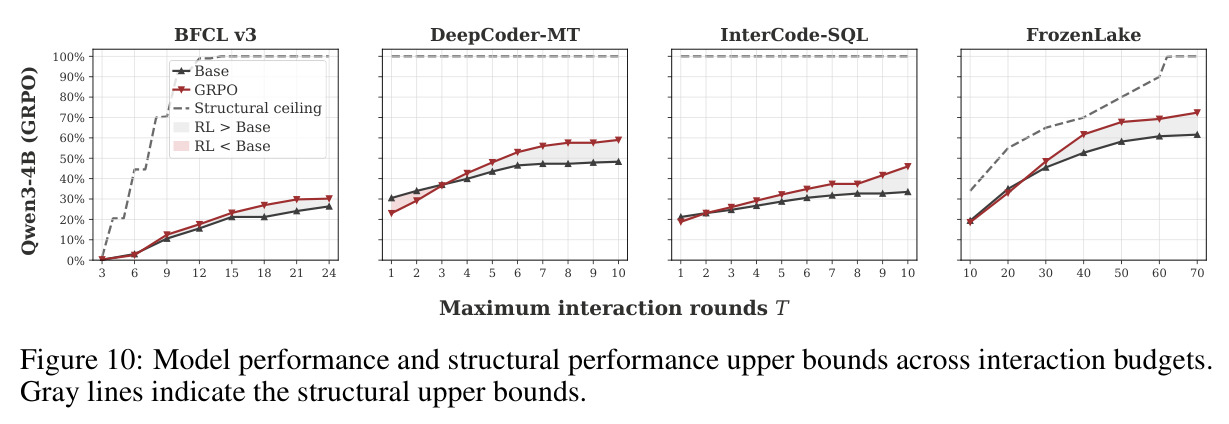
现有多轮智能体 RL 工作几乎只用轨迹级成功率汇报收益:任务在给定预算内完成即算成功。这种评估方式掩盖了两个问题。其一,单轮 RLVR 的已有研究表明 RL 未必扩展基座模型的能力边界(Pass@K 不提升),但多轮场景下 RL 是否扩展边界缺乏系统检验。其二,也是更关键的:真实部署中交互预算往往严格受限——金融交易、数据库操作等含不可逆动作的场景要求每一步都谨慎,API 成本也限制轮数;而现有评估通常在固定(往往充裕)的预算下进行,无法回答'当预算收紧时,RL 模型的优势还剩多少'。作者用 Qwen3-4B/8B 在 BFCL v3、DeepCoder-MT、InterCode-SQL、FrozenLake 四个基准上的实验揭示了风险:固定采样广度 $k=8$、扫描预算 $T$ 时,RL 相对基座的优势随 $T$ 增大而扩大,随 $T$ 收紧而缩小甚至反转为劣势——例如 Qwen3-4B 在 BFCL 25% 预算下 GRPO 只有 2.5%,低于基座的 3.0%;FrozenLake 25% 预算下 GRPO 28.7% 也低于基座 30.3%。
本文的目标是本文的目标不是再刷一个 SOTA,而是系统回答'多轮智能体 RL 到底改善了什么'。具体拆成四个可检验的子目标:(1)用二维指标 Pass@(K,T) 分别沿采样广度 $K$(扫到 128)与交互深度 $T$ 两个轴,刻画 RL 模型与基座模型能力边界的差异;(2)在匹配状态上直接比较单步动作质量,检验 RL 是否均匀提升了每一步的决策,还是只在特定状态(如错误之后)占优;(3)通过似然分析与训练动态分析,解释轨迹级收益的来源——为什么单步不更优的模型能赢得更长程的任务;(4)针对暴露出的'预算依赖'部署风险,讨论过程监督信号的收益与局限,并提出一个简单、可与现有算法组合的替代训练策略 BudgetMix RL,使其在 25%/50%/75%/100% 四档预算下都保持稳健性能,同时不牺牲满预算时的长程执行能力。
与已有工作不同的是,此前最相关的工作(Zhai et al., 2026)已提出 Pass@(K,T) 并证明智能体 RL 能超越基座能力边界,但止步于'能超越'这一正面结论。本文的独特切入在于把 $T$ 从固定的'评估配置'提升为被扫描的'诊断维度':通过固定 $K$ 扫 $T$,首次量化出 RL 收益对预算的系统性依赖,并用结构上界分析排除了'小预算下任务无解'的平凡解释。接着通过匹配状态上的步级动作质量比较(FrozenLake 用动态规划精确 $Q^*$ 值、DeepCoder-MT 用单元测试通过率作可靠步级度量),证明 RL 并不均匀提升单步质量,其优势集中在错误状态之后和轨迹后期。机制层面,用'单动作 NLL 重叠、轨迹级累积对数似然比分离'这一对互补证据,解释了'单步不更优、轨迹却更强'的表象矛盾;再诊断出训练全程 $R_{\mathrm{multi}}$ 上升伴随 $R_{\mathrm{single}}$ 退化的'步级质量侵蚀'现象后,又把 $T$ 反过来变成'训练维度'提出 BudgetMix。这条'评估 → 诊断 → 机制 → 干预'的完整链条是以往轨迹级评估工作所缺失的。
核心方法
直觉上,这篇论文像一位'体检医生'而非'药厂':先用更细的指标给多轮 RL 做全身检查,找到病灶,再开一个便宜的处方。技术路线分四步。第一步,二维评估:定义 $\mathrm{Pass@}(K,T) = \Pr[\exists i \le K: R(\tau_{\le T}^{(i)})=1]$,固定任务扫广度(Pass@K,$k$ 从 1 到 128)与固定 $k=8$ 扫深度(Pass@T),所有评估温度 0.6、top-p 0.9,并在提示中告知预算。第二步,步级诊断:从 base 与 RL 轨迹各取一半构建匹配状态池,每个状态从两个策略各采 $G=16$ 个动作并取平均质量,FrozenLake 用 $\gamma=0.95$ 的有限时域动态规划求精确 $Q^*$,DeepCoder-MT 用官方单元测试通过率。第三步,机制分析:比较两策略对同一动作的负对数似然 $\mathrm{ActionNLL}_B$ 与对完整轨迹的累积对数似然比 $\mathrm{LLR}_{1:t}(\tau) = \sum_{i=1}^{t}\big[\log \pi_{\mathrm{RL}}(r_i \mid h_i) - \log \pi_B(r_i \mid h_i)\big]$,并在训练全程追踪轨迹奖励 $R_{\mathrm{multi}}$ 与步级奖励 $R_{\mathrm{single}}$。第四步,干预:先测 oracle Q 值、GiGPO、PPO、LLM judge 等过程信号的缓解效果,再提出 BudgetMix RL——训练时按 10% 间隔均匀采样每个任务组的交互预算,其余与标准 RL 完全一致。
核心创新是两个'再定义'。第一,把 $T$ 从固定的评估配置变成被扫描的实验变量:由此首次量化出'RL 收益依赖充分交互预算'——预算充裕时 RL 大幅领先,预算收紧时优势缩小、消失甚至反转(且通过结构上界排除了平凡解释:小预算下距上界仍有大量空间,RL 却无优势)。第二,把 $T$ 从评估维度变成训练维度:标准多轮 RL 在固定 $T_{\max}$ 下训练,奖励完全不区分'用 3 轮完成'与'用 10 轮完成'两种解;BudgetMix 对任务 $x$ 构造候选预算集 $T(x) = \mathrm{Unique}\{\lfloor k \cdot 10\% \cdot T_{\max}(x) \rfloor : k = 1,\dots,10\}$,每个任务组均匀采样一个预算,把总预算与剩余预算写进提示词,超预算未完成记零奖励。这迫使同一个策略在'每步必须谨慎'(紧预算)与'可以长程试错'(宽预算)两种奖励条件之间共享权重,本质是把预算当作课程维度做多条件训练。它与已有方法的本质区别在于:不引入新的奖励模型或信用分配机制,与 GRPO/GiGPO/PPO 完全兼容,仅仅改变训练轨迹的预算分布,就同时修复了预算脆弱性与步级质量退化。
方法步骤详情
完整流程如下。(1)训练设置:以 Qwen3-4B/8B 为基座,在 VeRL 框架上分别用 GRPO、GiGPO($\omega=1$,$\gamma=0.95$)、PPO(critic 学习率 $10^{-5}$,clip 0.2,价值 clip 0.5)训练,学习率 $10^{-6}$、温度 1.0、每组 $G=16$ 条轨迹;任务覆盖 FrozenLake($T_{\max}=70$)、DeepCoder-MT(10)、BFCL v3(24)、InterCode-SQL(10),训练数据分别来自自生成地图、DeepCoder 题目、EnvFactory 环境与 Spider 训练集。(2)评估协议:温度 0.6、top-p 0.9,系统提示(Table 2)显式给出最大/已完成/剩余轮数;Pass@K 用无偏估计扫到 $k=128$,Pass@T 固定 $k=8$ 扫 $T$,并计算结构上界(FrozenLake 最短路径、BFCL 官方标注轨迹)以排除小预算无解情形。(3)步级质量比较:构建 base/RL 各半的匹配状态池(512 个验证状态),每状态从两策略各采 16 个动作取平均;错误状态池通过注入错误动作构造——FrozenLake 执行使最短路径距离变大的动作,DeepCoder-MT 用 Qwen3-1.7B 改坏代码使单元测试通过数下降。(4)BudgetMix 训练(Algorithm 1):每组按式 (2) 均匀采样预算 $B$ 并写入预算感知提示,组内轨迹共享同一预算;GRPO 照常算组相对优势,GiGPO 的锚定状态扩展为 $(s_t, B-t)$,PPO 的 actor 与 critic 同预算条件化,超时轨迹奖励为零。(5)验证:在 25%/50%/75%/100% 四档预算上评 Pass@8,并对比训练动态中 $R_{\mathrm{multi}}$ 与 $R_{\mathrm{single}}$ 的走向。
技术新颖性
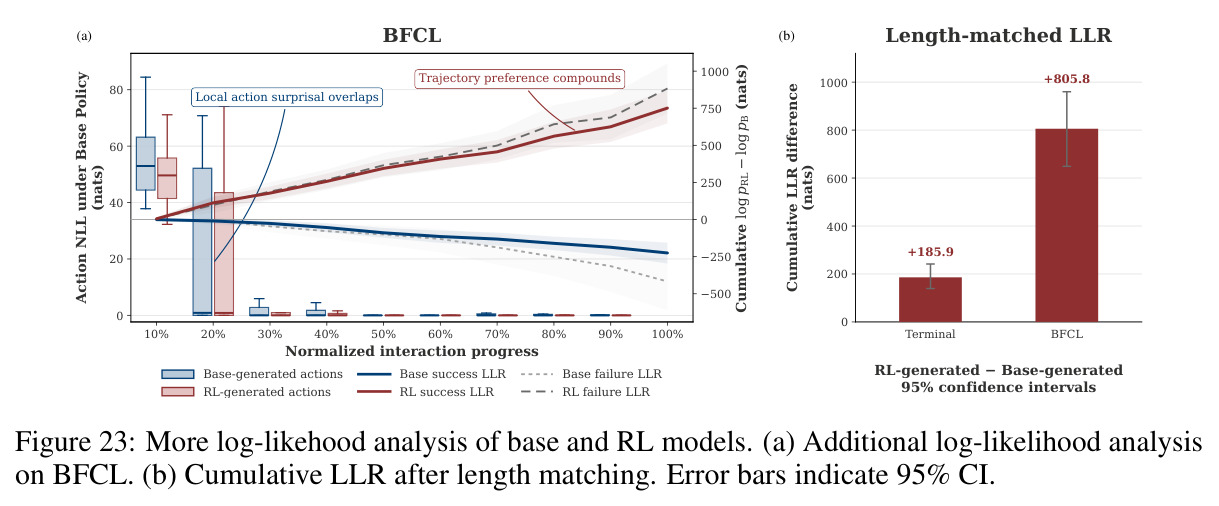
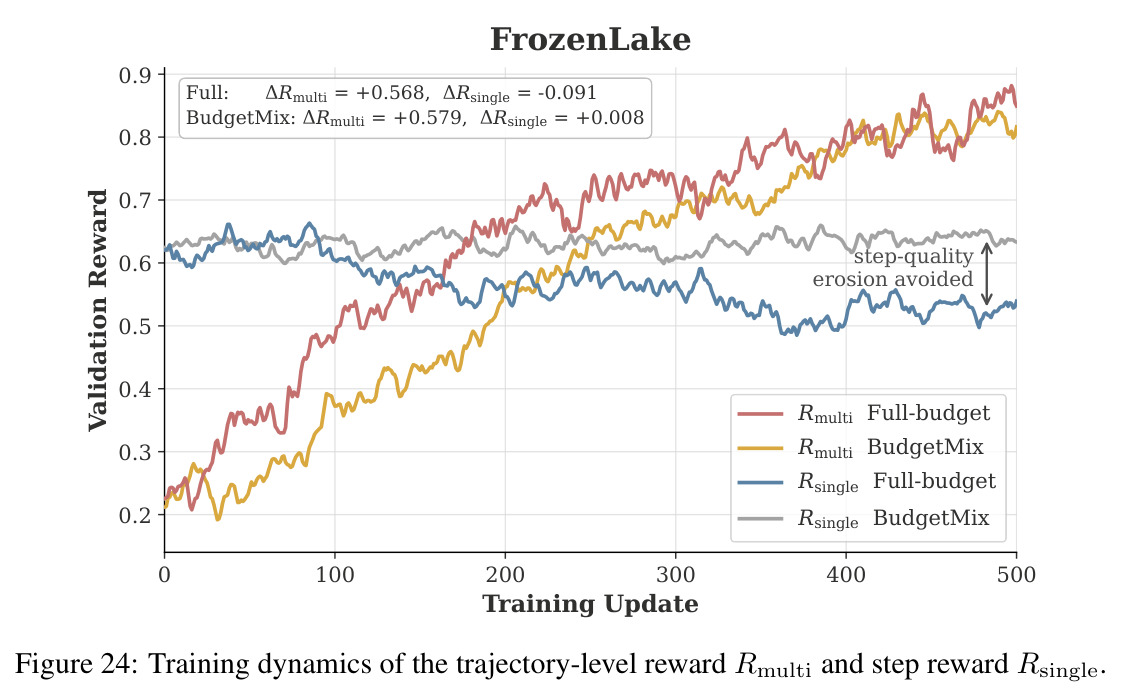
新颖性有四点。一是评估学贡献:Pass@(K,T) 虽非本文首创,但'固定 K 扫 T'并配合结构上界排除平凡解释的严谨做法,以及'在匹配状态上用精确 $Q^*$ 值逐点对比训练前后策略单步决策'的实验范式是新的。二是机制发现:用'单动作 NLL 重叠 + 轨迹 LLR 分离'这对互补量说明,RL 改变的是把局部合理动作可靠地组合成长轨迹的能力,而非单步分布的大幅偏移——RL 动作在基座策略下平均 NLL 为 10.25,与基座自身动作的 12.20 大幅重叠;但成功 RL 轨迹的累积 LLR 升至约 228 nats,成功基座轨迹仅 26 nats。三是训练动态诊断:首次展示 $R_{\mathrm{multi}}$ 上升伴随 $R_{\mathrm{single}}$ 下降(DeepCoder-MT 上 +0.331 对 −0.097,FrozenLake 上 +0.568 对 −0.091)这一'步级质量侵蚀'随训练渐进出现的现象。四是干预的极简主义:BudgetMix 不新增模型、奖励项或损失函数,只改预算采样分布,即可同时修复预算脆弱性与步级退化;这种'改数据分布而非改算法'的思路,与 SPA-RL、ARPO、GiGPO 等复杂的信用分配方法形成鲜明对比,也与把预算视为测试时维度的先前工作(如 Tmax)视角互补。
实验结果
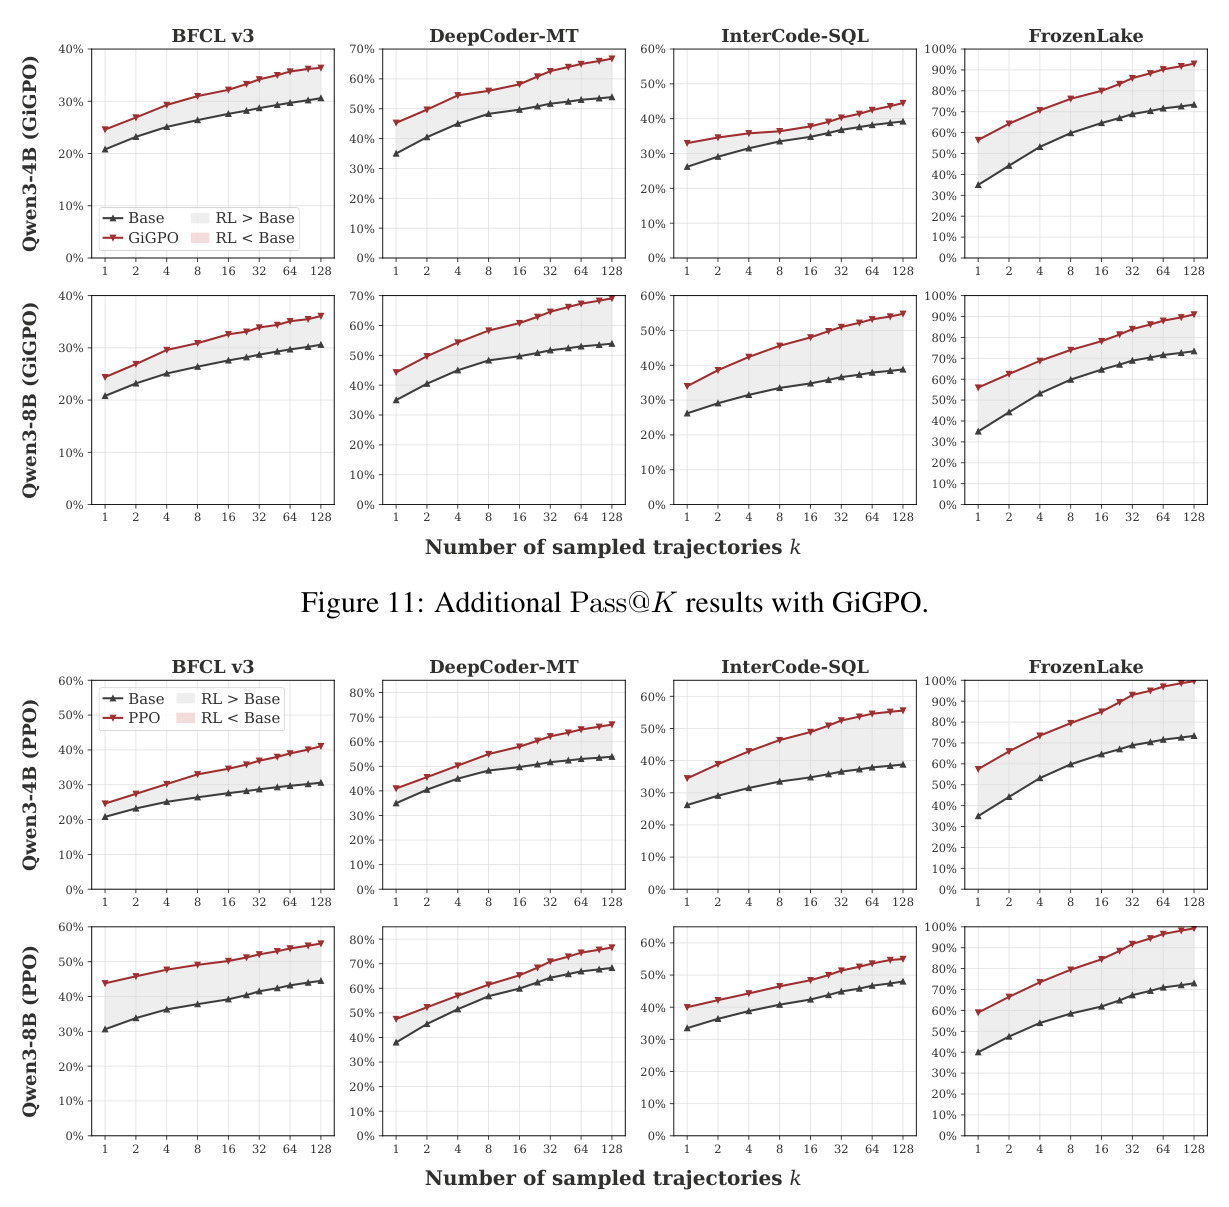
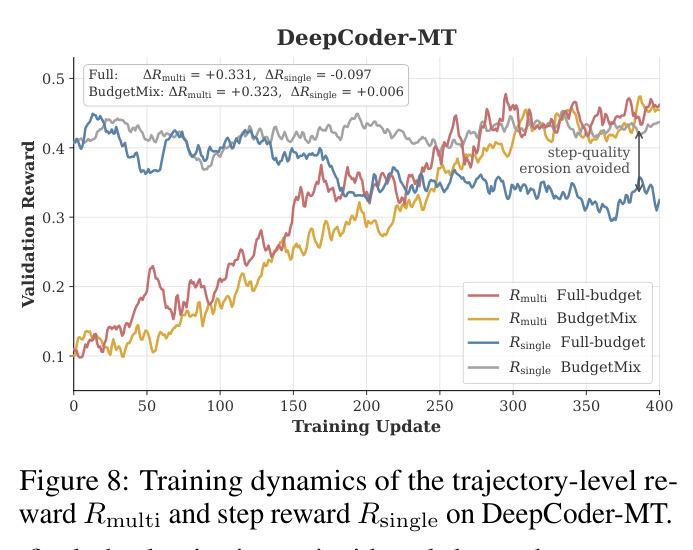
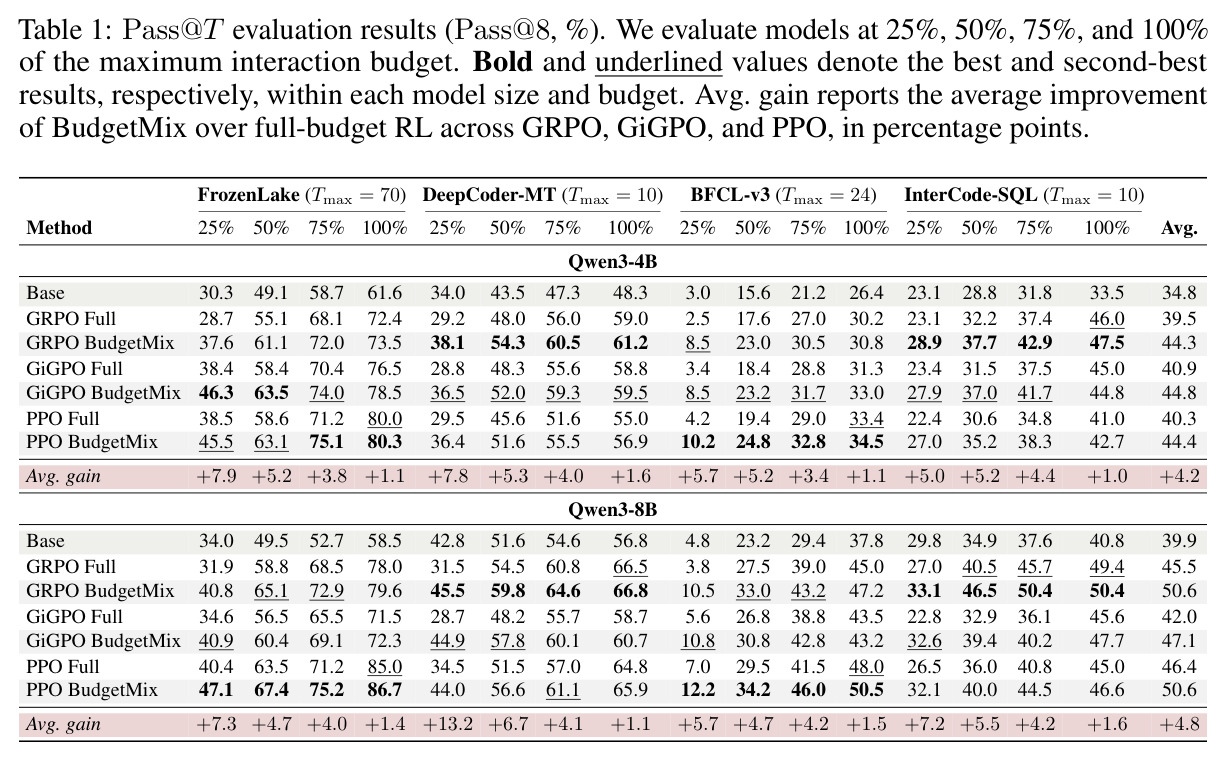
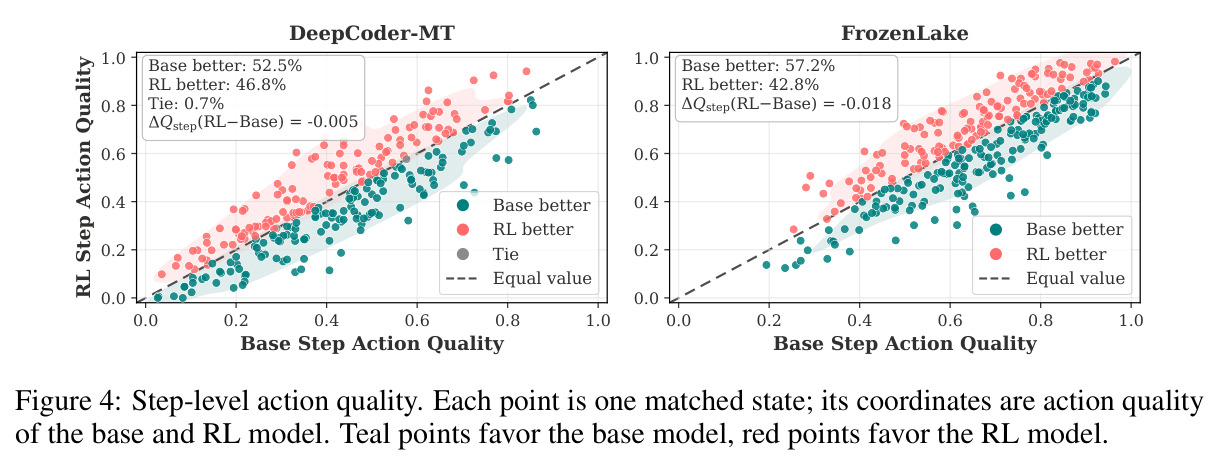
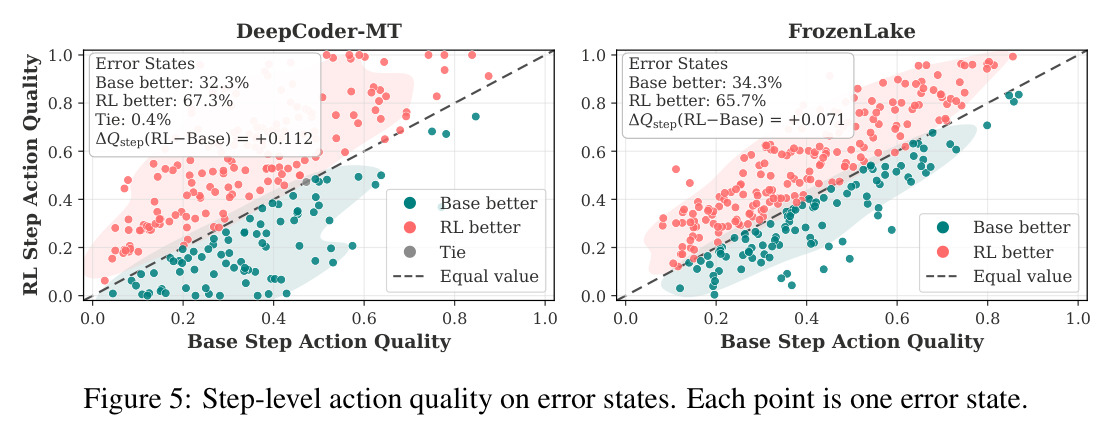
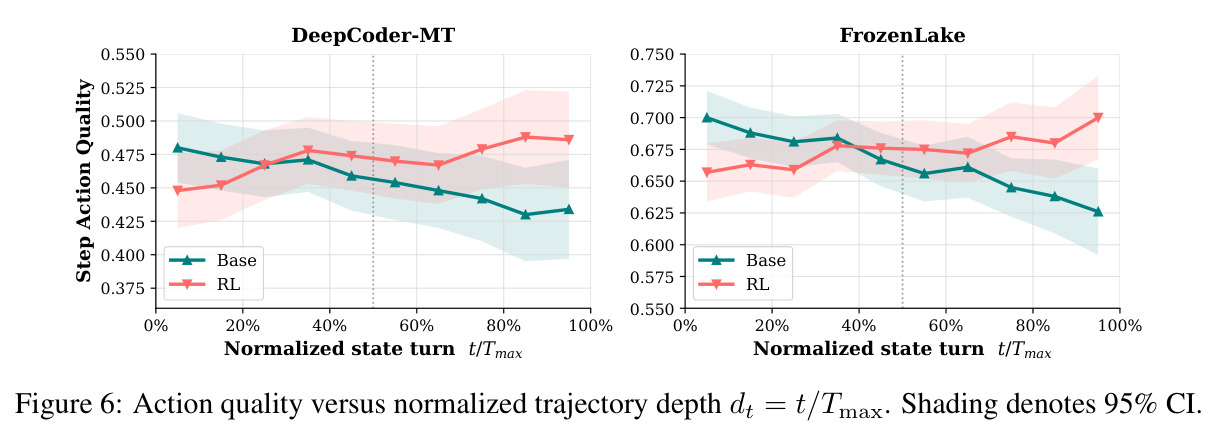
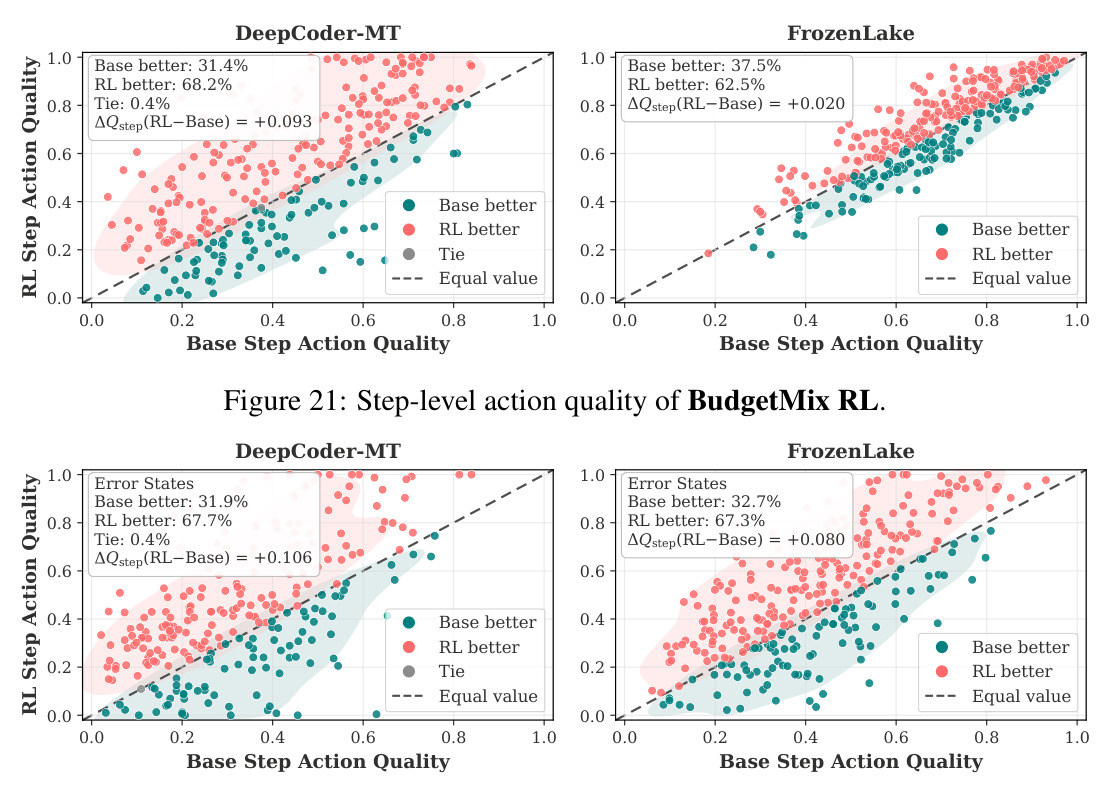
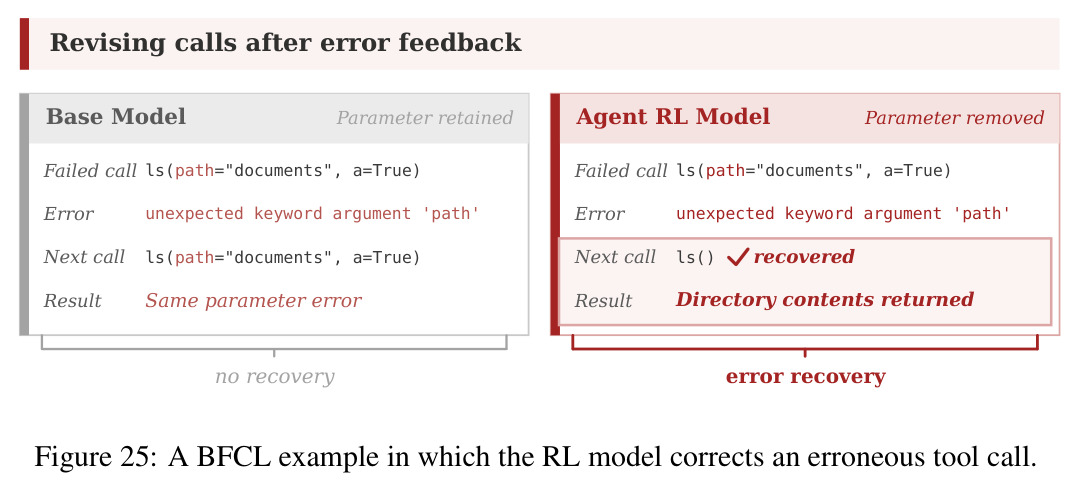
论文的实证发现可按实验逐一梳理。(1)Pass@K(Figure 2 及附录 11–14):在四个基准加 Terminal-Bench 上,GRPO/GiGPO/PPO 训练的模型在 $k$ 从 1 扫到 128 时始终优于基座,且在 InternVL3.5-8B、DeepSeek-R1-Distill-Llama-8B 上同样成立——多轮智能体 RL 确实扩展了基座的经验能力边界,与单轮 RLVR 的既有观察形成对照。(2)Pass@T(Figure 3 及附录 15–18):固定 $k=8$ 后 RL 优势随 $T$ 增大而扩大、随 $T$ 收紧而缩小甚至反转:Qwen3-4B 在 BFCL 25% 预算下 GRPO 2.5% 低于基座 3.0%,FrozenLake 25% 预算下 GRPO 28.7% 低于基座 30.3%;Figure 10 的结构上界显示此时仍有大量空间,排除了任务无解的平凡解释。(3)步级质量(Figure 4):匹配状态上 RL 仅在 DeepCoder-MT 46.8%、FrozenLake 42.8% 的状态上更优,平均质量差 $Q_{\mathrm{step}}(\mathrm{RL}-\mathrm{Base})$ 分别为 −0.005 与 −0.018,即 RL 并不均匀提升单步决策、甚至轻微变差。(4)错误状态(Figure 5):注入错误后模式完全反转,RL 在 FrozenLake 65.7%、DeepCoder-MT 67.3% 的错误状态上选到更优动作($Q_{\mathrm{step}}$ 为 +0.071 与 +0.112);从相同错误状态续跑的终端成功率 FrozenLake 51.3% 对基座 38.6%,DeepCoder-MT 38.5% 对 22.9%;BFCL 错误工具调用纠正率 41.4% 对 27.2%(Figure 25)。(5)轨迹深度(Figure 6):RL 优势在轨迹早期不明显甚至为负,随归一化深度 $d_t = t/T_{\max}$ 增大逐渐反超。(6)似然分析(Figure 7、23):RL 动作在基座策略下的平均 NLL 10.25 与基座自身动作 12.20 大幅重叠,说明单步动作仍被基座分布支持;但成功 RL 轨迹的累积 LLR 随交互推进升至约 228 nats(成功基座轨迹仅 26),长度匹配后 Terminal/BFCL 的差值仍为 +185.9/+805.8 nats 且 95% 置信区间为正。(7)训练动态(Figure 8、24):DeepCoder-MT 上全程预算训练 $R_{\mathrm{multi}}$ 升 +0.331 而 $R_{\mathrm{single}}$ 降 −0.097,FrozenLake 上 +0.568 对 −0.091,步级侵蚀是渐进出现的系统现象。(8)过程监督(Figure 9):FrozenLake 上 oracle Q 值与 GiGPO 能在小预算下稳住收益,但 BFCL 上无 oracle,GiGPO/PPO 与 GRPO 相近,GPT-5.6-Sol 作 judge 也难提供可靠过程信号。(9)BudgetMix(Table 1):四档预算全面稳健,对全程预算 RL 的平均增益为 25% 预算 +7.5pt、50% +5.3pt、75% +4.0pt、100% +1.1pt;Qwen3-8B 在 DeepCoder-MT 25% 预算增益高达 +13.2pt;100% 预算下与 Full 持平甚至略优(如 PPO FrozenLake 86.7% 对 85.0%),且步级奖励不再退化(BudgetMix +0.006 对 Full −0.097)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四基准 Pass@T 平均(Qwen3-4B/8B × GRPO/GiGPO/PPO) | Pass@8 平均增益(百分点) | BudgetMix RL:25% 预算 +7.5、50% +5.3、75% +4.0、100% +1.1 | Full-budget RL(固定满预算训练) | 整体平均 +4.2(4B)/+4.8(8B)pt;单点最大 +13.2pt(8B DeepCoder-MT 25% 预算) |
| BFCL v3(Qwen3-4B,GRPO,25% 预算) | Pass@8 (%) | BudgetMix 8.5 | GRPO Full 2.5(低于 Base 3.0,出现反转) | +6.0pt,扭转紧预算下劣于基座的反转现象 |
| FrozenLake(Qwen3-4B,GRPO,25% 预算) | Pass@8 (%) | BudgetMix 37.6 | GRPO Full 28.7(Base 30.3) | +8.9pt(相对 Full),且高于基座 +7.3pt |
| 错误状态续跑(FrozenLake / DeepCoder-MT) | 终端成功率 (%) | RL 51.3 / 38.5 | Base 38.6 / 22.9 | +12.7pt / +15.6pt,证明纠错恢复是 RL 收益的主要来源 |
| BFCL 错误工具调用纠正(191 个含错前缀) | 纠正率 (%) | RL 41.4 | Base 27.2 | +14.2pt |
| 能力边界扩展(Pass@K,k 扫至 128,4 基准 + Terminal-Bench) | Pass@K 曲线 | RL 在全部 k 上高于基座(跨 GRPO/GiGPO/PPO 与 Qwen3、InternVL3.5、R1-Distill-Llama 多架构) | 基座模型 | 多轮 RL 扩展经验能力边界(与单轮 RLVR 不扩展的结论形成对照) |
| 训练动态步级质量(DeepCoder-MT,400 步更新) | 步级验证奖励 $R_{\mathrm{single}}$ 变化量 | BudgetMix +0.006 | Full-budget −0.097 | 消除步级质量侵蚀(两者轨迹奖励相当:+0.323 对 +0.331) |
局限与改进
作者承认的局限:(1)过程监督的缓解方案依赖可靠步级信号,而这类信号在真实任务(BFCL)中不可得,强模型 judge(GPT-5.6-Sol)也难以稳定提供高质量过程奖励,因此第 5 节只能算'初步讨论';(2)BudgetMix 在 100% 预算下只是持平略升而非大幅超越,对满预算场景收益有限;(3)错误状态的构造是代理性的——随机注入使最短路径变长的动作、用 1.7B 小模型改坏代码——并非严格的错误定义。我自己的观察:(1)BudgetMix 主表只覆盖四个较结构化的任务,最现实的 Terminal-Bench 仅有 Pass@K/Pass@T 曲线而无 BudgetMix 结果,干预方案在最真实环境上的效果未验证;(2)步级质量评估只在两个有可靠步级度量的任务上进行,'单步变差'能否推广到网页、GUI 等开放任务存疑;(3)BudgetMix 与全部评估都依赖提示中的显式预算信息,若部署时不提供预算或预算软约束,收益可能打折,论文也未测试训练与部署预算分布不匹配的情形;(4)LLR 机制分析属相关性证据,'更可靠地组合局部合理动作'的解释仍是猜想,缺少干预性实验(如在 RL 轨迹中点截断让基座续写);(5)结论基于 ≤8B 模型与每组 16 条轨迹的设置,更大规模上是否复现未知。
独立分析的弱点
弱点一:预算感知提示是双刃剑。BudgetMix 与所有评估都依赖在提示中注入 [MAX TURNS]/[CURRENT TURN]/[REMAINING TURNS],这要求部署环境能精确给出预算;面对软约束(成本随负载波动)或用户不声明预算的场景,模型可能无法泛化。改进方向:训练时随机扰动预算信息的呈现(有时不给、给近似值),或训练模型隐式自行计数以增强鲁棒性。弱点二:步级质量退化的机制未完全定位。论文观察到 $R_{\mathrm{single}}$ 下降,但未回答'退化发生在哪些 token/哪类动作'——是推理链变长挤占行动质量,还是策略对探索性动作过度自信。改进方向:结合熵动态与高熵 token 分析定位退化子集,再做针对性正则或数据加权。弱点三:均匀预算采样未必最优。10% 间隔均匀采样是对预算分布的任意选择,而任务难度与所需预算强相关,均匀采样会把 rollout 浪费在过紧(结构上不可解)或过松(组内无梯度差异)的预算上。改进方向:用结构上界过滤不可行预算后自适应采样,或采用从宽到紧的课程式退火。弱点四:核心洞见缺少标准化指标。错误恢复、长程韧性这些被识别出的能力没有进入标准 leaderboard 的量化指标,导致结论难以被后续工作直接比较。改进方向:把'错误状态续跑成功率'与 budget-robustness 曲线下面积做成开源评估套件。弱点五:规模与任务谱系有限,所有结论来自 ≤8B 模型与结构化环境,大模型与开放环境上的外推需要验证。
未来方向
作者方向:(1)研究如何在不依赖 oracle 的条件下合成或学习可靠的过程信号,使 GiGPO 类方法在 BFCL 等真实任务中也能缓解预算依赖;(2)把 BudgetMix 推广为更一般的'执行条件课程'——混合预算、工具可用性、观测噪声等多种执行条件进行训练;(3)在金融、数据库等含不可逆操作的场景中验证 BudgetMix 带来的步级谨慎性。基于本文成果可延伸的:(1)机制验证实验——用轨迹拼接、策略插值、activation patching 等手段检验'更可靠地组合局部合理动作'假说,并定位轨迹级 LLR 增长来自哪些 token;(2)把 Pass@(K,T) 与步级质量诊断整合为标准评估协议,要求智能体论文报告 budget-robustness 曲线;(3)预算课程与自适应 BudgetMix——按任务结构上界动态调整候选预算集,或与早停、self-consistency 等测试时策略联合优化成本-成功率 Pareto 前沿;(4)跨规模与跨环境复检'步级质量侵蚀'是否随模型规模、环境开放度变化;(5)BudgetMix 产生的锚定状态天然带 $(s_t, B-t)$ 条件,可用来训练预算感知的过程奖励模型,反向为紧预算部署提供步级监控。
复现评估
复现条件较好。论文给出项目主页 rethinking-agentic-rl.github.io,实现基于开源 VeRL 框架;附录 A 提供完整超参(学习率 $10^{-6}$、权重衰减 0.01、KL 系数 0.001、组大小 $G=16$;PPO critic 学习率 $10^{-5}$、clip 0.2、价值 clip 0.5;GiGPO $\omega=1$、$\gamma=0.95$),附录 B 提供评估协议(温度 0.6、top-p 0.9、Table 2 预算提示模板、Pass@K 无偏估计公式)与结构上界算法(FrozenLake 最短路径、BFCL 官方标注),附录 A.4 给出 BudgetMix 伪代码 Algorithm 1。任务环境全部基于开源基准:BFCL/EnvFactory、DeepCoder、InterCode-SQL/Spider、FrozenLake、Terminal-Bench/Tmax,其中 FrozenLake 训练/测试地图为自生成但保证 split 不相交,需要复刻生成逻辑。算力方面,4B/8B 模型加 GRPO/GiGPO 免 critic,单节点多卡(约 8×A100 级别)即可在数百步更新内复现主表量级;PPO 需额外 critic,开销略高。步级质量分析(DP 求 $Q^*$、单元测试打分、每状态 16 动作、512 状态验证池)计算量中等但逻辑简单。总体难度中等偏低:有 VeRL 经验的团队约 1–2 周可复现主结果;论文未明确说明是否发布训练脚本与 checkpoint,若未发布,环境搭建与数据构造将是主要成本。
论文图表
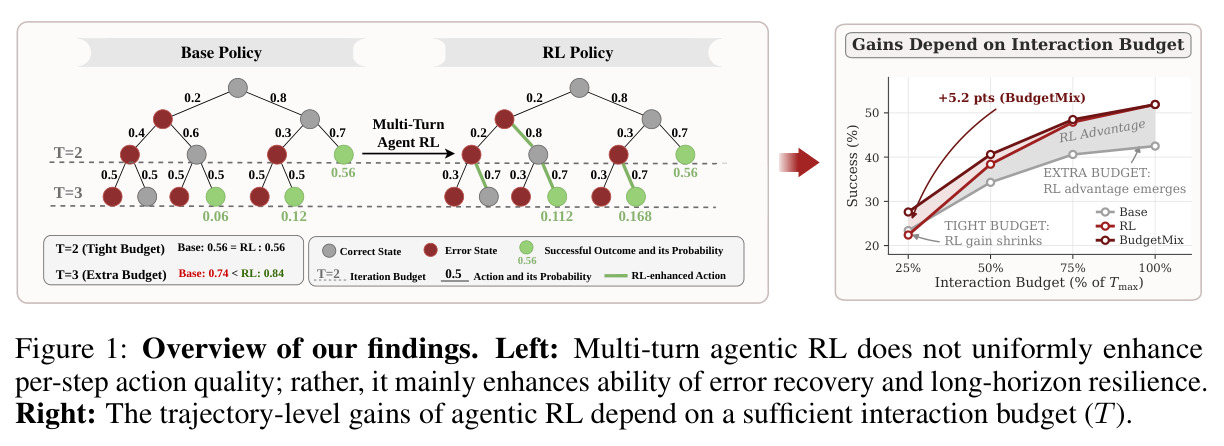
左图用状态转移示意图对比 Base 与 RL 策略:RL 并不均匀提升每步动作质量(紧预算 T=2 时两者成功率同为 0.56),而主要增强错误后的恢复能力,使轨迹级收益在预算充裕时显现(T=3 时 Base 0.74 < RL 0.84);右图展示 RL 相对基座的成功率先随预算收紧而消失、随预算放宽而涌现,BudgetMix 在各预算档位带来约 +5.2pt 提升。
一页概括全文两大核心发现——'收益依赖交互预算'与'优势源于纠错恢复而非单步质量',是理解论文整体叙事的地图。
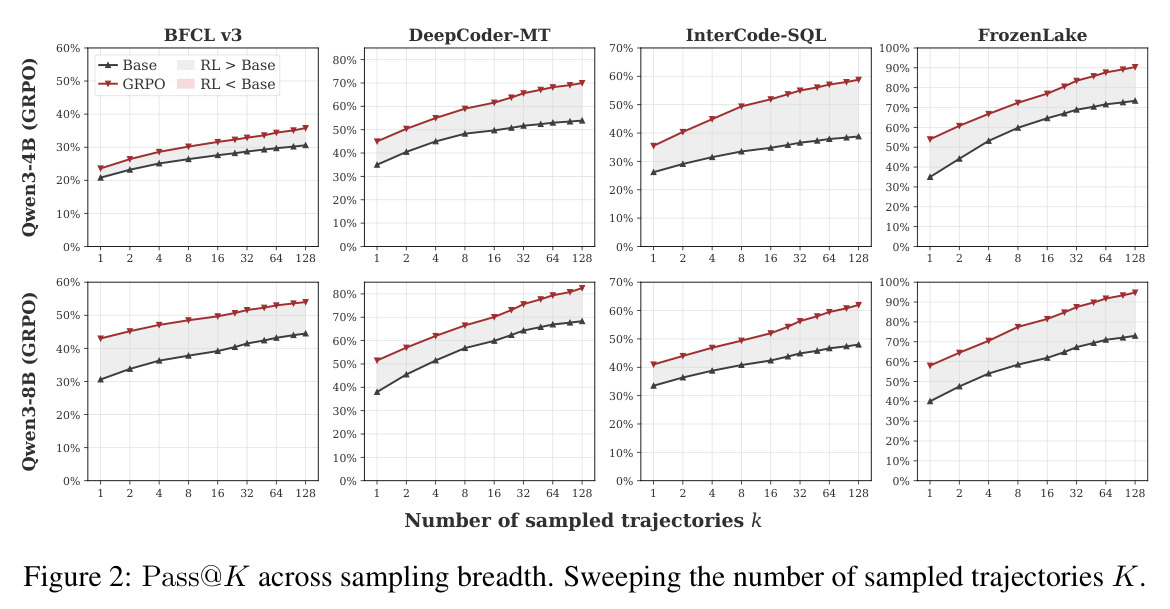
在 BFCL v3、DeepCoder-MT、InterCode-SQL、FrozenLake 四个基准上,对 Qwen3-4B 与 Qwen3-8B(GRPO 训练),把采样轨迹数 k 从 1 扫到 128 绘制 Pass@K 曲线;RL 模型的曲线在所有 k 上都高于基座模型。
证明多轮智能体 RL 能扩展基座模型的经验能力边界,这是与单轮 RLVR 关键结论的对照点,也是后文沿预算维度分析的前提。
给出训练与评估共用的系统提示模板:声明智能体在有限交互预算下工作,显式注入环境名、最大轮数 [MAX TURNS]、已完成轮数 [CURRENT TURN]、剩余轮数 [REMAINING TURNS],以及任务特定指令与动作格式约束。
预算条件化是 BudgetMix 与全部评估协议的关键实现细节——所有 Pass@T 数字都建立在该模板之上,没有它无法复现论文结果。