结果奖励强化学习究竟买到了什么:完成、可靠,而很少拓展 What Outcome RL Buys: Finishing, Reliability, Rarely Reach
Outcome RL的pass@1提升主要来自按时答完与更可靠,很少带来新解题能力
前置知识
pass@k 与 pass@1
对每道题让模型独立采样 $k$ 次,pass@k 是至少一次答案正确的题目占比,pass@1 即单次采样准确率。采样次数越多,模型「偶尔能解」的难题越可能被命中,因此 pass@k 随 $k$ 单调上升,反映可采样覆盖面;pass@1 则反映单次生成的可靠度。二者可以反向运动。
本文的全部问题就是「pass@1 的提升从何而来」,而其背景结论(Yue et al. 2025)是 outcome RL 抬高 pass@1 却在大 $k$ 下让 pass@k 低于基座——解的题几乎是基座解的子集。不理解这两个指标的对立,就无法理解本文动机与 reach 的定义。
Outcome RL / RLVR(结果奖励强化学习)
只用最终答案的对错(0/1 结果奖励,经符号等价或答案匹配器判定)训练语言模型推理,典型算法是 GRPO/GSPO 这类组相对优势方法:对同一题采样一组回答,用组内相对奖励算优势再做策略梯度。DeepSeek-R1 及几乎所有开源 RL recipe 均属此类。
本文研究的正是 20 个已发布的 outcome-RL 模型;理解「未完成的推导记零分、组相对优势最先分辨完成与否」这一点,是理解紧预算下 finishing 为何主导增益的机制基础。
Token budget(生成长度上限)
推理模型会生成数百到数万 token 的思维链,评测时在固定 token 预算 $B$ 处截断;凡未在预算内给出最终答案的推导记为未完成、得零分。同一模型在更松预算下准确率更高,所以任何一个 pass@1 数字都隐含了预算条件。
本文的核心分解就是把预算效应显式拆出来:finishing 完全由「预算内是否答完」定义,且每个 recipe 也在某个长度 cap 下训练。忽略预算会让「写得更短」被误读成「推理更强」。
Sharpening(锐化)
Huang et al. (2024) 等提出的机制:RL 不是扩展模型能力,而是把输出分布收窄到基座本就赋予较高概率的少数正确样本上,于是 pass@1 上升、大 $k$ 下 pass@k 下降。后续工作把覆盖损失归因于困难题的罕见成功在小组采样中丢失,以及对基座已有倾向的赢者通吃式强化。
锐化正是本文要定量检验的假设:如果 RL 只是锐化,增益应分解为「完成 + 可靠」两项行为改变而 reach ≈ 0。本文正是按这一预测设计分解并做预注册检验的。
预注册预测(registered prediction)
在生成任何实验输出之前,先把可证伪的预测(方向、区间)公开固定下来,之后再用数据检验,避免事后挑选结论(p-hacking)。本文对后补的十个模型对在生成前注册了 H1/H2 等预测,并如实报告其中 H2 在物理单域上失败。
评估这篇论文的可信度离不开这一点:它的多数结论有预注册保护,但个别普适性声明(匹配增益 < 0.03)被自己的注册检验证伪,读者应据此校准信任程度。
研究动机
Outcome RL 已成为训练推理模型的标准配方,其增益几乎都以 pass@1 报告。但 Yue et al. (2025) 发现一个尴尬事实:RL 模型的 pass@1 更高,当 $k$ 达到数百时 pass@k 反而低于它训练前的思维基座——在 AIME24 与 MATH-500 上,$k$ 到 1024 时 RL 独解的题目只占 0–1%,所谓增益似乎只是行为收窄。问题在于每个 pass@1 都是在某个固定 token 预算下测得的:一个数字同时混着「预算内答完」「答完且答对」「解出基座不会的新题」三件事,而每个 recipe 也在某个长度 cap 下训练。已有工作证明预算不匹配和长度膨胀会虚增报告增益(Wu et al. 2025a),却从没有人在固定预算下把增益拆开——因此社区无法回答:RL 到底让模型更强了,还是只是让它更会在预算内交卷。
本文的目标是本文要给「RL 的 pass@1 增益里有多少是行为改变、有多少是新知识」一个可精确记账的答案。目标分两层。第一层(主研究):构造一个预算感知的分解,把任意 RL 模型相对其思维基座的 pass@1 变化无损拆成 finishing(预算内完成)、reliability(完成后答对)、reach(解出基座 8 样本全错的题,扣除镜像)三项,并在 20 个已发布 recipe(1.5B–32B)上、物理与竞赛数学两个域、4k–64k 多个预算处量化三者占比。第二层(受控探针):观察只能说明「几乎不拓展」,于是用干预检验反面——主动把基座缺失的物理建模知识(setup)用五种通道喂给一个 8B 模型做 RL,看知识能否被安装并迁移到留出题,为「锐化能否被知识供给补救」给出因果证据。
与已有工作不同的是,已有证据全是观察性的,且各管一段:Yue et al. (2025) 用大 $k$ 的 pass@k 交叉证明 RL 解的题是基座子集,但没法在 $k=1$ 的部署场景下量化;Qin et al. (2025) 提出「固定覆盖内的执行增益」却没有剔除完成效应;Wu et al. (2025a) 只做预算修正,指出报告数字被长度差异污染。本文的独特切入是把这三种观察合成一个精确的会计恒等式 $\Delta\text{pass}@1(B) = F + P + \text{reach}@8(B)$:三项互斥、可加、无残差,并首次在每个 recipe 自己的训练 cap 处读数(避免「训练得久在低预算下被冤枉」)。更进一步,此前没有任何工作真正供给缺失内容做干预实验——本文是第一个,用五种通道把 setup 喂给模型,把「RL 能否学会被教的知识」变成可检验命题。
核心方法
直觉上,一个 pass@1 增益可能来自三种完全不同的机制:模型更快收尾(少犹豫、少回溯)、收尾后更常答对(把基座已会写的步骤执行得更稳)、或真的解出了以前不会的题(新知识)。技术路线分三步。第一步是分解:利用恒等式 $\text{pass}@k(B) = \text{fin}@k(B) \times \text{pass}@k(B\,|\,\text{fin})$,把变化拆成 finishing 项 $F$ 与 reliability 项 $P$;reach 用「基座 8 样本全部完成且全错的题」定义并扣除镜像,三项之和精确等于总变化。第二步是大规模读数:20 对「RL 模型 vs 基座」在物理(300 题过滤集 + 671 题未过滤校验集)与数学(MATH-500 + 276 道新竞赛题)上、于 4k/8k/16k、各自训练 cap 及其上一档预算(至 64k)各采 8 样本($T=0.6$)。第三步是受控探针:Qwen3-VL-8B-Thinking 用 GSPO 在 12k cap、60 步内做 RL,用五种通道供给题目所需的物理 setup,与两个对照种子在 87 题留出集上做配对 bootstrap 比较。
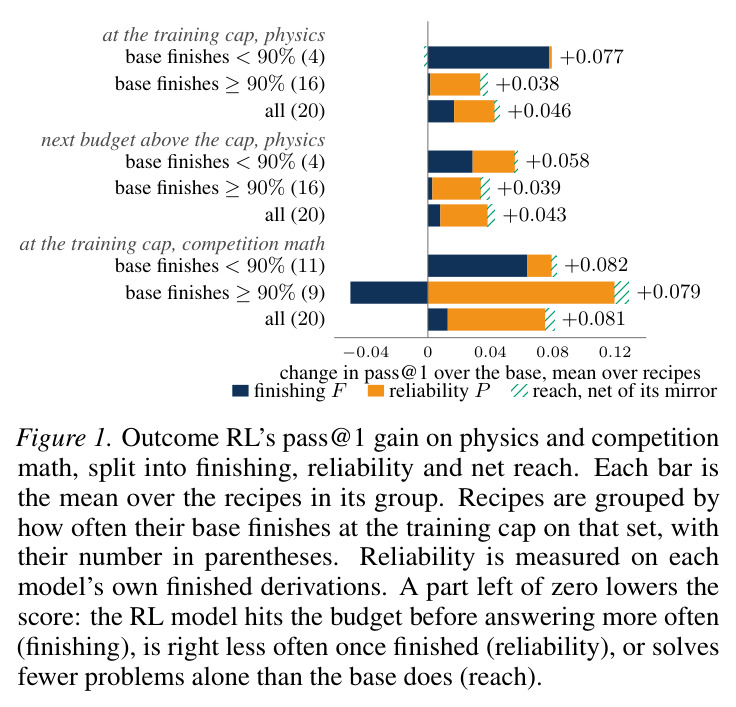
核心创新是把「行为改变 vs 新知识」的哲学争论转成一个无损的记账问题:任何 pass@1 变化都必须落入三个互斥桶之一,桶之和恒等于总变化,不存在可藏污纳垢的残差项。三个关键设计缺一不可:(1) reach 只在基座 8 个样本全部完成且全错时才认账,排除「基座只是没来得及答完」的题;(2) reach 减去镜像——即 RL 8 样本全错而基座解出的题上基座的得分——控制双向的采样运气,后经 $k=32$ 重采样证实 lone win 大多是噪声;(3) 完成与可靠性的交叉项 $\Delta\text{fin}@k \times \Delta\text{pass}@k(B|\text{fin})$ 的归属有三种方式,作者证明主要结论对排序选择稳健;(4) 匹配可靠性只在两模型都完成 7/8 的题上测量,避免「RL 新完成的题更难」把可靠性拉低的选择效应。这与只画 pass@k 曲线或只做预算校正有本质区别:它给出每个预算点上的完整账本。
方法步骤详情
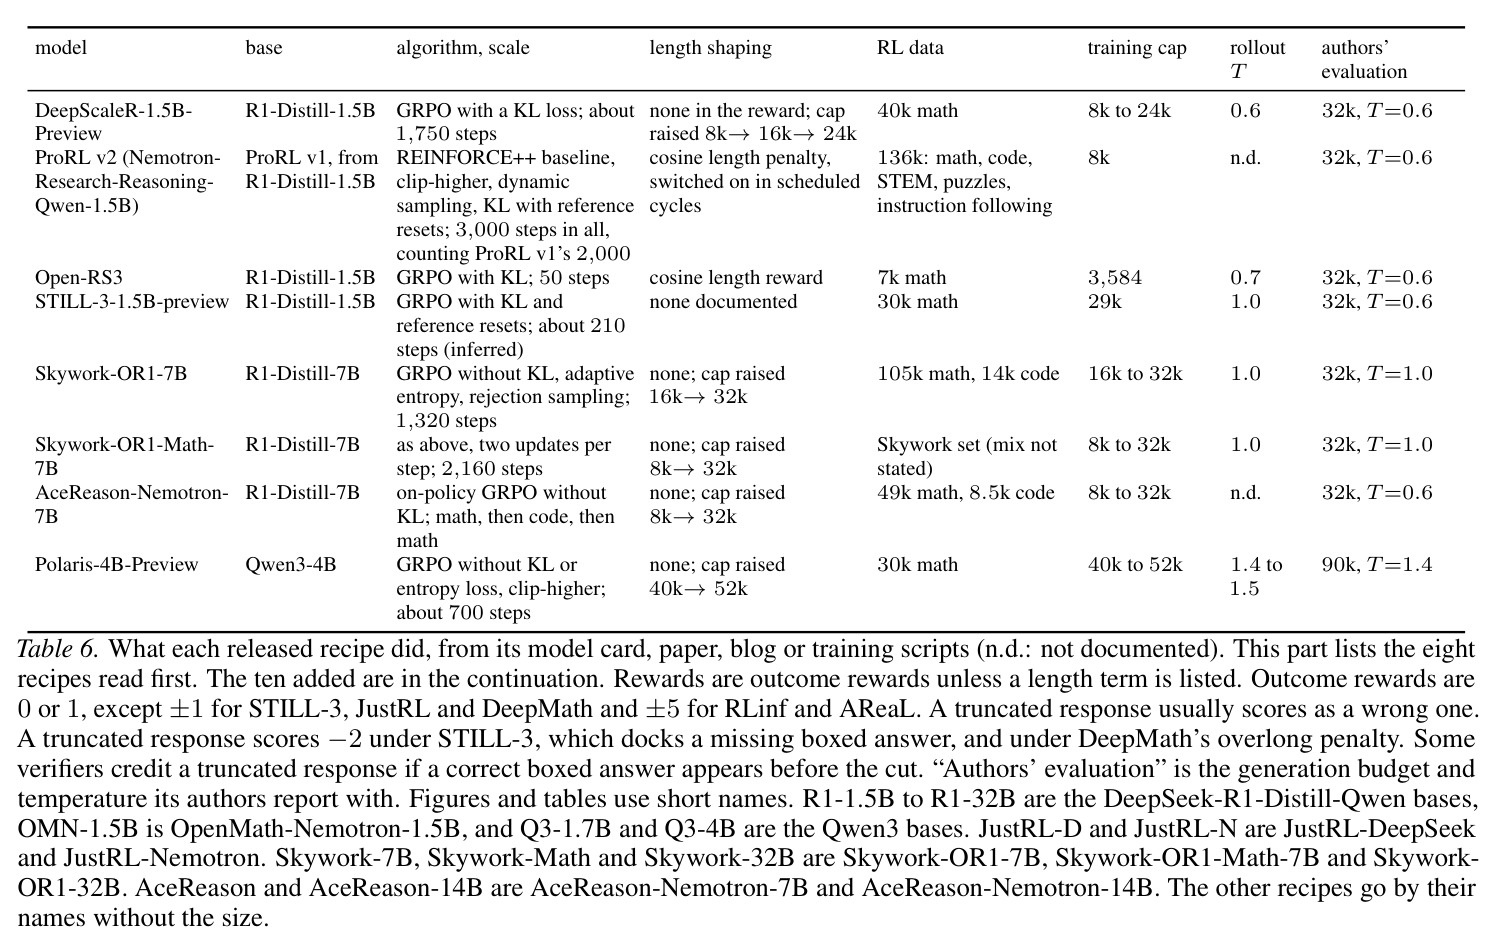
步骤一:选定 20 个已发布 outcome-RL recipe 及其思维基座(DeepScaleR、ProRL v2、Open-RS3、STILL-3、JustRL-D/N、e3、Polaris-1.7B/4B、Skywork-OR1 7B/Math/32B、AceReason 7B/14B、QuestA、KnowRL 等),从模型卡确认训练 cap(3.5k–52k)。步骤二:每对模型在 300 道物理题与 MATH-500 上用同一 prompt、同一判分器各写 8 个样本($T=0.6$),预算取 4k、8k、16k、训练 cap 及其上一档(至 64k);对后补的十个对先预注册预测再生成。步骤三:按 Eqs.(1)–(5) 计算 $F = \Delta\text{fin}@k \times \text{pass}@k^{RL}(B|\text{fin})$、$P = \text{fin}@k^{base} \times \Delta\text{pass}@k(B|\text{fin})$、reach@8 与 robust reach(对手 8 样本中 ≥4 次解出才算),并用 24 个额外样本检验 lone win。步骤四:机制审计——盲读 143 对「RL 对基座错」的推导找决定性步骤,作者人工复核 50 对中的判定,再在另一模型的其余 4 个样本中搜索该步骤是否早已出现。步骤五:受控探针——8B 模型按五通道(奖励 setup、提示中渐退 hint、教师推导拼接、策略自写 setup、蒸馏提问习惯)训练,与两个对照种子在 87 题留出集上做 2 万次聚类配对 bootstrap,检测下限约 0.03;另有 60 题重访 + replay、160 题文本孪生的迁移检验。
技术新颖性
新颖性不在算法而在测量学,具体有四点前人未做。其一,第一个无损分解:以前的证据要么是 pass@k 曲线交叉(只能观察大 $k$ 行为),要么是事后预算修正(只能说明报告数字虚高),本文给出精确可加的恒等式,并量化交叉项归属带来的不确定性(至多移动 0.03)。其二,reach 的对抗式定义:「基座全完成且全错 + 镜像扣除」把 Yue et al. 的大 $k$ 观察转译到 $k=1$/$k=8$ 的预算场景,并当场证伪——24 个额外样本让基座找回 87/121 个 lone win,证明所谓新题多半是采样运气。其三,从观察到干预:此前「RL 不教新内容」全是相关性证据,本文首次真正供给内容(5 通道对照实验),得到「奖励只在其落地的题上起作用」这一因果结论,并用总协方差分解解释为什么 finishing 信号能跨题迁移而内容信号不能(把奖励写成 $r_j = f_j c_j$,finishing 项在整批数据上累加,内容项只在重复出现的题上累加)。其四,给出可执行的报告规范:pass@1 必须与 fin@1(B) 同报、比较必须在 ≥ 训练 cap 处进行。
实验结果
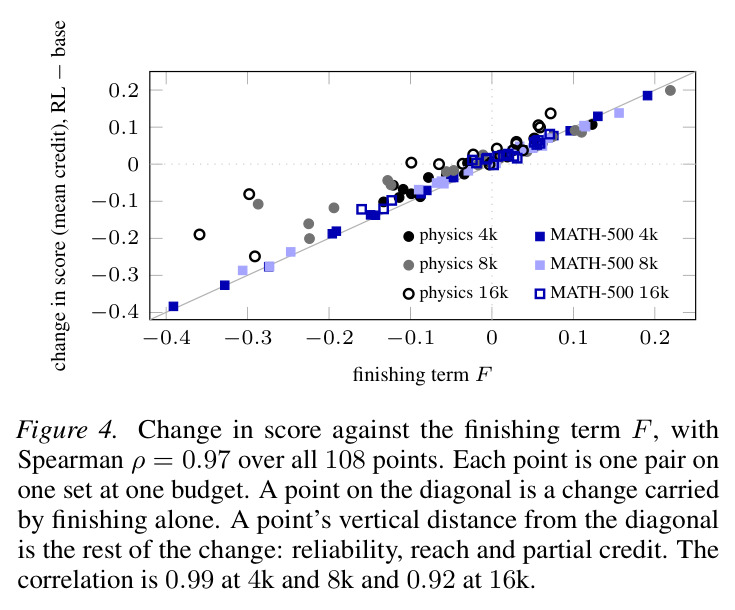
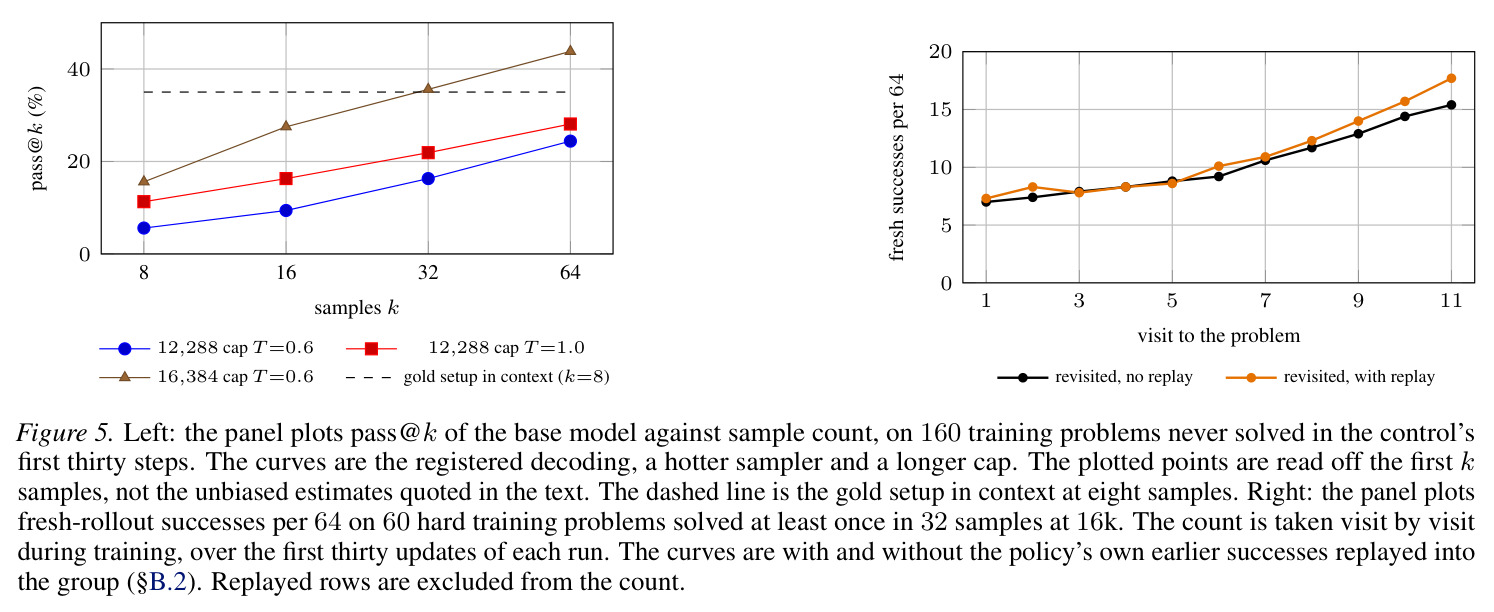
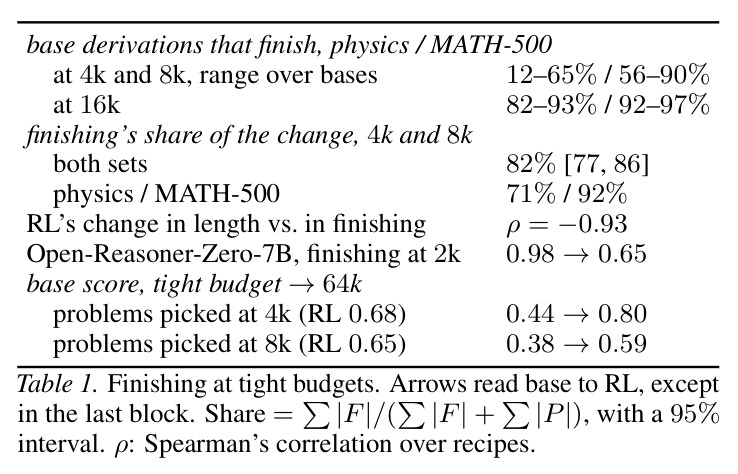
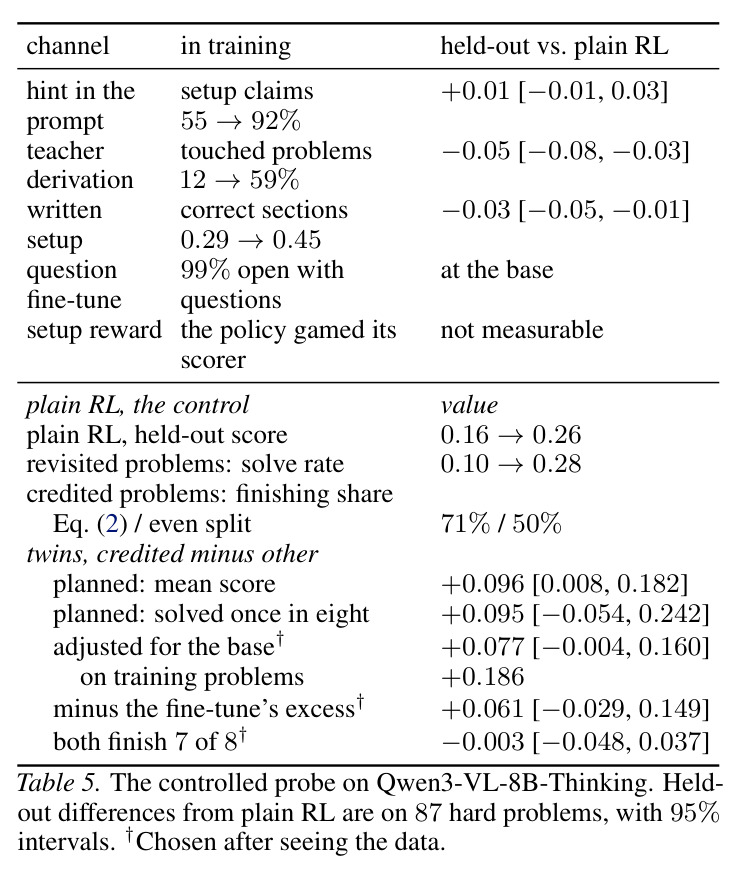
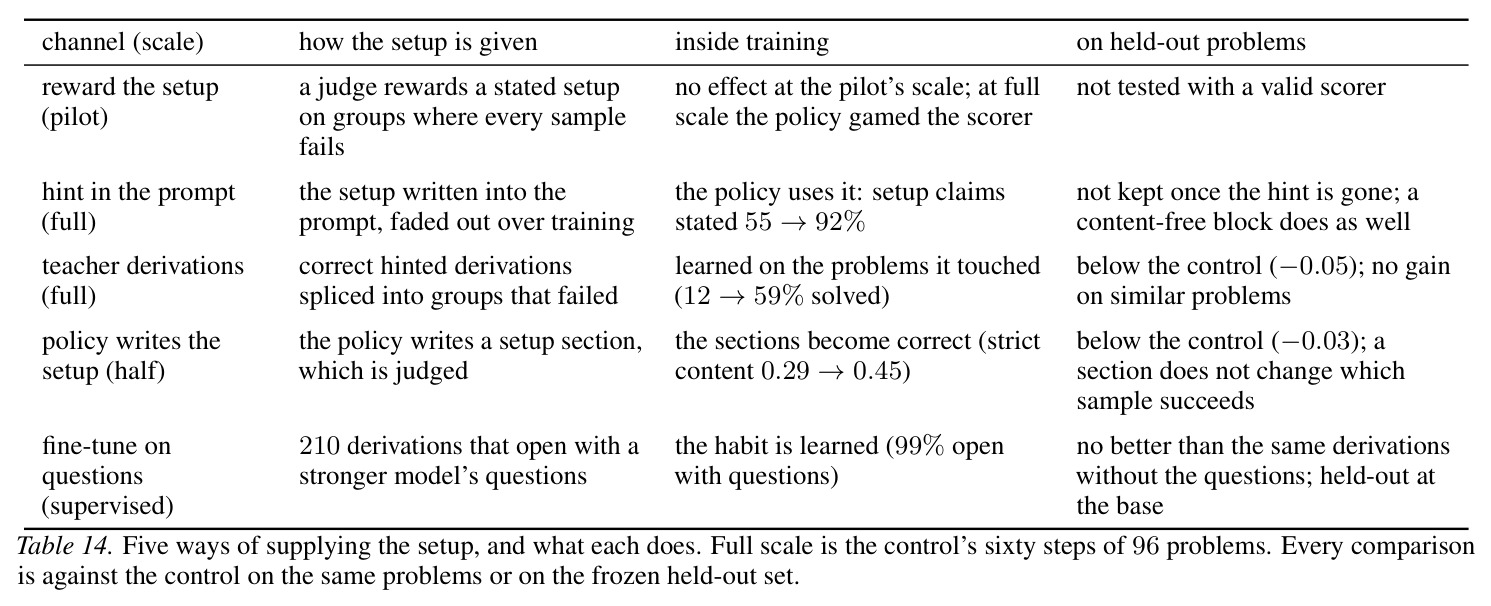
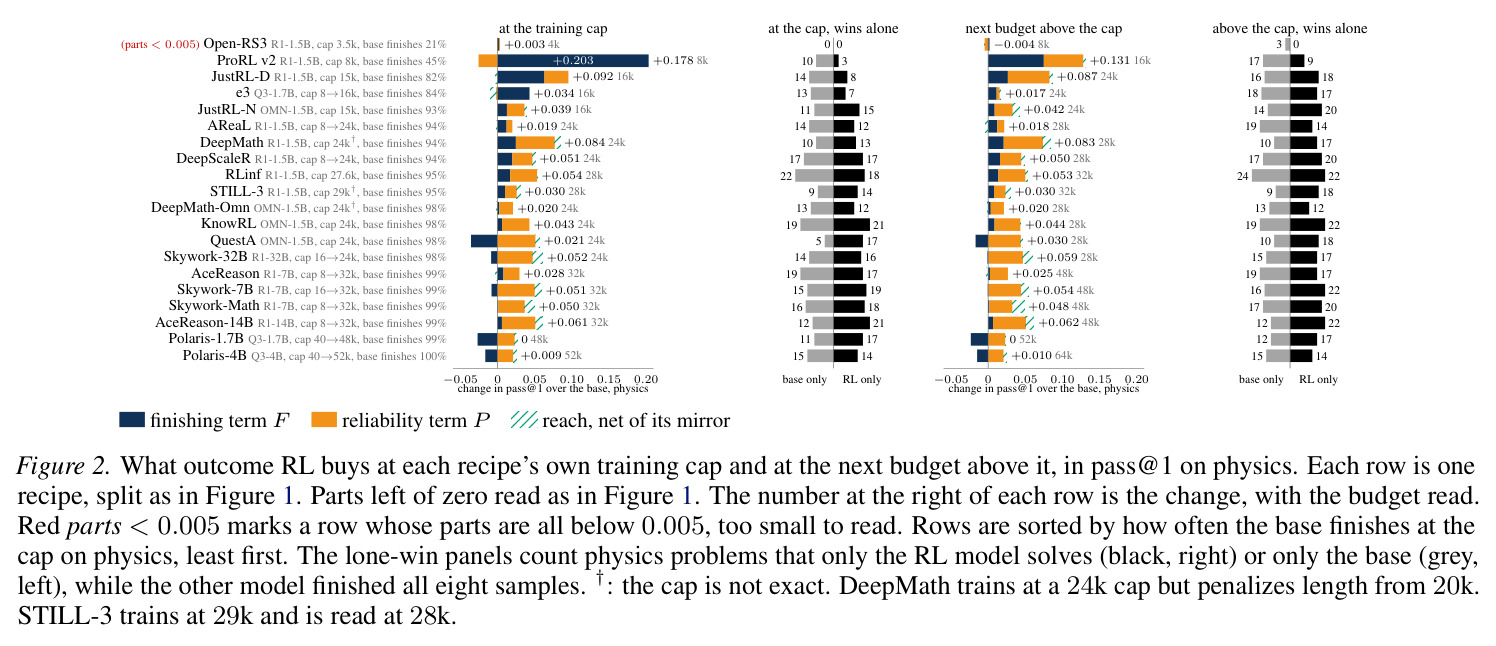
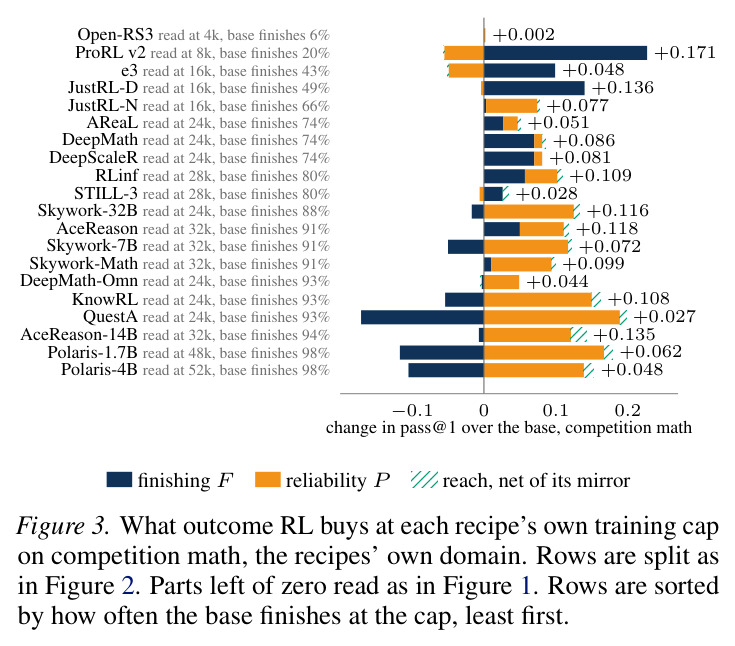
四个发现。(1) 基座常撞预算处 finishing 主导:4k/8k 下变化的 82% [77, 86] 是 finishing;ProRL v2(8k cap)基座完成率 45%→99%、$F=+0.203$;但基座给到 64k 就自己追回——4k 选出的题上 0.44→0.80 反超 RL 的 0.68,8k 选出的 0.38→0.59 对 0.65;RL 把回溯词(wait/actually)减半,长度变化与 finishing 变化的 $\rho=-0.93$。(2) 基座完成无虞处 reliability 主导:16 个非 cap-bound recipe(基座 cap 处完成 93–100%)全部 reliability 上升、14 个按量计更大;但步骤审计显示 26 个决定性步骤无一缺失于基座——基座自己的样本里就写着这些步骤(17/26 写了却没走通)。(3) reach 极少:四个集合上净 reach 全部 ≤ 0.021;144 个物理 lone win 仅 5 个(3.5%)经重采样和细读成立;人工确认的新步骤 9/10 已在基座样本中;专为注入知识的 QuestA/KnowRL/ProRL v2 的 robust win 也只有 1/3/3 个。(4) 受控探针:五通道无一在 87 题留出集上超过 plain RL(hint +0.01 区间含零、teacher −0.05、自写 setup −0.03、setup 奖励被策略刷分无法测量);plain RL 自身 0.16→0.26 几乎全靠 finishing(fin@1 0.39→0.69、条件正确率 0.38 纹丝不动);重访 60 题把解率从 0.10 提到 0.28(replay 0.31),但留出集与 293 道未重访题都不动。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 物理 pass@1 @ 4k/8k 紧预算 | finishing 占变化的比例 | 82% [77, 86](物理 71%,MATH-500 92%) | —(分解结果,无传统基线) | 确立紧预算下增益主要是按时完成而非能力提升 |
| ProRL v2 (1.5B) @ 8k cap 物理 | pass@1 变化分解 | +0.178 [0.146, 0.211],其中 F=+0.203、P=−0.026 | 基座 fin@1 0.45 → RL 0.99 | 增益几乎全部来自预算内完成率的跃升 |
| 16 个非 cap-bound recipe 物理 @ 各自 cap | matched reliability(双方都完成的题) | 16/16 上升(12 个 95% 区间不含零) | finishing 在其中 7 个 recipe 上为负 | 可靠性是基座完成后增益的一致来源 |
| 净 reach(4 个评测集) | reach@8 扣镜像 | −0.007 至 +0.021(32B 经宽容 judge 降至 0.004) | 0(无新覆盖) | 无:RL 几乎不解出基座 8 样本全错的题 |
| 8B 受控探针留出集(87 题) | pass@1 @ 12k | plain RL +0.098;最佳通道 hint +0.01 [−0.01, +0.03] | 两个对照种子 | 五种供知识通道均未显示超出 plain RL 的迁移增益 |
局限与改进
作者明确承认的:探针规模有限——每臂单种子、单模型族(Qwen3-VL-8B)、单域,最小可检测效应约 0.03,小效应(如 hint 的 +0.01)可能被漏检;采样每题只有 8 样本(lone-win 题加到 32/64),预算网格到 64k(只有 Polaris 自评 90k);判分器严格且对大模型更严,答案形式差异污染 reliability——40 个被检 reliability 胜利中 12 个只是形式不同,宽容 judge 让 32B 的净 reach 从 0.013 降到 0.004;只研究思维基座;物理在 RL 数据中 ≤1% 但可能藏在基座预训练里,且未与各 recipe 训练集查重。我自己的观察:主物理集按「基座有时能解」过滤,天然压低 reach 上限(作者用 671 题未过滤集补救且结论不变,算处理得当);预注册的 H2「匹配增益均值 <0.03」在物理单域失败(QuestA +0.108 超界),说明该声明不能一概而论;步骤审计依赖 Claude Opus 5.5 盲读加一位作者复核,无全程人工标注;「lone win 是运气」的结论基于 $k \le 64$ 的重采样,对成功概率更低的题仍可能漏判真实新能力。
独立分析的弱点
独立分析有四个弱点。第一,finishing 与知识不能干净分离:「在预算内决定正确方向」本身就是技能,作者也承认这一点;当基座是因反复回溯而超时,把它记为 finishing 还是能力损失有模糊空间——改进方向是引入过程级计费(对犹豫/回溯段单独计 token)或用过程奖励模型标注。第二,结论外推范围窄:只覆盖 outcome RL + 思维模型 + 物理/数学,过程奖励 RL、SFT(已知能迁移知识)与其他域未测,「reach 稀少」可能只是当前配方的性质——改进是把分解套用到 SFT vs RL、代码生成与 Agent 任务上做判别性检验。第三,探针的否定结论证据强度有限:单种子、8B、60 步,而 ProRL v2 训练 3,000 步(约 50 倍)确实拿到 3 个 robust win,作者也承认「规模可能重要」未被排除——改进是多种子、更大模型、更长训练的因子化实验。第四,reliability 里混着答案形式效应:主表用严格 matcher,judge 再判平均只拉低 reliability 项约 8%,但 12/40 的被检胜利纯属答案形式,意味着报告的 reliability 增益有一到两成判分伪影——改进是主结果双轨报告(matcher + 规范化 judge)。
未来方向
作者提出的方向:其一,更大规模的供给知识实验——ProRL v2 训练 3,000 步保住了 5 个真实物理胜利中的 2 个,暗示规模可能改变结论;其二,把已知能迁移知识的监督蒸馏与 RL 并排对照,补上「知识能否安装」的另一半;其三,解释 recipe 间 reliability 增益差异为何大(数据、步骤、算法同时不同,本文无法归因)。基于成果可延伸的:把三分解做成评测基础设施——要求每篇 RL 论文同时报告 $\text{pass}@1(B)$ 与 $\text{fin}@1(B)$ 并在 ≥cap 处对比基座,可做成开源评测工具;利用「增益随 $p(1-p)$ 走、每加倍 $k$ 乘 1.67–1.39」的规律设计课程与采样调度(把训练预算集中到 $p$ 中等的题);检验 replay/RLEP 能否扩大「奖励落地范围」——探针显示 replay 只把 60 题的 0.10 加速到 0.31,能否扩散到相似题是关键开放问题;最后在代码、Agent 等其他域重复分解,检验「完成-可靠-拓展」框架的普适性。
复现评估
复现条件相当好。作者是独立研究者,代码与全部 released tables(含每个 recipe 每个预算的分解单元格)开源在 github.com/shanyang-me/outcome-rl-buys,项目页为 shanyang.me/what-outcome-rl-buys/。20 个模型全部是公开权重(1.5B–32B),评测集(300 物理、671 未过滤物理、MATH-500、276 竞赛数学)都给出来源与判分协议(冻结的 matcher + judge v2,7,398 条 setup claims 经审计精度 73.8%)。主要成本是推理:每对每域每预算 8 样本,外加 $k=32/64$ 重采样与 16 对的二次生成;缩减预算档或 recipe 数即可在数十 GPU 时量级复现核心结论。唯一需要训练的是 8B 探针(GSPO、60 步、每步 96 题、每臂单种子),约数个 GPU 天。难度评估:分解公式与协议简单,整体中等难度;瓶颈在评测基础设施工程、步骤审计的人工环节(盲读与人工复核无法完全自动化),以及 20 对模型全量推理的算力。
论文图表
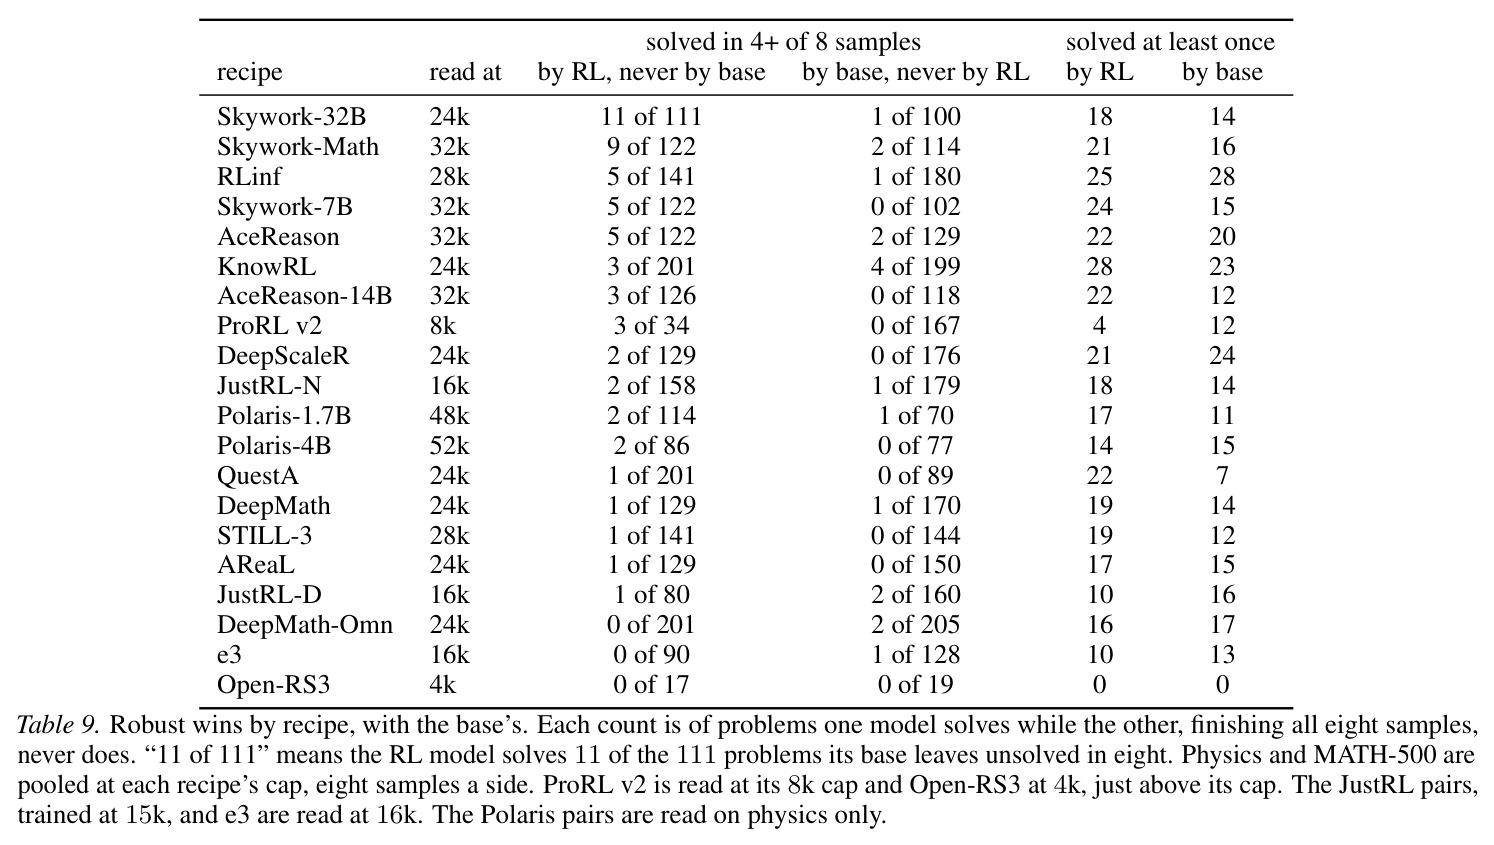
每个 recipe 在其 cap 处(物理 + MATH-500 合并)统计:RL 在基座 8 样本全错的题上、以 8 样本中 ≥4 次解出的题数(如 Skywork-32B 11/111、QuestA 1/201),以及镜像方向基座的对应数(多为 0–4 个)。最大值也只有 11 题,且两方向大体对称。
给出「即便用最严的 robust 标准,新解出的题也寥寥且双向对称」的逐 recipe 证据,补齐 reach 结论在最保守口径下的图景。
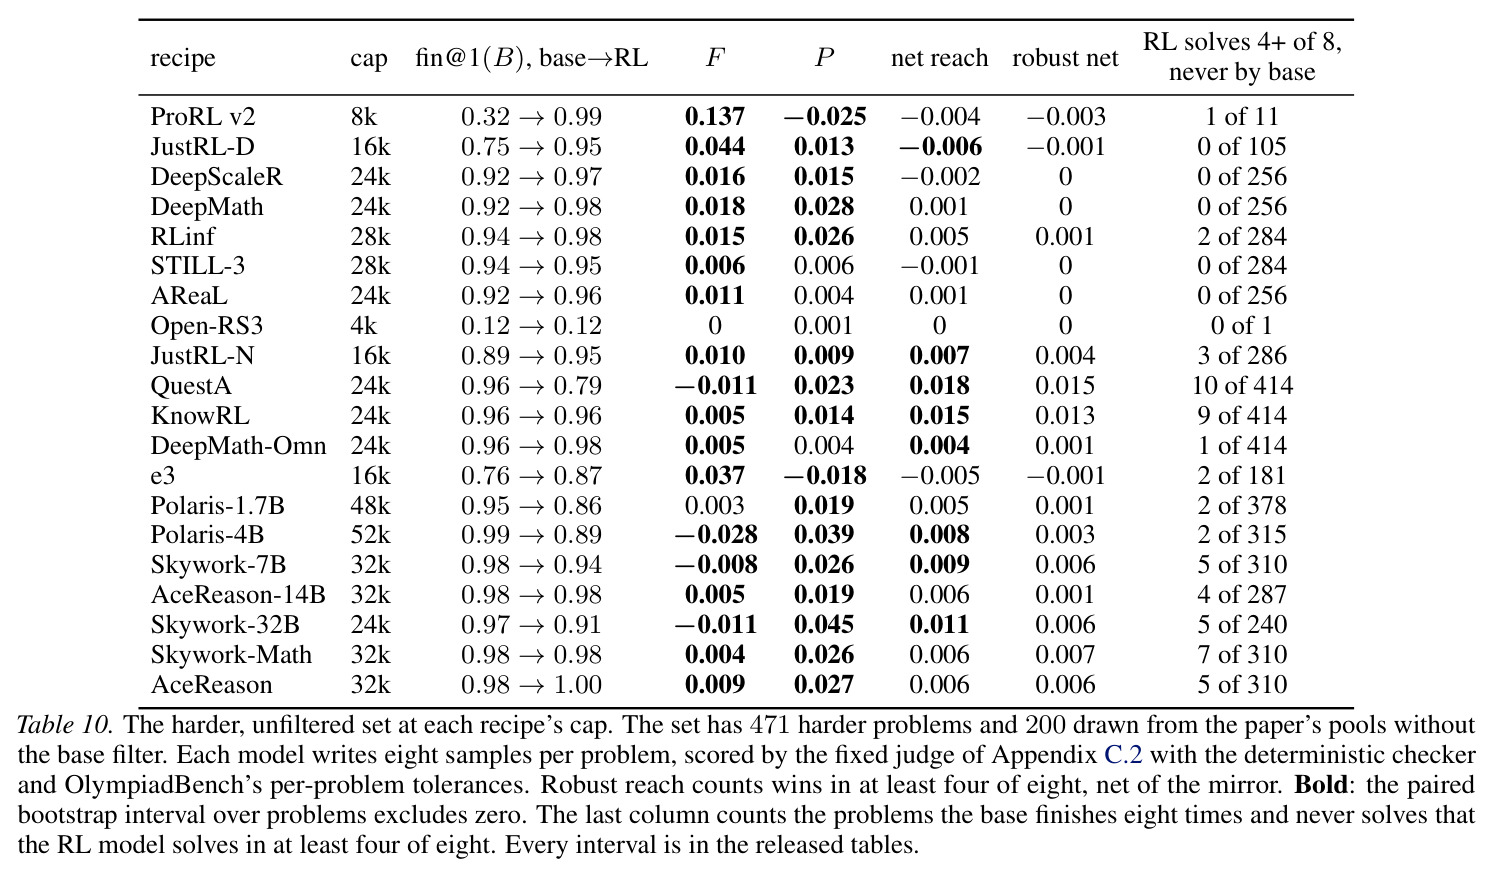
在 471 道 OlympiadBench/PHYBench 等更难题 + 200 道未过滤题上重复分解:净 reach −0.006~0.018,只有 QuestA(0.018)与 KnowRL(0.015)显著且 robust win 为 10/9 个;逐题细读后 19 个 robust win 中 13 个成立、无一是答案形式。
回应「主物理集按基座过滤压低了 reach」的质疑:在不设过滤、远离天花板的题集上 reach 依然稀少,说明过滤没有掩盖真实的新覆盖。
在 276 道 2025–2026 竞赛数学题(其中 63 道晚于所有模型)上于各 cap 处分解:净 reach −0.002~0.021;可靠性在基座完成 ≥90% 的 9 个 recipe 上全部显著上升(QuestA/KnowRL 的匹配可靠性 +0.109/+0.129);该评测管线复现了原作者的 AIME 2025 数字(差 ≤0.040)。
域内检验:在 RL 的训练域、用晚于模型的赛题排除污染后结论不变,并验证了本文评测管线与原作者报告的一致性。
受控探针的全部 17 个训练臂档案:两个对照种子、setup 奖励臂、hint 臂、教师拼接臂、自写 setup 臂(宽严两种判分)、提问蒸馏臂、16k cap 臂、深采样臂、dense-revisit 与 replay 臂等,标注每臂与对照的差异(语料版本、判分器、步数 × 组数、 rollout 数)。
探针可复现性的关键档案:明确每个臂只改一个变量,使「五通道」比较可审计,也标注了哪些臂只跑了部分规模或被提前停止。
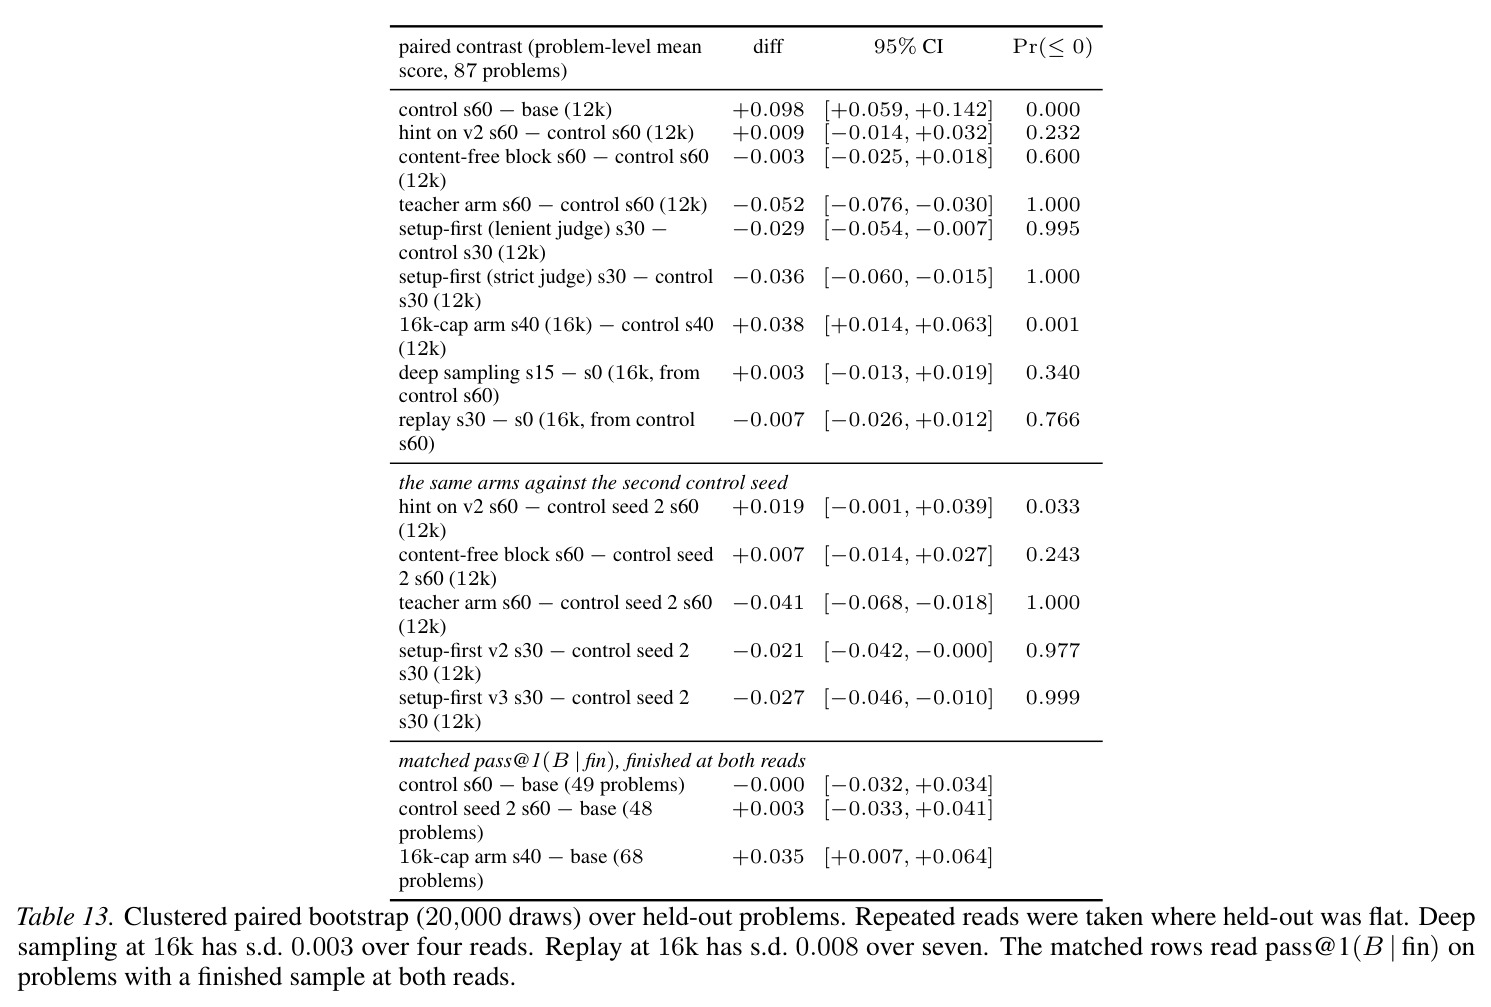
留出集(87 题)上的配对对比:对照 s60−base +0.098 [0.059,0.142];hint 臂对两个对照种子分别 +0.009 与 +0.019;teacher 臂 −0.052/−0.041;自写 setup −0.029~−0.036;16k cap 臂 +0.038;深采样与 replay 的前后差均含零;匹配可靠性(双方都完成的题上)对照为 ±0.00。
给出探针所有因果声明的置信区间与检测下限(约 0.03),读者可据此判断哪些「无增益」是真无、哪些可能只是测不出。
五通道的「训练内变化 vs 留出表现」矩阵:奖励(全规模被策略刷分,学会给答案加单位);提示 hint(陈述率 55%→92%,撤掉就不保留,与内容无关的空白块效果相同);教师推导(触及题 12%→59%,留出 −0.05,未触及题更差 −5.1);自写 setup(正确率 0.29→0.45,但段落的对错不影响组内解题率);提问蒸馏(99% 学会提问,但提问样本解题率 2.0% 反而低于不问的 2.6%)。
以统一框架展示「每种供给都改变了模型、却没有一种迁移」的完整因果链,是「奖励只在落地的题上起作用」这一结论的证据总表。
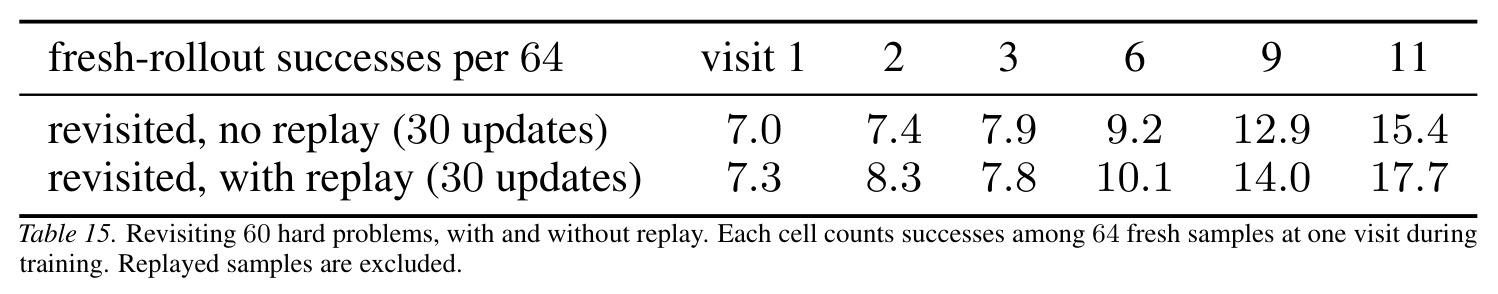
训练中逐次访问 60 道可学会难题,统计每次访问时 64 个新鲜样本的成功数:无 replay 从第 1 次的 7.0 升到第 11 次的 15.4,有 replay 升到 17.7;新成功与 replay 样本的中位 shingle Jaccard 仅 0.039,说明多数新成功是全新推导而非复制旧样本;留出集读数 0.329(无 replay)对 0.325(有 replay)。
量化 revisit + replay 的效果:replay 只把成功积累加速约 15%,既不解锁新题也不迁移到留出集,支持「信用只安装在被解出的那道题上」。
160 道训练难题各有同物理、换表面的文本孪生题。被奖励「credited」的 75 题原题 pass@1 从 0.02 升至 0.21/0.23(两个种子);其孪生题从 0.28 升至 0.55/0.57,其中 finishing 项占 0.288/0.304,匹配可靠性对比 −0.003 [−0.048,0.037](含零);计划的均值分超出 +0.096 [+0.008,0.182],按基线与问题类型调整后 +0.077 [−0.004,0.160] 也含零。
这是「知识能否跨表面迁移」最直接的检验:孪生题上的超出主要被 finishing 解释,内容成分在任何分解顺序下都无法与零区分,为否定结论提供最细粒度的证据。