SleuthVLM:不直接听音频的智能体式全模态视频理解 SleuthVLM: Do We Really Need Audio-in-Video for Omni Video Understanding?
VLM 只读带时间戳的转录并自主搜证,全模态基准反超直接听音频的 omni 模型
前置知识
VLM(视觉语言模型)
以大语言模型为骨干、通过视觉编码器把图像或视频帧映射成 token 序列后与文本联合建模的多模态模型,典型代表有 Qwen3-VL、Claude 等。它具备强大的推理、规划与工具调用能力,但不含音频编码器,无法直接接收任何声音信号,只能处理图像和文本。
SleuthVLM 的推理核心就是一个普通 VLM,理解它“只会看图和读文本、却要回答音视频问题”这一设定,是读懂全文所有实验对比的前提。
Omni 模型(全模态模型)
在 VLM 基础上外挂音频编码器,并在海量“视频-音频-文本”配对数据上联合训练的模型,如 Qwen3-Omni、MiniCPM-o、video-SALMONN 等。它们对固定采样的帧和音轨做一次前向推理即直接作答,新能力依赖昂贵的联合训练,且会部分损失 VLM 原有的推理与工具使用能力。
本文的对照对象和质疑目标就是这类模型:论文核心问题正是“omni 模型必须直接听音频”这一主流配方是否必要。
ASR 与强制对齐(Forced Alignment)
ASR 把语音转成文字;强制对齐则在给定转录与音频的条件下,把每个词 $w_j$ 的起止时间 $s_j, e_j$ 精确标出,得到 $W=\{(w_j,s_j,e_j)\}_{j=1}^M$。配合静默间隙检测(阈值 $\gamma=3$ 秒),转录就变成带时间坐标的索引,并标出无词的音乐或音效区段。
带词级时间戳的转录是 SleuthVLM 唯一的音频信息来源,也是“转录即时间索引”这一核心机制的物质基础。
智能体工具调用循环
模型在多轮对话中交替输出推理与工具调用 $a_t \sim \pi(\cdot \mid h_t)$,环境返回结果 $x_t$ 拼入历史 $h_{t+1}$,直到模型主动调用 answer 结束;通常受轮数、图像数、时长等预算约束。与预定义工作流的区别是每一步做什么由模型自主决定。
SleuthVLM 的全部方法就是一个无预定义工作流的智能体循环,论文三大发现(搜索优于被动观测、瓶颈是智能体能力而非听觉)都围绕它展开。
研究动机
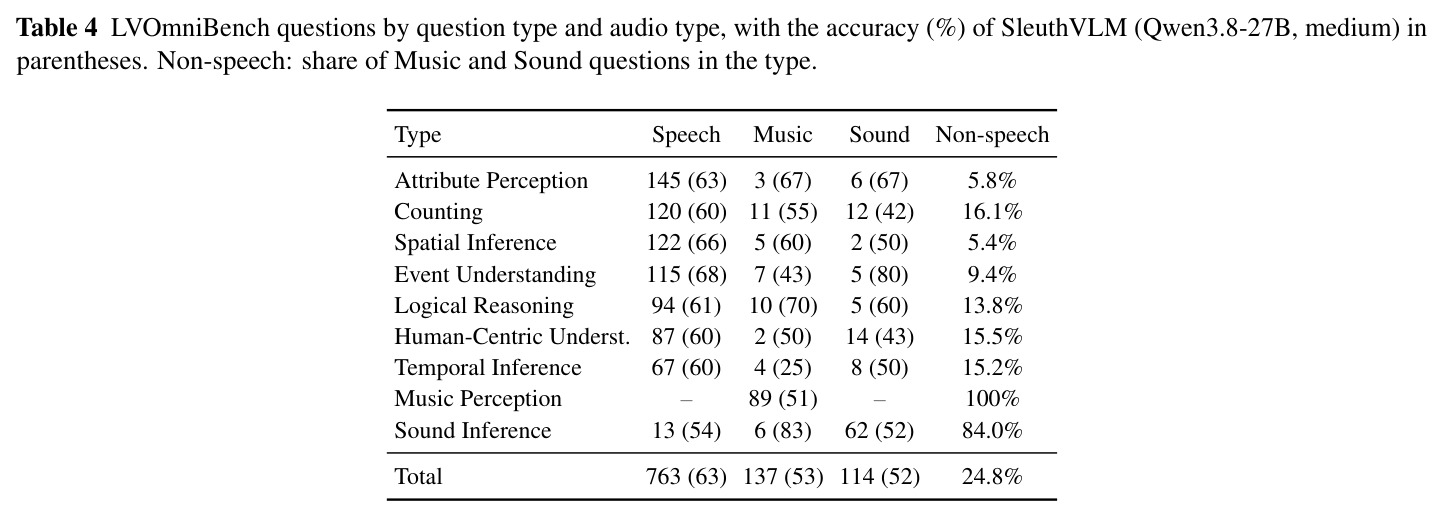
现有 omni 模型(Gemini 3.8 Flash、Qwen3.8-Omni-Flash、MiniCPM-o、video-SALMONN 等)走的是同一条路线:在 VLM 上外挂音频编码器,用海量音视频配对数据联合训练,再对固定采样的帧和音轨做一次前向推理作答,领域进步主要靠加大模型和堆数据。这条路线隐含两个可疑假设。其一,模型必须“直接听”音频——但论文统计发现 LVOmniBench 上 75.2% 的问题所依赖的音频其实是语音,而语音可以用 ASR 转成带时间戳的文字;直接听不仅让每个新能力都依赖昂贵的联合训练,还会稀释强 VLM 已有的推理与工具调用能力。其二,一轮推理足够——固定采样率对长视频覆盖稀疏,35 分钟视频按每秒 1 帧需看 2100 帧,而答案往往只藏在几秒钟里,一次性推理的模型无法回头重看,导致长视频性能崩塌(如 Qwen3.5-Omni-Plus 在 10–90 分钟视频的 LVOmniBench 上仅 53.2% 的准确率)。
本文的目标是本文想回答一个被领域忽视的基本问题:全模态视频理解是否真的需要模型直接接收音频输入?具体目标有三层。第一,构造一个从不直接听音频的系统 SleuthVLM——音频每视频离线转写一次,VLM 用通用工具在沙箱里自主搜证作答——检验它能否在覆盖 30 秒到 90 分钟视频的四个全模态基准(Daily-Omni、WorldSense、OmniVideoBench、LVOmniBench)以及 Video-MME-v2 排行榜上达到最优。第二,通过把 omni 模型放进同一个 harness(甚至额外提供 listen_audio 听音频工具)做受控对比,分离“听得见”与“会搜证”两种能力对准确率的贡献。第三,提炼可迁移的领域结论:搜索式推理是否优于被动观测、性能瓶颈到底是听觉还是智能体能力、小模型能否借助好的 harness 追平闭源大模型。
与已有工作不同的是,本文的独特之处在于做“减法”而非“加法”。已有改进要么继续堆数据和参数(Qwen3-Omni、MiniCPM-o),要么给智能体配专门感知工具、把“看和听”外包给独立模型——OmniAgent 用 o3 协调七个音视频工具模型,Omni-Decision 用 GPT-5.2 规划器加 Gemini-3.1-Pro 感知,结果反而低于 Gemini-3.1-Pro 单轮成绩;TFO 虽然也只给 VLM 转录文本,但只做单轮前向、没有搜索。SleuthVLM 则只规定模型能访问的资源(静音视频、词级时间戳转录、通用工具)和固定预算,把“看哪里、看多细、何时停”全部留给一个 VLM 自主决定;同时用受控实验证明:同一个 harness 里,即使 omni 模型能直接听音频,仍输给只读转录的纯 VLM。这把瓶颈从“模态对齐数据不够”重新定位到“智能体能力不足”,是与既有工作最本质的视角差异。
核心方法
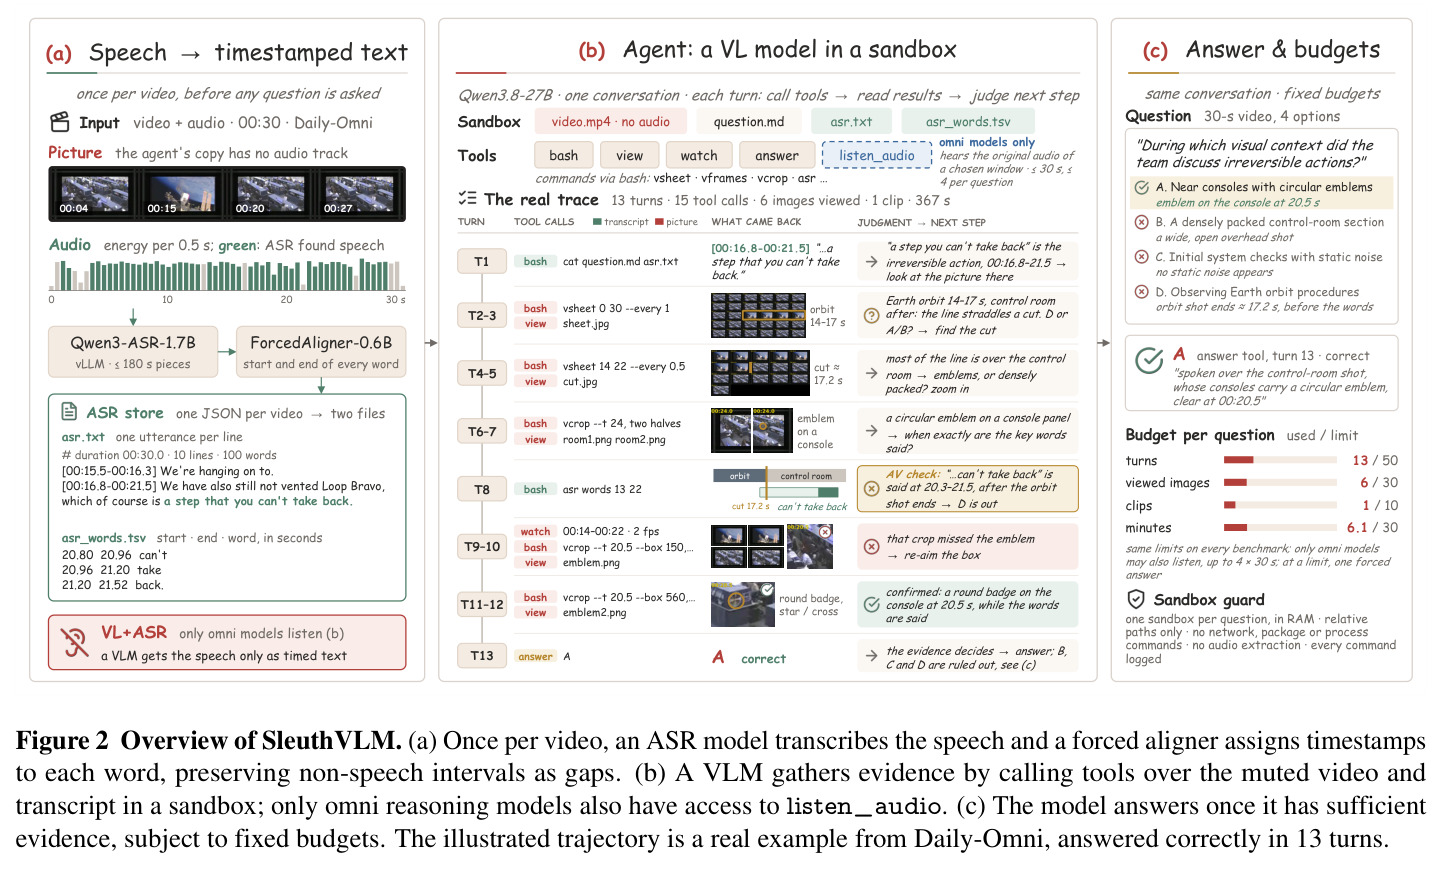
直觉上,与其让模型边看边听一遍,不如让它像侦探一样带着问题去搜证。技术上,SleuthVLM 把 omni 模型的单轮推理 $\hat{y}=\arg\max_{o\in O} p(o\mid V,A,q)$ 替换为智能体形式 $\hat{y}=\mathrm{Agent}_\pi(V,T,q,O)$,其中 $T=\mathrm{ASR}(A)$ 是每视频离线转写一次的转录文本,$V$ 是静音视频帧。每问题开一个内存沙箱,内含静音视频、question.md、asr.txt(逐句转录与静默间隙)和 asr_words.tsv(词级时间表)。VLM 可用四类工具:bash(vsheet 联络表、vframes 抽帧、vcrop 裁剪、asr 检索等)、view、watch 与 answer。预算 $B=(N_{turn},N_{img},N_{clip},T_{max})$ 固定为 50 轮、30 图、10 段、30 分钟;模型自主决定搜证路径,调用 answer 即结束。主结果用 Qwen3.8-27B(单张 H200),最强版只换推理模型为 Claude Opus 5.5。
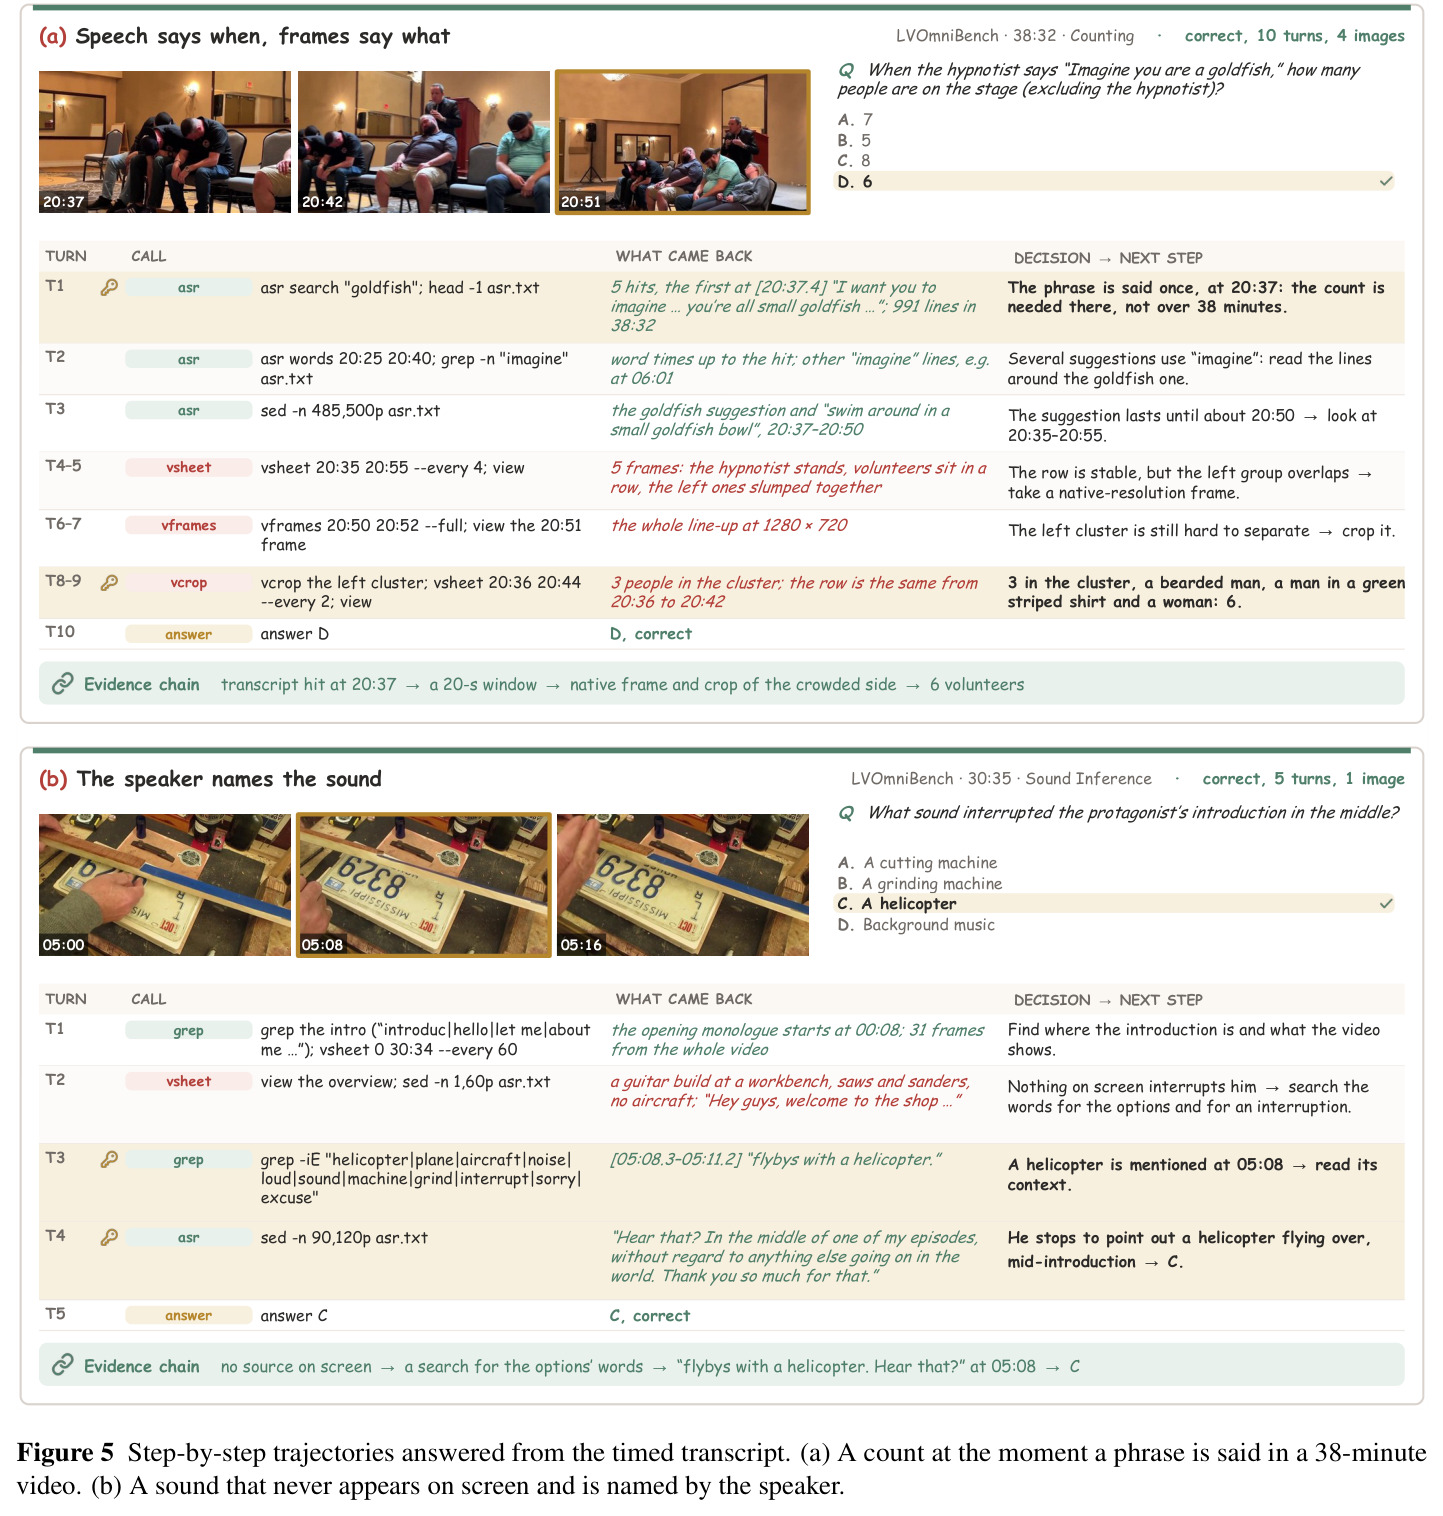
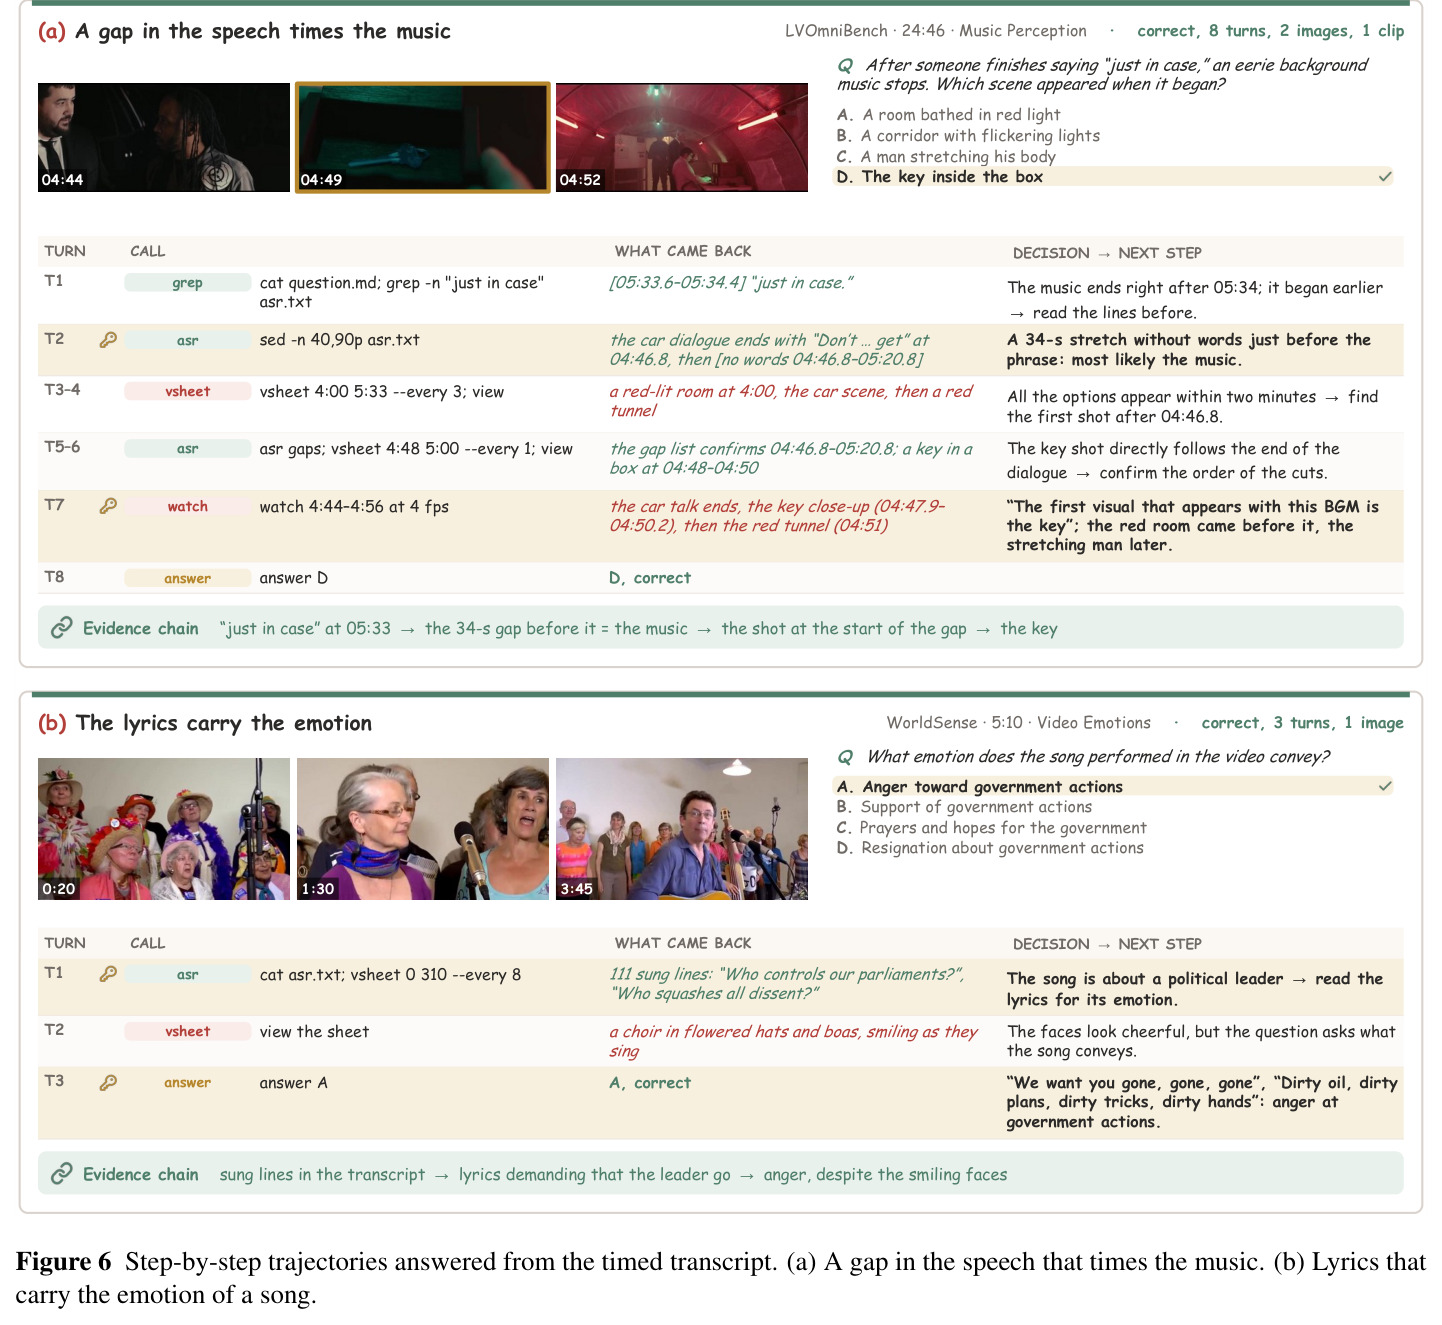
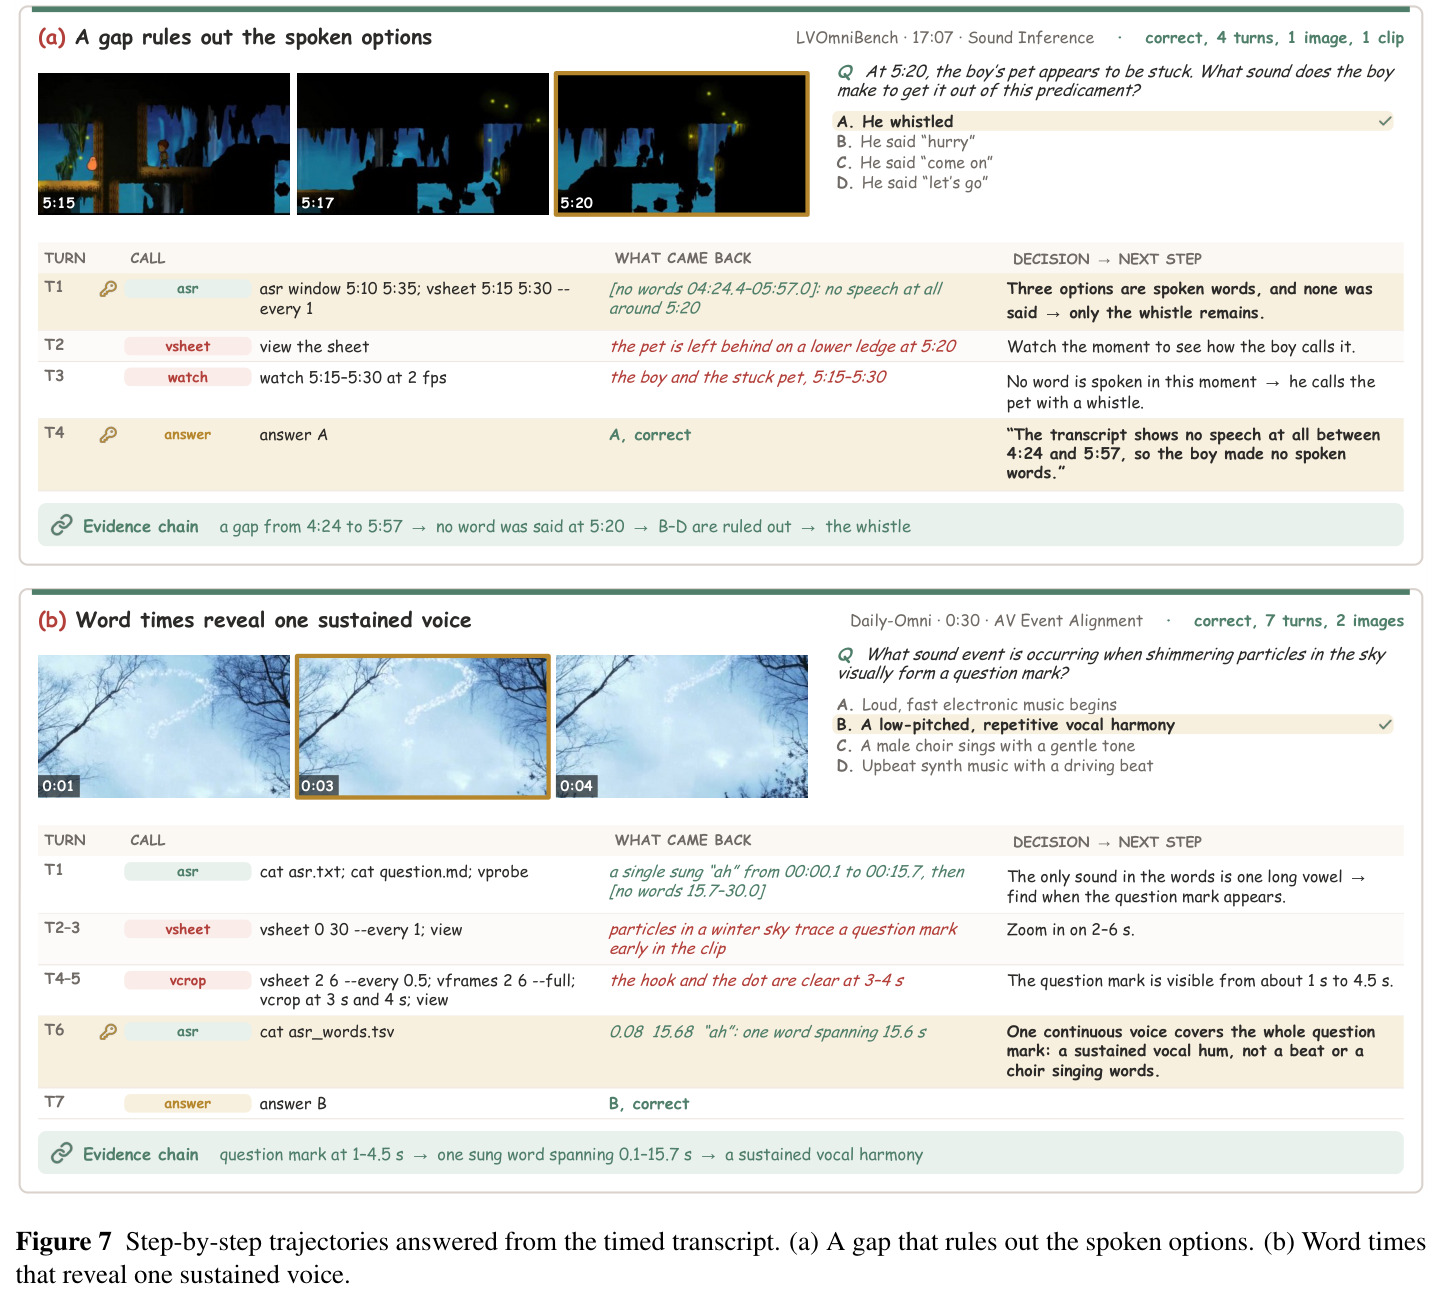
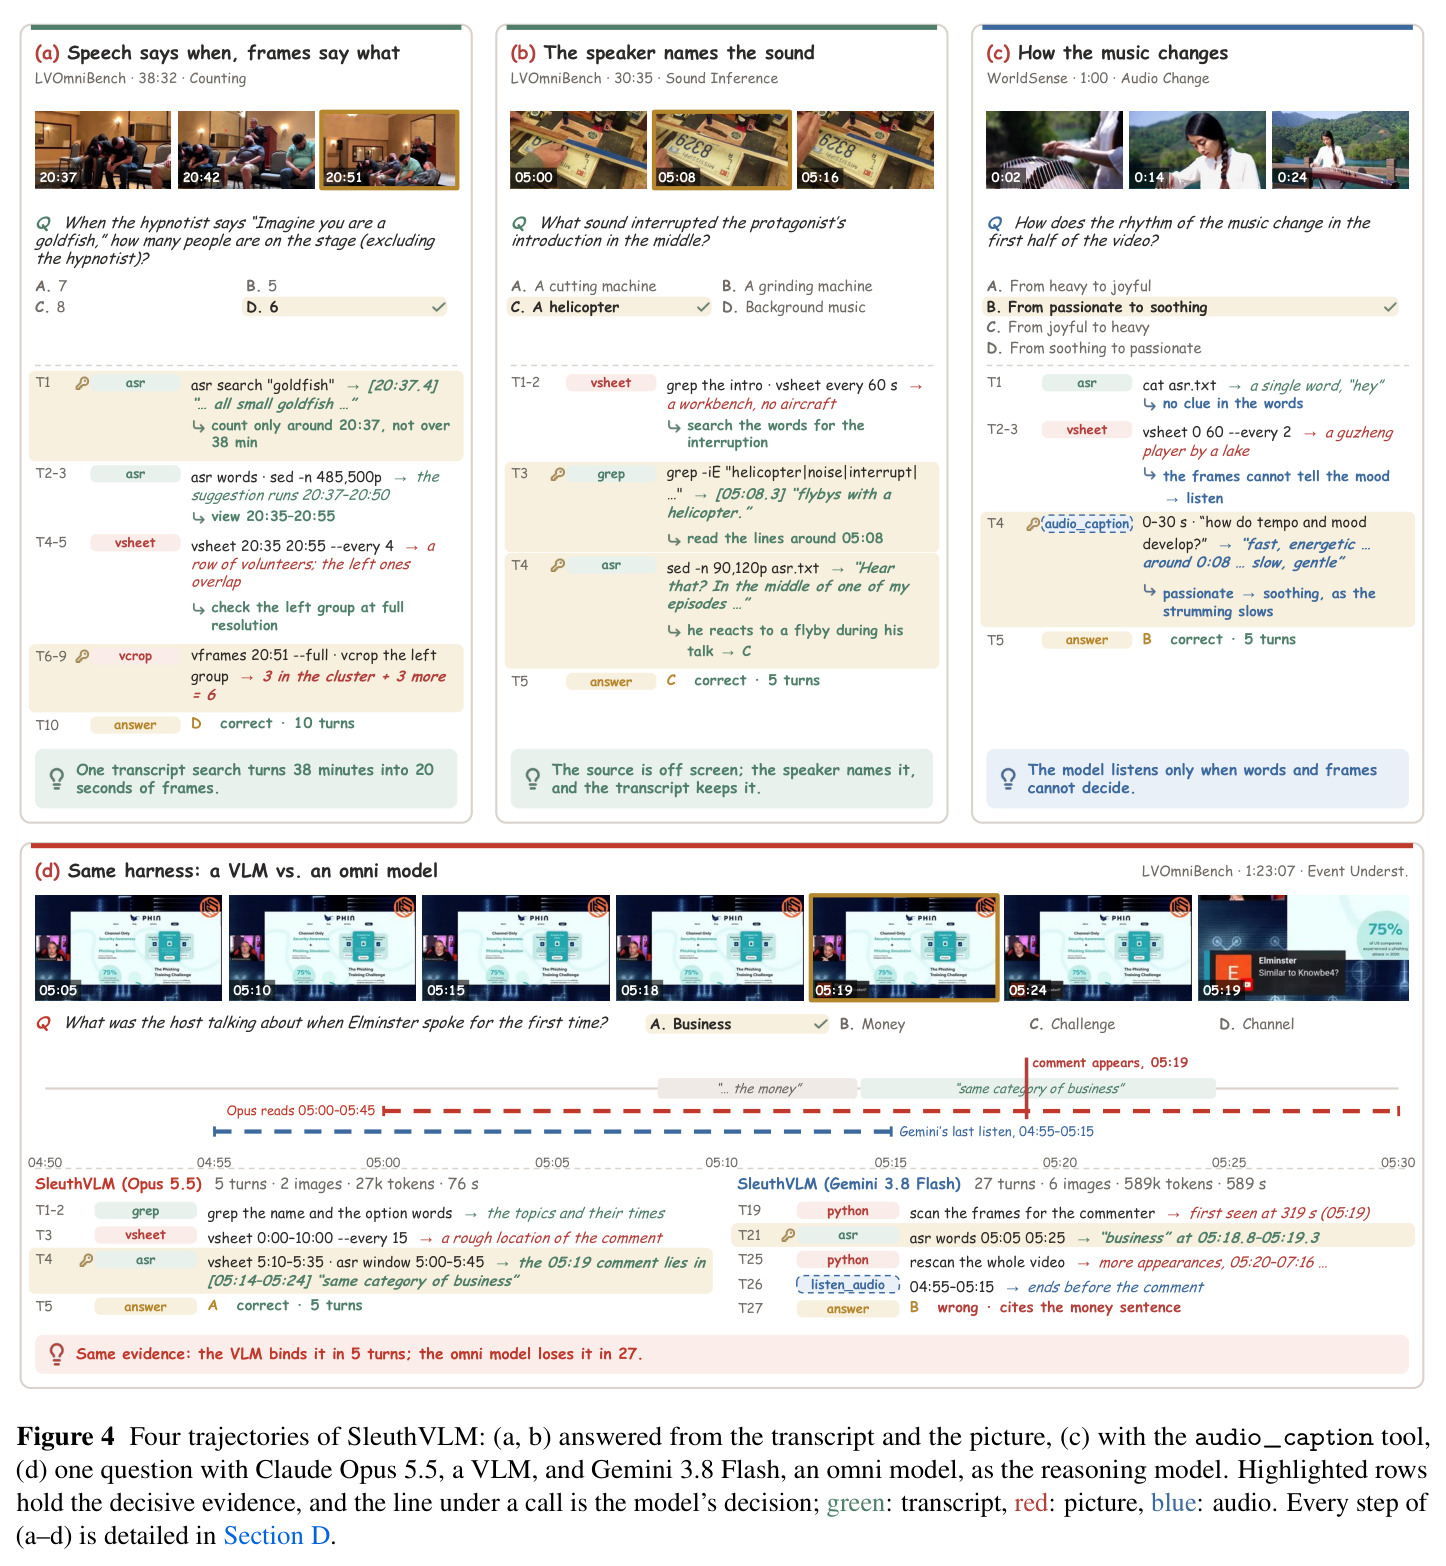
核心创新是“转录即时间索引”加“把感知决策归还给模型”。一方面,词级时间戳把文本变成视频的时间坐标系:问题关键词在转录中的命中区间 $[s,e]$ 直接给出观察窗口 $\Omega=[s-\delta,\, e+\delta]$;超过 $\gamma=3$ 秒的无词间隙 $G=\{(e_j, s_{j+1})\}$ 标出音乐和音效所在;词区间与视觉事件区间的交集判据 $[s,e]\cap[\alpha,\beta]\neq\varnothing$ 支撑跨模态绑定。模型据此由粗到细地在窗口链 $\Omega_1\supset\Omega_2\supset\cdots$ 上以递减间隔观察,总帧数 $\sum_k |\Omega_k|/\Delta_k \ll D/\Delta_K$,论文实例把 38 分钟视频的计数题压缩到只看 20 秒画面解决。另一方面,与 OmniAgent 等把感知外包给专门模型的方案不同,harness 只声明资源与预算,看哪里、看多细、何时停完全由 VLM 自己决定。本质区别在于:让通用推理能力直接支配感知过程,而不是用预定义工作流或外部专家模型约束它。
方法步骤详情
流程分两阶段。离线阶段(每视频一次、与问题无关):Qwen3-ASR-1.7B 转写语音,Qwen3-ForcedAligner-0.6B 给每个词打上起止时间 $s_j, e_j$;长录音在静音处切成不超过 180 秒的片段分别转写对齐后拼回视频时间轴;对齐失败时退化为 30 秒块级时间戳、不生成词级文件;四个基准共 3249 个视频约 302 小时音频,单张 H200 约 113 分钟完成。在线阶段(每问题):系统提示词包含对四个基准完全一致的范围定义(沙箱文件、工具清单、禁止联网/装包/抽音频等规则)和操作指南(读题读转录→联络表总览→按转录命中定位窗口→放大细看→证据足够即作答)。第 $t$ 轮模型基于历史 $h_t$ 输出推理与工具调用 $a_t$,结果 $x_t$ 拼入 $h_{t+1}$;调用 answer(o) 或预算耗尽时结束。若推理模型本身是 omni 模型,则额外提供 listen_audio$(t_0,t_1)$ 工具(窗口不超过 30 秒、至多 4 次);纯 VLM 版本没有该工具。Qwen3.8-27B 以高推理强度、温度 1.0 运行。
技术新颖性
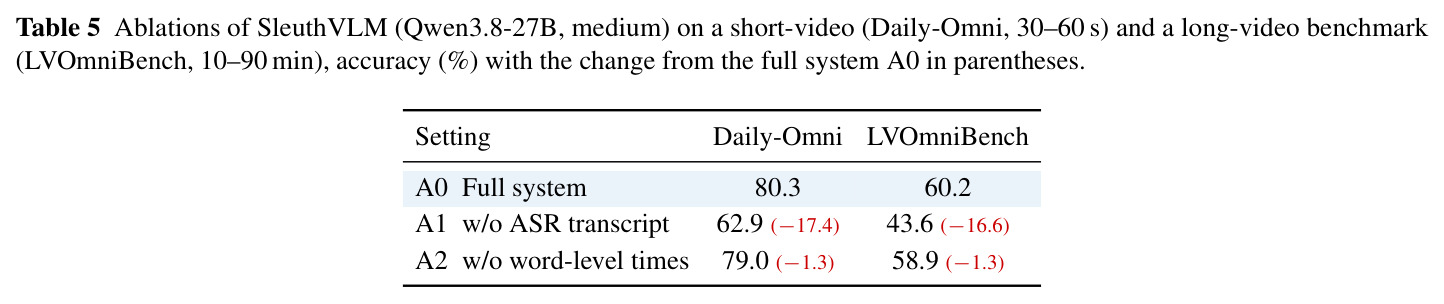
新颖性体现在四个层面。第一,范式层面:证明“完全不直接听音频”也能做到全模态理解 SOTA,直接挑战“omni = VLM + 音频编码器 + 配对数据”的主流配方,且全程零训练。第二,机制层面:把转录形式化为时间索引——检索窗口 $\Omega$、静默间隙 $G$、区间交集绑定判据——不同于把字幕当纯文本一次性喂给模型的 TFO;词级而非句级时间戳是关键,消融显示词级时间在两个基准上各再贡献 1.3 个点且集中在音乐声音题。第三,系统层面:单个 VLM 加通用工具的组合胜过七工具协作的 OmniAgent(最高领先 10.8 个点)、GPT-5.2 加 Gemini-3.1-Pro 的 Omni-Decision(WorldSense 上高 11.8 个点)和需专门训练的 7B 智能体(高 15.6–26.3 个点),说明 harness 设计比工具数量更重要。第四,实验层面:在 harness 内给 omni 模型加 listen_audio 的受控对比,干净分离了“听觉”与“智能体能力”两个混淆因素。
实验结果
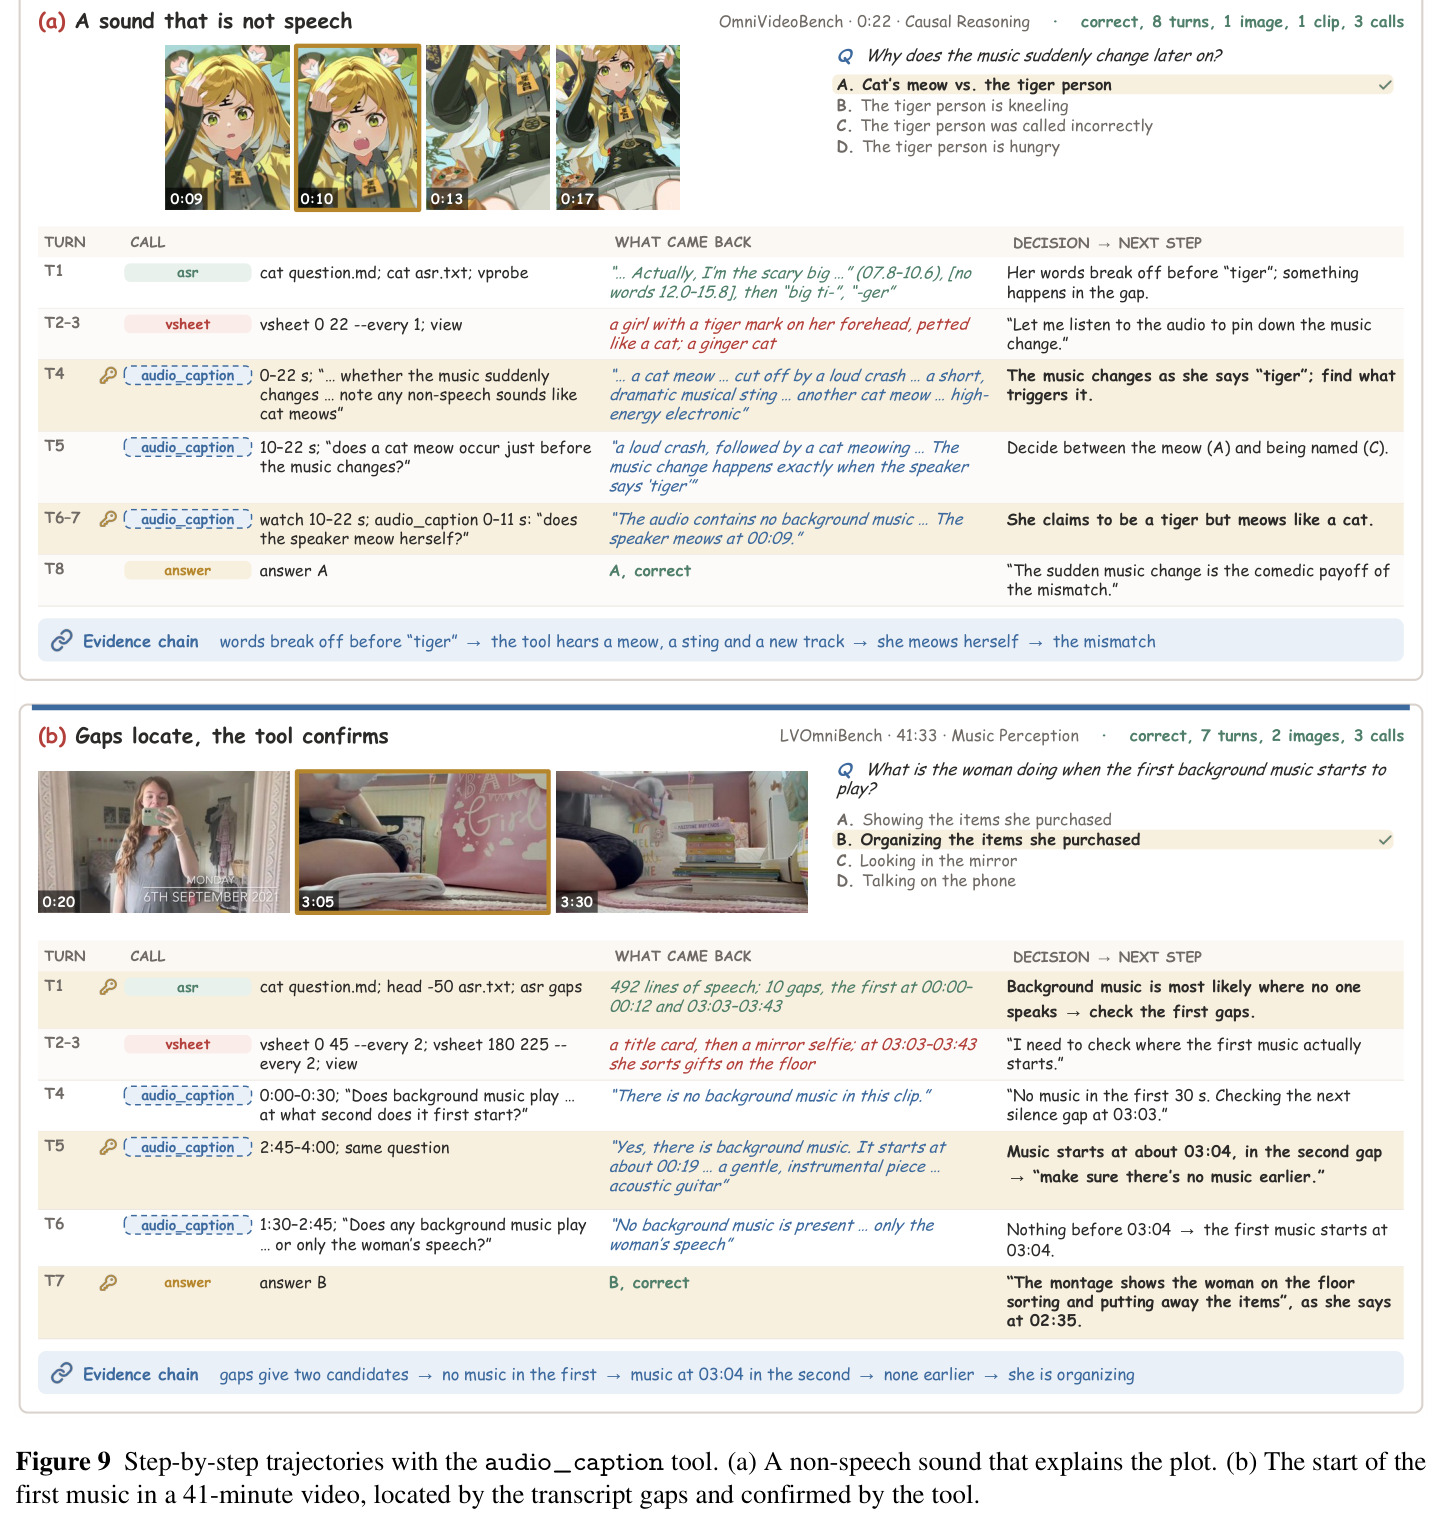
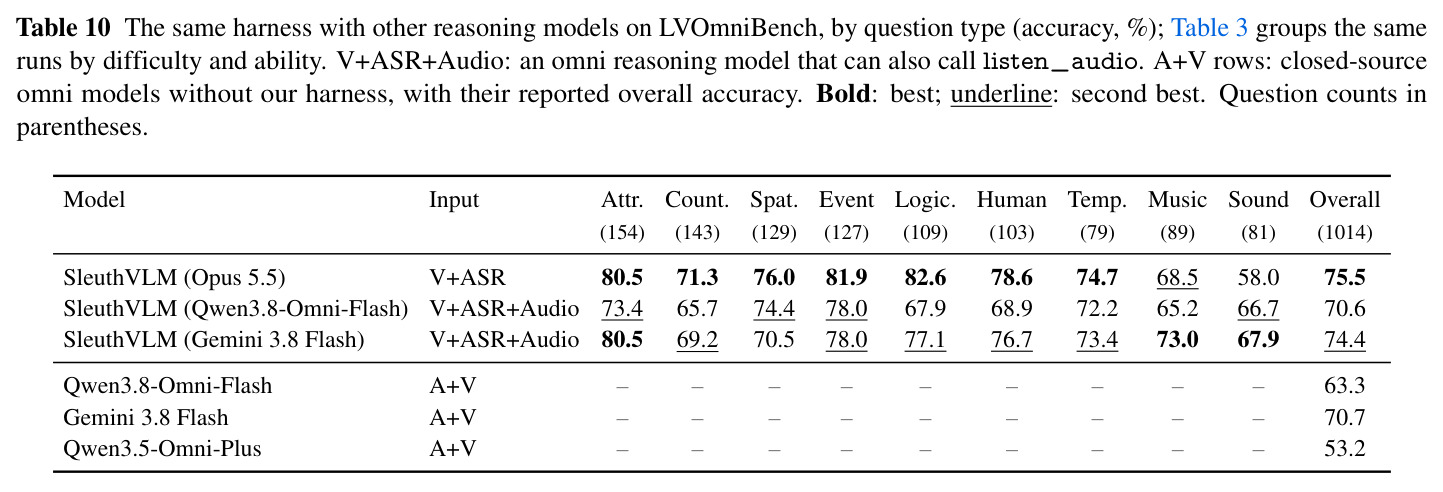
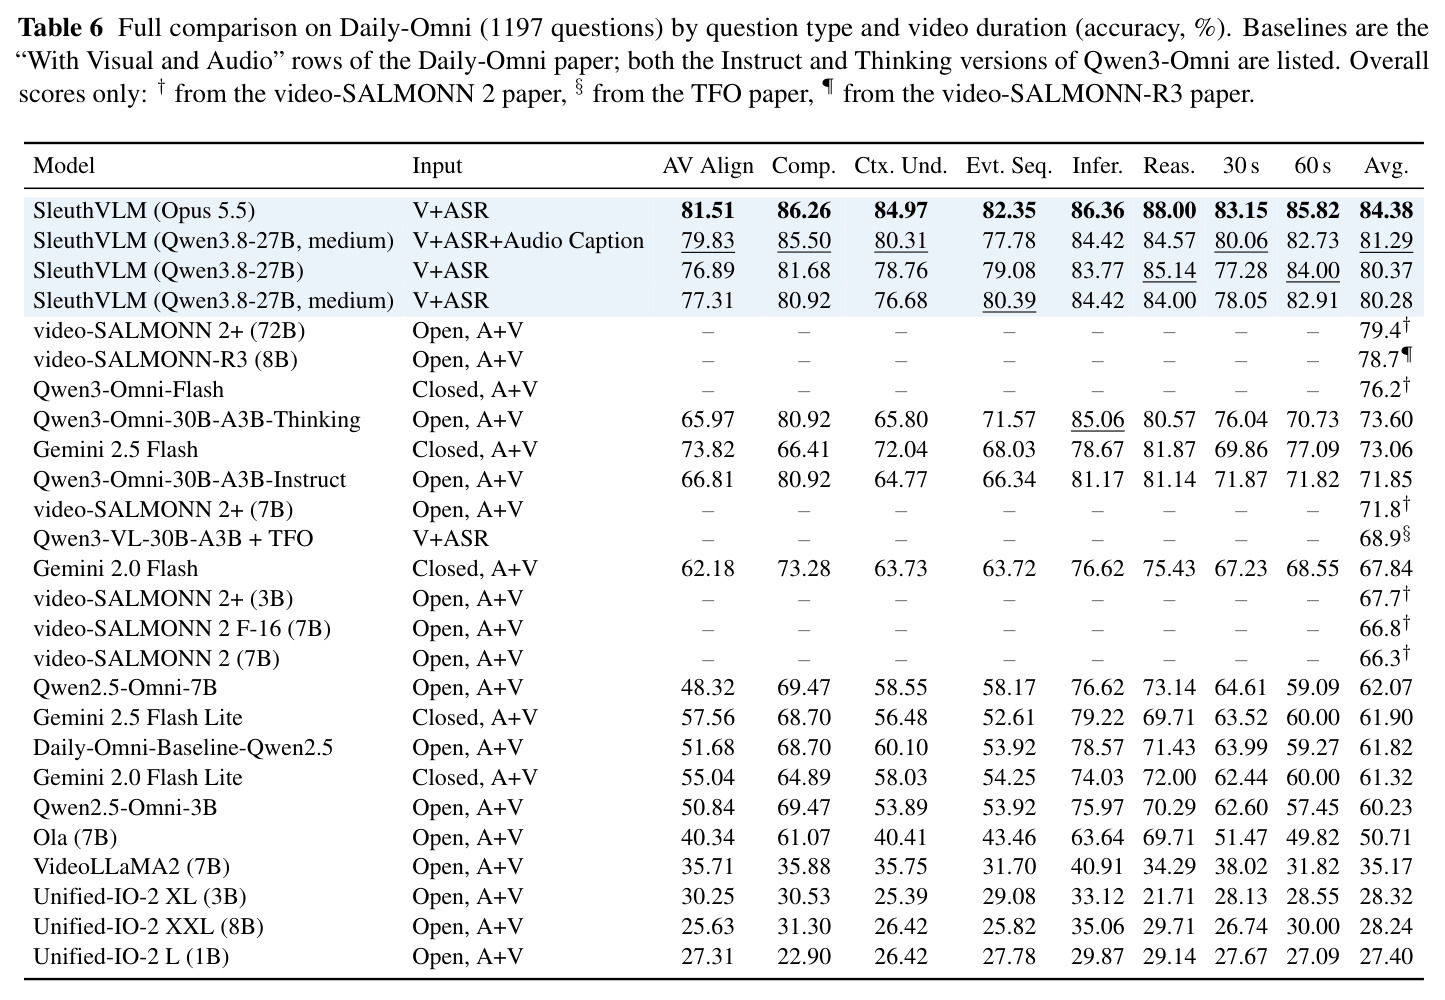
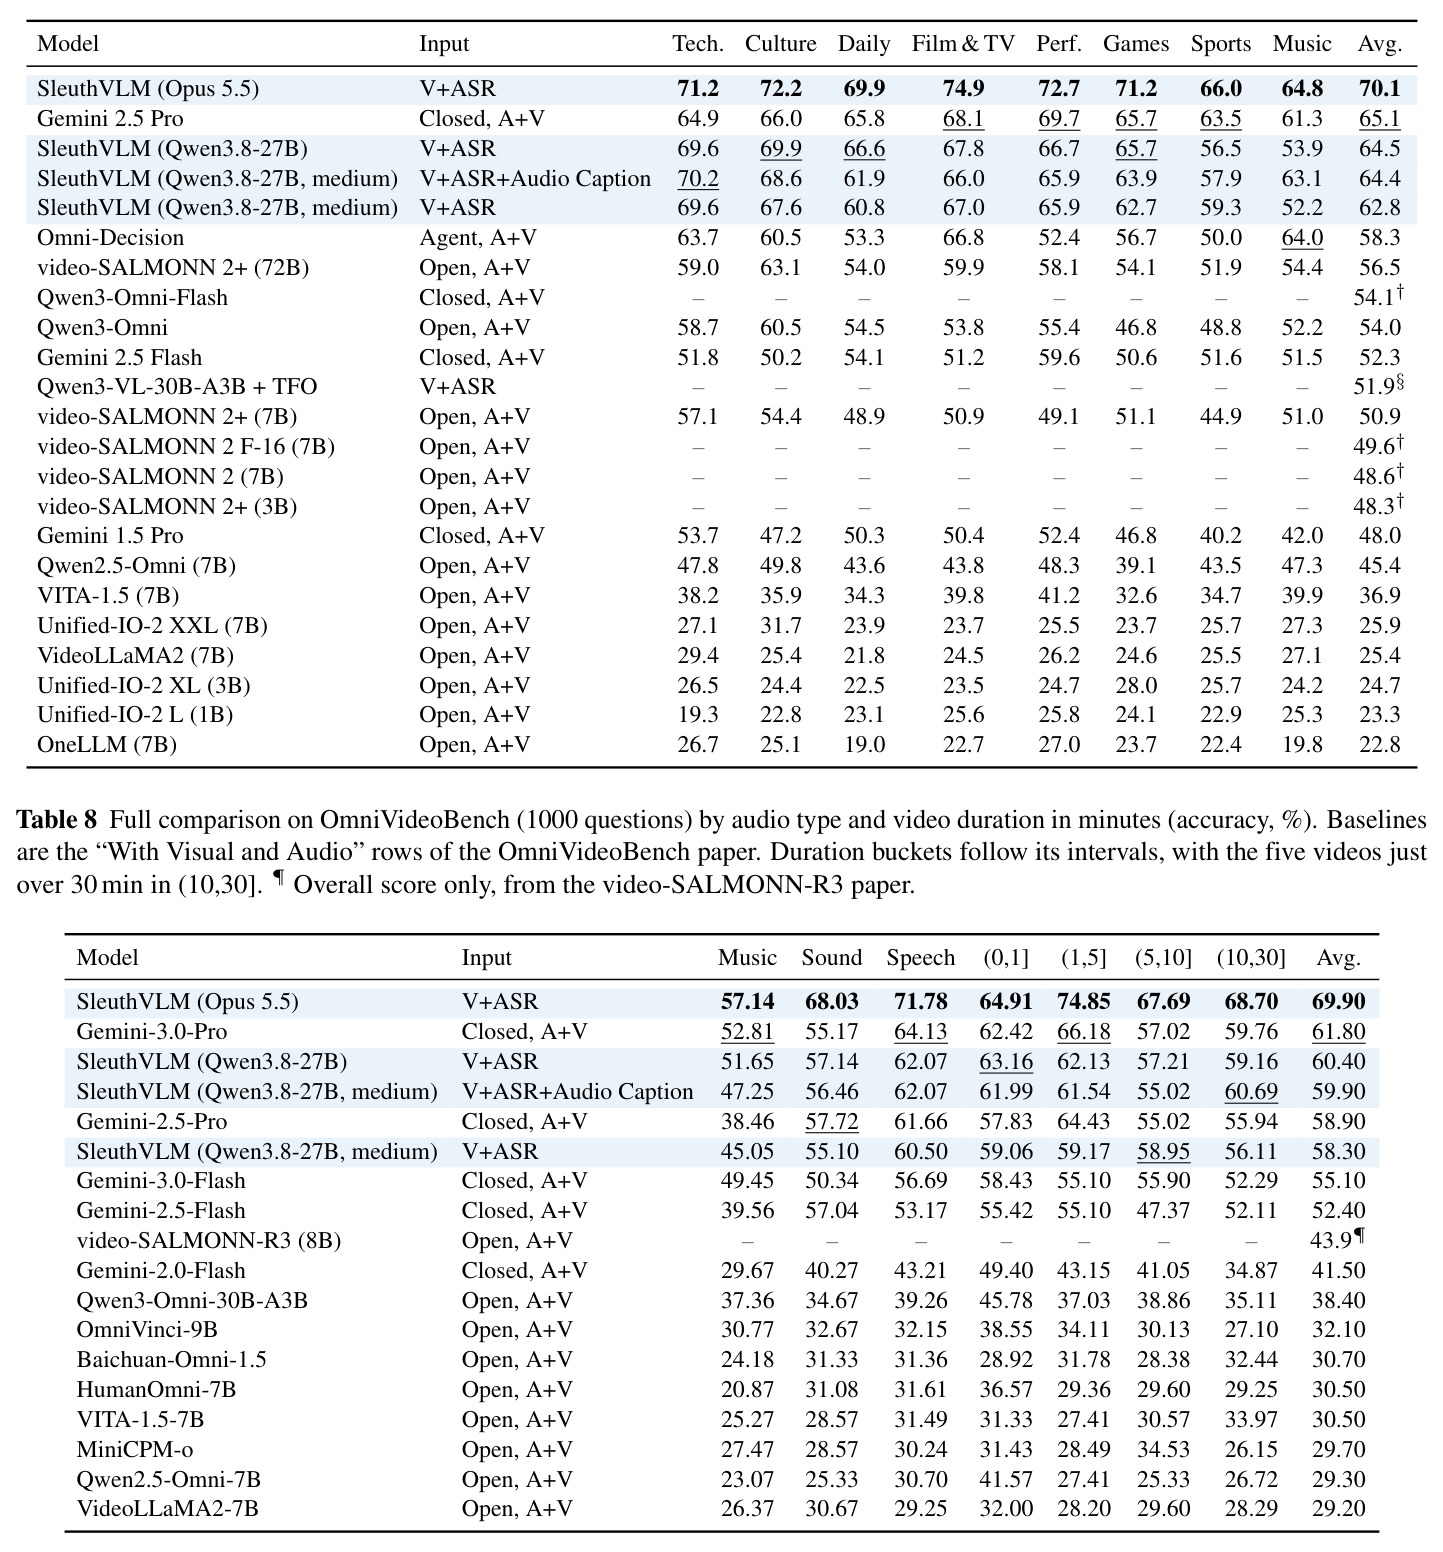
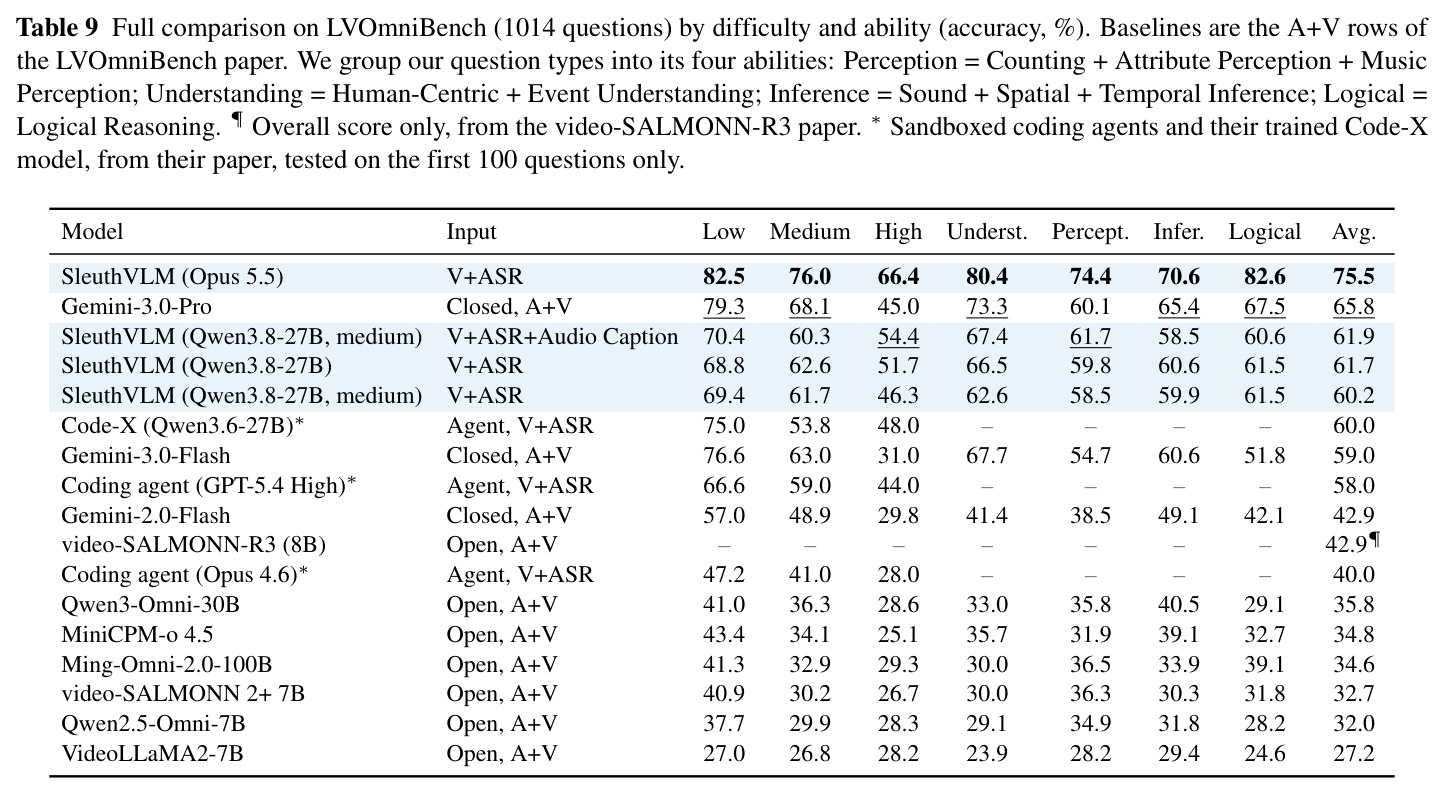
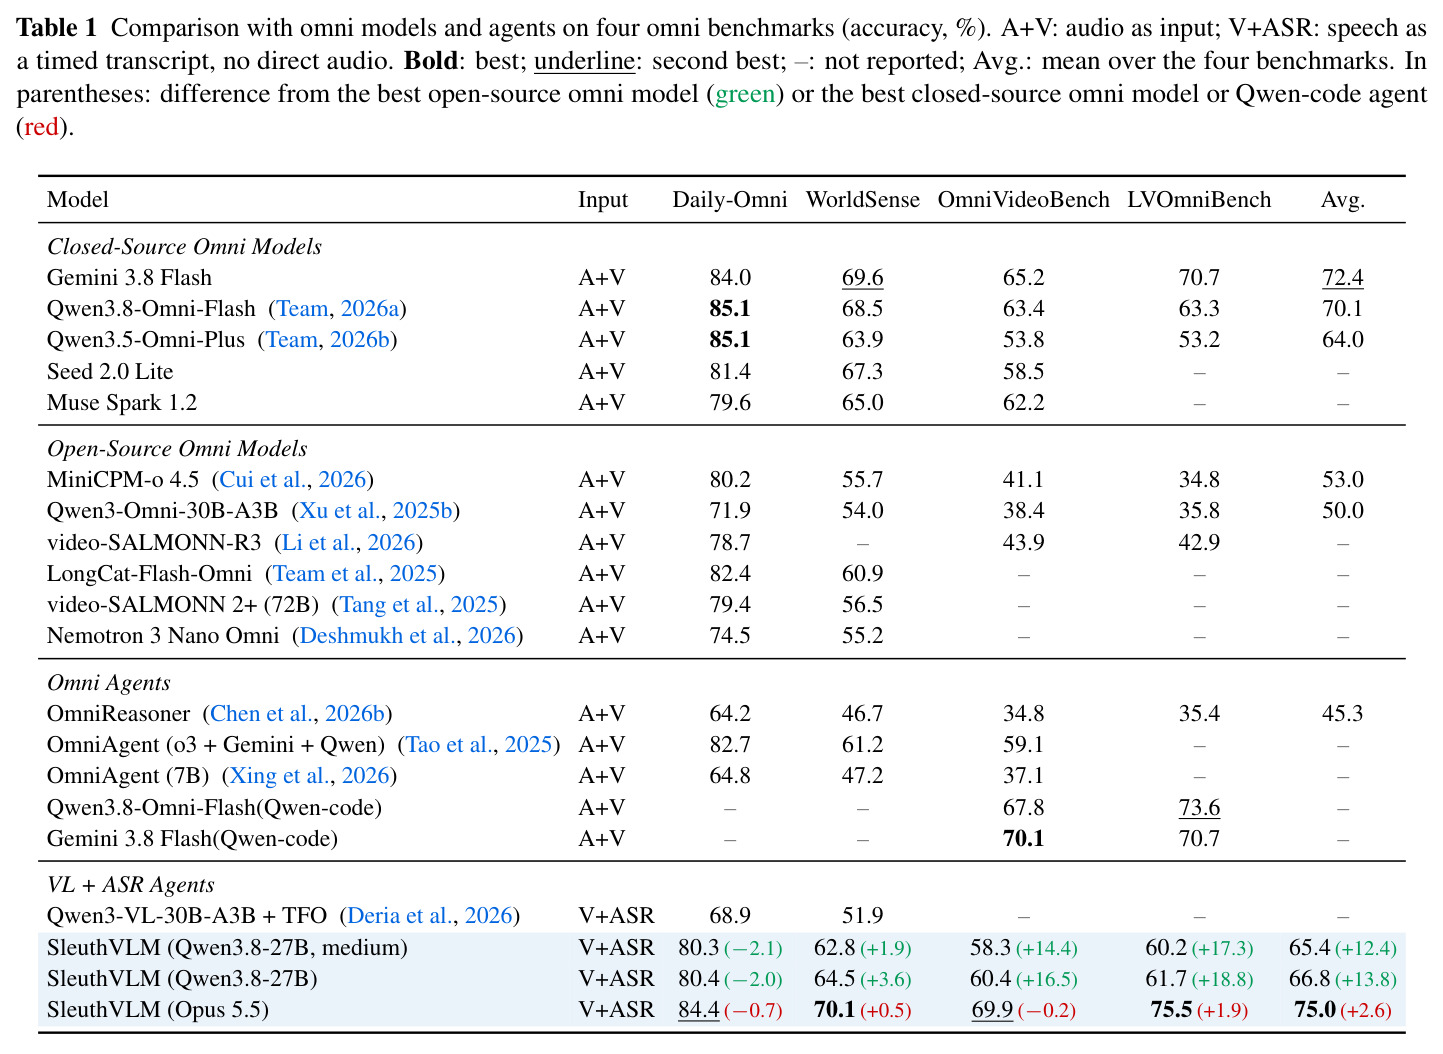
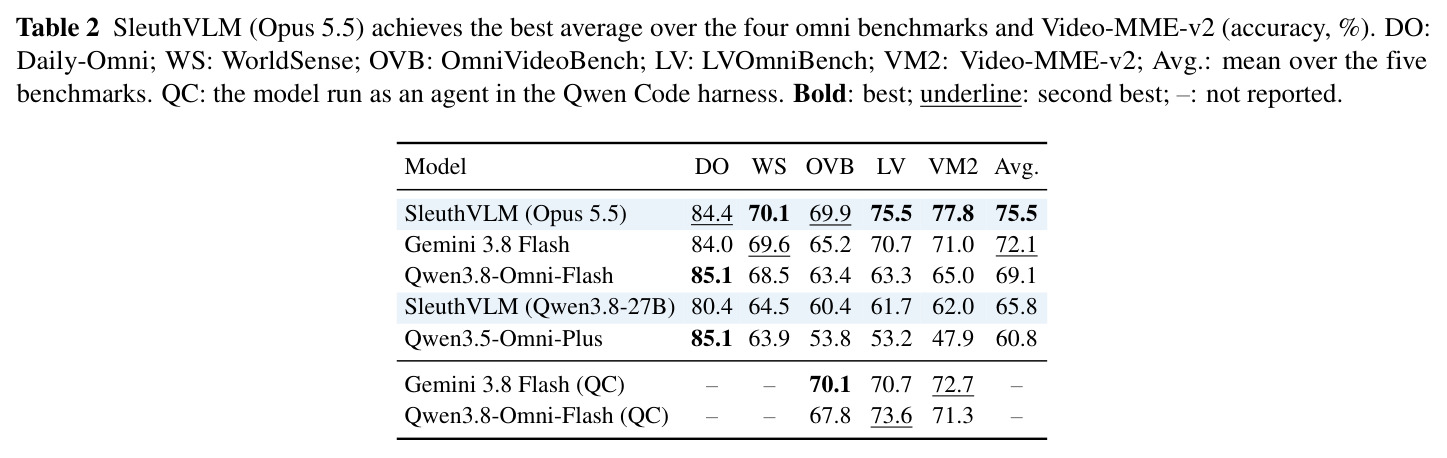
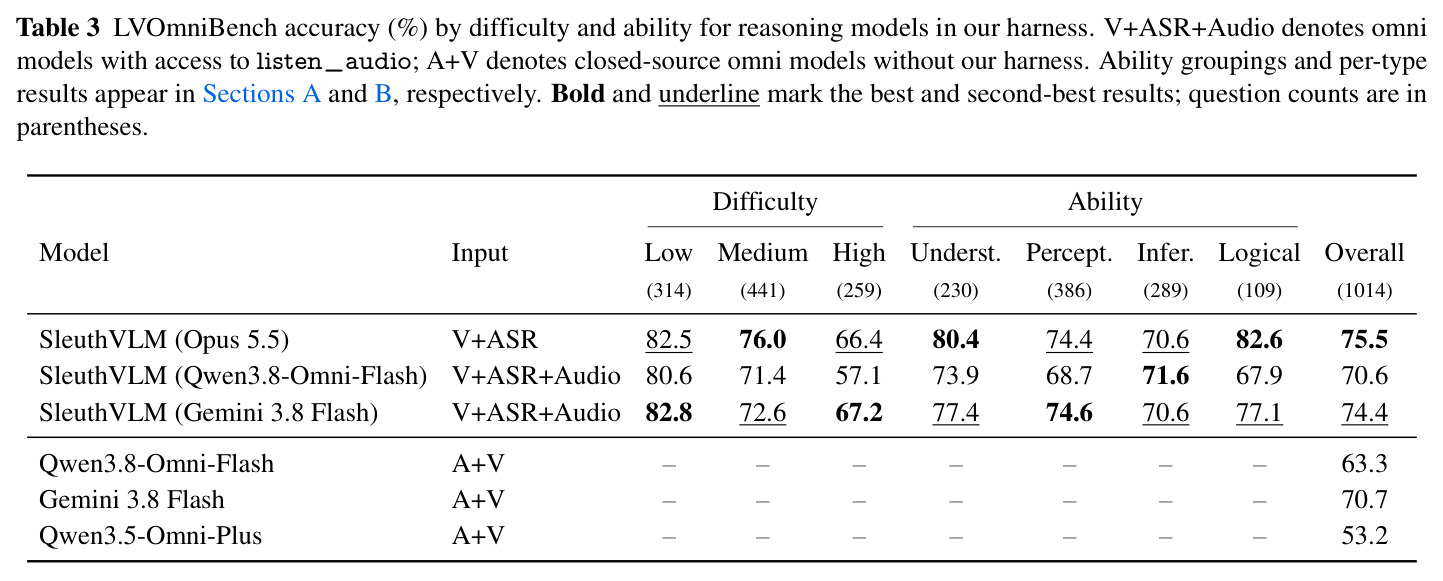
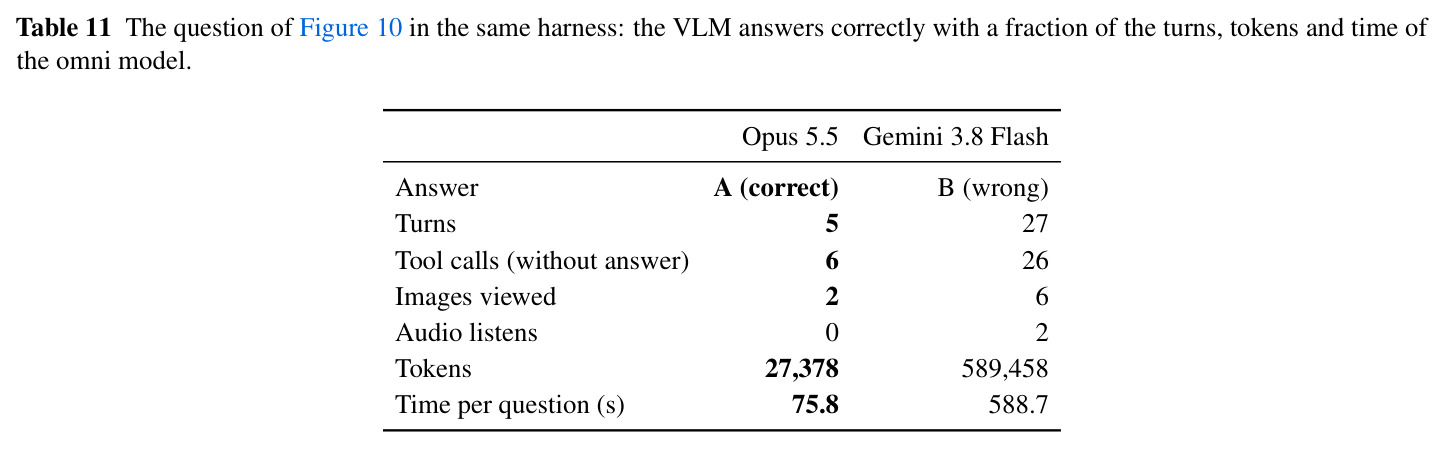
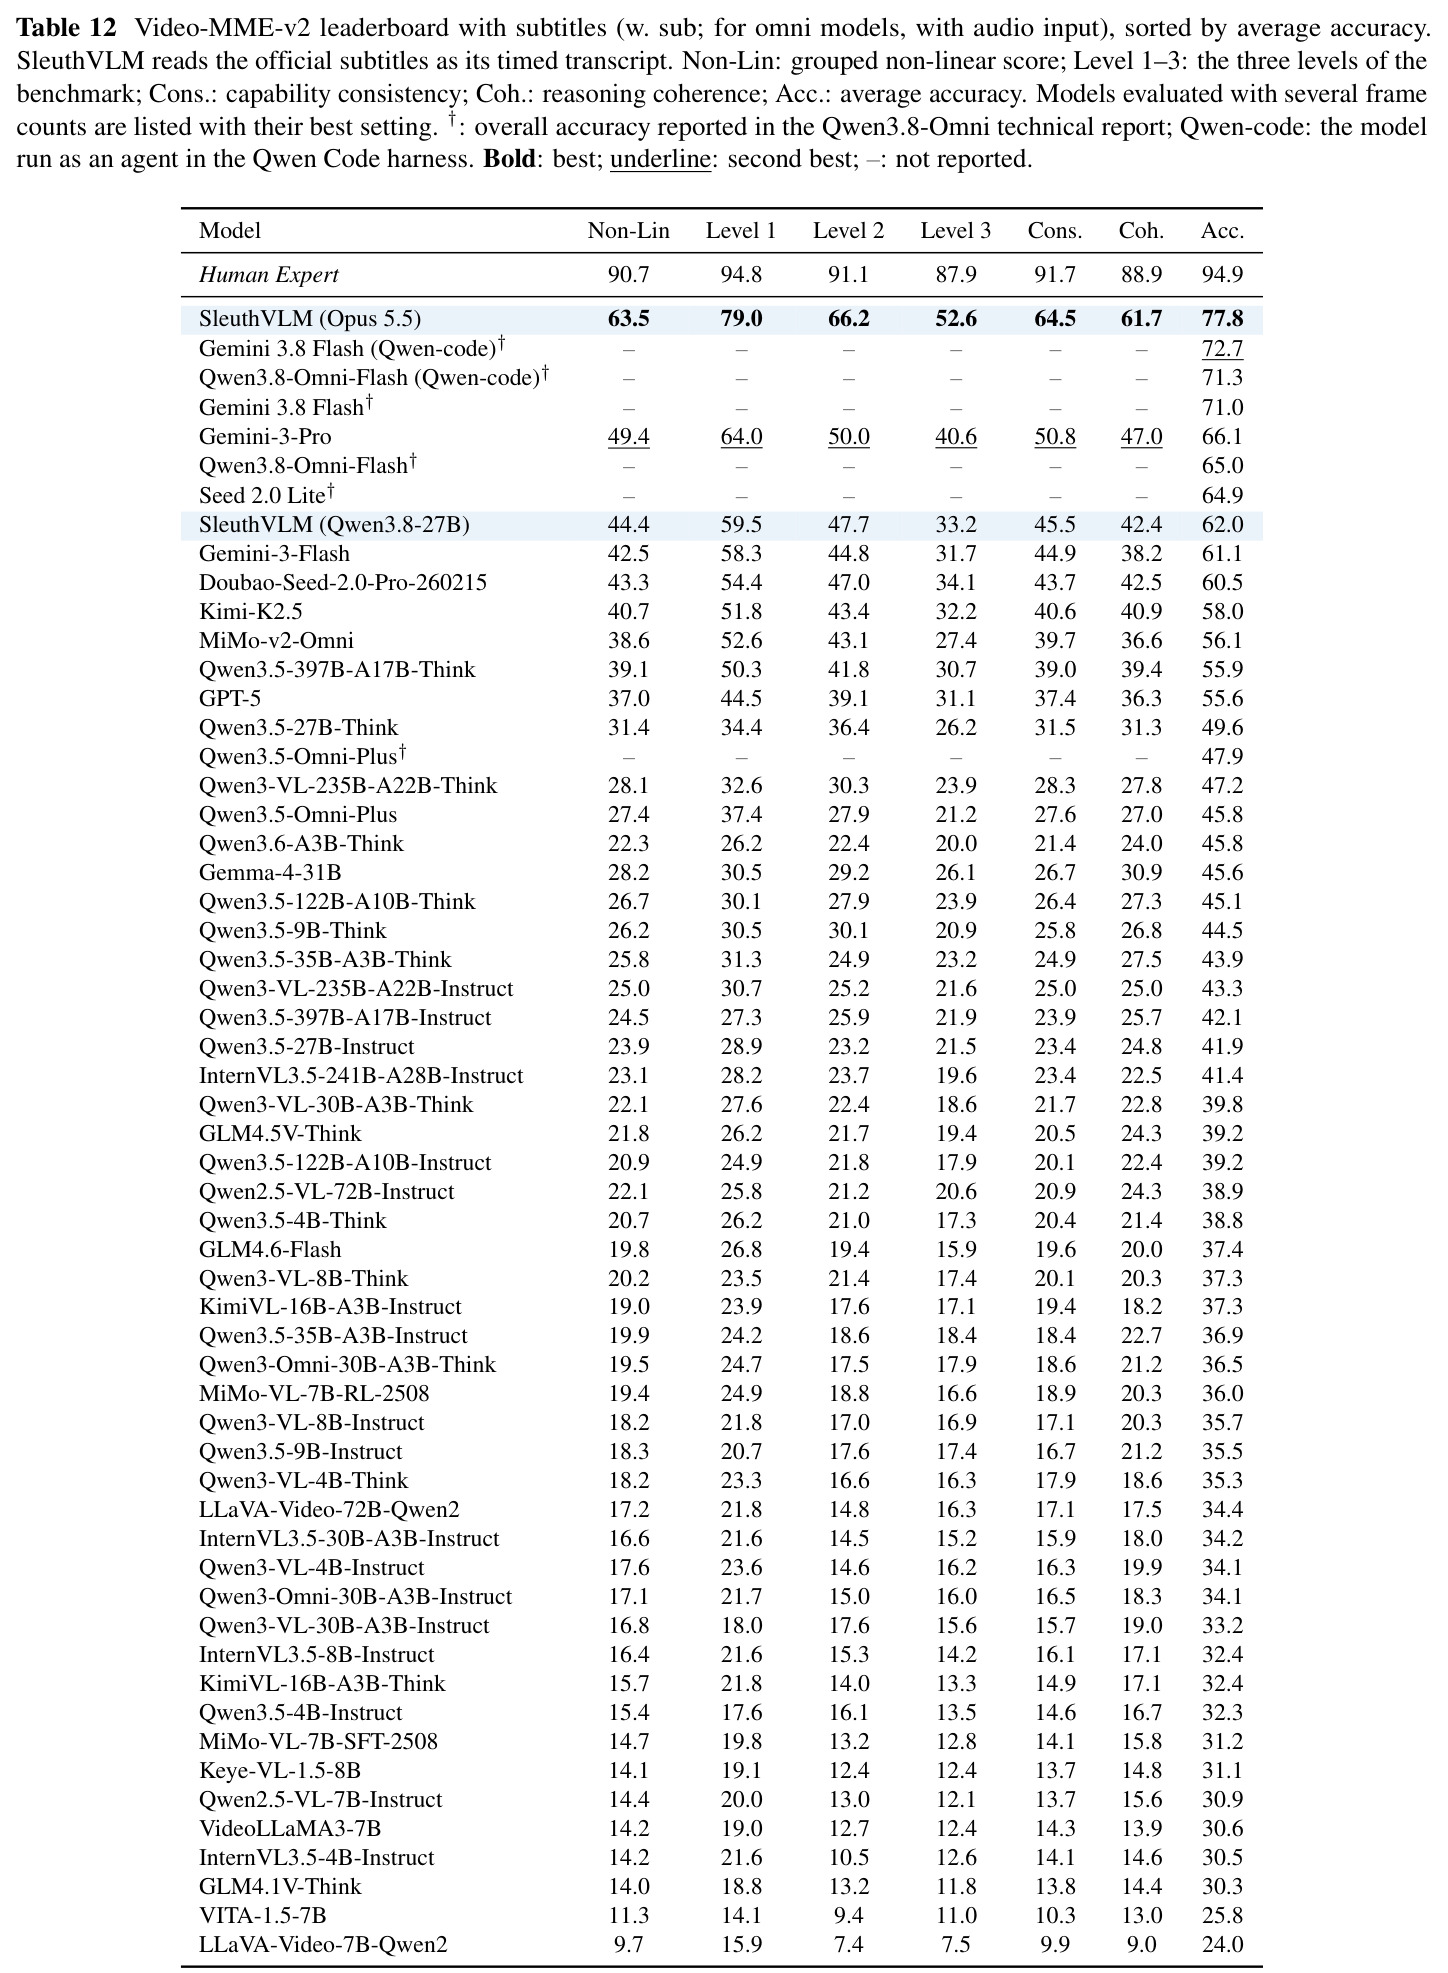
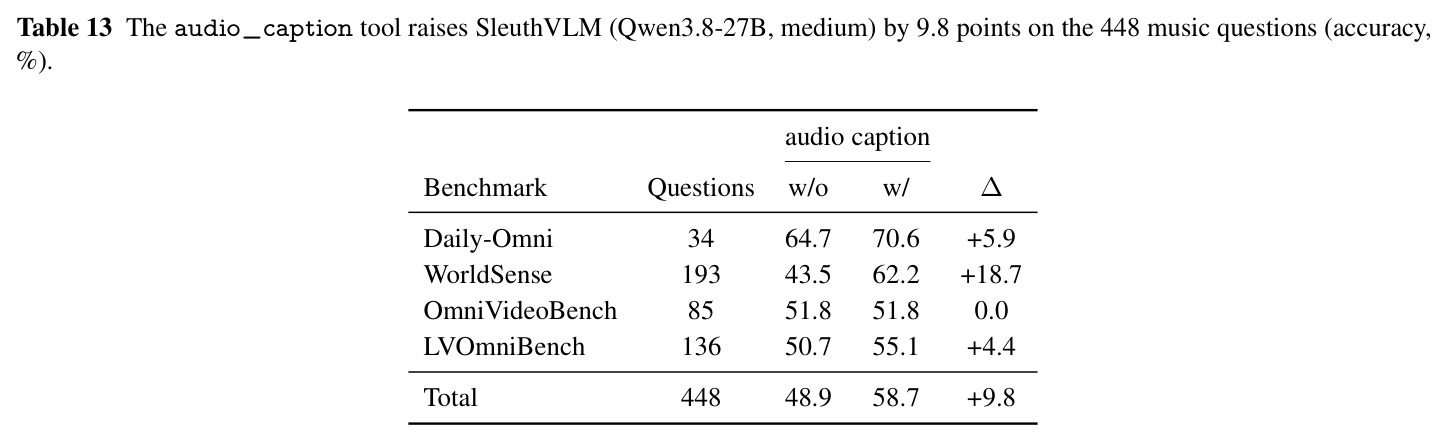
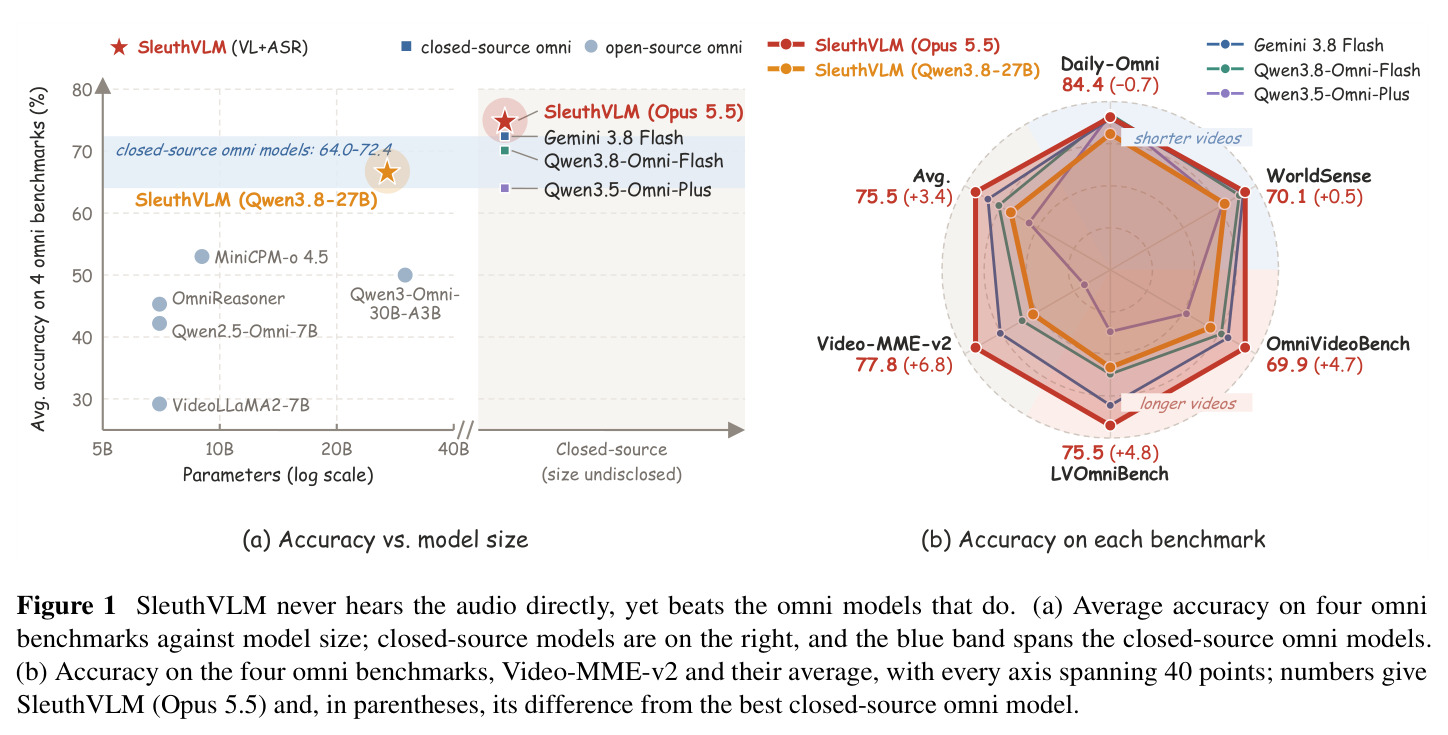
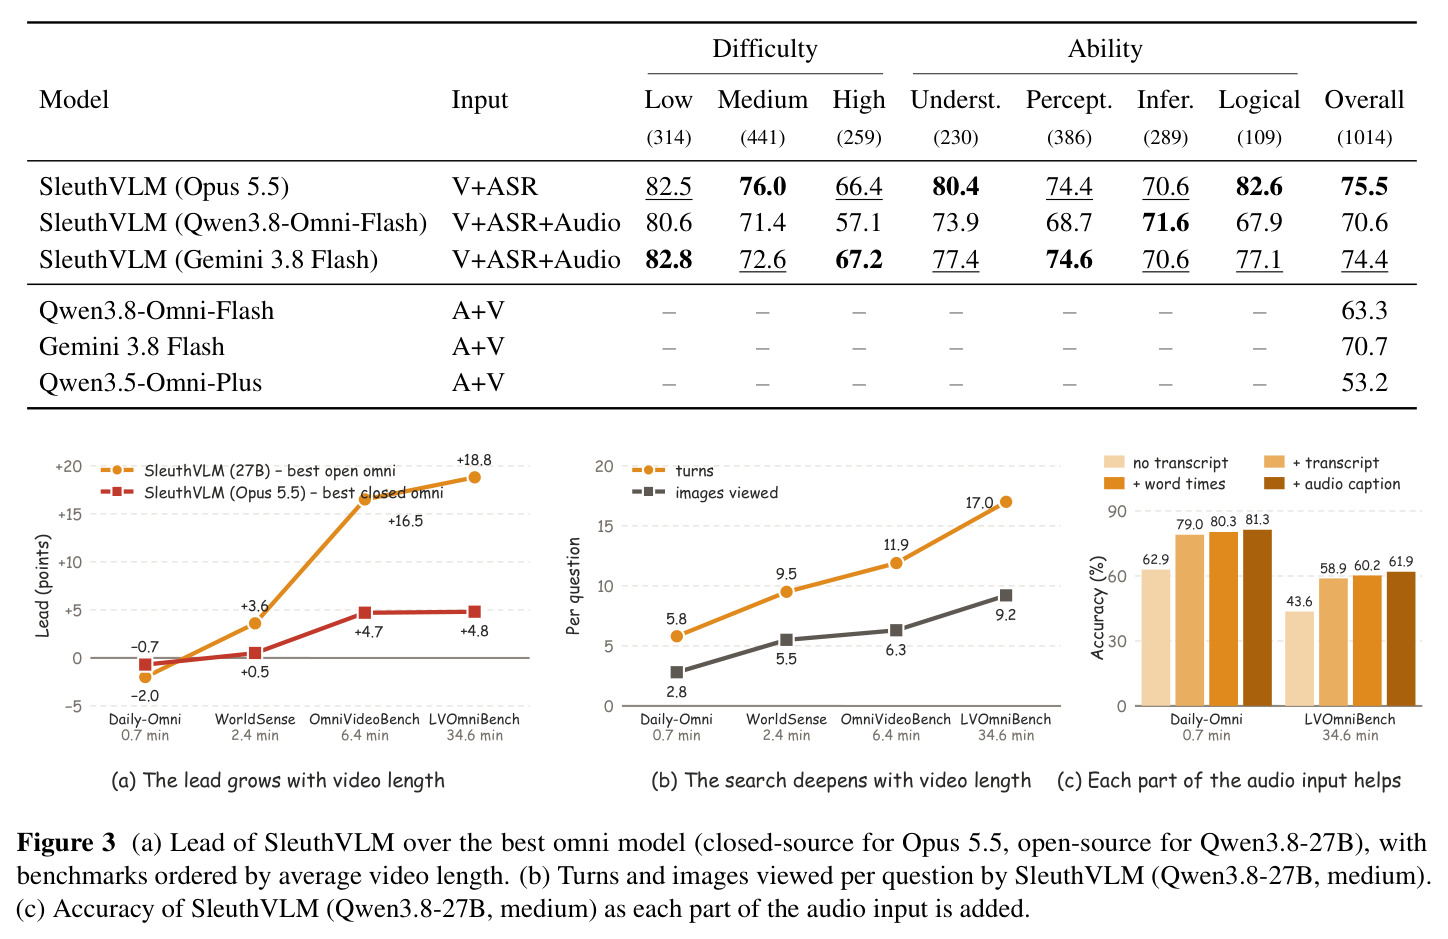
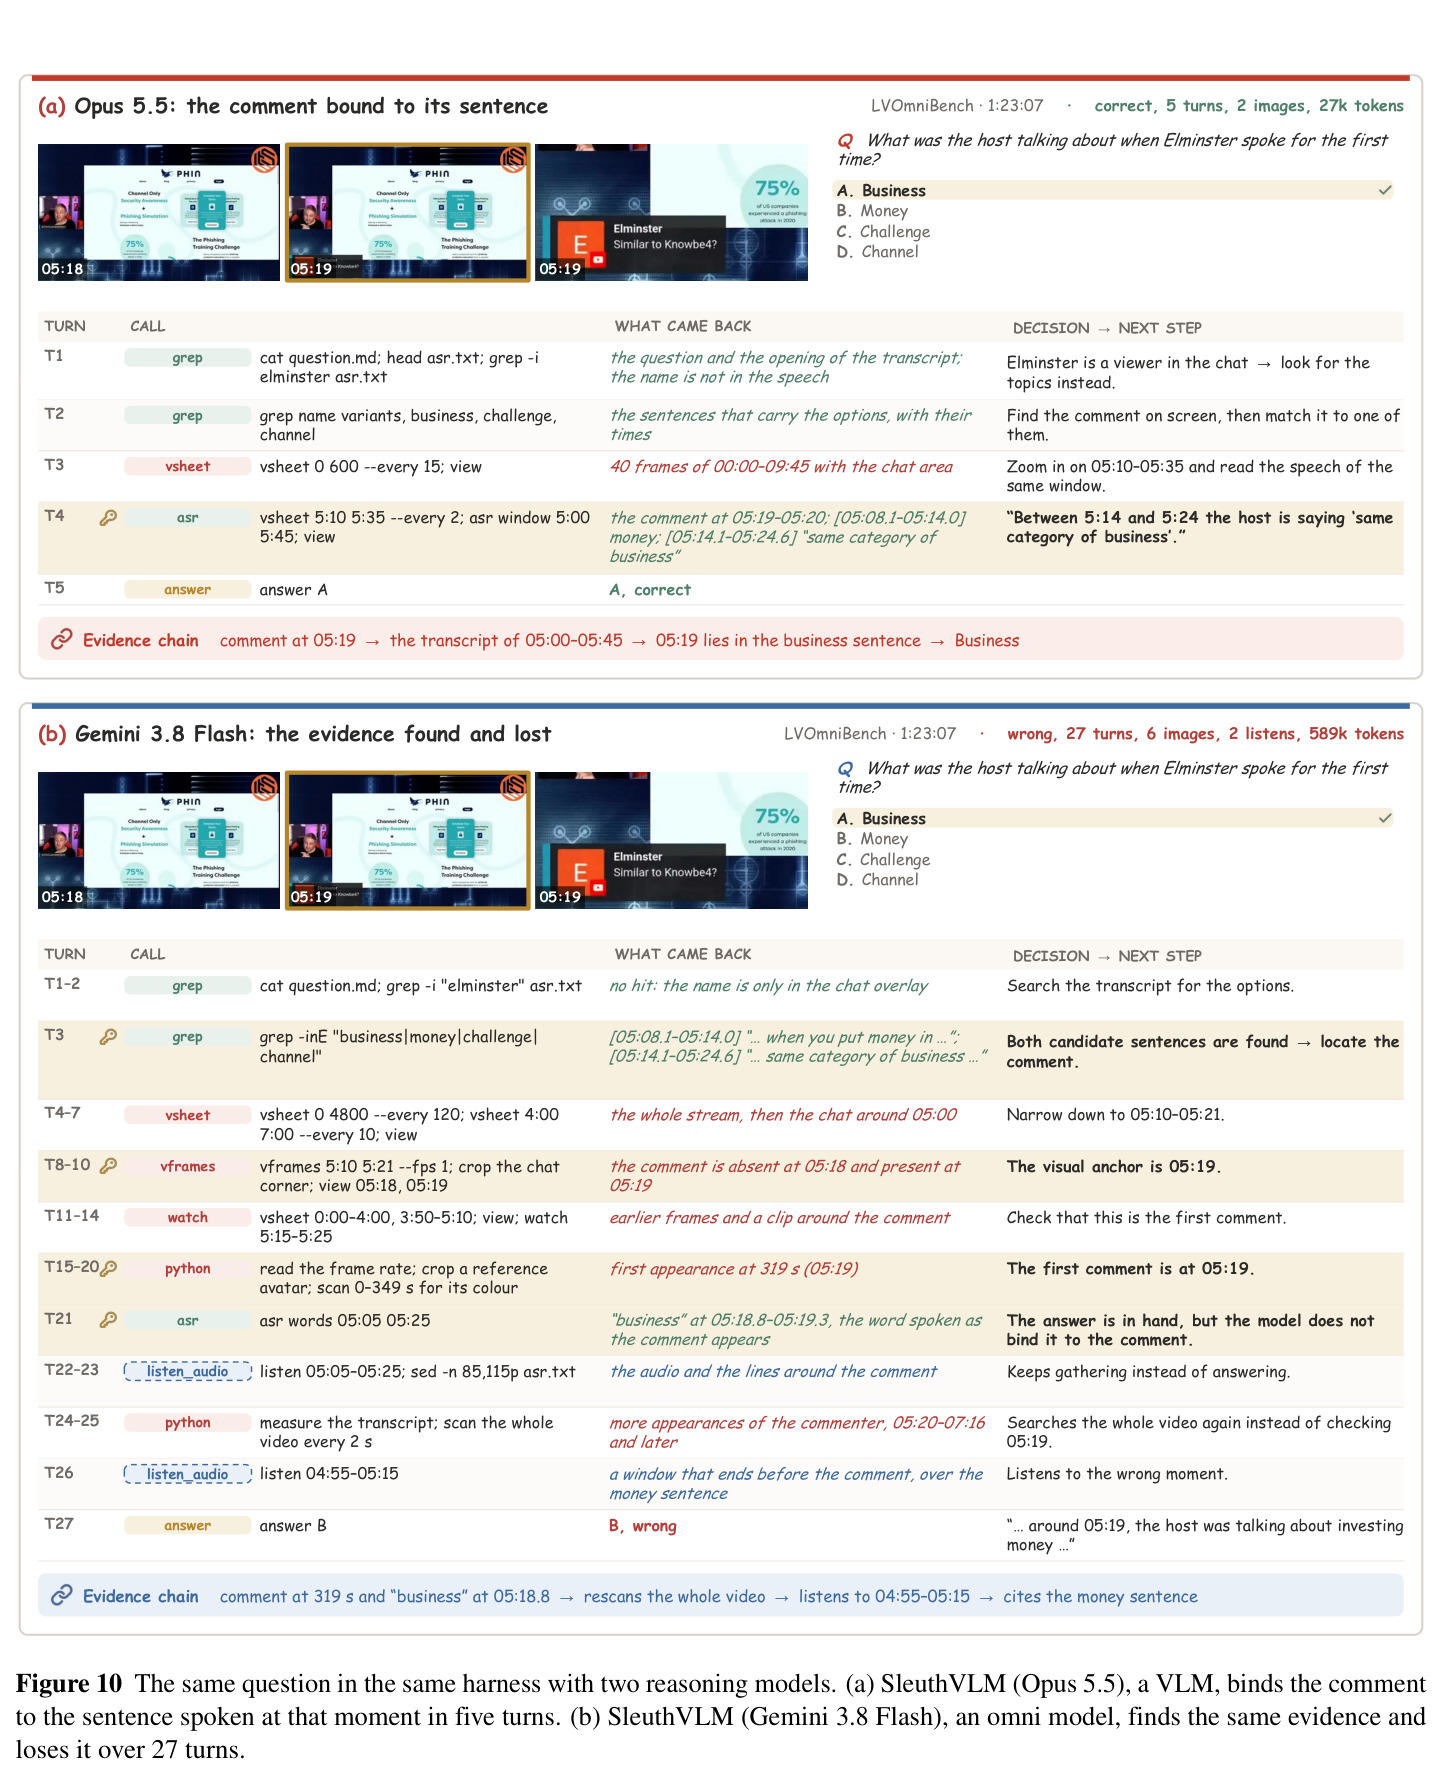
(1) 主榜:Opus 5.5 版四基准平均 75.0%,超最强闭源 omni 模型 Gemini 3.8 Flash(72.4%)2.6 个点,长视频领先更大(OmniVideoBench +4.7、LVOmniBench +4.8);开源 27B 版平均 66.8%,超最强开源 omni(MiniCPM-o 4.5 的 53.0%)13.8 个点。(2) Video-MME-v2 榜首:准确率 77.8%、非线性分 63.5 均第一,超 Gemini 3.8 Flash 6.8 个点。(3) 消融:去掉转录两基准掉 17.4/16.6 个点,去掉词级时间戳各掉 1.3 个点,audio_caption 使 448 道音乐题涨 9.8 点。(4) 智能体对比:omni 模型进 harness 最多涨 10.3 个点,但带听音频工具的 Gemini 3.8 Flash(74.4%)仍低于纯 VLM 的 Opus 5.5(75.5%);同一道题上 Opus 5.5 用 5 轮、27,378 token 答对,Gemini 3.8 Flash 用 27 轮、21 倍 token 仍答错。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四个全模态基准平均(Daily-Omni/WorldSense/OmniVideoBench/LVOmniBench) | 平均准确率 (%) | 75.0(SleuthVLM + Opus 5.5) | 72.4(Gemini 3.8 Flash,最强闭源 omni) | +2.6 |
| Video-MME-v2 排行榜 | 准确率 (%) / 非线性分 | 77.8 / 63.5 | 71.0 / –(Gemini 3.8 Flash) | +6.8(准确率,榜单全部指标第一) |
| LVOmniBench(10–90 分钟长视频) | 准确率 (%) | 75.5(Opus 5.5);61.7(Qwen3.8-27B) | 70.7(Gemini 3.8 Flash);53.0(MiniCPM-o 4.5) | +4.8(闭源对比);27B 版超开源最佳 +13.8(四基准平均) |
| OmniVideoBench(平均 6.4 分钟视频) | 准确率 (%) | 69.9(Opus 5.5) | 65.2(Gemini 3.8 Flash);70.1(其 Qwen Code 智能体版) | +4.7(对比闭源 omni);超训练型 7B 智能体最高 +23.3 |
| WorldSense(平均 2.4 分钟视频) | 准确率 (%) | 70.1(Opus 5.5) | 69.6(Gemini 3.8 Flash);65.1(Gemini 2.5 Pro) | +0.5;音乐题加 audio_caption 后该基准 +18.7 |
| Daily-Omni(30/60 秒短视频) | 准确率 (%) | 84.4(Opus 5.5) | 85.1(Qwen3.8-Omni-Flash) | -0.7(唯一未超越的短视频基准) |
局限与改进
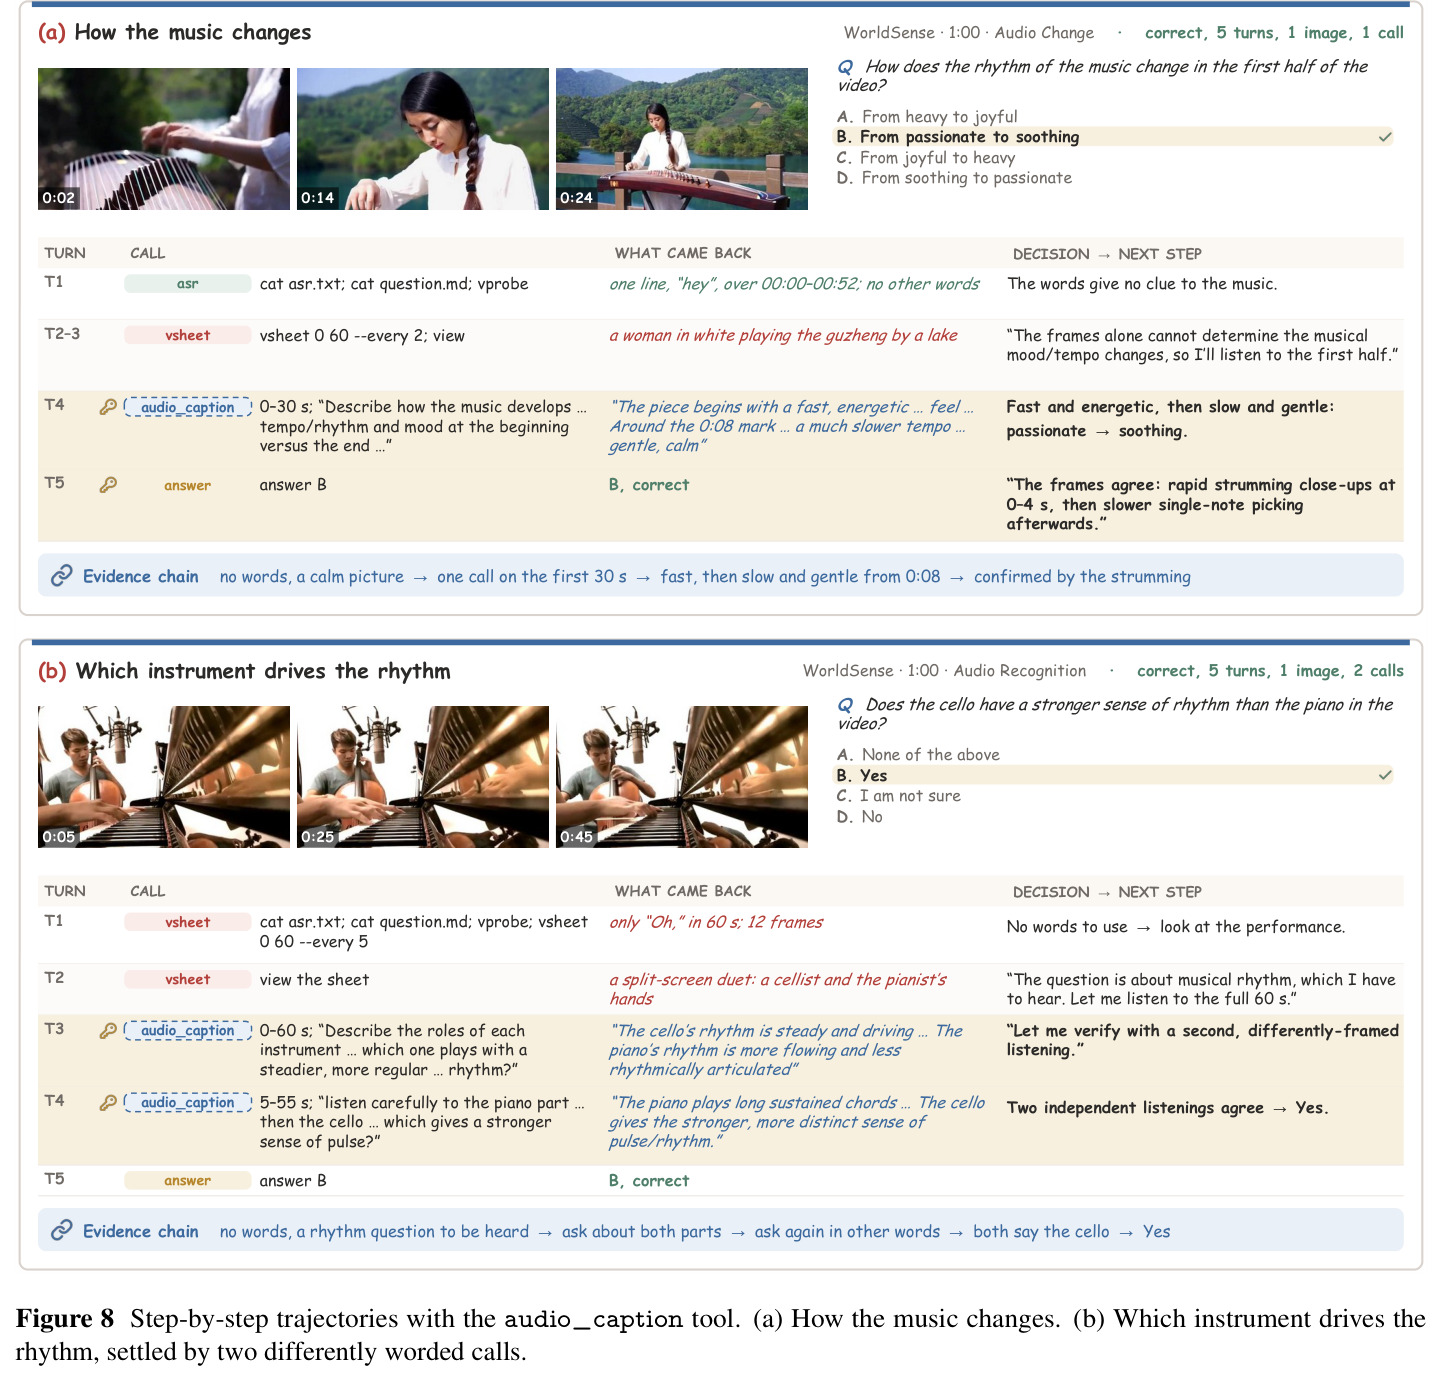
作者承认的局限:其一,转录质量决定上限——对齐器不支撑的语言只能退化为 30 秒块级时间戳,丢失词级文件;其二,非语音音频仍需外挂——音乐与音效占 LVOmniBench 问题的 24.8%,必须调用 Ming-3.0-audio-tiny(9.3B 参数)的 audio_caption 工具,即便如此 Opus 版在 Sound Inference 上仍只有 58.0%,是各能力类别最低;其三,Daily-Omni 上 84.4 略低于 Qwen3.8-Omni-Flash 的 85.1,短视频优势消失。我补充的观察:其一,推理成本高——预算上限 50 轮、30 分钟每题,中等强度下平均也要 5.8–17 轮,比单轮 omni 模型贵一个量级;其二,最强结果依赖闭源 API(Opus 5.5 比 27B 高 8.2 个点);其三,全部评测为四选一选择题,未覆盖开放式问答与时间定位输出;其四,Video-MME-v2 上直接读官方字幕而非 ASR 转写,条件与其他模型不完全对齐;其五,榜单对比多用各家报告数字,推理强度与帧数设置未必严格可比。
独立分析的弱点
弱点一:成本与延迟。智能体循环天然放大 token 消耗(案例中 omni 模型单题 58.9 万 token、589 秒),50 轮预算在流媒体、机器人等实时场景不可行。改进方向:学习“何时停”的提前退出策略、按难度自适应分配预算、并行工具调用、把长轨迹蒸馏成单次定位的小模型。弱点二:非语音音频是结构性短板。歌词可转录,但旋律、音色、节奏、说话人情绪等副语言信息全部丢失,音乐声音题只能依赖外挂 caption 模型,Opus 版音乐感知仅 68.5%、声音推理 58.0%。改进:接入更强的音频事件检测与音频 embedding 检索工具,或让 VLM 生成结构化听觉查询并做交叉验证。弱点三:ASR 鲁棒性。嘈杂场景、重叠说话人、强伴奏歌曲、口音都会污染转录,而转录一旦出错整个时间索引失效,论文只测了较干净的基准音频。改进:置信度感知转录、多 ASR 投票、用视觉线索辅助纠错。弱点四:强依赖底座智能体能力。27B 与 Opus 5.5 的 8.2 个点差距说明 harness 收益上限由推理模型的规划与证据绑定能力决定。改进:用强化学习针对工具使用做后训练,专门提升小模型的搜证策略。
未来方向
作者提出的方向:Qwen3-Omni、MiniCPM-o、video-SALMONN 等 omni 模型应把精力从“更多模态对齐数据”转向智能体能力建设,本文 harness 是一个简单有效的起点。基于其成果可延伸的研究:其一,用强化学习在可验证的视频问答任务上训练 VLM 的搜证策略(何时检索、放大、停止),并把 Opus 级轨迹蒸馏进开源模型以缩小 8.2 个点的差距;其二,超越 ASR 的多模态索引——视觉场景图、对象轨迹表、音频事件表,让“转录即索引”升级为“多模态记忆索引”,进一步降低帧数开销;其三,流式与在线版本,支持边播边答和有限回看缓冲;其四,把 audio_caption 与主控 VLM 深度耦合,自动生成听觉查询并对多次听测结果做一致性校验(论文案例已出现两次独立听测交叉验证);其五,扩展到开放式问答、时间片段定位、主动感知等非选择题任务;其六,从机理上诊断 omni 联合训练究竟损失了哪些能力(案例指认了证据绑定、搜索收敛、自检三点),探索“先 VLM 后补听觉”的课程式训练。
复现评估
复现条件较为友好。代码承诺开源(github.com/WPR001/OpenOmniHarness,发表时标注 coming soon),项目主页已上线;方法无需任何训练,只需推理。开源组合为 Qwen3.8-27B + Qwen3-ASR-1.7B + Qwen3-ForcedAligner-0.6B,单张 H200 即可,vLLM 服务、每 GPU 并发 16 题;302 小时音频转写约 113 分钟;预算、采样参数与系统提示词结构在附录 C/G 给得较细,还公开了沙箱拦截规则与防泄漏审计方法(6,383 题、71,132 次调用全部核查);基准全部公开可得。难点有二:最强结果需调用 Claude Opus 5.5 API,六千多题、平均每题 6–17 轮的费用不低,且开源 27B 与 Opus 有 8.2 个点差距,无法完全复现 headline 数字;harness 细节(输出截断 8000 字符、prompt 超 110k 丢旧图、图像预算计数等)需仔细对齐才能匹配成绩。总体:开源版可完整复现,难度中等;闭源版结果可验证但成本可观。
论文图表