NitroFusion2:将对抗损失引入多模态扩散 Transformer 的文本流 NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers
以 MMDiT 文本流为对抗表示、按方面线索引导判别器,把文生图蒸馏压到 1-2 步
前置知识
多模态扩散 Transformer(MMDiT)与联合注意力
SD3、Z-Image 等文生图骨干采用的架构:文本与图像 token 不再用交叉注意力单向注入,而是通过 joint attention 双向交互。文本查询 $Q_T = H_T W_Q$ 对拼接键值 $K = [K_I; K_T]$、$V = [V_I; V_T]$ 做注意力,输出 $U_T = A_I V_I + A_T V_T$,图像信息 $A_I V_I$ 被直接写回文本 token 状态,因此文本流隐藏状态随所处理的样本而变化。
本文全部立论于此:只有文本流携带图像信息,附加在文本流上的判别头才能读出真假信号并给学生回传对抗梯度。
对抗扩散蒸馏(ADD)
少步生成的主流路线:冻结一个预训练骨干作判别器主干,在其中间特征上接轻量判别头,区分真实样本 $x_t$ 与学生样本 $\hat{x}_t$(经插值加噪到同一噪声水平),学生被训练去骗过判别头。代表工作 ADD(DINOv2 像素空间)、LADD(latent 空间)、NitroFusion(专家判别头集成)。
NitroFusion2 延续这一范式,但首次更换判别器读取的特征来源——从图像流换到文本流,理解原范式才能看清这次替换的意义。
Flow-matching 插值
rectified flow 类模型(如 Z-Image)的框架:数据 $x$ 与噪声 $\epsilon$ 的线性插值 $x_t = (1-t)x + t\epsilon$,$t=1$ 为纯噪声、$t=0$ 为干净数据。蒸馏时把参考与学生样本都插值到同一 $t$ 再比较,学生另有低噪声段回归损失 $\mathcal{L}_{fm} = \mathbb{E}_{t \le t_{fm}}[w(t)\|G_\theta(x_t,t,p) - x\|_2^2]$。
论文式 (1)(6) 与整个判别器输入构造都建立在这个插值上,不懂它就看不懂训练流程。
专家判别器集成
NitroFusion 提出的判别器组织方式:不用单一打分头,而是为不同噪声水平(本文中为不同方面 cue)维护多组专家头,每步随机抽取一组使用,并周期性重初始化头权重以防过拟合。本文沿用该设计:图像流与每个 cue 类别各备一个 3 头池子。
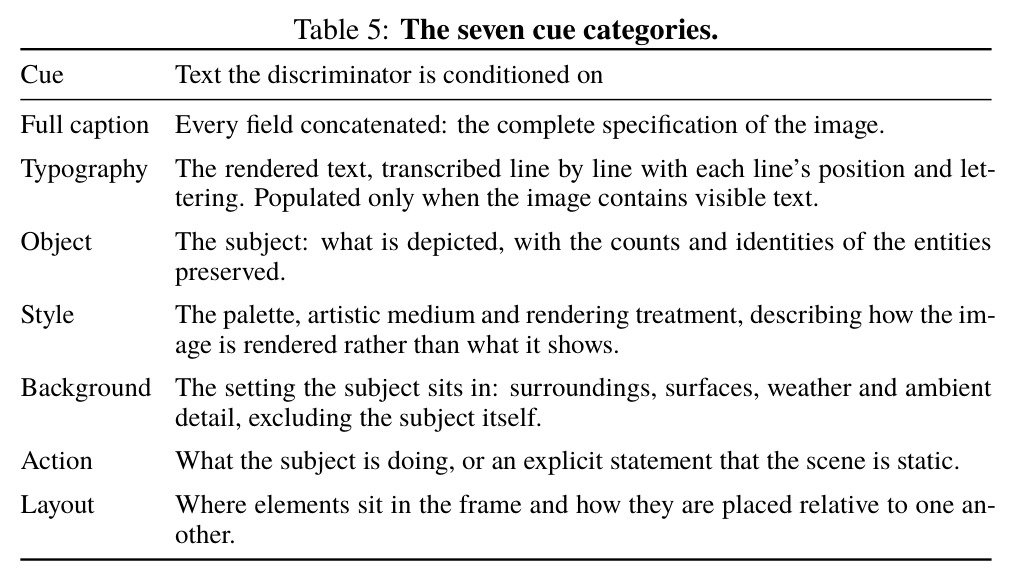
ACD 按 cue 路由文本流判别头正建立在专家头机制之上——没有它,7 类 cue 无法各配专属判别头。
Hinge 对抗损失
GAN 的另一种判别器目标(Geometric GAN):$\mathcal{L}_D = 2\,\mathbb{E}_{x_t \sim p_{real}}\max(0, 1 - \ell(x_t)) + \mathbb{E}_{\hat{x}_t \sim p_{fake}}\max(0, 1 + \ell(\hat{x}_t))$,把真样本 logits 推向 +1、假样本推向 -1;学生最小化自己样本的负 logits。相比交叉熵,hinge 只在越过边界时产生梯度,训练更稳。
论文式 (4)(5) 的对抗目标即 hinge 形式,是看懂学生与判别器交替更新的关键。
研究动机
对抗扩散蒸馏是少步文生图的主流配方,其目标函数、训练策略、判别头结构都已被反复改进,唯独「判别器读什么」从未被质疑:从 ADD、LADD 到 SDXL-Lightning、NitroFusion,判别头一律读取图像特征。这在交叉注意力 UNet 时代是必然——文本嵌入 $E(p)$ 与图像无关、全程固定,$\partial E(p)/\partial \hat{x}_t = 0$,根本不存在随样本变化的文本侧表示可供判别。与此同时,少步蒸馏的实践瓶颈依旧突出:把 6B 的 Z-Image-Turbo 压到 1 步,LongText-EN 从 8 步的 91.74 崩到 11.72、GenEval 从 75.01 降到 57.08,渲染文字几乎全毁;即便做到 2 步,最强的 Z-Image-Turbo++ 也要两套独立 6B 权重(合计 12B)才能把 LongText-EN 推到 89.88,成本翻倍。
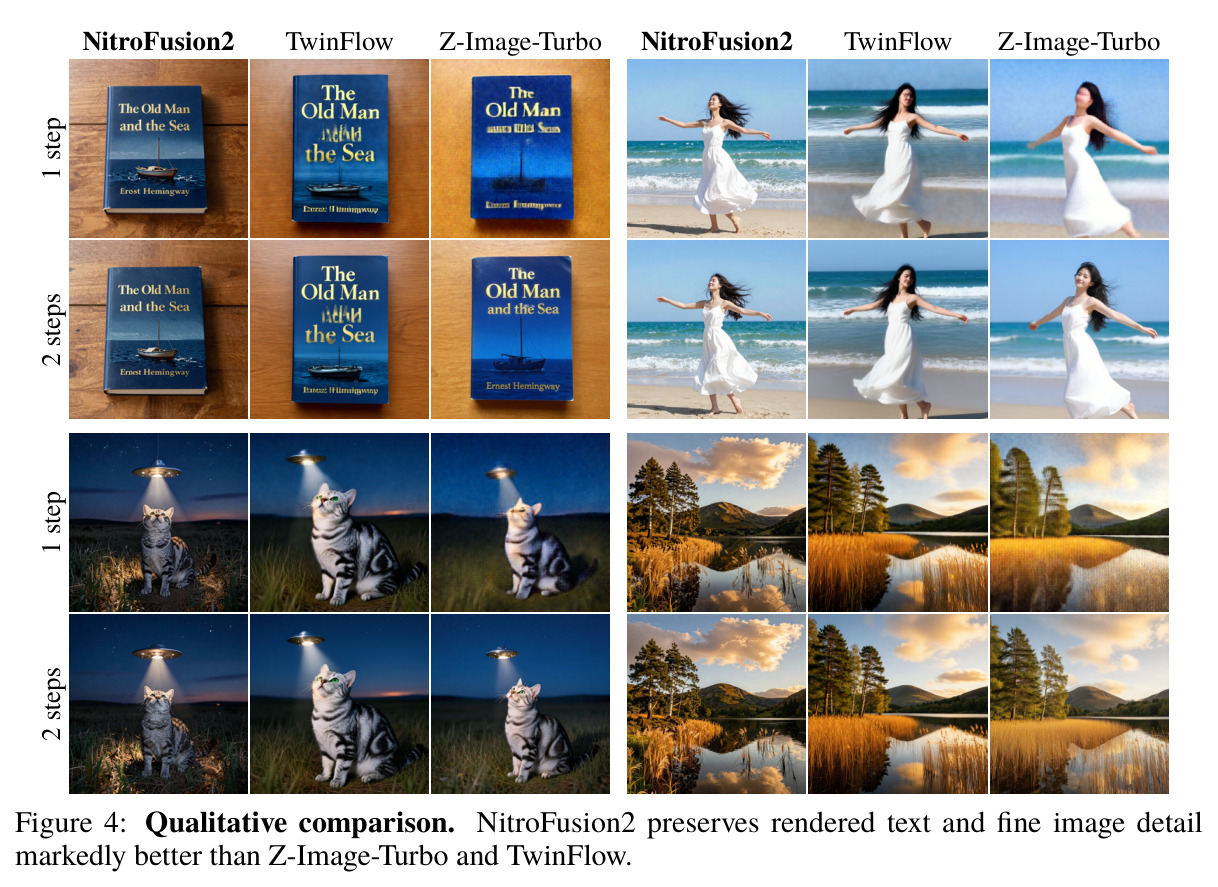
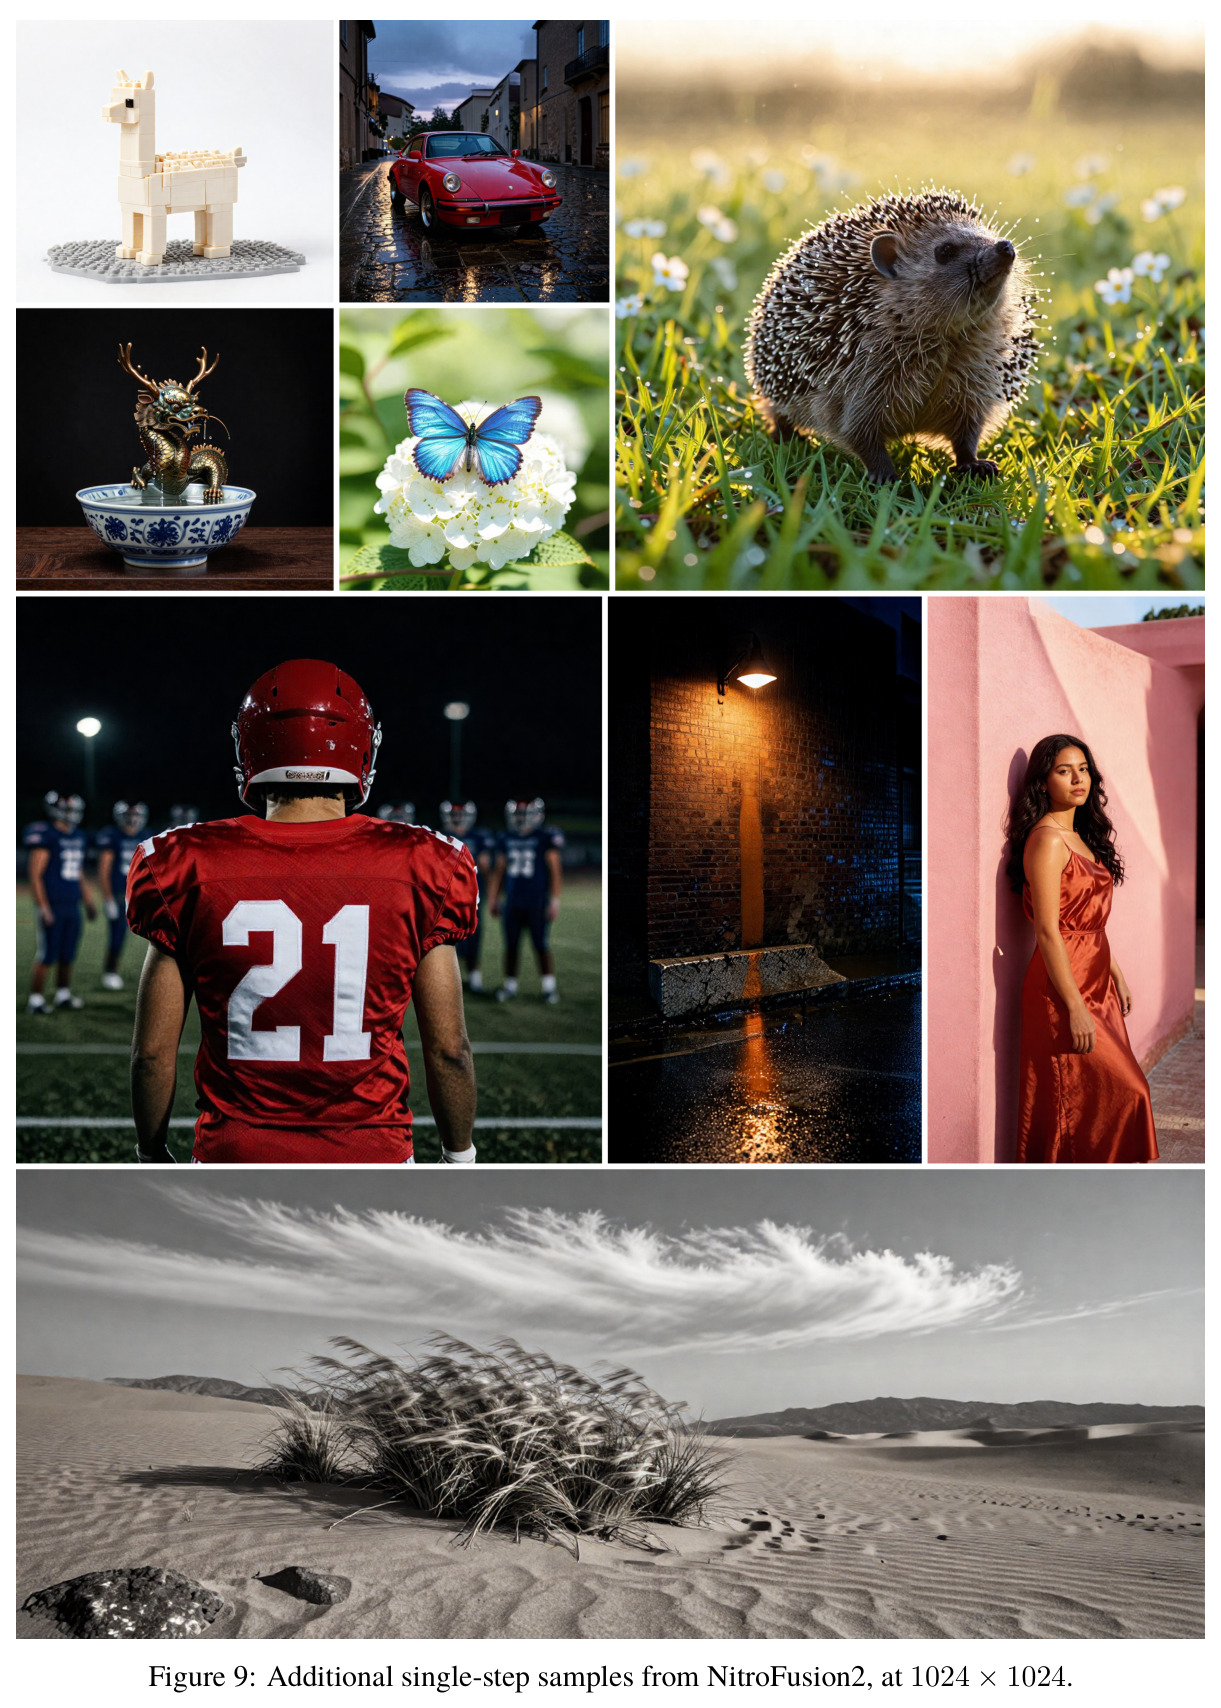
本文的目标是本文要回答的问题是:MMDiT 的文本流中间状态既然已经读过图像,能否直接充当判别器的特征来源?落点是 NitroFusion2——从 Z-Image-Turbo(6B)蒸馏出的单套权重学生:1 步生成要从蒸馏的压力测试变成实用选项,在 LongText-EN/CN、GenEval、DPG-Bench、OneIG 五个基准上全面超越 1 步基线,尤其要保住渲染文字和发丝、毛发、水面反射等细粒度细节;2 步则要追平传统 4-8 步蒸馏的水准,并以单一 6B 模型逼近使用 12B 参数、两套权重的 Z-Image-Turbo++。
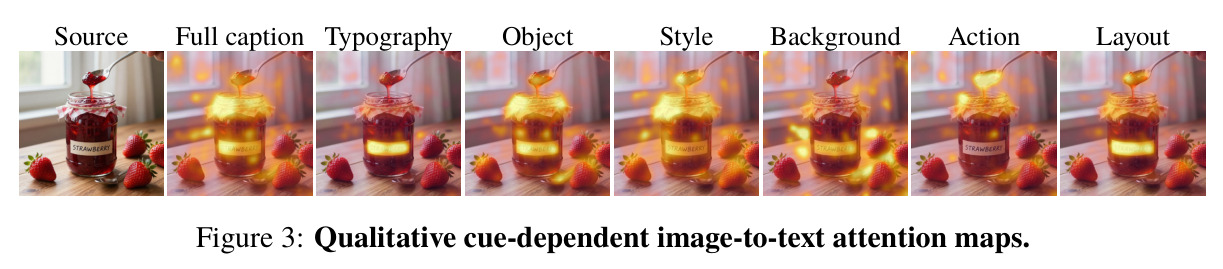
与已有工作不同的是,独特切入是发现并利用 MMDiT 一个被忽视的性质:联合注意力下文本 token 相当于对图像的查询,图像信息经 $A_I V_I$ 写回文本状态,使文本流成为「随样本变化、又与文本条件绑定」的表示。此前对 MMDiT 文本流的研究(ConceptAttention 概念定位、padding token 机制分析、TexTailor 推理时引导等)只用于分析、推理时控制或偏好奖励,从未直接充当对抗监督的特征空间。第二个巧思是判别器的文本条件可与学生 prompt 解耦:既然判别器读文本流,改判别器的条件文本就能改变文本流去图像里查什么——于是提出按 typography、object、style、background、action、layout 六方面提示判别器,把对抗信号定向调向指定属性。这种可操控的判别是只读图像流的方案原理上做不到的。
核心方法
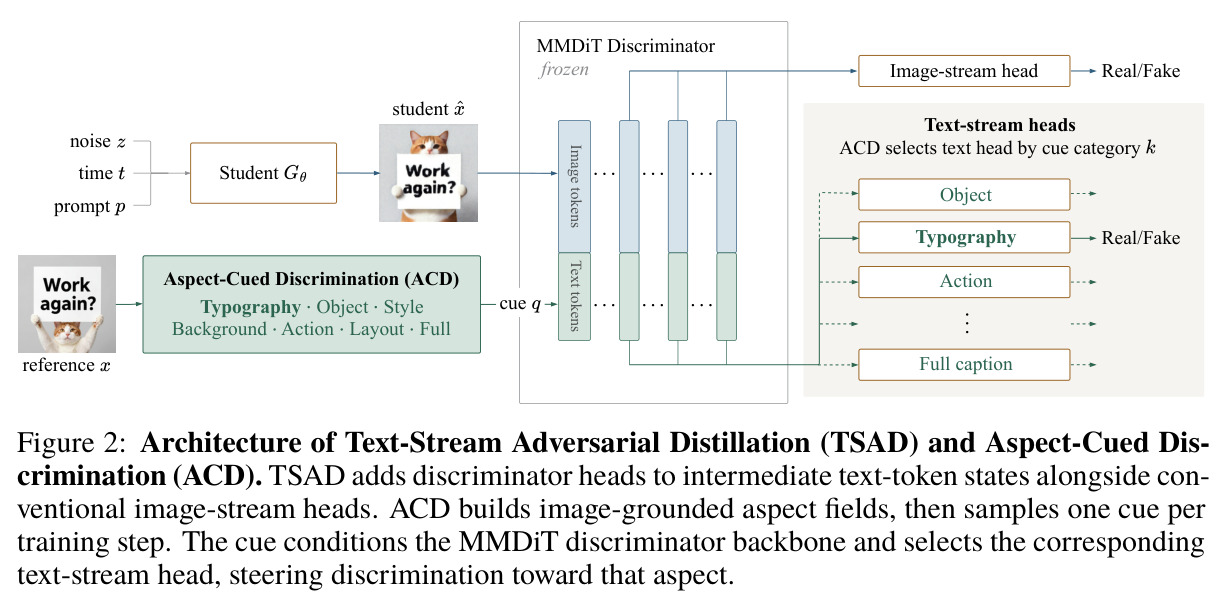
整体框架仍是对抗扩散蒸馏:学生 $G_\theta$ 从纯噪声一步出图,参考与学生样本经插值 $x_t = (1-t)x + t\epsilon$ 加噪到同一水平,送入冻结的 MMDiT 判别器主干(Z-Image-Turbo,6B)。两处核心改动:其一 TSAD——在选定层上同时给文本流注意力输出 $U_T$ 与图像流输出 $U_I$ 接轻量判别头,文本流头读的是已经读过图像的文本 token 状态;其二 ACD——每张参考图由 Qwen3.5-35B-A3B 仅看图生成六字段字幕,每步从有效 cue 集合(full caption 加全部非空字段)均匀采样一个 cue $q$,同时用作判别主干条件输入和文本流专家头的路由,学生仍以原 prompt 为条件。学生目标由文本流对抗项、图像流对抗项与低噪声回归项加权组成(权重均为 0.1,回归上限 $t_{fm}=0.75$);8 张 H100、batch 256、学习率 $5\times10^{-5}$ 训练 2 万步:5 千 off-policy,1.5 万 on-policy 去掉回归项。
核心洞察是「MMDiT 文本流已不只是条件,而是读过图像的判别性表示」。形式化地,文本查询对图像键值的注意力输出 $A_I V_I$ 直接写进文本 token 状态,使文本流特征随学生样本变化,判别器从文本流读特征才能给学生回传对抗梯度;这在交叉注意力 UNet 里不可能($\partial E(p)/\partial \hat{x}_t = 0$)。与图像流按空间位置描述局部外观不同,文本流沿 prompt 所指的语义轴汇总样本,因此对抗信号天然按语义组织而非按局部纹理组织。第二个创新 ACD 利用了「判别器条件可与学生 prompt 解耦」:同一个冻结主干,换一个 cue 就变成另一位专家评委(typography cue 强调渲染文字、style cue 强调画风),零额外前向成本;且 cue 同时决定文本查询读什么、并路由到对应专家头,两个耦合效应共同把对抗预算投放向指定属性。这是把「文本条件化判别」从 GigaGAN 时代的全局描述符条件推进到改变判别器读取内容本身的机制。
方法步骤详情
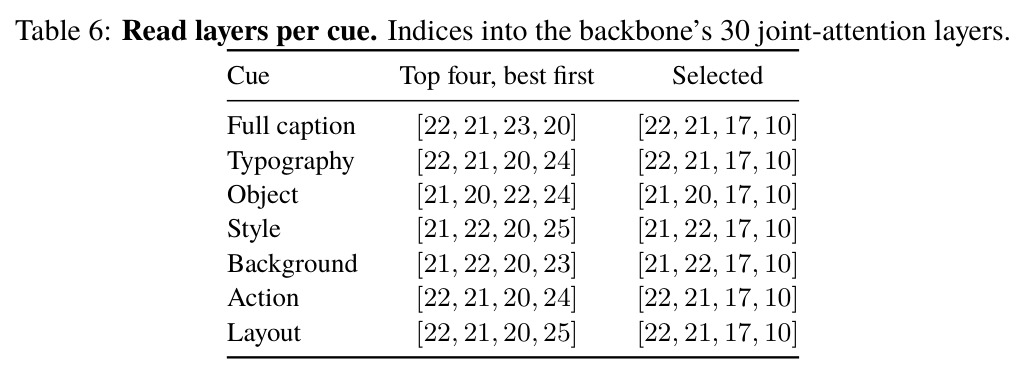
分五步。第一步造数据:用 12 步 Z-Image-Turbo 生成 10 万张约 1024×1024 参考图(中英文 prompt 各半),Qwen3.5-35B-A3B 仅看图写六字段字幕,内容缺失的字段留白。第二步选层:对 30 层联合注意力按各 cue 注意力图与 full caption 的偏离度打分,cue 差异在第 20 层后更大,文本流头读 [22, 21, 17, 10] 层,图像流头均匀放 [5, 13, 21, 29] 层。第三步每步训练:采样 $(x, c_{full}, p)$ 与噪声 $z$,学生出 $\hat{x} = G_\theta(z, 1, p)$;ACD 采样 cue 得条件 $q$,并从该 cue 的 3 头池随机抽文本流头。第四步更新判别头:$x_t$、$\hat{x}_t$ 各过一次冻结主干(条件均为 $q$),按 hinge 损失在两流输出上更新($\hat{x}_t$ 梯度截断),头周期重置防过拟合。第五步更新学生:按总目标下降,回归项仅在 $t \le 0.75$ 生效;on-policy 阶段改用自身 rollout 状态。
技术新颖性
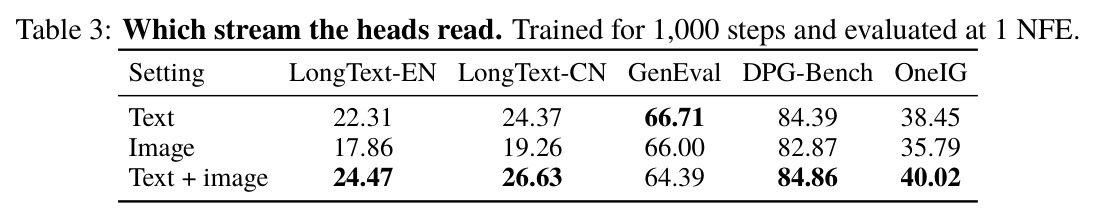
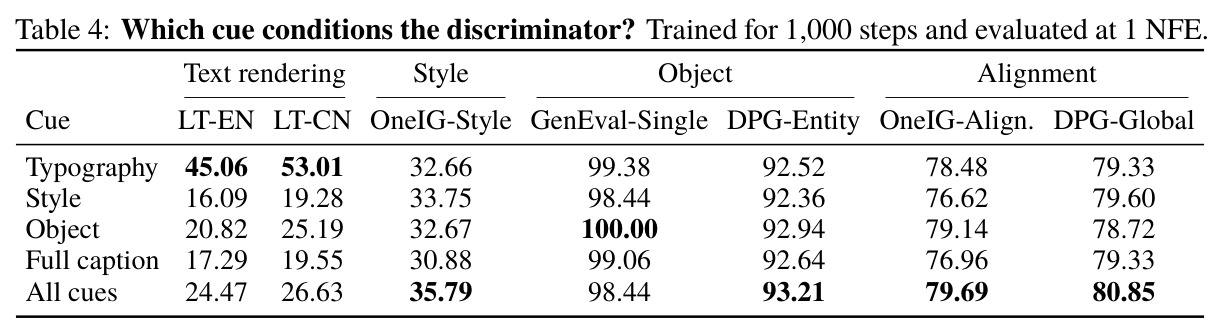
新颖性有三层。第一,特征来源的替换是范式级的:自 ADD/LADD 以来对抗蒸馏第一次把判别头移出图像流,消融(Table 3,千步训练、1 NFE)证明仅用文本流就在全部五个基准上超过传统图像流判别(LongText-EN 22.31 vs 17.86、OneIG 38.45 vs 35.79),双流结合在 4/5 指标上更好。第二,ACD 的可操控判别是全新机制:传统文本条件 GAN(GigaGAN、StyleGAN-T)里文本只做条件、特征仍来自图像;本文的 cue 改变的是判别器读取的内容本身,Table 4 显示 typography 单 cue 把 LongText-EN 推到 45.06(远超最终混合模型的 24.47),证明 cue 确实把监督定向投放。第三,工程上一鱼两吃:cue 复用同一冻结主干不加前向开销,文本流选层靠 cue 间注意力分离度自动打分而非网格搜索。局限作者也坦承:六字段是经验设计选择,ACD 有跷跷板效应,选层只是经验支持而非理论最优。
实验结果
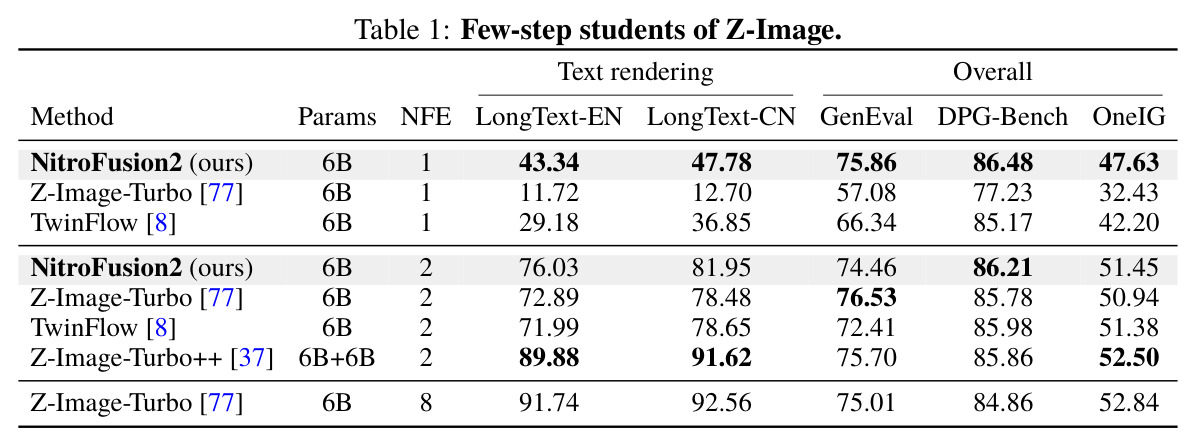
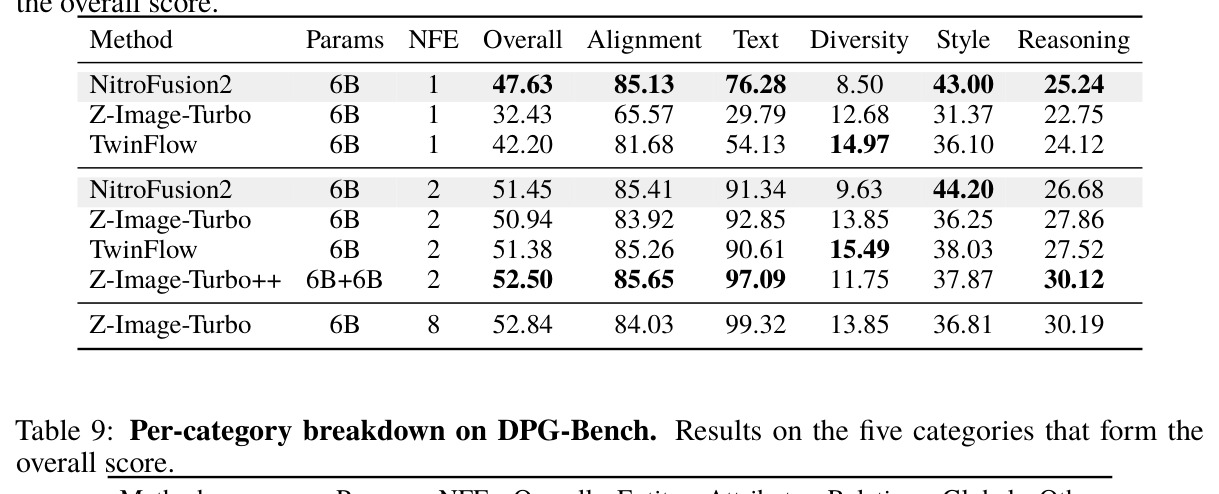
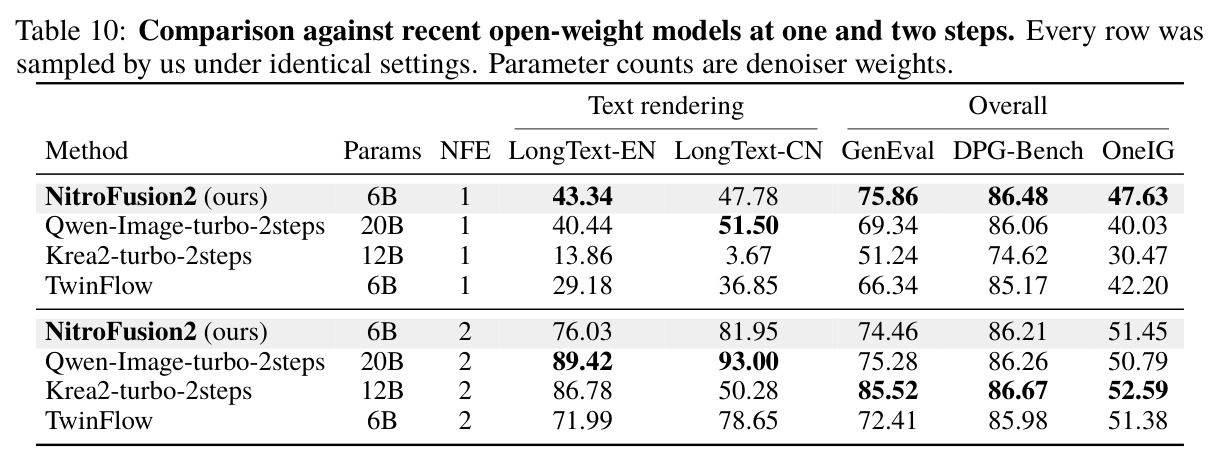
Table 1 主实验:1 步 NitroFusion2 五基准全面领先——LongText-EN 43.34、LongText-CN 47.78、GenEval 75.86、DPG 86.48、OneIG 47.63,较 TwinFlow 文字渲染 +14.2/+10.9,远超 1 步 Z-Image-Turbo(LongText-EN 11.72);最关键的是 1 步 DPG 反超 8 步参考、GenEval 持平。GenEval 细分(Table 2)六类占五类,仅 Position 32.25 落后。2 步 LongText 达 76.03/81.95 超 TwinFlow,唯双份权重的 Z-Image-Turbo++ 更高;对比 20B/12B 开放权重模型(Table 10)1 步五基准占四,2 步文字渲染被 Qwen 反超。消融(Table 3)证明文本流判别全面优于图像流、双流最佳;cue 消融(Table 4)中 7-cue 混合 6/7 项超 full caption。短板是多样性:OneIG diversity 1 步 8.50,低于基线 12.68/14.97。
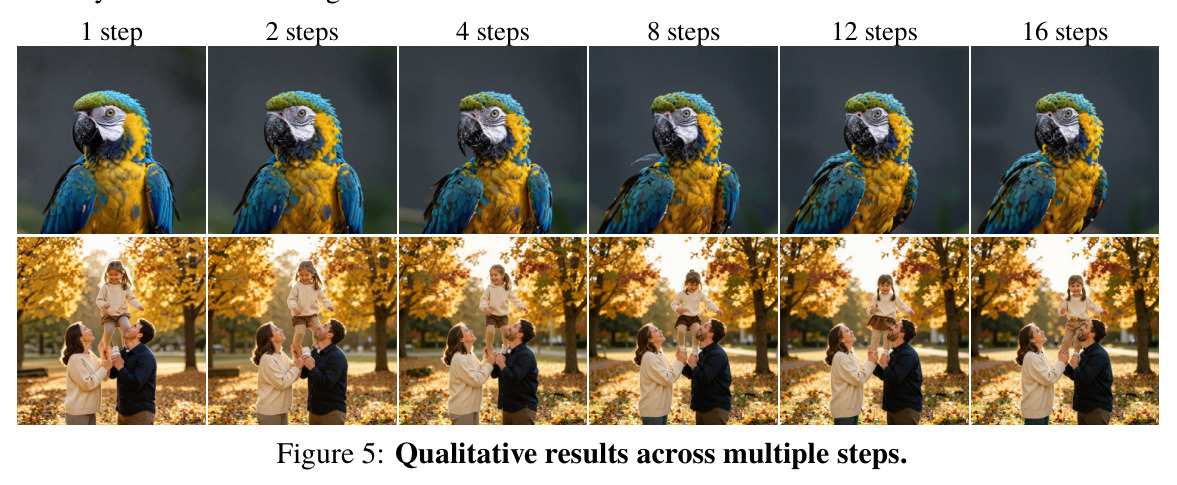
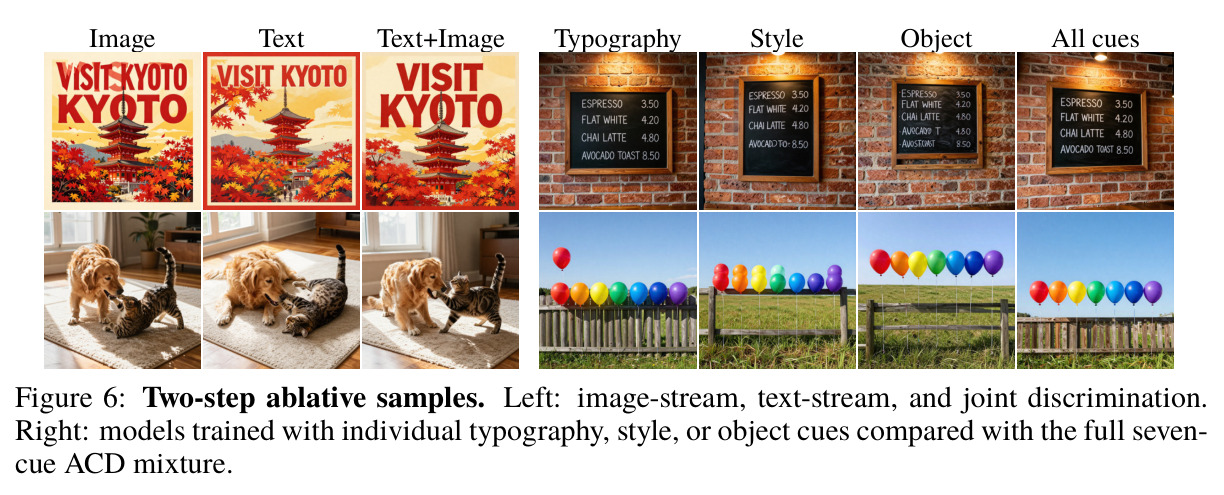
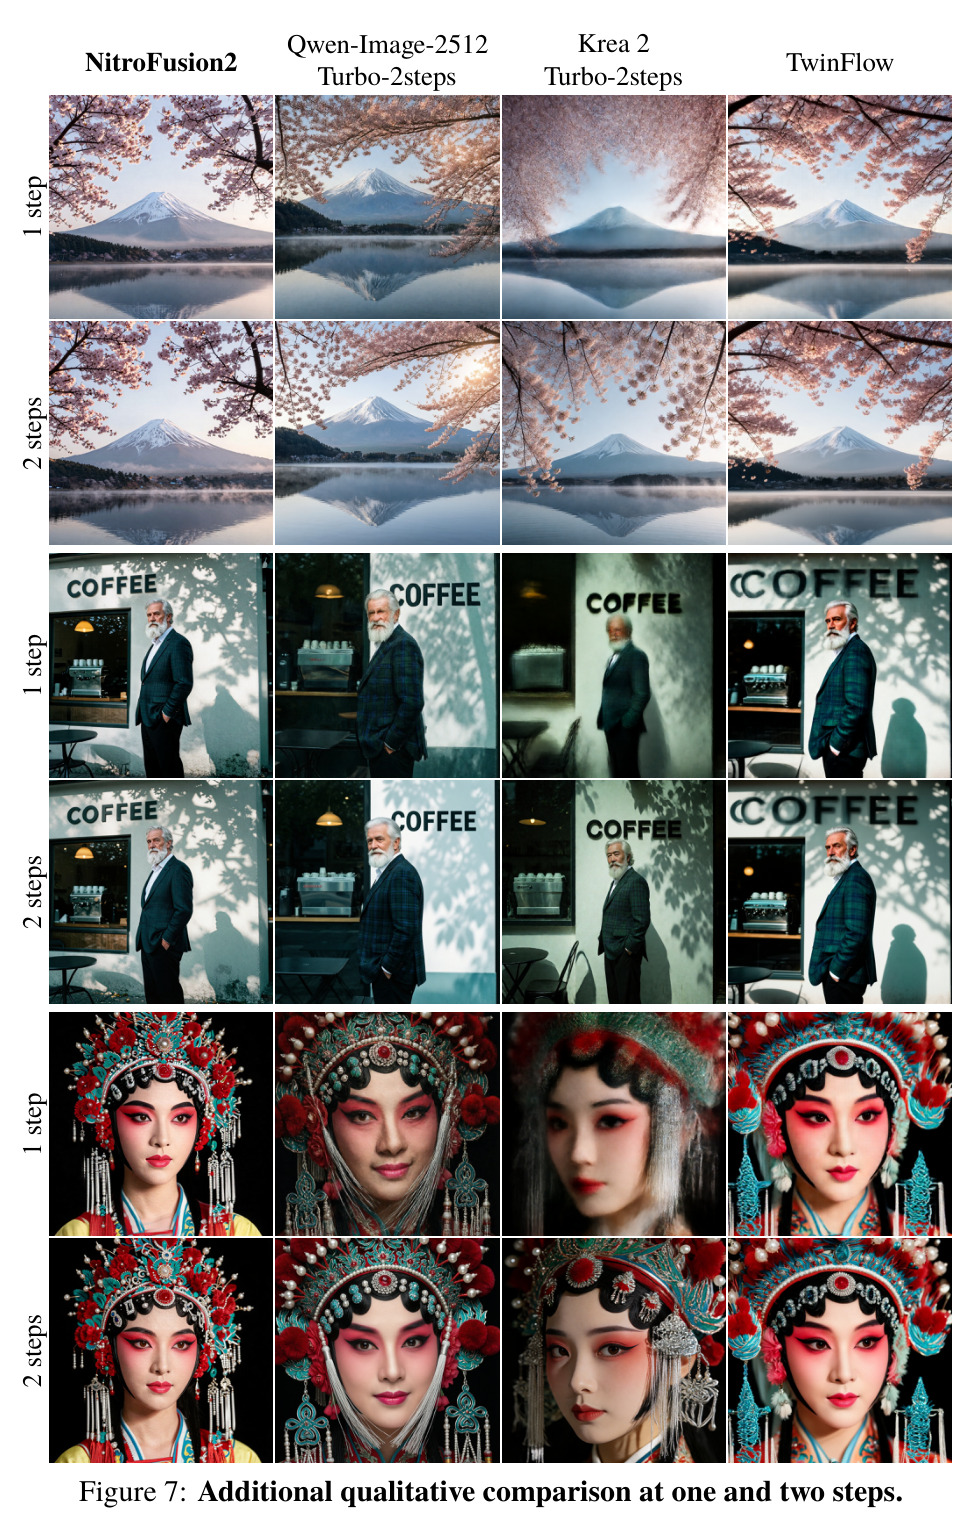
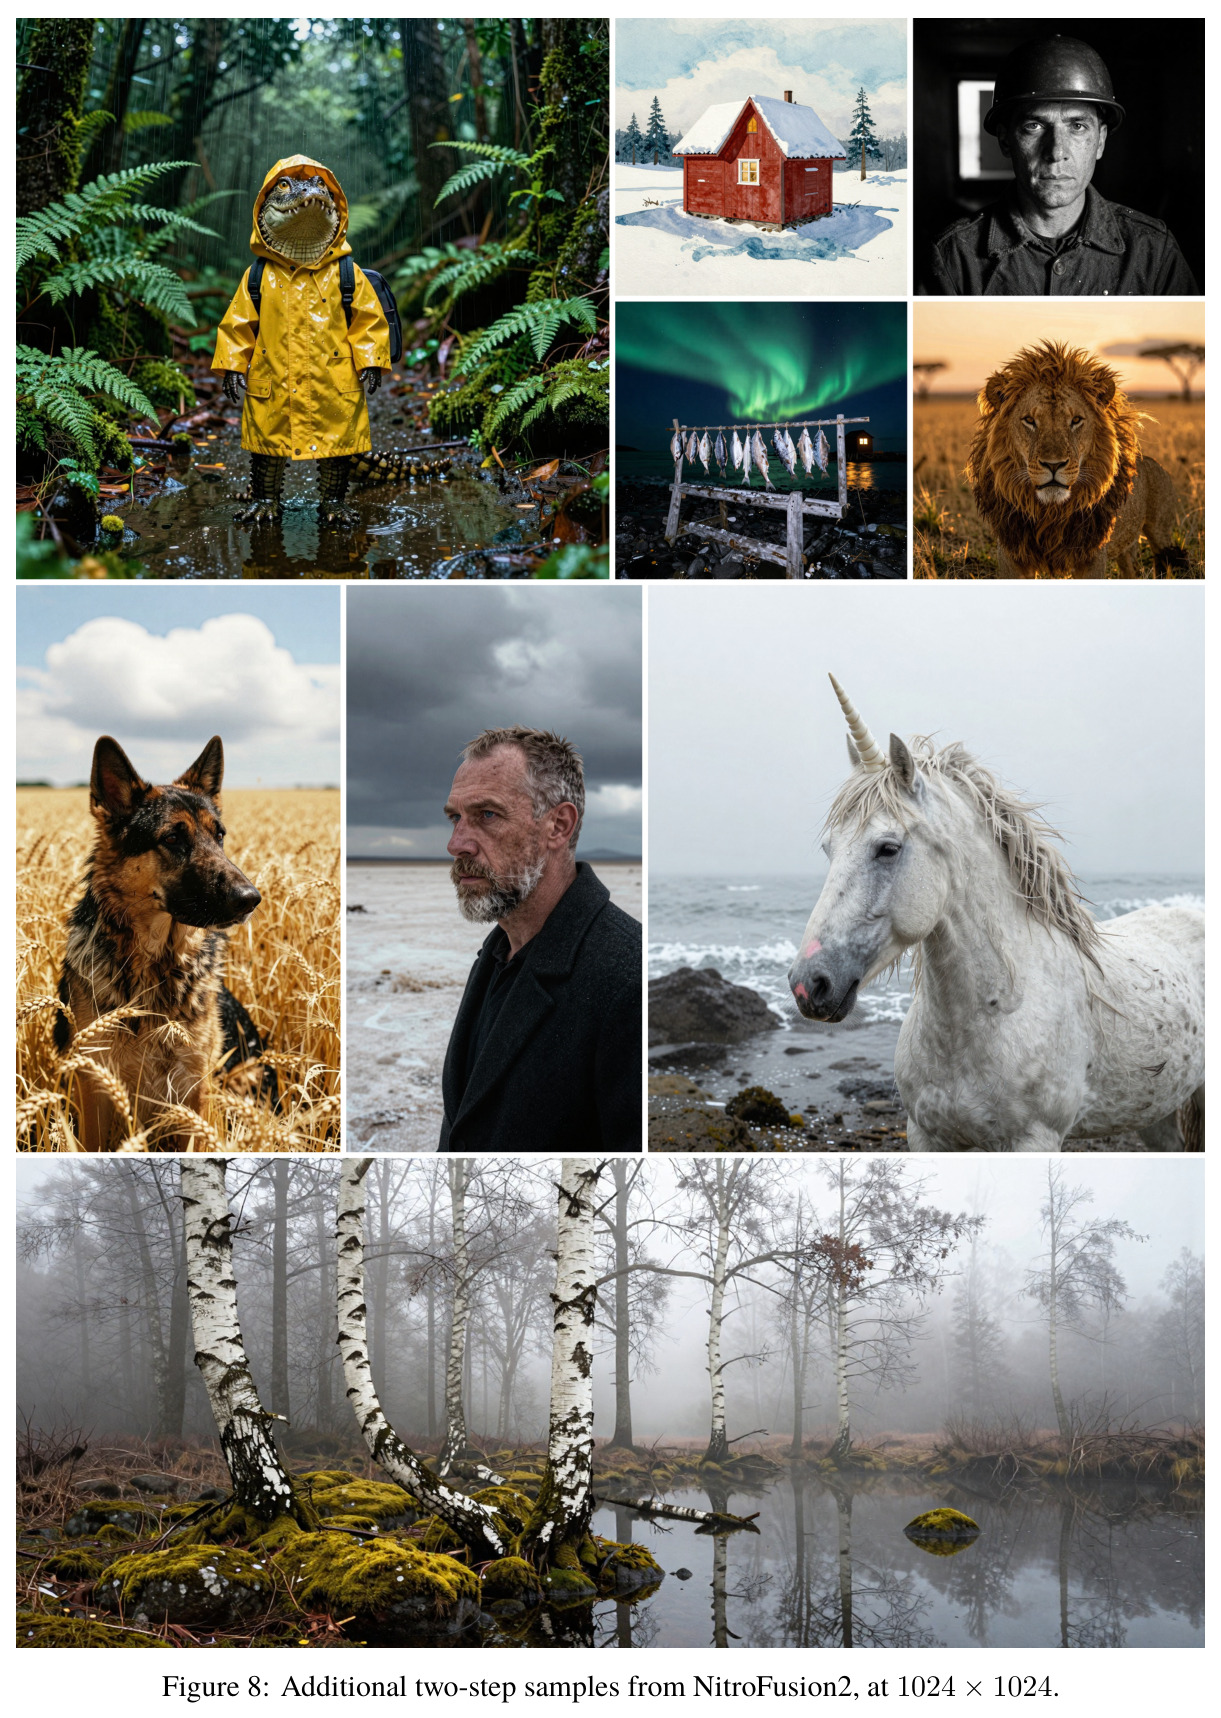
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文字渲染(英文) | LongText-Bench EN | 1 步 43.34 / 2 步 76.03 | 1 步 TwinFlow 29.18;1 步 Z-Image-Turbo 11.72 | 1 步较 TwinFlow +14.16 |
| 文字渲染(中文) | LongText-Bench CN | 1 步 47.78 / 2 步 81.95 | 1 步 TwinFlow 36.85;8 步 Z-Image-Turbo 92.56 | 1 步较 TwinFlow +10.93,仍低于 8 步参考 |
| 组合语义一致性 | GenEval 总分 | 1 步 75.86 / 2 步 74.46 | 1 步 TwinFlow 66.34;8 步 Z-Image-Turbo 75.01 | 1 步即持平 8 步参考(+0.85) |
| 细粒度提示跟随 | DPG-Bench | 1 步 86.48 / 2 步 86.21 | 1 步 TwinFlow 85.17;8 步 Z-Image-Turbo 84.86 | 1 步反超 8 步参考 +1.62 |
| 综合生成质量 | OneIG-Bench 总分 | 1 步 47.63 / 2 步 51.45 | 1 步 TwinFlow 42.20;8 步 Z-Image-Turbo 52.84 | 1 步较 TwinFlow +5.43,2 步逼近 8 步参考 |
| 判别特征流消融 | 五基准(1 NFE、千步训练) | 文本流 22.31/24.37/66.71/84.39/38.45;双流 24.47/26.63/64.39/84.86/40.02 | 图像流 17.86/19.26/66.00/82.87/35.79 | 文本流在全部五个基准超过图像流 |
局限与改进
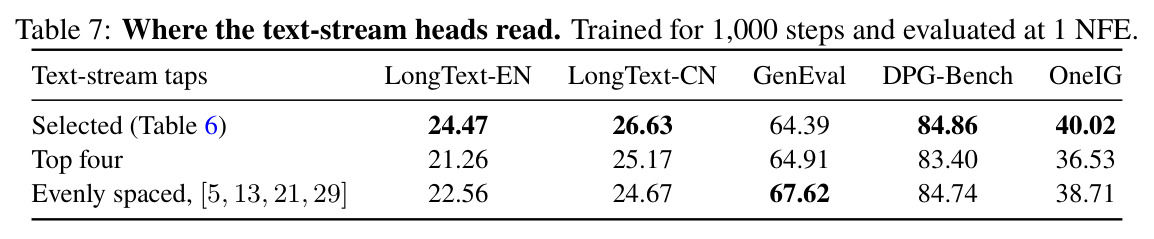
作者承认四点:复杂场景(尤其 1 步)仍困难;样本多样性下降(OneIG diversity 1 步 8.50 vs TwinFlow 14.97,是保真与多样性的权衡);ACD 有跷跷板效应——强化一个方面会弱化其他(typography cue 的 LongText-EN 45.06 远超混合模型 24.47,但只有混合模型在风格、对齐等维度全面);文本流选层靠经验打分而非最优性证明,Table 7 中 GenEval 上均匀布层(67.62)反而最高。我的补充观察:其一,参考样本全部由 12 步 Z-Image-Turbo 自生成,天花板受教师限制,8 步教师 LongText 仍有 91.74/92.56,学生 1 步 43.34/47.78 差距巨大,文字渲染离可用尚远;其二,10 万张训练数据全合成、字幕由 Qwen3.5-35B-A3B 生成,typography 字段仅在有可见文字时填充,可能欠覆盖真实排版多样性;其三,对比对象全是 Z-Image 家族或其 Turbo LoRA,未与 SD3.5、Flux 等其他 MMDiT 蒸馏方法直接比较,跨架构普适性待验证。
独立分析的弱点
弱点一:教师蒸馏天花板。参考图全由 12 步 Z-Image-Turbo 生成,学生最多学到教师水平;1 步 LongText-EN 43.34 与 8 步教师 91.74 之间近 48 分鸿沟说明文字渲染远未闭环。改进方向:混入真实图像或更强教师作参考,或叠加文字正确性奖励。弱点二:跷跷板效应。cue 均匀采样虽平衡监督,但各方面强度被稀释——typography 单 cue 的 LongText-EN 比七 cue 混合高约 20 分(45.06 vs 24.47)。改进方向:按验证集反馈动态调整 cue 采样分布,或训练后对单一 cue 的头微调。弱点三:多样性塌缩。1 步 OneIG diversity 8.50 显著低于基线,强条件判别可能加剧模式坍缩。改进方向:对条件或 cue 做噪声化扩展保留条件熵,或引入多样性正则。弱点四:位置与计数弱。1 步 GenEval Position 仅 32.25、Counting 62.19 且 2 步反降至 56.88,六字段不含数量与位置的强显式 cue。改进方向:增加 count/position 字段。
未来方向
作者提出的方向:更好平衡 ACD 的跷跷板效应;系统研究文本流信息如何随深度演化以设计更优判别器布层;探索六字段之外还有哪些有效 cue;把文本流状态拓展到对抗蒸馏之外的监督用途。基于本文成果可延伸的:把 TSAD 迁移到 SD3.5、Flux、Qwen-Image 等其他 MMDiT 骨干验证跨架构普适性;把文本流判别信号引入视频 MMDiT 用于时间一致性监督;与 DMD、一致性蒸馏等非对抗路线结合,例如用文本流特征构造分布匹配的度量;利用 cue 可操控性做推理时的属性加权生成,或自动化失败检测——哪个 cue 的判别器最不信任学生样本,就说明哪个属性生成失败,可作为定向重采样或局部修正的信号。此外,ACD 的六字段由 VLM 从图像反推,也可以反向用于构造针对性训练数据,主动补齐学生弱项属性。
复现评估
复现门槛较高但路径清晰。权重承诺接收后公开,目前未放出。训练资源:8 张 H100、batch 256、2 万步,估算需数千 GPU 时。数据可完全自建:10 万张参考图用公开的 Z-Image-Turbo 12 步生成,字幕用 Qwen3.5-35B-A3B(需多模态接口)标注六字段;评测基准 LongText-Bench、GenEval、DPG-Bench、OneIG-Bench 全部公开。方法描述完整度高:损失函数、超参($\lambda_{img}=0.1$、$\lambda_{fm}=0.1$、$t_{fm}=0.75$、学习率 $5\times10^{-5}$、Adam $\beta_1=0.0, \beta_2=0.9$)、两阶段训练(5 千 off-policy + 1.5 万 on-policy)、七类 cue 的文本内容(Table 5)、各 cue 布层(Table 6)与完整伪代码(Section C)均已给出。小规模验证友好:核心消融只需 1000 步训练即可复现「文本流优于图像流」的结论,适合先在单卡或少量卡上验证核心思想,再决定是否投入全量训练。
论文图表
GenEval 六个子任务(Single/Two/Counting/Colors/Position/Color attr)分解:1 步 NitroFusion2 五类领先(Single 100.00、Two 96.97、Colors 91.22、Color attr 72.50),仅 Position 32.25 落后。
揭示优势与短板的具体分布:组合能力强但位置类弱,是评估方法适用场景的关键。
OneIG 五维度分解:NitroFusion2 的 Alignment(1 步 85.13)与 Text(76.28)领先,但 Diversity 仅 8.50,低于 Z-Image-Turbo 12.68 与 TwinFlow 14.97。
量化本文最明确的短板——多样性塌缩,是保真-多样性权衡的直接证据。