对抗性投机推理:把草稿模型变成上下文精度分配器以提升长程智能体 Adversarial Speculative Reasoning Improves Long Horizon Agents
训练草稿模型在关键决策点故意被目标拒绝,让关键推理以最低噪声写入上下文,长程智能体成功率显著提升
前置知识
投机解码(Speculative Decoding)
大模型推理加速技术:小草稿模型一次提出若干 token 组成的块,大目标模型在单次前向中并行给整块打分,用拒绝采样规则以概率 $\min(1, p(v)/q(v))$ 接受草稿 token $v$;被拒位置从残差分布 $r(v) \propto \max(0, p(v)-q(v))$ 重采样。可证明提交 token 严格服从目标模型分布,因此长期被视为不改变行为的无损加速。
本文的全部对象就是投机解码中的草稿模型与验证过程,理解接受/拒绝机制才能看懂如何把'被拒绝'当作控制信道使用。
验证块与槽位(Verification Block & Slot)
草稿一次提议 $W-1$ 个 token,与上一个已提交 token 组成宽度 $W$ 的验证块,槽位 $s=0,\dots,W-1$。槽位 0 存放最近提交的 token,其分布只读取已有 KV 缓存;槽位 $s\ge 1$ 的 token 相互之间及对同块内更早槽位 KV 条目的注意力都在同一次前向 launch 中计算,每次执行舍入不同,噪声随槽位累积。
论文的核心测量发现是:同一输出分布在块内不同槽位的数值精度不同,而整个方法本质上就是把关键 token 挪到最精确的槽位 0。
DPO 直接偏好优化
Rafailov 等人提出的偏好训练方法:给定同一上下文下的偏好续写 $y_w$ 与被拒续写 $y_l$,用损失 $L=-\log\sigma(\beta[r_\theta(y_w)-r_\theta(y_l)])$ 直接优化策略,无需显式奖励模型。本文将其'反方向'用在草稿模型上:让草稿学会偏好目标模型'应该避免'的那个选项,从而在该点可靠地被拒绝。
对抗性草稿的训练目标就是反向 DPO,看懂 §4.3 的加权窗口损失函数与 $\beta=10$ 等超参都依赖对 DPO 的理解。
KV 缓存与数值非确定性
自回归解码把已生成 token 的 key/value 写入 KV 缓存,供后续所有注意力读取。生产环境中目标模型以 NVFP4 权重、FP8 KV 缓存、稀疏注意力服务,GPU kernel 非批不变,同一输入重复前向的 logits 并不逐位一致;偏移用自然对数单位 nat 度量(1 nat ≈ 概率相差 $e\approx2.7$ 倍),且槽位 $s$ 会继承同块内前 $s$ 个槽位的舍入累积。
论文动机建立在这种非确定性上:'分布无损'不等于'数值无损',每个 token 以多高精度进入 KV 缓存是真实存在的自由度。
nucleus 采样(top-p)与噪声敏感性
从累积概率超过阈值 $p$ 的最小 token 集合中按温度采样。本文智能体在 temperature 1、top-p 0.95 下运行,论文测得发射 token 的 log-prob 偏移 1–2 nats 时约 12% 的情形会改变它是否落在采样核内,2–3 nats 时约 47%,超过 3 nats 时超过 84%——说明几个 nat 的数值噪声足以真实改变采样输出。
它回答了'为什么 1–3 nat 量级的块内噪声不是纯理论问题',是连接数值测量与端到端行为变化的关键证据。
研究动机
投机解码一直被视为纯粹的系统级加速:拒绝采样保证输出分布与目标模型完全一致,训练更好草稿的全部努力(EAGLE、DFlash 等)都只盯接受率。但'无损'结论针对理想化目标模型;生产环境的前沿模型以 NVFP4 权重、FP8 KV 缓存和稀疏注意力服务,前向计算并非逐位可复现,logits 是依赖计算布局的含噪量。作者实测 GLM-5.3(DFlash 验证块宽 8):槽位 0 与单 token 解码一样精确(0.473 vs 0.478 nats),此后每槽噪声约增 4%(+0.0195 nats/slot),末槽比首槽高 34%,>2 nats 的偏移占比从 3.2% 涨到 6.2%。更关键的是,长程软件工程智能体要跑几十到几百轮、上下文数十万 token,每个 token 都写入 KV 缓存并被后续所有步骤读回;对智能体轨迹的审计发现,以'原则'或'证据'为框架的决策正确率约 70%,而'猜测隐藏测试想要什么'或'求稳'框架仅 36%——少数关键决策 token 的编码质量决定整条长程轨迹的成败。
本文的目标是本文的目标是:在不改变目标模型权重、不放松验证精确性保证的前提下,提升长程智能体推理的端到端成功率。具体拆成三步:第一,定量刻画投机验证中的数值噪声,证明验证在分布上无损但在精度上不均匀——噪声随块内槽位位置结构性增长,且验证写入的上下文会在约 30 轮之后产生 10%–20% 的额外极端偏差;第二,把草稿模型从'加速器'重新定义为'上下文精度分配器',通过训练草稿在关键决策点故意提出会被目标拒绝的续写,迫使目标从残差采样中自己生成这些决策 token,并将其写入新验证块的槽位 0——全系统噪声最低的位置;第三,在不牺牲解码速度(每步接受 token 数基本不变,DeepSeek 仅降 1.8%)的条件下,在 DeepSWE 和 NL2Repo-Bench 两个长程编程基准上验证成功率提升,且整个过程只训练占部署参数 0.06%–0.28% 的草稿参数。
与已有工作不同的是,本文的独特切入角度有三。其一,测量视角新颖:以往数值非确定性研究(bfloat16 非批不变 kernel、KV 量化等)把精度当作整个系统的属性去消除,本文首次测量噪声在单个验证块内随槽位的结构性增长(每槽约 4%),并证明这种结构不是只能消除的缺陷,而是可以被利用的资源。其二,草稿角色重定义:从 EAGLE、DFlash 到 DistillSpec,所有草稿训练工作都以'与目标更一致、接受更多 token'为目标;本文反其道而行,训练草稿在选定位置'可靠地被拒绝',把被拒绝这个被先前所有工作视为失败信号的事件变成控制信道。其三,与放松精确性的路线(如 Judge Decoding 允许目标本会拒绝的草稿通过)方向相反,本文保持拒绝采样精确性原封不动,改变的不是目标输出什么,而是每个 token 以多高的精度写入 KV 缓存;同时与在目标模型上做关键 token DPO 的工作不同——本文只训练草稿,而且是反向训练。
核心方法
直觉上,智能体推理绝大多数 token 是例行的,真正决定轨迹走向的是少数'提交句'——模型在思维过程中敲定如何解读模糊需求、是否运行测试验证、是否签字确认的时刻。第 3 节的测量表明:验证块槽位 0 的精度与单 token 解码完全一致,之后每槽约衰减 4%;而被拒绝的 token 会被目标重采样并成为新验证块的槽位 0。这构成一个巧妙的杠杆:草稿无法改变目标采什么(分布精确性不可动摇),但能决定验证块在哪里结束——如果草稿恰好在决策点提出目标会拒绝的东西,关键思考 token 就会以最低噪声写入 KV 缓存,其后推理也从新鲜块的精确状态出发。技术路线分四步:(1)在真实智能体轨迹中用目标模型自己当裁判,逐字定位提交句(≤35 词)作为决策点;(2)在每个决策点以共享前缀做分叉重采样,构造偏好对;(3)用反向 DPO 训练草稿偏好'不该有的决策框架'或'不跑测试'的行为;(4)部署时只换草稿不换目标,例行文本上草稿仍是普通高接受率草稿以保持速度,验证规则与分布精确性完全不变。
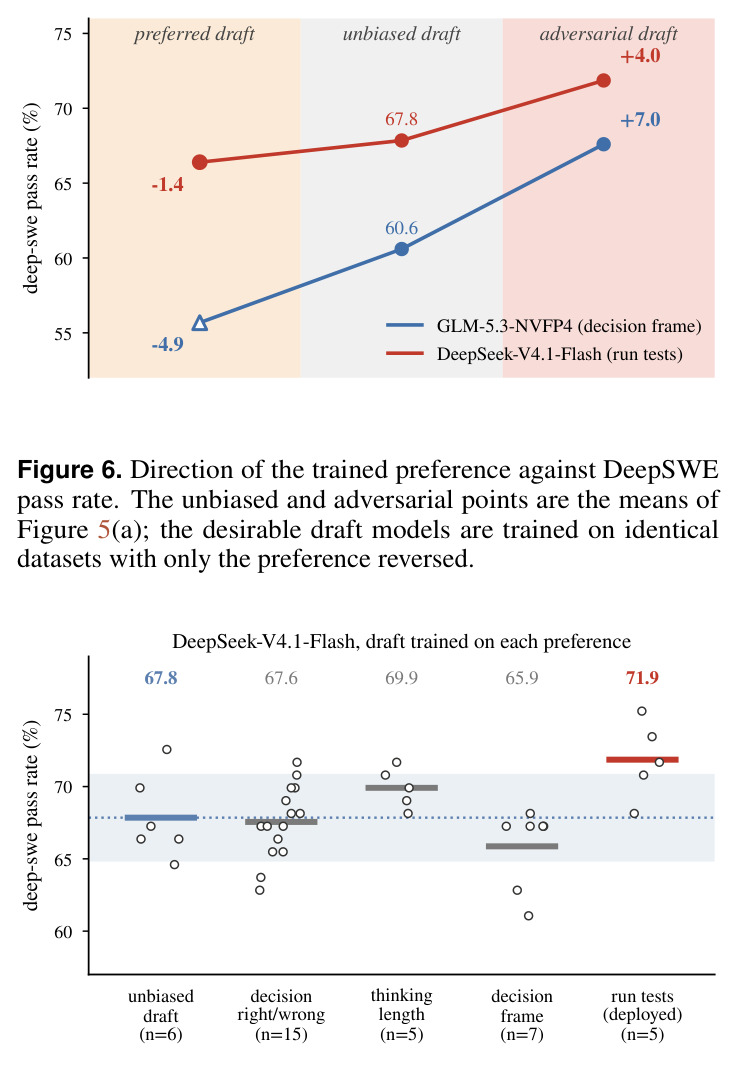
核心创新是把'拒绝'当作控制信道。设目标分布为 $p(\cdot|x)$、草稿分布为 $q(\cdot|x)$,则拒绝概率恰为 $\Pr[\text{reject}]=1-\sum_v \min(p(v),q(v))=\mathrm{TV}(p,q)$,即两分布的总变差距离:草稿把自己的概率质量放在目标认为低概率的地方就会被拒绝,重采样得到的 token 成为新块的槽位 0,其后所有 token 的 KV 条目都从最精确的位置重新计算。与已有方法的本质区别在于:传统草稿训练追求'处处与目标一致',导致关键决策落在块头还是块尾纯属运气;本文训练草稿'例行文本处处一致 + 决策点故意不一致',于是关键决策 100% 由目标自己从槽位 0 提交,而例行 token 保持普通接受率。作者进一步假设:高精度编码的决策在长程推理中被'抓住'得更牢,低精度编码的决策更容易被漂移稀释,因此仅改变编码位置就能改变几十轮后的端到端成功率;同数据正向训练反而掉点的对照实验(GLM 掉 4.9 点)支持这一机制解释。
方法步骤详情
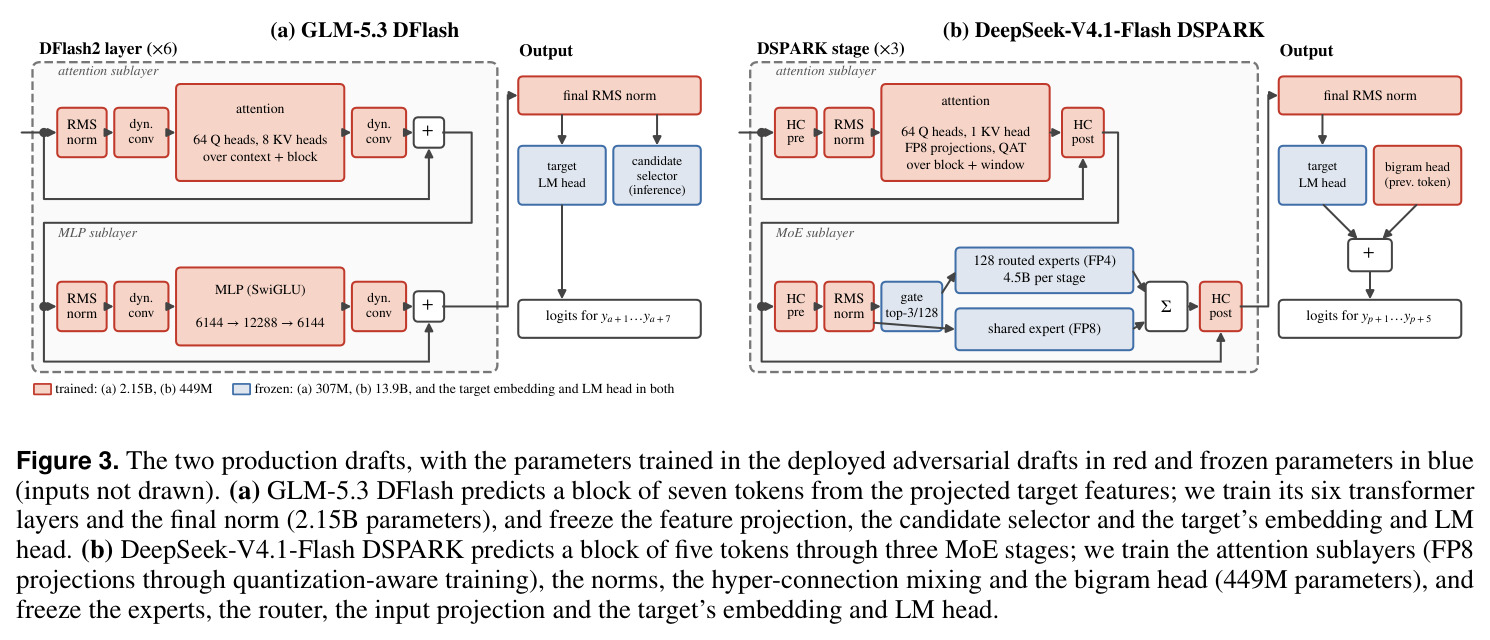
第一步,噪声测量:固定前缀于内存,同一验证前向重复 $R=4$ 次,比较参考 top-4 token 与实际发射 token 的 $|\Delta\log p|$(GLM 测 1631 位置、DeepSeek 测 1294 个),排除预填充噪声;再把源回合 token 分别经验证与解码路径写入 KV 缓存,对其后最多 128k token 教师强制打分(96 任务)。第二步,定位决策点:裁判即目标模型本身,逐字提取提交句(≤35 词);GLM 用'决策框架'偏好(原则/证据框架正确率约 70% 为偏好侧,likely/risk/simpler 约 36% 为对抗侧),DeepSeek 用'是否跑测试'偏好。第三步,构造分叉对:以提交句前推理为共享前缀,temperature 1、top-p 0.95 重采样(GLM $n{=}16$ 得 2,843 对、留出 6 任务;DeepSeek $n{=}12$ 得 6,391 对、留出 10% 任务),按任务划分防泄漏。第四步,训练:窗口内反向 DPO,$L=-\log\sigma(\beta[r_\theta(y_w)-r_\theta(y_l)])+\alpha\,\mathrm{NLL}_\theta(y_w)$,$\beta=10$,窗口为提交句前 32 token 至句末加 128 token 线性衰减(跑测试偏好取前 512 token);GLM 训 DFlash2 六层与 norm(2.15B 参数),DeepSeek 用 QAT 训 DSPARK 注意力、norm 与 bigram 头(449M),冻结专家与路由。第五步,部署:只换草稿,验证规则与输出分布不变。
技术新颖性
新颖性体现在四个层面。概念上:首次实证'投机验证分布无损但精度不均匀',用两套互补测量(滑动窗口验证分离解码与预填充噪声源;跨路径 KV 写入对比隔离长程影响)把精度从系统属性细化为块内位置属性。机制上:给出 $\Pr[\text{reject}]=\mathrm{TV}(p,q)$ 的简洁刻画,把草稿接受与否这一传统上无关紧要的自由度变成上下文精度分配旋钮。训练上:反向 DPO 是全新用法——已有工作要么对齐草稿与目标(DistillSpec),要么放松验证让草稿引导输出(SFAD),本文保持验证精确、只训练草稿偏好'应被拒绝的框架';可训练参数仅占系统 0.28%(GLM)与 0.06%(DeepSeek),还需把推理专用不可微的 DSPARK 移植到可微 PyTorch(每专家误差 $10^{-7}$),并对 FP8 权重按部署块格式做 QAT。实证上:通过方向对照(正向草稿掉 4.9/1.4 点)与无关偏好对照(27 次运行合并 p=0.83)证明收益来自'拒绝落点'机制本身,而非'训练过草稿'这一动作。
实验结果
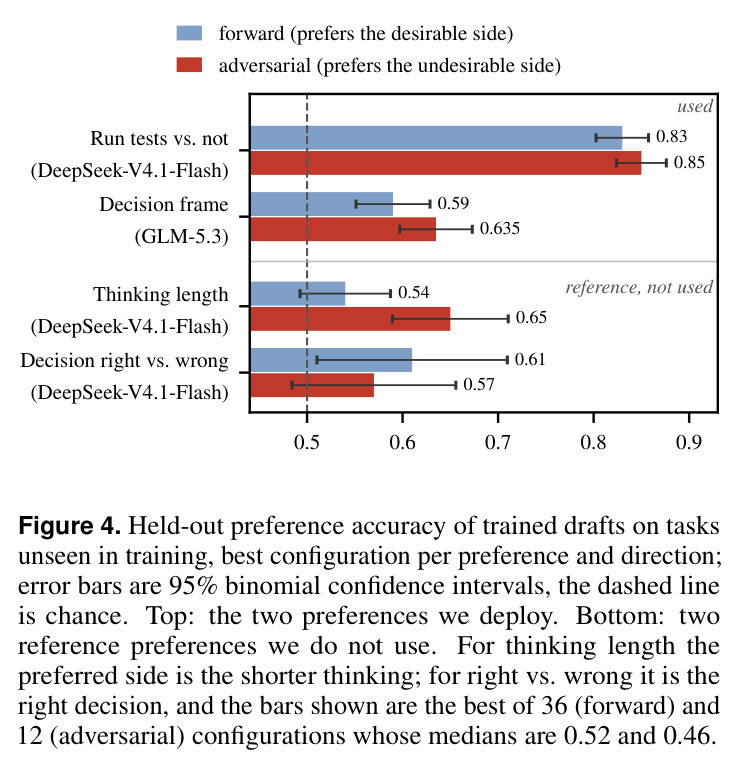
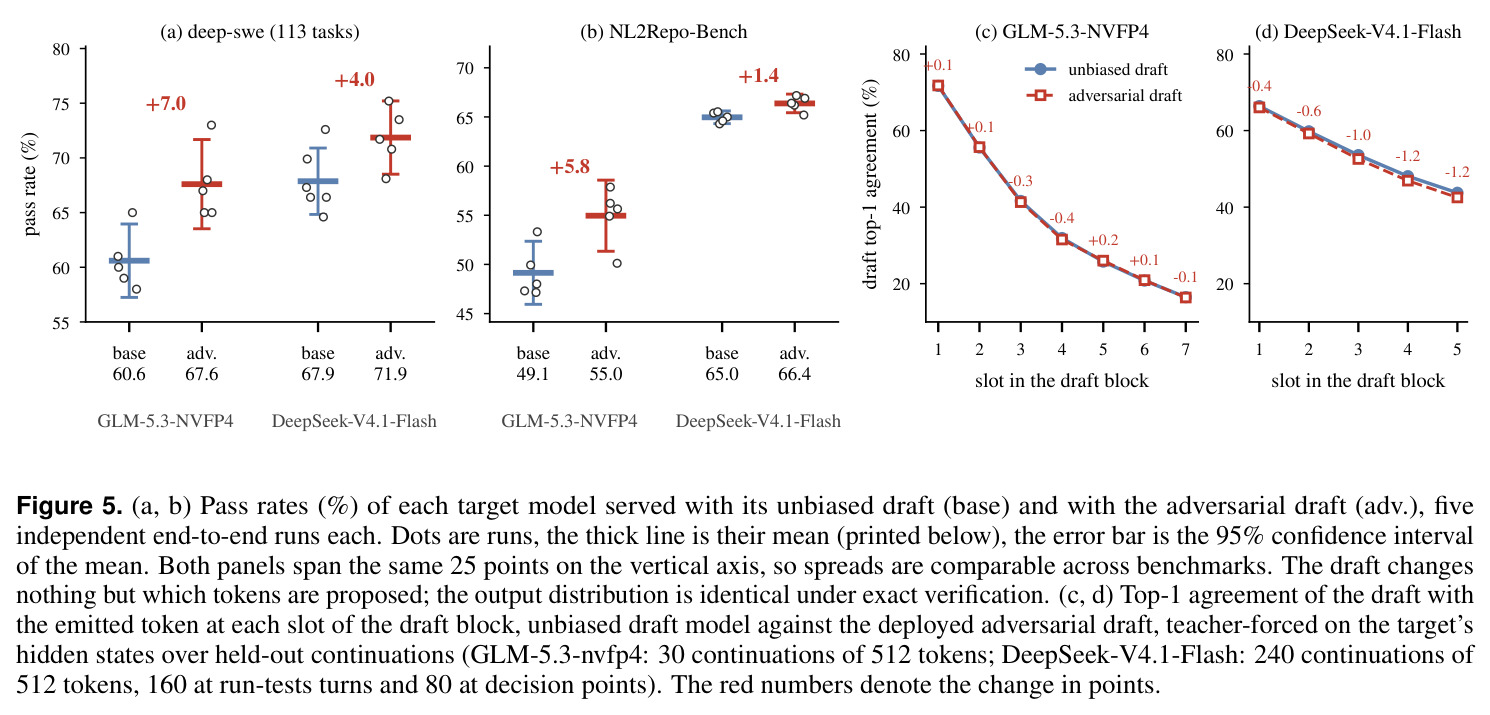
实验分三部分。第一,偏好可学习性(§5.1):GLM 决策框架对抗草稿在留出任务上达 0.635 准确率(±0.015),DeepSeek 跑测试偏好达 0.85;对照显示草稿学不会'决策对错'(0.61/0.57,近随机)和思考长度(0.54/0.65),说明草稿能学表述框架与行为习惯、学不了语义正确性——这支撑'草稿无法改变输出分布'的设计前提。第二,端到端成功率(§5.2,每配置 5 次运行):DeepSWE 上 GLM-5.3-NVFP4 60.6%→67.6%(+7.0 点,CI 2.6–11.4);DeepSeek-V4.1-Flash 67.8%→71.8%(+4.0 点,CI −1.3–7.3);NL2Repo 上 DeepSeek 65.0%→66.4%(+1.4,p=0.011)、GLM 49.1%→55.0%(+5.8)。方向对照:同数据正向训练使 GLM 掉到 55.7%(−4.9)、DeepSeek 掉到 66.4%(−1.4),且正向草稿偏好准确率(0.80)不低于对抗版(0.70)。无关偏好对照:27 次运行合并 67.5% vs 67.8%(p=0.83),部署草稿高出 4.3 点(p=0.018)。第三,效率(§5.3):槽位级 top-1 一致率最大变化 −1.2 点,每步期望接受 token 数 GLM 保持 2.28、DeepSeek 2.50→2.46(−1.8%),以不到 2% 的解码速度换取显著推理增益。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepSWE(113 个软件工程任务,mini-swe-agent 框架,隐藏测试评分)— GLM-5.3-NVFP4 | 端到端通过率(5 次独立运行均值) | 67.6%(对抗性决策框架草稿) | 60.6%(原始无偏 DFlash2 草稿) | +7.0 点(95% CI 2.6–11.4) |
| DeepSWE(113 个软件工程任务)— DeepSeek-V4.1-Flash | 端到端通过率(5 次独立运行均值) | 71.8%(对抗性跑测试草稿) | 67.8%(原始无偏 DSPARK 草稿) | +4.0 点(95% CI −1.3–7.3,跨零点) |
| NL2Repo-Bench(104 个从需求文档从零构建多模块 Python 库的任务)— DeepSeek-V4.1-Flash | 上游 pytest 测试平均通过率 | 66.4% | 65.0% | +1.4 点(95% CI 0.4–2.4,p=0.011) |
| NL2Repo-Bench — GLM-5.3-NVFP4 | 上游 pytest 测试平均通过率 | 55.0% | 49.1% | +5.8 点 |
| 推理效率(DeepSeek-V4.1-Flash,贪心链接受近似) | 每验证步期望接受草稿 token 数 | 2.46(对抗性草稿) | 2.50(无偏草稿);GLM-5.3 训练前后均为 2.28 | 速度代价仅 −1.8%,换取上述成功率增益 |
局限与改进
局限包括以下几点。首先,统计功效有限:每配置仅 5 次运行,DeepSeek 在 DeepSWE 上的 +4.0 点 CI [−1.3, 7.3] 跨过零点,严格说不显著;NL2Repo 的 +1.4 点虽 p=0.011 但幅度很小。其次,增益机制是间接推断:'高精度编码的决策更持久'是假设,方向对照与无关偏好对照只是间接支持,缺少直接干预实验——如用批不变 kernel 完全消除噪声后收益是否消失,或随机位置强制拒绝的安慰剂对照。第三,偏好定义手工且模型特异:GLM 用决策框架分类学、DeepSeek 用跑测试行为,互不通用;裁判依赖目标模型本身且提交句限 35 词,可能漏掉无明确提交句的决策。第四,方法只适用于块状草稿的投机解码,单 token 解码无从获益;71–90 轮后偏差比率回落到 0.99,说明效应依赖上下文长度与工具反馈。第五,两个目标都是约 750B 的 MoE 模型,对中小模型或其他量化方案的普适性未验证(噪声减半的 DeepSeek 增益也更小)。最后,噪声集中在极端尾部(>4 nats),对贪心或低温度解码场景的效果可能不同,论文未讨论。
独立分析的弱点
独立分析后有几点值得推敲。第一,评估统计薄弱:5 次运行、113/104 个任务,DeepSeek 主结果的 CI 含零;改进方向是增加运行次数、按任务配对 bootstrap 并报告难度分层增益。第二,'决策点'与'偏好'的构造高度依赖人工先验:决策框架分类学来自对 GLM 轨迹的审计,跑测试偏好来自对 DeepSeek 失败模式的分析,换模型就要重做轨迹审计;改进方向是自动从失败轨迹聚类挖掘偏好、用可学习裁判定义决策点。第三,存在未排除的混杂因素:论文用无关偏好对照回应了'任何训练都有增益'的质疑,但未报告对抗草稿下轨迹长度、工具调用次数、思考 token 比例等行为统计,无法完全排除草稿改变了思考结构的可能。第四,工程复杂度过高:需要把推理专用的 DSPARK 可微化并对 FP8 权重做 QAT;改进方向是只训练 bf16 小型附加模块或 LoRA 式参数。第五,收益机制依赖 temperature 1 采样:若部署用更低温度,噪声改变采样核成员资格的概率(12%/47%/84%)会大幅下降,方法收益可能随之减弱,论文对此完全未讨论;对非智能体、短上下文任务的价值也未知。
未来方向
作者在结论中指向的大方向是把投机解码从加速器重新理解为'上下文精度分配器',且只训练 0.06%–0.28% 参数即可改变长程行为。基于此可延伸:(1)与批不变 kernel 工作(Thinking Machines Lab 的去非确定性方案)结合做正交实验——完全消除噪声 vs 重分配噪声,直接检验因果假设;(2)把对抗性草稿用于 RL 训练的 rollout 阶段,让训练时的轨迹分布与部署更一致,可能减少 self-conditioning 式的误差累积;(3)自动偏好发现:用失败轨迹聚类自动挖掘'该被拒绝的行为',替代手工框架分类学,推广到新模型;(4)组合多个偏好(决策框架 + 跑测试)以及动态块宽——按上下文长度或噪声预算调整 $W$;(5)推广到其他长程域:计算机操作智能体、科研智能体、长文档多轮编辑等,检验'关键决策精度持久性'是否是普遍现象;(6)理论化:为 KV 缓存噪声如何经注意力影响下游 logits 建模,预测哪些 token 最值得保护;(7)与更宽验证块、EAGLE-3 等投机解码改进的共存性研究——块越宽噪声增长空间越大,本方法的潜在收益理论上也随之增大。
复现评估
复现难度中等偏上。有利条件:两个目标模型均开放权重(GLM-5.3-NVFP4 在 HuggingFace 公开),DeepSWE 与 NL2Repo-Bench 基准公开,SGLang 开源;论文对数据规模与超参($\beta=10$、学习率 $5\times10^{-6}$/$2\times10^{-5}$、$\alpha=0.2$、窗口 128/512 token)及留出划分(GLM 2,843 对留 619 对;DeepSeek 6,391 对留 719 对)描述充分。不利条件:未提及发布对抗草稿 checkpoint 或训练代码;完整复现需 4 张 B200 托管 750B 级模型(NVFP4 + FP8 KV + DSA)抽取隐状态,离线训练 2.15B 或 449M 参数,并把推理专用的 DSPARK 移植为可微实现(对齐到每专家 $10^{-7}$、每阶段输出 3–5%);决策点裁判还需大规模轨迹生成(GLM 1,668 分叉、DeepSeek 2,203 分叉)。相对而言,第 3 节的噪声测量部分成本低、更易独立复现,是检验核心主张的入口;端到端增益复现基本局限于拥有同等算力与服务栈工程能力的团队。
论文图表
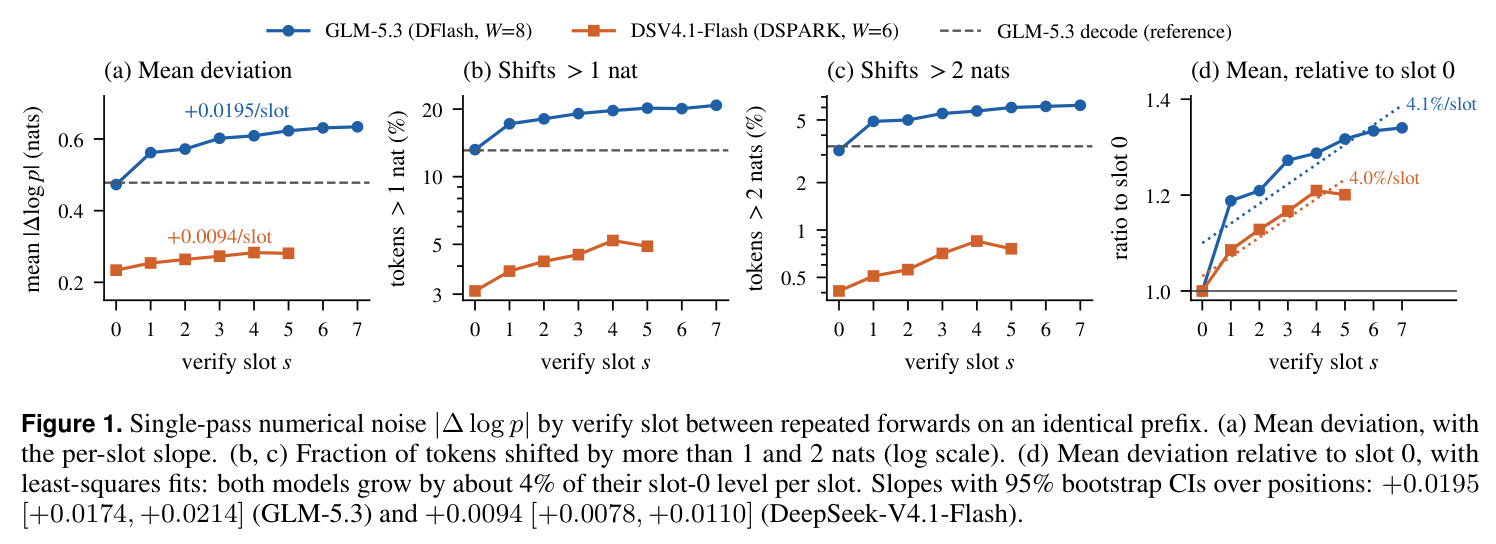
四个子图展示同一前缀重复前向时的数值噪声随验证槽位的变化:GLM-5.3(DFlash,W=8)槽位 0 平均偏差 0.473 nats 与单 token 解码(0.478)持平,此后以 +0.0195 nats/slot(95% CI [+0.0174, +0.0214])线性增长,末槽比首槽高 34%;>1 nat 与 >2 nats 的偏移占比随槽位上升(>2 nats 从 3.2% 到 6.2%,>3 nats 从 1.1% 到 2.1%)。DeepSeek-V4.1-Flash(DSPARK,W=6)槽位 0 噪声约为 GLM 的一半,但相对增长率相同(+0.0094 nats/slot,约每槽 4%),>1 nat 从 3.1% 升至 4.5%,>2 nats 从 0.41% 升至 0.68%。
这是全文的经验基石:证明投机验证'分布无损但精度不均匀',且噪声增长是跨两种草稿架构的普遍规律。没有这张图,'把 token 挪到槽位 0'的方法动机就不成立。
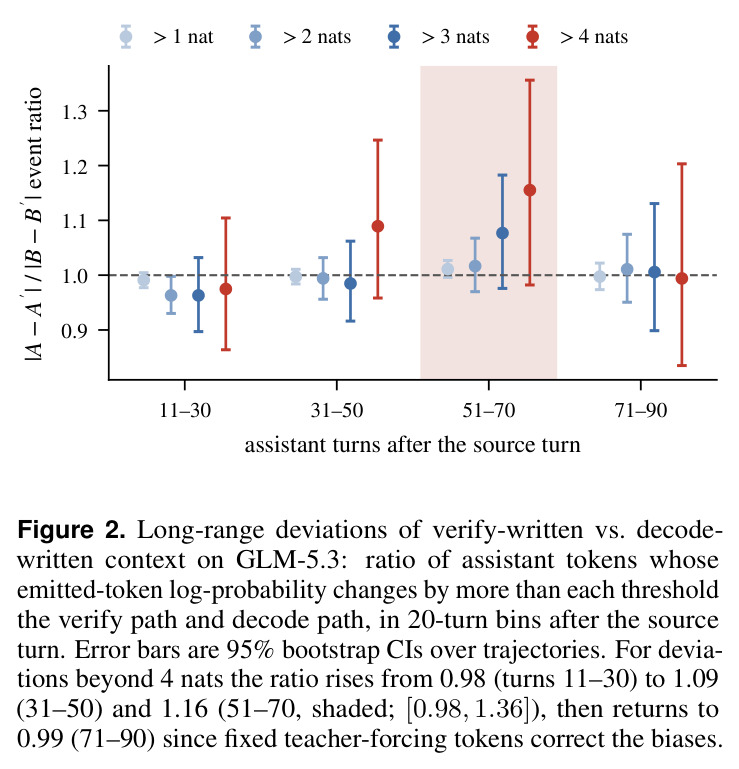
把源回合 token 分别经验证路径(A)和解码路径(B)写入 KV 缓存后,比较两条路径各自构建间偏差 |A−A'| 与 |B−B'| 中超过 1/2/3/4 nats 的事件数之比,按距源回合的轮数分箱。>4 nats 的比率从 11–30 轮的 0.98 升至 31–50 轮的 1.09、51–70 轮的 1.16(CI [0.98, 1.36]),独立复验构建在 30 轮后给出 1.20 [1.03, 1.40];≤2 nats 的偏差在所有距离上两条路径不可区分,71–90 轮比率回落到 0.99。
它证明块内噪声不是瞬态的:验证写入的上下文在约 30 轮后开始产生 10%–20% 的额外极端偏差,且效应集中在极端尾部——这把'槽位精度'与'长程智能体成败'联系起来,是方法成立必需的第二块经验证据。
汇总 DeepSeek-V4.1-Flash 用本项目各偏好草稿的全部 27 次 DeepSWE 运行:无偏草稿 67.8%(n=6,置信带),决策对错草稿 67.6%(n=15,未学会偏好,如预期停在无偏均值上),思考长度草稿 69.9%(n=5),决策框架草稿 65.9%(n=7,学会了却无效,说明该目标丢失运行不在提交句处),跑测试(部署)草稿 71.9%(n=5)。合并的无关偏好草稿 67.5% vs 无偏 67.8%(Welch p=0.83),部署草稿高出 4.3 点(p=0.018)。
排除'随便训练个草稿都有用'的替代解释:只有针对该模型真实失败模式(不跑测试)的偏好才带来增益,且学会偏好的决策框架草稿毫无效果——增益精确跟随偏好与失败模式的匹配,而非训练动作本身。