AgSpec:在编码Agent流水线中突破检索式投机解码的极限 AgSpec: Pushing the Limits of Retrieval-Based Speculative Decoding in Coding Agent Pipelines
为编码Agent定制检索语料与草稿长度策略,检索式投机解码最高加速4.76倍
前置知识
投机解码(Speculative Decoding, SD)
一种不改变模型输出分布的解码加速技术:一个廉价的草稿器(小模型、草稿头或检索)一次提出若干候选 token,目标大模型并行验证,被接受的 token 保留、被拒绝的丢弃并由目标模型重新生成。每个被接受的 token 省去一次目标模型的串行前向计算。代价是被拒绝的草稿浪费了验证算力——在 batch size 1 时几乎免费,但在大 batch 下验证是计算受限的,拒绝 token 会消耗整个 batch 共享的算力,因此只有草稿器又便宜又准时 SD 才划算。
本文的全部设计目标都是提高投机解码在编码 Agent 场景下的净收益,理解"接受省一步、拒绝付验证成本"这一收益模型是读懂其草稿长度控制的前提。
检索式投机解码
不使用任何草稿模型,而是把当前解码上下文(prompt 与已生成前缀)的后缀在文本语料库中做最长后缀匹配,直接复制匹配位置之后的文本作为草稿。对代码特别有效,因为标识符、代码片段和仓库惯例反复出现。代表工作:PLD(只查当前 prompt)、REST(预建数据存储)、SuffixDecoding(后缀树+历史输出)、SAM-Decoding(后缀自动机)。
AgSpec 正是检索式 SD 的框架级改进,它不改匹配引擎,只改语料策略与草稿长度策略,理解这一基线范式才能看清它改了什么。
后缀自动机与后缀树
对一段文本预构建的字符串索引结构,可以高效回答"当前上下文结尾这段字符串在语料中出现于何处、其后跟随什么 token",天然支持以任意后缀做最长匹配并取出延续。SAM-Decoding 使用后缀自动机(内存更省),SuffixDecoding 使用后缀树(支持更灵活的树状草稿)。两者是本文 AgSpec 直接叠放其上的两个检索引擎。
AgSpec 声称与引擎正交,实验正是分别在这两个引擎上叠加(AgSpec-SAM / AgSpec-Suffix)并对比各自的裸引擎,不了解这两个结构就看不懂引擎叠加实验的意义。
编码Agent与多轮会话流水线
SWE-agent、OpenHands 类系统把一个用户请求处理为一个会话:模型调用与工具执行交替进行,常由多个专职 agent 协作——localizer 定位相关文件、coder 编辑代码、executor 运行测试、reviewer 审查。任务很少一次成功,失败的尝试会触发新一轮(turn)重试,每轮复用大量前一轮的文本。会话还维护持久工作区(仓库检出与执行环境),prompt 只暴露被选中的、常被截断的工件片段。
本文的核心观察是"复用与接受规律存在于请求之上的结构(会话/仓库/角色/轮次)",不熟悉编码 Agent 的多 agent 多轮工作方式就无法理解其语料划分与按 agent 定制长度的动机。
unified diff 补丁格式
代码 agent 常用的文件编辑输出格式:文件头之后,保留的行以空格为前缀,删除的行以减号为前缀,新增的行以加号为前缀。这意味着 agent 从仓库文件中复制的每一行都带有一个文件原文中没有的前缀字符,token 序列因此不同——同一份代码在"工作区存储形式"和"agent 发射形式"下是两个不同的 token 串。
这是论文最关键的创新点 emission-form indexing 的直接出发点:按文件原样索引的语料匹配不上 agent 发出的 diff 补丁,必须额外索引带前缀的副本。
分位数回归与 pinball loss
Koenker-Bassett 提出的损失 $\rho_\tau(u) = u(\tau - \mathbb{I}[u<0])$,其期望恰在分布的 $\tau$ 分位数处取最小,故对它做(随机)次梯度下降即是在线追踪一个分位数。本文用它为在线缩放因子 $\alpha$ 的更新规则给出理论解释:$\alpha \leftarrow \alpha + \eta(\tau - \mathbb{I}[A_i < D_i])$ 等价于对"可接受长度与匹配长度之比"的 $\tau$ 分位数的随机次梯度步。
论文 §G.1 用它论证在线长度控制的收敛目标,并把 $\tau = 1-\lambda$ 与离线 cap 的盈亏平衡点对齐,是理解方法理论根基的钥匙。
研究动机
投机解码的收益取决于草稿器"又便宜又准",检索式 SD 复制已有文本作草稿,看似天然适合会反复重现代码、日志与早前尝试的编码 Agent,但作者发现现有方法远未发挥潜力,问题有三层。一是语料可用性缺失:现有方法只索引当前调用(PLD、SAM-Decoding)或预建静态存储(REST),而 Agent 复用的文本来自进行中的会话(上轮失败尝试的输出、早前工具日志)和仓库工作区(文件一旦被 prompt 截断便不可达)。二是可匹配性缺失:语料按 Agent 读的方式存储,而 coder 以 unified diff 写回,每个复制行都带文件原文没有的空格或减号前缀,token 序列不同导致匹配失败。三是草稿长度失配:现有方法用静态上限(PLD/REST/SAM 的固定 K)或按匹配长度乘固定系数(SuffixDecoding),但 Fig.1(b) 实测各 Agent 的可达接受长度处于截然不同的区间(coder 可达约 45,localizer 仅约 5)且随轮次漂移,固定策略会在接受率低处过度草拟,大 batch 下消耗全 batch 共享的验证算力。
本文的目标是本文的目标是构建一个不修改检索引擎、即插即用的框架(AgSpec),为编码 Agent 流水线补齐现有检索式投机解码缺失的两块策略:语料策略与草稿长度策略。具体而言:(1) 语料要覆盖会话轨迹与仓库工件两个来源,并按 Agent 的输出格式(emission form)索引工件,使 diff 补丁中的复制行能够命中;(2) 草稿长度要遵循统一准则——只有当"多草拟一个 token 的期望收益覆盖其验证成本"时才草拟,由离线 profile 出的每 Agent 上限(cap)捕捉 Agent 间稳定差异,由验证反馈在线学习的缩放因子(scale)捕捉会话内漂移;(3) 在仓库级多 Agent 基准(SWE-bench Verified 与 TeamBench)上系统超越五种检索式 SD 方法和训练式 EAGLE-3,并把吞吐相对 AR 解码提升至最高 4.37×(batch=1)与 4.76×(batch=16);同时验证框架在无仓库(LiveCodeBench)与单 Agent(Terminal-Bench)场景依然有效,证明收益可泛化到编码 Agent 大家族。
与已有工作不同的是,作者的独特切入是把检索式 SD 在 Agent 场景的失效归因于"匹配引擎之外的策略"而非匹配机制本身。检索式 SD 可分解为引擎(找最长后缀匹配并返回延续)与策略(语料放什么、草拟多长),现有工作都在引擎层面竞争,策略却全部围绕"单个请求"这一推理引擎的服务单元设计——索引当前调用、预建存储或跨请求池化的输出,长度用静态上限或匹配自身属性。而编码 Agent 的复用与接受规律存在于请求之上的结构:会话(轨迹跨调用跨 Agent 共享)、仓库(工件是工作区状态而非对话历史)、角色(各 Agent 生成不同类型文本)与轮次(失败重试带来大量重复)。AgSpec 因此不动引擎、只重写策略,可直接套在 SAM-Decoding 或 SuffixDecoding 上。与最接近的自适应长度工作 SmartSpec 相比,后者面向通用请求流、用 goodput 估计选长,AgSpec 则利用了 Agent 流水线特有的信号——"这次调用由哪个 Agent 发出",把角色身份作为长度先验,这是此前所有检索式 SD 都未利用的信息。
核心方法
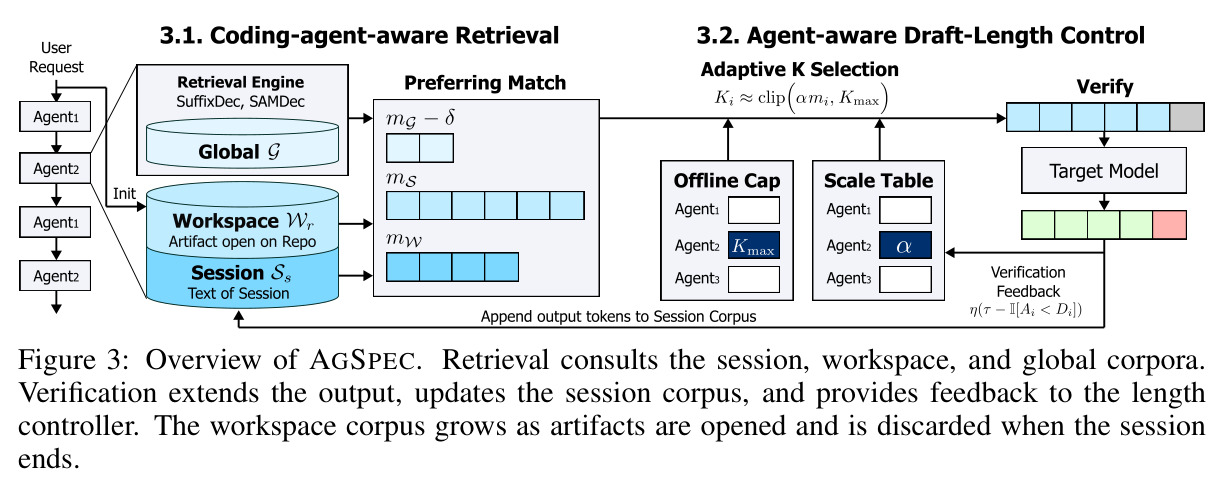
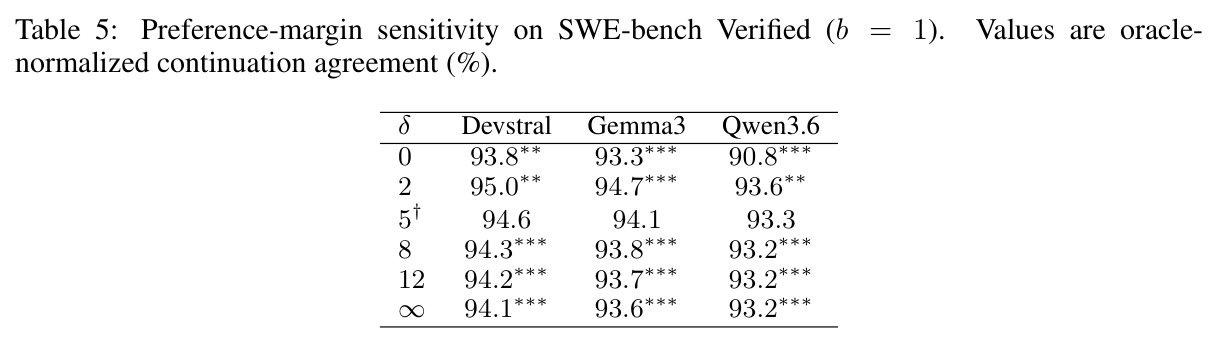
直觉:草稿 token 只有在"足够可能被接受、省下的目标模型步数能覆盖其验证成本"时才值得草拟;编码 Agent 恰好让"可能被接受的文本"既可检索又可估长。方法分两半。语料侧按来源建三库:会话语料 $S_s$(会话内全部文本,跨调用跨 Agent 共享,会话结束释放)、工作区语料 $W_r$(会话打开的仓库文件,首次打开即索引原样与发射形式:空格与减号前缀两种副本)、全局语料 $\mathcal{G}$(不相交任务日志构建并固定)。检索时三库同查得最长匹配 $m_S, m_W, m_G$,仅当 $m_G > \max(m_S, m_W) + \delta$($\delta=5$)才用全局库,否则活库长者胜。长度侧每步设 $K_i = \mathrm{clip}(\mathrm{round}(\alpha^{(a_i)} m_i), 1, K^{\max}_{(\mathcal{M},a_i)})$:cap 由离线回放各 Agent 轨迹满足 $\Pr(R \ge k) \ge \lambda$ 的最大 k 定出,scale $\alpha$ 由验证反馈在线更新。
两大创新。一,emission-form indexing:工件是工作区状态而非对话历史,prompt 只暴露被选中且常截断的片段,写回时用 scaffold 格式——unified diff 中保留行加空格前缀、删除行加减号前缀(Fig.2)。故把文件索引为多份副本:原样、全空格前缀、全减号前缀,使补丁中复制的行都能命中。这与"索引 Agent 读到的文本"有本质区别——匹配的是 Agent 写出的形态。二,把 Agent 身份当作长度控制信号:接受长度随 Agent 与轮次系统性变化并漂移。离线 cap 取历史轨迹可复用长度 $R$ 分布上满足 $\Pr(R \ge k) \ge \lambda$ 的最后位置;在线 scale 经 $\alpha \leftarrow \alpha + \eta(\tau - \mathbb{I}[A_i < D_i])$ 追踪 $R_i/m_i$ 的 $\tau$ 分位数(§G.1:pinball 次梯度步),$\tau=1-\lambda$。已有方法要么固定 K,要么只按匹配乘系数,从不用验证校正、不分角色与轮次。
方法步骤详情
流程五步(Fig.3)。(1) 启动前:用不相交任务日志构建 $\mathcal{G}$(SWE-bench 70、TeamBench 213 个),离线回放求每 Agent 的 cap $K^{\max} = \max\{k: \Pr(R \ge k) \ge \lambda\}$,$\alpha_0=1.0$。(2) 会话开始:建空 $S_s$、$W_r$,$S_s$ 留各 prompt 末尾 2048 token。(3) 每解码步:查三库得 $m_S, m_W, m_G$,活库优先、$\mathcal{G}$ 需超 $\delta$ 余量;延续上 $\mathcal{G}$ 与 $S_s$ 取最高频后继、$W_r$ 取首现;按式(1)复制至多 $K_i$ token。(4) 验证后:输出 token 入 $S_s$;未触顶则按式(3)更新 $\alpha$(全接受且触顶则跳过);新开文件以原样与两种前缀副本入 $W_r$。(5) 会话结束释放活库。超参:$\eta=0.5$、$\delta=5$、最大草稿 64(b=1)/24(b=16)。
技术新颖性
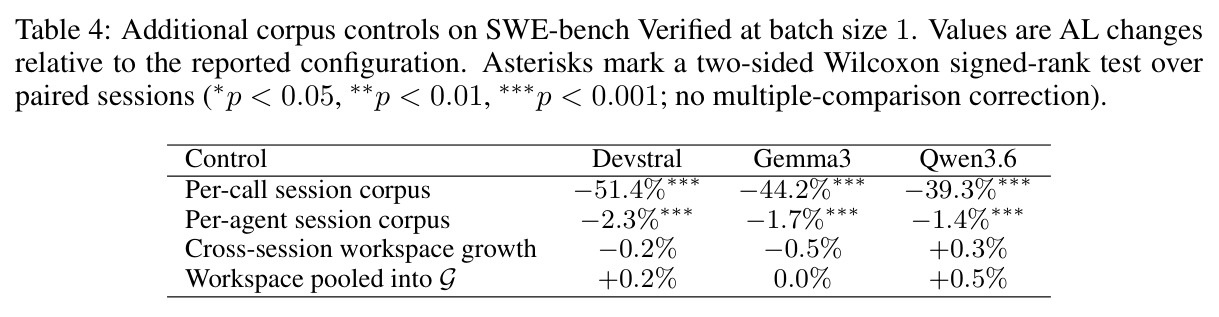
新颖性有四。(1) 框架与引擎正交:只换语料与长度策略、不改匹配结构;叠加后 SuffixDecoding 吞吐 +16.5%(AL +18.5%),SAM-Decoding +64.6%(AL 近翻倍)。(2) emission-form indexing 首次解决"scaffold 输出格式 ≠ 工件存储格式"的错位:按文本被生成的而非被读取的形式索引,首轮 coder AL 提升 13–39%。(3) 长度控制首次把 Agent 角色作为先验,将"多草一个 token 是否回本"形式化为接受概率 ≥ λ 的单一准则:cap 捕捉 Agent 间稳定差异,在线 scale 分位数追踪轮次漂移,由同一 λ 对齐;不同于依赖草稿分布或熵的模型式方法(SpecDec++、DISCO、AdaEDL),检索草稿无分布与隐状态,AgSpec 只用匹配与验证结果两信号,再叠加 Agent 身份。(4) 会话语料跨调用跨 Agent 共享:退化为 per-call 使 AL 暴跌 39.3–51.4%,退化为 per-agent 损失 1.4–2.3%,证明复用存在于请求之上的结构。
实验结果
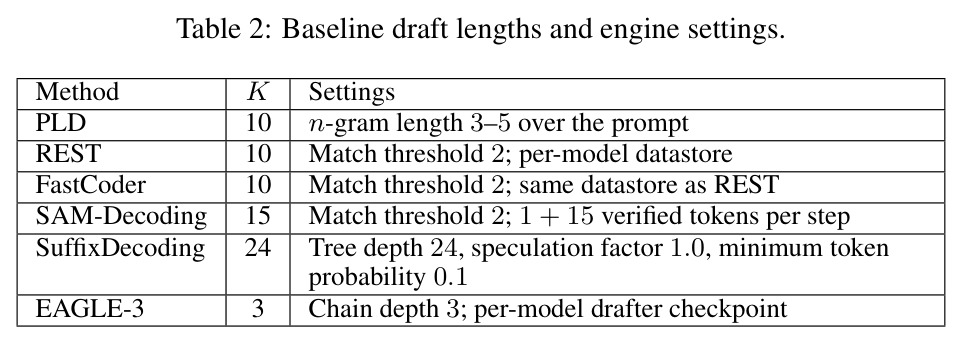
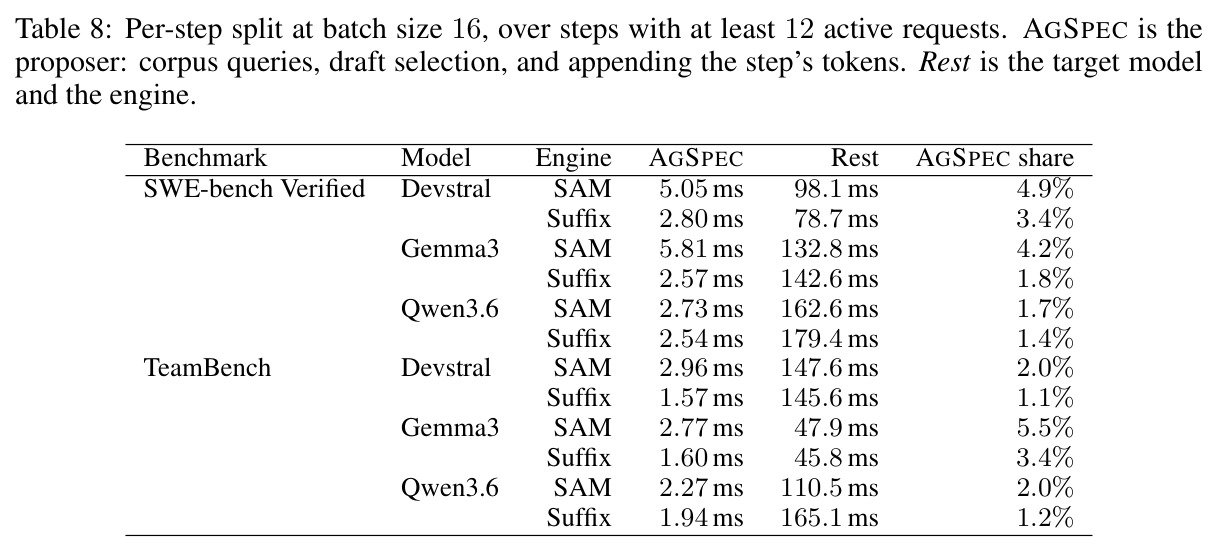
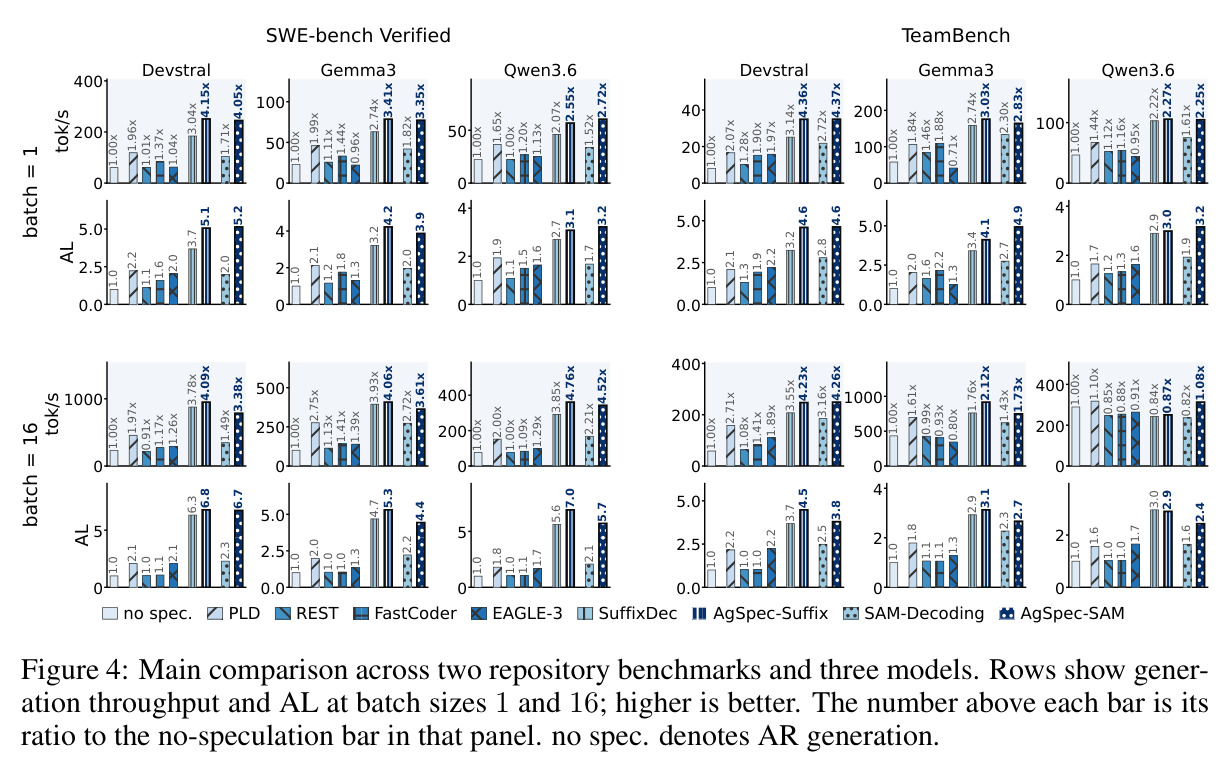
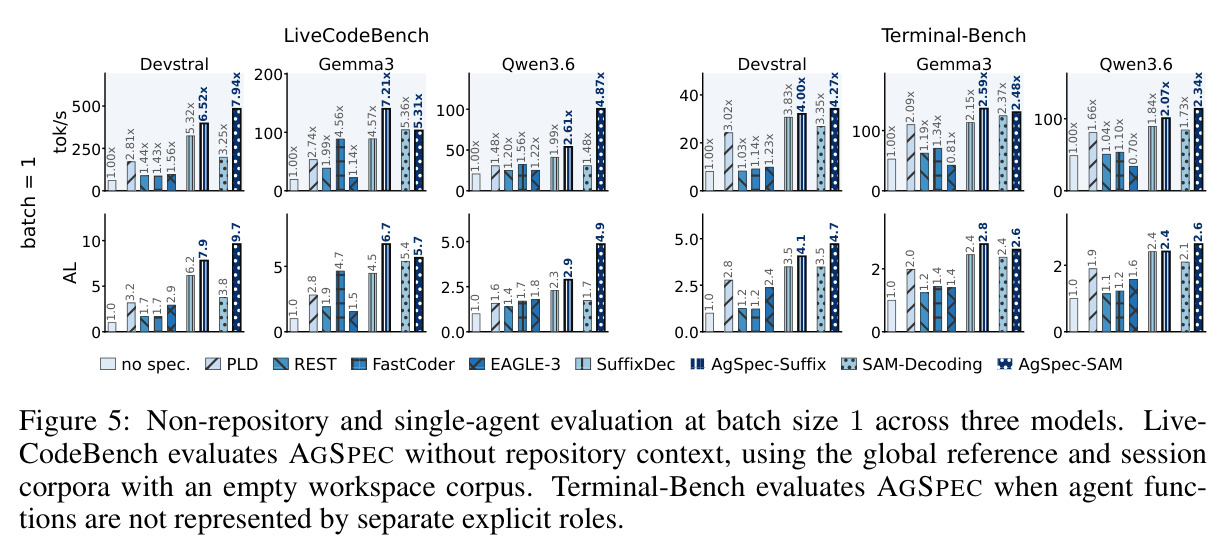
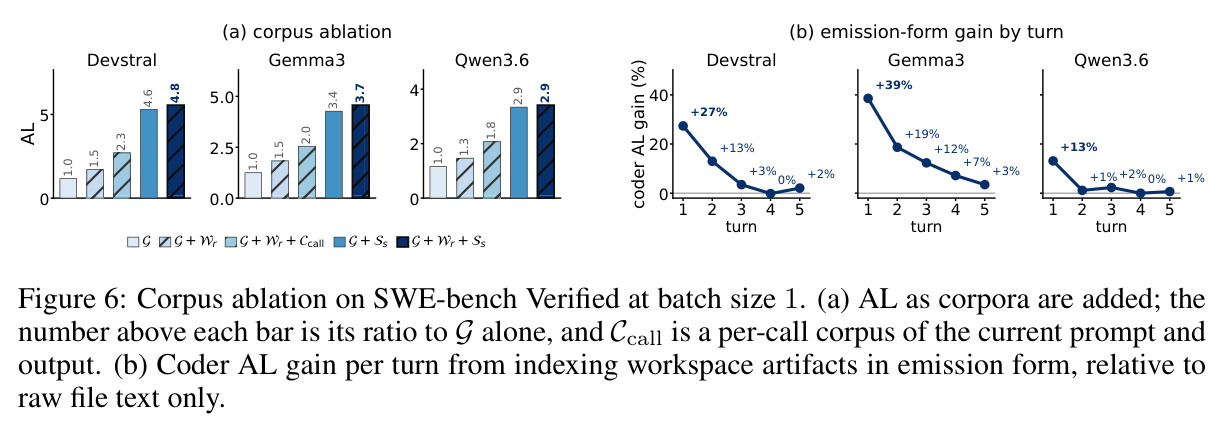
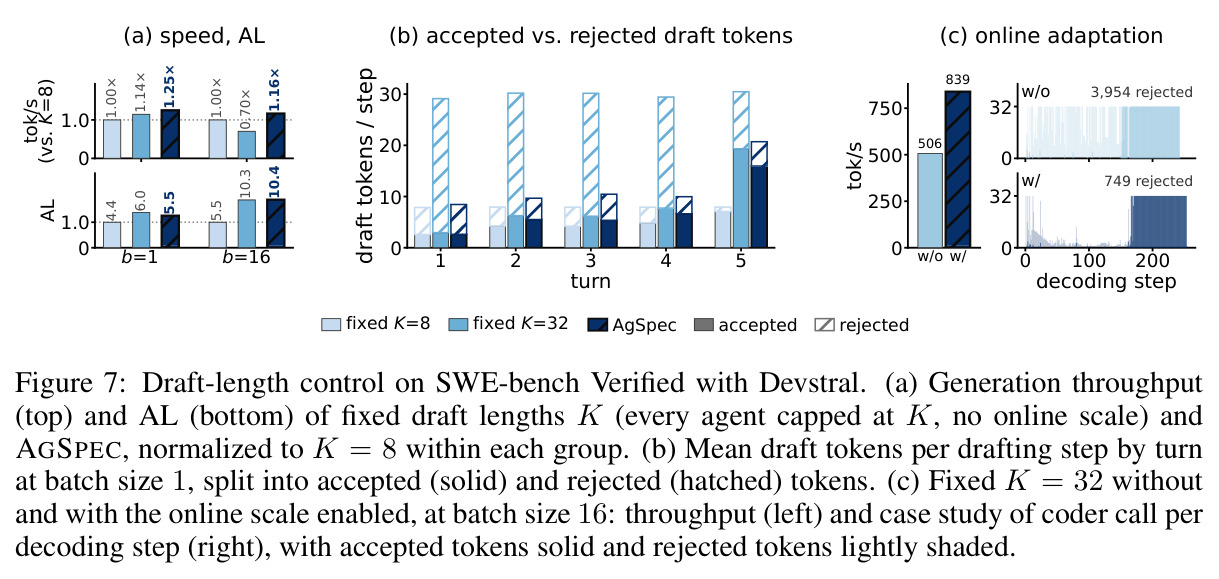
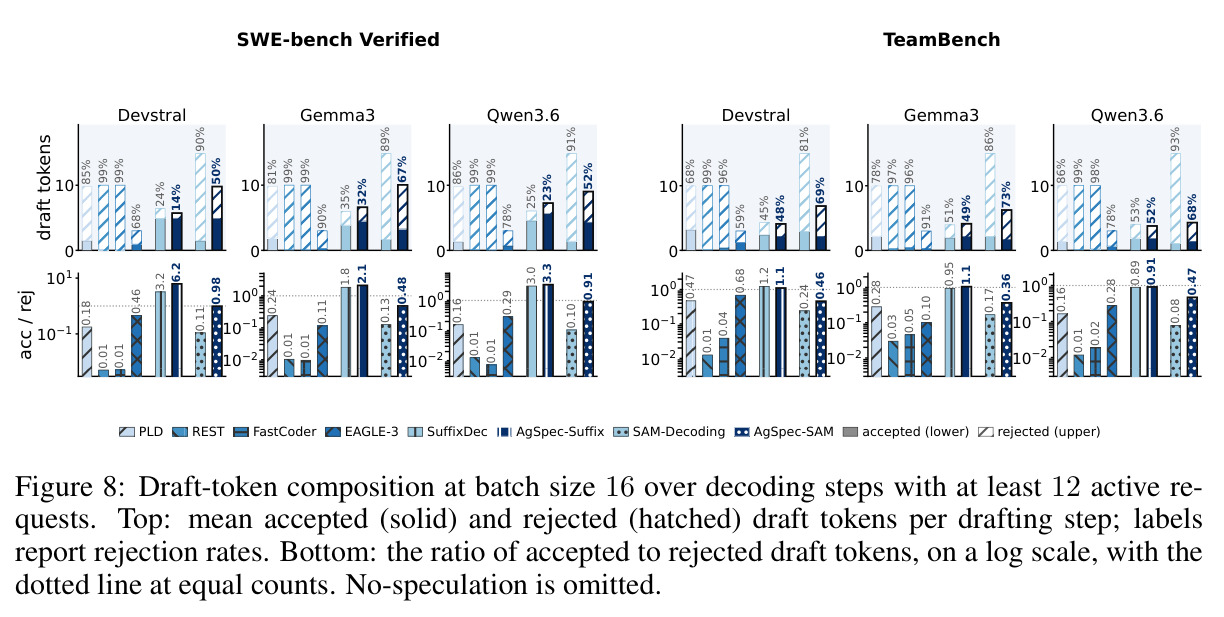
主实验(Fig.4:两仓库基准 × 三模型 × b=1/16):12 个设置中全部最高或次高,b=1 达 AR 的 2.27–4.37×,b=16 达 1.08–4.76×,平均比最快基线高 18.0%(单点最大领先 1.36×,Devstral b=1);Gemma3 b=16 由 2.72× 提至 3.61×;AgSpec-SAM 于 9/12 反超 SuffixDecoding。泛化(Fig.5):LiveCodeBench(无仓库)达 AR 的 4.87–7.94×;Terminal-Bench(单 Agent)超最快基线 9.3–27.2%。语料消融(Fig.6):会话语料使 AL ×1.6–2.1,工作区再 +26–47%(合计 G-only 的 2.9–4.8×);emission form 首轮 +13–39%。长度控制(Fig.7):K=32 在 b=1 快 14% 但 b=16 慢 30%,AgSpec 两边最快;K=32 每步拒 11–26 token 而 AgSpec ≤6;在线 scale 单开在 b=16 提升吞吐 66%。开销占每步 1.1–5.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 仓库级多Agent编码(SWE-bench Verified 与 TeamBench,12个设置) | 生成吞吐(相对 AR 解码的倍数) | b=1 达 2.27–4.37×;b=16 达 1.08–4.76× | AR = 1.00×;次优的检索式基线与 EAGLE-3 在多数设置落后 | 平均比最快先前方法高 18.0%,最大单点领先 1.36×(Devstral, SWE-bench, b=1) |
| SWE-bench Verified,Gemma3-27B,b=16 | 生成吞吐(相对 AR) | 3.61×(AgSpec-SAM) | SAM-Decoding 2.72× | 同一引擎上提升 32.7%(2.72× → 3.61×) |
| LiveCodeBench(无仓库,b=1) | 生成吞吐(相对 AR) | 4.87–7.94×(三模型中最快 AgSpec 变体) | 最快的先前投机方法 | 超出最快先前方法 35–145% |
| Terminal-Bench(单Agent Terminus,b=1) | 生成吞吐与接受长度 AL | 吞吐比最快先前方法高 9.3–27.2%;AL 高 16.7–34.3% | PLD / REST / FastCoder / EAGLE-3 / SuffixDecoding / SAM-Decoding | 即使无显式角色(共享 cap + 单一 α 表)仍全面领先 |
| 草稿 token 组成(b=16,仅统计 ≥12 活跃请求的步) | 草稿拒绝率 | AgSpec-SAM 在 98–99% 的步数上草拟,拒绝率较 SAM-Decoding 降 12.0–39.8 个百分点 | SAM-Decoding 拒绝率 50–56% | 证明收益来自"更短但更准"的草稿而非更少草拟 |
| 语料消融(SWE-bench Verified,b=1,轨迹回放) | 期望接受长度 AL(相对仅全局语料 G) | G + Wr + Ss 达 G-only 的 2.9–4.8×;emission form 使 coder 首轮 AL +13–39% | 仅全局语料 G;per-call 会话语料变体的 AL 反而暴跌 39.3–51.4% | 会话语料 +1.6–2.1×,工作区语料再 +26–47%(叠加后 +2.2–7.0%) |
| 草稿长度控制(SWE-bench Verified,Devstral,SAM 引擎) | 生成吞吐(相对固定 K=8) | AgSpec 在 b=1 高 25%、b=16 高 16%,两个 batch 均最快 | 固定 K=8 / K=32;K=32 在 b=16 比 K=8 慢 30% | 在线 scale 单独开启即提升 b=16 吞吐 66%(拒绝份额 78%→50%) |
局限与改进
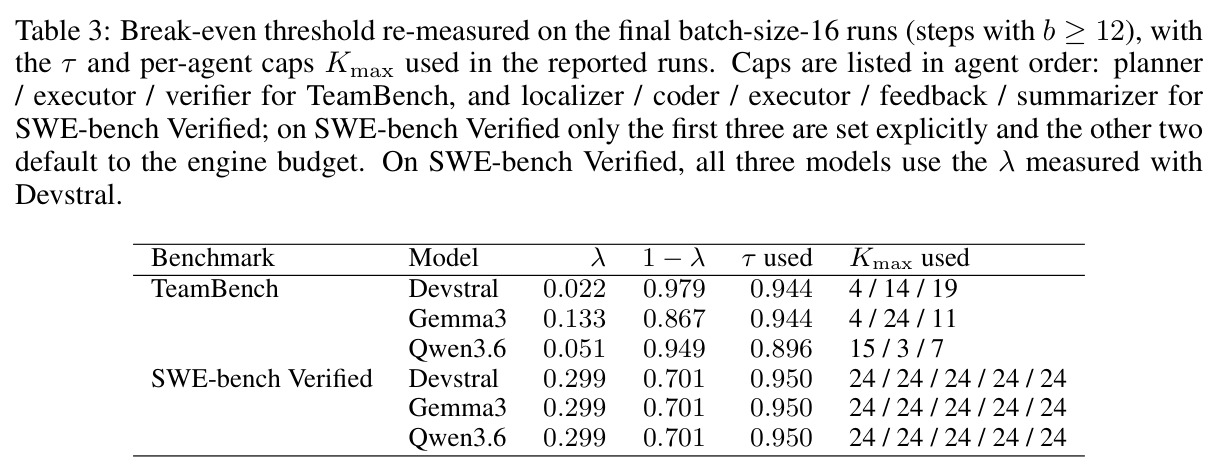
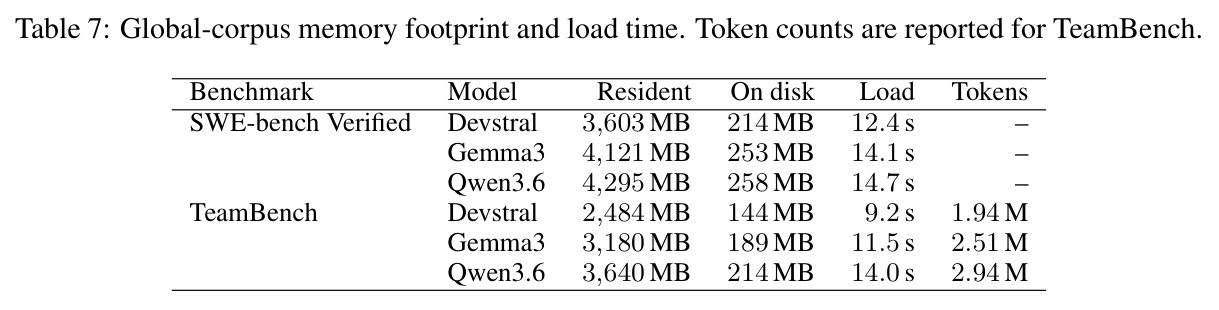
作者承认的局限:(1) 方法主要面向仓库级多 Agent 场景,单 Agent 下须退化为共享 cap 与单一 α 表,收益缩水;(2) 工作区语料跨会话增长无收益(Table 4),同仓库多会话场景留作未来工作;(3) λ 依赖成本 profile,batch 或硬件变化需重测,SWE-bench 三模型直接共用 Devstral 测得的 0.299;(4) 在线 scale 在非平稳分布下不收敛,只在移动目标附近波动(§G.1)。我的观察:(1) 评测规模小——两基准各仅 30 个评测实例,未报告置信区间,Agent 轨迹的随机性可能造成较大波动;(2) 全局语料由同分布任务日志构建(70/213 个任务),对新仓库、新框架的泛化未测,2.5–4.3 GB 驻留内存在多租户服务下是负担;(3) emission form 只穷举 unified diff 两种前缀与整文件转义,其他编辑格式需 scaffold 特定规则;(4) 全部实验用 greedy 解码与固定 seed,采样解码下接受长度分布会变;(5) 与 EAGLE-3 对比固定链深 3,未探索检索与树状草稿的结合。
独立分析的弱点
(1) 语料选择依赖"最长匹配优先",缺乏语义感知:最长匹配若来自偶然重合的样板文本会把草稿带偏,δ=5 余量只保护全局语料,两个活库之间无校正;改进方向:来源置信度评分或对多候选做轻量一致性检验。(2) 在线 scale 只用一位反馈(是否全接受),丢弃"拒到第几个 token"的细粒度信号,α 只波动不收敛,极短会话可能来不及适配;改进方向:利用被拒位置的多级信号,或以检索特征训练小型接受预测器。(3) 离线 cap 需为每个(模型,Agent)组合回放轨迹,新 Agent 上线前要先收集数据,且不同模型 cap 差异悬殊(如 Devstral 4/14/19 vs Qwen3.6 15/3/7),难以迁移;改进方向:冷启动先用引擎预算再快速在线收敛。(4) 大 batch 收益受验证算力上限约束(b=16 多个设置仅 1.08–2.3×),且实验关闭了 prefix caching,与生产 KV cache 管理的相互作用未知;改进方向:与 KV cache/调度联合优化。(5) 工作区为每文件保留多份全文副本,token 占用随打开文件数线性增长;改进方向:大文件分段索引。
未来方向
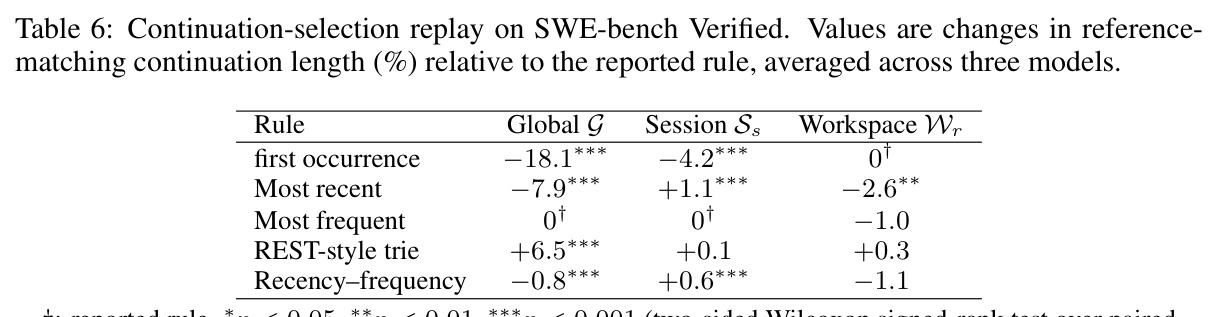
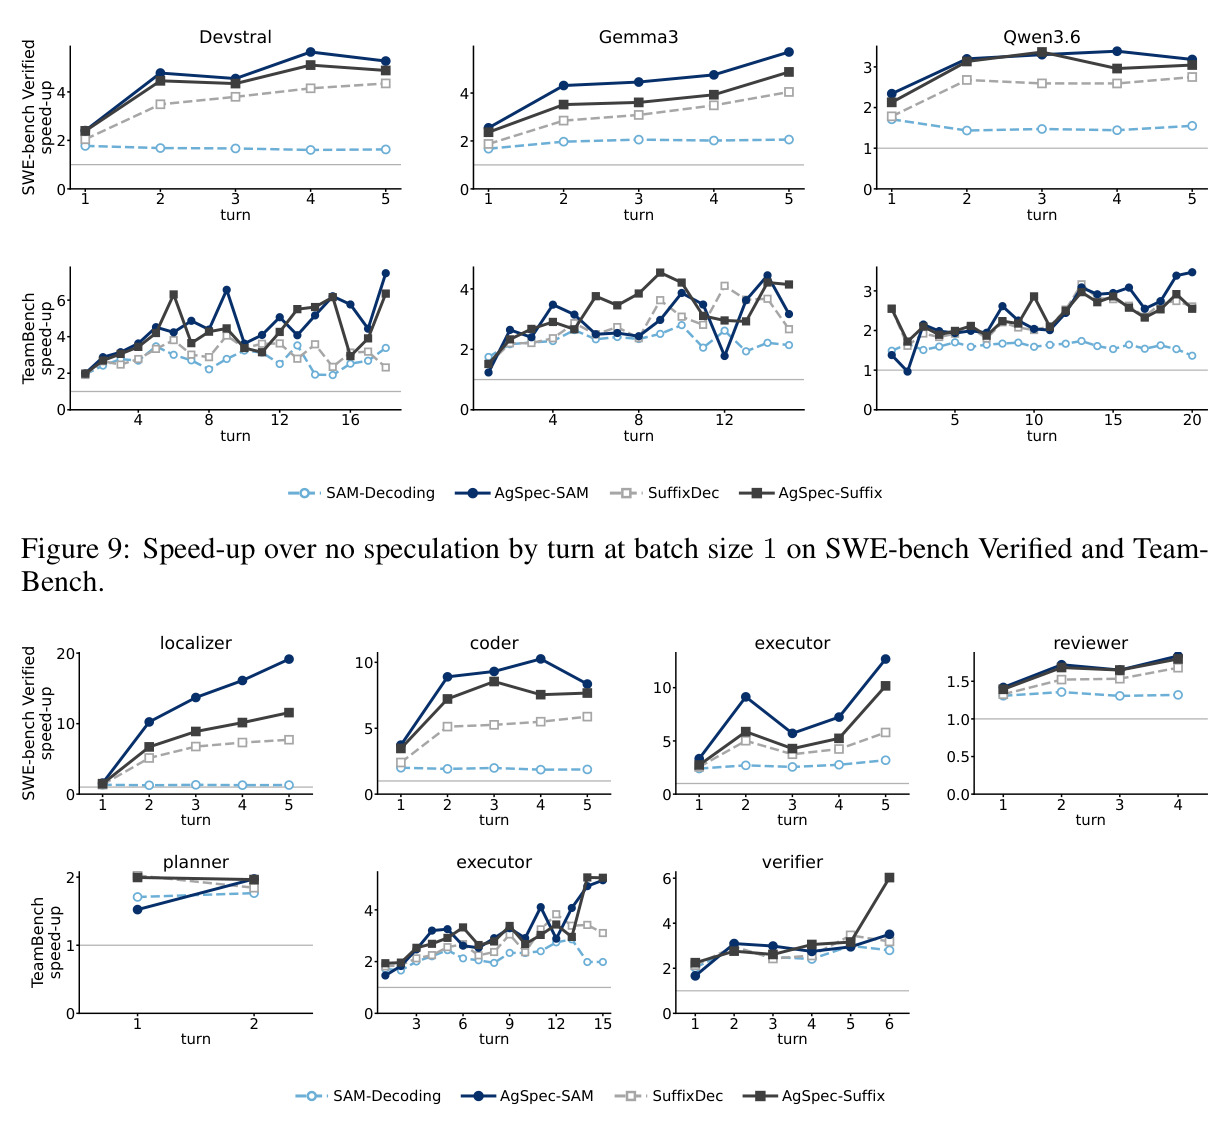
作者提出的:跨会话共享工作区语料(Table 4 显示当前设置无收益,但同仓库多会话的生产场景未覆盖);加速随 Agent 与轮次显著变化且非单调(Fig.9/10),支持按观测轨迹自适应调度投机行为。可延伸的方向:(1) 把"按来源分语料 + 按发射形式索引 + 按 Agent 定长度"推广到通用 Agent 流水线(浏览器、数据分析、DevOps),凡"调用有角色、输出有固定格式、历史有重复"的场景皆适用;(2) 与树状投机结合:检索常返回多个候选延续,可建草稿树而非链(Table 6:REST 式 trie 在全局语料上还有 +6.5% 空间);(3) 以匹配特征训练轻量接受概率模型,兼取免训练草稿器与自适应停止之长;(4) 多租户下的语料隔离与隐私——会话语料含敏感内容,需访问隔离与会话后丢弃,可探索加密检索或语料脱敏;(5) 与 prefix caching 等优化协同:本文为隔离变量关闭了它,真实系统中两者可能相互增强或冲突;(6) 采样解码下重新估计 λ、τ 与 cap,覆盖非贪婪生成的生产主流配置。
复现评估
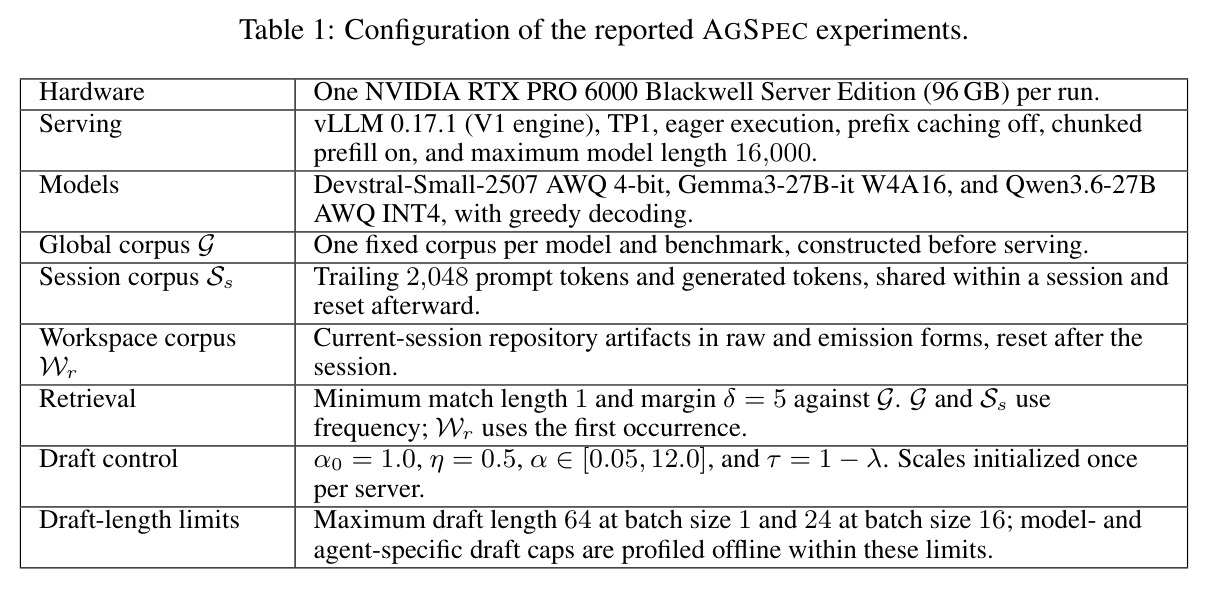
复现条件:细节披露完整——§3.1/§3.2 给出算法,§A/§4.1 给出任务划分(SWE-bench 70/30、TeamBench 213/30)与测量协议;Table 1 给出硬件(单张 RTX PRO 6000 96GB)、软件(vLLM 0.17.1、prefix caching 关、最大长度 16000)、模型(三模型均 4-bit 量化)、greedy 解码与固定 seed;Table 2/3 给出基线配置与各 Agent 的 λ、τ、cap;超参完整($\eta=0.5$、$\delta=5$、$S_s$ 留 prompt 末尾 2048 token)。主要缺口:未提供开源代码链接,这是最大障碍。算力与工程量:单卡 96GB 可跑 27B 级 4-bit 模型,硬件门槛中等;工程量在重建多 Agent 容器化流水线(SWE-bench 五 Agent×5 轮)与把语料和长度控制器嵌入 vLLM 草稿路径。只复现核心算法(三语料 + emission 前缀副本 + 式(1)-(3))约几百行代码。总体:中等难度——算法透明,难点在系统工程与基线对齐。
论文图表
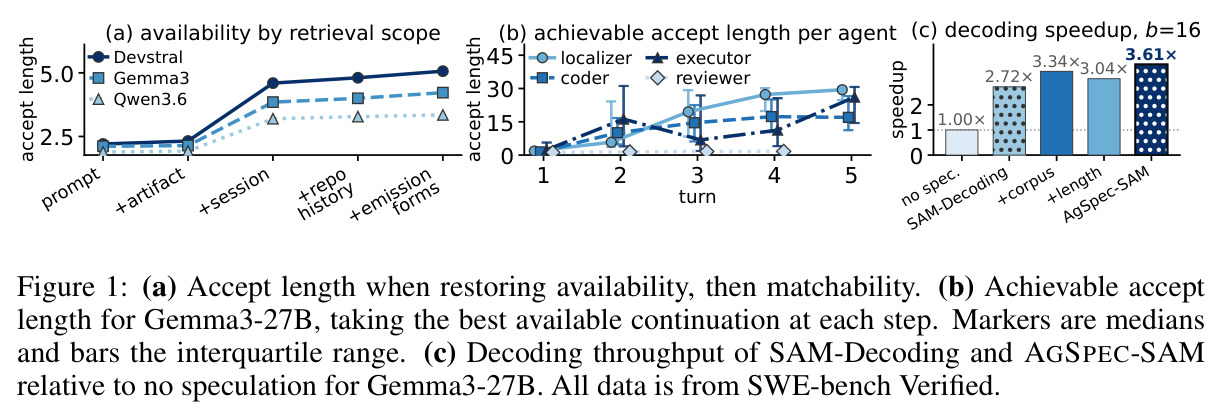
动机三联图。(a) 显示逐步恢复语料可用性(prompt → 工件 → 会话历史 → 仓库 → 发射形式)时三个模型的接受长度均单调上升,其中会话历史增益最大;(b) 显示 Gemma3-27B 各 Agent(localizer/coder/executor/reviewer)的可达接受长度处于截然不同的区间(coder 可达约 45,localizer 仅约 5),且随轮次漂移;(c) 显示 b=16 下 AgSpec-SAM 相对裸 SAM-Decoding 的吞吐提升(2.72× → 3.61×)。
一张图同时给出了论文的三大动机:语料来源要扩展、发射形式要索引、草稿长度要按 Agent 定制,是理解全文问题定义的入口。
用一个 io.py 的最小示例展示同一份代码的两种形态:左侧是工作区文件原文(def load(p): return open(p).read()),右侧是 coder 发出的 unified diff 补丁(---/+++ 头部加 @@ 块,保留行带空格前缀、删除行带减号前缀),红色标注每条被复制行获得的前缀字符。
直观解释了为什么"按文件原样索引"的语料匹配不上 Agent 输出——token 序列因前缀而不同,这是 emission-form indexing 这一核心设计的直观依据。
按 Agent 与轮次双重分解的加速比:SWE-bench 的 localizer/coder/executor/reviewer 与 TeamBench 的 planner/executor/verifier 各自随轮次的加速曲线(TeamBench 为跨模型几何平均)。不同 Agent 的加速区间差异悬殊。
直接可视化"每个 Agent 有自己的加速特征"这一核心观察,是按 Agent 定制草稿长度(离线 per-Agent cap)的经验基础。