万物皆可路由:面向通用AI系统的模型与策略路由研究 Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems
构建25基准37万次运行的全模态轨迹矩阵,统一研究模型路由潜力、训练与效率
前置知识
模型路由(Model Routing)
系统在收到每个输入时,从候选池(多个语言模型、图像/视频/语音生成器、机器人策略或执行计划)中动态挑选一个来处理该输入,而非固定使用同一个模型。理想路由器按价值减去加权成本 $v(s,u)-\lambda c(s,u)$ 在每一状态排序候选,在质量与成本之间按需取舍。
本文的核心研究对象就是路由:理论框架、轨迹矩阵和全部实验都围绕「路由能带来多大增益、路由器怎么训练、何时便宜路由就够」三个问题展开。
最佳固定候选与per-input oracle
最佳固定候选指在训练集上表现最好的单一模型,对所有输入都用它;per-input oracle 是假想的事后路由器,为每个测试输入挑选实际得分最高的候选。两者得分之差就是路由的潜力上限(headroom),任何真实路由器都无法超越这条天花板。
论文所有实验都用这两条外层基线度量路由器,学习型路由器的增益统一表示为它回收的 oracle 差距比例(如 16 基准上回收 6%)。
信息阶梯(Information Ladder)
论文命题3刻画:路由器可观测的状态粒度决定其可达性能,从粗到细有 $V^\star(\sigma_1)\le V^\star(\sigma_2)\le V^\star(x)\le \mathbb{E}\max_u W_u$。基准级对应最佳固定候选,输入级对应 oracle;粗粒度信息只有当它改变最优候选选择时才有价值,最后一项是不可预测的结局噪声。
读懂「任务类型标签只回收8%差距」「路由器要读相机帧」等核心发现,都必须先理解这条阶梯。
Dinkelbach方法与分式规划
效率 $\eta=\mathbb{E}[V_g]/\mathbb{E}[D_g]$ 是质量与成本之比,属于分式规划问题。Dinkelbach 方法把比值最大化转化为一系列带价格参数 $\lambda$ 的线性目标 $J_\lambda(g)=\mathbb{E}[V_g]-\lambda\,\mathbb{E}[D_g]$ 的最大化,迭代更新 $\lambda$ 逼近最优比值。
定理2用 Dinkelbach 加线性规划对偶证明「效率最优路由等价于某个价格下的普通路由」,这是论文成本分析部分的理论支柱。
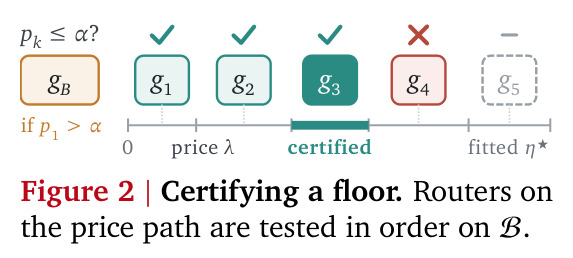
固定序列检验(Fixed-Sequence Testing)
一种多重假设检验方法:预先固定各假设的检验顺序,按顺序逐个检验,在第一个不显著处停止。因为顺序事先确定且停止后不再继续检验,无需 Bonferroni 类多重比较校正即可控制总体第一类错误率。
论文命题5用它在价格路径上逐个认证路由器满足质量底线,把拟合出的无损路线升级为测试集上有 95% 保证的认证路线(CodeRouterBench 上 200/200 个分割成立)。
级联(Cascade)
级联是一种特殊的候选:先用便宜的主模型生成答案,由验证器决定是否接受,拒绝则调用昂贵的参考模型兜底。其价值与成本为 $V=HY_P+(1-H)Y_B$、$D=A+(1-H)C_B$,其中 $H$ 是验证器接受指示,$A$ 是主模型加验证的成本。
RouterBench 上的零损失路由正是靠级联达到 7.1 倍效率;理解级联才能读懂「参考模型入场费 $\lambda_B$」与「何时该调用参考模型」的分析。
研究动机
现有路由研究几乎全部集中在语言模型上:级联方法先试便宜模型再升级到更强模型,另一类从偏好数据中学习路由,还有工作把质量-成本权衡形式化为带预算的优化。但现代 AI 系统早已超出文本范畴:图像与视频生成器、语音合成、代码与办公 agent、机器人 VLA 策略都在同一系统中共存,跨模态的路由是否有增益仍是开放问题。同时,已有研究的比较方法本身有缺陷:固定基线常要求候选在所有训练输入上都有分数,导致强模型因缺少数个分数而被错误排除——论文发现这样的基线会因 Opus 5.5 在 1,122 个 HLE 训练输入中缺 11 个分数而将其降级(HLE 上 52.90 对 58.24、AA-Omniscience 上 70.00 对 77.50),使学习路由器从真实落后 0.40 分变成虚假领先 2.38 分。此外,路由的训练目标该怎么选(学每个候选的结局还是学胜者标签)、路由潜力的上限在哪里,此前都没有统一回答。
本文的目标是本文要建立统一框架 Route Anything,系统回答三个问题:第一,路由能带来多大收益,用 per-input oracle 与最佳固定候选的差距度量潜力上限;第二,学习型路由器能兑现多少潜力,跨文本、图像、视频、语音、代码与机器人训练并匹配比较不同路由器;第三,什么时候一条更便宜的路由就足够好,即引入资源价格、参考策略与质量容差 $Q\ge-\epsilon$,给出经认证的质量底线。为此作者构建了覆盖 25 个基准、7 种能力类型、452 个候选配置、374,401 次评分运行的全模态轨迹矩阵,让池中所有候选在完全相同的输入上运行并打分,并配上两个记录真实 token 价格的代码(CodeRouterBench)与文本(RouterBench)测试床补足成本维度。
与已有工作不同的是,本文的独特切入有三点。范围上,它首次在语言理解、图文问答、图像/视频/语音生成、代码与办公 agent、机器人操作的 25 个基准上,用同一套理论和同一个矩阵研究路由,而以往工作基本局限于单一模态或单一任务。理论上,它用信息阶梯刻画「路由器能看什么决定它能达到什么」,证明了学习结局回归优于胜者分类(命题4),并把质量底线转化为固定序列检验下的有限样本认证问题(命题5)。方法学上,它强调候选必须在相同输入上比较、增益必须对允许 fallback 的匹配固定基线度量,并实证展示违反这两条会颠倒结论。认证设计也与众不同:价格不是手工调的预算,而是由参考策略和质量容差内生决定,这把「省钱」从启发式变成了可证明的保证。
核心方法
论文把输入 $x$、候选菜单、候选价值 $V_u\in[0,1]$(基准指标)与成本 $D_u>0$(美元或秒)放进统一框架。路由器观察状态 $s=\sigma(x)$ 并选候选 $g(s)$,在价格 $\lambda$ 下最大化 $J_\lambda(g)=\mathbb{E}[V_g]-\lambda\mathbb{E}[D_g]$。定理2用Dinkelbach方法与线性规划对偶证明:$J_\lambda$ 最优者恰在每状态最大化 $v(s,u)-\lambda c(s,u)$,且在 $Q\ge-\epsilon$ 下最大化效率等价于价格 $\lambda_\epsilon$ 下的普通路由,信息阶梯(命题3)刻画可观测信息对可达性能的约束。实证上先构建25基准、452候选配置、374,401次评分运行的全模态轨迹矩阵,再微调Qwen3.5-4B训练三类路由器(outcome/type/winner-label),最后在带价格的CodeRouterBench与RouterBench上分析效率并认证底线;路由器单次决策仅0.13秒(H20 GPU),远小于图像生成的27-158秒。
核心是三个互相支撑的想法。其一,信息决定上限:信息阶梯证明粗粒度状态只有在改变最优候选选择时才有价值,这直接解释了为什么 107 个叶子的能力类型即便事后选择也只回收 8% 的 oracle 差距,而机器人路由器必须读取三帧相机图才能跟踪场景条件下的最优策略。其二,学结局不学赢家:命题4证明对每个候选回归 $\mathbb{E}[V_u|x]$ 并取 argmax 可达 $V^\star(x)$,而胜者标签可能损失近半价值区间——机器人上 94% 的胜者标签由延迟平局规则决定,31,408 个成功训练结局中有 24,556 个成为错类目标,导致胜者分类器仅 42.8% 成功率而结局回归达 71.6%。其三,参考与容差自动定价:定理2(ii) 表明在 $Q\ge-\epsilon$ 下最大化效率等价于价格 $\lambda_\epsilon=\eta^\star_\epsilon/(1+\kappa)$ 下的路由,无需手调预算;推论6进一步给出参考模型的入场费判据——若 $\lambda_B<\eta^\star$,最优路由器从不调用参考模型。
方法步骤详情
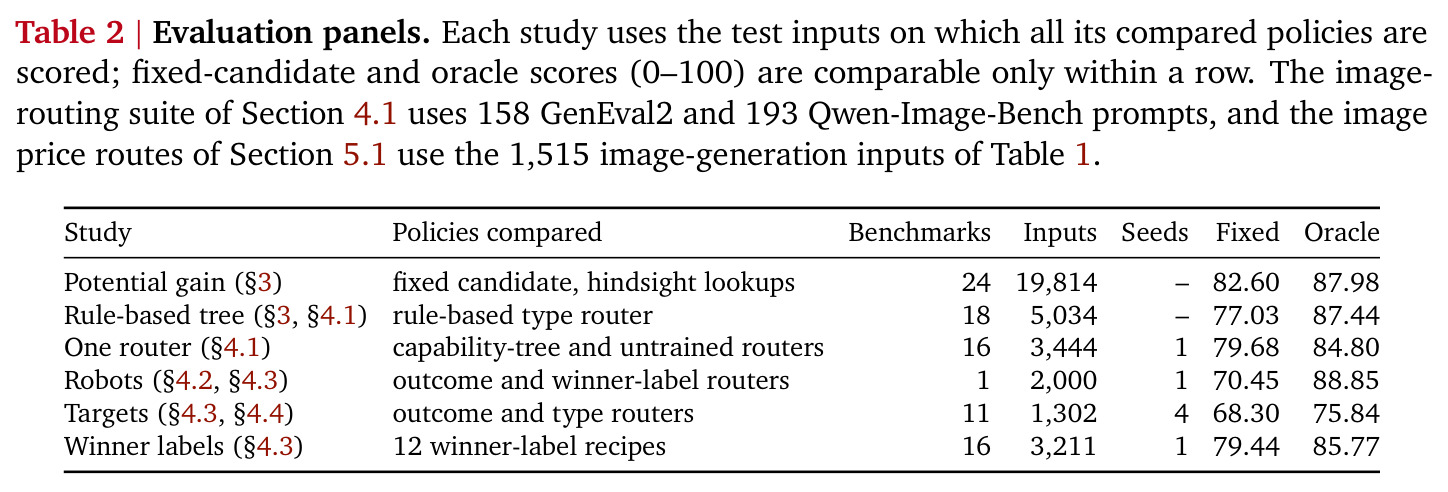
第一步构建轨迹矩阵:452个候选配置(四个语言模型Opus 5.5、GPT-6.1 Sol、DeepSeek V4.1 Flash、GPT-6 Astra,各类生成器,7个机器人VLA策略)在25基准的相同输入上运行,共374,401次评分运行。第二步按来源组70/10/20划分训练/开发/测试集,同源输入不跨集;RoboTwin的2,000个测试场景来自训练未见过的10个任务。第三步训练路由器:outcome路由器对每个输入-候选对用sigmoid头回归归一化结局并选最高分者;type路由器(能力树157叶)分类后查拟合的最优候选表,无法归类则回退固定候选;winner-label路由器预测胜者。第四步匹配评估:只在全部比较策略都有结局的测试输入上评分,用配对95%自助区间。第五步价格与认证:在CodeRouterBench(8模型、9,999任务)与RouterBench(11模型、36,497提示)上按 $V=HY_P+(1-H)Y_B$、$D=A+(1-H)C_B$ 构造级联,拟合满足 $Q\ge-\epsilon$ 的路线,沿价格路径用固定序列检验认证。
技术新颖性
与 Dekoninck 等把拉格朗日价格调到预算目标的做法不同,本文的价格由参考策略与质量容差内生确定,并附有限样本认证——拟合的零损失底线在 200 个随机对半分割中仅 12.5% 在测试集上成立,而认证版全部 200 个成立、中位效率 19.4 倍。与从胜者偏好学习的路由不同,命题4从理论上证明结果回归可达 oracle 而胜者分类在最坏情况下损失近半价值,机器人实验以 71.6% 对 42.8% 验证。与 RouterBench、CodeRouterBench 等单一模态基准不同,全模态矩阵让跨模态路由第一次可测:同一理论、同一协议覆盖七种能力类型。方法学上的匹配比较规则也是新的贡献:固定基线必须允许 fallback、组合必须在同任务上对比,否则结论会翻转——在 11 基准研究中,未匹配基线把路由器的 -0.40 分劣势错报成 +2.38 分优势;组合比较的相同任务法在 CodeRouterBench 上选对最佳新增模型的比例达 96.4-97.1%,冻结平均法只有 86.3-94.3%。
实验结果
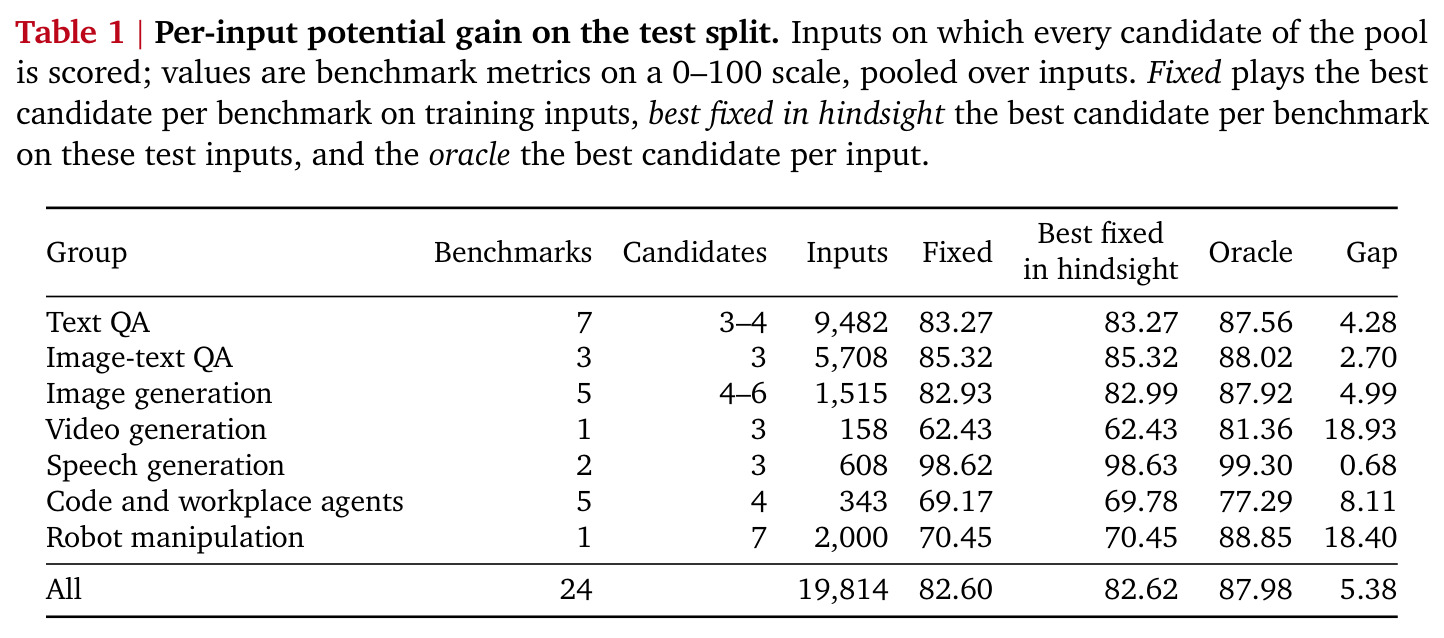
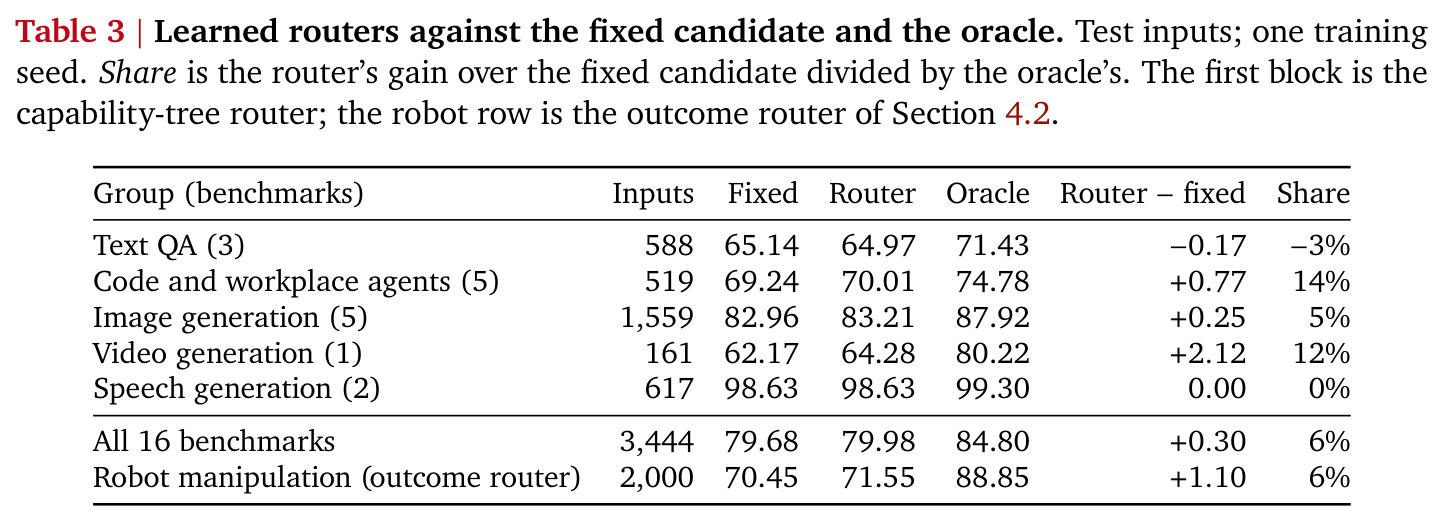
七大发现。一是潜力大:24基准19,814个测试输入上oracle 87.98对固定候选82.60,差距5.38分;视频生成18.93、机器人18.40,语音仅0.68;事后按类型选最佳只回收8%差距。二是学习路由器小幅胜出:16基准能力树路由79.98对固定79.68(+0.30,oracle 84.80),视频+2.12;但图像生成124个配置无一显著超过固定生成器。三是机器人读场景路由:成功率71.55%对最佳单策略70.45%(+1.10),策略时间14.51秒降到11.05秒(-24%),每秒成功率1.33倍。四是学结局不学赢家:结局回归71.6%对胜者分类42.8%,94%标签由延迟平局决定。五是匹配比较必不可少:修正后基线68.30对65.52,路由器从-0.40变+2.38。六是便宜路线够用:四测试床平均8.82倍,代码25.5倍、文本QA 7.1倍;认证底线在200/200分割成立、中位19.4倍而拟合版仅12.5%;图像生成省26%成本只损0.47分。七是富候选须物有所值:失败使下一模型成功率约减半(中位0.49),免费编译门4.09倍,标价LLM裁判0.30倍。
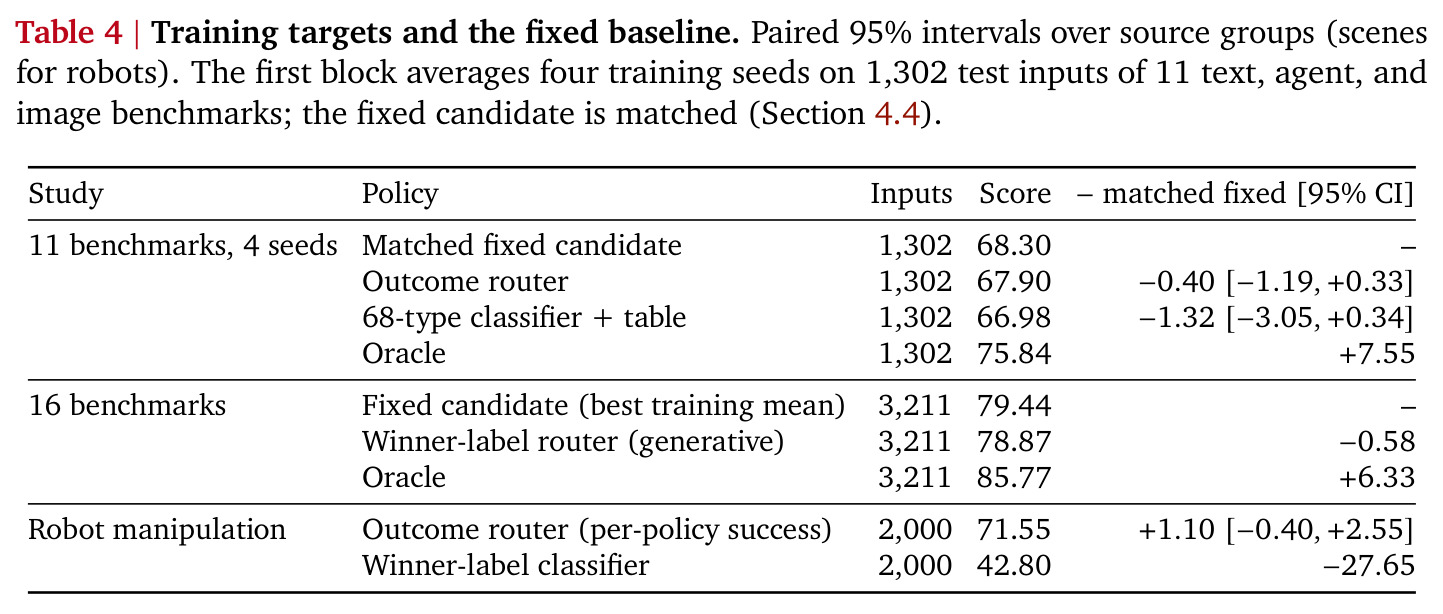
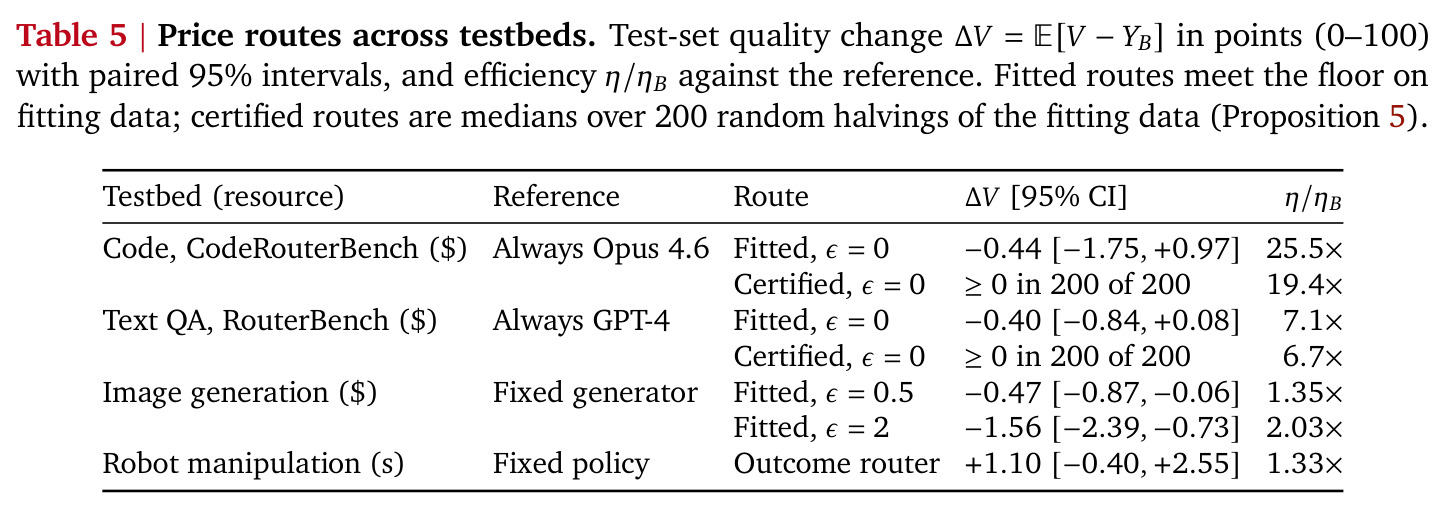
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨 24 基准的潜力上限(固定候选 vs oracle) | 池化基准指标(0-100) | oracle 87.98 | 最佳固定候选 82.60 | +5.38 分(视频生成 +18.93、机器人 +18.40、语音仅 +0.68) |
| 16 基准学习路由(能力树路由器) | 池化基准指标(0-100) | 路由器 79.98 | 固定候选 79.68 / oracle 84.80 | +0.30 分(回收 oracle 差距 6%;视频生成 +2.12,回收 12%) |
| RoboTwin 机器人操作(2,000 测试场景) | 成功率 % / 每场景策略秒 | 71.55%,11.05 秒 | 最佳单策略 70.45%,14.51 秒 | +1.10 分且时间 -24%,每秒成功率 1.33 倍 |
| CodeRouterBench 代码路由(零损失 $\epsilon=0$) | 相对参考的效率 $\eta/\eta_B$ | 拟合 25.5 倍;认证 200/200 分割、中位 19.4 倍 | 始终调用 Opus 4.6(0.4383 分、11.655 m$/任务) | 质量损失 -0.44 分下效率 25.5 倍 |
| RouterBench 文本 QA 路由(零损失) | 相对参考的效率 $\eta/\eta_B$ | 拟合 7.1 倍;认证 6.7 倍 | 始终调用 GPT-4(gpt-4-1106-preview) | 质量损失 -0.40 分下效率 7.1 倍 |
| 图像生成价格路由($\epsilon=0.5$) | 成本降幅 / 质量变化 | 测试成本 -26% | 每基准最佳固定生成器 | 仅 -0.47 分质量损失,效率 1.35 倍 |
| 机器人训练目标对比(同输入同骨干) | 成功率 % | 结局回归 71.6% | 胜者标签分类 42.8% | +28.8 分(94% 胜者标签由延迟平局决定) |
局限与改进
作者承认的局限:学习型路由器的平均增益只有 0.3 分,远低于 5.4 分的 oracle 差距,增益集中在代码 agent、视频与图像生成;图像生成上 124 个路由配置无一显著超过固定生成器,其中 44 个还显著更差;文本 QA 组甚至 -0.17 分;七个理解类基准(MMLU-Pro、MMLU-Redux、SuperGPQA、GPQA 和三个图文 QA,占 3/4 输入、一半池化差距,差距 1.4-6.0 分)被排除在学习实验之外。我的补充观察:oracle 差距中有相当部分是不可预测的结局噪声,如 AA-LCR 上 oracle 的 2.4 分优势在三次运行取均值后完全消失,说明潜力上限本身可能被噪声高估;68 类型分类器 75% 准确却把 93% 的预测映射到与真实类型相同的候选,得分反比匹配基线低 1.32 分,说明有效的中间粒度状态尚未找到;机器人路由器 71.55% 甚至低于按场景条件选择的 72.1%,说明像素级信息尚未真正兑现;价格采用列表价,与实际折扣、缓存命中下的成本差异很大;研究限于单步任务与固定菜单,多轮对话、长程任务和候选池随时间变化的情况未覆盖。
独立分析的弱点
弱点一:类型路由的信息瓶颈。68 类型分类器准确率 75%,但 93% 的预测映射到与真实类型相同的候选,得分仍比匹配基线低 1.32 分(CI [-3.05,+0.34]),说明「离散类型+查表」不携带输入级信息;改进方向是学习连续的质量预测头、检索增强的路由特征或代码子维度聚类等中间粒度状态。弱点二:胜者标签目标虽被证伪,但简单弃用未必最优——标签中的成本信息仍有价值,可显式建模平局类、按延迟归一化效用或用对比学习处理并列结局。弱点三:成本测量粗糙。图像生成路线在测试集上 -0.47 分(CI [-0.87,-0.06] 不含 0)却宣称满足 0.5 分容差,暴露拟合路线的分布偏移;LLM 裁判按标价只有 0.30 倍效率完全不可用,实际部署需谈判价格或缓存裁决结果。弱点四:机器人路由只兑现了条件级粗粒度——路由器 71.55% 反而低于按 clean/随机化条件选择的 72.1%,剩余 17 个百分点的 oracle 差距需要预测单个场景的成败,这对场景理解与因果泛化提出更高要求。弱点五:效率结论依赖参考模型选择,参考换代会改变所有 $\eta/\eta_B$ 数字。
未来方向
作者在附录 A.8 与 A.9 已搭好重试与路由器记忆的理论框架,但实证只做了初步检验(DeepSeek-v4-pro 成败预报花 2.4 次尝试的代价,prompt-only TF-IDF 预报仅 0.06% 次尝试),在线记忆、顺序决策与主动信息购买值得深化;认证底线也可推广到时变价格与非平稳部署。基于成果可延伸的方向:一是寻找任务类型与完整输入之间的有效中间粒度——类型只回收 8% 差距而输入级 oracle 有 5.4 分空间,聚类或检索式状态可能兑现更多;二是主动探测,即花小代价试探候选以获取信息,用价值-信息权衡形式化;三是把并行多候选执行再择优纳入路由统一框架,与级联互补;四是利用失败后成功率约减半(中位 0.49)的规律为重试策略定价,设计自适应重试预算;五是在真实生产价格(折扣、批量、缓存命中)下重新校准 8.82 倍的平均效率结论;六是把认证流程做成部署管线的一等公民,随数据漂移周期性重认证。
复现评估
论文提供项目页、GitHub 与 HuggingFace 入口;CodeRouterBench 与 RouterBench 是公开基准,RoboTwin 为开源仿真环境。复现门槛分两档:训练路由器本身不难——Qwen3.5-4B 微调、每策略一个 sigmoid 头,单张 H20 GPU 可完成,推理每决策 0.13 秒;机器人路由器在 49,000 条训练结局上训练,仿真成本可控。但完整复现轨迹矩阵代价极高:374,401 次评分运行涉及顶级闭源模型的 API 费用,视频生成每条 211-314 秒、图像生成每张 27-158 秒,还需要真实模型调用产生验证器判定与成败预报。普通实验室的现实路径是复用作者发布的运行数据,只重训路由器与认证流程。理论部分自包含:附录 A 给出全部证明(引理1、定理2、命题3-5、推论6),附录 B-D 给出基准、路由器、价格与局限的细节,复现实验协议所需信息完整。
论文图表
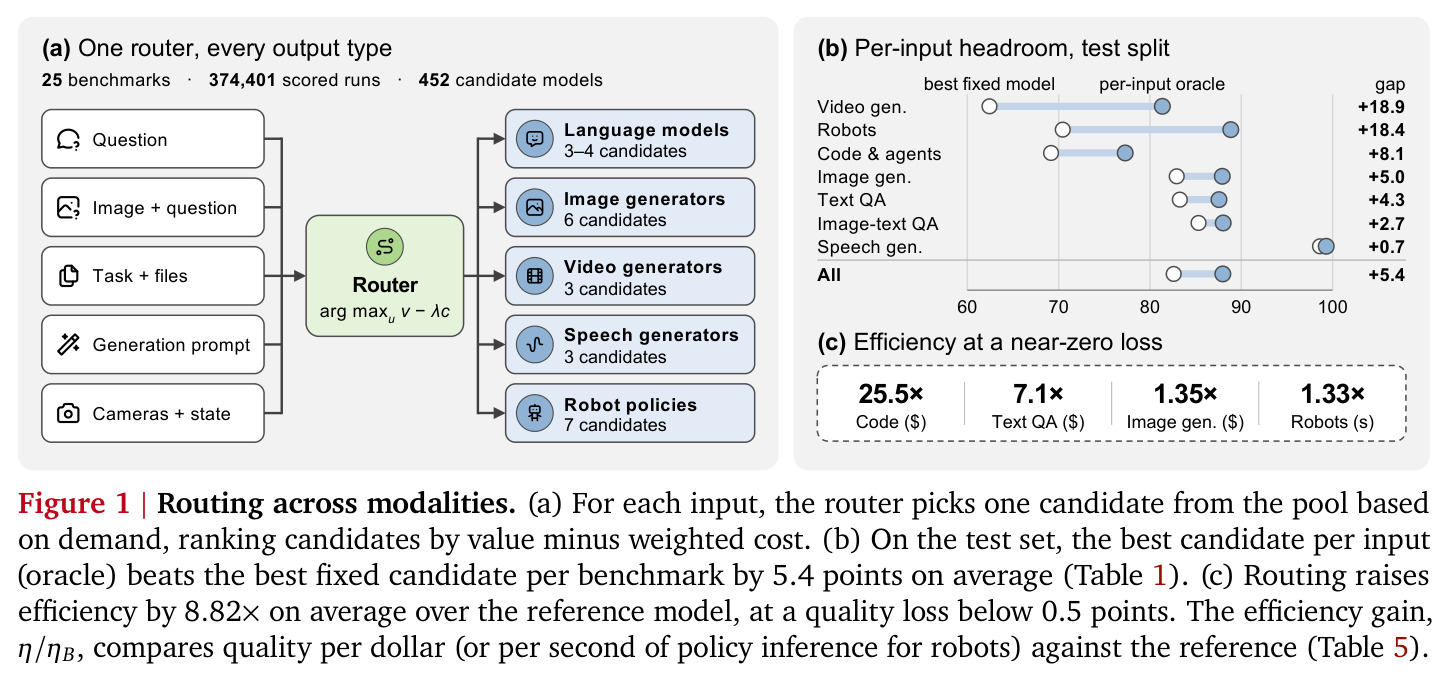
三联总览图。(a) 一个路由器覆盖所有输出类型:语言模型、图像/视频/语音生成器、代码与办公 agent、机器人策略都在候选池中,路由器按 argmax 的 $v-\lambda c$ 为每个输入选一个候选。(b) 测试集上的每输入提升空间:视频生成 +18.9、机器人 +18.4、代码 +8.1、图像生成 +5.0、文本 QA +4.3、图文 QA +2.7、语音 +0.7,全体 +5.4。(c) 近零质量损失下的效率:代码 25.5 倍、文本 QA 7.1 倍、图像生成 1.35 倍、机器人 1.33 倍。
这是全文的地图:一图同时呈现路由的统一框架、潜力上限的空间分布和成本效率三大卖点,读完它就掌握了论文的问题设定与核心数字。
展示 oracle 差距能被不同粒度的事后选择回收多少:按基准选最佳候选只回收 0.4%(99.6% 的差距在类型内部),按能力类型回收 8%(92% 在类型内部),机器人按任务与场景条件回收 23%(77% 在条件内部)。
它是信息阶梯最直观的实证:证明粗粒度标签几乎不携带可用信息,增益必须到输入级去找,直接支撑「为什么类型路由只能小胜」的解释。
机器人实验的核心图:2,000 个测试场景分 clean 与 domain-randomized 两半。ME-Dex 在 clean 场景 78.4%、随机化场景 62.5%;PatchWAM 则是 81.7% 对 45.6%,最优策略随条件翻转;路由器把 929/1000 个 clean 场景发给 PatchWAM、842/1000 个随机化场景发给 ME-Dex,两侧分别得 81.6% 与 61.5%,总体 71.55%,且每场景策略时间 11.05 秒对 14.51 秒(-24%)。
它展示学习型路由器最扎实的跨模态胜利:从三帧相机图读出场景条件并跟踪翻转的最优策略,同时省时间,是视觉路由可行性的直接证据。
机器人训练目标诊断图:31,408 个成功训练结局中 6,852 个保留正确标签、24,556 个变成错类标签,94% 的胜者标签由延迟平局规则决定,导致胜者分类器学会选快但常失败的策略(1.9 秒/场景),成功率仅 42.8%,而结局回归达 71.6%、最佳单策略 70.5%。
它给命题4提供了最有说服力的机制级证据:说明标签为何被污染、错在哪个环节,对任何要训练路由器或偏好模型的实践者都是关键警示。
展示固定基线的选择规则如何翻转结论:要求候选在每个训练输入都有分数的基线(因 Opus 5.5 在 HLE 缺 11/1,122 分等)会把 outcome 路由器的 -0.40 分劣势错报成 +2.38 分优势;允许 Opus 5.5 用 GPT-6 Astra fallback 的匹配基线才反映真相,HLE 上 58.24 对 52.90、AA-Omniscience 上 77.50 对 70.00。
它是方法学警示图:证明评测协议的细节能制造虚假的路由增益,对复现和比较路由论文的读者具有普遍方法论价值。
在价格轴(以 $\eta_B$ 为单位、对数刻度)上对比两个测试床:CodeRouterBench 上参考入场费 $\lambda_B=2.9\,\eta_B$ 低于零损失底线价格 $\lambda_\epsilon=4.2\,\eta_B$、更远低于 $\eta^\star$,所以路由器从不调用参考(reference-free);RouterBench 上 $\lambda_\epsilon=1.6$ 低于 $\lambda_B=5.85$,参考必须保留在级联末端。
它把推论6的入场费判据可视化,解释了为什么代码路由能彻底甩开 Opus 而文本 QA 必须级联到 GPT-4,是理解效率差异机制的关键。